Questo articolo presenta un flusso di lavoro bioinformatico riproducibile che integra set di dati trascrittomici pubblici, apprendimento automatico, validazione esterna, PCR quantitativa a retrotrascrizione, screening della Connectivity Map e docking molecolare per identificare biomarcatori dell'ipertensione polmonare e composti terapeutici candidati.
Articolo di ricerca
Identificazione di biomarcatori per l'ipertensione polmonare e di composti terapeutici candidati tramite bioinformatica e apprendimento automatico
In questo articolo
Sommario
Abstract
Questo studio ha avuto lo scopo di identificare biomarcatori molecolari associati all'ipertensione polmonare (PH) e composti di piccole molecole candidati, utilizzando dati trascrittomici pubblici e risorse indipendenti di validazione. Tre dataset del Gene Expression Omnibus (GSE22356, GSE33463 e GSE48149) sono stati integrati dopo normalizzazione, annotazione delle sonde e correzione dell'effetto batch con ComBat. Sono state impiegate analisi di espressione differenziale, analisi di rete co-espressiva pesata dei geni, analisi di arricchimento funzionale, analisi di rete di interazione proteina-proteina e tre algoritmi di apprendimento automatico per identificare i geni chiave. Le prestazioni diagnostiche sono state valutate mediante curve ROC (receiver operating characteristic). La validazione esterna ha incluso una coorte indipendente di tessuto polmonare (GSE117261), un dataset di sequenziamento dell'RNA a singola cellula dell'arteria polmonare (GSE210248) e una validazione mediante PCR quantitativa a retrotrascrizione inversa su campioni di tessuto polmonare indipendenti. La riposizionamento di farmaci basato sulla Connectivity Map e il docking molecolare sono stati utilizzati per selezionare composti candidati. Sono stati identificati 78 geni differenzialmente espressi, e CXCL10, JUN, IFIH1, MX1 e TLR7 sono stati selezionati come geni chiave. Nella coorte indipendente di tessuto polmonare GSE117261, JUN ha mostrato il supporto esterno più forte, mentre la replicazione degli altri geni è risultata variabile. La PCR quantitativa a retrotrascrizione inversa su 20 campioni biologicamente indipendenti di ipertensione arteriosa polmonare e 20 campioni di controllo ha confermato l'upregolazione di tutti e cinque i geni. Il modello apparente di qRT-PCR a cinque geni e le analisi di cross-validazione stratificata ripetuta cinque volte per 100 volte hanno entrambi prodotto un'area sotto la curva di 1,000, sebbene la piccola dimensione del campione richieda un'interpretazione cauta e una validazione prospettica indipendente. L'analisi a singola cellula del dataset GSE210248 ha supportato un'alterata comunicazione tra cellule immunitarie e cellule strutturali e un cambiamento fenotipico delle cellule muscolari lisce. BRD-K91900765/VX-745 ha ottenuto il punteggio più alto nel screening della Connectivity Map. MAPK14/p38α, il suo noto bersaglio farmacologico, è stato incluso come proteina di riferimento positiva per il docking, mentre il docking contro le cinque proteine associate ai biomarcatori è stato considerato esplorativo. Questi risultati supportano i cinque geni come biomarcatori candidati per la PH e VX-745 come ipotesi di riposizionamento farmacologico computazionale da validare sperimentalmente.
Introduzione
L'ipertensione polmonare (PH) è un disturbo cardiopolmonare progressivo caratterizzato da una pressione arteriosa polmonare persistentemente elevata, da un aumento della resistenza vascolare polmonare e da un'insufficienza ventricolare destra conclamata. I criteri emodinamici attuali definiscono la PH come una pressione arteriosa polmonare media a riposo pari o superiore a >20 mmHg, misurati mediante cateterizzazione del cuore destro1Tra i diversi sottotipi clinici, l'ipertensione arteriosa polmonare (PAH) è una delle forme più gravi ed è caratterizzata da un rimodellamento progressivo dei vasi polmonari. Le sue caratteristiche patologiche includono disfunzione endoteliale, proliferazione e migrazione anomala delle cellule muscolari lisce arteriose polmonari, attivazione dei fibroblasti avventiziali, deposizione della matrice extracellulare, infiltrazione di cellule infiammatorie e restringimento o occlusione delle arterie polmonari distali.2Questi cambiamenti indicano che l'ipertensione polmonare/ipertensione arteriosa polmonare (PH/PAH) non è soltanto un disturbo della vasocostrizione, ma anche una malattia complessa di rimodellamento vascolare determinata da meccanismi molecolari, cellulari e infiammatori-immunitari coordinati.
Le attuali terapie per l'ipertensione arteriosa polmonare (PAH) mirano principalmente alle vie del prostaciclina, endotelina, ossido nitrico–guanilato ciclasi solubile e fosfodiesterasi di tipo 53˒4. Sebbene questi trattamenti migliorino i sintomi, la capacità di esercizio e i parametri emodinamici, i loro effetti rimangono prevalentemente vasodilatatori ed emodinamici. La loro capacità di invertire il rimodellamento vascolare polmonare già instaurato è limitata e molti pazienti continuano a presentare un progressivo aggravamento della malattia nonostante la terapia combinata. Pertanto, l'identificazione di nuovi biomarcatori molecolari e di potenziali bersagli terapeutici che riflettano il processo di rimodellamento rappresenta un importante bisogno insoddisfatto. In particolare, l'attivazione immunitario-infiammatoria, i segnali correlati agli interferoni, le vie dei recettori tipo Toll, il reclutamento immunitario mediato da chemochine e il passaggio fenotipico delle cellule muscolari lisce si sono rivelati possibili fattori coinvolti nella progressione dell'ipertensione polmonare (PH)/PAH5˒6.
I dataset trascrittomici ad alto rendimento forniscono risorse preziose per l'identificazione di firme molecolari associate a malattie nell'ipertensione polmonare (PH/PAH). Tuttavia, gli studi basati su un singolo dataset sono spesso limitati da piccole dimensioni del campione, effetti di lotto, eterogeneità delle piattaforme e validazione insufficiente. L'analisi dell'espressione differenziale può identificare geni con espressione alterata, ma potrebbe non cogliere pienamente i moduli di co-espressione correlati alla malattia o le interazioni a livello di rete. L'analisi della rete di co-espressione genica pesata (WGCNA) può identificare moduli genici associati a caratteristiche della malattia, mentre l'analisi della rete di interazione proteina-proteina (PPI) può rivelare geni altamente connessi all'interno delle reti biologiche. I metodi di apprendimento automatico (machine learning) possono inoltre selezionare geni con valore diagnostico o di classificazione. Tuttavia, il ricorso a un singolo algoritmo potrebbe introdurre un bias specifico del modello. L'integrazione dell'analisi dell'espressione differenziale, della WGCNA, dell'analisi della rete PPI e di più algoritmi di machine learning potrebbe quindi migliorare la robustezza nella scoperta di biomarcatori.
Un'altra sfida importante negli studi sui biomarcatori trascrittomici è l'interpretazione biologica. I segnali derivanti da tessuti bulk possono riflettere cambiamenti nell'espressione genica all'interno delle cellule vascolari residenti, l'infiltrazione di cellule immunitarie o proporzioni alterate di diverse popolazioni cellulari. Il sequenziamento dell'RNA a singola cellula offre l'opportunità di collocare i geni candidati derivati dai dati bulk in un contesto cellulare. Nell'IP/AIP, il rimodellamento vascolare polmonare coinvolge cellule endoteliali, cellule muscolari lisce, fibroblasti, monociti/macrophagi, linfociti e altre cellule immunitarie o strutturali. Alla progressione della malattia è inoltre associata una comunicazione alterata tra le cellule e il passaggio fenotipico delle cellule muscolari lisce. Pertanto, combinare lo screening trascrittomico bulk con una validazione a singola cellula può aiutare a determinare se i biomarcatori candidati siano associati all'attivazione immunitaria, al rimodellamento strutturale vascolare o a uno squilibrio nella comunicazione multicellulare.
Oltre alla scoperta di biomarcatori, le firme trascrittomiche possono essere utilizzate per il riposizionamento computazionale di farmaci. La mappa di connettività (Connectivity Map, CMap) collega profili di espressione genica associati a malattie con piccole molecole che potrebbero invertire o modulare tali firme7. Quando combinata con la cura dei composti e il docking molecolare, questa strategia può generare ipotesi terapeutiche verificabili sperimentalmente. Sebbene le previsioni di CMap e il docking molecolare non possano stabilire l'efficacia di un farmaco, possono selezionare composti candidati da sottoporre a futuri saggi di legame al bersaglio, esperimenti su cellule e validazione in modelli animali.
È stato sviluppato un flusso di lavoro integrato e riproducibile per identificare biomarcatori e composti terapeutici candidati per l'ipertensione polmonare (PH)/ipertensione arteriosa polmonare (PAH). Tre dataset trascrittomici pubblici del Gene Expression Omnibus sono stati integrati dopo normalizzazione e correzione degli effetti di batch. Sono state utilizzate analisi di espressione differenziale, WGCNA, analisi di arricchimento funzionale, analisi della rete di interazione proteina-proteina (PPI) e tre algoritmi di apprendimento automatico (machine learning) per selezionare geni caratteristici robusti. L'analisi della curva ROC (receiver operating characteristic), un coorte di validazione indipendente su tessuto polmonare, evidenze da sequenziamento dell'RNA a singola cellula dell'arteria polmonare e la validazione mediante PCR quantitativa a retrotrascrizione inversa su campioni indipendenti sono state impiegate per ulteriori valutazioni dei geni selezionati. Infine, il riposizionamento di farmaci basato su CMap e il docking molecolare sono stati applicati per identificare composti candidati. La novità dello studio risiede nel suo schema di validazione multilivello, che collega la scoperta trascrittomica su popolazione cellulare eterogenea (bulk), la priorizzazione mediante apprendimento automatico, la validazione indipendente, la conferma sperimentale con PCR quantitativa a retrotrascrizione inversa, l'interpretazione meccanicistica a singola cellula e lo screening computazionale di composti. L'ipotesi dello studio era che la PH/PAH sia determinata da un programma coordinato di infiammazione-immunitaria e rimodellamento vascolare e che geni robusti all'interno di questo programma possano fungere da biomarcatori candidati e offrire opportunità di riposizionamento di farmaci.
Protocollo
I set di dati pubblici del Gene Expression Omnibus (GEO) analizzati in questo studio contenevano dati trascrittomici anonimi provenienti da studi precedentemente pubblicati e non richiedevano ulteriore approvazione etica. Il comitato etico dell'Università di Huaihua ha approvato lo studio indipendente di validazione mediante PCR quantitativa a retrotrascrizione inversa (qRT-PCR) su tessuti polmonari umani (numero di approvazione: 2024(A05112)). Il consenso informato scritto è stato ottenuto da tutti i partecipanti o dai loro rappresentanti legalmente autorizzati prima della raccolta dei campioni. Le procedure di approvazione e consenso si sono applicate a tutti i 20 campioni di tessuto polmonare provenienti da pazienti con ipertensione arteriosa polmonare (PAH) e ai 20 campioni di controllo inclusi nella validazione mediante qRT-PCR. Gli strumenti di ricerca utilizzati per questo protocollo sono elencati nella Tabella dei materiali.
1. Raccolta e preelaborazione di dataset trascrittomici pubblici
I set di dati microarray relativi all'ipertensione polmonare (PH) GSE22356, GSE33463 e GSE48149 sono stati ottenuti dal database GEO. I campioni di PH/ipertensione arteriosa polmonare (PAH) e i campioni di controllo sono stati estratti in base alle annotazioni fenotipiche originali. Le matrici di espressione e i file di annotazione della piattaforma sono stati scaricati utilizzando script R riproducibili e il pacchetto GEOquery.
L'annotazione delle sonde e l'associazione ai simboli genici sono state eseguite in modo coerente tra i diversi set di dati. Quando più sonde corrispondevano allo stesso gene, è stato calcolato il valore medio di espressione. È stata applicata la normalizzazione quantile e sono stati rimossi i geni con espressione bassa o varianza ridotta. I set di dati sono stati uniti e gli effetti di batch sono stati corretti utilizzando l'algoritmo ComBat nel pacchetto sva8. La correzione è stata valutata mediante boxplot e analisi delle componenti principali.
2. Identificazione dei geni differenzialmente espressi
Il pacchetto limma è stato utilizzato per confrontare i livelli di espressione tra campioni di PH e controlli nella matrice di espressione corretta per il batch9. È stato adattato un modello lineare e sono state applicate statistiche bayesiane empiriche. I geni differenzialmente espressi sono stati definiti utilizzando un valore di P corretto <0,05 e un cambio di fold log2 assoluto > 0,585. I risultati sono stati visualizzati mediante plot a vulcano e mappe termiche.
3. Costruzione della rete di co-espressione genica pesata
È stata costruita una rete di co-espressione genica pesata utilizzando il pacchetto WGCNA10. È stata eseguita la clusterizzazione dei campioni per rilevare valori anomali. La potenza di soglia morbida è stata scelta in base all'indice di adattamento alla topologia senza scala. I moduli genici sono stati identificati utilizzando l'algoritmo di taglio dinamico dell'albero. Gli eigengeni dei moduli sono stati correlati al fenotipo di ipertensione polmonare (PH), e il modulo associato alla malattia con la correlazione più forte è stato selezionato. I geni nel modulo chiave sono stati incrociati con i geni differenzialmente espressi per ottenere i geni in consenso.
4. Analisi del riparrimento funzionale
Le categorie del processo biologico, della componente cellulare e della funzione molecolare della Gene Ontology sono state analizzate utilizzando clusterProfiler11. È stata eseguita un'analisi di arricchimento dei percorsi della Kyoto Encyclopedia of Genes and Genomes per identificare i percorsi di segnalazione12. Sono stati utilizzati un valore di P < 0,05 e un valore di q < 0,2 come soglie di arricchimento, e i termini arricchiti sono stati visualizzati mediante grafici a bolle11.
5. Costruzione della rete di interazione proteina-proteina e identificazione dei geni hub
L'elenco genico consensuale è stato inviato al database STRING, selezionando Homo sapiens come specie e una soglia di confidenza dell'interazione > 0,413. Il file delle interazioni è stato importato in Cytoscape e il plug-in CytoHubba è stato utilizzato per ordinare i geni in base al grado del nodo. I geni altamente connessi sono stati definiti geni hub.
6. Selezione di geni caratteristici diagnostici mediante apprendimento automatico
Sono stati applicati tre algoritmi indipendenti di selezione delle caratteristiche. In primo luogo, è stata eseguita una regressione logistica con operatore di riduzione e selezione della norma L1 utilizzando il pacchetto glmnet e una validazione incrociata a 10 ripetizioni, al fine di identificare i geni con coefficienti diversi da zero14. In secondo luogo, è stata applicata l'eliminazione ricorsiva delle caratteristiche mediante macchine a vettori di supporto per rimuovere le caratteristiche ridondanti e selezionare il sottoinsieme di caratteristiche che ha ottenuto la massima accuratezza nella validazione incrociata15. In terzo luogo, è stato costruito un modello di foresta casuale e le caratteristiche sono state ordinate in base alla riduzione media dell'impurità di Gini16. L'intersezione degli insiemi di geni ottenuti dai tre algoritmi è stata utilizzata per definire l'insieme finale dei geni caratteristici principali. Il pacchetto pROC è stato utilizzato per generare le curve caratteristiche operative del ricevitore e calcolare i valori dell'area sotto la curva17.
7. Validazione dei geni fondamentali mediante set di dati indipendenti in bulk e singola cellula
GSE117261 è stato utilizzato come coorte esterna indipendente di validazione su tessuto polmonare, contenente 58 campioni di ipertensione arteriosa polmonare (PAH) e 25 campioni di controllo da donatori non idonei18Questo set di dati non è stato utilizzato nell'analisi differenziale di espressione per la scoperta, nella costruzione della rete di co-espressione genica pesata o nella selezione delle caratteristiche mediante apprendimento automatico. La matrice di espressione è stata normalizzata e annotata, e l'espressione differenziale è stata analizzata utilizzando limma v3.68.0. È stata applicata la correzione del tasso di falsa scoperta di Benjamini-Hochberg sull'intero trascrittoma annotato. Le curve ROC (caratteristica operativa del ricevitore) per singolo gene sono state calcolate utilizzando pROC v1.19.0.1, intervalli di confidenza al 95% di DeLong e soglie basate sull'indice di Youden. È stato costruito un modello esplorativo di regressione logistica a cinque geni all'interno di GSE117261, e le sue prestazioni interne sono state ulteriormente valutate mediante validazione incrociata annidata ripetuta.
GSE210248 (Tabella 1) è stato utilizzato come dataset di validazione singola cellula dell'arteria polmonare contenente campioni di tre pazienti con ipertensione arteriosa polmonare (PAH) e di tre donatori sani19. I dati sono stati elaborati utilizzando Seurat v5.5.1 per il controllo di qualità, la normalizzazione, la riduzione della dimensionalità, il clustering e l'annotazione cellulare20. Sono state identificate le principali popolazioni cellulari, inclusi cellule endoteliali, cellule muscolari lisce, fibroblasti, monociti/macrophagi e cellule T/cellule natural killer. La comunicazione intercellulare è stata analizzata utilizzando CellChat v2.1.2 e il database di ligandi-recettori CellChatDB.human21. È stato creato un oggetto CellChat a partire dalla matrice di espressione normalizzata di Seurat e dai metadati relativi ai tipi cellulari. Sono stati identificati geni sovraespressi e interazioni ligando-recettore; sono state calcolate le probabilità di comunicazione; sono state eliminate le interazioni che coinvolgevano gruppi cellulari con meno di 10 cellule; e sono state inferite e aggregate reti di comunicazione a livello di pathway. Questo dataset è stato utilizzato esclusivamente per la validazione meccanicistica esterna e non per l'addestramento del modello.
| Elemento | Descrizione |
| Dataset | GSE210248 |
| Tipo di dati | Sequenziamento dell'RNA monocellulare basato su goccioline 10x Genomics; profilazione trascrittomica ad alto rendimento |
| Campioni umani | Tre campioni di arteria polmonare da pazienti con ipertensione arteriosa polmonare (PAH) e tre campioni di arteria polmonare da donatori sani |
| Origine del tessuto | Tessuto arterioso polmonare ex vivo, che riflette principalmente l'ecologia cellulare della parete vascolare polmonare e il processo di rimodellamento vascolare |
| Scopo principale dell'analisi | Localizzazione dei tipi cellulari, transizione fenotipica delle cellule muscolari lisce, comunicazione tra cellule immunitarie e strutturali, e validazione della coerenza meccanicistica dei geni candidati |
Tabella 1: Informazioni di base per il set di dati di convalida single-cell GSE210248. La tabella riassume l'accession del set di dati, la piattaforma di sequenziamento, la fonte del tessuto, la composizione del campione e lo scopo analitico dell'analisi di convalida single-cell dell'arteria polmonare.
8. Validazione dell'espressione genica mediante qRT-PCR
La validazione mediante qRT-PCR ha incluso 20 campioni di tessuto polmonare da pazienti con ipertensione polmonare/ipertensione arteriosa polmonare (PAH), biologicamente indipendenti, e 20 campioni di controllo di tessuto polmonare, altrettanto biologicamente indipendenti. L'RNA totale è stato estratto utilizzando il Kit per l'estrazione di RNA totale. La concentrazione e la purezza dell'RNA sono state valutate mediante spettrofotometro, mentre l'integrità dell'RNA è stata verificata tramite elettroforesi su gel di agarosio. Sono stati inclusi soltanto campioni di RNA con valori A260/280 compresi tra 1,8 e 2,1 e privi di degradazione visibile.
Quantità uguali di RNA sono state retrotrascritte in DNA complementare utilizzando il kit Solarbio Universal RT-PCR (AMV; numero di catalogo RP1200). La PCR quantitativa per CXCL10, JUN, IFIH1, MX1 e TLR7 è stata eseguita utilizzando il SYBR Green PCR Master Mix su un sistema di PCR in tempo reale. Ogni campione biologico è stato analizzato in tre replicati tecnici, insieme a controlli senza stampo e senza retrotrascrizione. Il valore medio di Ct dei tre replicati tecnici è stato utilizzato per l'analisi successiva; i replicati tecnici non sono stati considerati osservazioni indipendenti. Sono stati utilizzati primer che attraversano i giunti esone-esone e producono ampliconi di 80–200 bp (Tabella 2). La specificità dei primer è stata verificata mediante l'analisi NCBI Primer-BLAST e l'analisi della curva di denaturazione22.
β-actina (ACTB) è stata utilizzata come gene di riferimento interno per normalizzare i livelli di espressione dei geni bersaglio. L'espressione relativa è stata calcolata utilizzando il metodo 2-ΔΔCt23. Per i confronti tra gruppi, in base alla distribuzione dei dati, sono stati utilizzati test U di Mann-Whitney a due code, e la correzione del tasso di falsa scoperta di Benjamini-Hochberg è stata applicata su tutti e cinque i geni. Sono state generate curve ROC per singolo gene con intervalli di confidenza al 95% di DeLong, e le soglie ottimali sono state selezionate utilizzando l'indice di Youden. Il modello di regressione logistica a cinque geni è stato inizialmente adattato e valutato sugli stessi 40 campioni biologici; questa stima è stata pertanto definita come prestazione apparente all'interno del campione. Per valutare un potenziale overfitting, sono state effettuate 100 ripetizioni di una cross-validation stratificata a cinque fold utilizzando un modello di regressione logistica regolarizzato con L2, e la prestazione ROC aggregata fuori-fold è stata calcolata.
| Gene | Accesso RefSeq | Primer diretto (5′–3′) | Primer inverso (5′–3′) | Dimensione del prodotto (bp) | Tm (°C) | Attraversamento di esoni |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Sì |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Sì |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Sì |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Sì |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Sì |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Sì |
Tabella 2: Sequenze dei primer utilizzate per la PCR quantitativa di retrotrascrizione. La tabella elenca i geni bersaglio, i numeri di accesso RefSeq, le sequenze dei primer forward e reverse, le dimensioni dei prodotti, le temperature di fusione e lo stato di attraversamento degli esoni dei primer utilizzati per la qRT-PCR.
9. Screening di composti candidati e docking molecolare
Le firme geniche centrali upregolate e downregolate sono state sottoposte al database Connectivity Map per identificare piccole molecole predette per invertire il profilo di espressione associato alla PH7. I candidati sono stati classificati in base al punteggio Logit e alla probabilità di previsione.
La struttura tridimensionale del BRD-K91900765/VX-745 è stata ottenuta da PubChem con il codice CID 303852524. Le informazioni farmacologiche relative al composto sono state raccolte da database pubblici di farmaci, mentre i descrittori strutturali sono stati calcolati utilizzando DrugBank e SwissADME25,26. Le strutture proteiche sono state ottenute dalla RCSB Protein Data Bank utilizzando i seguenti identificatori PDB: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; e MAPK14/p38α, 1OUK27. La rilevazione cieca delle cavità e il docking molecolare sono stati eseguiti utilizzando CB-Dock2 v2.0 con il motore di punteggio AutoDock Vina v1.2.028,29. I file della proteina e del ligando sono stati caricati su CB-Dock2, le cavità candidate sono state rilevate automaticamente e il docking è stato effettuato all'interno delle box specifiche per ciascuna cavità generate dal server. Per ogni proteina sono stati registrati l'identificatore della cavità, il punteggio Vina, il volume della cavità, il centro della box di docking, le dimensioni della box di docking e il file del complesso proteina-ligando. La conformazione con il punteggio Vina più negativo è stata selezionata come la previsione di conformazione principale. MAPK14/p38α è stata inclusa come bersaglio farmacologico accertato e proteina di riferimento positivo per il docking di VX-745. Il docking contro CXCL10, JUN, IFIH1, MX1 e TLR7 è stato di tipo esplorativo e non è stato interpretato come evidenza di un targeting farmacologico diretto, legame, inibizione o efficacia.
10. Analisi statistica e controllo della riproducibilità
Tutte le analisi statistiche sono state eseguite in R, salvo diversamente specificato. I valori di P a due code < 0,05 sono stati considerati statisticamente significativi. È stata applicata la correzione per confronti multipli alle analisi di espressione differenziale, arricchimento, validazione esterna e qRT-PCR come specificato in precedenza. È stata utilizzata la validazione incrociata per valutare la stabilità dei modelli di apprendimento automatico e combinati di qRT-PCR.
Risultati
Preelaborazione dei dati transcriptomici pubblici e identificazione dei geni differenzialmente espressi
L'integrazione e la correzione con ComBat dei dataset GSE22356, GSE33463 e GSE48149 hanno ridotto le differenze sistematiche tra i set di dati. I boxplot hanno mostrato che le distribuzioni dell'espressione campionaria sono diventate più coerenti dopo la correzione. L'analisi delle componenti principali ha indicato che i campioni si raggruppavano principalmente in base alla fonte del dataset prima della correzione, ma sono risultati più mescolati dopo la correzione, indicando una efficace riduzione degli effetti di batch (Figura 1).
Utilizzando soglie di un valore assoluto del log2 di fold change >0,585 e un valore di P corretto < 0,05, sono stati identificati 78 geni espressi in modo differenziale, compresi 44 geni sovaregolati e 34 geni sottoregolati (Figura 2A). La mappa termica ha mostrato che i geni associati all'interferone, tra cui XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 e TLR7, erano generalmente sovaregolati nei campioni correlati alla PH. Al contrario, i geni associati all'eritroide, tra cui HBG1, HBD, ALAS2, CA1 e SLC4A1, tendevano a essere sottoregolati (Figura 2B).
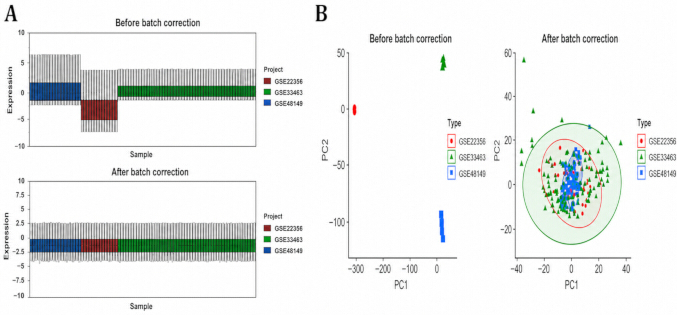
Figura 1: Correzione dell'effetto batch. (A) Boxplot della matrice di espressione unita prima e dopo la correzione con ComBat. (B) Grafici dell'analisi delle componenti principali che mostrano la distribuzione dei campioni prima e dopo la correzione dell'effetto batch. Cliccare qui per visualizzare una versione ingrandita di questa figura.
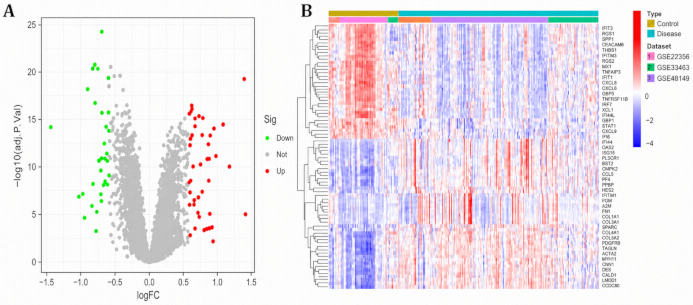
Figura 2: Geni espressi in modo differenziale. (A) Grafico a vulcano che mostra i geni upregolati e downregolati nei campioni associati alla PH. (B) Mappa termica che mostra i geni espressi in modo differenziale tra i gruppi di controllo e quelli malati. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Costruzione della rete di co-espressione genica pesata e arricchimento funzionale
Il clustering del campione ha mostrato un raggruppamento complessivo stabile, senza outlier evidenti (Figura 3A). L'indice di adattamento alla topologia priva di scala si è avvicinato a 0,8 con un esponente pari a 9, e pertanto è stato scelto β = 9 per la costruzione della rete (Figura 3B). Il clustering genico e l'identificazione dinamica dei moduli hanno prodotto diversi moduli di co-espressione (Figura 3C). Il modulo blu ha mostrato la correlazione più forte con lo stato di ipertensione polmonare (r = 0,55, P = 1 × 10⁻¹⁹), mentre anche i moduli turchese e grigio hanno mostrato correlazioni con l'ipertensione polmonare (Figura 3D).
I geni di consenso ottenuti intersecando i geni chiave del modulo dell'analisi della rete di co-espressione genica pesata con i geni differenzialmente espressi sono risultati arricchiti in difesa immunitaria antivirale, regolazione di NF-κB e JAK-STAT, risposte ai fattori infiammatori, legame ai recettori di citochine e chemochine, e regolazione trascrizionale (Figura 4A). L'analisi di arricchimento del Kyoto Encyclopedia of Genes and Genomes ha identificato l'interazione citochina-recettore di citochina, il segnale delle chemochine, il segnale dei recettori di tipo NOD, il segnale dei recettori di tipo Toll, il segnale del fattore di necrosi tumorale e il segnale dell'interleuchina-17 (Figura 4B), sostenendo un'alterazione immuno-infiammatoria come base molecolare del rimodellamento vascolare polmonare.
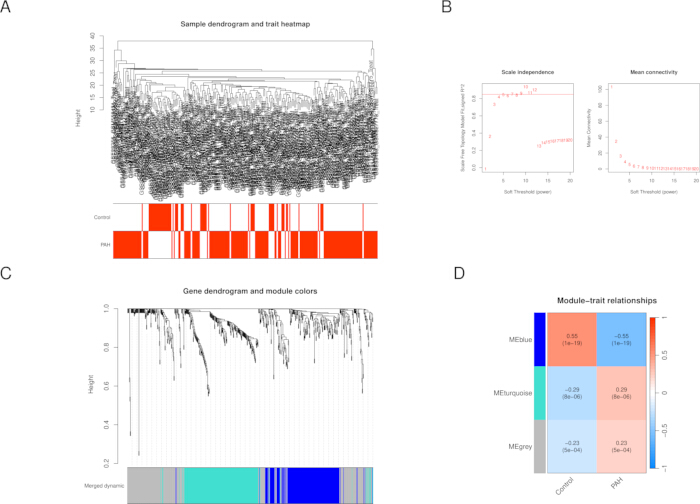
Figura 3: Analisi della rete di co-espressione genica pesata. (A) Albero di raggruppamento dei campioni e mappa termica dei tratti. (B) Grafico della selezione della soglia morbida. (C) Dendrogramma genico e colori dei moduli. (D) Mappa termica delle relazioni tra moduli e tratti. Cliccare qui per visualizzare una versione ingrandita di questa figura.
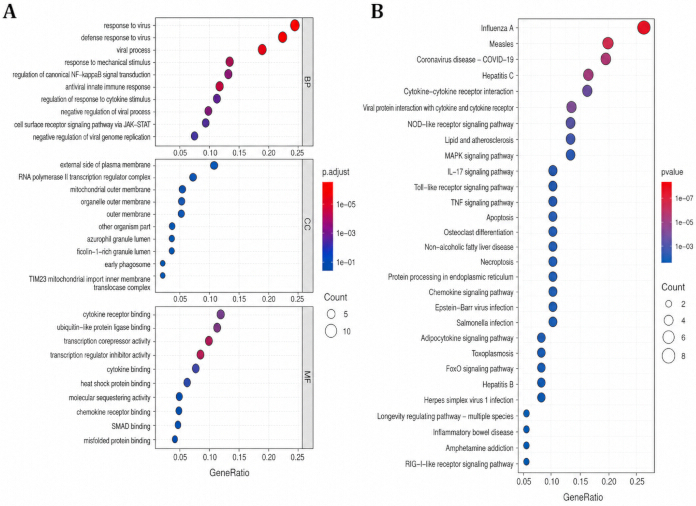
Figura 4: Analisi funzionale di arricchimento. (A) Risultati dell'arricchimento dell'ontologia genica per i geni consenso. (B) Risultati dell'arricchimento del percorso dell'Enciclopedia di Kyoto dei Geni e dei Genomi per i geni consenso. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Rete di interazione proteina-proteina e screening dei geni hub
La rete di interazioni proteina-proteina STRING costruita a partire dai geni in comune ha rivelato una rete immunitaria-infiammatoria interconnessa (Figura 5A). Il ranking basato sul grado effettuato con CytoHubba ha mostrato che FN1, CD44, JUN, TGFB1, CXCL8 e BCL2 presentavano un'elevata connettività (Figura 5B). Questi geni centrali potrebbero partecipare alla segnalazione infiammatoria, all'adesione cellulare, al rimodellamento della matrice extracellulare e al rimodellamento strutturale del vaso polmonare.
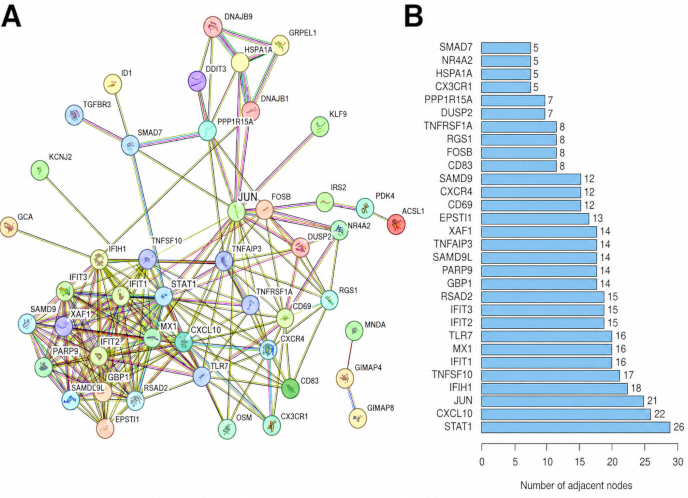
Figura 5: Rete di interazione proteina-proteina e geni hub. (A) Rete di interazione proteina-proteina di STRING relativa ai geni in consenso. (B) Geni hub identificati mediante CytoHubba, ordinati per grado di connettività. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Selezione delle caratteristiche basata sull'apprendimento automatico e prestazioni diagnostiche
La regressione con operatore di riduzione e selezione della minima deviazione assoluta ha identificato sei geni candidati con coefficienti diversi da zero dopo la validazione incrociata (Figura 6A, B). La macchina a vettori di supporto con eliminazione ricorsiva delle caratteristiche ha mantenuto otto geni, ottenendo un'accuratezza nella validazione incrociata di 0,883 e un errore di 0,117 (Figura 7A). L'errore "out-of-bag" della foresta casuale si è stabilizzato quando il numero di alberi era ≥100, e IFIH1, JUN e TLR7 si sono posizionati tra i geni più importanti in base al punteggio di rilevanza (Figura 7B).
L'intersezione tra i risultati ottenuti con l'operatore di shrinkage e selezione con norma L1 (least absolute shrinkage and selection operator), la macchina a vettori di supporto con eliminazione ricorsiva delle caratteristiche (support vector machine-recursive feature elimination) e la foresta casuale ha identificato cinque geni fondamentali: CXCL10, JUN, IFIH1, MX1 e TLR7 (Figura 8A). L'analisi della curva operativa del ricevitore per singolo gene ha mostrato una discriminazione diagnostica da moderata a buona, con valori dell'area sotto la curva (AUC) pari a 0,842 per IFIH1, 0,833 per JUN, 0,827 per TLR7, 0,814 per CXCL10 e 0,759 per MX1 (Figura 8B).
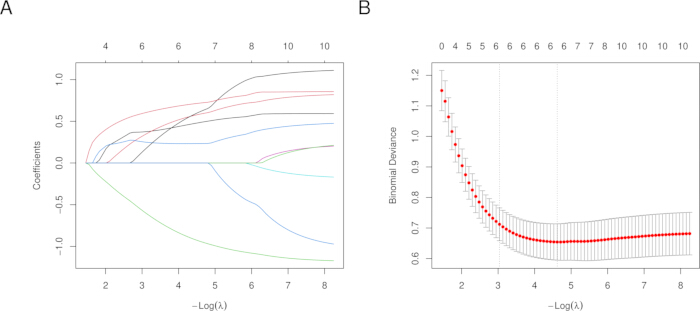
Figura 6: Analisi di regressione con operatore di riduzione e selezione a minimo valore assoluto. (A) Percorso dei coefficienti generato dalla regressione con operatore di riduzione e selezione a minimo valore assoluto. (B) Grafico dell'errore di validazione incrociata. Cliccare qui per visualizzare una versione ingrandita di questa figura.
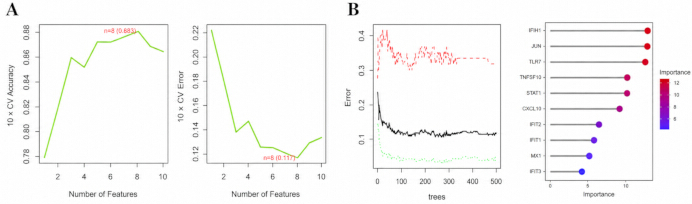
Figura 7: Analisi con macchina a vettori di supporto - eliminazione ricorsiva delle caratteristiche e foresta casuale. (A) Grafico di selezione delle caratteristiche mediante eliminazione ricorsiva delle caratteristiche con macchina a vettori di supporto. (B) Modello di foresta casuale e classificazione dei geni per importanza. Cliccare qui per visualizzare una versione ingrandita di questa figura.
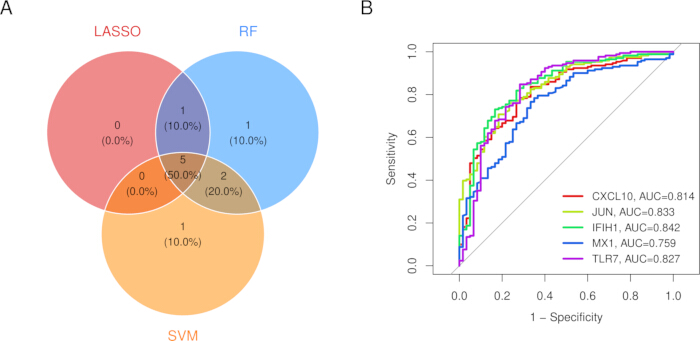
Figura 8: Sintesi dell'apprendimento automatico. (A) Diagramma di Venn che mostra l'intersezione dei tre algoritmi di selezione delle caratteristiche. (B) Curve caratteristiche operative del ricevitore per i cinque geni fondamentali. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Validazione esterna in GSE117261
GSE117261 è stato utilizzato come coorte indipendente di validazione su tessuto polmonare ed è stato escluso dalla selezione differenziale dell'espressione, dalla costruzione della rete di co-espressione genica pesata e dalla selezione delle caratteristiche mediante apprendimento automatico (Tabella 3). I risultati completati della validazione hanno mostrato una replicazione eterogenea tra i cinque geni (Tabella 4). CXCL10 era aumentato (variazione del log₂ = 0,677; P = 0,0410; FDR = 0,144) e ha prodotto un AUC di 0,639 (IC 95%, 0,491–0,786), con una soglia di 6,245, una sensibilità di 0,724 e una specificità di 0,600. JUN era aumentato (variazione del log₂ = 0,463; P = 0,00248; FDR = 0,0194) e ha prodotto un AUC di 0,714 (IC 95%, 0,593–0,835), con una soglia di 8,708, una sensibilità di 0,707 e una specificità di 0,720.
IFIH1 (variazione del log2 = 0,107; P = 0,371; FDR = 0,591; AUC = 0,543, IC 95%, 0,398–0,687), MX1 (variazione del log2 = 0,109; P = 0,488; FDR = 0,690; AUC = 0,475, IC 95%, 0,337–0,614) e TLR7 (variazione del log2 = -0,050; P = 0,543; FDR = 0,733; AUC = 0,546, IC 95%, 0,414–0,679) non hanno soddisfatto i criteri prespecificati di supporto esterno. TLR7 ha mostrato anche una direzione opposta rispetto al risultato ottenuto con qRT-PCR. Il modello esplorativo basato su cinque geni, adattato e valutato all'interno di GSE117261, ha prodotto un AUC apparente di 0,740, mentre la validazione incrociata nidificata ripetuta ha fornito un AUC di 0,656. Pertanto, JUN ha ricevuto il supporto indipendente più forte, CXCL10 ha mostrato evidenze limitate ma coerenti nella direzione, mentre la replicazione di IFIH1, MX1 e TLR7 è risultata debole o discordante.
| Elemento | Descrizione |
| Accesso al dataset | GSE117261 |
| Fonte dei dati | Gene Expression Omnibus (GEO) |
| Tipo di campione | Dati microarray trascrittomici da tessuto polmonare umano |
| Dimensione del campione | 58 campioni di ipertensione arteriosa polmonare (PAH) e 25 campioni di controllo da donatori deceduti |
| Piattaforma | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| Obiettivo della validazione | Differenze di espressione, analisi ROC per singolo gene e modellizzazione ROC esplorativa combinata per cinque geni: CXCL10, JUN, IFIH1, MX1 e TLR7 |
| Ruolo nello studio | Dataset di validazione esterna indipendente; non incluso nelle analisi originali di training, WGCNA o selezione delle caratteristiche |
Tabella 3: Informazioni di base per il dataset esterno di validazione indipendente GSE117261. La tabella riassume la fonte del dataset, il tipo di campione, la dimensione del campione, la piattaforma, gli obiettivi di validazione e il ruolo di GSE117261 nello studio.
| Gene/modello | PAH n | Controllo n | log2 fold change | Valore P | FDR | AUC | IC 95% AUC | Limite di Youden | Sensibilità | Specificità |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Modello a cinque geni (apparente/in-sample) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Modello a cinque geni (CV nidificato ripetuto) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tabella 4: Risultati effettivi delle differenze di espressione e della validazione ROC per GSE117261. La tabella riporta le dimensioni campionarie di PAH e controllo, i cambiamenti del log₂ fold, valori di P, valori aggiustati per il tasso di falsa scoperta, AUC, intervalli di confidenza al 95%, cutoff dell'indice di Youden, sensibilità, specificità e interpretazioni per i cinque geni e i modelli combinati esplorativi.
Validazione mediante PCR quantitativa a trascrizione inversa
La validazione mediante PCR quantitativa con trascrizione inversa ha incluso 20 campioni biologicamente indipendenti di tessuto polmonare da pazienti con ipertensione arteriosa polmonare (PAH) e 20 campioni di controllo biologicamente indipendenti, con tre replicati tecnici mediati per ciascun campione biologico. CXCL10, JUN, IFIH1, MX1 e TLR7 erano significativamente sovraespressi nella PAH (Tabella 5; Figura 9A). I valori medi di espressione relativa erano approssimativamente 3,470 per CXCL10, 2,560 per JUN, 2,760 per IFIH1, 2,650 per MX1 e 2,580 per TLR7. I corrispondenti valori di P/valori FDR erano rispettivamente 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 e 1,37 × 10⁻6/2,63 × 10⁻6.
L'analisi ROC basata sull'espressione tramite qRT-PCR per singolo gene ha mostrato AUC pari a 0,988 per CXCL10 (IC 95%, 0,961–1,000), 0,880 per JUN (IC 95%, 0,758–1,000), 0,908 per IFIH1 (IC 95%, 0,820–0,995), 0,945 per MX1 (IC 95%, 0,874–1,000) e 0,948 per TLR7 (IC 95%, 0,886–1,000) (Figura 9B; Tabella 5). Il modello di regressione logistica basato su cinque geni ha raggiunto un AUC apparente di 1,000 (IC 95% DeLong: 1,000–1,000), con sensibilità e specificità pari a 1,000 (Figura 9C). La coerenza della direzione dell'espressione tra la validazione tramite PCR quantitativa di trascrizione inversa e GSE117261 è stata visualizzata mediante una mappa termica (Figura 9D). Poiché gli stessi 40 campioni sono stati utilizzati sia per l'adattamento del modello che per la valutazione, questi risultati riflettono le prestazioni apparenti all'interno del campione. In 100 ripetizioni di una cross-validation stratificata a cinque fold, utilizzando un modello di regressione logistica regolarizzato L2, l'AUC aggregato al di fuori dei fold è rimasto pari a 1,000 (IC 95%, 1,000–1,000), e ogni ripetizione ha prodotto un AUC di 1,000. Nonostante questa stabilità interna, la coorte era di piccole dimensioni e rimane necessaria una validazione prospettica indipendente. Il confronto direzionale con GSE117261 ha mostrato aumenti concordanti per CXCL10, JUN, IFIH1 e MX1, ma una direzione discordante per TLR7 (Figura 9D).
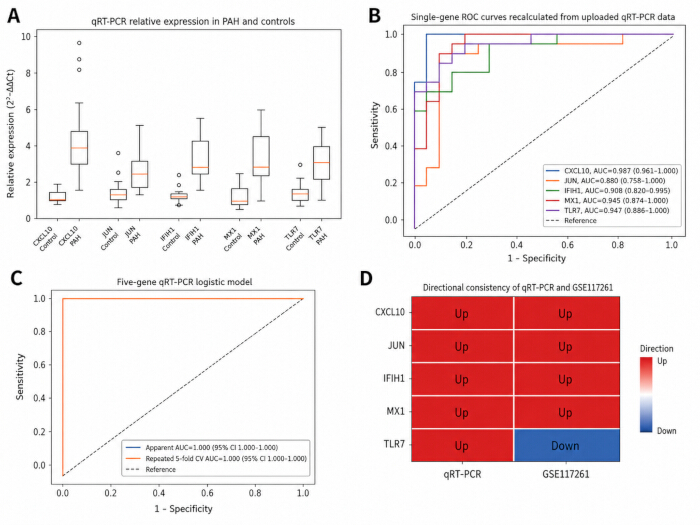
Figura 9: Convalida mediante PCR quantitativa a retrotrascrizione. (A) Grafici a scatola che mostrano l'espressione relativa di CXCL10, JUN, IFIH1, MX1 e TLR7 in 20 campioni biologicamente indipendenti di tessuto polmonare PAH e in 20 campioni di controllo biologicamente indipendenti. Ogni campione biologico è stato misurato in tre replicati tecnici, e il valore medio di Ct è stato utilizzato per l'analisi. Per ogni grafico a scatola, la linea centrale rappresenta la mediana, la scatola rappresenta l'intervallo interquartile, i baffi si estendono fino a 1,5 volte l'intervallo interquartile, e i singoli punti al di fuori dei baffi rappresentano valori anomali. (B) Curve ROC per singolo gene basate sui valori di espressione ottenuti con qRT-PCR; sono riportate le AUC e gli intervalli di confidenza al 95% di DeLong. (C) Curve ROC per il modello di regressione logistica a cinque geni, che mostrano sia le prestazioni apparenti/all'interno del campione sia le prestazioni complessive fuori dal fold ottenute da 100 analisi ripetute di cross-validation stratificata a cinque fold. (D) Mappa termica che mostra la coerenza della direzione di espressione tra qRT-PCR e GSE117261; CXCL10, JUN, IFIH1 e MX1 sono risultati concordemente aumentati, mentre TLR7 è risultato discordante. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Gene/modello | PAH n | Controllo n | Controllo 2^-ΔΔCt, media ± DS | PAH 2^-ΔΔCt, media ± DS | Direzione | Valore P | FDR | AUC | IC 95% AUC | Limite di Youden | Sensi- bilità | Specifi- cità | Tipo di validazione | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Sovraespresso | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Analisi qRT-PCR singolo gene | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Sovraespresso | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Analisi qRT-PCR singolo gene | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Sovraespresso | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Analisi qRT-PCR singolo gene | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Sovraespresso | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Analisi qRT-PCR singolo gene | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Sovraespresso | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Analisi qRT-PCR singolo gene | ||||
| Modello a cinque geni (apparente/in-sample) | 20 | 20 | Non appli- cabile | Non appli- cabile | Non applicabile | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Stessi 40 campioni biologici utilizzati per l'adattamento e la valutazione del modello | ||||
| Modello a cinque geni (CV ripetuta 100× a 5 pieghe) | 20 | 20 | Non appli- cabile | Non appli- cabile | Non applicabile | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Cross-validation interna mediante regressione logistica con regolarizzazione L2 | ||||
Tabella 5: Risultati completi di espressione tramite qRT-PCR e analisi ROC per CXCL10, JUN, IFIH1, MX1 e TLR7, inclusi i risultati dei modelli combinati con i cinque geni. La tabella riporta le dimensioni del campione per PAH e controlli, i valori di espressione relativi, le direzioni dell'espressione, i valori P, i valori aggiustati per il tasso di falsa scoperta, le AUC, gli intervalli di confidenza al 95%, le soglie individuate tramite indice di Youden, le sensibilità, le specificità e i tipi di validazione per i singoli geni e per i modelli combinati.
Convalida trascrittomica a singola cellula in GSE210248
GSE210248 ha fornito un supporto meccanicistico a livello cellulare dimostrando che il rimodellamento delle arterie polmonari nella PAH era accompagnato da una modificata comunicazione tra cellule immunitarie e cellule strutturali vascolari. Questa osservazione era coerente con l'arricchimento transcriptomico globale delle risposte infiammatorie, della segnalazione dei chemochine, della segnalazione dei recettori Toll-simili e della segnalazione del fattore di necrosi tumorale.
Le evidenze a livello di singola cellula hanno suggerito che la rete di segnalazione dell'arteria polmonare associata alla PAH si è spostata verso le cellule strutturali, inclusi i cellule muscolari lisce e i fibroblasti. Le cellule muscolari lisce hanno mostrato diversi stati, tra cui pericito-simili/sensibili all'ossigeno, contrattili, sintetici e simili ai fibroblasti. Questi risultati supportano un modello di malattia in cui l'attivazione immunitario-infiammatoria e il rimodellamento delle cellule strutturali vascolari concorrono insieme alla progressione dell'IP/PAH.
Screening dei composti candidati e docking molecolare
La schermata della mappa di connettività ha identificato BRD-K91900765 come il composto candidato con il punteggio più alto tra i primi 10 risultati, con un punteggio Logit di 10,13 e una probabilità prevista di 0,085 (Figura 10). La cura del composto ha mostrato che BRD-K91900765 corrisponde a VX-745/neflamapimod, un inibitore selettivo di p38α/MAPK14 con un identificatore del composto PubChem di 3038525 e una massa molecolare di 436,27 g/mol (Tabella 6).
Il docking esplorativo di BRD-K91900765/VX-745 con le cinque proteine associate ai biomarcatori ha prodotto punteggi Vina massimi di -7,5 kcal/mol per CXCL10, -7,6 kcal/mol per JUN, -7,5 kcal/mol per IFIH1, -8,7 kcal/mol per MX1 e -8,1 kcal/mol per TLR7 (Tabelle 7–11; Figura 11A–E). Questi risultati indicavano una compatibilità strutturale prevista, ma non stabilivano le cinque proteine come bersagli farmacologici diretti. Le previsioni preliminari di assorbimento, distribuzione, metabolismo, escrezione e tossicità suggerivano che il composto possedesse diverse proprietà simili a quelle di un farmaco, sebbene il valore relativamente alto di cLogP calcolato richieda ulteriori valutazioni (Tabella 12). È stato incluso un docking contro il target noto di VX-745, MAPK14/p38α (PDB ID: 1OUK), come analisi di riferimento positiva. La cavità principale di MAPK14, C1, ha prodotto un punteggio Vina di -7,9 kcal/mol, un volume della cavità di 3560 Å3, un centro della scatola di docking di (2, 22, 34) e dimensioni di (22, 31, 31) (Tabella 13; Figura 11F).
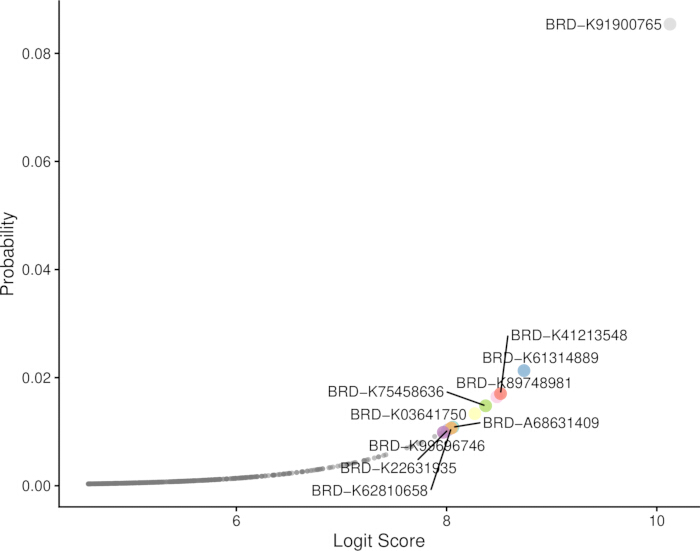
Figura 10: Classificazione dei composti candidati tramite Connectivity Map. Classificazione dei composti candidati identificati mediante screening della Connectivity Map. BRD-K91900765 è il composto con il punteggio più alto, con un punteggio Logit di 10,13 e una probabilità predetta di 0,085. Fare clic qui per visualizzare una versione ingrandita di questa figura.
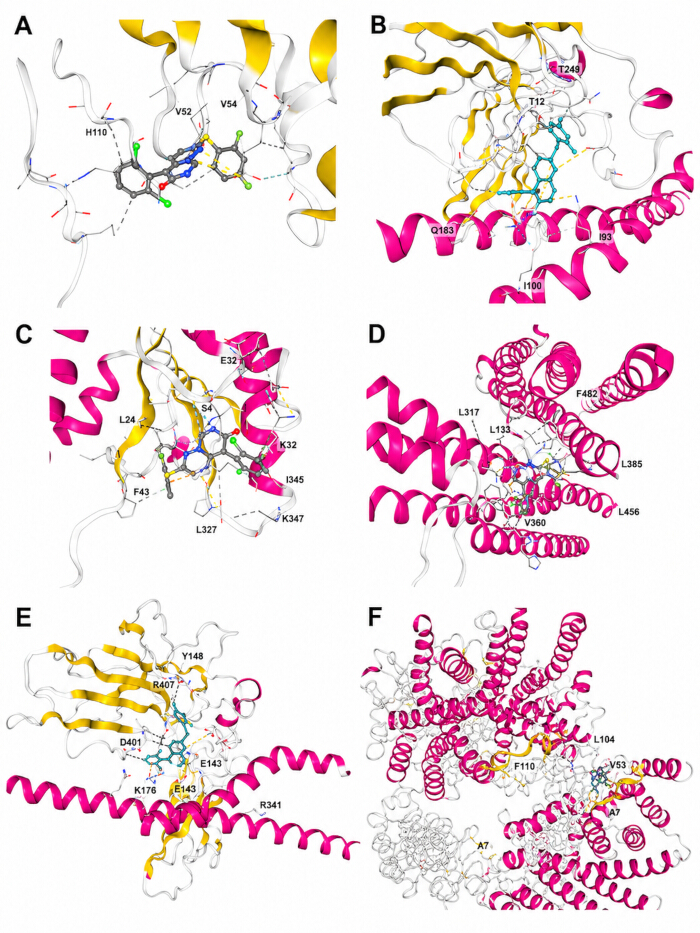
Figura 11: Diagrammi tridimensionali di docking molecolare per BRD-K91900765/VX-745. (A) Docking esplorativo con CXCL10. (B) Docking esplorativo con JUN. (C) Docking esplorativo con IFIH1. (D) Docking esplorativo con MX1. (E) Docking esplorativo con TLR7. (F) Docking di riferimento positivo con la nota proteina farmacologica bersaglio MAPK14/p38α (PDB ID: 1OUK). I pannelli A–E indicano una compatibilità strutturale prevista e non dimostrano un targeting farmacologico diretto. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Elemento | Descrizione |
| CMap/Broad ID | BRD-K91900765 (formato comune del lotto: BRD-K91900765-001-xx-x) |
| Nome comune/alias | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Nome chimico | 5-(2,6-diclorofenil)-2-(2,4-difluorofenil)tiopirimidino[1,6-b]piridazin-6-one |
| PubChem CID | 3038525 |
| Numero CAS | 209410-46-8 |
| Formula molecolare / massa molecolare relativa | C19H9Cl2F2N3OS; 436.27 g/mol |
| SMILES canonico | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Principale bersaglio farmacologico noto | MAPK14/p38α; è stata inoltre riportata l'inibizione di p38β con selettività inferiore rispetto a p38α |
Tabella 6: Informazioni chimiche e farmacologiche per BRD-K91900765/VX-745. La tabella riassume gli identificatori del composto, gli alias, il nome chimico, la formula molecolare, la massa molecolare, i descrittori strutturali e il target farmacologico stabilito di BRD-K91900765/VX-745.
| CurPocket ID | Punteggio Vina (kcal/mol) | Volume della cavità (ų) | Centro (x, y, z) | Dimensione del docking (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tabella 7: Tasche di docking previste per BRD-K91900765/VX-745 con CXCL10 (PDB ID: 1LV9). La tabella riporta gli identificatori delle cavità in ordine di classifica, i punteggi di Vina, i volumi delle cavità, i centri delle scatole di docking e le dimensioni delle scatole di docking generati da CB-Dock2.
| ID di CurPocket | Punteggio Vina (kcal/mol) | Volume della cavità (ų) | Centro (x, y, z) | Dimensioni docking (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tabella 8: Tasche di docking predette per BRD-K91900765/VX-745 con JUN (ID PDB: 1JUN). La tabella riporta gli identificatori delle cavità in ordine di rango, i punteggi di Vina, i volumi delle cavità, i centri delle box di docking e le dimensioni delle box di docking generati da CB-Dock2.
| ID CurPocket | Punteggio Vina (kcal/mol) | Volume della cavità (ų) | Centro (x, y, z) | Dimensioni docking (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tabella 9: Tasche di docking previste per BRD-K91900765/VX-745 con IFIH1 (PDB ID: 3B6E). La tabella riporta gli identificativi delle cavità ordinati per rango, i punteggi di Vina, i volumi delle cavità, i centri delle box di docking e le dimensioni delle box di docking generati da CB-Dock2.
| ID CurPocket | Punteggio Vina (kcal/mol) | Volume della cavità (ų) | Centro (x, y, z) | Dimensioni del docking (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tabella 10: Tasche di docking previste per BRD-K91900765/VX-745 con MX1 (PDB ID: 5GTM). La tabella riporta gli identificatori delle cavità in ordine di classifica, i punteggi di Vina, i volumi delle cavità, i centri delle scatole di docking e le dimensioni delle scatole di docking generati da CB-Dock2.
| ID CurPocket | Punteggio Vina (kcal/mol) | Volume della cavità (ų) | Centro (x, y, z) | Dimensioni docking (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tabella 11: Tasche di docking previste per BRD-K91900765/VX-745 con TLR7 (PDB ID: 7CYN). La tabella riporta gli identificatori delle cavità in ordine di classifica, i punteggi di Vina, i volumi delle cavità, i centri delle scatole di docking e le dimensioni delle scatole di docking generati da CB-Dock2.
| Proprietà fisico-chimica | Parametro | Risultato | Interpretazione |
| Proprietà fisico-chimica | Peso molecolare | 436,27 g/mol | Inferiore a 500 Da, soddisfa la soglia del peso molecolare di Lipinski |
| Proprietà fisico-chimica | cLogP | Circa 5,49 | Leggermente superiore a 5, suggerisce un'elevata lipofilicità e la necessità di considerare solubilità e legame non specifico |
| Proprietà fisico-chimica | TPSA | Circa 47,26 Ų | Bassa area superficiale polare, coerente con una permeabilità di membrana potenzialmente favorevole |
| Somiglianza a farmaco | Accettori/donatori di legami a idrogeno (HBA/HBD) | 0/5 | Soddisfa le soglie di Lipinski per accettori e donatori di legami a idrogeno |
| Somiglianza a farmaco | Legami rotazionali | 3 | Bassa flessibilità conformazionale, favorevole per conformazioni di legame stabili |
| Avvisi strutturali | Avvisi PAINS/Brenk | Non rilevati | Nessun avviso strutturale comune di interferenza in svariati saggi o reattività rilevato |
| Previsione di tossicità | Mutagenicità di Ames | Previsione di non tossicità per Ames | Suggerisce un rischio mutageno previsto basso; è comunque richiesta una validazione sperimentale |
| Previsione di tossicità | Cancerogenicità | Previsione di non cancerogenicità | Suggerisce un rischio cancerogeno a lungo termine relativamente basso; è comunque richiesta una validazione sperimentale |
| Note farmacocinetiche | Disponibilità orale/penetrazione cerebrale | Letteratura e basi dati indicano una molecola di piccole dimensioni disponibile per via orale e in grado di attraversare la barriera ematoencefalica | Coerente con il suo background di sviluppo come inibitore di p38α; è comunque necessaria una rivalutazione per indicazioni PH |
Tabella 12: Previsioni preliminari di proprietà fisico-chimiche, farmaco-similitudine, ADMET e tossicità per BRD-K91900765/VX-745. La tabella riassume le proprietà fisico-chimiche previste, parametri di farmaco-similitudine, allarmi strutturali, endpoint tossicologici e caratteristiche farmacocinetiche. Queste previsioni computazionali sono preliminari e non sostituiscono la validazione sperimentale di dati farmacocinetici o tossicologici.
| ID CurPocket | Punteggio Vina (kcal/mol) | Volume della cavità (ų) | Centro (x, y, z) | Dimensioni del docking (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tabella 13: Tasche di docking previste per BRD-K91900765/VX-745 con il suo target farmacologico accertato MAPK14/p38α (PDB ID: 1OUK), inclusa come analisi di riferimento positivo. La tabella riporta gli identificatori delle cavità in ordine di classifica, i punteggi di Vina, i volumi delle cavità, i centri delle box di docking e le dimensioni delle box di docking generati utilizzando lo stesso flusso di lavoro di docking applicato alle cinque proteine associate ai biomarcatori.
Nel complesso, le analisi di scoperta e i risultati della qRT-PCR supportano CXCL10, JUN, IFIH1, MX1 e TLR7 come biomarcatori candidati per l'ipertensione polmonare/ipertensione arteriosa polmonare associati a una disregolazione immuno-infiammatoria e a un rimodellamento vascolare polmonare, sebbene la replica indipendente su GSE117261 sia stata più forte per JUN e variabile per gli altri geni. BRD-K91900765/VX-745 è un candidato identificato mediante analisi computazionale per il riposizionamento farmacologico, con un meccanismo plausibile di inibizione di MAPK14/p38α; sono necessarie validazioni riguardo al legame con il bersaglio, agli effetti cellulari, alla farmacocinetica, alla tossicità e ai modelli animali prima di poterne trarre interpretazioni terapeutiche.
DISPONIBILITÀ DEI DATI:
Tutti i set di dati trascrittomici pubblici utilizzati in questo studio sono disponibili nel database Gene Expression Omnibus con i numeri di accessione GSE22356, GSE33463, GSE48149, GSE117261 e GSE210248. Tutti i file di codice, i set di dati elaborati, i dati grezzi e analizzati di qRT-PCR de-identificati, gli output del modello e i file di input/output per il docking molecolare sono stati raccolti in un archivio strutturato su Zenodo. L'archivio include un file README che descrive ogni file, le versioni di software e pacchetti, l'ordine di esecuzione degli script e tutti i passaggi necessari per riprodurre completamente il lavoro - https://zenodo.org/records/21682282
Discussione
È stato sviluppato un flusso di lavoro integrato e riproducibile per identificare biomarcatori molecolari associati all'ipertensione polmonare (PH/PAH) e composti terapeutici candidati, combinando trascrittomica pubblica, analisi della rete di co-espressione genica pesata, arricchimento funzionale, analisi della rete di interazione proteina-proteina, tre algoritmi di apprendimento automatico, validazione esterna, interpretazione trascrittomica a singola cellula, conferma mediante PCR quantitativa a retrotrascrizione, screening della Connectivity Map e docking molecolare. CXCL10, JUN, IFIH1, MX1 e TLR7 sono stati costantemente identificati come geni caratteristici principali e mappati collettivamente a un asse molecolare infiammatorio-immunitario e correlato agli interferoni. Questi risultati supportano l'idea che la PH/PAH non sia soltanto un disturbo emodinamico, ma anche una malattia complessa di rimodellamento vascolare che coinvolge attivazione immunitaria, segnalazione infiammatoria, riconoscimento innato di acidi nucleici e cambiamenti fenotipici cellulari e strutturali2,5,6.
Il potenziale diagnostico dei cinque geni è stato supportato da una selezione delle caratteristiche basata su più algoritmi e dall'analisi ROC nel coorte di scoperta. La validazione indipendente in GSE117261 si è rivelata eterogenea piuttosto che uniforme: JUN ha soddisfatto i criteri prefissati di FDR e AUC, CXCL10 ha mostrato un aumento nominale direzionalmente coerente senza significatività di FDR a livello trascrittomico, IFIH1 e MX1 hanno mostrato una replicazione limitata, mentre TLR7 ha mostrato una direzione discordante. Questi risultati non supportano l'affermazione che tutti e cinque i geni siano stati validati in modo indipendente e indicano possibili effetti della composizione del coorte, dell'eterogeneità tissutale, delle differenze tra piattaforme e della gravità della malattia. Al contrario, la qRT-PCR eseguita su 20 campioni di tessuto polmonare di pazienti con PAH e 20 controlli ha confermato un significativo aumento dell'espressione di tutti e cinque i geni e una favorevole prestazione ROC per ciascun gene singolo.
Il modello logistico basato su qRT-PCR di cinque geni ha raggiunto un AUC apparente di 1.000 (IC 95%, 1.000–1.000), e il suo AUC aggregato fuori dal fold è rimasto a 1.000 in 100 analisi ripetute di cross-validazione stratificata a cinque fold. Tuttavia, il modello è stato sviluppato su soli 40 campioni biologici, e una separazione completa in una piccola coorte retrospettiva può produrre stime di prestazione ottimistiche e instabili. Il pannello dovrebbe pertanto essere considerato una firma molecolare esplorativa piuttosto che uno strumento diagnostico clinicamente validato. Sono necessarie coorti più ampie e multicentriche, coefficienti del modello prefissati e fissi, una validazione a livello proteico, l'immunohistochimica e test prospettici prima della traduzione clinica.
Tra i cinque geni principali, CXCL10 potrebbe favorire il reclutamento delle cellule immunitarie e l'amplificazione dell'infiammazione locale nell'ambiente microvascolare polmonare. IFIH1 e TLR7 sono coinvolti nel riconoscimento innato degli acidi nucleici e potrebbero riflettere l'attivazione di vie infiammatorie simili a quelle antivirali. MX1 è un gene classico stimolato dall'interferone e potrebbe rappresentare un marcatore a valle dell'attivazione della via del tipo I dell'interferone. JUN è un fattore di trascrizione sensibile allo stress che collega la stimolazione infiammatoria alla proliferazione cellulare, all'apoptosi e al rimodellamento del tessuto. Nel complesso, questi geni suggeriscono un modello biologicamente coerente in cui l'attivazione dell'immunità innata e la segnalazione correlata all'interferone interagiscono con i processi di rimodellamento vascolare nell'ipertensione polmonare (PH/PAH). Questa interpretazione è in accordo con evidenze precedenti secondo cui l'infiammazione, l'immunità e le vie correlate all'interferone contribuiscono alla patobiologia della PAH2,5,6.
La validazione a singola cellula ha fornito un contesto meccanicistico per i risultati ottenuti con l'analisi di massa. GSE210248 ha suggerito che il rimodellamento arterioso polmonare nella PAH era accompagnato da una modificata comunicazione tra cellule immunitarie e cellule strutturali vascolari, inclusi i miociti lisci, i fibroblasti, le cellule endoteliali e i monociti/macrophagi. La presenza di diversi fenotipi delle cellule muscolari lisce, tra cui quelli contrattili, sintetici, sensibili all'ossigeno/simili ai periciti e simili ai fibroblasti, supporta un modello di malattia in cui l'attivazione immunitaria e il rimodellamento strutturale delle cellule avvengono contemporaneamente. Questa evidenza cellulare è importante perché i segnali trascrittomici di massa possono derivare da alterazioni nelle proporzioni cellulari, dall'infiltrazione di cellule immunitarie o da cambiamenti trascrizionali nelle cellule vascolari residenti. L'analisi a singola cellula, pertanto, colloca CXCL10, JUN, IFIH1, MX1 e TLR7 all'interno di un ecosistema multicellulare di rimodellamento vascolare polmonare, piuttosto che in un processo limitato a un singolo tipo cellulare18,19,20,21.
L'analisi di riposizionamento farmacologico ha identificato BRD-K91900765, corrispondente a VX-745/neflamapimod, come il candidato computazionale con il punteggio più alto. VX-745 è un inibitore selettivo della p38α/MAPK14, e la sua relazione con le vie dello stress infiammatorio lo rende meccanicamente plausibile nel contesto dell'infiammazione associata a IP/AIP30. Pertanto, il docking contro MAPK14/p38α è stato incluso come analisi di riferimento positiva meccanicamente rilevante. Al contrario, il docking contro CXCL10, JUN, IFIH1, MX1 e TLR7 è stato di tipo esplorativo e indica soltanto una compatibilità strutturale prevista; non dimostra che queste proteine associate ai biomarcatori siano target diretti di VX-745 né stabilisce un legame diretto, l'inibizione del target o l'efficacia terapeutica. Un'ipotesi biologicamente più plausibile è che VX-745 possa modulare indirettamente la firma trascrizionale infiammatoria-immunitaria e interferon-correlata identificata, inibendo MAPK14. Le previsioni della Connectivity Map, i punteggi di docking e le stime ADMET rimangono evidenze di tipo computazionale. Ulteriori studi dovrebbero includere saggi biochimici di legame al target, esperimenti su cellule endoteliali e muscolari lisce arteriose polmonari, modelli di stimolazione infiammatoria, valutazioni farmacocinetiche e tossicologiche, e la validazione in modelli animali.
Recenti studi sperimentali sull'ipertensione polmonare ipossica hanno inoltre evidenziato l'importanza della comunicazione tra neutrofili e cellule vascolari polmonari. Sono state segnalate interazioni mediate da HCK tra neutrofili e cellule muscolari lisce arteriose polmonari e interazioni mediate da SERPINB3 tra neutrofili e cellule endoteliali come fattori che contribuiscono al rimodellamento vascolare polmonare31˒32. L'asse SERPINB3–STAT1/3 è particolarmente rilevante per i risultati attuali poiché segnali correlati all'interferone, STAT1 e JAK–STAT sono stati identificati nelle analisi trascrittomiche. Nel complesso, queste osservazioni sostengono l'interpretazione secondo cui l'attivazione delle cellule immunitarie e la loro comunicazione con le cellule strutturali vascolari potrebbero contribuire alla progressione dell'IP/PAH.
Lo studio presenta diversi punti di forza. Sono stati utilizzati diversi dataset pubblici e una correzione degli effetti di batch per ridurre i bias specifici dei dataset. L'analisi dell'espressione differenziale, l'analisi della rete di co-espressione genica pesata, l'analisi delle interazioni proteina-proteina e tre algoritmi di apprendimento automatico sono stati combinati per migliorare la robustezza delle caratteristiche. Una validazione indipendente su campioni bulk, la conferma mediante qRT-PCR e prove a singola cellula hanno fornito strati complementari ma non identici di evidenza. I risultati eterogenei ottenuti nel dataset GSE117261 e la piccola coorte utilizzata per la qRT-PCR evidenziano anche importanti limitazioni, tra cui una replicazione esterna incompleta, potenziali effetti specifici del tessuto e della piattaforma e il rischio di overfitting. La scoperta di biomarcatori è stata inoltre estesa alla selezione di composti candidati, ma le analisi di docking rimangono generatrici di ipotesi. Studi futuri dovrebbero validare i cinque geni in coorti indipendenti più ampie, utilizzando trascrittomica spaziale, proteomica, immunohistochimica e modelli di organoidi o di vasi su chip. Nel complesso, CXCL10, JUN, IFIH1, MX1 e TLR7 rimangono biomarcatori candidati per l'IP/AIP associati al rimodellamento vascolare di tipo infiammatorio-immunitario e interferon-correlato, mentre BRD-K91900765/VX-745 rappresenta un candidato per il riposizionamento farmacologico identificato per via computazionale, la cui rilevanza terapeutica richiede una validazione sperimentale.
Dichiarazioni
Gli autori dichiarano di non avere interessi concorrenti.
Ringraziamenti
Questo studio è stato sostenuto dal progetto di costruzione della provincia innovativa di Hunan (n. 2022JJ30465).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. SR1110 | Amplificazione PCR quantitativa in tempo reale basata su colorante e rilevamento della fluorescenza |
| AI21.msvmRFE.R e e1071 | Script R personalizzato con il pacchetto CRAN e1071 | AI21.msvmRFE.R; e1071 v1.7-17 | Eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto |
| Agarosio | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. A8201; CAS 9012-36-6 | Valutazione dell'integrità dell'RNA totale mediante elettroforesi su gel di agarosio |
| Apparecchiatura per elettroforesi su gel di agarosio | Beijing Liuyi Biotechnology Co., Ltd. | Modello DYCZ-24DN | Valutazione elettroforetica dell'integrità dell'RNA |
| Motore di punteggio AutoDock Vina | Center for Computational Structural Biology, Scripps Research | v1.2.0; RRID: SCR_011958 | Valutazione della posa del legame proteina-ligando all'interno del flusso di lavoro CB-Dock2 |
| CB-Dock2 | Cao Laboratory, server web CB-Dock2 | v2.0; accesso luglio 2026 | Rilevamento cieco delle cavità e docking molecolare di VX-745 con le strutture proteiche selezionate |
| CellChat | Pacchetto R CellChat | v2.1.2 | Inferenza e visualizzazione della comunicazione tra cellule a partire dalla matrice di espressione monocellulare |
| CellChatDB.human | Distribuito con il pacchetto R CellChat | CellChatDB.human; sottoinsieme di segnalazione secreta; soglia minima di cellule = 10 | Database umano di interazioni ligando-recettore per CellChat |
| clusterProfiler | Pacchetto R Bioconductor | v4.20.0; rilascio Bioconductor 3.23 | Analisi di arricchimento per Gene Ontology e Kyoto Encyclopedia of Genes and Genomes |
| Connectivity Map (CMap/CLUE) | Broad Institute | Risorsa L1000/CLUE; RRID: SCR_016204; accesso luglio 2026 | Analisi computazionale per il riposizionamento dei farmaci |
| Primer oligonucleotidici personalizzati | Beijing Solarbio Science & Technology Co., Ltd. | Sintetizzati su misura; sequenze dei primer fornite nella Tabella 2 | Amplificazione di ACTB, CXCL10, JUN, IFIH1, MX1 e TLR7 |
| cytoHubba | Negozio di app per Cytoscape | v0.1 | Classificazione dei geni centrali (hub) basata sul grado nella rete di interazione proteina-proteina |
| Cytoscape | Consorzio Cytoscape | v3.10.4; RRID: SCR_003032 | Visualizzazione e analisi della rete di interazione proteina-proteina |
| DrugBank | Database DrugBank | v6.0; RRID: SCR_002700 | Cura delle informazioni sull'identità del composto e sulle proprietà farmacologiche |
| Sistema di documentazione elettroforetica | Beijing Liuyi Biotechnology Co., Ltd. | Modello WO-9413B | Visualizzazione e registrazione dei risultati dell'integrità dell'RNA su gel di agarosio |
| Gene Expression Omnibus (GEO) | National Center for Biotechnology Information | GSE22356, GSE33463, GSE48149, GSE117261 e GSE210248; RRID: SCR_005012 | Recupero di dataset trascrittomici bulk e monocellulari |
| GEOquery | Pacchetto R Bioconductor | v2.80.0; rilascio Bioconductor 3.23 | Download e importazione automatizzati dei dati di espressione e fenotipici da GEO |
| glmnet | Pacchetto R CRAN | v5.0 | Regressione logistica con operatore di riduzione e selezione assoluta (lasso) e modellizzazione logistica regolarizzata |
| limma | Pacchetto R Bioconductor | v3.68.0; rilascio Bioconductor 3.23; RRID: SCR_010943 | Analisi dell'espressione differenziale e statistiche bayesiane empiriche |
| Spettrofotometro NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000; software v3.8 | Misurazione della concentrazione dell'RNA e dei rapporti di purezza A260/280 e A260/230 |
| NCBI Primer-BLAST | National Center for Biotechnology Information | Strumento web; RRID: SCR_003095; accesso luglio 2026 | Verifica della specificità dei primer |
| pROC | Pacchetto R CRAN | v1.19.0.1; RRID: SCR_024286 | Analisi della caratteristica operativa del ricevitore (ROC), intervalli di confidenza di DeLong e soglie basate sull'indice di Youden |
| Protein Data Bank (PDB) | RCSB Protein Data Bank | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Recupero di strutture proteiche determinate sperimentalmente per il docking molecolare |
| PubChem | National Center for Biotechnology Information | PubChem CID 3038525; RRID: SCR_004284 | Recupero della struttura tridimensionale e degli identificatori chimici di BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | Calcolo statistico, elaborazione dei dati, apprendimento automatico e visualizzazione |
| randomForest | Pacchetto R CRAN | v4.7-1.2 | Selezione delle caratteristiche e classificazione dell'importanza delle variabili mediante foresta casuale |
| Sistema di PCR in tempo reale | Stratagene, ora Agilent Technologies | Mx3000P Real-Time PCR System | Amplificazione qRT-PCR, acquisizione della fluorescenza, analisi della curva di denaturazione ed esportazione dei valori Ct |
| Seurat | Pacchetto R CRAN; Satija Laboratory | v5.5.1; RRID: SCR_016341 | Controllo di qualità, normalizzazione, riduzione della dimensionalità, raggruppamento e annotazione dei dati di sequenziamento dell'RNA monocellulare |
| STRING | Consorzio STRING | v12.0; RRID: SCR_005223 | Costruzione della rete di interazione proteina-proteina |
| sva (ComBat) | Pacchetto R Bioconductor | v3.60.0; rilascio Bioconductor 3.23 | Correzione degli effetti di lotto tra dataset |
| SwissADME | Istituto Svizzero di Bioinformatica | Server web; accesso luglio 2026 | Prevalutazione di somiglianza ai farmaci, proprietà fisico-chimiche e ADME |
| Kit per l'estrazione di RNA totale | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. R1200 | Estrazione e purificazione dell'RNA totale da campioni di tessuto polmonare |
| Kit RT-PCR Universale (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. RP1200 | Trascrizione inversa dell'RNA totale in DNA complementare |
| WGCNA | Pacchetto R CRAN | v1.74 | Costruzione della rete di co-espressione genica pesata e analisi dei moduli in relazione ai tratti |
Riferimenti
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.