Questo studio identifica cinque biomarcatori correlati a cuproptosi e ferroptosi nella colite ulcerosa attraverso un approccio integrato basato su apprendimento automatico, sequenziamento dell'RNA a singola cellula e validazione sperimentale, fornendo nuove prospettive per la diagnosi clinica e l'immunoterapia mirata.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Targeting della ferroptosi e della cuproptosi nella colite ulcerosa: risultati derivanti da bioinformatica completa e validazione sperimentale
In questo articolo
Sommario
Abstract
La colite ulcerosa (CU) è un disturbo intestinale cronico con una patogenesi non completamente definita e con tassi crescenti di prevalenza e ricoveri nei paesi recentemente industrializzati. Nella CU, la morte eccessiva delle cellule epiteliali intestinali compromette la barriera mucosale e innesca risposte infiammatorie. La ferroptosi e la cuproptosi sono due forme recentemente descritte di morte cellulare regolata. La maggior parte degli studi sulla CU ha esaminato questi processi separatamente; tuttavia, il loro ruolo combinato nella progressione della CU rimane insufficientemente caratterizzato. Per indagare il loro ruolo sinergico nella patogenesi della CU, abbiamo adottato un approccio graduale che include il profilo trascrittomico su larga scala per identificare target candidati, seguito da una validazione in modelli in vitro. I geni differenzialmente espressi (DEG) sono stati incrociati con geni associati alla ferroptosi (FRG) e geni associati alla cuproptosi (CRG). I target sovrapposti sono stati prioritizzati mediante un consenso di algoritmi di apprendimento automatico e analisi della rete di co-espressione genica pesata (WGCNA). Cinque biomarcatori—LCN2, IDO1, CXCL2, NOS2 e CD274—sono risultati significativamente upregolati nella CU. L'analisi a singola cellula ha caratterizzato la loro espressione in diversi tipi cellulari, con LCN2 e NOS2 principalmente arricchiti nelle cellule epiteliali. La rilevanza meccanicistica di questi marcatori è stata ulteriormente valutata mediante saggi in vitro. Il trattamento con inibitori della ferroptosi o della cuproptosi ha attenuato l'infiammazione associata alla CU e modulato l'espressione dei biomarcatori nei modelli cellulari Caco-2. Questi risultati identificano cinque biomarcatori associati alla progressione della CU e forniscono evidenze sperimentali a sostegno del loro potenziale utilizzo nella diagnosi clinica e nell'intervento terapeutico.
Introduzione
La colite ulcerosa (CU) è una malattia infiammatoria intestinale recidivante associata a un crescente onere globale e a costi di trattamento a lungo termine sostanziali1,2. Sebbene gli aminosalicilati, i corticosteroidi, i farmaci biologici e le terapie a base di piccole molecole abbiano ampliato le opzioni terapeutiche, ottenere una remissione duratura rimane difficile per molti pazienti3,4. Questa esigenza clinica insoddisfatta sottolinea l'importanza di identificare marcatori molecolari riproducibili e meccanismi affrontabili che possano favorire una diagnosi precoce e una terapia guidata dai meccanismi5.
La ferroptosi è una forma dipendente dal ferro di morte cellulare regolata, determinata dalla perossidazione lipidica, dalla deplezione di glutathione e dall'alterazione dell'attività della GPX46. L'aumento dei livelli di ferro e di malondialdeide nella colite ulcerosa è coerente con un danno epiteliale di tipo ferroptotico, mentre l'attivazione sperimentale dell'asse SLC7A11–GSH–GPX4 o l'inibizione diretta della ferroptosi possono proteggere la barriera intestinale7,8.
La cuproptosi, descritta nel 2022, è innescata quando il rame si lega alle proteine mitocondriali lipoylate, portando all'aggregazione proteica e allo stress proteotossico9. Poiché l'intestino svolge un ruolo centrale nella gestione del rame, il disturbo di questa via potrebbe amplificare il danno epiteliale ossidativo e infiammatorio nella colite ulcerosa10.
La ferroptosi e la cuproptosi potrebbero convergere attraverso uno squilibrio di ioni metallici, il metabolismo mitocondriale, l'esaurimento del glutatione e lo stress ossidativo11. Tuttavia, non è ancora chiaro se questa interazione produca una firma molecolare riproducibile nella colite ulcerosa e se tale firma risponda all'inibizione specifica del percorso.
L'ipotesi dello studio era che una comunicazione incrociata disregolata tra ferroptosi e cuproptosi nell'UC converga su una firma riproducibile di biomarcatori che può essere individuata in dataset trascrittomici bulk e a singola cellula e attenuata mediante inibizione specifica del percorso in un modello di danno all'epitelio intestinale. Di conseguenza, sono stati integrati bioinformatica multicohorte, apprendimento automatico, analisi a singola cellula ed esperimenti mirati su Caco-2 per identificare e valutare funzionalmente i biomarcatori candidati (Figura 1).
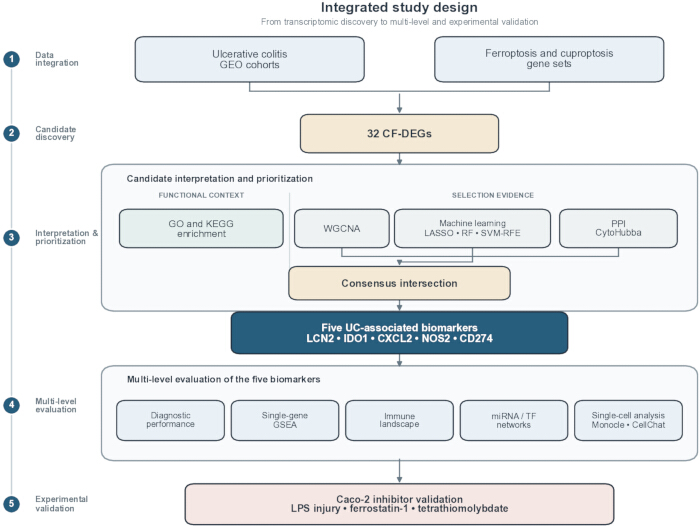
Figura 1: Flusso di lavoro dello studio. Flusso di lavoro integrato per lo screening trascrittomico multicohorte, la priorizzazione dei biomarcatori basata su apprendimento automatico e reti, la localizzazione a singola cellula e la validazione mediante inibitori in cellule Caco-2. UC: colite ulcerosa; GEO: Gene Expression Omnibus; WGCNA: analisi della rete di co-espressione genica pesata; PPI: interazione proteina-proteina; ROC: caratteristica operativa del ricevitore; GSEA: analisi di arricchimento dei set genici. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha utilizzato set di dati pubblicamente disponibili e linee cellulari umane reperibili in commercio. Non sono stati coinvolti partecipanti umani, tessuti umani appena raccolti o animali vertebrati; pertanto, non è stata richiesta l'approvazione da parte del comitato etico istituzionale. Gli strumenti di ricerca, il software e le risorse online utilizzati nel protocollo sono elencati nella Tabella dei Materiali.
1. Elaborazione dei dati per l'analisi dell'espressione differenziale
Per definire i cohorti di scoperta e di validazione transcriptomici, è stata effettuata una ricerca nel database Gene Expression Omnibus (GEO) utilizzando il termine „colite ulcerosa“. Quattro dataset — GSE87466, GSE92415, GSE107499 e GSE75214 — sono stati utilizzati come set di addestramento, mentre il dataset GSE47908 è stato riservato per la validazione esterna. I dataset di addestramento sono stati normalizzati e corretti per effetti di batch mediante ComBat in Sangerbox 3.0, mentre il dataset di validazione è stato processato in modo indipendente.
Un totale di 583 geni associati alla ferroptosi (FRGs) è stato ottenuto da FerrDB e integrato con geni riportati in letteratura per ridurre il bias derivante da un'unica fonte12. Un insieme di 96 geni associati alla cuproptosi (CRGs) è stato raccolto da studi pubblicati12,13,14. L'espressione differenziale è stata analizzata utilizzando limma con soglie di |variazione del log₂| > 1 e P corretto con il metodo di Benjamini–Hochberg < 0,05. I grafici diagnostici relativi alla normalizzazione, alla correzione del batch, all'espressione differenziale e al clustering sono forniti nella Figura Supplementare 1. La composizione dei campioni, le piattaforme e le assegnazioni dei cohort sono riportate nella Tabella Supplementare 1.
2. Identificazione di CF-DEG nella UC
È stata eseguita un'analisi della correlazione di Pearson utilizzando soglie di |r| > 0,5 e P < 0,05 per identificare i FRG e i CRG co-espressi. L'insieme genico risultante è stato incrociato con i geni differenzialmente espressi (DEG) per identificare i geni differenzialmente espressi co-espressi in cuproptosi e ferroptosi (CF-DEG).
3. Analisi di arricchimento
Le analisi di arricchimento di Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) sono state eseguite utilizzando clusterProfiler e la piattaforma Bioinformatics.com.cn. È stato utilizzato un valore di P corretto con il metodo di Benjamini–Hochberg < 0,05 come soglia di significatività. I grafici di arricchimento sono forniti nella Figura supplementare 2.
Analisi della rete di co-espressione genica pesata (WGCNA)
La struttura modulare sottostante i profili di espressione genica è stata analizzata mediante l'analisi di rete di co-espressione genica pesata (WGCNA). I campioni anomali sono stati identificati ed esclusi attraverso il clustering gerarchico combinato con la funzione goodSamplesGenes. Successivamente è stata determinata una potenza di soglia morbida (β) adeguata per soddisfare il criterio di topologia libera da scala nella costruzione della rete.
I dati di espressione elaborati sono stati utilizzati per costruire una matrice di sovrapposizione topologica (TOM) per l'analisi della co-espressione genica. Mediante l'approccio di taglio dinamico dell'albero, i geni con pattern di espressione altamente coerenti sono stati raggruppati in moduli genici, ciascuno contenente almeno 100 geni. Le associazioni tra eigengeni dei moduli (ME) e fenotipi sono state analizzate per identificare i moduli associati al processo della malattia ed estrarre i corrispondenti insiemi genici. I risultati diagnostici della selezione WGCNA sono riportati nella Figura supplementare 3.
5. Selezione dei biomarcatori
Per stabilire una gerarchia di priorità tra i candidati da sottoporre a ulteriori analisi sperimentali, sono stati applicati in parallelo tre algoritmi di apprendimento automatico¹⁵. È stata utilizzata la regressione con operatore di riduzione e selezione della contrazione assoluta (LASSO) per la selezione delle caratteristiche, la foresta casuale con ntree = 500 per determinare l'ordine di importanza dei geni e la macchina a vettori di supporto con eliminazione ricorsiva delle caratteristiche (SVM-RFE) per identificare il sottoinsieme di caratteristiche con l'errore minore nella validazione incrociata. I risultati completi delle analisi di screening sono riportati nella Figura 5 supplementare.
L'importanza dei geni è stata valutata in base al contributo di ciascun gene all'accuratezza della classificazione, e i geni con rango più elevato sono stati raccolti per generare un insieme preliminare di geni¹⁶. L'algoritmo SVM-RFE ha eseguito la selezione delle caratteristiche e l'ottimizzazione del modello mediante eliminazione iterativa delle caratteristiche, consentendo l'identificazione del sottoinsieme ottimale di caratteristiche per la classificazione¹⁷. I geni comuni ai tre algoritmi sono stati considerati biomarcatori candidati identificati attraverso l'apprendimento automatico.
I CF-DEGs sono stati utilizzati per costruire una rete di interazione proteina-proteina (PPI), e CytoHubba è stato impiegato per classificare i nodi centrali. L'intersezione tra i moduli chiave di WGCNA, i tre risultati dell'apprendimento automatico e il set centrale PPI ha identificato cinque biomarcatori candidati integrati: LCN2, IDO1, CXCL2, NOS2 e CD274. Questi geni sono stati classificati come candidati diagnostici associati alla colite ulcerosa. Successivi esperimenti con inibitori hanno ulteriormente classificato LCN2, IDO1, CXCL2 e NOS2 come marcatori responsivi all'inibizione della ferroptosi e CD274 come marcatore responsivo all'inibizione della cuproptosi. Tali geni non sono stati considerati regolatori primari dimostrati di nessuno dei due percorsi.
6. Sviluppo del modello predittivo e valutazione multimetodo
Per valutare il potenziale clinico traslazionale della firma genica identificata, è stato costruito un nomogramma utilizzando il pacchetto rms per analizzare le prestazioni diagnostiche. Le prestazioni del modello sono state valutate mediante una curva di calibrazione, il test di Hosmer–Lemeshow (HL) e l'indice di concordanza di Harrell (C-index).
La calibrazione del modello è stata valutata utilizzando il test di Hosmer-Lemeshow (HL) e l'errore assoluto medio (MAE). Sono stati stabiliti come soglie per un adeguato adattamento del modello e per l'accuratezza rispettivamente un valore di P > 0,05 e un MAE < 0,1. Sono state generate curve caratteristiche operative del ricevitore (ROC) e calcolata l'area sotto la curva (AUC) per valutare le prestazioni predittive del nomogramma per la colite ulcerosa (UC). Un dataset indipendente è stato utilizzato per valutare la generalizzabilità e la stabilità del modello.
7. Analisi dell'arricchimento di geni (GSEA)
Nel set di addestramento, è stata eseguita un'analisi della correlazione di Spearman tra ciascun biomarcatore e tutti gli altri geni. I risultati della correlazione sono stati ordinati per generare un insieme di geni ordinato. È stata effettuata un'analisi dell'arricchimento degli insiemi genici (GSEA) utilizzando l'insieme genico c2.cp.kegg_medicus.v2025.1.Hs.symbols del Molecular Signatures Database (MSigDB) come riferimento. I percorsi biologici con P < 0,05 sono stati considerati significativamente arricchiti.
8. Analisi del paesaggio immunitario
Lo strumento CIBERSORT e la matrice di firma LM22 sono stati utilizzati per eseguire l'analisi di deconvoluzione dei dati di espressione e stimare le proporzioni di 22 sottotipi di cellule immunitarie. Successivamente è stata effettuata un'analisi di correlazione di Spearman per valutare le associazioni tra i cinque biomarcatori e i sottotipi di cellule immunitarie.
9. Analisi della rete regolatoria
Le informazioni sulla regolazione genica da parte di fattori di trascrizione (TF) e microRNA (miRNA) sono state ottenute dalle basi di dati integrate ChEA3 e TarBase 9.0 attraverso la piattaforma NetworkAnalyst. I miRNA associati ad almeno due nodi sono stati inclusi nella rete di regolazione.
10. RNA-seq a singola cellula
I dataset di singole cellule UC GSE116222, costituiti da tre campioni sani e tre campioni UC, e GSE214695, costituiti da sei campioni sani e sei campioni UC, sono stati integrati. Le cellule sono state mantenute se contenevano da 200 a 5.000 geni rilevati, >1.000 identificatori molecolari unici, < 30% di trascritti mitocondriali, < 3% di trascritti di emoglobina e < 50% di trascritti ribosomiali. La funzione NormalizeData è stata utilizzata per la normalizzazione e Harmony è stato impiegato per la correzione del batch prima del clustering e dell'annotazione.
Dopo il filtraggio, i dati sono stati normalizzati utilizzando la funzione NormalizeData. Harmony è stato utilizzato per minimizzare gli effetti di batch tra i campioni. L'approximazione uniforme della varietà (UMAP) e l'incorporamento stocastico di vicini distribuiti in t (t-SNE) sono stati impiegati per la riduzione della dimensionalità e il raggruppamento cellulare al fine di caratterizzare le strutture locali e globali all'interno della popolazione cellulare. Un totale di 31.712 cellule di alta qualità è stato mantenuto per ulteriori analisi. I tipi cellulari sono stati annotati in base ai geni marcatore canonici.
L'analisi del pseudotempo è stata eseguita utilizzando Monocle 2 per studiare i cambiamenti negli stati delle cellule epiteliali e mieloidi provenienti da tessuti di colite ulcerosa. Sono state valutate le traiettorie di sviluppo cellulare e le differenze tra gruppi, e i modelli di espressione dei biomarcatori lungo la traiettoria del pseudotempo sono stati visualizzati.
CellChat è stato utilizzato per valutare la comunicazione tra cellule epiteliali e sottopopolazioni di cellule mieloidi. I profili di espressione specifici delle sottopopolazioni sono stati integrati per inferire le probabilità di interazione e le principali vie di segnalazione tra cellule epiteliali e mieloidi e per caratterizzare le potenziali reti di regolazione intercellulare.
11. Esperimenti sulle cellule
Le cellule umane di adenocarcinoma colon-rettale Caco-2 sono state coltivate in terreno di Dulbecco modificato di Eagle contenente il 10% di siero fetale bovino, 100 U/mL di penicillina e 100 µg/mL di streptomicina a 37 °C in atmosfera al 5% di CO₂. Le cellule Caco-2 sono state scelte come modello riproducibile di monocapa epiteliale per saggi sulla barriera intestinale e su quelli infiammatori e lesivi; tuttavia, la loro origine maligna limita l'estrapolazione diretta all'epitelio colonnare non maligno. Le informazioni sui passaggi cellulari non erano disponibili nei registri sperimentali archiviati.
Un modello in vitro di infiammazione-danno è stato stabilito esponendo le cellule a 1 µg/mL di lipopolisaccaride (LPS) per 24 h. Le cellule sono state assegnate a un gruppo controllo con dimetilsulfossido come veicolo, a un gruppo con solo LPS, a un gruppo con LPS + 4 µM di ferrostatina-1 o a un gruppo con LPS + 40 µM di tetratiomolibdato, con concentrazioni finali di solvente equivalenti. Il gruppo con solo LPS è stato utilizzato come controllo positivo del danno/modello per i confronti di recupero con inibitori.
- Viabilità cellulare
La viabilità cellulare è stata valutata mediante un saggio di viabilità cellulare secondo le istruzioni del produttore. Dopo un'incubazione a 37 °C per circa 2 h, l'assorbanza a 450 nm è stata misurata utilizzando un lettore di micropiastre. - Misurazione dei livelli di MDA e Fe²⁺
I livelli intracellulari di malondialdeide (MDA) e Fe2⁺ sono stati misurati utilizzando i rispettivi kit di saggio secondo le istruzioni dei produttori. Le proteine totali sono state quantificate mediante un saggio con acido bicinconinico e ogni valore ottenuto è stato normalizzato rispetto al contenuto proteico del campione corrispondente. - Saggio con sonda fluorescente per ioni rame
Dopo la rimozione del mezzo di coltura, è stata aggiunta una sonda fluorescente specifica per Cu2⁺ a una concentrazione finale di 1 µM e incubata per 30 min a 37 °C. Le immagini sono state acquisite immediatamente senza lavaggi mediante un microscopio a fluorescenza invertito con lunghezze d'onda di eccitazione e di emissione di 510 e 578 nm, rispettivamente. Le impostazioni di acquisizione sono state mantenute costanti tra i diversi gruppi e la barra di scala delle immagini è stata calibrata a 50 µm. - RT-qPCR
L'RNA totale è stato isolato utilizzando un reagente di estrazione dell'RNA basato su fenolo–guanidinio. Il DNA complementare è stato sintetizzato da 1 µg di RNA utilizzando un kit per la sintesi del DNA complementare del primo filamento e reagenti a base di SYBR Green sono stati impiegati per la PCR in tempo reale. Ogni reazione è stata eseguita in triplicato tecnico. Le sequenze dei primer sono riportate nella Tabella Supplementare 2 e l'abbondanza relativa dell'RNA messaggero è stata calcolata con il metodo 2⁻ΔΔCt.
12. Analisi statistica
La normalità e l'omogeneità della varianza sono state valutate utilizzando rispettivamente i test di Shapiro–Wilk e di Levene centrato sulla mediana. I dati che soddisfacevano entrambe le assunzioni sono stati analizzati mediante un test t a due code non appaiato o un'analisi della varianza ad un fattore seguita dal test di Tukey per la differenza significativa onesta. Quando una delle due assunzioni non era soddisfatta, è stato utilizzato il test t di Welch o l'analisi della varianza di Welch seguita dai confronti di Games–Howell.
I risultati sono presentati come media ± deviazione standard. I conteggi effettivi dei replicati biologici, i valori P esatti a due code e i controlli delle assunzioni sono riportati nella Tabella Supplementare 3. Il foglio sorgente dell'Figura 13 archiviato contiene un numero minore di replicati di controllo per i pannelli A (n = 4), C (n = 4) e F (n = 2), mentre tutte le altre combinazioni pannello/gruppo contengono n = 6.
Le analisi computazionali sono state eseguite utilizzando R e i flussi di lavoro limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat e Cytoscape/CytoHubba. Le risorse online incluse sono FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn e Sangerbox 3.0.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Identificazione e annotazione funzionale dei geni co-espressi nella cuproptosi e ferroptosi
Sono stati integrati quattro set di dati di addestramento composti da 421 campioni di colite ulcerosa e 97 controlli sani. Sono stati identificati complessivamente 551 geni a espressione differenziale, inclusi 362 geni upregolati e 189 geni downregolati. L'analisi di correlazione ha prodotto 444 geni correlati con la ferroptosi e la cuproptosi, e l'intersezione con i geni a espressione ...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo studio ha integrato trascrittomica su larga scala, apprendimento automatico, analisi a singola cellula e esperimenti mirati sulle cellule per esaminare l'interazione tra ferroptosi e cuproptosi nella colite ulcerosa. Cinque candidati diagnostici associati alla colite ulcerosa si sono dimostrati riproducibili in coorti di scoperta e di validazione, localizzandosi principalmente nei compartimenti epiteliali e mieloidi, e hanno mostrato un'espressione modulata da inibizione di pathway nelle cellule Caco-2. Questi ris...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori non hanno nulla da dichiarare.
Ringraziamenti
Questo lavoro è stato sostenuto dal progetto Young Qihuang Scholar dell'Amministrazione Nazionale della Medicina Tradizionale Cinese (Grant No. 2022256). Si ringraziano tutti i membri dei gruppi di ricerca dell'Università di Medicina Tradizionale Cinese del Liaoning e del Terzo Ospedale Affiliato dell'Università di Medicina Tradizionale Cinese del Liaoning per il supporto tecnico e i contributi alla cura dei dati e all'analisi bioinformatica.
OpenAI Codex (OpenAI) è stato utilizzato durante la revisione esclusivamente per assistere con la correzione linguistica in inglese, la formattazione del documento e i controlli sulla qualità delle figure. Tutti i contenuti scientifici, le analisi, le citazioni e la presentazione finale sono stati esaminati e verificati dagli autori, che si assumono piena responsabilità per il manoscritto.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Kit per saggio proteico BCA | Beyotime Institute of Biotechnology | P0010 | Quantificazione delle proteine per la normalizzazione. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Piattaforma online; accesso 2026 | Piattaforma per visualizzazione e analisi GO/KEGG. |
| Linea cellulare Caco-2 | ATCC | HTB-37 | Linea cellulare di adenocarcinoma colorettale umano utilizzata per il modello di danno epiteliale. |
| Cell Counting Kit-8 | GLPBio | GK10001 | Saggio di vitalità cellulare misurato a 450 nm. |
| CIBERSORT con profilo LM22 | Sviluppatori di CIBERSORT | LM22 | Deconvoluzione delle frazioni di 22 cellule immunitarie. |
| ChEA3 | Ma'ayan Laboratory | Piattaforma online; accesso 2026 | Arricchimento dei fattori di trascrizione e previsione di reti regolatorie. |
| Incubatore in atmosfera di CO2 | Non registrato | N/A | Incubatore umidificato utilizzato per la coltura a 37 °C e 5% CO2. |
| Probe fluorescente per Cu2+ | BIOFOUNT | CAS 98907-26-7 | Rilevamento della fluorescenza intracellulare di Cu2+ . |
| Cytoscape con CytoHubba | Consortium Cytoscape | Versione non registrata | Visualizzazione delle interazioni proteina-proteina e classificazione dei nodi principali. |
| Mezzo di Eagle modificato di Dulbecco | Gibco | 11965092 | Mezzo di coltura per cellule Caco-2. |
| Dietilsolfossido | Non registrato | N/A | Controllo del veicolo. |
| Serum fetale bovino | Non registrato | N/A | Integratore del mezzo al 10%. |
| Kit per saggio del Fe2+ | Abcam | ab83366 | Misurazione del Fe2+ intracellulare. |
| FerrDB | Sviluppatori di FerrDB | Database online; accesso 2026 | Fonte di geni associati alla ferroptosi. |
| Ferrostatina-1 | Sigma-Aldrich | SML0583 | Inibitore della ferroptosi; concentrazione finale 4 µM. |
| Harmony | Broad Institute/comunità | Versione non registrata | Correzione batch per singola cellula. |
| Microscopio a fluorescenza invertito | Olympus | IX71 | Acquisizione di immagini di fluorescenza del Cu2+ con eccitazione/emissione a 510/578 nm. |
| Lipopolisaccaride | Non registrato | N/A | Stimolo di danno infiammatorio a 1 µg/mL per 24 h. |
| Kit per saggio del malondialdeide | Beyotime Institute of Biotechnology | S0131S | Misurazione della perossidazione lipidica. |
| Lettore di micropiastre | Non registrato | N/A | Misurazione dell'assorbanza a 450 nm. |
| Monocle | Bioconductor/comunità | Versione 2 | Analisi del pseudotempo per singola cellula. |
| Molecular Signatures Database | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Set di geni di riferimento per GSEA. |
| NetworkAnalyst | Sviluppatori di NetworkAnalyst | Piattaforma online; accesso 2026 | Integrazione delle reti di fattori di trascrizione e di miRNA. |
| Penicillina–streptomicina | Non registrato | N/A | 100 U/mL di penicillina e 100 µg/mL di streptomicina. |
| R | R Foundation for Statistical Computing | Versione non registrata | Ambiente di analisi bioinformatica. |
| Set di pacchetti R | CRAN/Bioconductor | Versioni dei pacchetti non registrate | Flussi di lavoro con limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC e rms. |
| Sistema di PCR in tempo reale | Non registrato | N/A | Strumento per RT-qPCR con SYBR Green. |
| Kit per la sintesi del primo filamento di cDNA RevertAid | Thermo Fisher Scientific | K1622 | Sintesi del primo filamento di cDNA da 1 µg di RNA. |
| Sangerbox | Sviluppatori di Sangerbox | 3.0 | Normalizzazione e correzione batch con ComBat. |
| Seurat | Satija Lab/comunità | Versione 4 | Controllo qualità, normalizzazione, raggruppamento e visualizzazione per singola cellula. |
| Software per analisi statistiche | Non registrato | N/A | Analisi statistica degli esperimenti cellulari originali. |
| STRING | Consortium STRING | Database online; accesso 2026 | Costruzione della rete di interazioni proteina–proteina. |
| Reagenti per PCR in tempo reale con SYBR Green | Takara | RR820A | PCR quantitativa in tempo reale. |
| TarBase | DIANA Tools | 9.0 | Interazioni sperimentali tra miRNA–gene. |
| Tetratiomolibdato | Sigma-Aldrich | 323446 | Chelestrante del rame; concentrazione finale 40 µM. |
| Reagente TRIzol | Takara | 9108 | Estrazione dell'RNA totale. |
Riferimenti
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.