La farmacologia delle reti e il docking molecolare hanno rivelato che Rhizoma Drynariae agisce su multipli bersagli e vie metaboliche per alleviare le lesioni della cuffia dei rotatori attraverso attività anti-infiammatorie, anti-apoptotiche e pro-angiogenetiche.
Articolo di ricerca
La Farmacologia di Rete e il Docking Molecolare Rivelano il Meccanismo dell'Rhizoma Drynariae Contro le Lesioni della Cuffia dei Rotatori
In questo articolo
Sommario
Abstract
La lesione della cuffia dei rotatori (RCI) è un disturbo muscoloscheletrico refrattario caratterizzato da infiammazione cronica, apoptosi dei tenociti, angiogenesi compromessa e alterata regolazione della matrice extracellulare (ECM), con trattamenti clinici disponibili limitati. Questo studio ha utilizzato la farmacologia di rete e il docking molecolare per indagare sistematicamente i componenti attivi, le principali proteine bersaglio e le vie di segnalazione del Rhizoma Drynariae (RD) contro la RCI. Diciotto ingredienti attivi del RD e 213 bersagli non ridondanti sono stati identificati da TCMSP, ETCM e SymMap, mentre 870 bersagli associati alla RCI sono stati recuperati da GeneCards e OMIM, ottenendo 71 bersagli candidati sovrapposti. L'analisi della rete di interazione proteina-proteina e lo screening tramite cytoHubba hanno rivelato dieci geni centrali, tra cui TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 e HMOX1. L'arricchimento Gene Ontology ha evidenziato risposta infiammatoria, stress ossidativo, angiogenesi, proliferazione cellulare e organizzazione della matrice extracellulare, mentre l'analisi dei percorsi KEGG ha indicato le vie di segnalazione TNF, PI3K-Akt, MAPK e HIF-1. Il docking molecolare ha confermato un legame stabile ad alta affinità di eriodictiole, luteolina, catechina, naringenina e aureusidina con queste proteine chiave. Nel complesso, il RD esercita effetti anti-RCI attraverso una rete multicomponente, multibersaglio e multipercorso, attenuando potenzialmente la RCI mediante soppressione dell'infiammazione e dell'apoptosi, promozione dell'angiogenesi e miglioramento della riparazione della matrice extracellulare, fornendo così una base teorica per la sua applicazione clinica e la validazione sperimentale.
Introduzione
La lesione della cuffia dei rotatori (RCI) è uno dei disturbi della spalla più comuni in ortopedia e medicina dello sport, che colpisce circa il 20% degli adulti con più di 20 anni e fino al 54% delle persone oltre i 60 anni1,2. Dal punto di vista patologico, la RCI è caratterizzata da degenerazione del tendine, infiltrazione di cellule infiammatorie, apoptosi eccessiva dei tenociti, neovascolarizzazione insufficiente e sintesi disordinata della matrice extracellulare, condizioni che provocano dolore cronico alla spalla, mobilità limitata, atrofia muscolare e persino instabilità articolare3. Se non trattata, la RCI può ridurre gravemente la qualità della vita e comportare un pesante onere socioeconomico4. Le attuali strategie terapeutiche per la RCI comprendono il trattamento conservativo e la riparazione chirurgica5. I farmaci anti-infiammatori non steroidei (FANS) e le iniezioni di corticosteroidi alleviano il dolore, ma comportano rischi di lesioni gastrointestinali, disfunzione renale, degenerazione della cartilagine e osteoporosi6,7. La riparazione chirurgica migliora la funzionalità a breve termine, ma è limitata da elevati tassi di re-rottura, aderenze post-operatorie e scarsa qualità della guarigione a lungo termine8,9. Pertanto, vi è un’urgente necessità di sviluppare agenti terapeutici sicuri, efficaci e a bersaglio multiplo per la RCI.
La medicina tradizionale cinese (MTC) vanta una lunga storia nel trattamento delle malattie muscoloscheletriche, grazie ai suoi vantaggi di multi-componente, multi-target e bassa tossicità10. Rhizoma Drynariae (RD), il rizoma essiccato di Drynaria fortunei (Kunze) J. Sm., è un'erba rappresentativa per il rafforzamento osseo che promuove la circolazione sanguigna, elimina la stasi ematica e accelera la riparazione di tendini e ossa11,12. La farmacologia moderna ha confermato che i flavonoidi sono i principi attivi principali del RD, che esercitano effetti anti-infiammatori, antiossidanti, osteogenici e condroprotettivi13. Il RD è stato ampiamente utilizzato nell'osteoporosi, nell'osteoartrite, nella necrosi della testa del femore e nella degenerazione del disco intervertebrale14,15,16. Tuttavia, nessuno studio sistematico ha ancora esplorato l'efficacia e il meccanismo d'azione del RD contro la RCI. La farmacologia di rete è un approccio interdisciplinare emergente che integra bioinformatica, biologia dei sistemi e farmacologia, ideale per decifrare il meccanismo olistico della MTC17,18. Essa permette la costruzione sistematica della rete regolatoria “farmaco–componente–target–via–malattia” e la previsione ad alto rendimento di potenziali target terapeutici19. In questo studio, la farmacologia di rete combinata con il docking molecolare è stata utilizzata per esplorare i componenti attivi, i geni centrali e le vie di segnalazione chiave del RD nel trattamento della RCI, con l'obiettivo di fornire una base teorica per l'applicazione clinica e ulteriori ricerche sperimentali.
Protocollo
Questo studio ha utilizzato esclusivamente database bioinformatici pubblici anonimizzati e non ha coinvolto esperimenti su esseri umani o animali. In conformità con l'articolo 32 delle normative nazionali cinesi sulla revisione etica e con la Dichiarazione di Helsinki, è stata dispensata l'approvazione etica e il consenso informato. Tutti i materiali utilizzati in questo studio sono elencati nella Tabella dei materiali.
Progettazione dello studio e diagramma del flusso di lavoro
L'intero flusso di lavoro di questo studio di farmacologia delle reti, comprensivo di screening degli ingredienti, acquisizione dei bersagli, costruzione della rete, analisi dell'arricchimento e verifica mediante docking molecolare, è stato eseguito seguendo standard bioinformatici unificati in ogni fase, al fine di garantire la riproducibilità di tutti i dati predetti (Figura 1).
Screening degli ingredienti attivi nel RD
La piattaforma online Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform (TCMSP, https://old.tcmsp-e.com/tcmsp.php) è stata sviluppata sulla base della farmacologia sistemica delle erbe medicinali20. Ha raccolto in modo esaustivo i parametri farmacocinetici dei composti naturali, inclusa la biodisponibilità orale (OB), la somiglianza ai farmaci (DL), la capacità di attraversare la barriera ematoencefalica e le informazioni relative ai bersagli corrispondenti. Gli autori hanno inserito la parola chiave "Rhizoma Drynariae" per cercare tutti i costituenti chimici di RD presenti nel database TCMSP, selezionando i principi attivi idonei in base agli indici di assorbimento, distribuzione, metabolismo ed escrezione (ADME), con OB ≥ 30% e DL ≥ 0,18. I composti che soddisfacevano entrambi questi criteri sono stati mantenuti come principi attivi candidati per lo studio del meccanismo terapeutico di RD contro RCI. Data di accesso al database: TCMSP V2.3 [2025-12-08]. I campi esportati includevano il nome del composto, il valore di OB, il valore di DL e le relative entrate delle proteine bersaglio. Le voci duplicate dei composti sono state rimosse manualmente.
Raccolta di potenziali bersagli dell'RD
I ricercatori hanno recuperato i bersagli d'azione della RD da tre database indipendenti: TCMSP, The Encyclopedia of Traditional Chinese Medicine (ETCM, http://www.tcmip.cn/ETCM/)21 e SymMap (http://www.symmap.org/)22. TCMSP ha funto da piattaforma specializzata di farmacologia sistemica erboristica, registrando l'interrelazione tra medicine erboristiche, composti a piccole molecole, bersagli proteici e malattie umane. ETCM ha integrato informazioni standardizzate su erbe medicinali cinesi comuni e formulazioni, registrando dati su ingredienti erboristici, geni bersaglio, vie metaboliche e malattie. SymMap ha integrato le teorie della medicina tradizionale cinese e della medicina moderna attraverso meccanismi molecolari e mappatura dei sintomi. Durante l'estrazione dei bersagli farmacologici, la specie è stata uniformemente impostata come Homo sapiens. Dopo aver ottenuto le sequenze proteiche dei bersagli grezzi, il database UniProt (https://www.uniprot.org/)23 ha convertito tutte le voci bersaglio in simboli genici standardizzati. I geni bersaglio duplicati sono stati eliminati e l'insieme di bersagli privo di duplicati della RD è stato conservato per l'analisi incrociata con i bersagli della malattia. Date di accesso ai database: ETCM V2.0 [2025-12-10], SymMap V2.0 [2025-12-11], versione UniProt [2025-12-12]. Gli autori hanno esportato le voci grezze relative ai bersagli proteici da TCMSP, ETCM e SymMap. UniProt è stato utilizzato per associare gli identificatori proteici ai simboli genici ufficiali umani HUGO. I duplicati dei bersagli provenienti da più database sono stati rimossi, mantenendo un solo simbolo genico univoco per ciascun bersaglio.
Ricerca di potenziali bersagli per RCI
Sono stati utilizzati due database autorevoli per identificare i geni umani associati alla lesione della cuffia dei rotatori (RCI) mediante la parola chiave di ricerca "rotator cuff injury". GeneCards (https://www.genecards.org/) ha aggregato dati multi-omici provenienti da oltre 150 piattaforme genetiche e ha fornito annotazioni funzionali dei geni24. L'Online Mendelian Inheritance in Man (OMIM, https://omim.org/) ha registrato malattie ereditarie umane e rivelato correlazioni tra variazioni genetiche e fenotipi clinici25. Sono state estratte tutte le voci di geni associate alla RCI, incluse denominazioni e ID dei geni. I dati provenienti dai due database sono stati uniti ed eliminati i duplicati al fine di ottenere un insieme completo di geni patogeni per l'analisi di intersezione di Venn. Date di accesso ai database: GeneCards [2025-12-15], OMIM [2025-12-21]. Termine di ricerca: “rotator cuff injury”. I campi esportati includevano i nomi dei geni umani associati alla malattia e gli ID genici. Le voci duplicate tra i due database sono state rimosse dopo l'unione. Il filtro della specie è stato impostato su Homo sapiens.
Costruzione della rete di interazione proteina-proteina (PPI)
Il set di dati degli obiettivi RD sottoposti a screening e il set di dati dei geni patogeni RCI sono stati caricati sulla piattaforma online Venny (https://bioinfogp.cnb.csic.es/tools/venny/) per generare un diagramma di Venn e identificare i geni condivisi in comune. I geni sovrapposti sono stati importati in STRING v11.5 (https://cn.string-db.org/) per la costruzione della rete di interazioni proteina-proteina26. STRING ha recuperato interazioni proteiche verificate e predette, coprendo oltre 24 milioni di proteine provenienti da più di 5000 specie. La specie è stata impostata su Homo sapiens e la soglia del punteggio di confidenza è stata fissata a 0,7 per filtrare le coppie di interazione a bassa credibilità. I file delle interazioni proteina-proteina esportati sono stati importati in Cytoscape 3.8.0 per la visualizzazione e l'analisi topologica27. Venny 2.0 è stato consultato il [2025-12-24] per il calcolo del diagramma di Venn. Data di accesso a STRING v11.5: [2025-12-28]. Gli autori hanno esportato l'intera tabella delle interazioni proteina-proteina in formato TSV, inclusi gli identificatori delle proteine, i simboli dei geni e i punteggi combinati di confidenza delle interazioni.
Analisi dei geni hub
Il plugin cytoHubba integrato in Cytoscape 3.8.0 ha analizzato le caratteristiche topologiche di ciascun nodo della rete. Sono stati selezionati i 10 principali geni hub con i punteggi più elevati di Centralità della Cricca Massima (MCC). MCC è uno degli algoritmi di classificazione integrati in cytoHubba; punteggi MCC più alti indicano posizioni topologiche più importanti all'interno della rete PPI. Questi geni esercitano effetti regolatori centrali nell'intera rete.
Analisi dell'arricchimento dei percorsi metabolici nel Gene Ontology (GO) e nella Kyoto Encyclopedia of Genes and Genomes (KEGG)
Tutti i bersagli terapeutici sovrapposti di RD contro RCI sono stati importati nel software R x64 4.0.3, impostando la specie come Homo sapiens. Il pacchetto Bioconductor clusterProfiler ha eseguito l'analisi di arricchimento GO e KEGG. L'analisi GO comprendeva tre moduli: processo biologico (BP), componente cellulare (CC) e funzione molecolare (MF), che annotavano rispettivamente i comportamenti biologici, la localizzazione subcellulare e le funzioni biochimiche delle proteine bersaglio28. L'analisi KEGG ha mappato i geni all'interno di cascate di segnalazione intracellulari per osservare la distribuzione dei bersagli in diversi percorsi biologici29. Sono stati estratti i termini BP, CC e MF significativamente arricchiti, nonché i percorsi chiave associati all'intervento di RD su RCI, e tutti i risultati di arricchimento sono stati esportati per la creazione di grafici, con p < 0,05 come soglia di significatività.
Simulazione di docking molecolare
I geni hub selezionati dall'analisi PPI sono stati definiti come recettori proteici, mentre gli ingredienti attivi di RD sono stati impostati come ligandi di piccole molecole. È stata eseguita una simulazione di docking molecolare per esplorare le interazioni naturali di legame tra le proteine hub e i corrispondenti ingredienti. Le strutture tridimensionali dei ligandi sono state scaricate da PubChem (https://pubchem.ncbi.nlm.nih.gov/)30, mentre le strutture cristalline dei recettori sono state ottenute da RCSB PDB (https://www.rcsb.org/)31. Le strutture dei recettori sono state pretrattate in AutoDock 432, inclusa la rimozione delle molecole d'acqua ridondanti e l'aggiunta di idrogeni polari. Il calcolo del docking multiplo è stato completato mediante AutoDock Vina, in combinazione con il software Open Babel. I complessi con energia libera di legame ≤ −7,0 kcal/mol sono stati definiti come strutture di legame stabili rappresentanti i complessi di docking meglio classificati. I complessi con energia libera di legame ≤ −7,0 kcal/mol sono stati considerati strutture di legame stabili con elevata affinità intermolecolare. Questa soglia empirica è comunemente utilizzata negli studi in silico basati su AutoDock-Vina per composti bioattivi di origine botanica, sebbene non sostituisca la validazione sperimentale delle interazioni proteina-ligando33. I primi 20 complessi di docking con affinità ottimale sono stati importati in PyMOL per generare diagrammi delle conformazioni tridimensionali di legame34. Data di accesso a PubChem: [2026-02-10]; data di accesso a RCSB-PDB: [2026-02-03]. Le strutture delle piccole molecole sono state recuperate tramite il nome del composto; le strutture dei recettori proteici sono state recuperate tramite gli ID di accesso PDB corrispondenti al gene.
Analisi statistica
R x64 4.0.3, Cytoscape 3.8.0 e PyMOL sono stati utilizzati per completare tutte le statistiche e la mappatura bioinformatiche. p < 0,05 indicava una differenza statisticamente significativa per tutti gli elementi arricchiti.
Risultati
I principi attivi di RD
Un totale di 71 ingredienti chimici grezzi è stato recuperato da TCMSP utilizzando "Rhizoma Drynariae" come parola chiave. È stata effettuata una seconda selezione in base ai criteri ADME (OB ≥ 30%, DL ≥ 0,18), ottenendo infine 18 ingredienti bioattivi con favorevole assorbimento orale e farmacologia. Tabella 1 riporta informazioni di base dettagliate relative a questi 18 ingredienti attivi. Questi 18 composti costituiscono la base materiale multicomponente di RD contro RCI.
Geni bersaglio rilevanti di RD
I database TCMSP, ETCM e SymMap sono stati ricercati per individuare geni bersaglio corrispondenti ai principi attivi della RD, raccogliendo complessivamente 327 voci di geni bersaglio originali. Dopo l'integrazione dei dati e la rimozione dei simboli genici ripetuti, sono stati ottenuti 213 geni bersaglio potenziali non ridondanti della RD per l'analisi successiva di intersezione.
Target genici rilevanti per RCI
I database Genecards e OMIM sono stati cercati utilizzando la parola chiave "lesione della cuffia dei rotatori", ottenendo 989 voci geniche grezze correlate a RCI. Dopo l'integrazione dei dati e la rimozione dei duplicati, sono stati ottenuti 870 geni patogeni umani unici strettamente correlati alla progressione di RCI.
Costruzione della rete di interazione proteina-proteina (PPI)
L'analisi di intersezione tra 213 geni bersaglio della RD e 870 geni patogeni della RCI ha identificato 71 geni sovrapposti, definiti come potenziali bersagli terapeutici della RD per il trattamento della RCI. Un diagramma di Venn che mostra la relazione di intersezione è stato generato mediante il software Venny 2.0 (Figura 2). I 71 bersagli sovrapposti sono stati importati in STRING per costruire la rete di interazione proteina-proteina (PPI) della RD nell'intervento sulla RCI (Figura 3). L'intero set di dati PPI è stato importato in Cytoscape, e cytoHubba ha selezionato i 10 geni hub principali con i punteggi MCC più elevati: TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3, HMOX1. Le informazioni topologiche relative al punteggio MCC sono riassunte in Tabella 2 e visualizzate in Figura 4. I 71 geni intersecanti rappresentano i bersagli principali che mediano l'effetto terapeutico della RD contro la RCI.
Analisi di arricchimento GO e KEGG
Per esplorare il meccanismo molecolare dei bersagli candidati di RD nel trattamento della RCI, il pacchetto clusterProfiler ha eseguito un'analisi di arricchimento GO e KEGG sui bersagli terapeutici sovrapposti. Sono state effettuate separatamente statistiche di arricchimento GO per BP, CC e MF. Figure 5A–B, 6A–B e 7A–B illustrano le 10 voci maggiormente arricchite in modo significativo per BP, CC e MF, e il sottografo B di ciascuna figura mostra la distribuzione genica di ciascun termine funzionale. È stata inoltre condotta un'analisi di arricchimento KEGG per individuare i percorsi chiave coinvolti nell'intervento di RD sulla RCI, e i 30 percorsi maggiormente arricchiti sono stati visualizzati in Figura 8.
Simulazione di docking molecolare
I primi 10 geni hub sono stati impostati come recettori proteici e tutti e 18 i principi attivi di RD sono stati utilizzati come ligandi per il calcolo del docking mediante AutoDock Vina e Open Babel. PyMOL ha visualizzato le conformazioni di legame tra ligandi e recettori. I risultati del docking hanno dimostrato che la maggior parte delle proteine bersaglio hub ha formato strutture di legame stabili con i principi attivi di RD. Tabella 3 e Figura 9 riportano i parametri completi del docking e i diagrammi tridimensionali di legame dei primi 20 complessi con affinità di legame ottimale.
Nell'attuale analisi di network-pharmacology, sono stati recuperati 18 ingredienti bioattivi di RD e 213 target non ridondanti associati al farmaco. Dopo l'intersezione con 870 geni associati a RCI, sono stati ottenuti 71 target terapeutici candidati condivisi. La costruzione della rete PPI e la selezione tramite cytoHubba-MCC hanno individuato dieci geni centrali: TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 e HMOX1. L'arricchimento GO ha riguardato BP, CC e MF, mentre l'arricchimento KEGG ha identificato molteplici vie di segnalazione arricchite. La simulazione di docking molecolare ha confermato un'affinità di legame favorevole tra i principali costituenti attivi di RD e queste proteine target centrali.
DISPONIBILITÀ DEI DATI:
Tutti i dati grezzi e processati generati in questo studio, inclusi elenchi di target, file di reti di interazione proteina-proteina (PPI), risultati di arricchimento GO e KEGG e matrice di docking molecolare, sono depositati nella Science Data Bank. Il link per l'accesso ai dati grezzi è https://www.scidb.cn/anonymous/alVOVlJu.
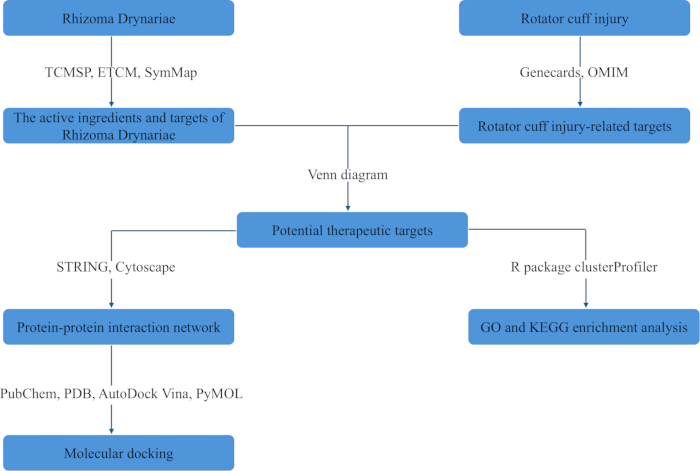
Figura 1: Schema del flusso di lavoro che illustra la pipeline bioinformatica applicata in questo studio. A partire da sinistra, i composti bioattivi candidati e i loro corrispondenti bersagli RD sono stati recuperati dai database TCMSP, ETCM e SymMap. A destra, i geni associati all'RCI sono stati recuperati da GeneCards e OMIM. I geni bersaglio comuni a questi due insiemi di dati sono stati identificati mediante un diagramma di Venn e definiti come potenziali bersagli terapeutici. I bersagli condivisi sono stati quindi elaborati in due rami separati: un ramo ha costruito una rete di interazione proteina-proteina utilizzando STRING e Cytoscape; l'altro ramo ha effettuato analisi di arricchimento GO e KEGG utilizzando il pacchetto R clusterProfiler. I geni centrali estratti dalla rete PPI sono stati ulteriormente validati mediante docking molecolare, con preparazione strutturale e simulazione completate utilizzando PubChem, PDB, AutoDock Vina e PyMOL. Abbreviazioni: RD = Rhizoma Drynariae, RCI = rotator cuff injury, TCMSP = The Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform, ETCM = The Encyclopedia of Traditional Chinese Medicine, OMIM = The Online Mendelian Inheritance in Man, GO = gene ontology, KEGG = Kyoto encyclopedia of genes and genomes. Cliccare qui per visualizzare una versione ingrandita di questa figura.
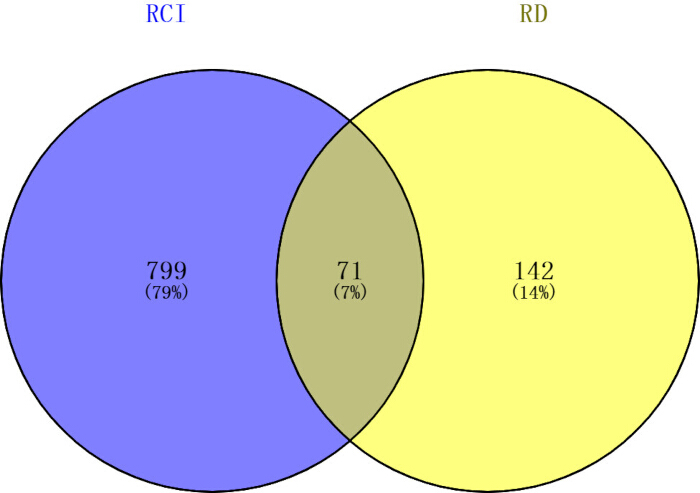
Figura 2: Diagramma di Venn degli obiettivi sovrapposti tra RD e RCI. Il cerchio blu rappresenta gli obiettivi associati a RCI. Il cerchio giallo rappresenta gli obiettivi terapeutici potenziali di RD. La regione sovrapposta di colore verde oliva indica gli obiettivi condivisi tra RD e RCI. I numeri e le percentuali all'interno di ciascuna regione indicano il numero e la proporzione di obiettivi unici o condivisi. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori. Cliccare qui per visualizzare una versione ingrandita di questa figura.
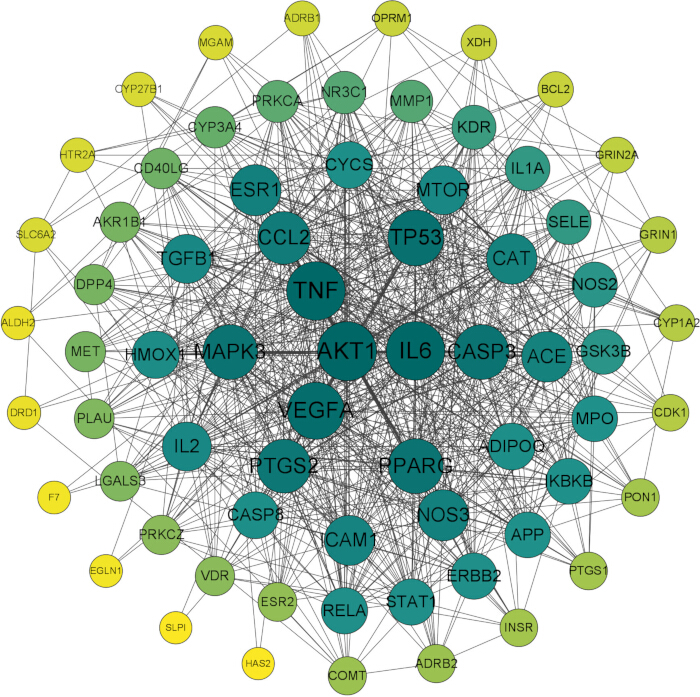
Figura 3: Rete di interazioni proteina-proteina (PPI) generata a partire dai 71 geni sovrapposti che collegano RD e RCI. Ogni cerchio nella rete rappresenta un gene bersaglio, etichettato con il suo simbolo ufficiale. Le linee che collegano due cerchi indicano associazioni proteina-proteina ricavate da database bioinformatici pubblici. La dimensione dei nodi e l'intensità del colore riflettono il significato topologico dei singoli geni all'interno della rete. I geni rappresentati da cerchi più grandi e da tonalità di verde più intense presentano punteggi topologici più elevati e occupano posizioni più centrali; cerchi più piccoli e di colore giallo pallido indicano geni con minore importanza topologica. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori, PPI = interazione proteina-proteina. Cliccare qui per visualizzare una versione ingrandita di questa figura.
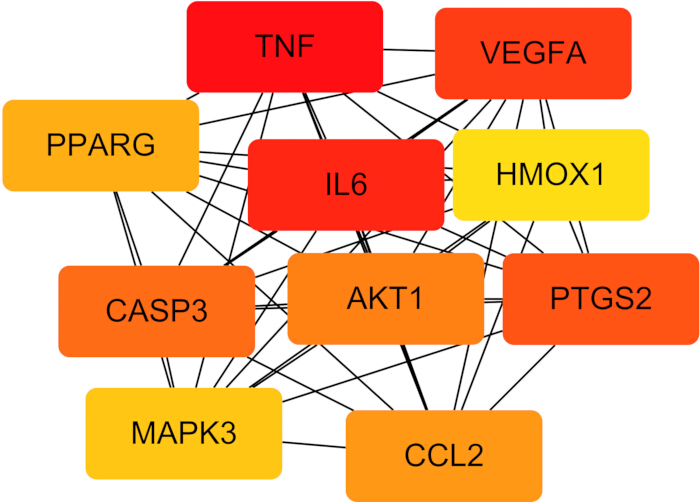
Figura 4: I 10 principali geni hub identificati dalla rete PPI utilizzando il plugin cytoHubba. I riquadri rettangolari rappresentano i geni hub, ciascuno etichettato con il relativo simbolo genico ufficiale. Le linee nere che collegano i riquadri indicano le interazioni proteiche tra questi target principali. Il gradiente di colore che va dal rosso brillante, attraverso l'arancione, fino al giallo visualizza il posizionamento dei geni hub in base ai punteggi MCC calcolati dal plugin cytoHubba; i riquadri rossi brillanti indicano i geni con i punteggi MCC più alti e la maggiore importanza nella rete, mentre i riquadri gialli indicano geni con punteggi relativamente più bassi. Abbreviazioni: PPI = interazione proteina-proteina, MCC = Centralità della Cricca Massimale.Cliccare qui per visualizzare una versione ingrandita di questa figura.
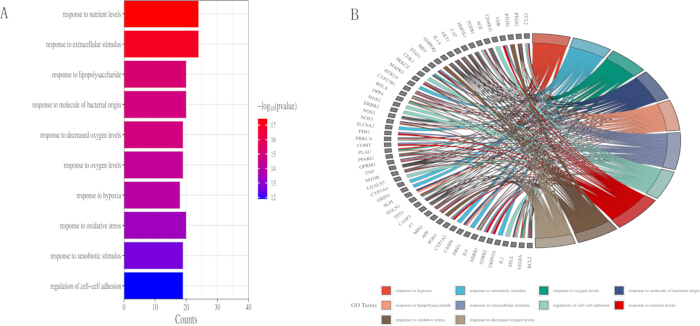
Figura 5: Analisi di arricchimento BP dei 71 geni target condivisi di RD rispetto a RCI. (A) Analisi di arricchimento GO dei potenziali target terapeutici per BP. Si tratta di un grafico a barre orizzontali che mostra i primi 10 termini del processo biologico GO significativamente arricchiti. L'asse orizzontale X rappresenta il numero di geni, corrispondente al numero di geni target annotati a ciascun termine GO. L'asse verticale Y elenca i singoli termini GO arricchiti. La barra di colore continua a destra codifica -log10(valore p); tonalità rosse più calde indicano valori più alti di -log10(valore p) e una significatività statistica maggiore, mentre tonalità viola e blu più fredde indicano una significatività inferiore. (B) Relazione tra potenziali target terapeutici e BP. Il pannello B è un diagramma a corde che illustra le associazioni a coppie tra i termini GO arricchiti e i corrispondenti geni target. I segmenti circolari esterni sono suddivisi in due categorie: blocchi colorati rappresentano distinti termini del processo biologico GO, e tacchetti rettangolari grigi indicano i simboli individuali dei geni target. Nastri curvi all'interno del cerchio collegano i termini GO ai geni target corrispondenti, con ciascun nastro che associa un gene al termine GO in cui partecipa. Il colore di ciascun nastro deriva dalla tonalità del corrispondente termine GO presente nell'anello esterno. Una legenda in basso associa ciascun colore al rispettivo termine GO. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori, BP = processo biologico, GO = ontologia genica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
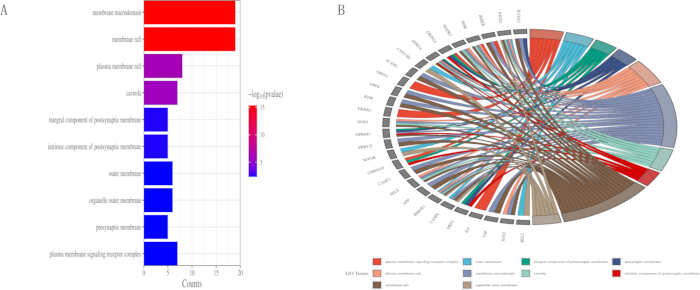
Figura 6: Termini GO-CC derivati dai 71 bersagli candidati di RD nel trattamento della RCI. (A) Analisi di arricchimento GO dei potenziali bersagli terapeutici per CC. (B) Relazione tra potenziali bersagli terapeutici e CC. Il pannello A è un grafico a barre orizzontali che mostra le prime 10 voci significativamente arricchite dell'ontologia genica per componente cellulare (GO-CC). L'asse orizzontale X quantifica il numero di geni bersaglio assegnati a ciascun termine GO, indicato come "Counts". Le descrizioni dei componenti cellulari arricchiti sono disposte lungo l'asse verticale Y. La barra colorata a destra associa le variazioni cromatiche ai valori di -log10(pvalue); il rosso brillante corrisponde a valori più alti di -log10(pvalue) e a una maggiore significatività statistica, mentre le tonalità blu indicano livelli di significatività inferiori. Il pannello B presenta un diagramma a corde che visualizza le connessioni tra i termini arricchiti del componente cellulare GO e i geni bersaglio associati. I segmenti sull'anello esterno sono suddivisi in due gruppi: i blocchi colorati rappresentano distinti termini del componente cellulare GO, mentre i trattini grigi indicano i simboli individuali dei geni bersaglio. Nastri curvi all'interno del cerchio collegano ciascun gene al relativo termine GO, assumendo ogni nastro il colore del corrispondente termine GO presente sull'anello esterno. Una legenda in basso definisce la codifica cromatica per tutte le categorie del componente cellulare GO. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori, CC = componente cellulare, GO = ontologia genica Cliccare qui per visualizzare una versione ingrandita di questa figura.
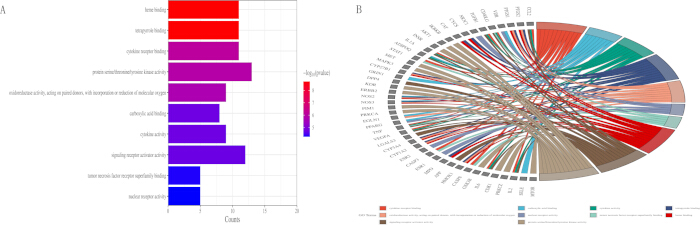
Figura 7: Analisi di arricchimento MF effettuata sui 71 geni sovrapposti bersaglio di RD per l'intervento RCI. (A) Analisi di arricchimento GO dei potenziali bersagli terapeutici per MF. (B) Relazione tra potenziali bersagli terapeutici e MF. Il pannello A è un grafico a barre orizzontali che classifica i primi 10 termini significativamente arricchiti della funzione molecolare GO. I valori sull'asse orizzontale X rappresentano il numero di geni, corrispondente al numero totale di geni bersaglio annotati per ciascuna voce di funzione molecolare. L'asse verticale Y elenca le singole descrizioni delle funzioni molecolari GO. La barra del gradiente di colore a destra traduce la variazione cromatica in metriche -log10(pvalue); il rosso brillante corrisponde a valori più alti di -log10(pvalue) e a una significatività statistica maggiore, mentre le tonalità blu indicano una significatività minore. Il pannello B è un diagramma a corde che rappresenta le relazioni tra le categorie arricchite di funzione molecolare GO e i relativi geni bersaglio. I segmenti sull'anello esterno contengono due tipi di etichette: blocchi colorati indicano distinti termini di funzione molecolare GO e piccoli trattini rettangolari grigi indicano i simboli individuali dei geni bersaglio. Nastri curvi che si estendono verso l'interno dall'anello esterno collegano ciascun gene al relativo termine funzionale, e ogni nastro eredita il colore assegnato al corrispondente termine GO. Una legenda in basso definisce la codifica cromatica per tutte le categorie di funzione molecolare GO mostrate nel grafico. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori, MF = funzione molecolare, GO = ontologia genica Cliccare qui per visualizzare una versione ingrandita di questa figura.
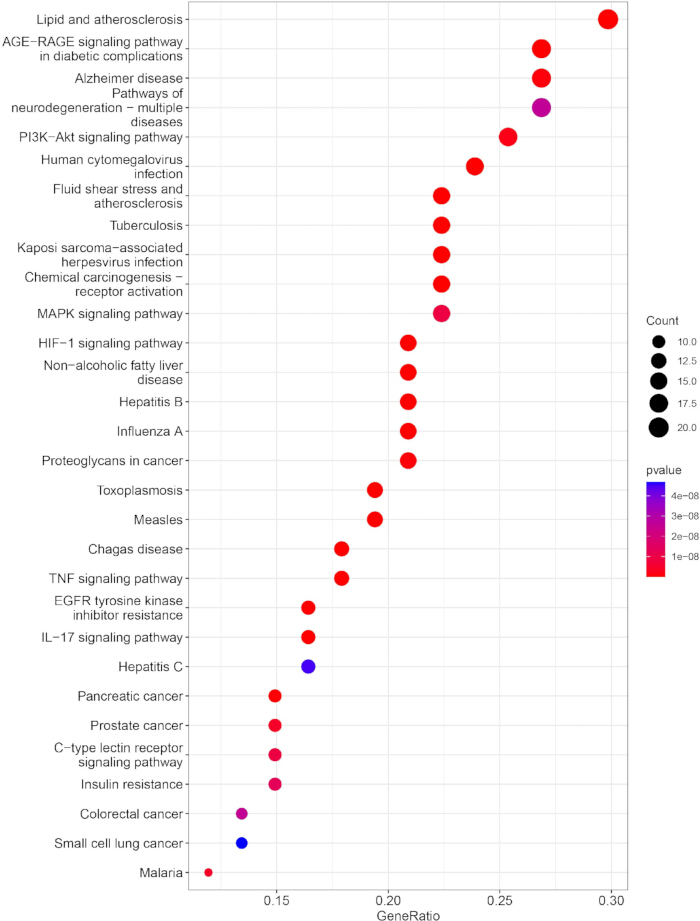
Figura 8: Analisi di arricchimento dei percorsi KEGG dei 71 geni bersaglio condivisi di RD rispetto a RCI. Questo grafico a punti visualizza i principali percorsi KEGG arricchiti. L'asse verticale Y elenca i nomi dei singoli percorsi arricchiti. L'asse orizzontale X rappresenta il GeneRatio, definito come il rapporto tra i geni bersaglio mappati su un percorso e il numero totale di geni in quel percorso. Ogni punto circolare rappresenta un percorso arricchito. La dimensione del punto corrisponde al numero di geni, con cerchi più grandi che indicano un maggior numero di geni bersaglio annotati al percorso. Il colore del punto riflette il valore p: il rosso indica valori p più bassi e una maggiore significatività statistica, mentre il blu scuro indica valori p più alti e una minore significatività statistica. Due legende laterali definiscono separatamente la scala per il conteggio dei geni e la corrispondenza dei colori per il valore p. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori, KEGG = Enciclopedia di geni e genomi di Kyoto. Cliccare qui per visualizzare una versione ingrandita di questa figura.
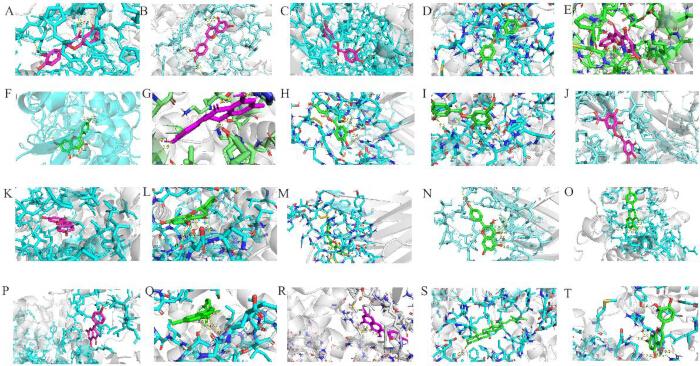
Figura 9: I complessi di docking meglio classificati. (A) (PTGS2, eriodittiofolo, -9,7 kcal/mol). (B) (PTGS2, luteolina, -9,6 kcal/mol). (C) (PTGS2, catechina, -9,5 kcal/mol). (D) (PTGS2, naringenina, -9,5 kcal/mol). (E) (PTGS2, aureusidina, -9,4 kcal/mol). (F) (PTGS2, kaempferolo, -9,2 kcal/mol). (G) (PTGS2, cromano, -9,1 kcal/mol). (H) (TNF, catechina, -9,1 kcal/mol). (I) (PTGS2, digallato, -9 kcal/mol). (J) (TNF, digallato, -9 kcal/mol). (K) (PPARG, cromano, -8,9 kcal/mol). (L) (PPARG, naringenina, -8,9 kcal/mol). (M) (TNF, aureusidina, -8,9 kcal/mol). (N) (TNF, kaempferolo, -8,8 kcal/mol). (O) (MAPK3, cromano, -8,7 kcal/mol). (P) (MAPK3, naringenina, -8,7 kcal/mol). (Q) (PPARG, aureusidina, -8,7 kcal/mol). (R) (PPARG, kaempferolo, -8,7 kcal/mol). (S) (PTGS2, 22_Stigmasten_3_one, -8,7 kcal/mol). (T) (MAPK3, luteolina, -8,6 kcal/mol). I pannelli da A a T mostrano separatamente la geometria di legame calcolata per singoli composti a basso peso molecolare all'interno della cavità di legame dei rispettivi bersagli proteici. I modelli a bastoncino in ciano rappresentano i residui amminoacidici che delimitano la cavità di legame della proteina. I ligandi a basso peso molecolare sono rappresentati con bastoncini magenta o verdi per distinguere diverse strutture chimiche. Le linee tratteggiate gialle indicano i legami a idrogeno intermolecolari tra i ligandi e i residui della tasca, con annotazioni numeriche che indicano le distanze dei legami a idrogeno in angstrom (Å). La superficie bianca traslucida delinea la topologia tridimensionale complessiva di ciascun recettore proteico. Tutti i calcoli delle conformazioni di legame sono stati eseguiti mediante docking molecolare con recettore rigido utilizzando il software AutoDock Vina. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| ID della molecola | Nome della molecola | Bio disponibilità orale (OB) (%) | Somiglianza a un farmaco (DL) |
| MOL001040 | (2R)-5,7-dihydroxy-2-(4-hydroxyphenyl)chroman-4-one | 42.36 | 0.21 |
| MOL001978 | Aureusidin | 53.42 | 0.24 |
| MOL002914 | Eriodyctiol (flavanone) | 41.35 | 0.24 |
| MOL000449 | Stigmasterol | 43.83 | 0.76 |
| MOL000358 | beta-sitosterol | 36.91 | 0.75 |
| MOL000422 | kaempferol | 41.88 | 0.24 |
| MOL004328 | naringenin | 59.29 | 0.21 |
| MOL000492 | (+)-catechin | 54.83 | 0.24 |
| MOL005190 | eriodictyol | 71.79 | 0.24 |
| MOL000569 | digallate | 61.85 | 0.26 |
| MOL000006 | luteolin | 36.16 | 0.25 |
| MOL009061 | 22-Stigmasten-3-one | 39.25 | 0.76 |
| MOL009063 | Cyclolaudenol acetate | 41.66 | 0.79 |
| MOL009075 | cycloartenone | 40.57 | 0.79 |
| MOL009076 | cyclolaudenol | 39.05 | 0.79 |
| MOL009078 | davallioside A_qt | 62.65 | 0.51 |
| MOL009087 | marioside_qt | 70.79 | 0.19 |
| MOL009091 | xanthogalenol | 41.08 | 0.32 |
Tabella 1: Profili farmacocinetici di diciotto costituenti bioattivi candidati derivati da RD. I composti sono stati recuperati dal database TCMSP e filtrati mediante due soglie relative all'ADME: OB ≥ 30% e DL ≥ 0,18. Le colonne riportano il numero di accesso TCMSP (Mol ID), il nome del composto, il valore calcolato di OB (%) e il punteggio DL per ciascun costituente selezionato. Abbreviazioni: RD = Rhizoma Drynariae, RCI = lesione della cuffia dei rotatori, ADME = assorbimento, distribuzione, metabolismo, escrezione, TCMSP = The Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform, OB = biodisponibilità orale, DL = somiglianza ai farmaci.
| Posizione | Gene | Nome | Punteggio |
| 1 | TNF | fattore di necrosi tumorale | 328291218366500 |
| 2 | IL6 | interleuchina 6 | 328291215913592 |
| 3 | VEGFA | fattore di crescita endoteliale vascolare A | 328291215896284 |
| 4 | PTGS2 | sintasi della prostaglandina-endoperossido 2 | 328288656326402 |
| 5 | CASP3 | Caspasi 3 | 328288180323600 |
| 6 | AKT1 | chinasi della serina/treonina AKT 1 | 328287745700516 |
| 7 | CCL2 | ligando 2 della chemochina con motivo C-C | 328161521686320 |
| 8 | PPARG | recettore gamma attivato da proliferatori di perossisomi | 325302724852296 |
| 9 | MAPK3 | chinasi 3 delle proteine attivate da mitogeni | 308779166166218 |
| 10 | HMOX1 | eme ossigenasi 1 | 299171945318400 |
Tabella 2: I 10 geni hub principali identificati dalla rete PPI. I geni sono stati ordinati in base ai punteggi MCC calcolati dal plugin cytoHubba all'interno di Cytoscape. MCC è una metrica topologica di cytoHubba in cui valori numerici più elevati indicano una maggiore importanza topologica all'interno della rete. Le colonne mostrano l'ordine di classificazione, il simbolo ufficiale del gene, il nome completo del gene e il corrispondente punteggio MCC grezzo per ciascun gene hub. Abbreviazioni: PPI = interazione proteina-proteina, MCC = Centralità della Cricca Massimale.
| Recettori | Ligandi | Energia libera (kcal/mol) | Numeri seriali corrispondenti nella Figura 9 |
| PTGS2 | eriodictyol | -9.7 | A |
| PTGS2 | luteolin | -9.6 | B |
| PTGS2 | catechin | -9.5 | C |
| PTGS2 | naringenin | -9.5 | D |
| PTGS2 | Aureusidin | -9.4 | E |
| PTGS2 | kaempferol | -9.2 | F |
| PTGS2 | chroman | -9.1 | G |
| TNF | catechin | -9.1 | H |
| PTGS2 | digallate | -9 | I |
| TNF | digallate | -9 | J |
| PPARG | chroman | -8.9 | K |
| PPARG | naringenin | -8.9 | L |
| TNF | Aureusidin | -8.9 | M |
| TNF | kaempferol | -8.8 | N |
| MAPK3 | chroman | -8.7 | O |
| MAPK3 | naringenin | -8.7 | P |
| PPARG | Aureusidin | -8.7 | Q |
| PPARG | kaempferol | -8.7 | R |
| PTGS2 | 22_Stigmasten_3_one | -8.7 | S |
| MAPK3 | luteolin | -8.6 | T |
Tabella 3: Risultati dell'affinità di legame ottenuti dal docking molecolare per i 20 complessi recettore-legante selezionati. Ogni riga riporta la proteina recettore, il legante di piccole dimensioni, l'energia libera di legame calcolata (kcal/mol) e l'etichetta del sottografico corrispondente nella Figura 9. Valori più negativi dell'energia libera indicano una maggiore stabilità del legame tra la tasca proteica e il composto legante. Abbreviazioni: PTGS2 = sintasi del prostaglandina-endoperossido 2, TNF = fattore di necrosi tumorale, PPARG = recettore gamma attivato da proliferatori di perossisomi, MAPK3 = chinasi mitogeno-attivata 3.
Discussione
L'RCI è un disturbo muscoloscheletrico complesso che coinvolge un'infiammazione cronica, un'eccessiva apoptosi dei tenociti, un'angiogenesi compromessa e un rimodellamento inadeguato della matrice extracellulare, i cui cambiamenti patologici combinati portano a una scarsa guarigione del tendine all'inserzione ossea e a una prognosi clinica subottimale35. Questa malattia spesso insorge a seguito di un trauma acuto o di un uso eccessivo cronico della spalla, e un'infiammazione persistente altera l'equilibrio metabolico della matrice extracellulare del tendine36. Clinicamente, i trattamenti attuali non riescono a colpire contemporaneamente più bersagli patologici, con conseguente efficacia limitata e un'elevata incidenza di recidive37. L'RD è un'erba classica della medicina tradizionale cinese che rafforza le ossa, attiva la circolazione sanguigna e promuove la riparazione dei tessuti, utilizzata da tempo in ambito clinico per il trattamento dei danni ossei e tendinei38. Tuttavia, il preciso meccanismo regolatorio molecolare dell'RD contro l'RCI non è stato analizzato sistematicamente negli studi esistenti.
Sulla base del suddetto contesto di ricerca, questo studio rivela in modo sistematico il meccanismo multicomponente, multibersaglio e multifunzionale di RD contro RCI mediante farmacologia delle reti e docking molecolare. Studi fitochimici e farmacologici precedenti hanno pienamente confermato che i flavonoidi derivati da RD possiedono significative attività biologiche anti-infiammatorie, antiossidanti, antiapoptotiche e pro-angiogeniche, che rappresentano la base materiale fondamentale per la sua funzione di riparazione tissutale39. In linea con i risultati di studi precedenti, sono state identificate un totale di 18 componenti attive provenienti da RD, tra cui l'eriodictiolo, la luteolina, la catechina, la naringenina e l'aureusidina, riconosciute come componenti centrali. Un gran numero di studi fitochimici ha dimostrato che i flavonoidi sono le principali sostanze farmacodinamiche di RD40. Questi composti a basso peso molecolare possono attraversare le barriere tissutali ed esercitare effetti regolatori complessivi sul microambiente di riparazione dei tendini danneggiati41. Le loro favorevoli proprietà ADME garantiscono un'elevata biodisponibilità (OB) e un buon profilo simile a quello di un farmaco, sostenendone il potenziale come agenti terapeutici naturali per RCI. A differenza dei farmaci sintetici chimici a bersaglio singolo, questi flavonoidi naturali possono intervenire contemporaneamente su infiammazione, danno ossidativo, sopravvivenza cellulare e angiogenesi, mostrando vantaggi unici nel trattamento delle lesioni tendinee degenerative croniche42.
Studi accumulati hanno confermato che l'insorgenza e lo sviluppo della RCI sono strettamente correlati all'espressione anomala di numerosi geni funzionali, e diversi geni chiave sono stati dimostrati partecipare ai processi patologici di infiammazione tendinea, apoptosi e rimodellamento del tessuto43. Sulla base del meccanismo genico regolatorio riconosciuto per la RCI, questo studio ha ulteriormente esplorato i bersagli terapeutici della RD. Sono stati identificati settantuno bersagli sovrapposti come potenziali bersagli terapeutici della RD contro la RCI. L'analisi della rete PPI ha selezionato 10 geni hub: TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 e HMOX1. Tra questi, TNF e IL6 sono citochine pro-infiammatorie fondamentali che innescano cascate infiammatorie, inibiscono la proliferazione dei tenociti e sopprimono la sintesi della matrice extracellulare, aggravando così il danno tendineo44. Il rilascio massiccio di queste due citochine recluta cellule immunitarie, amplifica la reazione infiammatoria e inibisce la proliferazione delle cellule staminali tendinee45. VEGFA promuove la neoangiogenesi nel sito della lesione, migliora l'apporto ematico locale e aumenta la resistenza meccanica del tessuto in fase di guarigione46. L'interfaccia tendine-osso è naturalmente povera di vasi sanguigni, e la formazione insufficiente di nuovi vasi rappresenta un fattore principale che porta a una qualità insoddisfacente della riparazione dopo la lesione47. PTGS2 media il dolore infiammatorio e la produzione di prostaglandine, mentre CASP3 è un esecutore chiave dell'apoptosi dei tenociti48,49. L'iperespressione di PTGS2 aggrava il gonfiore e il dolore infiammatori, mentre un'elevata attivazione di CASP3 induce una perdita continua di tenociti funzionali50,51. AKT1 e MAPK3 sono chinasi centrali che regolano la sopravvivenza, la proliferazione e la differenziazione cellulare, essenziali per la rigenerazione tendinea52,53. Un'attivazione moderata di queste due chinasi può mantenere la vitalità delle cellule riparative e accelerare il deposito della matrice extracellulare54. CCL2 recluta cellule infiammatorie, mentre PPARG e HMOX1 esercitano effetti antinfiammatori e antiossidanti55,56,57. Questi due geni possono alleviare lo stress ossidativo e ridurre l'infiltrazione infiammatoria eccessiva nei tessuti tendinei locali58. Nel complesso, questi geni hub formano una rete regolatoria centrale che modula infiammazione, apoptosi, angiogenesi e rimodellamento del tessuto nella RCI.
Studi patologici esistenti hanno chiarito che la progressione patologica della RCI è principalmente guidata da risposta infiammatoria, stress ossidativo, proliferazione cellulare anomala e alterata organizzazione della matrice extracellulare, che rappresentano i principali collegamenti patologici durante l'insorgenza e la riparazione della RCI59. Sulla base di ciò, nell'attuale studio è stata effettuata un'analisi di arricchimento GO per esplorare il potenziale meccanismo biologico con cui RD interviene nella RCI. Questi processi biologici corrispondono esattamente ai principali collegamenti patologici della RCI durante l'insorgenza della lesione e la sua riparazione, suggerendo che RD può agire contemporaneamente su più processi patologici60. Un gran numero di precedenti studi meccanicistici ha confermato che le vie di segnalazione del TNF, la via di segnalazione PI3K-Akt, la via di segnalazione MAPK e la via di segnalazione HIF-1 sono vie di segnalazione chiave che regolano l'infiammazione tendinea, la riparazione cellulare e la ricostruzione del tessuto61,62,63,64. Per approfondire ulteriormente il potenziale meccanismo di segnalazione di RD nel trattamento della RCI, questo studio ha condotto un'analisi di arricchimento delle vie KEGG sulla base dei suddetti risultati di ricerca. I risultati hanno rivelato che l'azione di RD contro la RCI coinvolge principalmente queste quattro vie. La via di segnalazione del TNF promuove la risposta infiammatoria e l'apoptosi dei tenociti, agendo come fattore scatenante a monte della degenerazione infiammatoria del tendine65. La via PI3K‑Akt potenzia la sopravvivenza cellulare e l'angiogenesi, processi benefici per la guarigione del tendine, e può coordinare diversi fattori di crescita per favorire la secrezione di collagene da parte dei fibroblasti66,67. La via di segnalazione MAPK regola la proliferazione cellulare, la differenziazione e la sintesi della matrice extracellulare, partecipando all'intero processo di ricostruzione tendinea68. La via di segnalazione HIF‑1 risponde all'ipossia e promuove la rigenerazione vascolare, migliorando efficacemente il microambiente ipossico dei tendini lesi69. Queste vie si influenzano reciprocamente e formano una rete regolatoria complessa, incarnando pienamente le caratteristiche multivia di RD nel trattamento della RCI.
Il docking molecolare è diventato un metodo di verifica di routine e ausiliario nella ricerca di farmacologia delle reti, in grado di caratterizzare direttamente l'attività di legame tra principi attivi e target principali. Pertanto, questo studio ha adottato il docking molecolare per verificare i risultati predittivi della farmacologia delle reti70. I risultati hanno dimostrato che i principali componenti flavonoidi del RD possono legarsi stabilmente alle cavità attive delle proteine centrali, confermando ulteriormente l'affidabilità delle previsioni ottenute mediante farmacologia delle reti. Queste modalità di legame stabili suggeriscono che il RD potrebbe agire direttamente su target chiave per esercitare effetti terapeutici. Il legame stretto tra ligandi flavonoidi e siti attivi delle proteine centrali fornisce evidenze intuitive sulle interazioni molecolari, offrendo inoltre composti candidati per successivi esperimenti di verifica funzionale cellulare.
Questo studio presenta diversi limiti. In primo luogo, le previsioni si basano su analisi bioinformatiche di database pubblici, che potrebbero introdurre un bias di annotazione verso proteine ampiamente studiate. L'espressione genica specifica del tendine della cuffia dei rotatori e le isoforme proteiche non sono state incorporate, e la rete di interazioni proteina-proteina (PPI) derivata da STRING, non diretta, non può riprodurre completamente la biologia specifica del tendine. I percorsi arricchiti, come TNF, PI3K-Akt e MAPK, rappresentano cascate infiammatorie comuni piuttosto che firme esclusive della RD. Le risorse omiche pubbliche non riescono a riprodurre i cambiamenti patologici dinamici in vivo e le differenze individuali nei tessuti umani della cuffia dei rotatori. Studi futuri potrebbero integrare dataset di sequenziamento dell'RNA a singola cellula per affinare l'interpretazione meccanicistica. In secondo luogo, lo screening dei composti ha utilizzato cutoff empirici ADME (OB ≥ 30%, DL ≥ 0.18), che potrebbero scartare composti bioattivi con bassa biodisponibilità orale. Il docking molecolare ha impiegato una configurazione con recettore rigido, ignorando la flessibilità proteica e le molecole d'acqua strutturali, senza validazione biofisica (ad esempio, SPR, ITC). Non sono stati eseguiti controlli con farmaci positivi, analisi di sensibilità, valutazione della tossicità né un completo profilo farmacocinetico. Tutti i risultati sono previsioni computazionali; esperimenti cellulari in vitro e su animali in vivo sono necessari per validare le funzioni dei percorsi bersaglio e le relazioni regolatorie tra ingredienti e geni hub. In terzo luogo, le interazioni sinergiche tra i diversi componenti della RD e il loro comportamento farmacocinetico in vivo non sono state esplorate. È necessario un lavoro sperimentale sistematico per decifrare la comunicazione tra ingredienti e i profili metabolici di questa medicina a base di erbe. Questo studio rivela in modo sistematico che la RD tratta la RCI attraverso una rete regolatoria multi-componente, multi-bersaglio e multi-percorso. La RD potrebbe esercitare effetti terapeutici inibendo l'infiammazione, riducendo l'apoptosi dei tenociti, promuovendo l'angiogenesi e potenziando la riparazione della matrice extracellulare attraverso i percorsi di segnalazione TNF, PI3K-Akt, MAPK e HIF-1. Questi risultati forniscono una solida base teorica per l'applicazione clinica e la ricerca meccanicistica della RD nella RCI.
Dichiarazioni
Gli autori dichiarano che la ricerca è stata condotta in assenza di qualsiasi relazione commerciale o finanziaria che potrebbe essere considerata un potenziale conflitto di interessi.
Ringraziamenti
Gli autori ringraziano gli sviluppatori e i responsabili delle risorse bioinformatiche pubbliche utilizzate in questo lavoro, tra cui TCMSP, ETCM, SymMap, GeneCards, OMIM, STRING, UniProt, PubChem e RCSB‑PDB. Questi database ad accesso aperto hanno fornito set di dati disponibili pubblicamente che hanno supportato le analisi computazionali descritte in questo studio. La presente ricerca non ha ricevuto finanziamenti esterni.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| AutoDock Vina | Istituto di Ricerca Scripps | V1.2.0 | Software per docking molecolare finalizzato alla simulazione del legame proteina-ligando; RRID: Non disponibile. URL: https://github.com/ccsb-scripps/AutoDock-Vina |
| clusterProfiler | Bioconductor | V3.2.14 | Pacchetto R per l'analisi di arricchimento GO e KEGG; compatibile con R 4.0.3; RRID: SCR_016884. URL: https://bioconductor.org/packages/release/bioc/html/clusterProfiler.html |
| cytoHubba | Università Nazionale di Taiwan (plugin per Cytoscape) | V0.1 | Plugin per Cytoscape per la selezione di geni hub mediante metriche topologiche; RRID: SCR_006556. URL: https://apps.cytoscape.org/apps/cytohubba |
| Cytoscape | Istituto per la Biologia dei Sistemi | V3.8.0 | Software per la visualizzazione e l'analisi di reti; RRID: SCR_003032. URL: https://cytoscape.org/ |
| ETCM (Enciclopedia della Medicina Tradizionale Cinese) | Istituto di Materiamedica Cinese, Accademia Cinese di Scienze Mediche Cinesi | V2.0 | Database curato contenente ingredienti, bersagli e formulazioni della MTC; RRID: Non disponibile. URL: http://www.tcmip.cn/ETCM2/front/#/ |
| GeneCards | Istituto Weizmann di Scienza | — | Database integrato sui geni umani con rilasci principali periodici e aggiornamenti incrementali; dati recuperati il 2025-12-15; RRID: Non disponibile. URL: https://www.genecards.org |
| Open Babel | Squadra di sviluppo di Open Babel | — | Database gene-fenotipo aggiornato quotidianamente, senza una versione globale di rilascio; dati recuperati il 2025-12-21; RRID: Non disponibile. URL: https://openbabel.org/ |
| OMIM (Ereditarietà Mendeliana Online nell'Uomo) | Università Johns Hopkins | — | Kit open source di cheminformatica per la conversione di file molecolari; dati recuperati il 2026-02-16; RRID: Non disponibile. URL: https://omim.org |
| PubChem | Centro Nazionale per l'Informatica in Biotecnologia (NCBI) | — | Database chimico pubblico continuamente aggiornato, senza un rilascio globale fisso; dati sui composti recuperati il 2026-02-10; RRID: Non disponibile. URL: https://pubchem.ncbi.nlm.nih.gov |
| PyMOL | Schrödinger, LLC | V2.5 | Software per la visualizzazione e la rappresentazione di strutture proteina-ligando; RRID: SCR_000305. URL: https://pymol.org |
| Software R | Fondazione R per il Calcolo Statistico | V4.0.3 | Ambiente per il calcolo statistico e la grafica; RRID: SCR_001905. URL: https://cran.r-project.org |
| RCSB PDB | Archivio Proteico RCSB | — | Archivio pubblico di strutture tridimensionali di proteine; ogni voce PDB ha una versione indipendente; file strutturali recuperati il 2026-02-03; RRID: SCR_012820. URL: https://www.rcsb.org |
| STRING | ELIXIR | V11.5 | Database di interazioni proteina-proteina note e predette; RRID: SCR_005223. URL: https://string-db.org |
| SymMap | Accademia Cinese di Scienze Mediche Cinesi | V2.0 | Database integrato che collega medicinali erboristici, ingredienti, bersagli e sintomi; RRID: Non disponibile. URL: http://www.symmap.org |
| TCMSP | Università Northwest A&F | V2.3 | Database di farmacologia dei sistemi della MTC contenente ingredienti, bersagli e proprietà ADME; RRID: Non disponibile. URL: https://old.tcmsp-e.com/tcmsp.php |
| UniProt | Istituto Europeo di Bioinformatica (EMBL-EBI) | — | Database completo di sequenze proteiche e annotazioni, con rilasci programmati e aggiornamenti continui; dati recuperati il 2025-12-12; RRID: SCR_002380. URL: https://www.uniprot.org |
| Venny | BioinfoGP, Centro Nazionale Spagnolo di Biotecnologia | V2.0 | Strumento basato sul web per la generazione di diagrammi di Venn e l'analisi di insiemi genici sovrapposti; RRID: SCR_016561. URL: https://bioinfogp.cnb.csic.es/tools/venny/index2.0.2.html |
Riferimenti
- Desmeules F, et al. Rotator cuff tendinopathy diagnosis, nonsurgical medical care, and rehabilitation: a clinical practice guideline. J Orthop Sports Phys Ther. 2025;55(4):235-274.
- Yoshida M, et al. Post-operative rotator cuff integrity, based on Sugaya's classification, can reflect abduction muscle strength of the shoulder. Knee Surg Sports Traumatol Arthrosc. 2018;26(1):161-168.
- Aydın A, et al. The effects of N-acetylcysteine and adipose-derived stem cells on tendon healing in chronic rotator cuff tears: a rabbit model study. BMC Musculoskelet Disord. 2025;26(1):1014.
- Bolam SM, et al. Ethnicity, sex, and socioeconomic disparities in the treatment of traumatic rotator cuff injuries in Aotearoa/New Zealand. J Shoulder Elbow Surg. 2023;32(1):121-132.
- Patel HP, Patel S, Zalin M, Agrawal DK. Calcified vs. non-calcified tendinopathy of the rotator cuff: clinical presentations, prognostic implications, and emerging therapeutic strategies. J Orthop Sports Med. 2025;7(3):379-391.
- Sewpaul Y, et al. Non-steroidal anti-inflammatory drugs and cyclooxygenase-2 inhibitors do not affect healing after rotator cuff repair: a systematic review and meta-analysis. Arthroscopy. 2024;40(3):930-940.e1.
- Hopewell S, et al. Progressive exercise compared with best practice advice, with or without corticosteroid injection, for the treatment of patients with rotator cuff disorders (GRASP): a multicentre, pragmatic, 2 × 2 factorial, randomised controlled trial. Lancet. 2021;398(10298):416-428.
- Kandikattu S, Aavula M, Pisarski T, Parvizi D, Agrawal DK. Effect of metabolic syndrome in the incidence of rotator cuff injury and recovery following surgical repair. J Surg Res (Houst). 2025;8(1):202-210.
- Longo UG, et al. Retear rates after rotator cuff surgery: a systematic review and meta-analysis. BMC Musculoskelet Disord. 2021;22(1):749.
- Siu WS, Ma H, Cheng W, Shum WT, Leung PC. Traditional Chinese medicine for topical treatment of skeletal muscle injury. Pharmaceuticals (Basel). 2023;16(8):1144.
- Jingying G, et al. A comprehensive review of Drynariae rhizoma: botany, traditional applications, and active flavonoid components. J Pharm Pharmacol. 2025;77(10):1319-1337.
- Chen GY, et al. Prediction of Rhizoma Drynariae targets in the treatment of osteoarthritis based on network pharmacology and experimental verification. Evid Based Complement Alternat Med. 2021;2021:5233462.
- Yang G, et al. Total flavonoids of Rhizoma Drynariae enhance bone marrow mesenchymal stem cell-mediated tendon-bone healing by promoting tissue regeneration, angiogenesis, and modulation of cytokine expression. Biology (Basel). 2025;14(11):1593.
- Shen J, et al. Rhizoma Drynariae-derived EV-like particles alleviate osteoporosis by promoting osteogenic differentiation in BMSCs through the activation of the hsa_circ_0001275/miR-422a pathway. Bone. 2025;196:117489.
- Cai L, et al. Hydrogel microspheres loaded with sinomenine and Drynaria rhizome enhance the treatment of rheumatoid arthritis via immune regulation and promoting bone repair. J Nanobiotechnology. 2026;24(1):174.
- Chen GY, et al. Network pharmacology analysis and experimental validation to investigate the mechanism of total flavonoids of Rhizoma Drynariae in treating rheumatoid arthritis. Drug Des Devel Ther. 2022;16:1743-1766.
- Chen GY, et al. Mechanisms of total glucosides of paeony in alleviating methotrexate-induced liver injury. Drug Des Devel Ther. 2025;19:3407-3423.
- Zhang P, et al. Network pharmacology: towards the artificial intelligence-based precision traditional Chinese medicine. Brief Bioinform. 2024;25(1):bbad518.
- Zhao L, et al. Network pharmacology, a promising approach to reveal the pharmacology mechanism of Chinese medicine formula. J Ethnopharmacol. 2023;309:116306.
- Ru J, et al. TCMSP: a database of systems pharmacology for drug discovery from herbal medicines. J Cheminform. 2014;6:13.
- Xu HY, et al. ETCM: an encyclopaedia of traditional Chinese medicine. Nucleic Acids Res. 2019;47(D1):D976-D982.
- Wu Y, et al. SymMap: an integrative database of traditional Chinese medicine enhanced by symptom mapping. Nucleic Acids Res. 2019;47(D1):D1110-D1117.
- UniProt Consortium. UniProt: the universal protein knowledgebase. Nucleic Acids Res. 2018;46(5):2699.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Amberger JS, Hamosh A. Searching Online Mendelian Inheritance in Man (OMIM): a knowledgebase of human genes and genetic phenotypes. Curr Protoc Bioinformatics. 2017;58:1.2.1-1.2.12.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-D646.
- Otasek D, Morris JH, Bouças J, Pico AR, Demchak B. Cytoscape Automation: empowering workflow-based network analysis. Genome Biol. 2019;20(1):185.
- Pitarch B, Chagoyen M, Ranea JAG, Pazos F. A review on Gene Ontology evaluations. Database (Oxford). 2025;2025:baaf058.
- Kanehisa M, Furumichi M, Sato Y, Kawashima M, Ishiguro-Watanabe M. KEGG for taxonomy-based analysis of pathways and genomes. Nucleic Acids Res. 2023;51(D1):D587-D592.
- Kim S, et al. PubChem in 2021: new data content and improved web interfaces. Nucleic Acids Res. 2021;49(D1):D1388-D1395.
- Burley SK, et al. RCSB Protein Data Bank: celebrating 50 years of the PDB with new tools for understanding and visualizing biological macromolecules in 3D. Protein Sci. 2022;31(1):187-208.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891-3898.
- Li QR, Han YX, Bian YT, Lan MQ, Chen GY. Unveiling the mechanism of Cibotium barometz in the treatment of rheumatoid arthritis: a study based on network pharmacology and experimental validation. Curr Med Chem. 2026. Online ahead of print.
- Seeliger D, de Groot BL. Ligand docking and binding site analysis with PyMOL and Autodock/Vina. J Comput Aided Mol Des. 2010;24(5):417-422.
- Wang Y, Xu B, Ma C, Huang D, Zhou L. Association between inflammatory proteins and rotator cuff tears: a bidirectional Mendelian randomization study. Sci Rep. 2025;15(1):26987.
- Wang KC, et al. The influence of age on cellular senescence in injured versus healthy muscle and its implications on rotator cuff injuries. J Shoulder Elbow Surg. 2025;34(6 Suppl):S117-S126.
- Wellington IJ, et al. Management of failed rotator cuff repairs: a review. Orthop Clin North Am. 2022;53(4):473-482.
- Han L, Wang C, Wang T, Hu Y, Wang H. Total flavonoids of Rhizoma Drynariae improves tendon-bone healing for anterior cruciate ligament reconstruction in mice and promotes the osteogenic differentiation of bone mesenchymal stem cells by the ERR1/2-Gga1-TGF-β/MAPK pathway. Environ Toxicol. 2024;39(1):106-119.
- Chai S, et al. Luteolin rescues postmenopausal osteoporosis elicited by OVX through alleviating osteoblast pyroptosis via activating PI3K-AKT signaling. Phytomedicine. 2024;128:155516.
- Li W, et al. Effects of total flavonoids of Rhizoma Drynariae on biochemical indicators of bone metabolism: a systematic review and meta-analysis. Front Pharmacol. 2024;15:1443235.
- Wang Z, Cao L, Wang X. Total flavonoids of Rhizoma Drynariae ameliorate tendon-bone healing following anterior cruciate ligament reconstruction in rats by activating the FSP1/CoQ10 pathway to inhibit osteoblast mitochondrial dysfunction and ferroptosis. Appl Biochem Biotechnol. 2026;198(8):5916-5938.
- Kim JG, et al. Therapeutic potential of quercetin as an antioxidant for bone-muscle-tendon regeneration and aging. Aging Dis. 2024;16(3):1414-1437.
- Worsfold SI, et al. Rotator cuff tendinopathy: pathways of apoptosis. Sports Med Arthrosc Rev. 2024;32(1):12-16.
- Chen L, et al. AMPK signaling in osteoarthritis: from mechanisms to targeted therapeutics. Front Pharmacol. 2025;16:1681610.
- Li Y, et al. Leptin enhances M1 macrophage polarization and impairs tendon-bone healing in rotator cuff repair: a rat model. Clin Orthop Relat Res. 2025;483(5):939-951.
- Yang Y, et al. Celastrol suppresses neovascularization in rat aortic vascular endothelial cells stimulated by inflammatory tenocytes via modulating the NLRP3 pathway. Open Med (Wars). 2025;20(1):20241121.
- Li Y, et al. Prevascularized bone marrow-derived mesenchymal stem cell sheets promote tendon-bone integration in rotator cuff repair. J Bone Joint Surg Am. 2026;108(17):1389-1398.
- Zhao MJ, et al. Eupatorin as a promising natural compound against knee osteoarthritis: from network pharmacology to experimental validation. Front Biosci (Landmark Ed). 2025;30(12):46747.
- Cho W, et al. Valdecoxib ameliorates apoptosis and ferroptosis in tenocytes via the SIRT6/NRF2-mediated suppression of oxidative stress. Arch Med Res. 2025;56(6):103231.
- Cheng Y, et al. Amentoflavone alleviated cartilage injury and inflammatory response of knee osteoarthritis through PTGS2. Naunyn Schmiedebergs Arch Pharmacol. 2024;397(11):8903-8916.
- Cho W, et al. Therapeutic potential of ginsenoside compound K in managing tenocyte apoptosis and extracellular matrix damage in diabetic tendinopathy. Tissue Cell. 2024;86:102275.
- Cheng P, et al. High-purity magnesium screws modulate macrophage polarization during the tendon-bone healing process in the anterior cruciate ligament reconstruction rabbit model. Regen Biomater. 2022;9:rbac067.
- Zhou L, et al. Regorafenib attenuates osteoclasts differentiation by inhibiting the NF-κB, NFAT, ERK, and p38 signaling pathways. ACS Omega. 2024;9(31):33574-33593.
- Cho MH, Jin H, Ha J, Chu S, An S. An integrated systems pharmacology approach combining bioinformatics, untargeted metabolomics and molecular dynamics to unveil the anti-aging mechanisms of Tephroseris flammea. Biomolecules. 2025;15(12):1740.
- Wang L, et al. IL-33/ST2 drives inflammatory pain via CCL2 signaling and activation of TRPV1 and TRPM8. Commun Biol. 2025;8(1):724.
- Zhang P, Xu X, Wang H, Zhang Y. Anti-inflammatory activity and potential anti-inflammatory mechanisms of Artemisia scoparia essential oil. J Pharm Pharmacol. 2026;78(2):rgag004.
- Wang Z, et al. Engineered mesenchymal stem cells with endogenous trehalose expression activate the NRF2-HMOX1 pathway to enhance antioxidant stress and wound healing capacity. Adv Wound Care (New Rochelle). 2026. Online ahead of print.
- Lu Y, et al. Dual-PPARα/δ agonist H11 alleviates tendinopathy via modulating the Nrf2/HO-1/GPX4 pathway. Free Radic Biol Med. 2026;242:333-344.
- Chung SW, Yoon JP, Park SJ. Inhibiting muscle degeneration in rotator cuff tears: integrative biologic approaches targeting regeneration, fibrosis, and metabolism. Stem Cells Transl Med. 2026;15(6):szag023.
- Feuerriegel GC, et al. Assessment of the rotator cuff muscles: state-of-the-art MRI and clinical implications. Radiology. 2025;315(2):e242131.
- He Y, et al. SHED-derived exosome-mimetics promotes rotator cuff tendon-bone healing via macrophage immunomodulation through NF-κB suppression and autophagy activation. Mater Today Bio. 2025;34:102146.
- Zhang Z, et al. Curcumin improves functional recovery of ruptured tendon by promoting tenogenesis via PI3K/Akt signaling. Stem Cells Transl Med. 2024;13(5):477-489.
- Chen C, et al. CTHRC1 attenuates tendinopathy via enhancing EGFR/MAPK signaling pathway. Adv Sci (Weinh). 2024;11(47):e2406611.
- Zulkifli A, et al. The potential mechanism of hypoxia-induced tenogenic differentiation of mesenchymal stem cell for tendon regeneration. Tissue Cell. 2023;82:102075.
- Xiang L, Deng H, Zhou S. Effects of TNF-α on behaviour and inflammation in rats with rotator cuff injury through NGF. Discov Med. 2024;36(185):1241-1249.
- Liu H, et al. RNA-sequencing-based elucidation of the mechanism underlying aFGF mediated regulation of BMSCs via the PI3K-AKT pathway and its implications for rotator cuff injury repair. J Orthop Surg Res. 2025;20(1):997.
- Chen GY, et al. Total flavonoids of Rhizoma Drynariae restore the MMP/TIMP balance in models of osteoarthritis by inhibiting the activation of the NF-κB and PI3K/AKT pathways. Evid Based Complement Alternat Med. 2021;2021:6634837.
- Wang Y, Gu X, Tu J, Xu B. MCP-1 exacerbates diabetic rotator cuff tear by driving synovial inflammation via MAPK/ERK-mediated macrophage polarization. J Shoulder Elbow Surg. 2026. Online ahead of print.
- Lin J, et al. Hypobaric hypoxia ameliorates impaired regeneration after diabetic skeletal muscle injury by promoting HIF-1α signaling. Int J Mol Sci. 2026;27(2):648.
- Tian M, Wang K, Chen D. Efficacy and mechanisms of Xiangsha Liujunzi Decoction for gastroesophageal reflux disease: a study integrating meta-analysis, network pharmacology and molecular docking. Phytomedicine. 2026;151:157766.