Questo protocollo integra la de-identificazione, la normalizzazione della terminologia, la verifica delle fonti e la visualizzazione riproducibile per generare output aggregati e verificabili a partire da registrazioni ambulatoriali reali di medicina tradizionale cinese.
Articolo metodologico
Estrazione e visualizzazione validate da fonti di registri di casi reali di Medicina Tradizionale Cinese utilizzando la formula Hegan Jianpi
* These authors contributed equally
In questo articolo
Sommario
Abstract
I referti ambulatoriali reali della medicina tradizionale cinese (TCM) contengono informazioni longitudinali su diagnosi, elementi del sindrome, descrizioni dei sintomi e prescrizioni personalizzate, ma il loro formato semi-strutturato complica l'analisi riproducibile. Questo articolo presenta un protocollo verificato alla fonte per convertire referti di casi anonimizzati in tabelle aggregate tracciabili e visualizzazioni pronte per la pubblicazione. Il flusso di lavoro definisce criteri di idoneità e unità di analisi, conserva le corrispondenze tra terminologia originale e normalizzata, verifica tutti i numeratori e denominatori riportati e rigenera le figure a partire da tabelle sorgenti con versione controllata. Applicato ai referti dal gennaio 2015 al giugno 2024, il protocollo ha identificato 555 visite con prescrizioni idonee provenienti da 396 pazienti. Il set di dati finale conteneva 324 etichette normalizzate di erbe e 9.339 occorrenze di utilizzo di erbe. Il flusso di lavoro ha generato spettri paralleli di malattie della medicina occidentale e della TCM, uno spettro esplicito di elementi del sindrome e una matrice di co-occorrenza, profili di frequenza delle erbe e della materia medica, uno spettro di sintomi derivato dalla storia clinica composto da 37 termini, 15 regole di associazione dirette, clustering gerarchico e heatmap dell'uso delle erbe stratificate per diagnosi. In almeno una visita su 474 (85,41%) è stata rilevata la presenza di almeno una parola chiave prespecificata della storia clinica. Quando consentito dalle politiche istituzionali, un'opzione di intelligenza artificiale (AI) supervisionata dall'uomo può assistere nei controlli terminologici, nella revisione della coerenza tra file e nell'allineamento tra didascalie e figure. Qualsiasi utilizzo dell'AI deve essere documentato in un registro di audit separato e non deve sostituire la revisione dei dati originali. Integrando governance, normalizzazione, calcolo, interpretazione clinica e output visivi in un unico flusso di lavoro riproducibile, il metodo trasforma la documentazione clinica dispersa in una risorsa di ricerca esaminabile. Il protocollo può essere adattato ad altri dataset di pratica esperta, progetti multicentrici di terminologia e piattaforme di dati clinici prospettici.
Introduzione
I referti ambulatoriali reali della medicina tradizionale cinese (TCM) conservano il ragionamento clinico longitudinale attraverso sintomi descritti in forma narrativa, sistemi diagnostici paralleli, descrizioni di sindromi e prescrizioni individualizzate. I primi studi sullo scoprimento di conoscenze hanno riconosciuto i referti clinici come dati esperienziali complessi, che richiedono metodi informatici dedicati prima che i loro schemi possano essere studiati in modo affidabile1. Ricerche successive hanno mostrato che espressioni sintomatiche sinonimiche, entità ad alta granularità e termini diagnostici documentati localmente devono essere normalizzati senza cancellare la formulazione originale2,3,4,5,6. I dati dei record sanitari elettronici (EHR) possono inoltre supportare la ricerca computazionale sulle prescrizioni e l'uso di strumenti analitici riutilizzabili, a condizione che il contesto clinico e la provenienza dei dati rimangano visibili7,8. Sono quindi necessari riferimenti autorevoli sulla materia medica per standardizzare i nomi delle erbe, le forme di preparazione, le proprietà, i sapori e le assegnazioni ai meridiani9,10. A livello di reportistica, le linee guida RECORD e STROBE richiedono descrizioni trasparenti delle fonti dati, delle regole di idoneità, delle variabili e delle decisioni analitiche, mentre i principi FAIR enfatizzano oggetti di ricerca tracciabili e riutilizzabili11,12,13. Queste considerazioni sono particolarmente importanti quando i referti contengono visite ripetute, campi mancanti, terminologia sovrapposta e testo libero. La valutazione dell'idoneità d'uso deve affrontare completezza, conformità, plausibilità e accordo tra le fonti14,15. Anche la de-identificazione del testo libero richiede procedure esplicite e revisione umana, poiché i metodi automatizzati possono preservare contenuti clinici utili lasciando comunque rischi residui per la privacy16,17,18.
Una volta stabiliti governance e terminologia, il profiling della frequenza, il data mining basato sulle regole di associazione e il clustering gerarchico possono fornire visioni complementari della struttura delle prescrizioni19,20,21. I metodi di analisi delle reti e della scienza-mapping dimostrano ulteriormente come rappresentazioni visive coordinate possano rivelare relazioni che una singola lista ordinata non è in grado di cogliere22,23,24,25. Studi recenti sull'artrite reumatoide associata a depressione, sugli inibitori della Janus chinasi nella colite ulcerosa e sull'artrite reumatoide con fibromialgia illustrano il valore di criteri di recupero dati bloccati per versione, reti di co-occorrenza, clustering, interpretazione temporale e dichiarazioni esplicite sui limiti analitici26,27,28. Il presente studio adatta questi principi progettuali trasferibili all'analisi dei dati clinici piuttosto che alla bibliometria letteraria. Nei documenti originali, Hegan Jianpi Formula indica una formula basata sull'esperienza clinica del Professor Nai-li Yao29,30. Pubblicazioni correlate descrivono il suo approccio clinico più ampio volto all'armonizzazione fegato-milza e milza-stomaco29,30. In questo articolo metodologico, il nome della formula identifica esclusivamente il contesto del documento d'origine e non stabilisce una composizione fissa, una dose, un'indicazione terapeutica o un'affermazione sull'efficacia. Il flusso di lavoro computazionale utilizza regole deterministiche e metodi statistici generali. Una pratica computazionale riproducibile richiede inoltre la conservazione degli input, la documentazione dei parametri, trasformazioni automatizzate tramite script e output soggetti a revisione31,32. Un'opzione di intelligenza artificiale (AI) supervisionata da un operatore umano può assistere nei controlli terminologici, nelle revisioni di coerenza tra file e nel controllo visivo della qualità, purché l'utilizzo sia documentato. L'esperienza clinica, le misure di protezione della privacy e decisioni umane responsabili devono rimanere prioritari (Tabella Supplementare 1)33,34. L'obiettivo generale di questo metodo è trasformare documenti clinici TCM anonimizzati in una catena verificabile di output stratificati per malattia, sindrome, sintomo, uso di erbe, associazioni, clustering e diagnosi. L'esempio illustrato utilizza 555 visite con prescrizioni idonee provenienti da 396 pazienti per dimostrare come governance, normalizzazione, calcolo, interpretazione clinica e pubblicazione visiva possano essere integrati senza divulgare dati a livello individuale, dettagli esatti delle formulazioni, rapporti tra dosi o istruzioni prescrittive.
Protocollo
Questa analisi retrospettiva di record clinici anonimizzati è stata esaminata e approvata dal Comitato Etico Medico dell'Ospedale Guang'anmen, Accademia Cinese di Scienze Mediche Cinesi (numero di approvazione 2026-108-KY; 13 luglio 2026). Il Comitato ha esonerato l'obbligo del consenso informato.
1. Stabilire etica, governance e sicurezza dei dati
- Assegnare un responsabile dei dati, un analista dei dati di origine, un revisore della terminologia clinica, un revisore quantitativo e un ricercatore autorizzato a approvare la divulgazione aggregata. Registrare ciascun ruolo nel registro del progetto.
- Preparare un piano di gestione dei dati che specifichi il sistema sorgente consentito, il periodo dello studio, i campi, la posizione di archiviazione, le autorizzazioni di accesso, la procedura di backup, il periodo di conservazione e le restrizioni relative alle chiavi di collegamento.
- Esportare solo le variabili minime necessarie per l'analisi predeterminata. Includere un identificatore locale del paziente, la data della visita, l'età o la data di nascita quando consentito, il sesso, la diagnosi occidentale, il nome della malattia secondo la medicina tradizionale cinese (TCM), il testo della storia clinica anonimizzato, la descrizione della lingua, la descrizione del polso, la descrizione del quadro sindromico e i campi relativi alla prescrizione delle erbe.
- Rimuovere nomi, numeri di identificazione nazionali, numeri di telefono, indirizzi dettagliati, identificatori assicurativi, informazioni di contatto e altri identificatori diretti all'interno dell'ambiente istituzionale controllato. Sostituire ogni numero di cartella clinica con un identificatore del paziente specifico per il progetto.
- Analizzare i campi di testo libero alla ricerca di identificatori residui e oscurare ogni elemento rilevato. Archiviare qualsiasi chiave di collegamento separatamente dal dataset analitico ed escluderla dalle cartelle di lavoro, collaborazione e invio.
- Conservare l'esportazione iniziale anonimizzata come una copia statica di sola lettura. Registrare nel manifesto della fonte il nome del file, la data di creazione, il numero di righe, il numero di colonne, la dimensione del file e il checksum.
- Creare directory separate per i file sorgente, i file di lavoro, i dizionari, le tabelle aggregate, le figure, gli script e i registri di controllo.
- Limitare i materiali divulgati o condivisi a tabelle aggregate, dizionari anonimizzati approvati, script e figure pubblicabili. Non caricare record identificabili o potenzialmente ridentificabili su sistemi pubblici di intelligenza artificiale generativa, servizi cloud non approvati o repository pubblici.
NOTA: Quando la politica istituzionale consente l'uso di sistemi di intelligenza artificiale con supervisione umana, fornire esclusivamente estratti di testo anonimizzati o tabelle aggregate. Registrare nello storico di controllo lo scopo, l'output revisionato, la correzione accettata, il revisore e la data.
2. Definire la regola di identificazione dei record e le unità di analisi
- Definire l'istituzione, l'ambiente ambulatoriale, il team clinico responsabile, il sistema di cartella clinica elettronica e il periodo di riferimento prima della selezione. Per l'esempio illustrato, utilizzare i dati compresi tra gennaio 2015 e giugno 2024.
- Archiviare la regola di identificazione del coorte in un file protetto e sottoposto a controllo delle versioni prima di esaminare i risultati analitici. Registrare le varianti terminologiche accettate e tutte le condizioni di inclusione ed esclusione senza rivelare dettagli confidenziali sulla formulazione nel manoscritto.
- Applicare la regola di identificazione dei record bloccata per versione a livello di visita-prescrizione dopo la normalizzazione dei nomi delle erbe. Definire definitivamente i file sorgente, i dizionari, la regola del coorte e i parametri di analisi come un unico insieme rilasciato.
- Creare una nuova versione e rigenerare tutti gli output dipendenti ogni volta che un componente bloccato per versione viene modificato. Non modificare la regola di identificazione del coorte dopo aver esaminato le distribuzioni delle malattie, le frequenze delle erbe, le regole di associazione o i raggruppamenti.
- Includere una visita ambulatoriale quando ricade nel periodo di studio bloccato per versione, corrisponde a un identificatore paziente valido del progetto, contiene un record di prescrizione interpretabile e soddisfa la regola ristretta di identificazione dei record.
- Escludere esportazioni esattamente duplicate, record al di fuori del periodo di studio, record privi di una prescrizione interpretabile e righe che non soddisfano la regola di identificazione bloccata per versione. Assegnare una motivazione principale di esclusione a ciascuna riga esclusa.
- Distinguere le esportazioni ripetute dalle visite di follow-up effettive. Rimuovere soltanto i duplicati esatti del sistema o dell'esportazione e mantenere le visite ripetute effettive.
- Assegnare identificatori stabili per paziente e per visita-prescrizione. Creare un elenco del coorte contenente la versione della fonte, la versione della regola, lo stato di selezione, la motivazione di inclusione o esclusione, l'identificatore del paziente, l'identificatore della visita e lo stato del revisore.
- Utilizzare un solo record per ogni paziente unico per i riepiloghi demografici fissi, inclusi età e sesso. Utilizzare la visita-prescrizione come unità di analisi per le analisi relative a malattia, sindrome, parole chiave della storia clinica, lingua, polso, erbe, regole di associazione e raggruppamenti.
- Separare l'idoneità del coorte dalla disponibilità delle variabili. Mantenere una visita altrimenti idonea quando un campo specifico della variabile è mancante e riportare il denominatore valutabile per ciascuna analisi.
- Bloccare l'elenco del coorte prima dell'analisi descrittiva. Registrare il numero di visite-prescrizione idonee e di pazienti unici, e rigenerare tutti gli output dipendenti se una decisione relativa all'idoneità cambia.
3. Normalizzare la terminologia e preservare la traccia di controllo
- Crea dizionari separati con controllo delle versioni per erbe, diagnosi occidentali, nomi di malattie della MTC, elementi del sindrome, parole chiave della storia clinica, termini della lingua, termini del polso e attributi della materia medica.
- Includi in ciascun dizionario il termine originale, il termine normalizzato, la categoria del termine, il campo di origine, la regola, la fonte di riferimento, la versione del dizionario, il revisore, la data di revisione e i commenti. Mantieni ogni termine originale dopo la normalizzazione.
- Normalizza i nomi dei materiali medicinali cinesi (CMM) utilizzando riferimenti autorevoli di nomenclatura9,10. Correggi le varianti tipografiche e le abbreviazioni del sistema, preservando al contempo le forme di preparazione clinicamente significative.
- Mantieni i qualificatori di preparazione, inclusi stir-fried, vinegar-processed, honey-fried, ginger-processed, wine-processed, charred e raw, come etichette distinte.
- Mantieni separate le erbe ortograficamente o clinicamente distinte. Non unire Bai Shao con Bai Zhu né dedurre un'erba da un'abbreviazione ambigua senza revisione della fonte.
- Mantieni il dosaggio originale e l'unità in campi separati quando disponibili. Rimuovi il testo del dosaggio solo quando si costruiscono variabili di presenza dell'erba a livello di visita.
- Non interpretare la frequenza di occorrenza come dose cumulativa o intensità del trattamento.
- Normalizza i nomi delle malattie occidentali e della MTC in modo indipendente. Preserva il sistema diagnostico e lo stato di diagnosi principale, e non tradurre un'etichetta di malattia della MTC in una diagnosi occidentale a meno che entrambe non siano esplicitamente registrate.
- Definisci un'etichetta di malattia della MTC traslitterata al primo utilizzo, quando necessario per orientare il lettore. Mantieni l'etichetta originale della fonte.
- Suddividi il testo esplicito del sindrome multivalore utilizzando delimitatori bloccati per versione e mappa le espressioni della fonte sugli elementi del sindrome normalizzati. Elimina i duplicati di ciascun elemento normalizzato all'interno di una visita.
- Mantieni il testo esplicito del sindrome separato dalle colonne di indicatori ereditate o derivate da punteggi.
- Mantieni i campi originali della lingua, del polso, dei sintomi strutturati e della storia clinica anonimizzata come prodotti dati distinti. Non considerare la corrispondenza con una parola chiave della storia clinica equivalente a un sintomo strutturato inserito dal clinico.
- Chiedi a un revisore di proporre ogni mappatura ambigua o molti-a-uno e fai verificare la mappatura da un secondo revisore clinico. Escludi le mappature incerte dalle analisi pubblicate finché una revisione della fonte non le risolve.
- Verifica la presenza di etichette normalizzate vuote, mappature uno-a-molti, mappature molti-a-uno, voci duplicate nel dizionario, termini non revisionati e perdite accidentali di etichette di preparazione. Blocca le versioni dei dizionari prima di generare tabelle aggregate.
4. Verificare i campi sorgente e bloccare gli output segnalabili
- Creare un registro delle evidenze con una riga per ogni affermazione del manoscritto, tabella e pannello di figura. Registrare l'unità di analisi, il campo sorgente, la versione della sorgente, la versione del dizionario, la versione dello script, il numeratore, il denominatore, il file di output, il revisore e la formulazione approvata.
- Ricalcolare direttamente dai file bloccati per versione i conteggi di visite idonee e di pazienti unici, i riassunti demografici, i conteggi di malattie, i conteggi di sindromi esplicite, i conteggi di parole chiave anamnestici, le frequenze di erbe unite e i totali di utilizzo delle erbe.
- Confrontare ogni valore ricalcolato con il valore corrispondente nel manoscritto, nel foglio di calcolo o nella figura. Correggere il manoscritto e rigenerare gli output dipendenti ogni volta che viene confermata una discrepanza.
- Risolvere ogni discrepanza a livello di campo sorgente. Registrare nel registro delle evidenze il motivo, la correzione, il revisore e la data prima di rilasciare il risultato interessato.
- Verificare che ogni tabella aggregata contenga l'etichetta normalizzata, il numeratore, il denominatore, la definizione della percentuale, l'unità di analisi e l'identificativo della sorgente necessari per riprodurre l'affermazione corrispondente.
- Verificare il denominatore utilizzato per ogni percentuale. Utilizzare i pazienti unici per caratteristiche demografiche fisse e le visite per prescrizione per variabili cliniche e prescrittive dinamiche.
- Confrontare etichette, valori, ordine e definizioni dei pannelli delle figure con le rispettive tabelle aggregate bloccate per versione. Rigenerare ogni figura dopo una correzione della tabella, anziché modificare manualmente i valori tracciati.
- Chiedere a un revisore clinico di verificare i mappature terminologiche. Chiedere a un revisore quantitativo di verificare conteggi, tassi, metriche delle regole e denominatori delle mappe termiche.
- Bloccare il registro delle evidenze, le tabelle aggregate e le sorgenti delle figure sotto un unico identificativo di versione prima dell'assemblaggio del manoscritto.
5. Generare spettri descrittivi e output di co-occorrenza
- Generare riepiloghi a livello paziente per età e sesso a partire da una riga per ogni paziente unico. Mantenere e riportare esplicitamente le categorie sconosciute.
- Generare separatamente gli spettri delle malattie occidentali e della medicina tradizionale cinese a livello di prescrizione-visita. Preservare il sistema diagnostico originale e calcolare le etichette normalizzate principali utilizzando un denominatore comune di visite.
- Generare lo spettro degli elementi-sindrome a partire dal campo testuale della sindrome normalizzata. Suddividere i termini utilizzando delimitatori bloccati alla versione, eliminare i duplicati di ciascun termine all'interno di una visita e calcolare le frequenze a livello di visita.
- Costruire la matrice di co-occorrenza delle sindromi a partire dagli stessi insiemi di token all'interno della visita. Codificare la dimensione dei nodi in base alla frequenza di visita e lo spessore dei collegamenti o l'intensità della mappa termica in base al conteggio di co-occorrenza a coppie.
- Predisporre in anticipo un dizionario esatto di parole chiave anamnestiche quando le informazioni sui sintomi sono principalmente narrative. Analizzare esclusivamente il campo anamnesi depersonalizzato e conteggiare ogni concetto non più di una volta all'interno di una visita.
- Calcolare la proporzione di visite idonee contenenti almeno una parola chiave anamnestica e ordinare tutti i conteggi delle parole chiave. Esportare l'intera tabella e il sottoinsieme rappresentato graficamente.
- Generare le frequenze delle erbe combinate a partire dai dati di prescrizione normalizzati. Contare ogni etichetta di erba normalizzata non più di una volta per visita e mantenere le forme di preparazione clinicamente rilevanti come etichette distinte.
- Generare i profili dei Quattro Qi, dei cinque sapori e dell'affinità per i meridiani a partire dal dizionario di materiale medico bloccato alla versione. Trattare i Quattro Qi come una categoria a valore singolo per ogni occorrenza di erba codificata per proprietà.
- Trattare i cinque sapori e l'affinità per i meridiani come attributi multi-etichetta. Indicare il denominatore codificato per proprietà e preservare l'unità di analisi distinta.
- Esportare una tabella aggregata in formato leggibile da macchina per ciascun dominio descrittivo prima di generare le figure finali.
6. Eseguire analisi basate su regole di associazione e analisi gerarchiche di clustering
- Costruire una matrice binaria prescrizione-visita-per-erba a partire dalla tabella normalizzata delle prescrizioni con versione bloccata. Utilizzare una riga per ogni visita idonea e una colonna per ogni etichetta normalizzata di erba.
- Calcolare supporto, confidenza e lift per regole associative dirette a singola erba19. Mantenere la direzione di ciascuna regola poiché la confidenza dipende dall'antecedente.
- Applicare le soglie prefissate di supporto ≥ 0,30, confidenza ≥ 0,70 e lift > 1,0. Esportare ogni regola mantenuta con il relativo conteggio di co-occorrenza e tutte e tre le metriche.
- Rappresentare l'intero insieme di regole mantenute come una rete bipartita diretta di regole e un profilo ordinato di forza delle regole. Codificare la larghezza degli archi della rete in base al supporto e il colore degli archi in base al lift.
- Codificare la dimensione dei punti in base al supporto e annotare la confidenza nel profilo ordinato.
- Verificare che entrambe le rappresentazioni delle regole contengano lo stesso insieme di regole mantenute e preservino la direzione delle regole. Correggere ogni discrepanza confrontandola con la tabella delle regole esportata prima della pubblicazione.
- Selezionare le 20 variabili di presenza di erbe con frequenza più elevata per il clustering gerarchico. Calcolare le distanze di Jaccard a coppie e applicare il collegamento medio (average linkage).
- Etichettare il dendrogramma con i nomi normalizzati delle erbe. Interpretare la vicinanza dei rami soltanto come somiglianza nei modelli di occorrenza a livello di visita.
- Esportare la specifica della matrice binaria, la tabella delle regole, l'elenco degli archi della rete, l'ordine di input per il clustering, la matrice delle distanze e la matrice di collegamento prima della generazione delle figure.
- Chiedere a un revisore quantitativo di riprodurre manualmente una metrica di regola. Confrontare ogni arco della rete con la tabella delle regole.
- Rieseguire l'intero flusso di lavoro per le regole e il clustering ogni volta che cambia il coorte, il dizionario terminologico o la matrice di presenza delle erbe.
- Per l'esempio illustrato, eseguire un'analisi di sensibilità deterministica con una visita per paziente mantenendo il record con l'ordine cronologico più precoce per ciascun paziente. Confrontare le 12 regole risultanti con le 15 regole ottenute dall'analisi a livello di visita.
- Segnalare la variazione come risultato descrittivo di robustezza piuttosto che come validazione a livello di paziente. Utilizzare il ricalcolo deterministico fornito in Supplementary File 1.
7. Generare modelli stratificati in base alla diagnosi e il quadro interpretativo clinico
- Selezionare prima le stratificazioni principali di diagnosi occidentale clinicamente rilevanti prima di esaminare le distribuzioni delle erbe specifiche per diagnosi.
- Contare ogni etichetta normalizzata di erba al massimo una volta per visita all'interno di ciascuno strato diagnostico. Calcolare la prevalenza come numero di visite contenenti l'etichetta diviso per il numero totale di visite idonee in quello strato.
- Utilizzare lo stesso insieme di erbe visualizzato e una scala cromatica fissa da 0% a 100% in tutti gli strati diagnostici. Visualizzare i valori delle celle per preservare un'interpretazione esatta.
- Indicare il numeratore e il denominatore per ogni cella visualizzata in una tabella aggregata indipendente.
- Costruire un pannello separato per l'interpretazione clinica dopo aver completato la mappa termica descrittiva. Mantenere distinte visivamente i risultati calcolati e l'interpretazione esperta.
- Riempire il livello di suggerimenti solo con termini riconducibili alla tabella delle parole chiave storiche bloccata per versione o al testo esplicito del sindromo normalizzato.
- Chiedere a due revisori clinici di concordare su brevi interpretazioni contestuali dei suggerimenti selezionati. Registrare i revisori e la formulazione finale nel registro delle evidenze.
- Collegare ogni interpretazione contestuale a un utilizzo nella ricerca, come la selezione di variabili, la validazione prospettica o la generazione di ipotesi.
- Utilizzare connettori tratteggiati e non direzionali per il livello di interpretazione. Omettere contenuti relativi a dosaggio, composizione fissa e raccomandazioni terapeutiche.
- Esaminare insieme la mappa termica e il pannello di interpretazione. Assicurarsi che prevalenza calcolata, contesto esperto e utilizzo futuro nella ricerca rimangano chiaramente separati.
8. Assemblare e verificare il pacchetto di riproducibilità
- Esportare il manifesto della fonte, il manifesto del coorte, le versioni del dizionario, il registro delle evidenze, gli script di analisi, le tabelle aggregate, le fonti delle figure e le figure finali in directory separate.
- Assegnare a ogni file un nome basato su un numero stabile della figura o della tabella e sulla data della versione. Conservare una versione corrente autorevole e archiviare separatamente le versioni superate.
- Generare ogni figura come un singolo file immagine multipanello. Esportare un PDF ad alta risoluzione e un PNG a 300 dpi per la revisione.
- Inserire le legende delle figure nel manoscritto e mantenerle al di fuori dei file immagine. Descrivere ogni pannello, unità di analisi, denominatore e codifica visiva.
- Preparare un file XLSX indipendente per ciascuna tabella.
- Chiedere a un revisore indipendente di confrontare i numeri nel manoscritto con quelli delle tabelle aggregate e le percentuali con i rispettivi numeratori e denominatori.
- Confrontare i bordi delle regole con la tabella delle regole e le celle della mappa termica con la matrice sorgente.
- Eseguire controlli automatici per verificare la coerenza dei nomi dei file, la presenza di sezioni obbligatorie, le dimensioni delle figure, il numero di tabelle, il numero di riferimenti, la presenza di residui del modello e l’uso di termini vietati.
- Chiedere al team degli autori clinici di rivedere la terminologia, l’interpretazione, i confini della proprietà intellettuale, i dettagli degli autori, l’ordine dei finanziamenti, la formulazione etica e l’insieme finale delle figure.
- Rimuovere dal pacchetto di sottomissione i file a livello di paziente, le chiavi di collegamento, il testo libero non limitato, la corrispondenza interna e gli artefatti temporanei di revisione.
- Bloccare il pacchetto rilasciato e registrare la sua versione, data, checksum, versione del manoscritto e stato di approvazione da parte degli autori. Creare una nuova versione e un registro delle modifiche per ogni correzione successiva.
Risultati
L'applicazione corretta del protocollo ha prodotto una catena tracciabile che collega l'istantanea anonima della fonte, il manifesto del coorte, i dizionari terminologici, le tabelle aggregate, gli script e le figure finali. La procedura di screening con versione bloccata ha identificato 555 visite per prescrizioni idonee provenienti da 396 pazienti unici. Figura 1 riassume le tre fasi coordinate del metodo: governance, normalizzazione della terminologia e analisi con revisione clinica. La documentazione corrispondente relativa a trasparenza e verifica, inclusa la delimitazione basata esclusivamente su dati aggregati per la revisione assistita da intelligenza artificiale, è fornita in Tabella Supplementare 1.
Il coorte finale comprendeva 555 visite per prescrizioni idonee effettuate da 396 pazienti unici (Figura 2 e Tabella 1). Le visite effettivamente ripetute sono state mantenute per le variabili cliniche e prescrittive dinamiche, mentre età e sesso sono stati riassunti dopo la deduplicazione a livello di paziente. L'età dei pazienti variava da 13 a 94 anni, con una media di 47,11 anni e una deviazione standard di 14,88 anni. Il coorte includeva 228 pazienti di sesso femminile (57,58%), 167 pazienti di sesso maschile (42,17%) e 1 paziente di sesso sconosciuto (0,25%). Questa distinzione delle unità di analisi ha preservato gli incontri longitudinali senza alterare il denominatore demografico.
Gli spettri delle malattie occidentali e della medicina tradizionale cinese sono riassunti nella Figura 3. Le diagnosi occidentali erano concentrate in disturbi gastrointestinali, epatobiliari e pancreatici. Il raggruppamento gerarchico ha assegnato 271 visite a disturbi gastrointestinali, 222 a disturbi epatobiliari o pancreatici e 62 ad altri sistemi (Figura 3A). Le principali diagnosi singole sono state gastrite cronica in 133 visite (23,96%), fegato grasso in 77 visite (13,87%) e cirrosi epatica in 46 visite (8,29%), seguite da gastrite atrofica cronica, dolore addominale, epatite cronica B, dispepsia, esofagite da reflusso, gastrite superficiale cronica e pancreatite cronica (Figura 3C e Tabella 2).
Lo spettro corrispondente dei nomi delle malattie della MTC ha organizzato le stesse visite secondo un sistema diagnostico parallelo. I nomi delle malattie della milza-stomaco o dell'intestino hanno riguardato 280 visite, quelli delle malattie del fegato-vescica biliare 223, i disturbi di qi-sangue-fluidi 26, i disturbi della mente-petto-testa 12, i disturbi dei meridiani o degli arti 5, i disturbi ginecologici 4 e altre categorie 5 visite (Figura 3B). Wei pi, un'etichetta diagnostica della MTC conservata per pienezza o disagio epigastrico, è stata registrata in 163 visite (29,37%). Ji disease (un'etichetta originale della MTC di tipo accumulativo), Gan zhuo (letteralmente, fissità del fegato; un'etichetta classica della MTC conservata), Bi disease (malattia da ostruzione) e Xiao ke (consumazione-sete) sono state mantenute come etichette originali della MTC e non sono state convertite in diagnosi biomédiche moderne. Gan pi, un'etichetta diagnostica della MTC utilizzata nel consenso cinese contemporaneo per i disturbi del fegato grasso, è stata registrata in 77 visite (13,87%)35. I campi diagnostici occidentali e quelli originali della MTC sono rimasti indipendenti e non sono stati sostituiti l'uno con l'altro (Figura 3D e Tabella 3). Xie xie (feci molli o acquose) e Fu xie (diarrea) erano due distinte etichette diagnostiche originali della MTC, registrate rispettivamente 6 e 2 volte, e nessuna delle due è stata equiparata a una diagnosi biomédica moderna. La rappresentazione affiancata dei due spettri ha conservato la logica di ciascun sistema diagnostico, mostrando al contempo l'ampiezza clinica dei dati originali.
Il campo testuale del sindromo normalizzato esplicito conteneva 555 righe di visite idonee. Dopo la deduplicazione all'interno di ciascuna visita, gli elementi principali erano milza in 362 visite (65,23%), fegato in 304 (54,77%), carenza di qi in 295 (53,15%), stomaco in 171 (30,81%), umidità in 151 (27,21%) e stasi di qi in 109 (19,64%; Figura 4A e Tabella 4). Calore, ritenzione idrica, sangue, stasi del sangue, meridiani, rene, cuore e carenza di yin costituivano il resto dello spettro visualizzato. Le percentuali non erano esclusive poiché più elementi sindromici potevano verificarsi durante una singola visita.
La rete e la matrice delle frequenze sono state generate dagli stessi insiemi di token a livello di visita (Figura 4B,C). Le associazioni più frequenti riguardavano milza, fegato e carenza di qi, con ulteriori collegamenti a stomaco, umidità, stasi di qi, calore e ritenzione idrica. L'uso di una singola matrice bloccata per versione per il grafico delle frequenze, la rete e la mappa termica ha garantito che tutti e tre i pannelli rappresentassero la stessa evidenza sottostante a diversi livelli di dettaglio. Il controllo recuperato ha identificato 0 corrispondenze esatte tra sindrome/testo e indicatore su 555 righe e una similarità media di Jaccard testo-indicatore pari a 0,1806. Le colonne relative agli indicatori sono state pertanto escluse dalla presentazione dei risultati principali. I materiali conservati non contenevano vettori di distribuzione ricostruibili precedenti alla pulizia; di conseguenza, la stabilità distribuzionale tra versioni non è stata stimata. L'analisi di sensibilità basata su una singola visita per paziente ha invece valutato l'effetto delle visite ripetute. I risultati del controllo della fonte e della qualità dei dati sono riassunti nella Tabella Supplementare 2.
Dopo la normalizzazione della terminologia e la conservazione delle forme di elaborazione clinicamente significative, le 555 visite comprendevano 324 etichette distinte di erbe unite e 9.339 occorrenze di utilizzo di erbe. Bai Shao è stata registrata in 531 visite (95,68%), seguita da Fu Ling in 520 (93,69%), Dang Gui in 510 (91,89%), Chi Shao in 467 (84,14%) e Bai Zhu stir-fried in 361 (65,05%; Figura 5A e Tabella 5). La curva rango-frequenza delle 36 etichette principali mostrava un segmento iniziale ripido e ad alta frequenza, seguito da una coda progressivamente più ampia (Figura 5B), fornendo una rappresentazione sintetica dei componenti comuni a tutti i pazienti e delle prescrizioni individualizzate. Le corrispondenze tra termini originali e termini normalizzati, i qualificatori di elaborazione, i nomi standard della MTC, le specie di origine e i confini delle evidenze alla base della nomenclatura delle erbe sono documentati nel Tabella Supplementare 3.
Il dizionario ausiliario di materia medica conteneva 9.115 occorrenze di impieghi erboristici codificati per proprietà. Le principali categorie dei Quattro Qi erano caldo (2.588, 28,39%), leggermente freddo (2.339, 25,66%), neutro (2.330, 25,56%) e freddo (1.221, 13,40%; Figura 5C). Dopo la normalizzazione della terminologia relativa al sapore delle sostanze, le principali categorie dei Cinque Sapori erano amaro (4.488, 49,24%), dolce (4.377, 48,02%) e piccante (2.893, 31,74%) (Figura 5D). La codifica della tropismo meridiano era dominata da milza (5.541, 60,79%), fegato (4.801, 52,67%), polmone (3.358, 36,84%), stomaco (2.988, 32,78%) e cuore (2.702, 29,64%; Figura 5E). Figura 5F riporta le diverse unità analitiche a livello di visita e codificate per proprietà, nonché il loro legame di riproducibilità. Nel complesso, questi pannelli illustrano come la frequenza delle prescrizioni e i descrittori standardizzati della materia medica possano essere riassunti senza perdere la specificità terminologica legata alla lavorazione.
Il dizionario di anamnesi predeterminato conteneva 37 concetti esatti di sintomi. Almeno un concetto è stato rilevato in 474 delle 555 visite idonee (85,41%). I termini principali erano secchezza della gola in 178 visite (32,07%), affaticamento in 151 (27,21%), sonno disturbato in 139 (25,05%), distensione addominale in 115 (20,72%), reflusso acido in 100 (18,02%), gusto amaro in 99 (17,84%), bruciore di stomaco in 90 (16,22%), singhiozzo in 87 (15,68%), eruttazione in 87 (15,68%) e feci molli in 77 (13,87%; Figura 6A,B e Tabella 6).
La curva completa rango-frequenza mostrava la distribuzione completa dei 37 termini, mentre la linea cumulativa riassumeva la concentrazione di tutte le rilevazioni delle parole chiave attraverso i ranghi (Figura 6C). Figura 6D registra la sequenza riproducibile utilizzata per generare lo spettro: bloccare il dizionario, analizzare il testo storico anonimizzato, eliminare i concetti duplicati all'interno di ogni visita ed esportare i conteggi aggregati e le frequenze.
Il data mining basato su regole di associazione ha utilizzato la matrice di presenza erbe-per-visita-prescrizione, bloccata alla versione con 555 righe. Quindici regole dirette basate su singole erbe hanno soddisfatto i criteri di supporto ≥ 0,30, confidenza ≥ 0,70 e lift > 1,0 (Figura 7A,B e Tabella 7). I valori di supporto conservati variavano da 0,3009 a 0,7892, quelli di confidenza da 0,7302 a 0,9748 e quelli di lift da 1,0010 a 1,1226.
La coppia diretta più frequentemente co-registrata è stata Chi Shao > Fu Ling, basata su 438 visite, con un supporto di 0,7892, una confidenza di 0,9379 e un lift di 1,0010. La regola inversa presentava lo stesso supporto e una confidenza di 0,8423, dimostrando perché la direzione della regola deve essere mantenuta. L'analisi di sensibilità della soglia ha mantenuto rispettivamente 18, 11, 21, 14, 7 e 4 regole con supporto ≥ 0,25 o ≥ 0,35, confidenza ≥ 0,65 o ≥ 0,75, o lift > 1,02 o > 1,05. Nell'analisi con una sola visita per paziente, la stessa coppia è comparsa in 316 visite, con un supporto di 0,7980, una confidenza di 0,9489 e un lift di 0,9994; pertanto, non è stata mantenuta secondo il criterio lift > 1,0. I risultati relativi alle perturbazioni delle soglie e alla sensibilità delle visite ripetute sono riportati in Supplementary Table 4, mentre il ricalcolo deterministico è fornito in Supplementary File 1. Di conseguenza, un elevato supporto a livello di visita non deve essere interpretato come una validazione a livello di paziente.
I valori di lift più elevati sono stati osservati per Gan Cao > Bai Zhu fritto (1,1226) e Gan Cao > Chi Shao (1,1200). Figura 7A integra tutte e 15 le regole conservate in una rete bipartita diretta, in cui lo spessore degli archi rappresenta il supporto e il colore degli archi rappresenta il lift. Figura 7B ordina le stesse regole in base al lift, ridimensiona ciascun punto in funzione del supporto e annota la confidenza. I due pannelli, pertanto, distinguono la topologia della rete dalla forza quantitativa delle regole, anziché duplicare la stessa rappresentazione visiva.
Il clustering gerarchico delle 20 variabili erbe con frequenza più elevata ha utilizzato la distanza di Jaccard e il collegamento medio (Figura 7C). Il dendrogramma fornisce una rappresentazione globale della somiglianza nei modelli di presenza a livello di visita, complementare alle informazioni direzionali locali fornite dalle regole di associazione. Insieme, i pannelli mostrano come diverse visioni analitiche complementari possano essere allineate a una singola matrice binaria con versione bloccata.
La prevalenza stratificata in base alla diagnosi è stata calcolata per steatosi epatica (77 visite), cirrosi epatica (46 visite) e gastrite cronica (133 visite; Figura 8A e Tabella 8). Bai Shao, Fu Ling e Dang Gui hanno mostrato un'alta prevalenza in tutti e tre i gruppi. Nelle visite per cirrosi epatica si è osservata una documentazione particolarmente rilevante di Dan Shen (95,65%), E Zhu preparato con aceto (86,96%), Bie Jia preparato con aceto (84,78%) e Sheng Huang Qi (60,87%). Nelle visite per steatosi epatica si è registrata una prevalenza maggiore di Yin Chen (41,56%) e Ze Xie (31,17%) rispetto agli altri strati, mentre nelle visite per gastrite cronica sono emersi con frequenza ripetuta Huang Lian (44,36%), Mu Xiang (34,59%) e Chai Hu (36,09%). La mappa termica fornisce quindi un confronto descrittivo sintetico dei modelli complessivi di prescrizione nei principali contesti clinici.
Figura 8B separa il calcolo dall'interpretazione. Gli indizi verificati della storia clinica sono collegati a contesti esperti concisi e quindi a utilizzi nella ricerca, tra cui contestualizzare gli elementi del quadro sindromico, confrontare modelli stratificati per diagnosi, selezionare variabili per la validazione prospettica e generare domande di approfondimento. Questo pannello finale dimostra come l'esperienza clinica possa arricchire l'output analitico mantenendosi chiaramente distinta dalla prevalenza calcolata.
Figura 8C riassume la riproducibilità e i limiti di rilascio distinguendo componenti verificati alla fonte o rivalutati da elementi che richiedono cautela o ulteriore conferma. Questo strato finale di verifica impedisce che prodotti analitici irrisolti o non ricostruibili vengano presentati come risultati validati.
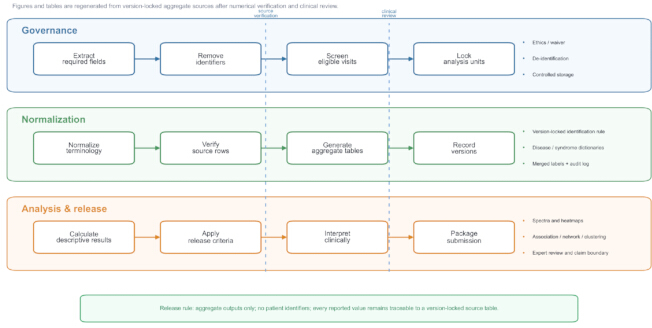
Figura 1: Flusso di lavoro per l'estrazione di dati da cartelle cliniche sottoposti a verifica della fonte. La governance, la normalizzazione della terminologia, l'analisi aggregata, la revisione clinica e il confezionamento per la divulgazione sono mostrate come fasi sequenziali del flusso di lavoro. Le fasce blu, verde e arancione distinguono i domini del flusso di lavoro, mentre le linee verticali tratteggiate indicano i punti di controllo. Le frecce indicano la sequenza del flusso di lavoro e non implicano causalità biologica. La regola di divulgazione specifica che vengono rilasciati esclusivamente risultati aggregati, che gli identificatori dei pazienti sono esclusi e che ogni valore riportato rimane riconducibile a una tabella sorgente con versione bloccata. Non sono applicabili barre di errore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
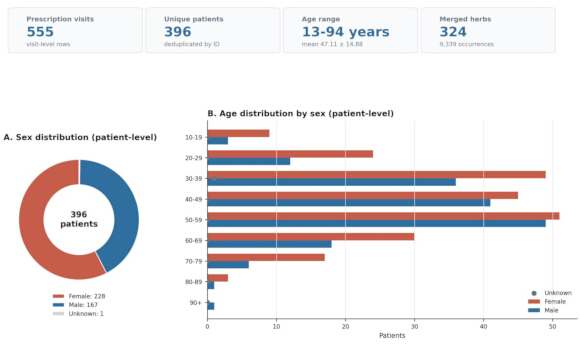
Figura 2: Profilo del dataset e dati demografici a livello paziente. I riquadri riassuntivi riportano 555 visite per prescrizione, 396 pazienti unici, un intervallo di età a livello paziente compreso tra 13 e 94 anni con un'età media di 47,11 ± 14,88 anni e 324 etichette di erbe unite che rappresentano 9.339 casi di utilizzo di erbe. (A) Distribuzione del sesso a livello paziente tra i 396 pazienti unici, inclusi i gruppi femmina, maschio e sconosciuto. (B) Distribuzione dell'età a livello paziente per sesso negli stessi 396 pazienti. I riquadri riassuntivi utilizzano i denominatori a livello visita o a livello paziente, come applicabile. I colori distinguono le categorie di sesso e gli elementi riassuntivi e non hanno un significato inferenziale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
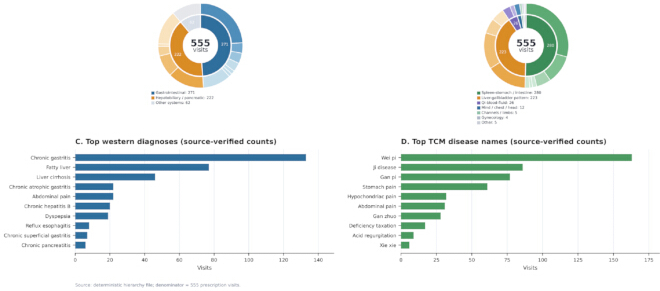
Figura 3: Spettri di malattia ricavati dalle visite per prescrizione. (A) Gruppi gerarchici di malattie occidentali e (B) gruppi gerarchici di malattie della MTC derivati da 555 visite per prescrizione idonee. (C) Principali diagnosi occidentali normalizzate e (D) principali denominazioni normalizzate di malattie della MTC a partire dallo stesso denominatore riferito alle visite. I settori circolari e le barre rappresentano il numero di visite; i colori distinguono i sistemi o le categorie diagnostiche e non indicano effetti terapeutici. Le etichette originali della MTC mantenute sono definite nella Tabella 3: Wei pi (pienezza o disagio epigastrico), Ji disease (etichetta originale della MTC di tipo accumulativo), Gan pi (un'etichetta di malattia della MTC utilizzata per i disturbi del fegato grasso), Gan zhuo (letteralmente, fissità del fegato; un'etichetta classica della MTC mantenuta), Bi disease (malattia da ostruzione), Xiao ke (consumazione-sete), Xie xie (stool molli o acquosi) e Fu xie (diarrea). Queste spiegazioni non trasformano le etichette originali in diagnosi biomédiche moderne. Cliccare qui per visualizzare una versione ingrandita di questa figura.
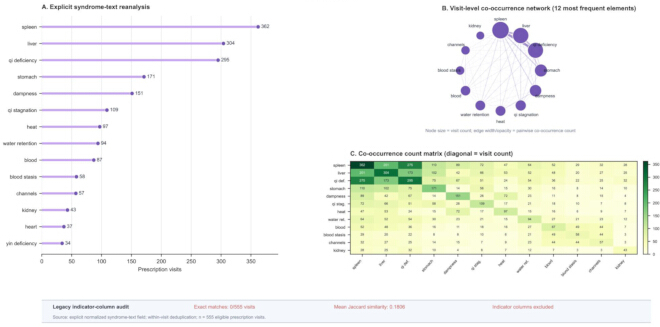
Figura 4: Spettro esplicito degli elementi del sindromo-testo e struttura di co-occorrenza. (A) Frequenze a livello di visita di 14 elementi del sindromo normalizzati dopo deduplicazione all'interno della stessa visita, utilizzando 555 visite con prescrizione idonee come denominatore. (B) Rete di co-occorrenza dei 12 elementi del sindromo più frequenti; le dimensioni dei nodi rappresentano la frequenza delle visite, mentre lo spessore e l'opacità dei collegamenti rappresentano i conteggi di co-occorrenza a coppie. (C) Matrice simmetrica corrispondente dei conteggi di co-occorrenza; le celle sulla diagonale rappresentano le frequenze individuali delle visite, mentre le celle fuori diagonale rappresentano i conteggi di co-occorrenza a coppie. La striscia di verifica riporta 0 corrispondenze esatte tra sindromo-testo e indicatori su 555 righe e una similarità media di Jaccard tra testo e indicatore pari a 0,1806; pertanto, le colonne degli indicatori precedenti sono state escluse dalla presentazione dei risultati. Nella matrice, Qi def. indica carenza di qi, Qi stag. indica stasi del qi e Water ret. indica ritenzione idrica. La scala cromatica è descrittiva. Non sono applicabili barre di errore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
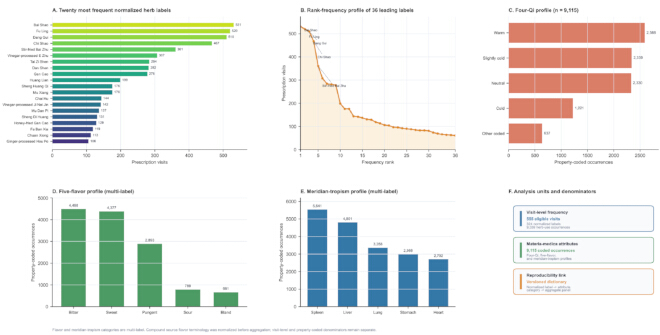
Figura 5: Erbe ad alta frequenza e profili normalizzati degli attributi della materia medica. (A) Le venti etichette di erbe normalizzate più frequenti tra 555 visite prescrittive idonee. (B) Profilo rango-frequenza delle 36 principali etichette di erbe normalizzate. (C) Distribuzione dei Quattro Qi basata su 9.115 occorrenze di utilizzo di erbe codificate per proprietà; il Quattro Qi ha un valore singolo per ogni occorrenza codificata. (D) Distribuzione dei Cinque Sapori e (E) distribuzione della tropismo dei meridiani basata sullo stesso denominatore di occorrenze codificate per proprietà; entrambi sono attributi a etichette multiple, pertanto i conteggi per categoria non sono mutuamente esclusivi. (F) Unità di analisi a livello di visita e codificate per proprietà e il loro legame di riproducibilità. La lunghezza delle barre rappresenta i conteggi, e i colori distinguono i pannelli. Non sono applicabili barre di errore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
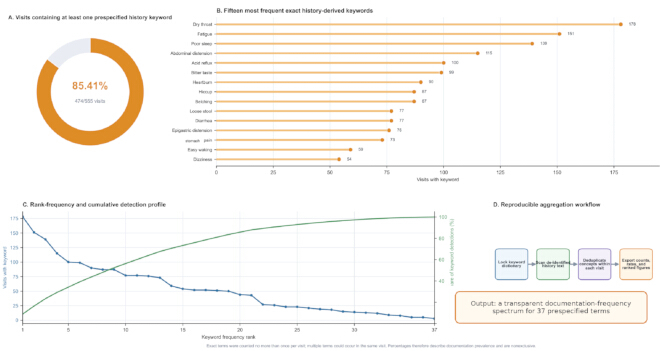
Figura 6: Spettro di parole chiave sintomatiche derivate dalla storia clinica e flusso di lavoro riproducibile per l'aggregazione. (A) Proporzione di 555 visite ambulatoriali idonee contenenti almeno una parola chiave predefinita nella storia clinica; 474 visite (85,41%) contenevano almeno una parola chiave. (B) I quindici concetti sintomatici esatti derivati dalla storia clinica più frequenti. (C) Distribuzione completa per rango e frequenza dei 37 termini e quota cumulativa delle rilevazioni delle parole chiave. (D) Flusso di lavoro bloccato alla versione, dal dizionario predefinito fino agli output aggregati. Ogni concetto è stato contato al massimo una volta per visita, mentre più concetti potevano verificarsi nella stessa visita. Le barre arancioni rappresentano i conteggi delle parole chiave, e i colori del flusso di lavoro distinguono le fasi di elaborazione. Non sono applicabili barre di errore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
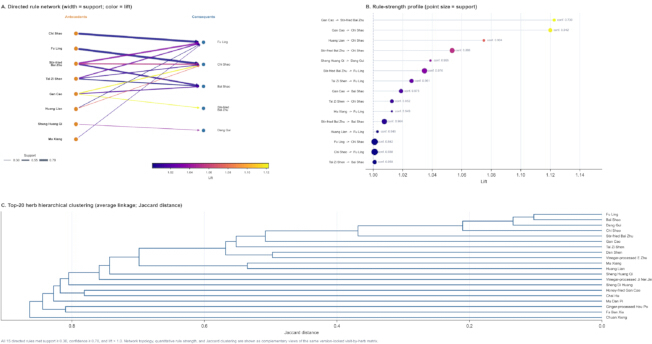
Figura 7: Regole di associazione dirette tra erbe e raggruppamento gerarchico. (A) Rete bipartita diretta di tutte e 15 le regole di associazione singole tra erbe che soddisfano le soglie prestabilite di supporto ≥ 0,30, confidenza ≥ 0,70 e lift > 1,0. La larghezza dell'arco rappresenta il supporto, e il colore dell'arco rappresenta il lift. (B) Profilo di intensità delle regole per le stesse 15 regole ordinate per lift; la dimensione del punto rappresenta il supporto, e le etichette adiacenti indicano la confidenza (conf.). (C) Raggruppamento gerarchico con collegamento medio delle 20 variabili di presenza di erbe con frequenza più elevata, utilizzando la distanza di Jaccard. Tutti i pannelli utilizzano le visite con prescrizione come unità di analisi e descrivono schemi di registrazione concomitante, piuttosto che efficacia, sinergia o una combinazione fissa raccomandata. Non sono applicabili barre di errore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
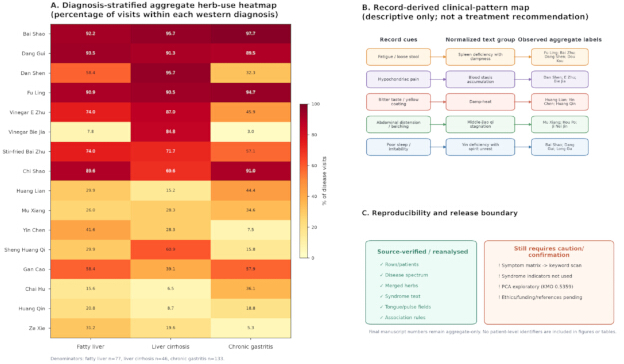
Figura 8: Modelli aggregati di erbe stratificati per diagnosi, mappa dei modelli clinici e confine di rilascio. (A) Mappa termica stratificata per diagnosi che mostra la prevalenza a livello di visita di 16 etichette normalizzate di erbe nel fegato grasso (n = 77), cirrosi epatica (n = 46) e gastrite cronica (n = 133). Ogni cella rappresenta la percentuale di visite idonee all'interno dello strato corrispondente alla diagnosi occidentale, utilizzando una scala cromatica fissa compresa tra 0% e 100%. (B) Mappa dei modelli clinici derivata dai record, che collega gli indicatori verificati nei record a gruppi di testo normalizzati e alle etichette osservate di erbe aggregate. I connettori tratteggiati e non direzionali distinguono questo livello interpretativo descrittivo dalla prevalenza calcolata; il pannello non costituisce un consiglio terapeutico. (C) Riproducibilità e confine di rilascio che distinguono componenti verificati dalla fonte o rivalutati da elementi che richiedono cautela o conferma. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Metrica | Valore | Unità/denominatore | Stato |
| Visite con prescrizione | 555 | 555 visite con prescrizione | verificato dai file XLSX recuperati |
| Pazienti unici | 396 | 396 pazienti unici | verificato dai file XLSX recuperati |
| Intervallo di età a livello paziente | 13-94 | anni | verificato |
| Eta media ± DS a livello paziente | 47,11 ± 14,88 | anni | verificato |
| Eta media ± DS a livello visita | 48,22 ± 15,82 | anni | verificato |
| Sesso a livello paziente | Femmina 228; maschio 167; sconosciuto 1 | 396 pazienti | verificato |
| Sesso a livello visita | Femmina 327; maschio 227; sconosciuto 1 | 555 visite | verificato |
| Erbe unite | 324 | nomi unificati distinti | verificato |
| Occorrenze di utilizzo delle erbe unite | 9339 | 555 visite con prescrizione | verificato |
Tabella 1: Profilo del dataset. Le caratteristiche demografiche a livello di paziente e le variabili a livello di visita-prescrizione sono riportate utilizzando i rispettivi denominatori. Sono inoltre forniti i totali normalizzati delle erbe.
| Nome della malattia | Conteggio | Percentuale di visite |
| Gastrite cronica | 133 | 24 |
| Steatosi epatica | 77 | 13,9 |
| Cirrosi epatica | 46 | 8,3 |
| Gastrite atrofica cronica | 22 | 4 |
| Dolore addominale | 22 | 4 |
| Epatite B cronica | 20 | 3,6 |
| Dispepsia | 19 | 3,4 |
| Esofagite da reflusso | 8 | 1,4 |
| Gastrite superficiale cronica | 7 | 1,3 |
| Pancreatite cronica | 6 | 1,1 |
| Colite ulcerosa | 6 | 1,1 |
| Polipo della colecisti | 6 | 1,1 |
| Sindrome da post-colecistectomia | 6 | 1,1 |
| Disfunzione intestinale | 6 | 1,1 |
| Calcoli biliari | 6 | 1,1 |
| Epatite cronica | 5 | 0,9 |
| Stanchezza | 5 | 0,9 |
| Disfunzione gastrointestinale (etichetta originale incerta) | 5 | 0,9 |
| Gastrite cronica (etichetta originale incerta) | 5 | 0,9 |
| Cirrosi epatica autoimmune | 4 | 0,7 |
Tabella 2: Principali diagnosi occidentali normalizzate. Numeri e percentuali delle principali diagnosi occidentali normalizzate registrate in 555 visite idonee per prescrizione. Le percentuali utilizzano le visite idonee per prescrizione come denominatore.
| Nome della malattia della MTC | Conteggio | Percentuale di visite |
| Wei pi (pienezza o fastidio epigastrico) | 163 | 29,4 |
| Malattia Ji (etichetta MTC di tipo accumulo) | 86 | 15,5 |
| Gan pi (etichetta di malattia della MTC utilizzata per i disturbi del fegato grasso) | 77 | 13,9 |
| Dolore gastrico | 61 | 11 |
| Dolore ipocondriaco | 32 | 5,8 |
| Dolore addominale | 31 | 5,6 |
| Gan zhuo (letteralmente, fissità del fegato; un'etichetta classica conservata della malattia della MTC) | 28 | 5 |
| Deficit da affaticamento | 17 | 3,1 |
| Reflusso acido | 9 | 1,6 |
| Xie xie (stool molli o acquosi) | 6 | 1,1 |
| Insonnia | 4 | 0,7 |
| Dissenteria | 4 | 0,7 |
| Cefalea | 4 | 0,7 |
| Malattia Bi (malattia da impedimento) | 4 | 0,7 |
| Disturbo mestruale | 3 | 0,5 |
| Impedimento toracico | 3 | 0,5 |
| Disturbo del sudore | 3 | 0,5 |
| Stitichezza | 3 | 0,5 |
| Fu xie (diarrea) | 2 | 0,4 |
| Xiao ke (magrezza con sete) | 2 | 0,4 |
Tabella 3: Principali nomi di malattie della MTC normalizzati. Conteggi e percentuali dei principali nomi di malattie della medicina tradizionale cinese normalizzati registrati in 555 visite con prescrizione idonee. Le percentuali utilizzano le visite con prescrizione idonee come denominatore. Le etichette originali e le spiegazioni conservate non implicano equivalenza con diagnosi biomediche moderne.
| Posizione | Elemento del sindromo | Visite per prescrizione | Visite idonee | Percentuale di visite |
| 1 | milza | 362 | 555 | 65,23% |
| 2 | fegato | 304 | 555 | 54,77% |
| 3 | deficit di qi | 295 | 555 | 53,15% |
| 4 | stomaco | 171 | 555 | 30,81% |
| 5 | umidità | 151 | 555 | 27,21% |
| 6 | stasi di qi | 109 | 555 | 19,64% |
| 7 | calore | 97 | 555 | 17,48% |
| 8 | ritenzione idrica | 94 | 555 | 16,94% |
| 9 | Sangue | 87 | 555 | 15,68% |
| 10 | stasi del sangue | 58 | 555 | 10,45% |
| 11 | meridiani | 57 | 555 | 10,27% |
| 12 | rene | 43 | 555 | 7,75% |
| 13 | cuore | 37 | 555 | 6,67% |
| 14 | deficit di yin | 34 | 555 | 6,13% |
Tabella 4: Elementi principali del sindromo normalizzati. Gli elementi del sindromo sono stati estratti dal testo esplicito del sindromo normalizzato e deduplicati all'interno di ciascuna visita prescrittiva. I conteggi utilizzano le 555 visite prescrittive idonee come denominatore; le percentuali non sono esclusive poiché più elementi del sindromo possono verificarsi all'interno di una singola visita.
| Etichetta unificata dell'erba | Conteggio | Percentuale di visite |
| Bai Shao | 531 | 95.7 |
| Fu Ling | 520 | 93.7 |
| Dang Gui | 510 | 91.9 |
| Chi Shao | 467 | 84.1 |
| Bai Zhu saltato in padella | 361 | 65 |
| E Zhu trattato con aceto | 307 | 55.3 |
| Tai Zi Shen | 284 | 51.2 |
| Dan Shen | 282 | 50.8 |
| Gan Cao | 278 | 50.1 |
| Huang Lian | 199 | 35.9 |
| Sheng Huang Qi | 176 | 31.7 |
| Mu Xiang | 176 | 31.7 |
| Chai Hu | 144 | 25.9 |
| Ji Nei Jin trattato con aceto | 142 | 25.6 |
| Mu Dan Pi | 137 | 24.7 |
| Sheng Di Huang | 131 | 23.6 |
| Gan Cao fritto al miele | 129 | 23.2 |
| Fa Ban Xia | 119 | 21.4 |
| Chuan Xiong | 113 | 20.4 |
| Hou Po trattato con zenzero | 106 | 19.1 |
| Yin Chen | 104 | 18.7 |
| Sheng Bai Zhu | 97 | 17.5 |
| Dou Kou | 96 | 17.3 |
| Sheng Long Gu | 92 | 16.6 |
| Zhe Bei Mu | 90 | 16.2 |
| Huang Qin | 88 | 15.9 |
| Dang Shen | 85 | 15.3 |
| Bie Jia trattato con aceto | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14.6 |
| Jiao Zhi Zi | 74 | 13.3 |
| He Huan Hua | 69 | 12.4 |
| Huang Jing trattato con vino | 66 | 11.9 |
| Chen Pi | 64 | 11.5 |
| Ze Xie | 63 | 11.4 |
| Jin Qian Cao | 61 | 11 |
Tabella 5: Etichette delle erbe normalizzate principali in base alla frequenza di prescrizione-visita. Ogni etichetta di erba normalizzata è stata conteggiata al massimo una volta per visita con prescrizione. I conteggi e le percentuali utilizzano 555 visite con prescrizione idonee come denominatore, e le forme di elaborazione clinicamente significative sono mantenute come etichette distinte.
| Posizione | Parola chiave derivata dalla storia clinica | Visite con prescrizione | Visite idonee | Percentuale di visite |
| 1 | Gola secca | 178 | 555 | 32,07% |
| 2 | Stanchezza | 151 | 555 | 27,21% |
| 3 | Scarso sonno | 139 | 555 | 25,05% |
| 4 | Distensione addominale | 115 | 555 | 20,72% |
| 5 | Reflusso acido | 100 | 555 | 18,02% |
| 6 | Sapore amaro | 99 | 555 | 17,84% |
| 7 | Bruciore di stomaco | 90 | 555 | 16,22% |
| 8 | Singhiozzo | 87 | 555 | 15,68% |
| 9 | Eruttazione | 87 | 555 | 15,68% |
| 10 | Stool molle | 77 | 555 | 13,87% |
| 11 | Diarrea | 77 | 555 | 13,87% |
| 12 | Distensione epigastrica | 76 | 555 | 13,69% |
| 13 | Dolore allo stomaco | 73 | 555 | 13,15% |
| 14 | Risveglio frequente | 59 | 555 | 10,63% |
| 15 | Vertigini | 54 | 555 | 9,73% |
| 16 | Vomito | 52 | 555 | 9,37% |
| 17 | Nausea | 52 | 555 | 9,37% |
| 18 | Dolore sordo | 51 | 555 | 9,19% |
| 19 | Dolore distensivo | 50 | 555 | 9,01% |
| 20 | Scarso appetito | 44 | 555 | 7,93% |
| 21 | Dolore addominale | 43 | 555 | 7,75% |
| 22 | Oppressione toracica | 27 | 555 | 4,86% |
| 23 | Irritabilità | 26 | 555 | 4,68% |
| 24 | Cefalea | 23 | 555 | 4,14% |
| 25 | Borborigmi | 23 | 555 | 4,14% |
| 26 | Disagio epigastrico | 21 | 555 | 3,78% |
| 27 | Palpitazioni | 19 | 555 | 3,42% |
| 28 | Urina gialla | 18 | 555 | 3,24% |
| 29 | Sensazione di corpo estraneo | 15 | 555 | 2,70% |
| 30 | Dolore pungente | 14 | 555 | 2,52% |
| 31 | Stitichezza | 13 | 555 | 2,34% |
| 32 | Sonnolenza | 12 | 555 | 2,16% |
| 33 | Sensazione di corpo estraneo alla faringe | 9 | 555 | 1,62% |
| 34 | Sudorazione eccessiva | 8 | 555 | 1,44% |
| 35 | Dolore ipocondriaco | 5 | 555 | 0,90% |
| 36 | Tenesmo | 5 | 555 | 0,90% |
| 37 | Stool secco | 3 | 555 | 0,54% |
Tabella 6: Principali parole chiave sintomatiche derivate dalla storia clinica. Concetti esatti di sintomi rilevati nel testo anonimizzato della storia clinica. Ogni concetto è stato conteggiato al massimo una volta all'interno di una visita per prescrizione, anche se più concetti potevano verificarsi nella stessa visita. I conteggi e le percentuali utilizzano come denominatore 555 visite per prescrizione idonee.
| Antecedente | Conseguente | Visite co-occorrenti | Supporto | Confidenza | Lift |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Stir-fried Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Stir-fried Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Stir-fried Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Stir-fried Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Tabella 7: Regole di associazione dirette tra erbe che soddisfano le soglie prestabilite. Le regole sono state generate da 555 righe binarie di prescrizioni per visita utilizzando un supporto ≥ 0,30, una confidenza ≥ 0,70 e un lift > 1,0. Il supporto utilizza 555 visite con prescrizione come denominatore, e la direzione della regola è mantenuta perché la confidenza è direzionale.
| Etichetta dell'erba | Steatosi epatica (n) | Steatosi epatica (N) | Steatosi epatica (%) | Cirrosi epatica (n) | Cirrosi epatica (N) | Cirrosi epatica (%) | Gastrite cronica (n) | Gastrite cronica (N) | Gastrite cronica (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| Vinegar-processed E Zhu | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Vinegar-processed Bie Jia | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Stir-fried Bai Zhu | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Tabella 8: Prevalenza dell'uso di erbe stratificata per diagnosi. Numeratori, denominatori e prevalenza a livello di visita dei 16 termini normalizzati di erbe utilizzati nei casi di fegato grasso (n = 77), cirrosi epatica (n = 46) e gastrite cronica (n = 133). Ogni termine di erba è stato conteggiato non più di una volta per ciascuna visita con prescrizione idonea.
Tabella supplementare 1: Trasparenza assistita da intelligenza artificiale e registro di audit. Documentazione che distingue il registro dell'analisi originale dalla revisione di coerenza effettuata il 21 agosto 2026. La tabella riporta lo strumento/modello/versione, l'ambito degli input, lo scopo, l'individuazione della discordanza nella cardinalità dei quattro Qi, la correzione effettuata dall'operatore umano, le limitazioni d'uso, le informazioni sul revisore, l'esito e il modello di prompt. Nessuna riga relativa ai dati grezzi a livello di paziente è stata fornita al sistema di intelligenza artificiale. Cliccare qui per scaricare il file.
Tabella supplementare 2: Risultati sulla qualità dei dati dell'audit delle fonti. Sono riportati la completezza dei campi recuperati, i risultati dell'audit, le azioni analitiche intraprese e gli stati di pubblicazione per i campi clinici delle fonti e le strutture analitiche storiche. La tabella documenta l'esclusione degli indicatori di sindrome storici non conciliati, la correzione dei totali precedenti delle erbe, l'assenza di vettori di distribuzione ricostruibili antecedenti alla pulizia per la stima della stabilità tra versioni e le quantità che non hanno potuto essere ricostruite. Cliccare qui per scaricare il file.
Tabella supplementare 3: Corrispondenze della nomenclatura delle erbe. Le etichette standardizzate per la visualizzazione delle erbe sono collegate a qualificatori di lavorazione, nomi standard dei materiali medicinali cinesi (CMM), terminologia delle fonti, fonti botaniche, zoologiche o minerali, versioni di riferimento, indicatori delle evidenze e limiti delle evidenze. Le etichette specifiche per la lavorazione vengono mantenute laddove clinicamente rilevanti. Cliccare qui per scaricare il file.
Tabella supplementare 4: Analisi di sensibilità per soglie e visite ripetute. Vengono riportate perturbazioni delle soglie delle regole associative, confronti tra insiemi di regole basati su una singola visita per paziente, metriche di sensibilità di Chi Shao > Fu Ling e confronto delle distanze di input per il raggruppamento di 190 coppie. Cliccare qui per scaricare il file.
File Supplementare 1: Script per la soglia deterministica e la sensibilità in caso di visite ripetute. Script deterministico utilizzato per riprodurre le metriche aggregate della soglia e della sensibilità in caso di visite ripetute a partire dal set di dati sorgente con versione bloccata. Il file non contiene dati a livello individuale. Cliccare qui per scaricare il file.
Discussione
Il contributo principale di questo protocollo è un percorso completo e controllabile che va da registrazioni di casi di MTC anonimizzate a figure statistiche per la ricerca. I passaggi più critici consistono nel bloccare la regola di identificazione del coorte prima di esaminare i risultati analitici, nel distinguere pazienti unici dalle visite per prescrizioni, nel conservare ogni mappatura originale-termine normalizzato e nel verificare ogni numeratore e denominatore prima della visualizzazione. Questi controlli trasformano la pulizia dei dati da attività preliminare invisibile in un componente documentato del metodo. Inoltre, allineano il flusso di lavoro ai framework RECORD, STROBE, FAIR e ad altri consolidati standard di qualità dei dati provenienti da cartelle cliniche elettroniche11,12,13,14,15. Un risultato è considerato pronto per la pubblicazione solo quando il campo sorgente, l'unità di analisi, la versione del dizionario, la regola di calcolo, il denominatore, la tabella, la figura e la decisione del revisore possono essere tracciati nel registro delle evidenze.
Il metodo è innovativo perché integra governance, ingegneria terminologica, calcolo, visualizzazione e revisione clinica invece di trattarle come compiti separati. Una singola matrice esplicita del sindromo genera lo spettro di frequenza, la rete di co-occorrenza e la mappa termica. Una singola matrice prescrizione-visita-per-erba supporta riepiloghi di frequenza, regole di associazione dirette e raggruppamento gerarchico19,20,21. Una singola tabella stratificata per diagnosi supporta sia percentuali esatte sia la mappa termica finale. Il flusso di lavoro analitico utilizza strumenti open source riproducibili e basati su script36,37,38,39,40, consentendo a una correzione in un dizionario iniziale o a una decisione sul coorte di propagarsi attraverso tutti gli output dipendenti. Precedenti studi su data warehouse clinici dimostrano inoltre l'importanza del preelaborazione collegato alla fonte e del riutilizzo di dati strutturati41,42. Questa architettura riduce la trascrizione manuale, mantiene l'allineamento tra codifiche grafiche e tabelle sorgenti e facilita la verifica, l'insegnamento e il trasferimento ad altri gruppi di ricerca.
Tre recenti studi basati sull'analisi di database forniscono utili principi di progettazione, sebbene l'unità di analisi sia una pubblicazione piuttosto che una visita clinica. Lo studio sull'artrite reumatoide e la depressione combina una strategia di ricerca predeterminata con analisi per paese, istituzione, autore, rivista, parola chiave e cronologia26. Lo studio sulla colite ulcerosa e gli inibitori della tirosina chinasi Janus utilizza collaborazioni coordinate, analisi di cocitazione, clustering e analisi di "burst" per distinguere temi persistenti da nuove frontiere della ricerca27. Lo studio sull'artrite reumatoide e la fibromialgia estende la mappatura bibliometrica integrandola con la bioinformatica, mantenendo al contempo una distinzione tra i due livelli di evidenza28. Il presente protocollo applica lo stesso principio di visioni analitiche coordinate ma non intercambiabili. Il trasferimento in ginecologia, medicina respiratoria, reumatologia o un'altra specialità richiede la ricostruzione di campi specifici della specialità, dizionari terminologici, regole di inclusione ed esclusione, esiti e procedure di revisione clinica prima che l'insieme di regole possa essere riutilizzato. Spettri di malattia, reti di sindromi, parole chiave dei sintomi, regole di associazione, clustering e modelli stratificati per diagnosi derivano tutti da fonti bloccate alla versione, ma ciascuno affronta una domanda distinta e mantiene il proprio denominatore e i propri limiti interpretativi.
L'intelligenza artificiale supervisionata dall'uomo può fornire un ulteriore livello di controllo qualità quando limitata a estratti anonimizzati approvati o materiali aggregati. All'interno di questo flusso di lavoro, l'IA può confrontare la terminologia tra file, segnalare incoerenze tra didascalie e tabelle, identificare etichette che si estendono oltre i margini delle figure, verificare che ogni nodo della rete visualizzata abbia un collegamento valido e suggerire formulazioni più chiare. L'IA non determina l'idoneità del gruppo di studio, non inventa corrispondenze terminologiche, non deduce gli effetti del trattamento e non sostituisce la revisione dei dati originali. Questa suddivisione delle responsabilità è coerente con la visione più ampia secondo cui l'IA in ambito medico dovrebbe potenziare il giudizio umano piuttosto che oscurare la responsabilità33. Riflette inoltre l'enfasi di DECIDE-AI sui fattori umani trasparenti, sulla gestione degli errori e sulla valutazione responsabile34. Pertanto, ogni volta che si utilizza l'assistenza dell'IA, devono essere conservati nel registro di audit lo scopo di ogni richiesta, l'output revisionato, la correzione accettata, il revisore e la data.
La risoluzione dei problemi è particolarmente importante quando un risultato appare clinicamente plausibile ma non supera il controllo di coerenza con la fonte. In tali casi, l'interpretazione successiva dovrebbe essere sospesa finché la discrepanza non viene ricondotta alla determinazione dell'idoneità, alla rimozione dei duplicati, alla mappatura della terminologia, alla selezione dei campi, alla scelta del denominatore o all'assemblaggio della figura. Tutti i risultati dipendenti devono quindi essere rigenerati dopo la correzione. L'esempio illustrato si basa su un insieme di dati retrospettivo, monocentrico, relativo a pazienti ambulatoriali esperti, in cui le visite ripetute non sono indipendenti l'una dall'altra. L'analisi di sensibilità basata su una sola visita per paziente ha ridotto l'insieme di regole conservate da 15 a 12, mantenendo l'appartenenza di tutte e 20 le erbe principali. Considerando tutte le 190 coppie non ordinate tra queste 20 variabili comuni, il coefficiente di correlazione di Pearson è stato 0,9944, il coefficiente rho di Spearman è stato 0,9836, la variazione media assoluta della distanza di Jaccard è stata 0,0146 e la variazione massima è stata 0,0528 (Supplementary Table 4). Di conseguenza, un elevato supporto a livello di visita non deve essere interpretato come una validazione a livello di paziente. Lo spettro delle parole chiave anamnestiche riflette una documentazione letterale piuttosto che una scala di sintomi validata. I riassunti della materia medica sono ponderati in base alla frequenza di occorrenza, non alla dose. Le regole di associazione descrivono la registrazione concomitante, non una relazione causale. Le mappe termiche stratificate per diagnosi sono descrittive e non stabiliscono efficacia comparativa, specificità per malattia o necessità del trattamento.
Il protocollo può essere applicato alla ricerca sull'ereditarietà dell'esperienza clinica specialistica, alla descrizione di coorti ambulatoriali specialistiche, all'armonizzazione terminologica multicentrica, alla revisione della qualità della documentazione, alla selezione di variabili per registri prospettici e alla preparazione consapevole della privacy di set di dati aggregati per collaborazioni. Lavori futuri potranno includere la raccolta prospettica strutturata dei sintomi, modelli raggruppati per paziente, variabili di dose esplicite, ipotesi comparative prefissate, validazione esterna, servizi terminologici con versioni controllate, elaborazione che preservi la privacy e registri interattivi delle evidenze. L'elaborazione del linguaggio naturale e la revisione assistita da intelligenza artificiale potrebbero ulteriormente ridurre la curatela ripetitiva, a condizione che siano regolate da regole bloccate per versione e da verifica umana. Più in generale, il protocollo consente di trasformare l'esperienza clinica distribuita in un oggetto di ricerca trasparente, che può essere esaminato, riprodotto, messo in discussione ed esteso. Il metodo non converte la frequenza in efficacia; piuttosto, trasforma decisioni analitiche non documentate in evidenze visibili, fornendo una base per domande cliniche più rigorose e per ricerche sulla medicina tradizionale cinese più solide nel mondo reale.
Dichiarazioni
Gli autori dichiarano di non avere interessi concorrenti.
Ringraziamenti
OpenAI Codex (gpt-5.6-luna e gpt-5.6-sol) è stato utilizzato esclusivamente durante la revisione del manoscritto per verifiche di coerenza a livello aggregato tra file diversi e suggerimenti relativi alla formulazione. Nessun record a livello di paziente è stato fornito al sistema di intelligenza artificiale. Tutti gli output assistiti dall'IA sono stati verificati indipendentemente rispetto ai materiali originali da Tian Xia il 21 agosto 2026. Gli autori hanno esaminato e approvato il contenuto finale e si assumono piena responsabilità per il manoscritto. Questo progetto è stato sostenuto dal National Key Research and Development Program of China, Key Special Project on Modernization of Traditional Chinese Medicine (n. 2025YFC3512800); dal National Science and Technology Major Project of China (Progetto n. 2026ZD0554100; Sottoprogetto n. 2026ZD0554101); dal Central High-level Traditional Chinese Medicine Hospital Clinical Research and Achievement Translation Capacity Improvement Project, Special Project for Inheriting the Academic Experience of Renowned Senior Traditional Chinese Medicine Experts (n. HLCMHPP2023016); e dalla Natural Science Foundation della Regione Autonoma di Xinjiang Uigura (n. 2025D01C213).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Fogli di calcolo aggregati di riesame | File locali generati dall'autore | Non applicabile | Utilizzati per conteggi aggregati, tabelle e generazione di figure. |
| Esportazione anonimizzata dei record dei casi ambulatoriali | Sistema elettronico istituzionale dei record medici | Non applicabile | Utilizzati esclusivamente nell'ambiente istituzionale controllato; i record a livello di paziente non sono materiali da sottoporre. |
| lxml | Progetto lxml | 6.1.1 | Versione del software utilizzata per la serializzazione con preservazione dello spazio dei nomi durante la rigenerazione nella fase di revisione; non è la versione originale storica utilizzata nell'analisi iniziale. |
| Matplotlib | Progetto Matplotlib (matplotlib.org) | 3.11.1 | Versione rilevata nell'ambiente di rigenerazione nella fase di revisione e nei metadati SVG della Figura 3; non è la versione originale storica utilizzata nell'analisi iniziale. |
| NetworkX | Progetto NetworkX | Pacchetto PyPI: networkx | Identificativo del pacchetto registrato; la versione esatta nella fase di revisione non è stata verificata nell'ambiente ereditato. |
| NumPy | Progetto NumPy | 2.3.5 | Versione del software utilizzata per rigenerare gli output aggregati rivisti; non è la versione originale storica utilizzata nell'analisi iniziale. |
| openpyxl | Progetto openpyxl | 3.1.5 | Versione del software utilizzata per scrivere gli output XLSX aggregati rivisti; non è la versione originale storica utilizzata nell'analisi iniziale. |
| pandas | Progetto pandas | 3.0.1 | Versione del software utilizzata per rigenerare gli output aggregati rivisti; non è la versione originale storica utilizzata nell'analisi iniziale. |
| PyMuPDF | Progetto PyMuPDF | 1.28.2 | Versione del software utilizzata per la rigenerazione nella fase di revisione degli output delle figure riviste; non è la versione originale storica utilizzata nell'analisi iniziale. |
| Python | Fondazione Python Software | 3.13.15 | Versione del software utilizzata per rigenerare gli output aggregati rivisti; non è la versione originale storica utilizzata nell'analisi iniziale. |
| SciPy | Progetto SciPy | Pacchetto PyPI: scipy | Identificativo del pacchetto registrato; la versione esatta nella fase di revisione non è stata verificata nell'ambiente ereditato. |
Riferimenti
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.