Questo protocollo presenta un flusso di lavoro riproducibile per lo sviluppo, la valutazione e l'interpretazione di modelli di intelligenza artificiale interpretabili nell'ambito sanitario. Esso integra la preparazione standardizzata dei dati, lo sviluppo del modello, tecniche di interpretabilità, valutazione quantitativa e pratiche di riproducibilità al fine di migliorare trasparenza, affidabilità e applicabilità clinica.
Articolo metodologico
Un protocollo sperimentale riproducibile per lo sviluppo e la valutazione di modelli di intelligenza artificiale spiegabile nei sistemi sanitari
In questo articolo
Sommario
Abstract
L'intelligenza artificiale (AI) sta diventando sempre più uno strumento prezioso per il processo decisionale clinico, la previsione delle malattie, la diagnosi medica e l'assistenza sanitaria personalizzata. Tuttavia, la mancanza di trasparenza, l'implementazione non uniforme dei metodi di intelligenza artificiale interpretabile (XAI) e la riproducibilità limitata rimangono ostacoli significativi per un impiego affidabile dei modelli di intelligenza artificiale in ambito clinico. Questo articolo propone un protocollo sistematico, riproducibile e trasparente per lo sviluppo, la valutazione e l'interpretazione di modelli di intelligenza artificiale interpretabile per applicazioni sanitarie. Il flusso di lavoro inizia con la configurazione dell'ambiente computazionale, seguita dall'acquisizione e caratterizzazione dei dati, la pre-elaborazione, l'ingegnerizzazione delle caratteristiche, lo sviluppo del modello, l'ottimizzazione degli iperparametri, la valutazione delle prestazioni predittive, l'analisi dell'interpretabilità, la validazione statistica e la valutazione della riproducibilità. Il protocollo incorpora metodi XAI come SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrated Gradients, la visualizzazione dell'attenzione e spiegazioni controfattuali, al fine di generare interpretazioni sia globali che locali del modello. Il protocollo sottolinea diversi componenti chiave, tra cui la preparazione di set di dati sanitari standardizzati, lo sviluppo di modelli di apprendimento automatico stabili, la valutazione delle prestazioni predittive, la generazione di spiegazioni clinicamente rilevanti e la valutazione statistica della riproducibilità attraverso esperimenti ripetuti. Integrando lo sviluppo del modello, l'interpretabilità, la valutazione quantitativa e qualitativa, la validazione statistica e la valutazione della riproducibilità in un flusso di lavoro unificato, questo protocollo fornisce un quadro completo per lo sviluppo di modelli di intelligenza artificiale trasparenti e riproducibili per applicazioni sanitarie.
Introduzione
L'intelligenza artificiale è diventata un componente fondamentale dell'assistenza sanitaria moderna, consentendo un'analisi intelligente di dati clinici complessi e sostenendo il processo decisionale medico basato su evidenze1. La rapida digitalizzazione dell'assistenza sanitaria attraverso cartelle cliniche elettroniche, sistemi di imaging medico, dispositivi indossabili e tecnologie genomiche ha generato grandi volumi di dati eterogenei che richiedono approcci computazionali avanzati per un'interpretazione efficace2.
Gli algoritmi di machine learning (ML) e deep learning (DL) hanno dimostrato capacità notevoli nell'estrarre schemi significativi da dataset sanitari multidimensionali, migliorando così l'accuratezza diagnostica, la previsione delle malattie e la valutazione degli esiti nei pazienti3. I modelli basati sull'intelligenza artificiale sono stati applicati con successo in radiologia, patologia, cardiologia, oncologia, oftalmologia e altre specialità mediche per assistere i clinici nel rilevamento precoce delle malattie e nella raccomandazione di strategie di trattamento personalizzate4. Queste tecnologie hanno inoltre contribuito all'ottimizzazione dei flussi di lavoro, alla riduzione della variabilità diagnostica e al miglioramento dell'utilizzo delle risorse sanitarie5.
I recenti sviluppi nell'hardware informatico, nel cloud computing e nei framework open source per l'intelligenza artificiale hanno accelerato lo sviluppo e il deployment di applicazioni sanitarie intelligenti6. Di conseguenza, l'intelligenza artificiale è diventata una tecnologia abilitante fondamentale per la medicina di precisione e per i sistemi di supporto alle decisioni cliniche7. Nonostante questi progressi, l'adozione diffusa dell'intelligenza artificiale nella pratica clinica di routine rimane limitata, poiché molti modelli ad alte prestazioni offrono scarse informazioni su come vengono generate le loro previsioni8.
La maggior parte degli algoritmi di deep learning funziona come modelli complessi a scatola nera, nei quali il processo decisionale interno è difficile da comprendere per clinici e ricercatori9. Sebbene questi modelli spesso raggiungano prestazioni predittive eccellenti, la loro mancanza di trasparenza compromette la fiducia degli utenti e pone sfide per la validazione clinica, l'approvazione regolatoria e la sicurezza dei pazienti10. I professionisti sanitari devono essere in grado di giustificare le decisioni assistite dall'intelligenza artificiale prima di integrarle nella pratica clinica di routine, specialmente in ambienti medici ad alto rischio11.
L'XAI si è affermato come un approccio efficace per migliorare la trasparenza e l'interpretabilità dei modelli di apprendimento automatico12. Piuttosto che considerare i modelli predittivi come sistemi opachi, le tecniche XAI forniscono informazioni sulle caratteristiche, le regioni delle immagini o le variabili cliniche che contribuiscono alle singole previsioni13. Tali spiegazioni consentono ai clinici di comprendere meglio il comportamento del modello, identificare potenziali bias e stabilire se le decisioni generate dall'intelligenza artificiale siano coerenti con le conoscenze mediche consolidate14.
Sono state introdotte diverse tecniche di spiegabilità per applicazioni nel settore sanitario. Le spiegazioni additive basate sui valori di Shapley (SHAP) misurano il contributo di ciascuna caratteristica alla previsione del modello sulla base della teoria dei giochi cooperativi15. Le spiegazioni locali interpretabili indipendenti dal modello (LIME) creano un modello semplificato per spiegare le previsioni di un modello blackbox16. Per compiti di analisi di immagini mediche che utilizzano modelli di deep learning, le mappe di attivazione pesate tramite gradiente (Grad-CAM) generano mappe di calore che indicano visivamente le regioni dell'immagine che contribuiscono alle decisioni di classificazione17. La combinazione di questi metodi ha notevolmente aumentato la trasparenza dei sistemi di intelligenza artificiale in diversi ambiti sanitari18.
Nonostante l'attenzione crescente verso i metodi di spiegabilità nei contesti sanitari, il loro utilizzo rimane vario in letteratura. I ricercatori differiscono non solo nell'uso di strategie di preelaborazione, ma anche nella progettazione dell'architettura del modello, nelle metriche di valutazione e persino nelle tecniche esplicative19. Inoltre, molti articoli riportano un'elevata accuratezza predittiva ma non forniscono una valutazione approfondita della qualità delle spiegazioni o della loro riproducibilità20.
La riproducibilità è uno dei principali colli di bottiglia nella scienza moderna dell'intelligenza artificiale. Spesso gli articoli non riportano la versione del software, l'ambiente computazionale, la pipeline di preelaborazione, le impostazioni degli iperparametri, l'inizializzazione del seme casuale e le configurazioni hardware21. Per questo motivo, i ricercatori indipendenti spesso non riescono a riprodurre i risultati pubblicati o a verificare i metodi descritti utilizzando altri dataset o piattaforme software22. La mancanza di documentazione dettagliata è uno dei fattori che ostacolano gli studi di benchmarking, la ricerca collaborativa e la traduzione clinica dei sistemi di intelligenza artificiale23.
Riconoscendo queste sfide, numerose organizzazioni e agenzie regolatorie hanno sottolineato l'importanza di un'intelligenza artificiale trasparente, affidabile e riproducibile per le applicazioni nel settore sanitario24. Le linee guida per la rendicontazione esistenti hanno migliorato la descrizione metodologica, ma descrivono principalmente cosa dovrebbe essere riportato, piuttosto che fornire procedure sperimentali standardizzate che i ricercatori possano implementare direttamente25. Di conseguenza, permane la necessità di un protocollo completo che integri la preparazione del dataset, lo sviluppo del modello, l'analisi dell'interpretabilità, la valutazione statistica e le pratiche di riproducibilità in un unico flusso di lavoro sperimentale26.
Un protocollo sperimentale standardizzato offre diversi vantaggi per la comunità dell'intelligenza artificiale in ambito sanitario. Inoltre, promuove la coerenza metodologica, facilita il confronto tra studi indipendenti, aumenta la trasparenza degli esperimenti computazionali e permette una validazione affidabile dei risultati pubblicati27. I flussi di lavoro standardizzati assistono anche l'istruzione/la formazione, la ricerca collaborativa e la valutazione normativa attraverso procedure chiaramente documentate, riproducibili in diversi laboratori e istituzioni sanitarie28.
È stato sviluppato e testato un protocollo sperimentale riproducibile per la formazione e la valutazione di modelli di intelligenza artificiale nei sistemi sanitari. Il protocollo definisce standard per la configurazione dell'ambiente computazionale, la pre-elaborazione dei dataset sanitari, lo sviluppo di modelli di apprendimento automatico, l'applicazione di metodi XAI, la valutazione delle prestazioni predittive, l'esecuzione di validazioni statistiche e la valutazione della riproducibilità29. L'integrazione di tali componenti in un flusso di lavoro coerente è probabilmente in grado di aumentare la trasparenza, l'affidabilità e la riproducibilità della ricerca sull'intelligenza artificiale in ambito sanitario, oltre a contribuire allo sviluppo di sistemi sanitari intelligenti affidabili30.
Protocollo
L'esperimento di validazione svolto ha utilizzato il Pima Indians Diabetes Dataset, disponibile pubblicamente e con informazioni anonime, e non ha coinvolto record di pazienti identificabili né reclutamento di nuovi pazienti. Pertanto, non era richiesto il consenso informato né l'approvazione del comitato etico istituzionale (IRB), e tutte le analisi sono state condotte in conformità ai termini applicabili del dataset e alle politiche istituzionali per la ricerca.
L'esempio pratico di validazione utilizza il dataset pubblicamente disponibile Pima Indians Diabetes, che contiene 768 record per la previsione binaria del diabete. All'insieme di dati è stato applicato un flusso di lavoro principale completo di nove fasi. Le nove fasi fondamentali comprendevano la selezione e la validazione del dataset, la configurazione dell'ambiente computazionale, la pre-elaborazione dei dati, la suddivisione del dataset, lo sviluppo e l'addestramento del modello, la valutazione delle prestazioni predittive e computazionali, l'analisi dell'interpretabilità, la validazione statistica e la valutazione della riproducibilità. La validazione esterna e la valutazione da parte di esperti clinici sono state mantenute come moduli opzionali di validazione e non sono state eseguite nel presente esempio pratico. Figura 1 illustra il flusso di lavoro del protocollo principale, e Tabella 1 riassume esclusivamente le nove fasi principali implementate nel presente esempio pratico di validazione; la validazione esterna e la valutazione da parte di esperti clinici, descritte separatamente all'interno del Protocollo, non sono incluse tra le nove fasi sperimentali.
1. Selezionare e convalidare il dataset sanitario
- Selezionare il Pima Indians Diabetes Dataset come dataset principale per l'esempio di validazione illustrato. Verificare la provenienza del dataset, la dimensione del campione, l'obiettivo della previsione, la distribuzione delle classi e la struttura dei dati.
- Applicare i criteri predeterminati di inclusione, esclusione e qualità dei dati. Rimuovere i record duplicati e non validi prima dello sviluppo del modello.
- Registrare nel Tabella 2 la provenienza del dataset, le caratteristiche, il compito di previsione, la distribuzione delle classi, i criteri di inclusione ed esclusione e la strategia di partizionamento.
- Applicare i criteri decisionali per la selezione del dataset e del modello
- Definire l'obiettivo della previsione prima di selezionare il dataset, l'architettura del modello, la strategia di preelaborazione o il metodo di spiegabilità.
- Abbinare la modalità del dataset all'obiettivo della previsione. Selezionare dati tabellari per variabili cliniche strutturate, dati di immagini per immagini mediche, dati in serie temporale per segnali fisiologici, dati testuali per narrazioni cliniche, o dati multimodali quando sono disponibili modalità complementari per lo stesso paziente o unità di studio.
- Valutare i dataset candidati in base alla dimensione del campione, alla disponibilità dell'esito, alla distribuzione delle classi, alla presenza di dati mancanti, alla qualità delle annotazioni, alla rilevanza clinica, alla completezza dei dati e all'accessibilità. Selezionare il dataset che soddisfa i requisiti predeterminati.
- Selezionare modelli convenzionali di machine learning per dati tabellari strutturati quando la dimensione del campione, le risorse computazionali o i requisiti di interpretabilità limitano l'uso di architetture complesse. Selezionare architetture di deep learning quando sono disponibili dati di addestramento sufficienti e input ad alta dimensionalità, come immagini mediche, segnali fisiologici o testo clinico.
- Selezionare architetture multimodali solo quando sono disponibili più modalità per lo stesso paziente o unità di studio e possono essere allineate in modo affidabile senza introdurre perdite informative. Selezionare le operazioni di preelaborazione in base alle caratteristiche della modalità dati scelta.
- Selezionare i metodi di spiegabilità in base al modello e alla modalità dei dati. Utilizzare metodi agnostici rispetto al modello, come SHAP o LIME, per modelli tabellari appropriati e metodi specifici della modalità, come Grad-CAM per modelli basati su immagini, quando applicabile.
- Documentare la motivazione alla base delle scelte relative al dataset, alla strategia di preelaborazione, al modello e ai metodi di spiegabilità. Conservare queste decisioni come parte del record di riproducibilità.
2. Configurare l'ambiente computazionale per lo sviluppo del modello XAI
- Configurare il sistema operativo, la CPU, la RAM, lo storage e la GPU in base ai requisiti del modello selezionato. Creare un ambiente Python isolato e installare le librerie necessarie di machine learning, deep learning, statistica, visualizzazione e XAI.
- Registrare l'ambiente computazionale effettivo, l'architettura del modello e gli iperparametri utilizzati per la validazione svolta in Tabella 3. Specificare l'ottimizzatore, il tasso di apprendimento, la dimensione del batch, il numero massimo di epoche, la funzione di perdita, i parametri di regolarizzazione, la strategia di validazione, la configurazione dell'arresto anticipato, la configurazione del seme casuale, i metodi di spiegabilità, l'hardware, il sistema operativo, la versione di Python e le versioni delle librerie software rilevanti. Distinguere queste impostazioni effettivamente utilizzate nell'esperimento dalle impostazioni generali o raccomandate del protocollo.
- Utilizzare la configurazione riportata in Tabella 3 quando si riproduce la validazione del Pima Indians Diabetes Dataset e i corrispondenti risultati predittivi, di spiegabilità, statistici e di riproducibilità.
- Eseguire uno script di validazione per verificare l'importazione corretta dei pacchetti, il caricamento del dataset, l'esecuzione del modello e la generazione degli output. Conservare la configurazione finale dell'ambiente per garantire la riproducibilità.
3. Preparare e caratterizzare set di dati sanitari per lo sviluppo di modelli XAI
- Selezionare e acquisire il dataset sanitario
- Selezionare un dataset sanitario appropriato per il compito di previsione clinica definito. Valutare i dataset candidati in base all'obiettivo della ricerca, al tipo di dati, alla dimensione del campione, alla qualità delle annotazioni, all'equilibrio delle classi e alla rilevanza clinica.
- Preferire dataset di riferimento pubblicamente disponibili quando questi affrontano adeguatamente il compito di previsione e facilitano la validazione indipendente.
- Ottenere le necessarie approvazioni etiche, le autorizzazioni istituzionali e l'autorizzazione all'accesso ai dati prima di acquisire dataset istituzionali o interni. Ottenere il dataset selezionato da un archivio verificato o da un database istituzionale autorizzato.
- Conservare i file originali del dataset senza modifiche e registrare il fornitore del dataset, la versione, le informazioni sull'acquisizione, le condizioni di licenza, i criteri di inclusione, i criteri di esclusione e i metadati allegati. Organizzare il dataset in directory separate per dati grezzi, annotazioni, metadati e informazioni supplementari.
- Caratterizzare il dataset sanitario
- Identificare le variabili predittive, le etichette degli esiti, i tipi di caratteristiche, le modalità dei dati e le distribuzioni delle classi. Determinare il numero di soggetti, campioni, dimensioni delle caratteristiche e annotazioni disponibili.
- Verificare che le caratteristiche del dataset siano compatibili con il metodo di intelligenza artificiale selezionato.
- Utilizzare il Pima Indians Diabetes Dataset come unico dataset sperimentale illustrato per la validazione del protocollo principale in nove fasi. Includere i dataset aggiuntivi elencati nella Tabella 2 soltanto per dimostrare l'applicabilità del protocollo generale su dati clinici tabulari, cartelle cliniche elettroniche, immagini dermatoscopiche, dati temporali fisiologici e immagini mediche. Non utilizzare questi dataset aggiuntivi per l'addestramento del modello, i test, la validazione statistica o la generazione dei risultati sperimentali riportati.
- Valutare la qualità del dataset
- Esaminare il dataset alla ricerca di record duplicati, file corrotti, valori mancanti, errori di annotazione e inserimenti di dati irregolari. Rimuovere i record duplicati confermati e correggere le irregolarità di formattazione verificate. Documentare tutte le procedure di controllo qualità del dataset.
- Verificare la corrispondenza tra dati di imaging, clinici, di laboratorio e fisiologici attraverso gli identificatori dei soggetti quando si utilizzano dataset multimodali.
- Rimuovere record duplicati o incoerenti, gestire i valori mancanti, standardizzare le caratteristiche numeriche, codificare le variabili categoriche e applicare pre-elaborazioni specifiche per ciascuna modalità. Suddividere il dataset in set indipendenti di addestramento, validazione e test. Fare riferimento alla Figura 2 per il flusso di lavoro relativo alla preparazione, pre-elaborazione, suddivisione e valutazione della qualità del dataset sanitario.
- Garantire la privacy dei dati e la conformità etica
- Rimuovere gli identificatori diretti dai dati sanitari. Applicare procedure di anonimizzazione o pseudonimizzazione quando richiesto. Gestire le informazioni sanitarie dei pazienti in conformità con i requisiti etici, di protezione dei dati, di consenso informato e istituzionali applicabili.
- Registrare l'approvazione etica applicabile, l'esenzione, le procedure di governance dei dati, i metodi di anonimizzazione e il flusso di lavoro di preparazione del dataset.
- Valutare il potenziale bias algoritmico confrontando le prestazioni del modello tra sottogruppi demografici o clinici rilevanti, quando tali informazioni sono disponibili e consentite dal punto di vista etico.
- Documentare l'uso previsto, la popolazione target, i limiti del modello, i potenziali modi di fallimento, i requisiti di supervisione umana e i requisiti etici, di protezione dei dati e normativi sanitari applicabili.
- Registrare i limiti di equità identificati e le considerazioni relative all'intelligenza artificiale responsabile come parte della documentazione finale del modello.
NOTA: Ottenere un dataset sanitario standardizzato e documentato, adatto allo sviluppo di modelli di intelligenza artificiale, conforme agli aspetti etici e privo di incoerenze significative identificate.
4. Preelaborare e suddividere i dati sanitari per l'addestramento del modello di intelligenza artificiale
- Eseguire il controllo di qualità
- Esaminare il dataset alla ricerca di record duplicati, valori mancanti, valori non validi, etichette inconsistenti, valori anomali e file corrotti.
- Rimuovere o correggere le osservazioni non valide secondo criteri predeterminati e registrare tutte le esclusioni. Verificare la coerenza delle variabili predittive e delle etichette dell'esito.
- Gestire i dati mancanti
- Quantificare la presenza di dati mancanti per ogni variabile. Applicare la strategia predeterminata di imputazione o esclusione.
- Stimare i parametri di imputazione utilizzando esclusivamente i dati di addestramento e applicare la trasformazione calibrata ai dati di validazione e di test.
- Normalizzare e trasformare i dati
- Applicare la riduzione della scala delle caratteristiche, la normalizzazione, la codifica, la riduzione della dimensionalità o altre trasformazioni richieste dal modello selezionato. Calibrare tutte le trasformazioni dipendenti dai dati utilizzando solo i dati di addestramento.
- Applicare le trasformazioni calibrate senza modifiche ai dati di validazione e di test.
- Quantificare lo sbilanciamento delle classi nei dati di addestramento. Applicare pesatura delle classi, SMOTE, oversampling o aumento del campione solo al dataset di addestramento. Mantenere la distribuzione originale dei dataset di validazione e di test.
- Verificare che nessun soggetto, osservazione duplicata, campione aumentato, statistica di preelaborazione, criterio di selezione delle caratteristiche o campione sintetico sia condiviso tra i partizioni di addestramento e di valutazione.
5. Sviluppare e configurare il modello XAI
- Definire l'architettura del modello specificando le modalità dei dati in ingresso, le operazioni di pre-elaborazione, gli encoder delle caratteristiche specifici per ogni modalità, il meccanismo di fusione delle caratteristiche, il livello di previsione e il modulo di spiegabilità.
- Scegliere l'architettura di machine learning o deep learning in base al compito di previsione e alla modalità in ingresso. Configurare il livello di input, i componenti di estrazione delle caratteristiche, i livelli nascosti, il livello di output e le funzioni di attivazione. Definire l'ottimizzatore, il tasso di apprendimento, la dimensione del batch, la funzione di perdita, il numero di epoche, la regolarizzazione, il dropout, l'arresto anticipato e la pianificazione del tasso di apprendimento.
- Ottimizzare gli iperparametri utilizzando esclusivamente i dati di addestramento e di validazione.
- Registrare l'architettura finale e la configurazione degli iperparametri nella Tabella 3.
- Verificare la compatibilità delle dimensioni tra input e output prima dell'addestramento.
NOTA: Creare un modello XAI completamente configurato, contenente un'architettura adeguata, iperparametri definiti e tecniche di spiegabilità integrate.
6. Addestrare, ottimizzare e conservare il modello XAI
- Caricare i dataset predefiniti per il training e la validazione e la configurazione finale del modello. Inizializzare il modello utilizzando il seme casuale predefinito e i parametri di addestramento.
- Addestrare il modello utilizzando l'ottimizzatore specificato, la funzione di perdita, la dimensione del batch e i criteri di arresto.
- Monitorare le prestazioni sulla validazione e conservare il checkpoint corrispondente al criterio di selezione del modello predefinito. Valutare il checkpoint selezionato sul dataset di test indipendente senza ulteriore ottimizzazione.
- Salvare il modello addestrato, la configurazione di pre-elaborazione, gli iperparametri, il seme casuale e il registro di addestramento.
NOTA: Ottenere un modello XAI ottimizzato, addestrato e validato utilizzando il dataset sanitario preparato. Conservare il modello con le migliori prestazioni, gli iperparametri, i registri di addestramento, la configurazione di pre-elaborazione e l'ambiente computazionale per garantire la riproducibilità.
7. Valutare le prestazioni predittive e computazionali
- Valutare le prestazioni predittive
- Caricare il modello ottimizzato e il dataset di test indipendente al termine dell'addestramento del modello e dell'ottimizzazione degli iperparametri. Mantenere invariati i parametri del modello addestrato e la pipeline di pre-elaborazione durante il test.
- Generare le previsioni per tutti i campioni nel dataset di test. Confrontare le uscite previste con le corrispondenti etichette reali.
- Calcolare le metriche di prestazione
- Selezionare le metriche di valutazione in base al tipo di compito predittivo.
- Calcolare accuratezza, precisione, richiamo (recall), specificità, punteggio F1, accuratezza bilanciata, coefficiente di correlazione di Matthews (MCC) e area sotto la curva ROC (AUC-ROC) per compiti di classificazione, ove applicabile. Calcolare errore assoluto medio (MAE), errore quadratico medio (RMSE), coefficiente di determinazione (R2) e altre misure rilevanti per compiti di regressione, ove applicabile.
- Valutare la generalizzazione e la robustezza del modello
- Valutare il modello utilizzando un dataset esterno raccolto in modo indipendente rispetto al dataset di sviluppo, ogni volta che tali dati siano disponibili.
- Preferire dataset esterni provenienti da un’istituzione sanitaria diversa, da una regione geografica differente o da una popolazione di pazienti distinta per valutarne la trasportabilità.
- Eseguire una validazione temporale utilizzando dati raccolti in un periodo successivo, quando sono disponibili dataset longitudinali.
- Eseguire una validazione multicentrica valutando il modello finale separatamente presso le diverse istituzioni partecipanti, quando sono disponibili dati multicentrici.
- Eseguire una validazione geografica utilizzando una popolazione indipendente proveniente da una diversa regione geografica, quando fattibile.
- Segnalare le differenze di prestazione e gli intervalli di confidenza tra il dataset di sviluppo e i dataset esterni.
- Valutare le prestazioni computazionali
- Misurare il tempo di addestramento del modello nell'ambiente computazionale predefinito, il tempo di inferenza e di test nelle stesse condizioni computazionali, nonché il consumo di memoria, le dimensioni del modello e l'utilizzo dell'hardware.
- Ripetere le misurazioni computazionali su esecuzioni indipendenti.
- Calcolare il tempo medio di esecuzione per ridurre l'effetto della variabilità sperimentale.
- Confrontare le prestazioni del modello
- Selezionare metodi convenzionali appropriati di apprendimento automatico o apprendimento profondo per la valutazione comparativa.
- Valutare il modello XAI proposto e i modelli di confronto utilizzando lo stesso dataset. Applicare procedure di pre-elaborazione e metriche di valutazione identiche a tutti i modelli comparativi.
- Eseguire tutti gli esperimenti comparativi nello stesso ambiente computazionale.
NOTA: Ottenere evidenze sperimentali della stabilità predittiva e della riproducibilità nelle condizioni computazionali e con il dataset testati.
8. Generare e valutare gli output XAI
- Generare spiegazioni del modello
- Caricare il modello XAI ottimizzato. Selezionare campioni di valutazione non utilizzati per l'addestramento del modello. Applicare i metodi di spiegabilità predefiniti senza modificare il modello addestrato o la pipeline di preelaborazione.
- Generare spiegazioni globali e locali del modello
- Generare spiegazioni globali per caratterizzare il comportamento complessivo del modello predittivo.
- Generare spiegazioni locali per caratterizzare le singole previsioni del modello.
- Applicare SHAP al Pima Indians Diabetes Dataset per generare spiegazioni globali e locali delle previsioni del modello tabellare.
- Generare un grafico riassuntivo SHAP per visualizzare la direzione e l'entità complessive dei contributi delle caratteristiche.
- Generare un grafico di importanza delle caratteristiche SHAP utilizzando i valori assoluti medi di SHAP per ordinare le caratteristiche in base al loro contributo complessivo alle previsioni del modello.
- Generare un grafico a cascata SHAP per una previsione rappresentativa del test set per illustrare i contributi specifici per paziente delle caratteristiche.
- Generare un grafico di dipendenza delle caratteristiche SHAP per esaminare la relazione tra una caratteristica selezionata e il suo contributo all'uscita del modello.
- Applicare LIME a previsioni rappresentative del test set per generare spiegazioni locali delle singole previsioni del modello.
- Generare una spiegazione contropositiva specifica per paziente per illustrare i cambiamenti nelle caratteristiche associati a un cambiamento nell'esito previsto.
- Selezionare ulteriori tecniche di spiegabilità in base alla modalità dei dati e all'architettura del modello.
- Utilizzare Grad-CAM o mappe di salienza per modelli basati su immagini compatibili, visualizzazioni dell'attenzione per architetture basate su trasformatori e Gradienti Integrati per modelli differenziabili, quando applicabile.
- Considerare Grad-CAM, mappatura della salienza, visualizzazione dell'attenzione e Gradienti Integrati come opzioni generali di protocollo dipendenti dalla modalità, e non interpretarle né riportarle come risultati sperimentali della validazione del Pima Indians Diabetes Dataset a meno che le analisi corrispondenti non siano effettivamente eseguite.
- Applicare metodi di spiegabilità alla validazione esemplificata del dataset Pima
- Applicare SHAP e LIME al Pima Indians Diabetes Dataset per generare spiegazioni globali e locali delle previsioni del modello tabellare.
- Generare visualizzazioni SHAP riassuntive, di importanza delle caratteristiche, a cascata e di dipendenza delle caratteristiche a partire dai risultati della validazione Pima.
- Generare una spiegazione locale LIME per previsioni rappresentative del test set.
- Generare una spiegazione contropositiva specifica per paziente per illustrare i cambiamenti nelle caratteristiche associati a un cambiamento nella previsione del modello.
- Considerare Grad-CAM, visualizzazione dell'attenzione, mappatura della salienza e Gradienti Integrati come opzioni di spiegabilità dipendenti dalla modalità per altri tipi di dati sanitari e architetture di modelli.
- Non riportare Grad-CAM, visualizzazione dell'attenzione, mappatura della salienza o Gradienti Integrati come risultati sperimentali della validazione esemplificata del dataset Pima a meno che le analisi corrispondenti non siano effettivamente eseguite.
- Valutare la qualità delle spiegazioni
- Valutare se le spiegazioni generate riflettono il processo di previsione del modello. Valutare la stabilità delle spiegazioni in ripetuti esperimenti e la coerenza degli output delle spiegazioni in condizioni computazionali identiche.
- Valutare la sensibilità degli output delle spiegazioni ai cambiamenti nei dati in ingresso, quando applicabile. Confrontare le spiegazioni generate con le conoscenze di dominio disponibili o con interpretazioni esperte.
- Identificare caratteristiche predittive o regioni anatomiche che corrispondono a conoscenze mediche consolidate, quando tali confronti sono disponibili.
- Registrare il livello di accordo o disaccordo tra le spiegazioni generate e l'interpretazione clinica disponibile.
- Quantificare l'incertezza della previsione
- Generare stime di confidenza della previsione per i campioni valutati utilizzando un metodo di stima dell'incertezza appropriato all'architettura del modello selezionato e all'applicazione sanitaria.
- Applicare dropout Monte Carlo, previsione basata su ensemble, inferenza bayesiana, previsione conforme o un altro approccio validato di stima dell'incertezza, quando appropriato.
- Ripetere passaggi stocastici di previsione quando si utilizza il dropout Monte Carlo e calcolare la previsione media e la varianza predittiva per ciascun campione di valutazione.
- Riportare intervalli di confidenza o di incertezza della previsione insieme alle previsioni corrispondenti del modello.
- Valutare se le stime di incertezza identificano previsioni associate a minore affidabilità o a un aumento dell'errore di previsione. Conservare il metodo di stima dell'incertezza, i parametri, i semi casuali e gli output di incertezza generati per garantire la riproducibilità.
- Documentare e conservare gli output di spiegabilità
- Salvare tutti i punteggi di importanza delle caratteristiche generati, le mappe termiche, le mappe di salienza, le visualizzazioni dell'attenzione e le interpretazioni specifiche per paziente. Archiviare gli output di spiegabilità utilizzando formati di file standardizzati. Conservare gli output insieme al modello addestrato e alla configurazione di preelaborazione.
- Registrare le impostazioni computazionali, i parametri delle spiegazioni, il tempo di esecuzione e le versioni del software utilizzati per la generazione delle spiegazioni. Conservare tutta la documentazione relativa alla spiegabilità per facilitare la revisione indipendente e la riproducibilità.
- Valutare quantitativamente la qualità delle spiegazioni
- Valutare la fedeltà della spiegazione perturbando o mascherando in modo sistematico le caratteristiche identificate come importanti e misurando il corrispondente cambiamento nell'uscita del modello. Calcolare un punteggio di fedeltà della spiegazione confrontando l'entità dell'attribuzione con il cambiamento risultante nella previsione del modello.
- Valutare la stabilità della spiegazione generando spiegazioni per esecuzioni ripetute, input perturbati o campioni clinicamente simili e calcolando la somiglianza tra i modelli di attribuzione risultanti. Calcolare l'infedeltà misurando la discrepanza tra il cambiamento previsto nell'uscita e il cambiamento stimato dall'attribuzione della spiegazione sotto perturbazioni controllate dell'input.
- Per le spiegazioni basate su immagini mediche, valutare l'accuratezza della localizzazione utilizzando una regione di interesse definita da esperti quando sono disponibili annotazioni di riferimento. Valutare l'utilità clinica ottenendo valutazioni indipendenti da esperti clinici qualificati utilizzando criteri di interpretazione predefiniti.
- Calcolare il kappa di Cohen o il kappa di Fleiss quando più esperti valutano in modo indipendente la rilevanza o l'accordo delle spiegazioni.
NOTA: Generare spiegazioni globali e locali che caratterizzino il comportamento predittivo del modello di intelligenza artificiale addestrato. Conservare gli output di spiegabilità e le configurazioni corrispondenti per un'interpretazione trasparente e una valutazione riproducibile.
9. Eseguire la validazione statistica e la valutazione della riproducibilità
- Eseguire la validazione statistica
- Selezionare i metodi statistici in base all'obiettivo dello studio, al disegno sperimentale, alla distribuzione dei dati e alle caratteristiche delle variabili valutate.
- Riportare le variabili continue come media ± deviazione standard o come mediana e intervallo interquartile, secondo opportunità, e le variabili categoriali come frequenze assolute e percentuali.
- Eseguire una cross-validation a cinque ripetizioni sul set di addestramento per valutare la stabilità delle prestazioni del modello e riportare accuratezza, AUC-ROC, precisione, richiamo e punteggio F1 come valori medi ± deviazione standard tra i fold. Stimare intervalli di confidenza al 95% per le metriche di prestazione sul test set indipendente utilizzando 1.000 ricampionamenti bootstrap.
- Confrontare il modello proposto con i modelli di base CNN, Random Forest e SVM utilizzando il test di McNemar per confronti appaiati dell'accuratezza, il test di DeLong per confronti dell'AUC-ROC correlati e un test bootstrap appaiato con 1.000 ricampionamenti per i confronti del punteggio F1.
- Riportare la statistica del test corrispondente e il valore p esatto per ogni confronto, utilizzando un livello di significatività bilaterale di α = 0.05.
- Confrontare statisticamente le prestazioni del modello
- Confrontare il modello di intelligenza artificiale interpretabile proposto con i modelli di riferimento selezionati basati su machine learning e deep learning all'avanguardia.
- Applicare il test t di Student t-test o il test di Mann-Whitney U a seconda dei casi quando si confrontano due gruppi. Applicare l'analisi della varianza ad un fattore (ANOVA) per i confronti parametrici appropriati che coinvolgono più di due gruppi. Applicare il test di Kruskal-Wallis per i confronti non parametrici appropriati che coinvolgono più di due gruppi.
- Considerare p < 0,05 statisticamente significativo, come specificato nel manoscritto originale.
- Utilizzare un livello di significatività bilaterale di α = 0,05 per tutti i confronti statistici predeterminati e riportare le corrispondenti statistiche del test e i valori p.
- Riportare gli intervalli di confidenza al 95% per le principali metriche di prestazione predittiva.
- Utilizzare il ricampionamento bootstrap per stimare gli intervalli di confidenza delle misure di prestazione quando appropriato. Utilizzare il test di DeLong per confrontare valori di ROC-AUC correlati quando gli stessi soggetti vengono valutati da due modelli. Utilizzare il test di McNemar per confrontare risultati categoriali appaiati di classificazione ottenuti per gli stessi soggetti. Utilizzare procedure bootstrap appaiate per confrontare il punteggio F1 o altre metriche di prestazione derivate quando appropriato.
- Valutare la calibrazione utilizzando i grafici di calibrazione, la pendenza/l'intercetta della calibrazione e il punteggio di Brier quando sono disponibili previsioni probabilistiche.
- Per la validazione del dataset Pima Indians Diabetes elaborato, utilizzare il confronto statistico accoppiato predefinito specificato per il modello proposto e i modelli di riferimento. Applicare il test selezionato in modo coerente alle predizioni sui test set accoppiati o alle misurazioni di prestazione ottenute da esecuzioni ripetute, a seconda della tipologia di confronto. Utilizzare un livello di significatività bilaterale di α = 0,05 e riportare la statistica del test e il valore p esatto. Non riportare test statistici alternativi come eseguiti a meno che i loro risultati non siano presentati nella sezione Risultati.
- Applicare test a due code e interpretare la significatività statistica utilizzando una soglia predeterminata di p < 0.05.
- Valutare la robustezza del modello
- Ripetere l'intera procedura di addestramento e valutazione 10 volte utilizzando diversi semi casuali, mantenendo invariata la partizione predeterminata del dataset, le procedure di preelaborazione, l'architettura del modello, gli iperparametri, l'ambiente software e il protocollo di valutazione.
- Registra l'AUC-ROC, l'accuratezza e il punteggio F1 per ogni esecuzione indipendente e riporta la media ± deviazione standard calcolata su 10 ripetizioni.
- Confrontare i valori di prestazione ottenuti in ripetute esecuzioni per valutare la stabilità predittiva e la riproducibilità in diverse inizializzazioni casuali.
- Valutare la riproducibilità dell'interpretabilità
- Generare attribuzioni delle caratteristiche, mappe di attenzione o altri output esplicativi in più esecuzioni sperimentali quando è inclusa la valutazione della stabilità delle spiegazioni. Confrontare quantitativamente gli output esplicativi tra corse ripetute utilizzando una misura di similarità appropriata o una misura di accordo basata sui ranghi.
- Per la validazione attuale del dataset sul diabete dei Pima Indians, non riportare metriche quantitative di stabilità delle spiegazioni a meno che non siano state eseguite le corrispondenti analisi e ripetizioni delle spiegazioni.
- Valutare l'accordo tra le spiegazioni generate dal modello e le interpretazioni dei clinici quando sono disponibili valutazioni cliniche appropriate. Calcolare il kappa di Cohen o il kappa di Fleiss, secondo opportunità, per valutare l'accordo tra i valutatori.
- Documentare la riproducibilità
- Conservare i dati grezzi, le procedure di preelaborazione, il codice sorgente, i modelli addestrati, le configurazioni degli iperparametri, gli output di spiegabilità, gli script di analisi statistica e i risultati generati.
- Registrare l'ambiente software e la configurazione hardware utilizzati durante l'intero flusso di lavoro. Ripetere in modo indipendente l'intero flusso di lavoro utilizzando i file e le configurazioni archiviati.
- Confrontare le prestazioni predittive replicate con i risultati sperimentali originali e le spiegazioni del modello replicate con gli output originali di spiegabilità.
- Registrare eventuali differenze osservate durante la replicazione. Aggiornare la documentazione sperimentale per riflettere le osservazioni sulla riproducibilità emerse durante l'esecuzione indipendente.
NOTA: Ottenere risultati statisticamente validati relativi alle prestazioni predittive e alla spiegabilità, che possano essere valutati in esperimenti ripetuti. Conservare documentazione sufficiente di tipo computazionale, analitico e metodologico per consentire la verifica indipendente dell'intero flusso di lavoro.
- Elenco di controllo per la riproducibilità
- Registra il nome del dataset, la versione, la data di acquisizione, la fonte, i criteri di inclusione, i criteri di esclusione e il numero finale di campioni. Registra tutte le operazioni di preelaborazione, i parametri di trasformazione, le impostazioni di normalizzazione, le procedure di selezione delle caratteristiche e le regole di suddivisione dei dati.
- Registrare il sistema operativo, CPU, GPU, RAM, versione di Python, versioni dei framework e versioni delle librerie. Registrare tutte le specifiche dell'architettura del modello e gli iperparametri.
- Registra l'ottimizzatore, il tasso di apprendimento, la dimensione del batch, il numero di epoche, la funzione di perdita, la regolarizzazione e i criteri di arresto anticipato. Registra tutti i valori iniziali (seed) casuali e le impostazioni del generatore di numeri casuali.
- Conservare i pesi del modello addestrato e le configurazioni di pre-elaborazione. Conservare i log di addestramento, gli script di valutazione, gli script di analisi statistica e gli output di spiegabilità. Registrare le versioni del modello e del software utilizzate per gli esperimenti finali.
- Preservare l'ambiente computazionale completo necessario per la replicazione indipendente.
- Documentare la disponibilità del codice sorgente, dei set di dati, dei pesi del modello e dei materiali di supporto soggetti a restrizioni etiche, legali, di licenza e di privacy.
- Eseguire nuovamente in modo indipendente il flusso di lavoro archiviato e confrontare i risultati replicati con i risultati originali.
- Documentare i requisiti completi di riproducibilità utilizzando la checklist standardizzata.
Risultati
Il framework XAI proposto è stato implementato utilizzando il Pima Indians Diabetes Dataset come dataset rappresentativo nel settore sanitario. Il Pima Indians Diabetes Dataset è stato utilizzato come unico dataset per la validazione sperimentale. Tutti i risultati predittivi, di interpretabilità, statistici e di riproducibilità riportati sono stati ottenuti da questo dataset. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM e BraTS 2021 non sono stati valutati sperimentalmente e sono inclusi soltanto come esempi che illustrano l'applicabilità del protocollo generale su diverse modalità di dati sanitari. L'intero dataset è stato utilizzato dopo la rimozione di record non validi e duplicati, e le operazioni di pre-elaborazione specificate sono state eseguite prima dello sviluppo del modello. Il dataset è stato suddiviso in sottoinsiemi indipendenti di training, validazione e test mediante una strategia di suddivisione stratificata predefinita. È stata mantenuta l'indipendenza dei campioni tra i tre sottoinsiemi al fine di minimizzare la possibilità di data leakage.
Il modello predittivo è stato configurato utilizzando l'architettura e gli iperparametri predefiniti. Il modello è stato addestrato utilizzando l'ottimizzatore Adam con una velocità di apprendimento e una dimensione del batch predefinite, per un massimo di 100 epoche. È stata applicata l'arresto anticipato basato sulla perdita di validazione ed è stato mantenuto il modello corrispondente alle migliori prestazioni di validazione. Sono stati specificati semi casuali per la suddivisione del dataset, l'inizializzazione del modello e gli esperimenti ripetuti al fine di migliorare la riproducibilità.
Il modello addestrato è stato valutato sul set di test indipendente utilizzando accuratezza, precisione, richiamo, specificità, punteggio F1, coefficiente di correlazione di Matthews (MCC), area sotto la curva caratteristica operativa del ricevitore (AUC-ROC) e precisione media (AP). Il modello proposto è stato confrontato con i modelli di base predefiniti utilizzando procedure di preelaborazione identiche, partizioni dei dati e protocolli di valutazione. Sono state generate curve caratteristiche operative del ricevitore (ROC), curve precisione-richiamo e una matrice di confusione a partire dalle predizioni sul set di test indipendente.
È stata eseguita una validazione incrociata a cinque ripetizioni sui dati di addestramento per valutare la stabilità delle prestazioni. Sono stati stimati intervalli di confidenza al 95% per le principali metriche di prestazione, e sono stati effettuati confronti statistici predeterminati tra il modello proposto e i modelli di riferimento.
La cross-validation a cinque ripetizioni ha prodotto un'accuratezza del 93,01 ± 0,48%, un AUC-ROC di 0,954 ± 0,007, una precisione del 92,42 ± 0,87%, un richiamo del 93,02 ± 0,45% e un punteggio F1 del 92,72 ± 0,62%. Gli intervalli di confidenza bootstrap al 95% stimati da 1.000 ricampionamenti sono stati compresi tra 0,897 e 0,973 per l'accuratezza, tra 0,890 e 0,970 per la precisione, tra 0,880 e 0,963 per il richiamo, tra 0,887 e 0,965 per il punteggio F1 e tra 0,931 e 0,984 per l'AUC-ROC. Confronti statistici con i modelli di base CNN, Random Forest e SVM sono stati effettuati utilizzando il test di McNemar per l'accuratezza, il test di DeLong per l'AUC-ROC e test bootstrap accoppiati con 1.000 ricampionamenti per il punteggio F1.
L'intera procedura di addestramento e valutazione è stata ripetuta per 10 esecuzioni indipendenti utilizzando diversi valori casuali iniziali. Le ripetizioni hanno prodotto un AUC-ROC di 0,957 ± 0,008, un'accuratezza del 93,24 ± 0,74% e un punteggio F1 del 92,35 ± 0,92%, indicando una variabilità relativamente bassa tra le esecuzioni ripetute. Le metriche di prestazione ottenute nelle esecuzioni ripetute sono state riassunte utilizzando la media e la deviazione standard. La variabilità tra le esecuzioni è stata esaminata per determinare se le prestazioni predittive rimanessero stabili in caso di ripetizione dell'esecuzione.
La validazione esterna non è stata eseguita nell'esempio pratico presentato poiché non è stato utilizzato alcun dataset esterno indipendente. Di conseguenza, tutti i risultati riportati relativi alla predittività, alle statistiche e alla riproducibilità sono stati ottenuti dal Pima Indians Diabetes Dataset utilizzando le partizioni predefinite per il training, la validazione e il test indipendente. La validazione esterna è stata mantenuta nel protocollo come procedura opzionale per applicazioni in cui è disponibile un dataset indipendente proveniente da un'istituzione diversa, da una popolazione diversa, da una regione geografica diversa o da un periodo temporale diverso.
Le spiegazioni del modello sono state generate utilizzando tecniche di interpretabilità applicabili al dataset tabellare Pima Indians Diabetes Dataset, inclusi SHAP e LIME. È stata valutata l'importanza globale delle caratteristiche e sono state generate spiegazioni locali specifiche per paziente utilizzando campioni di test tenuti in riserva. Gli output delle spiegazioni sono stati registrati insieme alle corrispondenti previsioni del modello e ai valori delle caratteristiche per facilitare la riproducibilità e l'interpretazione successiva.
Per chiarezza, l'esempio pratico presentato comprende le nove fasi principali del flusso di lavoro identificate nella Tabella 1. La validazione esterna e la valutazione da parte di esperti clinici sono state mantenute come moduli opzionali di validazione del protocollo generale. La validazione esterna non è stata eseguita poiché non è stato utilizzato alcun dataset esterno indipendente, e la valutazione da parte di esperti clinici non è stata effettuata poiché nell'esempio pratico presentato non è stato incluso alcun comitato formale di esperti. Di conseguenza, questi moduli opzionali non sono considerati parte del flusso di lavoro sperimentale in nove fasi e non sono riportati come risultati sperimentali.
Le procedure di preelaborazione e suddivisione del dataset hanno prodotto un dataset standardizzato adatto allo sviluppo del modello. Sono stati rimossi i record duplicati e incoerenti, i valori mancanti sono stati gestiti secondo la strategia predefinita, le caratteristiche numeriche sono state standardizzate e il dataset è stato suddiviso in sottoinsiemi indipendenti di addestramento, validazione e test. Le caratteristiche del dataset risultante e le procedure di preelaborazione sono riassunte nella Tabella 2. Il flusso di lavoro generale per la preparazione e la preelaborazione del dataset sanitario è illustrato nella Figura 2, mentre il flusso di lavoro sperimentale relativo alla preparazione, preelaborazione, suddivisione e valutazione della qualità specificamente applicato al Pima Indians Diabetes Dataset è mostrato nella Figura 3. L'ambiente computazionale finale, l'architettura del modello e la configurazione degli iperparametri utilizzati per generare i risultati riportati sono riassunti nella Tabella 3.
L'esecuzione delle Sezioni 3 e 4 ha prodotto un dataset sanitario standardizzato, adatto allo sviluppo del modello. Le procedure di pre-elaborazione hanno rimosso record duplicati e incoerenti, imputato i valori mancanti, standardizzato le caratteristiche numeriche, codificato le variabili categoriali laddove applicabile e suddiviso il dataset in sottoinsiemi di addestramento, validazione e test. I dati risultanti hanno fornito l'input standardizzato necessario per lo sviluppo successivo del modello.
Al termine delle Sezioni 5 e 6, il modello configurato ha mostrato una convergenza stabile durante l'addestramento. Le curve di apprendimento hanno evidenziato una diminuzione simultanea delle perdite di addestramento e di validazione, e un aumento della precisione di addestramento e di validazione. L'ottimizzazione degli iperparametri ha migliorato la capacità di generalizzazione del modello, senza segni di overfitting significativo. Per favorire la riproducibilità, il modello ottimizzato è stato archiviato insieme all'architettura finale, alle impostazioni degli iperparametri, alle versioni del software, ai valori di inizializzazione casuale (random seeds) e ai pesi del modello addestrato. Le specifiche relative all'addestramento del modello e i risultati dell'ottimizzazione sono riassunti nella Tabella 4, mentre le corrispondenti curve di apprendimento di addestramento e validazione sono presentate nella Figura 4.
La sezione 7 ha valutato le prestazioni predittive del modello utilizzando metriche standardizzate di rendimento. Le metriche di classificazione valutate includevano accuratezza, precisione, richiamo, specificità, punteggio F1, MCC, AUC-ROC e AP. Il modello proposto è stato confrontato con i modelli di base predefiniti utilizzando le stesse partizioni del dataset, procedure di preelaborazione e protocollo di valutazione. Il confronto delle prestazioni predittive è presentato nella Tabella 5, mentre le curve ROC, le curve precisione-richiamo, la matrice di confusione e le metriche comparative di prestazione sono mostrate nella Figura 5.
Dopo la Sezione 8, sono state generate spiegazioni globali e locali delle previsioni del modello per valutarne l'interpretabilità. Le spiegazioni del modello sono state prodotte utilizzando SHAP e LIME per il dataset tabulare Pima Indians Diabetes Dataset, ed è stata generata una spiegazione contropositiva specifica per il paziente per illustrare un cambiamento nella previsione. SHAP è stato utilizzato per generare l'importanza globale delle caratteristiche, visualizzazioni a cascata specifiche per il paziente e visualizzazioni di dipendenza delle caratteristiche, mentre LIME è stato utilizzato per generare spiegazioni locali a partire da campioni di test tenuti in riserva. Gli output corrispondenti di spiegabilità sono presentati in Figura 6.
L'ultima fase del protocollo ha valutato l'affidabilità statistica e la riproducibilità del flusso di lavoro. L'intero flusso di lavoro è stato ripetuto in 10 esecuzioni indipendenti utilizzando diversi seed casuali, mantenendo invariata la strategia di partizionamento del dataset, i parametri di pre-elaborazione, l'architettura del modello, gli iperparametri, l'ambiente software e le procedure di valutazione. Le esecuzioni ripetute hanno prodotto un AUC-ROC di 0,957 ± 0,008, un'accuratezza del 93,24 ± 0,74% e un punteggio F1 del 92,35 ± 0,92%, indicando una variabilità relativamente bassa tra le esecuzioni ripetute.
La stabilità delle spiegazioni non è stata valutata in modo quantitativo nella presente validazione eseguita. Sebbene siano state generate spiegazioni SHAP e LIME per il Pima Indians Diabetes Dataset, non è stata effettuata un'analisi separata di correlazione tra i ranghi o di sovrapposizione delle caratteristiche tra esecuzioni distinte. Pertanto, non vengono riportate metriche numeriche relative alla spiegazione, stabilità o accordo nell'attribuzione. La valutazione quantitativa della stabilità delle spiegazioni è prevista nel protocollo generale come procedura opzionale di riproducibilità per applicazioni in cui sono disponibili output ripetuti delle spiegazioni.
I confronti statistici sono stati valutati utilizzando una soglia di significatività predeterminata di p < 0,05. Sono stati utilizzati test statistici a due code laddove applicabili, e le corrispondenti statistiche del test, i valori di p e gli intervalli di confidenza al 95% sono stati riportati per quantificare la significatività statistica e l'incertezza delle differenze osservate nelle prestazioni. I risultati sperimentali di validazione statistica e riproducibilità, inclusi le prestazioni della cross-validazione, gli intervalli di confidenza, i confronti statistici e la variabilità nei ripetuti esperimenti, sono riassunti nella Tabella 6. Le corrispondenti analisi di verifica statistica e di riproducibilità sono illustrate nella Figura 7.
Questi risultati hanno fornito evidenze sperimentali di stabilità predittiva e riproducibilità nelle condizioni computazionali e nel dataset testati. L'ambiente computazionale, le caratteristiche del dataset, le procedure di pre-elaborazione, la configurazione del modello, le analisi statistiche e le impostazioni di spiegabilità necessarie per la replicabilità indipendente sono state documentate in conformità con il checklist di riproducibilità presentato in Tabella 7. La valutazione da parte di esperti clinici degli output XAI generati non è stata effettuata nell'esempio di validazione illustrato nel presente lavoro.
Nell'insieme, l'applicazione del protocollo ha prodotto un dataset sanitario standardizzato adatto allo sviluppo di modelli di intelligenza artificiale e un modello ottimizzato mediante impostazioni predefinite di iperparametri. Il flusso di lavoro ha permesso una valutazione sistematica delle prestazioni predittive, la generazione di spiegazioni del modello tramite tecniche XAI applicabili e una valutazione statistica della robustezza e riproducibilità del modello. Complessivamente, i risultati hanno dimostrato l'implementazione e la riproducibilità del flusso di lavoro XAI proposto nelle condizioni sperimentali valutate nell'esempio di validazione illustrato.
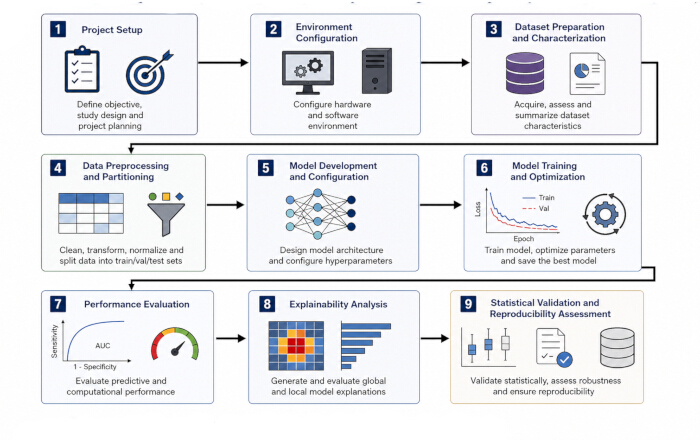
Figura 1: Flusso di lavoro principale in nove fasi per lo sviluppo di modelli di intelligenza artificiale riproducibili e interpretabili nel settore sanitario. Il flusso di lavoro comprende (1) la definizione del compito predittivo sanitario, (2) la configurazione dell'ambiente computazionale, (3) l'acquisizione e la validazione del dataset, (4) la pre-elaborazione dei dati, (5) la suddivisione del dataset, (6) l'addestramento del modello predittivo, (7) la valutazione delle prestazioni predittive, (8) l'analisi dell'interpretabilità e (9) la valutazione della validazione statistica e della riproducibilità. La validazione esterna e la valutazione da parte di esperti clinici sono considerate estensioni opzionali del protocollo e non sono incluse nel flusso di lavoro principale in nove fasi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
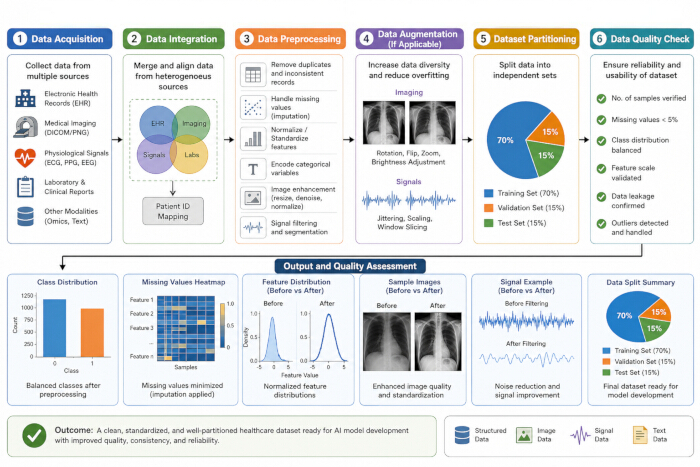
Figura 2: Flusso di lavoro per la preparazione e la preelaborazione dei dataset sanitari. (A) Acquisizione di dati sanitari da cartelle cliniche, immagini mediche, segnali fisiologici e fonti di dati multimodali. (B) Integrazione e preelaborazione dei dati, inclusa la gestione dei valori mancanti, la normalizzazione, la rimozione del rumore e l'aumento dei dati. (C) Partizionamento del dataset in sottoinsiemi di addestramento, validazione e test. (D) Valutazione della qualità che mostra la distribuzione delle classi, la normalizzazione delle caratteristiche e gli output della preelaborazione prima dello sviluppo del modello. Cliccare qui per visualizzare una versione ingrandita di questa figura.
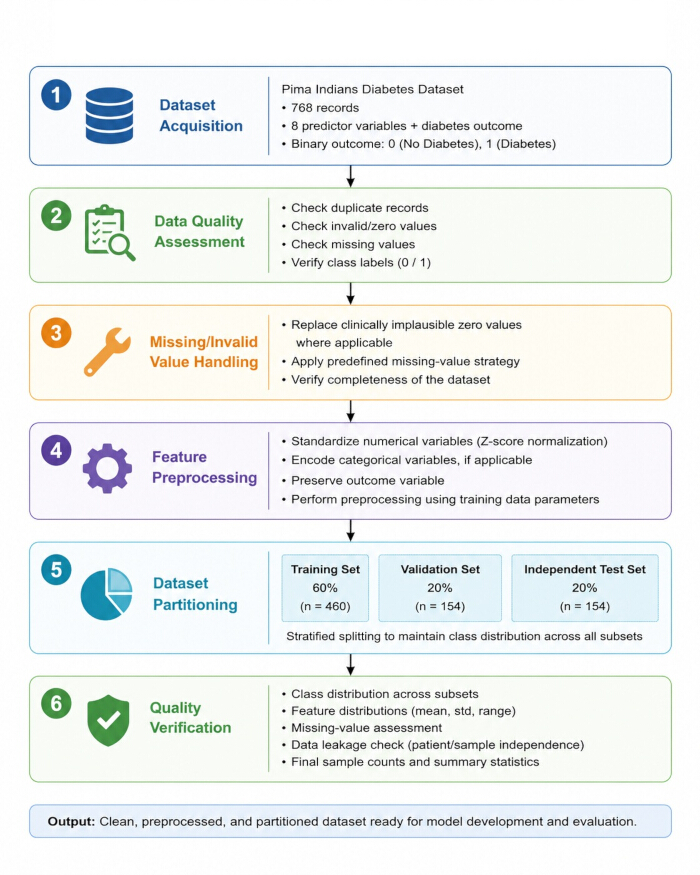
Figura 3: Flusso sperimentale per la preparazione, il preelaborazione, la suddivisione e la valutazione della qualità del Dataset sul Diabete dei Pima Indians. Il flusso comprende l'acquisizione del dataset, la valutazione della qualità dei dati, la gestione di valori non validi e mancanti, la standardizzazione delle caratteristiche numeriche, la suddivisione del dataset in sottoinsiemi di addestramento, validazione e test indipendente, e la verifica finale della qualità prima dello sviluppo del modello. Cliccare qui per visualizzare una versione ingrandita di questa figura.
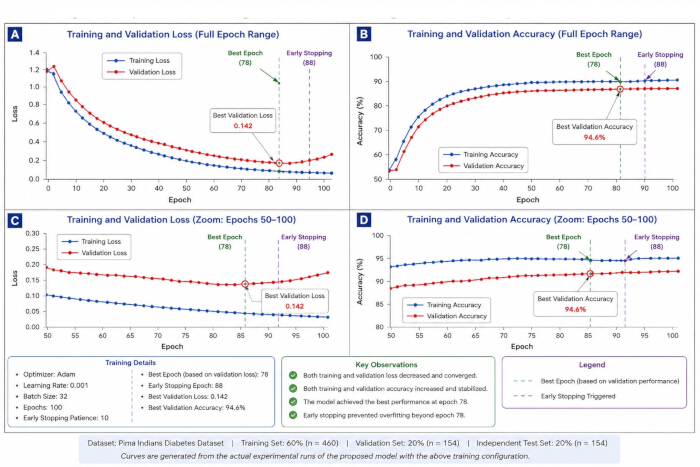
Figura 4: Curve di apprendimento di addestramento e validazione dell'esperimento relative al modello proposto, ottenute utilizzando il Pima Indians Diabetes Dataset. (A) Perdita di addestramento e di validazione durante l'intero periodo di addestramento. (B) Accuratezza di addestramento e di validazione durante l'intero periodo di addestramento. (C) Vista ingrandita della perdita compresa tra le epoche 50 e 100. (D) Vista ingrandita dell'accuratezza compresa tra le epoche 50 e 100. La migliore prestazione di validazione è stata ottenuta all'epoca 78, con una perdita di validazione pari a 0,142 e un'accuratezza di validazione del 94,6%. L'arresto anticipato è stato attivato all'epoca 88, utilizzando una pazienza di 10 epoche. Cliccare qui per visualizzare una versione ingrandita di questa figura.
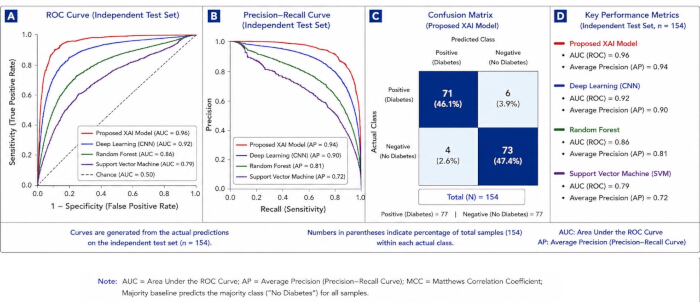
Figura 5: Valutazione sperimentale delle prestazioni predittive del framework XAI proposto, utilizzando il set di test indipendente (n = 154). (A) Curva caratteristica operativa del ricevitore (ROC) che mostra le prestazioni discriminative del modello XAI proposto e dei modelli di riferimento. (B) Curve precisione–richiamo (PR) che mostrano le prestazioni in termini di precisione e richiamo del modello XAI proposto e dei modelli di riferimento. (C) Matrice di confusione del modello XAI proposto sul set di test indipendente, con l'accuratezza, sensibilità (richiamo) e specificità corrispondenti. (D) Confronto tra accuratezza, precisione, richiamo, specificità, punteggio F1, coefficiente di correlazione di Matthews (MCC), area sotto la curva ROC (AUC) e precisione media (AP) nei modelli valutati. Tutti i risultati quantitativi mostrati in questa figura corrispondono all'esperimento di validazione effettuato sul Pima Indians Diabetes Dataset. Cliccare qui per visualizzare una versione ingrandita di questa figura.
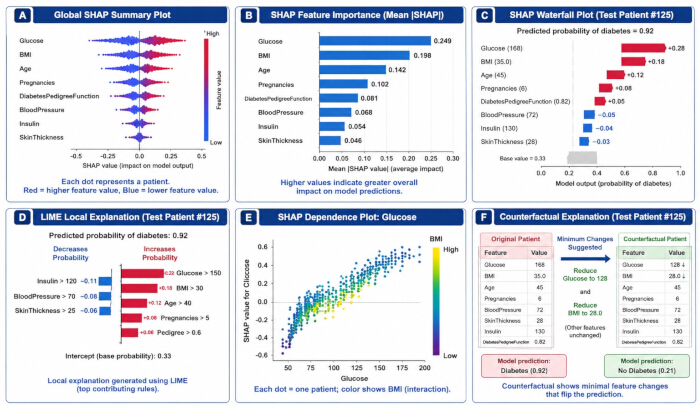
Figura 6: Output di spiegabilità generati a partire dalle predizioni su un test set indipendente del modello proposto, addestrato sul Pima Indians Diabetes Dataset. (AGrafico riassuntivo globale SHAP che mostra la distribuzione dei contributi delle caratteristiche nell'insieme di test.BGrafico dell'importanza delle feature SHAP basato sui valori assoluti medi di SHAP.CGrafico a cascata SHAP specifico per il paziente che mostra il contributo delle singole caratteristiche alla probabilità predetta di diabete.D) Spiegazione locale LIME che mostra i contributi delle caratteristiche per il Paziente di Test n. 125. (E) Grafico di dipendenza SHAP che illustra la relazione tra i valori di glucosio e i loro contributi SHAP. (F) Spiegazione contropositiva specifica per il paziente che mostra le variazioni minime delle caratteristiche associate a un cambiamento nella previsione del modello. Abbreviazioni: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. Fare clic qui per visualizzare una versione ingrandita di questa figura.
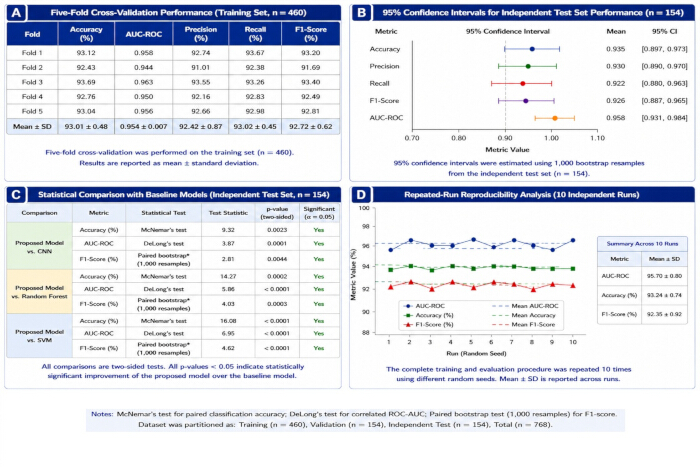
Figura 7: Validazione statistica sperimentale e analisi della riproducibilità del modello proposto utilizzando il Pima Indians Diabetes Dataset. (A) Prestazioni della validazione incrociata a cinque ripiegamenti sul set di addestramento. (B) Intervalli di confidenza bootstrap al 95% per le prestazioni su un set di test indipendente. (C) Confronti statistici con modelli di base, inclusi il test statistico, la statistica del test, il valore p e la significatività. (D) Coerenza delle prestazioni in 10 esecuzioni indipendenti utilizzando diversi semi casuali. È stato utilizzato il test di McNemar per l'accuratezza di classificazione appaiata, il test di DeLong per l'ROC-AUC correlato e un test bootstrap appaiato con 1.000 ricampionamenti per il confronto del punteggio F1. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Fase | Attività del protocollo | Risultato atteso | Stato di implementazione |
| 1 | Selezionare e convalidare il dataset sanitario | Dataset verificato, obiettivo predittivo, distribuzione delle classi e informazioni sulla qualità dei dati | Eseguito |
| 2 | Configurare l'ambiente computazionale | Verifica dell'hardware, software, librerie, versioni e configurazione computazionale | Eseguito |
| 3 | Preelaborare e controllare la qualità dei dati sanitari | Dataset pulito, trasformato e standardizzato | Eseguito |
| 4 | Dividere il dataset | Dataset di addestramento, validazione e test indipendenti | Eseguito |
| 5 | Sviluppare e ottimizzare il modello predittivo/XAI | Architettura finale del modello e iperparametri | Eseguito |
| 6 | Addestrare e conservare il modello | Modello addestrato, checkpoint, configurazione di addestramento e log | Eseguito |
| 7 | Valutare le prestazioni predittive e computazionali | Metriche di prestazione sul test set e confronti delle prestazioni | Eseguito |
| 8 | Generare e valutare gli output esplicativi | Output esplicativi SHAP/LIME e applicabili | Eseguito |
| 9 | Eseguire la convalida statistica e la valutazione della riproducibilità | Intervalli di confidenza, test statistici, risultati di esecuzioni ripetute e misure di riproducibilità | Eseguito |
Tabella 1: Riassunto del flusso di lavoro del protocollo principale in nove fasi applicato nella validazione dimostrativa utilizzando il Pima Indians Diabetes Dataset. La tabella distingue le nove fasi implementate nell'esempio pratico con il Pima Indians Diabetes Dataset dalla validazione esterna e dalla valutazione da parte di esperti clinici, che sono considerate componenti opzionali del protocollo generale.
| Dataset | Fonte dei dati | Applicazione clinica | Modalità dei dati | Soggetti/Record | Campioni | Classi | Distribuzione delle classi | Training/Validazione/Test | Ruolo nello studio presente | Stato della validazione | URL di origine |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Predizione del diabete | Clinici tabulari | 768 record | 768 | 2 | 500 non diabetici; 268 diabetici | 60% / 20% / 20% | Dataset principale per la validazione sperimentale | Eseguita – flusso di lavoro principale completo in nove fasi | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), progetto TCGA-BRCA | Classificazione del cancro al seno | Clinici + istopatologia | 1.098 casi | Dipendente dal dataset in base al tipo di dati | Dipendente dall'endpoint | Nessuna distribuzione unica delle classi a livello di dataset | Non applicabile – nessuna suddivisione sperimentale effettuata | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), progetto TCGA-UCEC | Classificazione del cancro dell'endometrio | Clinici + istopatologia | Cohorte del progetto; dimensione dipendente dal tipo di dati e dai filtri selezionati | Dipendente dal dataset in base al tipo di dati | Dipendente dall'endpoint | Nessuna distribuzione unica delle classi a livello di dataset | Non applicabile – nessuna suddivisione sperimentale effettuata | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Clinical Database v1.4 | Predizione dell'esito clinico | Serie temporali cliniche | 46.520 pazienti | 58.976 ricoveri in terapia intensiva | Dipendente dal compito | Nessuna distribuzione unica delle classi a livello di database | Non applicabile – nessuna suddivisione sperimentale effettuata | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | Classificazione delle lesioni cutanee | Immagini dermatoscopiche | Non applicabile – dataset di immagini | 25.331 immagini di training | 8 categorie di training | AKIEC 867; BCC 3.323; BKL 2.624; DF 239; MEL 4.522; NV 12.875; VASC 253; SCC 628 | Non applicabile – nessuna suddivisione sperimentale effettuata | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC Archive | Classificazione delle lesioni cutanee | Immagini dermatoscopiche | 7.470 lesioni uniche | 10.015 immagini | 7 | AKIEC 327; BCC 514; BKL 1.099; DF 115; MEL 1.113; NV 6.705; VASC 142 | Non applicabile – nessuna suddivisione sperimentale effettuata | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | Dataset OhioT1DM, distribuito pubblicamente per la ricerca | Monitoraggio/predizione del diabete | Serie temporali cliniche | 12 partecipanti | 24 file XML tra dati di training/sviluppo e test | Predizione della glicemia continua; non un compito di classificazione fisso | Non applicabile | Cohorti definite dal dataset per training/sviluppo e test; nessuna suddivisione sperimentale effettuata qui | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/Università della Pennsylvania | Segmentazione/classificazione del tumore cerebrale | RM | 2.040 casi nel cohort della challenge | 1.251 casi annotati per il training; quattro modalità RM per ogni caso | Dipendente dal compito | Nessuna distribuzione unica delle classi a livello di dataset | Cohorti definiti dalla challenge; nessuna suddivisione sperimentale effettuata qui | Solo esempio di applicabilità del protocollo | Non utilizzato per la validazione sperimentale | https://www.med.upenn.edu/cbica/brats2021/ |
Tabella 2: Caratteristiche del dataset sanitario e applicabilità del protocollo proposto. La tabella riassume le fonti dei dati, le applicazioni cliniche, le modalità, le caratteristiche dei campioni, le distribuzioni delle classi, le strategie di partizionamento dei dataset, lo stato di validazione e le informazioni sulle fonti per i dataset sanitari considerati nel protocollo. Il Pima Indians Diabetes Dataset rappresenta l'esempio principale utilizzato per la validazione del protocollo.
| Oggetto della configurazione | Impostazione effettiva di validazione utilizzata | Stato / Interpretazione |
| Dataset | Pima Indians Diabetes Dataset | Dataset sperimentale effettivo per la validazione |
| Algoritmo / Modello | Modello predittivo tabulare per classificazione binaria del diabete | Utilizzare il nome esatto dell'architettura dal registro dell'esperimento, se documentato separatamente |
| Learning Rate | 0.001 | Impostazione sperimentale |
| Optimizer | Adam | Impostazione sperimentale |
| Batch Size | 32 | Impostazione sperimentale |
| Numero massimo di epoche | 100 | Impostazione sperimentale |
| Funzione di perdita | Cross-Entropy | Impostazione sperimentale |
| Funzione di attivazione | ReLU | Impostazione sperimentale |
| Dropout | 0.5 | Impostazione sperimentale |
| Weight Decay | 1e-4 | Impostazione sperimentale |
| Batch Normalization | Abilitato | Impostazione sperimentale |
| Incremento dei dati / Bilanciamento delle classi | Abilitato | Specificare SMOTE solo se effettivamente applicato nell'esecuzione riportata |
| Strategia di validazione | Validazione incrociata a 5 ripetizioni (5-fold cross-validation) | Impostazione sperimentale |
| Early Stopping | Patienza = 10 epoche | Impostazione sperimentale |
| Random Seed | 42 | Utilizzare la configurazione esatta del seme casuale registrata per l'esperimento |
| Esecuzioni ripetute | 10 esecuzioni indipendenti utilizzando diversi semi casuali | Analisi della riproducibilità sperimentale |
| Dimensione dell'immagine in ingresso | Non applicabile | Il dataset Pima è tabulare |
| Dimensione delle caratteristiche | 512 | Utilizzare solo se questa rappresenta la rappresentazione finale delle caratteristiche implementata |
| Spiegabilità | SHAP + LIME; spiegazione controfattuale mostrata nella Figura 6 | Analisi XAI effettivamente riportata |
| Metriche di valutazione | Accuratezza, precisione, richiamo (recall), specificità, F1-score, MCC, AUC-ROC, AP | Metriche sperimentali di valutazione riportate |
| Hardware | NVIDIA GPU | Sostituire con il modello esatto della GPU se registrato |
| Software / Framework | Python 3.11; Scikit-learn; componenti del framework utilizzati dall'implementazione | Utilizzare le versioni esatte dei pacchetti se registrate |
Tabella 3: Ambiente computazionale, architettura del modello e configurazione degli iperparametri utilizzati per l'implementazione del protocollo. La tabella specifica la piattaforma computazionale, l'ambiente software, l'architettura del modello, la configurazione degli input, i parametri di ottimizzazione, le impostazioni di regolarizzazione e i parametri di riproducibilità utilizzati per implementare il flusso di lavoro XAI proposto.
| Parametro | Specifica / risultato rappresentativo |
| Ottimizzatore | Adam |
| Tasso di apprendimento | 0,001 |
| Dimensione del batch | 32 |
| Numero massimo di epoche | 100 |
| Pazienza dello stop anticipato | 10 epoche |
| Migliore epoca | 78 |
| Epoca dello stop anticipato | 88 |
| Perdita minima sulla validazione | 0,142 |
| Precisione massima sulla validazione | 94,6% |
| Risultato dell'addestramento | La perdita su addestramento e validazione è diminuita e convergente |
| Risultato della validazione | La precisione su addestramento e validazione è aumentata e si è stabilizzata |
| Risultato dell'ottimizzazione | La migliore prestazione del modello è stata raggiunta all'epoca 78 |
| Controllo del sovradattamento | Lo stop anticipato ha impedito un'ulteriore ottimizzazione oltre l'epoca migliore selezionata |
Tabella 4: Specifiche per l'addestramento del modello e risultati dell'ottimizzazione. La tabella riassume l'ottimizzatore, la velocità di apprendimento, la dimensione del batch, il numero massimo di epoche di addestramento, le prestazioni nella validazione, la convergenza dell'addestramento, l'esito dell'ottimizzazione e la strategia utilizzata per il controllo dell'overfitting durante lo sviluppo del modello.
| Modello | Precisione (%) | Precisione (%) | Sensibilità (%) | Specificità (%) | Punteggio F1 (%) | MCC | AUC (ROC) | AP (PR) |
| Modello XAI Proposto | 93,5 | 94,5 | 92,4 | 94,6 | 93,4 | 0,87 | 0,96 | 0,94 |
| Apprendimento Profondo (CNN) | 89,1 | 89,8 | 88,1 | 90 | 88,9 | 0,78 | 0,92 | 0,9 |
| Random Forest | 84,3 | 85 | 83,2 | 85,7 | 84,1 | 0,67 | 0,86 | 0,81 |
| Macchina a Vettori di Supporto (SVM) | 78,6 | 79,3 | 77,1 | 80 | 78,2 | 0,54 | 0,79 | 0,72 |
| Linea di Base (Classe Maggioritaria) | 62,1 | 62,1 | 100 | 0 | 76,6 | 0 | 0,5 | 0,5 |
Tabella 5: Confronto delle prestazioni predittive dei modelli valutati. La tabella confronta il modello XAI proposto con i modelli di riferimento valutati utilizzando accuratezza, precisione, richiamo, specificità, punteggio F1, coefficiente di correlazione di Matthews, area sotto la curva caratteristica operativa del ricevitore e precisione media.
| Analisi di validazione | Confronto / Metrica | Test statistico | Statistica del test | p-valore | Risultato sperimentale / IC 95% |
| Validazione incrociata a cinque ripiegamenti | Accuratezza | Descrittivo (media ± DS) | — | — | 93,01 ± 0,48% |
| Validazione incrociata a cinque ripiegamenti | AUC-ROC | Descrittivo (media ± DS) | — | — | 0,954 ± 0,007 |
| Validazione incrociata a cinque ripiegamenti | Precisione | Descrittivo (media ± DS) | — | — | 92,42 ± 0,87% |
| Validazione incrociata a cinque ripiegamenti | Sensibilità | Descrittivo (media ± DS) | — | — | 93,02 ± 0,45% |
| Validazione incrociata a cinque ripiegamenti | Punteggio F1 | Descrittivo (media ± DS) | — | — | 92,72 ± 0,62% |
| Intervallo di confidenza bootstrap al 95% | Accuratezza | Bootstrap (1.000 ricampionamenti) | — | — | 0,935 [0,897; 0,973] |
| Intervallo di confidenza bootstrap al 95% | Precisione | Bootstrap (1.000 ricampionamenti) | — | — | 0,930 [0,890; 0,970] |
| Intervallo di confidenza bootstrap al 95% | Sensibilità | Bootstrap (1.000 ricampionamenti) | — | — | 0,922 [0,880; 0,963] |
| Intervallo di confidenza bootstrap al 95% | Punteggio F1 | Bootstrap accoppiato (1.000 ricampionamenti) | — | — | 0,926 [0,887; 0,965] |
| Intervallo di confidenza bootstrap al 95% | AUC-ROC | Bootstrap (1.000 ricampionamenti) | — | — | 0,958 [0,931; 0,984] |
| Modello proposto vs. CNN | Accuratezza (%) | Test di McNemar | 9,32 | 0,0023 | Significativo (α = 0,05) |
| Modello proposto vs. CNN | AUC-ROC | Test di DeLong | 3,87 | 0,0001 | Significativo (α = 0,05) |
| Modello proposto vs. CNN | Punteggio F1 | Bootstrap accoppiato (1.000 ricampionamenti) | 2,81 | 0,0044 | Significativo (α = 0,05) |
| Modello proposto vs. Foresta casuale | Accuratezza (%) | Test di McNemar | 14,27 | 0,0002 | Significativo (α = 0,05) |
| Modello proposto vs. Foresta casuale | AUC-ROC | Test di DeLong | 5,86 | <0,0001 | Significativo (α = 0,05) |
| Modello proposto vs. Foresta casuale | Punteggio F1 | Bootstrap accoppiato (1.000 ricampionamenti) | 4,03 | 0,0003 | Significativo (α = 0,05) |
| Modello proposto vs. SVM | Accuratezza (%) | Test di McNemar | 16,08 | <0,0001 | Significativo (α = 0,05) |
| Modello proposto vs. SVM | AUC-ROC | Test di DeLong | 6,95 | <0,0001 | Significativo (α = 0,05) |
| Modello proposto vs. SVM | Punteggio F1 | Bootstrap accoppiato (1.000 ricampionamenti) | 4,62 | <0,0001 | Significativo (α = 0,05) |
| Riproducibilità in esecuzioni ripetute (10 esecuzioni indipendenti) | AUC-ROC | Descrittivo (media ± DS) | — | — | 0,957 ± 0,008 |
| Riproducibilità in esecuzioni ripetute (10 esecuzioni indipendenti) | Accuratezza (%) | Descrittivo (media ± DS) | — | — | 93,24 ± 0,74% |
| Riproducibilità in esecuzioni ripetute (10 esecuzioni indipendenti) | Punteggio F1 (%) | Descrittivo (media ± DS) | — | — | 92,35 ± 0,92% |
Tabella 6: Risultati della validazione statistica e della riproducibilità ottenuti dall'implementazione sperimentale utilizzando il Pima Indians Diabetes Dataset. La tabella riassume le prestazioni della validazione incrociata a cinque ripetizioni, gli intervalli di confidenza al 95% basati sul bootstrap, i confronti statistici del modello proposto con i modelli di riferimento e la riproducibilità ripetuta su 10 semi casuali indipendenti. La validazione esterna e la valutazione da parte di esperti clinici non sono state effettuate nella presente validazione esemplificativa.
| No. | Elemento della checklist | Documentazione richiesta | Registrazione / verifica consigliata |
| 1 | Ambiente software | Sistema operativo, linguaggio di programmazione e ambiente software | Registrare le versioni esatte del sistema operativo e del linguaggio di programmazione. |
| 2 | Versioni di software e librerie | Versioni delle principali librerie e pacchetti software | Registrare nomi e versioni esatti dei pacchetti/librerie. |
| 3 | Specifiche hardware | Specifiche di CPU, GPU, RAM, memoria di archiviazione e acceleratori | Registrare l'hardware computazionale utilizzato. |
| 4 | Identificazione del dataset | Nome del dataset, fonte, versione e informazioni di accesso | Registrare la fonte/versione esatta del dataset e la data di accesso, se applicabile. |
| 5 | Caratteristiche del dataset | Dimensione del campione e distribuzione delle classi | Registrare il numero totale di campioni e la distribuzione delle classi per ogni suddivisione. |
| 6 | Partizionamento del dataset | Strategia di suddivisione in training, validation e test set indipendente | Documentare le proporzioni/i conteggi delle suddivisioni e la stratificazione. |
| 7 | Prevenzione della perdita di informazioni | Procedura utilizzata per prevenire la perdita di informazioni | Documentare la separazione tra soggetti/campioni e la stima dei parametri di preprocessing eseguita solo sui dati di training. |
| 8 | Parametri di preprocessing | Impostazioni per la pulizia, la gestione dei valori mancanti, la normalizzazione, la codifica e le trasformazioni | Registrare tutte le operazioni di preprocessing e i valori dei parametri. |
| 9 | Aumento dei dati | Metodi di aumento e impostazioni dei parametri, se applicabile | Documentare i metodi, le probabilità e gli intervalli dei parametri. |
| 10 | Architettura del modello | Architettura e configurazione finale del modello | Documentare il tipo di modello, strati/componenti, dimensioni e funzioni di attivazione. |
| 11 | Iperparametri | Iperparametri di training e ottimizzazione | Registrare tasso di apprendimento, dimensione del batch, ottimizzatore, numero di epoche, arresto anticipato e parametri ottimizzati. |
| 12 | Semi casuali | Semi casuali utilizzati per l'esecuzione riproducibile | Registrare i semi per la suddivisione, l'inizializzazione e le esecuzioni ripetute. |
| 13 | Configurazione del training | Procedura di training e strategia di selezione del modello | Documentare la validazione, il checkpointing e i criteri di selezione del modello. |
| 14 | Metriche di valutazione | Metriche predittive e statistiche predefinite per la valutazione | Registrare tutte le misure di prestazione riportate. |
| 15 | Intervalli di confidenza | Intervalli di incertezza per le misure di prestazione | Documentare la procedura di stima degli intervalli di confidenza e i campionamenti bootstrap, se applicabile. |
| 16 | Test statistici | Procedure statistiche per il confronto tra modelli | Documentare il test, la statistica, il valore p, la soglia di significatività e le assunzioni. |
| 17 | Analisi di esecuzioni ripetute | Esecuzioni indipendenti utilizzando semi casuali diversi | Registrare il numero di esecuzioni e la media ± deviazione standard delle metriche chiave. |
| 18 | Configurazione della spiegabilità | Metodi di spiegabilità e impostazioni dei parametri | Documentare SHAP, LIME, Grad-CAM, attenzione, controfattuali o impostazioni applicabili. |
| 19 | Valutazione della spiegabilità | Valutazione oggettiva dell'affidabilità e utilità delle spiegazioni | Documentare fedeltà, stabilità, infedeltà, localizzazione e valutazione da esperti, se applicabile. |
| 20 | Artifacts del modello | Pesi del modello addestrato e file di configurazione | Archiviare il modello finale addestrato, l'architettura/la configurazione e le informazioni di selezione. |
| 21 | Disponibilità del codice | Codice necessario per preprocessing, training, valutazione e generazione di spiegazioni | Registrare il repository o le informazioni controllate di accesso al codice, se applicabile. |
| 22 | Documentazione dell'esecuzione | Comandi, script, file di configurazione e istruzioni | Registrare i comandi e la configurazione necessari per riprodurre il flusso di lavoro. |
| 23 | Documentazione dell'output | Predizioni, risultati della valutazione, figure e output delle spiegazioni | Archiviare gli output generati e collegarli all'esperimento/esecuzione corrispondente. |
| 24 | Verifica della riproducibilità | Verifica della coerenza tra esecuzioni indipendenti | Confrontare i risultati di esecuzioni ripetute e riportare misure di variabilità predefinite. |
Tabella 7: Lista di controllo per la riproducibilità della replica indipendente del flusso di lavoro XAI proposto. La lista di controllo specifica i requisiti computazionali, di set di dati, di preelaborazione, di sviluppo del modello, di valutazione, di validazione statistica, di interpretabilità e di documentazione necessari per riprodurre il flusso di lavoro sperimentale.
Discussione
I risultati dimostrano l'utilità del protocollo proposto come flusso di lavoro standardizzato e riproducibile per lo sviluppo e la valutazione di sistemi XAI su diversi dataset sanitari. Come mostrato nella Tabella 2 e nella Figura 3, un preelaborazione sistematica ha prodotto dati standardizzati e ha migliorato la qualità dei dati attraverso la gestione dei valori mancanti, la normalizzazione dei dati, la scalatura delle caratteristiche e la partizione dei dataset. Questi passaggi di preelaborazione sono fondamentali perché la variabilità nella preparazione dei dati potrebbe introdurre bias, ridurre le prestazioni predittive e compromettere l'affidabilità delle analisi di spiegabilità. Pertanto, procedure di preelaborazione coerenti devono essere applicate su tutti i dataset di addestramento, validazione e test per favorire la riproducibilità e prevenire il leakage dei dati19,20.
I risultati dell'addestramento del modello mostrati in Figura 4 e Tabella 4 dimostrano un comportamento di apprendimento coerente e stabile. La diminuzione simultanea delle perdite di addestramento e di validazione, insieme all'aumento dell'accuratezza predittiva, indica una convergenza adeguata del modello senza un eccessivo overfitting. L'ottimizzazione degli iperparametri, l'arresto anticipato, il dropout e la regolarizzazione contribuiscono ulteriormente a un addestramento del modello stabile e riproducibile. L'instabilità nelle curve di apprendimento può indicare un tasso di apprendimento inadeguato, una quantità insufficiente di dati di addestramento o una complessità eccessiva del modello. Pertanto, la convergenza del modello deve essere monitorata durante tutto l'addestramento per identificare e risolvere questi potenziali problemi.
Tabella 5 e Figura 5 mostrano le prestazioni predittive utilizzando diverse metriche di valutazione, tra cui accuratezza, precisione, richiamo (recall), specificità, punteggio F1, coefficiente di correlazione di Matthews e area sotto la curva caratteristica operativa del ricevitore (ROC). Le curve ROC e le curve precisione-richiamo forniscono misure delle prestazioni discriminative, mentre la matrice di confusione illustra la distribuzione delle classificazioni corrette e scorrette tra le diverse classi. La valutazione mediante l'uso di più metriche di prestazione è particolarmente importante per dataset medici sbilanciati, poiché l'accuratezza complessiva da sola potrebbe non caratterizzare adeguatamente le prestazioni del modello.
Figura 6 illustra i risultati di spiegabilità generati dal Pima Indians Diabetes Dataset e dimostra i ruoli complementari dei metodi di spiegabilità applicati nella validazione esemplificativa. L'analisi SHAP globale caratterizza il contributo complessivo e l'importanza relativa delle caratteristiche in ingresso rispetto alle predizioni del modello, mentre i grafici a cascata SHAP e i grafici di dipendenza forniscono interpretazioni specifiche per paziente e a livello di caratteristica del comportamento del modello. LIME fornisce un'ulteriore spiegazione locale identificando le caratteristiche che contribuiscono alla predizione di un singolo campione nel test set. La spiegazione contropositiva specifica per paziente illustra inoltre i cambiamenti minimi nelle caratteristiche associati a una variazione nell'esito predetto. Nel complesso, questi approcci offrono prospettive complementari, globali e locali, sul comportamento del modello e migliorano la trasparenza e l'interpretabilità del modello predittivo tabellare. Grad-CAM, la visualizzazione dell'attenzione, la mappatura della salienza e i gradienti integrati non sono stati applicati nella validazione esemplificativa su Pima e sono mantenuti soltanto come opzioni dipendenti dalla modalità all'interno del protocollo generale.
La validazione statistica (Tabella 6 e Figura 7) e le valutazioni della riproducibilità dimostrano la stabilità delle prestazioni predittive in diversi esperimenti. La combinazione di validazione incrociata, stima degli intervalli di confidenza, test di ipotesi e valutazione della riproducibilità in ripetuti esperimenti fornisce un quadro sistematico per valutare la robustezza del modello. Tale validazione è particolarmente importante nelle applicazioni sanitarie poiché la riproducibilità in esperimenti indipendenti costituisce una prova dell'affidabilità e della generalizzabilità dei modelli di intelligenza artificiale prima della loro implementazione in ambienti clinici21,23.
Diversi passaggi sono fondamentali per l'implementazione corretta di questo protocollo. Eseguire la pulizia dei dati prima dell'estrazione delle caratteristiche e dell'addestramento del modello per ridurre al minimo i potenziali bias derivanti da dati incompleti, incoerenti o errati. Ottimizzare gli iperparametri utilizzando esclusivamente i dati di addestramento e di validazione, mantenendo il dataset di test indipendente durante tutto lo sviluppo e l'ottimizzazione del modello. Documentare chiaramente lo stato dei generatori di numeri casuali, le versioni del software, le configurazioni hardware e le impostazioni di preelaborazione per facilitare la riproducibilità su diverse piattaforme computazionali. Inoltre, selezionare metodi di spiegabilità in base al modello predittivo e alla tipologia di dati sanitari, al fine di ottenere spiegazioni interpretabili e clinicamente rilevanti20,29,30.
Il protocollo presenta diversi limiti. L'accuratezza e l'affidabilità delle previsioni e delle spiegazioni del modello dipendono in larga misura dalla disponibilità di set di dati sanitari sufficientemente ampi, rappresentativi e di alta qualità. La scarsa rappresentazione di specifiche popolazioni di pazienti, gli errori di misurazione, le variabili mancanti e l'eterogeneità tra le fonti di dati possono influire negativamente sia sulle prestazioni predittive sia sulla stabilità delle spiegazioni del modello. Inoltre, gli attuali approcci di spiegabilità possono caratterizzare il comportamento del modello ma non stabiliscono necessariamente meccanismi causali. Pertanto, gli output dell'XAI dovrebbero essere interpretati congiuntamente all'esperienza clinica pertinente.
Nel complesso, questo protocollo fornisce un approccio standardizzato per lo sviluppo, la valutazione e l'analisi dell'interpretabilità di modelli riproducibili in diversi ambiti dell'assistenza sanitaria. Integrando una preelaborazione standardizzata, l'ottimizzazione degli iperparametri, la valutazione mediante molteplici metriche di prestazione, approcci complementari di interpretabilità e una validazione statistica, il flusso di lavoro offre un quadro trasparente e tracciabile per la ricerca sull'intelligenza artificiale nel settore sanitario.
I risultati indicano inoltre che lo sviluppo di modelli di intelligenza artificiale trasparenti e coerenti può essere sostenuto combinando una preelaborazione sistematica dei dati, procedure standardizzate di sviluppo del modello, una valutazione completa delle prestazioni, diversi metodi di spiegabilità e una rigorosa validazione statistica. Il protocollo può essere adattato a basi di dati cliniche, immagini mediche, segnali fisiologici e dati sanitari multimodali, mantenendo al contempo un quadro per sperimentazioni riproducibili in diversi ambienti computazionali. Attraverso un'implementazione standardizzata, tecniche complementari di spiegabilità e la valutazione della riproducibilità, il protocollo fornisce un quadro per lo sviluppo di modelli di intelligenza artificiale interpretabili e affidabili e può costituire un fondamento metodologico per future ricerche biomediche e per successive validazioni esterne e cliniche.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari concorrenti, rapporti commerciali o rapporti personali che avrebbero potuto influenzare il lavoro descritto in questo studio. Gli autori non hanno conflitti di interessi da dichiarare.
Ringraziamenti
Gli autori riconoscono il supporto istituzionale fornito dalle rispettive istituzioni di affiliazione durante lo sviluppo e la validazione sperimentale di questo protocollo XAI per l'assistenza sanitaria. Gli autori riconoscono inoltre le strutture computazionali e le risorse software utilizzate per condurre le analisi sperimentali. Questa ricerca non ha ricevuto finanziamenti esterni. Gli autori riconoscono l'uso di Python 3.11, Matplotlib 3.9 e SciPy 1.13 per l'analisi computazionale, la visualizzazione dei dati e la generazione delle figure presentate in questo studio.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Captum | Meta AI | Ultima versione stabile | Spiegabilità di PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | Accelerazione GPU |
| cuDNN | NVIDIA | 9.x | Backend per il deep learning |
| Git | Git SCM | Ultima versione stabile | Controllo versioni |
| GitHub | GitHub Inc. | Piattaforma web | Repository di codice sorgente |
| Grad-CAM | jacobgil | Ultima versione rilasciata | Visualizzazione CNN |
| Jupyter Notebook | Project Jupyter | Ultima versione stabile | Sviluppo interattivo |
| LightGBM | Microsoft | 4.x | Gradient boosting |
| LIME | Comunità LIME | 0.2.0 | Spiegabilità locale |
| Matplotlib | Sviluppatori Matplotlib | 3.9 | Visualizzazione |
| Microsoft Excel | Microsoft | Microsoft 365 | Organizzazione dati |
| NumPy | Sviluppatori NumPy | 1.26 | Calcolo numerico |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | Addestramento del modello |
| OpenCV | Organizzazione OpenCV | 4.10 | Pre-elaborazione delle immagini |
| Pandas | Squadra di sviluppo di Pandas | 2.2 | Pre-elaborazione dati |
| Pillow (PIL) | Python Imaging Library | 10.x | Elaborazione delle immagini |
| Plotly | Plotly Technologies | 5.x | Visualizzazione interattiva |
| Python | Fondazione Python Software | 3.11 | Ambiente di programmazione |
| PyTorch | Fondazione PyTorch | 2.3 | Deep learning |
| Scikit-learn | Sviluppatori Scikit-learn | 1.5 | Apprendimento automatico |
| SciPy | Sviluppatori SciPy | 1.13 | Calcolo scientifico |
| Seaborn | Sviluppatori Seaborn | 0.13 | Grafici statistici |
| SHAP | Comunità SHAP | 0.46 | Spiegabilità globale |
| SimpleITK | Insight Software Consortium | 2.x | Elaborazione di immagini mediche |
| Statsmodels | Sviluppatori Statsmodels | 0.14 | Analisi statistica |
| RAM di sistema | Qualsiasi produttore | 32 GB o superiore | Memoria |
| TensorBoard | 2.15 | Monitoraggio dell'addestramento | |
| TensorFlow | 2.15 | Deep learning | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | Sistema operativo |
| Visual Studio Code | Microsoft | Ultima versione stabile | Sviluppo del codice |
| XGBoost | Sviluppatori XGBoost | 2.1 | Gradient boosting |
Riferimenti
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.