Analisi trascrittomica integrate, bulk e a singola cellula, hanno identificato sei biomarcatori diagnostici legati al metabolismo dell'eme per i cheloidi. La validazione sperimentale ha confermato una disregolazione del recettore 1 per il virus della leucemia felina del sottogruppo C (FLVCR1) nei fibroblasti cheloidei, mentre il docking molecolare ha individuato la (+)-gallocatechina come un composto potenzialmente in grado di interagire con FLVCR1, meritevole di ulteriori indagini funzionali.
Articolo di ricerca
Identificazione di biomarcatori correlati al metabolismo dell'eme nei cheloidi mediante analisi trascrittomica e fibroblasti umani in coltura
In questo articolo
Sommario
Abstract
Il cheloide è un disturbo fibroproliferativo caratterizzato da elevata ricorrenza e patogenesi poco chiara, per il quale mancano target terapeutici efficaci. Evidenze recenti suggeriscono che un riprogrammamento metabolico, in particolare nel metabolismo dell'eme, possa favorire la fibrosi. Questo studio indaga il ruolo del metabolismo dell'eme, concentrandosi sul recettore 1 del virus della leucemia felina del sottogruppo C (FLVCR1), nella patogenesi del cheloide, esplorandone il potenziale diagnostico e terapeutico. Sono stati analizzati dataset di RNA-seq su popolazione cellulare omogenea e dati di RNA-seq a singola cellula (scRNA-seq). Mediante analisi di espressione differenziale, modelli di selezione e riduzione assoluta minima (LASSO) e modelli di random forest (RF) sono stati identificati biomarcatori diagnostici associati al metabolismo dell'eme. Sono state inoltre effettuate analisi sull'infiltrazione immunitaria, mappatura a singola cellula, costruzione di reti di microRNA (miRNA) e docking molecolare con composti della medicina tradizionale cinese. Sono stati identificati sei biomarcatori correlati al metabolismo dell'eme, che formano un nomogramma diagnostico ad alta accuratezza. FLVCR1, arricchito nelle cellule endoteliali e nei melanociti, mostra una correlazione negativa con le cellule T helper follicolari, suggerendo un dialogo immunometabolico. L'analisi della rete regolatoria dei miRNA ha rivelato cinque miRNA che bersagliano congiuntamente tutti e sei i biomarcatori. Il docking molecolare ha identificato la (+)-gallocatechina come ligando di FLVCR1 con elevata affinità. Questi risultati indicano un'associazione tra il metabolismo dell'eme mediato da FLVCR1 e alterazioni immunitarie nella patogenesi del cheloide. Il pannello di biomarcatori ha mostrato un potenziale diagnostico esplorativo, e la (+)-gallocatechina è emersa come composto candidato in grado di interagire con FLVCR1, richiedente ulteriori conferme. Questo studio ridefinisce il cheloide all'interno dello spettro metabo-fibrotico e propone un intervento metabolico-immunitario come nuova strategia terapeutica.
Introduzione
Il cheloide, un disturbo fibroproliferativo caratterizzato da un'eccessiva deposizione della matrice extracellulare che si estende oltre i confini della lesione cutanea originaria, colpisce dal 4% al 16% della popolazione mondiale, con una prevalenza notevolmente più elevata tra individui di origine africana, asiatica e ispanica1,2. Nonostante la sua natura istologica benigna, il cheloide provoca un notevole carico fisico e psicosociale a causa di prurito persistente, dolore, contrattura funzionale e difformità estetica. Le attuali modalità terapeutiche, tra cui corticosteroidi intralesionali, escissione chirurgica, radioterapia e terapia laser, rimangono subottimali, con tassi di recidiva superiori al 50% dopo terapia monodose3,4,5. Questo stallo terapeutico evidenzia una lacuna fondamentale nella comprensione della patogenesi del cheloide, in particolare riguardo ai fattori iniziali che innescano e mantengono la cascata fibrotica al di là della segnalazione profibrotica canonica.
La ricerca contemporanea si è concentrata principalmente su vie canoniche come la segnalazione TGF-β/Smad e l'attivazione anomala dei fibroblasti6,7,8. Sebbene l'infiltrazione di cellule immunitarie—in particolare macrofagi polarizzati verso il fenotipo M2, cellule T regolatorie e cellule dendritiche disregolate—sia stata documentata nei tessuti cheloidei9,10, tali studi considerano in larga misura le alterazioni immunitarie come conseguenze secondarie della disfunzione dei fibroblasti piuttosto che come regolatori primari. In modo critico, i programmi metabolici che potrebbero modulare attivamente questa interazione immunofibrotica rimangono completamente inesplorati nella patogenesi del cheloide11,12,13. Questa lacuna conoscitiva è sorprendente, alla luce di nuovi paradigmi emergenti nelle malattie fibrotiche in cui la riorganizzazione metabolica agisce come regolatore principale del rimodellamento tissutale.
La riprogrammazione metabolica è emersa di recente come un nodo centrale nella fibrogenesi in diversi sistemi organici. Nella fibrosi polmonare ed epatica, un'omeostasi dell'eme alterata—dovuta a un'espressione modificata di trasportatori, scavenger o enzimi biosintetici—induce stress ossidativo, ferroptosi e infiammazione sterile che promuovono direttamente il deposito di collagene14. L'accumulo di eme attiva l'inflammasoma NLRP3, inducendo l'attivazione dei fibroblasti, mentre la carenza del recettore del virus della leucemia felina del sottogruppo C 1 (FLVCR1) aggrava la fibrosi tissutale a causa di una tossicità dell'eme non risolta. Questi risultati collocano il metabolismo dell'eme non semplicemente come un processo di mantenimento cellulare, ma come un centro di segnalazione dinamico in grado di innescare cascate fibrotiche—un paradigma che non è ancora stato testato nei disturbi cutanei fibroproliferativi.
La plausibilità di una immunomodulazione mediata dall'eme è ulteriormente supportata da evidenze meccanicistiche provenienti da modelli di cancro e di infiammazione cronica. L'eme svolge la funzione di molecola segnale che modula direttamente il destino delle cellule immunitarie: promuove la polarizzazione da macrofagi M1 a M2 attraverso il segnale TLR4/NF-κB15, influenza la differenziazione dei linfociti T mediante repressione trascrizionale mediata da Bach216 e regola in modo critico la maturazione delle cellule dendritiche tramite l'esportazione dell'eme dipendente da FLVCR117,18. In particolare, FLVCR1, un trasportatore di eme a livello della membrana plasmatica essenziale per l'omeostasi cellulare dell'eme, è stato recentemente associato allo sviluppo delle cellule immunitarie e alla disfunzione endoteliale19. Queste evidenze convergenti collocano FLVCR1 come un plausibile nodo molecolare che collega il disordine metabolico dell'eme al rimodellamento immunitario patologico, un'ipotesi con profonde implicazioni nella patogenesi dei cheloidi, considerando il loro caratteristico microambiente ricco di cellule immunitarie.
Nonostante i notevoli progressi nella comprensione della comunicazione tra eme e sistema immunitario in altri contesti patologici, rimane completamente inesplorato se un metabolismo dell'eme deregolato possa fungere da fattore iniziale a monte che innescchi o amplifichi il panorama immunitario patologico nei cheloidi. Questa fondamentale lacuna conoscitiva richiede un'indagine urgente per diverse ragioni interconnesse: i cheloidi condividono caratteristiche patologiche distintive—tra cui infiammazione persistente e stress ossidativo—con disturbi fibrotici di origine metabolica come la fibrosi polmonare ed epatica, suggerendo una possibile comune base nei meccanismi regolatori sottostanti. Il sistema di esportazione dell'eme centrato su FLVCR1 è stato validato meccanicisticamente in tessuti non cutanei come regolatore diretto di funzioni immunitarie chiave, come la polarizzazione dei macrofagi e la maturazione delle cellule dendritiche, fornendo una solida base teorica per la sua estensione all'immunopatologia del cheloide20. Ancor più importante, il targeting di questo asse metabolismo-immunità offre un'opportunità innovativa per andare oltre le attuali terapie sintomatiche, che semplicemente sopprimono gli effetti fibrotici a valle, consentendo potenzialmente interventi precoci all'origine metabolica della progressione della malattia21.
Sulla base di questa logica, abbiamo formulato l'ipotesi che una disregolazione centrata su FLVCR1 del metabolismo dell'eme rimodelli attivamente il microambiente immunitario, favorendo la patogenesi del cheloide. Per validare sistematicamente questa ipotesi, abbiamo integrato analisi trascrittomiche bulk e single-cell in un approccio articolato su più livelli: innanzitutto, abbiamo identificato e convalidato biomarcatori diagnostici associati al metabolismo dell'eme nei tessuti cheloidei mediante algoritmi di apprendimento automatico e verifica su coorti indipendenti; successivamente, abbiamo risolto i modelli spaziali di espressione di questi biomarcatori in diversi compartimenti cellulari—compresi cellule endoteliali, fibroblasti, melanociti e sottogruppi immunitari—attraverso un mappaggio con risoluzione single-cell; in seguito, ne abbiamo delineato le correlazioni quantitative con specifiche popolazioni di cellule immunitarie al fine di stabilire collegamenti funzionali tra immunità e metabolismo; infine, abbiamo costruito una rete regolatoria di microRNA (miRNA) centrata su FLVCR1 ed effettuato docking molecolare con composti della medicina tradizionale cinese per identificare potenziali punti d'intervento terapeutico. Questa indagine completa non solo rivela un asse precedentemente sconosciuto tra metabolismo dell'eme e sistema immunitario nella patogenesi del cheloide, ma fornisce anche un pannello di biomarcatori clinicamente rilevante, con potenziale sia diagnostico che terapeutico per questo disturbo fibroproliferativo di difficile gestione.
Protocollo
L'approvazione etica e il consenso informato non erano applicabili per questo studio poiché tutti i dati sono stati ottenuti da database pubblicamente disponibili, inclusi il Gene Expression Omnibus (GEO), e non sono stati coinvolti direttamente né soggetti umani identificabili né animali.
Acquisizione dei dati e preelaborazione
I geni associati al metabolismo dell'eme sono stati ottenuti dal Molecular Signatures Database (MSigDB; vedere la Tabella dei Materiali e la Tabella Supplementare S1), inclusi i set genici da REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma e HALLMARK_Heme_Metabolism. Tutti i dataset analizzati in questo studio sono stati ottenuti da fonti pubblicamente disponibili. Due dataset di microarray per l'espressione genica su larga scala sono stati recuperati dal database Gene Expression Omnibus (GEO): GSE44270, composto da 18 campioni di cheloide e 14 campioni di cute normale, e GSE7890, composto da 10 campioni di cheloide e 9 campioni di cute normale. GSE44270 e GSE7890 sono stati generati rispettivamente sulle piattaforme GPL6244 e GPL570. I file di matrice delle serie e le corrispondenti informazioni sui campioni sono stati scaricati e importati nell'ambiente R. Poiché i valori di espressione nei file di matrice delle serie erano già stati preelaborati e normalizzati dai soggetti che avevano sottomesso i dati originali, non è stata effettuata alcuna ulteriore trasformazione log2 né normalizzazione tra i campioni. I due dataset sono stati elaborati separatamente e non sono stati uniti poiché sono stati generati su piattaforme di microarray differenti. I dataset sono stati preelaborati come descritto di seguito (vedere la Tabella dei Materiali). Le sonde geniche sono state associate ai corrispondenti simboli genici, e sono state escluse le sonde che non presentavano annotazioni geniche o che corrispondevano a più geni. Per i geni con più set di sonde, il valore di espressione è stato assegnato in base al livello di espressione rilevato più alto. Inoltre, sono stati scaricati ed elaborati i dati di sequenziamento dell'RNA a singola cellula (scRNA-seq) da GSE163973, contenenti tre campioni di cheloide, seguendo gli standard di controllo qualità definiti nello studio originale.
Selezione e validazione di marcatori diagnostici legati al metabolismo dell'emina nel cheloide
Per identificare geni associati al metabolismo dell'eme differenzialmente espressi nel cheloide, è stato applicato il test della somma dei ranghi di Wilcoxon a GSE44270 utilizzando la funzione R wilcox.test, con una soglia di significatività di P < 0,05. Per identificare potenziali marcatori diagnostici per il cheloide, sono stati impiegati due modelli di apprendimento automatico: foresta casuale (RF) e regressione logistica con operatore di riduzione e selezione assoluta minima (LASSO). L'analisi della foresta casuale è stata eseguita con un seme casuale pari a 1 per garantire la riproducibilità (vedere la Tabella dei Materiali). Il modello è stato costruito utilizzando 500 alberi (ntree = 500) e l'importanza dei geni è stata valutata in base alla diminuzione media dell'impurità del nodo (IncNodePurity). Sono stati selezionati come biomarcatori candidati derivati dalla foresta casuale i geni con valori di importanza superiori a 0,3. La regressione logistica LASSO è stata eseguita con α = 1 e sono stati valutati 50 valori di lambda durante l'addestramento del modello (vedere la Tabella dei Materiali). Il parametro di penalizzazione ottimale è stato determinato mediante validazione incrociata a cinque ripetizioni con la funzione cv.glmnet, con risposta binomiale. Sono stati mantenuti come candidati selezionati da LASSO i geni con coefficienti di regressione diversi da zero. Infine, l'intersezione dei geni identificati mediante foresta casuale e regressione LASSO è stata considerata come la firma genica diagnostica finale. La firma genica diagnostica finale è stata valutata utilizzando un modello basato su nomogramma. La selezione di tutte le caratteristiche e la stima dei parametri del modello sono state effettuate esclusivamente nel gruppo di scoperta (GSE44270) e la firma di sei geni così ottenuta è stata ulteriormente valutata nel gruppo di convalida indipendente (GSE7890). Le prestazioni diagnostiche del nomogramma sono state valutate calcolando l'area sotto la curva caratteristica operativa del ricevitore (AUC). Per esaminare la stabilità del modello, l'analisi ha incluso una validazione incrociata a cinque ripetizioni e 1.000 iterazioni di ricampionamento bootstrap, dalle quali è stata derivata un'AUC corretta per l'ottimismo. L'analisi della curva decisionale (DCA) è stata quindi utilizzata per stimare il potenziale beneficio netto del nomogramma; tuttavia, questo risultato è stato interpretato con cautela a causa della ridotta dimensione del campione.
Infiltrazione delle cellule immunitarie e analisi della correlazione
L'arricchimento delle cellule immunitarie è stato valutato mediante analisi di arricchimento di set genici su singolo campione (ssGSEA) (vedere la Tabella dei Materiali). La matrice di firma delle cellule immunitarie è stata ottenuta da uno studio pubblicato in precedenza da Charoentong et al.22 e conteneva 782 geni marcatore rappresentanti 28 popolazioni di cellule immunitarie adattative e innate. L'analisi è stata eseguita utilizzando un kernel gaussiano sui valori di espressione microarray normalizzati e continui. È stato richiesto un numero minimo di geni per set pari a 10 dopo l'abbinamento dei geni marcatore alla matrice di espressione, e i punteggi ssGSEA risultanti sono stati normalizzati. Tutte le altre impostazioni sono state mantenute ai valori predefiniti. Successivamente, sono stati calcolati i coefficienti di correlazione di Pearson per valutare le relazioni tra i punteggi di arricchimento delle cellule immunitarie e l'espressione genica diagnostica. La matrice di correlazione risultante è stata visualizzata come grafico di correlazione, e alcune associazioni selezionate sono state ulteriormente rappresentate come grafici a lecca-lecca (vedere la Tabella dei Materiali).
Elaborazione e analisi dei dati di sequenziamento dell'RNA a singola cellula
I dati di sequenziamento dell'RNA a singola cellula sono stati ottenuti da GSE163973 e solo i tre campioni di cicatrice cheloide, KF1, KF2 e KF3, sono stati inclusi nell'analisi attuale. I dati di espressione sono stati importati e processati come descritto di seguito (vedere la Tabella dei Materiali). Sono state escluse le cellule con meno di 200 o più di 6.000 conteggi totali di identificatori molecolari unici (UMI) e sono stati rimossi i doppietti previsti. I conteggi di espressione genica per ciascuna cellula sono stati normalizzati rispetto all'espressione cellulare totale, moltiplicati per un fattore di scala di 10.000 ed espressi in forma logaritmica. La variazione associata al lotto è stata eliminata durante la normalizzazione dei dati e i residui normalizzati risultanti sono stati utilizzati per le analisi successive. Sono stati selezionati i primi 2.000 geni altamente variabili in base alla loro espressione media e dispersione, e su di essi è stata eseguita un'analisi delle componenti principali. I primi 15 componenti principali sono stati utilizzati per costruire un grafo di vicini più prossimi (k-nearest-neighbor) basato sulle distanze euclidee, successivamente convertito in un grafo di vicini comuni (shared nearest-neighbor). Le cellule sono state raggruppate con l'algoritmo Louvain a una risoluzione di 0,8 e l'approximazione uniforme della proiezione su varietà (uniform manifold approximation and projection) è stata eseguita utilizzando gli stessi 15 componenti principali. I tipi cellulari sono stati annotati secondo le definizioni di tipo cellulare riportate nello studio originale e le annotazioni risultanti sono state registrate nel campo dei metadati. Le annotazioni dei tipi cellulari e le assegnazioni dei cluster sono state visualizzate sulle coordinate dell'approximazione uniforme della proiezione su varietà e l'espressione genica diagnostica è stata mostrata nei diversi popolamenti cellulari annotati.
Costruzione della rete regolatoria miRNA–mRNA
La rete di regolazione miRNA-mRNA è stata costruita come descritto di seguito (vedere la Tabella dei Materiali). È stato selezionato Homo sapiens come organismo e gli identificatori genici sono stati forniti come simboli ufficiali dei geni. I geni candidati sono stati inviati al modulo Interazioni Gene-miRNA, e TarBase v9.0 è stato selezionato come database di interazioni. TarBase contiene interazioni di regolazione miRNA-gene validate sperimentalmente. Per la costruzione della rete sono state mantenute solo le interazioni miRNA-mRNA supportate sperimentalmente che coinvolgevano i geni candidati in ingresso, mentre sono state escluse le interazioni predette ma prive di evidenza sperimentale. Non è stata impostata alcuna soglia aggiuntiva di punteggio di affidabilità.
Screening virtuale basato sulla struttura e analisi del docking molecolare
È stata eseguita una selezione virtuale per individuare i ligandi candidati da una libreria di composti contro la FLVCR1 umana (proteina correlata al recettore del virus della leucemia felina, sottogruppo C 1; vedere la Tabella dei Materiali) utilizzando un flusso di lavoro di screening virtuale basato sulla struttura (SBVS). La struttura tridimensionale della FLVCR1 umana è stata recuperata dal Protein Data Bank (PDB ID: 8UBZ). Questa struttura rappresenta la FLVCR1 umana legata alla colina, determinata mediante microscopia crioelettronica a singole particelle con una risoluzione globale di 3,02 Å (accessione EMDB: EMD-42110). La struttura determinata sperimentalmente è stata scelta perché contiene la conformazione della FLVCR1 con substrato legato e fornisce quindi informazioni strutturali utili a definire la cavità di legame del ligando fisiologicamente rilevante. Durante la preparazione del recettore, le molecole di colina (CHT) e emisuccinato di colesterolo (Y01) risolte insieme alla struttura sono state mantenute per preservare l'ambiente strutturale circostante la regione di ingresso del substrato e di legame del ligando. Lo spazio di ricerca per il docking è stato definito attorno alla cavità di legame del substrato/ligando della FLVCR1, comprendendo la regione di legame della colina risolta insieme alla struttura. La griglia è stata centrata alle coordinate x = 160,587 Å, y = 160,613 Å e z = 160,484 Å. Le dimensioni della scatola di docking sono state impostate a [X × Y × Z Å] per garantire una copertura adeguata della cavità di legame del substrato e dei residui circostanti. I composti candidati sono stati successivamente posizionati mediante docking in questa regione di legame predefinita. Le conformazioni ottenute dal docking sono state ordinate in base alle affinità di legame previste, con punteggi di docking più negativi che indicano interazioni previste più favorevoli tra il ligando e la FLVCR1. I composti con i punteggi più alti sono stati selezionati per ulteriori analisi della modalità di legame e delle interazioni proteina-ligando.
Simulazione di dinamica molecolare e calcolo dell'energia libera di legame MM/GBSA
È stata utilizzata una simulazione di dinamica molecolare (MD) per esaminare ulteriormente il complesso proteina–ligando predetto (vedere la Tabella dei Materiali). La topologia del ligando è stata preparata assegnando i parametri del General Amber Force Field (GAFF) e incorporando cariche basate sul potenziale elettrostatico ristretto (RESP). Il complesso è stato quindi descritto mediante il campo di forze Amber99SB-ILDN, posizionato in un modello d'acqua TIP3P (trasferibile con potenziale intermolecolare a 3 punti) e neutralizzato con tre ioni Na⁺. Dopo la minimizzazione dell'energia mediante il metodo del gradiente più ripido, il sistema è stato equilibrato per 100 ps nell'ensemble a numero costante di particelle, volume e temperatura e per altri 100 ps nell'ensemble a numero costante di particelle, pressione e temperatura, con 100.000 passi in ciascuna fase. Successivamente è stata effettuata una fase di produzione della durata di 100 ns a 300 K e 1 bar, utilizzando un passo temporale di 2 fs. Alla traiettoria risultante sono stati applicati analisi di deviazione quadratica media (RMSD), fluttuazione quadratica media (RMSF), raggio di girazione (Rg), area superficiale accessibile al solvente (SASA), persistenza dei legami a idrogeno ed energia libera di legame calcolata con il metodo della meccanica molecolare/area superficiale generalizzata di Born (MM/GBSA).
Coltura cellulare
La linea cellulare di fibroblasti dermici umani normali NHDF e la linea cellulare di fibroblasti primari di cheloide PKF sono state coltivate in un mezzo di crescita per fibroblasti integrato con siero fetale bovino al 2%, fattore di crescita fibroblastico basico umano ricombinante (1 ng/mL) e insulina (5 µg/mL). Entrambe le linee cellulari sono state mantenute in un incubatore umidificato a 37 °C con 5% di CO₂ e sono state sottoposte a passaggio al raggiungimento di una confluenza dell'80–90%.
Analisi di Western blot
Le proteine totali sono state isolate da cellule NHDF e PKF utilizzando un buffer di lisi composto da saggio di immunoprecipitazione radioimmunologica, fluoruro di fenilmetilsulfonile, un cocktail di inibitori delle proteasi e inibitori delle fosfatasi. La concentrazione proteica è stata determinata mediante saggio con acido bicinconinico; successivamente, quantità uguali di proteine sono state separate mediante elettroforesi su gel di poliacrilammide in presenza di dodecilsolfato di sodio e trasferite su una membrana di fluoruro di polivinilidene. La membrana è stata bloccata per 90 minuti a temperatura ambiente con latte in polvere scremato al 5% preparato in soluzione salina tamponata con Tween/Tris, quindi incubata tutta la notte a 4 °C con anticorpi primari diretti contro FLVCR1 (policlonale da coniglio, 1:1.000) e GAPDH (monoclonale da mouse, 1:20.000). Il giorno seguente, è stata effettuata l'incubazione con l'anticorpo secondario per 90 minuti a temperatura ambiente. Le intensità delle bande sono state misurate con ImageJ e i livelli proteici relativi sono stati normalizzati rispetto al controllo interno GAPDH. Per ogni saggio di immunoblotting occidentale sono stati utilizzati almeno tre replicati biologici indipendenti.
Analisi di retrotrascrizione quantitativa in tempo reale con PCR fluorescente (qRT-PCR)
L'RNA totale è stato preparato da cellule NHDF e PKF utilizzando il kit di riferimento. Successivamente, il cDNA è stato generato con il mix di sintesi del cDNA di riferimento per qPCR (con dsDNase). La qRT-PCR è stata eseguita su un sistema di PCR in tempo reale e l'espressione di FLVCR1 è stata misurata utilizzando il mix rapido SYBR Green di riferimento. L'mRNA di GAPDH è stato utilizzato come riferimento interno per la normalizzazione. Ogni reazione di qRT-PCR è stata eseguita in triplicato tecnico e i livelli relativi di mRNA sono stati calcolati con il metodo 2−ΔΔCt. Ogni esperimento è stato ripetuto in modo indipendente almeno tre volte e le sequenze dei primer sono riportate in Tabella S2 Supplementare.
Analisi statistica
Le differenze tra i gruppi sono state valutate con il test della somma dei ranghi di Wilcoxon e i valori sono riportati come media ± deviazione standard (SD). Le associazioni tra variabili continue sono state analizzate utilizzando il coefficiente di correlazione di Pearson. I risultati con P < 0,05 sono stati considerati statisticamente significativi. I livelli di significatività sono indicati come ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; e ****, P < 0,0001.
Risultati
Selezione di biomarcatori diagnostici candidati per il cheloide mediante un algoritmo di apprendimento automatico
In questo studio sono stati inclusi un totale di 283 geni associati al metabolismo dell'eme. L'analisi dell'espressione differenziale del dataset GSE44270, che confronta tessuti di cicatrice cheloide e tessuti cutanei normali, ha identificato 25 geni espressi in modo significativamente differente (Figura 1A e Tabella Supplementare S3). Per effettuare un'ulteriore selezione di biomarcatori associati alla malattia, la regressione LASSO ha identificato 9 geni candidati (Figura 1B,C e Tabella Supplementare S3), mentre l'algoritmo random forest (RF) ha selezionato 11 geni con elevata importanza predittiva (Figura 1D e Tabella Supplementare S3). L'intersezione tra i risultati di LASSO e RF è stata visualizzata mediante un diagramma di Venn, che ha evidenziato sei biomarcatori principali, ovvero FLVCR1, TMCC2, EIF2AK1, XK, HPX e KEL (Figura 1E e Tabella Supplementare S3). L'analisi della curva ROC (receiver operating characteristic) nella coorte GSE44270 ha dimostrato un'adeguata capacità diagnostica per tutti e sei i biomarcatori, con valori di AUC pari a 0,8016 per FLVCR1, 0,7063 per TMCC2, 0,7817 per EIF2AK1, 0,7460 per XK, 0,7500 per HPX e 0,7857 per KEL (Figura 1F). Sulla base di questi sei biomarcatori, è stato successivamente costruito un nomogramma diagnostico per il cheloide utilizzando il pacchetto rms in R (Figura 1G).
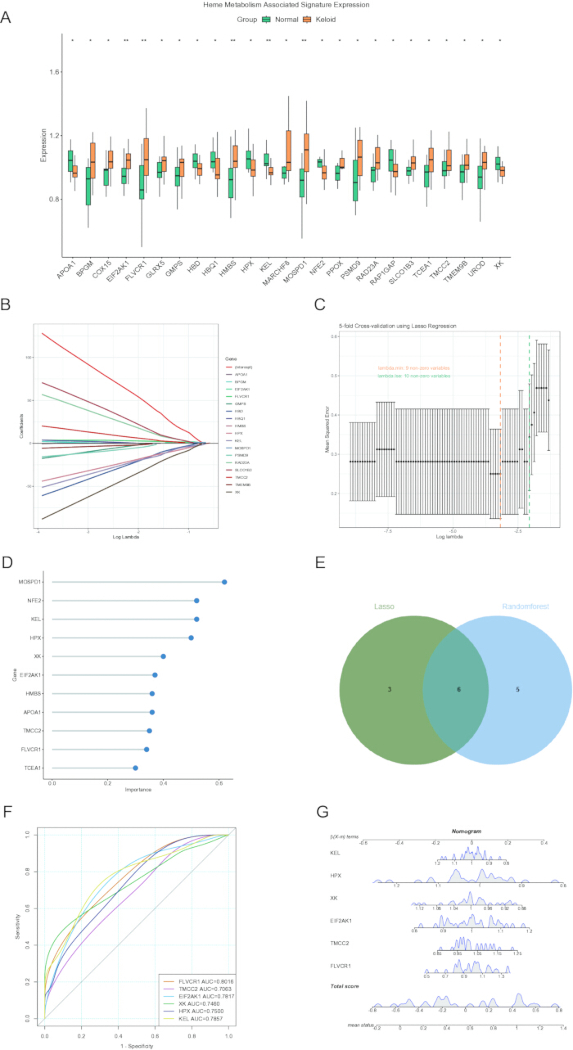
Figura 1: Identificazione di geni candidati associati al metabolismo dell'eme e correlati ai cheloide mediante l'uso di algoritmi di apprendimento automatico. (A) Diagramma a scatola (box plot) che illustra l'espressione differenziale dei geni correlati al metabolismo dell'eme tra tessuti cheloidei e tessuti normali. (B,C) Analisi di regressione logistica LASSO per la selezione di marcatori diagnostici candidati. (D) Biomarcatori candidati selezionati dall'algoritmo RF. (E) Diagramma di Venn che mostra i geni sovrapposti identificati dai due algoritmi di apprendimento automatico. (F) Analisi della curva ROC per valutare le prestazioni diagnostiche dei biomarcatori candidati. (G) Nomogramma per la previsione del cheloide basato sulla firma genica a sei geni. Abbreviazioni: LASSO, operatore di riduzione e selezione assoluta minima; RF, foresta casuale; ROC, caratteristica operativa del ricevitore. Significatività statistica: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; e ****, P < 0,0001. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Le prestazioni predittive del nomogramma diagnostico sono state valutate sia nel gruppo di addestramento (GSE44270) che nel gruppo di validazione (GSE7890). Il modello ha dimostrato un'elevata accuratezza diagnostica, raggiungendo valori di AUC pari a 0,984 (IC 95%: 0,950–1,000) e 0,922 (IC 95%: 0,806–1,000), rispettivamente (Figura 2A,D). Per ulteriormente valutare la robustezza e il potenziale overfitting della firma diagnostica basata su sei geni, sono state effettuate ulteriori analisi di validazione interna nel gruppo di scoperta (GSE44270). La validazione incrociata a cinque ripetizioni ha dimostrato prestazioni discriminative costanti tra i sottoinsiemi, con un valore medio di AUC pari a 0,925, indicando che il modello ha mantenuto prestazioni stabili di classificazione nonostante le variazioni nei campioni di addestramento. Inoltre, la validazione con metodo bootstrap, effettuata su 1.000 iterazioni di ricampionamento, ha prodotto un valore medio di AUC pari a 0,930 (IC 95%: 0,794–1,000). Dopo la correzione per l'eventuale ottimismo derivante dalla dimensione limitata del campione, l'AUC corretta per l'ottimismo è rimasta pari a 0,930, suggerendo che le prestazioni diagnostiche della firma basata su sei geni erano relativamente stabili dopo la validazione interna. Inoltre, l'analisi della curva decisionale (DCA) ha indicato che il nomogramma presentava un beneficio netto potenziale superiore rispetto ad altre strategie diagnostiche in un ampio intervallo di probabilità soglia, anche se questi risultati devono essere interpretati con cautela a causa della limitata dimensione del campione (Figura 2B,E). Inoltre, i campioni di cheloide hanno mostrato punteggi di rischio significativamente più elevati rispetto ai controlli sani sia nel gruppo di addestramento che in quello di validazione (Figura 2C,F), confermando ulteriormente la stabilità e l'affidabilità del modello diagnostico.
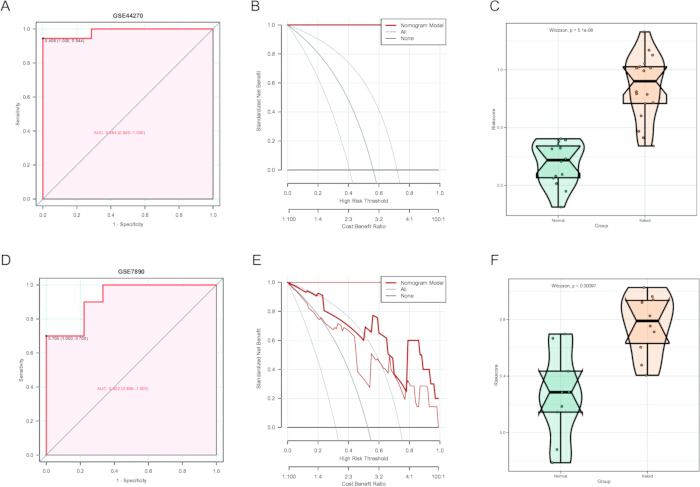
Figura 2: Convalida del nomogramma per la previsione dei cheloidi. (A) Curva ROC per la valutazione delle prestazioni predittive del nomogramma nel dataset GSE44270. (B) DCA per la valutazione dell'utilità clinica del nomogramma in GSE44270. (C) Distribuzione del punteggio di rischio nel confronto tra campioni cheloidei e sani in GSE44270. (D) Curva ROC per la valutazione delle prestazioni predittive del nomogramma nel dataset indipendente GSE7890. (E) DCA per la valutazione dell'utilità clinica del nomogramma in GSE7890. (F) Distribuzione del punteggio di rischio nel confronto tra campioni cheloidei e sani in GSE7890. Abbreviazioni: ROC = caratteristica operativa del ricevitore; DCA = analisi della curva decisionale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
I biomarcatori diagnostici sono associati alle caratteristiche immunitarie del cheloide
Per esplorare la relazione tra i sei biomarcatori diagnostici e il microambiente immunitario, è stata effettuata un'analisi di correlazione per valutare le associazioni tra l'espressione dei biomarcatori e l'infiltrazione delle cellule immunitarie. I risultati hanno rivelato che tutti e sei i biomarcatori erano significativamente associati a diverse popolazioni di cellule immunitarie infiltranti (Figura 3A). In particolare, l'espressione di FLVCR1 era negativamente associata alle cellule T helper follicolari (Figura 3B). TMCC2 mostrava correlazioni positive con le cellule natural killer e le cellule dendritiche attivate, mentre era negativamente correlato alle cellule dendritiche immature e alle cellule B immature (Figura 3C–F). Inoltre, l'espressione di EIF2AK1 era negativamente associata alle cellule natural killer CD56dim (Figura 3G), mentre XK era negativamente associato agli eosinofili (Figura 3H).
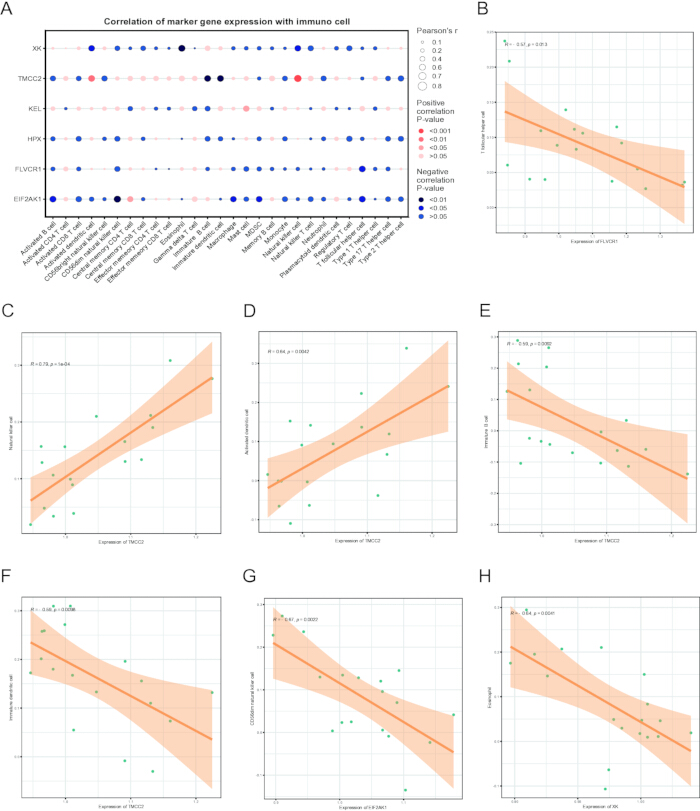
Figura 3: Correlazione tra geni candidati coinvolti nel metabolismo dell'eme e l'infiltrazione di cellule immunitarie. (AMappa termica che mostra le correlazioni tra i geni candidati e le popolazioni di cellule immunitarie. Il rosso indica correlazioni positive, mentre il blu indica correlazioni negative.B). Correlazione tra FLVCR1 espressione e cellule T follicolari helper.C-F) Correlazioni tra TMCC2 espressione e cellule natural killer, cellule dendritiche attivate, cellule dendritiche immature e cellule B immature, rispettivamente. (G) Correlazione tra EIF2AK1 espressione e cellule natural killer CD56dim. (H). Correlazione tra XK espressione e eosinofili. Abbreviazioni: FLVCR1 = recettore per il virus della leucemia felina sottogruppo C 1; TMCC2 = domini transmembrana e a coil-coil 2; EIF2AK1 = chinasi alfa del fattore di inizio della traduzione eucariotica 2; CD56dim = cluster di differenziazione 56 debole Cliccare qui per visualizzare una versione ingrandita di questa figura.
Analisi dei dati del trascrittoma a singola cellula
Per caratterizzare i modelli di espressione dei biomarcatori diagnostici identificati all'interno del microambiente del cheloide, abbiamo analizzato il dataset di sequenziamento dell'RNA a singola cellula GSE163973. Dopo il controllo di qualità e l'integrazione dei dati, sono state mantenute 21.488 cellule di alta qualità per le analisi successive. Sono state escluse le cellule con meno di 200 o più di 6.000 conteggi totali di identificatori molecolari unici (UMI) e i potenziali doppietti sono stati identificati ed eliminati utilizzando il pacchetto DoubletDetection. Sono stati selezionati i 2.000 geni che mostravano la maggiore variabilità di espressione, seguiti da riduzione della dimensionalità e visualizzazione mediante Uniform Manifold Approximation and Projection (UMAP). Sono state identificate complessivamente 10 principali popolazioni cellulari, incluse cellule endoteliali, fibroblasti, fibre muscolari, cheratinociti, cellule immunitarie, cellule endoteliali linfatiche, cellule ghiandolari, cellule neurali, melanociti e una popolazione cellulare non classificata (Figura 4A,B). Il profilo di espressione ha rivelato distinti modelli di distribuzione specifici per tipo cellulare dei biomarcatori diagnostici. FLVCR1 era prevalentemente espresso nelle cellule endoteliali e nei melanociti, mentre EIF2AK1 mostrava un'espressione relativamente elevata nelle cellule neurali, nelle cellule ghiandolari e nei fibroblasti. HPX era principalmente arricchito nei melanociti, mentre KEL mostrava un'espressione predominante nelle cellule ghiandolari (Figura 4C,D).
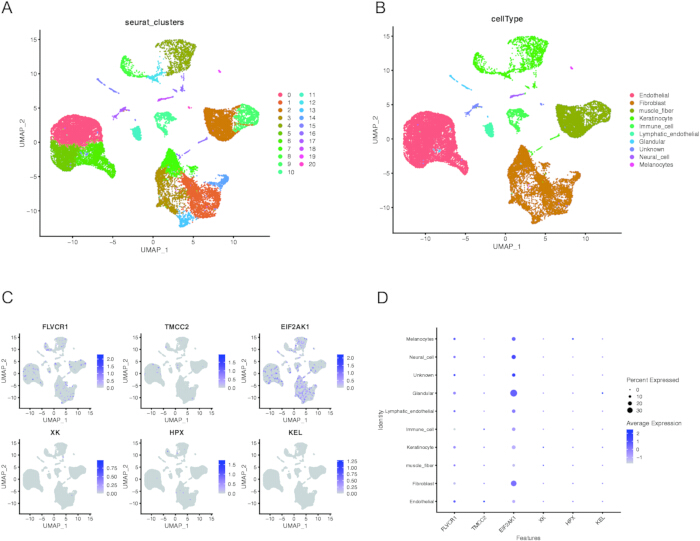
Figura 4: Distribuzione dei biomarcatori diagnostici legati al metabolismo dell'eme nel trascrittoma singola-cellula del cheloide. (A) Grafico UMAP che mostra 21 cluster cellulari composti da 21.488 cellule provenienti da campioni di cheloide. (B) Annotazioni dei tipi cellulari basate sulle annotazioni riportate nello studio originale. (C) Grafici delle caratteristiche che mostrano l'espressione dei biomarcatori diagnostici legati al metabolismo dell'eme in diversi tipi cellulari. (D) Grafico a bolle che mostra i livelli medi di espressione e le percentuali di cellule che esprimono i biomarcatori diagnostici legati al metabolismo dell'eme in diversi tipi cellulari. Abbreviazione: UMAP = uniform manifold approximation and projection. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Identificazione e analisi della rete di interazione di biomarcatori diagnostici candidati
Per esplorare i meccanismi regolatori alla base dei biomarcatori diagnostici candidati, è stata costruita una rete regolatoria miRNA-mRNA. Per migliorare l'affidabilità delle interazioni predette, sono stati identificati i miRNA sovrapposti che bersagliano i biomarcatori candidati. Sono stati ottenuti complessivamente 282 miRNA che interagiscono con i sei biomarcatori diagnostici, e la rete regolatoria risultante è mostrata in Figura 5. In particolare, si prevede che hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p e hsa-miR-26b-5p regolino contemporaneamente tutti e sei i biomarcatori candidati.
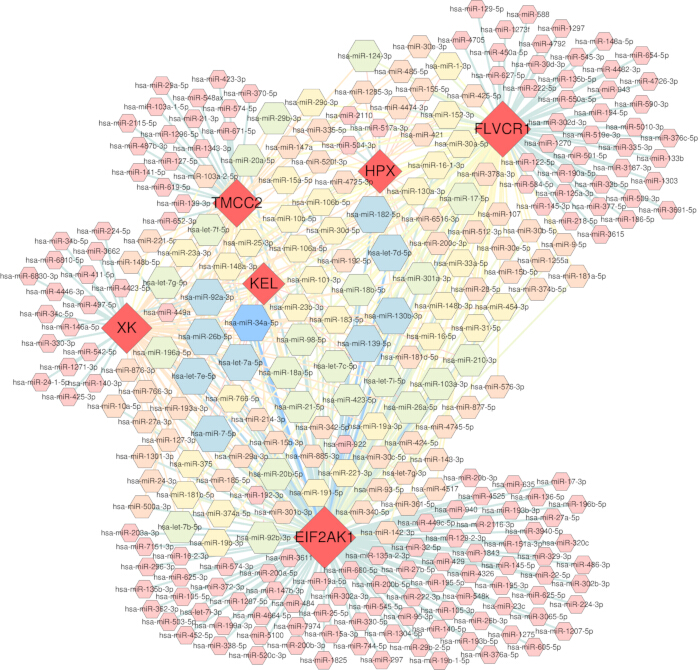
Figura 5: Rete regolatoria di miRNA dei biomarcatori diagnostici associati al metabolismo dell'eme. La rete illustra le relazioni regolatorie tra i sei geni biomarcatori diagnostici (FLVCR1, HPX, TMCC2, KEL, XK e EIF2AK1) e i rispettivi miRNA associati. I nodi genici rappresentano i biomarcatori diagnostici, mentre i nodi circostanti rappresentano i miRNA. I collegamenti indicano interazioni miRNA–mRNA supportate sperimentalmente. Abbreviazioni: FLVCR1 = recettore 1 del virus della leucemia felina del sottogruppo C; HPX = emopesina; TMCC2 = domini transmembrana e a coil-coil 2; KEL = metallo-endopeptidasi Kell; XK = gruppo sanguigno X-linked Kx; EIF2AK1 = chinasi 1 del fattore di inizio della traduzione eucariotica 2 alfa; miRNA = microRNA; mRNA = RNA messaggero. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Convalida sperimentale dell'espressione di FLVCR1 e analisi di docking molecolare di potenziali composti terapeutici
Per convalidare i risultati bioinformatici e confermare la rilevanza funzionale del gene centrale identificato, abbiamo valutato sperimentalmente l'espressione di FLVCR1 in PKF e NHDF. Analisi di qRT-PCR e immunoblotting hanno dimostrato in modo coerente che FLVCR1 era significativamente sovraespresso nei fibroblasti cheloidei rispetto ai controlli normali (Figura 6A–C, Figura Supplementare S1 e Tabella Supplementare S4). Questa espressione cellulare elevata supporta il possibile coinvolgimento di una disregolazione metabolica dell'eme associata a FLVCR1 nella patogenesi del cheloide.
Data la possibile implicazione di FLVCR1 nei cambiamenti immunitari associati al metabolismo dell'eme, abbiamo successivamente cercato di identificare potenziali composti terapeutici in grado di agire direttamente su FLVCR1 per interrompere questo asse patogenetico. È stata effettuata una selezione virtuale ad alto rendimento utilizzando una libreria di composti della medicina tradizionale cinese (TCM) e la struttura proteica preparata. I 20 composti con i punteggi di docking più favorevoli sono stati selezionati per ulteriori valutazioni (Tabella Supplementare S5). In generale, un'energia di legame più bassa indica un'affinità di legame più elevata, e valori di energia di docking inferiori a −5 kcal/mol sono considerati indicativi di interazioni stabili tra ligando e proteina. Tra i composti analizzati, (+)-Gallocatechina, (−)-Epicatechina, (−)-Gallocatechina e Cianidina (cloruro) hanno mostrato affinità di legame favorevoli verso FLVCR1. In particolare, la (+)-Gallocatechina ha mostrato l'interazione più forte con FLVCR1, formando quattro legami a idrogeno con GLU214, ASN245, GLN246 e GLN471, suggerendo una modalità di legame ligando-proteina stabile (Figura 6D–G). Questi risultati indicano la (+)-gallocatechina come un candidato promettente per interventi terapeutici basati su meccanismi mirati a FLVCR1.
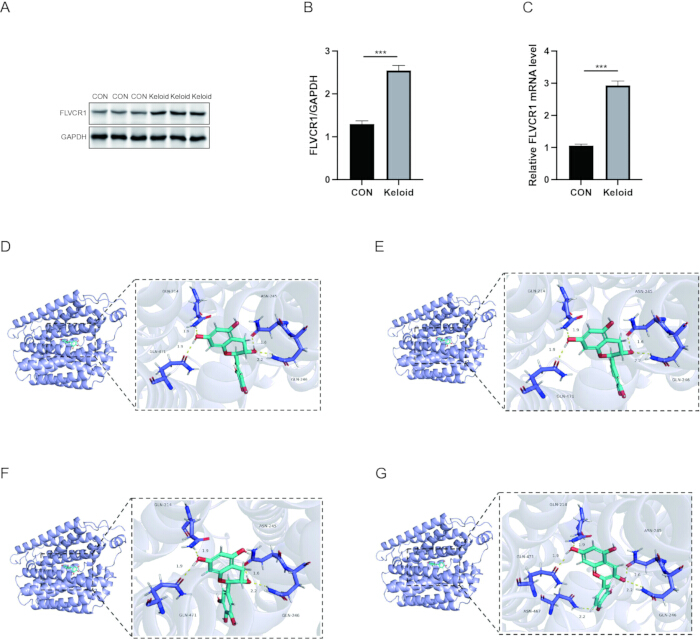
Figura 6: Convalida sperimentale dell'espressione di FLVCR1 e docking molecolare di composti potenziali che bersagliano FLVCR1. (A) Immagini rappresentative di immunoblotting a western che mostrano l'espressione proteica di FLVCR1 in CON e cheloide. GAPDH è stato utilizzato come controllo di caricamento. (B) Quantificazione dei livelli proteici di FLVCR1 normalizzati rispetto a GAPDH. (C) I livelli relativi di espressione dell'mRNA di FLVCR1 in fibroblasti CON e cheloidi sono stati determinati mediante qRT-PCR. GAPDH è stato utilizzato come riferimento interno. (D–G) Rappresentazioni tridimensionali delle modalità di legame previste tra FLVCR1 e composti selezionati di piccole molecole: (D) (+)-Gallocatechina. (E) (-)-Epicatechina. (F) (-)-Gallocatechina. (G) Cianidina (Cloruro). Abbreviazioni: FLVCR1 = recettore 1 del virus della leucosi felina sottogruppo C; CON, controllo; GAPDH, gliceraldeide-3-fosfato deidrogenasi; qRT-PCR, reazione a catena della polimerasi con trascrizione inversa quantitativa; SD, deviazione standard. I dati sono riportati come media ± SD. Significatività statistica: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; e ****, P < 0,0001. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Conferma della stabilità del complesso FLVCR1–(+)-Gallocatechina mediante simulazione di dinamica molecolare
Per esaminare l'affidabilità della modalità di legame ligando-proteina predetta, è stata effettuata una simulazione di dinamica molecolare (MD) per il complesso FLVCR1–(+)-gallocatechina. L'analisi si è concentrata sulla stabilità strutturale del complesso nel tempo e su eventuali alterazioni del comportamento conformazionale della proteina indotte dal legame del ligando, utilizzando RMSD, RMSF, raggio di girazione (Rg), SASA, analisi dei legami idrogeno e calcoli MM/GBSA. L'analisi dell'RMSD (Figura 7A) ha mostrato che sia la proteina aplo che il complesso legato al ligando hanno subito fluttuazioni iniziali nei primi 20 ns, seguite da una graduale stabilizzazione, indicando che i sistemi hanno raggiunto l'equilibrio durante la simulazione. Dopo l'equilibrazione, il valore di RMSD del complesso FLVCR1–(+)-gallocatechina è rimasto al di sotto di 0,2 nm, suggerendo che il legame del ligando abbia contribuito al mantenimento della stabilità strutturale di FLVCR1. L'analisi dell'RMSF (Figura 7B) ha dimostrato che la maggior parte dei residui ha mostrato fluttuazioni limitate per tutta la durata della simulazione, indicando il mantenimento dell'integrità complessiva della proteina, mentre alcune regioni flessibili potrebbero corrispondere a loop coinvolti nell'accomodamento del ligando. Inoltre, i profili stabili di Rg e SASA (Figura 7C,D) hanno indicato che il complesso ha mantenuto una conformazione compatta, senza evidenti espansioni strutturali o variazioni nell'esposizione al solvente. L'analisi dei legami idrogeno (Figura 7E) ha rivelato che il complesso FLVCR1–(+)-gallocatechina ha mantenuto interazioni intermolecolari persistenti, con la formazione di circa 3–4 legami idrogeno durante la simulazione, sostenendo la stabilità dell'associazione ligando-proteina. L'analisi MM/GBSA ha inoltre mostrato che il complesso FLVCR1–(+)-gallocatechina presentava un'energia libera di legame favorevole (ΔGtotal = −34,87 ± 4,13 kcal/mol) (Tabella Supplementare S6). L'analisi della decomposizione energetica ha indicato che le interazioni di van der Waals (ΔVDWAALS = −46,34 ± 2,16 kcal/mol) e le interazioni elettrostatiche (ΔEelec = −14,09 ± 3,45 kcal/mol) sono stati i principali contributi favorevoli al legame, nonostante il contributo sfavorevole dell'energia di solvatazione polare (ΔGsolvation = 25,55 ± 0,74 kcal/mol) (Tabella Supplementare S6). Nel complesso, questi risultati della simulazione di dinamica molecolare hanno dimostrato che la (+)-gallocatechina forma un complesso stabile con FLVCR1 e hanno ulteriormente confermato l'affidabilità della modalità di legame predetta dal docking.
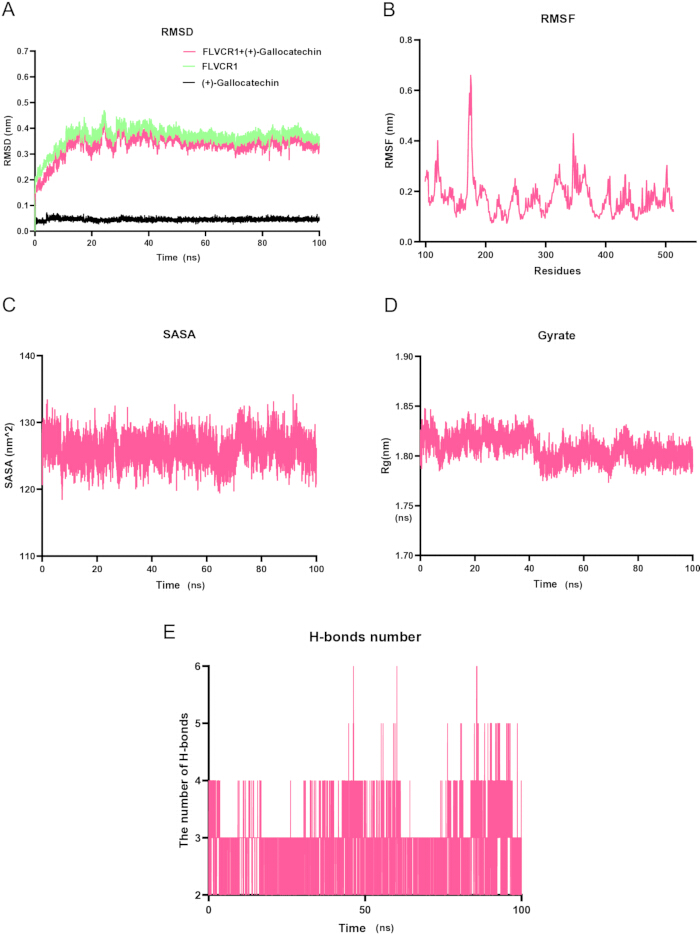
Figura 7: Analisi della simulazione di dinamica molecolare del complesso FLVCR1–(+)-Gallocatechina. (A) Profili RMSD di FLVCR1 in forma aplo e del complesso FLVCR1–(+)-Gallocatechina durante la simulazione di dinamica molecolare di 100 ns. (B) Profilo RMSF che mostra le fluttuazioni a livello di residuo di FLVCR1 durante la simulazione. (C) Profilo SASA che mostra le variazioni dell'area superficiale accessibile al solvente del complesso FLVCR1–(+)-Gallocatechina. (D) Profilo Rg per valutare la compattezza del complesso FLVCR1–(+)-Gallocatechina durante la simulazione. (E) Analisi dei legami a idrogeno che mostra le interazioni intermolecolari dinamiche tra FLVCR1 e (+)-Gallocatechina durante tutta la simulazione. Abbreviazioni: FLVCR1 = recettore 1 del virus della leucemia felina del sottogruppo C; RMSD = deviazione quadratica media; RMSF = fluttuazione quadratica media; SASA = area superficiale accessibile al solvente; Rg = raggio di girazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Disponibilità dei dati:
I set di dati trascrittomici disponibili pubblicamente analizzati in questo studio possono essere consultati tramite il Gene Expression Omnibus (GEO) utilizzando i numeri di accessione GSE44270, GSE7890 e GSE163973. I dati originali generati in questo studio e alla base della validazione sperimentale, inclusi i risultati di qRT-PCR, le immagini originali dei western blot e i dati di quantificazione dei western blot, sono forniti come Figura Supplementare S1, Tabella Supplementare S1, Tabella Supplementare S2, Tabella Supplementare S3 e Tabella Supplementare S4. I risultati del docking molecolare e i dati dell'energia libera di legame calcolati con MM/GBSA sono inoltre disponibili nella Tabella Supplementare S5 e nella Tabella Supplementare S6.
Figura supplementare S1: Dati originali del western blotting.Cliccare qui per scaricare il file.
Tabella supplementare S1: Geni associati al metabolismo dell'emina.Cliccare qui per scaricare il file.
Tabella supplementare S2: Sequenze dei primer dei geni selezionati. Cliccare qui per scaricare il file.
Tabella supplementare S3: Approcci di apprendimento automatico per l'identificazione di potenziali biomarcatori diagnostici nel cheloide. Cliccare qui per scaricare il file.
Tabella supplementare S4: Dati grezzi a supporto della validazione sperimentale dell'espressione di FLVCR1. Cliccare qui per scaricare il file.
Tabella supplementare S5: I 20 principali composti candidati identificati mediante docking molecolare con FLVCR1.Cliccare qui per scaricare il file.
Tabella supplementare S6: Analisi dell'energia libera di legame MM/GBSA del complesso FLVCR1–(+)-Gallocatechina.Cliccare qui per scaricare il file.
Discussione
Questo studio identifica un'associazione potenziale tra un metabolismo dell'eme disregolato, l'espressione di FLVCR1 e i cambiamenti nel microambiente immunitario nella formazione dei cheloidi. Integrando trascrittomica su popolazione cellulare intera e trascrittomica a singola cellula, abbiamo identificato FLVCR1 come un nodo molecolare che collega il deficit nell'esportazione dell'eme a un riprogrammazione immunitaria patologica, collocando il cheloide all'interno dello spettro emergente dei disturbi «metabo-fibrotici»23,24,25. L'importanza potenziale di FLVCR1 è supportata da evidenze convergenti provenienti da diversi livelli analitici. La trascrittomica su popolazione cellulare intera ha rivelato un suo significativo aumento di espressione nei tessuti cheloidei, con elevata capacità diagnostica, mentre la mappatura a risoluzione di singola cellula ha localizzato la sua espressione principalmente nelle cellule endoteliali e nei melanociti, due tipi cellulari implicati in modo critico nella patogenesi del cheloide attraverso angiogenesi aberrante e iperpigmentazione, rispettivamente26,27. In modo particolarmente convincente, l'espressione di FLVCR1 ha mostrato una forte correlazione negativa con le cellule T follicolari helper (Tfh), un sottogruppo linfocitario riconosciuto sempre più per il ruolo nel promuovere un'immunità polarizzata verso il Th2 e il deposito di collagene in microambienti fibrotici28. Studi precedenti hanno dimostrato che l'esportazione dell'eme mediata da FLVCR1 è coinvolta nella maturazione delle cellule dendritiche e nella presentazione dell'antigene29, suggerendo un potenziale legame tra l'omeostasi dell'eme associata a FLVCR1 e la regolazione immunitaria. L'aumento osservato dell'espressione di FLVCR1 e la sua correlazione negativa con l'infiltrazione delle cellule Tfh potrebbero quindi riflettere alterazioni nell'omeostasi immunitaria, che potenzialmente coinvolgono citochine profibrotiche associate alle cellule Tfh come IL-4 e IL-1329,30,31.
Inoltre, l'accumulo intracellulare di eme risultante dalla disfunzione di FLVCR1 probabilmente attiva l'inflammasoma NLRP3 — un meccanismo ben documentato nella fibrosi epatica, in cui l'eme agisce come un pattern molecolare associato al danno (DAMP) che innesca un'infiammazione sterile32,33,34. Tale attivazione dell'inflammasoma promuoverebbe il rilascio di IL-1β/IL-18, inducendo la polarizzazione dei macrofagi verso il fenotipo M2 attraverso il segnale TLR4/NF-κB e creando un circuito autoperpetuante di stress ossidativo e attivazione dei fibroblasti35,36. Nel complesso, questi dati supportano FLVCR1 come biomarcatore candidato e possibile contributore alle interazioni tra metabolismo dell'eme e sistema immunitario nel cheloide; tuttavia, la cascata meccanicistica proposta richiede una validazione funzionale diretta. Il trattenimento intracellulare di eme induce inizialmente danni ossidativi e attiva l'inflammasoma, che successivamente porta a una disfunzione delle cellule dendritiche, favorendo così uno spostamento verso le cellule T helper follicolari e risposte immunitarie di tipo Th2; questa deviazione immunitaria promuove ulteriormente la polarizzazione dei macrofagi verso il fenotipo M2, determinando infine l'attivazione dei fibroblasti e la progressione della fibrogenesi.
Oltre al ruolo isolato di FLVCR1, la disregolazione sinergica di tutti e sei i biomarcatori rivela un collasso coordinato dell'omeostasi dell'eme attraverso multipli nodi regolatori. TMCC2, positivamente correlato con le cellule dendritiche attivate ma negativamente associato ai sottoinsiemi immaturi, potrebbe rappresentare un meccanismo compensativo che tenta di ripristinare la competenza immunitaria in condizioni di stress da eme37,38. EIF2AK1, altamente espresso nei fibroblasti cheloidei e nelle cellule ghiandolari, agisce come un sensore molecolare diretto dell'eccesso di eme che fosforila eIF2α per sopprimere globalmente la sintesi proteica mentre regola selettivamente verso l'alto i geni di risposta allo stress39,40,41. Questo colloca EIF2AK1 come un ponte critico che traduce l'accumulo di eme in un cambiamento fenotipico dei fibroblasti—spiegando potenzialmente perché i fibroblasti cheloidei mostrano una resistenza accentuata all'apoptosi e una produzione esagerata di collagene42,43,44. HPX, il principale scavenger plasmatico dell'eme, ha mostrato un'espressione limitata nei melanociti, suggerendo un tentativo autonomo della cellula di tamponare la tossicità dell'eme all'interno di compartimenti ricchi di pigmento45,46,47. La disregolazione contemporanea di XK e KEL implica ulteriormente i meccanismi di gestione dell'eme della linea eritroide nella patogenesi del cheloide—un risultato con implicazioni interessanti per comprendere perché i cheloidi si sviluppano frequentemente in siti di trauma con microemorragie. Piuttosto che considerare questi sei geni come marcatori indipendenti, interpretiamo la loro disregolazione collettiva come evidenza di un fallimento a livello sistemico del compartmentalizzazione dell'eme, in cui l'esportazione compromessa (FLVCR1), il rilevamento (EIF2AK1), lo smaltimento (HPX) e il traffico di membrana (XK, KEL) convergono per creare un microambiente ricco di eme e pro-fibrotico.
Questo modello metabolico-immunitario è ulteriormente rafforzato da un livello epigenetico convincente: abbiamo identificato una rete ceRNA in cui la downregolazione di specifici miRNA (ad esempio, la famiglia let-7 e miR-34a-5p) potrebbe simultaneamente dereprimere vie metaboliche legate al metabolismo dell'eme e vie fibrotiche, sebbene questo modello regolatorio richieda ulteriore validazione23. La risoluzione spaziale offerta dall'analisi single-cell illumina la coreografia cellulare alla base di questo processo, dimostrando come la disfunzione metabolica nelle cellule strutturali semini attivamente un microambiente ricco di cellule immunitarie attraverso un segnale paracrino mediato dall'eme, trasformando così la nostra comprensione da una prospettiva di "tessuto bulk" a un modello dinamico di ecosistema cellulare48,49,50. L'accumulo di eme nelle cellule endoteliali potrebbe favorire la fuoriuscita vascolare e l'extravasazione dei leucociti tramite l'induzione dell'eme ossigenasi-1 e l'upregolazione delle molecole di adesione, contribuendo così alla formazione del microambiente ricco di cellule immunitarie osservato nei cheloidi51,52,53. Contemporaneamente, l'espressione di FLVCR1 nei melanociti è in linea con le osservazioni cliniche di iperpigmentazione nei cheloidi e suggerisce vulnerabilità metaboliche condivise tra le vie pigmentarie e fibrotiche—probabilmente mediate da risposte allo stress ossidativo54,55. Questa mappatura spaziale trasforma la nostra comprensione da una prospettiva di "tessuto bulk" a un modello di ecosistema cellulare in cui la disfunzione metabolica nelle cellule strutturali (endotelio, melanociti) modula attivamente il comportamento delle cellule immunitarie attraverso un segnale paracrino mediato dall'eme.
Dal punto di vista traslazionale, il nostro nomogramma che integra tutti e sei i biomarcatori ha raggiunto un'accuratezza diagnostica quasi perfetta, superando in modo sostanziale qualsiasi singolo marcatore e dimostrando un chiaro beneficio clinico netto attraverso l'analisi della curva decisionale. In modo ancora più suggestivo, il docking molecolare ha identificato la (+)-gallocatechina—un polifenolo bioattivo abbondante nel tè verde e nelle erbe medicinali tradizionali cinesi—come un ligando di alta affinità per FLVCR1, capace di formare legami a idrogeno stabili con GLU-214, ASN-245, GLN-246 e GLN-471. Questa scoperta è particolarmente convincente alla luce di precedenti evidenze secondo cui le catechine sopprimono la sintesi del collagene, inibiscono il rilascio del fattore di crescita trasformante-beta 1 e attenuano lo stress ossidativo nei fibroblasti del cheloide56,57,58. Ipotesizziamo che la (+)-gallocatechina possa stabilizzare la conformazione di FLVCR1 per potenziare la capacità di esportazione dell'eme, interrompendo così il trigger metabolico della fibrosi alla sua origine—una strategia fondamentalmente diversa dalle attuali terapie che semplicemente sopprimono la produzione di collagene a valle. Se questo tipo di intervento metabolico possa influenzare la ricorrenza del cheloide richiede ulteriori conferme sperimentali e cliniche.
Ovviamente, anche questo studio presenta delle limitazioni. In primo luogo, le nostre analisi rimangono in gran parte computazionali, e l'associazione osservata tra l'espressione di FLVCR1 e l'infiltrazione delle cellule T follicolari helper (Tfh) non stabilisce una relazione causale diretta. Sono necessarie la validazione mediante citometria a flusso delle cellule Tfh e studi funzionali che prevedano il silenziamento o la sovraespressione di FLVCR1 nei fibroblasti del cheloide, insieme a saggi sulle interazioni tra fibroblasti e cellule immunitarie o su condizionamento del mezzo, per chiarire il potenziale ruolo di FLVCR1 nella regolazione immunitaria. In secondo luogo, la dimensione relativamente ridotta del campione potrebbe introdurre incertezze e un'eccessiva ottimizzazione nella stima delle prestazioni della firma genica composta da sei geni. Sebbene sia stata effettuata una validazione interna, la valutazione affidabile delle prestazioni diagnostiche e della calibrazione rimane limitata. Pertanto, il pannello di sei geni dovrebbe essere considerato una firma molecolare esplorativa che richiede ulteriore validazione in coorti più ampie e indipendenti. In terzo luogo, il dataset a singola cellula necessita di un ampliamento per rappresentare meglio l'eterogeneità inter-paziente e le popolazioni cellulari rare. In quarto luogo, una validazione a livello proteico dell'espressione dei biomarcatori e della loro localizzazione spaziale mediante immunohistochimica rafforzerebbe la rilevanza clinica dei nostri risultati. Infine, sebbene il docking molecolare suggerisca un potenziale legame tra (+)-gallocatechina e FLVCR1, sono necessari saggi di legame in vitro e studi sull'efficacia in vivo prima di qualsiasi traduzione clinica. Nonostante queste limitazioni, i nostri risultati forniscono un quadro multidimensionale che collega il metabolismo dell'eme associato a FLVCR1 alle alterazioni immunitarie nel cheloide, identificando potenziali biomarcatori molecolari e candidati terapeutici da approfondire in ulteriori ricerche.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Contributi degli autori
Qiuyan Yang ha contribuito alla progettazione dello studio. Jianping Zhang ha contribuito alla raccolta dei dati. Qiuyan Yang e Xiaofang Sun hanno contribuito all'analisi statistica. Qiuyan Yang e Jing Wang hanno contribuito alla creazione dei diagrammi e al completamento del manoscritto. Tutti gli autori hanno letto e approvato la versione finale del manoscritto.
Ringraziamenti
Ringraziamo sentitamente i ricercatori che hanno generato e condiviso pubblicamente i set di dati GSE44270, GSE7890 e GSE163973 attraverso il database Gene Expression Omnibus (GEO).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Versione 22; Generazione di parametri del ligando utilizzando il campo di forza GAFF |
| Anti-FLVCR1 | Proteintech | 26841-1-AP | |
| Anti-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Versione 1.2.3; Docking molecolare e previsione dell'affinità di legame del ligando |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Versione 1.5.6; Preparazione del ligando e del recettore per il docking molecolare |
| Kit per saggio proteico BCA | Servicebio | G2026 | |
| Mix per sintesi di cDNA per qPCR con dsDNase | UnionScript | Trascrizione inversa per qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Versione 14.0; Ottimizzazione conformazionale 3D e minimizzazione dell'energia dei ligandi |
| Sistema di imaging chemiluminescente | Visualizzazione delle bande del western blot | ||
| Pacchetto DoubletDetection | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Rilevamento e rimozione dei doppietti predetti nell'analisi scRNA-seq |
| Substrato chemiluminescente ECL | Rilevamento del segnale nel western blot | ||
| Siero fetale bovino | Concentrazione finale al 2%; Supplemento per il mezzo di coltura dei fibroblasti | ||
| Fibroblast Growth Medium 2 | PromoCell | C-23020 | |
| Primers per FLVCR1 e GAPDH | Tabella supplementare S2 | Amplificazione per qRT-PCR di geni bersaglio e di riferimento | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W; Calcolo delle cariche atomiche RESP per la parametrizzazione del ligando |
| Apparecchiatura per elettroforesi su gel | Separazione proteica mediante SDS-PAGE | ||
| Pacchetto GEOquery | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Versione 2.68.0; Recupero di espressione genica e metadati dal database GEO |
| Pacchetto ggplot2 | CRAN | https://cran.r-project.org/package=ggplot2 | Versione 4.0.2; Visualizzazione dei dati |
| Pacchetto glmnet | CRAN | https://cran.r-project.org/package=glmnet | Versione 4.1.10; Selezione di caratteristiche con LASSO |
| GROMACS | Team di sviluppo di GROMACS | https://www.gromacs.org/ | Versione 2022.3; Simulazioni di dinamica molecolare e analisi delle traiettorie |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | Database GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 campioni di cheloide; Analisi dell'espressione a singola cellula |
| GSE44270 | Database GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 campioni di cheloide e 14 normali; Espressione differenziale e screening di biomarcatori |
| GSE7890 | Database GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 campioni di cheloide e 9 normali; Validazione indipendente di biomarcatori diagnostici |
| Pacchetto GSVA | Bioconductor | https://bioconductor.org/packages/GSVA/ | Versione 1.48.3; Analisi dell'infiltrazione delle cellule immunitarie basata su ssGSEA |
| Capra anti-topo IgG coniugata con HRP | Abcam | ab97040 | |
| Capra anti-coniglio IgG coniugata con HRP | Abcam | ab97051 | |
| Incubatore umidificato con CO2 | 37 °C, 5% CO2; Mantenimento delle cellule NHDF e PKF | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Quantificazione dell'intensità delle bande del western blot |
| Insulina | Concentrazione finale di 5 μg/mL; Supplemento per il mezzo di coltura dei fibroblasti | ||
| Database delle firme molecolari (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Versione 2024.1.Hs; Fonte di set genici associati al metabolismo dell'eme |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Versione 3.0; Costruzione della rete di interazione miRNA-mRNA |
| NHDF | Procell | CP-H106 | |
| Latte in polvere scremato | Soluzione al 5%; Bloccaggio della membrana per l'analisi del western blot | ||
| Film o tappi sigillanti ottici | Sigillatura delle reazioni di qRT-PCR | ||
| PBS | Procell | PB180327 | |
| PDB ID: 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Struttura umana di FLVCR1; Fonte della struttura proteica FLVCR1 per lo screening virtuale basato sulla struttura |
| Inibitori della fosfatasi | Supplemento per il buffer di lisi proteica | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| Pacchetto pROC | CRAN | https://cran.r-project.org/package=pROC | Versione 1.19.0.1; Analisi della curva ROC e dell'AUC |
| Cocktail di inibitori della proteasi | Roche | 4693124001 | |
| Apparecchiatura per trasferimento proteico | Trasferimento delle proteine su membrana PVDF | ||
| Membrana PVDF | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Versione 2.6.1; Visualizzazione e analisi delle pose di docking proteina-ligando e delle interazioni molecolari |
| Piastre o provette per qRT-PCR | Impostazione della reazione di qRT-PCR | ||
| R | Fondazione R per il calcolo statistico | https://www.r-project.org/ | Versione 4.3.1; Analisi statistiche e bioinformatiche |
| Pacchetto randomForest | CRAN | https://cran.r-project.org/package=randomForest | Versione 4.7.1.2; Selezione di caratteristiche con foresta casuale |
| REACTOME_HEME_BIOSYNTHESIS; REACTOME_HEME_DEGRADATION; WIKIPATHWAYS_HEME_BIOSYNTHESIS; REACTOME_SCAVENGING_HEME_FROM_PLASMA; HALLMARK_HEME_METABOLISM | Database delle firme molecolari (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Versione 2024.1.Hs; 283 geni unici dopo fusione; Definizione dei geni associati al metabolismo dell'eme |
| Sistema di PCR in tempo reale | Amplificazione e rilevamento mediante qRT-PCR | ||
| Fattore di crescita fibroblastico umano ricombinante di base | Concentrazione finale di 1 ng/mL; Supplemento per il mezzo di coltura dei fibroblasti | ||
| Buffer RIPA | Servicebio | G2002 | |
| Pacchetto rms | CRAN | https://cran.r-project.org/package=rms | Versione 6.7.1; Costruzione del nomogramma |
| Reagenti o gel prefabbricati per SDS-PAGE | Separazione proteica mediante SDS-PAGE | ||
| Pacchetto Seurat | CRAN | https://satijalab.org/seurat/ | Versione 5.4.0; Pre-elaborazione, raggruppamento e visualizzazione di scRNA-seq |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Versione 9.0; Fonte di interazioni miRNA-mRNA supportate sperimentalmente |
| Kit per RNA totale II | Omega | R6934-01 | |
| Libreria di composti attivi di medicina tradizionale cinese | Fonte di composti candidati per lo screening virtuale | ||
| Soluzione salina tamponata con Tween/Tris | Preparazione del buffer di bloccaggio e lavaggio della membrana | ||
| UnionScript First-strand cDNA Synthesis Mix for qPCR (with dsDNase) | Genesand | SR511 |
Riferimenti
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.