Questo flusso di lavoro integra la trascrittomica su larga scala e a singola cellula con saggi preliminari su tessuti pazienti per individuare MMP1 nell'ulcera del piede diabetico. MMP1 ha mostrato un modello di espressione centrato sui fibroblasti e un'elevata abbondanza tissutale, suggerendo un'associazione con il rimodellamento della matrice, sebbene il rapporto di causalità e l'utilità clinica non siano ancora definiti.
Articolo di ricerca
Trascrittomica Complessiva e a Singola Cellula Integrata con Validazione su Tessuto Individua MMP1 nel Piede Diabetico
* These authors contributed equally
In questo articolo
Sommario
Abstract
Le fonti cellulari di cambiamenti trascrittomici riproducibili nell'ulcera del piede diabetico (DFU) non sono ancora completamente definite. Questo studio ha integrato l'analisi dell'espressione differenziale, l'analisi della rete co-espressiva pesata dei geni (WGCNA), lo screening dei geni associati alla neuropatia periferica diabetica (DPN), una selezione esplorativa delle caratteristiche mediante apprendimento automatico, due dataset esterni di trascrittomica bulk, un'analisi single-cell, l'analisi di rete della medicina tradizionale cinese (TCM) e analisi quantitative di pazienti mediante reazione a catena della polimerasi (qPCR) e immunoblotting. Nel dataset GSE199939 (10 campioni di DFU e 11 controlli), sono stati identificati 3.691 geni differenzialmente espressi, e il modulo blu della WGCNA si è dimostrato fortemente associato alla DFU (r = 0,97, p = 5 × 10-13). L'intersezione tra i geni differenzialmente espressi, i geni hub del modulo blu e i 1.062 geni correlati alla DPN ha prodotto 77 candidati. CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2 sono stati supportati da almeno due metodi di selezione delle caratteristiche; la separazione completa nell'eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto ha sollevato preoccupazioni riguardo a un overfitting nel coorte di scoperta. MMP1 ha mostrato la maggiore variazione di espressione nel coorte di scoperta (cambio del log2 = 9,854; p corretto = 1,24 × 10⁻²⁹). Nella matrice combinata GSE68183/GSE80178, MMP1 presentava un p corretto di 0,0159 e un'area sotto la curva ROC (AUC) di 0,981. Nel dataset GSE134431, l'espressione di MMP1 era nominalmente più elevata nella pelle del piede diabetico con ulcera rispetto a quella senza ulcera (p = 0,0225; p corretto = 0,135; AUC = 0,808). L'analisi di 69.944 cellule provenienti da 24 campioni ha mostrato l'espressione media più alta di MMP1 nei fibroblasti, con un'espressione a livello di campione più elevata nei fibroblasti, nei cheratinociti e nelle cellule endoteliali della DFU. Gli esami sui tessuti dei pazienti hanno rivelato un'abbondanza maggiore di mRNA di MMP1 in quattro coppie abbinate (test appaiato su ΔCq, p = 3,04 × 10⁻⁵) e un'abbondanza proteica maggiore in tre coppie abbinate (p appaiato = 0,0107). La replicazione statistica è risultata incompleta. I risultati suggeriscono un'associazione centrata sui fibroblasti nel rimodellamento della matrice, soggetta a limitazioni dovute all'uso di transcripts per million (TPM) come input nell'analisi di scoperta basata sui conteggi, alla mancanza di informazioni complete sui passaggi di pre-elaborazione single-cell e alle piccole dimensioni dei gruppi negli esami sui tessuti. La causalità e l'utilità clinica non sono ancora state dimostrate.
Introduzione
L'ulcera del piede diabetico è una complicanza grave e ricorrente del diabete che insorge a causa della convergenza tra neuropatia, carico meccanico ripetitivo, malattia arteriosa periferica, suscettibilità alle infezioni e riparazione tissutale compromessa. Stime attuali indicano che milioni di persone nel mondo sono colpite ogni anno, e la guarigione è spesso prolungata, con rischi significativi di recidiva, ricovero ospedaliero, amputazione degli arti inferiori e decesso1. La prevenzione e la gestione dipendono quindi non solo dalle cure locali della ferita, ma anche dall'identificazione della perdita della sensibilità protettiva, dalla riduzione della pressione plantare, dal trattamento dell'infezione e dell'ischemia e dall'affrontare i fattori di rischio sistemici1,2. La neuropatia periferica diabetica è particolarmente rilevante poiché un'alterazione sensoriale progressiva può ridurre la consapevolezza riguardo a pressione, trauma e degrado tissutale, mentre anomalie motorie e autonomiche possono ulteriormente modificare la biomeccanica del piede e l'integrità della cute2,3. A livello tissutale, il danno neuropatico può coesistere con neuroinfiammazione, disfunzione microvascolare, stress metabolico e riparazione difettosa, creando un ambiente della ferita in cui la lesione persiste nonostante le cure standard1,3.
Una corretta guarigione cutanea richiede un'infiammazione coordinata, una ri-epitelializzazione, un'angiogenesi, un'attivazione dei fibroblasti, un deposito di matrice extracellulare (ECM) e un successivo rimodellamento della matrice. Nel diabete, questi processi possono diventare temporalmente disorganizzati: i segnali infiammatori possono rimanere attivi, la migrazione dei cheratinociti può essere compromessa, le risposte endoteliali possono risultare insufficienti e i fibroblasti possono produrre o organizzare una matrice anomala. I fibroblasti rivestono un ruolo centrale nella fase stromale della riparazione poiché sintetizzano le proteine della matrice, regolano l'architettura del collagene, comunicano con le cellule immunitarie ed epiteliali e contribuiscono alla contrazione della ferita. Studi condotti su fibroblasti derivati da pazienti con ulcere del piede diabetico (DFU) hanno evidenziato anomalie persistenti nella trascrizione legata alla ECM e nell'assemblaggio della matrice, sostenendo l'ipotesi che lo stato dei fibroblasti rappresenti un componente importante della biologia delle ferite croniche4. Le metalloproteasi della matrice (MMP) partecipano a questo processo degradando i substrati della ECM e consentendo la migrazione cellulare, il turnover tissutale e il rimodellamento; tuttavia, i loro effetti dipendono dalla localizzazione, dal momento temporale, dalla disponibilità del substrato e dalla regolazione da parte degli inibitori tissutali delle metalloproteasi (TIMP)5. Un'alterazione dell'equilibrio tra proteolisi e sostituzione della matrice potrebbe quindi essere compatibile con un riparo compromesso, ma un aumento dell'espressione di una singola MMP non implica di per sé un ruolo dannoso o benefico. La metalloproteasi della matrice 1 (MMP1), una collagenasi interstiziale in grado di partecipare al turnover del collagene fibrillare, è stata descritta come alterata nei tessuti delle DFU e studi clinici precedenti hanno associato i profili MMP/TIMP allo stato della ferita o alle traiettorie di guarigione6,7. Queste osservazioni supportano ulteriori indagini sulla MMP1 nelle DFU.
Il profilo trascrittomico fornisce un approccio sistematico per identificare i programmi molecolari associati alle ulcere del piede diabetico (DFU), ma diverse limitazioni metodologiche complicano l'interpretazione. I dataset ottenuti da tessuti interi mediano i segnali provenienti da cheratinociti, fibroblasti, cellule endoteliali, cellule immunitarie e altri compartimenti, rendendo difficile determinare se un candidato rifletta un'espressione alterata all'interno di un tipo cellulare, cambiamenti nella composizione cellulare o entrambi. La comparabilità tra dataset può inoltre essere ridotta da differenze nelle piattaforme, nelle strategie di normalizzazione, nei siti di campionamento del tessuto, nella gravità dell'ulcera, nello stato di infezione, nella fase della malattia e nel tessuto di riferimento. È importante notare che la cute del piede diabetico non ulcerata rappresenta un comparatore tissutale diabetico clinicamente rilevante, ma non è intercambiabile con la cute sana. Il sequenziamento dell'RNA a singola cellula può risolvere parzialmente il problema dell'origine cellulare, distinguendo popolazioni cellulari eterogenee e i loro stati trascrizionali. Uno studio precedente basato su trascrittomica a singola cellula e trascrittomica spaziale delle DFU ha identificato popolazioni distinte di fibroblasti e ha dimostrato che i programmi dei fibroblasti variano in base al contesto della ferita e allo stato di guarigione8. Questi risultati sostengono l'utilizzo di analisi risolte a livello cellulare per integrare i dati trascrittomici ottenuti da tessuti interi.
I metodi di selezione delle caratteristiche possono aiutare a individuare i candidati più promettenti a partire da dati di espressione ad alta dimensionalità, tuttavia gli studi biomedici con campioni ridotti sono particolarmente soggetti a stime ottimistiche e a una selezione instabile dei geni. Quando il numero di variabili misurate supera di gran lunga il numero di campioni biologici, può verificarsi una separazione apparentemente perfetta anche in presenza di informazioni predittive generalizzabili limitate. Il riutilizzo delle stesse osservazioni per la selezione delle caratteristiche, l'ottimizzazione e la valutazione delle prestazioni amplifica ulteriormente l'AUC, rendendo essenziali la cross-validation annidata, i modelli bloccati e coorti di test genuinamente indipendenti per valutare l'effettiva capacità predittiva9,10. Queste considerazioni sono rilevanti negli studi sulle ulcere del piede diabetico (DFU), poiché le coorti disponibili pubblicamente sono spesso di piccole dimensioni e eterogenee. I database degli ingredienti, dei bersagli e delle erbe della medicina tradizionale cinese sono stati inoltre utilizzati esclusivamente per la generazione di ipotesi.
Questo studio ha integrato trascrittomica su larga scala, WGCNA, screening di geni associati a DPN, selezione di caratteristiche mediante apprendimento automatico, valutazione su dataset esterni, analisi single-cell, analisi di rete della medicina tradizionale cinese e validazione su tessuti di pazienti. I geni candidati identificati nel gruppo di scoperta sono stati valutati attraverso ulteriori dataset trascrittomici, e il candidato principale è stato localizzato in specifici tipi cellulari utilizzando dati single-cell. MMP1 è stato quindi analizzato a livello di mRNA e di proteina nel tessuto del paziente mediante qPCR e immunoblotting. Questo approccio è stato progettato per identificare un candidato riproducibile associato alle ulcere del piede diabetico e per caratterizzarne il contesto cellulare e biologico.
Protocollo
Progettazione dello studio e fonti dei dati
Lo studio, compresa la raccolta e l'uso di campioni di tessuto umano per la validazione mediante qPCR e western blot, è stato esaminato e approvato dal Comitato Etico dell'Ospedale Quarto di Wuhan (numero di approvazione KY2024-161-01). Tutte le procedure che hanno coinvolto tessuti umani sono state condotte in conformità con il protocollo approvato e i principi etici applicabili. La componente trascrittomica dello studio ha utilizzato dataset pubblicamente disponibili e anonimizzati. È stato ottenuto il consenso informato scritto da tutti i partecipanti i cui campioni di tessuto sono stati utilizzati per la validazione sperimentale. I dataset trascrittomici pubblicamente disponibili sono stati analizzati in forma anonimizzata, e le procedure di consenso per gli studi originali che hanno generato i dati sono state gestite dalle rispettive istituzioni.
Questo studio ha integrato trascrittomica su larga scala, analisi di rete, selezione di caratteristiche, analisi single-cell, previsione di rete della medicina tradizionale cinese (TCM) e validazione su tessuti di pazienti. Il gruppo di scoperta era costituito dal dataset Gene Expression Omnibus (GEO) GSE199939 (10 campioni di ulcere del piede diabetico [DFU] e 11 campioni di controllo). La valutazione esterna mediante trascrittomica su larga scala ha incluso una matrice fusa GSE68183/GSE80178 (9 campioni DFU e 6 campioni di controllo) e GSE134431 (13 campioni DFU e 8 campioni di cute di piede diabetico non ulcerata [DFS]). L'analisi single-cell ha utilizzato un oggetto Seurat preelaborato e annotato con SingleR derivato da GSE165816, comprendente 69.944 cellule provenienti da 24 campioni (14 DFU e 10 controlli). La valutazione su tessuto ha incluso quattro coppie abbinate di pazienti con tessuto DFU e tessuto periulcerato per qPCR e tre coppie abbinate per il test di western blotting, in base ai dati degli esami recuperati e alle coppie confermate dagli autori. Tutti i materiali e le attrezzature utilizzati in questo studio sono elencati nella Tabella dei Materiali.
Costruzione del set di geni associati al DPN
I geni associati alla neuropatia periferica diabetica (DPN) sono stati recuperati dal database Gene del National Center for Biotechnology Information (NCBI) utilizzando rentrez. I termini di ricerca includevano “diabetic peripheral neuropathy”, “diabetic neuropathy”, “diabetic polyneuropathy”, “painful diabetic neuropathy” e “diabetic sensorimotor polyneuropathy”, limitati a Homo sapiens. Gli identificatori ottenuti sono stati associati ai simboli ufficiali dei geni, convertiti in maiuscolo, puliti ed eliminati i duplicati. I geni derivati dal database sono stati combinati con un elenco di geni DPN curato dalla letteratura e nuovamente depurati da duplicati, ottenendo un totale di 1.062 geni associati alla DPN. Le stringhe complete di ricerca e il codice per la pulizia degli identificatori sono inclusi negli script allegati; questi includono anche neuropatie diabetiche, diabete associato a polineuropatia distale simmetrica o simmetrica o neuropatia periferica, e il termine MeSH Diabetic Neuropathies. La componente derivata dalla letteratura richiede ancora l'attribuzione a livello di citazione.
Pre-elaborazione del cohort di scoperta e analisi dell'espressione differenziale
La matrice di espressione GSE199939 è stata allineata alla tabella dei fenotipi mediante l'identificatore del campione. Gli identificatori genici duplicati sono stati resi univoci. L'analisi di scoperta archiviata ha arrotondato i valori di espressione e adattato un modello binomiale negativo utilizzando DESeq2 (versione 1.48.2), con il gruppo come fattore sperimentale e DFU rispetto al controllo come contrasto. I geni con valori di p corretti mancanti sono stati esclusi. Il controllo delle prove multiple è stato effettuato mediante la procedura di Benjamini–Hochberg (BH). L'elenco archiviato dei geni differenzialmente espressi (DEG) ha utilizzato un valore assoluto del log2 fold change maggiore di 1 e un valore di p corretto con BH < 0,05. Il confronto con la fonte pubblica GEO ha confermato che l'input era TPM, piuttosto che il numero grezzo di letture. Arrotondare i valori TPM non soddisfa il requisito di conteggi grezzi di DESeq2. Le stime originali sono state mantenute, ma la validità delle statistiche di scoperta e dei risultati dipendenti di WGCNA e della selezione delle caratteristiche rimane irrisolta in attesa di un'adeguata ri-analisi. Il confronto con la fonte è documentato nell'archivio supplementare.
Per la visualizzazione, è stata applicata la trasformazione stabilizzante la varianza (VST) di DESeq2 con blind = FALSE. L'analisi delle componenti principali (PCA) è stata eseguita sulla matrice di espressione VST. La mappa termica ha utilizzato i punteggi z per riga relativi ai 50 geni con i valori di p aggiustati più bassi. L'implementazione della PCA ha centrato e scalato i valori trasformati per gene utilizzando prcomp con scale. = TRUE.
Analisi della rete di co-espressione genica pesata
Per l'analisi WGCNA, sono stati mantenuti i geni con conteggi maggiori di 5 in almeno tre campioni GSE199939. I fattori di dimensione sono stati stimati con DESeq2, è stata applicata la trasformazione VST con blind = TRUE, e sono stati selezionati i 5.000 geni con la maggiore varianza tra i campioni. La qualità dei campioni e dei geni è stata valutata utilizzando goodSamplesGenes, ed è stata impiegata la clusterizzazione gerarchica con collegamento medio per la valutazione della qualità a livello di campione.
È stata costruita una rete con segno utilizzando WGCNA (versione 1.74). Sono state valutate potenze candidate da 1 a 10 e da 12 a 30 con incrementi di 2 mediante pickSoftThreshold; è stato utilizzato un valore obiettivo di adattamento alla topologia priva di scala pari a 0,85, e la potenza di soglia morbida selezionata è stata 18. I moduli sono stati identificati con blockwiseModules utilizzando un'adiacenza con segno e una matrice di sovrapposizione topologica con segno, correlazione di Pearson, dimensione minima del modulo di 30, altezza di taglio per la fusione di 0,25, soglia di riassegnazione di 1 × 10⁻⁶, pamRespectsDendro = FALSE e dimensione massima del blocco di 10.000.
Gli eigengeni dei moduli sono stati correlati a un tratto DFU binario. I moduli non grigi con |r| > 0,5 e p < 0,05 sono stati considerati associati a DFU. Per ciascun modulo associato, la significatività genica (GS) è stata definita come la correlazione di Pearson tra l'espressione genica e lo stato DFU, e l'appartenenza al modulo (MM) come la correlazione di Pearson tra l'espressione genica e l'eigengene del modulo corrispondente. I geni hub sono stati definiti in base a |MM| > 0,8 e |GS| > 0,5. Il modulo blu, che ha mostrato la più forte associazione positiva con DFU, è stato selezionato per ulteriori analisi. I suoi geni hub sono stati incrociati con i DEG e con il set genico associato a DPN. La soglia di hub riportata utilizza quindi i valori assoluti sia di MM che di GS, indipendentemente dal segno della correlazione.
Selezione delle caratteristiche basata sull'apprendimento automatico
I 77 geni condivisi dagli insiemi di geni DEG, hub-gene del modulo blu e geni correlati a DPN sono stati valutati in GSE199939. I simboli genici duplicati sono stati accorpati in base alla loro espressione media. La matrice dei geni candidati è stata trasformata in log2, rimuovendo le caratteristiche a varianza nulla quando il valore massimo superava 50, e le caratteristiche rimanenti sono state standardizzate. È stato utilizzato un seme casuale pari a 123. La sequenza implementata è stata: screening dei candidati a livello di coorte, accorpamento dei simboli duplicati, trasformazione logaritmica condizionata, filtraggio delle caratteristiche a varianza nulla, centratura e scalatura su tutta la coorte e selezione delle caratteristiche specifica per algoritmo. Lo screening di DEG e WGCNA ha utilizzato l'intera coorte di scoperta prima della cross-validazione a livello di algoritmo. Il flusso di lavoro riportato non stabilisce quindi una validazione annidata priva di leakage, e le sue AUC interne non possono essere utilizzate come stime non distorte della performance predittiva.
Sono state applicate tre procedure di selezione delle caratteristiche. In primo luogo, è stata adattata una regressione logistica con operatore di riduzione e selezione del valore assoluto minimo (LASSO) utilizzando glmnet (versione 5.0), famiglia binomiale, alpha = 1, errore di classificazione come misura di validazione incrociata, nessuna standardizzazione aggiuntiva e validazione incrociata a cinque ripetizioni vincolata dalla dimensione della classe più piccola. Sono state selezionate le caratteristiche corrispondenti a lambda.1se; lambda.min è stata utilizzata solo se lambda.1se non selezionava alcun gene. In secondo luogo, è stata adattata una foresta casuale composta da 1.000 alberi utilizzando randomForest (versione 4.7-1.2); sono stati mantenuti i geni con una riduzione media del Gini almeno pari all'importanza media tra i geni candidati. In terzo luogo, è stata implementata l'eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto lineare (SVM-RFE) con e1071 (versione 1.7-17), ordinando le caratteristiche in base al quadrato del peso lineare sull'intero coorte prima di valutare progressivamente sottoinsiemi di caratteristiche sempre più piccoli mediante l'area sotto la curva (AUC) della validazione incrociata leave-one-out (LOOCV). L'ordinamento non è stato ricalcolato all'interno di ciascun blocco di addestramento. L'adattamento della SVM lineare ha utilizzato scale = FALSE e probability = TRUE senza una griglia esplicita di ottimizzazione del parametro cost. La selezione della penalità LASSO ha utilizzato la propria validazione incrociata interna senza un ciclo esterno di valutazione separato, e l'importanza della foresta casuale è stata calcolata sull'intero coorte.
Nessun gene è stato selezionato da tutti e tre i metodi; pertanto, sono stati mantenuti i geni supportati da almeno due metodi. SVM-RFE ha prodotto un AUC di 1,00 in tutti i sottoinsiemi valutati, ed è stato selezionato il sottoinsieme più piccolo tra quelli a pari merito. Poiché questa separazione completa ha sollevato preoccupazioni riguardo all'overfitting e a una valutazione troppo ottimistica nella piccola coorte di scoperta, l'AUC di SVM-RFE non è stato interpretato come una stima della performance clinica. Nessun modello multigenico bloccato è stato testato in una coorte esterna; analisi esterne della curva ROC (receiver operating characteristic) hanno valutato l'espressione dei singoli geni candidati. L'esame dello script di analisi ha confermato che la pre-elaborazione e il ranking delle caratteristiche SVM non erano limitati ai fold di training. Sono stati utilizzati gli stessi risultati LOOCV per scegliere la dimensione del sottoinsieme, senza un ciclo esterno di valutazione. Di conseguenza, questo flusso di lavoro presenta una perdita di informazioni e supporta esclusivamente un'analisi esplorativa di priorizzazione delle caratteristiche.
Analisi di arricchimento funzionale
Sono state eseguite analisi di sovra-rappresentazione Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) sul pannello di sei geni. I simboli genici sono stati associati agli identificatori Entrez utilizzando org.Hs.eg.db (versione 3.21.0). L'analisi GO è stata condotta con clusterProfiler (versione 4.16.0) attraverso le ontologie di processo biologico, componente cellulare e funzione molecolare. Per l'arricchimento KEGG è stato utilizzato il codice dell'organismo umano (hsa). I termini significativi sono stati definiti come valori di p nominale < 0,05 e p corretto con BH < 0,05. Poiché erano inclusi soltanto sei geni, l'analisi di arricchimento è stata utilizzata principalmente per l'annotazione funzionale. Lo script KEGG ha utilizzato annotazioni locali di KEGG.db con enrichKEGG(use_internal_data = TRUE); la versione delle annotazioni deve essere documentata. Gli script GO e KEGG non hanno fornito un universo personalizzato, pertanto le basi di dati di annotazione hanno definito gli sfondi predefiniti.
Valutazione trascrittomico bulk esterna
Per la matrice unita GSE68183/GSE80178, i simboli genici sono stati standardizzati e i simboli duplicati sono stati accorpati calcolando l'espressione media tra le righe corrispondenti. I sei geni candidati sono stati allineati al file fenotipico. Poiché i file disponibili non documentavano completamente la procedura di unione preliminare e di correzione per effetti di batch, questo dataset è stato analizzato così come fornito e interpretato con cautela. Di conseguenza, non è possibile stabilire, sulla base del record di elaborazione fornito, né l'eliminazione degli effetti di batch né l'indipendenza del segnale del gruppo dagli effetti dello studio. Questa matrice fornisce un supporto esplorativo tra dataset piuttosto che una replica definitiva.
Per GSE134431, i sei geni candidati sono stati estratti dalla matrice di letture per chilobase per milione di letture mappate (RPKM) e trasformati come log2(RPKM + 1). DFS è stato utilizzato come gruppo di riferimento e DFU come gruppo di confronto. DFS rappresenta la cute del piede diabetico senza ulcere. Il Figura 4C originariamente inviata riportava valori RPKM grezzi; il pannello rivisto utilizza la scala log2(RPKM + 1) indicata. Test di Wilcoxon bilaterali con approssimazione normale e correzione per la continuità, insieme ad analisi ROC orientate automaticamente, sono stati verificati su entrambe le scale e hanno fornito valori p e AUC identici poiché la trasformazione è strettamente monotona.
All'interno di ciascun set di dati di validazione su larga scala, le differenze di espressione tra gruppi sono state valutate mediante test di somma dei ranghi di Wilcoxon a due code, e la correzione di BH è stata applicata attraverso i sei geni. Le curve ROC sono state calcolate con pROC (versione 1.19.0.1), utilizzando la direzione selezionata automaticamente dal pacchetto. Sono stati calcolati gli AUC e i corrispondenti intervalli di confidenza al 95% (IC) per confrontare i modelli discriminatori tra i diversi set di dati. La selezione automatica della direzione della ROC da ciascun set di dati di valutazione potrebbe fornire una discriminazione ottimistica; questi AUC per singolo gene hanno valore descrittivo e non convalidano un modello predittivo clinico predeterminato.
Localizzazione a livello di singola cellula e analisi a livello di campione
L'analisi a singola cellula ha utilizzato l'oggetto Seurat salvato biofsci_SingleR_annotated_MMP1_analyzed.rds da GSE165816, contenente 22.889 geni e 69.944 cellule nel saggio RNA. Il saggio RNA conservava un livello di conteggi interi non negativi e un livello dati generato mediante LogNormalize con un fattore di scala di 10.000, seguito da trasformazione log1p; quest'ultimo non era TPM. L'oggetto conteneva 2.000 geni variabili selezionati utilizzando il metodo vst (loess.span = 0,3; 20 bin di uguale larghezza), espressione scalata per tutti i geni conservati (centratura e scalatura abilitate; scale.max = 10) e 50 componenti principali calcolate a partire dalle caratteristiche variabili con seme 42. La cronologia dei comandi salvata ha utilizzato le dimensioni Harmony da 1 a 20 per la costruzione del nearest-neighbor e l'approximation uniforme della varietà (UMAP). Le impostazioni dei vicini includevano k = 20, Annoy con 50 alberi e distanza euclidea, e una soglia di potatura shared nearest-neighbor (SNN) pari a 1/15. Il clustering ha utilizzato risoluzione 0,8, algoritmo 1, n.start = 10, n.iter = 10 e random.seed = 0. UMAP ha utilizzato l'implementazione uwot, 30 vicini, due dimensioni di output, una metrica di distanza coseno, min.dist = 0,3, spread = 1, learning.rate = 1 e seme 42. L'oggetto conservava una riduzione Harmony, ma i cutoff originali di controllo qualità, la chiamata completa RunHarmony inclusi i covarianti per batch e le impostazioni di riferimento e annotazione SingleR per questo oggetto analizzato non potevano essere recuperati. Le etichette dei tipi cellulari, le etichette dei gruppi e gli identificatori dei campioni erano memorizzati rispettivamente in SingleR_label, Group e orig.ident. Sono stati conservati dieci tipi cellulari annotati: cellule B, cellule T CD8+, cellule endoteliali, cellule epiteliali, fibroblasti, cellule staminali ematopoietiche, cheratinociti, macrofagi, monociti e neuroni.
L'espressione di MMP1 è stata riassunta per tipo cellulare. Le cellule con espressione normalizzata di MMP1 maggiore di zero sono state classificate come positive per MMP1. Per l'analisi a livello di campione, è stata calcolata l'espressione normalizzata media per ogni combinazione campione-tipo cellulare. I campioni di DFU e di controllo sono stati confrontati all'interno di ciascun tipo cellulare mediante test di somma dei ranghi di Wilcoxon a due code, seguiti da correzione BH su tutti i tipi cellulari testati. L'accesso al campione GEO, piuttosto che la singola cellula, è stata l'unità utilizzata in questi confronti riportati. I 24 accessi non sono stati considerati prova di 24 donatori indipendenti. L'oggetto salvato non conteneva un identificatore di donatore verificato, e il campionamento ripetuto del tessuto all'interno degli stessi donatori non è stato modellato; pertanto, i test a livello di campione vanno interpretati come esplorativi. Questi riassunti calcolano la media dell'espressione normalizzata all'interno di ciascun campione e tipo cellulare; non si tratta di modelli differenziali di espressione pseudobulk basati sulla somma dei conteggi.
Dieci set genici funzionali sono stati valutati con Seurat AddModuleScore. Sono state calcolate le correlazioni di Spearman tra l'espressione cellulare di MMP1 e i punteggi dei moduli, corretti con il metodo BH. Per l'analisi esplorativa di MMP1-alto, sono stati selezionati i tre tipi cellulari con l'espressione media più elevata di MMP1 tra i tipi cellulari contenenti almeno 50 cellule. Una soglia globale è stata definita come l'espressione mediana tra le cellule positive per MMP1 quando erano disponibili più di 10 cellule positive; in caso contrario, lo script ha utilizzato il 75° percentile complessivo. Le cellule al di sopra di questa soglia sono state assegnate al gruppo MMP1-alto e le restanti al gruppo MMP1-basso. FindMarkers ha utilizzato un test di Wilcoxon, logfc.threshold = 0,25 e min.pct = 0,1. I geni upregolati con p aggiustato < 0,05 sono stati sottoposti a arricchimento GO per processi biologici. Poiché i gruppi sono stati definiti in base all'espressione di MMP1, questa analisi è stata utilizzata per descrivere i percorsi associati allo stato MMP1-alto. Le correlazioni per cellula, i loro valori p aggiustati e l'arricchimento di MMP1-alto rispetto a MMP1-basso sono descrittivi poiché la dipendenza all'interno del campione non è stata modellata. Le singole cellule non sono state interpretate come replicati biologici indipendenti.
Previsione degli ingredienti, bersagli e erbe della MTC
I sei geni prioritari sono stati abbinati alla colonna 4 della tabella locale delle interazioni chimico-gene del Comparative Toxicogenomics Database (CTD). I record sono stati limitati a Homo sapiens nella colonna 7. I nomi degli ingredienti sono stati semplificati e normalizzati in minuscolo per l'abbinamento, e sono stati rimossi gli abbinamenti duplicati tra ingrediente-target e erba-ingrediente. Gli ingredienti sono stati collegati alle erbe utilizzando la tabella di riferimento erba-ingrediente. Per l'arricchimento del database sono stati utilizzati un valore di p nominale < 0,05 e un valore di p corretto < 0,05. Sono stati rimossi i record duplicati erba-ingrediente-target prima del riassunto basato sulla copertura. L'arricchimento delle erbe è stato effettuato con clusterProfiler::enricher, utilizzando l'abbinamento erba-ingrediente come TERM2GENE, con minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 e qvalueCutoff = 1, prima di applicare le soglie di significatività nominale e corretta con il metodo BH. Questi collegamenti nel database possono descrivere variazioni nell'espressione o nell'attività, ma non stabiliscono un legame diretto né un effetto uniforme in una direzione specifica.
Le erbe sono state classificate utilizzando il seguente punteggio di copertura:
S = 3R + 5L +2T + 3C + 2I + N (1)
Qui, R è il numero di record di MMP1, L è il numero di ingredienti associati a MMP1, T è il numero di target coperti, C è il numero di ingredienti principali, I è l'indicatore dell'asse della matrice e N è il numero totale di ingredienti.
Gli ingredienti principali erano quercetina, luteolina e berberina. L'indicatore dell'asse matrice era impostato a 1 quando un'erba copriva sia MMP1 che MMP13, e a 0 in caso contrario. Si richiedeva che le erbe candidate contenessero almeno un record associato a MMP1 e o almeno due ingredienti associati a MMP1 o almeno quattro target più un ingrediente principale. Il punteggio è stato utilizzato per riassumere la copertura del database e non è stato considerato una misura dell'efficacia farmacologica. I coefficienti definiscono una regola personalizzata e euristica di copertura che enfatizza i record e gli ingredienti associati a MMP1, una più ampia copertura dei target, i tre ingredienti designati e la copertura congiunta di MMP1/MMP13. Tali coefficienti non sono stati adattati a risultati clinici né validati sperimentalmente, e pesi alternativi potrebbero modificare la classificazione delle erbe.
Prelievo del tessuto del paziente e valutazione preliminare mediante qPCR e western blot
I pazienti con ulcere del piede diabetico clinicamente diagnosticate, sottoposti a debridement o intervento chirurgico clinicamente indicato presso l'Ospedale Quarto di Wuhan, sono stati considerati idonei se era disponibile tessuto del piede e se era stato ottenuto consenso informato scritto. I criteri di esclusione includevano la presenza di malignità nel sito di campionamento, una causa non diabetica dell'ulcera o una quantità o qualità insufficiente del tessuto per i saggi previsti. Il tessuto dell'ulcera del piede diabetico (DFU) e il tessuto non ulcerato circostante la ferita sono stati prelevati dallo stesso paziente secondo il protocollo di studio approvato. Quest'ultimo è stato utilizzato come controllo abbinato perilesionale; non si trattava di cute sana non diabetica. La valutazione mediante qPCR ha incluso quattro coppie abbinate (quattro campioni di DFU e quattro corrispondenti campioni perilesionali), mentre il western blotting ha incluso tre coppie abbinate. L'abbinamento è stato confermato dagli autori per ciascun saggio; non è stata utilizzata l'identità incrociata tra i saggi nei confronti statistici. Ogni paziente rappresentava l'unità biologica, mentre le pozzette tecniche della PCR costituivano misurazioni ripetute all'interno di un singolo campione. Questi saggi preliminari avevano lo scopo di valutare l'espressione tissutale di MMP1 e non erano progettati per stabilire prestazioni diagnostiche, causalità o generalizzabilità tra diversi fenotipi di DFU.
Per la validazione tramite qPCR, l'RNA totale è stato estratto da campioni di tessuto derivati dai pazienti utilizzando un reagente per l'estrazione dell'RNA totale, seguendo le istruzioni del produttore. La concentrazione e la purezza dell'RNA sono state valutate mediante spettrofotometria, e i campioni con un rapporto A260/A280 compreso tra 1,8 e 2,1 sono stati utilizzati per le analisi successive. L'RNA totale (1 µg) è stato sottoposto a trascrizione inversa utilizzando un kit di trascrizione inversa da virus della leucemia murina di Moloney (M-MLV) in un volume finale di reazione di 20 µL. Il progetto dello strumento disponibile identifica un sistema di PCR in tempo reale. La PCR quantitativa è stata eseguita utilizzando una miscela maestra PCR SYBR Green 2x in una reazione da 20 µL contenente 10 µL di miscela maestra SYBR Green 2x, 0,4 µL ciascuno dei primer forward e reverse, 2 µL di DNA complementare (cDNA) e 7,2 µL di acqua priva di nucleasi. Il programma di amplificazione ha previsto una denaturazione iniziale a 95 °C per 30 s, seguita da 40 cicli di 95 °C per 5 s e 60 °C per 30 s. È stata effettuata un'analisi della curva di denaturazione per verificare la specificità dell'amplificazione. L'abbondanza dei trascritti di MMP1 è stata misurata utilizzando β-actina (ACTB) come gene di riferimento. Le sequenze dei primer sono elencate nella Tabella 1. Per l'analisi accoppiata rivista, le cinque pozzette tecniche per bersaglio all'interno di ciascun campione sono state mediate prima del calcolo del ΔCq, e l'espressione relativa di MMP1 è stata calcolata utilizzando il metodo 2-ΔΔCq , utilizzando il gruppo di tessuto periulceroso non ulcerato come campione di calibrazione. Le coppie di campioni recuperate erano NC–DFU, NC1–DFU1, NC2–DFU2 e NC3–DFU3, confermate dagli autori come quattro coppie appaiate di pazienti. Il precedente grafico di qPCR utilizzava cinque valori per pozzetta tecnica provenienti solo da NC e DFU; il grafico rivisto mostra un singolo valore a livello di campione dopo la media delle pozzette tecniche per ciascuna delle quattro coppie. L'inferenza appaiata ha utilizzato ΔCq = Cq medio(MMP1) − Cq medio(ACTB), piuttosto che valori di fold-change a livello di pozzetta. Il progetto dello strumento archiviato differisce anche dal volume di reazione e dal programma di ciclaggio riportati, e la corrispondenza con l'esperimento rappresentato graficamente rimane irrisolta.
Per la validazione tramite immunoblotting (WB), i campioni di tessuto sono stati omogeneizzati in buffer per saggio di immunoprecipitazione radioattivo freddo di ghiaccio, integrato con inibitori delle proteasi. I lisati sono stati incubati sul ghiaccio per 30 minuti e centrifugati a 12.000 x g per 15 minuti a 4 °C. I soprannatanti sono stati raccolti e le concentrazioni proteiche sono state determinate mediante un saggio con acido bicinconinico. Quantità uguali di proteina (20 µg per corsia) sono state separate su gel gradienti di elettroforesi in poliacrilamide contenenti dodecilsolfato di sodio (4%–20%) e trasferite su membrane di difluoruro di polivinilidene da 0,22 µm. Le membrane sono state bloccate con latte scremato al 5% in soluzione salina tamponata al Tris contenente Tween-20 allo 0,1% per 1 h a temperatura ambiente e incubate tutta la notte a 4 °C con un anticorpo policlonale anti-MMP1 (1:1.000) e un anticorpo policlonale anti-cofilina (1:6.000). Dopo tre lavaggi con soluzione salina tamponata al Tris contenente Tween-20 allo 0,1%, le membrane sono state incubate con immunoglobulina G (IgG) di capra anti-coniglio coniugata con perossidasi di rafano (1:5.000) per 1 h a temperatura ambiente. Le bande proteiche sono state visualizzate utilizzando un substrato chemiluminescente migliorato e acquisite con un sistema di imaging chemiluminescente mediante il software operativo associato (versione 1.2.0), come registrato nei metadati dell'immagine. Le bande sono state quantificate utilizzando il software ImageJ. La cofilina è stata utilizzata come controllo di caricamento e l'abbondanza proteica di MMP1 è stata normalizzata rispetto alla cofilina per il confronto tra gruppi.
Analisi statistica e software
Tutti i test erano a due code, salvo diversamente indicato. È stato utilizzato un valore di p corretto con il metodo di Benjamini-Hochberg (BH) < 0,05 come soglia principale per la correzione per confronti multipli. Le dimensioni esatte del campione variavano in base al set di dati e, per l'analisi a livello di singola cellula, in base alla presenza di un determinato tipo cellulare in ciascun campione. I riassunti dell'espressione continua sono mostrati come osservazioni individuali con boxplot che indicano la mediana e l'intervallo interquartile; i baffi si estendono fino a 1,5 volte l'intervallo interquartile. Per la western blot, i sei rapporti tra MMP1 e cofilina ottenuti sono stati analizzati mediante un test t appaiato a due code su tre coppie di pazienti confermate dagli autori (df = 2; p = 0,0107). Per la qPCR, cinque valori di Cq di ACTB e cinque valori di Cq di MMP1 sono stati mediati separatamente all'interno di ogni campione prima del calcolo del ΔCq. Un test t appaiato a due code ha confrontato i valori di ΔCq delle ulcere del piede diabetico (DFU) e dei tessuti perilesionali abbinati in quattro coppie di pazienti confermate dagli autori (df = 3; p = 3,04 × 10⁻⁵). La media del ΔCq perilesionale è stata utilizzata come calibratore comune per la rappresentazione dell'espressione relativa. Il rapporto medio di variazione dell'espressione all'interno dei pazienti e il suo intervallo di confidenza al 95% sono stati ottenuti antitrasformando la differenza media del ΔCq appaiato e il relativo intervallo di confidenza basato sulla distribuzione t. Le singole osservazioni biologiche sono mostrate con linee che collegano i tessuti abbinati; i pozzetti tecnici non aumentano la dimensione del campione biologico. I valori di p relativi ai saggi sui tessuti sono nominali ed esplorativi. Con tre o quattro pazienti, la normalità delle differenze appaiate non può essere valutata in modo affidabile e i saggi rimangono preliminari. Le analisi bioinformatiche e la generazione delle figure sono state eseguite in R 4.5.2 su Windows 11. Le versioni dei pacchetti principali includevano DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 e ggplot2 4.0.3. Un inventario consolidato di software, basi di dati e parametri è fornito nella Tabella Supplementare 1.
Risultati
La trascrittomica di scoperta identifica un ampio programma di espressione associato alle ulcere del piede diabetico
GSE199939 ha funto da coorte di scoperta ed includeva 10 campioni di DFU e 11 campioni di controllo (Figura 1A). L'analisi delle componenti principali dell'espressione normalizzata con VST ha mostrato una chiara separazione tra i gruppi; le componenti principali 1 e 2 spiegavano rispettivamente il 34,8% e il 15,1% della varianza totale (Figura 1B).
Utilizzando un valore |log2 fold change| > 1 e un valore di p corretto con il metodo BH < 0,05, l'analisi dell'espressione differenziale ha identificato 3.691 geni differenzialmente espressi (DEG), compresi 1.247 geni upregolati nel DFU e 2.444 geni downregolati nel DFU (Figura 1C). I 50 DEG più significativi hanno formato un pattern di espressione fortemente strutturato per gruppi (Figura 1D). Tra i sei geni selezionati successivamente, MMP1 ha mostrato la variazione maggiore nella coorte di scoperta (log2 fold change = 9,854; p corretto = 1,24 × 10⁻²⁹).
Un modulo di co-espressione associato alle DFU converge con i DEG e i geni correlati alla DPN
WGCNA è stata eseguita sui 5.000 geni con maggiore variabilità trasformati con VST. È stata selezionata una potenza di soft-thresholding pari a 18 per la rete firmata, al fine di bilanciare l'adattamento alla topologia scale-free e la connettivitàFigura 2A). L'analisi di clustering gerarchico e il rilevamento dinamico di moduli hanno identificato diversi moduli di co-espressione (Figura 2B). Il modulo blu presentava la più forte associazione positiva con l'ulcera del piede diabetico (Pearson r = 0.97, p = 5 × 10-13; Figura 2C). Vengono forniti i corrispondenti riassunti del controllo qualità relativi al raggruppamento dei campioni e alle dimensioni dei moduli in Figura supplementare 1A,B.
All'interno del modulo blu, 689 geni hanno soddisfatto i criteri per essere considerati hub: |MM| > 0,8 e |GS| > 0,5 (Figura 2D). L'intersezione tra i 3.691 geni DEG, i 689 geni hub del modulo blu e i 1.062 geni associati ai DPN ha prodotto 77 geni candidati condivisi (Figura 2E). Una rappresentazione semplificata della rete degli hub del modulo blu e le statistiche degli hub con i punteggi più elevati sono mostrate nella Figura supplementare 2A,B.
La selezione multi-metodo delle caratteristiche identifica sei geni ma evidenzia un overfitting nel coorte di scoperta
I 77 geni sovrapposti sono stati analizzati mediante LASSO, foresta casuale e SVM-RFE. LASSO ha mantenuto sette geni alla penalità selezionata: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 e CHEK1 (Figura 3A). Il filtraggio mediante foresta casuale ha conservato 41 geni con un'importanza pari o superiore alla media, inclusi cinque membri del pannello finale tra le caratteristiche più altamente classificate (Figura 3B). SVM-RFE ha prodotto un AUC di 1,00 per ogni sottoinsieme nidificato valutato; secondo la regola del legame di dimensione minima, CHEK1 è stato selezionato come sottoinsieme composto da un singolo gene (Figura 3C), sollevando preoccupazioni riguardo all'overfitting e a una valutazione troppo ottimistica nel gruppo di scoperta. Le relative espressioni nel gruppo di scoperta, le mappe termiche e le curve ROC sono mostrate nella Figura supplementare 3A–C.
Nessun gene è stato selezionato da tutti e tre i metodi. La conservazione dei geni supportati da almeno due metodi ha prodotto CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2 (Figura 3D). L'annotazione GO di questi sei geni ha evidenziato il disassemblaggio della matrice extracellulare, i processi catabolici e metabolici del collagene, il cromosoma condensato e le funzioni legate alle metalloendopeptidasi (tutti con p corretto BH < 0,05; Figura 3E). L'analisi KEGG ha identificato la via di segnalazione dell'interleuchina-17 (IL-17) (CCL7/MMP1/MMP13; p corretto = 1,81 × 10⁻⁴) e la via di segnalazione della relaxina (MMP1/MMP13; p corretto = 0,0175; Figura 3F). Questi risultati di arricchimento sono stati utilizzati per caratterizzare le funzioni biologiche rappresentate dal pannello di sei geni.
La valutazione incrociata tra dataset mostra un supporto eterogeneo per MMP1
Nella matrice unita GSE68183/GSE80178 (9 ulcere del piede diabetico e 6 controlli), CCL7, MMP1, e MMP13 differivano tra i gruppi dopo la correzione di BH per i sei geni (aggiustato p = 0,0168, 0,0159 e 0,0431, rispettivamente; Figura 4A). CHEK1, MKI67, e TRPV2 non ha raggiunto la soglia di significatività corretta (corretta p = 0,259, 0,680 e 0,259). L'analisi ROC per singolo gene ha prodotto AUC di 0,944 per CCL7 (95% CI, 0,825–1,000), 0,704 per CHEK1 (0,403–1,000), 0,574 per MKI67 (0,243–0,905), 0,981 per MMP1 (0,930–1,000), 0,870 per MMP13 (0,686–1,000) e 0,722 per TRPV2 (0.447–0.997; Figura 4B). Questi valori ROC sono stati considerati esplorativi poiché la procedura di unione preliminare e di correzione per effetti di batch non era completamente documentata.
In GSE134431 (13 campioni di ulcere del piede diabetico e 8 campioni di piede diabetico senza ulcere), MMP1 l'espressione era maggiore nelle ulcere del piede diabetico (DFU) rispetto ai campioni di controllo non ulcerati (DFS) al test di Wilcoxon al livello di significatività nominale (p = 0,0225), anche se questa associazione non è rimasta significativa dopo la correzione BH (aggiustato p = 0.135; Figura 4C). Gli altri cinque geni non hanno mostrato differenze significative tra i gruppi. MMP1 ha mostrato anche l'AUC descrittiva più elevata, con un valore di 0,808 (IC 95%, 0,589–1,000), mentre gli AUC degli altri candidati variavano da 0,529 a 0,635 (Figura 4D). In generale, MMP1 ha mostrato il modello descrittivo più coerente tra i sei candidati, ma la replica statistica è risultata incompleta.
L'analisi a singola cellula localizza MMP1 principalmente nei fibroblasti
Il dataset a singola cellula conteneva 69.944 cellule provenienti da 24 campioni (14 DFU e 10 controlli) e comprendeva 10 tipi cellulari annotati (Figura 5A). La visualizzazione delle caratteristiche tramite UMAP ha localizzato l'espressione di MMP1 in regioni cellulari ristrette, piuttosto che mostrare un'espressione uniforme lungo tutto l'atlante (Figura 5B). Nel complesso, 3.799 cellule (5,43%) presentavano un'espressione normalizzata di MMP1 maggiore di zero. I fibroblasti mostravano l'espressione normalizzata media più alta (0,181) e la frazione maggiore complessiva di cellule positive per MMP1 (7,88%; Figura 5C).
A livello di campione, l'espressione media di MMP1 era più elevata nei campioni di DFU rispetto ai campioni di controllo in cheratinociti, fibroblasti e cellule endoteliali. Dopo la correzione BH su tutti i tipi cellulari testati, ciascuno di questi confronti presentava un valore p aggiustato di 0,0214 (cheratinociti: 9 campioni di controllo e 14 di DFU; fibroblasti: 10 e 14; cellule endoteliali: 10 e 14; Figura 5D). La frazione positiva per MMP1 è aumentata dal 5,86% al 9,29% nei fibroblasti, dallo 0,026% al 6,68% nei cheratinociti e dallo 0,29% al 2,67% nelle cellule endoteliali (Figura 5E).
Le correlazioni tra i punteggi dei moduli per cellula sono state modeste. La correlazione positiva più elevata è stata osservata per il punteggio del modulo senescenza/fenotipo segreto associato alla senescenza (SASP) (rho di Spearman = 0,274), seguita da rimodellamento della matrice extracellulare (rho = 0,240), ferroptosi (rho = 0,197) e attivazione dei fibroblasti (rho = 0,170; Figura 5F). Il confronto tra fibroblasti MMP1-alti e MMP1-bassi ha mostrato un arricchimento per termini legati all'organizzazione della matrice extracellulare, all'organizzazione della struttura extracellulare, all'organizzazione delle fibrille di collagene, all'elaborazione delle glicoproteine e al ripiegamento delle proteine (Figura 5G). Questi risultati descrittivi hanno associato lo stato dei fibroblasti MMP1-alti a processi legati al rimodellamento della matrice. Ulteriori rappresentazioni UMAP a livello di gruppo, sommari campionari comprendenti tutti i tipi cellulari e contesto relativo ai punteggi funzionali sono forniti nella Figura supplementare 4A–C. Le associazioni a livello di singola cellula non sono state considerate come evidenza indipendente dal donatore.
La copertura della rete dà priorità agli ingredienti associati a MMP1 e alle erbe candidate
La tabella filtrata delle relazioni tra erbe, ingredienti e target conteneva 561 record unici che collegavano 99 erbe, 14 ingredienti e cinque dei sei target candidati. MMP1 era il target più frequente, con 156 record, seguito da CHEK1 (120), MMP13 (102), MKI67 (100) e TRPV2 (83; Figura 6A). Tra gli ingredienti, la quercetina e la luteolina presentavano la copertura maggiore di erbe ed erano collegate rispettivamente a 83 e 62 erbe. La berberina era collegata a 10 erbe; questi tre ingredienti sono stati utilizzati come ingredienti principali nella regola di priorizzazione (Figura 6B).
Il punteggio di copertura ha posizionato Guanhuangbo, Mahuang e Niuxi al primo posto in classifica (punteggio = 38 ciascuno; Figura 6C). Ognuno di essi copriva tutti e cinque i bersagli disponibili e conteneva due ingredienti associati a MMP1. La matrice ingredienti-bersagli ha mostrato che la quercetina garantiva la copertura più ampia tra tutti i bersagli analizzati, mentre la luteolina e la berberina fornivano ulteriore connettività centrata su MMP1 (Figura 6D). Una rete mirata ha collegato le erbe principali a ingredienti rappresentativi e ai cinque bersagli disponibili (Figura 6E). Questi risultati hanno identificato combinazioni erba-ingrediente-bersaglio con elevata copertura nei database, da sottoporre a ulteriore valutazione. Le matrici di supporto per la copertura erbe-bersagli e ingredienti principali sono mostrate nella Figura supplementare 5A,B.
Saggi preliminari su tessuti accoppiati mostrano una maggiore abbondanza di mRNA e proteina MMP1
La valutazione mediante Western blot ha mostrato un'abbondanza maggiore di MMP1 nei campioni di DFU rispetto ai corrispondenti campioni del tessuto perilesionale non ulcerato (Figura 7A,B). Le tre coppie appaiate hanno mostrato una differenza media nel rapporto MMP1/cofilina (ulcera meno perilesionale) di 0,3553 (IC 95%, 0,1959–0,5147; test t appaiato a due code, t(2) = 9,592, p = 0,0107). Le misurazioni appaiate di ciascun paziente sono riportate nella Figura 7B. Dopo aver mediato cinque pozzetti tecnici per gene per ciascun campione, la qPCR ha mostrato un'abbondanza normalizzata di mRNA di MMP1 maggiore in ciascuno dei quattro campioni di DFU rispetto al corrispondente campione perilesionale (Figura 7C). La differenza media all'interno del paziente (ulcera meno perilesionale) nel ΔCq è stata di −2,6035 (IC 95%, −2,8024 a −2,4046; test t appaiato a due code, t(3) = −41,663, p = 3,04 × 10⁻⁵), corrispondente a un aumento geometrico medio di 6,08 volte (IC 95%, 5,30–6,98). Queste osservazioni, ottenute con un piccolo numero di campioni, sono preliminari e non dimostrano un effetto funzionale.
Nei dataset di scoperta e nei dataset esterni in bulk, MMP1 ha mostrato il modello descrittivo più coerente tra i sei geni prioritizzati, anche se la replicazione statistica non è stata completa. I riassunti a livello di singola cellula hanno evidenziato l'espressione media più elevata nei fibroblasti, e le misurazioni accoppiate di WB da tre pazienti e le misurazioni accoppiate di qPCR da quattro pazienti hanno mostrato un'abbondanza maggiore di MMP1. Queste osservazioni supportano MMP1 come candidato associato alle ulcere del piede diabetico (DFU) da approfondire in ulteriori indagini. Il flusso di lavoro complessivo, dalla computazione alla valutazione tissutale, è riassunto nella Supplementary Figure 6.
DISPONIBILITÀ DEI DATI:
I set di dati transcriptomici pubblici sono disponibili presso l'NCBI Gene Expression Omnibus con i numeri di accessione GSE199939, GSE68183, GSE80178, GSE134431 e GSE165816. Nell'File Supplementare 1 sono inclusi gli script disponibili per l'analisi e la generazione di figure, tabelle di espressione e risultati elaborati, tabelle sorgenti quantitative per le figure, tabelle di output statistici, la cartella di lavoro originale per la qPCR e il progetto strumentale, nonché le immagini originali non ritagliate dei blot western fornite. L'archivio contiene inoltre metadati cellulari estratti, cronologia dei comandi dall'oggetto single-cell recuperato, rapporti di verifica del tipo di matrice e un elenco dei file. L'File Supplementare 1 conserva i file sorgenti storici e include una cartella R2_Updates contenente le tabelle sorgenti riviste per il saggio accoppiato, gli output statistici, il codice per la generazione delle figure e l'inventario corretto dei parametri. L'analisi completa in formato Seurat RDS è indicata nella documentazione dell'archivio ma non è incorporata in questo file ZIP supplementare. La cronologia completa della fusione bulk, le impostazioni originali di filtraggio e annotazione single-cell e i dettagli completi relativi alla sottrazione dello sfondo nei blot e alla quantificazione per banda non sono interamente disponibili; tali limitazioni sono descritte nel protocollo e nella discussione. L'RDS recuperato localmente non è stato depositato in un archivio pubblico.
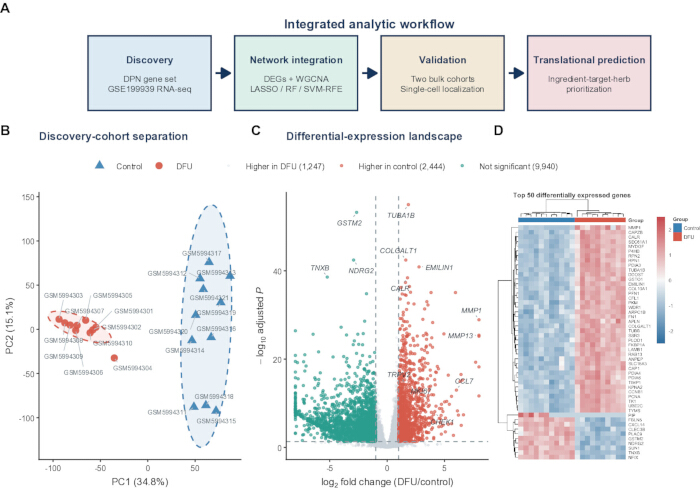
Figura 1: La trascrittomica di scoperta identifica un programma di espressione associato all'ulcera del piede diabetico (DFU). (A) Panoramica del flusso di lavoro computazionale, comprendente la costruzione del set genico DPN, l'analisi di scoperta su GSE199939, l'integrazione di rete e di apprendimento automatico, la valutazione su dati bulk e single-cell, e la previsione degli ingredienti-target-erbe nella medicina tradizionale cinese (TCM). (B) Analisi delle componenti principali dei profili di espressione di GSE199939 sottoposti a trasformazione stabilizzante la varianza (VST) ottenuti da 10 campioni DFU e 11 campioni di controllo. Le ellissi indicano le regioni del gruppo al 90%; le percentuali indicano la varianza spiegata da ciascuna componente. (C) Diagramma a vulcano dei risultati dell'analisi differenziale di espressione con DESeq2 per DFU rispetto al controllo. I punti rossi e turchesi indicano geni sovraespressi rispettivamente in DFU e nel controllo, utilizzando |log2 fold change| > 1 e p corretto con BH < 0,05; i punti grigi non soddisfano entrambi i criteri. (D) Mappa termica dei punteggi z per riga dei 50 geni con i valori di p corretti più bassi. Le colonne rappresentano i campioni biologici e la barra di annotazione indica il gruppo. DEGs, geni diversamente espressi; DFU, ulcera del piede diabetico; DPN, neuropatia periferica diabetica; VST, trasformazione stabilizzante la varianza. La valutazione sperimentale finale è descritta nel protocollo e nella Figura 7. qPCR, reazione a catena della polimerasi quantitativa; TCM, medicina tradizionale cinese; RF, foresta casuale; LASSO, operatore di selezione e riduzione assoluta minima; SVM-RFE, eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto. Cliccare qui per visualizzare una versione ingrandita di questa figura.
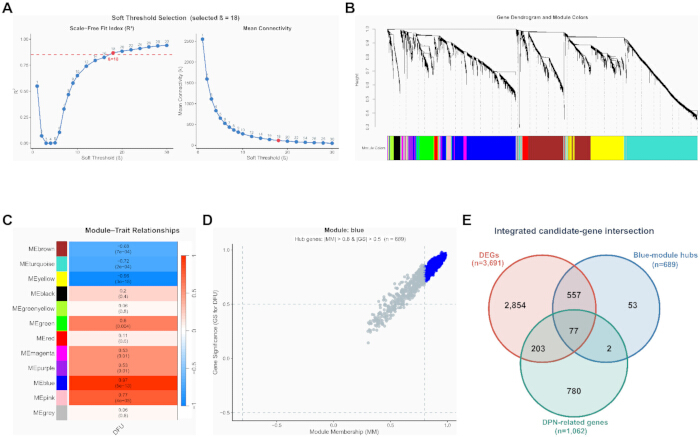
Figura 2: WGCNA e conoscenze pregresse su DPN convergono su 77 geni candidati. (A) Valutazione della soglia morbida della rete con segno per i 5.000 geni con maggiore variabilità trasformati con VST. La potenza selezionata era beta = 18; la linea tratteggiata indica l'adattamento desiderato alla topologia scale-free di 0,85. (B) Dendrogramma genico con assegnazione dinamica dei colori dei moduli basata sul legame medio. (C) Correlazioni di Pearson tra gli eigengeni dei moduli e il carattere binario DFU. Ogni cella mostra il coefficiente di correlazione e il corrispondente valore p a due code; il colore indica direzione e intensità. (D) Significatività genica per DFU rispetto all'appartenenza al modulo nel modulo blu. I punti blu soddisfano |appartenenza al modulo| > 0,8 e |significatività genica| > 0,5; n = 689 geni hub. (E) Intersezione tra tre insiemi: 3.691 DEG, 689 geni hub del modulo blu e 1.062 geni associati a DPN, che produce 77 candidati comuni. DFU, ulcera del piede diabetico; DPN, neuropatia periferica diabetica; GS, significatività genica; MM, appartenenza al modulo; WGCNA, analisi della rete di co-espressione genica pesata. Il gruppo di scoperta comprendeva 21 campioni (10 DFU e 11 controlli). L'annotazione della Figura 2D utilizza |MM| > 0,8 e |GS| > 0,5, coerentemente con il criterio basato sul valore assoluto verificato nel codice originale di selezione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
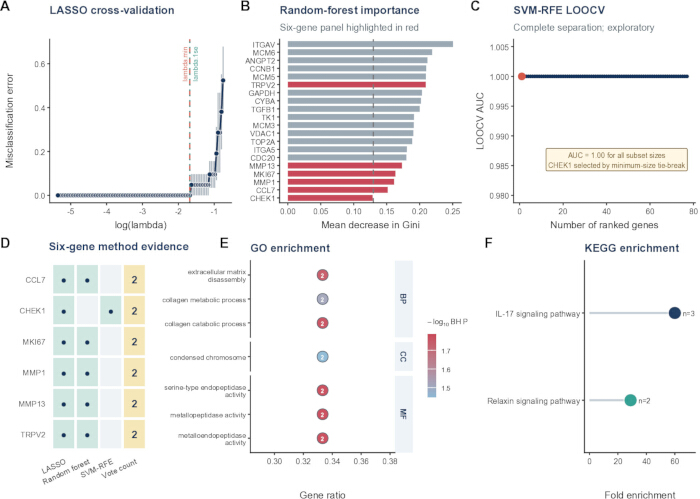
Figura 3: La priorizzazione delle caratteristiche multimetodo produce un pannello di sei geni. (A) Curva di validazione incrociata a cinque ripetizioni per la regressione LASSO binomiale. Le linee verticali tratteggiate indicano lambda.min e lambda.1se; le caratteristiche non nulle selezionate sono state prese a lambda.1se, a meno che quella penalità non abbia prodotto nessuna caratteristica. (B) Riduzione media del Gini nella foresta casuale per i 20 geni con punteggio più alto da un modello di 1.000 alberi. Le barre rosse identificano i membri del pannello finale di sei geni; la linea tratteggiata indica l'importanza media utilizzata come soglia di mantenimento per l'intero insieme di candidati. (C) AUC della LOOCV con SVM lineare-RFE attraverso sottoinsiemi annidati di caratteristiche. Tutte le dimensioni dei sottoinsiemi hanno prodotto AUC = 1,00; CHEK1 è stato selezionato secondo la regola del legame a dimensione minima, indicando un overfitting nel coorte di scoperta. (D) Matrice di supporto dei metodi per CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2. I punti indicano la selezione tramite LASSO, foresta casuale o SVM-RFE; l'ultima colonna riporta il numero di metodi di supporto. (E) Termini selezionati di Gene Ontology arricchiti tra i sei geni. La posizione dei punti mostra il rapporto genico, le etichette dei punti indicano il numero di geni mappati, il colore mostra il -log10 del p aggiustato BH e la striscia laterale denota l'ontologia. (F) Percorsi KEGG arricchiti tra i geni mappati. La posizione dei punti mostra l'arricchimento in termini di fold, le dimensioni delle etichette dei punti indicano il numero di geni mappati e il colore distingue i percorsi. L'arricchimento richiedeva un p nominale < 0,05 e un p aggiustato BH < 0,05. AUC, area sotto la curva ROC; BH, Benjamini-Hochberg; BP, processo biologico; CC, componente cellulare; KEGG, Kyoto Encyclopedia of Genes and Genomes; LOOCV, validazione incrociata leave-one-out; MF, funzione molecolare; SVM-RFE, eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto. LASSO, operatore di selezione e riduzione assoluta minima. I pannelli A–D utilizzano i 21 campioni di scoperta (10 DFU e 11 controlli). Nel pannello A, le barre di errore indicano l'errore standard dell'errore di validazione incrociata. Cliccare qui per visualizzare una versione ingrandita di questa figura.
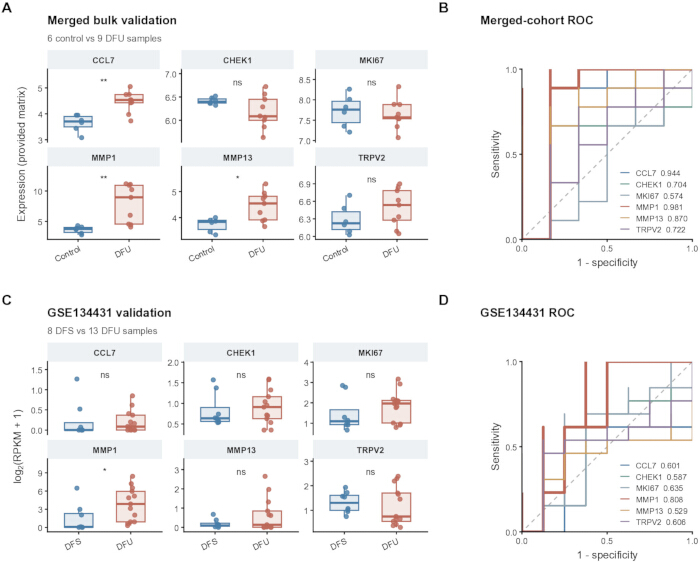
Figura 4: Valutazione trascrittomica bulk su dataset incrociati del pannello di sei geni. (A) Espressione dei sei geni nella matrice fusa GSE68183/GSE80178 (6 controlli e 9 campioni di DFU). (B) Curve ROC corrispondenti per singolo gene con valori di AUC; gli intervalli di confidenza al 95% sono riportati nella tabella dei dati sorgente. Poiché la fusione iniziale e la correzione per batch non sono state completamente documentate, questi risultati sono stati interpretati come esplorativi. (C) Espressione log2(RPKM + 1) in GSE134431 (8 campioni di DFS non ulcerati e 13 campioni di DFU). (D) Curve ROC corrispondenti per singolo gene e valori di AUC. In (A) e (C), i box mostrano la mediana e l'intervallo interquartile, i baffi si estendono fino a 1,5 volte l'intervallo interquartile e i punti rappresentano i campioni biologici. Gli asterischi indicano significatività nominale ottenuta da test di Wilcoxon rank-sum bilaterali (*p < 0,05, **p < 0,01); i valori di p aggiustati con metodo BH per i sei geni sono riportati nel testo e nella tabella dei dati sorgente. La direzione ROC è stata selezionata automaticamente da pROC. AUC, area sotto la curva caratteristica operativa del ricevitore; DFS, cute di piede diabetico non ulcerata; DFU, ulcera del piede diabetico; RPKM, letture per chilobase per milione di letture mappate; ROC, caratteristica operativa del ricevitore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
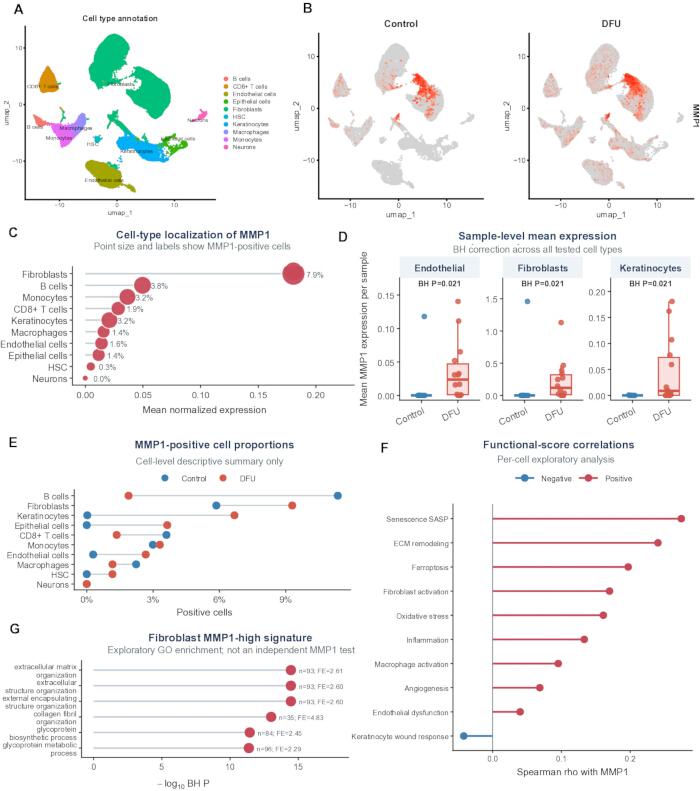
Figura 5: La localizzazione a singola cellula associa MMP1 ai segnali di rimodellamento da parte dei fibroblasti e della matrice. (A) UMAP di 69.944 cellule provenienti da 24 campioni (10 controlli e 14 campioni di DFU), colorati in base alle 10 annotazioni dei tipi cellulari ottenute con SingleR. (B) Grafici delle caratteristiche UMAP che mostrano l'espressione normalizzata di MMP1 nelle cellule di controllo e DFU. (C) Riassunto per tipo cellulare dell'espressione media normalizzata di MMP1; la dimensione dei punti e le etichette indicano la frazione complessiva di cellule positive per MMP1, definita come espressione normalizzata > 0. (D) Espressione media di MMP1 a livello di campione in cellule endoteliali, fibroblasti e cheratinociti. I riquadri mostrano la mediana e l'intervallo interquartile; i punti rappresentano i campioni biologici. Sono stati eseguiti test bilaterali di Wilcoxon rank-sum seguiti da correzione BH per tutti i tipi cellulari testati. I numeri disponibili di campioni erano 10 controlli e 14 DFU per cellule endoteliali e fibroblasti, e 9 controlli e 14 DFU per cheratinociti. (E) Frazioni di cellule positive per MMP1 per gruppo e tipo cellulare. (F) Correlazioni di Spearman per cellula tra l'espressione di MMP1 e i punteggi dei moduli funzionali. (G) Arricchimento dei processi biologici GO tra i geni upregolati nei fibroblasti MMP1-alti rispetto ai fibroblasti MMP1-bassi. BH, Benjamini-Hochberg; DFU, ulcera del piede diabetico; ECM, matrice extracellulare; GO, Gene Ontology; HSC, cellule staminali ematopoietiche; UMAP, uniform manifold approximation and projection. Le correlazioni per cellula e l'arricchimento condizionato all'espressione nei pannelli F e G sono descrizioni esplorative, senza inferenza confermativa che tenga conto del donatore. L'indipendenza a livello di campione richiede la verifica degli identificatori dei donatori. Cliccare qui per visualizzare una versione ingrandita di questa figura.
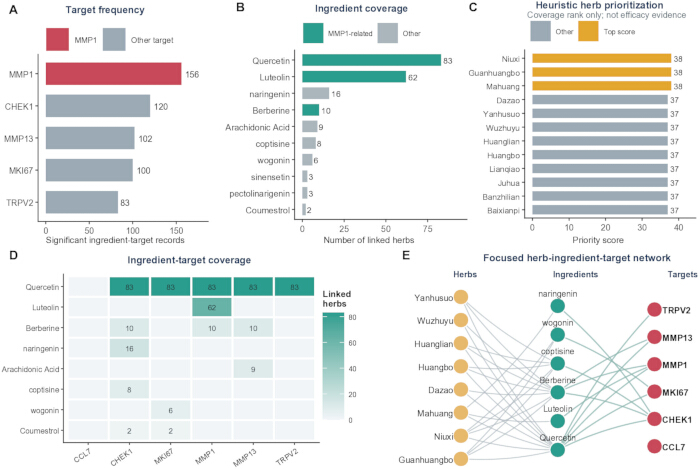
Figura 6: Previsione basata sul coverage degli ingredienti, bersagli ed erbe della medicina tradizionale cinese centrata su MMP1. (A) Numero di record erba-ingrediente-bersaglio filtrati nel database per ciascun bersaglio candidato disponibile. (B) Numero di erbe associate agli ingredienti più frequenti; in turchese sono indicati gli ingredienti collegati a MMP1. (C) Erbe principali ordinate in base al punteggio di coverage; le barre dorate indicano i tre punteggi più alti in assoluto. (D) Matrice ingrediente-bersaglio per ingredienti rappresentativi con alto coverage. I valori delle celle mostrano il numero di erbe collegate; le celle vuote indicano l'assenza di record nella tabella delle relazioni filtrata. (E) Rete dettagliata che collega erbe, ingredienti e bersagli candidati con punteggio elevato. Il colore dei nodi indica il tipo di entità; i collegamenti erba-ingrediente in grigio indicano contenimento, mentre i collegamenti ingrediente-bersaglio in turchese indicano link presenti nel database. La tabella delle relazioni filtrata conteneva 561 record univoci, 99 erbe, 14 ingredienti e cinque bersagli con collegamenti qualificanti; CCL7 è mostrato come un sesto nodo candidato isolato. TCM, medicina tradizionale cinese. Cliccare qui per visualizzare una versione ingrandita di questa figura.
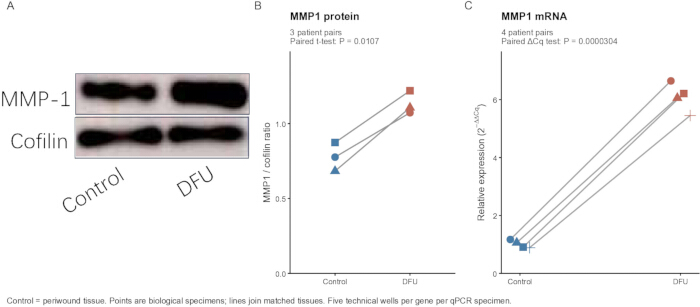
Figura 7: Valutazione preliminare mediante qPCR e western blot del tessuto del paziente dell'espressione di MMP1 nel DFU. (A) Western blot rappresentativo fornito in precedenza che mostra l'abbondanza proteica di MMP1 nel tessuto perilesionale non ulcerato e nel tessuto DFU, con cofilina come controllo di caricamento. (B) Rapporti MMP1-cofilina recuperati dal progetto originale di tracciamento grafico. I simboli indicano singole misurazioni biologiche di tre coppie di pazienti; le linee collegano campioni appaiati di tessuto perilesionale e DFU. Il test t appaiato bilaterale ha dato t(2) = 9,592 e p = 0,0107. (C) Abbondanza relativa di mRNA di MMP1 in quattro coppie di pazienti appaiate confermate dagli autori: NC–DFU, NC1–DFU1, NC2–DFU2 e NC3–DFU3. Cinque pozzetti tecnici per ACTB e cinque pozzetti tecnici per MMP1 sono stati mediati separatamente all'interno di ciascun campione prima del calcolo di ΔCq. L'espressione relativa è stata calcolata con il metodo 2−ΔΔCq utilizzando la media di ΔCq del tessuto perilesionale come calibratore comune. Ogni simbolo rappresenta un singolo campione biologico; le linee collegano tessuti appaiati. Il test t appaiato bilaterale ha utilizzato i valori di ΔCq a livello di campione (t(3) = −41,663; p = 3,04 × 10⁻⁵), non le variazioni di espressione nei pozzetti tecnici. Non vengono utilizzati asterischi di significatività. I pozzetti tecnici non sono replicati biologici. Controllo indica tessuto perilesionale non ulcerato. Cq, ciclo di quantificazione. I valori di p relativi al tessuto e al saggio sono nominali ed esplorativi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Gene | Accesso RefSeq | Primer diretto da 5 prime a 3 prime | Primer inverso da 5 prime a 3 prime |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tabella 1: Sequenze dei primer per la validazione tramite PCR quantitativa di MMP1. Sono riportate le sequenze oligonucleotidiche dirette e inverse (5′–3′) e gli identificativi dei trascritti NCBI RefSeq per MMP1 umano (NM_002421) e ACTB (NM_001101.5). ACTB (β-actina) è stato utilizzato come gene di riferimento per l'espressione relativa di MMP1.
Figura supplementare 1: Riepiloghi del controllo qualità della WGCNA. (A) Clustering gerarchico con collegamento medio dei campioni GSE199939 basato sui 5.000 geni con maggiore variabilità trasformati con stabilizzazione della varianza. Le etichette dei campioni sono colorate per gruppo; la linea tratteggiata orizzontale rappresenta la guida dell'altezza del dendrogramma al 95° percentile utilizzata per la valutazione visiva degli outlier. (B) Numero di geni assegnati a ciascun modulo WGCNA. Le barre turchesi indicano gli otto moduli non grigi che soddisfano il criterio di associazione con DFU; le barre grigie indicano gli altri moduli. DFU, ulcera del piede diabetico; VST, trasformazione con stabilizzazione della varianza; WGCNA, analisi della rete di co-espressione genica pesata. Cliccare qui per scaricare questo file.
Figura supplementare 2: Supporto per la co-espressione del modulo blu. (A) Rete semplificata di co-espressione dei 25 geni hub del modulo blu con rango più alto. Tra le correlazioni a coppie con |r| > 0,70, la rete visualizzata contiene l'unione dei due collegamenti più forti per ciascun gene. La dimensione dei nodi indica il grado all'interno di questa rete visualizzata e semplificata, mentre il colore di riempimento indica la significatività genica per l'ulcera del piede diabetico (DFU). (B) Significatività genica e appartenenza al modulo blu per i 15 hub con rango più alto. Il sottoinsieme di collegamenti è stato selezionato per migliorare la leggibilità e non rappresenta tutte le correlazioni valide. DFU, ulcera del piede diabetico; GS, significatività genica; MM, appartenenza al modulo. Cliccare qui per scaricare il file.
Figura supplementare 3: Rappresentazioni grafiche dell'analisi con apprendimento automatico nella coorte di scoperta. (A) Espressione normalizzata di CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2 nella coorte di scoperta GSE199939. I box mostrano la mediana e l'intervallo interquartile, mentre i punti rappresentano i campioni biologici. (B) Mappa termica dei punteggi z-score a livello di campione per gli stessi sei geni. Le etichette brevi dei campioni sono associate agli identificatori GEO nella chiave dei dati di origine. (C) Curva ROC del modello multigenico adattato alla coorte di scoperta. Un valore AUC di 1,00 è stato ottenuto adattando e valutando il modello sugli stessi 21 campioni, indicando un overfitting nella coorte di scoperta. AUC, area sotto la curva caratteristica operativa del ricevitore; ROC, curva caratteristica operativa del ricevitore. La coorte di scoperta comprendeva 21 campioni (10 DFU e 11 controlli). Cliccare qui per scaricare questo file.
Figura supplementare 4: Contesto dell'espressione a singola cellula. (A) UMAP di 69.944 cellule colorate in base al gruppo di controllo e al gruppo DFU. (B) Espressione media di MMP1 a livello di campione biologico in tutte e 10 le annotazioni dei tipi cellulari; i punti rappresentano i campioni, e l'asse x utilizza una trasformazione della radice quadrata per la visualizzazione. (C) Mappa termica dei punteggi dei moduli funzionali riassunti tra le cellule all'interno di ciascun tipo cellulare annotato e standardizzati all'interno di ogni modulo. DFU, ulcera del piede diabetico; UMAP, uniform manifold approximation and projection. Cliccare qui per scaricare questo file.
Figura supplementare 5: Matrici di copertura del MTC di supporto. (A) Numero di record erbe-target presenti nel database per le 18 erbe con maggiore punteggio che presentano copertura associata a MMP1 e per i cinque target candidati rappresentati nella tabella delle relazioni filtrata. (B) Numero di record nel database che collegano le stesse erbe con i principi attivi principali quercetina, luteolina e berberina. I valori nelle celle indicano i record univoci del database dopo la rimozione dei duplicati. MTC, medicina tradizionale cinese. Cliccare qui per scaricare questo file.
Figura supplementare 6: Flusso di lavoro per la valutazione computazionale e tissutale. Lo schema riassume gli input della scoperta, l'intersezione DEG/WGCNA, la selezione esplorativa delle caratteristiche, la valutazione bulk esterna, il contesto a singola cellula, l'estensione TCM e la valutazione dell'espressione tissutale abbinata. La qPCR ha utilizzato quattro coppie di pazienti abbinate e il western blotting ha utilizzato tre coppie di pazienti abbinate. I conteggi dei candidati e i risultati computazionali riportati sono stati mantenuti dall'analisi originale. L'input TPM nel flusso di lavoro di scoperta basato sui conteggi, i record incompleti della pre-elaborazione originale a singola cellula e i piccoli cohort per i saggi tissutali rimangono limitazioni. Lo schema non implica che le analisi di scoperta siano state revalidate. Cliccare qui per scaricare questo file.
Tabella Supplementare 1: Elenco del software, database, parametri e limitazioni per l'analisi. Questo file documenta 26 passaggi analitici, indicando il passaggio di analisi, lo strumento o database utilizzato, la versione riportata, gli input, i parametri principali, gli output e le informazioni mancanti o le limitazioni. Comprende trascrittomica di scoperta, WGCNA, screening genico e selezione di caratteristiche, arricchimento, analisi esterne bulk e single-cell, analisi di rete TCM e reportistica degli esperimenti su tessuti. La tabella riporta le informazioni metodologiche disponibili e non stabilisce di per sé un'indipendente riproducibilità. Cliccare qui per scaricare il file.
File Supplementare 1: Archivio di dati, codice di analisi, figure originali e saggi originali. Questo archivio contiene gli script disponibili per l'analisi e la generazione delle figure, tabelle di espressione e risultati elaborati, dati numerici e statistici originali per le figure, la cartella di lavoro originale per la qPCR e il progetto dello strumento, immagini non ritagliate dei blot western fornite, metadati e cronologia dei comandi per singola cellula, rapporti di verifica in formato matrice e un elenco dei file. I file storici sono stati conservati; la cartella R2_Updates fornisce l'analisi corretta dei saggi accoppiati, le figure originali aggiornate e l'inventario dei parametri rivisto. Cliccare qui per scaricare questo file.
Discussione
Questo flusso di lavoro integrato ha avuto priorità MMP1 a partire dalla trascrittomica su larga scala, WGCNA, screening dei geni associati a DPN e selezione esplorativa di caratteristiche, quindi ne è stato esaminato il contesto cellulare e l'espressione tessutale. Sei geni sono stati supportati da almeno due metodi di selezione, e MMP1 ha mostrato la maggiore variazione di espressione nel coorte di scoperta. Le evidenze esterne erano eterogenee: MMP1 è rimasto significativo nella matrice fusa GSE68183/GSE80178, mentre la sua associazione in GSE134431 era nominale (p = 0,0225) e non hanno superato la correzione di BH (aggiustata p = 0,135). L'AUC di 0,808 in GSE134431 è descrittiva, in particolare perché la direzione della curva ROC è stata selezionata all'interno del dataset di valutazione. Di conseguenza, l'espressione "più coerente" descrive il pattern osservato tra i sei candidati e non implica una replica statistica completa né un biomarcatore diagnostico validato.
Il pannello candidato è stato annotato per il turnover del collagene, il disassemblaggio della matrice extracellulare (ECM), l'attività di metalloendopeptidasi e la segnalazione di IL-17 e relaxina. Queste annotazioni sono compatibili con la biologia delle ferite croniche ma coinvolgono solo alcuni geni. Studi precedenti sull'uomo hanno riportato profili alterati di MMP e dei loro inibitori nelle ferite diabetiche6, mentre uno studio prospettico sulle ulcere del piede diabetico (DFU) ha associato un rapporto più elevato tra MMP1 e l'inibitore tissutale delle metalloproteasi 1 (TIMP1) a un processo di guarigione7. Pertanto, un'espressione aumentata di MMP1 non deve necessariamente indicare un effetto uniformemente dannoso; la sua rilevanza potrebbe dipendere dalla fase della riparazione, dalla disponibilità di substrati e dall'equilibrio con gli inibitori. Osservazioni sperimentali relative a MMP13, CCL7 e IL-17 forniscono ulteriore contesto11,12,13,14, ma non si può presumere che le loro funzioni siano equivalenti nelle DFU umane.
I riassunti a livello di singola cellula hanno localizzato l'espressione media più elevata di MMP1 nei fibroblasti, con un'espressione a livello di campione più alta nei fibroblasti del DFU, nei cheratinociti e nelle cellule endoteliali. Questo profilo è in accordo con quanto riportato in letteratura riguardo all'organizzazione alterata della matrice extracellulare (ECM) nei fibroblasti derivati dal DFU4, agli stati eterogenei dei fibroblasti osservati in studi di singola cellula e di analisi spaziale8 e ai programmi di fibroblasti coinvolti nella guarigione associati ai macrofagi15. Tuttavia, gli identificatori dei campioni richiedono una verifica a livello del donatore, e le correlazioni tra punteggi modulari a livello cellulare e l'arricchimento condizionato dall'espressione rimangono descrittivi poiché non è stato modellato il legame all'interno dello stesso donatore. Inoltre, il contributo delle popolazioni epiteliali ed endoteliali contrasta con un meccanismo esclusivamente autonomo dei fibroblasti. La trascrittomica spaziale, l'ibridazione in situ dell'RNA o l'immunomarcatura potrebbero fornire una localizzazione complementare16.
Il valore metodologico risiede nella combinazione di espressione differenziale, co-espressione, conoscenze pregresse sui geni, sommari risolti a livello cellulare e modalità di saggi indipendenti per stabilire una gerarchia di priorità tra i candidati. Non risiede nell'accuratezza predittiva del cohort di scoperta. Lo screening su tutto il cohort ha preceduto la cross-validazione a livello di algoritmo, e l'AUC uniforme di 1,00 ottenuta con SVM-RFE solleva preoccupazioni riguardo a possibili leakage, overfitting e una valutazione troppo ottimistica. Il pannello dovrebbe pertanto essere considerato un risultato di priorizzazione delle caratteristiche. Per una valutazione predittiva sarebbero necessari una pre-elaborazione completamente annidata, una selezione e un tuning, seguiti da un test indipendente bloccato9,10. L'input della scoperta è stato verificato come TPM nonostante il suo utilizzo in un modello basato sui conteggi; le statistiche di scoperta risultanti e la selezione successiva rimangono quindi non verificate in attesa di un'analisi appropriata. La matrice bulk unita non dispone della sua storia completa di pre-elaborazione. L'oggetto Seurat recuperato fornisce informazioni su normalizzazione, selezione delle caratteristiche variabili, PCA, vicini, clustering e impostazioni UMAP, anche se il filtraggio iniziale, la chiamata completa di Harmony e il riferimento per l'annotazione rimangono documentati in modo incompleto. La riprocessazione armonizzata a partire dai dati originali, la valutazione documentata degli effetti di batch e analisi pseudobulk o con modelli misti che tengano conto del donatore rappresentano approcci alternativi per ulteriori valutazioni.
I saggi su tessuti provenienti da pazienti forniscono evidenze ortogonali preliminari di un maggiore abbondanza di MMP1. Il confronto è stato effettuato con tessuto perilesionale non ulcerato proveniente dagli stessi pazienti, pertanto la differenza rispecchia variazioni locali associate all'ulcera all'interno del tessuto diabetico, piuttosto che un confronto con cute sana. Le misurazioni di WB ottenute da tre coppie di pazienti appaiate e le misurazioni di qPCR da quattro coppie appaiate confermate dagli autori sono state analizzate mediante test appaiati, mostrando le singole osservazioni biologiche. Per la qPCR, le replicate tecniche sono state mediate all'interno di ogni campione e l'inferenza si è basata su ΔCq; le replicate tecniche non hanno incrementato la dimensione del campione biologico. La coerenza nel verso delle osservazioni appaiate sostiene un confronto preliminare sull'espressione, ma le piccole dimensioni dei gruppi non consentono di stabilire la generalizzabilità né di valutare in modo affidabile le assunzioni distribuzionali. L'abbondanza nel tessuto bulk non permette di determinare la localizzazione cellulare della proteina, l'attività enzimatica o un effetto causale sulla guarigione. Sono necessari gruppi più ampi con caratterizzazione clinica completa. Altri limiti includono covariate cliniche incomplete, tessuti di confronto diversi, un insieme genico DPN derivato dalla letteratura e non completamente documentato, e registrazioni incomplete della sottrazione del fondo nelle immagini originali dei blot. Tessuto sano, tessuto di controllo definito nello studio e cute diabetica del piede non ulcerata non devono essere considerati intercambiabili.
La rete TCM è un'estensione volta alla generazione di ipotesi. I pesi personalizzati riassumono la copertura del database piuttosto che l'interazione con il bersaglio o l'efficacia, e le classifiche potrebbero variare in base al contenuto del database e alle scelte dei pesi. La quercetina e la berberina presentano inoltre un'esposizione sistemica variabile o limitata17,18. Gli ingredienti e le erbe candidati richiedono quindi test diretti su bersagli, risposta dose-dipendente, farmacocinetica, tossicità e funzionalità. Studi futuri dovrebbero combinare coorti indipendenti ben documentate con localizzazione spaziale e perturbazione di MMP1 in fibroblasti primari o modelli multicellulari di ferita. I risultati attuali supportano MMP1 come candidato associato alle ulcere del piede diabetico (DFU) in un contesto di rimodellamento della matrice centrato sui fibroblasti, senza tuttavia stabilire un rapporto di causalità o un'utilità clinica.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Questa ricerca è stata sostenuta dal Progetto di Ricerca Scientifica Medica Municipale di Wuhan (Progetto di Guida, numero di concessione WX23Z77), gestito dalla Commissione Sanitaria Municipale di Wuhan.
Gli autori ringraziano i partecipanti che hanno fornito i campioni di tessuto per questo studio e i ricercatori che hanno generato e depositato i set di dati disponibili pubblicamente nel Gene Expression Omnibus del NCBI.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Strip di provette PCR trasparenti sottili da 0,2 mL | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| Punte filtranti sterili da 1.000 μL | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| Provette microcentrifuga sterili da 1,5 mL, prive di DNasi/RNasi | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| Punte filtranti sterili da 10 μL | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| Mastermix PCR SYBR Green 2× | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| Soluzione tampone al Tris 20× (TBS) | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| Punte filtranti sterili da 200 μL | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| Coppia di primer qPCR per ACTB | Solarbio Life Sciences (sintesi personalizzata di oligonucleotidi) | Personalizzato | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Svezia | Amersham Imager 600 | Modello registrato in tutti i 22 file TIFF forniti; software operativo Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Kit per saggio proteico con acido bicinconcinico (BCA) | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Versione 4.16.0 |
| Anticorpo policlonale contro la cofilina (coniglio anti-cofilina) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Cina) | 10960-1-AP | Diluizione WB utilizzata in questo studio: 1:6.000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Risorsa ingrediente-target |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Versione 1.48.2 |
| Acqua priva di DNasi/RNasi | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / autori e1071 | https://cran.r-project.org/package=e1071 | Versione 1.7-17 |
| Substrato chemiluminescente ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | National Center for Biotechnology Information | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | National Center for Biotechnology Information | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | National Center for Biotechnology Information | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | National Center for Biotechnology Information | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | National Center for Biotechnology Information | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Gene Ontology Consortium | https://geneontology.org/ | GO |
| ggplot2 | Sviluppatori di ggplot2 | https://ggplot2.tidyverse.org/ | Versione 4.0.3 |
| glmnet | CRAN / autori glmnet | https://cran.r-project.org/package=glmnet | Versione 5.0 |
| Tabella di riferimento erbe-ingrediente | Fonte non riportata nel manoscritto | Non riportato | Non documentato: nome esatto del database/file, versione/data e URL di accesso pubblico |
| IgG (H+L) di capra anti-coniglio coniugata con HRP | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Cina) | SA00001-2 | Diluizione WB utilizzata in questo studio: 1:5.000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Campioni di tessuto umano da ulcera del piede diabetico | Ospedale Quarto di Wuhan, Wuhan, Cina | N/A | Campioni DFU abbinati ai pazienti; qPCR n=4 campioni; WB n=3 campioni; protocollo approvato KY2024-161-01 |
| Campioni di tessuto perilesionale non ulcerato umano | Ospedale Quarto di Wuhan, Wuhan, Cina | N/A | Comparatore perilesionale abbinato ai pazienti; qPCR n=4 campioni; WB n=3 campioni; protocollo approvato KY2024-161-01 |
| ImageJ | National Institutes of Health | https://imagej.net/ij/ | Versione non documentata |
| Kyoto Encyclopedia of Genes and Genomes | KEGG | https://www.genome.jp/kegg/ | Codice organismo umano hsa |
| Elenco di geni DPN curato dalla letteratura | Componente derivato dalla letteratura; tabella sorgente a livello genico non completamente documentata | Non riportato | Provenienza a livello genico non completamente documentata |
| Spettrofotometro UV-visibile microvolume | Produttore/modello non riportato nel manoscritto | Non riportato | Non documentato: produttore esatto, modello e URL del prodotto; uso dichiarato: concentrazione dell'RNA e valutazione A260/A280 |
| Anticorpo policlonale contro MMP1 (coniglio anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Cina) | 10371-2-AP | Diluizione WB utilizzata in questo studio: 1:1.000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| Coppia di primer qPCR per MMP1 | Solarbio Life Sciences (sintesi personalizzata di oligonucleotidi) | Personalizzato | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/gene/ | Database geni umani |
| Latte in polvere scremato, reagente bloccante | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Versione 3.21.0 |
| Gel SDS-PAGE preformato, gradiente 4%–20% | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / autori pROC | https://cran.r-project.org/package=pROC | Versione 1.19.0.1 |
| Miscela inibitrice di proteasi, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| Sistema di trasferimento proteico | Produttore/modello non riportato nel manoscritto | Non riportato | Non documentato: produttore esatto, modello e URL del prodotto; uso dichiarato: trasferimento su membrana PVDF da 0,22 μm |
| Membrana PVDF, 0,22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | Fondazione R per il calcolo statistico | https://www.r-project.org/ | Versione 4.5.2 |
| randomForest | CRAN / autori randomForest | https://cran.r-project.org/package=randomForest | Versione 4.7-1.2 |
| Strumento per PCR in tempo reale | Roche Diagnostics | LightCycler 96 | Versione del software non confermata. Il volume/cicli del progetto differiscono dal protocollo riportato; il collegamento esatto dell'esperimento deve ancora essere verificato. |
| Microcentrifuga refrigerata | Produttore/modello non riportato nel manoscritto | Non riportato | Non documentato: produttore esatto, modello e URL del prodotto; uso dichiarato: 12.000 × g per 15 min a 4 °C |
| rentrez | CRAN / autori rentrez | https://cran.r-project.org/package=rentrez | Versione 1.2.4 |
| Tampone di lisi RIPA ad alta concentrazione | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| Sistema elettroforesi SDS-PAGE | Produttore/modello non riportato nel manoscritto | Non riportato | Non documentato: produttore esatto, modello e URL del prodotto; uso dichiarato: separazione proteica su gel a gradiente 4%–20% |
| Seurat | Satija Lab / sviluppatori Seurat | https://satijalab.org/seurat/ | Versione 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Versione 2.10.0 |
| Omotenizzatore tissutale | Produttore/modello non riportato nel manoscritto | Non riportato | Non documentato: produttore esatto, modello e URL del prodotto; uso dichiarato: omogeneizzazione tissutale in tampone di lisi ghiacciato |
| Reagente TriQuick per l'estrazione totale di RNA | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Cappucci piatti ultra-trasparenti per strip di provette PCR da 0,2 mL | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Kit RT-PCR universale (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / autori WGCNA | https://cran.r-project.org/package=WGCNA | Versione 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Riferimenti
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.