トランスレーショナル ・ リサーチのための理想的なマウス モデルを識別するトランスクリプトーム データの遺伝子セット濃縮分析用標準プロトコルを提供します。
このプロトコルは、dna と RNA シーケンス データで使用できるし、データが利用可能な場合他のオミックス データをさらに拡張することができます。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
マウス モデル従来の遺伝子-遺伝子比較技術を使用してからデータセットを人間の病気のトランスクリプトームのデータセットを比較した最近の研究の動物モデルの妥当性に関する矛盾した結論の結果並進研究。異なる遺伝子発現解析の間の相違の主な理由は、特異的発現遺伝子の任意のフィルタ リングです。さらに、単一の遺伝子種と多くのプラットフォームとの間の比較は、人間と動物モデルからのデータ間のコン/不一致の誤解につながる技術の差異によって制限されます。したがって、体系的なデータ解析のための標準化されたアプローチが必要です。主観的な遺伝子のフィルタ リングと非効果的な遺伝子-遺伝子比較を克服するために我々 は最近、遺伝子セット濃縮分析 (GSEA) これらの問題を回避する可能性があることを示した。そこで、トランスレーショナルリサーチの適切と不適切な動物モデルを区別する GSEA の使用のための標準化されたプロトコルを開発しました。このプロトコルは、それは既存の実験的オミックス データを必要と-先験的モデルの新しいシステムを設計する方法を予測するため適していません。ただし、プロトコルでは、このように不必要な動物実験を避けるとトランスレーショナル研究を誤解を招く最も適切な動物モデルを選択するために標準化された方法で既存のデータを解釈する方法について説明します。
概要
動物モデルは、遺伝学、解剖学と生理学の観点から人間を想定した類似性のための人間の病気の研究に広く使用されます。また、動物モデルはしばしば臨床治療にゲートキーパーとして、橋渡し研究の成功に大きな影響を持つことができます。最適な動物モデルの慎重な選択は、誤解を招く動物実験の数を減らすことができます。最近では、橋渡し研究の動物モデルの関連性議論されている論争的、矛盾した結論を導いた人間の炎症性疾患と関連するマウス モデルから得られた同じデータセットを分析するために特に1,2。この議論は、オミックス データを分析中に根本的な問題を明らかにした: 偏りのある遺伝子淘汰を減らすために、種間比較3の堅牢性を高めるため体系的なデータ解析のための標準化されたアプローチが必要です。
伝統的に、トランスクリプトーム データ (および他のオミックス データ) の分析が単一遺伝子レベルで行われます、厳格なカットオフ パラメーターに基づく遺伝子選択の最初のステップが含まれています (例えばフォールドの変更を > 2.0、p 値 < 0.05)。ただし、初期カットオフ パラメーターの設定は多くの場合主観的、恣意的で生物学的正当化されなかったは、反対の結論1,2にもつながることができます。さらに、初期遺伝子淘汰は一般的に、いくつか高度のアップとダウンレギュ レート遺伝子分析を制限してより少ない程度に発現された遺伝子の大半を含むように十分な区別はこうして。
2000 年代初頭のゲノミクス時代の上昇と生物学的経路とコンテキストの知識を増やす、統計的方法は、単一遺伝子レベルの解析の限界を回避するために許可されて開発されました。遺伝子セット濃縮分析 (GSEA)4、トランスクリプトーム データの解析のための広く受け入れられている方法の一つである、遺伝子 (例えば、シグナル伝達経路、染色体などの近位場所。) の事前定義グループを使用します。GSEA 最初式で彼らの個々 の変更に関係なくすべて検出されたフィルター処理されていない遺伝子 (例えば経路)、目的の遺伝子セットをマップします。従ってこのアプローチにはも適度に調整された遺伝子単一遺伝子レベルの解析と失われるそれ以外の場合が含まれます。遺伝子セット内の式で添加剤の変更が実行中の合計の統計情報を使用してを実行してその後。
医学研究における広い使用、にもかかわらず GSEA と関連セット濃縮方法がない 考慮複合オミックス データの分析のため。ここでは、橋渡し研究のための理想的なモデルを識別するためにマウス モデルからひと試料からオミックス データを比較するためのプロトコルについて述べる。人間の炎症性疾患を模倣するために使用されるマウス モデルのコレクションに基づくプロトコルの有効性を示す.しかし、この解析パイプライン人間マウス比較に制限されていません、さらに amendable 研究質問です。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
1 GSEA ソフトウェアおよび分子シグネチャ データベースのダウンロード
- 公式 GSEA 広範な研究所のウェブサイト (http://software.broadinstitute.org/gsea/index.jsp) に移動し、GSEA ソフトウェアへのアクセスを得るために登録。ツールと分子シグネチャ データベース (MSigDB).
- ダウンロード javaGSEA デスクトップ アプリケーションまたは別のソフトウェア オプション (例えば、R スクリプト).
注: すべてのオプションは、まったく同一のアルゴリズムを実装します。GSEA ソフトウェア学界と業界内部の研究目的のために個人に自由に利用可能です 。
- さらに GSEA ソフトウェアの詳細については、ドキュメントのウェブサイト (http://software.broadinstitute.org/cancer/software/gsea/wiki/index.php/Main_Page)、GSEA ユーザー ガイド (http://software.broadinstitute.org/gsea/doc/ に行くGSEAUserGuideFrame.html).
- 個々 の遺伝子セットのコレクションへのアクセスを得るためには、GSEA ウェブサイトから分子シグネチャ データベース (MSigDB) をダウンロードします
。 注: MSigDB は GSEA ソフトウェアまたはその他の目的で使用するための注釈付きの遺伝子セットのコレクションです。遺伝子セットは、シグナル伝達経路、遺伝子オントロジー利用規約、cis 調節モチーフ、実験の署名によると分けることができます。その公式のヒューゴ (人間のゲノムの組織) 遺伝子の記号によって常に、MSigDB から遺伝子と呼びます。与えられた人体の疾病と異なるマウス間経路制御の比較モデルのそれは、ダウンロードをお勧めは、' すべての正規の経路、遺伝子記号 ' ファイル (c2.cp.v5.2.symbols.gmt)。このファイルに注釈され、KEGG 5 , 6 Reactome 7 、 8 BioCarta シグナル伝達経路に主催遺伝子セットが装備されています。 9 します。 文字列 ' v5.2 ' コレクションのバージョン情報を表します。ファイルの最新バージョンをダウンロードすることを確認します。MSigDB は、学界と業界内部の研究目的のために個人に自由に利用可能です。分析中にインターネット接続が提供されている場合、それは、MSigDB をダウンロードする必要ありません。この場合、MSigDB は直接 GSEA ユーザー インターフェイス内で選択することができます 。
- ダウンロード DNA チップ プローブ アレイ固有識別子が一般的な HUGO 遺伝子記号 (例えば、Mouse430_2.chip) を翻訳する GSEA のウェブサイトから (配列) アノテーション ファイル
。 注: それは必要ありません DNA チップ注釈をダウンロードする場合は分析中にインターネット接続を提供します。ここでは DNA チップ注釈は GSEA ユーザー インターフェイス内で直接選択できます。プロトコルは、RNA シーケンス データとも使用できます。この場合、それはアノテーション ファイルをダウンロードする必要はありません。代わりに、(ステップ 4.12 を参照) の遺伝子発現データを分析するため GSEA preranked ツールを使用します 。
2。人体の疾病と適切な動物モデルの実験的遺伝子発現データをダウンロード
- 識別実験的遺伝子発現産物研究人間障害 (例えば、遺伝子発現プロファイルの選択のためGSE9960 敗血症性障害患者由来の白血球). 人間の研究 (例えば、黄色ブドウ球菌 (ブドウ球菌)、 GSE20524 の投与後マウス由来の血液細胞の遺伝子発現プロファイル) と比較されることになっている
- 同様に、いくつかの動物のための検索モデル。この段階で人間の状況を模倣するために適しているかもしれない動物モデルの予選の事前の知識を使用します 。
- この目的の文献を参照してくださいおよび遺伝子発現オムニバス (GEO) などのデータベース データベースの 10 または ArrayExpress 11 および興味の正規化されたトランスクリプトーム データをダウンロードします。ローカル ハード_ディスク上のテキスト ファイルとしてデータを保存します。GEO データベース タブ区切りシリーズ マトリックス本文ファイルのダウンロードをお勧めします。またこの情報は一般的な HUGO 遺伝子シンボルにプローブ アレイ固有識別子を変換するために必要ですので、研究用プラットフォーム (配列型) の注意してください
。 注: データの記憶域に十分なメモリを確保は、トランスクリプトーム データ セットは通常数百 MB を占めています 。
3。データ処理および書式設定
- GSEA のソフトウェア ツールに実験的遺伝子発現データをインポートする前に必要なデータ構造体を考えます。各研究の 2 つのファイルを手動で作成: さまざまな遺伝子や、サンプルの測定値を含む 1) 遺伝子表現データ ファイルとグループ化 (例えば、治療グループに) 個々 のサンプルにサンプル ラベルを含む 2) 表現型ファイル
。 さらなる詳細とデータ構造オプション GSEA データ形式] ページ (http://software.broadinstitute.org/cancer/software/gsea/wiki/index.php/Data_formats) を参照してください
。 注: 一般的には、トランスクリプトーム データのすべてのフォーム、チップ seq 研究や RNA seq DNA マイクロ アレイ実験を含むプロトコルと互換性があります。DNA マイクロ アレイ実験を用いた場合遺伝子表現データ ファイルはアレイ固有のプローブ id や各遺伝子 (プローブ分析、1.5 と 4.10 手順中に識別子をヒューゴ遺伝子記号に変換されます) HUGO 遺伝子記号を含める必要があります。RNA シーケンスまたはチップ seq データを使用する場合は、遺伝子発現データ (例えば、グループ平均比) のメトリックを手動で計算されたグループを使用して個々 のサンプル データではなくください。これらのグループ メトリック GSEA preranked ツールを使って分析する必要があります (手順 4.12 を参照してください)。遺伝子発現データは GSEA ソフトウェアにインポートする前にいつものように正規化する必要があります。(例えば、四分位数またはスプライン) の正規化のタイプ一般に研究者に任されています 。
- 遺伝子発現データ ファイル: タブ区切りのテキスト ファイル (*.txt) 形式を使用して、 図 1 a に示されている、式のデータセットを記述するため。またファイルのサポートされている例を参照してください GSE20524_expression.txt
。 注: 遺伝子発現データ ファイルを含む すべて の検出可能な遺伝子 (またはプローブ)、式の値も可能性がありますいない発現する遺伝子。したがって、ファイルには何千もの遺伝子の通常装備されています。それは、 図 1 a に示されているように整理されています。最初の行にラベル名が含まれている (例えば、遺伝子記号またはプローブ ID) (例えば サンプル 1、サンプル 2 など) は、データセット内の各サンプルの識別子が続きます。ファイルの残りの部分には、それぞれの遺伝子と、データセット内の各サンプルの式の値が含まれています。GSEA ソフトウェア ツールは、グループ測定値 (例えば、グループ平均比率または信号にノイズ比) の計算を実行、したがってそれぞれの個々 のサンプルのデータを含めるをお勧めします。また、遺伝子発現データ ( 図 1B 参照) の外部計算されたグループ メトリックを使用することが可能です 。
- 表現型ファイル: 定義およびグループにラベルを付ける構成個々 のサンプルに示すように別のファイルを作成 < 強いクラス「xfig」= > 図 2。スペースまたはタブを使用してフィールドを区切ります。CLS (C++ クラス定義) ファイル形式で保存します。またファイルのサポートされている例を参照してください GSE20524_pheno_infection.cls
。 注: 最初の行には、サンプルの合計数とさらにグループ ( 図 2) の数が含まれます。サンプルの数は遺伝子表現データ ファイルに対応する必要があります間 (3.2 を参照)、グループの数は研究デザインによって異なります。最初の行の 3 番目のフィールドは、常に ' 1 '.
CLS ファイルの 2 行目には、各グループの名前が含まれています。行はポンド記号 (#) の後にスペース ( 図 2) に始まるべきである
。 3 番目の行には、各サンプルのグループ ラベルが含まれています。グループのラベルには、任意の数またはテキストを指定できます。それはグループに各サンプルの協会を決定するラベルの順序のみ: 使用される最初のラベルは 2 番目の行の最初のグループに割り当てられています。2 番目のユニークなラベルは、ように 2 番目のグループに割り当てられます。同じグループの各サンプルでは、このステップの同じラベルとラベルの数が最初の行で指定されたサンプルの数と同じであることを確認します。最後に、タブ区切りのテキスト ファイル (*.txt) としてファイルを保存し、(*.cls) にファイル名拡張子を手動で変更します 。
- (省略可能) 遺伝子データベースの設定ファイル: カスタムの遺伝子のセットを定義します。 図 3 に示されている、遺伝子セットの GMT (遺伝子行列の転置) ファイルのタブ区切り形式を使用します。またファイルのサポートされている例を参照してください Gene_sets_Inflammation_BIOCARTA_KEGG_REACTOME.gmt
。 注: カスタムの遺伝子セットを定義することができます例えば遺伝子を制限する (例えば、免疫シグナリングの敗血症研究)、特別な関心のまたは独自の遺伝子セットを定義する de novo 経路に濃縮分析を設定 (例えば、活性化し、比較するの研究で遺伝子を抑制した)。ファイルは、 図 3 に示したように編成されます。GMT フォーマットでは、各行は、遺伝子セット ( 図 3) を表します。各遺伝子セットは、名前、説明、および遺伝子セットの遺伝子によって記述されます。最初の列には、ユニークな遺伝子セットの名前が含まれています。2 行目は、遺伝子セットの説明を含めることができます。次の列には、対応する遺伝子セットの遺伝子名 (公式 HUGO 遺伝子記号) が含まれています。最後に、タブ区切りテキスト ファイル (*.txt) としてファイルを保存し、ファイル名拡張子を手動で変更 (* .gmt).
4。実行して、GSEA
- GSEA ソフトウェア ツールを開きます (1.2 を参照してください).
- クリックして、' データを読み込む ' メイン ウィンドウ ( 図 4 a) の左側にあるボタン。必要なデータ ファイル ( 図 4 b) のインポートの新しいタブが開きます。遺伝子表現データ (*.txt) ファイルに新しいタブで参照 (3.2 を参照)、表現型 (*.cls) ファイル (3.3 を参照) と、必要に応じて、カスタムの遺伝子セット (* .gmt) ファイル ( 図 4 b).
- は GSEA がインターネットに接続できない場合にもダウンロードした MSigDB ロード (* .gmt) ファイル (例えば、c2.cp.v5.2.symbols.gmt 経路の 1.4 を参照)、DNA チップ (配列) の注釈 (* .chip) ファイル (例えば、Mouse430_2.chip、1.5 を参照)。正常にインポートされたデータに表示されます、' データを読み込む ' セクション ( 図 4).
注: 各遺伝子発現の調査は分析されなければならない GSEA を個別に。手順 5 で 2 つの研究 (例えば 人間障害対マウス モデル) との比較を行います 。
- は GSEA がインターネットに接続できない場合にもダウンロードした MSigDB ロード (* .gmt) ファイル (例えば、c2.cp.v5.2.symbols.gmt 経路の 1.4 を参照)、DNA チップ (配列) の注釈 (* .chip) ファイル (例えば、Mouse430_2.chip、1.5 を参照)。正常にインポートされたデータに表示されます、' データを読み込む ' セクション ( 図 4).
- をクリックして、' 実行 GSEA ' メイン ウィンドウの左側にあるボタン。( 図 4) 解析のパラメーターを設定するために新しいタブが開きます。タブは 3 つの部分に分割されます: 必須、基本フィールド、詳細フィールド 。
- 必須フィールド で 式データセット に 4.2 ( 図 4) の手順でロードを選択最初します 。
- 接続の web サイトから、または手動でインポートされた遺伝子設定ファイル ( 図 4) から 遺伝子設定データベース を選択します 。
- (例えば、黄色ブドウ球菌 の治療 と 健康コントロール) 互いに比較することになっているサンプルのグループを選択する 表現型ラベル を編集する ( 図 4).
- 遺伝子シンボルに崩壊データセット 遺伝子セットのデータベースで使用される公式のヒューゴ遺伝子記号式データセット内のプローブ id を翻訳するために (= true)。式のデータセットに既にヒューゴ遺伝子記号 ( 図 4) が含まれている場合 false を選択します 。
- ( 図 4) を 1,000 に順列の数 の既定の設定を設定します
。 注: 高い数値計算時間が大幅に増加します 。
- 置換型 を変更 ' 遺伝子セット ' 表現型順列が推奨されるすべての表現型 ( 図 4) には、7 つ以上のサンプル場合だけですので、.
- は、最後に、遺伝子発現データを生成するために使用されるチップ プラットフォームを選択、接続されている web サイトまたは手動でインポートされた DNA からチップ (配列) アノテーション ファイル ( 図 4).
注: この手順がアップロードされた発現データセットでプローブ識別子を使用する場合、必要に応じてのみです 。
- 基本フィールド で少なくとも結果ファイル ( 図 4) を再び見つけるため 解析名 と このフォルダーに結果を保存 セクションを編集します。さらにさらに、統計的パラメーターは変更できます。さらに、パラメーターおよび 高度なフィールド] セクションの詳細については GSEA ユーザー ガイド (http://software.broadinstitute.org/gsea/doc/GSEAUserGuideFrame.html) にアクセスしてくださいのです 。
- (省略可能): 遺伝子発現データ (例えば、グループ平均比) を個々 のサンプル データの代わりに使用する必要のケースの外部計算されたグループ メトリック、GSEA preranked ツールを使用します。解析は遺伝子をランク付けに使用される計算済みグループ測定値に割り当てられている遺伝子の単純なリストを基に実施します。代替遺伝子式ファイルをロードした後メイン ナビゲーション バーに移動し、ツール/GseaPreranked をクリックします。同様に、新しいタブが分析 ( 図 4E) パラメーターの設定を開きます
。 注: GSEA preranked ツールを使用して個々 のサンプルに固有の遺伝子発現データを持っていない研究のため勧めします。個々 のサンプル データではなくグループの平均値につながるデータの特別な統計や正規化の手順を行った場合になります。RNA シーケンス データは、GSEA preranked ツールを使用することをお勧めします。RNA シーケンス式データを正規化し、彼らの表現によると遺伝子をランク付けに使用することができますサンプル (例えば フォールドの変更のログ)、グループ メトリックスを計算します 。
- をクリックして、' 実行 ' ウィンドウの右下のボタンです
。 注: 分析し、かかることがあります計算速度に応じて数分。ウィンドウの左下に GSEA レポート セクションの解析の進行に従います。状態分析を終えて ' 成功 ' GSEA レポート] セクションに表示されます 。
解析結果を開く GSEA レポート] セクションで、成功の - クリック解析します
。 注: 新しいナビゲーション メニューがすべての結果とパラメーター設定 ( 図 5) をまとめたブラウザー ウィンドウで開きます。ナビゲーション メニューの上部の 2 つのセクションを構成します。遺伝子は、定義済みのグループ (例えば、S. 扱われる球菌サンプルまたは健康な対照サンプルの濃縮) の濃縮の結果を設定します。両方のセクションの最初の行では、統計結果の概要を示します。False 発見率 (FDR) 25% 以下でかなり濃縮されている遺伝子セットは、次の解釈の濃縮と見なされます。GSEA ユーザー ガイド (http://software.broadinstitute.org/gsea/doc/GSEAUserGuideFrame.html) の分析の解釈についての詳細を見つけることができます 。
- クリック で詳細な濃縮結果エクセル形式 分析結果をスプレッドシート ( 図 6 a) にエクスポートするに。で豊かな詳細結果 excel 両方の表現型 ( 図 5) 個別をエクスポートし、1 つのスプレッドシート ファイルに結果データを結合します。その後いくつかの研究では、遺伝子発現データを比較維持遺伝子セット (列 A) の名前で、少なくともの正規化された濃縮スコア (ファミコン) (列 F) とその FDR (虚偽の発見率) の値 (列 H) ( 図 6B).
注: スプレッドシート ファイルにごとに分析したは膨大なデータが含まれている遺伝子を遺伝子セット (列 A) のサイズ (つまり、列 D の遺伝子発現データで検出された遺伝子の数) の名前を含む、そのファミコン設定 (方向の定量的測定と濃縮、F 列の範囲)、その公称 p 値 (裸眼、列 G) と (H 列複数仮説の修正) FDR 値。さらの解釈の詳細についてを参照してください GSEA ユーザー ガイド (http://software.broadinstitute.org/gsea/doc/GSEAUserGuideFrame.html) です 。
- は、2 番目の研究 (例えば、黄色ブドウ球菌 GSE9960)、互いに比較することになっているすべてのさらなる研究、遺伝子設定濃縮分析 (手順 4.1 に 4.15) を繰り返します。トランスレーショナル ・ リサーチの質問に最適なマウス モデルを識別するために可能な限り多くの臨床研究と異なるマウス モデルが含まれます 。
5。GSEA 結果を比較する
- GSEA 結果互いにすべての研究の人間の状況比較を模倣するため最適な動物モデルを識別するために
- 。濃縮スコアと FDR 値を使用して、アクティブ化されたときに経路 (遺伝子セット) を分類 (ファミコン > 0、FDR < 25%)、抑制 (ファミコン < 0、FDR < 25%) または両方のどれも (FDR > 25%)。2 つの研究の各比較のため 3 x 3 分割表 ( 図 7 a) によって示される経路制御の 9 つの可能な組み合わせの認識の数をカウントします 。
- 評価、肯定的な予言する値 (ppv) の計算による 2 つの研究と定義によって 2 つの研究で同じ規制 (アクティブ化または抑制) を示す経路の一部である否定的な予測値 (npv) との相関.
- 計算 ppv と npv 次の式 (1) と (2) によると:
(1)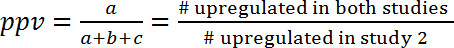
(2)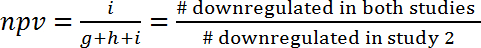
注: 重複だったため純粋な偶然、ppv と、npv がさらに偶然と予想される値と比較します。この方法は、別の研究で影響を予測する 1 つの研究から得られる情報量の推定できます。たとえば、2 つのモデルの規制プロセス互いから独立した (と偶然重なるのみ)、最初のモデルで、経路の 10% であった誘導、2 番目のモデルに ppv も 10% になるし、追加があった場合利得 inf情報。反対側で、両方のモデルは、一般的な規制メカニズムによってリンクされていた場合、ppv (および npv) なります偶然予想よりも大幅に大きかった。たとえば、マウス s. 球菌インジェクション モデル (GSE20524) の影響から人間敗血症 (GSE9960) 時の遺伝子発現変動の予測、ppv は 43% (6/(6+8+0))、npv は 61% (11/(0+7+11))。つまり、マウス s. 球菌インジェクション モデル (GSE20524) における活性化経路の 43% も人間敗血症 (GSE9960) 中にアクティブ化されます。同様に、マウス s. 球菌インジェクション モデル (GSE20524) における抑制経路の 61% も人間敗血症 (GSE9960) の間に抑制される ( 図 7 b)。ppv と npv は (つまり 2 を勉強する 1 の研究から予測) 逆の方角にも判断できます 。
- 計算 ppv と npv 次の式 (1) と (2) によると:
- の重なりを計算する偶然 3 x 3 分割表 ( 図 7) を参照し、ppvchance および次の式 (3) と (4) によると npvchance を計算:
(3) < img alt =「方程式 3」src ="/files/ftp_upload/55768/55768eq3.jpg"/>
(4)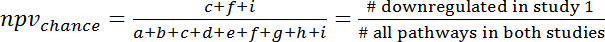
注: たとえば、マウス, 黄色ブドウ球菌の効果から人間敗血症 (GSE9960) 時の遺伝子発現変動の予測インジェクション モデル (GSE20524)、ppvchance は 13% (8/64)、npvchance、22% (14/64). - は、ppv から ppvchance を減算することでチャンス対 ppv のゲインを計算します。それに応じて計算 npv の:
(5)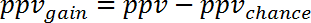
(6)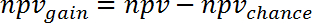
注: たとえば、遺伝子の予測マウス s. 球菌インジェクション モデル (GSE20524) の効果から人間敗血症 (GSE9960) 中に表現変更 ppv の変化とチャンス対 npv は +30% (13% 43%) と +39% (61%-22%)、それぞれします 。
- は、ppvgain と npvgain を平均することによってに関する研究 1 研究 2 から得られる情報の利得を計算する:
(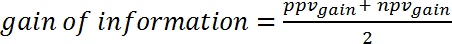 7)
- ペアの研究 (study1.pathway, study2.pathway) カイ二乗テストによる p 値を計算する、5.1 手順で定義した分割表を使用して
X. 実行カイ二乗検定 など 行列に分割表のデータ格納、R の使用により機能する chisq.test です
。 注: たとえば、マウス 黄色ブドウ球菌 選択した人間敗血症研究 (GSE9960) の比較インジェクション モデル (GSE20524) は、統計的に有意な重複炎症経路制御:
> chisq.test(X,simulate.p.value=F)$p.value
3.82e-07
6。最適な動物モデルを識別する
- 比較、GSEA 解析した研究のすべての組み合わせの結果です
。 注: それを互いに異なる動物の研究と同様、互いに (同じような) 人間の研究を比較するお勧めも。この比較臨床試験 (または障害) の種族内の分散に洞察力を提供できる動物モデルが異なる。臨床研究する必要がありますを示す許容オーバー ラップと重要な情報を得るため、そうでなければ臨床研究は、人間の状況をまねることができる動物のモデルを見つけるにも異種かもしれないので期待されます。この場合は、適切な動物モデルの同定の互いに類似している人間の研究のみが含まれてお勧めします 。
- はすべての組み合わせの情報 (ステップ 5.5) のゲインを並べ替えます。多くのデータセットの比較のためのマトリックスを使用し、色ヒートマップなどの使用によって調査結果を可視化する ( 図 8).
- は、情報の最高の利得動物モデルを選択します。情報利得の意義を評価するためにまた考慮カイ二乗検定 (ステップ 5.6).
注: 動物モデルだけみなされるべき適切な情報のゲインが相当な場合、カイ 2 乗検定の p 値が有意水準を下回る場合。ユーザー定義のしきい値は、一般的にいくつかの要因に依存: 1) 動物モデルから結果を人間 (例えば同じような生理学)、2)、3) 実用的な推定成功によって人間のため、期待される利益の譲渡に関する事前調査の知識動物実験ではと 4 の適用性) 予想される苦痛、苦労、またはラボの害礼拝堂動物 。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
GSEA ワークフローと模範的なデータのスクリーン ショットを示した。図 1は、関心のトランスクリプトーム データを含む遺伝子表現データ ファイルを示しています。わかりやすい表現型ファイルすべての研究が必要を図 2に示します。(例えば経路) の注釈付きの遺伝子セットは、遺伝子セットのデータベース ファイル (図 3) で定義されます。図 4は、GSEA ソフトウェア ツールの使用のための段階的なプロトコルを示します。模範的な結果レポートは、図 5に示されます。図 6は、GSEA 濃縮結果の詳細をまとめたものです。異なる遺伝子発現研究の比較のため特にマウス研究対人間、コンティンジェンシー テーブルが必要...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
動物モデルは、疾患発現機構の解明と新規治療戦略の開発の適用されている長い。しかし、動物モデルの予測性について懐疑的な見方は、次の臨床試験12の失敗を広めるため始めた。さらに、適切な戦略を分析し、前臨床試験から大きなオミクス データの解釈について論争の議論は、同じデータから異なるデータ分析戦略1 を適用した後反対の結論によって提起されました。 ,2。したがって、体系的に特定の人間の病気のため最適な動物モデルの定義にさらに堅牢なバイオインフォマティクス技術の複雑なオミックス データ解析のための高需要があります。最高の使用可能なモデルを適用するだけではなくトランスレーショナルリサーチを向上しますが、さらに人間の状況と相関がない場合があります動物実験を避けることによって動物の福祉に貢献します。
提案するプロトコルは、体系的に最適な動物モデルと特定の人間の無秩序のための治療プロトコルを識別する目的で異なる種のオミックス データを...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者は、彼らは競合する金銭的な利益があることを宣言します。
謝辞
この作業は、リスク アセスメント (BfR) ドイツ連邦研究所によって融資されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Excel | マイクロソフト株式会社 |
参考文献
- Seok, J., et al. Genomic responses in mouse models poorly mimic human inflammatory diseases. Proc Natl Acad Sci U S A. 110 (9), 3507-3512 (2013).
- Takao, K., Miyakawa, T. Genomic responses in mouse models greatly mimic human inflammatory diseases. Proc Natl Acad Sci U S A. 112 (4), 1167-1172 (2015).
- Weidner, C., Steinfath, M., Opitz, E., Oelgeschläger, M., Schönfelder, G. Defining the optimal animal model for translational research using gene set enrichment analysis. EMBO Mol Med. 8 (8), 831-838 (2016).
- Subramanian, A., et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 102 (43), 15545-15550 (2005).
- Kanehisa, M., Sato, Y., Kawashima, M., Furumichi, M., Tanabe, M. KEGG as a reference resource for gene and protein annotation. Nucleic Acids Res. 44 (D1), D457-D462 (2016).
- Kanehisa, M., Goto, S. KEGG: kyoto encyclopedia of genes and genomes. Nucleic Acids Res. 28 (1), 27-30 (2000).
- Fabregat, A., et al. The Reactome pathway Knowledgebase. Nucleic Acids Res. 44 (D1), D481-D487 (2016).
- Croft, D., et al. The Reactome pathway knowledgebase. Nucleic Acids Res. 42 (Database issue), D472-D477 (2014).
- Nishimura, D. BioCarta. Biotech Software & Internet Report. 2 (3), 117-120 (2001).
- Edgar, R., Domrachev, M., Lash, A. E. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 30 (1), 207-210 (2002).
- Kolesnikov, N., et al. ArrayExpress update--simplifying data submissions. Nucleic Acids Res. 43 (Database issue), D1113-D1116 (2015).
- Cohen, J., et al. Sepsis: a roadmap for future research. Lancet Infect Dis. 15 (5), 581-614 (2015).
- Spinelli, L., Carpentier, S., Montanana Sanchis, F., Dalod, M., Vu Manh, T. P. BubbleGUM: automatic extraction of phenotype molecular signatures and comprehensive visualization of multiple Gene Set Enrichment Analyses. BMC Genomics. 16 (1), 814(2015).
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
再版と許可
