この研究は、外国語アクセントの影響がメトリックと韻律音響パラメータの両方、および音声ラインナップのターゲット音声の選択にどの程度影響するかを確認するために、L1-L2-EnglishとL1-L2ポルトガル語を比較することを目的としています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
本研究は、外国語アクセントの英語と外国語アクセントのブラジルポルトガル語の韻律音響的特徴と知覚的相関性の両方を調べ、話者の外国語アクセントとネイティブアクセントの制作がリスナーの知覚とどのように相関しているかを確認することを目的としています。方法論では、L2ブラジルポルトガル語のアメリカ人グループとL2英語のブラジル人グループとの音声生成手順と、両方の言語の音声ラインナップを実行する音声認識手順を実行しました。音声生成統計分析では、一般化加法モデルを実行して、反対クラスの共変量の平滑化効果を制御する特徴の各クラス(メトリックまたは韻律音響)に対する言語グループの影響を評価しました。音声知覚統計分析では、Kruskal-WallisテストとPost-hoc Dunn'sテストを実行して、リスナーが判断するスコアに対するラインナップの音声の影響を評価しました。それにもかかわらず、コサイン距離とユークリッド距離に基づく音響(音声)類似性テストを実施しました。その結果、f0のばらつき、持続時間、および声質の点で、言語グループ間で大きな音響的違いが示されました。ラインナップについては、f0、強度、および音声品質の韻律的特徴がリスナーの知覚判断と相関していることが示されました。
概要
アクセントは、母国語(L1)と外国語(L2)の両方で、コミュニケーションと流暢さの顕著でダイナミックな側面です。1。外国語アクセントは、ターゲット言語のL2音声機能を表し、話者のL2経験、話し方、入力品質、説明などの変数に応じて(時間の経過とともに)変化する可能性があります。外国語アクセントは、外国語話者によって生成された L2 音声と、ターゲット言語のローカルまたは参照アクセントとの間の (スカラー) 程度として定量化できます2,3,4,5.
この研究は、外国語アクセントの英語と外国語アクセントのブラジルポルトガル語(BP)の韻律音響的特徴と知覚的相関の両方を調べるとともに、話者の外国語アクセントとネイティブアクセントの制作がリスナーの知覚とどの程度相関しているかを確認することを目的としています。法医学分野の先行研究では、外国語のアクセント識別における母音と子音の堅牢性は、個人の長期的な分析に対して安定している(The Lo Case6)、話者の高いID精度を参照している(The Lindbergh Case7)ことが示されています。しかし、持続時間、基本周波数(f0、つまりピッチの音響相関)、強度、および音声品質(VQ)に基づく韻律音響特性の探求は、ますます注目を集めています8,9。したがって、この研究における韻律音響機能の選択は、法医学音声学の分野で有望な道筋を表しています8,10,11,12,13.
本研究は、法医学的なケースにおける音声変装の一形態としての外国語アクセントに特化した研究によって支えられています14,15、および話者認識のための音声ラインナップの準備16,17。たとえば、ドイツ語、イタリア語、日本語、ブラジル語の英語話者の識別には、発話速度が重要な役割を果たしました18,19,20,21,22.発話速度に加えて、脳と認知基盤が記憶、注意、感情に欠損しているため、長期のスペクトルとf0の特徴は、ターゲット言語に精通しているL2に熟練した話者に挑戦します。これは、長時間の話しかしゃぶり23。法医学分野での外国語アクセントの見方は、実際に外国語アクセントのように聞こえるものの定義は、外国語アクセントのスピーチが極端にない程度にあるのではなく、リスナーのなじみのなさに大きく依存するということです24。
知覚領域では、1990年代半ばから犯罪者の認識に使われる一般的な法医学ツールは、犯罪現場で加害者を特定するために使用される視覚認識に類似した音声ラインナップ(聴覚認識)です16,25。ボイスラインナップでは、容疑者の声は、年齢、性別、地理的位置、方言、文化的地位などの社会言語学的側面で類似したフォイルと一緒に提示され、目撃者による識別に使用されます。音声ラインナップの成功または失敗は、音声サンプルの数とサンプルの持続時間によって異なります25,26。さらに、実際のサンプルでは、音声品質が一貫して音声認識の精度に影響を与えると考えられます。オーディオ品質が悪いと、voice27 の固有の特性が歪む可能性があります。音声の類似性の場合、f0 に基づく詳細な音声の詳細は、音声認識中にリスナーを混乱させる可能性があります28,29。このような音響的特徴は f0 を超えて拡張され、持続時間の要素と、強度と VQ30 のスペクトル特徴が含まれます。この複数の韻律的特徴のビューは、フォレンジック音声比較のコンテキストで、正確な話者識別を確保するために重要です9,14,15,29,31.
要約すると、法医学的音声学の研究は、過去数十年にわたって外国語のアクセントの識別に関していくつかのバリエーションを示しています。一方では、外国語のアクセントは話者を識別するプロセスに影響を与えないように思われます32,33(特に、話者が対象の外国語のアクセントに詳しくない場合34)。一方、逆方向の調査結果があります12,34,35。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
この研究は、ヒト研究倫理委員会から承認を得ました。さらに、この研究に関与したすべての参加者から、データの使用と公開についてインフォームド コンセントが得られました。
1. 音声生成
注:グループ1の「L1 English-L2 BP」のリーディングタスクから音声を収集しました:The American English(米国から)のSピーカー(AmE-S)と、グループ2の「L1 BP-L2 English」の両方の「L1 BP-L2 English」:Brazilian Speakers(Bra-S)。音声生成のフローチャートについては、図 1 を参照してください。

図 1: 音声生成の概略フローチャート。 この図の拡大版を見るには、ここをクリックしてください。
- 参加者
- 参加者の数、言語(L1英語、L2 BP;L1 BP、L2 英語)、性別(女性または男性)、年齢(平均、標準偏差)、グループ特性(専門学生または学部生)、および各グループのL2能力レベル(上級または上級)
注:本研究では、AmE-SとBra-Sの両方がL2に習熟していると見なされました(両方のグループはB2-C136として認定されました)。AmE-Sは、手続きが行われたとき、ブラジルに2年間住んでいました。Bra-Sは、手術が行われたとき、米国に2年以上住んでいました。海外に住んでいる間、どちらのグループも、少なくとも週に6日、1日~4〜5時間、勉強や仕事の目的でL2を話していました。 - 参加者を快適で静かな部屋に割り当て、各グループに読み物を提示します。
- 参加者の数、言語(L1英語、L2 BP;L1 BP、L2 英語)、性別(女性または男性)、年齢(平均、標準偏差)、グループ特性(専門学生または学部生)、および各グループのL2能力レベル(上級または上級)
- データ・コレクション
注:音声データは、次の言語のリーディングタスクから収集する必要があります:L1-英語、およびL2-BP;L1-BP、およびL2-英語。必要に応じて、参加者に事前にテキストを読ませてください。- 録音手順
- 音声データは、適切な音響条件の静かな場所で録音してください。
- デジタルボイスレコーダー(資料の表を参照)37と一方向の電磁絶縁カーディオイドマイク(資料の表を参照)38を使用します。
- オーディオデータを「.wav」形式で録音します。
- サンプリングレートを48kHz、量子化レートを16ビットに設定します.
注:手順1.2.1.3および1.2.1.4で説明したサンプリングレートと量子化レートのオーディオ形式と構成は、高品質の品質とノイズリダクションを確保して、後の音響分析に使用されるスペクトル特性を保持するために適用されます。
- 録音手順
- 音響解析
注:音響解析手順は、強制アライメント、再アライメント、音響特徴抽出の3つのステップに分けます。- 言語の転写('で。txt' ファイル) を使用します。
- '.txt'/'.wav' ファイルのペアに同じ名前 (つまり、'my_file.wav'/ 'my_file.txt').
注: セクション 1.3.7 で概説されている手順のパフォーマンスを向上させるには、'.txt/.wav' ファイル タグの最初の 3 文字が言語、方言、またはアクセントを表し、4 番目から 6 番目の文字が性別を示すことを強くお勧めします (例: EL1FEM は English L1 Fem の場合)ale)です。7 文字目以降、ユーザーはスピーカー番号を示す必要があります (たとえば、最初のスピーカーの場合は 001)。したがって、最初の '.txt/.wav' ペアは EL1FEM001 です。 - L1-L2言語ごとにフォルダを作成します。.
注意: L1-L2 英語用のフォルダーと L1-L2 BP 用のフォルダー。 - 同じ言語のすべてのファイルペアが同じフォルダにあることを証明します。
- 強制アライメントを実施します。
- ミュンヘン自動セグメンテーション(MAUS)強制アライナー(webMAUS)39のWebインターフェイスに https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline でアクセスします。
- の各ペアをドラッグアンドドロップします。wav / です。txt ファイルをフォルダから Files の破線の四角形に移動します (または、四角形の内側をクリックします 図 2A)。
- 「アップロード」ボタンをクリックして、ファイルをアライナーにアップロードします (図 2A の赤い矢印を参照)。
- 「サービス・オプション」メニューで次のオプションを選択します (図 2B): 「パイプライン名」に「G2P-MAUS-PHO2SYL」を選択します。英語 (米国) (言語の場合) L1-L2 英語データの場合。イタリア語 (IT) (言語用) if L1-L2 BP data.
注:BPデータに「イタリア語」を選択したのは、webMAUSがBP強制アライメントの事前学習済み音響モデルを提供していないためです。音声学の文献では、イタリア語の音韻論には、BP40と同様に、ある程度同等の対称的な7母音の目録があり、子音の音響的類似性もあるとされています41,42。 - 「出力形式」と「すべて保持」のデフォルトオプションをそのまま使用します。
- 使用条件に同意するために、「実行」オプション・ボックスをオンにします (図 2C の緑色の矢印を参照)。
- 「Run Web Service」ボタンをクリックして、アップロードしたファイルをaligner.
で実行します。 注:各オーディオファイルについて、MAUS強制アライナーはPraat TextGridオブジェクト(ステップ1.3.1で説明した「.txt」ファイルから抽出された言語転写に基づいて、単語、音韻音節、および電話の注釈を含むPraatの事前にフォーマットされた「.txt」ファイル)を返します。 - 「Download as ZIP-File」ボタンをクリックして、TextGridファイルをzipファイル(図2C).
としてダウンロードします。 注:圧縮されたTextGridファイルがオーディオファイルと同じフォルダにダウンロードされていることを確認してください。 - 音声解析ソフトウェア43で後で再調整するためにTextGridファイルを抽出します。
- 再調整を行います。
- https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat から Praat VVUnitAligner44 のスクリプトにアクセスしてダウンロードします。
- 同じ言語のすべてのファイル ペアと VVUnitAligner スクリプトが同じフォルダにあることを確認します。
注: L1-L2 英語ファイルおよび VVunitAligner 用のフォルダー、および L1-L2 BP ファイルおよび VVunitAligner 用のフォルダー。 - 音声解析ソフトウェアを開きます。
- Praat |Praat スクリプトを開き、オブジェクトウィンドウからスクリプトを呼び出します。
- 「実行」ボタンを一度クリックします。
注: スクリプトを使用するための設定を含む「Phonetic sylable alignment」という形式が画面上にポップアップ表示されます (図 3A)。 - [言語] ボタンをクリックして、[英語 (米国)]、[ポルトガル語 (BR)]、[フランス語 (FR)]、または [スペイン語 (ES)] 言語から選択します。
- [チャンク セグメンテーション] ボタンをクリックして、[自動]、[強制 (手動)]、または [なし] のセグメンテーション手順から選択します。
- 新しいTextGridファイルを自動的に保存するには、TextGridファイルを保存オプションを確認してください。
- [OK] をクリックします |ステップ 1.3.5.7 .
から音声単位を再調整するための Run ボタン 注: 各オーディオ ファイルについて、VVUnitAligner はセクション 1.3.7 用の新しい TextGrid ファイルを生成します (図 3B)。
- 音響特徴の自動抽出を行います。
- 韻律音響機能を自動的に抽出するために、https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat からスクリプト SpeechRhythmExtractor45 にアクセスしてダウンロードします。
- 新しいフォルダを作成し、SpeechRhythmExtractorをすべての言語のオーディオ/TextGridファイルのすべてのペアと一緒に配置します。
- 音声解析ソフトウェアを開きます。
- Praat |Praat スクリプトを開き、オブジェクトウィンドウからスクリプトを呼び出します。
- [実行] ボタンを 1 回だけクリックします。
注:スクリプト設定を含むフォームが画面にポップアップ表示されます。出力 '.txt' ファイル名のボックスで、それに応じてファイルの名前を変更するか、既定の名前のままにします。 - 音声品質パラメータ・オプションをチェックして、出力ファイル VQ を音声品質 (図 3C).
に保存します。 注:この2番目の出力ファイル(出力ファイルVQ)には、1次と2番目の高調波(H1-H2)とケプストラルプロミネンスピーク(CPP)9の差のパラメータが含まれています。 - 「言語ターゲット」オプションにチェック・マークを付けて、「言語」、「方言」、または「アクセント」のラベルから選択します (図 3C)。
- 「単位」オプションをチェックして、f0 機能を Hz または半音で選択します (図 3C)。
- F0 しきい値の値、最小および最大 f0 しきい値 (図 3C).
注意: 研究に特定の目的がある場合や事前に設定された特定のオーディオ機能がある場合を除き、ステップ1.3.7.9のパラメーターはデフォルト値のままにしておくことを強くお勧めします。 - [OK] をクリックします |音響機能 .
の自動抽出のために実行します 注:スクリプトSpeechRhythmExtractorは、スピーカーから抽出された音響機能を含むタブ区切りの「.txt」ファイル(出力ファイル/出力ファイルVQ)を返します。
- 統計分析
- 音響機能を含むスプレッドシートを R46 環境 (または任意の統計ソフトウェア/環境) にアップロードします。
- 一般化加法モデル (GAM) ノンパラメトリック統計を実行します。
- R で GAM を実行します。
- 次のコマンドを入力して、Enter.
キーを押します。 図書館(MGCV)
model = gam(分析における計量/韻律音響の特徴 ~ 言語 + s(選択された計量の特徴、by = 言語) + その他の計量/韻律音響の特徴、データ = データフレーム)
注:Rプログラミング言語でプロトコルのテスト統計を実行することにしたのは、学術コミュニティの音声学者(および言語学者)の間で人気が高まっているためです。Rは、主に音声フィールドワーク研究で使用されてきました47。ステップ 1.4.2.2 には擬似コードが含まれていることに注意してください。研究変数に従ってコードを記述します。

図2:MAUS強制整列機能を使用した音声整列のスクリーンショット(A)破線の長方形は、'my_file.wav'/' my_file.txt'ファイルをドラッグ&ドロップしたり、フォルダからそのようなファイルを検索するために内部をクリックするためのものです。アップロードボタンは赤い矢印で示されます。(B)パネルAからアップロードされたファイル(青い矢印を参照)、使用するパイプライン、ファイルのペアの言語、返されるファイル形式、およびすべてのファイルを保持するための「true / false」ボタン。(C) チェックボックスの使用条件 (緑色の矢印を参照)、[Web サービスの実行] ボタン、および結果 (ダウンロードする TextGrid ファイル)。この図の拡大版を表示するには、ここをクリックしてください。
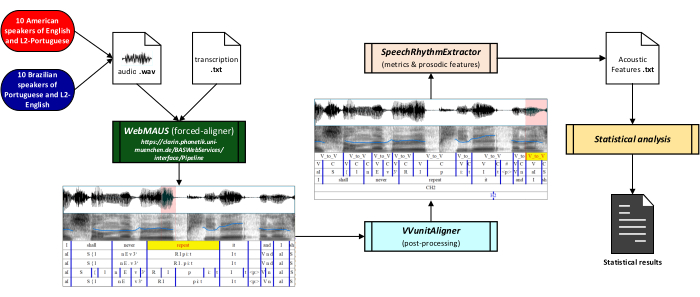
図3:再調整手順のスクリーンショット。(A)再調整手順の入力設定フォーム。(B)部分波形、f0(青)輪郭の広帯域スペクトログラム、および層1としてセグメント化(およびラベル付け)された6つの層:母音の開始から次の母音の開始(V_to_V)の単位。母音の開始(V_to_V);ティア2:母音(V)、子音(C)、および一時停止(#)の単位。Tier 3:音声表現V_to_V;Tier 4:テキストからのいくつかの単語。Tier 5:テキストからの音声のいくつかのチャンク(CH)。tier 6: 女性の AmE-S によって生成された各音声チャンクの最高音 (H) と最低音 (L) を含む声調層。(C)音響特徴の自動抽出のための入力設定。この図の拡大版を表示するには、ここをクリックしてください。
2. 音声認識
注:アメリカ人リスナーと英語で4つの音声ラインナップを、ブラジルのリスナーとBPで4つの音声ラインナップを実施しました。音声認識のフローチャートについては、図 4 を参照してください。
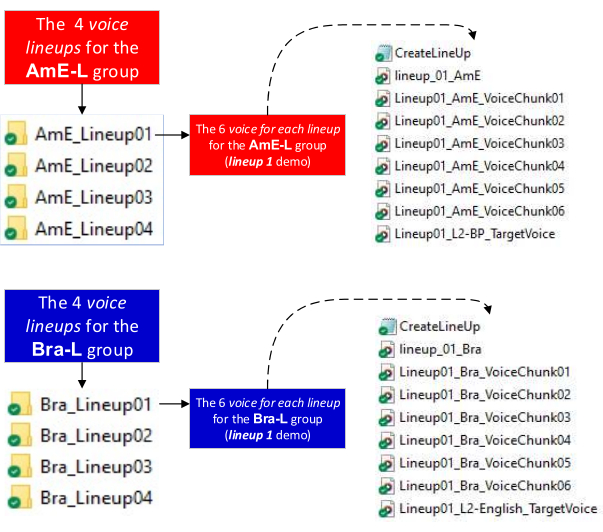
図 4: 音声知覚の概略フローチャート. この図の拡大版を見るには、ここをクリックしてください。
- 参加者
- スピーチ制作プロトコルに参加した参加者から、グループごとに異なる参加者を選びます
注:プロトコルのこの部分には、参加者の2つのグループが選ばれました:グループ1:American English(米国から)Listeners (AmE-L)、およびグループ 2: Brazilian Listeners (Bra-L)。本研究では、AmE-LとBra-Lの両方がL2に堪能であると見なされました(両グループはB2-C136 AmE-Lは、手順が実施されたときブラジルに2年間住んでいました。Bra-Lは、手続きが行われたとき、米国に2年以上住んでいました。海外に住んでいる間、どちらのグループも勉強や仕事の目的でL2を話していました(少なくとも週に6日、1日約4〜5時間 )。
- 参加者の数、言語(L1英語、L2 BP;L1 BP、L2 英語)、性別(女性または男性)、年齢(平均、標準偏差)、グループ特性(専門家または学部生)、および各グループのL2能力レベル。
- スピーチ制作プロトコルに参加した参加者から、グループごとに異なる参加者を選びます
- 音声ラインナップ
注: 音声ラインナップの手順は、音声ラインナップの準備と実行の 2 つの異なる手順に分けます。- 英語用4名、BP用4名のボイスラインナップをご用意。
- セクション 1: 音声制作のスピーカーからオーディオ ファイルを取得します。
- 各言語要素のオーディオ ファイルが別々のフォルダーにあることを確認します。
- L1英語またはL1 BPの6つのボイスチャンクをランダムに選択します
注: ラインナップの 6 つのボイスは、1 つのターゲットボイスと 5 つのフォイルを表しています。 - ステップ 2.2.1.3.
に含まれるスピーカーの 1 つから、L2 英語または L2 BP の音声チャンクを選択します 注: 手順 2.2.1.4 の音声チャンクは参照音声です。チャンクの長さは約 20 秒でなければなりません8。 - https://github.com/pabarbosa/prosody-scripts-CreateLineUp から Praat CreateLineup48 のスクリプトにアクセスしてダウンロードします。
- CreateLineup スクリプトを実行する前に、L2 参照音声、L1 フォイル、および L1 ターゲット音声が同じフォルダにあることを確認します (<強力な class="xfig">図 5) 。
- 音声解析ソフトウェアを開きます。
- オブジェクト ウィンドウで、[Praat |Praat スクリプトを開いて、スクリプトを呼び出します。
- [実行] |Run.
注: スクリプトは、(L2 参照音声) + (L1 ターゲット音声とランダムに配布されたフォイル) (図 5) の順序でファイルを返します。
- ボイスラインナップの運営
- オンラインスペースを作成して、任意のプラットフォーム(SurveyMonkeyなど)でラインナップをホストします。資料表を参照)音声ラインナップをリモートで指揮するためのもの。
- オンラインスペースのリンクにアクセスします。
- CreateLineup スクリプトから返されたファイルをプラットフォームにアップロードします。
- 参加者の前に手順を実行して、すべてのステップをテストします。
注:事前にリンクにアクセスし、ラインナップを実行して、すべてが正常に機能しているかどうかを確認することをお勧めします。
- 英語用4名、BP用4名のボイスラインナップをご用意。
- 統計分析
- リスナーの判断のスコアを含むスプレッドシートをR環境(または任意の統計ソフトウェア/環境)にアップロードします。
- RでKruskal-Wallis検定を実行します。
- 次のコマンドを入力して、Enter.
キーを押します。 model = kruskal.test(判断~各音声ラインナップ、データ=データフレーム)
- 事後的なダンのテストを実行します。
- Rでダンのテストを実行します。
- 次のコマンドを入力して、Enter.
キーを押します。 図書館
model = dunnTest(判断~各音声ラインナップ, data = data, method = "bonferroni")
注: 手順 2.3.1.2 と 2.3.2.2 のコードは擬似コードです (注 1.4.2.2 を参照)。
- リスナーの判断のスコアを含むスプレッドシートをR環境(または任意の統計ソフトウェア/環境)にアップロードします。
- 音響類似性解析
- ターゲットとフォイルとの間に有意でない違いが見られたラインナップ(ステップ2.2.1.3の注を参照)を選択します。
- 手順1.3.1から1.3.7.5、および手順1.3.7.8から1.3.7.10の手順を繰り返します。
- Python49, AcousticSimilarity_cosine_euclidean50 from https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
注: スクリプトは 3 つの行列 ('.txt' と '.csv' で) を返します。1 つはコサイン類似度 51,52、1 つはユークリッド距離52,53)、もう 1 つは変換されたユークリッド距離の値、およびターゲット ボイスと各フォイルのペアワイズ 比較です。 - スクリプトがラインナップデータセットの同じフォルダーにダウンロードされていることを証明します。
- [ファイルを開く...] ボタンをクリックして、スクリプトを呼び出します。
- [実行] |デバッグボタンなしで実行.
注: 2 番目の [実行] ボタンには、[実行] または [デバッグなしで実行] または [スクリプトの実行] というタグが付けられている場合があります。これらはすべて同じコマンドを実行します。それは単に使用されるPython環境に依存します。 - 音響特性に基づいて音声類似性テストを実行します。
注:コサイン類似度(またはコサイン距離)は、人工知能(AI)、特に自動音声認識(ASR)システムの機械学習に適用される手法です。これは、0 と 1 の間の類似性の尺度です。1 に近いコサイン類似性は、2 つの声が類似している可能性が非常に高いことを意味します。コサイン類似度が 0 に近いということは、音声が非類似である可能性が非常に高いことを意味します52。ユークリッド距離は、ユークリッド類似度と呼ばれることが多く、AI、機械学習、ASRでも広く使用されています。これは、ユークリッド空間53 の 2 点間の直線距離を表し、つまり、点が近い (距離の値が短い) ほど、ボイスはより類似しています。両方の手法で報告された結果をより明確に理解するために、ユークリッド距離の生スコアを 0 (音声類似性が少ない) から 1 (音声類似性が高い) までの値に変換しました54。

図 5: 音声認識のためのディレクトリ設定。ラインナップフォルダ。各フォルダには、6 つの L1 音声、L2 ターゲット音声、"CreateLineup" スクリプト、音声ラインナップ オーディオ ファイル (スクリプトの実行後に返される) が含まれています。この図の拡大版を表示するには、ここをクリックしてください。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
発話産出の結果
本セクションでは、統計的に有意であった韻律・音響的特徴およびリズム指標のパフォーマンスについて述べました。これらの韻律的特徴には、持続時間に関連する発話速度、調音速度、ポーズ率、および声質に関連するシマーが含まれます。リズム指標は、音節持続時間の標準偏差(SD)、子音のSD、母音または子音の持続時間のSD、および音節持続時間の変動係数でした(補足表 S1を参照)。
The 発話速度 (図6A)L1-L2英語はL1-L2ブラジルポルトガル語よりも急速に減少するが、いずれのL2においてもその速度はより低い。 発話速度 3つの指標、すなわち音節持続時間の標準偏差(SD)に関連しています。SD-S)、母音の標準偏差(SD-V)、および音節変動係数(Varco-S)。また...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
現在のプロトコルは、(法医学的)音声学の分野に目新しさをもたらします。それは、生産に基づくフェーズ(音響分析)と知覚に基づくフェーズ(判断分析)の2つのフェーズに分かれています。生産分析フェーズは、統計に加えて、データ準備と強制アライメント、再アライメント、および韻律音響特徴の自動抽出で構成されます。このプロトコルは、主に手動のセグメンテーションに基づく従来のプロトコルよりも高速かつ効率的な方法で、データ収集の段階をデータ分析に接続します。
ただし、プロトコル ステップ 1.3.6 から 1.3.6.9 に示されている再調整プロセスは、基本的にプロトコル ステップ 1.3.1 から 1.3.4 で生成された電話およびワード ユニットで機能します。再配置プロセスの目新しさは、音節層、単語に基づいて自動または手動で生成できる音声チャンク層、およびf0小節の計算に非常に役立つトーン層の3つの新しいテキスト層を含む新しいTextGridを生成することです。このプロトコルに提案された再調整ガイドラインは、L2 音声リズム21、
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者には宣言すべき利益相反はありません。
謝辞
この研究は、全米科学技術開発評議会 - CNPq、第一著者に助成金番号307010/2022-8、第二著者に助成金番号302194/2019-3の支援を受けました。筆者より、本研究の参加者の皆様の多大なるご協力と貴重なご貢献に心より感謝申し上げます。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| CreateLineup | Personal collection | # | 音声ラインナップ用スクリプト |
| Dell I3 (ソリッドステートドライブ - SSD) | Dell | # | ラップトップコンピュータPraat |
| Paul Boersma &David Weenink | # | 音声解析用ソフトウェア | |
| Python 3 | Python Software Foundation | # | インタープリター、高水準、汎用プログラミング言語 |
| R | The R Project for Statistical Computing | # | Programming language for stattistical computing |
| Shure Beta SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | Personal collection | # | Script for praat for automatic extraction of acoustic features |
| SurveyMonkey | SurveyMonkey Inc. | # | 無料のカスタマイズ可能な調査と、データ分析、サンプル選択、バイアス除去、データ表現を含む一連のバックエンドプログラムの組み立て。 |
| Tascam DR-100 MKII | Tascam | # | デジタルボイスレコーダー |
| ミュンヘン自動セグメンテーションシステム MAUS | ミュンヘン大学 | # | オーディオ (.wav) および言語情報 (.txt) ファイルの強制アライナー |
| VVUnitAligner | 個人コレクション | # | 音声単位の自動再調整と後処理のためのプラアットのスクリプト |
参考文献
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
再版と許可
