本研究は、関係性マーケティング要素が中国スーパーリーグファンのスポーツ推薦システムを改善するかどうかを検証します。満足度、信頼、コミットメント、相互性を取り入れることで、特にスパースやロングテール条件下でTop-Nの推薦精度が大幅に向上します。結果は、コミットメントと相互性が繰り返しの高い関与行動を促進し、満足度と信頼が主に早期の関与を支えることを示しています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
ファンの消費行動を理解し予測することはプロスポーツにおける中心的な課題ですが、ほとんどの推薦システムは主に過去のやり取りに頼り、ファンのエンゲージメントを形作る関係性マーケティング要因にはあまり注意を払っていません。このギャップを埋めるために、本研究はMLP-PA(ピラミッドアテンション付きマルチレイヤーパーセプトロン)を開発し、満足度、信頼、コミットメント、相互性といったファンの関係状態を取り入れることで、中国スーパーリーグ(CSL)ファンの複数の消費シナリオにおける推薦効果を向上させるかどうかを検討しています。チケット、グッズ、会員、デジタルコンテンツをカバーするマルチシナリオデータセットを用いると、MLP-PAで生成された推薦は従来の協働フィルタリング手法よりもTop-Nランキングの精度が大幅に向上し、特にスパースやロングテール設定で顕著な改善が見られます。さらに、分析は異なる関係要因が異なる消費パターンに関連していることを明らかにしました。コミットメントと相互性は繰り返しの高関与行動により強く関連し、満足度と信頼は主に初期および短期的な反応に影響を与えます。これらの発見は、関係性マーケティング要素がファンの消費行動において実質的かつ差別化された役割を果たし、プロフットボールにおけるパーソナライズされたエンゲージメント戦略やデジタル運営のための実用的な洞察を提供していることを示しています。
概要
近年、レコメンターシステムはデジタルプラットフォームの中心的な要素となり、データ駆動型のパーソナライズを通じてユーザー、製品、消費の状況を整合させることを可能にしています。推薦技術はeコマースやオンラインメディアなどの分野で確立されていますが、プロスポーツにおける応用は比較的未発達です。中国スーパーリーグ(CSL)のようなリーグでは、ファンの消費行動は非常に文脈に敏感で、試合前、試合当日、試合後の各段階で変化し、購入決定はオフラインの観客、感情的なつながり、社会的アイデンティティと密接に結びついています。しかし、既存のスポーツ推薦者研究の多くは、主に他分野からの協働フィルタリングやコンテンツベースの手法を取り入れ、クリックや購入などの短期的なインタラクションシグナルに焦点を当てています。これらのアプローチは、スポーツマーケティングリサーチで長期的なエンゲージメントや繰り返し消費を形作ることが知られている信頼、コミットメント、相互性といったファンとクラブ間の関係的なダイナミクスをほとんど見落としています。その結果、現在のモデルは、類似した行動履歴が異なる関係状態下で消費結果の異なる結果を引き起こす理由を説明するのに苦労しています。このギャップは、インタラクション頻度を超え、ファンの意思決定における関係に基づくメカニズムを明示的に考慮する推薦者フレームワークの必要性を浮き彫りにしています。3.
関係マーケティングの観点から見ると、満足度、信頼、コミットメント、相互性は関係の質を構成し、試合観客動員、グッズ購入、会員更新、口コミ促進など、主要なファン成果の推進力として確立されています。対照的に、既存の多くのスポーツレコメンデーションシステムは、ファンとアイテムの相互作用をほぼ均質な行動シグナルとしてモデル化し続けており、その背後にある関係性の文脈にはほとんど注意を払っていません。この単純化は、消費段階やエンゲージメント強度を超えて異なる関係要因がどのように異なる影響を及ぼすかを捉える能力を制限し、インタラクション履歴のみに基づくモデルが短期的な反応と持続的で高い関与度を持つファン行動を区別できない理由を説明する助けとなります。
工学的観点から見ると、スポーツレコメンデーションシステムは非対称的な暗黙的フィードバック、深刻なロングテールスパーシティ、異種的なマルチタッチインタラクションコンテキストなど、追加の課題に直面しています。従来の協働フィルタリング手法や単一経路のディープモデルは、このような環境で文脈横断の一般化が限られ、マーケティング業務における意思決定支援の解釈性が乏しいことが多いです。
方法論的には、これまでの推薦システム研究では、稀薄さ、異質性、長期最適化に対応するためのさまざまな解決策が提案されています。グラフベースおよび注意駆動モデルは、近傍の重要性を再重み付けし、高次相互作用を捉えることで表現学習とランキング性能を向上させました 8,9。協働信号とディープラーニングを組み合わせたハイブリッドアーキテクチャは、大規模な推薦タスクで成果を上げています。強化学習ベースのアプローチは、近視的な精度ではなく長期的な目標に向けて最適化をさらに拡張します11。これらの進展は、疎フィードバック下での複雑な相互作用をモデル化するための貴重な方法論的基盤を提供します。
それでも、これらのアプローチの多くは関係性マーケティングの枠組みに依存せず、満足度、信頼、コミットメント、相互性といった変数を推薦プロセスに明示的に組み込んでいません。この制約は特にプロフットボールの文脈で顕著であり、ファンとクラブの関係が進化し、異なる関係性の側面が異なる行動結果を支配することが知られている(例:初回購入と再来訪)12,13,14,15。
このギャップを埋めるために、中国スーパーリーグ(CSL)シナリオに特化した関係認識型レファレンジャーフレームワークであるMLP-PA(マルチレイヤーパーセプトロン・ウィズ・ピラミッドアテンション)を提案します。多層パーセプトロン(MLP)バックボーンを持つニューラル協働フィルタリング(NCF)アーキテクチャを基盤に、満足、信頼、コミットメント、相互性を一流の関係的特徴として扱い、注意に基づく事前チャネルに注入します。その後、後期融合にはピラミッド型特徴注意モジュールを用いて、ファン、アイテム、文脈的表現を統合しながら、複数のスケールにわたる顕著な相互作用パターンを選択的に増幅します。関係変数を非線形相互作用の特徴と並べて明示的にモデル化することで、MLP-PAはスポーツ推薦における予測精度と解釈可能性の両方を向上させることを目指しています。
自作CSLデータセットでの実証的評価では、提案されたアプローチがTop-Nランキング指標においてUserCF、ItemCF、MF-BPRなどの古典的なベースラインを一貫して上回る性能を示していることが示されました。モデル変異のさらなる分析により、関係性認識型注意を取り入れることで、ロングテールのスパーシティや文脈的異質性が緩和されることが示されています。また、関係要因の異なる役割も明らかになります。コミットメントと相互性は繰り返しの高関与行動により強く関連し、満足度と信頼は主に初回および短期的な反応を支持します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究は、研究目的のみで収集された匿名化されたファンとアイテムの相互作用ログと匿名化されたアンケートデータを用いています。個人を特定できる情報はアクセス、保存、処理されませんでした。機関および国家のガイドラインによれば、この研究は正式な倫理委員会の承認や個人のインフォームド・コンセントを必要としませんでした。
データセット準備と実験手順
ステップ1。データ準備と前処理
データセットの準備と実験手順は、生の行動ログや調査回答を、モデルの訓練および評価に適した統一的かつ再現可能な実験データセットに変換するよう設計されました。このプロセスは、データのクレンジング、匿名化、特徴構築、正規化、そして関係関連変数とのインタラクションレコードの整合性に焦点を当てています。生のインタラクションログはまずスクリーニングされ、不完全なエントリーや重複イベントを除去し、データの整合性を確保しました。ファン識別子やアイテム識別子はハッシュ処理で匿名化され、ユーザーのプライバシー保護が行われました。ブラウジング、クリック、購入、出席検証など複数の相互作用が暗黙のフィードバック信号にマッピングされ、観察された各相互作用は肯定的なインスタンスとして扱われました。関係性に関連する変数—満足度、信頼、コミットメント、相互性—はアンケート回答から収集され、対応するファン識別子と関連付けられました。同じ会員層内でのアンケートの欠落値は、グループレベルの特性を保持するために平均補完を用いて対処しました。連続特徴量は最小最大スケーリングを用いて範囲[0, 1]まで正規化され、変数間の比較可能性を確保しました。前処理後、最終データセットは匿名化されたファンID、アイテムID、タイムスタンプ、文脈タグ、正規化された関係変数からなる構造化ファイルに保存され、すべての実験設定で一貫して使用されました。
期待される成果:
このプロセスの結果、出力にはクリーン化されたインタラクションテーブル、ファン識別子にアラインメントされた関係変数の正規化テーブル、最終データセットにおけるファン数、アイテム数、インタラクションの数を詳細に示した統計的要約が含まれます。
ステップ2。トレーニング/検証/テストの分割とネガティブサンプリング
情報漏洩を防ぐため、データはユーザーレベルで時系列に分割されています。各ファンに対して、直近のやり取りはテスト用、2番目に新しいやり取りは検証用、残りのやり取りはトレーニング用に割り当てられます。ネガティブサンプルは、項目セットから相互作用のない項目を均一にサンプリングすることで生成されます。各正の相互作用に対して、訓練中に一定数のネガティブサンプル(負のサンプリング比=1:5)が抽出されます。同じ候補集合構成がすべてのモデルに一貫して適用されます。
期待される成果:
このステップの結果、出力には時系列に分けられたトレーニング、検証、テストデータセットと、指定されたサンプリング比率に基づいて作成されたあらかじめ生成されたネガティブサンプルリストが含まれます。
ステップ3。ソフトウェア環境と実装
すべての実験はPythonで実装されています。モデルのトレーニングと評価はPyTorch(バージョン≥1.12)を用いて行われます。ベイズ超パラメータ最適化はOptuna(バージョン≥3.0)を用いて実行されます。トレーニングスクリプトは、1つのNVIDIA GPU(≥ 8GBメモリ)を搭載したワークステーション上で実行されます。設定ファイルは、再現性を確保するためにデータセットの経路、モデルパラメータ、最適化設定を指定します。
ステップ4。モデル構成とパラメータ仕様
MLP-PAモデルは、埋め込み層、多層パーセプトロンバックボーン、関係-注意チャネル、そしてピラミッド注意融合モジュールで構成されています。主なパラメータは以下の通りに設定されます:埋め込み次元 = 32;MLP隠れ層 = [64, 32];活性化関数 = ReLU;オプティマイザー = 学習率0.001、重み減衰1e-5のアダム。ピラミッド注意モジュールは、核サイズ{1, 2, 4}、歩幅が核サイズに等しい3つのプーリングスケールを使用します。注意軽減比率は4に設定されています。過学習を防ぐために、レート0.3のドロップアウトが適用されます。検証NDCG@10が10回連続で改善しない場合、早期停止が発動します。
ステップ5。訓練とハイパーパラメータ最適化
このモデルはペアワイズベイズパーソナライズ順位(BPR)損失を用いて訓練されます。トレーニング中、各エポック終了時に検証性能が監視されます。学習率、埋め込みサイズ、ドロップアウト率、負のサンプリング比、注意関連パラメータに関するベイズ超パラメータ最適化の探索。最適化の目的は検証NDCG@10です。各候補構成は計算コスト削減のために早期停止を学習します。
期待される成果:
このプロセスの結果、出力には訓練済みのモデルチェックポイント、検証性能ログ、ベイズ最適化によって特定された最適なハイパーパラメータ構成が含まれます。
ステップ6。評価と結果生成
トレーニング後、検証NDCG@10に基づく最も性能の高いモデルがテストセット上で評価されます。各ファンごとにトップNのおすすめリストが作成され、性能はHR@KとNDCG@Kで測定されます。同様の評価プロトコルを用いて、アブレーション研究や位相条件付き注意プロファイリングなどの追加解析も行われ、比較可能性を確保します。
修了基準
以下の出力が得られた場合、プロトコルは完全とみなされます:1) 最適化されたハイパーパラメータを備えた完全に訓練済みのMLP-PAモデル;2) すべてのベースラインおよびアブレーションモデルのテストセットHR@KおよびNDCG@K結果;3) 保存されたモデルチェックポイント、評価指標、再現可能な設定ファイル。これらの出力が集合することで、提案されたレコメンタシステムプロトコルの独立した再現が可能になります。
コミットメント・トラスト・リレーションシップ・リレーションシップ・マーケティング理論
コミットメント・信頼理論は、コミットメントと信頼を関係の質の中核的な決定要因と位置づけます。取引の不確実性を減らし、長期志向と協力意欲を促進することで、これらの要素は関係の連続性と価値創造を促進します。信頼は、ファンがクラブの能力、誠実さ、善意を信じていることを反映し、リスクや情報の非対称性を低減します。その結果、より高い信頼は、パーソナライズされた推薦、データ認証、支払いプロセスによる低摩擦のエンゲージメントを促進し、クリック購入ファネルにおける初期段階かつ低コミットメントの行動を支援します。一方、コミットメントは、ファンが競合する選択肢や一時的な不満にもかかわらず、時間、経済的資源、感情的なつながりを投資して関係を維持する意欲を捉えています。コミットメントはアイデンティティの整合性、埋没コスト、専用投資と密接に関連しているため、リピート購入、会員更新、スタジアム入場、口コミ促進など、高コストかつ関与の多い行動に対してより安定した説明力を提供します。
これらの区別に基づき、以下の仮説を導き出します。
H1(信頼→支援行動):高い信頼は意思決定の摩擦やリスクの認識を減らし、クリック、カート追加、初回購入などの浅い行動の可能性を高めます。
H2(コミットメントの相対的優位):4つの関係性次元の中で、コミットメントは高コストかつ長期的な行動(リピート購入、更新、オフライン参加など)に対して最も強い限界説明力を示し、予測パフォーマンスへの貢献度は満足度や信頼を上回ります。
社会交換理論
社会交換理論は、個人が繰り返しの相互作用において相互性と公平の規範に従うことを強調します。相互性の認識は、ファンがクラブから価値譲歩、感情的な反応、資源配分において相互に譲歩があると感じることを意味します。相互性が真実で持続可能と認識されると、ファンは消費や来場を通じて相互反応しやすくなり、ポジティブなフィードバックループを形成します。満足度は、期待に対して累積された経験の関数です。期待・確認メカニズムを通じて、短期的な遵守と良好な口コミを促進し、信頼とコミットメントの育成に肥沃な土壌を提供します21。
したがって、次の式が導出されます:
H3(満足度→支援行動):満足度が高いほど後悔が減り、反応の即時性が高まり、短期的な購買と参加を促進します。
H4(Reciprocity → Conversion and Repurchase):繰り返しゲームの枠組み内で、リキプリシティシグナルは「私は恩恵を受け→返す」という交換の強度を増幅し、特に価格に敏感または希少性のある文脈でコンバージョン率や再購入率を大幅に向上させます。
これら二つの理論を統合すると、4つの次元は影響の経路において明確な文脈的異質性を示します。
不確実性や高いリスク認識の文脈—新製品、動的価格設定、高リスクの承認・支払い—においては、信頼がより強い限界効果を発揮します(H1の支持)。
長期的でアイデンティティの定着性が強い状況—シーズンパス、連続ホームゲーム、会員更新—では、コミットメントが支配的(H2を支持)します。
主要なマッチノードやインセンティブ・希少性(限定的な特典、昇進)では、相互性によりコンバージョンと再購入がより強く向上します(H4のサポート)。
満足は「基盤の土壌」として機能し、ほぼすべての文脈で短期的な行動を正に推進し(H3を支持)、体験の質を向上させることで間接的に信頼とコミットメントを強化します。構造方程式モデリングでこれらの仮説を検証するのではなく、4つの次元を注意層に注入し、モデルが文脈化された重みを学習し、アブレーション実験でそのメカニズムを裏付けることを可能にします。
MLP
多層パーセプトロン(MLP)は、私たちのフレームワークにおけるバックボーン表現学習器として機能します。
(1) 入力マッピング層。
元の特徴ベクトルは重み行列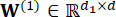 とバイアスb(1)によって一度線形展開され、次のようになります。
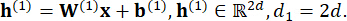 (1)
(2) 深い非線形層。
私たちはリニアレイヤー、アクティベーションレイヤー、正規化レイヤーを重ねています。線形写像は完全連結アフィン変換を用います。
z = Wx + b, (2)
ここで 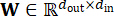 は重み行列、
 はバイアスベクトル、x は前の層の出力、 z は線形出力です。ReLUの活性化特性に合わせ、トレーニング中の勾配を安定させるために、Wの初期化を採用します:
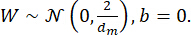 (3)
活性化関数はReLUであり、特にディープアーキテクチャ22に適しています。x>0のとき、ReLUの微分は一定となり、シグモイド活性化に伴うゼロ勾配問題を効果的に緩和し、逆伝播と収束を加速させる23。ReLUは計算上も単純(指数関数なし)で、自然に疎(x<0に対してゼロを出力)であり、冗長なニューロン応答を減らし、一般化を向上させます。その定義は24です
σ(x) = max(0,x), (4)
線形出力に要素ごとに適用すると、次のようになります。
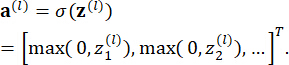 (5)
各「線形→活性化」操作の後、勾配を安定化し収束を加速させるバッチ正規化(BN)を導入します。BNは各ミニバッチ内で機能を動的に標準化し、内部共変量シフトを緩和し、トレーニングの安定性を向上させ、学習率に対する感度を低減します。BNはノイズ注入に似た軽度の正則化効果を持ち、モデル容量を損なうことなく過学習を防ぐのに役立ちます。
現在のミニバッチ出力を 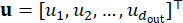 とします。j番目の特徴に対するBN変換は
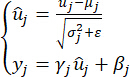 (6)
ここでμj と σ j2 は j 番目の特徴のバッチ平均と分散、ε は数値的安定性のための小さな定数、γj、βj は学習可能なスケールおよびシフトパラメータで、ネットワークの非線形表現性を回復させます。
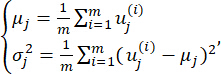 (7)
ここで m はミニバッチサイズ、 ε は数値安定性のための小さな定数、 γj、βjは正規化後にネットワークの非線形表現性を復元するための学習可能なスケール/シフトパラメータです。
(3) 特徴圧縮層
深い特徴抽出後、MLPブロックの末尾に特徴圧縮層を追加し、顕著な情報を保持しつつ冗長性を抑制し、後続モジュールの計算負荷を軽減し、軽度の正則化を提供します。入力ベクトルを  とします。圧縮出力は
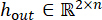 で、パラメータ
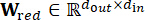
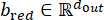 です。操作は以下の通りです:
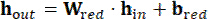 (8)
ピラミッドアテンション(PA)機構
最後のMLP層の出力を とします。高次の非線形相互作用に対する明示的な選択を可能にするために、まず場/チャネルごとに
 を行列25に再配置します。

 (9)
ここで Cはチャネル数、 L はチャネルあたりの長さです。
(1) 多スケールの特徴構造。
特徴軸Lに沿って複数のスケールを用いた1次元プーリングを適用して26を得る
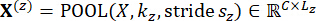 (10)
ここで ks と stride は s 番目のスケールを定義します。
(2) スケールごとの注意のチャネル。
各スケールごとにチャネル記述子を作成し、注意の重みを27:
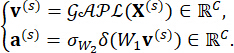 (11)
ここで δ(⋅)はReLU、σ(⋅)はSigmoidです。
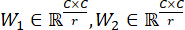 、 r は還元比です。
チャンネルごとに重みを適用します:
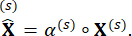 (12)
(3) 融合と書き込み。
各スケールをGAPLで統一された1次元空間に投影し、それらを融合させます:
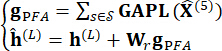 (13)
ここでPは融合重み、Wrは残差書き込みで用いられる学習可能な射影です。
最終スコア:
 (14)
ここで⊙は要素ごとの積であるハダマールを表し、  はベクトル連結を表します。
トップN課題の形式化と学習目的
(1) 問題設定。
ファンセットはF、 アイテムセットI (チケット、グッズ、会員特典、コンテンツ)とします。暗黙のフィードバック  は、ファン
 がアイテム
 (クリック、購入、出席・検証など)に関わったかどうかを示します。訓練セット内の正のサンプルは次の通りです。
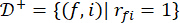 、
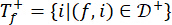 。
私たちは、満足度、信頼、コミットメント、相互性という4つの関係マーケティング変数をベクターとして注入します。注意層に 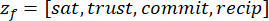 して、文脈を認識した関係表現
 を得て、ファンやアイテムの埋め込み
 と融合してスコア
 を生成します。各正の
 に対して、
 から一定の比率で複数の負を描いて
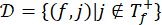 を形成します。
(2) ペアワイズ・オブジェクト。
相対順位を直接最適化するために、BPR(ベイズ個別順位)損失28を使用します。
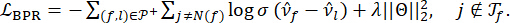 (15)
ここで 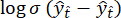 は「正のスコアが負のスコアを上回る可能性」を表します。
 は過学習を制御する L2正則化子であり、
 はすべての学習可能なパラメータを示します。
(3) 推論と順位付け。
試験時には候補者セットが 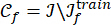 です。スコアを 計算し、トップNリスト29を返します。
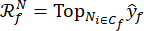 (16)
推薦アルゴリズム設計
このセクションでは、本研究で用いられた推奨ワークフロー全体を説明し、データ前処理からモデルトレーニング、オンライン推論までのエンドツーエンドパイプラインをカバーします。このワークフローは、生のファンとアイテムの相互作用データや関係性変数が、表現学習と注意ベースのモデリングを通じてパーソナライズされたランキングスコアに変換される過程を説明しています。詳細な手順は以下の通りです。
ステップ1:データ準備と正規化。
CSLのファンとアイテムの相互作用ログは暗黙のフィードバック信号に変換されます。欠損値は処理され、満足度、信頼、コミットメント、相互性の4つの関係変数が正規化されます。データはトレーニング、検証、テストセットに年代順に分けられ、各肯定的な相互作用ごとに複数のネガティブサンプルが生成されます。
ステップ2:関係性の注意エンコーディング。
4つの関係変数は注意モジュールに入力され、文脈認識された重要度の重みを学習し、下流モデリングのためのコンパクトなファン関係表現を生成します。
ステップ3:インタラクション入力の構築。
ファンとアイテムの埋め込みは学習され、関係表現と連結されて各ファンとアイテムの相互作用の完全な特徴ベクトルを形成します。
ステップ4:表現学習。
相互作用特徴はMLP分岐を通って高次非線形パターンを捕捉し、融合潜在表現を生成します。
ステップ5:ピラミッド機能の注意。
MLP出力の上にマルチスケールの特徴ピラミッドが構築されます。チャネルごとの注意とスケール横断の融合が適用され、残留接続を通じて顕著なチャネルを増幅し冗長チャネルを抑制するために強化された特徴が統合されます。
ステップ6:スコアリングとアウトト。
線形分岐は強化非線形表現と連結され、出力層に入力されて各ファン・アイテムペアの好みスコアを計算します。
ステップ7:トレーニングと最適化。
モデルはペアワイズランキングの目的を用いて最適化されています。適応最適化器は、重み減衰、ドロップアウト、早期停止と組み合わせて一般化を改善し過学習を軽減します。
ステップ8:ベイズ超パラメータ最適化。
検証ランキング指標は、埋め込み次元、ネットワークの深さと幅、学習率、負のサンプリング比率、ドロップアウト率、ピラミッド型および注意関連パラメータなどの主要なハイパーパラメータを自動的に検索する目的として用いられます。
ステップ9:推論と順位付け。
オンライン推論では、候補アイテムセットに対する各ファンの好みスコアが計算され、トップNの推薦が生成されます。さらに、新鮮さ、多様性、ビジネス上の制約を考慮したオプションのランキング後戦略が適用されます。
実験的検証
データセットと特徴スキーマ
私たちは、ハッシュ化されたファンIDを介して非特定化されたCSLクラブ情報システムのログを、同時の関係調査と結びつけた自己構築データセットで評価しました。データはチケット、グッズ、会員、コンテンツの4つのビジネスドメインをカバーし、ブラウジング、クリック、カートに追加/お気に入り、購入・チケット、スタジアム内検証イベント、タイムスタンプ、タッチポイントチャネル、コンテキストタグ、プロモーションフラグなどが含まれます。このスパンは1シーズン≥、スケールはファン、アイテム、イベントのレベルで、ディープモデリングに十分な量です。
特徴スキーマとエンコーディング:Items-ItemID、ItemType、TeamTag、PriceBand(ID/カテゴリ埋め込み);ファン—FanID、地域、会員階層、任期(FanIDは埋め込み学習、その他のカテゴリ・数値フィールドは標準化);RQの特徴—満足度、信頼、コミットメント、相互性を[0,1]にスケーリングし、注意チャネルに供給し、PAを介してMLP表現と融合;コンテキスト—PhaseTag、Channel、PromoFlag、Hour、Weekday(埋め込みとして分類;正弦波の正弦波/cos符号化による時間特徴)。
ハイパーパラメータ最適化
MLP-PAの主要なハイパーパラメータは、あらかじめ設定された探索空間内でベイズ最適化によって調整され、検証セットのNDCG@10を主ターゲット(HR@10を基準)とし、過学習を緩和するために早期停止を行っています。各候補構成は複数のランダムシードの下で実行され、平均化されます。最終展開設定は 表1に報告されています。
| ハイパーパラメータ | 概要 | 捜索範囲 | 選定された価値 |
| 埋め込み次元 | ファン/アイテム埋め込みサイズ | {32, 64, 128} | 64 |
| MLP隠れ層 | MLP層の数 | {2, 3, 4} | 3 |
| MLP隠しユニット | 隠れ層ごとの単位 | {64, 128, 256} | 128 |
| 中退率 | ドロップアウト確率 | [0.1, 0.5] | 0.3 |
| 学習率 | 初期学習率 | [1e-4, 1e-2] | 1.00E-03 |
| 負のサンプリング比 | 正のサンプルあたりの負数 | {1, 3, 5, 10} | 5 |
表1: MLP-PAモデルの最終ハイパーパラメータ設定
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
収束と安定性
提案モデルの収束挙動と訓練安定性を評価するため、ピラミッド特徴注意や関係認識注意を持たない標準的なMLPベースのレコメンター(制御モデルとして機能)と検証性能を比較します。すべてのモデルは、公正な比較を確保するために、同一のデータ分割、最適化設定、停止基準の下で訓練されています。
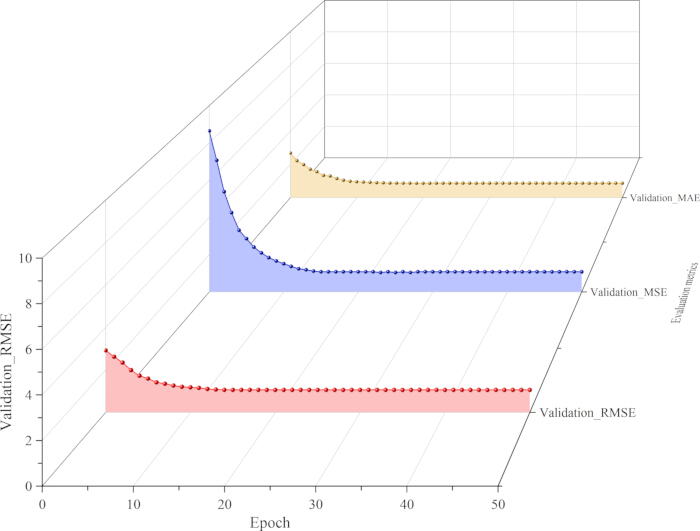
図1: 訓練中の提案モデルの収束と安定性。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
概念的および方法論的貢献
本研究は、満足度、信頼、コミットメント、相互性といった関係性の次元を静的な補助的特徴としてではなく、エンゲージメント段階ごとに影響が異なる文脈に敏感な関係シグナルとして再構築することで概念的に貢献しています。提案されたフレームワークは、行動表象と連携して関係的な手がかりを動的に重み付けする注意ベースのメカニズムを通じてこの考えを実用化しています。これにより、機能強化を超え、現代の推薦アーキテクチャに関係性マーケティングの構造を原則的に組み込む方法を導入しています。
方法論的には、関係性認識の優先順位を多スケール表現学習の基盤と統合することで、解釈可能性と予測モデリングを共同で取り組む方法を示しています。注意を単なるパフォーマンス向上の要素として扱うのではなく、このフレームワークは注意を分析のレンズとして用い、関係性メカニズムを検証・解釈することを目的としています。これにより、このモデルはスポーツ分析に...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者は利益相反を主張する義務はありません。
謝辞
著者は、この原稿の明瞭さと質の向上に寄与した建設的なコメントや提案をいただいた匿名のレビュアーの皆様に感謝申し上げます。また、本研究で使用されたデータへのアクセスを提供してくれた協力組織の支援にも感謝しています。本論文に表明された意見、調査結果、結論は著者のものであり、関連機関の見解を必ずしも反映するものではありません。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| ディープラーニングフレームワーク | PyTorch | https://pytorch.org | >= 1.12 |
| ハイパーパラメータ最適化ライブラリ | Optuna | https://optuna.org | >= 3.0 |
| ハードウェア | NVIDIA GPU | https://www.nvidia.com | シングルGPU、>= 8 GBメモリ |
| データセット | 自作のCSLファンデータセット | N/A | 1シーズン以上、深層モデリングに十分なスケール |
| 相互作用データ | ファン–アイテムの暗黙的な相互作用ログ | N/A | 別途バージョン管理なし |
| 調査データ | 関係性質問票データ | N/A | 別途バージョン管理なし |
| データ前処理方法 | ハッシュベースの匿名化 | N/A | ファンとアイテムの識別子に適用 |
| データ前処理方法 | メンバーシップ層内での平均補完 | N/A | 質問票の欠損回答に適用 |
| データ前処理方法 | Min–max正規化 | N/A | 範囲[0, 1] |
| データ分割戦略 | 時系列ユーザーレベル分割 | N/A | 最新=テスト、2番目に最新=検証、残り=トレーニング |
| 負のサンプリング | 均一な負のサンプリング | N/A | ポジティブ:ネガティブ比= 1:5 |
| モデルバックボーン | MLP(多層パーセプトロン) | https://pytorch.org/docs/stable/nn.html | 隠れ層 [128, 64, 32](最適化) |
| 注意モジュール | 関係性注意チャンネル | N/A | カスタムモジュール |
| 融合モジュール | ピラミッドアテンション(PA) | N/A | プーリングスケール{1, 2, 4}、ストライド=カーネルサイズ、縮小比= 4 |
| オプティマイザ | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | 学習率0.001、ウェイト減衰1e-5 |
| 正則化 | ドロップアウト | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | レート0.3 |
参考文献
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。