コンピュータシステムと教師による2つのNLP意味ベースのフィードバックの形でフィードバックを提供し、生徒の英語の流暢さと正確さを向上させました。結果は前者に関して良好な結果を示しました。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
コンピュータ支援言語学習技術は、特に人工知能(AI)の文脈で、ここ数年で最も大きな進歩を遂げています。自動ライティング評価(以下AWE)や自動エッセイ採点(AES)など、コンピュータ分野だけでなく教育分野でも言語学習の柱とされるさまざまな技術があります。評価はAWE技術を用いた総合スコアの形でのみ行えますが、この技術は言語学習の向上に非常に効果的であるため、詳細かつ詳細なフィードバックは提供できません。言語の主要な要素(文法と流暢さ)に関する詳細な文章フィードバックを提供するために、ニューラルネットワークモデルを含むコンピュータ支援実装システム、そして2つの意味論ベースの自然言語処理(以下NLP)手法が検討されました。そのために、英語第二言語学習者(ESL)であるパキスタンの大学生90名が、対照群、講師フィードバック群、実験群に無作為に割り当てられました。コンピュータ支援による評価はニューラルネットワークを含んでいました。AWEベースラインモデルと採点担当教員との比較テストの結果は、これらのニューラルネットワークを用いたコンピュータ支援フィードバックとの間に相関関係があることを示しました。このような結果の示唆は、特に言語の正確さや流暢さが課題となるESLライティング教育法に関わっています。
概要
ライティングにおけるフィードバックは、構成、文法、流暢さ、内容、メカニクスなど言語のさまざまな属性に対応し、学習者が書き直したり新しい文章を作成したりできるようにします1,2,3。現在、英語ライティングの教師は、コンピュータ支援言語学習(以下CALL)やAWEやAESなどのコンピュータ支援ライティング評価、そしてエッセイの採点の急速な変化と進歩により大きな恩恵を受けています。さらに、英語の文章に対するコンピュータ支援評価は、内容、文法、語彙などの言語要素に対して診断的フィードバックを提供し、学生の文章に対してタイムリーで個別かつ客観的な回答を提供します。AWEシステムは、学生がこれらの書面回答から得た知識を内面化し、認知能力を高めるために明確な書面回答を提供する機能も備えています。
本研究は、英語ライティングフィードバック理論を重視し、分析的採点プロセスを念頭に置いたマルチ戦略的コンピュータベースの英語ライティング学習の概念を提示した研究4に基づいています。これには、ディープラーニングを書面フィードバックに組み込み、詳細な書面フィードバックスコアリングを提供する他のNLPセマンティックベースのモデルも含まれていました。これは、従来のAWE技術の限界に対応しています。AWEは全体的評価のみを重視し、分析的かつ具体的なスコアリングは重視していません。したがって、これは言語学的指標の一連の要素に関する部分点と総合点を用いた正確かつ即時の評価により大きく関わっており、学生の英語作文学習を向上させることを目指します。言語学のさまざまな特徴(内容、複雑さ、正確さ、流暢性)のうち、本研究はパキスタンにおけるESL学習者の流暢さと文法的側面のみを検討します。この目的のために、本研究ではニューラルネットワークを活用し教師の評価を伴うNLP技術の戦略を提案しています。
パキスタンの言語学習の文脈では、パキスタンの学生は英語の学習に問題に直面しますが、英語の学習は1年生から14年生まで必修科目と考えています。ここで、誤ったコースや文法説明に古い方法を使うことなど、多くの要因が関わってきます。大学レベルでは、教師が教えなければならない学生の数はかなり多いです。なぜなら、学生はさまざまな大学や学校の出身者からです。これにより教師は生徒の執筆ミスを修正することに多くの時間を費やさざるを得ず、負担が過重になってしまいます。一方で、生徒たちは教師の書面によるフィードバックを当然のことと考え、誤りを認識して修正しようと努力しませんでした。
ある研究では、流暢さは主に、学生がミスを恐れるため流暢に書く障壁となり、その結果、思考に向き合うよりもミスを頻繁に避けたいと考えることに影響されると述べられています。ウルドゥー語が英語の文字に干渉することもあり、他の文脈的要因もあります。さらに、ウルドゥー語は国語です。これらの文脈的要因の結果として、教師は生徒が論文を作成したり編集したりする際に、正確でタイムリーかつ一貫したフィードバックを提供するのが難しいと感じています。ライティング評価の理論を考慮すると、本研究は従来の教師評価と比較して自動機械ライティングフィードバック戦略を用い、全体採点ではなく分析的評価を採用し、生徒が文法と流暢さという2つの重要な言語的側面について即時にフィードバックを得ることを確実にする研究を追跡できます。
Pigai.org、Bingo English、My Access、E-rater、I-write、Criterionなど、さまざまな産業用AWEおよびAES製品が登場しています。AES/AWEの開発初期段階では、主にベイズの定理10、線形回帰11 に基づく従来の機械学習システムが特徴です。現在、特にニューラルネットワーク技術を中心とした深層学習の長期的な発展は、リカレントニューラルネットワーク(RNN)12、長時短期記憶13、畳み込みニューラルネットワーク(CNN)14、BERTアプローチ15などの書き込みフィードバック分野にも顕著な恩恵をもたらしています。AWEはNLP16開始時に用いられた事前訓練戦略からも恩恵を受けました。多くの研究では、学習目的の敵対的サンプル生成、マルチタスクによる学習17、自己監督による学習18、グラフアルゴリズム19など、ニューラルネットワークに焦点を当てたさまざまな解決策が検討されています。フィードバック作成のためのトレーニングデータ不足の問題に対処するための異なる手法を提案する人もいます。また、多くのニューラルネットワークモデルに寄与するスコアリングモデルも存在します。
文法的誤り訂正(以下GEC)は、NLPミッションの独立した方法であり、作成の誤りを自動的に検出し、その後訂正する能力を持っています。GECの課題内容はAWEの側面と相互に関連しています。AWE課題は文法誤りの診断を考慮しており、その多くは正しい形で強調する必要があります。しかし、AWEの研究はGECにあまり注目を払っておらず、初期のGECモデルをAWE技術に統合した研究はごくわずかです。当初、GECの研究ではほとんどの場合N-gram2、言語モデル23(BERT24を含む)が文法誤りの特定と訂正に選ばれています。しかし、上記の解決策では、無秩序や成分の省略といった問題を完全に解決することはできませんでした。エンコーダ-デコーダ25のアーキテクチャは、他のモデルがこれまで対処できなかった課題に対応することで、GECでも同様の成功を収めています。高度なGECアーキテクチャは、Transformerベースのアプローチ26を含む複数のモデルを用いて問題解決に行ったことに注意が必要です。
複数の研究で、AESの評価が人間の評価と比較して効果的であることが確認されました。27,28。29の研究では、自動評価が学習者の英語流暢さに与える影響が示されました。結果は、自動評価が英語の書き方流暢さに良い影響を与えたことを示しました。対照的に、他の研究ではAESによる人間の評価に比べて高い誤り検出率が無視されています。最近の研究では、言語教育におけるAI支援ツールの作文評価の効果が高まっていることが明らかになっています。そのうちの一つの研究31は、中国の学生の学習文脈における自動採点と教師のフィードバックを比較しました。
学術執筆におけるAIベースのツールの革命的な役割は、近年の文献で積極的に報告されています。従来のEFLライティング教育の補完としてAI搭載のライティングツールの応用に関する研究は、技術の成功裏に導入するために、機会均等と積極的な教師支援の極めて重要性を強調しています。PigaiのようなAWEを調査した研究は、コンピュータの支援下でのフィードバックとESLのライティング、復習、新しい文章の強化との間に強い相関があることを示しました。別の研究では、変分オートエンコーダ(VAE)が学習者の英語文章の訓練面に良い影響を与え、特に言語的特徴を専門とするより高度な深層学習に対するフィードバックを得る利点が強調されています。別の研究では、神経AWEシステムは深層学習を用いて即時評価を提供するNLPベースのGECと組み合わせて有効であると示唆されています35。
マルチエージェントシステムの改善は、執筆を支援する技術の開発において重要な一歩です。アカデミークラフトは、アカデミック・ライティング・リファイニングアシスタントであるマルチエージェントの例であり、ディープラーニングに基づいて詳細なフィードバックを書き、詳細なフィードバックを提供する能力を示しており、AIベースのEFL/ESLライティング支援を複雑な分析スキームで実現しています。実際、技術ベースの言語学習研究では、ディープラーニング、自動評価、セマンティックフィードバックといった多様な出現パターンがパフォーマンス分析で明らかになり、文章の精度が徐々に一貫して増加し、学習者のエンゲージメントも向上していることが示されています。37。
トランスフォーマー-LSTMモデルは、英語の文章に対して自動採点やフィードバックを行う傾向が一定の傾向を示しています。このようなハイブリッドアーキテクチャは、トランスフォーマーの文脈的理解とLSTMシステムの逐次処理を相互に取り入れ、文法およびコヒーレンスグレーディングの精度が向上し、より微妙なフィードバック生成を提供しました。38。AIライティングツールに対するEFL教師の認識は、コンテンツの構成や執筆の質において測定可能な改善が一貫して報告されており、技術統合の有用性を促す教育的支援の重要な役割に焦点を当てています。39。教師のフィードバックとコンピュータ支援フィードバックを比較する研究は少なく、ESL学習者の英語の書き方に与える流暢さや文法の影響を探るディープラーニングモデルが示唆されています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
研究で使用されるすべてのソフトウェアとツールは 材料表に記載されています。
評価基準
本研究で採用された評価の分類は、流暢さと正確性という二つの主要な領域を対象としており、英語外国語(EFL)における文章の包括的な評価に必要なすべての要件を含んでいます。これらの次元は、効果的なコミュニケーションや言語能力の証明に役立つ文章の質の重要なポイントを測定することを目的としています。流暢さモジュールは、アイデアの滑らかさや単語や文構造の使い方のしっかりを測定することで、文章の自然さ、表現力、一貫性を測定します。正しさモジュールは、正確な文法的正確さ、機械的な完璧さ、標準的な英語慣習への適合性を目指し、仮に言語の誤りを複数のレベルで測定・カウントします。( 表1参照)
タスク定義
英語学習中の学生に対する自動ライティング評価の条件に従い、本研究はEGのコンピュータ支援英語ライティング評価システムの新しいモデルを提案しています。自動化評価システムの範囲に制限されていた従来の研究と比較して、提案されたシステムは革新的なディープラーニング技術の導入を通じて、広範なデータ処理に基づく言語分析、修正範囲、システム全体のフィードバック分析のレベルをユーザーに提供することで、これらの制約を解消する助けとなるでしょう。構成の最も重要な指標である流暢さ(作品がどれだけ自然で一貫性があり表現力豊かであるか)か(文法的、機械的、言語的な誤りが多いテキストがどれだけ正しく書かれているか)という二つの重要な指標を用い、ニューラルネットワークの別々の構成要素を用いて、デュアルモデルシステムは複数の評価を行う必要があります。さらに、複数の言語レベルでの誤りを特定し、修正措置を推奨し、リスト形式でフィードバックを提供して、ユーザーが体系的に生徒の言語学習を向上させることができます。コンピュータ支援自動評価システムの計算プロセスを記述するために、以下の数学モデルを式(1)–(4)で提案します( 表2参照)。
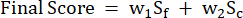 (1)
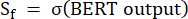 (2)
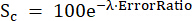 (3)
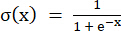 (4)
ここで:最終スコア = 総合ライティング評価スコア; w1 = 流暢さスコアに割り当てられた重み; w2 = 正しさスコアに割り当てられた重み; Sf = BERTベースの流暢性スコア(正規化[0, 1]); Sc = 指数減衰正しさスコア;λ = 減衰定数制御誤差ペナルティ;σ(x) = ロジスティック・シグモイド活性化関数;ErrorRatio = テキスト内のエラーとトークン数の比率。流暢度スコアはロジスティック・シグモイド関数σ(x)によって[0, 1]に正規化され、指数減衰関数は誤り周波数に適切なペナルティを課すために正しさを評価します。
システムアーキテクチャと設計
そのシステムアーキテクチャは並列処理アーキテクチャを持つ二モデルシステムを採用しており、入力エッセイの分析は並列評価経路を通じて並列で行われます。流暢さモジュールと正確性モジュールはそれぞれのスコアを算出し、最終的な総合スコアは2つのサブスコアの加重平均値です。正しさモジュールは、スコアリング以外にも誤り検出と訂正の提案を提供しています( 図1参照)。
フルエンシーモジュール
書き方の流暢さとは、語彙の正しい選択、文の構造の多様性、構文の複雑さ、一貫性などに関して言語の使用の性質やパターンとして定義できます。流暢さ評価モデルは、どもったりぎこちなく、ネイティブ主義的なコミュニケーショントレンドに近い、つまずくことなく伝えられるアイデアを捉えます。従来の流暢さ測定は尺度に基づいており、評価者間の信頼性に関する懸念が浮き彫りになります。提案されたシステムは、BERTベースのニューラルネットワークを含み、深い状況理解を通じて意味的整合性と言語的自然性を自動的に誘導することで、この欠点を克服しています。このアーキテクチャ上の決定は、流暢さ測定に必要な文脈的関係や意味パターンの特定に効果的であることが判明したBERTの強みを考慮してなされました。入力シーケンスはシステムに入力され、12のトランスフォーマー層を通過し、マルチヘッドセルフアテンションで長距離依存関係や文脈関係を特定します( 図2参照)。
注意のメカニズムは以下の通りです。
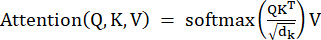 (5)
Q、K、V をそれぞれクエリ、キー、値を表現する行列、d と k をキーベクトルの次元とします。CLSトークン埋め込みは要約型で、入力シーケンス全体の意味的整合性を記録します。
流暢さスコアの計算方法は以下の通りです。
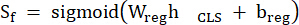 (6)
ここで hCLS は BERT [CLS] トークン埋め込み、Wレジグは回帰ヘッドのパラメータ bレジグ 、σ は出力を [0, 1] に正規化するシグモイド活性化関数です。
正しさモジュール
正しさ評価は、文法の正確さ、機械的な正確さ、標準的な英語慣習の遵守に焦点を当てています。この次元は、構文、形態論、句読点、スペルの正確さなど、書くことの技術的側面に関わります。正確性の要素は言語誤りの数を評価するだけでなく、テキスト全体の質への影響も検討します。流暢性評価が意味的一貫性と自然な流れを重視するのに対し、正確性評価モジュールは正確な誤りの特定と体系的な訂正を必要とします。このモジュールは異なるエラータイプを区別し、深刻度を評価し、学習改善を支援するための的確な修正を提供します。正しさの損失は、文法的な誤りの発見と訂正のために微調整されたFLAN-T5モデルを使用しています。この選択は、T5のテキスト間変換能力により、システムが単に故障検出だけでなく、1システム内で関連する修正を行うことも可能としています。このシステムはエンコーダ-デコーダ形式であり、テキストはこの変換の形で入力されます( 図3参照)
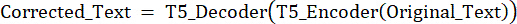 (7)
エンコーダ要素は文法的傾向だけでなく、失敗の可能性がある部分も捉える文脈依存の表現を生成します。
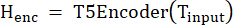 (8)
誤って識別された誤りに対して適切な文法的バリエーションを生成することで、デコーダは修正されたシーケンスを生成します:
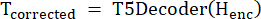 (9)
このような双方向処理により、システムは誤りの文脈を認識し、文脈をどのように修正すべきかを把握し、ヒントは意味的に整合性を持ちつつも文法の訂正に集中できます。
誤差の定量化とスコアリングアルゴリズム
正確さのスコアは、言語的な誤りやテキスト内の位置、意味への干渉に基づく深刻さを考慮し、元の文章と正しい書き方を比較したものです。この方法は、誤りの種類とテキストの理解への影響を比較して捉えます。エラーの頻度とテキストの質の低さの関係は、採点システムにおいて対数的に強調されました。元のテキストと修正済みテキストのトークン比較における基本的なステップは、ビットごとの文字列アライメント技術に基づく2つの比較段階です。第二段階は、既知の言語分類法に基づいて誤りの種類を特定し分類し、文法誤り(主語と動詞の一致、時制の一貫性、統語構造の信頼性)、機械的誤り(大文字、句読点、綴り)、用法誤り(語の選択、慣用句、語域の適切性)を区別します。第三段階は、テキストの総長に基づいて誤り率を算出することです。第4ステップでは、誤りの比率を直接解釈可能な正しさスコアに変換し、誤りの頻度とテキスト品質の非加法的かつ非線形的な依存性を近似する指数減衰スコアアルゴリズムを活用します。
誤り定量化プロセスの数学的処理は、インストールされた誤りの比率を計算することから始まり、これにより正規化された誤りインストール率が得られ、これにより異なる長さのテキストを公平に比較できるようになります。
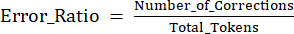 (10)
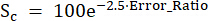 (11)
この比較パラメータは、人間の専門家の判断で完全に検証され、経験的に2.5の比較パラメータが確立され、エラー頻度の増加に伴うテキスト品質の低下に関して、人間の理解に沿った結果を得られるようにしています。このようにパラメータ値を設定することで、誤り率が低いテキスト(Error_Ratio < 0.1)は標準英語のルールに忠実に従って高い正しさスコアを得られます。中程度の誤り率(0.1 < Error_Ratio ≤ 0.3)のテキストは中間の正しさスコアとなり、言語学的な懸念が存在しつつも、完全に致命的ではないことを示しています。 誤り率が高いテキスト(Error_Ratio >0.3)は、理解の可能性に大きな影響を与える重要な言語学的問題があるため、正しさのスコアが低いとされています。
正しさ評価のための正しさスコアリングアルゴリズムは、最終誤差比率の計算において、T5ベースのシステムによって検出され修正されたすべての誤りをペナルティ項目として体系的に考慮します。文法誤りに対するペナルティクレジットの仕組みは、誤り比率の増加が指数関数的に減少し、高値に向かってテキストの質が非常に低く、誤り比率が0になると100になり、誤りが検出されないことを意味します。これは英語の標準的な慣習の完璧な使い方です。このような数学的関係により、正確さのコードは言語能力レベル全体のスペクトルにおいて重要な区別を提供し、実際の習得を示す小さな連続的な進歩にも反応します。
データセット:トレーニングおよび評価コーパス
十分な品質と範囲のトレーニングデータは、デュアルモデルシステムのパフォーマンスにとって極めて重要です。本研究では、学生が書いたテキストのよく設計されたデータセットを用いてモデルを開発・評価し、異なる執筆課題を用いて作成しました。サンプルは、平均年齢19歳のパキスタンの大学生45名と女性45名で構成され、必修科目として「機能英語」を履修していました。各生徒は8週間にわたり8つのエッセイを書き、試験前、介入エッセイ、テスト後の機会を含めました。生徒は各執筆課題で400〜450語を書くことが許されていました。データセットの統計量は以下の特徴を提供します。
70,500語
平均文長:15.7語(SD = 3.2)
語彙範囲(タイプ・トークン比):0.64(標準標準差0.08) 文法誤差密度:100語あたり2.3(標準差=1.1)
選定データの正当化とデータ品質保証
選ばれたデータセットは、自動化文書評価の研究成果に豊かさと関連性を持ついくつかの重要な考慮点によって推進されました。まず、経済学の学生層は、パキスタンの高等教育におけるEFL学習者に似た性質から選ばれ、より現実的な状況を反映したより本物の文章サンプルを提示できるようになったからです。第二に、最大および最小の潜在語域である400〜450語の確立は、パイロット研究のデータに基づき、この言語範囲は機械で確実に解析できる言語学的に十分複雑であり、人間の評価においても管理可能なサイズを維持していることが示されました。各作文は、3人の訓練を受けた英語教師(レーティング間信頼性 κ = 0.847、流暢度次元、0.823 正確度次元)によって、標準化された10点流暢度および正しさ評価尺度で評価されました。人間評価者の訓練は厳格で、IELTSやTOEFLのライティング評価に関するスコア評価基準に基づいていました。データは人間による注釈付きデータセットで構成されており、人間注釈付きデータ上で訓練するモデルの訓練や検証に利用できます。
データ前処理および検証の手順
このデータセットは体系的に前処理され、テキスト正規化、BERT WordPieceトークナイザーによるトークン化、品質検証チェックが含まれていました。不完全な作業を提出し、盗用されたテキストを作成した者はデータの整合性を判断するために含まれていません。最後のデータは、階層化されたサンプリングを通じて、習熟度レベルやタスクの種類にバランスを取るために、トレーニング(70%、n = 189)、検証(15%、n = 41)、テストセット(15%、n = 40)にランダムに分割されました。専門的に編集された学術テキスト、新聞記事、発表されたエッセイを含む大規模な参考資料群の言語学的分析で、約5,000万語に及びます。このコーパスは流暢さテストに必要な言語パターンを提供し、標準的な用法と比較することで誤り検出の手順を支援します。リファレンスコーパスでは、前処理とインデックス付けの前のステップはトークン化、品詞タグ付け、構文解析、意味的ラベリングで、リアルタイム評価時に効率的にアクセスできるようにします。
流暢さモデルのトレーニング戦略
データを流暢性を達成するための逐次最適化システムを提案します。このトレーニングは、適応型学習率スケジューリング、段階的バッチサイズ、高度な正則化手法など、学習進行中の過学習を防ぐ最先端の機能を用い、言語流暢さを示す言語パターンの特定におけるモデルの効果を維持しました。学習率は5×10⁻⁴ で、収束が安定し最適パラメータ値の周りで振動しないように設定された線形減衰スケジュールが設定されています。この学習率は[1 x 10⁻⁶, 1 x 10⁻⁴]のグリッドサーチによって決定され、収束速度と安定性の最も適切なトレードオフは5 x 10⁻⁵ です。実際の訓練は3エポックに制限され、検証損失トラッキングによって過学習を防ぎつつ、学習を効果的にするパラメータ更新を妨げずに過学習を防ぐために、実証的利点に基づいて最適化されています。分解を防ぐために、2エポックの忍耐と最小差0.001の期間で機構の早期停止が行われています。
最適化はAdamWオプティマイザによって行われ、β₁ = 0.9(運動量、第一モーメント推定値の指数関数的減衰を制御)、β₂ = 0.999(第二モーメント推定、第二モーメント推定の指数関数的減衰を制御)、ε = 1 × 10⁻8 (数値安定性項)などの簡略化された選択肢が適用されます。ウェイト減衰正則化(λ = 0.01)はパラメータの大きさが過度に大きくなるのを防ぎ、この値は範囲全体の検証性能解析によって選択されます[0.001, 0.1]。複雑なモニタリングは、トレーニング全体でさまざまな指標を監視し、モデルの最良のパフォーマンスを保証し、過学習を回避することができます。モニタリング枠組みに含まれるものは以下の通りです:
損失トラッキング:トレーニングおよび検証の損失は各エポック内で追跡され、2つの連続したエポックで検証ロスが改善しなくなった場合に自動的に早期停止が行われます。
パフォーマンス指標:検証データは、100回のトレーニングステップごとに予測スコアと実際のスコア間のピアソン相関係数を計算するために使用されます。
勾配センシング:勾配ノルムは消失や爆発する勾配を検出するために監視され、勾配ノルム1.0では勾配クリッピングが適用されます。
学習率スケジューリング:1回以上の時代の停滞が検出された場合、検証に基づく学習率低下(係数=0.5)。
正則化関連:系統的アブレーションにより、BERTが0.1、回帰ヘッドが0.3のドロップアウト率が検出されました。訓練過程では、過学習防止に基づくいくつかの正則化手法が用いられます。(1) ネットワーク内の層の種類ごとに最適化されたドロップアウト率を用いたドロップアウト正則化、(2) 上記のウェイト減衰、(3) 検証性能によって決定される早期停止、(4) トレーニング例の15%を逆翻訳法でパラフレーズしたデータ拡張。最も性能の良いモデルのチェックポイントは各エポック後に保存され、検証相関スコアに基づいて最も得点の高いモデルが選ばれました。流暢性評価部分で使用される損失関数は平均二乗誤差(MSE)であり、これは連続流暢性スコアを予測する回帰課題の主な目的関数です。損失の定式化は数学的に次のように表されます:
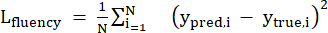 (12)
Nはトレーニングサンプルの総サイズ、y_pred、iは第iサンプルの予測流暢度スコア、y_trueは人間の専門家評価者によって与えられた対応するグラウンドトゥルーススコアです。この損失は、予測誤差と実際の誤差を二次的に抑制し、誤差が大きいほど大きなペナルティを受けやすくし、微分可能であることに非常に有用です。学習率スケジューリング機構は高度に進んでおり、2段階プロセスで、線形ウォームアップ段階から始まり、その後体系的な減衰プロセスを経て最適な収束特徴を作り出します。これはウォームアップ段階で行われ、学習率はゼロから始まり徐々に最大速度に変化し、その後モデルパラメータは訓練データセットに対して最適化されます。ウォームアップフェーズの数学的表現は次の通りです:
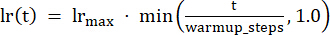 (13)
ウォームアップフェーズの後、学習率は最適パラメータ値のオーバーシュートを避けるために体系的に線形に減衰し、安定した収束をもたらします。数学的には、減衰相は次のようになります。
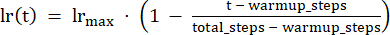 (14)
ここでtは現在の訓練ステップ、lr maxはウォームアップ中に達成された最大学習率、warmupはウォームアップフェーズに割り当てられたステップ数、totalはすべてのエポックにおけるトレーニングステップ数の合計です。前述のスケジューリング手順により、下位レベルでの積極的な学習と収束レベルでの安定性が保証されます。
正確性モデルの訓練戦略
正しさモデルは、事前学習済みFLAN-T5モデルを用いた転移学習戦略に基づいており、必要なすべての文法知識を活用しました。これは一般的な言語理解度とESL学習者が犯したミスに関する具体的な情報を探ることを目的としています。転移学習法はpszemraj/flan-t5-large-grammar-synthesisチェックポイントをベースモデルとして用い、正確性の面でいくつかの注目すべき利点があります。モデルはすでに訓練されており、さまざまな分野で高度な言語理解能力を有しているため、多様な文体やテーマに適応します。特に、第二言語の書き方で遭遇するような複数の文法誤りを含む大規模な訂正データセットに対して、文法特有の微調整が行われています。さらに、チェックポイントには形態的誤り、統語的誤り、意味誤りなど異なる種類の誤りに対して検証される強力な誤り検出システムが含まれており、研究の自然修正テストパラメータとの完全な比較基準を確立しています。
ドメイン適応プロセスは、事前学習モデルの言語理解の一般的な能力を変えることなく、評価タスクの記述ソリューションの特有の特徴を導入する体系的なパラメータ修正を反映しています。この適応の過程は数学的導出で次のようになります:
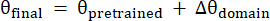 (15)
ここでθは一般的な言語理解と文法知識を符号化する事前学習モデルのパラメータを表し、 Δθドメイン は対象のライティング評価タスクから学習される特定のパラメータ更新を表します。ドメイン固有の更新は、ターゲットデータセットに対して勾配ベースの最適化によって計算され、EFLライティングに共通するエラータイプに対するタスク特有の感度を育成しつつ、広範な言語的能力を損なうことなく実現します。
比較実験
EGの機能を証明するために、Pearson相関係数が測定の鍵となる指標として提案され、自動化スコアと人間の専門知識との線形関係を決定します。相関係数は次の式で求められます。
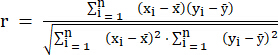 (16)
ここでxi は自動スコア、は人間の評価、  と
 はそれぞれの平均を表します。相関係数は−1から1の範囲で、1に近い値は自動評価と人間の評価の間に強い正の関係があることを示します。
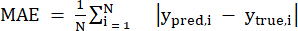 (17)
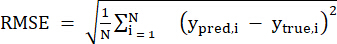 (18)
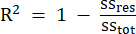 (19)
ベースラインモデル比較
EGの性能を評価し、既存手法に対する優位性を示すために、確立されたAWEおよび従来の単一指標アプローチとの詳細な比較が行われます。これらのベースライン比較は、EGアーキテクチャの付加価値を検証し、流暢性と正確性の評価の統合が個別の次元に焦点を当てたアプローチに比べて測定可能な改善をもたらすことを示すために不可欠です。ベースラインモデルの選択はAWEの4つのカテゴリーをカバーし、それぞれが執筆の評価方法に対する独自の志向を反映しています。最初のモデルは流暢さを評価するための単一のBERTモデルを持っています。これらのモデルはトランスフォーマーアーキテクチャを用いて、テキストの滑らかさや一貫性のパターンを評価します。第二のカテゴリーは、伝統的な言語学的方法論に組み込まれており、文法的誤り検出のためのルールベースのシステムに焦点を当てています。そのため、焦点は正確さにとどまり、文章の品質に関わる一貫性や内容など他の側面は無視されていました。3つ目のカテゴリーは特徴ベースのAWEシステムで、変分文の長さ、語彙の多様性、統語の複雑さなど、言語複雑度の指標を含み、全体的な品質スコアを生成します。4つ目は、様々な表面的な言語的特徴を組み合わせることでハイブリッドシステムを考慮し、しばしばアンサンブル法や加重平均を用います。これらのモデルは、EGの神経アーキテクチャが達成する統合的な高度化には達していません。ベースラインモデルのパフォーマンスは主に3つの次元で評価されます。最初のものは、標準化されたルーブリックを用いて、システム生成の成績と訓練を受けた人間の専門家(英語講師)の評価との整合性を測定します。第二は一般化可能性を判断し、異なるテーマや複雑さを持つ3つのエッセイ間でパフォーマンスが一貫しているかどうかを判断します。第三の次元は予測信頼性に依存し、平均絶対誤差、平方根誤差、信頼区間分析などの統計的手法を通じてスコアリングの正確性と安定性を評価します。これらの側面は総合的に比較の強固な枠組みを確立し、特に従来のアプローチよりも高い精度と安定性を達成する点でEGシステムの優位性を強調しています。
実験群と対照群
この研究は、機能的な英語の授業を2つの完全なクラスで履修していた90人の学部経済学学生で構成されました。データは、事前テスト、介入、事後の3つのタイミングで取得され、時間経過による筆記の正確さと流暢さの進捗を追跡しました。このヒト被験者研究は、パキスタンのCOMSATS大学イスラマバード、ラホールキャンパスの学科諮問委員会によって承認されました。参加者は従来の人間のフィードバックとコンピュータによるフィードバックの2つの条件にさらされました。対照群は45名の学生で構成され、訓練を受けた英語教師から伝統的な書面によるフィードバックを受け取りました。参加者は、学生のエッセイに関する書面によるフィードバックを受け取り、総合的な評価、誤りの特定、そして指導者による課題改善に関するコメントの形で提案を受け取りました。実験グループは教室で同じ指導を受けた45名の学生で構成されていましたが、EGによる迅速な自動フィードバックの助けを借りて、提出から約30秒以内に流暢さと正確さの診断情報が提供されました。
この研究は8週間にわたって実施され、介入前に被験者の初期の作文能力を判断するための事前テスト(第1週)が実施されました。実験群ではNLP意味マーカーを用いたコンピュータベースのフィードバック、対照群では教師による評価が6週間行われました。最終的に、8週目のポストテストは、精度と流暢さスコアの事前・事後測定の違いを理解するために実施されました。比較可能性で同様の結果を得るために、回答者には各評価期間で同様の課題を執筆で行うよう求められ、課題の難易度や内容の習熟度といった交絡変数を最小限に抑えました。難易度に見合った文章の課題を揃え、内容の妥当性を設定するために、文章の課題は一貫性のある方法で選ばれました。エッセイのテーマは、参加者が長時間同じ課題をこなさずに練習効果や退屈を感じないように、さまざまな内容をカバーしていることを基準に選ばれました。
事前試験段階では、参加者は400〜450語のエッセイを書き、学業およびキャリア目標について書くよう求められました。この記述的な課題は、個人的な経験と将来の予測に基づいており、文章の整理、明確な例の提示、個人的な目標や動機の論理的な陳述が必要であることを意味します。介入執筆課題は、日常生活のルーティン、趣味、旅行、大学初日、思い出深い日々、親友の瞬間など、さまざまなテーマに基づいていました。テスト後の課題は「技術がコミュニケーションに与える影響」というテーマに関連しており、必要なエッセイの長さは400〜450語でした。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
統計的アプローチの妥当性と信頼性
このシステムは、EGが書き書き能力の発達に与える影響を包括的に示す、さまざまな補完的な統計手法で試験されました。これは多面的な分析手法であり、教育介入は単なるグループ比較に還元されるのではなく、変化パターン、効果の大きさ、さまざまな測定戦略の相関分析に還元されることを認めています(表1、表3、表4)。
グループ間の文章力向上の比較分析
対照群と実験群間の精度および流暢度のスコアの変化を観察するため、独立した標本t検定を用いて、両群間の事前検査後の文章力向上のスコアを比較しました。この分析の方向性は、研究の主な問いである、自動化フィードバックが従来の指導法よりも学習効果が良いかどうかに基づいています。t検定の手法は統計的有意性を測定できるだ...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
実験結果はいくつかの重要な成果を示しています。まず、二重モデルシステムは人間の専門家判断(r = 0.923)との強い相関を達成し、単一モデル手法や現代のAWEシステムを大きく上回る性能を示しました。第二に、対照介入研究ではESL学生のライティングパフォーマンスに有意な改善が見られ、大きな効果量(d = 1.28)が最近の文献で報告されたものを上回ることが示されました。第三に、システムは複数の評価指標で優れた性能を示し、平均絶対誤差(0.149)の低減や多様な執筆タスクでの一貫性の向上などが挙げられました。
現在の発見をより広い研究環境に位置づけるため、同様の方法論と評価基準を用いた最近の研究との包括的な比較が行われました。本研究は、流暢性と正確性評価のための別々のモジュールを実装し、流暢性評価にはBERTベースのアーキテクチャ、文法的誤りの検出と訂正にはT5ベースのモデルを用いることで、既存のAWEシステムの重大な制約に対応しました。現在の研究環境における二重モデルシステムは、AWEに関する最近の5つの研究と比較...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
すべての著者間に利益相反はありません。
謝辞
学生からのデータ収集を支援してくれたCOMSATS大学イスラマバード・ラホールキャンパスの英語学部の支援に感謝します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| <研究で使用されたソフトウェア>ライブラリ | |||
| ディープラーニングフレームワーク | パイトーチ | 1.13.1 | ニューラルネットワーク実装のためのディープラーニングフレームワーク |
| 事前学習済みモデル | トランスフォーマー(ハギングフェイス) | 4.21.3 | 事前学習済みモデルロード、BERTおよびT5モデル実装 |
| 言語モデル | BERT(トランスフォーマーからの双方向エンコーダ表現) | バートベース・アンケース | 流暢性評価、意味的整合性評価、文脈的理解 |
| 言語モデル | FLAN-T5(ファインチューニングされた言語ネット T5) | pszemraj/flan-t5-large-文法-合成 | 文法誤り訂正、テキスト間変換、誤り検出 |
| 数値計算 | NumPy | 1.23.5 | 数値計算、数学関数の配列演算 |
| データ分析 | パンダ | 1.5.2 | データ操作、統計解析および前処理 |
| 機械学習 | Scikit-learn(シキット学習) | 1.1.3 | 統計指標の計算、相関分析、評価指標 |
| 可視化 | Matplotlib | 3.6.2 | データ可視化、トレーニング進捗プロット、パフォーマンスチャート |
| 可視化 | シーボーン | 0.12.1 | 統計データの可視化、相関ヒートマップ |
| NLPツールキット | NLTK(自然言語ツールキット) | 3.7 | テキストの前処理、トークン化、言語分析 |
| NLP処理 | スパーシー | 3.4.4 | 高度なNLP前処理、POSタグ付け、構文解析 |
| トークン化 | トークナイザー | 0.13.2 | BERT WordPieceおよびT5トークン化の高速トークン化 |
| STATISTICAL AND ANALYSIS SOFTWARE | |||
| 統計ソフトウェア | SPSS統計ソフトウェア | バージョン26.0 | 統計解析、独立標本t検定、ANOVA分析、相関分析 |
| トレーニングデータセット | Kaggle ASAPデータセット | 2012年版 | トレーニングコーパス参照(AWEモデルの90%がこのデータセットを使用しています) |
| PYTHON OPTIMIZATION AND TRAINING LIBRARIES | |||
| オプティマイザー | torch.optim.AdamW | パイトーチ 1.13.1 | 重み減衰正則化(λ=0.01)、β1=0.9, β2=0.999, ε=1×10⁸ |
| 喪失/活性化 | torch.nn.functional(火花灯の音)です。 | パイトーチ 1.13.1 | シグモイド活性化、損失関数、ドロップアウト正則化 |
| データロード | torch.utils.data.DataLoader | パイトーチ 1.13.1 | プログレッシブバッチサイズ(4→16)、データの読み込みとバッチ処理 |
| トークン化 | トランスフォーマー。オートトークナイザー | トランスフォーマー 4.21.3 | BERT WordPieceトークン化、テキスト前処理 |
| モデルのローディング | トランスフォーマー。オートモデル | トランスフォーマー 4.21.3 | BERTおよびT5アーキテクチャ向けの事前学習済みモデルロード |
| 勾配制御 | torch.nn.utils.clip_grad_norm_ | パイトーチ 1.13.1 | トレーニング安定性のための勾配クリッピング(しきい値:1.0) |
| LRスケジューリング | torch.optim.lr_scheduler | パイトーチ 1.13.1 | 線形減衰とウォームアップによる学習速度スケジューリング |
| 指標 | sklearn.metrics | Scikit-learn 1.1.3 | ピアソン相関、MAE、RMSEの評価計算 |
| PYTHON NEURAL NETWORK IMPPLEMENTATION | |||
| ベースクラス | torch.nn.モジュール | パイトーチ 1.13.1 | カスタムニューラルネットワークアーキテクチャ(Fluency &正しさモジュール) |
| 線形層 | torch.nn.リニア | パイトーチ 1.13.1 | 線形回帰ヘッド実装(768→512→256→128→1つのニューロン) |
| 正則化 | トーチ.ン.ドロップアウト | パイトーチ 1.13.1 | ドロップアウト正則化(BERTは0.1、回帰ヘッドは0.3) |
| 活性化 | torch.nn.functional.sigmoid | パイトーチ 1.13.1 | 流暢性スコア正規化のためのS状結腸活性化 [0,1] |
| 活性化 | torch.nn.functional.relu | パイトーチ 1.13.1 | 非線形変換における回帰層におけるReLU活性化 |
| トランス | トランスフォーマー。バートモデル | トランスフォーマー 4.21.3 | 流暢性評価のための多ヘッドセルフアテンションを備えた12のトランスフォーマー層 |
| Seq2Seq | トランスフォーマー。T5For 条件生成 | トランスフォーマー 4.21.3 | 文法的誤り訂正のためのエンコーダ・デコーダアーキテクチャ |
| 損失関数 | torch.nn.MSELoss | パイトーチ 1.13.1 | 流暢さ回帰訓練のための平均二乗誤差損失関数 |
| PYTHON評価とメトリクスライブラリ | |||
| 相関 | scipy.stats.pearsonr | SciPy 1.9.3 | モデルとヒトの一致に対するピアソン相関係数 |
| 誤差指標 | sklearn.metrics.mean_absolute_error | Scikit-learn 1.1.3 | 予測精度のための平均絶対誤差(MAE)計算 |
| 誤差指標 | sklearn.metrics.mean_squared_error | Scikit-learn 1.1.3 | 誤差の大きさ評価のための二乗平均平方根誤差(RMSE) |
| 統計検定 | scipy.stats.ttest_ind | SciPy 1.9.3 | 統計的有意性検定のための独立標本t検定 |
| 相関行列 | numpy.corrcoef | NumPy 1.23.5 | 評価者間信頼性のための相関行列計算 |
| データ相関 | パンダ。DataFrame.corr | パンダス 1.5.2 | データ相関分析と統計報告 |
| 可視化 | matplotlib.pyplot | Matplotlib 3.6.2 | パフォーマンスの可視化、相関プロット、トレーニング進捗チャート |
| ヒートマップ | seaborn.heatmap(Seaborn.Heatmap) | シーボーン 0.12.1 | 相関行列の可視化と統計データ表示 |
| NLPライブラリ | |||
| テキスト処理 | re(正則表現) | Python 3.9+の組み込み | テキストパターンマッチング、データクリーニングおよび前処理 |
| 設定処理 | JSON | Python 3.9+の組み込み | 構成ファイルの取り扱い、モデルパラメータの保存 |
| 連載 | ピクルス | Python 3.9+の組み込み | モデルのシリアライズとチェックポイントの保存/読み込み |
| 進捗追跡 | TQDM | 4.64.1 | トレーニングループとデータ処理のための進行バー |
| 伐採 | 伐採 | Python 3.9+の組み込み | トレーニング進捗記録、エラー追跡およびデバッグ |
| 再現性 | ランダム | Python 3.9+の組み込み | 再現可能な実験のためのランダムシード設定 |
| ファイルシステム | OS | Python 3.9+の組み込み | ファイルシステム操作、モデルパス管理 |
| CLIの構文解析 | argparse | Python 3.9+の組み込み | 訓練構成のためのコマンドライン引数解析 |
| COMMERCIAL AWE / AES プラットフォーム(参照) | |||
| 商業プラットフォーム | Pigai.org | 商用AWEプラットフォーム | 中国語EFLライティング評価、自動フィードバックシステム |
| 商業プラットフォーム | ビンゴ英語 | 商用AWEシステム | 英語学習支援、ライティングスキルの発展 |
| 教育プラットフォーム | 私のアクセス | 教育用執筆プラットフォーム | 学生のライティング評価とフィードバック提供 |
| スコアリングエンジン | E-rater | ETS自動スコアリングエンジン | 標準化テストのエッセイ採点、総合的評価 |
| 評価ツール | I-write(書きたい) | ライティング評価ツール | 学術的な文章評価と診断フィードバック |
| 練習勤務 | 基準 | ETSライティング練習サービス | ライティングスキルの育成と自動フィードバック |
| AI言語モデル | ChatGPT | OpenAI言語モデル | AI支援によるライティングフィードバックと評価(文献で参照) |
| DEEP LEARNING ARCHITECTURES(文献参照) | |||
| 建築 | 再帰神経ネットワーク(RNN) | 蔡、2019年 | シーケンシャルテキスト処理およびmdash;フィードバックシステムの作成と自動評価 |
| 建築 | 長期短期記憶(LSTM) | Jin ら、2018年 | 長距離依存モデリング—自動エッセイ採点とシーケンス分析 |
| 建築 | 畳み込みニューラルネットワーク(CNN) | ドンら、2017年 | 局所パターン認識とmdash;スコアリングのためのテキスト分類と特徴抽出 |
| 建築 | トランス-LSTMハイブリッド | Xuan、2025年 | コンテキスト処理と逐次処理を組み合わせたものとmdash;自動スコアリングとフィードバック生成 |
| 建築 | 変分オートエンコーダ(VAE) | クマールら、2024年 | 生成モデリングとmdash;文章力の向上と個別フィードバック |
| 建築 | マルチエージェントシステム | Thompsonら、2024年 | 協働AI処理およびmdash;アドバンスドライティング支援(AcademiCraftプラットフォーム) |
| メカニズム | 注意メカニズム | ドンら、2017年 | 自己注意と多頭注意 & mdash;AES性能の向上と文脈理解の向上 |
| TRADITIONAL MACHINE LEARNING TECHNIQUES (REFERENCED) | |||
| 統計的手法 | ベイズの定理 | ラドナー&梁、2002年 | 従来の機械学習アプローチとmdash;初期のAES/AWE開発と確率スコアリング |
| 統計的手法 | 線形回帰 | Phandi ら、2015年 | 統計モデリング—特徴に基づく文章評価とスコア予測 |
| 学習方法 | ランク優先学習 | チェン&彼、2013年 | ランキングベースの方法論とmdash;比較エッセイ採点と好みモデリング |
| 言語モデル | Nグラムモデル | Xieら、2015年 | 統計的言語モデリング—文法的誤り訂正とパターン認識 |
| 建築 | エンコーダ・デコーダアーキテクチャ | Geら、2018年 | シーケンス間モデリング & mdash;文法誤り訂正とテキスト変換 |
| 評価基準とフレームワーク | |||
| 評価基準 | IELTSライティング評価 | 評価ルーブリックの適応 | 流暢さと正確性に関する標準化された評価基準 |
| 評価基準 | TOEFLライティング評価 | 学術的な執筆基準 | 習熟度評価と標準化された採点 |
| 統計的指標 | コーエンのd効果サイズ | 0.2=小、0.5=中、0.8=大 | 介入効果のための実践的有意性評価 |
| 信頼性指標 | 評価者間信頼性(κ) | 流暢さ:0.847 / 正確度:0.823 | カッパ係数とmdash;人間評価者の一貫性と一致検証 |
参考文献
- Bitchener, J. Evidence in support of written corrective feedback. J Second Lang Writ. 17 (2), 102-118 (2008).
- Nusrat, A., Ashraf, F., Narcy-Combes, M. F. Effect of direct and indirect teacher feedback on accuracy of English writing: A quasi-experimental study among Pakistani undergraduate students. 3L Lang Linguist Lit. 25 (4), 84-98 (2019).
- Nusrat, A., Khan, S., Kashif, F., Fawad, R. Effect of teachers’ asynchronous e-feedback and synchronous oral feedback on English language learners’ writing accuracy. Front Educ. 7, 783684 (2022).
- Chen, B., Bao, L., Zhang, R., Zhang, J., Liu, F., Wang, S., et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: A writing feedback perspective. J Educ Comput Res. 61 (8), 60-102 (2024).
- Li, J., Link, S., Hegelheimer, V. Rethinking the role of automated writing evaluation (AWE) feedback in ESL writing instruction. J Second Lang Writ. 27, 1-18 (2015).
- Ellis, R. Explicit form-focused instruction and second language acquisition. The handbook of educational linguistics. , 437-455 (2008).
- Shamim, F. Trends, issues and challenges in English language education in Pakistan. Asia Pac J Educ. 28 (3), 235-249 (2008).
- Haider, G. An insight into difficulties faced by Pakistani student writers: Implications for teaching of writing. J Educ Soc Res. 2 (3), 17-27 (2012).
- Nawaz, M., Hussain, S. A., Bughio, F. A. Exploring the preferred corrective feedback and practiced corrective feedback among Pakistani ESL secondary school students and teachers in writing class: Matches and mismatches. Int J Lang Lit Transl. 6 (1), 31-45 (2023).
- Rudner, L. M., Liang, T. Automated essay scoring using Bayes theorem. J Technol Learn Assess. 1 (2), 1-22 (2002).
- Phandi, P., Chai, K. M. A., Ng, H. T. Flexible domain adaptation for automated essay scoring using correlated linear regression. , 431-439 (2015).
- Cai, C. Automatic essay scoring with recurrent neural network. , 1-7 (2019).
- Jin, C., He, B., Hui, K., Sun, L. TDNN: A two-stage deep neural network for prompt-independent automated essay scoring. 1, 1088-1097 (2018).
- Dong, F., Zhang, Y., Yang, J. Attention-based recurrent convolutional neural network for automatic essay scoring. CoNLL. , 153-162 (2017).
- Sharma, A., Kabra, A., Kapoor, R. Feature enhanced capsule networks for robust automatic essay scoring. , 365-380 (2021).
- Mim, F. S., Inoue, N., Reisert, P., Ouchi, H., Inui, K. Corruption is not all bad: Incorporating discourse structure into pre-training via corruption for essay scoring. IEEE ACM Trans Audio Speech Lang Process. 29, 2202-2215 (2021).
- Cummins, R., Rei, M. Neural multi-task learning in automated assessment. arXiv. , 1-9 (2018).
- Cao, Y., Jin, H., Wan, X., Yu, Z. Domain-adaptive neural automated essay scoring. , 1011-1020 (2020).
- Jiang, Z., Liu, M., Yin, Y., Yu, H., Cheng, Z., Gu, Q., et al. Learning from graph propagation via ordinal distillation for one-shot automated essay scoring. , 2347-2356 (2021).
- Li, X., Chen, M., Nie, J. Y. SEDNN: Shared and enhanced deep neural network model for cross-prompt automated essay scoring. Knowl Based Syst. 210, 106491 (2020).
- Beseiso, M., Alzubi, O. A., Rashaideh, H. A novel automated essay scoring approach for reliable higher educational assessments. J Comput High Educ. 33 (3), 727-746 (2021).
- Xie, W., Huang, P., Zhang, X., Hong, K., Huang, Q., Chen, B., et al. Chinese spelling check system based on an n-gram model. , 128-136 (2015).
- Brockett, C., Dolan, W. B., Gamon, M. Correcting ESL errors using phrasal SMT techniques. , 249 (2006).
- Zhang, S., Huang, H., Liu, J., Li, H. Spelling error correction with soft-masked BERT. , 882-890 (2020).
- Ge, T., Wei, F., Zhou, M. Reaching human-level performance in automatic grammatical error correction: An empirical study. arXiv. , 1-15 (2018).
- Zhao, W., Wang, L., Shen, K., Jia, R., Liu, J. Improving grammatical error correction via pre-training a copy-augmented architecture with unlabeled data. 1, 156-165 (2019).
- Shermis, M. D., Koch, C. M., Page, E. B., Keith, T. Z., Harrington, S. Trait ratings for automated essay grading. Educ Psychol Meas. 62 (1), 5-18 (2002).
- Mizumoto, A., Shintani, N., Sasaki, M., Teng, M. F. Testing the viability of ChatGPT as a companion in L2 writing accuracy assessment. Res Methods Appl Linguist. 3 (2), 100116 (2024).
- Ajabshir, Z. F., Ebadi, S. The effects of automatic writing evaluation and teacher-focused feedback on CALF measures and overall quality of L2 writing across different genres. Asian Pac J Second Foreign Lang Educ. 8 (1), 26 (2023).
- Almusharraf, N., Alotaibi, H. An error-analysis study from an EFL writing context: Human and automated essay scoring approaches. Tech Knowl Learn. 28 (3), 1015-1031 (2023).
- Chen, H., Pan, J. Computer or human: A comparative study of automated evaluation scoring and instructors' feedback on Chinese college students' English writing. Asian Pac J Second Foreign Lang Educ. 7 (1), 34 (2022).
- Liu, X., Zhang, Y., Chen, L. The transformative impact of AI-powered tools on academic writing: Perspectives of EFL university students. Lang Learn Technol. 28 (2), 78-95 (2024).
- Zhang, Q., Li, F. From process to product: Writing engagement and performance of EFL learners under computer-generated feedback instruction. System. 115, 102998 (2023).
- Kumar, S., Patel, R., Williams, T. Automated deep learning approaches in variational autoencoders (VAEs) for enhancing English writing skills. J Educ Technol Res. 45 (3), 234-251 (2024).
- Martinez, A., Rodriguez, P., Thompson, K. Neural automated writing evaluation with corrective feedback. Comput Linguist. 50 (1), 123-145 (2024).
- Thompson, J., Anderson, C., Davis, R. AcademiCraft: Transforming writing assistance for English for academic purposes with multi-agent system innovations. Artif Intell Educ. 12 (4), 445-462 (2024).
- Rodriguez, M., Kim, S., Brown, D. Technology-enhanced language learning in English language education: Performance analysis, core publications, and emerging trends. Appl Linguist Rev. 15 (2), 201-225 (2024).
- Xuan, Y. Transformer-LSTM models for automatic scoring and feedback in English writing assessment. IEEE Access. 13, 82084-82096 (2025).
- Anderson, R., Smith, K., Johnson, M. The impact of AI writing tools on the content and organization of students' writing: EFL teachers' perspective. Comput Educ. 195, 104712 (2023).
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。