本研究では、染色体配列が既に知られている場合や興味がない場合のプラスミドのナノ孔シーケンシングのワークフローを記述しています。初期のプラスミドDNA濃縮ステップは、最適なプラスミド配列深度を確保し、フローセルあたりのシーケンス可能なサンプル数を最大化します。
方法論記事
ナノ孔シーケンシングを用いたロングリードプラズミドシーケンシングおよびアセンブリ ワークフロー
* These authors contributed equally
この記事について
サマリー
要約
本研究は、プラスミドDNAの収率と配列決定精度を最大化することを目的としたナノ孔シーケンシングのワークフローを説明しています。研究者たちは、プラスミドDNA抽出、迅速なバーコードおよびアダプターライゲーションによるライブラリー準備、ライブラリーのフローセルへのロードによるシーケンス、ベースコール(リアルタイムまたは事後処理)、Autocyclerを用いた配列組み立てなど、各工程をカバーします。著者らはまた、ベースコールがリアルタイムで行われるかどうかに大きく依存するコンピュータ要件も明示しています。著者らはこのワークフローを用いて10株の臨床株から精製されたプラスミドをシーケンスしました。宿主-細胞株の違いを変数として除去するため、著者らはこれらの臨床株を共通の受容株と結合させ、トランス結合株を配列決定しました。これらの実験では、ゲル移動度から推定されるプラスミドサイズに一致するプラスミドアセンブリが生成され、3分の2ではショートリードのポリッシュされたアセンブリも一致するか、ペアワイズ配列同等数が0.05%以内のものとなりました。プラスミドDNA配列の濃縮は、最適なカバレッジで最大24サンプルの並列シーケンスを可能にし、プラスミドシーケンスの効率も最大化します。このプロトコルは4kbから174 kbまでのプラスミドに適しており、最大72%の染色体汚染を精度に影響することなく耐えられます。このプロトコルは、染色体配列が既に知られているか興味がない状況、例えばプラスミド配列の検証、WGSで既に得られたプラスミド配列の精度向上、または接合によって捕獲されたプラズミドのシーケンスなどに理想的です。この研究を図示するために用いられた生物は大 腸菌であり、これは組換え遺伝子発現や共役によるプラスミド捕獲に用いられる宿主の代表です。
概要
プラスミドは細菌に広く見られる自己複製可能なDNAの断片です。サイズは大きく変動が大きく、<800 bpから2.5 Mbpまで幅広く、通常は二峰分布をたどります。小さなピークは多重コピーの非接役プラスミドに対応し、大きなピークは低コピーでしばしば接役性プラスミドに対応します1,2。プラスミドは微生物生態学において重要な役割を果たし、宿主が環境の課題に適応したり新たな生態的ニッチにアクセスするのを助ける遺伝子を運んでいます。プラスミドはまた、進化加速のプラットフォームとしても機能し、遺伝的可塑性を高め、系統、種、属、さらにはファミリーを超えた水平的な遺伝子移動を媒介します3,4。ネットワークおよび比較ゲノム解析により、環境抵抗体が臨床的に関連性のある抗生物質耐性遺伝子(ARG)の持続的な貯蔵庫としての役割が確認され、生態系環境全体での維持と拡散が促進されることが確認されました。プラスミドと抗生物質耐性および病原性遺伝子の積載を追跡することで、伝播経路の特定に役立ちます。6.したがって、プラスミドの同定と特性評価は、公衆衛生、臨床微生物学、バイオテクノロジー分野で非常に関心が高いものです。
未知のDNAテンプレートのハイスループットシーケンシングを可能にする次世代シーケンシング(NGS)技術の導入により、微生物分離株のゲノム的特性解析への扉が開かれました。全ゲノムシーケンシング(WGS)は、新たな病原体、薬剤耐性株、ワクチン回避型変異株の出現、拡散、伝播を追跡することを可能にします。また、臨床アウトブレイク時の感染経路の特定にもますます活用されており、将来のアウトブレイク予防のための介入策に役立つ可能性があります7.最後に、WGSはARGのプロファイリングを可能にし、治療決定の参考となります8。ただし、ARGを抗生物質耐性の定性的および定量的な表現型に結びつけるのはまだ進行中の課題です。
しかし、WGSが大規模に作成するショートリード(SR)シーケンシングデータは、一般的に400〜500 bpの範囲です。このサイズはほとんどの移動性遺伝子要素(MGE)よりも短く、したがってそれらを分解することはできません。WGSデータにおけるプラスミド配列の インシリコ 同定は、カバレッジが不完全であること、さらにプラスミド間および細菌染色体と他のプラスミド間で共有配列が存在することにより複雑化しています。その結果、アセンブリはしばしば広範に断片化され不完全であり、そのサブゲノム位置(染色体またはプラスミド)を10に帰属させることが不可能です。
ロングリード(LR)シーケンシング技術は、より多くのリピートにまたがる非常に連続したアセンブリを生成することで、完全なプラスミドアセンブリの生成を大いに容易にします。基本的には、利用可能な長リードの単一分子技術には2種類あります。これらの手法の一つであるナノポアシーケンシングは、低コスト、迅速な処理時間、資源制限環境への適合性から微生物ゲノミクスで人気が高まっています13,14。
ナノ孔シーケンシング装置は、数千のナノポアのアレイを含むフローセルを使用します。DNAはフローセルにロードされ、ヘリカーゼ活性を持つモータータンパク質によって開かれ、電流差動によって駆動されるナノ孔を通過します。特定の単一鎖のヌクレオチドが個々のナノ孔を通過すると、電流が妨害され、それぞれの孔に接続された電子センサーによって測定される特徴的な信号が生成されます。この信号はベースコールアルゴリズムを用いて復号され、得られたデータはさらに組み立てられ、さまざまなバイオインフォマティクスツールを用いて解析されます。
SRシーケンシング手法と比較して、ナノポアシーケンシングは読み取り品質(Qスコアが低い)を生じ、電気信号のデータ解析(ベースコール)中にホモポリマー配列への挿入・欠失が生じる傾向があります15。また、ネイティブDNA中の近接メチル化が体系的な塩基呼び出し誤差を引き起こすことも指摘されています。一般的に採用されている解決策として、アセンブリ後の誤り訂正のためのショートリードデータを含めることが挙げられます。しかし、このプロセス(「研磨」と呼ばれる)はコストと複雑さのオーバーヘッドを増加させます。シーケンスカバレッジを増やすことも精度の向上につながりますが、技術的には必ずしも達成可能とは限りません。
2024年には、オックスフォード・ナノポアシーケンシング(ONT)R10.4.1フローセルとV14化学がG菌に対して高品質かつ連続したアセンブリを生成することが示されました。一方、単一塩基レベルのより細かい解析でもSRシーケンシングデータの恩恵を受けています18。 しかし、LRとSRのシーケンシング精度の差は徐々に縮まっています。最近の改良点としては、より精密なデータサンプリングプロセスとより高速なシーケンス速度、ネイティブ細菌DNAとメチル化に特化した新しいベースコーラーの導入により塩基コール精度の向上(19)、そして位相、変異コーリング、スター対立遺伝子コーリングの新しいアルゴリズムなどの解析ツールの更新が含まれます。また、最新のDoradoアルゴリズムV.0.9.0 ONT(2025年)は生のスキグルデータのリベース呼び出しにも利用できます。実際、いくつかのWGSの研究では、ナノポアシーケンスによる微生物ゲノム生成が報告されており、短リードの研磨ではコンセンサス配列が大幅に改善されないと期待されています20,21。
プラスミドは特に腸内細菌科分離株22において、獲得耐性遺伝子の大部分を含んでいることが多いです。したがって、プラスミド配列の解消によりAR遺伝子の文脈化が可能となり、AMR伝播の追跡に鍵となります 23,24。ナノポアシーケンシングはすでに、プラスミド25. を保持するblaKPCの微小進化を調べるために用いられていますMinIONデバイスはまた、病院環境での臨床分離株におけるプラスミドのリアルタイムベンチトップシーケンスや耐性遺伝子検出にも使用されています。とはいえ、プラスミドの尋問はまだ通常の感染管理の一部ではありません。
LRシーケンシングは、ゲノム配列27からプラスミドを救出する能力においてSRシーケンシングに比べて大幅に改善されているにもかかわらず、いくつかの問題は残っています。Flye28、Canu29 、Raven30 などの長リードアセンブラは高品質な染色体アセンブリを生成しますが、プラスミド配列の組み立てには苦労しています。これは部分的には、WGSのシーケンシングデータでプラスミドDNAが過小代表されているため、カバー範囲が不十分であることが一因です。モジュール構造、二次構造の豊富さ、そして頻繁なリピートの存在により、プラスミドDNA配列の高品質な組み立ては染色体DNAよりも高いカバレッジ(50倍の読み取り深度32)を必要とします。
プラスミド配列でDNAサンプルを濃縮することは、カバレッジの深さを広げる効果的な方法ですが、DNA配列決定前にプラスミドDNAを単離または濃縮することは、臨床診断には高コストまたは労力がかかり、選択されたDNA配列を濃縮することでバイアスを生じさせる恐れがあります。2017年には、プラスミド濃縮DNAを用いて臨床サンプル中のプラスミドDNAを完全に組み立て、ARGs24の検出を試みました。6種の異なる腸内細菌科から8種の分離株をシーケンスし、個体群とプラスミドの構造多様性を最大化しました。いくつかのアセンブラを試した結果、Canu/Canu+Pilonが明らかに他社を上回ることが示されました。また、この研究グループはメタアセンブリ手法を試み、追加のプラスミド構造の解像を実現し、配列サンプル中の既知の全プラズミドの78%を完全に組み立てることを達成しました。しかし、大規模リピート構造の存在や(程度は小さいものの)DNA抽出の問題は、すべての単一コンティグ・プラスミドアセンブリの検出に依然として重大な問題をもたらしました。
近年では、低存在量プラスミド配列の濃縮を補完的に利用する適応サンプリングが、細菌分離サンプル中の染色体配列をリジェクトすることで検討されていますが、この方法は既知の参照配列を必要とします。
ここでは、プラスミドDNAが濃縮されたサンプル向けにカスタマイズされたONTシーケンスのプロトコルについて説明しています。プラスミドDNAの表現性向上と最新のライブラリー調製プロトコル、フローセル技術、配列アセンブリツールを組み合わせたワークフローにより、ゲル移動度から推定されるサイズに一致し、3分の2ではSRシーケンスのポリッシュ結果に一致するか、ペアワイズ同定0.05%以内のアセンブリを生成しました。プラスミドDNA配列の濃縮は、最適なカバレッジで最大24サンプルの並列シーケンスを可能にし、プラスミドシーケンスの効率も最大化します。これらのプロトコルは標準的なナノポアWGSアプローチを置き換えるものではなく、染色体配列が既に知られているか関心のない状況でプラスミドシーケンスの精度と効率を最大化するためのものです。
ワークフローには、プラスミドDNA抽出、バーコーディングを用いたライブラリー準備、モータータンパク質へのアダプターライグation、フローセルのチェック、シーケンスのためのライブラリへのロード、電気信号のデータ解析(リアルタイムまたは事後処理)、Autocycler34を用いた配列組み立て、および様々な下流解析が含まれます(図1)。
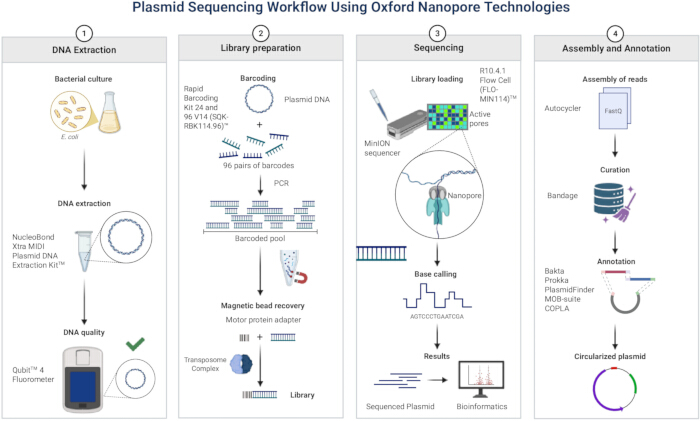
図1:オックスフォード・ナノポア技術を用いたプラスミドシーケンスワークフロー。 ステップ1:DNA抽出;ステップ2:図書館の準備;ステップ3:シーケンス;ステップ4:アセンブリと注釈付け。BioRenderで作成。コルテス, G. (2026) https://BioRender.com/u3b15st. この図の拡大版はこちらをクリックしてご覧ください。
プロトコル
1. プラスミドDNA抽出
注:このプロトコルは、市販のプラスミドDNA抽出キット35を用いて臨床的な大腸菌株および対応するトランスコンジャムからプラスミドDNAを抽出するために使用されました。活用の詳細なプロトコルは36に記載されています。このプロトコルは、高コピーおよび低コピーのプラスミドの両方に適しており、約3 kbから~200 kbの範囲です。大型プラスミドはコピー数が少なく(細胞あたり1〜2コピー程度)、DNAの収率が制限されるため、特に注意が必要です。これを補うために、プロトコルでは細胞量と溶解・中和バッファーの体積を増加させ、カラム結合に必要な十分なプラスミドDNAを確保することを推奨しています。このプロトコルを用いて最大200 kbのプラスミドも回収可能です。しかし、メガプラスミド(>200 kb)への適用範囲は限定的です。
- プラスミド抽出
- 1日目:適切な抗生物質を補充したLuria–Bertani(LB)寒天プレートにストリークサンプルを照射し、それぞれのプラスミド伝媒耐性マーカーを選択するために37°Cで24時間インキュベートします。
注意:カルベニシリン(または適切な抗生物質)を最終濃度100μg/mLでLBに加える際は、培地1mLあたり100 mg/mLのストック溶液1μLを加えます。 - 2日目:1日目から単独コロニーを使い、適切な抗生物質培地でLBを3〜5mL接種します。37°Cで振って~8時間、または培養液のOD₆₀₀₀が1〜2に達するまで培養します。
注:OD600の測定:適切な抗生物質を含む新しいLB培地で分光光度計を空白し、1mLの培養液をクリーンなキュベットに移し、600nmでODを測定します。測定値が線形範囲を超えた場合は試料を希釈して再測定します。 - 400 mLのLBに適切な抗生物質培地を補足し、400 μLの2日目スターター培養を接種します。37°Cで振って8〜12時間、またはOD600 が1〜2に達するまで培養します(前述の通り)。
注意:OD600 が12時間以内に1〜2に達しない場合は、培養体積を400mL以上に増やしてください。プラスミドの喪失や再配置のリスクを減らすために、培養への通過をできるだけ制限し、すべての成長段階で抗生物質の選択を維持してください。より高いDNA収率を望む場合にのみ培養体積を増やしてください。 - 3日目:培養液を培養体積に適した遠心分離機ボトルに移します。4200 x g で遠心分離機で10分間加熱した後、製造者が推奨する試薬量で以下の公式に従ってペレットを再懸浮させます。
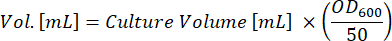
注:例:低コピーの細菌培養液(OD600 = 2)を400 mL溶解する場合、適切な溶解バッファー RES、LYS、NEUの容量はそれぞれ16 mLです。
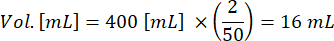
注意:再懸濁、溶解、または中和のための試薬体積が、全培養バイオマス(OD600 × 体積、ODV)に対して適切にスケールされていない場合、溶解が不完全で、中和が効率的でなく、沈殿物の生成が過剰になる可能性があります。これによりプラスミド収率の低下、純度の低下、精製カラムの詰まりの可能性があります。製造元の処方(ステップ1.1.4)を用いてバッファーの体積を比例的にスケーリングすることで、効率的な溶解、完全な中和、高品質なプラスミドDNAの一貫した回収が保証されます。 - キットの指示に従い、細胞溶解、適切なバッファーを用いたフィルター濡れ、中和を行います。
注意:沈殿物の量が多い場合はフィルターを2つ積み重ね、バッファーを比例的に調整してください。上清液が不透明のままであれば、追加の遠心分離工程を行います。中和後、大量の沈殿物のため追加の遠心分離工程が必要になることがあります。これはほとんどの大 腸菌臨床サンプルに当てはまり、おそらく培養37でバイオフィルムを形成する傾向があるためであり、これは厚いマトリックス38の分泌を伴うものです。溶解液中の過剰な沈殿物はカラムを詰まらせ、ドレン時間を延長し、サンプルをタンパク質で汚染する可能性があります。上澄液が透明であれば、これらの追加作業は不要かもしれません。 - 溶解液を4200 x g で30分間遠心分離します。上澄液を新しいチューブに移し、再び遠心分離機で30分間処理します。これらのスピン後も上清液が不透明なままであれば(図2)、4200 x gで追加の遠心分離を行います。
注:遠心分離中に溶離液を50mL培養チューブに移すことで、沈殿物が適切にペレット化できずチューブ上部付近に閉じ込められることがあるため、上清液の除去が容易になることがあります。大量の処理量のために、単一のカラムが飽和状態になり、追加のサンプルを収容できなくなることがあります。ろ過速度を上げたりDNA収量を最大化したりするために、解体液を2つのカラムに分割することができます。 - キットの説明書に従ってEQU、WASH、ELUのステップを実行してください。
- イソプロパノールを用いてDNAを沈殿させます。
注意:ペレットが見えない場合は、-20°Cで約10分間培養してください。しかし、上澄液は慎重に除去し、たとえペレットが見えなくてもチューブ壁に付着していると信じて行うのが最善です。 - 指示通りにエタノールでDNAを洗浄してください。タンパク質沈殿物が残る場合は追加の洗浄を行います。
- 室温(~20°C)で15〜30分間DNAを乾燥させます。
- DNAをヌクレアーゼフリー水100μLに再懸濁させる。この小さな体積により、ナノポアライブラリーの調製における濃度の最大化に役立ちます。
注意:これは便利な中断点です。プラスミドDNAは–20°Cの環境で数か月間保存可能です。 本プロトコルで使用される抽出キットは、最適化されたバッファー化学、穏やかな溶解、溶解液の清算工程を通じて染色体(ゲノム)DNAからの汚染を最小限に抑えるよう設計されていますが、染色体DNAの重大な汚染を完全に排除することはできず、著者らは調製過程でこれを発見しました(結果参照)。
- 1日目:適切な抗生物質を補充したLuria–Bertani(LB)寒天プレートにストリークサンプルを照射し、それぞれのプラスミド伝媒耐性マーカーを選択するために37°Cで24時間インキュベートします。
- DNA収率と品質管理
蛍光染料を用いてDNAを定量し、その品質を評価する。蛍光染料はUV吸収法に比べて低DNA濃度に対して特異性と感度が高い。このプロトコルでは、蛍光計装置を用いてDNA、RNA、またはタンパク質サンプルを正確かつ便利に定量します。- フルオロメーターのワークフロー
- DNAサンプルを室温に移してください。標準試験とサンプル用のチューブを準備してください。
注意:サンプル数に基づいて作業溶液に含める適切な染料とバッファーの量を計算してください。各標準および試料ごとに、バッファー内の染料を1:200の比率で希釈して200μLの作動溶液を準備する必要があります。この装置には、これらの計算にも使用できる試薬計算機が内蔵されています。 - 表1に従ってアッセイチューブを準備します。
- 各チューブを数秒間渦巻かせてから、室温で2分間孵化します。
- 標準を使って蛍光計を校正してください。サンプルチューブを挿入し、測定値を記録します。詳細な指示は、フルオロメーターマニュアル39を参照してください。
注:典型的なプラスミドMidi製剤では、プラスミドサイズ、コピー数、成長条件に応じて、DNA収量は100〜400 mLあたり~50〜150 μgの範囲で予想されます。典型的なナノポアリード長は~2 kbから20 kbの範囲で、標準プラスミドでは中央値リードは5〜10 kb程度であることが多いです。ライゲーションベースのキットは、より大きなプラスミドに対してより長いリード(>20 kbの中央値)を生成できますが、ラピッドキットはやや短いリードを代償としてより早く準備できます。
- DNAサンプルを室温に移してください。標準試験とサンプル用のチューブを準備してください。
- フルオロメーターのワークフロー
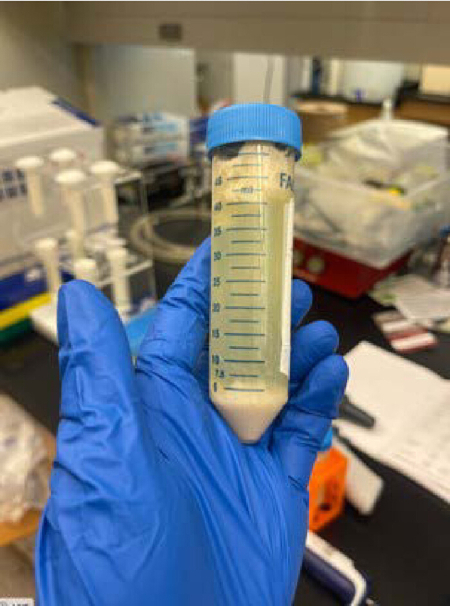
図2:遠心分離1回後の濁った溶解液上清液。 上清液が透明になるまでは連続遠心分離が必要で、ろ過カラムの詰まりを防ぎます。 この図の拡大版はこちらをクリックしてご覧ください。
| 標準分析管 | ユーザーサンプルアッセイチューブ | |
| 作業液(染料とバッファー、1:200) | 190 μL | 180–199 μL |
| スタンダード(キットから) | 10 μL | – |
| ユーザーサンプル | – | 1–20 μL |
| 各アッセイチューブ内の総体積 | 200 μL | 200 μL |
表1:蛍光計用の試薬体積と量。 単一サンプルの量が示されています。分析するサンプル数に基づいてプールを準備できます。
2. 方法2:ライブラリの準備
注意点:考慮事項。抽出されたプラスミドのシーケンス準備は、バーコードキット40に付属する指示に従って行われました。このプロトコルはトランスポザーゼベースのキットを用いて、DNAを同時に断片化しバーコードを処理し、迅速かつ効率的なワークフローを提供し、実務作業の時間を短縮しライブラリ作成を簡素化します。
- DNA調製
- 1日目:サーマルサイクラーをプログラムします:30°Cで2分、その後80°Cで2分間。
- キットの部品を室温で解凍し、スピンダウンして表 2に従って混合してください。
注意:遠心分離機を使用する場合は、330× gを超えない低速でスピンダウンしてください。 - ヌクレアーゼフリー水でのDNA調製:200 ngのDNAを0.2 mLのPCRチューブに移し、各サンプルに適切な量のヌクレアーゼフリー水を加えて最終的な10 μLにします。ピペッティングで10〜15回優しく混合します。マイクロフュージまたは遠心分離機で330 x g で短時間スピンダウンして、以下のピペット処理を容易にします。
- 表3に示されたようにPCRチューブで混合物を準備します。
- ピペッティングで混ぜ、短時間スピンダウンします。
- ステップ1の熱サイクルプログラムでPCRチューブをインキュベートします。冷やすためにチューブを氷の上に置いてください。
- 短くスピンダウンします。
- ネイティブバーコードリゲーション
- プールでバーコードされたサンプルをクリーンな1.5 mLエッペンドルフチューブに入れます。総体積が1000μLを超えないようにしてください。
- ビーズを渦巻いて再サスペンドする。バーコードサンプルに同量のビーズを加え、はじいて混ぜます。
- チューブを室温のHulaミキサーで10分間孵化させます。
- ヌクレアーゼフリーの水に80%エタノール2mLを準備します。
- サンプルとペレットを磁石に押し付けて回転させます。チューブを磁石につけたまま、ピペットで上清液を廃棄物として取り除きます。
注意:適切な強度とサイズの磁石、ネオジム磁石を含むものは、高価な磁石ラックの効果的な代替手段として機能します。保持力が約5〜12ポンド、直径0.3〜1インチの磁石は、標準的な0.2〜1.5 mL管に適しており、ビーズによるクリーンアップ作業中に上清液をきれいに除去できます。 - 磁石の上でビーズを1mLの80%エタノールで洗います。エタノールを取り除きます。洗いを繰り返します。
注意:チューブの磁石に対する位置を変えることで、エタノールの除去が容易になる場合があります。ペレットが誤って動かされた場合、完全なビーズペレットを確保するために、追加の低速スピンを活用してください。 - 短く回転させてチューブを磁石に戻します。残留したエタノールはピペットで取り除きます。30秒間乾燥させますが、割れるほど乾燥させないでください。
- 磁石を取り外し、ビーズを洗脱バッファーに再懸浮させます。使用中のバーコード数に応じて適切なEBのボリュームについては表 4 を参照してください。
- チューブを室温で10分間孵化させます。
- チューブを磁石に戻し、溶出液が透明になるまで戻します。
- フルオロメーターで溶出サンプル1μLを用いてDNA濃度を定量し、ライブラリー準備が成功したか確認し、失敗したライブラリーにフローセルを無駄にしないようにします。
- アダプターライゲーション
- DNAライブラリーの11μLを新しいチューブとラベルに移します。
注意:必要に応じて将来のシーケンス実行のために、余分なDNAは-20°Cで保存してください。 - 解凍したラピッドアダプターを表 5 に従って新しいチューブで希釈し、ピペットで上下に混ぜます。
- 11μLのDNAライブラリに希釈されたRAを1μL追加します。
- チューブをひねって混ぜ、一瞬だけ回転を下げてチューブの底に全体の体積がたまるようにします。
- ベンチで5分間孵化させます。
- DNAライブラリーの11μLを新しいチューブとラベルに移します。
| 試薬 | 室温での解凍 | スピンダウン | ピペッティングによる混合 |
| ラピッドバーコード | アナと雪の女王ではない | ✓ | ✓ |
| ラピッドアダプター | アナと雪の女王ではない | ✓ | ✓ |
| AMPureのXPビーズ | ✓ | ✓ | 使用直前にピペットまたはボルテックスで混合してください |
| 洗脱バッファ | ✓ | ✓ | ✓ |
| アダプターバッファ | ✓ | ✓ | 渦巻きによる混合 |
表2:ナノ孔ライブラリー調製のための試薬体積と量。 各試薬で実行すべき動作は(✓)にマークされています。
| 試薬 | 体積/サンプル数 |
| 10 μL テンプレートDNA(前段階から200 ng) | 10 μL |
| 1.5μLのラピッドバーコード、各サンプルごとに1つ | 1.5 μL |
| 総体積 | 11.5 μL |
表3:迅速なバーコーディングのための試薬と体積。 DNAサンプルごとの体積は示されています。混合体を調合し、DNAを別途添加することができます。
| 1-24バーコード | 48バーコード | 72バーコード | 96バーコード | |
| 洗脱バッファの体積 | 15 μL | 30 μL | 45 μL | 60 μL |
表4:24バーコードごとに使用される洗脱バッファボリューム。 ボリュームはバーコードの数に応じて示されます。
| 試薬 | 音量 |
| ラピッドアダプター(RA) | 1.5 μL |
| アダプターバッファ(ADB) | 3.5 μL |
| 総体量 | 5μL |
表5:アダプターの試薬および量。 サンプル数に応じてボリュームを調整できます。
3. フローセルの実行
注意:中程度のカバレッジを必要とする少数のプラスミドをシーケンスする際は、標準出力フローセルを選択してください。Nanoporeはアクティブ孔数を測定するためにフローセルチェックを行うことを推奨しています。ナノポアデバイスのフローセルは、保証基準で定義される少なくとも800個のアクティブポアを持つ必要があります。単一のMinIONフローセルは、プラスミドDNAで富集された複数のDNAサンプルのシーケンスに十分な出力を提供し(多重化の詳細は議論セクションを参照)、GRIDionやPrometheanフローセルよりも低コストかつ柔軟性が高いです。
- フローセルのプライミングと負荷
注:このプロトコルの開発にはR10.4.1フローセル(2022年発売)が使用されました。これらのフローセルはより長い孔を持ち、ダブルリーダーヘッドを持ち、ホモポリマーのシーケンスが改善されます20,21.このシーケンスプロトコルとバーコーディングキットは他のフローセルとは互換性がありません。大規模な多重化、高いカバレッジ、またはより大きなプラスミドやゲノムを扱う場合は、高出力フローセルを選択してください。サンプル数とターゲット深度を考慮し、コスト、スループット、シーケンス品質のバランスを取ってください。- シーケンシングバッファ(SB)、ライブラリービーズ(LIB)またはライブラリー溶液(LIS)、牛血清アルブミン(BSA)、フローセルテザー(FCT)、フローセルフラッシュ(FCF)などの試薬を冷蔵から取り出します。室温の氷で解凍します。試薬が解凍したら、渦巻きで混ぜ、クイックスピンして氷に保管します。
- 表6に記載された試薬を使って新鮮なDNAチューブを混ぜて、フローセルプライミングを準備します。逆さとピペットで混ぜます。
- 装置の蓋を持ち上げてフローセルを挿入します。適切な位置を確保するために優しく圧力をかけてください。
- カバーをそっと押しのけてプライミングポートを露出させます。
- プライミングポートの内または隣接する空気の泡がないか確認してください。気泡を除去するために20〜30μLの液体を引き戻します。
注意:バッファーは20〜30μLを超えて除去しないでください。孔は常にバッファ内に沈んでいなければなりません。空気にさらされた孔は使用不能になることがあります。バッファが可視チャンネル全体で連続していることを確認しましょう。 - プライミングミックス800μLを取り出し、プライミングポートに注ぎます。気泡の発生は避けてください。デバイスを5分間そのままにしてください。
- リブをピペッティングで上下に再停止させます。
注意:使用直前にリサスペンドしてください。リブはすぐに落ち着きます。 - 表7に示された通り、新しいチューブで適切な容量のライブラリービーズとDNAライブラリーを混ぜます。
注:著者らが使用するRapid Barcoding kitは、トランスポザーゼを用いたDNA断片化とバーコードの付着に意図的なサイズ選択を除き、リード長は主に元の入力DNAを反映しています。ネイティブバーコーディングキットのようなライゲーションベースのキットとは異なり、ラピッドバーコーディングキットには個別の短片または長片バッファが含まれていません。長いDNAでも長いリードを生成することは可能ですが、分布はより多様で一般的に短く、ロングフラグメントバッファを用いて長断片を濃縮するライゲーションベースのライブラリに比べて短くなります。バッファがないことでワークフローが簡素化され、作業時間が短縮されますが、ライブラリサイズの分配管理が難しく、アセンブリ品質に影響を与えることがあります。ライゲーションベースのキットは、大きな断片を選択的に濃縮し短い断片を除去することで、特に新規アセンブリや複雑なゲノムにおいて、中央値リード長が高くなりアセンブリの連続性が向上します。 - サンプルポートのカバーを調整してポートを露出させます。200μLのプライミングミックスをフローセルのプライミングポートに注入します。
- 準備済みのDNAライブラリーを優しく混ぜてからローディングしてください。
- 75μLのDNAライブラリーとビーズを1滴ずつサンプルポートに注ぎ、各滴を吸収させてから次の滴を加えます。
- サンプルポートのカバーを再度貼り付け、プライミングポートを閉じます。
- ライトシールドをフローセルに追加するには、ライトシールドの前縁をクリップに合わせて整え、残りの部分を下げてフローセルを覆います。ライトシールドをクリップの下に置こうとしないでください。ライトシールドはカバーの周りに設置し、フローセルの上部全体を光の当たる部分から守るべきです。
注意:ライブラリを読み込んだらすぐにフローセルにライトシールドを取り付けて最適なシーケンス出力をしてください。ライブラリがフローセルから取り外されるまで、その後の手順ではオンにしておく。ライトシールドはデバイスにしっかりと固定されていません。取り除かないように注意して扱ってください。 - 装置の蓋をしっかり閉じてシーケンスランを開始します。
- シーケンス実行の計算要件を始める:
最低条件:8スレッドCPU、16GB RAM、1070 NVIDIA GPU、500GB SSD
推奨:16スレッドCPU、32GB RAM、2070 NVIDIA GPU、1TB SSD
注意:ソフトウェアとパソコンの両方が最新であることを確認し、新しいファイルを収容できるよう少なくとも500GBの空きストレージを確保してください。ソフトウェアのアップデートやその他のプログラムはシーケンス実行に干渉することがあります。必ずWindowsまたはUbuntuのOS上でソフトウェアを動かしてください。- 実行時間制限を設定する:多重化されるプラスミドの数に応じて実行制限を設定します。デフォルトは48時間で、最大72時間のプレイが可能です。詳細な説明はマニュアルを参照してください。
注:実行時間はプラスミド数ではなく、多重化やプラスミドサイズに依存します。多重化可能なサンプルやプラスミドの数は、望ましいシーケンス深度と流量セルの出力によって異なります。典型的なプラスミドシーケンシングでは、標準ナノポールフローセルあたり20〜24サンプルを多重化することで、プラスミドサイズ~200 kb未満を仮定した場合、正確なアセンブリおよび変異検出に十分なカバレッジが得られます。より大きなプラスミドやより高いカバレッジ要件は、1セルあたりのサンプル数が少なくて済みます。高出力フローセルは1回のランで最大96個以上のサンプルをサポートできるため、高スループットのプラスミドシーケンシングや非常に深いカバレッジを必要とするプロジェクトに適しています。ユーザーはバーコードの数、プラスミドサイズ、ターゲット深度のバランスを取って、各プラスミドが完全な組み立てに必要な十分なリードを受けられるようにすべきです。 - シーケンス中にデマルチプレクシングを行う場合はバーコードトリミングを有効にしてください。
注意:モニターはバーコードごとに読み取り、フローセルの寿命を保つために十分なカバレッジが得られたら実行を停止します。 - 超高精度ベースコーリングモードを選択します。
注意:アダプティブサンプリング/バーコードバランシングを選択しないでください。この方法は読み取り出力を大幅に減らし、孔の劣化速度を速くします。GPUがない場合は、ラン終了後はベースコールを控えたほうが良いです。 - 適切なラピッドバーコードキット(24または96)を選択してください。
- デバイスが水平であることを確認し、デフォルト設定(最小Qスコア10)でシーケンス実行を開始します。
注意:これは便利な中断点です。この装置は一晩中稼働可能です。 - 事後ベースコーリング(コンピュータがライブベースコーリングに十分な容量がない場合や、ベースコーリングの精度を向上させるために、生データを改良された分析ツールで再解析する場合):ソフトウェア内で完了したシーケンス実行を開きます
注意:次のステップは、ライブベースコールを選択していない場合のみ適用されます。 - ベースコールを選択し、超高精度(SUP)モデルを選択します。
- 生のFAST5/POD5データを選択して出力ディレクトリを設定します。
- ベースコールを始めて。
- 実行時間制限を設定する:多重化されるプラスミドの数に応じて実行制限を設定します。デフォルトは48時間で、最大72時間のプレイが可能です。詳細な説明はマニュアルを参照してください。
| 試薬 | フローセルあたりの体積 |
| フローセルフラッシュ(FCF) | 1,170 μL |
| 牛血清アルブミン(BSA)を50 mg/mLで | 5 μL |
| フローセルテザー(FCT) | 30 μL |
| チューブ内の最終総体積 | 1,205 μL |
表6:プライムおよびフローセルの充填のための試薬と体積。試薬の体積はフローセルごとに示されています。
| 試薬 | フローセルあたりの体積 |
| シーケンスバッファ(SB) | 37.5 μL |
| ライブラリビーズ(LIB)またはライブラリソリューション(LIS)、 | 25.5 μL |
| DNAライブラリ | 12 μL |
| 合計 | 75 μL |
表7:ライブラリを読み込む試薬およびボリューム。 DNAライブラリの巻数は示されています。ライブラリビーズ(入札)は使用直前に混ぜるべきです。
4. 方法4:オートサイクラーによる組み立て
注意:リードをコンティグに組み立てる方法は多数あります。各アセンブラには長所と偏りがあります。このプロトコルでは、多くの異なるアセンブリを組み合わせて1つのアセンブリにまとめるAutocyclerの使用を推奨しています。これはより手間がかかり、単一のアセンブラで時間を節約できます。適切なソフトウェアをダウンロードするには、端末にCondaをインストールしてください。補助コマンド文書には、システムを設定するための環境ファイルへのリンクが含まれています。
- ランの質を評価する:Minknowソフトウェアやランレポート.htmlファイルからランの質を確認し、品質指標(収量、Qスコア、長さ、分布)を記録します。オプションとして、NanoPlotを使ってFASTQファイルを評価し、各バーコードの読み取り長分布、N50、品質スコアプロファイルを確認することも可能です。シーケンス収量およびリード長分布が期待されるプラスミドサイズと整合している場合にのみ進めてください。
- バーコード削除:シーケンス実行中にバーコードトリミングが有効だったかどうかを確認しましょう。バーコードが除去されない場合は、Porechop(v0.2.4)を使ってFASTQファイルをトリミングし、バーコードアダプターシーケンスの除去が成功しているかを確認してから、下流解析に進みます。
- トリムリード:Filtlong(v0.3.1)を用いてロングリードをトリミングし、約5〜10%の低品質リードを除去しつつ、総収量の約90%を保持します。組み立て用にフィルタリング済みのFASTQファイルを生成します。もし後続アセンブリでキメラ連体が生じた場合は、最小リード長閾値を≥,000 bpに設定し、フィルタリング済みリードを再生成することでフィルタリングの厳密性を高めます。
- サブサンプルとアセンブルリードサブセット:サブサンプルは推奨設定に従ってAutocyclerで読み取り、各リードサブセットはRaven(v1.8.3)、Floy(v2.9.6)、Canu(v2.3.0)、miniasm(v0.3.0)、Myloasm(v0.2.0)、NECAT(v0.0.1)、Plassembler(v1.8.1)、その他任意のアセンブリでアセンブリをアセンブルします。各アセンブリの連帯長と円形化状況に注目してください。円形化を報告するアセンブラ(Raven、Flye、miniasm、Myloasm、Plassembler)はプラスミド再構築に優先すべきです。CanuおよびNECATアセンブリについては、過去のアセンブリの円形コンティグから予想されるプラスミドサイズに基づいて候補プラスミドコンティグを特定します。
- アセンブリの検査とキュレーション:Bandage(v0.9.0)を使って各アセンブリグラフファイル(.gfa)を可視化し、円環性、アセンブラ間のサイズ一貫性、キメラ結合の証拠を評価します。複数のアセンブラでサポートが不足している線形コンティグを削除し、一貫したサイズ推定で円形コンティグを保持します。多くのアセンブリにキメラ結合が含まれている場合は、ステップ4.3に戻り、最小リード長閾値(推奨≥3,000 bp)を増加させます。主要なプラスミドが円形化されているものの、より小さく支持されていない連体が残る場合は、合意生成前に小規模な連体を除去します。コンセンサス生成に進み、手作業でキュレーションした後に一括で仕上げを行うことができます。
- 合意形成と最終組立:手動キュレーション後、キュレーションされたアセンブリを用いてAutocyclerの合意生成を進めます。残りのオートサイクラーコマンドを実行し、最終的なコンセンサスプラスミド配列を作成してください。詳細なコマンドライン指示やパラメータ設定は 補足資料に記載されています。
- 研磨:アセンブリが完成したら、Medaka(v2.1.1)でトリミングしたロングリードを使ってアセンブリを研磨し、コンセンサスの精度を大幅に向上させます。
注意:追加の研磨弾は合意の正確さ向上に役立ちますが、誤りを生むこともあります。新しいコンティグを研磨する前に回転させるのがDNAaplerのようなプログラムのベストプラクティスです。コマンドは補足コマンドのセクションで確認できます。
5. 方法5:注釈
注:細菌に関する効果的な注釈ツールは多数存在します。詳細な注釈のために、以下のプログラムを推奨します。
- Baktaは現在積極的に維持されており、Prokka41,42の精神的な後継として機能しているため、プロテオミクス解析に非常に適しています。
- レプリコン型、プラスミド可動性型、結合型にはMOBスイートが信頼できる6。MOBスイートはマッシュディスタンシングを用いてプラスミド系統を推定でき、挿入配列(IS)元素を同定できます。
- COPLAはまた、プラスミド分類学においても有用なツールです。コプラ独自のアプローチであるプラスミドをプラスミド分類単位に分類する手法は、フィールド44で推奨されています。
注:プラスミドの系統発生は、過去に大きな課題を抱えてきました。なぜなら、プラスミドのモジュール構造と高い頻度の組換えにより配列のアラインメントが困難だからです。COPLAは平均ヌクレオチド同等性(ANI)を計算することでこれらの課題に対応しています。
結果
臨床的大 腸菌 株
臨床株のプラスミド配列決定にONTを用いる例を示すために、著者らはワシントン大学のスティーブン・サリパンテ博士からの寛大な寄贈を受けた10株を配列決定しました。これらの株は、ワシントン大学医療センター45での定期臨床治療中に得られた312株の血液または尿由来のエストレクター病原性大腸菌(ExPEC)のコレクションの一部でした。
プラズミドの接合とゲル移動度アッセイによる特性評価
研究者たちはまた、受容体として 大腸菌 株LMB100を用いた結合アッセイも実施しました。結合とは、細胞(ドナー)に存在するプラスミドが別の細胞(受容者と呼ばれる)へ移転する過程です46。移転は2つの細胞間の物理的接触を必要とし、通常は受容細胞内の接合プラスミドの存在を示すマーカーを用いて検出されます。これにより、著者らは宿主株の違いを変数として排除し、プラスミド捕獲(特定の生態的ニッチのプラスミドをプロファイリングする方法)によって得られるプラスミドのシーケンスプロトコルの利用を示しました。すべての接合アッセイでトランス接合体が得られ、ドナーに接合プラスミドが存在することが確認されました。著者たちが従ったプロトコルは36で説明されています。グループはドナー株とレシピエント株に存在するプラスミドを特定し、パルスフィールドゲル電気泳動(PFGE)によってその移動度を推定しました。表8には代表的な10種類のドナー株のリスト があり、 それらに含まれるプラスミドの推定サイズは3列目に示されています。PFGEゲルの解像度範囲外のプラスミドはこの表から除外されますが、研究者たちは約4kb(示されていない)約4kb程度の小さなプラスミドをいくつか組み立てることができました。
| ドナー株 | プラスミド | 推定PFGEサイズ | アセンブリの長さ | 平均深度 | bp ゼロ深度 | カバレッジパーセント | ポジション変更 | SR以前の精度% |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
表8:10株のドナー株パネルにおけるプラスミドサイズ推定およびシーケンス精度指標。PFGEまたは組み立て済みONTドナープラスミド配列に基づくプラスミドサイズ推定値が記載されています。ONT単独とSR配列のポリッシュドプラスミドアセンブリのペアワイズ比較も、精度の指標として示されています。指標には、アセンブリ長、平均深度、ゼロ深度領域、カバレッジ率、ポジション変更、SR前の精度割合が含まれます。
ONTベースのプラスミドシーケンシング出力指標
シーケンスランは24時間に設定されていました。合計24サンプルが多重化されました。各サンプルの技術データ(品質スコア(Q)、長さ、カバレッジは 表9に記載されています。ナノ孔シーケンシングにより、解析されたすべてのサンプルに対して十分なリード出力と品質が得られました。すべてのライブラリで、シーケンシングはサンプルあたり平均134,115本のリードを生成し、平均収量は576.2 Mbに相当します。リードの平均長は8,797 bp、平均N50は3,693 bpで、プラスミド組み立てに十分なリード連続性を提供しました。平均読書品質スコアはQ16.0、中央値はQ16.6、個別のランはQ13.7からQ18.0の範囲でした。
| 序列変形 | リード(KB) | ベース数(Mb) | 平均長さ | 最大長さ | 最小長さ | N50 | 中央値長 | 平均Q | 中央値Q | |
| Blood_08_0081ドナー | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094ドナー | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447ドナー | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913ドナー | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154ドナー | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238ドナー | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108ドナー | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134ドナー | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217ドナー | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90ドナー | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 LMB100トランスコンジャガント | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 LMB100 トランスコンジャガント | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 LMB100 トランスコンジャガント | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 LMB100 トランスコンジョガント | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 LMB100 トランスコンジャガント | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 LMB100 トランスコンジョーガント | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 LMB100 トランスコンジャガント | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 LMB100 トランスコンジャガント | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 LMB100 トランスコンジャガント | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 LMB100 トランスコンジャガント | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
表9:10株ドナー株のパネルに対するNanoQのシーケンス出力指標報告。 シーケンス出力指標が一覧化されています。これにはリード数、塩基数、長さ(平均、中央値、最大値、最小値)、長さ、N50、Q(平均値および中央値)値が含まれます。
プラスミドの組み立てと精度
プラスミド配列はAutocycler34で組み立てられました。10サンプルの組み立て済みプラスミド配列のサイズは 表8第4列に記載されており、いずれもPFGE移動度に基づく推定値(第3列に記載)と一致していました。精度は、Medakaで研磨された長リードアセンブリとMedaka(v2.2.0)およびポリポリッシュ(v0.6.1)アセンブリを比較することで評価されました。配列同定はMUMmer(v3.2.4)のdnadiffを用いて算出されました(表8)。解析されたすべてのプラスミド(n=12)で、アセンブリの平均長さは120.4 kbで、平均シーケンス深度は109倍、平均的なカバレッジ率は97.9%でした。研磨前は、アセンブリの平均配列同一性はSR配列研磨アセンブリに比べて99.74%でした。
染色体汚染の推定
プラスミドの被覆率と染色体汚染を推定するために、リードを組み立てたプラスミド配列および大 腸菌 LMB100染色体配列にマッピングしました。Baseと呼ばれるNanoporeリードはminimap2(v2.2.6)を用いてアライメントされました。得られたアライメントはSAMtools(v1.1.7)を用いて処理され、ソートされたBAMファイルを作成し、マッピング統計を計算しました。プラスミドの被覆率と平均深度はSAMtoolsのカバレッジを用いて推定されました。プラズミドのシーケンス深度はサンプルごとに異なりましたが、正確な組み立てに必要な最小カバレッジ(50〜70倍)を大きく上回っていました。リードの一部が染色体にマッピングされ、プラスミド抽出中の宿主DNAのキャリーオーバーが示唆されています(表10)。
| プラスミド | 総読数 | 染色体の読み取り | 染色体読み取り率 | 平均染色体カバレッジ | 平均プラスミドカバレッジ | P:C比率 |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
表10:染色体DNA汚染の推定値。 レシピテイント株から精製されたプラスミドにおける染色体汚染は、プラスミドリードに対してLMB100染色体配列にマッピングされるリードの割合として定量化されました。各プラスミドに対して、プラスミドリード数、総リード数、染色体リード数、平均染色体カバレッジ、平均プラスミドカバレッジ、P:C比が一覧化されています。pBlood_08_0081_1は、受容者から回収できなかったため含まれず、これらの推定は染色体背景が均一であった受容者に対して行われたことに注意してください。
染色体汚染は、組み立てされたLMB100染色体配列にマッピングされたリードの割合とプラスミドリードの比率として定量化されました。染色体汚染率は72.1%から28.0%の範囲で、平均は46.9%でした(表10)。この方法は、プラスミドと染色体の両方へのマッピングが染色体のみとみなされるため、染色体汚染を過大評価する可能性が高いですが、それでもかなりの染色体残留があることを示しています。この染色体移行にもかかわらず、アセンブリワークフローは完全なプラスミド配列の再構築に成功し、すべてのサンプルにおけるPFGE移動度から予測されるサイズと整合していました(表8、 第3列および第4列)。
結合プラスミドの代表的なドナー-レシピンのペア
株upec271は2011年から2013年にかけて尿サンプルから単離され、系統群B2および配列タイプST131に分類されました。PFGE解析により、約145 kbのプラスミドに対応するバンドの存在が確認されました[図3A、(ドナー)]。ショートリード配列解析によりIncFリプリコンの存在が確認されました。
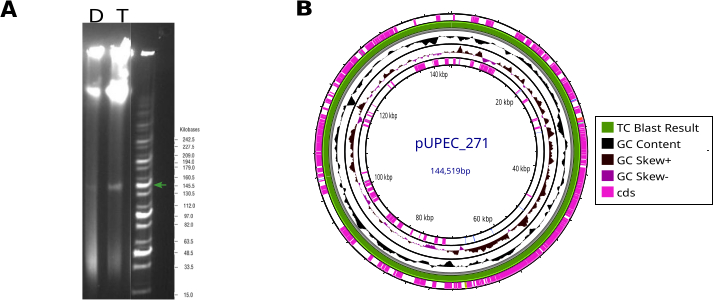
図3:pUPEC271の特性評価。 (A)ドナーとトランスコンジョージェントのPFGE。ドナー(D)とトランスコンジョガント(T)のPFGEバンドが示されています。緑色の矢印はpUPEC271に対応するプラスミドバンドを示しています。PFGEに用いられるプロトコルは研究36で説明されています。(B)pUPEC271の地図。トランスコンジャガントはドナーに強く照射され、コンセンサス(100%同一)は緑のリングとして示されます。この表現はProksee48を用いて生成されました。最も外側のリングはCDSの位置を示し、内側の2つのリングはGC含有量と歪みを示し、最も内側のリングはtRNA遺伝子の位置を示しています。この図の拡大版はこちらをクリックしてご覧ください。
著者らがpUPEC271と呼んだこのプラスミドの移動は、前述のプロトコル36 [図3A、T(トランスコンjugant)]を用いたPFGE解析によってさらに確認されました。ドナーのupec271株(pUPEC271_donor)から精製されたプラスミドDNAはナノ孔でシーケンスされました。PFGEゲル上のバンドの大きさと一致し、pUPEC271_donor配列は144,519 bpのプラスミドを明らかにしました(図3B)。このプラスミドはIncF型レプリコンを持ち、6つの異なる抗生物質クラスに対する耐性遺伝子を保有していました(補 足表1参照)。著者らはまた、トランスコンジョガントの1つ(pUPEC271_TC)からDNAを精製し、ドナーと同一の配列を得ました。最終組立体をpUPEC271_donorと比較した様子は 図3Bに示されています。これにより、ドナーに存在する接合プラスミドがトランスコンジュガント株に移行していることが確認されました。技術データの詳細は 表9に示されています。
ストレインBlood_10_0913は複数のプラスミドを持つ株の例です。このサンプルは2008年から2013年の間に血液から採取され、ショートリードシーケンスによりIncFとIncYの2つのリプリコンが存在することが示されました。この株のPFGE解析により、それぞれ約70kbと110kbの2つのプラスミドが同定されました(図4A)。これはナノポアシーケンスによって確認され、それぞれ71,182 bpと111,226 bpの2つのアセンブリが生成されました。著者らはこれら2つのプラスミドをpBlood_10_0913_1とpBlood_10_0913_2と名付けました(図4B)。しかし、当初、結合機構を持つプラスミドの断面における広範な配列ホモロジー(図 4Bに示されている)により、アセンブリは円形化に失敗しました。Bandage47 を使って作成された失敗した組立図は 図4Cに示されています。2つのプラスミドの完全な組み立ては、より短いリード(<3000 bp)配列の積極的なリードカリングによってのみ可能でした。
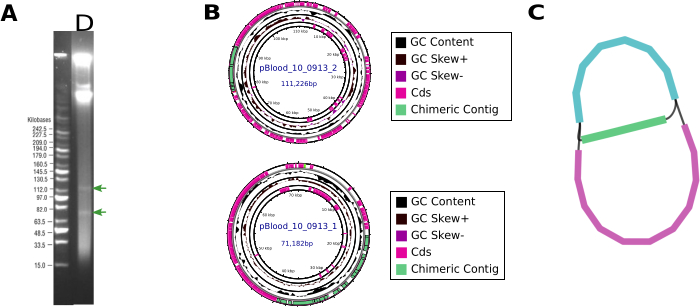
図4:Blood_10_0913株のプラスミドの同定と組み立て。 (A) PFGE。緑色の矢印はプラスミドバンドを示しています。 PFGEで使用されるプロトコルは36(B)シーケンスアセンブリで説明されています。pBlood_10_0913サンプルに含まれる2つの小さなプラスミド、pBlood_10_0913_2とpBlood_10_0913_2の組み立て。(C) 組み立て失敗。異なるアセンブリ間で共有されたシーケンスが存在することによるアセンブリ失敗の表現。この表現はBandage47を用いて生成されました。 この図の拡大版はこちらをクリックしてご覧ください。
補足表1:pUPEC271が運ぶ耐性遺伝子。 pUPEC271に関連するプラスミドサイズ、レプリコン、耐性遺伝子が示されています。このファイルをダウンロードするには、こちらをクリックしてください。
ディスカッション
プラスミドの同定と特徴付けは、公衆衛生、臨床微生物学、微生物生態学において非常に関心が高く、適応遺伝子の維持と生態系での伝達を促進し、進化加速のプラットフォームとなる4。NGS技術の導入により、微生物分離株や集団のゲノムの高スループットシーケンスが可能になりましたが、完全なプラスミドやプラスミド由来コンティグの組み立て後の同定には、ショートリードシーケンスデータではリードサイズを超えるリピート領域を解読できないため、一般的にロングリード配列が必要です。ONTは非常に人気のあるロングリードシーケンシング手法となっており、全ゲノムシーケンシングやメタゲノミクスを超えた応用が行われており、プラスミド配列の検証、エピジェネティック修飾の検出と特性解析、RNAシーケンシング、そしてタンデム遺伝子配列の本質的不安定性の評価(12,49でレビュー)などが含まれます。
ここでは、染色体配列が既に知られているか興味のない状況向けに設計されたプラスミドのONTシーケンスワークフローを紹介します。その理由は、プラスミド抽出は労力集約的でコストが高く時間がかかるため(宿主集団を培養し処理する必要があるため)、ナノポア技術を用いた全ゲノムのシーケンスが、完全なプラスミドアセンブリを得つつゲノム的な文脈を提供するのに十分であることが多いためです。プロトコルが役立つ例としては、プラスミド遺伝子工学の文脈でのプラスミド配列の検証(50,51)、WGS24で既に取得されたプラスミド配列の精度向上、臨床または環境サンプルから結合によって捕獲されたプラスミドの特徴付けなどがあります。
臨床サンプルや環境サンプルからのDNA抽出には、多少のカスタマイズが必要になる場合があります。ここで著者らは、使用した臨床株の中にはバイオフィルムマトリックスが発生し、フィルターを詰まらせる原因が複数回のペレット処理が必要となり、時には2つのフィルターを追加する必要があると報告しています。また、接合プラスミドの配列決定には、多重コピープラスミドのシーケンスに比べてより多くの培養量が必要で、自然に存在する中型および大型プラスミドは2番目のコピー数が少ない傾向があります。
このプロトコルにより、4 kbから173 kbサイズのプラスミドのシーケンスが可能になりました。この範囲はメーカーの仕様(2〜200 kbの範囲)に完全に収まっています。最近、NCBIに堆積した23,000件のプラスミド配列を調査した研究では、供給源によって大きなサイズ差が見られました。ヒト由来のプラスミドは最も小さい中央値サイズ(76 kb)、土壌および植物のプラスミドは最大(それぞれ215 kbと427 kb)でした。他のすべての供給源のプラスミドの中央値サイズは79〜147 kbの間だったため、このプロトコルはほとんどのプラスミドをカバーするはずです。ただしメガプラスミド52 や土壌または植物起源3のプラスミドは例外かもしれません。
著者らはプラスミドDNA濃縮のステップを含め、プラスミドDNAアセンブリの精度向上を図っています。大量の染色体DNAが存在すると、シーケンシングフローセルの細胞孔に非標的リードが大量に流れ込み、プラスミドDNAの深さを大幅に減少させます。すでに、臨床サンプル中のプラスミドDNAを完全に組み立ててARGs24の検出を試みるプラスミドDNA濃縮段階が実施されています。これにより、ナノ孔のみ配列でプラスミド組み立てを完了した際の効果が大幅に向上し(ベンチマークに対して78%の完成度)、他の例は50、53、54の後に続きました。
リード精度を向上させるために、これらの研究のうち2件はナノポアによって開発された「擬似ペアペアリード上のペアベースコールティング」という手法を用いました50,53。この手法は、同じDNA分子のセンス鎖とアンチセンス鎖からの生の電気信号を整列させることを含み、精度が約1桁向上します。擬似ペアリードでのペアドベースコールは、同じ分子の順鎖と逆鎖の識別が可能であれば多重化と両立します。したがって、未知のプラスミド補体サンプルから精製されたものや、プラスミドの混合物を含むプラスミドには使用できません。ゲノム内のプラスミド数は通常0から7個の範囲(特に臨床分離株)であることに注意してください2,55。
研究者たちはサンプル中に高いレベルの染色体汚染を観察しました(表10)。分析した10サンプルの汚染レベルは、リードマッピングに基づく28%から72%の範囲でした。しかし、研究者たちがこの配列を存在するプラスミドまたはプラスミドの染色体に対して染色体のサイズに合わせて正規化したところ、プラスミド配列は染色体配列よりも平均して144倍の存在量であることがわかりました。この数値をプラスミドDNA濃縮レベルに変換するには、各サンプル中のプラスミドのコピー数を知る必要があります。
MinIONフローセルは通常、約30GBのシーケンス出力を生成し、理論的には1回のランで96個以上のプラスミドのシーケンスが可能です。実際には、マルチプレクシングは96バーコードの制限にも制約されており、フローセルあたり96プラスミドが実用的な上限となります。しかし、染色体DNA汚染や自然なバーコードの不均衡により、サンプルごとの有効読み取り深度は減少します。各サンプルに十分なリード深度を確保するために、より保守的なアプローチとしては、1つのフローセルあたり約24個のプラスミドを多重化する方法があります。プラスミド配列の正確な組み立てに推奨される深度は50から70×32.56の範囲です。本記事で示した例では、著者らは1つのフローセルで21個の多重化サンプルを運用し、平均深度(109x)を得ました。これはフローセルごとの推奨サンプル最適値とよく一致します。
読み取り深度が過剰になると、パス/フェイルリードのパーティションは全体の読み取り品質を評価する上であまり情報量が薄れます。代わりに、長さ分布から導き出された指標は、データセットの品質をより明確に表現します。その一例がN50で、N50はその長さ以上のリードが全基数の50%を占めるリード長として定義されます。この値は品質管理の段階に非常に敏感です。例えば、Filtlongのようなツールで低品質または短いリードをフィルタリングすると、分布の短いテールのかなりの部分が除去され、その結果N50が増幅されます。この効果は 表9に明確に示されています。
著者らはONTのRapid Barcode kitを使用し、トランスポソームを使ってプラスミドDNAを断片化するため、プラスミドの制限パターンに関する事前知識を必要としません。以前の研究では、小型プラスミド(<20 kb)では、小型プラスミドがほとんどのDNA抽出で円形のままでいるため、適応ライゲーション54のための自由末端を含まないため、酵素的断片化が必要であることが示されました。その研究ではPCR増幅によって追加の自由末端を生成するバーコードが使われていなかったため、この件に関してはおそらく議論の余地がありません。OnRampは、通常のプラスミド検証のための高度な手順の一つであり、全長プラスミドリードを活用して組み立てを行い、バーコードの使用を回避し、サンプル準備54を簡素化します。この場合、著者たちは3つの理由でバーコードを好んだ。一つ目はプラスミドの長さに関係なくアセンブリを作ることです。第二は染色体DNA汚染に耐えることです。三つ目は、上記のように複数のサンプルを多重化する可能性を開くことです。
以前の研究では、異なるアセンブリーの集約が個々のアセンブリプラットフォームに組み込まれたバイアスを打ち消し、最終的な結果を向上させることが指摘されています。このメタアナリシスは、著者らが使用するアセンブリプログラムであるAutocycler34に組み込まれた機能です。以前のバージョンであるTrycycler57と比べると、Autocyclerはやや自動化されています。リードの複数のサブセットを使用し(前述の通り)複数のアセンブラでアセンブリを実行し、より正確なコンセンサスアセンブリを作成します。しかし、Flye28、Canu29、Raven30のような優れたアセンブラでさえ、広範な配列相同性を持つプラスミドの存在に苦労し、誤って合成される、あるいは単一のプラスミドの複数のコピーを生成すること、さらに小さなプラスミドが欠落しやすい(図4C参照)。この場合、低品質のリードをカットし、短いリードを除去することでキメラ的連合を解くことができます。
シーケンスプロトコルの全体的な精度を確立するために、著者らはONTのみアセンブリと、長リードと短リードを組み合わせて磨き上げたアセンブリを比較しました。これは(PacBioデータを除く)現在のゴールドスタンダードです。著者らはまた、存在するプラスミドの数とその推定サイズを示すゲルデータも持っていました(表8, 第3列)。研究者たちは10サンプルで見つかった13個すべてのプラスミドを組み立て、組み立てた配列と一致するサイズを得ました。これは非常に成功したもので、LR配列アセンブラは構造的に複雑な配列を持つプラスミドの組み立てに失敗することが多いためです。より細かいレベルでは、2つの配列セット間のペアワイズ比較で精度の変動が示されました(表8)。5つのプラスミドアセンブリはONTアセンブリにカバーされていない領域があり、これはONTのみのシーケンスアセンブリでシーケンスアーティファクトが追加された結果と考えられます。残りの7件のうち3件は単一塩基多型を示し、ペア間の差は0.0023%から0.05%の範囲で、4件は完全な一致を示しました。精度のレベルはプラスミドDNAの濃縮レベルやシーケンスの深さとは相関しないようですが、サンプル内に複数のプラスミドが存在することは相関しています。これは複数のプラスミドが存在することで配列の複雑さが増幅される傾向があるためと考えられます(表8)。まとめると、このワークフローはプラスミド配列の収量と精度を最適化するよう設計されています。プラスミド配列の組み立ては可能ですが、ヌクレオチドレベルでの精度は変動します。このプロトコルは幅広いサイズのプラスミドの配列決定に用いられ、染色体DNA汚染の少なくとも72%に耐えられ、プラズミドサイズやフローセルの状態に応じて1つのフローセル内に少なくとも24個のプラスミドを収容可能です。
開示事項
著者たちは何も明かすことはありません。
謝辞
私たちは、1945年に発表された臨床大腸菌株のセットを寛大に共有してくださったワシントン大学のスティーブ・サリパンテ氏に大変感謝しています。この研究は、UCSCからMCへのイノベーション・起業家開発ディレクター職の研究支援資金と、カリフォルニア大学アリアンサMXの助成金「メキシコの高負荷・脆弱集団における結核分離株のゲノムプロファイリング:伝播と薬剤耐性に関する洞察」によって部分的に支援されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | シグマ・アルドリッヒ | EP022431081 | 別のブランドに交換可能 |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | 別のブランドに交換可能 |
| 15 mL conical tubes | FALCON | 352096 | 別のブランドに交換可能 |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | 別のブランドに交換可能 |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | 別のブランドに交換可能 |
| 250 mL sterile flasks | PYREX | 5320 | 別のブランドに交換可能 |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | 別のブランドに交換可能 |
| Centrifuge | Eppendorf | 5424R-PR-R | 別のブランドに交換可能 |
| Centrifuge | Eppendorf | 5810R-P-R | 別のブランドに交換可能 |
| Centrifuge bottles | シグマ・アルドリッヒ | B1283-4EA | 別のブランドに交換可能 |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | 別のブランドに交換可能 |
| Electronic Digital Scale | Denver Instrument | APX-2001 | 別のブランドに交換可能 |
| Ethanol | Fisher Scientific | 04-355-720 | 別のブランドに交換可能 |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | 別のブランドに交換可能 |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | 任意のニトリル手袋ブランドが機能する |
| Ice bucket | Thermo Fisher Scientific | 432128 | 別のブランドに交換可能 |
| Isopropanol | Fisher Scientific | BP26184 | 別のブランドに交換可能 |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | 別のブランドに交換可能 |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | 別のブランドに交換可能 |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | マイクロピペットは校正する必要があります |
| Spectrophotometer | Thermo Scientific | 335905P | 別のブランドに交換可能 |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | 別のブランドに交換可能 |
| Water bath | Thermo Scientific | 51221052 | 別のブランドに交換可能 |
参考文献
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
再版と許可
