実験的脳マラリア(ECM)は神経炎症と血脳関門機能障害を引き起こします。GSE162535を用いて、この再現可能なRベースのRNA-seqワークフローは、対照(CB)、ECM(MB)、アルテスン酸処理(AB)脳を比較し、QC、PCA、DESeq2解析を行います。ECM駆動の転写変化を特定し、アルテスン酸媒介による炎症および神経血管経路の調節を評価する。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
方法論記事
DESeq2を用いて実験的な脳マラリア脳組織におけるアルテスン酸関連トランスクリプトミクスシフトを定量化する計算プロトコル
* These authors contributed equally
この記事について
サマリー
要約
RNAシーケンシング(RNA-seq)は疾患に関連する転写プログラムの定義に広く用いられていますが、実験群間の再現性を保証し、生物学的に解釈可能な結果を容易にするためには、一貫したエンドツーエンドのワークフローが必要です。ここでは、実験的脳マラリア(ECM)における脳トランスクリプトム変化およびアルテスネート治療後の評価のための完全なRNA-seq解析プロトコルを公開データセットGSE162535提示します。このワークフローは、HTSeqカウントマトリックスから始まる3つのグループ、すなわちコントロール脳(CB)、ECM脳(MB)、アルテサン酸処理ECM脳(AB)を分析します。生カウントをインポート・フォーマットした後、プロトコルはCBを基準レベルとするDESeq2データセットを構築し、低カウント遺伝子をフィルタリングし、ライブラリサイズの可視化、主成分解析、サンプル距離クラスタリングを用いて品質管理を行います。次に、3つの主要対比(MB対CB、AB対MB、AB対CB)で差異発現を計算し、log2フォールド変化縮縮を適用して安定した効果サイズ推定を行います。プロトコルは完全および有意な差分発現表をエクスポートし、火山プロットおよびMAプロットを生成し、最も変動性の高い遺伝子および対照的に上位にランクされた差異発現遺伝子のヒートマップを作成します。機構的解釈を支援するために、ワークフローにはサイトカイン、ケモカイン、ミクログリア活性化マーカー、BBB/内皮遺伝子などの標的免疫マーカー抽出が含まれ、有意にアップレギュレーションおよびダウンレギュレーションされた遺伝子セットに対して遺伝子オントロジーおよびKEGG濃縮解析を実施しています。このプロトコルは、ECMに関連する神経炎症転写プログラムの特性評価と、これらの署名のアルテサン酸関連調節の定量化のための再現可能なテンプレートを提供します。
概要
脳マラリア(CM)は、Plasmodium falciparum感染症による生命を脅かす神経学的合併症であり、症例管理の進歩にもかかわらずマラリア死亡率の主要な要因となっています。CMは急性脳症、微小血管機能障害、内皮活性化、血液脳関門(BBB)障害を特徴とし、昏睡を引き起こす神経炎症や生存者には持続的な神経認知後遺症1が伴います。CMの病因は多因子的であり、宿主の炎症反応が神経血管界面で寄生虫および宿主由来因子と相互作用するため、臨床的評価項目だけで因果機序を推測することは困難です。
特にC57BL/6マウスにおける脳マラリア(ECM)実験モデルは、脳特異的免疫病理、BBB損傷、神経炎症シグナル伝達を制御された環境で検証するための扱いやすいプラットフォームを提供します2,3。これらのモデルは、疾患の段階を超えた細胞および分子反応のマッピングや、in vivoでの補助的介入の検証に用いられています。しかし、ECMの病態生物学は複雑かつ非常に動的であり、標的アッセイでは複数の免疫および神経血管プログラムで起こる協調した経路レベルのシフトを見逃す可能性があります。
アルテスネートは重度マラリアに対する推奨される第一選択の静脈注射療法であり、主要なエビデンスベースにおいてキニーネと比較して生存率に大きな利益があることを示しています。迅速な寄生虫除去はアルテスン酸の有効性の中心ですが、神経学的転帰は寄生虫減少と炎症および神経血管経路の二次的調節の両方を反映している可能性が高い1,4。したがって、ECM中にアルテミシニン治療が脳の転写プログラムをどのように再形成するかを理解することは、臨床的有効性データを補完するメカニズム的知見を提供し、補助的な神経保護戦略の候補経路を特定する可能性があります。
RNAシーケンシング(RNA-seq)は、疾患および治療状態における転写応答の偏りのないゲノム全体プロファイリングを可能にし、差別的発現解析と下流の機能解釈を支援します。NCBI遺伝子発現オムニバス(GEO)などの公開リポジトリは、再現可能な再解析に適した厳選されたデータセットを提供しており、GSE162535には対照脳(CB)、ECM脳(MB)、アルテスネート処理されたECM脳(AB)からの脳RNAシーケンスが含まれています5。このようなデータセットからの再現性発見を支援するためには、数に基づく差異発現のための堅牢な統計的枠組みが必要であり、遺伝子レベルの変化を生物学的経路やプロセスの観点から解釈するための濃縮ツールも必要です。
本研究は、脳組織を横断してコントロール群(CB)、実験的脳マラリア(MB)、アルテスネート処理群(AB)群に対して、再現性のあるエンドツーエンドRNA-seq解析ワークフローを提供します。本論文の新規性は、標準化されたDESeq2ベースのパイプラインにあり、事前に定義された生物学的関連コントラスト(MB対CB、AB対MB、AB対CB)、厳格な品質管理出力(ライブラリサイズ評価、主成分解析、サンプル距離ヒートマップ)、そしてclusterProfiler 6,7を用いたGene Ontology(GO)およびKEGG経路濃縮による統合的な下流解釈にあります.さらに、このワークフローは構造化された免疫パネルベースの解釈を実装し、神経炎症性、免疫性および神経血管の転写応答を体系的に特徴付けることを可能にします。統計的厳密さ、透明性、論文発表に適した成果を組み合わせることで、本プロトコルはECM関連トランスクリプトム異常の解析および前臨床マラリア研究における治療駆動調節の評価に向けた堅牢かつ再利用可能な枠組みを提供します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究は公開されているRNA-seqデータを用い、新たな人間や動物実験は含まれていませんでした。したがって、倫理的承認やインフォームドコンセントは必要ありませんでした(資料表参照)。
1. コンピューティング環境とフォルダ構造の準備
- ハードウェアとオペレーティングシステムのセットアップ
- ダウンロードや出力には最低でも8GBのRAM(推奨16GB)と≥10GBの空きディスク容量があるワークステーションやノートパソコンを使いましょう。
- Windows、macOS、またはLinuxを使ってRパッケージをインストールし、作業ディレクトリにファイルを書き込む権限を持っています。
- 必要なソフトウェアをインストールする
- R(バージョン4.2以降)をインストールしてください。ワークフローをインタラクティブに実行し、プロジェクトディレクトリを管理するためにRStudio Desktop(推奨)をインストールしてください。
- プロジェクトディレクトリと出力フォルダを作成します
- 分析用の新しいフォルダを作成します(例:GSE162535_RNAseq_DESeq2)。このフォルダをRワーキングディレクトリとして設定してください。
- 出力フォルダは正確に以下のように作成します:
- 結果を出す。結果を作り出す/図など。結果や表などを作成します。
- 必要なRパッケージをインストールする
- CRANパッケージをインストールしましょう:tidyverse、pheatmap、rcolorBrewer。Bioconductorパッケージをインストールしてください:DESeq2、apeglm(オプション)、clusterProfiler、org。Mm.eg.db。
- スクリプトの開始時に必要なパッケージを読み込みます:DESeq2、tidyverse、pheatmap、RColorBrewer、clusterProfiler、org。Mm.eg.db、そしてggplot2。set.seed(123)を実行して再現性を高めるシードを設定します。
- データの整合性とプライバシー保護を適用しましょう
- ダウンロードしたファイルはプロジェクトディレクトリにのみ保存してください。環境に機密データやエンバーゴされたデータが含まれている場合は、プロジェクトディレクトリへのアクセスを制限してください。ワークフローの最後にsessionInfo()をエクスポートして結果やsessionInfo.txtに変換してソフトウェアのバージョンを記録します。
注: このプロトコルは公開されたRNAセクシーカウントデータのインサイコ解析を行い、生物学的標本の取り扱いは伴いません。
- ダウンロードしたファイルはプロジェクトディレクトリにのみ保存してください。環境に機密データやエンバーゴされたデータが含まれている場合は、プロジェクトディレクトリへのアクセスを制限してください。ワークフローの最後にsessionInfo()をエクスポートして結果やsessionInfo.txtに変換してソフトウェアのバージョンを記録します。
2. RNA-seqカウント行列を取得し、実験群を定義する
- GEOデータセットのファイルをダウンロードしてGSE162535
- GEOからGSE162535用のHTSeqカウントファイルをダウンロードし、プロジェクトディレクトリにGSE162535_All.HTSeq.counts.txt.gzとして保存してください。gzfile()とread.delim()を使ってエラーなく開くことを確認することでファイルの整合性を検証します。
- HTSeqをRにカウントします
- read.delim(gzfile(...)、ヘッダー = TRUE、check.names = FALSE、quote = ""、comment.char = """"を使って圧縮カウントテーブルをインポートします。str()、head()、colnames() を使ってインポートされたオブジェクトを確認し、以下のことを確認してください:
- 最初の列には遺伝子識別子(例:AccID)が含まれます。残りの列にはサンプルレベルのカウントが含まれています。
- read.delim(gzfile(...)、ヘッダー = TRUE、check.names = FALSE、quote = ""、comment.char = """"を使って圧縮カウントテーブルをインポートします。str()、head()、colnames() を使ってインポートされたオブジェクトを確認し、以下のことを確認してください:
- データ型の標準化と重複した遺伝子識別子の解消
- サンプル列を遺伝子識別子列(AccID)を除くすべての列と定義します。すべてのサンプルカラムを整数数に強制的に設定します。同じAccIDを共有する行間のカウントを合計することで、重複した遺伝子識別子をコラプスします。
- 折りたたんだテーブルを標準のデータフレームに変換します。行名を遺伝子識別子に設定し、カウントマトリックスから識別子列を削除します。
- カウント行列構造の検証
- カウント行列に12列のサンプルがあることを確認してください。サンプルカラム名がAB_1..AB_4、CB_1..CB_4、MB_1.MB_4の形式に従っているか確認してください。
- カウント行列が12列でない場合は実行を停止します。
- サンプルメタデータの作成と検証
- 以下の列を含むサンプルメタデータテーブル(colData)を作成します:
- サンプル:カウント行列の列名に対応する一意のサンプル識別子。グループ:各サンプルに割り当てられた生物学的状態。
- Gene Expression Omnibus(GEO)からデータセットGSE162535対応するサンプル注釈を取得してください。
- GEOの取得情報と実験状態を示すサンプル注釈フィールドを用いて各サンプルの同一性を検証します。カウント行列内の各サンプル識別子を検証済みのGEO注釈にマッピングします。
- 検証済みの各サンプルは、対照脳(CB)、実験的脳マラリア脳(MB)、またはアルテスネート処理実験性脳マラリア脳(AB)のいずれかのグループに割り当てられます。
- メタデータテーブルをサンプルの順序がカウント行列の列順序と一致するように配置します。
- メタデータ表のサンプル識別子をカウントマトリックスと比較し、1対1の対応を確認します。グループ変数を係数として符号化し、レベルはCB、MB、ABの順に並べます。
- CBを基準レベルとして設定し、下流の差異発現解析の基準としてコントロール脳群を定義します。
- メタデータテーブルの行名をサンプル識別子と同じ値に設定します。
注:グループラベルはカウントマトリックス内のサンプルの順序だけから割り当てられました。サンプルの同一性は、表現行列と整合させる前にGEOメタデータとアクセッション情報を用いて独立して検証され、再現性を高めサンプル誤分類のリスクを低減しました。
- 以下の列を含むサンプルメタデータテーブル(colData)を作成します:
3. DESeq2データセットを構築し、基本的な品質管理を行う
- カウントマトリックスをサニタイズする
- カウント行列の欠落値をゼロに置き換えます。列ごとの is.na()サマリーを使って欠損値の欠如を確認しましょう。
- DESeq2データセットを作成する
- DESeqDataSetFromMatrix()を使ってDESeqDataSetを作成します。以下はcountData = countsです。colData = sample_info;デザイン = ~ グループ。
- フィルターの低カウント遺伝子
- 全サンプルで総数<10の遺伝子をdds <- dds[rowSums(counts(dds)) >= 10, ]で除去します。オブジェクト概要を印刷して保持遺伝子の数を記録します。
- ライブラリサイズの評価
- ライブラリサイズをフィルタリングされたカウント行列の列和として計算します。ライブラリサイズのバープロットを作成し、結果/図/library_sizes.pdfとして保存します。
- ライブラリサイズプロットを確認し、研究デザインと矛盾する極端なシーケンス深度を持つサンプルがないか確認してください。
4. DESeq2を実行し、可視化用の変換オブジェクトを生成する
- DESeq2モデルに適合
- dds <- DESeq(dds)を使って微分式モデリングを実行します。すべての下流結果抽出のために、Fitted DDSオブジェクトを保持します。
- 変換された式行列を作成する
- rld <- rlog(dds, blind = FALSE)を用いて正則化対数変換を計算します。分散安定化変換を vsd <- vst(dds, blind = FALSE)を用いて計算します。PCA、クラスタリング、ヒートマップにはrldとvsdを使ってください。
注: グループ依存の分散構造を保つために、ブラインド = FALSE を用います。
- rld <- rlog(dds, blind = FALSE)を用いて正則化対数変換を計算します。分散安定化変換を vsd <- vst(dds, blind = FALSE)を用いて計算します。PCA、クラスタリング、ヒートマップにはrldとvsdを使ってください。
5. PCAおよびサンプル間距離クラスタリングを用いたグローバルQCの実施
- 主成分解析(PCA)を生成する
- plotPCA(rld, intgroup = "group", returnData = TRUE)を用いてPCAを計算します。PC1とPC2の説明したパーセント分散を抽出します。ggplot2を使ってPC1とPC2をプロットし、サンプル名でポイントをラベル付けし、グループごとに色分けします。
- PCAプロットは結果/図/PCA_samples.pdfとして保存してください。生物学的にはグループごとにクラスタリングが重複し、どのサンプルも例外として分離しないことを確認してください。
- サンプル距離のヒートマップを生成する
- dist(t(assay(vsd)))を用いてペアワイズサンプル距離を計算します。距離オブジェクトを行列に変換して可視化します。各サンプルのグループファクターを含む列注釈表を作成します。
- 距離マトリックスをpheatmap()でプロットし、結果/図/sample_distance_heatmap.pdfとして保存します。サンプルが主にグループごとにクラスタリングされていることを確認します。
6. 3つの主要対比の微分式を計算する
- コントラストを定義する
- 疾患効果をECMと対照、すなわちMB対CBと定義します。ECM内の治療効果をアルテスン酸処理型とECM、すなわちAB型とMB型で定義します。治療とベースラインをアルテスン酸治療型と対照群(AB vs CB)で定義します。
- log2フォールド変化収縮を伴うDESeq2結果を抽出
- 各造影剤の生結果を結果(dds, contrast = c("group", groupA, groupB))を用いて抽出します。lfcShrink(dds, contrast = c("group", groupA, groupB), res = res, type = "normal"を用いて log2 フォールドの縮小を行います。
- 結果をデータフレームに変換し、遺伝子識別子を「gene_id」という列として保存します。安定した報告のために、結果を名目p値で順番に配置します。
- 各完全な結果表をresults/table/に以下のように保存してください:
- DESeq2_MB_vs_CB_all_genes.csv、DESeq2_AB_vs_MB_all_genes.csv、DESeq2_AB_vs_CB_all_genes.csv
注: パッケージ設定でシュリンクが失敗した場合は、ローカルインストールでサポートされている別のシュリンクタイプで再実行してください。
- DESeq2_MB_vs_CB_all_genes.csv、DESeq2_AB_vs_MB_all_genes.csv、DESeq2_AB_vs_CB_all_genes.csv
- 有意性閾値を定義し、有意遺伝子セットをエクスポートする
- 調整p値(FDR)<0.05および絶対log2フォールド変化≥1を用いて差分発現遺伝子(DEGs)を定義します。各造影剤をフィルターして、修正済みp値が欠けている遺伝子を除外します。
- 重要なDEGテーブルをエクスポートして、results/tables/DESeq2_MB_vs_CB_sig.csv、results/tables/DESeq2_AB_vs_MB_sig.csv、results/tables/DESeq2_AB_vs_CB_sig.csv
- 対照的にDEGカウントをまとめる
- 造影剤あたりの有意遺伝子の数を計算します。サマリーテーブルは結果/表/DE_summary_counts.csvとして保存してください。
7. 各コントラストごとに火山プロットを生成する。
- 火山プロット関数を作成します。
- 各遺伝子ごとに-log10(調整p値)を計算します。各遺伝子を「Up」「Down'「Not Presigne(有意でない)」の閾値を用いて分類します:FDR(FDR < 0.05)および|log2FC|≥ 1.
- ggplot2を使ってlog2FC(x軸)と-log10(FDR)(y軸)をプロットします。log2FC = ±1 と -log10(0.05)に破線しきい値線を追加します。
- 輸出火山区画
- 各プロットをresults/fig/: volcano_MB_vs_CB.pdf, volcano_AB_vs_MB.pdf, volcano_AB_vs_CB.pdfにPDFとして保存してください。
注: コントラストごとに一貫した軸制限を用いて、図形間の視覚的比較を支援しましょう。
- 各プロットをresults/fig/: volcano_MB_vs_CB.pdf, volcano_AB_vs_MB.pdf, volcano_AB_vs_CB.pdfにPDFとして保存してください。
8. 各コントラストごとにMAプロットを生成する
- MAプロットを単一のPDFにエクスポートしてください。
- results/fig/MA_plots.pdfというPDFデバイスを開きます。plot MAは、plotMA()を用いて各生のDESeq2結果オブジェクトに対してプロットを行います。各プロットにコントラスト名をラベル付けしてください。PDFデバイスを閉じてください。
9. グローバルバリアリティおよびコントラスト特異的DE遺伝子の発現ヒートマップを生成する。
- すべてのサンプルで上位の変異遺伝子をプロットします。
- vsdアッセイ行列からサンプル間の行ごとの分散を計算します。最も変異性の高い遺伝子トップ100を選びます。各遺伝子をサンプル間で平均中心に配置します。
- サンプル群の注釈付きでpheatmap()を用いてヒートマップを生成します。図は結果/図/heatmap_top100_variable_genes.pdfとして保存してください。
- 各対照株の上部の差異発現遺伝子をプロットします。
- 各コントラストに対して調整されたp値で上位50遺伝子を選択します。VSD発現マトリックスと平均中心を遺伝子で抽出します。各コントラストごとにヒートマップを作成し、以下のように保存します:
- 結果/図/heatmap_top50_MB_vs_CB.pdf、結果/図/heatmap_top50_AB_vs_MB.pdf、結果図/heatmap_top50_AB_vs_CB.pdf
注: 行ラベルが有効なら、PDFの幅と高さを拡大できます。
10. ターゲット型免疫マーカー解析を行う。
- 対照的に選ばれた免疫遺伝子を要約します。
- 免疫マーカーセットを定義します:Il6、Il1b、Il10、Tnf、Ifng、Il21、Icam1。各造影結果表からこれらの遺伝子のlog2FC、p値、調整済みp値を抽出します。
- 遺伝子識別子ごとに3つの対照的な要約を統合します。統合したテーブルを結果/テーブル/immune_genes_summary.csvとして保存してください。
- 免疫マーカーのヒートマップ(rlog)を生成する。
- 形換えたアッセイマトリックス中に存在する免疫遺伝子を特定します。現在の免疫遺伝子のrlog発現マトリックスを抽出します。
- 遺伝子による平均中心発現。ヒートマップを作成して結果/図/heatmap_immune_genes.pdfに保存してください。
11. 機能カテゴリ別に拡張免疫パネル解析を行う
- 免疫パネルを定義しましょう。
- 免疫マーカーパネルをカテゴリー別に定義します。これには、炎症促進サイトカインおよびインターフェロン応答遺伝子、抗炎症および調節遺伝子、ケモカイン、微膠細胞活性化マーカー、アストロサイトマーカー、BBBおよび内皮活性化マーカー、T細胞マーカーおよび疲労マーカー、単球/マクロファージマーカー、補体経路遺伝子、酸化ストレスおよび細胞死遺伝子が含まれます。
- 各造影剤の免疫パネルDE結果を抽出します。
- 遺伝子記号から免疫カテゴリーへのマッピング表を作成します。各造影結果表を免疫パネル遺伝子でフィルタリングしてください。カテゴリマッピングを各フィルタリング済みの結果テーブルに結合します。
- 造影剤特異的免疫テーブルを3つにまとめて1つのテーブルにまとめます。統合されたテーブルを結果/テーブル/immune_panels_DE_all_contrasts.csvとして保存してください。機密免疫パネル発現ヒートマップを作成してください。
- rldアッセイマトリックスに存在する免疫パネル遺伝子を特定します。図内のパネル分類を保持するために、行名にカテゴリラベルを付け加えてください。rlogヒートマップをサンプルグループの注釈付きでプロットします。
- 出力を保存しましょう。
- 名前を付けて保存:results/fig/heatmap_immune_panels_all.pdf、results/figure/heatmap_immune_panels_all.png
12. 免疫重ね火山プロットの作成
- 免疫オーバーレイ火山プロットを作成しましょう。
- 免疫パネルに結合して各造影結果表にマッピングし、遺伝子を免疫または非免疫にマークします。すべての非免疫遺伝子をグレーの背景点としてプロットします。免疫遺伝子を免疫カテゴリーごとに色分けしたものを前景にプロットします。log2FC = ±1 と -log10(0.05)にしきい値線を追加します。
- 免疫オーバーレイ火山区画をエクスポートする。
- MBとCBの免疫オーバーレイ火山プロットを保存してください:
- 結果/図/volcano_MB_vs_CB_immune_overlay.pdf
- 結果/図/volcano_MB_vs_CB_immune_overlay.png
- ABとMBの免疫オーバーレイ火山プロットを以下のように保存してください:
- 結果/図/volcano_AB_vs_MB_immune_overlay.pdf
- 結果/図/volcano_AB_vs_MB_immune_overlay.png
注: 選別された免疫遺伝子パネルはあらかじめ定義され、機能カテゴリに分類されました。注釈付きの遺伝子記号の完全なリストは補足表S1に掲載されています。この表は透明性と再現性を確保し、パネルベースの分析を研究間で直接再利用・検証できるようにします。
- MBとCBの免疫オーバーレイ火山プロットを保存してください:
13. 機能的濃縮解析(GOおよびKEGG)の実施
- 濃縮のための遺伝子セットを定義する
- 各造影(MB対CB、AB対MB)ごとに、調整されたp値閾値<0.05と絶対log₂フォールド変化閾値≥1を用いて有意に差を引く遺伝子(DEG)を抽出します。
- DEGをアップレギュレーション遺伝子(log₂FC > 0)とダウンレギュレーション遺伝子(log₂FC < 0)に分割します。
- 背景(宇宙)遺伝子セットを定義する
- DESeq2データセットでカウントフィルタリング後に保持されたすべての遺伝子を背景宇宙として使用します。フィルタリング済みDESeq2オブジェクトから遺伝子シンボルを抽出します。orgのbitr()関数を使って背景遺伝子記号をEntrez識別子に変換します。Mm.eg.db。
注: 一貫した背景遺伝子セットを使用することで、偏りのない濃縮結果が保証されます。
- DESeq2データセットでカウントフィルタリング後に保持されたすべての遺伝子を背景宇宙として使用します。フィルタリング済みDESeq2オブジェクトから遺伝子シンボルを抽出します。orgのbitr()関数を使って背景遺伝子記号をEntrez識別子に変換します。Mm.eg.db。
- 濃縮のための遺伝子識別子マップ
- 各DEGセットの遺伝子シンボルをbitr()を使ってEntrez識別子に変換します。KEGG濃縮のために成功裏にマッピングされた遺伝子のみを保持します。遺伝子セットのエンリッチ解析を、どの遺伝子も成功裏にマッピングできていない場合は省略してください。
注: 遺伝子オントロジー(GO)の濃縮は遺伝子シンボルを使用しますが、KEGGの濃縮はEntrez識別子を必要とします。
- 各DEGセットの遺伝子シンボルをbitr()を使ってEntrez識別子に変換します。KEGG濃縮のために成功裏にマッピングされた遺伝子のみを保持します。遺伝子セットのエンリッチ解析を、どの遺伝子も成功裏にマッピングできていない場合は省略してください。
- 遺伝子オントロジー(GO)の濃縮(生物学的プロセス)を行う
- enrichGO()を使ってGOエンリッチメントを実行し、OrgDb = orgで実行します。Mm.eg.db. KeyType = "SYMBOL" および ontology (ont) = "BP" を設定します。宇宙はDESeq2データセットからフィルタリングされたすべての遺伝子シンボルとして指定します。
- 複数テスト補正にはpAdjustMethod = "BH"を用いてください。pvalueCutoff = 0.05、qvalueCutoff = 0.05の有意性閾値を適用します。遺伝子セットのサイズはminGSSize = 10、maxGSSize = 500で制限します。
- GOのエンリッチメント結果をresults/tables/ディレクトリにエクスポートしてください。上位の強化されたGO項のバープロットを作成し、結果や図に保存します。
- KEGG経路濃縮を行う
- enrichKEGG()を用いて、生物 = "mmu" でKEGG濃縮を実行します。入力遺伝子としてDEGセットのエントレズ識別子を提供します。マッピングされたEntrezの背景を宇宙として使うのが良いでしょう。
- pAdjustMethod = "BH"を適用します。pvalueCutoff = 0.05 および qvalueCutoff = 0.05 の有意性閾値を用います。遺伝子セットのサイズはminGSSize = 10、maxGSSize = 500で制限します。
- KEGGのエンリッチメントテーブルをresults/tables/にエクスポートします。強化されたKEGG経路のバープロットを作成し、結果や図に保存します。
注: 遺伝子マッピングが不十分な場合、KEGG濃縮は結果を返さないこともあります。このようなケースはワークフローを中断することなく処理されます。
14. 免疫のみ濃縮解析の実施(オプションモジュール)
- 免疫特異的遺伝子セットの構築
- 厳選された機能カテゴリに基づいて免疫パネル遺伝子を定義します。DEGリストと免疫パネル遺伝子を交差させます。各造影剤に対して免疫特異的DEGをアップレギュレートセットとダウンレギュレートセットに分けます。
- 免疫特異的遺伝子セットに濃縮を行います。
- 第13節で説明されているGOおよびKEGG濃縮手順を適用してください。背景ユニバースとパラメータ設定は同じものにしてください。「immune」というラベルを含むファイル名を使って、グローバルな濃縮結果と区別するために保存出力を保存してください。
15. エンリッチメントドットプロットの生成(オプションモジュール)
- リッチの結果をロードします。
- results/tables/ディレクトリからGOまたはKEGGのエンリッチメントテーブルをインポートします。
- 濃縮指標を変換する。
- GeneRatioの値を分数形式(x/y)から数値比率に変換します。可視化のために−log₁₀(調整済みp値)を計算します。
- ドットプロットを生成します。
- 遺伝子比をx軸にプロットし、y軸に充実した用語記述を配置します。遺伝子数によるドットサイズのスケールと、調整されたp値による−log₁₀による色。
- 調整済みp値ランキングに基づいて、上位の豊かな用語を選択します。dotプロットはresults/fig/ディレクトリにPDFやPNGファイルとして保存してください。
16. セッション情報の保存とランの最終決定
- セッション情報をエクスポートしてください。
- sessionInfo()の出力を結果に保存し、sessionInfo.txtをドキュメントに保存します。Rのバージョンとパッケージのバージョンです。
- 完了確認
- ワークフローが生成されたことを確認してください:結果/図/に図、結果/表/に表が。
- 3つの主要なコントラスト出力が存在し、空でないことを確認しましょう:DESeq2_MB_vs_CB_all_genes.csv、DESeq2_AB_vs_MB_all_genes.csv、DESeq2_AB_vs_CB_all_genes.csv
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
データ品質評価とグローバルトランスクリプトム構造
12の脳サンプル(CB、MB、AB、n=各グループ4)からのRNAシークエンザデータは、標準化されたワークフローで処理されました。低カウント遺伝子(合計≥10個)をフィルタリングした後、データセットは後続解析のために保持されました。rlog変換されたカウントの主成分解析(PCA)では、サンプルが実験群ごとに分離され、複製がグループ内で一貫してクラスタリングされることが示されました(図1A–B)。
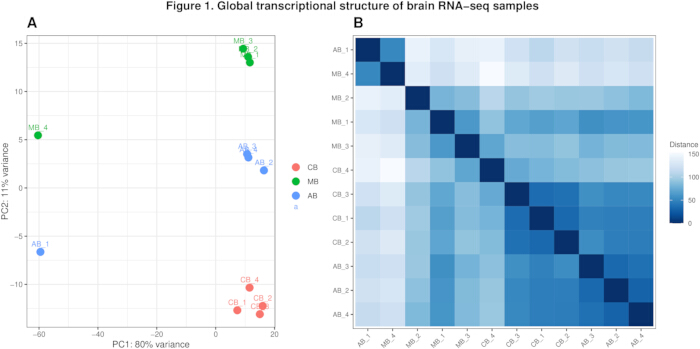
図1...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究は、あらかじめ定義された生物学的コントラストを横断した大量RNA-seqデータ解析のための再現性のあるDESeq2ベースのワークフローを提示します。このプロトコルは、標準化された前処理、検証済みのメタデータ割り当て、正規化、差別発現検査、構造化された下流出力を統合し、一貫性のある透明なトランスクリプトミック結果の生成を可能にします。分析ステップとパラメータを明示的に定義することで、ワークフローは研究6、7、11間での再現性と比較可能性を向上させるよう設計されています。
ワークフローの堅牢なパフォーマンスを確保するためには、いくつかのステップが重要です。まず、サンプルメタデータを遺伝子発現オムニバス(GEO)注釈と照合することで、グループ割り当てがカウントマトリックスの順序だけから推測されることを防ぎ、サンプル誤分類のリスクを...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者同士には競合する利害関係はありません。
謝辞
著者には謝辞はありません。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
```html
```
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| clusterProfiler (R パッケージ) | Bioconductor | RRID:SCR_016884 | 機能エンリッチメント分析 (GO と KEGG 経路) |
| DESeq2 (R パッケージ) | Bioconductor | RRID:SCR_015687 | カウントベースの RNA-seq データの差異発現解析 |
| ggplot2 (R パッケージ) | CRAN | RRID:SCR_014601 | PCA プロット、火山図、サマリー図の可視化 |
| GitHub (オプション) | GitHub Inc. | RRID:SCR_002630 | 再現可能なスクリプトのバージョン管理と共有 |
| HTSeq-count RNA-seq データセット (GSE162535) | NCBI Gene Expression Omnibus (GEO) | RRID:SCR_005012 | 解析入力用のバルク RNA-seq カウントマトリックス |
| matrixStats (R パッケージ) | CRAN | RRID:SCR_016361 | 行/列統計 (例:分散) の効率的な計算 |
| openxlsx (R パッケージ) | CRAN | RRID:SCR_019215 | 結果テーブルのエクセル形式エクスポート |
| オペレーティングシステム | Microsoft / Apple / Linux | N/A | Windows 10+、macOS、または Linux がサポートされています |
| org.Mm.eg.db (R パッケージ) | Bioconductor | RRID:SCR_002815 | 遺伝子 ID マッピングのためのマウス遺伝子アノテーションデータベース |
| PDF ビューア | 任意 | N/A | 出力図形の閲覧 (PCA、ヒートマップ、火山図) |
| パーソナルコンピュータまたはワークステーション | 任意 | N/A | RNA-seq 解析には最低 16 GB RAM 推奨 |
| pheatmap (R パッケージ) | CRAN | RRID:SCR_016418 | 遺伝子発現とクラスタリングのヒートマップ可視化 |
| R 統計ソフトウェア (バージョン ≥ 4.2) | R Foundation for Statistical Computing | RRID:SCR_001905 | すべての RNA-seq 解析のためのコア計算環境 |
| RColorBrewer (R パッケージ) | CRAN | RRID:SCR_015742 | ヒートマップとプロット用のカラーパレット |
| RStudio Desktop | Posit Software | RRID:SCR_000432 | スクリプティングと再現性のための統合開発環境 (IDE) |
| サンプルメタデータファイル (CSV 形式) | 生成 / GEO アノテーション | N/A | サンプルを CB、MB、AB グループにリンクするキュレーションされたサンプルアノテーション |
| stringr (R パッケージ) | CRAN | RRID:SCR_019195 | エンリッチメント可視化とフォーマットのための文字列処理 |
| tibble (R パッケージ) | CRAN | RRID:SCR_019186 | データフレームの扱いと整頓されたデータ構造 |
| tidyverse (R パッケージスイート) | CRAN | RRID:SCR_019186 | データ操作、変換、可視化 |
参考文献
- Storm J, Craig AG. Pathogenesis of cerebral malaria—inflammation and cytoadherence. Front Cell Infect Microbiol. 2014;4:100.
- Hinduja S, Kunieda M. Modelling of ECM and EDM processes. CIRP Annals. 2013 Jan 1;62(2):775–97.
- Soares SMA, Gualberto ACM, da Costa AC, Gonçalves DA, Gameiro J. A high-fat diet protects C57BL/6 mice from Plasmodium berghei ANKA infection in an experimental malaria study. Front Trop Dis. 2023;4:1188902.
- Manzoni G, Try R, Guintran JO, Christiansen-Jucht C, Jacoby E, Sovannaroth S, Zhang Z, Banouvong V, Shortus MS, Reyburn R, Chanthavisouk C. Progress towards malaria elimination in the Greater Mekong Subregion: perspectives from the World Health Organization. Malaria Journal. 2024 Mar 1;23(1):64.
- Wang Q, Tang Y, Pan Z, Yuan Y, Zou Y, Zhang H, et al. RNA-seq-based transcriptome analysis of the anti-inflammatory effect of artesunate in early treatment of a mouse cerebral malaria model. Mol Omics. 2022;18(8):716–30.
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 2014;15(12):550.
- Anders S, Huber W. Differential expression analysis for sequence count data. Genome Biol. 2010;11(10):R106.
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. bioinformatics. 2010 Jan 1;26(1):139-40.
- McCarthy DJ, Chen Y, Smyth GK. Differential expression analysis of multifactor RNA-Seq experiments with respect to biological variation. Nucleic Acids Res. 2012;40(10):4288–97.
- Conesa A, Madrigal P, Tarazona S, Gomez-Cabrero D, Cervera A, McPherson A, et al. A survey of best practices for RNA-seq data analysis. Genome Biol. 2016;17:13.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–7.
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013 Jan 16;14(1):7.
- Shen-Orr SS, Gaujoux R. Computational deconvolution: extracting cell type–specific information from heterogeneous samples. Curr Opin Immunol. 2013;25(5):571–8.
- Subramanian A, Tamayo P, Mootha VK, Mukherjee S, Ebert BL, Gillette MA, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545–50.
- Stark R, Grzelak M, Hadfield J. RNA sequencing: the teenage years. Nat Rev Genet. 2019;20(11):631–56.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
再版と許可
この記事は公開されました
動画は近日公開