本記事では、人間の読書実験における高精度なアイトラッキングデータ収集のための段階的なプロトコルを提示します。高精度かつ高正確度のデータと再現性のある結果を得るために、ハードウェアとディスプレイの選択、ラボのセットアップ、被験者の管理、キャリブレーションとバリデーション、オンラインでの品質管理、および前処理(イベント検出とドリフト補正)について解説します。
この記事について
サマリー
要約
アイトラッキングは、読解中の注意と言語処理を研究するための中心的な手法的なアプローチです。結果の妥当性と再現性は、データの質、明確な方法論、および一貫した前処理に依存します。本記事では、読解研究において高品質なアイトラッキングデータを収集するための、包括的で段階的なプロトコルを提示します。本プロトコルは、まず研究室の環境整備と装置のセットアップから始まり、次にアイトラッキングのハードウェアとソフトウェアの選定および設定、そして刺激の作成と実験設計へと進みます。被験者の管理、インフォームド・コンセント、ならびに言語的および心理計測学的特性の記録が行われます。その後、キャリブレーションとバリデーションの手順が実施され、データ収集中は被験者の快適性とデータの質がオンラインで綿密に監視されます。前処理のパイプラインには、標準形式での生データの書き出し、データのクリーニング、固定(fixation)およびサッカード(saccade)の検出(速度ベースおよび分散ベースのアルゴリズムを採用し、明確に定義されたパラメータを使用)が含まれ、信号消失の視覚的確認とノイズ制御、複数行テキストに対する垂直ドリフト補正、および標準的な読解指標(固定時間、サッカード指標、単語スキップ、回帰率)の抽出が行われます。プロトコル全体を通じて、研究目的とハードウェア仕様の整合性、定期的なチェックによるドリフトの管理、およびすべての重要なパラメータと決定事項の詳細な報告が特に強調されています。データ収集が成功すると、通常、設定範囲内で安定したバリデーション精度が得られ、データ損失率が低くなり、単語の長さ、頻度、予測可能性に関連する既知の効果を再現する固定時間およびサッカード挙動の解釈可能な分布が得られます。本プロトコルは、デスクトップ型アイトラッカー、一般的なソフトウェア環境、および頭部固定式・頭部自由式の両方の配置に対応しており、照明条件、眼鏡による反射、被験者の姿勢の変化などの実務的な課題に対処しています。本研究は、方法論的なガイダンスを統合したワークフローとして、明確で実用的なプロトコルを提示するものです。これにより、読解研究における信頼性の高いアイトラッキングデータの収集を支援し、再現性とメタ分析を促進し、研究室やグループ間の整合性を向上させ、最終的に読解研究の科学的な信頼性を高めることを目的としています。
概要
アイトラッキングは、読書中の注意と言語処理を研究するための中心的な手法です。なぜなら、注視とサッカードは、刺激に対する視覚的および認知的リソースの瞬間ごとの配分を示すためです。古典的および現代的なレビューでは、眼球運動と、知覚スパン、プレビュー効果、眼球運動制御モデルなどの理論的構成概念との間の強固な関連性が記録されています1,2。これらの関連性を調べる信頼性の高い研究を行うには、装置の選択、実験デザイン、キャリブレーションとバリデーション、および前処理における方法論的な厳密さが不可欠です。そうでなければ、データ品質の低下が推定値にバイアスを与え、再現性を損なうことになります3。
過去10年間で、いくつかの入門書やベストプラクティスに関する論文によって、この分野の手法的な知見が集約されてきました。最近の基礎シリーズでは、理論と測定指標を関連付け、操作化とアルゴリズムの変動性について論じ、特定の研究課題に応じたアイトラッカーの選択に関するガイダンスを提供しています4,5,6,7,8。また、補完的なガイドラインでは、ハードウェアの選定、正確性と精度の確保、測定指標の定義、および報告に関するベストプラクティスが提示されており、妥当性への脅威を軽減するための推奨事項がまとめられています9。読書研究の導入リソースにおいても、実験デザイン、一般的な測定指標、および解析パイプラインについて、分かりやすい概要が提供されています10,1。応用言語学および読書研究における領域固有のレビューでは、測定指標とトラッカーの選定についてまとめられており、タスク依存的な制約が強調されています12,13,14,15,16,17。
本記事では、読書研究における高精度なアイトラッキングデータ収集のためのガイダンスを、段階的なプロトコルへと落とし込んで解説します。広範で理論的なベストプラクティスのガイドラインを提示するものや、特定の解析手法のみに焦点を当てた既存のリソースとは異なり、本プロトコルではこれらの概念をエンドツーエンドで実行可能なワークフローとして具体化しています。その目的は、具体的かつ連続的な手順を提供することで、日常的な研究室での実践を容易にすることにあります。適用範囲に関して、本プロトコルは、頭部固定装置(顎または額のレスト)を備えた高周波デスクトップ型アイトラッカー(例:50-20 Hz)を使用する、高度に制御された研究室での読書実験に特化して最適化されています。したがって、単語レベルの正確な固視や詳細なサッカード指標の分析など、厳格なデータ品質の制約、高い空間精度、および精密さが求められる研究に最適です。
読書研究においても、ヘッドフリーまたは自然な設定の使用が普及しつつありますが、本記事では範囲を研究室での研究に限定します。ここでは、ハードウェアとソフトウェアの選定、研究室のセットアップ、刺激の作成、被験者の管理、キャリブレーションと検証、オンラインでの品質管理、および前処理(イベント検出とドリフト補正を含む)について解説します。本プロトコルに従うことで、研究者は現在の標準に準拠したデータ品質を記録し達成することができ、それによって読書関連の知見における透明性、信頼性、および再現性を向上させることができます。
プロトコル
COST CA2131のデータ収集に関する倫理承認は、ポーランドのヤギェロ大学哲学部の研究倫理委員会より、プロトコル番号21.042.18_2024として得られた。また、すべての参加者からインフォームドコンセントを得た。
1. 実験環境の準備および装置のセットアップ
- 実験環境の準備
- 光および環境ノイズの状態を確認する。実験環境内の窓は、急激な瞳孔散大の変化や、アイトラッカーのカメラおよびモニターへの光の反射を引き起こす可能性がある。可能であれば、窓のない部屋でデータを収集するか、遮光カーテンを使用して日光を遮断する。人工照明を使用し、反射光源を排除する。モニターに反射が現れていないことを確認し、反射がなくなるまでブラインドや角度を調整する。室内が静かであることを確認し、妨げ(例:案内表示、ドアのロック)を防ぐ。外部信号を用いて中断を避ける(例:部屋の外に「実験実施中。ドアをノックしたり入室したりしないでください」という掲示を出す)。
- 物理的なエルゴノミクスを確認する。安定した回転しない椅子を使用し、姿勢を維持し、椅子の回転によるキャリブレーションの喪失を避けるために(調整可能な場合は)テーブルの高さを調整する。
- 社会的存在を避ける。同じ部屋に実験者がいると、参加者が気を散らす可能性がある。社会的存在による影響を最小限に抑えるため、制御室を参加者の部屋から分離するか、視界に入らないようにする。
- 換気状態を確認する。実験セッションの前後に換気を行う。参加者が一定時間静止する必要があるため、室温を確認する。
- アイトラッキング装置の選定
- 研究目的と測定尺度の整合性を確認する。特定の研究の目的、すなわちターゲットとなる測定尺度(従属変数)は、アイトラッキング装置の性能と一致している必要がある。施設で利用可能な装置によって、意図した研究範囲に制限が生じる場合がある。アイトラッキングシステムの3つの主要な特性(サンプリングレート、精度/precision、正確度/accuracy)と、それらが研究ニーズを満たす可能性があるかを確認する。重要な点は、アイトラッキング装置の性能が研究目的と互換していることを確実にすることである。
注:サンプリングレート = サンプリングレートは Hz で表され、一定期間にアイトラッカーが収集するサンプルの数を反映する。例えば、60 Hz のアイトラッカーは 16 ms ごとにサンプルを収集し、50 Hz のアイトラッカーは 1 ms ごとにサンプルを収集する。これは測定尺度の種類に影響し、低周波のアイトラッカーでは、16 ms の間に開始されたサッカードが凝視として記録されたり、あるいはその逆が起こったりすることがある。サンプリングはしばデータの正確度と混同されるが、これらは異なる特性である。
精度 (Precision) = アイトラッカーが時間経過とともに一貫してデータを収集できる能力。
正確度 (Accuracy) = アイトラッカーが検出した注視点と実際の注視点との間の誤差量。
例として、単語上の文字の注視位置として記述される単語への凝視着地点を研究する場合、読書中の回帰サッカードの割合(前進サッカードと比較して)のみに焦点を当てた研究よりも、はるかに高いサンプリングレート(≥500-20 Hz)、精度、および正確度が求められる。 - 眼球運動記録の手法を決定する。高いサンプリングレート、精度、正確度を備えたデスクトップ型アイトラッカーを使用する。チンレストやフォアヘッドレストを用いて頭部を固定する。ヘッドフリー・アイトラッキング(リモート・アイトラッキング)を使用する場合は、顔トラッキングを向上させるために、可能であれば参加者の額にステッカーを貼付する。また、トラッカーメーカーが推奨しない限り、反射性ステッカーの使用は避ける。
注:ウェアラブル・アイトラッキング装置は、デスクトップ型と比較してサンプリングレート、精度、正確度が相対的に低く、眼球運動データの解析が困難であるため、読書研究での使用は稀であった。しかし、ここ10年でデータ品質の向上と自動解析パイプラインの整備に伴い、ヘッドフリーまたは自然な設定でのセットアップが普及しており、読書中の眼球運動研究の範囲は、自然な設定や VR 環境下での読書へと拡大している。
- 研究目的と測定尺度の整合性を確認する。特定の研究の目的、すなわちターゲットとなる測定尺度(従属変数)は、アイトラッキング装置の性能と一致している必要がある。施設で利用可能な装置によって、意図した研究範囲に制限が生じる場合がある。アイトラッキングシステムの3つの主要な特性(サンプリングレート、精度/precision、正確度/accuracy)と、それらが研究ニーズを満たす可能性があるかを確認する。重要な点は、アイトラッキング装置の性能が研究目的と互換していることを確実にすることである。
- ハードウェアおよびソフトウェアのセットアップ
- ハードウェアをセットアップする。参加者の顔、モニター、およびアイトラッカー間の距離を測定する。メーカーの指示に従って視距離(例:~60–70 cm)と必要な構成ジオメトリを設定する。すべてのテキストが中心視野およびトラッカーの有効範囲内に収まるよう、好ましくはフラットな 21–27 インチの LCD モニター(例:60 cm の距離で 24 インチ、視野角 ~48° x 28°)を使用する。モニターの傾きと回転、および視線ベクトルと画面上の対応位置との整合性を確認する。モニターのサイズとリフレッシュレートを目標値に設定する。画面解像度を指定された値に設定する。指定された距離で、白色背景におけるモニター輝度を測定する。輝度値をセッションレポートに記録する。
- 必要に応じて、特に注視点依存タスクやタイミングの検証を行う場合は、高リフレッシュレート(120 Hz 以上、例:14–240 Hz)の LCD モニターを優先的に使用する。可変リフレッシュレート技術(G-Sync/FreeSync)を無効にする。アイトラッカーを異なる研究者が異なる実験に使用する場合、各データ収集時に行われた変更を記録しておくことが重要である。各データ収集の終了時に、セットアップをセッション開始時の状態、またはラボのプロトコルで定義された状態に戻す必要がある。
- ソフトウェアをセットアップする。ほとんどのアイトラッカーメーカーは、オープンソースソフトウェアとの互換性と統合のための関連ソフトウェア、ソフトウェア開発キット(SDK)、および/またはライブラリを提供している。
注:最近でも、特定のセットアップは技術的な課題として残っており、カスタムソリューションを必要とする。例えば、アイトラッカーを EEG や fNIRS などの補完的な測定手法と時間同期させるには、アイトラッカーのクロックと刺激提示クロックの間で適切なレベルの時間同期を確保し、および/または画面リフレッシュの同期ズレを解消するための、特別なハードウェアおよび/またはソフトウェアソリューションが必要となる。したがって、ほとんどのメーカーツールは、刺激の提示や眼球運動の記録など、研究者の基本的なニーズを満たす実験設計環境を提供している。現在利用可能なソフトウェアパッケージの一覧は、材料表に記載されている。
- ハードウェアをセットアップする。参加者の顔、モニター、およびアイトラッカー間の距離を測定する。メーカーの指示に従って視距離(例:~60–70 cm)と必要な構成ジオメトリを設定する。すべてのテキストが中心視野およびトラッカーの有効範囲内に収まるよう、好ましくはフラットな 21–27 インチの LCD モニター(例:60 cm の距離で 24 インチ、視野角 ~48° x 28°)を使用する。モニターの傾きと回転、および視線ベクトルと画面上の対応位置との整合性を確認する。モニターのサイズとリフレッシュレートを目標値に設定する。画面解像度を指定された値に設定する。指定された距離で、白色背景におけるモニター輝度を測定する。輝度値をセッションレポートに記録する。
2. 実験の設計とパイロット試験
- 刺激の調製
- 読解教材を準備します。読解教材は通常、研究の目的に応じて、文章または段落の形式で提示されます。この方法が研究の目的に合致している限り、テキストを手動で作成するのではなく、既存のリソースから読解教材を抜粋することを検討してください。
- テキストの再利用に関するライセンス条件を確認してください。すべてのテキストについてライセンス条件を確認する必要があります。公開済みの実験資料がオープンソースであり、利用希望者すべてに公開されている場合は、許可を得る必要はありません。それ以外の場合は、使用前に必要な許可を取得してください。刺激物が実験に使用可能か、また、それらを補足資料として共有可能かを確認することが重要です。
- フォーマット済みの刺激を準備します。テキスト刺激のフォーマットには、適切なフォント属性(書体、サイズ、文字間隔、単語間隔、および行間隔)を使用する必要があります。先行研究で用いられている設定を考慮し、適切なフォントサイズと間隔を備えた等幅フォントを使用してください。
注:単語ベースの関心領域(AOI)を用いる読書実験では、Courier Newなどの等幅フォントの使用が推奨されます。これらのフォントは、ラテンアルファベット内の異なる英数字や記号に対して同一のピクセルサイズを提供するためです。研究者は、フォント、インターフェース、および刺激の具体的な特性(非ラテン文字による刺激の提示や右から左への読書方向など)との互換性を確認し、実験用ソフトウェアツールにIA(関心領域)またはAOI(関心領域)を自動的に指定する手法が備わっているかを確認する必要があります。
- 実験手順の設計
- 手順書の作成
注:指示事項は読書中の眼球運動に大きな影響を与えるため、重要である。最小限の形式であっても、タスク指示を用いることは不可欠である。明確な指示がない場合、参加者の視線挙動に影響を及ぼす意図しない結果を招く可能性がある。例えば、ある参加者は注意深く読むという潜在的な想定を持っているかもしれない一方で、別の参加者は理解のための自然な読書ではなく、スキミング(すくい読み)を行う可能性がある。- 標準化された指示を画面上に提示し、指示の提示開始時刻と持続時間を記録してください。記録中の口頭による促しは避けてください。一般的な手法として、参加者に内容を理解しながら読むよう求める方法があります。日常生活と同様の読み方を求める場合は、自然に読んでよいこと、つまり、瞬きや読み返しを避ける必要はないことを参加者に伝えてください。また、読解問題などの追加タスクがある場合は、その旨を参加者に伝えてください(読解問題は、参加者が内容を理解しながら読んでいることを保証するために重要です)。指示内容はタスクによって異なるだけでなく、実験のフェーズ(例:トレーニングフェーズと本タスク)によっても異なる場合があります。例として、トレーニングフェーズで使用された指示の例を以下に示します。18.
それでは、トレーニングセッションを開始します。このセッションでは、印の付いた4つのキー(A、B、C、D)を使用します。詳細な指示は後ほど表示されます。トレーニング終了後、1〜2分かけてパフォーマンスの評価を行います。トレーニングの成績が不十分な場合は、トレーニングの最後のパートを繰り返します。十分な成績であれば、私は退室します。準備ができたら、スペースキーを押してください。 - 読解の研究を目的とした実験のトレーニングセッションにおいて、このような指示を用いるかは研究者の判断に委ねられます。それとは別に、実験セッションでは指示を用いてください。一般的関連性指示条件(テキスト内に質問がある場合とない場合の両方)で使用される実験フェーズの指示の例を以下に示します。19.
一連の短い解説文を読みます。テキストを注意深く読み、内容を最大限に理解してください。読了後、テキストの主旨について口頭で要約していただき、読解状況を確認します。
文章読解タスクを用いる実験について、もう一つの指示例を以下に示します。20.
読解研究にご協力いただきありがとうございます。本研究では、さまざまな出典からランダムに選出された約10個の文章を、ランダムな順序で提示します。本や記事を読むときと同様に、ご自身の自然な読書ペースで、意味を理解しながら黙読してください。一部の文章の後に、内容に関する質問が表示される場合があります。その際は、質問に回答してください。答えが分からない場合は、その質問をスキップしてください。セッションの中ほどに休憩時間を設けています。また、不快に感じた場合は、いつでも休憩を申し出たり、セッションを中断したりすることができます。ご不明な点があれば、実験者に知らせてください。準備が整いましたら、ボタンを押して手続きを開始してください。
- 標準化された指示を画面上に提示し、指示の提示開始時刻と持続時間を記録してください。記録中の口頭による促しは避けてください。一般的な手法として、参加者に内容を理解しながら読むよう求める方法があります。日常生活と同様の読み方を求める場合は、自然に読んでよいこと、つまり、瞬きや読み返しを避ける必要はないことを参加者に伝えてください。また、読解問題などの追加タスクがある場合は、その旨を参加者に伝えてください(読解問題は、参加者が内容を理解しながら読んでいることを保証するために重要です)。指示内容はタスクによって異なるだけでなく、実験のフェーズ(例:トレーニングフェーズと本タスク)によっても異なる場合があります。例として、トレーニングフェーズで使用された指示の例を以下に示します。18.
- 試行およびブロックを設計します。ブロックごとの試行の提示、ならびにブロック内およびブロック間での試行順序のランダム化を考慮して、実験の流れを設計してください。各試行の前に注視点(50~80 ms)を提示し、参加者の初期注視点がディスプレイ上の同一位置にあり、かつテキストのいかなる部分からも離れていることを確実にしてください。
瞳孔径を従属変数とするアイトラッキング実験の設計では、瞳孔径が固視とサッカードのシーケンスのような瞬間的な反応ではないため、それに合わせて実験フローを調整する必要がある。具体的に瞳孔径を従属変数として用いる場合は、刺激の提示前および次回の試行前に瞳孔径を安定させるため、適切な期間のプリオンセット・ベースラインウィンドウと黒画面の間隔を導入する必要がある。研究者は、記録された瞳孔データが従属変数として適切に解釈されるよう、瞳孔計測(プピロメトリー)のガイダンスに関する最新の研究を確認すべきである。21,22. - ブロック間に休憩を設けてください。データの質を確保し、疲労を軽減するため、実験ブロックの間にドリフト補正スクリーンと任意の短い休憩を導入してください。あらかじめ指定した試行回数後、または精度が明らかに低下した時点でドリフトチェックを挿入してください(実験中にキャリブレーションやバリデーションを強制実行するためのショートカットキーがあるか確認してください)。ドリフトが認められた場合は再バリデーションを行ってください。 >1° 視角(x座標とy座標の平均)の。
- ターゲットとなる独立変数を特定します。読解研究では、単語頻度や単語の文脈的予測可能性といったテキストの特定の特性が、主要なターゲット独立変数となります。研究目的に応じて、実験の独立変数をリストアップしてください。統計解析において、独立変数の指標は値の正規化を必要とする場合があります。刺激の特性に基づいて、各変数の関連性を評価してください。
- 行頭の単語は、それらへの固視は通常正確ではないため、分析から除外してください。これらの固視は、テキストまたは文章における最初の試行的な固視、あるいは改行後の最初の固視(いわゆるリターン・スウィープ)を反映している可能性があり、いずれにせよ正確ではなく、通常はその後に修正的な固視が続きます。また、各行の末尾の単語も除外してください。これらの単語は(後続の単語による)視覚的な混雑の影響を受けにくく、行末の単語への固視は、試行の終了や次行へのリターン・スウィープの準備を反映していることが多いためです。
注:冠詞などの機能語が多い言語では、最初の注視時間はそれほど重要ではない可能性があります(分析領域には冠詞と名詞を含める必要がありますが、最初の注視は冠詞の処理のみを反映している可能性があるため、その重要性は低くなります)。
- 行頭の単語は、それらへの固視は通常正確ではないため、分析から除外してください。これらの固視は、テキストまたは文章における最初の試行的な固視、あるいは改行後の最初の固視(いわゆるリターン・スウィープ)を反映している可能性があり、いずれにせよ正確ではなく、通常はその後に修正的な固視が続きます。また、各行の末尾の単語も除外してください。これらの単語は(後続の単語による)視覚的な混雑の影響を受けにくく、行末の単語への固視は、試行の終了や次行へのリターン・スウィープの準備を反映していることが多いためです。
- ターゲットとなる従属変数を特定してください。読解研究では、研究目的に関連する主要なターゲット従属変数として、初回注視時間、単一注視時間、注視時間、回帰率、単語スキップ確率などの一連の眼球運動指標が用いられます。解析対象とする眼球運動指標を指定してください。これらの指標を統計解析の主軸として使用します。
注:参加者がキーボードで入力するタスクは避けてください。顎台(チンレスト)から離れる必要があり、キャリブレーションが失われる可能性があるためです。代わりに、マウスを用いて回答を選択させてください。眼球運動の記録中に参加者からの口頭でのフィードバックが必要な場合は、顎台の代わりに額台(フォアヘッドレスト)を使用し、額台に固定したまま口頭で回答させるか、単一キーによる回答を許可してください。
- 手順書の作成
- 実験手順の実施
- 刺激提示ソフトウェアを選択してください。適切な刺激提示ソフトウェアを使用して、実験のセットアップを行います。テキストの提示および眼球運動の記録には、メーカー提供のツールと汎用の実験設計ツールのいずれも使用可能です。ソフトウェアを選択する際は、利用可能なハードウェア統合(例:使用するアイトラッカーへのネイティブサポート)、要求されるタイミング精度のレベル、およびスクリプト作成とGUIベースの設計のどちらを優先するかを検討してください。プラットフォームにかかわらず、解析時に固視(fixation)とサッカード(saccade)を対応するテキスト要素と整合させることができるよう、ソフトウェアは刺激イベント(例:単語の提示開始、文章の提示開始)とアイトラッキングのデータストリームとの間で信頼性の高い同期をサポートしている必要があります。外部ソフトウェアを使用する場合は、アイトラッカー用ソフトウェアと外部ソフトウェアとの互換性、特にデータの可視化およびデータエクスポートに関する互換性を確認してください。
注:ソフトウェアの例として、Experiment Builder(SR Research社製、EyeLinkシステム用)は、ドリフトチェック、キャリブレーションルーチン、および記録用コンピュータに送信されるイベントメッセージを組み込みでサポートするグラフィカルインターフェースを提供しています。PsychoPyやOpenSesameなどのオープンソースプラットフォームも同様の機能を提供しており、これらはハードウェアに依存せず、グラフィカルインターフェースやスクリプティング(例:PsychoPyの場合はPython)による試行の設計、刺激タイミングの制御、および単語や行の周囲の関心領域(Interest Areas: IA、またはAreas of Interest: AOI)の定義が可能です。研究キャリアの初期段階にある研究者にとって、データの可視化とデータエクスポートの連携が容易でない場合があるため、メーカー提供のソフトウェアを使用する方が簡便なことがあります。したがって、アイトラッカーを選択する際の重要な検討事項は、各メーカーまたは開発者コミュニティによって提供されるサポートのレベルです。 - 予備実験を行う。実施した実験手順をテストし、記録されたデータを確認して、実験が期待通りに進行することを確認する。あらかじめ定義した成功基準をモニタリングし、ラボ環境で予備研究を実施して、実験が期待通りに進行することを確認する。記録されたデータをチェックし、研究に必要なすべての項目が登録されているかを確認する。
- 刺激提示ソフトウェアを選択してください。適切な刺激提示ソフトウェアを使用して、実験のセットアップを行います。テキストの提示および眼球運動の記録には、メーカー提供のツールと汎用の実験設計ツールのいずれも使用可能です。ソフトウェアを選択する際は、利用可能なハードウェア統合(例:使用するアイトラッカーへのネイティブサポート)、要求されるタイミング精度のレベル、およびスクリプト作成とGUIベースの設計のどちらを優先するかを検討してください。プラットフォームにかかわらず、解析時に固視(fixation)とサッカード(saccade)を対応するテキスト要素と整合させることができるよう、ソフトウェアは刺激イベント(例:単語の提示開始、文章の提示開始)とアイトラッキングのデータストリームとの間で信頼性の高い同期をサポートしている必要があります。外部ソフトウェアを使用する場合は、アイトラッカー用ソフトウェアと外部ソフトウェアとの互換性、特にデータの可視化およびデータエクスポートに関する互換性を確認してください。
3. 被験者の募集とインフォームドコンセント
- 参加者の選定
- 視力の条件要件を決定する。正常視力または矯正視力が正常な参加者を募集する。メーカーのガイダンスに従い、反射が最小限である(アンチグレア、モニター角度など)眼鏡およびコンタクトレンズの使用は可能である。共変量チェックのため、矯正の種類(眼鏡、コンタクトレンズ)を記録する。
注意:通常、ハードコンタクトレンズ(現在はあまり一般的ではない)はトラッキングが非常に困難である。コンタクトレンズ自体は問題ないが、レンズと角膜の間に気泡が生じ、それが反射となってトラッキングを妨げることがある。光沢のあるフレームの眼鏡もトラッキングを妨げる可能性がある。光沢のあるフレームを使用している場合は、アイトラッカーソフトウェアで視野検出範囲を狭める。 - 年齢、読解能力、言語背景、利き手などの個人の特性に基づいて参加者をスクリーニングする。また、読字障害、バイリンガル、または読書障害などの一般的な除外基準および包含基準は、眼球運動データに影響を与える可能性がある。したがって、研究目的に応じて、どのような読者が実験の適切な参加者となるか、すなわち包含基準および除外基準を明確に定める(「考察」を参照)。
- 視覚障害の有無を確認する。白内障(手術後を含む)、緑内障、または黄斑変性などの矯正不能な視覚障害がないことを確認する。
- 神経学的状態を確認する。眼球運動の記録に不快感を抱くような疾患がないことを確認する。ほとんどのアイトラッカーは近赤外線(NIR)LED/レーザー、または認定済みのNIR LED/VCSEL照明を使用しており、これらは眼球に対して安全であるとされる。デバイスの眼球安全性認定(例:Class 1 IEC 60825-1、IEC/EN 62471、または同等の規格)を確認する。参加者に装置の安全規制について説明する(例:メーカー発行のCE証明書、一般にEU適合宣言書として知られる、製品が必要なすべての欧州の健康、安全、および環境規制に準拠していることを証明するためにメーカーが発行する文書など)。
- 視力の条件要件を決定する。正常視力または矯正視力が正常な参加者を募集する。メーカーのガイダンスに従い、反射が最小限である(アンチグレア、モニター角度など)眼鏡およびコンタクトレンズの使用は可能である。共変量チェックのため、矯正の種類(眼鏡、コンタクトレンズ)を記録する。
- 衛生管理の確立
- 対人距離に関する注意を払う。必要に応じて使い捨て手袋とマスクを着用する。実験プロトコルの実施において、対人距離を縮める必要がある場合があるためである。
- 装置を消毒する。現在の施設ガイダンスに従い、アルコール綿を使用して顎台およびその他のアクセサリーを消毒する。装置を損傷させる可能性のある化学薬品を使用しないよう注意し、メーカーの仕様書を確認する。特に顎台、ヘッドレスト、マウス、または参加者が接触するその他の装置パーツについて、参加者の目の前で清掃を行うことで、参加者がより安心感を得られる場合がある。
- 参加者への説明
- 実験環境について説明する。実験者が参加者にラボ環境とアイトラッキング装置を紹介する口頭説明セッションを設計する。
- 実験の内容について説明する。実験の背景(研究の目的と概算所要時間。これはパイロットテスト中に確認すること)、インセンティブまたは謝礼の手続き、実験における参加者の貢献、および長期的に研究結果を確認する権利について明確に説明する。記録セッション中の注意事項(すべきこととすべきでないこと)を伝える。高品質なデータを記録するためである旨を伝え、(ヘッドスタビライザーを使用しない場合は)記録中に頭をあまり動かさないこと、または顎台から離れないよう参加者に求める(それ以外の場合、参加者はいつでも理由を述べることなく実験を中止し、セッションを終了することができる)。
- インフォームド・コンセントを得る。セッション開始前に、参加者に倫理承認書と同意書を渡し、内容を説明する。成人参加者の場合は、研究目的、実施内容、および自発的な参加の選択肢、データプライバシー、撤回権を含む権利を理解したことを確認した上で、書面によるインフォームド・コンセントを得る。未成年者が参加する場合は、親または保護者から書面による同意を得て、かつ未成年者本人の同意(アセント)を得る。必要なすべての同意書およびアセントフォームが完了した後にのみ、キャリブレーションと記録に進む。インフォームド・コンセントの手順は、成人参加者と未成年参加者で大きく異なる。したがって、研究者は現地の施設のガイドラインに従う必要がある。
注意:実験中に中断や休憩があった場合は、キャリブレーションの再検証が必要である。再検証に失敗した場合は、再キャリブレーションが必要となる。
4. 校正およびバリデーションの実施
- 参加者の配置と装置の調整
- 参加者を配置する。参加者に楽な姿勢で座ってもらう。椅子やテーブル、およびチンレストを調整し、頭部位置を安定させる。これがキャリブレーション、バリデーション、および記録フェーズ中の想定頭部位置であることを参加者に伝える。
- 装置を調整する。アイトラッカーのカメラを合わせ、参加者の瞳孔が明確に視認され、検出できるようにアイトラッキング装置を調整する。アイトラッキングシステムによっては、このアライメントを自動的に行うものもあるが、カメラのフォーカスを手動で調整する必要がある場合もある。
注:参加者の負担を軽減するため、実験者は実際のデータ収集を開始する前に、装置の調整とキャリブレーションの練習を行っておくべきである。
- キャリブレーションの実行
- 参加者に説明する。キャリブレーションの手順について参加者に説明する(例:一連のターゲットマーカーが表示されること、および約1分ほどそれらを追う必要があることを伝える)。
注:調整を行う際は、言葉選びに注意することが推奨される。例えば、実験者は、この手順は参加者をアイトラッカーに合わせるためではなく、参加者のためにアイトラッカーを校正するためのものであることを強調する。さらに、アイトラッキング装置でビデオや画像が記録されていないことを確認することが重要である。参加者の目は視認できるが、記録されるのは座標に変換された目の位置のみである。 - キャリブレーション手順を実行する。参加者にターゲットマーカーを追跡し、頭部の位置を一定に保つよう指示する。例えば、キャリブレーション手順の終了後に後方に寄りかからないように伝える。キャリブレーションシンボルの中心を凝視し、シンボルが動くまで目を動かさないよう参加者に指示する。参加者は、特にバリデーション中にシンボルの動きを予測する傾向があり、それがエラーを増やし、不必要なキャリブレーション手順につながる可能性がある。この説明を指示書またはキャリブレーション/バリデーションプロセスの説明に含める。
注:メーカーによって、キャリブレーションプロセスに使用するシンボルの種類(点、子供向けシンボル、静止または縮小するシンボルなど)や、キャリブレーション設定(すなわちキャリブレーションポイントの数)が異なる。これらの異なるキャリブレーション設定による精度の違いを確認し、特定の研究のニーズに最も適したものを選択することが重要である。例えば、刺激が画面全体を使用する場合(例:多くの段落があるテキスト)、四隅を含む上下方向まで良好に校正できるキャリブレーション設定が必要となる。一方、刺激が画面中央に提示される文章である場合は、ポイント数の少ないキャリブレーション設定で十分な場合がある。さらに、後者の場合は前者に比べて水平方向(x座標)のキャリブレーション精度がより重要であり、前者は垂直・水平両方向の座標において高い精度が求められる。 - キャリブレーション手順を終了する。キャリブレーション手順の完了後、バリデーション手順について参加者に伝える。
注:キャリブレーションに繰り返し失敗する場合は、アイトラッカーのカメラのアライメント、照明条件、および参加者の配置を確認する。成人参加者の場合、パール系のメイク、眼鏡、またはコンタクトレンズがトラッキングを妨げる可能性がある。参加者を安心させ、短い休憩を設けるか、必要に応じてキャリブレーションを繰り返す。問題が解決しない場合は、アイトラッキングシステムの再起動を検討する。再起動後も問題が続き、設定パラメータを確認してもキャリブレーション失敗の原因が見つからない場合は、アイトラッキング技術が十分に開発されていないためであり、参加者の問題ではなく技術的な状況による問題であることを参加者に伝える。
- 参加者に説明する。キャリブレーションの手順について参加者に説明する(例:一連のターゲットマーカーが表示されること、および約1分ほどそれらを追う必要があることを伝える)。
- バリデーションの実施
- バリデーション手順を実行する。キャリブレーションの直後にバリデーション手順を実行する。
- エラーを確認する。平均視線位置エラーを確認し、それが許容範囲内であることを確認する。通常、視角1度(<1°)未満が望ましく、これは約4文字に相当する(つまり、0.5は約2文字に相当する)。エラーがこれらの範囲外である場合は再キャリブレーションを行う。例えば、平均エラーが ≤0.5–1.0° かつ最大/ポイントあたりエラーが ≤1.5–2.0° であればキャリブレーションを承認し、それ以外の場合は再キャリブレーションを行う。再バリデーションの頻度(例:各ブロック後または中断後)を指定する。メーカーである SR Research によるキャリブレーション品質の評価基準の例を挙げると、平均エラーが <1° かつ最大エラーが <1.5° の場合はほとんどのタスクで「許容範囲内(acceptable)」、平均エラーが <1°-1.5° かつ最大エラーが <1.5°-2° の場合は「普通(fair)」、これらを超える場合は「不良(poor)」と見なされる。
- 参加者に伝える。参加者にできるだけ同じ姿勢を維持するように指示し、記録セッションの開始について伝える。
5. データ収集
- データ収集手順の実行
- 記録セッションの開始。記録セッションを開始し、口頭での指示を出すなどして、タスク実行中の参加者を妨げないようにします。
- 参加者のモニタリング。データ記録中、参加者の快適さをモニタリングします。参加者が負担や疲労なく、安定した姿勢を維持していることを確認してください。注意散漫な様子や目の乾燥、あご置き・額置きによる不快感がないか注意深く観察します。
- データ記録のモニタリング。記録中のデータ品質をモニタリングします。平均検証誤差またはオンライン精度が1°(またはあらかじめ規定した精度しきい値)を超えた場合、あるいは参加者の姿勢が変動した場合は、再キャリブレーションを行ってください。
- ログの記録。実験中に観察された異常(例:キャリブレーション手順が異常に長い、記録中に意図しない中断が発生したなど)をメモし、後で検査できるように記録セッションのログを保持します。セッションログスキーマを用いて、イベントの発生時刻、中断、再キャリブレーションの回数とその誤差、ドリフトチェック、および照明の変化をモニタリングします。
- セッションの終了
- データの保存。実験セッションの終了時に生の視線データを保存します。その際、セッションをラベル付けするための体系的な方法(例:実験日と参加者番号を用いて、2025年7月18日の参加者01であれば 25071801 または 250718-P01 とするなど)を使用することが推奨されます。参加者の個人特定につながる情報の使用は避けてください。)
- 終了処理。参加者に感謝を伝え、実験に関する質問に対応します。その後、機器の消毒を行います(ステップ 3.2.2 参照)。
- データの確認。データとログを確認し、セッションが正しく完了したことを確認します。
6. データの前処理と品質チェック
- 生データのエクスポート、整理、およびクリーニング
- データのエクスポート。生視線データを標準形式(例:.csv, .tsv, .edf)でエクスポートし、セッションIDを標準化する(例:25071801 または 250718-P01、5.2.1を参照)。
- データのクリーニング。メーカーのソフトウェアに内蔵されているツール、またはデバイスやサンプリングレートに合わせて調整したカスタムスクリプトを用い、瞬目検出および欠損データ検出のためのアルゴリズムを適用して生データをクリーニングする。
注意:クリーニングルーチンを実行する際は、生データのバックアップを作成すること。
- 眼球運動イベントの検出
- 眼球運動イベント検出アルゴリズムの選択。注視検出の手順を選択して実行し、必要に応じてアルゴリズムのパラメータを調整する。注視同定の代表的なアルゴリズムには、主に速度ベースのアルゴリズム(例:I-VT 速度閾値同定法)や分散ベースのアルゴリズム(例:I-DT 分散閾値同定法)などがある23。各アルゴリズムには固有のパラメータが存在する。
注意:メーカーのソフトウェアは通常、デフォルトで特定のアルゴリズムと一般的に使用されるパラメータセットを想定している。適切なアルゴリズムとそのパラメータを選択し、分散/速度閾値、最短注視時間閾値(例:60 ms または 10 ms:この値より短い注視を除去するため)、最長注視時間閾値(例:10 ms:この値より長い注視を除去するため)、使用した平滑化ウィンドウ、および隣接する注視の統合ルールなどを、研究手法の説明の中で報告することは研究者の責任である23。 - 不適切な注視の特定。ディスプレイ領域外の注視を除去またはラベル付けする。事前に定義した最小閾値より短く、または最大閾値より長い注視を除去またはラベル付けする。
- データの視覚的検査。利用可能な可視化ツールを用いてデータを視覚的に検査し、データの妥当性を確認する。信号消失、過剰なノイズ、欠損サンプル、または注視位置のずれがないかを確認する。各記録セッション後、視線追跡ソフトウェアに付属の可視化ツール(例:ゲイズプロット、スキャンパス、時系列トレース)を用いてデータを視覚的に検査する。このステップにより、前処理および解析に進む前に、データが十分な品質であることを確認できる。
- 特に、視線パターンに長い空白があるか、または刺激上の視線サンプルが記録されていない領域がないかを確認し、信号消失やトラッキングの問題をチェックする。トラッキングの消失が頻繁に、あるいは長時間発生している場合は、そのセッションを除外または再実施することを検討すべきである。
- 過剰なノイズを確認するには、生のx/y座標トレースを調べ、刺激のレイアウトと一致しない急激なジャンプや誤ったサンプルがないかを確認する。過剰なノイズは、キャリブレーションの不備、頭部の位置の不安定さ、またはハードウェアの問題を示唆している可能性がある。
- 欠損または不規則なサンプルを見つけるには、サンプリングレートが想定通り(例:50 Hz)であるか、および通常の瞬目以外に予期しない欠損サンプルのクラスターがないかを確認する。
- 注視位置のずれを見つけるには、提示した刺激の上に注視点を重ね合わせ、意図した行や単語上に位置しているかを確認する。系統的なオフセット(例:注視点が常にテキストの外にある)は、キャリブレーションのドリフトや、視線座標と画面座標の誤ったマッピングを示唆している可能性がある。記録された視線パターンは、概ねテキストの構造(例:左から右への進行、一行ずつ)に従っており、単語上に注視点が集中し、その間を比較的スムーズなサッカードが結んでいる必要がある。このパターンから系統的に逸脱している場合、または利用可能なデータの喪失が頻繁にある場合は、影響を受けたデータを以降の解析から除外する必要がある。
- ドリフト補正の実施。必要に応じて垂直方向のドリフト誤差補正を行う。複数行のテキストに対しては、行ごとの垂直ドリフト補正を適用する。検証済みの手法21の適用可能性を確認すること。
注意:図1は、プロトコルセクションで説明した、視線追跡実験のセットアップ設計およびデータ解析パイプラインに含まれる手順を示している。次のセクションでは、記録されたセッションからの代表的な結果を示す。
- 眼球運動イベント検出アルゴリズムの選択。注視検出の手順を選択して実行し、必要に応じてアルゴリズムのパラメータを調整する。注視同定の代表的なアルゴリズムには、主に速度ベースのアルゴリズム(例:I-VT 速度閾値同定法)や分散ベースのアルゴリズム(例:I-DT 分散閾値同定法)などがある23。各アルゴリズムには固有のパラメータが存在する。
結果
データの品質とバリデーション
成功したセッションでは通常、ターゲット全体で平均誤差 ≤0.5–1.0°、および最大/点あたりの誤差 <1.0–1.5° のバリデーション精度が得られます。平均値と点あたりの値の両方を報告してください。点あたりの誤差のヒストグラムと、セッションごとの平均 ± SD および最大誤差をまとめた表を提示してください。これらの基準は一般的な慣行およびベンダーの推奨事項に準拠しています。これらの閾値を超えるセッションは、研究ルールに従って部分的または完全に除外する必要があります。図 2 は、3回のキャリブレーション試行を含む9点キャリブレーションのキャリブレーション精度に関する点あたりの誤差ヒストグラムの例を示しています。
精度とデータ損失
精密度(例:注視中のサンプル間分散のRMS:二乗平均平方根)およびデータ損失(試行/セッションごとの欠損サンプルの割合%)を報告してください。良好な試行では、通常、注視時の分散が小さく、データ損失が少なくなります(例: <(アイトラッキング装置およびセットアップにより異なりますが、5~10%程度です)。データ損失率の分布、および外れ値を明らかにするための試行ごとの精度対損失の散布図を提示してください。定義および最小報告項目について、最新の文献を確認してください。3,4,5,6,7,8,9,10,11.
ドリフト挙動(補正前/後)
良好な試行ランでは、垂直方向のオフセットが小さくほぼ一定であり、自動ドリフト補正アルゴリズム21または手動による行ごとの補正によって大幅に低減されます。対して、問題のあるランでは、非単調なドリフトや大きな残留ドリフトが見られます。補正前後の垂直方向の平均絶対誤差を記載してください。自動ドリフト補正法の適用可能性を確認してください。
一般的な読字指標の分布
初回注視時間(FFD)、単回注視時間(SFD)、初回通過時間(FP)、合計/注視時間(GD)、go-past time、スキッピング確率、および回帰確率の要約分布を提示してください。アルファベット文字を読み書きできる熟練した成人の場合、注視時間は通常 ~200–250 ms 前後に集中し(大幅な歪みを伴う)、サッカードの平均スパンは ~7–9 文字となります。これらの範囲から大きく外れた値や、高度に二峰性を示すサッカード分布が見られた場合は、それがタイミングの誤差ではなく、タスクの制約や処理の困難さによる想定内の前進サッカードおよび回帰サッカードを示しているかどうかを確認する必要があります。指標の選択および範囲は、対象集団、特定の言語、および正書法によって適宜異なる場合があります。図 3に、代表的なセッションから得られた注視時間分布プロトコルのサンプルを示します。
サニティチェック
一般的に、単語の長さが増すと(長い単語になると)、スキップ率が低下し、それらの単語への注視時間が長くなります。一方で、機能語(冠詞や前置詞など)は通常スキップされます。また、高頻度語や、言語的文脈(テキスト内または文内)に基づいて予測可能性が高い単語は、通常、初回固視時間と注視時間が短くなり、スキップ率が高くなります(低頻度語および予測可能性が低い単語では、その逆が予想されます)。データがこれらのパターンのいくつかを、少なくとも一方の方向において再現しているかを確認してください。大幅な逆転傾向が見られる場合は、ドリフト誤差、単語と固視位置の不整合、またはデータ処理エラーの可能性があります。
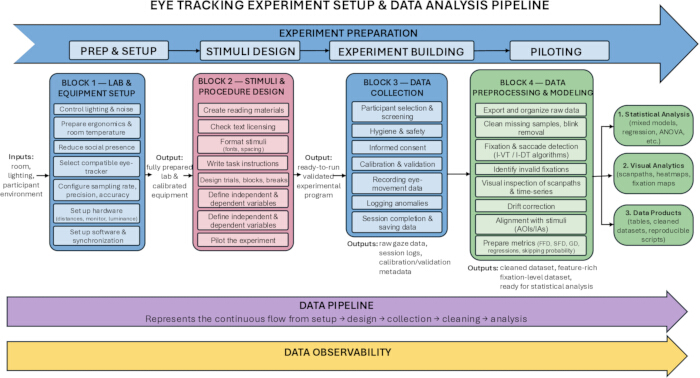
図 1. アイトラッキング実験のセットアップ設計およびデータ解析パイプラインに含まれる手順の図解。こちらのリンクをクリックして、この図の拡大版を表示してください。
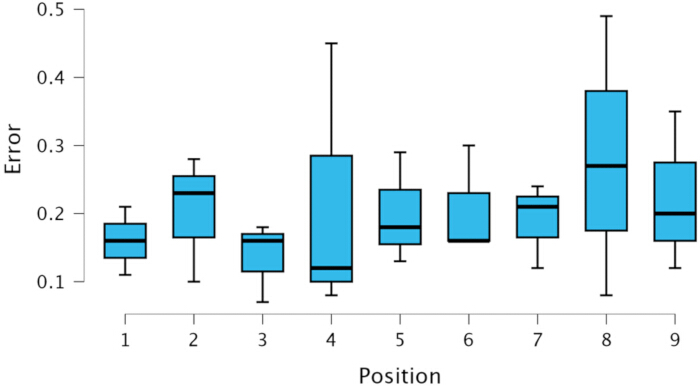
図 2. 3回の校正試行を含む9点校正における、校正精度の各点誤差ヒストグラム。こちらをクリックして、この図の拡大版を表示してください。
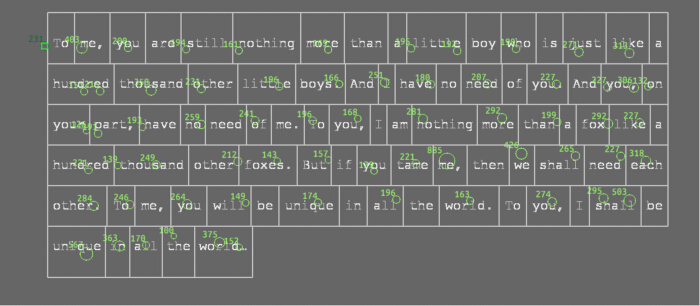
図 3. 代表的なセッションにおける注視時間の分布プロトコル。1名の被験者が小説『星の王子さま』の抜粋を読んでいる。円の位置と大きさは、それぞれ注視位置と注視時間を表している。円の横の数字は注視時間を ms で示している。ここをクリックして、この図の拡大版を表示してください。
ディスカッション
本プロトコルでは、読解研究において信頼性の高いアイトラッキングデータを取得するために必要な主要な手順をまとめています。これらの手順の多くは熟練した研究者には周知のことかもしれませんが、個別の手法論文やベンダーのドキュメント、研究室内の慣習などに分散していることが少なくありません。ラボの準備から前処理までの単一のワークフローとして整理することで、読解のアイトラッキング研究を初めて行う研究者にとって実用的なガイドを提供することを目的としています。一般的なアイトラッキングのガイドラインや、主に眼球運動検出アルゴリズムに焦点を当てたリソースとは異なり、本プロトコルは、高い空間分解能とサンプリング周波数を伴うデータ記録が求められる読解研究に応えるためのエンドツーエンドのフレームワークを提供します。
ワークフローの全段階における中心的なテーマは、環境制御と装置のセットアップから始まる、積極的なデータ品質管理の重要性です。モニター上の反射、椅子の不安定さ、あるいは視距離の不一致といった些細な問題が、注視位置や精度に系統的なバイアスを生じさせる可能性があります。これらの要因に早期に対処することで、事後的な大幅な補正の必要性を最小限に抑え、より一貫した検証精度(平均誤差 ≤ 0.5–1°)を維持することが可能になります。
本プロトコルでは、研究目的とハードウェア特性との整合性の重要性についても強調しています。読書に関する多くの研究は、注視点、サッケードの着地位置、および回帰の精密な空間的・時間的測定に依存しています1,2。したがって、特に着地位置やパラフォービア・プレビューのように小さな空間的誤差に敏感な指標を測定する場合、適切なサンプリングレート、精度、および正確性を備えたアイトラッカーを選択することが不可欠です。具体的な研究上の制約に応じて、これらの手法を変更することが可能です。例えば、顎台(チンレスト)に耐えられない神経多様性を持つ集団を対象とする場合、研究者はリモート型のヘッドフリー・トラッカーへの切り替えを検討し、フォントサイズの拡大、行間の拡大、および関心領域(Interest Areas)の拡大を行うことで、空間的精度の低下を補うことができます。ヘッドフリー・システムを使用する場合、研究者は動きの増加と潜在的なデータ損失を考慮しなければなりません。リモート・トラッカーはより自然な設定を可能にしますが、現在のところ、ほとんどの読書タスクにおいては依然として頭部の固定が好ましいとされています。
実験デザインは、データの品質と解釈可能性の両方に影響を与えるもう一つの重要な要因です。標準化された画面上の指示、試行のランダム化、および適切なブロック構造によって、セッションを通じて参加者の行動を安定させることができます。読書実験においては、わずかな緩やかなオフセットであってもテキストの行をまたいで蓄積される可能性があるため、定期的なドリフトチェックを組み込むことが特に重要です。また、本プロトコルは、言語依存的な語彙ノルムの使用および独立変数と従属変数の透明性のある報告を支持しており、これにより研究間での再現や比較が容易になります。
データ収集中は、精度、姿勢、および参加者の快適性を継続的にモニタリングすることで、大規模なデータ損失を防ぐことができます。よくある問題に対しては、積極的なトラブルシューティングが必要になることが多々あります。例えば、画面の隅でキャリブレーションが失敗する場合、モニターや椅子の高さを調整することで周辺部のトラッキング損失を解決できることがあります。反射性の眼鏡やコンタクトレンズによる問題は、周囲の照明を調整したりモニターの角度を変えたりすることで解決できる場合があります。詳細なセッションログを維持することは、後日のトラブルシューティングを容易にし、中断、再キャリブレーション、および予期せぬ事象を記録することで透明性を高めることにつながります。多くの既報の研究において、精度やデータ損失率などの品質指標の明示的な報告が求められるようになっているため、この点はます重要になっています。
前処理のセクションでは、イベント検出、ドリフト補正、およびクリーニングルーチンにおける一貫性があり、十分に文書化された選択を重視しています。注視点の分類アルゴリズムや閾値は、結果として得られる指標に強い影響を与える可能性があるため、研究者はすべてのパラメータ設定を明記し、一般的なデフォルト設定と異なる場合はその根拠を提示する必要があります。自動化ツールを適用する場合であっても、視覚的な確認は依然として重要なステップです。また、本プロトコルでは、研究間の信頼性の高い比較を可能にするため、検証精度、適合率、データ損失、およびドリフト挙動などの標準的な品質指標を報告することを推奨しています。
さらに、本プロトコルでは、単語の長さ、頻度、または予測可能性の影響など、読解行動に関する簡便なサニティチェックを行うことを推奨しています。これらの標準的なパターンを再現することで、気づかないうちに生じたアライメントの問題や問題のあるドリフト、あるいは前処理のエラーに対する追加的な保護策となります。これらのチェックは完全な統計分析に代わるものではありませんが、データが熟達した読解において期待通りに挙動しているかについて、迅速なフィードバックを提供します。
既に述べた実験プロトコルの詳細に加えて、参加者の言語的および心理測定学的特性を記述することが重要です。その主な理由は、実験研究者が直面する異なる研究間での比較可能性という課題にあります。これはオープンサイエンスの時代において特に重要であり、公開されたデータセットを、元々データを収集していない研究者が利用する場合、参加者の(社会)言語学的背景の相違から生じる潜在的な特異性に気づかない可能性があるためです。
言語的背景に関しては、参加者の母国語を記録し、結果に影響を与える可能性のある方言の違いを考慮するため、使用している方言に関する情報を収集する必要があります。現代社会において一般的であるように、参加者が複数の言語を話す場合は、第二言語の習熟度を記録すべきです。バイリンガリズムや第二言語処理の研究では、妥当性が確認された第二言語判定テストを用いて、第二言語の習熟度を評価する必要があります。さらに、社会経済的状況に関する関連事項(例:参加者の読書習慣など)を記録する場合もあります。
参加者のワーキングメモリ容量や認知柔軟性(特にバイリンガル研究において)などのサイコメトリック特性を評価するためのテストを実施する必要があります。方法論的な観点からは、どのテストを選択するか、それらに要する認知負荷と時間、および実験プロトコル内のどのタイミングでこれらの測定を行うか(アイトラッキングセッションの前か後か、あるいは別のセッションか)を検討する必要があります。
読書研究において、言語行動は刺激の言語的特性と読者のサイコメトリックな特性(または参加者の言語行動に関連するその他の特徴)の両方を用いて測定および説明されることを念頭に置くことが不可欠です11,12,17,20。研究間での比較を可能にするためには、データ解釈に関連し得るすべての要因を含める必要があります。どの特性を含めるかの選択は、研究の目的に依存します。データは比較可能でなければなりません。要約すると、潜在的な利用者が最大限の柔軟性を持ってデータを利用できるよう、十分な詳細さをもってデータを収集し、記述すべきです。これらの検討事項はプロトコル自体に含まれていないかもしれませんが、個々のあらゆる研究に関連します。今日のグローバルな科学環境において、このような詳細は収集されたデータの将来的な活用可能性を高めることになります。
本プロトコルには限界があり、特にデータ品質と生態学的妥当性のトレードオフが顕著です。頭部を固定して静止したモニターで読書を行うことは、自然な読書行動を完全には捉えておらず、また厳格な視覚的組み入れ基準はサンプルの代表性を制限する可能性があります。さらに、アイトラッカーは座標のスケーリング、タイムスタンプの精度、およびイベント分類において大幅に異なります。現在のプロトコルの限界は、このような変動性が研究室間やハードウェアブランド間の再現性にどのように影響するかを明確にしていない点にあります。デバイス間バリデーションのためのガイドラインを作成することや、研究室のパラダイムを没入型のバーチャルリアリティ(VR)や拡張現実(AR)の読書環境に適応させること、また認知障害や注意障害のデジタルバイオマーカーを開発することなど、現実的な将来の応用に向けた指針を策定することは、重要な空白を埋めることになるでしょう。
全体として、本プロトコルは既存の手法的なガイダンスを、読解における高品質なアイトラッキングデータを収集するための明確かつ透明性の高いワークフローへと統合したものです。これらの手順に従い、関連する品質指標を報告することで、研究者は読解研究の再現性と信頼性を向上させ、分野全体における手法的な一貫性をより強固に確立することに寄与できます。
謝辞
資金提供:本プロジェクトは、COST–European Cooperation in Science and Technology (CA2131–Enabling multilingual eye-tracking data collection for human and machine language processing research (MultiplEYE), https://www.cost.eu/actions/CA21131)24、ポルトガル科学技術財団(助成金:UID/214/2025, UI/BD/15450/202)、およびヤギェロ大学戦略的プログラム・エクセレンス・イニシアチブ優先研究領域 DigiWorld (ID.UJ) プロジェクト「Cognitive Aspects of Interaction and Communication in Natural and Artificial Agents」の支援を受けています。また、技術的なサポートを提供してくださった Anna Maria Wilkosz 氏に感謝いたします。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| アルコール綿 (70% isopropyl) | 洗浄材 | 地域の研究用品供应商 | |
| 高さ調節可能なチンレスト | 頭部固定装置 | 各種研究用品供应商 | |
| 同意書およびデブリーフィング資料 | 文書 | 機関承認済みテンプレート | |
| アイトラッカー (例: SR Research EyeLink 100 Plus, Tobii Pro Fusion) | 視線計測ハードウェア | SR Research Ltd., Tobii AB | |
| 視線計測データ解析ソフトウェア (Data Viewer, Tobii Pro Lab) | 眼球運動データ解析ソフトウェア | SR Research Ltd., Tobii AB | |
| 視線計測ソフトウェア (例: Experiment Builder, Tobii Pro Lab, PsychoPy) およびそのSDK | 刺激提示ソフトウェアおよびソフトウェア開発キット | SR Research Ltd., Tobii AB, Open source | |
| 汎用データ解析ソフトウェア (lme4, ggplot2 を含む R, JASP, Pandas, NumPy, Matplotlib を含む Python) | データの前処理および解析 | Open source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| 汎用実験設計ソフトウェア (PsychoPy) | 刺激提示ソフトウェア | Open source, https://www.psychopy.org | |
| その他のサードパーティ製ソフトウェア (例: E-Prime) | 刺激提示ソフトウェア | Psychology Software Tools, Inc. | |
| 防音室 | 環境制御 | 機関施設 | |
| 標準的な 24 インチ LCD モニター (またはそれ以下) | 表示装置 | ISO準拠の任意のメーカー |
参考文献
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).