本論文では、You Only Look Once version 11 (YOLOv11) と畳み込みニューラルネットワークを統合した生産ラインの安全監視手法を提案する。本手法は、グラフィックスプロセッシングユニットにおいて、IoU(intersection-over-union)しきい値0.5での平均適合率(mAP@0.5)0.91、mAP@0.5:0.95で0.82、および秒間120フレームを達成し、評価したベースラインモデルを上回る性能を示した。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
インダストリー4.0の深化に伴い、生産ラインの自動化および知能化レベルが大幅に向上しており、モニタリングのリアルタイム性能、精度、および安全性に対する要求が高まっています。目視点検や単純なしきい値ベースの判定に依存する従来のモニタリングシステムは、一般に応答時間が遅く、誤報率が高く、知能化に限界があるという課題があります。そこで本論文では、You Only Look Once version 11 (YOLOv11) と畳み込みニューラルネットワーク (CNN) を統合した生産ライン安全モニタリングシステムを提案します。まず、取得した画像を前処理しました。次に、YOLOv11を用いて、作業員、設備、および潜在的な危険要因をリアルタイムで識別しました。続いて、小規模な対象物や遮蔽された対象物の特徴抽出能力を向上させるため、マルチスケール特徴融合とアテンションメカニズムを備えた拡張CNNネットワークを導入しました。最終的に、検出結果をCNNで強化された特徴と融合させ、安全状態を評価しました。自作の生産ライン安全データセットを用いて実験を行い、最適化アルゴリズムにはモメンタム0.9の確率的勾配降下法 (SGD) を採用し、初期学習率0.01、荷重減衰0.0005、コサインアニーリングによる学習率調整、バッチサイズ32、学習エポック数200として実施しました。評価指標としてmAP@0.5および1秒あたりのフレーム数 (FPS) による検出速度を用い、評価対象のベースラインアルゴリズムと比較しました。その結果、提案システムはmAP@0.5で0.91、検出速度で120 FPSを達成しました。また、遮蔽や変動する照明などの複雑な条件下でも堅牢な性能を示し、生産ラインの安全モニタリングにおける有効性と実用的な適用可能性が裏付けられました。
概要
現代の工業生産において、安全性は生産効率の確保と人員の健康維持の根幹をなすものです。生産ラインの環境には、通常、高速機械設備、複雑な技術プロセス、および複数のタスクを伴う協調作業が含まれます。いかなる小さな潜在的な安全上のリスクであっても、重大な生産事故につながる可能性があり、その結果、多大な経済的損失や、場合によっては死に至る事故を招く恐れがあります。したがって、工業生産における安全性を高めるためには、効率的かつインテリジェントなリアルタイム安全監視システムを構築することが極めて重要です1,2.
従来の安全監視方法は、主に手動のビデオ監視とさまざまなセンサー(赤外線、煙、振動センサーなど)に依存しています3。手動監視は効率が低いだけでなく、監視員の疲労による検知漏れが発生しやすく、継続的かつ包括的なカバー範囲を提供することができません。センサーはある程度の早期警告機能を提供できますが、検知範囲が限られており、環境干渉に敏感であるため、誤報という顕著な問題が生じます4。そのため、インテリジェント監視システムが研究の焦点となっています。ディープラーニングアルゴリズムを用いてビデオストリームをリアルタイムで分析することで、異常事象、不安全行動、潜在的な危険性を自動的に特定でき、これにより監視システムのインテリジェンスを大幅に向上させることが可能です4,5。
物体検出は、インテリジェントモニタリングにおける中核技術です。シングルステージ物体検出器の代表格であるYou Only Look Once (YOLO) シリーズのアルゴリズムは、大きな優位性を示しています。YOLOv1からYOLOv8に至るまで、このアルゴリズム群は、ネットワークアーキテクチャ、損失関数、トレーニング手法などの側面において継続的な開発と改良が行われてきました6,7。特にYOLOv11は、複雑な背景や密集したターゲットに直面した場合でも、高いフレームレートを維持しつつ、より高い検出精度を達成しています8。
しかしながら、一般的な物体検出タスクにおいて優れた性能を示すYOLOv11であっても、特定の製造ラインにおける安全監視シナリオでは依然として課題が存在します9。例えば、作業員が設備によって部分的に遮られていたり、安全標識が小さく背景色と酷似していたりする場合、YOLOv11の検出精度が低下することがあります。そのため、モデルにはより強力な特徴抽出能および意味理解能力が求められます10。
畳み込みニューラルネットワーク(CNN)は、画像特徴抽出において強力な能力を備えています11。より深く複雑なネットワークアーキテクチャを設計することで、CNNはより豊かで抽象的な画像特徴を学習することが可能です。CNNをYOLOv11と組み合わせることで、YOLOv11の高速な検出能力とCNNの深い特徴抽出能を活用でき、それにより、より堅牢でインテリジェントな安全監視システムを構築できます。
これに基づき、本論文ではYOLOv11とCNNを用いた生産ラインの安全監視システムを提案します。本研究の革新的な点は以下の通りです。(1) YOLOv11と改良されたCNNの深層融合アーキテクチャを提案したこと、(2) 重要な安全機能の認識精度を向上させるために、マルチスケール特徴融合と複合アテンションメカニズムを導入したこと、(3) 自作の複雑なシーンデータセットを用いてモデルの性能上の優位性を検証したことです。
YOLOシリーズアルゴリズムの開発
2015年にRedmonらによって初めて導入されて以来12、You Only Look Once (YOLO) アルゴリズムは大きな関心を集めてきました。リージョンプロポーザルに依存する2ステージ検出器とは異なり、YOLOは物体検出を回帰タスクとして処理します。画像内の物体のクラスと位置を直接予測することで、YOLOは検出速度を著しく向上させ、リアルタイムでの利用に適したものとなっています13.
本シリーズの先駆的な研究であるYOLOv1は、初めてエンドツーエンドのターゲット検出を実現しました14。YOLOv1では、入力画像をグリッド構造に分割し、通常S × S形式で配置される各グリッドセルが、その境界内に含まれるオブジェクトを検出する役割を担います。
具体的に、YOLOv1の出力はテンソルです。S × S × (B × 5 + C) の中で、各バウンディングボックスの予測には、中心点座標(x,y)、幅 w、高さ h、および信頼度 c の5つの要素が含まれています。計算プロセスは式(1)に示されています:
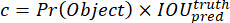 (1)
そのうち、Pr(Object)はグリッド内にターゲットが存在する確率を表し、IOUは予測されたバウンディングボックスと正解ボックス(ground-truth box)との交差領域と結合領域の比率を表します。また、各グリッドはクラス確率の集合も予測し、Pr はターゲットが存在する場合にそのターゲットがi番目のクラスに属する確率を表します。YOLOv1の損失関数は、座標予測の損失、信頼度推定の損失、およびカテゴリ予測の損失という3つの主要な構成要素から成り立っています15。
YOLOv2では、バッチ正規化(Batch Normalization)、高解像度分類器、およびマルチスケール学習戦略が導入され、安定性と精度が向上しました16。YOLOv3は、バックボーンネットワークにDarknet-53を使用し、ターゲット検出を強化するためにFeature Pyramid Network(FPN)の概念から着想を得ています17。
YOLOv4はYOLOv3に基づいて数多くの最適化を行っており、モデルの性能をさらに向上させるために、Cross Stage Partial Network (CSPNet)18、Path Aggregation Network (PANet)19、およびMosaicデータ拡張などの技術を導入しています。YOLOv5はエンジニアリング面で大きな貢献を果たしており、より使いやすく効率的な実装を提供しています20。
近年、YOLOシリーズは進化を続けており、YOLOv6、YOLOv7、YOLOv8などのバージョンが次々とリリースされています。YOLOv7は、Extended Efficient Layer Aggregation Network(E-ELAN)構造とモデル再パラメータ化技術を導入することで、速度と精度の両面で新たなブレイクスルーを達成しました。これらの強化により、特徴学習の効率が向上しただけでなく、ネットワークの推論パフォーマンスが最適化され、YOLOv7は様々なリアルタイム物体検出タスクにおいて、以前のバージョンや多くの主要な検出器を凌駕しています。YOLOv8では、さらにネットワーク構造が最適化され、アンカーフリー設計の採用、モデルの簡素化、および汎化性能の向上が図られています21。
本研究で使用したYOLOv11は、以前のバージョンの利点を活かし、複雑な産業シナリオ向けに最適化されています。主な改良点として、特徴抽出ネットワーク、より効率的な特徴融合モジュール、およびより堅牢な損失関数の設計が挙げられます。これらの改善により、YOLOv11は製造環境における遮蔽物、小さなターゲット、および複雑な背景の処理において、より高い性能を発揮します。YOLOv11はUltralytics社によってリリースされたYOLOシリーズのバージョンです。YOLOv8と比較して、C3K2モジュールと特徴融合パスが改善されており、さらに適応的なアンカーボックス戦略が導入されたことで、産業シナリオにおける検出の堅牢性が向上しています。
畳み込みニューラルネットワーク(CNN)の基礎と進展
畳み込みニューラルネットワーク(CNN)は、コンピュータビジョンにおけるディープラーニングの成功に多大な影響を与えた極めて重要なモデルである。CNNは、畳み込み演算を通じて局所的な画像特徴を抽出し、続いてプーリング演算によって特徴量の次元を削減することで、階層的な画像抽象化を実現している22。
典型的なCNNは、複数の畳み込み層、プーリング層、および全結合層で構成されています。畳み込み層は、畳み込みカーネルを用いて入力画像を走査し、局所領域で内積を計算し、特徴マップを生成します。計算プロセスを式(2)に示します:
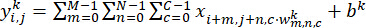 (2)
xを入力画像、wkおよびbkをそれぞれ畳み込みカーネルの重みとバイアスとし、 は位置(i,j)における出力特徴マップの値である。プーリング層では一般的に、マックスプーリング(Max Pooling)またはアベレージプーリング(Average Pooling)が使用される。全結合層は、特徴の抽出および分類確率の予測を担う。
これに基づき、本論文ではYOLOv11向けにCNN特徴量強化モジュールを設計した。これは2つの並列ブランチで構成されており、一つは3 × 3および5 × 5の畳み込みカーネルを用いてマルチスケール特徴を抽出するマルチスケール畳み込みブランチであり、もう一つはチャネルアテンション(Squeeze-and-Excitation)と空間アテンションモジュールを順次接続して主要ターゲットの識別的特徴を強化するアテンションブランチである。これら2つのブランチの出力は要素ごとの加算によって融合され、対応する特徴量強化損失関数を式(3)に示す。
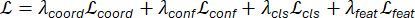 (3)
Lcoordはバウンディングボックス座標回帰損失、Lconfはターゲット信頼度損失、Lclsはカテゴリ分類損失、Lfeatは特徴量強化損失であり、後者はCNN強化モジュールによって抽出された小規模ターゲットおよび遮蔽ターゲットの識別的特徴を制約するために使用されます。λcoord、λconf、λcls、λfeatは、対応する損失項の重み係数です。本タスクでは、λfeat = 0.05に設定し、残りの重みは検出タスクの要件に応じて調整しました。
VGGNet23やResNet24などの古典的なCNN構造は、画像分類タスクにおいて大きな成功を収めています。これらのアーキテクチャの中でも、ResNetは深層ネットワークの学習における勾配消失問題を効果的に緩和し、それによってより深く複雑なネットワーク構造の構築を可能にしています。
物体検出タスクにおいて、CNNは通常、特徴抽出器(バックボーン)として使用されます。例えば、YOLOシリーズのアルゴリズムにおけるDarknetやcross-stage partial Darknet(CSPDarknet)などは、すべてCNNに基づいて構築されています25。特徴抽出能力を向上させるため、研究者は数多くの改良されたCNN構造を提案してきました。例えば、Inceptionモジュールはマルチスケールの畳み込みカーネルを用いて並列に特徴を抽出します。DenseNetは密な接続(dense connections)により特徴の再利用性を高めています。Squeeze-and-Excitation Networkは、アテンションメカニズムを通じて特徴チャネルの重要度を適応的に調整します26。
本研究では、YOLOv11の特徴抽出能力を向上させるために、改良されたCNNモジュールを設計しました。このモジュールは、マルチスケール特徴融合とアテンションメカニズムを組み合わせることで、生産ラインのシナリオにおける重要な安全情報をより効果的にキャプチャします。
産業安全モニタリングにおけるディープラーニングの適用状況
産業安全モニタリングにおいて、ディープラーニングが大きな注目を集めています。CNNベースのアルゴリズムは、作業員が安全ヘルメットを適切に着用しているかの判定、危険区域への不正侵入の検知、および故障した設備の状況監視に採用されています27。
行動認識に関しては、3D CNNおよびリカレントニューラルネットワークを用いて作業者の操作行動を分析し、潜在的に危険な動作を特定します。例えば、作業者の姿勢シーケンスを分析することで、安全操作手順に違反しているかどうかを判断できます28。
YOLOおよびFaster R-CNNは、リアルタイム監視ビデオにおける人員および機器の検出に広く利用されています。例えば、文献ではYOLOv5に基づいたリアルタイムヘルメット検出システムが提案されており、建設現場の安全管理の知能化を効果的に向上させています29。
既存の研究である程度の進展は見られるものの、依然としていくつかの課題が残っている。第一に、産業現場では一般的に複雑な照明条件、遮蔽、および背景干渉が存在し、アルゴリズムに極めて高い堅牢性が求められる。第二に、リアルタイム性能が重要な要件であり、精度を維持しつつ高速な推論を実現しなければならない。最後に、既存の研究は主に単一タスクの検出に焦点を当てており、多ソース情報の融合や包括的な分析に関する探索が不足している30。
本研究で提案するYOLOv11とCNNの融合モデルは、上述の課題に対処し、特徴抽出および融合能力を向上させることで、製造ラインにおける安全リスクの包括的かつリアルタイムなモニタリングを実現することを目的としています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
YOLOv11およびCNNアルゴリズム
システム全体のアーキテクチャ
本論文で提案する生産ライン安全監視システムは、YOLOv11と改良型CNNを組み合わせたハイブリッドアーキテクチャを採用し、高精度かつ高速なリアルタイム安全監視を実現している。図1に示すように、本システムは主に、入力前処理モジュール、YOLOv11物体検出モジュール、CNN特徴強化モジュール、および融合決定モジュールの4つで構成される。まず、入力画像は前処理モジュールによって正規化および拡張され、モデルの汎化能力が向上する。その後、CSPDarknetバックボーンによって特徴が抽出され、空間ピラミッドプーリング-fast (SPPF) モジュールによって受容野が拡大される。アップサンプリング後にマルチスケール特徴が融合され、融合された特徴に対してチャネルアテンションと空間アテンションを順次適用することで、重要ターゲットの識別表現をさらに強化する。CNN特徴強化モジュールは、YOLOv11バックボーンネットワークのC3、C4、C5層の出力後に挿入され、それぞれ80 × 80 × 256、40 × 40 × 512、20 × 20 × 1,024のサイズのマルチスケール特徴マップを受け取る。このCNN特徴強化モジュールにより、小型のターゲットや遮蔽されたターゲットの特徴抽出がさらに強化される。最終的に、融合決定モジュールがYOLOv11の検出結果とCNNで強化された特徴を組み合わせ、設計された損失関数を通じて共同的に最適化することで、ターゲットの正確な位置、カテゴリ、および信頼度スコアを出力する。
YOLOv11検出フレームワーク
YOLOv11では、YOLOシリーズのシングルステージ検出フレームワークの強みを活かした、いくつかの重要な機能強化が導入されています。そのアーキテクチャは、バックボーンネットワーク、特徴融合ネットワーク、および検出ヘッドの3つの主要コンポーネントで構成されています。バックボーンネットワークには、強化されたCSPDarknet構造が採用されています。特徴融合ネットワークには、クロスステージ局部接続と深度別分離畳み込みが組み込まれており、特徴ピラミッドネットワーク(FPN)やパス集約ネットワーク(PAN)から着想を得て、マルチスケール特徴を効果的に統合しています。
特徴量強化モジュール
特徴量強化モジュールは、主要な安全特性に対するモデルの感度を向上させることを目的としている。本モジュールはYOLOv11バックボーンネットワークの各層から出力される特徴マップを処理し、アップサンプリングおよびダウンサンプリング操作を通じて異なるスケール間の情報を融合させる。具体的には、マルチスケールブランチが空間的なスケールの多様性を捉え、アテンションブランチが重要なチャネルおよび位置応答を動的に強化する。これら2つのブランチは独立して機能するのではなく、残差接続と特徴量再校正(feature recalibration)を通じて相補的に融合される。各スケールで強化モジュールによって処理された特徴マップは、1×1畳み込みを介して元の特徴マップのチャネル数と一致するように調整され、その後、要素ごとの加算(element-wise addition)によって元のYOLOv11特徴マップと融合される。融合された特徴マップは、次段階の特徴ピラミッドネットワーク(FPN)に供給されてマルチスケール融合が行われ、これにより階層的な安全特性表現が形成される。モジュール間のシームレスな統合を確実にするため、エンドツーエンドの共同トレーニング戦略が採用されており、損失関数はYOLOv11の検出損失とCNNモジュールの特徴量強化損失で構成される。
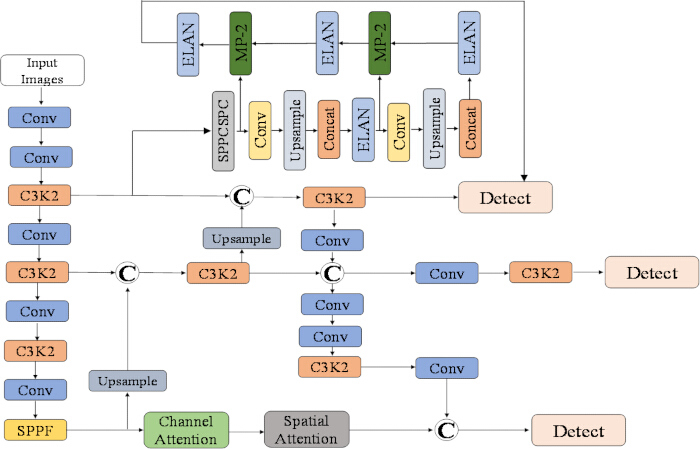
図1. YOLOv11-CNNアルゴリズム。 特徴強化モジュールは、重要な安全上の特徴に対するモデルの感度を高めることを目的としています。このモジュールはYOLOv11バックボーンのさまざまなレイヤーからの特徴マップを処理し、アップサンプリングおよびダウンサンプリング操作を通じて異なるスケールの特徴を融合させます。さらに、チャネル注意および空間注意メカニズムが組み込まれています。YOLOv11とCNNモジュールのシームレスな統合を確実にするため、共同学習戦略が採用されています。学習中、両モジュールのパラメータはエンドツーエンドで最適化されます。損失関数は、YOLOv11の検出損失とCNNモジュールの特徴強化損失を組み合わせたものです。こちらのリンクをクリックして、この図の拡大版を表示してください。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
提案されたYOLOv11とCNNの融合モデルが生産ラインの安全監視において有効であることを検証するため、さまざまな安全上の危険シナリオを網羅したデータセットを構築した。このデータセットは12,000枚の生産ラインのシーン画像で構成されており、ランダムシードを42に固定し、訓練用、検証用、テスト用に7:1.5:1.5の比率で分割した。データセットには、標準的な照明、低照度、部分的な遮蔽、高度な遮蔽、モーションブラー、および複雑な背景を含む、さまざまな作業条件が含まれている。推論の信頼度しきい値は0.5に、非最大値抑制(NMS)のしきい値は0.45に設定した。すべての実験は3回繰り返し行い、結果を平均 ± 標準偏差として報告した。アノテーションのカテゴリは、作業員、安全ヘルメット、ロボットアーム、危険エリア、工具、および車両とし、PASCAL Visual Object Classes (VOC) 形式を用いた。Intersection-over-Union (IoU) のしきい値は0.5に設定し、アノテーションの一貫性は2名によるクロスバリデーションを通じて検証した。入力画像は一律に640 × 640にスケーリングし、Mosaicデータに...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
実験結果により、提案されたYOLOv11–CNN融合モデルが、生産ラインの安全監視における検出精度とリアルタイム性を向上させることが示されました。YOLOv11の効率的なシングルステージ検出とCNNモジュールの特徴強化を活用することで、本システムは複雑な照明条件や遮蔽条件下においても、作業員、設備、および危険区域を特定しました。マルチスケール特徴融合とアテンションメカニズムにより、重要な安全要素への注目能力が向上し、早期警告のための解釈可能な視覚的根拠が提供されました。
本システムは、自動車製造や電子機器の組み立てなどの生産ラインにおいて実用的な価値を持ち、リアルタイムモニタリングによって目視検査への依存を減らし、潜在的な安全上の危険への対応時間を短縮できます。ネジや工具などの小型のターゲットや、ロボットアームやその他の設備によって部分的に遮蔽された作業員のターゲットに対しては、マルチスケール特徴融合とアテンションメカニズムにより、安全に関連する特徴を抽出および強調するモデルの能力が向上します。これらの改善は、ターゲットのサイズや視認性が多様な生産環境において有用です。
<...アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者に開示すべき利益相反はありません。
謝辞
本研究は、台州市大学高度人材科学研究財団「インテリジェント製造のための精密検出における基幹技術の研究」(TZXY2020QDJJ006)より一部助成を受けています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| COCO API | N/A | ターゲット検出精度の評価および統計分析に使用した評価ツール。 | |
| CUDA 11.4 | NVIDIA | N/A | PyTorch 1.12フレームワークと共に使用した並列コンピューティングプラットフォーム。 |
| Edge TPU | N/A | レイテンシおよび消費電力のテストに使用したデプロイプラットフォーム。報告されたレイテンシは18 ms、消費電力は15 Wであった。 | |
| Jetson Xavier エッジコンピューティングデバイス | NVIDIA | スループットテストに使用したエッジコンピューティングデバイス。報告された処理速度は70 FPSであり、99パーセンタイルレイテンシは50 ms以内であった。 | |
| NVIDIA Tesla V100 GPU | NVIDIA | トレーニング/評価サーバーに使用したGPU。 | |
| PyTorch 1.12 | N/A | モデルのトレーニングおよび評価に使用したディープラーニングフレームワーク。 | |
| scikit-learn | N/A | モデル評価に使用した評価/統計分析ツール。 | |
| 自作生産ライン安全データセット | N/A | N/A | VOC形式の生産ラインシーン画像12,000枚からなるデータセット。標準照明、低照度、部分的遮蔽、高度な遮蔽、モーションブラー、複雑な背景を網羅しており、アノテーションカテゴリは作業員、安全ヘルメット、ロボットアーム、危険区域、工具、車両の6種類である。 |
| トレーニングサーバー | NVIDIA Tesla V100 GPUとUbuntu 20.04オペレーティングシステムを搭載したサーバー。 | ||
| Ubuntu 20.04 オペレーティングシステム | N/A | トレーニング/評価サーバーに使用したオペレーティングシステム。 | |
| VOCアノテーション形式 | N/A | N/A | 自作生産ライン安全データセットに使用したアノテーション形式。 |
| YOLOv11物体検出モデル | Ultralytics | N/A | 作業員、設備、および潜在的な危険をリアルタイムで検出するために使用した物体検出モデル。 |
参考文献
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。