CORTA(Correlation Optimized Ranked Transfer-Attention)-Netは、デリーの短期PM₂.₅予測のためのハイブリッドディープラーニングフレームワークです。このモデルは、CorrXGBoost-Rankの特徴選択、長期短期記憶ネットワークを用いた転移学習、時間的および特徴レベルの解釈のための多頭注意力を組み合わせ、大気質、気象学、衛星由来の火災カウントデータを用いてPM2.5の予報を向上させています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
デリーでの短期PM2.5の予測は困難です。なぜなら、粒子状物質濃度は局所的な排出、気象変動、季節的な停滞、そして偶発的な火災関連汚染の影響を受けるからです。本研究は、2012年から2024年までのマルチソース環境データを用いてPM2.5 予測のためのハイブリッド深層学習フレームワークCORTA-Netを提示します。入力データには、CPCB(中央汚染管理委員会)/DPCC(デリー汚染管理委員会)の監視ステーションによる毎時の大気質観測、インド気象局(IMD)からの気象変数、MODIS(中解像度イメージング分光計)製品による衛星由来の火災カウント情報が含まれます。提案されたフレームワークはまずCorrXGBoost-Rank特徴選択を適用し、冗長な予測変数を減らし、重要な汚染物質、気象学的、時間的、火災関連変数を保持します。選ばれた特徴は教師ありのスライディングウィンドウシーケンスとして整理され、移行学習ベースのLSTMエンコーダで処理され、その後マルチヘッドアテンションレイヤーが適用されます。注意メカニズムはPM2.5 の予報を特徴および時間ステップレベルで解釈します。CORTA-Netは、時系列的なトレーニング、テスト、検証のパーティションとクロスバリデーションを用いて評価されました。ランダムフォレスト、XGBoost、LSTM、注意-LSTMのベースラインと比較して、提案されたフレームワークは評価されたデリー監視局設定下で予測誤差を低減しました。CORTA-Netの新規性は、明示的なCorrXGBoost-Rank特徴スクリーニング、移移学習に基づく時間符号化、MODIS火災活動統合、多頭注意力ベースのモデル行動分析を単一の再現可能なPM2.5 予測パイプラインに組み合わせている点にあります。実際的には、このフレームワークは、汚染記録、気象観測、火災活動指標が利用可能なデータ豊富な監視環境下での短期都市大気質予測を支援できます。
概要
空気力学≤直径2.5μm(PM2.5)の微細粒子状物質は、デリーで重要な大気質問題であり、地域排出量1,2,3、地域交通4、季節気象5、そして断続的なバイオマス燃焼イベント6の影響を受けます。モンスーン後および冬季期は7、風速8、浅い境界層条件9、温度逆温は汚染物質の拡散を減少させ、粒子の蓄積を増加させます。PM2.5の短期予測は、時系列10の非線形的で季節的かつ急激な高汚染現象のため困難です。PM2.5予測に関する過去の研究では、統計モデル、機械学習モデル、リカレントニューラルネットワークモデルが利用されてきました。統計的手法はデータの傾向や季節性の特定に有用ですが、汚染物質と気象学の間に存在する非線形相互作用を完全には説明できない場合があります。ランダムフォレストやXGBoostなどの機械学習モデルは非線形関係のモデル化に利用できます。しかし、遅延特徴が設計されない限り、通常は時間的依存性を持ちません。長短期(LSTM)ニューラルネットワークは、時間的依存性と非線形関係の両方をモデル化することができます。
長期短期記憶ネットワークは時間パターンをモデル化できますが、非定常状態や急激な汚染エピソードによってそのパフォーマンスが影響を受ける可能性があります。最近の注意ベースおよびトランスフォーマーベースのアプローチは時間表現を改善しますが、多くはすべての候補変数を直接処理し、シーケンスモデリング前の特徴冗長性の制御が限定的です。トランスフォーマーベースおよびハイブリッドディープラーニングモデルは最近PM2.5やAQI予測21を改善しましたが、それらの貢献はしばしば時間表象学習22、空間グラフ構築23、モデル融合24、または最適化に集中しています。多くのモデルは利用可能な多変量入力セットを直接利用し、主な学習負担をシーケンスモデルに置いています。これにより入力の冗長性が増し、解釈性が低下し、時間モデル、特徴スクリーニング、外部環境指標、注意に基づく重み付けのいずれかから改善が生まれるのかを特定するのが難しくなります。したがって、CORTA-Netは新しい独立したニューラルネットワークレイヤー26ではなく、ワークフローレベルの予測フレームワークとして位置づけられています。その特徴は、シーケンスモデリング前のCorrXGBoost-Rank特徴スクリーニング、時間的適応のための移転学習LSTM符号化、エピソード的バイオマス燃焼影響のためのMODIS由来の火災カウント包含、特徴および時間ステップレベルのモデル行動解釈のためのマルチヘッドアテンションの4段階の秩序統合にあります。この設計により、同じデリー監視局設定27の下で、予測精度と選択された汚染物質、気象学的、時間的、火災活動変数の寄与の両方を評価することが可能となります。
近年の大気質予測の進展では、ハイブリッドなディープラーニングモデル、注意メカニズム、グラフベース学習28、トランスフォーマーアーキテクチャが用いられ、非線形的時間的・空間的依存関係を捉えることが増えています。これらの手法は、より長期的な依存関係を学び、時間ステップや入力変数に適応的な重みを割り当てることで予測性能を向上させました。しかし、多くの近年モデルは依然として大量の入力特徴セットに依存し、時間的モデリング前に冗長な予測変数を明示的に減らしておらず、エピソード的なバイオマス燃焼効果が重要な場合に外部火災活動指標を含まない場合があります。CORTA-Netは、特徴スクリーニング、移移学習LSTM符号化、MODIS由来の火力カウント統合、複数ヘッド注意を単一の予測ワークフローに組み合わせることで、このギャップを埋めています。
本研究では、CORTA-Netを新たなニューラルネットワーク層としてではなく、再現可能なハイブリッドPM2.5 予測パイプラインとして提示しています。このフレームワークは、CorrXGBoost-Rankの特徴選択、移移学習に基づくLSTM時間符号化、MODIS由来の火種カウント統合、そしてマルチヘッド注意ベースのモデル行動分析の4段階を組み合わせています。CorrXGBoost-Rankはまず冗長な汚染物質および気象変数を削減し、その後シーケンスモデリングを行います。選ばれた特徴はスライディングウィンドウシーケンスに整理され、トランスファーラーニングLSTMエンコーダで処理されます。MODISの火災カウント変数は地域火災活動の外部指標として含まれ、マルチヘッドアテンションレイヤーを用いて、最近の時間ステップや入力変数が予報に最も強く寄与しているかを調べます。このフレームワークは、少なくとも1つの監視ステーションから連続的なPM2.5 観測が得られる環境、できれば数年分の時間単位のデータを含む環境に適しています。また、地域のバイオマス燃焼影響が関係する場合には、気象観測や衛星由来の火災カウント情報の恩恵を受けています。したがって、CORTA-Netはデータ豊富な都市の大気質予報環境を想定しており、モニタリング記録がまばらで不規則、または短期間の記録がある場所には適さない場合があります。
デリーはモンスーン後および冬季期に繰り返し高いPM₂.₅レベルを経験するため、研究地域に選ばれました。この都市は交通、工業活動、住宅排出、気象の停滞、地域的な農業焼失の影響を受けています。この調査では4つの監視所が使用されました:ドワルカセクター8、アナンドヴィハール、ムンドカ-DPCC、ソニアヴィハールです。各駅は住宅地、交通影響地域、工業効果のある地域など、異なるタイプの都市マイクロ環境を表しています。2012年から2024年までの各モニタリングステーションからの観測データは 補足図1に示されています。モデルのトレーニングは2015年から2022年のデータで行われ、2023年のデータでモデル開発およびモデル検証のテストが行われました。32 は2024年に収集されたデータを基に行われました。入力として使用された変数にはPM2.5、PM10、NO、NO2、NOx、CO、ベンゼン、空気温度、風速、太陽放射、気圧が含まれ、サイト33で利用可能なものから決定されました。MODIS由来の火災カウントデータは、その地域の火災活動レベルを代表する外部変数として使用されました。 表1は 、4つのモニタリングステーションそれぞれのPM₂.₅濃度統計の概要を示しています。
| データセット | 駅名 | 平均 | 性病 | ミン | 25% | 50% | 75% | マックス |
| 1 | ドワルカ・セクター8 | 98.24 | 79.12 | 7.52 | 38.65 | 70.83 | 133.47 | 588.15 |
| 2 | アナンド・ヴィハール | 115.87 | 89.42 | 8.91 | 49.28 | 84.36 | 152.89 | 574.92 |
| 3 | ムンドカ-DPCC | 113.62 | 91.05 | 4.21 | 43.58 | 86.74 | 158.42 | 682.31 |
| 4 | ソニア・ヴィハール | 101.35 | 80.25 | 5.80 | 42.15 | 75.60 | 138.75 | 565.40 |
表1:デリーの4つのモニタリングステーションにおけるPM₂濃度の要約統計。 表1はデリーの4台のモニターで測定された平均PM2.5(微細粒子状物質)レベルを示しています。PM2.5 は直径2.5ミクロン未満の空気中の汚染物質で構成されており、そのため肺の奥深くに簡単に吸入できるほど小さく、さまざまな健康リスクを生じさせます。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
方法論
監督付きスライディングウィンドウモデルを構築し、以前の時間観測からt+1時刻のPM2.5 値を予測しました。12時間、24時間、48時間ステップの候補入力ウィンドウが検証性能で評価され、最終的なCORTA-Net構成では24時間の入力シーケンスが用いられました。線形補間は欠損値を埋めるために用いられました。外れ値はIQR法で除去されました。すべての変数は最小最大正規化を用いてスケーリングされ、遅延PM2.5 特徴量を生成しました。その後、特徴選択にはCorrXGBoost-Rank手順が適用されました。まず、ピアソン相関フィルタリングで|r|≥ 0.30。第二に、ペアワイズ相関を持つ高度に冗長な特徴対 |corr(xi, xj)|≥0.85は多重共線性を減らすためにフィルタリングされました。第三に、残りの変数に対してXGBoost回帰計を訓練し、XGBoostゲインベースの重要度スコアが0.015≥の予測変数を最終モデル入力として保持しました。最終的なCORTA-Netアーキテクチャは、時間符号化のための積層されたLSTM層、特徴量および時間ステップレベルの重み付けのためのマルチヘッドアテンション層、PM2.5 推定のための密度回帰層で構成されていました。モデルは平均二乗誤差損失と早期停止を伴うアダム最適化器を用いて訓練されました。モデル評価は、訓練、検証、テスト、10分割クロス検証のパーティションでRMSEおよびR2 を用いて実施されました。 表2 はデータの前処理および特徴量エンジニアリングの概要を表しています。
| ステップ | 使用方法 | パラメータ / しきい値 | 目的 |
| 欠損計算 | 観測が欠落する割合 | 変数ごとのレポート割合 | データの完全性を定量化します |
| ショートギャップ補欠 | 線形補間 | 差の長さ≤6時間 | 短い欠損区間を埋めます |
| 外れ値検出 | IQR法 | Q1 − 1.5 × IQR、Q3 + 1.5 × IQR | 無効な極値の除去 |
| 正規化 | 最小最大スケーリング | トレーニングセットの最小・最大 | 機能範囲の標準化 |
| PM₂.₅ の遅延 | 遅延変数 | lag₁, lag₂, lag₃ | 時間的持続性を捉える |
| ローリング統計 | 移動平均線 | 3時間、6時間、12時間、24時間 | 短期蓄積を捉える |
| 発射カウント機能 | モディス・ファイアカウント | 当日/前日カウント | 地域的な火災の影響を表しています |
表2:データ前処理および特徴量エンジニアリングの概要。 表2では、データ処理は2つの方法で行われます。第一に生データのクリーニングと変換(前処理)、もう一つは特徴量エンジニアリングによる特徴の作成・選択・修正(特徴)です。これら2つのプロセスは一体として、ノイズの除去や低減に役立ちます。欠損値を処理します。データの一貫性を向上させること。そして、より予測的なモデルを作り出すこと。
正規化パラメータは訓練セットからのみ推定され、情報漏洩を防ぐためにテストセットや検証セットに変更せずに適用されました。
CorrXGBoostランクの数学的定式化
X = {x1, x2, ..., xn} を候補入力変数の集合、y を目標 PM₂.₅ 濃度とします。各特徴 xi に対して、ターゲット変数とのピアソン相関係数は次のように計算されました。
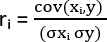 (1)
ここでcov(xi, y)は特徴量X、i とターゲットYの共分散であり、σx、i 、σyは標準偏差です。保持された特徴は満足:|ri|≥ τr であり、この研究では τr = 0.30。
保持されたすべてのi, xj, および |corr(xi, xj)| の保持features_x 間でペアワイズ相関が計算されました。>= τ赤(τred = 0.85)では、PM2.5 目標に対する絶対相関が低い特徴は特徴セットから除外されます。この過程は、多重共線性を持つ特徴セットの変数を削減します。その後、残りの特徴にXGBoost回帰モデルを当てはめ、XGBoostの重要度を用いて各特徴量の重要度スコアを計算しました。i_i ≥τ xgb = 0.015を満たす特徴は、最終的な特徴セット(S)に保持され、SはSfinal=S corr ∪S xgbとして定義されました。すなわち、相関に関する冗長性をフィルタリングし、XGBoost変数の重要度に基づく特徴を除外して定義された特徴セットです。 特徴選択における全体的なアプローチは次の通りです:特徴目標のペアワイズPearson相関を計算し、|r_i|< 0.30の特徴を破棄し、ペアワイズ相関が0.85≥を持つペアの特徴を破棄し、XGBoostを残された特徴に当てはめる、XGBoost重要度スコア≥0.015の特徴を保持し、最終的な望ましい特徴を定義します。S、final=Scorr、∪Sxgbを定義します。 ここで、Scorrは冗長相関フィルタリング後に保持される特徴、SxgbはXGBoost特徴重要度スコアで選択された特徴です。したがって、CorrXGBoost-Rankのワークフローは次の通りです:特徴-ターゲットPearson相関を計算し、|ri|0.30<、ペアワイズ相関が0.85≥の高い重複性を持つ特徴を削除し、残りの変数でXGBoostを訓練し、XGBoost重要度スコア≥0.015の変数を保持し、相関選択変数とXGBoost選択変数の和集合を最終機能セットとして使用します。この研究で用いられたパラメータは、τr = 0.30、τred = 0.85、τxgb = 0.015です。
データソース
著者らは研究のために3つの大規模なデータセットを統合しました。これらは、著者がCPCB(中央汚染管理委員会)/DPCC(デリー汚染管理委員会)を通じて大気質の監視、インド気象局(IMD)からの気象データ(温度、湿度、風速・風向・気圧)、NASAのMODISアクティブファイア製品による活発火災に関する衛星情報など、大気汚染物質(PM2.5、PM10、NO2、CO、SO₂)に関するデータです。これら3つのデータセットは2012年1月から2023年12月までの12年間を対象としており、異なる種類の排出を表しています。火災事故は大気汚染に寄与しており、補足図2は2012年から2024年までのFIRECOUNTの傾向を示しています。
研究期間中の汚染物質の長期的な傾向
図1は、研究期間(2012–2024年)における汚染物質の長期的な傾向を示しています。2012年から2024年までの年間火災カウントと平均PM₂.₅濃度は中程度の強い正の関係(r = 0.688)を持ち、火災活動の増加は通常PM₂濃度の増加に関連しています。測定データと予測されたPM₂.₅データの両方が同様の傾向を示し、バイオマス燃焼が粒子状汚染に寄与するという考えを支持しています。年次変動は大きいものの、火災関連の排出はPM₂.₅の変動を決定する重要な要因であり、地域的な火災管理の必要性を強調しています。補足図3に示された30ラグでの予測PM2.5の自己相関は、ほぼすべてのラグでかなりの正の自己相関を示し、デリーのPM2.5が強い時間的依存性と数日間持続性を持つことを裏付けています。
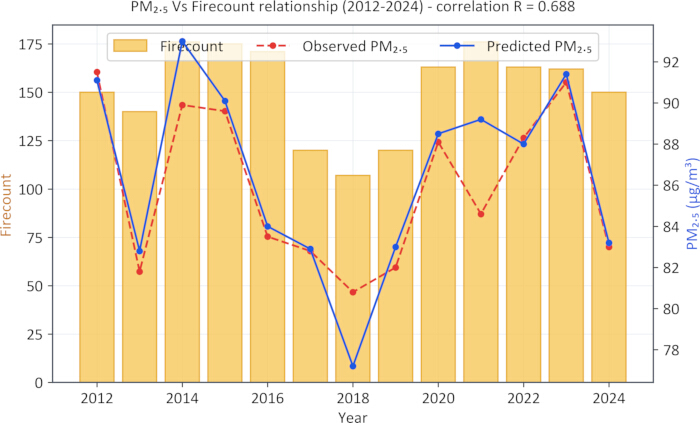
図1: 2012年から2024年までの長期PM₂.₅および火災カウントの傾向。 図1は、年間火災カウントの変動と観測および予測されたPM₂.₅濃度を比較しています。PM₂.₅はμg/m3単位で報告されています。FIRECOUNTはMODIS製品からの衛星由来の火災活動を表しています。 この図の拡大版はこちらをクリックしてご覧ください。
STL(ロースを用いた季節およびトレンド分解)分解
STL(ロースを用いた季節およびトレンド分解)は、時系列データを図 2に示すように3つの加算成分に分解できる反復アルゴリズムです:トレンド(長期トレンド)(図2A)、(図2D)、(図2G)、(図2J)、季節(周期)(図2B)、(図2E)、(図2H)、(図2K)、および余り(ノイズ/残差)(図2C)。 (図2F)、(図2I)、(図2L)。STLは、季節信号の振幅変動や外れ値の存在により多くの他の解析手法が失敗してきた環境データの複雑な非線形特性(PM2.5など)に成功していることが証明されています。LOESS平滑化により、これらの成分を正確に分離でき、傾向やパターンの解釈がより明確になります。STL処理により、PM2.5 の広範な上昇トレンドを短い日周期/季節周期およびそれらの周期内の不規則残差から分離することが可能です。この分離により、PM2.5に影響を与えた排出物を特定し、気象要因がPM2.5に影響を与えたものを特定できます。この分離の結果は、将来のPM2.5 排出量の正確な予測に役立ちます。規制上の意思決定のためのデータを提供すること。そして、大気質調査のための厳密な時系列データの細分化基準に準拠しています。2012年から2024年にかけてデリーのモニタリングステーションで実施された平均PM2.5 濃度測定では、全体的にPM2.5 レベルの変化は最小限(すなわち2022–24年からの有意な変化なし)であり、4つのモニタリング地点間でPM2.5 レベルの一貫性も極めて限定的でした。ドワルカセクター8およびムンドカ-DPCCのPM2.5 レベルは持続的な下降傾向(すなわち減少を続けている)を示している一方、アナンド・ヴィハールは上昇傾向(大幅に上昇)、ソニア・ヴィハールはわずかな上昇傾向(2022年以降のごくわずかな上昇から)見られます。さらに、4つの観測所それぞれの日次PM2.5 濃度の残差は、PM2.5 濃度が季節(気象)変化に強く影響されており、個々の観測所の平均PM2.5 濃度に大きな変動が生じていることを示しました。デリーの4つの監視所(2012–2024年)の日次PM2.5 濃度は 図2に示されています。
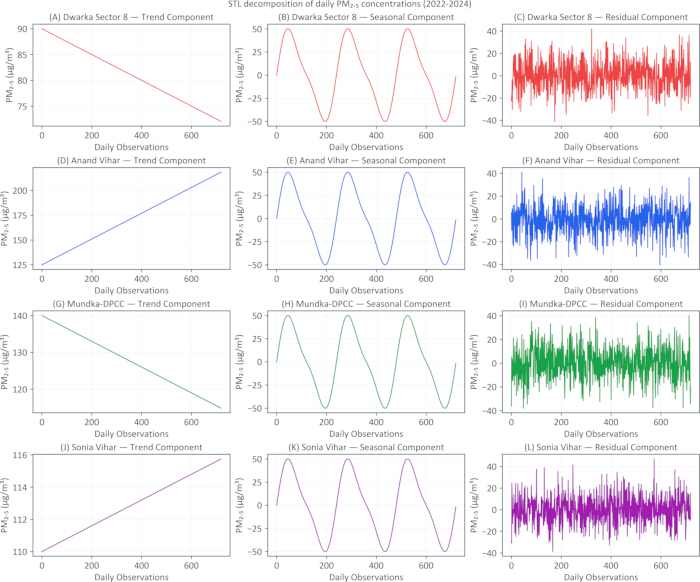
図2:2022年から2024年までのデリーの4つのモニタリングステーションにおける日次PM₂濃度のSTL(Loessを用いた季節および傾向分解)。 各監視局の時系列は、長期トレンド、季節変動、残差(残差)の3つの加算要素に分解されます。(A) ドワルカセクター8のトレンド要素。(B) ドワルカ・セクター8の季節的要素。(C) ドワルカ・セクター8の残留成分。(D) アナンド・ヴィハールのトレンド要素。(E) アナンド・ヴィハールの季節的な要素。(F)アナンド・ヴィハールの残留成分。(G)ムンドカ-DPCCのトレンド成分。(H) ムンドカ-DPCCの季節的要素。(I) ムンドカ-DPCCの残留成分。(J) ソニア・ヴィハールのトレンドコンポーネント。(K) ソニア・ヴィハールの季節的な要素。(L) ソニア・ヴィハールの残留成分。ロースを使ったSTL、季節分解、トレンド分解。 この図の拡大版はこちらをクリックしてご覧ください。
図2 は、2022年から2024年にかけて4つの都市モニタリング地点における1日PM2.5濃度の時間的分解を示しており、長期的な減少、徐々の増加、大きな日周期変動のパターンを明らかにしています。これらの違いは主に天候の物理的影響、すなわち惑星境界層(PBL)の高さの変化(昼間の膨張による垂直拡散の増加と濃度の低下、夜間の収縮により汚染物質が地表近くに残り夜間にピークが高まるなど)に起因します。その他の気象学的影響は、最も多くの時間帯(朝夕のピーク)、産業、そして局所特有の変化や全体的な長期的減少を生み出す場所特有の要因(例えば冬季の相関の大きさ)に関連する地域特有の要因からの影響です。 その結果、全体的に下降傾向につながっています。
特徴間の相関
図3 はCORTA-Netモデルで使用されるすべての入力特徴の分布を示しています。パネルでは、汚染物質変数(PM10 (図3A)、NO₂(図3B)、一酸化炭素(図3C)、SO₂(図3D))は都市の大気質データに典型的な右偏り分布を示し、O₃(図3E)と圧力(図3I)はほぼ正規パターン35を示します。気温(図3F)は明確な二峰性の季節構造を示し、湿度(図3G)は広く均一な分布を示し、風速(図3H)はライトテール分布を示します。これらのパターンは、予測変数の統計的挙動が異様であることを浮き彫りにし、モデルトレーニング前の特徴工学と正規化の必要性を正当化しています。
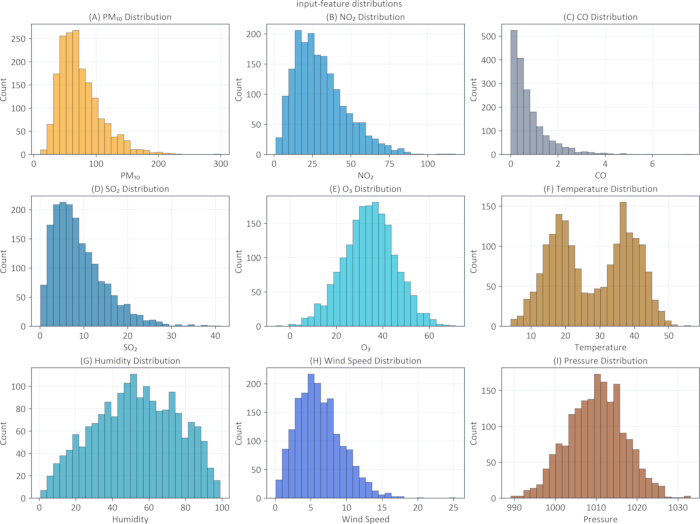
図3:CORTA-Netモデルで使用される入力特徴の分布(大気汚染物質濃度や気象変数を含む)。 分布は、前処理およびモデルトレーニング前の予測変数の統計的特徴を示しています。(A) PM₁₀濃度。(B)NO₂濃度。(C)一酸化炭素濃度。(D) SO₂濃度。(E) O₃濃度。(F)気温。(G)相対湿度。(H)風速。(I) 大気圧。汚染物質変数、特にPM₁₀、NO₂、CO、SO₂は都市部の大気質データに典型的な右傾分布を示しますが、O₃と大気圧はおおよそ正規分布を示します。気温は二峰性の季節パターンを示し、湿度は広く分布し、風速は低い値に集中し、ライトテール分布を示します。これらの異種特徴分布は、モデル開発前の特徴工学と正規化の利用を支援します。 この図の拡大版はこちらをクリックしてご覧ください。
図4 は、PM₂.₅予測のためのCorrXGBoost-Rank前処理後のXGBoostゲインに基づく特徴重要度ランキングを示しています。現在の特徴重要度プロットでは、前日PM₂.₅が最も高い順位の予測変数で重要度スコア0.280、次いでPM10 = 0.180、FIRECOUNT = 0.150、NO₂ = 0.120、CO = 0.080、風速 = 0.070、気温 = 0.040、湿度 = 0.030、年 = 0.020 が続きます。縦線は実際のXGBoost機能選択閾値0.015を表しています。重要度スコアが0.015以上の予測変数は最終的なCORTA-Net入力セットに残され、SO₂=0.010、O₃=0.010、気圧=0.005、降雨=0.005、週末=0.002、祝日=0.001などの予測変数は除外されました。これらの値はXGBoostゲインに基づく特徴重要度スコアを表しており、ピアソン相関係数や因果効果として解釈すべきではありません。
したがって、この閾値を超えて寄与した特徴のみがモデルに含まれました。XGBoostモデルは決定木のアンサンブルを用い、損失関数を最小化するために反復的に木を構築します(勾配ブースティング)。XGBoostは特徴の重要性を3つの指標のいずれかで計算します:ゲイン(特徴の分割がモデルのパフォーマンスをどれだけ向上させるか)、重み(特徴が木の分割として選ばれた回数)、または被覆(分割によって影響を受ける観測数)です。XGBoostモデルは大気質(汚染物質、気象変数)に関連するデータに基づいて構築されており、遅れたPM2.5 からPM2.5の自動回帰予測に重点を置いています。これはデリーのPM2.5 モデルでよく見られるもので、PM2.5の時間的持続を捉えるのに役立ちます。Delhi_PM2.5 は微細粒子の高い自己相関特性から重要な寄与者であり、これらは一貫した排出源からの汚染慣性の存在も示しています。風速は汚染物質の拡散のメカニズムを提供するため、重要な要因です。一方、弱風は逆転現象が起きる冬季に汚染物質が蓄積しやすいのです。NO2 は交通量や排出量によりPM2.5 と相関し、日付は汚染物質の年間排出サイクル(すなわち週末の排出量が少ない)を示します。デリーでは、PM2.5 は冬の気象が停滞し、車両、産業、バイオマスからの継続的な排出により高い自己持続性を持っています。風はエアロゾルの拡散を助けますが、2 m/s<弱い風が逆転によるPM2.5 の蓄積に寄与しました。NO2 とPM2.5 の関係は、共通の起源(燃焼)によるものであり、時間的な影響(例:日次と週次)に影響を受けます36。AQIの変動の93%以上を説明する主な要因は、PM2.5 の蓄積遅延による汚染物質濃度の変動(93%+)や低風速による排出物の捕捉、車両や産業からのNO2/PM排出、そして日々の交通量の変動です。さらに、デリーの地理的条件はこの地域での逆転現象の持続に寄与しており、PM2.5 濃度を悪化させています。ハイパーパラメータの調整、正則化、温度などの追加変数の追加は、過学習の可能性を抑え、モデル全体の性能を向上させるのに役立ちます。PM排出量削減のための運用戦略の実施には、PM排出量の日々の制限設定、PMの存在をリアルタイムで監視する装置の使用、風力を利用してPMを都市の緑地に拡散させることが含まれます。
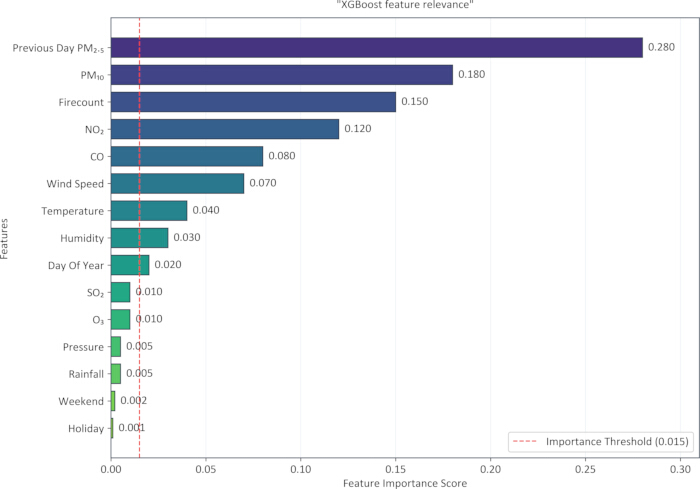
図4: PM₂.₅予測のためのCorrXGBoost-Rank特徴スクリーニング後のXGBoostゲインに基づく特徴重要度ランキング。 予測バーは重要度の降順に並べられています。縦線は実際のXGBoost機能選択閾値0.015を表しています。スコア0.015≥の予測変数は最終的なCORTA-Net入力セットで保持し、この閾値以下の予測変数は除外しました。このランキングは特徴スクリーニングやモデル行動の解釈に用いられ、因果的な帰属として解釈すべきではありません。 この図の拡大版はこちらをクリックしてご覧ください。
CORTA-netモデルアーキテクチャ
図5 は提案されたPM2.5 予測フレームワークを示しています。 補足図4 および 図5 はLSTMユニットの内部配置とマルチヘッドアテンションブロック図の表現を示しています。すべてのデータソース(すなわち、環境条件、気象観測、火災活動、および時間的および文脈的側面)は、時間的に一致し、欠落データを(必要に応じて)帰属化し、モデル構築プロセスで使用する前に外れ値除去と正規化の両方を経て、事前処理を経ています。モデルのアーキテクチャ、特徴工学、訓練構成、データ構成、転移学習、評価指標、将来予測、実装の詳細は 補足表1に示されています。CorrXGBoost-Rankモジュールを活用し、最適な特徴セットをLSTMアーキテクチャに入力する前に決定します。LSTMは、モデリング段階における時系列挙動を考慮するためにマルチヘッドアテンションレイヤーの導入によって強化されています。PM2.5 の予測とPM2.5 の特徴の重要度、さらに複数のヘッドの注意重みを注意力マップとして出力として提供しました。内部LSTMユニット構造とマルチヘッド注意ブロック図はそれぞれ 補足図4および図5として含まれており、 補足表1 はこのアーキテクチャ内の各層タイプのアーキテクチャパラメータを示しています。
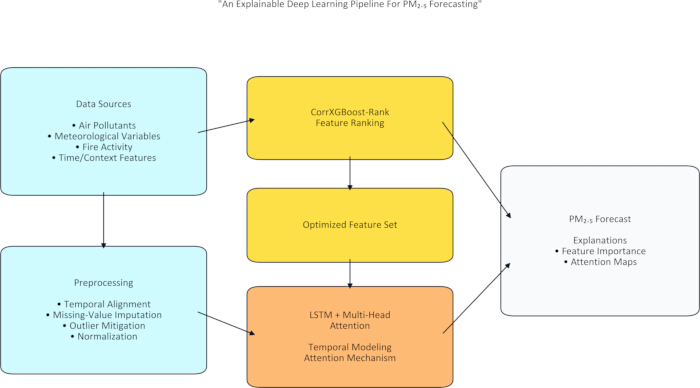
図5:CORTA-Net PM₂.₅予測モデルの全体アーキテクチャ。入力予報プロセスには、大気質指標、気象指標、時間指標、MODIS(中解像度イメージング分光計)火災カウント指標からの入力が含まれます。これらの各ステップで、アルゴリズムはタイムスタンプのアラインメント、欠損値の処理、外れ値のフィルタリング、データの正規化、特徴の設計を行いました。最終的な予測変数はCorrXGBoost-Rankプロセスを用いて選定されました。その後、選ばれた特徴は時間順序のスライディングウィンドウに配置され、LSTM(Long Short-Term Memory)エンコーダに転送学習を用いて処理されました。各特徴量とタイムステップごとに、マルチヘッドアテンション機構は重みを適用し、最終的な回帰密度層に出力を送ってPM₂.₅予測を生成します。この図の拡大版はこちらをクリックしてご覧ください。
研修と評価
スライディングウィンドウ方式を用いて教師あり学習シーケンスを形成しました。トレーニングではアダム最適化器と平均二乗誤差損失を用いました(補足表2)。モデル性能は、訓練、検証、テスト、クロスバリデーションの各パーティションでRMSEおよびR2 を用いて評価されました。モデルのアーキテクチャ、特徴量エンジニアリング、トレーニング構成、データ構成、転移学習、評価指標、将来予測、実装詳細は 補足表1にまとめられています。 図6 はCORTA-Net PM₂.₅予測モデルの訓練診断を示しています。パネルでは、 図6A はトレーニングおよび検証損失曲線を示し、エラーが段階的に減少し、最適な停止はエポック106で行われます。過フィット解析の評価における一般化ギャップの進化は 、図6Bの検証データと訓練データ間の乖離によって示されています。特に、発散があらかじめ定められた限界を超える期間を示します。この情報は、学習率の挙動と損失削減パターンが、 臨界エポックにおける計画的学習率(LR)減衰が収束安定性を高める手段として有効であることを示す証拠を提供します。これらの図は、学習のダイナミクス、一般化能力、推奨されるトレーニング構成の概要を示しています。
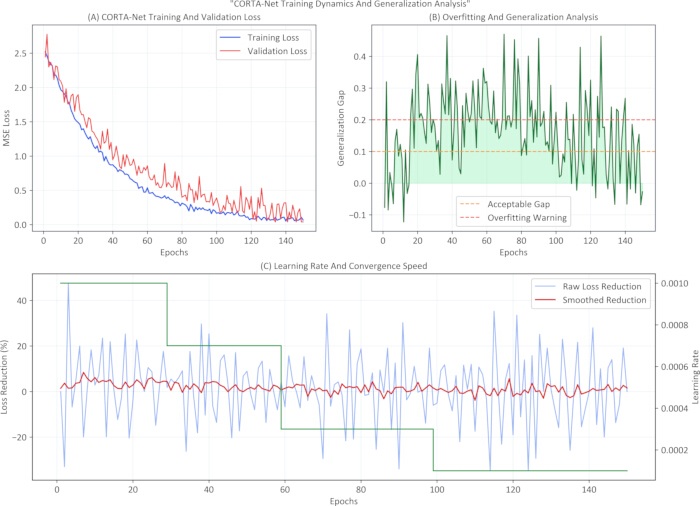
図6:CORTA-Net PM₂.₅予測モデルの訓練診断。(A) モデル訓練中の誤差が段階的に減少し、検証性能に基づくエポック106で早期停止を示す訓練および検証損失曲線。(B) エポックをまたぐ訓練損失と検証損失の一般化ギャップを示し、モデルの一般化の進化と潜在的な過学習を示す発散増加の期間を示しています。(C) 学習率スケジュール:学習率の減衰が訓練中の最適化に与える影響を示す。(D) モデル収束挙動の概要、安定した最適化の実証、そしてCORTA-Netモデルで選択された最終的な訓練構成。これらの診断を合わせることで、モデルのダイナミクス、収束特性、訓練中の一般化性能が示されます。この図の拡大版はこちらをクリックしてご覧ください。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
特徴選択と予測結果
CorrXGBoost-Rank手順では、遅れたPM₂.₅、風速、湿度、気温、時間指標、MODIS由来の火災カウントを大気質の重要な予測因子として選定しました。これらの各変数は、汚染の持続性、気象条件による拡散、季節ごとの汚染レベルの違い、火災による地域的影響を考慮しています。不要な入力次元を減らすために、シーケンスモデリングの前に冗長な変数が除去されました。CORTA-Netは平均絶対誤差、平方根誤差、決定係数を用いて評価されました。デリーのデイリーデータセットでは、RMSE = 3.19、R2 = 0.983を達成しました。Daily Delhi気候トレーニング分割では、RMSE = 4.98、R2 = 0.845を達成しました。ターゲットテストセットの散乱解析では、観測および予測されたPM₂.₅値がPearson r = 0.942、R2 = 0.873を示しました。これらの値は異なる評価区画を指しており、モデル全体の結果として交換可能なも...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
CORTA-Netは3つの主要なコンポーネントを連続して組み合わせ、ハイブリッドアーキテクチャを形成します。CorrXGBoost-Rank:時間モデリングステージ38の前に冗長な予測変数を排除するカスタマイズされた特徴選択コンポーネント。LSTMエンコーダ:スタックされたLSTMレイヤーを用いて、選択された24時間入力シーケンス39における短期および長期の時間的依存関係をキャプチャします。マルチヘッド注意層:LSTM出力(関連する注意重み付き)に適用され、CORTA-Netハイブリッドシーケンスモデルの最終段階の一部として適用されます。最終出力の解釈性を高めつつ、主要なLSTMバックボーン40の役割を置き換えることはありません。LSTMエンコーダは選択されたスライディングウィンドウシーケンスから時間的依存関係を学習します。CORTA-Netは、CorrXGBoost-Rankが冗長な予測変数を剪定するハイブリッドシーケンスモデ...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちには利益相反はありません。
謝辞
プリンセス・ヌーラ・ビント・アブドゥルラフマン大学 研究支援プロジェクト番号(PNURSP2026R300)、プリンセス・ヌーラ・ビント・アブドゥルラフマン大学、リヤド、サウジアラビア。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Calibriフォント | Microsoft Corporation | URL: https://learn.microsoft.com/en-us/typography/font-list/calibri | 修正された図とラベルの基本書体として使用されました。 |
| CORTA-Netの図生成スクリプト | このCORTA-Netプロジェクト用のカスタムスクリプト | URL: https://github.com/saravagnamahasiva/CORTA-Net | ラベルと順序を修正した出版用図のPDFを再生成するために使用されました。 |
| CORTA_Net_High_Resolution_Images.zip | ユーザー提供のプロジェクト画像アーカイブ | カタログ番号/RRID: 該当なし; ローカルソースアーカイブ | ソース/参照画像セットとして使用され、図の識別に使用されました。 |
| GitHub | GitHub, Inc. | URL: https://github.com/ | プロジェクトコードと図生成ファイルの意図されたリポジトリホストとして使用されました。 |
| Matplotlib | Matplotlib開発チーム | RRID: SCR_008624; URL: https://matplotlib.org/ | チャート、図、ラベル、パネルマーカー、ベクターPDF図を再描画するために使用されました。 |
| NumPy | NumPy開発者 | RRID: SCR_008633; URL: https://numpy.org/ | 再生成された図のパネルの決定論的配列とシミュレーション値に使用されました。 |
| OpenAI Codex | OpenAI | URL: https://openai.com/codex | コード編集、図再生成、PDFパッケージング、検証の支援に使用されました。 |
| Pillow | Pillow貢献者 | URL: https://python-pillow.org/ | ラスター画像出力を検査、リサイズ、プレビュー、検証するために使用されました。 |
| Poppler | Poppler開発者/freedesktop.org | URL: https://poppler.freedesktop.org/ | 生成されたPDFをPNGプレビューにレンダリングして視覚的な品質チェックに使用されました。 |
| pypdf | pypdf貢献者 | URL: https://pypdf.readthedocs.io/ | 各最終図PDFが1つの有効なページを含むことを確認するために使用されました。 |
| Python | Pythonソフトウェア財団 | RRID: SCR_008394; URL: https://www.python.org/ | 図生成とPDF処理のプログラミング環境として使用されました。 |
| ReportLab | ReportLab Inc. | URL: https://www.reportlab.com/ | 必須資料/ツール/ソフトウェアの表をPDFアートワークとして作成するために使用されました。 |
| Windows PowerShell | Microsoft Corporation | URL: https://learn.microsoft.com/en-us/powershell/ | ファイルのオーケストレーション、アーカイブの抽出、最終的なZIPパッケージングコマンドに使用されました。 |
参考文献
- AlShafeey M. Unraveling climate trends in the mediterranean: a hybrid machine learning and statistical approach. Model Earth Syst Environ. 2024;10:6255-6277.
- Li B, Qian Y. Weather prediction using CNN-LSTM for time series analysis: a case study on Delhi temperature data. arXiv:2409.09414. 2024.
- Bashardoost A, Mesgari MS, Karimi M. Quantifying uncertainty in the spatial prediction of PM2.5 using a deep learning algorithm. Ann GIS. 2025;31(4):679-712.
- Bi K, Xie L, Zhang H, et al. Accurate medium-range global weather forecasting with 3D neural networks. Nature. 2023;619:533-538.
- Xu C, Liu J, Han S, Duan X, Xiang L, Zhang T. FourCastLSTM: a precipitation nowcasting model integrating global and local spatiotemporal features. Comput Geosci. 2025;204:105966.
- Damkliang K, Chumnaul J. Deep learning and statistical approaches for area-based PM2.5 forecasting in Hat Yai, Thailand. J Big Data. 2025;12:36.
- Elabd E, Hamouda HM, Ali MAM, et al. Climate change prediction in Saudi Arabia using a CNN GRU LSTM hybrid deep learning model in al Qassim region. Sci Rep. 2025;15:16275.
- Guo Q, He Z, Wang Z. Monthly climate prediction using deep convolutional neural network and long short-term memory. Sci Rep. 2024;14(1):17748.
- Zhang H, Jin Y, Shi J, Zhang S. Predicting PM2.5 concentrations using stacking-based ensemble model. Appl Comput Math. 2021;10(6):156-162.
- Şener İF, Tuğal İ. Optimized CNN-LSTM with hybrid metaheuristic approaches for solar radiation forecasting. Case Stud Therm Eng. 2025;72:106356.
- Shen J, Wu W, Xu Q. Accurate prediction of temperature indicators in Eastern China using a multi-scale CNN-LSTM-Attention model. arXiv:2412.07997. 2024.
- Karimian H, Li Q, Wu C, et al. Evaluation of different machine learning approaches to forecasting PM2.5 mass concentrations. Aerosol Air Qual Res. 2019;19:1400-1410.
- Kumar S, Mishra S, Singh SK. A machine learning-based model to estimate PM2.5 concentration levels in Delhi's atmosphere. Heliyon. 2020;6(11):e05618.
- Ladjal B, Nadour M, Bechouat M, et al. Hybrid deep learning CNN-LSTM model for forecasting direct normal irradiance: a study on solar potential in Ghardaia, Algeria. Sci Rep. 2025;15:15404.
- Lakshmi S, Krishnamoorthy A. Deep transfer learning and attention based PM2.5 forecasting in Delhi using a decade of winter season data. Sci Rep. 2025;15:31787.
- Lan R, Eastham SD, Liu T, et al. Air quality impacts of crop residue burning in India and mitigation alternatives. Nat Commun. 2022;13:6537.
- Lütjens B, Ferrari R, Watson-Parris D, Selin NE. The impact of internal variability on benchmarking deep learning climate emulators. J Adv Model Earth Syst. 2025;17:e2024MS004619.
- Suleman MAR, Shridevi S. Short-term weather forecasting using spatial feature attention-based LSTM model. IEEE Access. 2022;10:82456-82468.
- Mansfield LA, Nowack PJ, Kasoar M, et al. Predicting global patterns of long-term climate change from short-term simulations using machine learning. npj Clim Atmos Sci. 2020;3:44.
- Masood A, Ahmad K. Data-driven predictive modeling of PM2.5 concentrations using machine learning and deep learning techniques: a case study of Delhi, India. Environ Monit Assess. 2022;195(1):60.
- Duan J, Gong Y, Luo J, Zhao Z. Air-quality prediction based on the ARIMA-CNN-LSTM combination model optimized by dung beetle optimizer. Sci Rep. 2023;13:12127.
- Liu X, Su K, Wang S, et al. Intelligent prediction of air quality index based on the transformer-BiLSTM model. Sci Rep. 2025;15:41838.
- Liu Z, Fang Z, Hu Y. A deep learning-based hybrid method for PM₂.₅ prediction in central and western China. Sci Rep. 2025;15:10080.
- Hu Y, Ding Y, Jiang W. Geographically aware air quality prediction through CNN-LSTM-KAN hybrid modeling with climatic and topographic differentiation. Atmosphere. 2025;16(5):513.
- Makhdoomi A, Sarkhosh M, Ziaei S. PM₂.₅ concentration prediction using machine learning algorithms: an approach to virtual monitoring stations. Sci Rep. 2025;15:8076.
- Jiang Z, Nie Y, Gong W. Enhanced PM₂.₅ forecasting via bio-inspired hybrid LSTM optimization for high-precision results. AIP Adv. 2025;15:075346.
- Pan P, Malarvizhi AS, Yang C. Data augmentation strategies for improved PM₂.₅ forecasting using transformer architectures. Atmosphere. 2025;16(2):127.
- Masood A, Hameed MM, Srivastava A, et al. Improving PM2.5 prediction in New Delhi using a hybrid extreme learning machine coupled with snake optimization algorithm. Sci Rep. 2023;13:21057.
- Meng X, Xie C, Tang X, et al. Prediction of particulate matter 2.5 concentration based on attention mechanism and convolutional BiLSTM network. Discov Appl Sci. 2025;7:1372.
- Mohammadi F, Teiri H, Hajizadeh Y, Abdolahnejad A, Ebrahimi A. Prediction of atmospheric PM2.5 level by machine learning techniques in Isfahan, Iran. Sci Rep. 2024;14(1):2109.
- Mutinda JK, Langat AK, Mwalili SM. Forecasting temperature time series data using combined statistical and deep learning methods: a case study of Nairobi County daily temperature. Int J Math Math Sci. 2025;2025:4795841.
- Nath P, Saha P, Middya AI, Roy S. Long-term time-series pollution forecast using statistical and deep learning methods. Neural Comput Appl. 2021;33(19):12551–12570.
- Patel P, Patel S, Shah K, Desai K, Patel S, Shah M, Patel S. A systematic study on PM2.5 and PM10 concentration prediction in air pollution using machine learning and deep learning model. Environ Chem Ecotoxicol. 2025;7:1401-1415.
- Li Q, Zhang C, Shangguan W, et al. LandBench 1.0: a benchmark dataset and evaluation metrics for data-driven land surface variables prediction. Expert Syst Appl. 2024;243:122917.
- Mojgani R, Waelchli D, Guan Y, Koumoutsakos P, Hassanzadeh P. Extreme event prediction with multi-agent reinforcement learning-based parametrization of atmospheric and oceanic turbulence. arXiv:2312.00907v1. 2023.
- Yu S, White BL, Bhiwandiwalla A, et al. ClimDetect: a benchmark dataset for climate change detection and attribution. arXiv:2408.15993. 2024.
- Li T, Hua M, Wu X. A hybrid CNN-LSTM model for forecasting particulate matter (PM2.5). IEEE Access. 2020.
- Farhangmehr V, Imanian H, Mohammadian A, Cobo JH, Shirkhani H, Payeur P. A spatiotemporal CNN-LSTM deep learning model for predicting soil temperature in diverse large-scale regional climates. Sci Total Environ. 2025;968:178901.
- Wu C, Wang R, Lu S, Tian J, Yin L, Wang L, Zheng W. Time-series data-driven PM2.5 forecasting: from theoretical framework to empirical analysis. Atmosphere. 2025;16:292.
- Wu Y, Wang X, Wang M, Liu X, Zhu S. Time-series forecasting of PM2.5 and PM10 concentrations based on the integration of surveillance images. Sensors. 2025;25:95.
- Gong Y, Zhang Y, Wang F, Lee C-H. Deep learning for weather forecasting: a CNN-LSTM hybrid model for predicting historical temperature data. arXiv:2410.14963. 2024.
- Zhou S, Wang W, Zhu L, Qiao Q, Kang Y. Deep-learning architecture for PM2.5 concentration prediction: a review. Environ Sci Ecotechnol. 2024;21:100400.
- Zhang Z, Dey S, Lee K, et al. Temporal difference-based graph transformer networks for air quality PM₂.₅ prediction. Front Environ Sci. 2022;10:924986
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。