本研究では、認知設計原則、知覚的色彩モデリング、およびディープラーニングを統合した自動ユーザーインターフェース・プロトタイピング・フレームワークを提示します。本システムは、アクセシビリティ、レイアウトの明快さ、色彩の調和、およびクロススクリーンの一貫性を向上させ、一貫性のあるユーザー中心のインターフェース設計を実現します。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
研究記事
ユーザビリティとレイアウトの明快さを向上させるために認知および視覚設計の原則を統合した、自動ユーザーインターフェース・プロトタイピング・フレームワーク
この記事について
サマリー
要約
効果的なユーザーインターフェース(UI)設計には、視覚的な訴求力、認知的ユーザビリティ、およびレイアウトの一貫性の調和のとれたバランスが必要です。しかし、現在の自動UI生成手法は主に視覚的な外観やコンポーネント検出に焦点を当てており、認知原理、カラーインテリジェンス、および構造的推論を統合した統一的なフレームワークを欠いています。さらに、既存の手法は、レイアウトの汎用性の低さ、解釈性の不足、静的な色選択、および画面間での動作の不整合という課題を抱えています。このような背景から、本研究では、Faster region-based convolutional neural network(Faster R-CNN)ベースのコンポーネント検出と、CIECAM02一様色空間(CAM02-UCS)による知覚的な色モデリングを統合し、認知・視覚設計原理を組み込んだ自動UIプロトタイピングフレームワークを提案します。Faster R-CNNを用いて、大規模なインターフェースデータセットからUIコンポーネントを特定し、階層構造を推論します。強化された色生成モジュールは、ブランド画像や参照画像を分析し、CAM02-UCSを用いて知覚的に一様で調和が取れた、ユーザビリティに準拠したカラースキームを保証します。これらの出力は、ゲシュタルトの群化法則、フィッツの法則、ヒックの法則、注意ベースの間隔配置、および視覚的階層モデリングを含む認知設計ルールを通じてさらに最適化され、洗練されたタスク指向のUIレイアウトを自動的に生成します。RICO、ENRICO、およびGuoのUI Colorデータセットを用いた実験の結果、提案システムは92.4%のコンポーネント検出精度を達成し、レイアウトの明快さと読書順の精度を18.7%向上させ、ベースライン手法と比較してデザイナーから24.5%より調和的であると評価されたカラーパレットを生成しました。ユーザー評価では、知覚される認知負荷が31%減少し、画面間での設計の一貫性が28%向上したことが示されました。これらの知見は、ディープラーニングベースの構造的理解を、知覚に基づいた色モデリングおよび認知設計原理と組み合わせることで、極めて効率的で、審美的に一貫しており、ユーザーフレンドリーなUIプロトタイプを構築できることを証明しています。本フレームワークは、インテリジェントで人間中心の自動UIプロトタイピングに対する、新しいエンドツーエンドのアプローチを確立するものです。
概要
グラフィカルユーザーインターフェース(GUI)は、人間とコンピュータシステムの間の基本的な通信手段として機能し、ユーザビリティ、アクセシビリティ、および全体的なユーザーエクスペリエンス(UX)に大きな影響を与えます1,2。現代のソフトウェアシステムは、ユーザーを引き付け、維持するために、直感的で視覚的に魅力的なインターフェースに依存しています。従来、UIデザインではグラフィカルなレイアウトを作成し、それを後にエンジニアがフロントエンドコードに変換するという手法が取られてきました。しかし、オペレーティングシステムによってプラットフォーム固有のプロトコルが異なるため、繰り返し適応させる必要があり、開発の複雑さと工数が増大します。そのため、手作業による工数を削減し、開発効率を向上させる自動UIコード生成が、重要な研究方向として台頭しています。
自動UI生成への初期のアプローチでは、領域検出および分類のために、従来の画像処理技術とディープラーニングモデルが組み合わされていました3,4。現在、GUIコード生成の主要な戦略では、コンピュータビジョン技術を用いてUI画像を分析し、それらを構造化されたフロントエンド表現に変換しています5,6,7。画像処理手法が手作業で設計された特徴量に依存するのに対し、ディープラーニングアプローチは大規模データセットから階層的な表現を抽出します。その結果、堅牢性と精度を向上させるために、ディープラーニングとドメイン固有の画像処理技術を組み合わせたハイブリッドアプローチが研究されています。
色はUIデザインにおけるもう一つの重要な要因であり、ユーザーの認識、ユーザビリティ、および審美的な魅力に影響を与えます1。視覚的な入力が色相やコンテキストによって異なる場合、画像コンテンツとUIの配色スキームとの間で一貫性を維持することは困難になります8,9,10。その結果、自動的なカラーパレット生成および知覚的な色モデリングに重点を置いた重要な研究が行われてきました。既存の色生成手法には、CIELAB色空間に基づいた技術が含まれます11。また、k-meansなどのクラスタリングアルゴリズムを用いて画像から支配的な色を抽出するアプローチもあります12。その結果、近年の研究では、色モデリングにデータ駆動型の機械学習ベースのアプローチを採用することが増えています。
並行して、ディープラーニングの手法により、UIコンポーネントの検出とレイアウトの理解が大幅に向上しました。ニューラルネットワークにより、モバイルインターフェースのより正確な構造解析が可能になりました13。しかし、これらの手法は主に検出精度に焦点を当てており、認知的なユーザビリティ、レイアウトの階層構造、インタラクション効率といったより高次の側面が見落とされがちです。UIレイアウト合成のための生成モデルも提案されていますが14,15、画面間の一貫性の維持や、解釈可能なデザイン決定の提供という課題に直面しています16。その他のアプローチは視覚的な類似性やレンダリング品質に焦点を当てていますが、コンポーネントのセマンティクス、色彩の調和、およびユーザビリティの制約を組み合わせた統一的なフレームワークを欠いています17。また、UIコンテンツを理解するためにはテキスト認識も重要です。畳み込み回帰ニューラルネットワーク(CRNN)などの手法により、インターフェース画面上の複雑なテキストパターンの正確な認識が可能になっています18,19,20。
スケッチや画像からUIコードを生成するためのいくつかのシステムが提案されています。Sketch2Codeは物体検出を用いてスケッチをコード表現に変換しますが21,22、画像品質に左右されるという課題があります。REDRAWは、データ収集とモデル学習のための自動化パイプラインを提供し、畳み込みニューラルネットワークとリカレントニューラルネットワークを組み合わせて構造化されたUI表現を生成します23,24。その後の研究では、生成されたUIの品質を評価するための改良された評価指標が導入されました25。より最近のアプローチには、オートエンコーダー法を用いない拡散レイアウトトランスフォーマーや、トランスフォーマーベースのGUI配置グラフを用いたGUIレイアウト生成、大規模言語モデルによる誘導型UIレイアウト生成など、レイアウト生成のための拡散ベースおよびトランスフォーマーベースのモデルが含まれます26,27,28。これらのアプローチの比較概要を表1に示します。
| 参考文献および主要手法 | 目的 | 長所 | 短所 |
| Automated Image-Based User Interface Color Theme Generation: prominent-color extraction + CAM02-UCS perceptual color modeling¹ | 調和とユーザビリティを最適化しつつ、参照画像からUIカラーテーマを自動生成する。 | 強力な知覚的根拠(CAM02-UCS)に基づいている。調和とユーザビリティ(コントラストと多様性)を明示的にバランスさせており、ウェブベースの実装とデザイナーによる評価を含んでいる。 | 色とテーマのみに焦点を当てており(レイアウトやコンポーネント構造は対象外)、エンドツーエンドで学習されたUI合成ではなく、ルールやヒューリスティックに基づいている。 |
| Unifying Layout Generation with a Decoupled Diffusion Model (LDGM)²⁵ | グラフィックシーンおよびUI向けの、統一的で柔軟なレイアウト生成を実現する。 | レイアウト生成における最先端の多様性と制御性を備え、条件付き生成や複数の属性タイプをサポートしている。 | 制約を設けない限り、拡散モデルベースの出力ではアライメントや微細なレイアウトの問題が発生する場合がある。モデルの複雑さと推論コストが高い。 |
| Diffusion Layout Transformers without Autoencoder Methods: transformer + diffusion for layout generation (no autoencoder)²⁶ | レイアウト生成ベンチマーク(FID、アライメント、およびオーバーラップ指標)における忠実度とアライメントを向上させる。 | 隣接するオブジェクト間の意味的な相関関係をより適切に捉えており、FIDおよびアライメント指標で高い性能を示す。 | UIの意味論よりも、主にレイアウトの幾何学的形状(位置、サイズ、カテゴリ)に焦点を当てている。 |
| GUI Layout Generation with Transformer-based Models from GUI Arrangement Graphs (GUI-AGs)²⁷ | デザイナーを支援するため、位置的・グラフ的な制約からGUIレイアウトを作成する。 | グラフ表現により関係性の制約を捉えることができ、Transformerによって柔軟な制約条件付き生成が可能となる。 | デザイナーによる明示的な制約グラフが必要となる場合がある。色やユーザビリティ指標への重視が限定的である。 |
| UI Layout Generation with LLMs Guided by UI Grammar: Large Language Models (LLMs) + hierarchical UI grammar²⁸ | レイアウト生成にLLMを応用し、文法表現を通じて説明可能性と制御性を向上させる。 | 高いレベルの制御性と説明可能性を備え、LLM(GPTタイプ)によるインコンテキスト学習を活用できる。 | 実証的な検証が限定的な初期段階の研究である。文法設計およびUI全般にわたる堅牢性に課題がある。 |
表1:既存のUIカラーモデリングおよびレイアウト生成手法の比較。 この表は、カラーテーマ生成、拡散モデルに基づくレイアウト生成、Transformerベースの手法、および大規模言語モデル(LLM)誘導によるレイアウト生成など、ユーザーインターフェース設計における代表的なアプローチをまとめたものである。各手法について、基盤となる技術、目的、利点、および限界を提示し、知覚モデリング、レイアウト生成能力、制御可能性、およびユーザビリティに関する考慮事項における相違点を明らかにしている。
これらの進展にもかかわらず、重要な制限が依然として残っています。それは、コンポーネント検出、知覚的カラーモデリング、認知的設計原則、およびマルチスクリーンレイアウトの一貫性を、単一のエンドツーエンドフレームワーク内で統合的に組み込んだ既存システムが存在しないことです1。現在のアプローチでは、通常、検出、レイアウト、色などの1つまたは2つの側面のみを最適化しており、それらの相互依存性は考慮されていません。このような断片化は、統一された人間中心の自動UIプロトタイピングシステムの開発における決定的な研究上の空白を浮き彫りにしています。特に、ゲシュタルト法則、フィッツの法則、ヒックの法則といった認知的設計原則は、計算モデルに正式に統合されるのではなく、概念的に扱われることが多くなっています。
これらの制限に対処するため、本研究では、コンポーネント検出、知覚的カラーモデリング、および認知設計原則を統合したシステムによる、エンドツーエンドの自動UIプロトタイピングフレームワークを提案します。このフレームワークは、レイアウト品質の向上、認知負荷の軽減、色彩調和の強化、および全体的なユーザビリティの向上を実現するように設計されています。これらの改善は、RICO、ENRICO、およびGuoのUIカラーデータセットを用いた実験を通じて検証されており、単一の自動UIプロトタイピングパイプライン内で構造的、知覚的、および認知的側面を組み合わせることの有効性が示されています。ディープラーニングベースのコンポーネント検出、知覚的カラーモデリング、および認知設計原則を統一されたフレームワークに統合することで、既存の手法と比較してUIプロトタイプの品質が大幅に向上するという仮説を立てています。具体的には、H1では、本フレームワークが配置、グループ化、および読書順を含むレイアウト品質を向上させることを提案します。H2では、本フレームワークがユーザーの認知負荷を軽減することを想定しています。H3では、知覚的カラーモデリングが色彩のコーディネートと視覚的な調和を改善することを示唆しています。H4では、UIプロトタイプの全体的なユーザビリティと審美的品質が向上することを述べています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、公開データセットを使用しており、ヒトまたは動物の被験者は含まれていません。
提案された自動UIプロトタイピングフレームワークは、ディープラーニングベースの構造理解、知覚的に均一な色モデリング、および認知設計原則を統合し、一貫性のあるユーザー中心のインターフェースプロトタイプを生成します。本手法は、まずRICOおよびENRICOデータセットで学習させたFaster R-CNNアーキテクチャを用いてUIコンポーネントを検出し、それらの階層関係を抽出することで、多様な画面レイアウトの正確な解釈を可能にします。検出されたコンポーネントは次にカラーインテリジェンスモジュールによって処理され、ブランドや画像に基づくカラーキューを抽出し、CAM02-UCSを用いて知覚的類似性をモデリングし、調和が取れ、コントラストに配慮したアクセシビリティ準拠のカラーパレットを生成します。続いて、ゲシュタルトのグループ化法則、フィッツの法則、ヒックの法則、注意に基づく間隔、および視覚的階層制約を含む認知設計原則を、認知最適化エンジンを通じて適用し、空間構成とコンポーネントの配置を洗練させます。最後に、レイアウト推論層が構造的、知覚的、および認知的制約を統合し、ユーザビリティ、審美性、および機能的な明快さのバランスが取れた、マルチスクリーンで一貫性のあるUIプロトタイプを生成します。この統合パイプラインにより、知覚的な一貫性が確保され、認知負荷が軽減し、人間中心の設計原則に準拠することが保証されます。提案手法の完全なワークフローを図1に示します。
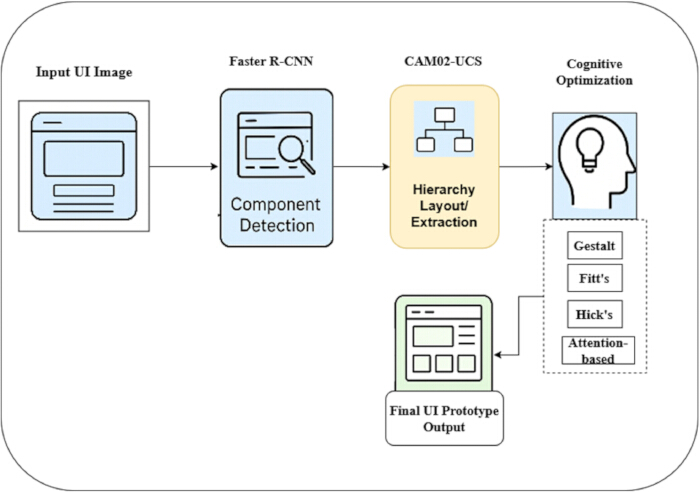
図1提案された自動ユーザーインターフェース・プロトタイピング・フレームワークの全体構成。 この図は、入力UI画像から始まる完全なパイプラインを示しています。まず、Faster R-CNNを用いてコンポーネント検出を行い、インターフェース要素を特定します。次に、検出されたコンポーネントをCAM02-UCSに基づく知覚モデリングを用いて処理し、階層構造とレイアウトを抽出します。その後、ゲシュタルト原則、フィッツの法則、ヒックの法則、および注意に基づく調整を用いて、認知的最適化を適用します。矢印はモジュール間のデータフローを示しており、最終的にUIプロトタイプが出力されます。 この図の拡大版を表示するには、ここをクリックしてください。
フレームワークの概要
図1は、生のUIスクリーンショットを認知的に洗練されたプロトタイプへと変換する、提案された自動UIプロトタイピングフレームワークのエンドツーエンドのワークフローを示しています。プロセスは入力UI画像から始まり、これがFaster R-CNNに基づくコンポーネント検出モジュールに送られます。このモジュールは、ボタン、アイコン、テキストフィールド、コンテナなどのインターフェイス要素を識別し、対応するバウンディングボックスとクラスラベルを出力します。検出されたコンポーネントは、次に階層およびレイアウト抽出段階で処理されます。空間的な関係性と構造的なパターンに基づき、システムはユーザーが自然に画面構成を認識する方法を反映した階層的なレイアウトツリーを構築します。この表現により、UI要素間の視覚的なグループ化と構造的な依存関係が捉えられます。抽出されたレイアウトは、その後、人間中心設計の原則を適用した認知的最適化を通じて洗練されます。これには、視覚的クラスタリングのためのゲシュタルトのグループ化、タッチターゲットのサイズとアクセシビリティを最適化するためのフィッツの法則、意思決定の複雑さを軽減するためのヒックの法則、および視覚的階層を改善するためのアテンションベースの間隔調整が含まれます。その結果、レイアウトはより直感的で読みやすく、ユーザーインタラクションにおいて効率的なものになります。最終的に、最適化されたレイアウトを知覚的カラーモデリングと組み合わせることで、一貫性のあるUIプロトタイプが生成されます。得られたインターフェイスは構造的に正確で、視覚的に調和し、人間のユーザビリティ期待に沿ったものとなります。
このフレームワークは、Ubuntu 2.04上のPyTorch 2.0を用いて実装されました。実験は、NVIDIA RTX 4090 GPU(24 GB VRAM)を搭載したシステムで実施されました。Faster R-CNNモデルには、ImageNetデータセットで事前学習されたResNet-50バックボーンを採用しました。学習は、学習率0.01、バッチサイズ16、最大60エポックの確率的勾配降下法(SGD)オプティマイザを使用して行われました。過学習を防ぐため、データの20%で構成される検証セットを用いて早期停止(early stopping)を適用しました。学習は最大60エポックまで行われましたが、通常は検証損失に基づく早期停止により、それより早く収束しました。モメンタムは0.9、荷重減衰(weight decay)は0.05に設定されました。データ拡張には、正規化、ランダムな水平反転、およびランダムなクロッピングとリサイズが含まれます。
データセットの準備
提案された自動UIプロトタイピングフレームワークをサポートするために、3つの相補的なデータセットであるENRICO29、RICO30、およびGuoのUI Color Dataset1を利用した。RICOデータセットには、9,700個のアプリケーションから収集された6,261枚のAndroid UI画面が含まれており、コンポーネント検出と階層的なレイアウト抽出のための大規模な多様性を提供している。ENRICOは、手動で20のデザインパターンに分類された1,464枚の高精度なUIスクリーンショットを含んでおり、構造的な推論とレイアウトの一貫性モデリングにおける汎化性能の向上を可能にする。GuoのUI Color Datasetは、注釈付きのカラーテーマを持つ精選された128枚のUI画像で構成されており、知覚的なカラーモデリングとパレット評価に使用される。ただし、データサイズが相対的に小さいため、このデータセットはレイアウト特性に変動をもたらす可能性がある。本研究では、トレーニングと評価のために、計5,128枚の画面からなる結合データセットを準備した。具体的には、RICOから約4,0枚の画像をコンポーネント検出用のFaster R-CNNモデルの学習に使用し、ENRICOから1,0枚の画像をレイアウトパターンの学習と構造的一貫性モデリングに使用し、Guoのデータセットから128枚の画像をカラー評価タスクに使用した。すべての画像は、データセット間での互換性を確保するため、解像度を480 × 80 pixelsに正規化し、統一されたsRGB色空間に変換し、標準化されたバウンディングボックスと階層的なメタデータを用いて再アノテーションを行った。本研究で使用したデータセットの概要をTable 2に示す。RICOデータセットはUIコンポーネントの大規模な検出と構造分析をサポートし、ENRICOはレイアウトパターンの認識能力と画面をまたぐ一貫性の強制能力を向上させる。GuoのUI Color Datasetは、規模こそ小さいが、知覚的な色の調和とコントラストモデリングの評価において重要な役割を果たす。これらのデータセットを組み合わせることで、提案した自動UIプロトタイピングフレームワークのトレーニング、検証、および評価のための、包括的でバランスの取れた基盤が提供される。
| データセット | 利用可能な総画像数 | 研究で使用された画像 | 提案されたフレームワークにおける目的 |
| RICOデータセット30 | 66,261 | 4,000 | UIコンポーネント検出、構造レイアウト抽出 |
| ENRICOデータセット29 | 1,464 | 1,000 | デザインパターンの学習、レイアウトの一貫性モデリング |
| GuoのUIカラーデータセット1 | 128 | 128 | 配色テーマの抽出、知覚的色評価 |
| 合計 | 67,853 | 5,128 | 検出、レイアウト、カラーモデリングのための包括的データセット |
表2:提案フレームワークで使用したデータセットの概要。本表は、RICO、ENRICO、およびGuo's UI Colorデータセットを含む、トレーニングおよび評価に利用したデータセットを示している。ここでは、利用可能な画像の総数、本研究で使用したサブセット、および提案フレームワークにおけるコンポーネント検出、レイアウトモデリング、知覚的色解析における各データセットの具体的な役割について報告する。
RICO、ENRICO、およびGuoのデータセットにおけるUIコンポーネント、レイアウト構造、および色の分布の多様性を維持するため、層化サンプリング戦略を採用した。データセットは層化サンプリングを用いて、トレーニング(70%)、検証(15%)、およびテスト(15%)のサブセットに分割した。画像は、平均(0.485, 0.456, 0.406)および標準偏差(0.29, 0.24, 0.25)を用いて正規化した。データ拡張には、ランダムな水平反転(確率 = 0.5)およびランダムクロッピング(スケール範囲:0.8–1.0)を含め、トレーニング中に24 × 24ピクセルへのリサイズを適用した。
コンポーネントのアノテーションおよび前処理
RICO、ENRICO、およびGuoのUI Color Datasetは、提案する自動UIプロトタイピングフレームワークの3つの主要な機能コンポーネントである、コンポーネント検出、レイアウトモデリング、および知覚的カラー最適化を総括的にサポートします。RICOデータセットは、6,0枚以上のモバイルUI画面を大規模に収集したものであり、主にコンポーネント検出モジュールのトレーニングに使用されます。その多様性により、Faster R-CNNモデルは、幅広いアプリケーションにわたるボタン、画像、テキストフィールドなどの一般的なUI要素の堅牢な表現を学習できます。これにより、さまざまな設計条件下でUIコンポーネントを正確に検出および局在化することが保証されます。ENRICOデータセットは、構造的関係とレイアウトパターンを学習させるための、高品質でパターンラベル付きのUI画面を提供します。これにより、システムはコンポーネント間の関係、階層的な構成、および一般的な設計テンプレートを理解することが可能になります。このデータセットは、レイアウト構造のモデリングとマルチスクリーンの一貫性の強制において重要な役割を果たし、フレームワークが確立された設計慣行に沿ったレイアウトを生成することを可能にします。対照的に、GuoのUI Color Datasetは、知覚的および認知的カラーモデリングに特化して使用されます。構造的な側面に焦点を当てたRICOやENRICOとは異なり、このデータセットにはカラーテーマがアノテーションされた精選済みのUI画像が含まれています。これらのアノテーションは、色の抽出および調和評価モジュールのトレーニングに使用されます。色の関係をCAM02-UCSなどの知覚色空間にマッピングすることで、フレームワークはコントラスト、アクセシビリティ、および審美的コヒーレンスのバランスが取れたカラーパレットを生成することを学習します。これらのデータセットを組み合わせることで、統合されたパイプラインが形成されます。すなわち、RICOがコンポーネント検出をサポートし、ENRICOがレイアウトパターンの理解と構造的一貫性を可能にし、Guoのデータセットが知覚的カラー最適化を促進します。この統合により、生成されたUIプロトタイプが構造的に正確で、視覚的に調和し、認知的に最適化されることが保証されます。
正規化は、平均 [0.485, 0.456, 0.406] および標準偏差 [0.229, 0.24, 0.25] を用いて行われました。モデルの汎化性能を向上させるため、ランダムクロッピング、水平反転、回転などのデータ拡張手法を適用しました。さらに、ピクセル値を [0, 1] の範囲にスケーリングし、データセット間の一貫性を確保するため、すべての画像を 480 × 80 pixels の解像度にリサイズしました。トレーニング中の拡張には 24 × 24 pixels にリサイズした画像を使用し、レイアウト解析には元の 480 × 80 pixels の解像度を維持しました。バウンディングボックスは、定義済みの閾値を用いて不適切なアノテーションをフィルタリングするように調整しました。データセット全体で均一性を達成するため、すべてのUI要素を LabelImg アノテーションツールを用いて手動でアノテーションしました。アノテーションに先立ち、UI要素をボタン、テキスト、画像、アイコン、コンテナなどのカテゴリに分類するための定義済みスキーマを策定しました。バウンディングボックスの表現には統一された座標系を適用し、要素間の空間的関係およびレイアウトツリー内での親子関係に基づいて階層情報を構築しました。さらに、RICO、ENRICO、および Guo データセット全体で、要素の一貫したアノテーション、重複コンポーネントの適切な処理、および最小サイズの閾値適用を保証するためのガイドラインを策定しました。
コンポーネント検出のトレーニングおよびレイアウトパターンの抽出に関する詳細な数式は、以下に記載されています。 補足ファイル 1.
Faster R-CNNモデルは、モメンタム0.9、ウェイトディケイ0.05のSGDを用いて学習させた。初期学習率は0.01に設定し、検証性能に基づくステップディケイポリシーを用いて調整した。学習はバッチサイズ16で最大60エポックまで実施した。過学習を防ぐために、トレーニングデータの20%で構成される検証セットを用いて早期停止を適用した。
マッピング関数f(.)は、検出されたUI要素を入力として受け取り、階層的なレイアウト表現を出力します。この関数は、空間的な距離とアライメント基準に基づいてUI要素間の隣接関係を算出し、これらの関係を表す隣接行列を構築します。次に、DBSCANなどのクラスタリングアルゴリズムを適用して、関連するコンポーネントをグループ化します。最後に、クラスタリングされた要素を親子関係に基づいて階層構造に整理し、構造化されたレイアウト表現を形成します。
色彩調和モデリングおよび統一最適化目的関数の詳細な定式化は、補足ファイル1に記載されています。
この目的関数は、構造検出、レイアウト推論、および知覚的カラーモデリングの統合を数学的に定式化し、フレームワークのすべての構成要素が、一貫性のあるユーザー中心のUIプロトタイプの生成に共同的に寄与することを保証します。最適化は、フレームワークの各コンポーネントに対してモジュール方式で実行されます。コンポーネント検出モジュールのトレーニングにはSGDが使用され、統合目的関数の共同最適化にはAdamオプティマイザが使用されます。この複合的な目的関数を用いて、システム全体の性能を導きます。共同最適化段階では、学習率0.01、バッチサイズ16のAdamオプティマイザを用いて目的関数を最小化します。トレーニングは最大60エポックまで行われ、検証損失の変化が5エポック連続で10−4未満になった場合に早期停止を適用します。
Faster R-CNNを用いたコンポーネント検出
提案されたフレームワークでは、ボタン、アイコン、テキストフィールド、画像、コンテナなどのUIコンポーネントを自動検出するためにFaster R-CNNを採用しています。Faster R-CNNは、高い物体検出精度と効率的な領域提案生成を兼ね備えており、要素が密集した複雑なUIレイアウトを扱う上で不可欠であるため、このタスクに適しています。このモデルは、ImageNetデータセットで事前学習されたResNet-50バックボーンを利用し、各UI画面から畳み込み特徴マップを抽出します。学習時には、一般的な視覚的特徴を保持するために初期層を凍結し、上位層(conv4_xおよびconv5_x)をUI特有のコンポーネント検出に合わせてファインチューニングしました。これらの特徴マップは、視覚的構造、エッジ、テクスチャ、およびコンポーネントの境界を捉えます。検出時には、領域提案ネットワーク(RPN)がUIコンポーネントを含む可能性の高い候補領域(アンカー)を特定します。アンカーは、様々なサイズのUI要素に対応するため、複数のスケール(128、256、512)とアスペクト比(1:1、1:2、2:1)を用いて定義されます。学習中、グランドトゥルースのボックスとのIoU(Intersection-over-Union)が0.7より大きいアンカーは正例としてラベル付けされ、IoUが0.3未満のものは負例としてラベル付けされ、中間のIoU値を持つアンカーは無視されます。各アンカーには、コンポーネントが存在する確率が割り当てられます。その後、非最大値抑制(NMS)を適用して冗長で重複する提案を除去し、乱雑なインターフェースにおいても意味のあるUI要素を効率的に局所化します。候補領域が生成されると、各提案は定義済みのコンポーネントカテゴリに分類され、バウンディングボックスの座標が精緻化されます。ROI(Region of Interest)Align操作によって各提案から固定サイズの特長表現が抽出され、全結合層で分類と回帰処理が行われます。分類ブランチはクラス確率を出力し、回帰ブランチは正確なバウンディングボックス座標を予測します。Faster R-CNNモデル全体は、RPN損失と最終的な検出損失を組み合わせた共通の損失関数を最適化することにより、エンドツーエンドで学習されます。これにより、システムはUIコンポーネントを正確に認識するだけでなく、多様なインターフェース構造にわたって精密に局所化することが可能になります。RPNステージ、ROI分類、バウンディングボックスの精緻化、および最終的な最適化目的を含むFaster R-CNNコンポーネント検出の詳細な説明は、Supplementary File 1に記載されています。
アルゴリズム S1 詳細なコンポーネント検出および構造抽出ワークフローを提供します(補完ファイル 1)。ここでは、生のスクリーン画像からUIコンポーネントを自動的に検出し、その構造を抽出する全プロセスについて記述します。まず入力画像に前処理を施し、CNNバックボーンに通して深い視覚的特徴を抽出します。これらの特徴をRPN(領域提案ネットワーク)で利用して候補バウンディングボックスを生成し、その後、分類と回帰によって精緻化します。NMS(非最大値抑制)により冗長な検出結果を排除し、正確なローカリゼーションを確保します。検出後、DBSCAN(密度準拠空間クラスタリング)を用いて、空間的な近接性に基づいてコンポーネントをグループ化します。このクラスタリングステップにより、コンポーネント間の親子関係や論理的なグループ化を捉えた階層的なUIツリーの構築が可能になります。この階層的表現が、その後のレイアウト解析およびUI理解の基盤となります。 図2 モバイルUI画面におけるFaster R-CNNを用いたコンポーネント検出プロセスを示しています。入力インターフェース(左)にはボタンやテキストブロックなどのUI要素が含まれており、これらは自動的にバウンディングボックスで囲まれます。検出されたこれらの領域は、ラベル付きの接続線で示されるように、コンポーネントカテゴリ(例:ボタンおよびテキスト)に分類されます。Faster R-CNN検出モジュール(右)は、バウンディングボックスの座標を精査し、意味的なラベルを割り当て、構造化されたコンポーネントレベルの情報として出力します。この工程は、UIコンポーネントの正確で意味的な表現を提供することにより、レイアウト抽出、認知的最適化、UIプロトタイプ生成などの後続プロセスの重要な基盤となります。
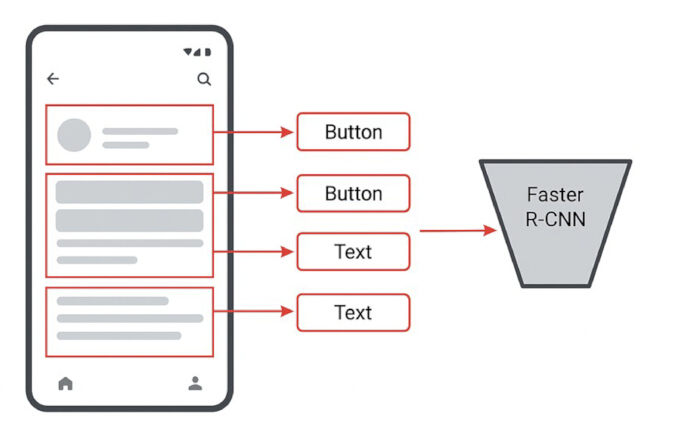
図2Faster R-CNNを用いたユーザーインターフェース要素のコンポーネント検出。 この図は、入力されたインターフェースのスクリーンショットからUIコンポーネントを検出する様子を示しています。バウンディングボックスを用いて関心領域を特定し、ボタンやテキストフィールドなどの要素をFaster R-CNNを用いて分類します。矢印は、検出されたコンポーネントから対応するセマンティックラベルへのマッピングを示しています。 こちらの図の拡大版を表示するには、ここをクリックしてください。
レイアウトパターンの抽出と階層的モデリング
Faster R-CNNを用いたコンポーネント検出の後、各UI要素はバウンディングボックスで表現されます。しかし、これらのバウンディングボックスだけでは、例えばどの要素がヘッダー、ナビゲーションバー、またはグループ化されたコンテンツ領域に属するかといった、インターフェース内での要素の構造的な構成を伝えることはできません。この制限を解消するため、検出されたコンポーネントは論理的なUIツリーへと変換されます。ここでは、各コンポーネントがノードとして扱われ、機能的または視覚的に関連するコンポーネントが共通の親ノードの下にグループ化されます。意味のあるレイアウトグループを特定するために、DBSCANや階層的アグロメラティブクラスタリングなどのクラスタリング手法が適用されます。これらの手法は、コンポーネント間の空間的な近接性とアライメントパターンを分析し、UI要素間の関係性を検出します。人間のデザイン手法と同様に、システムはヘッダー、フッター、グリッド、コンテンツブロックなどの一般的な構造パターンを認識するように学習します。グループ化が確立されると、アライメント、グリッド構成、読取順などの追加の構造的特性が分析され、包括的なレイアウト表現が構築されます。例えば、等幅のカラムに整列したコンポーネントはカードベースのレイアウトを示唆し、垂直に積み重なった要素はフォームまたはフィードベースのインターフェースを示唆する可能性があります。クラスタリング、空間推論、およびアライメントルールを統合することで、本フレームワークは視覚的なグループ化と機能的な関係性の両方を捉えた階層的UIツリーを構築します。この階層的表現は、その後のレイアウトの洗練およびマルチスクリーン一貫性モデリングの基礎となり、システムが構造的で一貫性のある、ユーザー中心のインターフェースデザインを生成することを可能にします。
空間的な距離およびアライメントの類似性に関する詳細な定式化は、Supplementary File 1に記載されています。
レイアウトグループ化のためのクラスタリング(DBSCAN)
レイアウトグループを特定するために、DBSCANを適用します。DBSCANでは2つのパラメータを使用します:(1) ε = 隣接するコンポーネント間の最大距離、および (2) = クラスターを形成するために必要なコンポーネントの最小数です。本解析において、DBSCANのパラメータは、正規化されたUI解像度(480 × 800 pixels)に基づき経験的に選択されました。隣接するUIコンポーネント間の空間的な近接性を捉えるため、近傍距離パラメータは ε = 50 pixels に設定されました。また、重要でない、あるいは偽のUIコンポーネントグループが形成されるのを避けるため、クラスター形成に必要な最小点数は MinPts = 3 に設定されました。
詳細な論理UIツリー構築の定式化は、補足資料 1に記載されています。
CAM02-UCSを用いた知覚的色モデリング
知覚的なカラーモデリングにより、生成されるUIに使用される色が調和し、視認性が高く、認知的に効率的であることが保証されます。UI画像などの入力ソースからは、クラスタリング手法を用いて支配的な色が抽出されます。具体的には、代表的なカラーパレットを得るために、K-means++初期化を用いたK-meansクラスタリングを30回反復して適用します。しかし、RGB色空間は人間の視覚的知覚を正確に反映しておらず、数値的に類似した色が知覚的に異なって見える場合があります。この制限に対処するため、抽出されたすべての色は、知覚的に均一なCAM02-UCSに変換されます。この空間では、等距離が知覚される色の差の等しさに対応するため、色の調和とコントラストのモデリングに適しています。CAM02-UCSにマッピングされた後、知覚的な色の差はユークリッド距離を用いて計算され、これによりシステムは色間のコントラスト、調和、および変動を定量化することが可能になります。類似しすぎている色は、視認性を向上させるために分離され、過度にコントラストが強い色は、視覚的な不快感を避けるために調整されます。生成されたパレットは、WCAG AAおよびAAAなどのアクセシビリティ基準にも準拠しており、前景要素と背景要素の間に十分なコントラストを確保します。さらに、意図するUIテーマに応じて、パレットの関係を補色、類似色、または三色配色(トライアド)のスキームに制限することで、色の調和が強制されます。これにより、結果として得られるカラーパレットは、視覚的に魅力的なだけでなく、機能的にアクセシブルで認知的に最適化されたものになります。パレットをさらに洗練させるために、知覚的類似性、コントラスト、調和、およびブランドの一貫性という制約の下で最適化プロセスが適用されます。まず主色(例:ブランドアイデンティから)が選択され、視覚的階層を維持するために、補助色の輝度と彩度が調整されます。ルールベースの評価メカニズムが、知覚的距離とアクセシビリティ指標に基づいて候補パレットを評価し、審美的バランスを維持しながら認知的負荷を最小限に抑えます。その結果、本フレームワークは、プロレベルの一貫性、可読性、および知覚的な整合性を備えたUI配色を生成します。
CAM02-UCSに基づく知覚的色モデリングの詳細な数式は、Supplementary File 1に記載されています。
アルゴリズム S2 (補足ファイル 1) では、調和およびアクセシビリティの制約条件下における、CAM02-UCSベースの知覚的色抽出および最適化ワークフローについて説明します。まず、入力画像から支配的な色を抽出し、色の差が人間の知覚と一致するようにCAM02-UCSに変換します。次に、色間の知覚的距離を算出し、明瞭さと調和の両方を維持するために、あらかじめ定義された範囲内に制約を設けます。続いて、WCAGガイドラインに従って輝度コントラスト比を評価し、アクセシビリティを強制します。最終的なパレットは、知覚的な間隔、コントラスト要件、および色彩調和の制約のバランスを調整する統合目的関数を最適化することで得られます。これにより、生成されたUI配色が視覚的に魅力的なだけでなく、読みやすく、アクセシブルで、知覚的に一貫していることが保証されます。
認知デザインの最適化
認知設計の最適化により、自動生成されるUIプロトタイプが視覚的に一貫しているだけでなく、理解しやすく、操作しやすいことが保証されます。本モジュールでは、ゲシュタルトの法則、フィッツの法則、ヒックの法則などの主要な認知設計原則を統合し、UIコンポーネントの配置、グループ化、および間隔を制御します。認知設計の最適化に関する詳細な数式は、Supplementary File 1に記載されています。
統合的認知最適化目的
統合認知最適化目的関数の数式は、Supplementary File 1に記載されています。 視覚的グループ化、インタラクション効率、および意思決定の複雑性の重要度を表す係数は、それぞれalpha、beta、gammaで定義されます。本研究では、alpha、beta、およびgammaの値は検証データセットを用いて経験的に決定されました。本実験では、係数をα = 0.5、β = 0.3、およびγ = 0.2に設定しました。この構成により、視覚的グループ化、インタラクション効率、および意思決定の簡潔性の間で効果的なバランスが得られます。
マルチスクリーンの一貫性とUI生成
マルチスクリーン整合性モデリングは、アプリケーション内の異なる画面間で、一貫した視覚的アイデンティ、構造的レイアウト、およびインタラクションパターンが共有されることを保証します。ユーザーが画面を遷移する際、要素の配置、タイポグラフィ、間隔、および視覚的階層に関する期待を形成します。これらの期待に応えるため、システムはRICOおよびENRICOデータセットから派生したテンプレートを使用して、画面をまたいだパターンを分析します。これらのテンプレートは、ホーム・詳細レイアウト、リスト・詳細パターン、マルチステップフォーム、ダッシュボードフローなどの一般的なUI構造を捉えています。コンポーネントの配置とグループ化の挙動を比較することで、システムは、どの要素を整合させるべきか、またどの要素を変化させてもよいかを識別するクロススクリーン構造プロファイルを構築します。構造的パターンが特定されると、フレームワークはタイポグラフィスケール、間隔比率、グリッドレイアウト、およびナビゲーションアンカーの一貫性を適用します。例えば、ヘッダーバーは一定の高さを維持し、プライマリボタンは均一なサイズと配置を保持し、コンテンツブロックは予測可能な視覚的順序に従います。これは、各画面をグローバルな構造的制約に照らして評価するレイアウト正則化プロセスを通じて達成されます。パディングの不整合やタイトルのずれなど、学習済みテンプレートから逸脱した画面がある場合、システムは自動的にレイアウトを調整して整合性を回復させます。これらの修正により、シームレスなUXが確保され、画面間の認知的な切り替えコストが削減されます。さらに、本フレームワークは画面間のナビゲーショングラフを分析し、インタラクションフローの一貫性を維持します。前進・後退遷移、タブナビゲーション、マルチステップワークフローなどの一般的なナビゲーションパターンを特定し、適用します。各遷移は、ユーザーのメンタルモデルとの整合性を確認するために検証され、これによりユーザビリティが向上し、混乱が軽減されます。結果として、マルチスクリーン整合性モデルは視覚的なノイズを最小限に抑え、親しみやすさを向上させ、統合されたインタラクション体験を促進します。
マルチスクリーンの一貫性とUI生成に関する詳細な数式は、補足ファイル1に記載されています。
最後に、レンダリングエンジンが、SVGワイヤーフレーム、HTML/CSSプロトタイプ、またはピクセルベースのUIモックアップなどの形式で視覚的な出力を生成します。得られたUI画面は、正しい読取順序、調和のとれた色の関係、正確なグリッド配置、および複数の画面にわたる一貫した視覚的階層を示します。
アルゴリズム S3は、認知・視覚的なレイアウト最適化およびマルチスクリーンの一貫性ワークフローを提供します(補足ファイル 1)。アルゴリズム S3は、ユーザーフレンドリーなUIレイアウトを生成するために用いられる、認知および構造的な統合最適化プロセスについて記述しています。これは、統一された最適化フレームワークの中で、知覚的グループ化(ゲシュタルト原則)、インタラクション効率(フィッツの法則)、および意思決定の単純性(ヒックの法則)を組み合わせています。まず、コンポーネント間の空間的関係を評価し、知覚的なグループ化を確立します。次に、コンポーネントのサイズと配置を調整することでインタラクション効率を最適化し、ユーザーに提示される選択肢の数を制限することで意思決定の複雑さを制御します。さらに、このアルゴリズムは、各画面を学習済みのレイアウトテンプレートに合わせることでマルチスクリーンの整合性を強制し、タイポグラフィ、間隔、および構造的な構成における均一性を確保します。その後、多目的最適化関数を用いて、配置、間隔、および認知コストのバランスを取りながらレイアウトを洗練させ、視覚的に一貫し、かつ認知的に効率的なインターフェースを実現します。総じて、このアルゴリズムにより、生成されたマルチスクリーンレイアウトが高い水準の視覚的一貫性、ユーザビリティ、および知覚的明瞭性を維持することが保証されます。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
提案された自動UIプロトタイピングフレームワークの評価は、3つのソースからなる計5,128枚のUI画面を統合したデータセットを用いて行われました。具体的には、4,0枚のRICO画像、1,0枚のENRICO画面、およびGuoのUI Color Datasetから抽出した色注釈付きUIサンプル128枚が含まれます。この混合データセットは、コンポーネント検出精度、レイアウト構造の明快さ、マルチスクリーンにおける一貫性、および知覚的な色の調和を評価するためのバランスの取れたベンチマークを提供します。
実験結果により、Faster R-CNNベースの検出モデルが92.4%のコンポーネント検出精度を達成し、多様なモバイルUIスタイルにわたって効果的に汎用化されることが示されました。さらに、ENRICOパターンのアノテーションを組み込むことでレイアウトの推論が強化され、レイアウトの明快さが18.7%向上し、読書順の保持が改善されました。色彩評価実験では、CAM02-UCS駆動のカラーモデリングモジュールが、デザイナーによる評価において24.5%より調和のとれたパレットを生成し、従来のRGBおよび...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
これらの知見は、ユーザビリティ、構造的組織化、および知覚的品質において統計的に有意な改善(p < 0.05)が認められたことを示しており、自動UIプロトタイピングに認知設計原則を組み込むことの有効性を裏付けている。視覚的な検出やルールベースのヒューリスティクスに主に依存する従来のUI生成システムとは異なり、提案されたフレームワークは、UI再構築プロセスの全体にわたって、ゲシュタルトグループ化、階層モデリング、間隔の制約、および知覚的な読みやすさを統合している。NASA-TLX、SUS、およびSETで観察された改善は、認知負荷の統計的に有意な減少(NASA-TLX, p.< 0.01)をさらに裏付けるものである。これらの結果は、自動UI生成が視覚的な再構築精度にとどまらず、実用的なユーザビリティを実現するために人間中心設計の知見を取り入れるべきであることを示唆している。加えて、策定されたすべての仮説(H1–H4)は、実験結果によって経験的に支持された。
レイアウトの改善に加え、CAM02-UCSに基づく知覚色モデリングの統合により、ΔE、CHI、CD...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者らに利益相反はありません。
謝辞
著者は、武漢外国語大学から提供された学術的および制度的な支援に感謝いたします。 & 本研究の遂行期間中、外務省、啓明大学、および上海外国語大学 commerce and foreign languages(上海商外大学)に所属していた。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| CPU(プロセッサ) | AMD Ryzen 9 7950X (16-core, 32-thread, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| CUDA Toolkit | バージョン 11.8 | NVIDIA Corporation, USA | CUDA Toolkit 11.8 |
| cuDNN | バージョン 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | 物体検出モデル(Region Proposal Network 搭載) | Meta AI Research / Detectron2 | Detectron2 フレームワーク |
| Matplotlib | バージョン 3.7 | Matplotlib Development Team | v3.7.0 |
| NVIDIA RTX 4090 GPU | 24 GB GDDR6X グラフィックスカード | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | バージョン 1.24 | NumPy Developers | v1.24.0 |
| OpenCV | バージョン 4.8 | OpenCV Foundation | v4.8.0 |
| PyTorch | バージョン 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| FPN搭載ResNet-50 | Feature Pyramid Network 搭載バックボーンCNN | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | バージョン 1.3 | Scikit-learn Developers | v1.3.0 |
| SciPy | バージョン 1.10 | SciPy Community | v1.10.0 |
| システムメモリ (RAM) | 64 GB DDR5 | Corsair / Kingston (または同等品) | DDR5 64GB Kit |
| Ubuntu オペレーティングシステム | バージョン 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
参考文献
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。