このプロトコルは、ウェブベースのがん臨床実践ガイドラインから内容を取得・要約し、ユーザーの問い合わせに対して参照に基づく回答を生成するガイドラインベースの検索拡張生成チャットボットの開発と評価を説明しています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
インターネット上での医療情報の広範な利用は、患者の医療関連知識へのアクセスを向上させました。しかし同時に、不正確な医療情報への曝露も増加させています。がん治療は複雑な情報を含み、患者が正確でエビデンスに基づく情報源を特定するのが困難です。大規模言語モデルは自然言語のやり取りを可能にしますが、しばしば幻覚を生み出し、医療情報伝達への応用を制限します。検索拡張生成(RAG)は、外部の参照源に応答を根拠にすることでこれらのリスクを軽減する可能性を秘めています。本研究は、公開されているウェブベースのがん臨床実践ガイドラインを用いたガイドラインベースのRAGチャットボットの開発と評価を説明しています。このシステムはガイドラインの目次ページからURLを抽出し、形態学的解析と用語頻度-逆文書頻度に基づく余弦類似性を用いてページテキストを処理し、関連性の高いページから参照情報を構築します。大規模な言語モデルはこれらの参照を用いて、ガイドライン内容に制約された回答を生成します。JLCSの『肺がん患者および家族向けガイドブック』が参考ガイドラインとして使用されました。問題セットには、ガイドラインでカバーされる範囲内がんタイプと範囲外がんタイプの両方が含まれ、反応コントロールを評価するようでした。医療情報は目次ページから成功裏に抽出され、抽出されたURLの98%に参照可能な医療コンテンツが含まれていました。範囲内の質問については、チャットボットがガイドライン内容を要約して回答を生成し、定義されたテスト条件下での手動レビュー中に幻覚は確認されませんでした。範囲外の質問に対しては、チャットボットは一貫して回答を拒否し、利用可能な情報が不十分であると示しました。ガイドラインのウェブ構造は、URLレベルでの引用コンテンツの効率的なスクレイピングと整理を可能にしました。このプロトコルは、ウェブベースの臨床実践ガイドラインに基づき医療情報を提供する人工知能システムを構築するための実践的な指針を提供します。
概要
インターネットやソーシャルメディアの普及により、患者が医療情報にアクセスしやすくなった 1,2.がんケアの情報はしばしば複雑かつ広範であるため、患者が正確で関連性があり、科学的証拠に基づく情報源を特定するのが特に困難です。オンラインリソースは患者の理解を助ける一方で、誤った医療情報が多く含まれており、患者のケアに関する判断に悪影響を及ぼす可能性があります。がん関連の誤情報が患者の転後に影響を与える可能性があるため、個々のユーザーが医療情報を検索、要約、解釈できる人工知能(AI)システムの需要が高まっています。
大規模言語モデル(LLM)は、ユーザーが自然言語会話を通じて情報にアクセスすることを可能にします7;しかし、誤情報(すなわち幻覚)の生成は医療分野で依然として深刻な懸念事項です。誤情報の主な原因の一つは、チャットボット開発に使われたトレーニングデータの質と正確さです。さらに、モデル訓練の静的な性質により、知識は時間とともに時代遅れになり、LLMが現在かつ文脈的に適切な情報を提供する能力が制限されます12,13。これらの制約は、チャットボットの回答が正確で関連性があり、最新であることを保証するための効果的な知識管理戦略の重要性を示しています。特に、臨床実践ガイドラインのような最新のエビデンスに基づくリソースに容易にアクセスし参照できるシステムは、推奨事項やケア基準が絶えず進化する医療現場において望ましいです。この課題に対処するため、外部知識源からの情報を取り入れて応答を生成する検索拡張生成(RAG)が注目を集めています(10,13,14,15,16,17)。
RAGは医療用チャットボットへの適用が増えていますが、臨床実践ガイドラインを参考情報源として体系的に組み込む方法については限定的な注目が払われてきました18。多くの臨床実践ガイドラインはウェブ上で公開されています。しかし、既存のウェブ構造がRAGシステム18の検索フレームワークとして直接機能するかどうかは依然として不明です。さらに、手動の知識ベース開発を行わずに参照情報を構築する実用的な手法も十分に確立されていません。
本研究では、医療分野におけるガイドライン参照AIシステムの設計原則を確立し、公開されているウェブベースのがん臨床診療ガイドラインを用いるガイドラインベースのRAGチャットボットを開発・評価し、ガイドラインに基づく情報への簡単かつタイムリーなアクセスを可能にすることを目指しました。概念実証として、既存の公開されている臨床実践ガイドラインのウェブ構造を用いて、ガイドラインの検索、反応生成、応答制限の技術的実現可能性を評価し、ガイドライン参照RAGシステムの再現性開発プロトコルを提案することを目標としました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究は、研究に伴うリスクからの保護を必要とするヒト被験者を対象としていません。したがって、日本の倫理ガイドラインによれば、ヒト被験者を含む医療研究に関しては機関審査委員会による審査は不要です。本研究は、個人予後または診断のための多変数モデルの透明報告(TRIPOD)-LLMガイドライン20に従って報告されています。
ガイドラインベースのRAGチャットボットプロトコルの概観については 図1 を参照してください。
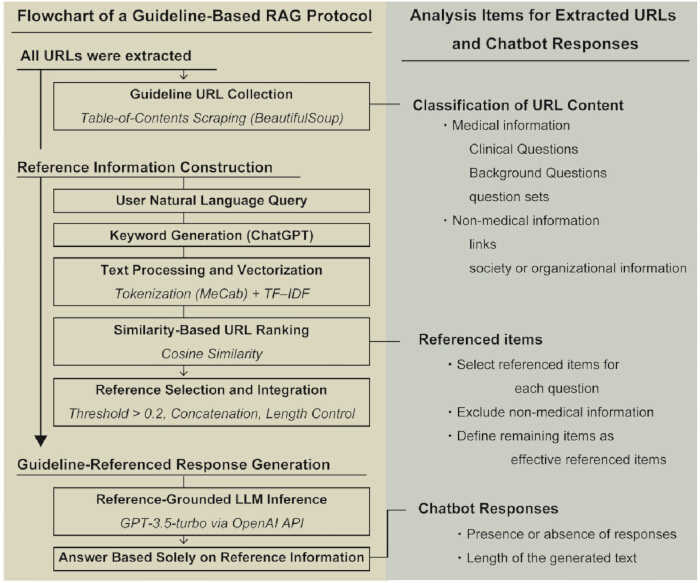
図1。ガイドラインベースの検索拡張生成(RAG)チャットボットプロトコルのワークフロー。 ガイドラインに基づくRAGチャットボットワークフローの概説。URLはウェブベースの臨床実践ガイドラインの目次ページから抽出され、参照情報の作成に利用されます。ユーザーのクエリはキーワードに変換され、ウェブページの内容はトークン化、用語頻度逆頻度ベクトル化、余弦類似度分析を経て関連するガイドラインページを特定します。選ばれた参考情報は統合され、大規模な言語モデルに提供され、参照されたガイドライン内容のみに基づいて回答を生成します。右パネルは抽出されたURL、参照情報、チャットボット応答に使用された評価項目をまとめています。 この図の拡大版はこちらをクリックしてご覧ください。
1. ウェブベースのガイドラインからの参考情報の作成
- Python(バージョン3.12)プログラミング言語で実装されたBeautifulSoup 4(HTML解析ライブラリ)を使い、対象のウェブベースの臨床実践ガイドラインの目次ページからすべてのURLを抽出します。
注意:以下のパッケージでURL抽出スクリプトを実装してください:HTMLパーシングライブラリ(バージョン4.12.3)およびリクエスト(ウェブページ検索ライブラリ;バージョン2.32.3)。pipを使ってパッケージをインストールしましょう。URL抽出のための完全なソースコードは 補足ファイル1に提供されています。ソフトウェアの詳細については 「材料表 」を参照してください。 - 抽出されたすべてのURLを手動で確認し、目標臨床実践ガイドラインへのアクセスと関連性を確認しましょう。
- 各URLを医療情報を含むものと非医療情報のどちらかに分類してください。URL分類は1人の著者(S.N.)で行います。
注:医療情報は臨床質問(CQ)、背景質問、問題セットを含む参照可能なガイドライン内容として定義されています。非医療情報には、リンク、学会や組織のページ、参照に適さないその他の付随的な内容が含まれていました。 - 検証済みのURLをMicrosoft Excelワークブック(.xlsx形式)にまとめ、1行に1つのURLを記録します。その結果得られたURLリストを入力データセットとして保存し、その後のテキスト検索、前処理、類似性分析に用いられます。
2. ユーザークエリからのキーワード生成
- 自然言語クエリをChatGPT(生成前学習トランスフォーマー、バージョン40、キーワード生成モデル)に入力します。
- モデルにユーザークエリに対応する2つのキーワードを抽出するよう促します。
- キーワード生成には、日本語で書かれた以下のプロンプトを使用してください:
「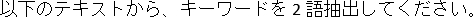 」
(英訳:「以下のテキストから2つのキーワードを抽出。」) - ユーザーの自然言語クエリをこの指示に付加し、キーワード生成モデルに提出します。
- モデルパラメータを手動で変更しないでください。キーワード生成モデルのデフォルト設定を使ってキーワード生成を行います。
- 各ユーザークエリごとに2つのキーワードを生成します。両方のキーワードを、さらなる修正、フィルタリング、手動選択なしで保持し、その後の類似度計算に活用してください。
- 生成されたキーワードはMicrosoft Excelのワークブック(.xlsx形式)に保存してください。各レコードに対して、元のユーザークエリとそれに対応する生成されたキーワードを保存し、後続の類似度に基づく検索のために保存します。
3. テキスト処理と類似度計算
- 各抽出URLからウェブページ検索ライブラリとHTML解析ライブラリを使って全文内容を取得します。BeautifulSoupのget_text()関数を使ってHTMLソースからテキスト内容を抽出します。
- 抽出したウェブページのテキストや生成されたキーワードは、HTMLタグや日本語以外の文字を削除して前処理します。
- MeCab(バージョン0.996)を用いて日本語形態解析を行うデフォルトの辞書を用いる日本語形態学分析ツール。名詞のみを保持し、それらを空間で区切られたテキスト文字列に連結します。
- 生成されたキーワードを1つのテキスト文字列にまとめ、ウェブページのテキストで使われるのと同じ前処理とトークン化手順を適用します。
- scikit-learnライブラリ(バージョン1.6.1)のTfidfVectorizer実装を用いて、処理済みのウェブページテキストとキーワードテキストから、デフォルトパラメータ設定で用語頻度逆文書頻度(TF–IDF)ベクトルを生成します。
注意:すべてのTfidfVectorizerパラメータはデフォルト値のままであり、カスタムパラメータ設定は適用されていません。 - 各ウェブページのベクトルとキーワードベクトル間のコサイン類似度をコサイン類似度関数で計算します。
- URLをコサイン類似度スコアに基づいて降順にランク付けします。追加の同点決定基準は適用しないでください。
- 候補の参考情報として、コサイン類似度スコアが≥0.2のページを選択します。
注:余弦類似度閾値(0.2)は、システム開発時に検索リコールの優先順位を置き、関連するガイドライン内容を除外しないように経験的に選択されました。 - 類似度の閾値を満たすすべての候補ページを保持してください。
4. 参照情報の構築
- 順番に選ばれたページのテキスト内容をランクリストの上部から抽出します。
- 抽出したテキストを連結して単一の参考文献を形成します。
- LLMに提出する前に、参照テキスト内の改行文字と連続した空白文字を1つのスペースに置き換えてください。
- 連結された参照テキストを最初の4,096文字に切り詰めてからLLMに提供してください。
注:切断制限はトークンではなく文字に基づいていました。4,096文字の制限が経験的に選択され、プロンプト情報と参照情報の合計がGPT-3.5-turbo-16k応答生成モデルの入力容量内に収まることを保証しました。
5. AIベースの応答生成
- 構成された参照情報と元のユーザークエリをアプリケーションプログラミングインターフェース(API)を通じて応答生成モデルに提供します。
- 以下のプロンプト(全文日本語で書かれ)を使って、提供された参考情報のみに基づいて回答を生成するようAIに指示します。
「あなたはがん患者に指導を提供する医療情報アシスタントです。以下の参考情報のみに基づいて回答を生成し、ご自身の一般的な知識や推論は使用しないでください。回答は詳細で理解しやすく、約500文字の長さであるべきです。もし参考情報に十分な情報が含まれていない場合は、推測や一般知識を使わずに「本文に不十分な情報があります」と答えてください。 - 参照情報とユーザークエリを一つのユーザーメッセージ内でまとめて提供します。入力は「参考情報:[参照テキスト]」に続き、「質問:[ユーザークエリ]」と構成します。
- 応答生成モデルを用いて、以下の設定で応答を生成します:温度 = 0.1、最大出力長 = 1,024トークン、n = 1、停止 = なし。
- AI生成の回答を取得し、その後の評価に備えます。
注意:参考情報とユーザークエリは単一のユーザーメッセージとして提出してください。応答生成命令はシステムメッセージとして別途提供してください。
6. 参考文献ガイドラインと質問の定式化
- ガイドラインベースのRAGチャットボットシステムの参考情報として、オンラインで無料で入手可能なJLCSの『肺がん患者と家族向けガイドブック』21を選択してください。
- がんの種類に基づいて評価質問を2つのカテゴリーに作成します。胸腺腫瘍(ガイドラインの範囲内)と、小児膠腫(参照情報の範囲外)です。
- 各がんタイプに対する診断と治療に関する4つの質問を作成しましょう。
「XX(例:胸腺性または小児性膠腫)腫瘍の診断方法にはどのようなものがありますか?」
「XX腫瘍の病理学的診断アプローチは何でしょうか?」
「XX腫瘍にはどのような治療法がありますか?」
「XX腫瘍の外科的治療法は何でしょうか?」 - 参照されたウェブベースのガイドラインで扱われているがんの種類に関する質問をチャットボットに送信してください。例えば、肺の診断に関する質問を、Lung Guidebookを参考資料として提出してください。
- 参照ガイドラインの範囲外の質問をチャットボットに提出し、外部情報や無関係な情報の使用を控えるかどうかを評価してください。例えば、Lung Guidebookを参考資料として小児膠腫に関する質問を提出します。
- それぞれの質問は独立したチャットセッションで評価してください。質問の間に会話履歴を持ち継がないでください。
- AI生成の回答を記録し、後続の評価に備えます。
7. 反応評価
- 生成されたすべての回答を手動で確認します。
- 各反応に幻覚が含まれているかどうかを評価してください。
- 各回答が参照ガイドライン内の情報によって裏付けられているかどうかを評価してください。
注:幻覚とは、存在しない出来事、名前、または医療上の害を引き起こす可能性のある用語を含む反応と定義されています。生成された回答は、大学病院で8年の経験を持つ1名の著者によって、正確性と幻覚の有無を審査し、患者支援やがん患者の医療コミュニケーションも含まれていました。反応分類に関する不確実性は、国立がんセンター日本で20年以上のがん情報サービス経験を持つ医師との協議によって解消されました。 - 回答を支持するとみなすのは、すべての臨床的に関連した記述が、追加の知識や根拠のない推論を必要とせずに、検索した参考文献から直接確認できる場合のみです。
- 各反応をあらかじめ定義されたアウトカムラベルで分類します。参照ガイドラインに裏付けられた情報のみを含む回答は「幻覚不在」と分類してください。裏付けられていない、または捏造された情報を含む回答を「幻覚の存在」と分類してください。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
目次ページを通じた医療コンテンツの取得可能性
ウェブスクレイピングのアーキテクチャは、ガイドラインの目次ページからURLを収集していました。肺ガイドブックから106のURLが目次ページから抽出され、そのうち104(98%)が医療情報を含むものでした(補足表1)。ガイドラインの内容ページに基づくチャットボットの回答の効果は 表1にまとめられています。チャットボットは、質問がガイドラインの範囲内であれば、4つの臨床キーワードすべてに対して回答を生成しました。「胸腺腫瘍診断」および「病理診断」については、各キーワードごとに3つの関連URLを抽出し、すべての抽出URLが有効(100%)とみなされました。「治療法」と「外科的治療」については、各キーワードごとに15のURLを抽出し、14項目(93%)が効果的でした。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究では、ウェブベースの臨床実践ガイドラインであるJLCSのGuidebook for Lung Cancer Patients and Familiesを参考情報源として用いるガイドラインベースのRAGチャットボットの有用性を検討しました。チャットボットはガイドラインのウェブ構造を活用し、ユーザーのクエリとの類似性に基づいてページを取得し、ガイドラインの内容に基づいた回答を生成しました。このアプローチは、類似性に基づく検索とガイドライン参照応答生成を組み合わせることで、信頼性が高く効率的な医療情報の提供を支援できることが示されました。最近の研究では、LLMベースの医療チャットボットの可能性と限界の両方が強調されており、特に幻覚や応答信頼性に関して12,13,14。従来の一般的なチャットボットフレームワーク10、<...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは競合する利害関係を一切認めていない。
謝辞
著者らは、ガイドラインベースの検索拡張型世代チャットボットの開発における豊富な技術的支援をいたいた井上健一医師(湘南記念病院乳房センター)に感謝しています。また、著者らは本論文で扱ったテーマに関して貴重な助言を提供してくれた山木千佳子博士および国立がんセンター(東京)の研究チーム全メンバーに感謝します。さらに、著者たちは英語版編集に感謝しています。この研究は、健康・労働科学研究助成金(R6–がん制御–23EA1026)によって支援されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
```html
```
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Beautiful Soup 4 (version 4.12.3) | Beautiful Soup プロジェクト | N/A | URLの抽出とHTMLの解析に使用されるPythonライブラリ |
| ChatGPT version 4o | OpenAI | N/A | キーワード生成に使用 |
| GPT-3.5-turbo | OpenAI | N/A | 応答生成に使用 |
| 肺がん患者と家族のためのJLCSガイドブック | 日本肺癌学会 | N/A | 参照情報として使用されるウェブベースの臨床実践ガイドライン |
| MeCab (version 0.996) | MeCab プロジェクト | N/A | 日本語形態素解析器 |
| OpenAI API | OpenAI | N/A | AIベースの応答生成に使用 |
| Python (version 3.12) | Python ソフトウェア財団 | N/A | プログラミング環境 |
| Requests (version 2.32.3) | Requests プロジェクト | N/A | ウェブページの取得に使用されるPythonライブラリ |
| scikit-learn (version 1.6.1) | scikit-learn 開発者 | N/A | TF–IDF ベクトル化と余弦類似度計算に使用 |
| urllib.parse | Python ソフトウェア財団 | N/A | URL の正規化と結合に使用される Python ライブラリ |
参考文献
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。