このプロトコルは、グリッド学習タスク(GLT)を提示します。これは、連続する学習エピソード間の異なる種類の重なり(すなわちオブジェクト と 位置)が、グリッド間の学習パフォーマンスの変化によって新しい学習をどのように促進または妨げるかを調査するための行動パラダイムです。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
日常生活では、ある日に車がどこに停まっていたかなど、物の位置を覚えておく必要があります。重要な問いは、前日に同じ駐車場に駐車したような類似の経験が、新しい出来事の記憶を助けるのか、それとも妨げるのかということです。グリッド学習タスク(GLT)はこの問題に対処するために開発されました。この課題では、参加者はグリッド上に配置されたオブジェクトのセットを調べ、それらを空のグリッドの正しい位置に配置するよう求められます。主に関心のある2つの重なり条件があります:位置重なり条件とオブジェクト重なり条件です。位置重なり条件では、異なるオブジェクトが前のグリッドと同じ空間構成で提示されます。オブジェクト重なり条件では、同じオブジェクトが異なる空間構成で提示されます。現在のプロトコルでは、参加者がすべての重複タイプを経験する被験者内設計に元の課題を修正しています。ロケーションの重複条件とオブジェクトの重複条件を比較することで、GLTは過去の経験との異なる形態の重複が新しい学習にどのように影響するかの洞察を提供します。この課題の発見は、重なり合うオブジェクトの同一性が後続のグリッドを学習するために必要な試行回数を増加させ、記憶干渉を反映していることを示しています。これに対し、オブジェクトの位置が重なり合うことは、次のグリッドを学習するために必要な試み回数を減らし、記憶の促進を反映しています。全体として、GLTは過去の経験が新しい学習にどのように影響を与えるかを検証する枠組みを提供し、妨害効果と促進効果の両方を明らかにします。
概要
私たちの日常の経験には、しばしば重なり合う情報が含まれています。事前知識は時に新しい学習を支える足場となりますが、同時に学習の妨げとなり、混乱を招き、パフォーマンスを妨げることもあります。1,2,3,4。例えば、新しい食料品店を訪れる際、過去の食料品店のレイアウトから得た知識を頼りにカートやレジカウンターを簡単に見つけることができます。しかし、特定の商品の正確な場所を覚えるのは、馴染みのある店舗と位置が異なる場合に難しくなることがあります。これはより広い問いを示しています。つまり、どのような条件下で以前の経験が新しい学習を促進し、いつそれを妨げるのか?
研究者たちは長らく先行知識が学習に与える影響を調査してきましたが、その促進的および干渉的効果の証拠はしばしば異なる実験パラダイム1,2,3,4から現れています。したがって、先行知識が新しい情報の獲得にどのように影響するかを一貫した説明を構築することは依然として困難です。干渉効果は通常、単語ペア学習課題1、2、5、6、7を用いて検証されます。これらの課題では、まず単語ペア(例:A-B)を学び、次にいくつかのペアが最初のリスト(例:A-C)とアイテムを共有し、重複のないコントロールペア(例:D-E)を学ぶ第二のリストを学びます。共有アイテム(A)が検索手がかりとして使われると、セカンドリストペア(C)の呼び戻しがしばしば妨げられ、これはプロアクティブ干渉6と呼ばれる現象です。この効果は、以前に学習された連合(A-B)と新しい連合(A-C)との競争に起因し、後者5つの連合を取り戻す可能性が低下すると考えられています。
対照的に、オブジェクト位置学習課題では促進効果が観察されています。これらの課題では、参加者はグリッド上の複数のオブジェクトの位置を学び、新しいオブジェクトのセットを新しい空間レイアウトの中に提示することで学習が促進されます。この重なり合う空間構造の有益な効果は、人間と齧歯類の両方で実証されており、先行知識が新しい学習を支えることが浮き彫りになっています。重要なのは、事前の空間知識は行動に影響を与える唯一の形態の図式的知識に過ぎないということです。スキーマには意味知識も含まれることがあります(例:食料品店は食品を販売する一方で家庭用品も扱う場合など)、これにより新しい情報の獲得を促進し、より広範な行動を導くことができます9。例えば、リンゴを購入したい場合、既存のスキーマに頼って、それが金物店よりも食料品店で見つかる可能性が高いと考えることがあります。
グリッド学習タスク(GLT)10 は、単一のタスク内にファシリテーションとインターフェレンスの両方を取り入れることで、既存の知識が新しい学習にどのように影響するかを検証するための統一的な枠組みを提供するために開発されました。GLTでは、参加者が複数のオブジェクト・ロケーショングリッドを学び、すべてのオブジェクト位置を覚えるまで学習プロセスを繰り返します。重要なのは、連続するグリッド間の重なりの種類が操作されていることです。ロケーションオーバーラップ条件では、異なるオブジェクトが同じ空間レイアウト内に提示されます。オブジェクト重なり条件では、同じオブジェクトが異なる場所に表示されます。以前の研究では、空間配置が重なると学習が促進される一方で、物体の同一性が重なると学習が妨げられることが示されました。しかし、GLTの初期適用では参加者10の重複条件が比較され、これらの相反する効果は重複タイプ自体ではなく個人差を反映している可能性が示されました。
本プロトコルは、各参加者がすべての重複状態を経験する、被験者内版のGLTを修正したものとしています。この方法論的修正により被験者間の変動が減少し、同一個人内で促進と干渉を測定できるようになります。その結果、設計は異なる形態の既存知識が新しい学習に異なる影響を与えるかどうかをより直接的に検証します。これらの発見は、事前知識の種類が、その後の学習を促進するか妨げるかを決定する可能性があることを示唆しています。
GLTの目的は、被験者内のグリッド学習パラダイム内で学習の試みを測定し、重複タイプを体系的に操作することで、学習パフォーマンスに対する促進および干渉効果を評価することで、過去の経験が人間の新しい学習にどのように影響するかを定量化することです。単一のパラダイム内で促進と干渉の両方を測定できることで、GLTは過去の経験が新しい学習をどのように形成するかを研究するための統一的な枠組みを提供します。従来のパラダイムが通常、促進や干渉を1,2,3,5,6,7,8だけ孤立して検討するのとは異なり、GLTは一貫したタスク構造を維持しつつ、重複を体系的に操作します。このアプローチにより、異なる形態の事前情報が個人の学習にどのように影響するかを直接比較できます。一つの潜在的な制約は、促進効果と干渉効果が重複条件の提示順序によって変化し、過小評価や過大評価につながることです。それにもかかわらず、GLTは記憶、学習、一般化、干渉のメカニズムや、学習文脈間での事前知識効果に対する個人差を調査するための多用途なツールであり続けています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
ヒト参加者を含むすべての手技はカリフォルニア大学リバーサイド校の機関審査委員会(プロトコル#30014)によって承認されました。参加前に全参加者から書面によるインフォームドコンセントが取得されました。すべての方法は、関連する機関のガイドラインおよび規則に従って実施されました。
1. 同意と指示
- 参加者に同意書を渡し、参加者の権利を説明し、研究の概要をまとめてください。参加前にすべての参加者から書面によるインフォームドコンセントを取得してください。
- 参加者が同意書に署名した後、この課題は4つの異なるグリッド上でオブジェクトの位置を暗記し、正しいタイルにオブジェクトを配置することを口頭で説明します。また、グリッド間で数学の気を散らすタスクも提示されます。
- 練習や研究したグリッドフェーズを含む全体的な課題構造を簡単に説明してください。参加者にタスク指示を研究者に繰り返し、必要に応じて説明するよう求めます。
2. グリッド学習課題
- PsychoPy11を使ってグリッド学習タスクプログラム(補足ファイル1および補足図1)を開きます。「実行」ボタンをクリックして、プログラムがパイロットテストモードに入っていないことを確認してください。
- 参加者識別番号の入力を求めるプロンプトが表示されます。参加者識別番号は匿名性を維持するために使用されます。参加者に事前に割り当てられた参加者識別番号を入力し、「OK」ボタンをクリックして続けるよう指示してください。
- プログラムを始めましょう。画面は参加者にスペースバーを使って指示を進めるよう促します。
- 参加者に、Commandキー(Mac)またはControlキー(Windows)と「+」または「-」キーを同時に押し、グリッドの四隅すべてが画面に見えるように調整するよう指示します。
注:作業を始める前に、グリッドの四隅すべてが見えるようにしてください。不適切なスクリーンスケーリングは刺激の提示や参加者のパフォーマンスに影響を与える可能性があります。 - 数学の気をそらす課題
- 数学の気晴らしタスクを始めましょう。参加者に画面上の指示を読み、簡単な算数問題を解いてから次のグリッドに進むよう指示します。
- 画面上で加算や引き算を含む簡単な算術問題を一つずつ提示します。参加者に各方程式が正しいか間違っているかを示すよう指示し、真の場合は「T」、偽の場合は「F」を押して示します。
- 例えば、方程式2 + 4 = 6が提示された場合、参加者に「T」を押すよう指示します。2 + 5 = 10の方程式が提示されたとき、参加者に「F」 を押す よう指示します。
- 各回答の後にフィードバック画面を表示します。
- 回答が正しかったか不正解かを示してください。4秒以内に返答がなければ、自動的にフィードバック画面に進み、参加者により速い返信を促すメッセージを表示します。
- フィードバック画面を2秒間表示しておく。2秒後、プログラムは自動的に次の試行に進みます。
- 参加者は次のグリッドに進む前に20問の算数問題を解答することを求めます。気をそらす作業の完了には通常約1分かかります。
注:このタスクは、前のグリッドのリハーサルを防ぎ、参加者の関与を維持するために活用しましょう。実験中の全体的な精度はフィードバックとして提供されませんが、精度が75%未満の場合は参加者を分析から除外してください10。
- オーバーラップ操作
- 数学の妨げタスクが完了すると、次のグリッドが開始されることを示す画面上の指示が表示されます。参加者にスペースバーを押して次の試験を開始するよう指示します。次のグリッドで「研究・固定・テスト・フィードバック」のサイクルを繰り返します。課題全体で、参加者は数学の妨げタスクで区切られた4つの異なるグリッドを学びます。
- 4つのグリッドを構成し、連続した2つのグリッドは同じオブジェクト画像を共有しつつ位置が異なるものの、別の連続したグリッドペアは同じ空間レイアウトを共有しつつ異なるオブジェクト画像を持つようにします(図2)。
- ステップ2.5.3.1–2.5.3.2および2.6.3.3で説明されたあらかじめ定義されたオブジェクトおよび位置セットから、研究対象となった4つのグリッドを構築します。グリッドはランダムに選ばれ、1つの遷移がオブジェクトの重なり合い、1つの遷移が位置の重なり合い、1つの遷移が重なりなしの条件を表します。
- オブジェクトの重なり条件では、同じオブジェクトセットを2つの連続したグリッドにまたがせつつ、異なる位置セットを割り当てます。ロケーションの重なり条件では、同じロケーションセットを2つの連続したグリッドに使い、異なるオブジェクトセットを割り当てます。重なりなし条件では、異なるオブジェクトセットや異なる位置セットを連続したグリッドで使用します。
- 参加者間で重複条件の順序をランダムに割り当て、完全にカウンターバランスし、6つの可能な重複順序を作り出します。
注: 参加者間の重複条件順序を完全に相殺し、順序効果を最小限に抑え、促進と干渉の有効な推定を確実にします。 - 各気を散らすフェーズごとに異なる20問の算術問題を提示し、実験全体で3つのユニークな問題セットを作ります。
- 4番目のグリッドをクリアした後、タスク終了画面を表示します。参加者にはスペースバーを押してプログラムを終了するよう指示します。
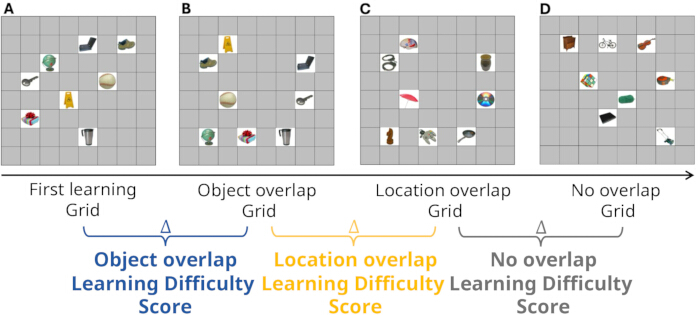
図2:グリッド学習課題における重なり条件。 参加者は4つの異なるグリッドを学びます。 (A) 最初のグリッドは、連続するグリッド間の学習難易度スコアを計算するための基準となります。2番目のグリッドから、参加者は(B)オブジェクトの重なり状態、(C)位置の重なりの状態、または(D)連続したグリッド間での重複なしの状態のいずれかを体験します。示された例は、重なりの順序を示しています。オブジェクトの重なり→場所の重なり→重なりはありません。重複条件の順序は参加者間でカウンターバランスされます。示されている画像は標準化刺激銀行(BOSS)セット12,13の未改変刺激であり、クリエイティブ・コモンズ表示ライセンス(http://creativecommons.org/licenses/by-sa/3.0/)の下で使用されています。この図の拡大版はこちらをクリックしてご覧ください。
3. 任意の形態
- フィードバックフォームを管理してください。参加者に、実験が何を調査したと考え、課題中にどのような戦略を用いたかを尋ねます。さらなるフィードバックや改善提案を歓迎します。
- 人口統計のフォームを管理してください。年齢や民族などの人口統計情報を収集してください。匿名性を保つため、すべての情報は集約形式で報告されることを参加者に伝えてください。
- 参加者に報告書の紙のコピーを渡してください。報告書には、調査の目的と課題の理由が説明されています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
参加者は以下の基準により除外されました:(a) 10回以内にグリッドを習得できなかった、または (b) 数学の気晴らし課題で75%未満の正確さ。これらの基準は、グリッド学習タスク(GLT)10を用いた以前の研究から採用されました。GLTを完了した46名のうち、1名が第一の基準で除外され、第二の基準で除外された者はいませんでした。すべての統計検定は、両側α水準0.05で評価されました。
4つのグリッド全体で、参加者はそれぞれのグリッドを約4回の試みで学習しました(M = 3.81、SD = 0.93)。学習試行回数はグリッド1(M = 4.69、SD = 1.53)からグリッド2(M = 3.62、SD = 1.59)、グリッド3(M = 3.51、SD = 1.50)、グリッド4(M = 3.40、SD = 1.21)へと数値的に減少しました(表1参照)。45人の参加者のデータを用いた反復分散分析(ANOVA)では、グリッド番号が学習...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
グリッド学習タスク(GLT)10 は、既存の知識と新しい情報の重なりが学習にどのように影響するかを検証するための柔軟な行動プロトコルを提供します。この課題では、参加者はグリッド上のオブジェクトと位置の関連を繰り返し研究し、すべてのオブジェクト位置を学習し、学習効果を学習難易度スコア(Learning Difficulty Score)を用いて定量化します。これは連続した2つのグリッドを学習するのに必要な試み回数の差を測定します。プロトコルの重要な特徴は、連続するグリッド間の重なりタイプを操作できることであり、オブジェクトの識別や空間配置のいずれかが重なり合うことを可能にします。GLTはもともと被験者間の設計として開発され、参加者は単一の重なり条件10のみを経験しましたが、本プロトコルでは被験者内設計に適応し、各参加者が複数のグリッドですべての重複タイプを経験します。この修飾により被験者間のばらつきが減少し、個人内での促進効果と干渉効果の直接比較が可能になります。このアプローチ...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは競合する利害関係を一切認めていない。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Bank of Standardized Stimuli (BOSS) set | Bank of Standardized Stimuli (BOSS) | N/A | (Stimuli) 刺激提示に使用される標準化されたオブジェクト画像のセット。参考文献12–13を参照。 |
| コンピュータ(デスクトップまたはラップトップ) | 任意のメーカー | N/A | (機器) PsychoPyを実行するために使用される標準的なデスクトップまたはラップトップコンピュータ。特殊なハードウェアは不要。 |
| 同意書 | 著者作成 | N/A | (参加者材料) 参加前の書面による情報に基づく同意を得るために使用されるIRB承認済みの同意書。 |
| デブリーフィングフォーム | 著者作成 | N/A | (参加者材料) 研究目的と手順を説明する実験後のデブリーフィング文書。 |
| 人口統計学的フォーム | 著者作成 | N/A | (参加者材料) 年齢と人口統計情報の収集に使用される質問票。データは匿名性を維持するために集計して報告されました。 |
| フィードバックフォーム | 著者作成 | N/A | (参加者材料) タスク中の参加者の戦略と主観的経験を評価するタスク後の質問票。 |
| グリッド学習タスクプログラム(PsychoPyスクリプト) | 著者作成 | N/A | (ソフトウェア) Grid Learning Taskを実装するカスタムPsychoPyベースのタスク。この研究で使用されたバージョンは補足ファイルS1に対応しています。PsychoPy v2024.2.4を使用して実行されます。https://www.psychopy.orgで利用可能。 |
| モニター/ディスプレイ | 任意のメーカー | N/A | (機器) 8 × 8グリッド刺激を表示するために使用される標準的なコンピュータモニター。画面サイズは完全なグリッドの可視性を確保するために調整されました。 |
| マウス/トラックパッド | 任意のメーカー | N/A | (機器) グリッド内のオブジェクトのドラッグアンドドロップ配置に使用される標準的な入力デバイス。 |
| PsychoPy | Open Science Tools Ltd. | バージョン2024.2.4 | (ソフトウェア) タスクを実行するために使用されるオープンソース実験制御ソフトウェア。https://www.psychopy.orgで利用可能。 |
参考文献
- Anderson MC, Neely JH. Interference and inhibition in memory retrieval. In: Bjork EL, Bjork RA, editors. Memory. 2nd ed. San Diego (CA): Academic Press; 1996. p. 237-313.
- Kliegl O, Bäuml KHT. Buildup and release from proactive interference-Cognitive and neural mechanisms. Neurosci Biobehav Rev. 2021;120:264-278.
- Tse D, et al. Schemas and memory consolidation. Science. 2007;316(5821):76-82.
- Bein O, et al. Predictions transform memories: How expected versus. unexpected events are integrated or separated in memory. Neurosci Biobehav Rev. 2023;153:105368.
- Postman L, Underwood BJ. Critical issues in interference theory. Mem Cognit. 1973;1(1):19-40.
- Underwood BJ. Interference and forgetting. Psychol Rev. 1957;64(1):4-60.
- McGeoch JA. The psychology of human learning. London: Longmans, Green and Co.; 1942.
- van Buuren M, et al. Initial investigation of the effects of an experimentally learned schema on spatial associative memory in humans. J Neurosci. 2014;34(50):16662-16670.
- Farzanfar D, Spiers HJ, Moscovitch M, Rosenbaum RS. From cognitive maps to spatial schemas. Nat Rev Neurosci. 2023;24(2):63-79.
- Chaloupka B, Zeithamova D. Differential effects of location and object overlap on new learning. Front Cognit. 2024;2:1325246.
- Peirce J, et al. PsychoPy2: Experiments in behavior made easy. Behav Res Methods. 2019;51(1):195-203.
- Brodeur MB, et al. The Bank of Standardized Stimuli (BOSS), a new set of 480 normative photos of objects to be used as visual stimuli in cognitive research. PLoS One. 2010;5(5):e10773.
- Brodeur MB, Guérard K, Bouras M. Bank of Standardized Stimuli (BOSS) phase II: 930 new normative photos. PLoS One. 2014;9(9):e106953.
- Chanales AJ, et al. Interference between overlapping memories is predicted by neural states during learning. Nat Commun. 2019;10:5363.
- Ritvo VJ, Turk-Browne NB, Norman KA. Nonmonotonic plasticity: How memory retrieval drives learning. Trends Cogn Sci. 2019;23(9):726-742.
- Zeithamova D, Bowman CR. Generalization and the hippocampus: More than one story? Neurobiol Learn Mem. 2020;175:107317.
- Gilboa A, Marlatte H. Neurobiology of schemas and schema-mediated memory. Trends Cogn Sci. 2017;21(8):618-631.
- Mitchell TM, Keller RM, Kedar-Cabelli ST. Explanation-based generalization: A unifying view. Mach Learn. 1986;1(1):47-80.
- Liao Z, Losonczy A. Learning, fast and slow: Single- and many-shot learning in the hippocampus. Annu Rev Neurosci. 2024;47(1):187-209.
- Tompary A, Zhou W, Davachi L. Schematic memories develop quickly, but are not expressed unless necessary. Sci Rep. 2020;10(1):16968.
- Umanath S, Marsh EJ. Understanding how prior knowledge influences memory in older adults. Perspect Psychol Sci. 2014;9(4):408-426.
- Yassa MA, Stark CE. Pattern separation in the hippocampus. Trends Neurosci. 2011;34(10):515-525.
- Hunsaker MR, Kesner RP. The operation of pattern separation and pattern completion processes associated with different attributes or domains of memory. Neurosci Biobehav Rev. 2013;37(1):36-58.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
再版と許可
この記事は公開されました
動画は近日公開