本研究では、トランスフォーマーエンコーダー、もつれを解いた感情表現、および視覚的マッピングを伴うグラフベースのクロスモーダルアテンションを活用し、2つのデータセットにおける感情認識精度を向上させるエンドツーエンドのマルチモーダル感情分析フレームワークを提案します。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
機械に人間の感情状態を理解させ、解釈させ、それに反応させることで、マルチモーダルな感情特性を視覚的にマッピングすることは、インテリジェントなインターフェース設計において極めて重要です。しかしながら、現在のマルチモーダル感情検出アルゴリズムは主に予測性能に焦点を当てており、解釈性、インタラクションの認識、あるいは特徴量レベルでのクロスモーダルな相互作用に関する知見はほとんど得られていません。本研究では、インタラクション指向の視覚化、解釈可能な表現学習、および感情予測を組み合わせた、マルチモーダル感情アスペクトの視覚的マッピングのためのフレームワークを導入しました。手動で作成した特徴量を使用せず、Transformerベースのエンコーダを用いて、テキスト、音声、および視覚的な各モダリティから高レベルの感情埋め込みを抽出しました。堅牢性を向上させるため、もつれ解消表現学習(disentangled representation learning)の手法を用いて、感情固有の情報とモダリティ固有の情報を分離しました。さらに、適応的なアテンション重み付けを用いてモダリティ間の微細な感情関係をシミュレートするため、グラフベースのクロスモーダルアテンションネットワークを構築しました。透明性を高めるために、時間的な感情の軌跡、クロスモーダルアテンションの分布、および潜在的な感情埋め込みを描写するマルチビュー視覚マッピングモジュールを作成しました。提案したフレームワークの評価には、Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) データセットおよびChinese Multimodal Sentiment Analysis Dataset (CH-SIMS) を使用しました。実験結果によれば、提案したフレームワークは、精度、F1スコア、相関、および平均絶対誤差において代表的なベースライン手法を一貫して上回りつつ、特徴量レベルの解釈性とインタラクション認識の視覚化を向上させました。加えて、視覚マッピングモジュールによって、マルチモーダルな感情表現、クロスモーダルな相互作用、および時間的な感情ダイナミクスの定性的な解釈が可能となり、インタラクション認識に基づいた視覚化と分析がサポートされました。
概要
人間の感情を正確に識別し、理解する能力は、人間と機械の間のインタラクションを向上させるために極めて重要になっています。感情分析は、ヒューマン・コンピュータ・インタラクションの向上に不可欠であるだけでなく、前診断的な医学的診断1、教室における行動分析2、患者の心理的トラッキング3、車両内での疲労識別4、およびスマートホーム環境におけるインテリジェント管理5など、多くの分野に革命をもたらす可能性があります。アフェクティブ・コンピューティングとディープラーニング6の最近の進展により、人間の感情の複雑さを捉えることができるリアルタイムシステムの構築への関心が高まっています。
現在の多くの手法は、主にテキスト、画像、音声などの単一モーダルデータに依存しています7,8,9。これらのアプローチでは、皮肉や文脈依存のニュアンスといった精緻なシグナルを検出できないことが繰り返し示されています。そのため、これらの制限を克服するために、複数のソースからの補完的なデータを取り入れたマルチモーダル感情評価へと研究が移行しています10,11,12。複数のモーダルを統合する利点は、early fusion-long short-term memory (EF-LSTM)13、light and FM deep neural networks (LF-DNN)14、tensor fusion networks (TFN)、および低ランクマルチモーダル融合アプローチなどのベースラインモデルによって実証されています。しかし、これらのアプローチのほとんどはオフラインでの特徴量生成に依存しており、動的な現実世界の状況には適していません。
感情状態に対応するため、マルチモーダル感情識別に関する研究と応用が過去10年間で発展してきました15。今日、最も困難かつ重要な研究領域の一つは、多様なデータソースを用いた感情状態の継続的なモニタリングです16。このような多様な知識システムの出現に伴い、マルチモーダリティという概念が自然に生まれ、感情コンピューティング、ヒューマンコンピュータインタラクション(HCI)、学習、ビデオゲーム、カスタマーサービス、医療ケア、ユーザーエクスペリエンス(UX)評価などの領域における感情応用の多くの進歩をもたらしました。しかし、UX評価に感情認識技術を適用することは、必ずしも容易ではありませんでした。
単一のモダリティ(unimodal)の手法ではなく、マルチモーダル認識に重点を置く主な理由の一つは、単一の情報源に依存することに内在する欠点があるためです。単一モダリティの感情検出システムは、データの欠落や不明瞭さにより精度が低下することがありますが、一方でMER(マルチモーダル感情認識)スキームは、複数のデータソースを統合することで、より信頼性が高く、表現状態に関するより包括的で思慮深い理解を提供します17。例えば、顔の表情だけで感情を正確に分類することは、特にジェスチャーが複雑であったり不明瞭であったりする場合に不十分である可能性があります。しかし、顔の表情を言語や身体的キューなどの他のコミュニケーション形式と組み合わせることで、感情認識の精度を高めることができると考えられます。
感情認識に関する広範な研究が、いくつかのモダリティを用いて行われてきました。初期の研究では、画像、音声、またはテキストベースの入力など、異なるモダリティから特徴的な要素を特定することに焦点が当てられていました。しかし、多様なモダリティを統合することで、バランスの取れた感情情報を得ることができ、より信頼性と精度の高い感情検出が可能になることがますます明らかになっています。本セクションでは、単一モダリティおよびマルチモーダル感情分析における主要な進展をレビューし、ベースラインの手法、その欠点、および我々の手法の根拠について考察します。
感情認識に関する初期の研究は、主に単一のモダリティに焦点を当てていました。視覚領域では、画期的な研究によりプロトタイプ的な顔の動きの分類が行われました20。その後の進展として、視覚的動き21や隠れマルコフモデル22など、時間的なダイナミクスを捉える手法が登場し、一方で顔の反応はFacial Action Coding System (FACS)23を用いてアクションユニットに分類されました。LSTMや畳み込みニューラルネットワーク (CNN) は、生の音声信号から有意義な特徴を直接抽出することに成功しており、音声ベースの感情識別手法は、従来の信号処理からディープラーニングへと進化しています24。テキストベースの感情分析における文脈的な感情信号の抽出は、アテンションメカニズムを組み込んだ回帰型ニューラルネットワーク (RNN) や、より最近ではTransformerベースのモデルによって大幅に強化されました。これらの成果はあるものの、単一モダリティの手法は、他のモードに含まれる補完的な情報が欠けているため、人間が経験する複雑さを正確に表現することは本質的に不可能です。
対話感情識別におけるより長期的なコンテキストデータを収集するため、2021年にDialogXLモデル25などのアテンションメカニズムに基づくモデルが提案された。Kimらは、26 2021年に、ERC(感情認識会話)の精度を向上させるためにEmoBERTaモデルが導入されました。このモデルは、話者データを利用することで、会話における話者の特徴および話者相互間の相互作用に関する特徴を改善します。2022年、Liらは27 CoG-BART法を提示した。この手法では、教師あり対照学習を用いることで、関連データの解釈におけるモデルの能力を向上させている。なお、教師あり学習には大量のラベル付きデータが必要であることに留意されたい。
このような研究の代表的な例として、特徴量間の相互作用トークンと対比的アライメントを用いてモダリティ間の汎化性能を向上させるMultimodal Interaction-Aware Representation (MIAR) フレームワーク28がある。MIARはモダリティのアライメントを改善し、複数のデータセットにおいて高い性能を達成しているが、主に予測精度に焦点を当てており、視覚的なマッピングには対応していない。同様に、Cross-Attentional Audio-Visual Fusion モデル29は、バレンス(快・不快)およびアロウザル(覚醒度)の予測において、きめ細かなオーディオ・ビジュアル間の相互作用を効果的に捉えているが、2つのモダリティに限定されており、可視化機能に欠けている。LSTMネットワークとオートエンコーダー融合に基づく時間的モデリング手法は、感情の時間的ダイナミクスを捉えることに成功しているが、モダリティ間の相互作用や学習された感情表現に関する知見は限定的である。より最近では、Transformer-based Multimodal Fusion Network (TMFN)30などのTransformerベースの手法が、マルチモーダル融合と対比学習の強化により、CMU-MOSIおよびCMU-MOSEIにおいて強力な性能を示している。それにもかかわらず、これらのアプローチは依然として主に性能重視であり、説明可能性、特徴量レベルの解釈、および相互作用を重視した可視化へのサポートは限られている。
テキスト、音声、および視覚データの統合を強化するために、いくつかのマルチモーダル感情認識手法が提案されてきました。EF-LSTMやLF-DNNなどの初期融合(early fusion)手法は、複雑なクロスモーダル相互作用を捉えることはできませんでしたが、感情分析においてマルチモーダル情報を活用することの有用性を示しました。TFNは、CMU-MOSIやCMU-MOSEIなどのベンチマークデータセットにおける性能を向上させ、モーダル間相互作用の明示的なモデリングを導入しましたが、解釈可能性の低さと計算複雑度の高さが実用性の妨げとなりました。モーダリティの整合性と動的な特徴融合を改善するため、MIAR、クロスアテンション融合モデル、TMFN、および適応的マルチモーダルTransformerなどのより現代的な手法では、Transformerトポロジーとアテンションメカニズムが採用されています。これらの手法は、正解率、F1スコア、平均絶対誤差などの一般的な評価指標において競争力のある結果を達成しているものの、主に予測性能に焦点を当てており、特徴レベルの感情表現やクロスモーダル依存性に関する知見はほとんど得られていません。さらに、潜在的な感情埋め込み、アテンション分布、および時間的な感情動態を明らかにできる可視化技術を確立した研究や、モーダル間相互作用のグラフベースのモデリングを統合した研究はほとんどありません。提案するアプローチでは、これらの欠点を克服し、マルチモーダル感情認識の性能を向上させるために、マルチビュー視覚マッピング、グラフベースのクロスモーダルアテンション融合、およびもつれ解消表現学習(disentangled representation learning)を組み込んでいます。
同様に、Adaptive Multimodal Transformer32は、ノイズを含む、あるいは欠落したモダリティ情報を適応的に軽減するための交換ベースの融合を提案し、これにより感情分類の性能を向上させています。このアプローチは、モダリティ情報の分布における不一致を効果的に解決できますが、その設計は感情分析という特定のタスクに特化しており、学習された感情表現に関する洞察は限定的です。もう一つの重要な貢献は、リアルタイムのマルチモーダル感情認識のためにCNN、乗算的LSTM、およびトランスフォーマーベースのアテンションを統合したMultimodal Fusion Model33です。このモデルは、ビデオ、オーディオ、テキストの各モダリティに対して完全な融合を行い、堅牢な認識性能を示しています。それにもかかわらず、他の既存モデルと同様に、主に予測精度に焦点を当てており、可視化やインタラクションを重視した解釈性のための明確な機能に欠けています。
結論として、現在の最先端のマルチモーダル感情認識アプローチは、クロスモーダル相互作用の捕捉と予測精度の向上において大きな成果を上げていますが、その多くは認識主導のタスクに重点を置いています。特徴レベルの解釈可能性、画像空間における感情表現の可視化、およびインテリジェントなインタラクション設計のための提案フレームワークの導入といった領域への関心はほとんど向けられていません。これらの課題を念頭に置き、本フレームワークを提案します。
マルチモーダル感情認識に顕著な進歩が見られるものの28,29、現在の手法の大部分は主に予測性能の向上に焦点を当てており、学習された感情表現やクロスモーダル相互作用の解釈可能性についてはほとんど提供されていません。テキスト、音響、視覚の各モダリティ間の複雑な相互作用は、特にモダリティ間の不一致や情報の不足が発生した場合、現在の融合戦略ではモデル化することが困難な場合が多くあります28,31。Transformerベースの設計やアテンションメカニズムは表現学習を強化しましたが、感情特有の情報とモダリティ特有の情報が明示的に分離されていないため、その透明性と解釈可能性はしばしば低下しています31,32,33。さらに、モーダル間相互作用のグラフベースのモデリングを調査したり、時間的な感情ダイナミクス、アテンション分布、および感情埋め込みを開示できる可視化フレームワークを構築したりした研究はわずかしかありません。これらの欠点は、相互作用を重視した視覚的マッピングと強力なクロスモーダル学習を組み合わせた、インテリジェントなヒューマンマシンインタラクションのための解釈可能なマルチモーダルフレームワークの必要性を示しています。
本研究では、インテリジェントインターフェース設計におけるマルチモーダルな感情アスペクトを視覚的にマッピングするための、解釈可能なフレームワークを提示します。本システムは、手動で作成された特徴量を必要とせず、エンドツーエンドのディープラーニングを用いて、テキスト、音声、視覚の各モダリティから高レベルの感情表現を抽出します。クロスモーダルな感情相互作用は、感情特有の情報とモダリティ特有の情報を分離するグラフベースのアテンション融合メカニズムを用いてモデル化されており、これによりもつれのない表現学習が可能となり、解釈性と堅牢性が向上します。さらに、感情の時間的ダイナミクス、クロスモーダルアテンションパターン、および感情エンベディングを表示するためのマルチビュー可視化モジュールを構築しました。提案したフレームワークの有効性と、インテリジェントなヒューマンマシンインタラクションシステムへの適合性は、ベンチマークとなるマルチモーダル感情認識データセットを用いた検証によって評価されています。
本研究では、マルチモーダルな感情側面の視覚的マッピングのための独自のフレームワークを提案します。これは、従来の予測重視のアプローチを超え、現在のマルチモーダル感情識別システムにおけるクロスモーダル相互作用のモデリングの不十分さと、限定的な解釈可能性を克服することを目的としています。提案された手法は、単一のアーキテクチャ内で、Transformerベースのマルチモーダル表現学習、もつれを解いた(disentangled)感情認識特徴モデリング、グラフベースのクロスモーダル・アテンション融合、および相互作用指向の視覚化を組み合わせています。分類性能に主眼を置く現在の手法とは対照的に、本フレームワークでは感情特異的な表現とモダリティ特異的な表現を明確に分離することで、解釈可能性、堅牢性、およびクロスモーダルの一貫性を向上させています。さらに、テキスト、音声、視覚の各モダリティ間における詳細な感情的相互依存性を捉えることで、モーダル間相互作用の適応的なモデリングを可能にするグラフベースのアテンション機構を導入しました。また、時間的な感情の軌跡、クロスモーダル・アテンションパターン、および潜在的な感情埋め込みを明らかにすることで、モデルの意思決定プロセスに対する直感的な洞察を提供し、透明性を高めるマルチビュー視覚化モジュールを構築しました。CH-SIMSおよびCMU-MOSEIのベンチマークデータセットを用いた実験的な評価により、マルチモーダルな感情ダイナミクスの視覚化と解釈可能性が向上しただけでなく、精度、F1スコア、平均絶対誤差、および相関において競争力のある性能が示されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究は、マルチモーダル感情特徴の視覚的マッピングのための解釈可能なフレームワークを提供することにより、インテリジェントなインタラクションデザインを改善することを目的としています。本研究では、一般に公開されているCH-SIMSおよびCMU-MOSEIデータベースを使用しました。両方のデータセットは公式の出所から取得され、それぞれの作成者が定めた利用ガイドライン、研究基準およびライセンス条件に従って使用されました。データセットのテキスト、音声、および動画データを含むマルチモーダルコンテンツは、データ提供者が承認された参加者の許可およびデータ収集プロトコルに従って、まず収集およびアノテーションを行ったものです。本研究では、人間との直接的な相互作用、新たな参加者の募集、個人を特定できる情報の収集は一切行われませんでした。すべての分析は、公開されている研究用データセットを用いて実施されました。したがって、我々の二次データ分析には、追加の倫理的承認や機関審査委員会(IRB)の審査は必要ありませんでした。本研究は、公開データセットの利用、倫理的な研究手順および関連するデータ利用方針を管理する適切な機関基準に準拠して実施されました。
感情の特徴をモーダル間で学習するために、感情またはモーダルに特有の特徴を用いたグラフベースのクロスモーダル注目機構が採用された。リアルタイムの感情認識型インタラクティブデザインを強化するために、マルチビュー視覚マッピングコンポーネントが使用され、感情認識におけるその効率が評価された。得られた結果は、現実世界における感情認識型インテリジェントユーザインタフェースに対して、解釈可能性と効率の両方を向上させることを示している。図1は、提案手法のアーキテクチャのワークフローを示している。図1は、インテリジェントインタラクションシステムの文脈におけるマルチモーダル感情特徴学習のための、提案された視覚マッピングフレームワークの全体的なワークフローを示している。このワークフローは、言語、韻律、顔の表情というそれぞれのモーダルから補完的な感情情報を捉える、同期された3つの入力モーダル(テキスト、音声、動画)から開始される。モーダルに特化したトランスフォーマーエンコーダーが各モーダルを処理し、生データの高次元表現を取得する。次に、これらの表現は、異種データソース間で学習された感情の一貫性を確保するために、感情に特化した埋め込みをモーダルに特化した特徴から分離する「分離された表現学習モジュール」に入力される。その後、各モーダルからの感情に特化した埋め込みは、グラフベースのクロスモーダル注目ネットワークによって統合され、このネットワークはモーダル間の感情的依存関係をモデル化し、インタラクションの文脈に基づいて各モーダルに動的な重要度重みを割り当てる。最終的に、本フレームワークは感情分類の出力とインタラクションに関する知見の両方を提供し、透明性のある感情認識型意思決定および適応型インテリジェントインタラクションデザインを可能にする。
マルチモーダルデータの取得
CH-SIMSおよびCMU-MOSEIデータセットは、同期された動画、音声、テキストなどのマルチモーダル情報を収集した、既存のパブリックドメインのマルチモーダルデータセットである。CH-SIMSデータセットは映画、テレビドラマ、バラエティ番組などから得られた複数の動画セグメントから派生した2,281の動画セグメントを含む中国人のマルチモーダル検査で構成されている。これらの動画セグメントにそれぞれ対応する音声およびテキストが追加されたことで、マルチモーダルデータを用いた感情のマルチモーダル分析に関する研究がより魅力的かつ実行可能になっている。しかし、意見、感情および情動の分析における最大規模のマルチモーダルデータセットの1つはCMU-MOSEIデータセットであり、これは1,000人を超える話者によるさまざまな話題の発話からなる23,000を超える動画クリップから収集された。このデータセットはクラス分布を維持しつつ、訓練用(70%)、検証用(15%)、テスト用(15%)のサブセットに無作為に分割された。
テキストの文字起こし、音声信号、およびビデオフレームは取得され、細かい時間レベルでタイムスタンプが揃えられます。フレームレベルでの統合により、提案された表現学習およびグラフベースの融合メカニズムが、視覚的表現、声のトーン、言語的内容から生じる感情的コンテンツを共同でモデル化し活用することが可能になります。このようなマルチモーダル取得技術により、モーダル間の感情動態を効果的に抽出でき、これはインテリジェントなインタラクション設計および理解可能な視覚的マッピングにとって不可欠です。
表1は、提案手法で使用されるマルチモーダル感情データセットの主要な構造を示しています。話された言葉、声のイントネーション、表情など、関連する感情の幅広い範囲を取得するために、CH-SIMSおよびCMU-MOSEIは、これらのデータセットから動画、音声、テキストのモダリティを統合しています。さらに、CH-SIMSには限られた数のデータサンプルしか存在しないため、中国におけるモダリティ間の相互作用や感情の変化を詳細に検討することが可能です。一方、CMU-MOSEIデータセットは、さまざまな言語、被験者、アノテーション付き感情レベルにわたる大量のデータを含んでいるため、本研究で扱う表現学習および関連する可視化アルゴリズムの堅牢性を評価する上でより重要です。また、従来の研究と比較して、モデルのテストにおける情報選択の困難さを低減しています。
マルチモーダル前処理および同期化
CH-SIMSおよびCMU-MOSEIデータセットからのタイムスタンプ注釈を用いて、テキスト、音声、視覚の各モダリティを同期させ、一貫したマルチモーダル表現学習を実現した。各発話は基本的な分析単位として機能し、同じ時間間隔内の対応する音声および動画セグメントと関連付けられた。アライメントは発話レベルで行われた。文字起こしは各発話の開始および終了タイムスタンプに基づいてセグメントに分割された。同じ時間間隔内に含まれる対応する動画フレームおよび音声信号を抽出することにより、文字起こし・音声・動画間の対応関係を確立した。音声セグメントはWav2Vec 2.0を用いて処理し、音響表現を生成したのに対し、動画セグメントからの視覚フレームはあらかじめ定められたレートでサンプリングされ、Vision Transformer(ViT)を用いてエンコードされた。発話の文字起こしからテキスト埋め込みを生成するにはRoBERTaエンコーダが用いられた。3つのモダリティが異なる長さの特徴系列を生成するため、すべてのモダリティ特徴を単一の発話境界にアライメントすることで時間的同期を達成した。可変長の系列を正規化するために固定長フォーマットが用いられた。より長い系列は最大許容系列長に短縮され、より短い系列はゼロパディングされた。訓練中は、パディングされた要素を有効な特徴位置から分離するためにアテンションマスクが使用された。モダリティ固有の埋め込みは、融合前に共通の潜在空間に射影され、モダリティ間の異なる系列長に対処した。これにより次元の一貫性が保たれ、グラフベースのアテンション機構が効果的なクロスモーダル相互作用学習を促進できるようになった。データ品質および同期の整合性を維持するため、破損したファイル、注釈の欠落、または不完全なモダリティ情報を持つサンプルは研究から除外された。
トランスフォーマーベースの特徴量抽出
ディープラーニング手法を用いて、視覚、音声、テキストなど複数のモダリティにわたる情報をアライメントし、必要な前処理を行った後、エンドツーエンドの方式で高次元の感情認識可能な特徴表現を学習する。提案手法では、生のマルチモーダルデータから本質的に識別性の高い特徴表現を学習するためにトランスフォーマーエンコーダを用いることで、従来の特徴量設計の必要性を排除している。提案アプローチで使用されるデータセット間の一貫性を確保するため、各モダリティに対して固定サイズの埋め込み表現を学習する。例えば、画像、音声、テキストの各モダリティにおいて768次元の特徴埋め込みを学習し、これらを統合して一貫した特徴空間を形成する。この特徴空間は、CH-SIMSデータセットおよびCMU-MOSEIデータセットで用いられる特徴抽出アプローチを含む、全体のアプローチで利用され、さまざまなサイズのデータにわたる高次元特徴の学習に特に活用される。
視覚モダリティ:感情認識可能なフレーム埋め込みのためのビジョン変換器
感情に関連する空間的表現を得るために、ビデオフレームから視覚情報を抽出する目的で、Vision Transformer(ViT-Base)モデルを使用した。特徴抽出の前に、各ビデオセグメントのフレームを(224 × 224)ピクセルにスケーリングし、一定の時間間隔でサンプリングした。16 × 16ピクセルのパッチサイズを用いることで、ViT-Baseアーキテクチャは12層のトランスフォーマーエンコーダーによって処理される一連の視覚トークンを生成する。取得されたフレームレベルの表現は、事前学習済みのViTモデルを視覚的バックボーンとして用いて、768次元の埋め込み空間に射影した。フレームレベルの埋め込みは、平均プーリングを用いて集約し、各セグメントの最終的な視覚表現を生成した。訓練中は、画像の正規化やランダムクロップ、水平反転などの一般的なデータ拡張手法を用いて、一般化性能を向上させた。その後、提案されたマルチモーダル融合フレームワークを用いて、これらの視覚的埋め込みをテキストおよび音響表現と統合した。
感情の時間的動態を維持するために、CH-SIMSおよびCMU-MOSEIデータセットからの動画サンプルは、視覚モダリティに対して均一にサンプリングされる。各動画のフレーム(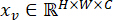 )は、N個の固定サイズのセクションに分割でき、その後フラット化され、次元が
 の潜在的埋め込み空間に逆変換される。位置エンベッディングと学習可能なグループ化トークンを追加することで系列が生成される:
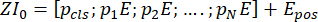 (1)
ここで、 は位置エンコーディングを表し、
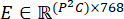 はパッチ埋め込み行列である。
フィードフォワードネットワークおよびマルチヘッド自己注意からなる積層型トランスフォーマーエンコーダ層を用いて、埋め込みパッチ系列を処理する。層 l における変換は次式で表される。
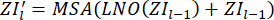 (2)
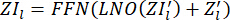 (3)
感情認識可能な視覚的特徴ベクトルを得るために、クラストークンに対応する出力を特徴ベクトル  として抽出する。データセット間での言語やコンテンツの違いがあっても、一貫した視覚的感情表現を実現するために、各ビデオセグメントからのフレームレベルの埋め込み表現を統合し、表情および感情の変化を捉える。
韻律および意味音響埋め込みのためのWav2Vec 2.0を用いた音声モダリティ 文脈を考慮した音声埋め込みは、事前学習済みのWav2Vec 2.0エンコーダーを音響の基盤として使用して生成された。各フレーズについて、平均プーリングを用いて出力された隠れ層の表現を集約することにより、固定長の音響特徴ベクトルが得られた。Wav2Vec 2.0モデルは、音響信号から音響表現を抽出し、文脈的かつ感情に関連する音声の特徴を捉えるために用いられた。特徴抽出の前には、音声記録を正規化し、16 kHzにリサンプリングした。テキストおよび視覚モダリティとの同期を確保するため、データセットのアノテーションで提供されたタイムスタンプの範囲を用いて、各発話レベルの音声セグメントを切り出した。モデル学習中に、事前学習済みの音響エンコーダーを調整し、タスク固有の適応性を高めることで、得られた表現が音声信号の感情的側面をより正確に反映できるようにした。その後、最終的な音声埋め込みを用いて、グラフベースのクロスモーダル注目融合および分離可能な表現学習を実施した。
音声モダリティでは、Wav2Vec-2.0を用いて、CH-SIMSおよびCMU-MOSEIデータセットに含まれる初期の音声情報から得られる音声信号をモデル化し、感情に関連する音響特徴を直接抽出する。各入力音声信号  に対して、畳み込みによる特徴エンコーディングが存在する:
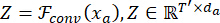 (4)
ここでZは、メロディー、トーン、エネルギーなどの低レベルの韻律的特徴を表す。トランスフォーマーに基づくコンテキストネットワークは、長時間にわたる時間的依存関係を表現する上で、前述の構造に有効である:
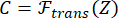 (5)
感情を表現するために不可欠な韻律的および意味的音響データが、これらの文脈的音響表現に含まれます。一定の長さの音声埋め込み表現は、時間的プーリング処理を行うことで生成されます。
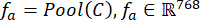 (6)
この設計では、MFCCなどの音響特徴量を使用せず、CMU-MOSEIの英語音声データとCH-SIMSの中国語音声データから波形の表現を単純に抽出するだけで、堅牢性を実現しています。
文脈的感情埋め込みのためのRoBERTaを用いたテキストモダリティ
テキストモダリティに対しては、深層双方向変換器であるRoBERTaを用いて、2つのデータセットから得られた音声文字起こしデータに適用し、文脈的意味および感情的意味を生成する。RoBERTaに基づく変換器エンコーダを用いて、文字起こしデータからテキスト表現を抽出し、文脈的意味情報および感情情報を捉える。英語のCMU-MOSEIデータセットには事前学習済みRoBERTaモデルを用い、中国語のCH-SIMSデータセットには言語特有の言語的特徴をより適切に扱うために中国語版RoBERTaモデルを用いた。テキストの前処理には、各言語に応じた適切なRoBERTaトークナイザを用いたトークン化およびテキスト正規化を含めた。一貫したバッチ処理を保証するため、入力系列をトークン埋め込みに変換し、所定の最大系列長に合わせてパディングまたは切り詰めを行った。RoBERTaの入力形式に従い、特別な分類トークンおよび区切りトークンを導入した。変換器エンコーダが生成する文脈化されたトークン表現を、最終的な[CLS]相当の文表現を用いて集約することで、固定長のテキスト埋め込みを得た。学習された表現を感情認識タスクに適応させるために、事前学習済みRoBERTaエンコーダをマルチモーダル学習によって微調整した。その後、提案するマルチモーダル融合フレームワークを用いて、テキスト埋め込みを音響および視覚的特徴と統合した。
トークン化された各入力に対して、トークンの埋め込みと位置エンコーディングを組み合わせることができ、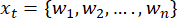 、いわゆるディープ双方向変換技術における入力表現を生成する。
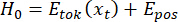 (7)
この形式は、単語間の文脈的依存関係を自己注意(self-attention)によって発見するLトランスフォーマーの層を通して表現される:
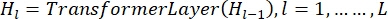 (8)
文脈的感情埋め込みは、分類トークンの最終的な隠れ状態を使用して取得される:
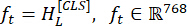 (9)
感情関連の言語的特徴の例として、感情の極性、強い感情、および関連する含意があり、これらはこの埋め込み表現によって表現される。RoBERTaは言語に依存しないモデリングを容易にする。これにより、CMU-MOSEIデータセットの英語テキストとCH-SIMSデータセットの中国語テキストの両方に対して、同じ埋め込みサイズを使用できるようになる。
提案されたディープ特徴表現学習ステップにより、視覚的 fv、音声的 fa、テキスト的 ft モダリティそれぞれの768次元のモダリティ特有の特徴ベクトルが抽出される。知的インタラクション設計において、これらの学習された表現は統一されたマルチモーダル特徴空間を形成し、特徴レベルの視覚的マッピング、グラフベースのクロスモーダル融合、および分離された表現学習の基盤となる。
ディセントangled表現学習
ディープフィーチャー表現を学習した後、視覚、聴覚、テキストという複数のモダリティから得られたマルチモーダルな特徴ベクトルをさらに処理することで、分離された感情記述を得ることができる。前のステップで使用された聴覚、視覚、テキストモダリティのモダリティ固有の特徴埋め込みをそれぞれ fv、fa、ft とすると、 および
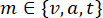 が成り立つ。このステップの目的は、各モダリティの以前の意味情報を考慮に入れたうえで、すべてのモダリティ特徴を感情記述を含む2つの異なる潜在的表現に分解することである。
これは、各モダリティ特徴fmを、感情エンコーダー  とモダリティエンコーダー
 という2つの並列プロジェクションネットワークに入力することで実現され、この2つのエンコーディングが生成される。
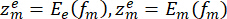 (10)
ここで、 は感情に関連付けられた潜在的特徴を表し、
 はモダリティ固有の潜在的特徴を表す。これにより、音声、視覚、テキストなど複数の入力に対して繰り返し共有される感情特有の埋め込み表現が可能となり、同時に各モダリティに固有の構造的データを維持することができる。
独立性制約を用いた再構成によって、効果的な分離が実現される。元のモダリティ特徴の再構成は次式で与えられる。
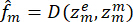 (11)
ここで、 はデコーダーネットワークである。再構成損失は以下のデータを保持する:
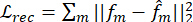 (12)
さらに、感情とモダリティ固有の描写との間の直交性、あるいは無相関性は、多くの場合、情報の重複を制限する:
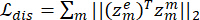 (13)
これらの目的を達成することで、モデルは信頼性が高く、理解可能で、モダリティの変動に対して頑健な感情表現を学習する可能性がある。後段のグラフベースのクロスモーダル融合や視覚的マッピングの特徴は、特に知的インタラクション設計において、解釈可能で構造化された感情表現に強く依存している。
モダリティ間における感情の一貫性
感情の整合性を追加することで、モダリティ間の融合の効果が明確に向上する。これは、モダリティ固有の感情埋め込みが潜在空間を共有しているため、2つの表現間の大きなギャップを融合戦略が考慮する必要がなくなるからである。2つの感情の統合的表現は次のように記述される  。感情固有の表現が整合している場合、モダリティ間の信号の変動が結果に影響しなくなるため、重み付き融合はより安定する。
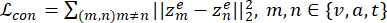 (14)
感情情報の意味論的対応を強制することにより、この目的はモダリティ間の不一致を最小限に抑え、感情知覚がそれを表現するために使用されるモダリティにかかわらず一貫性を保つようにする。その結果、音声信号、表情、言語的コンテンツから得られる感情手がかりを射影することで、統合的かつ情動的な表現空間が構築される。
クロスモーダル融合への影響
感情の一貫性がモダリティ間で導入されると、クロスモーダル融合はより効果的になる。感情特有の埋め込み表現が共通の潜在空間で整列しているため、融合メカニズムはもはやモダリティ間の大きな表現のギャップを埋める必要がなくなる。融合された感情表現は次のように定義される。
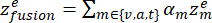 (15)
αmはモダリティmに与えられるアテンションの重みを表す。感情特異的な表現が一貫している場合、融合結果が矛盾したモダリティ信号ではなく、補完的な感情的根拠を示すため、重み付き融合はより安定し、解釈可能になる。
数学的には、 感情特有の表現形式間の分散を に対して低下させることは、次と等価である。
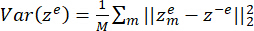 (16)
ここで、 は平均的な感情表現を表す。分散が小さくなることで、入力モダリティはモダリティのノイズではなく、正確な感情的意義に基づいて重み付けられ、ネットワークの収束性が向上し、より正確なアテンション評価が保証される。
感情の分離された可視化を学習する際の最終的な目標は、断片化、再構成、および感情の一様性を組み合わせることである:
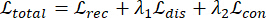 (17)
このモデルでは、2つのハイパーパラメータλ1およびλ2が、クロスモーダル感情の信頼性と非関連性との関係を制御する。提案モデルは、モダリティに依存しない、解釈可能で融合可能な感情表現を獲得することでこれを実現し、知的インターフェース設計における後続のグラフベース融合および特徴レベル表現に堅固な基盤を提供することを重視している。
グラフベースのクロスモーダル注目融合
細粒度の感情関係をモダリティ間で模擬するために、グラフベースの交差モダリティ注意ネットワークが使用された。モダリティ間の情報フローを促進するため、各モダリティ固有の埋め込み(テキスト、音声、視覚)をグラフノードとして表現した完全連結マルチモダリティグラフを構築した。モダリティ間の関係性を用いてグラフ隣接行列を構築し、その後、学習可能な注意手法によってこれを改善した。複数の注意ヘッドからの出力を連結・射影することにより、共有潜在空間を作成した。統一されたマルチモダリティ感情表現は、注意重み付きプーリングを用いてノード表現を集約することで生成された。この融合表現は、相互作用を考慮した分析および感情認識のための予測および可視化モジュールに送られた。グラフ融合モジュールは256の隠れ層次元を持ち、それぞれ8つの注意ヘッドを有する2つのグラフ注意層を備えていた。隣接するモダリティの相対的な重要度を特定するために、接続されたノード間の注意係数を計算し、ソフトマックス関数を用いて正規化した。各グラフ注意層には、層正規化、残差接続、および過学習を抑制して学習の安定性を高めるためのドロップアウト率0.2が適用された。複数の注意ヘッドの出力を共通の潜在空間に連結・射影した後、注意重み付きプーリングを用いてノード表現を単一のマルチモダリティ感情埋め込みに統合した。その後、この融合表現を用いて多視点の視覚的マッピングおよび感情予測を行った。
多様なクロスモーダル相互作用は、マルチヘッドグラフアテンションを用いて捉えられた。接続されたノード間のアテンション係数を正規化するために、各ノードに対してソフトマックス関数が使用された。学習の安定性を高め、過学習を回避するために、グラフ融合モジュールの積層されたグラフアテンション層の後に、残差接続、層正規化、およびドロップアウト正則化を設けた。
ここで、はそれぞれ、視覚、音声、テキストという各モダリティによって捉えられた特定の感情に対応する表現を個別に表している。各成分は共有された潜在空間  内に存在する。モダリティノードのモデルは、グラフの表記
 を用い、
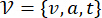 で表されるノードの集合は、3つのモダリティノードそのものを指し、さまざまなモダリティ表現間で共有される感情的依存関係を明示的に強化する。
グラフ内の各ノードに感情固有の特徴ベクトルを割り当てた後、次のようになります:
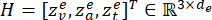 (18)
従来の融合手法は事前に決定されたまたは固定された融合重みを使用するのに対し、本提案手法は、チャンネル間および感情状況間の重要性と相互依存性に基づいて、適応的なエッジ重みを学習する。
クロスモーダル融合には、グラフアテンションネットワーク(GAT)が利用される。各ノード i とその隣接ノード(すなわちノード j)に対して、アテンション係数が計算される:
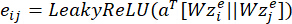 (19)
モード j からモダリティ i に切り替えることによる感情的効果は、正規化された重み αij によって測定される。
次に、各モダリティノードの融合された外観は、その隣接ノードの重み付きグループ化として計算される:
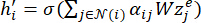 (20)
ここで、活性化関数  は非線形である。最終的に、各ノードの更新された特徴量を統合して、グローバルな感情融合表現を得る:
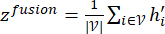 (21)
さまざまなモダリティからの補足的な情報を捉えながら、複雑なモダリティ間の関係性を維持するため、解釈可能な感情モデリングとその後の視覚的マッピングに有用な技術である。
アルゴリズム1(補足ファイル1)は、グラフベースのクロスモーダル融合を実行するための一般的な枠組みを示している。まず、視覚、音声、テキストの各モダリティにそれぞれ関連付けられた感情特有の特徴を用いてグラフが構築される。次に、感情的依存関係を表す各グラフノードペア間のアテンションスコアが計算される。その後、これらのアテンションスコアは正規化され、指定された感情的文脈において各モダリティが持つ相対的な寄与度を示すことで、アテンション重みの学習を可能にする。最終段階では、グラフのノードに関連付けられた特徴を集約することにより、一般的な感情埋め込み表現が生成される。このように、指定された感情に関連するマルチモーダル特徴を一般的に融合する本アルゴリズムは、適応性、解釈可能性、文脈的知性の面で有望である。
図2は、マルチモーダル感情融合のための提案されたクロスモーダル注目ネットワークの構造と動作を示している。テキスト、音声、動画の各モダリティから独立に得られた感情特有の埋め込み表現は、最初にモダリティレベルの注目機構を通過し、これにより特定の感情的文脈における言語的、声学的、顔の情報の相対的な重要性が学習される。モダリティの注目重み付き表現は、次に統一された感情埋め込みを形成するために統合され、この中で注目行列はモダル間の依存関係および相互作用の強さを捉える。ネットワークによって学習された注目行列は、モダリティの寄与を動的に調整し、ノイズが多く情報量が少ないモダリティを無視しながら、最も効果的な指導モダリティに注目することを可能にする。融合された感情表現により、中立、抱擁、不安などの感情状態について正確な感情認識および細かな分析が可能になる。
視覚的マッピングモジュール
視覚マッピングセクションの支援を受けて、知覚された感情状態の統一表現を、グラフに基づくクロスモーダル融合プロセス後に理解可能で容易に利用可能な視覚的形態に変換することが、優れたインタラクションデザイナーにとって可能になる。
潜在的な感情表現を理解しやすくするために、次元削減技術を用いて学習されたマルチモーダル感情埋め込みを可視化した。主成分分析(PCA)を用いて特徴量の次元を削減しつつ、大部分の分散を保持した後、t分布型確率的近傍埋め込み(t-SNE)を用いて埋め込みを2次元空間に投影して表示した。t-SNEには、パープレキシティ30、学習率200、最適化反復回数1,000を設定した。得られた投影を用いて、感情特異的なクラスタおよびモダリティ間の関係性を可視化した。グラフベースのアテンションネットワークによって得られた正規化されたクロスモーダルアテンション重みを用いて、アテンションヒートマップを作成した。これらのヒートマップは、感情予測中にテキスト、音声、視覚モダリティがそれぞれどの程度寄与しているかを示している。学習されたアテンション係数をエッジの重みとして用いてクロスモーダル相互作用グラフを作成し、融合フレームワーク内のモダリティ間の関係性および情報の流れを視覚的に検討できるようにした。連続する発話における潜在的感情埋め込みの変化を追跡することで感情軌跡プロットを作成し、時間的経過に伴う感情の動的変化を調査した。これらの軌跡は、感情状態およびモダリティの寄与が時間とともにどのように変化するかを明らかにする。すべての可視化は、MatplotlibおよびScikit-learnといったPythonパッケージを用いて作成した。解釈可能性、クラスタ形成、モダリティの寄与、および時間的経過に伴う感情の動的変化を評価するために、埋め込みの可視化、相互作用グラフ、アテンションヒートマップについて定性的な分析を行った。
変数 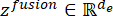 は、グラフ注意ネットワーク関数による感情状態の融合表現を表すものとする。感情状態プロットの出力レベルの可視化とは対照的に、本モジュールの主な目的は、感情状態の表現と注意機構に対応する重みを、理解可能な視覚的形態に変換することである。
αjiを用いて、各モダリティの寄与度を視覚的に検討するためのアテンションヒートマップを作成する。次に、入力アテンション重みを合計して、各モダリティに対する複合的な重要度スコアを決定する:
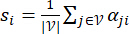 (22)
ここで、si はモダリティIの相対的な感情的寄与度を表す。アテンションヒートマップを作成するために、得られた値は正規化され、色マップにマッピングされる。これにより、ユーザーはさまざまな時間ステップやインタラクティブな状態において、どのモダリティが顕著であるかを容易に識別できるようになる。このようなインタフェースは、視覚的、聴覚的、またはテキスト入力といったさまざまな入力モダリティを通じて、システムのアテンション機構がどのように機能しているかをユーザーが理解するのを支援する。
学習されたグラフは、人間の感情のクロスモーダル依存関係を表現するために、「重み付き相互作用グラフ」として具体的にモデル化される。モダリティ自体はグラフ内の各ノードで表され、人間の感情に関わる相互作用の強度は、それらを接続するエッジ上のαjiの形の重みによって表現される。上記の重み付きグラフは、人間の感情的相互作用の強度を示している。iおよびjの定義は次のとおりである:
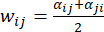 (23)
これらの重みのおかげで、グラフの可視化における線の太さや透明度が適切に表示される。これにより、モダリティ間の相互作用を理解しやすくなる。クロスモーダル相互作用グラフを用いることで、設計者は融合プロセス中に感情指標がどのように相互作用するかをより明確に理解できる。
さまざまな時間ステップにおける融合された感情の埋め込み表現  は、主成分分析(PCA)やt-SNEなどの次元削減アルゴリズムを用いて低次元空間に圧縮され、時間的変化する感情の推移を可視化する。
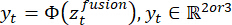 (24)
ここで、射影関数は  で表される。感情の推移、強度、および相互作用における安定性を示す2次元/3次元の感情軌跡の出現は、時間とともに変化する感情状態の推移を直感的に描いたものと解釈できる。これらの側面は、知的相互作用、意思決定、およびリアルタイム監視に利用可能である。
従来の感情システムが特定のクラスやスコアへの単なる対応付けを提供するだけであるのに対し、本システムは人間の感情がどのように形成されるかを示すことに重点を置いています。本システムは、重み付け因子、モデル間の相互作用、およびそれらに対応する経路を含む中間的特徴の可視化を通じて、意思決定プロセスを明らかにします。これにより、ユーザーは視覚的、音声的、言語的といった各因子が、人間の感情に対する応答の生成にどのように影響しているかを理解できるようになります。
視覚的な表現を通じて感情を理解しやすい形にマッピングすることで、ディープラーニングを用いた感情分析とインテリジェントなインターフェース設計への統合との間にあるギャップを埋めることができる。両者のアプローチから収集されたデータは、より正確なユーザーインターフェースを作成するために活用できる。したがって、提案されたアプローチは、インタラクションデザイナーがより正確なユーザーインターフェースを設計するための重要な情報を提供することができる。言い換えれば、感情の理解はインタラクションデザインにおいて非常に能動的な要素となる。感情の理解がインタラクションデザインに能動的に組み込まれるとき、正確性はさらに高まるのである。
視覚的マッピングモジュールは、いくつかの相互に関連しつつも異なる方法で説明可能性を実現します。特徴レベルの説明可能性は、DNNによって生成された感情の基礎となる表現を明らかにし、感情に関連する各特徴を記述するために使用される意味内容を理解することを可能にします。モダリティーレベルの説明可能性は、インタラクショングラフと視覚的アテンションヒートマップのデータを用いて、視覚、音声、テキストの各モダリティーが感情表現の意思決定にどのように寄与しているかを説明します。最後に、感情の埋め込みから得られる軌跡により、視覚的およびテキストモダリティーが動的な相互作用の観点から時間とともにどのように変化するかを理解できます。詳細はアルゴリズム2(Supplementary File 1)を参照してください。
融合されたマルチモーダル感情特徴は、提案する視覚マッピングアルゴリズム2を用いて、インテリジェントなインタラクション設計のための視覚的に有意な表現へとマッピングされる。グラフベースのマルチモーダルアテンション重みを用いて、各時刻における入力される視覚的、音声的、テキスト的要素間の差異を定量化する。これらの差異は、ヒートマップ視覚要素を用いて感情に影響を与える主な要因を強調するために、視覚的表現へとマッピングされる。入力要素間の相互作用の関係性を明らかにし、マルチモーダル入力要素によって生成される感情の変化を伝えるために、次にペアワイズの相互作用強度を計算し、マルチモーダル相互作用重みを作成する。同時に、時間経過とともに収集された融合感情要素を低次元空間へとマッピングすることで、感情の変化過程を示す視覚表現を生成する。
感情の予測と相互作用のフィードバック
融合された感情表現の結果は、として表され、インタラクションフィードバックと感情予測の両方の関数として利用される。さらに、感情予測は、連続的な感情強度認識のための回帰タスクと、離散的な感情認識のための分類タスクから構成されるマルチタスクモデルとして記述される。離散的な感情認識には、以下のソフトマックスに基づく分類モデルが用いられる。
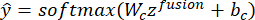 (25)
ここで、 は期待される感情クラスの確率を表し、Wc および bc は学習可能な制約条件である。分類目的の最適化には交差エントロピー損失が用いられる:
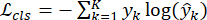 (26)
ここで、yk は正解のタグ、Kは感情クラスの数を表す。回帰ブランチは感情の強度を並行して推定するために使用され、価値(ヴァレンス)や覚醒度など、さまざまな連続的な感情属性の予測を生成する。これに対して以下の定義を与える:
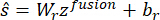 (27)
期待される感情の強さのスコアは、 で示される。回帰タスクの精度向上には、平均二乗誤差損失が用いられる:
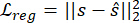 (28)
一般的に、この2つのタスクは予測目的において統合される:
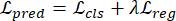 (29)
ここで、回帰と分類の目的はλによってバランスが取られます。このアプローチは、感情状態に基づいて可視化モジュールを動的に調整し、このようなインタラクションを認識したフィードバックを可能にすることを示唆しています。ある時刻tにおけるインタラクションの文脈は、ctで表現されます。可視化モジュールの応答は次式で与えられます。
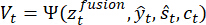 (30)
ここで、可視化適応関数は  で表される。これにより、予測される変化や感情に基づいて、モダリティヒートマップ、相互作用グラフ、感情の軌跡をリアルタイムで調整することが可能になる。これは、感情状態の予測において高い性能を発揮するだけでなく、フィードバックに対して実質的な支援を提供していることを示している。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
本研究では、2つのベンチマークデータセットであるCH-SIMSおよびCMU-MOSEIを用い、提案するマルチモーダル感情特徴の視覚的マッピングフレームワークを、インタラクションを考慮した解釈性と予測性能の両面から検証しました。実験結果によると、提案手法は相関、精度、F1スコア、平均絶対誤差(MAE)を含む多様な指標において、現在のマルチモーダル感情認識技術よりも一貫して優れた性能を示しました。もつれを解消した感情表現、グラフベースのクロスモーダル融合メカニズム、およびエンドツーエンドの深層表現学習戦略のすべてが、より安定し、意味的に整合した感情モデリングを可能にすることで、この性能向上に寄与しています。提案手法は、視覚的マッピングを通じて、定量的な向上にとどまらず、モダリティの寄与度や感情のダイナミクスをより容易に把握できる、より豊かな特徴レベルの洞察を提供します。言語、文化的表現、およびデータセットの規模が異なるにもかかわらず、前述の性能向上は両方のデータセットで一貫して観察され、提案フレームワークの強力な汎化能力が実証されました。
提案する手法では、マルチモーダル感情解析のため...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
実験結果から、CH-SIMSおよびCMU-MOSEIデータセットにおいて、提案されたマルチモーダル感情特性の視覚的マッピングフレームワークが、現在のマルチモーダル感情認識技術を上回ることが実証されました。EF-LSTMやTFNなどの早期融合(early fusion)および後期融合(late fusion)モデルと比較して、提案手法はより高い精度(accuracy)とF1スコアを達成しており、多様な感情情報を処理する上での堅牢性が示されました。本手法による改善は、モダリティ固有のノイズを抑制し、視覚、音声、テキストの各モダリティ間で感情の一貫性を確保する、もつれを解いた感情表現(disentangled emotion representation)によるものであると考えられます36。
近年、Adaptive Multimodal Transformers37やMIAR38などのトランスフォーマーベースのマルチモーダルモデルが、クロスモーダ...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者らに利益相反はありません。
謝辞
著者らは、マレーシアのペナンにあるマレーシア科学大学(Universiti Sains Malaysia)の住宅・建築・計画学部、および中国の長沙にある長沙理工大学(Changsha University of Science & Technology)のデザイン・アート学部の支援に感謝いたします。また、本研究を通じて学術的および研究的支援をいただいた、中国の厦門にある福州大学(Fuzhou University)の厦門芸術・デザイン学院に深く感謝いたします。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| アダム | PyTorchオプティマイザライブラリ | https://pytorch-optimizers.readthedocs.io/en/latest/ (学習率 = 1) × 10-4) | モデルトレーニングにおけるパラメータの最適化 |
| CH-SIMS | オリジナルデータセットリポジトリ | 最新の一般公開版 | 中国語マルチモーダル感情・情動分析のためのベンチマークデータセット |
| CMU-MOSEI | CMUマルチモーダルSDKリポジトリ | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (最新パブリックリリース) | マルチモーダル感情および情動認識のためのベンチマークデータセット |
| もつれ解消済み感情エンコーダー | カスタム実装 | (デュアルエンコーダー・アーキテクチャ) | 感情特異的およびモダリティ特異的な潜在表現の分離 |
| グラフアテンションネットワーク (GAT) | PyTorch Geometric | マルチヘッドGAT (https://pytorch-geometric.readthedocs.io/en/latest/) | クロスモーダル感情関係のモデリングと適応的特徴融合 |
| グラフベースのクロスモーダル・アテンション層 | カスタム実装 | マルチヘッドアテンション融合 | モダリティ間におけるきめ細かな感情依存関係の学習 |
| Matplotlib | Matplotlibプロジェクト | 3.7+ | プロットの作成と視覚的分析 |
| NetworkX | NetworkXプロジェクト | 3.0+ | クロスモーダル相互作用グラフの構築と可視化 |
| NVIDIA GPU | NVIDIA Corporation | CUDA対応GPU | トランスフォーマーおよびグラフニューラルネットワークの学習加速 |
| 主成分分析 (PCA) | Scikit-learn | sklearn.decomposition.PCA | 高次元感情埋め込みの初期次元削減 |
| Python | Python Software Foundation | 3.8+ | マルチモーダル感情分析フレームワークの実装に使用される主要プログラミング言語 |
| PyTorch | PyTorch Foundation | 2.0+ | 深層ニューラルネットワークの開発、学習、および最適化 |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base、768次元埋め込み) | 文脈的な言語的および意味的な感情表現の抽出 |
| Seaborn | Seabornプロジェクト | 0.12+ | アテンションヒートマップの作成と統計的視覚化 |
| t-分布確率的近傍埋め込み法 (t-SNE) | Scikit-learn | scikit-learn.org (パープレキシティ = 30, 反復回数 = 1000) | 潜在的な感情クラスターとトラジェクトリの可視化 |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS 以降 | 実験実施環境 |
| ビジョン・トランスフォーマー (ViT-Base) | Google Research Vision Transformer | ViT-Base/16、768次元埋め込み | ビデオフレームからの感情認識視覚表現の抽出 |
| Wav2Vec 2.0 | Meta AI Research | ベースモデル、768次元埋め込み | 文脈的な音響的特徴および音声感情特徴の抽出 |
参考文献
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。