このプロトコルは、ピンホイール畳み込み、デュアルアテンション、多スケール融合を統合したU字型ディープラーニングネットワークを実装し、大腸ポリープをセグメント化します。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
方法論記事
大腸前がん病変診断のためのピンホイール畳み込みと二重注意に基づくポリープセグメンテーションネットワーク
* These authors contributed equally
この記事について
サマリー
要約
大腸ポリープの正確なセグメンテーションは、大腸がんの早期予防と診断に不可欠です。しかし、ポリープの形状、大きさ、質感が非常に異質であり、腸内環境(ひだ、鏡面反射、糞便残渣など)も複雑であるため、既存の方法は境界の定位や小ポリープ検出において依然として大きな課題に直面しています。これらの課題に対処するため、本論文はピンホイール畳み込みとデュアルアテンション(PWD-Net)に基づくポリップ分割ネットワークを提案します。提案されたネットワークはU字型のエンコーダ–デコーダアーキテクチャを採用しており、事前学習済みのResNetをエンコーダとして用いて多層局所特徴を抽出します。具体的には、ピンホイール畳み込みモジュール(PCM)をボトルネック層に導入し、多角度回転畳み込みカーネルを通じてポリプのグローバルな幾何学的構造と多方向の文脈情報を捉えます。チャネル注意と空間注意を統合するデュアルアテンションメカニズム(DAM)は、背景雑音を適応的に抑制し、ポリープ領域の特徴を強化することを目的としています。さらに、マルチスケール特徴融合(MSF)戦略を用いて、深い意味情報と浅い境界の詳細を組み合わせ、セグメンテーション結果の完全性と精度の両方を確保しています。Kvasir-SEGおよびCVC-ClinicDBデータセットで行われた実験では、PWD-Netはそれぞれ平均Dice係数0.865と0.944、IoUスコア0.765と0.892を達成し、既存の最先端手法を大きく上回っています。アブレーション研究は各モジュールの有効性を検証し、データセット横断評価によりモデルの強力な一般化能力が確認されます。本研究は、臨床ポリープの分割に関する高精度かつ堅牢なソリューションを提供し、大腸前がん病変の早期診断に大きな価値を提供し、コンピュータ支援介入を支援します。
概要
大腸がんは世界的に最も一般的な悪性腫瘍の一つであり、発生率と死亡率は常に高いです。研究によれば、ほとんどの大腸がんは腺腫性ポリープから発症することが示されており、この過程は通常10〜15年かかるため、早期発見や介入のための貴重な時間軸となっています。腺腫検出率(ADR)を1%増加させることで、大腸がんのリスクを約3%減少させ、患者の死亡率を有意に低下させることができます。大腸内視鏡検査は大腸がん検診のゴールドスタンダードとされており、検査中にポリープを直接除去できるため、がんの発生率と死亡率を効果的に減少させます。
しかし、従来の大腸内視鏡検査は内視鏡医の経験と技術レベルに大きく依存します。主観的判断、視覚疲労、注意散漫などの要因により、20%〜30%の誤入率が生じ、スクリーニングの効果に直接影響します。したがって、大腸ポリープの自動分割のためのコンピュータ支援検出(CAD)システムの開発は、ADRの改善と診断見落としの減少に非常に重要です。最近の臨床調査では、人工知能を内視鏡病変評価ワークフローに統合する関心がさらに浮き彫りになり、堅牢で再現性の高いセグメンテーション手法の必要性が強調されています3.
近年、ディープラーニングは医療画像解析、特に畳み込みニューラルネットワーク(CNN)において顕著な進歩を遂げており、画像セグメンテーションタスクにおける特徴抽出と表現に強い能力を示しています。古典的な医療画像セグメンテーションモデルとして、U-Netは対称エンコーダ–デコーダアーキテクチャを採用し、接続をスキップして正確なピクセルレベルのセグメンテーションを実現しており、この分野のベンチマークとなっています5。U-Netを基に、複雑な医療画像セグメンテーションタスクに対応するために多くの改良アーキテクチャが提案されています。UNet++は、ネストされたスキップ接続と密集したスキップ接続を導入することで、エンコーダとデコーダの特徴マップ間の意味的なギャップを減らします。ResUNet++は残留ブロック、圧縮・励起モジュール、拡張畳み込み、注意メカニズムを統合し、ポリップ分割7で高い性能を達成しています。U2-Netは、マルチスケールの特徴情報を捉えるために2層の入れ子状U字型構造を採用しています8。最近では、並列符号化と復号経路を活用して分割精度をさらに向上させる二重エンコーダー・デコーダベースの深層ポリープ分割ネットワークが提案されています。
一方で、注意機構の導入により、特徴の強化やノイズ抑制の新たな解決策が生まれます。注意 U-Netは注意ゲートを用いてターゲット領域に集中しつつ、無関係な背景情報を抑制します。デュアルアテンションネットワーク(DANet)はチャネル次元と空間次元の両方から特徴を適応的に重み付けし、重要な特徴の知覚を向上させます。トリプルアテンションネットワーク(TANet)は、マルチスケール特徴の適応選択を通じてセグメンテーション性能をさらに向上させます12。
自然言語処理やコンピュータビジョン13におけるトランスフォーマーアーキテクチャの成功を受けて、研究者たちは医療画像セグメンテーションへの応用を探り始めています。TransUNetは、長距離依存関係を実質的にモデル化するためにトランスフォーマーをエンコーダとして初めて使用した企業です。Swin-UNetは純粋なトランスフォーマーアーキテクチャを採用し、シフトウィンドウメカニズム15を通じて効率的なグローバル情報集約を実現します。UTNetはCNNの局所的特徴抽出能力とTransformers16のグローバルモデリング能力を組み合わせたハイブリッドアーキテクチャを提案しています。
ポリップセグメンテーションの分野では、Polyp-PVTはピラミッドビジョンのTransformerを用いて多スケールのグローバルセマンティック情報を捉え、マルチスケールのネストUNetはTransformers18を統合することで文脈理解を強化します。最近の研究では、クロスドメインポリプセグメンテーション19、ゴンパーツ拡張セグメンテーション強化20、境界ガイダンスを取り入れた注意ベースのアーキテクチャ21における負の相関学習戦略も探求されています。これらの手法はある程度セグメンテーションの性能を向上させますが、ポリプセグメンテーションには依然としていくつかの課題があります。まず、ポリプは形態、大きさ、質感において非常に異質で、5mm未満の微小ポリプから30mmを超える大きなポリプまで幅広く、形状は円形や楕円形から非常に不規則な形状まで様々です。第二に、腸環境は複雑かつ多様であり、粘膜ひだ、鏡面反射、便残留物、食物残渣などが深刻な背景干渉をもたらします。第三に、多くのポリープは境界がぼやけたり、ひだで部分的に塞がれたり、腸液に浸かっていることがあり、正確な境界の特定は非常に困難です。
既存の手法はこれらの課題に対処する上で依然として明確な限界を抱えています。従来のCNNは局所的なテクスチャやエッジの特徴を抽出するのに効果的です。しかし、固定された正方形畳み込みカーネルは、特に高度に不規則なポリプに対して多様な幾何学的形状23の捕捉には適しておらず、多方向の幾何学的特徴を効果的にモデル化することはできません。トランスフォーマーベースの手法はグローバル依存関係をモデル化できますが、細かい局所的詳細や境界情報の取得には効果が劣ります。さらに、計算の複雑さが高いため、リアルタイムの臨床応用にはあまり適していません。最近のポリップセグメンテーション手法であるPraNet(リバースアテンションモジュールを用いて重要な領域を精細化)、境界指向カスケード注意ネットワーク(境界特徴抽出を強化する)26、エンコーダーとデコーダの特徴をクロスアテンション機構で融合させるCAFE-Net(27)などは、小さなポリプを扱う際に特徴表現が不十分で境界局在の精度が低い28の課題に直面しています、曖昧な境界線、複雑な背景。さらに、多くの手法は幾何学的形態を無視し、多方向の文脈情報を十分に活用できず、不規則な形状のポリープの最適でない分割を生み出しています。
まとめると、現在のCNNベースの手法は固定された正方形畳み込みカーネルに依存しているため、多方向幾何学的特徴を捉える能力が不足しています。トランスを基盤としたアプローチはグローバルモデリングを提供しますが、局所境界の精度を犠牲にし、計算コストも高くなります。一方で、既存の注意強化型およびマルチスケール融合戦略は、ポリップセグメンテーションに特化した統一フレームワークの中で共同で最適化されていません。これらのギャップが、幾何学的特徴モデリング、適応ノイズ抑制、スケール横断特徴統合を同時に扱う手法の開発を促しています。
これらの問題に対処するため、本プロトコルはピンホイール畳み込みとデュアルアテンション(PWD-Net)に基づくポリップセグメンテーションネットワークを提示します。提案されたネットワークは幾何学的特徴モデリング、多次元注意強化、多スケールの特徴融合を統合し、複雑なポリプの正確なセグメンテーションを可能にします。この研究の主な貢献は以下の通りです:ピンホイール畳み込みモジュール(PCM)は、ピンホイールの構造に着想を得て、0°、45°、90°、135°、180°、225°、270°、315°の複数の角度での畳み込み操作を通じてポリプの多方向幾何学的特徴を捉える新しい回転畳み込みカーネル設計を提案します。このモジュールはボトルネック段階で従来の畳み込み層に代わり、多様なエッジの向きを効果的に認識し、不規則な形状のポリプの表現を大幅に向上させます。二重注意機構(DAM)は、大腸内視鏡画像における褶曲、反射、便残留物などの背景ノイズに対応します。チャネル注意と空間注意を統合した二重注意モジュールが設計されています。スキップ接続に組み込まれたこのモジュールは、背景干渉を適応的に抑制し、ポリップ領域における特徴応答を強化します。これは「重要なもの」(チャネル寸法)と「どこ」の標的であるか(空間次元)を共同で識別することで、後の融合には精細化された特徴のみが関与するようにします。マルチスケール特徴融合戦略(MSF)は、デコーダで導入された階層的なメカニズムを通じて、深い意味情報と浅い境界の詳細の両方を保持します。DAM強化エンコーダの特徴をアップサンプリングされたデコーダ機能と段階的に統合することで、ダウンサンプリングによる空間的ディテール損失を効果的に補正し、小さなポリープの正確な検出や境界の正確な区分を可能にします。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究は公開されている匿名化された大腸内視鏡画像データセット(Kvasir-SEG)のみを使用しています。新たなヒト被験者データは収集されませんでした。非特定化された公開データセットの遡及的分析に関する機関審査方針によって確認されているように、機関倫理承認および患者インフォームド同意は必要ありませんでした。
1. データ準備
- 公式リポジトリ33(https://datasets.simula.no/kvasir-seg/)からKvasir-SEGデータセットをダウンロードしてください。データセットには、ピクセルレベルのグラウンドトゥルースマスクを備えた1,000枚のポリップ画像が含まれています。
- データセットを訓練(800枚)、検証(100枚)、テスト(100枚)にランダムに分割し、固定されたランダムシード(シード=42)を用いて8:1:1の比率で分けます。データ漏洩を防ぐために、3つのサブセット間で画像が重複していないか確認してください。
- 画像および対応するマスクを、画像にはバイリニア補間、マスクには近傍補間を用いて352×352ピクセルにリサイズします。
- ピクセル値を255で割って[0, 1]に正規化し、その後ImageNetのチャネルごとの平均減算(0.485, 0.456, 0.406)と標準偏差正規化(0.229, 0.224, 0.225)を適用します。
- 以下の拡張変換は訓練セットにのみ適用します(検証セットやテストセットには適用しません):ランダム水平反転(確率=0.5);ランダムな垂直反転(確率=0.5);ランダム回転(範囲:−30°から+30°、確率=0.5);ランダムなマルチスケールリサイズ(スケールファクター:0.75から1.25、確率=0.5)
注意:アライメントを維持するために、画像と対応するマスクの両方に同一の空間変換を適用してください。トレーニング開始前に、複数の拡張画像–マスクペアを視覚的に確認して拡張の正確性を確認しましょう。
2. 全体的なアーキテクチャ
注:PWD-Netのマクロレベルのエンコーダ–デコーダバックボーンについては図1、フィーチャーフロー内のコアモジュールの統合と相互作用については図2を参照してください。全体のアーキテクチャは、ポリープのスケール変化や大腸内視鏡画像における背景干渉に対応するため、U字型のエンコーダー・デコーダ設計に従っています。
- バックボーンと符号化経路(図1)
- ImageNetで事前学習済み(公式のPyTorchモデル動物園から提供)をバックボーンエンコーダーとして使用してください。トレーニング中にすべてのエンコーダー層を微調整してください。
- 入力された大腸内視鏡画像(352×352ピクセルにリサイズ)を5段階の残留畳み込みブロックを通して送り込み、階層的特徴を抽出します。特徴マップの空間分解能は5段階にわたって段階的にダウンサンプリングされ、チャネル寸法もそれに応じて増加します(64 → 128 → 256 → 512 → 1024)。
- ボトルネック(最も深いエンコーダ層)では、標準畳み込み層をピンホイール畳み込みモジュール(PCM、セクション3で説明)に置き換え、グローバルな幾何学的形態と多方向の文脈情報を低解像度でキャプチャします。
注: 5つのエンコーダ段階は標準的なResNet-50レイヤーグループ(conv1、layer1、layer2、layer3、layer4)に対応しています。事前学習済み重みは、低レベルおよび中間レベルの機能初期化を堅牢なものにし、小規模な医療データセットでの収束時間を短縮します。
- 主要コンポーネントと機能相互作用(図2および図3)
- 各エンコーダステージの出力にデュアルアテンション機構(DAM、セクション4で説明)を適用し、スキップ接続を介してデコーダに送信します。このステップは腸のひだや鏡面反射によって発生する背景ノイズを適応的に抑制しつつ、ポリープ領域の特徴応答を高めます。フィルタリングされた特徴だけが対応するデコーダ層に渡されます。
- デコーダでは、バイリニアアップサンプリングを通じて空間分解能を段階的に復元します。各デコーダ層で、前のデコーダ段階からアップサンプリングされた特徴と、同じ空間分解能を持つDAM強化エンコーダの特徴を連結します。
- 連続した2つの畳み込みレイヤー(それぞれにバッチ正規化とReLU活性化)を適用してマルチスケール情報を融合させます。これが第5節で説明されているマルチスケール特徴融合(MSF)戦略を構成します。
注: デコーダは深層から浅層(ステージ5→ステージ1)へと進み、深い意味的局在情報と浅い境界詳細情報が各レベルで効果的に統合されることを保証します。
- 出力生成
- 最終的なデコーダ出力に畳み込み層を適用し、その後シグモイド活性化関数を適用して予測マスクを生成します。
- 予測マスクを0.5の閾値で二分化し、最終的なセグメンテーション結果を得る。予測確率0.5のピクセルはポリップ、残りのピクセルは背景として分類≥。
3. ピンホイール畳み込み加群 (図3)
- ピンホイール畳み込みモジュール(PCM)は、標準的なボトルネック畳み込みに代わってポリプの多方向幾何学的特徴を捉えます。このモジュールを以下のように実装します:
- 入力チャネルにC、出力チャネルにCを割り当てるサイズの基底畳み込みカーネルWを定義します。
- 回転角の集合 Θ = {0°, 45°, 90°, ..., 315°} を定義します。各角度θ∈Θに対して、Wに双線形補間に基づく回転を適用して回転核Wθ を生成します。8つの回転した核すべてが同じ基準パラメータを共有しています。異なるのは重みの空間配置だけです。
- 各角度θに対して、方向ごとの特徴マップを計算します:

ここで X は入力特徴マップです。 - 8つの方向性特徴写像をチャネル軸に沿ってチャネルごとに連結して集約し、次元(8 x Cout) x H x W のテンソルを生成します。次に1×1畳み込みを適用してチャネル次元をCアウトに戻し、バッチ正規化とReLU活性化31を行います。

注意:回転と補間は入力特徴マップではなく核重み上で行われます。この設計により、入力分解能を上げることなくパラメータ効率の高い多方向特徴抽出が可能になります。現在の実装では、ボトルネック段階でCin = 1024、Cout = 1024となり、ResNet-50のlayer4の出力チャネル寸法と一致します。完全な実装については補足コードパッケージを参照してください。
4. 二重注意メカニズム(図4)
注: デュアルアテンション機構(DAM)は各スキップ接続に組み込まれ、背景雑音を抑制し、チャネル次元および空間次元の両方からポリープ領域の特徴を強化します。
- チャンネル・アテンション
チャネルアテンションブランチは、どの特徴チャンネルが最も情報を提供するかを特定します。入力特徴F ∈ RC×H×Wが与えられると:- グローバル平均プーリングによって空間次元を圧縮し、RC×1×1 ∈チャネル記述子zを得ます。
- zを2層MLP(完全連結層)に通し、還元比はr = 16です。最初の層では、ReLUの活性化により次元をCからC/16に減少させます。第2層では、シグモイド活性化によりC/16からCへ戻し、チャネルウェイトベクトルAcを生成します。
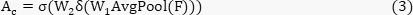
ここでδはReLU、σはシグモイドを表します。
- 空間的注意
空間注意枝は、ターゲット領域がどこにあるかを示します:- チャネル次元に沿って最大プーリングと平均プーリングの両方を適用し、サイズ1×H×Wの2Dフィーチャーマップを生成します。
- 2つの写像をチャネル軸に沿って連結し、2×H×Wテンソルを形成します。7×7畳み込み層を適用し、その後シグモイド活性化を行って空間重みマップAs ∈R1×H×Wを生成します。
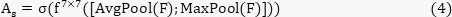
- フィーチャーフュージョン
- チャネルと空間注意の出力を入力特徴と要素ごとに乗算して融合させます:

ここでαとβは学習可能なバランス係数で、どちらも0.5に初期化され、トレーニング中に勾配ベースの最適化によってネットワークパラメータと同時に更新されます。
注:完全な実装については補足コードパッケージ(dam_module.py)を参照してください。
- チャネルと空間注意の出力を入力特徴と要素ごとに乗算して融合させます:
5. マルチスケール特徴融合
- デコーダにマルチスケール特徴融合(MSF)戦略を適用し、深部特徴における空間的詳細損失を解決します。各デコーダ段階で、以下の作業を行います。
- 前段階のデコーダから特徴マップをバイリニア補間を用いて2倍アップサンプリングします。
- アップサンプリングされた特徴を、チャネル軸に沿って対応する空間分解能のDAM強化エンコーダ機能と連結します。
- 連続した2つの3×3畳み込みレイヤー(それぞれにバッチ正規化とReLU活性化32)を適用して連結した特徴を融合させます。
注:このクロスレベル融合により、ポリプの境界詳細(浅いエンコーダー特徴によって提供される)と意味的局在(深い特徴によって提供される)が同時に保持され、細かな分割結果が生成されます。
6. 損失関数と訓練構成
- 損失関数
- ネットワークを共同最適化するためにハイブリッド損失関数L_total採用され、ポリップセグメンテーションにおける広く見られる前景と背景のクラスの不均衡に対応しています。
バイナリクロスエントロピー損失(LBCE)は、ピクセルレベルの分類精度を測定します:
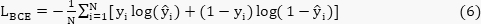
ここで N はピクセル数の総数、yi ∈ {0,1} はグラウンドトゥルースラベル、ŷi ∈ [0,1] は予測確率です。 - ダイス損失(LDice)は、予測領域と実際の領域の集合的な類似度を定量化します。


ここでεは、ゼロでの割り算を避けるために平滑化係数(1×10⁻5に設定)です。
λ = 0.5を設定して、2つの損失項の寄与を釣り合います。
- ネットワークを共同最適化するためにハイブリッド損失関数L_total採用され、ポリップセグメンテーションにおける広く見られる前景と背景のクラスの不均衡に対応しています。
- トレーニング構成
- ImageNetで事前に学習されたResNet-50の重みでエンコーダを初期化します。すべてのデコーダ層、PCM、DAMパラメータをKaimingの均一初期化で初期化します。
- オプティマイザーとトレーニングスケジュールを以下のように設定します。β₁ = 0.9、および β₂ = 0.999 の Adam オプティマイザを使用します。初期学習率を1×10⁻⁴に設定します。T最大 値=50、η分 =1×10⁻⁶のコサインアニーリング学習率スケジュールを適用します。バッチサイズを16にし、モデルを50エポックで訓練します。
- トレーニングセット上で50エポック(800枚の画像)を学習させます。各エポック終了時に、検証セット(100枚の画像)上でモデルを評価し、ダイス係数を主要なモニタリング指標として使用します。
- 検証セット上で最大のダイス係数を達成するモデルのチェックポイントを保存します。このチェックポイントをテストセットでの最終モデルとして使用してください。
注意:早期停止は明示的に適用されません。最良の検証-ダイスチェックポイント選択戦略がモデル選択基準として機能します。すべての実験は、 材料表に指定されたハードウェアおよびソフトウェア環境で行われます。800枚の画像で50エポックの訓練は、記載された構成の下で約2時間かかります。報告されたすべての結果は、指定されたランダムシード(シード=42)を用いた単一のトレーニングランから得られます。完全なトレーニングスクリプトについては補足コードパッケージを参照してください。
7. 擬似コード
- アルゴリズム1をPWD Netの完全なワークフローマップとして使用してください。アルゴリズム内のPCM、DAM、メインアーキテクチャ、トレーニングパイプラインのブロックを、補助コードパッケージ内の対応ファイルと照合してください。
- 4行目から12行目に示されたPCMブロックを実装してください。3×3の畳み込みカーネルを定義し、0°、45°、90°、135°、180°、225°、270°、315°の方向で8つの回転したカーネルを双線形補間を用いて生成します。
- 回転したPCMカーネルは同じ学習可能な基準パラメータを保持してください。各回転角ごとに、1方向固有の特徴マップを計算します。
- 8つのPCM特徴写像をチャネル次元に沿って連結します。1×1の畳み込み、バッチ正規化、ReLUの活性化を適用して、元のチャネル次元を復元します。
- 14行目から19行目に示されたDAMブロックを実装してください。グローバル平均プーリングを適用してチャネルディスクリプタを作成し、その後、還元比16の2層MLPに通してチャネル重みを取得します。
- 入力特徴にチャネルごとの平均プーリングと最大プーリングを適用して空間注意マップを生成します。2つのマップを連結し、7×7畳み込み処理の後、シグモイドの活性化を行います。
- DAMチャネルと空間注意出力を入力機能と要素ごとの乗算で融合させます。学習可能な係数αとβの2つの注意マップを重み付けし、どちらも0.5に初期化します。
- 21行目から32行目に示された主要なPWDネットワークアーキテクチャを構築します。入力画像を事前学習済みのResNet 50エンコーダの5段階に通し、e1からe5までを得ます。空間分解能はH×WからH/32×W/32へと低下します。
- ボトルネックのe5にPCMを塗布します。これらの機能をスキップ接続でデコーダーに送る前に、e1からe4にDAMを適用してください。
- 特徴マップを深層から浅層まで復号します。各デコーダレベルで、前述の特徴をアップサンプリングし、対応するDAMエンハンストエンコーダ機能と連結し、DoubleConvを適用して特徴量融合を行います。
- 1×1畳み込みで分割出力を生成し、その後シグモイド活性化を行います。得られたピクセルごとの確率マップを予測マスクとして用いてください。
- 34行目から39行目に示されたトレーニングループを実装してください。各エポックでPWDネットを通じて順方向伝搬を実行し、予測されたマスクを計算します。
- トレーニング損失は0.5×BCE損失に0.5×ダイス損失を加えて計算します。Adam最適化器でバックプロパゲーションを通じて学習可能なパラメータをすべて更新します。
アルゴリズム1:PWD-Netポリープ分割
1: 入力: 大腸内視鏡画像 I∈ R H×W×3
2: 出力: セグメンテーションマスク M ∈ {0,1}(H×W)
3:
4: 関数 PCM(X) ▷ ピンホイール畳み込み加群
5: 基底核W(3×3)を定義し、角度Θ = {0°, 45°, ..., 315°}
6: θ ∈ Θ に対して
7: Wθ ← BilinearRotate(W, θ) ▷ 核を回転させる
8: Yθ ← Conv2d(X, Wθ) ▷ 方向特異的特徴
9: 終了
10: Yout ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ 集計
11: Yを戻す
12: 終了関数
13:
14: 関数 DAM(F) ▷ デュアルアテンション機構
15: Ac ← Sigmoid(MLP(AvgPool(F))) ▷ チャネル注意 (r=16)
16: As ← シグモイド(Conv7 x 7([平均プール(F);MaxPool(F)])) ▷ 空間注意
17: F' ← F ⊗(α ·Ac + β ·As) ▷ 学習可能なαと融合β (init=0.5)
18:帰還 F'
19: 終わり関数
20:
21: 関数 PWD-Net(I)
22: エンコーダ: e1,e 2, e3, e4, e5 ← ResNet50_Stages(I) ▷ 5段階の事前学習済みエンコーダ
23: ボトルネック: b ← PCM(e5) ▷ ボトルネックにPCMを適用
24: 接続スキップ: si ← DAM(ei) に対して i = 1, 2, 3, 4 ▷ フィルターエンコーダ機能
25: デコーダー:
26: d4 ← ダブルコンバージョン(Concat(Up(b), s4))
27: d3 ← ダブルコンヴ(Concat(Up(d4)、s3))
28: d2 ← ダブルコンヴ(Concat(Up(d3)、s2))
29: d1 ← ダブルコンヴ(Concat(Up(d2), s1))
30: M ← シグモイド(Conv1 x 1(d1))
31:帰還 M
32: 終末関数
33:
34:トレーニング:
35: 各時代 ごとに
36: M̂ ← PWD-Net(I)
37: L ← 0.5 ·BCE(M̂, Mgt) + 0.5 ·DiceLoss(M̂, Mgt) ▷ λ = 0.5
38: パラメータを逆伝播で更新(Adam optimizer)
39:終わり
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
実験装置
データセット
Kvasir SEGデータセットは、異質なポリープの外観を持つ大腸内視鏡画像におけるPWD Netのセグメンテーション挙動を評価するために用いられました。このデータセットには1,000ピクセルの注釈付きポリプ画像が含まれており、ポリップのサイズ、形状、質感、照明、背景の複雑さに変化があるため、小さなターゲット検出、境界の定位、視覚干渉に対する強靭性の評価に適しています。データセットはトレーニング、検証、テストのサブセットに分けられ、最終的なテストセットはパフォーマンス評価のみに使用されました。画像の分布は表1にまとめられています。
実装の詳細
再現性に必要な実装設定は 表2 にまとめられており、完全な手続きの詳細はプロトコルのデータ準備ステップおよびセクション5.2に記載され...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
PWD-Netプロトコルのいくつかの設計選択は、信頼性の高いセグメンテーション結果を得るために重要であり、実装時に細心の注意を払う必要があります。まず、エンコーダバックボーンの選択と初期化が収束挙動や最終性能に直接影響します。このプロトコルはImageNet上で事前学習されたResNet-50エンコーダを採用しており、低レベルおよび中間レベルの機能初期化を堅牢な提供します。これは、利用可能な訓練データが限られている医療画像セグメンテーションタスク(本研究では800枚の画像)において特に重要です。すべてのエンコーダ層を凍結するのではなく微調整することで、ネットワークは事前に学習済みの特徴を粘膜テクスチャや鏡面反射など大腸内視鏡画像の特定の特性に適応させることができます。次に、各コアモジュールのアーキテクチャ内での配置は意図的です。ピンホイール畳み込みモジュール(PCM)は、空間分解能が最も低いが意味情報が最も豊富なボトルネックに位置し、過度な計算コストなしにグローバル幾何学的パターンを効率的にキャプチャすることを可能にします。デュアルアテンション機構(DAM)はデコーダ内...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは何も明かすことはありません。
謝辞
本研究は中国国家重点研究開発プログラム(プログラム番号2022YFC3500200および2022YFC3500204)によって資金提供を受けました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Adam Optimizer | — | — | PyTorchに含まれている |
| Albumentations | Albumentations Team | v1.0+ | データ拡張ライブラリ |
| CUDA Toolkit | NVIDIA | v11.3+ | GPUアクセラレーション |
| Kvasir-SEG dataset | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | 学習曲線の可視化 |
| NumPy | NumPy Community | v1.21+ | 数値計算 |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | トレーニングと推論用のGPU |
| OpenCV | OpenCV Community | v4.5+ | 画像前処理 |
| Python | Python Software Foundation | v3.8+ | プログラミング言語 |
| PyTorch | Meta Platforms | v1.12+ | ディープラーニングフレームワーク |
| ResNet-50 pretrained weights | PyTorch Model Zoo | — | ImageNet-1K pretrained |
| Ubuntu | Canonical | 18.04+ | オペレーティングシステム |