メタ学習ハイブリッド量子・古典ニューラル分類器(ML-HQNC)プロトコルは、量子に着想を得た認知モデリング、データ前処理、特徴量選択、およびハイブリッドニューラル学習を統合し、工学系学生の関心を特定するものである。本プロトコルでは、多次元的な教育データを用いた工学系学生の関心特定を通じて、教育分析のための再現可能な量子着想ハイブリッド機械学習ワークフローを提示する。
この記事について
サマリー
要約
本プロトコルでは、多次元的な教育および行動データを用いて工学部生の興味を特定するための、量子着想の計算フレームワークを提示します。目的は、データの前処理、行動パターン分析、特徴量選択、およびハイブリッドニューラル学習を統合し、教育的な意思決定と個別最適化された学習を支援するための、体系的かつ再現可能なワークフローを提供することです。このワークフローは、まずBox-Cox Robust IQR Scaling (BCRIS)を用いて教育データを前処理および正規化し、意味的なノイズを低減してデータ品質を向上させることから始まります。続いて、不確実な条件下での行動遷移と進化する学習好みを表現するQuantum Cognitive State Model (QCSM)を用いて、学生の学習行動を分析します。次に、Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS)アルゴリズムを使用して関連する特徴量を選択し、特徴量の冗長性を排除して有益な行動特性を特定します。最終的に、Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC)が、量子着想の学習とディープニューラルネットワークを統合して学生の興味を分類します。本プロトコルは、公開されている教育データセットを用いて検証されました。モデルの性能は、正解率、F1スコア、受信者動作特性曲線下面積 (AUC) などの従来の指標に加え、Interest Detection Precision (IDP)、Quantum Pattern Stability Index (QPSI)、およびCross-Domain Adaptability Gain (CDAG) を用いて評価されました。本フレームワークは、評価データセットにおいて96.17%の総合分類正解率を達成しました。本プロトコルは、インテリジェントな教育管理および個別最適化された学習アプリケーションを支援するために、多次元的な教育データを分析するための再現可能な計算ワークフローを提供します。
概要
情報技術とコンピュータネットワークの急速な進展に伴い、教育分野全体で教育管理システムの導入が進んでいます。高等教育の継続的な拡大により、特に工学系の学生の入学者が増加し、その結果、教育管理データが大幅に増大しています。この成長は、持続可能な教育開発を支え、教育の情報化を加速させ、教育管理の整合性と効率性を向上させる標準化された教育管理システムの構築を促進します。機械学習(ML)は、明示的なプログラミングを行うことなく、システムがデータを分析し、パターンから学習し、予測性能を継続的に向上させることを可能にする計算手法を提供します1,2。
教育の質は、高等教育における根幹となる要素である。近年、工学部の学生がコース内容をどの程度理解しているか、また新しい知識を習得する能力があるかを評価するために試験が広く利用されており、これにより教育の質の継続的な向上が促進されている。オンライン教育プラットフォームを通じて利用可能な多様な学習リソースを活用し、さまざまな学習者のニーズに対応するために複数の学習理論を適用することで、学習者中心の環境を構築できる。大学やカレッジにおける工学部学生の学習成果を向上させるには、効果的な教授法が重要な役割を果たす3,4。さらに、効果的な教授法は、肯定的な学習環境を促進し、コース内容に対する学生の理解をサポートし、学業成績を向上させる。教育の質は、カリキュラム構成、教室環境、教授内容など、学習プロセス全体を通じて複数の指標を用いて評価される。
高等教育は、学生の知的、個人的、および社会的な発達を促進します。同時に、行動的、情緒的、および認知的側面を含む学生のエンゲージメントと学業の継続性は、学習成果の重要な決定要因となっています。高いレベルの学生エンゲージメントは、長期的な学業成就に大きく寄与します5,6。教育テクノロジーの進歩により、機械学習(ML)およびディープラーニング(DL)の手法を用いて、学生の認知的、行動的、および学術的な特性間の複雑な非線形関係をモデル化することで、データ駆動型の教育分析における新たな機会が創出されています。
学生の行動の変化を考慮しつつ、教室内のダイナミクスを効果的に観察および評価することは、依然として大きな課題となっています。教育の質を評価し、工学系学生の行動を分析するための従来の手法は、多くの場合、時間がかかり、主観的な人間による判断の影響を受けやすくなります。教室活動中の学生の不注意は、学習成果や学業成績に悪影響を及ぼします7,8。しかし、内部的および外部的な誘惑やモチベーションの変動があるため、工学系学生の持続的な注意力を維持させることは依然として困難です。
オンライン学習やスマートクラスルーム、その他のインタラクティブな教育技術が広く普及したことで、学生のエンゲージメントの評価と向上はますます重要になっています。多様な工学系学生グループ全体にわたるインクルージョンを確保することは、プライバシーと倫理基準を維持しつつ、テクノロジー主導のアプローチを教育実践と統合する包括的なフレームワークの必要性をさらに浮き彫りにしています。加えて、モデルの透明性の低さや、方法論的なバイアスや教育的公平性を含むテクノロジー統合に伴う課題9,10が、継続的なモニタリングを通じて学習者をサポートできる予測システムの開発を依然として妨げています。
学生のリスクや中途脱落率の予測といった教育上の課題に対処するために、機械学習の手法が広く用いられてきました。これらの手法は、ハイリスクな学生を特定する能力を示しており、それによって学業成績を向上させる介入策を支援しています11。また、高等教育機関における管理プロセスと学術プロセスの両方を強化するために、人工知能(AI)ベースの教育管理システムも開発されています。教育データセットには、一般的に、コースの成績、出席記録、入学履歴などの学業記録が含まれます12。
先行研究では、評価データ、手法、および成果という3つの視点から学生の行動が分析されてきました13,14。大学生の行動特性を分析するために、情報リテラシーに基づいた予測モデルが開発されています。これらの研究は主に、ディープラーニング(DL)手法を用いた学習者の行動評価に焦点を当てています。しかし、インテリジェントな教師の行動評価に関する研究はまだ初期段階にあり、この分野の進展を制限しています。教室内の活動検出を向上させるために、教育用データセットにFast Region-based Convolutional Neural Networks (Fast R-CNNs) が適用されており、従来の手法に比べて大幅な性能向上が示されています15。
自己監視メカニズムを組み込んだ双方向長短期記憶(Bi-LSTM)モデルにより、大学生の成績予測の精度が向上しています。同様に、オンライン学習行動データセットを用いて開発された予測モデルにおいても、予測性能の向上が示されています16,17,18。加えて、k-means法(KMC)を用いたクラスター分析により、異なる学生グループの特性を特定し、教育、管理、学習の改善を支援する学生行動への洞察が得られています。また、教室での指導行動の検出および評価を改善するために、ディープラーニングに基づく戦略も提案されています。これらのアプローチでは、教室での行動特徴を用いて、サポートベクターマシン(SVM)の線形分離可能な初期値を利用し、特徴表現と超平面の間の関係を構築します19,20。しかし、遮蔽、微細な行動の詳細、環境干渉などの課題があり、教室環境における工学部生の行動認識の精度は依然として制限されています。
ディープラーニングは、政治および思想教育における教育評価を含む、大学コースのアウトカムベースの評価にも適用されています21,22。これらの予測モデルの有効性は、公開されている教育データセットを用いて実証されています。オンライン学習プラットフォームや学習管理システムから収集したデータを用いて学生の学業成績を予測するために、フィードフォワード・スパイキングニューラルネットワーク(FSNN)が採用されています。図1に示すように、提案された計算ワークフローでは、データの前処理、行動パターンの分析、特徴選択、および分類という一連の段階を経て、工学部生の関心を特定するために教育評価データセットを組み込んでいます。表123,24,25,26,27,28,29,30,31,32には、学習管理システム内での学生の関心を特定するために採用された手法、用いた技術、およびそれに関連する限界について、先行研究で報告された代表的な方法をまとめています。
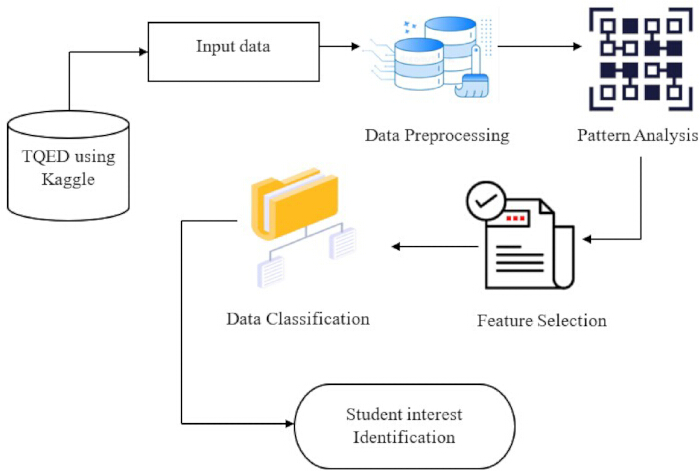
図 1: 学生の興味特定フレームワーク。 データ取得、前処理、行動パターン分析、特徴量選択、および分類を含む、提案された工学部生の興味特定フレームワークの全体的なワークフロー。こちらのリンクをクリックして、この図の拡大版を表示してください。
表1:教育管理における学生の行動分析。教育管理における学生の行動分析に用いられる代表的な手法、技術、データセット、評価指標、および報告されている限界点のまとめ。こちらのリンクから本表をダウンロードしてください。
Swin Transformerおよび軽量化特徴ピラミッドネットワーク(FPN)は、マルチスケール特徴マップを効率的に処理することで、学生の教室内の行動検出に適用されています33。加えて、ショウジョウバエ最適化可変回帰ニューラルネットワーク(PFFO-ARNN)が、学生のオンライン学習行動の分析およびコース達成度の予測に使用されています34。大学の学習管理システムから収集された学生の行動データに基づく研究では、従来のディープラーニング手法による教室行動のモニタリングが非効率的であり、時間を要することが指摘されています35。表236,37,38,39,40,41,42,43,44,45,46,47に、工学教育におけるインテリジェント教育管理システムの代表的な分類手法、データセット、評価指標、および報告されている限界をまとめています。
表2:工学教育のためのディープラーニングに基づくインテリジェント教育管理システム 代表的なディープラーニングベースの教育管理システム、データセット、評価指標、および報告されている限界の比較。こちらのリンクからこの表をダウンロードしてください。
先行研究48では、Deep Belief Networks (DBNs) に基づいた blended teaching の質評価モデルが開発され、大学における教育の質を評価するための混合評価戦略が提案されました。提案されたアプローチは、分類精度と実行時間の両面で従来の遺伝的アルゴリズム (GA) を上回り、5.4 ms 未満で 95% 以上の精度を達成しました。このモデルは、ラベル付きの教育データセットを用いて学習され、独立したテスト戦略を用いて評価されました49,50。報告された結果では、平均絶対誤差 (MAE) が 0.593%、平方根平均二乗誤差 (RMSE) が 0.785% となり、強力な予測性能が示されました。
KANFormer51などの最近の注意機構強化アーキテクチャは、マルチヘッド自己注意機構とコルモゴロフ・アーノルドネットワークを統合し、複雑な特徴量間の相互作用を捉えることで、学習者の成績予測の精度を向上させています。また、Transformerベースの知識追跡モデルは、注意機構を利用して学習者の学習軌跡をモデル化することで、予測精度の向上と解釈性の改善を実証しています52。Transformerおよび注意機構ベースのアーキテクチャは、文脈依存性や長距離の特徴量相互作用をモデル化することで、教育予測タスクのパフォーマンスを向上させましたが、これらの手法は主に学習者の成績予測や知識追跡に焦点を当てており、量子着想の認知モデリング、最適化された特徴量選択、およびハイブリッドメタ学習を通じた、不確実性を考慮した学習者の興味関心特定には取り組んでいません。
教育分析における機械学習およびディープラーニングの最近の進展にもかかわらず、工学系学生の関心を特定する既存の手法にはいくつかの限界があります。多くの従来のアプローチは主に予測精度に焦点を当てており、進化する学習嗜好、行動の不確実性、文脈的関係、および意味的相互作用を含む、学生の行動の多面的な性質を見落としています。さらに、これらの手法は多くの場合、従来の特長量エンジニアリングと決定論的な学習戦略に依存しており、非線形な行動パターンを十分に捉えられなかったり、動的な学習環境に適応できなかったりすることがあります。その結果、複雑な教育データの分析を改善するためには、堅牢なデータ前処理、インテリジェントな行動モデリング、適応的な特長量選択、およびハイブリッド学習手法を統合した、より包括的なフレームワークが必要とされています。
これらの制限に対処するため、提案されたフレームワークでは、堅牢なデータ前処理、量子インスパイア行動モデリング、最適化された特徴選択、およびハイブリッド量子・古典ニューラル学習を、工学系学生の関心を特定するための統一された計算ワークフローに統合しています。これらの相補的なコンポーネントを組み合わせることで、提案されたプロトコルは、パーソナライズされた学習および教育的な意思決定を支援するために、複雑な教育データを分析するための体系的かつ再現可能なアプローチを提供します。
本研究の目的は、工学系学生の興味関心の特定に向けて、多次元的な教育・行動データを用いたCQEIフレームワークを開発し、その妥当性を検証することである。本フレームワークは、堅牢なデータ前処理、量子着想の認知状態モデリング、最適化された特徴量選択、およびメタ学習ハイブリッド量子古典ニューラル分類器(ML-HQNC)を組み合わせることで、学生の学習行動を分析し、正確な興味関心の特定を促進する。性能評価には、正解率、F1スコア、受信者動作特性曲線下面積(AUC)などの標準的な指標に加え、興味検出精度(IDP)、量子パターン安定性指数(QPSI)、およびクロスドメイン適応利得(CDAG)を用いる。これらの相補的な構成要素を単一の計算ワークフローに統合することで、提案するフレームワークは、教育分析および知的な教育的意思決定のための体系的なアプローチを提供する。
プロトコル
本研究では、Kaggleリポジトリから取得した、公開されている匿名化データセットを使用した。ヒト被験者の直接的な募集や関与はなく、個人を特定できる情報の収集も行われなかった。したがって、施設内の倫理承認およびインフォームドコンセントは不要であった。本研究で使用した研究ツールは材料表に記載されている。
1. CQEIフレームワークの概要
提案された量子着想概念教育インテリジェンス(CQEI)フレームワークは、Kaggleリポジトリから取得した教育品質評価データセットを用いて工学系学生の関心を特定するため、データ前処理、行動パターン分析、特徴量選択、および分類を統合したものである。まず、セマンティックノイズを低減し入力特徴量を正規化するために、Box–Cox Robust IQR Scaling (BCRIS)法を用いてデータセットの前処理を行った。続いて、量子認知状態モデル(QCSM)を用いて学生の行動パターンを分析した。次に、量子最適選択、フィードバックの重要性、および一過性の行動変動をモデル化することで、特徴量の冗長性を排除しつつ有益な特徴量を特定するため、量子強化スウォーム・ホエール最適化特徴量選択(QES-WOFS)アルゴリズムを適用した。最終的に、メタ学習ハイブリッド量子・古典ニューラル分類器(ML-HQNC)が、量子着想学習とディープレジデュアルセマンティックレイヤーを統合し、学生の関心を特定した。
提案されたML-HQNCフレームワークの全体的なワークフローを図2に示します。本プロトコルは6つの連続したステージで構成されており、まずKaggleリポジトリから教育用データセットを取得し、次にBox–Cox Robust IQR Scaling (BCRIS)を用いてデータの前処理を行います。続いて、Quantum Cognitive State Model (QCSM)を用いて特徴変換および行動表現を行い、Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS)アルゴリズムを用いて特徴量選択を行います。選択された特徴量は、その後、Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC)によるモデルのトレーニングと検証に使用され、最終的に、正解率、F1スコア、受信者動作特性曲線下面積 (AUC)、Interest Detection Precision (IDP)、Quantum Pattern Stability Index (QPSI)、およびCross-Domain Adaptability Gain (CDAG)を用いてフレームワークを評価しました。
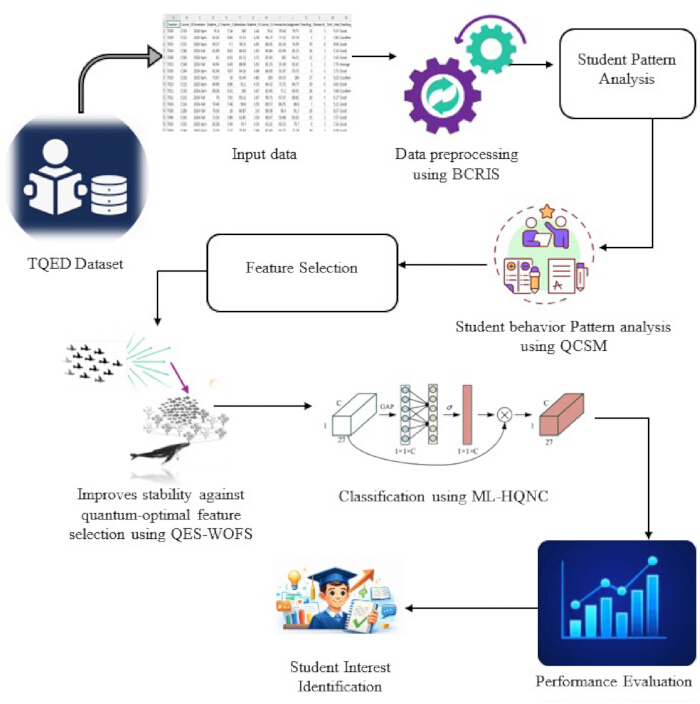
図 2: メタ学習ハイブリッド量子・古典ニューラル分類器(ML-HQNC)フレームワーク。データ前処理のためのBox–Cox Robust IQR Scaling(BCRIS)、行動パターン分析のための量子認知状態モデル(QCSM)、特徴量選択のための量子強化スウォーム・ホエール最適化特徴量選択(QES-WOFS)アルゴリズム、および学生の興味を分類するためのハイブリッド量子・古典ニューラル学習を統合した、提案するML-HQNCフレームワークの全体アーキテクチャ。こちらのリンクをクリックして、この図の拡大版を表示してください。
2. 教育品質評価データセット
提案されたフレームワークは、Kaggleリポジトリから取得した公開データセットであるTeaching Quality Evaluation Datasetを用いて開発されました。このデータセットには、総合教育管理プラットフォーム(CEMP)を通じて収集された、学業成績、評価スコア、出席率、指導特性、および学生の行動指標を表す14の多次元特徴量を含む1,014件の教育記録が含まれていました。これらの属性により、工学系学生の関心を特定することに関連する非線形関係をモデル化するために必要な、多次元的な教育情報が提供されました。
図3に示すように、データセットをトレーニングセット(80%)とテストセット(20%)に分割しました。提案モデルの学習に合計800件のレコードを使用し、200件を性能評価用に確保しました。データセットは、https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset で公開されています。その後、提案したフレームワークを用いてトレーニングデータセットおよびテストデータセットを処理し、学習モデルの構築と予測能力の向上を図りました。
基となるデータセットの名称は「Teaching Quality Evaluation Dataset(教育の質評価データセット)」となっていますが、本研究の目的は工学系学生の関心を特定することにあります。データセットに含まれる教育的、行動的、および指導的な属性を、提案したフレームワークの学習および評価のための入力変数として使用しました。したがって、報告されたすべての予測結果およびパフォーマンス指標は、教育の質を評価したものではなく、工学系学生の関心を特定するにおける本フレームワークの有効性を示すものです。データの前処理を行う前に、インポートしたデータセットについて、全1,014件のレコードが正常に読み込まれていること、データセットのスキーマが想定される形式と一致していること、および欠損レコードや重複レコードが特定され対処されていることを確認しました。
3. Box–Cox robust IQR scaling (BCRIS)を用いたデータ前処理
Box–Cox変換と四分位範囲(IQR)に基づくロバストスケーリングを組み合わせ、極端な値の影響を軽減することで教育データセットの前処理および正規化を行うため、Box–Cox Robust IQR Scaling(BCRIS)法を用いた。対称性の補正と中央値中心の正規化により、その後の解析に適した、統計的に安定しスケーラブルな特徴量表現を生成した。提案された教育インテリジェンスフレームワークにおいて、BCRISは多次元的な教育、指導、および行動指標を、分散制御された特徴量表現に変換した。attendance_rate、interactive_sessions_percentage、および関連する教育変数を含む特徴量を正規化し、トレーニングデータセットとテストデータセットの一貫性を向上させた。詳細な数学的解説は、Supplementary File 1 (Section S1)に記載されている。BCRIS法は、後続のモデリングに必要な基礎的な行動特性を保持しつつ、統計解析の前に不均一な教育データを正規化する、量子互換の前処理戦略を提供した。行動解析の前に、正規化されたデータセットに無効な値や欠損値が含まれていないこと、意味的なノイズが低減されていること、および処理された特徴量がその後の行動モデリングに適していることを確認するため、前処理パイプラインの検証を行った。
4. 量子認知状態モデル(QCSM)を用いた特徴量変換と行動表現
量子に着想を得た確率論的表現を用いて、工学部生の関心のダイナミクスをモデル化するために量子認知状態モデル(QCSM)を実装した。学生の関心は、認知概念の階層、不確実性、概念的な重複、複数のトピックへの同時従事、ためらいや優柔不断な学習行動、および学習好みの移行確率を反映する、複数の概念状態のオーバーラップとして表現された。Student_Avg_Score、Attendance_rate、Student_Feedback_Ratingを含む工学教育質評価データセットからの多次元指標は、正規化された量子状態空間における振幅重み付き認知遷移として表現された。QCSMは、量子状態遷移と干渉に基づく概念的整合性を組み合わせることで、学生の関心の経時的な安定性と進化を反映した量子着想の認知表現を生成した。詳細な数式はSupplementary File 1 (Section S2)に記載されている。QCSMは、正規化された量子状態表現を通じて、知識習得、概念変化、学習への従事、および科目への関心を表現するために確率的認知状態をモデル化した。抽出された認知状態の特徴量が学習行動とトピックの遷移を正確に捉えていることを確認するため、すべての学生レコードにわたって行動表現の検証を行った。
5. 量子強化スウォーム・ホエール最適化特徴選択(QES-WOFS)アルゴリズムを用いた特徴選択
多次元的な教育データから最適な特徴サブセットを特定し、情報量の多い行動特性を決定するために、量子強化スウォーム・ホエール最適化特徴選択(QES-WOFS)アルゴリズムを使用した。量子着想の探索メカニズムにより、特徴最適化のためのグローバル探索戦略とローカル探索戦略の統合が強化された。interactive_sessions_percentage、assignments_time_percentage、course_completion_rateを含む教育変数を、ターゲットとなるアウトカムとの相関に基づいて評価した。候補となる特徴サブセットは量子確率表現を用いてモデル化し、量子トンネルメカニズムによって局所最適解を超えた確率的な遷移を可能にした。各特徴の分類性能および適応的スウォーム状態への寄与度を定量化するため、周辺尤度を用いて特徴量の重要性を推定した。QES-WOFSアルゴリズムは、安定し、かつ行動的に意味のある特徴を選択し、ノイズ、学期ごとの変動、および周期的な行動変動に対する堅牢性を向上させた。
Whale Optimization Algorithm (WOA) または Particle Swarm Optimization (PSO) のいずれかを単独で使用することに伴う制限を克服するため、QES-WOFSアルゴリズムは、PSOベースのグローバル探索とWOAベースのローカル開発を組み合わせました。さらに、量子トンネル効果メカニズムにより、局所最適解を超えた確率的な遷移が可能となり、それによって個体群の多様性が向上し、特徴量の冗長性が低減され、工学系学生の関心を特定するための最適な特徴量サブセットへの収束が改善されました。
詳細な数式は、以下に記載されています。 補足ファイル1(セクションS3)QES-WOFSアルゴリズムは、量子確率的特徴エンコーディング、PSO(粒子群最適化)を適応させた速度戦略、およびクジラに着想を得たスパイラル探索メカニズムを組み合わせることで、最も有益な教育的特徴を特定した。ハイパーパラメータは、訓練データセットを用いて経験的に最適化した。候補値を系統的な実験を通じて評価し、検証性能が最大となった組み合わせを選択した。具体的には、検証精度、F1スコア、および収束挙動に基づき、Box–Cox変換パラメータ(λ = 0.25)、対照損失マージン(m = 1.0)、および量子トンネル係数(α = 0.7およびβ = 0.3)を選択した。分類器の学習前に、QES-WOFSアルゴリズムが最適な特徴サブセットを選択し、冗長な特徴や重要度の低い特徴を除去したことを確認するため、特徴選択の結果を検証した。
6. メタ学習ハイブリッド量子・古典ニューラル分類器(ML-HQNC)を用いたモデルのトレーニングと検証
工学部生の関心を特定するため、ディープニューラルネットワークと量子インスパイア計算を組み合わせたメタ学習ハイブリッド量子・古典ニューラル分類器(ML-HQNC)を実装した。マルチヘッド量子アテンションメカニズムとディープレジデュアルセマンティックレイヤーにより、変分量子回路(VQC)を用いて表現された多次元教育データ内の複雑な非線形関係を捉えた。student_average_grade、attendance_rate、student_feedback_ratingを含む行動由来の特徴量を量子状態空間に投影し、正規化された入力を振幅ベースの量子表現に変換することで、重複および確率的なエンゲージメントパターンをモデル化した。正規化された学生の行動特徴ベクトルは、Supplementary File 1 (Section S4)に提示された方程式に従って算出した。その後、ML-HQNCを用いて工学部生の関心を分類および特定した。
ML-HQNC分類器は、トレーニング中にエピソードメタ学習戦略を採用しました。トレーニングデータセットからランダムに選択された1つのメタ学習タスクが、各エピソードに割り当てられました。クラス分布を維持しながら、トレーニングデータはサポートセット(80%)とクエリセット(20%)に分割されました。サポートセットは内部最適化ループを通じてタスク固有のパラメータ適応に使用され、クエリセットは適応後のモデルを評価し、共有パラメータの更新に使用されるメタ損失を算出しました。各トレーニングサイクルにつき、合計100個のメタ学習タスクが生成されました。内部ループの適応には、内部学習率0.001で5回の勾配更新ステップが使用され、メタパラメータの最適化には外部学習率0.0005のAdamオプティマイザが使用されました。モデルを多様な行動パターンにさらし、未知の学生プロフィールへの汎化性能を向上させるため、トレーニングエポックごとにランダムなタスクサンプリングが繰り返されました。量子対照アライメントの損失推定については、Supplementary File 1 (Equations 41–45)に記載されています。計算エラーなく正常に収束したこと、およびトレーニング損失と検証損失の曲線が連続するエポックにわたって安定したことを確認し、モデルのトレーニングを検証しました。
結果
提案されたML-HQNCフレームワークの評価は、正解率(Accuracy)、適合率(Precision)、再現率(Recall)、F1スコア、および受信者動作特性曲線下面積(AUC)などの一般的な分類指標を用いて、Fast R-CNN、Bi-LSTM、CNN、およびXGBoostと比較して行われました。併せて、提案された評価指標である関心検出適合率(IDP)、量子パターン安定性指標(QPSI)、およびクロスドメイン適応利得(CDAG)も使用されました。これらの指標の数学的定義は、補足ファイル1(セクションS5)に記載されています。
提案したフレームワークの堅牢性を評価するため、異なるランダム初期化を用いてすべての実験を5回繰り返した。報告された性能値は、5回の試行における平均値 ± 標準偏差として示している。提案したフレームワークとベースラインモデルとの間の統計的有意性は、対応のあるt検定を用いて評価し、p < 0.05を統計的に有意であると見なした。
付録表1にまとめられているように、1,014件のレコードを含む教育品質評価データセットを用いてシミュレーション実験を実施した。合計800件のレコードをモデルのトレーニングに使用し、200件のレコードをテスト用に確保した。提案するML-HQNCフレームワークおよび比較モデルは、Pythonを用いてJupyter Notebook環境で実装した。公開されている教育品質評価データセットにおいて、Teaching_Quality属性が元のターゲット変数として機能しており、これはGoodとExcellentの2つのクラスで構成されていた。これらのラベルを、ML-HQNCフレームワークのトレーニングおよび評価における予測ターゲットとして使用した。得られた予測カテゴリを表3にまとめる。Box–Cox Robust IQR Scaling (BCRIS) 前処理段階の検証結果を付録表2にまとめる。この前処理パイプラインは、特徴量変換とモデルトレーニングの前に、欠損および重複レコードの削除、外れ値の影響の軽減、特徴量分布の正規化を行い、意味的および行動的な一貫性を向上させた。
表 3:教育品質評価データセットのターゲット変数。元のTeaching_Qualityターゲット変数と、モデルのトレーニングおよび評価に使用されたその分類カテゴリー(GoodおよびExcellent)の説明。この表をダウンロードするには、ここをクリックしてください。
付随表3に、量子認知状態モデル(QCSM)によって生成された代表的な特徴量を示します。抽出された特徴量は、認知状態、エンゲージメント、不確実性、トピックの遷移、行動の一貫性を含む学生の学習行動を記述しており、後続のQES-WOFS特徴量選択ステージへの入力として使用されました。付随表S4には、QES-WOFSアルゴリズムによって最終的に選択された特徴量と、その特徴量カテゴリー、相対的な影響度、および提案フレームワーク内での機能的役割を列挙しています。抽出された多次元行動特徴量の特性については、付随表5にまとめています。付随表6は、2つの予測クラス(GoodおよびExcellent)の行動表現中に生成された代表的なエッジ構造を示しています。
図4および表4に示すように、提案したML-HQNCフレームワークは、評価した手法の中で最高のF1スコア(87.9%)を達成した。対応するFast R-CNN、Bi-LSTM、CNN、およびXGBoostのF1スコアは、それぞれ77.9%、80.2%、82.8%、および85.8%であった。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価した。
図 5および表 5に、関心検出精度(IDP)の結果をまとめる。提案したML-HQNCフレームワークは89.3%のIDPを達成し、これに対しFast R-CNN、Bi-LSTM、CNN、XGBoostはそれぞれ79.11%、82.12%、84.6%、87.10%であった。図 6および表 6に、量子パターン安定性指数(QPSI)の結果を示す。提案したフレームワークは92.7%のQPSI値を達成したが、Fast R-CNN、Bi-LSTM、CNN、XGBoostはそれぞれ81.1%、84.11%、87.4%、90.9%であった。図 7および表 7に、クロスドメイン適応利得(CDAG)の結果をまとめる。提案したML-HQNCフレームワークは、Fast R-CNN(0.78)、Bi-LSTM(0.83)、CNN(0.80)、XGBoost(0.86)と比較して、最高のCDAG値(0.95)を達成した。図 8および表 8に示すように、提案したML-HQNCフレームワークは最高の分類精度(96.17%)を達成した。これに対応するFast R-CNN、Bi-LSTM、CNN、XGBoostの精度は、それぞれ85.10%、87.21%、90.14%、93.19%であった。図 9および表 9に、各手法で必要とされた計算時間を示す。提案したML-HQNCフレームワークで必要とされた時間は9.02 msであったが、Fast R-CNN、Bi-LSTM、CNN、XGBoostではそれぞれ31.2 ms、27.5 ms、22.4 ms、17.6 msであった。図 10に、受信者動作特性(ROC)解析を示す。提案したML-HQNCフレームワークは0.944のAUCを達成し、評価した分類しきい値全体にわたって高い真陽性率と低い偽陽性率を示した。
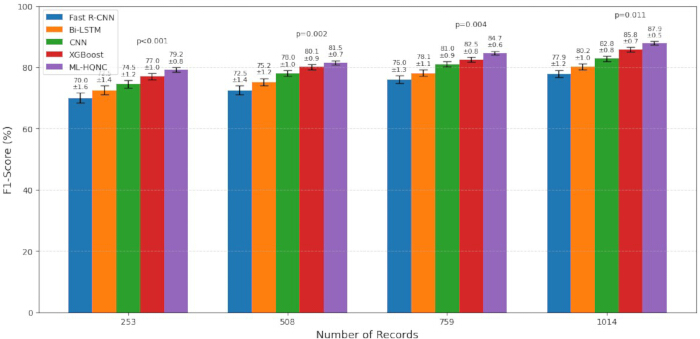
図 4: データセットサイズごとのF1スコアの比較。異なるデータセットサイズにおけるML-HQNCと競合モデルで達成されたF1スコアの比較。 結果は5回の独立した実験試行(n = 5)の平均値 ± 標準偏差として報告されている。エラーバーは1標準偏差を表す。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価した。こちらのリンクをクリックして、この図の拡大版を表示してください。
表4:異なるデータセットサイズにおけるF1スコアの比較。ML-HQNCと競合モデルによって達成されたF1スコアの比較。結果は5回の独立した実験試行(n = 5)における平均値 ± 標準偏差として報告されている。こちらのリンクから本表をダウンロードしてください。
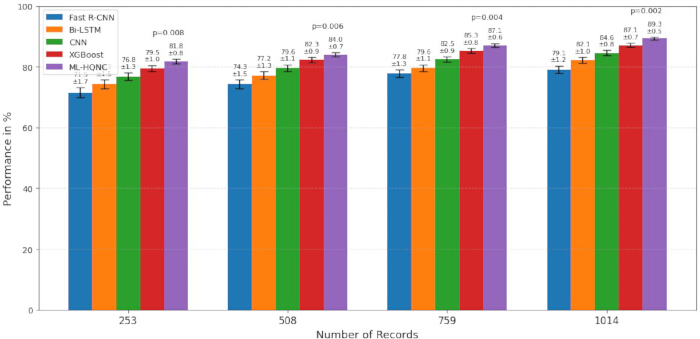
図 5: データセットサイズごとの関心検出精度(IDP)の比較。異なるデータセットサイズにおいて、ML-HQNCおよび競合モデルによって達成された関心検出精度(IDP)の比較。結果は5回の独立した実験(n = 5)における平均値 ± 標準偏差として報告している。エラーバーは1標準偏差を表す。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価した。こちらのリンクをクリックして、この図の拡大版を表示してください。
表5:異なるデータセットサイズにおける関心検出精度(IDP)の比較。ML-HQNCと競合モデルによって達成された関心検出精度(IDP)の比較。結果は、5回の独立した実験ラン(n = 5)における平均値 ± 標準偏差として報告されている。こちらのリンクからこの表をダウンロードしてください。
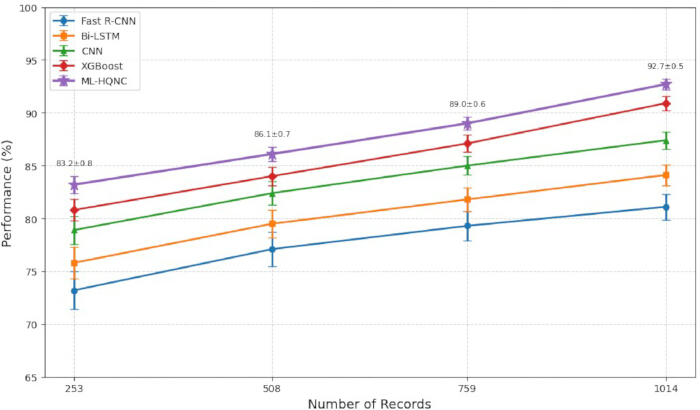
図 6: 異なるデータセットサイズにおける量子パターン安定性指標(QPSI)の比較。異なるデータセットサイズにおいて、ML-HQNCおよび競合モデルで達成された量子パターン安定性指標(QPSI)の比較。結果は5回の独立した実験ラン(n = 5)における平均値 ± 標準偏差として報告されている。エラーバーは1標準偏差を表す。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価した。こちらのリンクをクリックして、この図の拡大版を表示してください。
表6:異なるデータセットサイズにおける量子パターン安定性指数(QPSI)の比較。ML-HQNCおよび競合モデルによって達成された量子パターン安定性指数(QPSI)の比較。結果は5回の独立した実験ラン(n = 5)の平均値 ± 標準偏差として報告されている。ここをクリックしてこの表をダウンロードしてください。
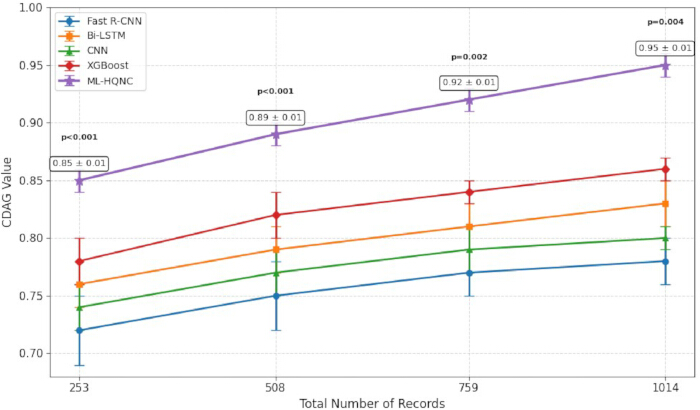
図 7: データセットサイズ別のドメイン間適応利得(CDAG)の比較。異なるデータセットサイズにおいて、ML-HQNCおよび競合モデルによって達成されたドメイン間適応利得(CDAG)の比較。結果は5回の独立した実験ラン(n = 5)の平均値 ± 標準偏差として報告されている。エラーバーは1標準偏差を表す。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価した。こちらをクリックして、この図の拡大版を表示してください。
表7:異なるデータセットサイズにおけるクロスドメイン適応利得(CDAG)の比較。ML-HQNCおよび競合モデルによって達成されたクロスドメイン適応利得(CDAG)の比較。結果は、5回の独立した実験ラン(n = 5)における平均値 ± 標準偏差として報告されている。こちらをクリックしてこの表をダウンロードしてください。
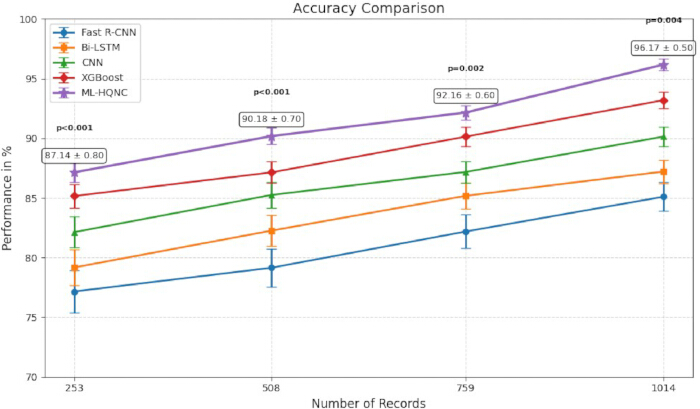
図 8: データセットサイズごとの分類精度の比較。異なるデータセットサイズにおけるML-HQNCと競合モデルで達成された分類精度の比較。結果は5回の独立した実験ラン(n = 5)における平均値 ± 標準偏差として報告されている。エラーバーは1標準偏差を示す。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価した。こちらのリンクをクリックして、この図の拡大版を表示してください。
表8:異なるデータセットサイズにおける分類精度の比較。ML-HQNCと競合モデルによって達成された分類精度の比較。結果は、5回の独立した実験走行(n = 5)における平均値 ± 標準偏差として報告されている。こちらのリンクからこの表をダウンロードしてください。
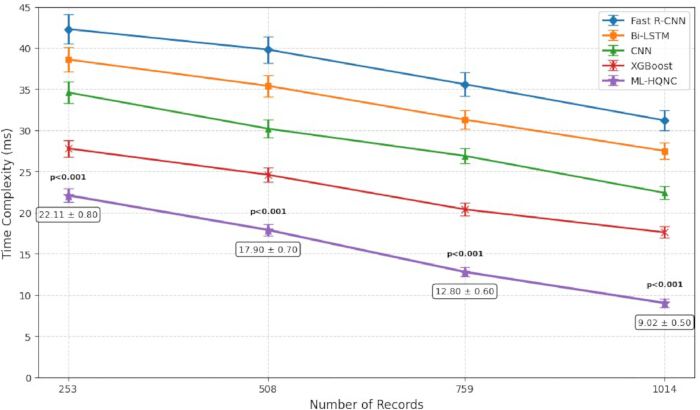
図 9: データセットサイズ別の計算時間の比較。異なるデータセットサイズにおけるML-HQNCと競合モデルの計算実行時間の比較。結果は5回の独立した実験走行(n = 5)における平均値 ± 標準偏差として報告されている。エラーバーは1標準偏差を表す。値が低いほど、計算実行時間が短いことを示す。統計的有意性は、両側独立t検定(p < 0.05)を用いて評価された。ここをクリックして、この図の拡大版を表示してください。
表9:異なるデータセットサイズにおける計算時間の比較。ML-HQNCと競合モデルの計算実行時間の比較。結果は5回の独立した実験(n = 5)の平均値 ± 標準偏差として報告されている。値が低いほど、計算実行時間が短いことを示す。こちらのリンクからこの表をダウンロードしてください。
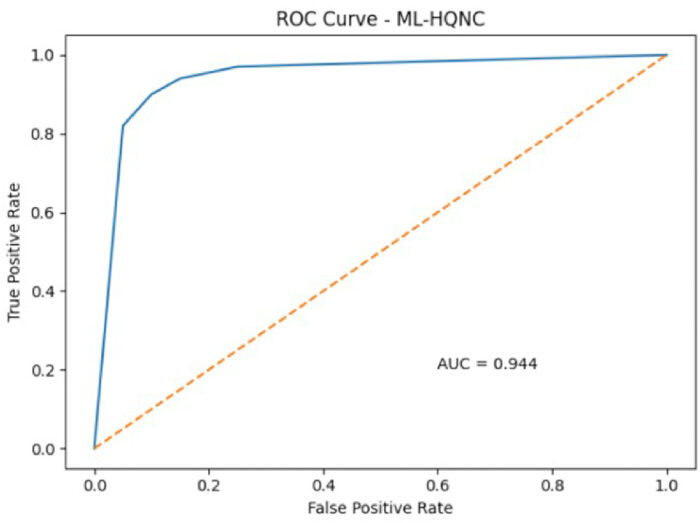
図 10: 受信者動作特性曲線下面積(AUC)の比較。工学系学生の関心特定において、ML-HQNCおよび競合モデルによって達成されたAUCの比較。報告されているAUC値は単一の実験ランに対応しているため、エラーバーおよび統計的有意性分析は提示していない。こちらのリンクをクリックして、この図の拡大版を表示してください。
付随図1に、代表的な行動変数の相関行列を示す。 Avg_ScoreとCourse_Completion_Rateの間(0.81)、およびAttendance_RateとCourse_Completion_Rateの間(0.75)に強い正の相関が観察された。また、Avg_ScoreとCourse_Completionの間(0.72)、およびAttendance_RateとTime_Assignment_Percentageの間(0.74)に中程度の相関が観察された。付随図2および3、および表10に、学習およびテストの精度マップをまとめる。提案したML-HQNCフレームワークは、学習精度96.1%、テスト精度93.8%を達成し、比較手法の性能を上回った。付随図4および5、および表11に、収束解析の結果をまとめる。提案したML-HQNCフレームワークは、最適化プロセス全体を通じて安定した収束を示し、最低の学習損失(0.21)およびテスト損失(0.26)を達成した。
表12は、提案されたML-HQNCフレームワークと、すべての評価指標における比較手法の総合的な性能をまとめたものである。提案フレームワークは、評価した手法の中で最も短い計算時間を必要としながら、Accuracy、F1-score、AUC、IDP、QPSI、およびCDAGにおいて最高の性能を達成した。表13は、提案フレームワークのコンポーネントごとのアブレーション解析を示している。BCRIS前処理ステージ、QCSM行動表現、QES-WOFS特徴選択アルゴリズム、および完全なML-HQNC分類器を段階的に組み込むことで、分類性能が漸進的に向上し、各コンポーネントがフレームワーク全体に寄与していることが実証された。
表10:トレーニング精度とテスト精度の比較。ML-HQNCおよび競合モデルによって達成されたトレーニング精度とテスト精度の比較。報告された値は1回の実験ランに対応している。こちらをクリックしてこの表をダウンロードしてください。
表11:トレーニング損失とテスト損失の比較。ML-HQNCと競合モデルによって達成されたトレーニング損失およびテスト損失の比較。報告された値は1回の実験ランに対応している。こちらのリンクから本表をダウンロードしてください。
表12:総合的な性能比較。複数の評価指標を用いたML-HQNCと競合モデルの比較。結果は5回の独立した実験走行(n = 5)における平均値 ± 標準偏差として報告されている。こちらのリンクから本表をダウンロードしてください。
データの可用性:
本研究で使用した元のTeaching Quality Evaluation Datasetは、Kaggleリポジトリ(https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset)から公開されています。データセットへのアクセスにはユーザー認証が必要な場合があり、Kaggleの利用規約が適用されます。元のデータセットのライセンス条件を遵守しつつ再現性を担保するため、合成データセット、ソースコード、実装および設定ファイル、特徴量の説明、前処理ワークフロー、および報告された実験を再現するために必要なサポートドキュメントを含む、本研究で生成されたリソースは、オープンアクセス可能なZenodoリポジトリ(https://doi.org/10.5281/zenodo.21393413)に登録されています。
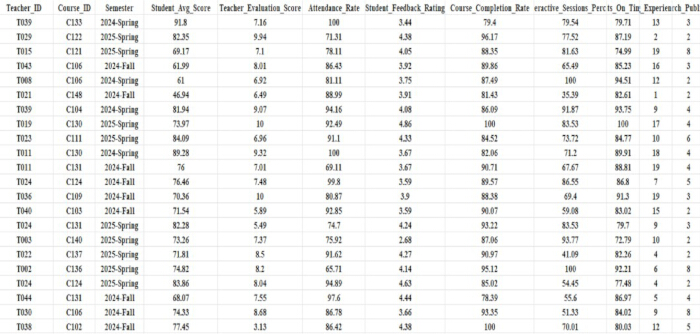
図 3: 教育品質評価データセットの特徴収集。工学系学生の興味特定に使用された教育品質評価データセットの構造および特徴構成。こちらのリンクをクリックして、この図の拡大版を表示してください。
付随図1:特徴量相関行列。提案されたML-HQNCフレームワークで使用される、代表的な教育的および行動的変数の間のペアワイズ関係を示す相関行列。こちらをクリックしてファイルをダウンロードしてください。
付随図2:訓練精度の比較。訓練プロセスにおけるML-HQNCと競合モデルによって達成された訓練精度の比較。こちらをクリックしてファイルをダウンロードしてください。
補足図3:テスト精度の比較テストプロセスにおけるML-HQNCと競合モデルで達成されたテスト精度の比較。こちらのリンクからファイルをダウンロードしてください。
補足図4:トレーニング損失の解析。モデル最適化中にML-HQNCおよび競合モデルによって達成されたトレーニング損失の比較。こちらのリンクからファイルをダウンロードしてください。
補足図 5:テスト損失の解析。モデル評価におけるML-HQNCと競合モデルで達成されたテスト損失の比較。このファイルをダウンロードするには、ここをクリックしてください。
補足表 1:シミュレーションパラメータおよび実験設定。 提案された ML-HQNC フレームワークを評価するために使用した、シミュレーションパラメータ、実装環境、データセットの分割、および実験設定の要約。こちらをクリックしてファイルをダウンロードしてください。
補足表2:Box–Cox Robust IQR Scaling (BCRIS) 前処理段階の検証結果。欠損値、重複レコード、外れ値の処理、特徴量の正規化、およびデータの整合性を含む、前処理前後の代表的なデータセット特性の比較。こちらをクリックしてファイルをダウンロードしてください。
補足表3:量子認知状態モデル(QCSM)によって生成された代表的な特徴量。データ前処理後にQCSMによって生成された、認知状態、エンゲージメント、不確実性、トピック遷移、および行動の一貫性の特徴量を含む代表的な行動特徴量。こちらのリンクをクリックしてファイルをダウンロードしてください。
補足表4:量子強化スウォーム・ホエール最適化特徴選択(QES-WOFS)アルゴリズムによって選択された特徴量。 QES-WOFSアルゴリズムによって選択された最終的な特徴量サブセットと、それに対応する特徴量のカテゴリ、相対的な影響レベル、および提案されたフレームワーク内での機能的役割を示す。 こちらをクリックしてファイルをダウンロードしてください。
補足表 5:指導品質の予測カテゴリー提案されたML-HQNCフレームワークで使用される予測カテゴリーの説明および代表的な行動特性。こちらをクリックしてファイルをダウンロードしてください。
補足表 6:マージン感度分析。モデル評価中に使用されたマージン感度分析の概要。こちらのリンクからファイルをダウンロードしてください。
補足ファイル 1:補足方法、数式、評価指標、および補足表このファイルには、メインプロトコルで説明されているBox–Cox Robust IQR Scaling (BCRIS)、Quantum Cognitive State Model (QCSM)、Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS)、およびMeta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC)の詳細な数式が含まれています。また、評価指標の定義、シミュレーションパラメータ、実験設定、およびメイン論文で提示された結果を裏付ける補足表S1~S6も含まれています。こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
提案されたML-HQNCフレームワークは、量子インスパイア行動モデリング、適応的特徴選択、およびメタ学習を統合した単一の計算ワークフローにより、工学系学生の関心を特定する性能が向上することを実証しました。Fast R-CNN、Bi-LSTM、CNN、およびXGBoostと比較して、本フレームワークは従来の分類指標および提案された行動評価指標のいずれにおいても、一貫して高い性能を達成しました。これらの知見は、量子インスパイア認知状態表現と適応的特徴最適化を組み合わせることで、堅牢な分類性能を維持しつつ、複雑な教育的行動をモデル化するフレームワークの能力が向上したことを示唆しています。また、計算時間が短く、学習性能とテスト性能の差が小さいことは、安定した最適化と良好な汎化性能が得られていることをさらに示しています。
提案された評価指標は、行動モデリングに関する追加情報を提供することで、従来の分類尺度を補完した。関心検出精度(Interest Detection Precision: IDP)は関心同定の正確性を定量化し、量子パターン安定性指標(Quantum Pattern Stability Index: QPSI)は量子着想の行動表現の安定性を評価し、ドメイン間適応ゲイン(Cross-Domain Adaptability Gain: CDAG)は異なるデータパーティションにわたって一般化するフレームワークの能力を評価した。これらの指標を併用することで、従来の予測指標のみよりも広範なモデル性能の評価が可能となった。
コンポーネントごとのアブレーション解析(表 13)により、提案したワークフローの各段階の寄与がさらに実証されました。Box–Cox Robust IQR Scaling (BCRIS) 前処理段階を組み込むことで、外れ値の影響を軽減し、正規化された特徴表現を生成し、データの整合性が向上しました。Quantum Cognitive State Model (QCSM) は、多次元の教育変数を、不確実性、エンゲージメント、および進化する学習嗜好を捉えた行動表現へと変換しました。それに続く Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) アルゴリズムを用いた特徴選択により、有益な行動特性を維持しつつ、特徴の冗長性が削減されました。最終的に、これらのコンポーネントを Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) に統合することで、ベースラインモデルと比較して分類性能と汎化性能が向上しました。
提案されたプロトコルは、デジタル学習環境から収集された多次元的な教育および行動データを用いて、工学系学生の関心を特定することを目的としています。この計算ワークフローは、学生の学習行動を分析し、進化する関心を特定するための体系的なアプローチを提供することで、個別最適化された学習、アカデミック・アドバイジング、カリキュラム計画、およびインテリジェントな教育管理を支援します。本フレームワークは、行動、学業、および文脈的な変数を含む構造化された教育データセットに特に適しています。
実装を成功させるには、高品質な教育データの可用性と適切な計算リソースが必要です。データの品質は前処理およびその後の行動モデリングに直接影響するため、解析前に、教育データセットについて欠損値、重複レコード、および不整合がないかを確認する必要があります。また、安定した特徴量表現は、適切な前処理、特徴量変換、およびハイパーパラメータの最適化に依存します。モデルのトレーニング中は、トレーニングおよび検証の損失曲線を通じて収束をモニタリングし、安定した学習動作を維持するために必要に応じて最適化パラメータを調整する必要があります。
本フレームワークは評価データセットを用いて効果的な性能を示しましたが、いくつかの限界を考慮する必要があります。本プロトコルは、単一の公開教育データセットを用いて検証されており、汎用性をさらに評価するためには、より大規模で、複数の機関にまたがる、より多様な教育データセットを用いた追加の評価が必要です。また、ハイブリッド量子着想学習フレームワークは、前処理、最適化、およびハイブリッド学習コンポーネントがあるため、従来の機械学習アプローチよりも多くの計算リソースを必要とします。さらに、本フレームワークは適切にアノテーションされた教育データに依存しており、不完全なデータセット、ノイズの多いデータセット、または極端に不均衡なデータセットによって性能が影響を受ける可能性があります。
今後の研究では、より詳細なマルチクラスの学生の関心特定へとフレームワークを拡張すること、テキスト形式のフィードバック、時間的な学習行動、リアルタイムの学習管理システムのアクティビティログなどの追加的な教育データモダリティを組み込むこと、および多様な工学教育環境において本プロトコルを評価することに焦点を当てます。また、計算ワークフローをさらに最適化することで、スケーラビリティを向上させ、大規模な教育管理システムへの導入を促進できる可能性があります。
要約すると、提案されたML-HQNCフレームワークは、多次元的な教育データを用いて工学系の学生の興味関心を特定するための、再現可能な計算ワークフローを提供します。堅牢な前処理、量子インスパイア行動モデリング、適応的特徴選択、およびハイブリッド量子・古典ニューラル学習を統合することで、このフレームワークは安定した最適化と効率的な計算を維持しつつ、分類性能の向上を達成しました。これらの特性は、インテリジェントな教育分析および工学教育管理における潜在的な応用の可能性を支持するものです。
開示事項
著者は競合する利害関係がないことを宣言します。
謝辞
著者は、本研究を促進するための学術的支援および研究環境を提供した中国の蚌埠大学に感謝いたします。本研究は、蚌埠大学2025年度学校レベル品質エンジニアリングプロジェクト(No. 2025zhkc1)の支援を受けて行われました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| ベースラインモデル (Fast R-CNN, Bi-LSTM, CNN, XGBoost) | オープンソース実装 | Fast R-CNN (2015); TensorFlow/Keras implementation v2.16; XGBoost v2.1.1 | 性能比較評価に使用したベンチマークモデル。 |
| BCRIS前処理モジュール | 本研究で開発 | Version 1.0 | Box-Cox変換および堅牢なIQR正規化を実装したカスタム前処理モジュール。 |
| Jupyter Notebook | Project Jupyter | Version 7.2.2 | 実装、トレーニング、およびテストに使用したインタラクティブ開発環境。 |
| ML-HQNC 分類器 | 本研究で開発 | Version 1.0 | メタ学習フレームワークを備えた、提案ハイブリッド量子・古典ニューラルネットワーク分類器。 |
| Python | Python Software Foundation | Version 3.11.9 | モデル開発および実験に使用したプログラミング言語。 |
| PyTorch | PyTorch Foundation | Version 2.5.1 | モデルの実装およびトレーニングに使用したディープラーニングフレームワーク。 |
| QCSMモデル | 本研究で開発 | Version 1.0 | 行動パターンの表現のために提案された量子認知状態モデル。 |
| QES-WOFSアルゴリズム | 本研究で開発 | Version 1.0 | 提案された量子強化群–クジラ最適化特徴選択アルゴリズム。 |
| Scikit-learn | Scikit-learn Developers | Version 1.6.1 | 前処理、特徴選択、および評価に使用した機械学習ライブラリ。 |
参考文献
- Xu Q, Deng H. Research on education management system based on machine learning and multidimensional data modeling. Applied Mathematics and Nonlinear Sciences. 2024;9(1). https://dialnet.unirioja.es/servlet/articulo?codigo=9386765
- Li D. An interactive teaching evaluation system for preschool education in universities based on machine learning algorithm. Comput Hum Behav. 2024;157:108211. https://doi.org/10.1016/j.chb.2024.108211
- Chunhua H, Kaabar MKA, Qiuju X, Zhang G. Fuzzy comprehensive evaluation of students' classroom experience in online teaching. International Journal of Emerging Technologies in Learning. 2023;18(21):79-88.
- He Z, et al. Assessment of influencing factors of college and universities' teaching effects using fuzzy and deep learning techniques. Scientific Reports. 2026;16:5168. https://doi.org/10.1038/s41598-026-35940-5
- Liu J. Innovation and practice of educational management system in colleges and universities based on the concept of data analysis education. Applied Mathematics and Nonlinear Sciences. 2023;9(1). https://www.researchgate.net/publication/377568313
- Li C, Cao Z. Deep learning-based AI model for predicting academic success and engagement among physical higher education students. Scientific Reports. 2025;15:45471. https://doi.org/10.1038/s41598-025-29000-7
- Kong Y, Dong R, Zhang H. Classroom behavior analysis and digital teaching quality evaluation based on spatiotemporal graph neural network. Discover Artificial Intelligence. 2025;5:404. https://doi.org/10.1007/s44163-025-00623-z
- Zedan F, Jabali RR, Raiyn J. Detecting student inattention using deep learning and behavioral analysis. Journal of International Education Practice. 2026;9(1):1-17.
- Feng F. Deep learning-based model for analyzing student engagement in activities. Scientific Reports. 2025;16:2552. https://doi.org/10.1038/s41598-025-32521-w
- Turkmenbayev A, et al. The application of machine learning in predicting student performance in university engineering programs: A rapid review. Frontiers in Education. 2025;10:1562586. https://doi.org/10.3389/feduc.2025.1562586
- Albreiki B, Zaki N, Alashwal H. A systematic literature review of student performance prediction using machine learning techniques. Education Sciences. 2021;11(9):552. https://doi.org/10.3390/educsci11090552
- Lai Q. Research on the refinement of college student education management based on artificial intelligence. Discover Artificial Intelligence. 2026;6:31. https://doi.org/10.1007/s44163-025-00651-9
- Yuanyuan L, et al. Research on the application framework of intelligent technologies to promote teachers' classroom teaching behavior evaluation. Frontiers of Education in China. 2023;18(1):12–35. https://doi.org/10.3868/s110-008-023-0012-8
- Shi Y, Sun F, Zuo H, Peng F. Analysis of learning behavior characteristics and prediction of learning effect for improving college students' information literacy based on machine learning. IEEE Access. 2023;11:50447-50461.
- Liu S, Zhang J, Su W. An improved method of identifying learner's behaviors based on deep learning. Journal of Supercomputing. 2022;78(10):12861-12872.
- Yang J. Accurate prediction and analysis of college students' performance from online learning behavior data. IEIE Transactions on Smart Processing and Computing. 2023;12(3):404-411.
- Xie Y, Zhang S, Liu Y. Abnormal behavior recognition in classroom pose estimation of college students based on spatiotemporal representation learning. Traitement du Signal. 2021;38(6):1769-1778.
- Shen X, Yuan C. A college student behavior analysis and management method based on machine learning technology. Wireless Communications and Mobile Computing. 2021;2021:6611630. https://doi.org/10.1155/2021/6611630
- Li G, et al. A convolutional neural network-based approach for the recognition and evaluation of classroom teaching behavior. Scientific Programming. 2021;2021:5513886. https://doi.org/10.1155/2021/5513886
- Feng C, et al. IMRMB-Net: A lightweight student behavior recognition model for complex classroom scenarios. PLoS ONE. 2025;20(2):e0318817. https://doi.org/10.1371/journal.pone.0318817
- Zhang Y, Liu T, Ru B. Effect evaluation and student behavior design method of moral education in colleges and universities under the environment of deep learning. Scientific Programming. 2022;2022:6056117. https://doi.org/10.1155/2022/6056117
- Liu C, Wang H, Yuan Z. A method for predicting the academic performances of college students based on education system data. Mathematics. 2022;10(19):3737. https://doi.org/10.3390/math10193737
- Vora DR, Iyer KR. Deep learning in engineering education: performance prediction using cuckoo-based hybrid classification. In: Machine Learning and Deep Learning in Real-Time Applications. Studies in Computational Intelligence, Vol. 841, pp. 187-218. Springer; Singapore; 2020.
- Li H, Liu Z. An intelligent educational system: analyzing student behavior and academic performance using multi-source data. Electronics. 2024;14(16):3328. https://doi.org/10.3390/electronics14163328
- Zhang Y, Li J. Deep learning-based model for predicting student learning behavior: a pathway to early intervention and enhanced outcomes. Journal of Computational Methods in Sciences and Engineering. 2025;25(2):1169-1184.
- Jia Q, He J. Student behavior recognition in classroom based on deep learning. Applied Sciences. 2024;14(18):7981. https://doi.org/10.3390/app14187981
- Luo H. Prediction of student decision-making behaviour based on machine learning algorithms. Pakistan Journal of Life and Social Sciences. 2024;22(2):11045-11058.
- Abdi A, Sedrakyan G, Veldkamp B. Students' feedback analysis model using deep learning-based method and linguistic knowledge for intelligent educational systems. Soft Computing. 2023;27(38):14073-14094.
- Ning X. Behavior recognition of college students based on improved deep learning algorithm. International Journal of Web-Based Learning and Teaching Technologies. 2023;18(1):1-16.
- Sravya MN, Prashanth D, Saifa S, Reddy LS. A comprehensive analysis of learning behaviour characteristics and predictive modeling of learning outcomes to enhance college-level academic performance. International Journal of Pharmacy and Medical Sciences. 2025;5(2):94-100.
- Kalita E, et al. Predicting student academic performance using Bi-LSTM: a deep learning framework with SHAP-based interpretability and statistical validation. Frontiers in Education. 2025;10:1581247. https://doi.org/10.3389/feduc.2025.1581247
- Alias MAH, Hambali N, Aziz MAA. Feature selection techniques and classification algorithms for student performance classification: a review. International Journal of Electrical and Computer Engineering. 2024;14(3):3230-3242.
- Wang Z, et al. Students' classroom behavior detection system incorporating deformable DETR with Swin Transformer and lightweight feature pyramid network. Systems. 2023;11(7):372. https://doi.org/10.3390/systems11070372
- Zou X. Design of student behavior analysis and management system based on deep learning. International Journal of High Speed Electronics and Systems. 2024;33(1):2450005. https://doi.org/10.1142/S012915642450005X
- Zhang Q. The impact of machine learning-based student behaviour detection on teaching in classroom scenarios. Journal of Information and Knowledge Management. 2025;24(1):2450101. https://doi.org/10.1142/S021964922450101X
- Yu C, Wang Y. College student management system based on K-means clustering algorithm. Int J New Dev Educ. 2022;4(2):28-33.
- Chen J, Lu H. Evaluation method of classroom teaching effect under intelligent teaching mode. Mobile Networks and Applications. 2022;27(3):1262-1270.
- Han X, Chen X. The evaluation model of engineering practice teaching with complex network analytic hierarchy process based on deep learning. Scientific Reports. 2025;15:14733. https://doi.org/10.1038/s41598-025-14733-x
- Guo S, et al. The analysis of teaching quality evaluation for college sports dance by convolutional neural network model and deep learning. Heliyon. 2024;10(8):e36067. https://doi.org/10.1016/j.heliyon.2024.e36067
- Gao Y. Deep learning-based strategies for evaluating and enhancing university teaching quality. Computers and Education: Artificial Intelligence. 2025;8:100362. https://doi.org/10.1016/j.caeai.2025.100362
- Li Y, Lu B. Intelligent educational systems based on adaptive learning algorithms and multimodal behavior modeling. PeerJ Computer Science. 2025;11:e3157. https://doi.org/10.7717/peerj-cs.3157
- Geng F, John AD, Chinnappan CV. Analysis of the teaching quality using novel deep learning-based intelligent classroom teaching framework. Progress in Artificial Intelligence. 2023;12(2):147-162.
- Veluri RK, et al. Learning analytics using deep learning techniques for efficiently managing educational institutes. Materials Today: Proceedings. 2022;51(Part 8):2317-2320.
- Chen W, Min L. The evaluation model of physical education teaching performance based on deep learning algorithm. Scalable Computing: Practice and Experience. 2025;26(3):458-466.
- Zhang Y. A comprehensive evaluation system for physical education teaching effectiveness supported by multimodal machine learning. Discover Artificial Intelligence. 2026;6:75. https://doi.org/10.1007/s44163-026-00075-x
- Pei Y, Lu G. Design of an intelligent educational evaluation system using deep learning. IEEE Access. 2023;11:29790-29799.
- Ding J, Su Y. A teaching management system for physical education in colleges and universities using the theory of multiple intelligences and SVM. Soft Computing. 2024;28(2):685-701.
- Li Y, Zhang L, Tian Y, Qi W. Research on teaching practice of blended higher education based on deep learning route. Computational Intelligence and Neuroscience. 2022;2022:5751843. https://doi.org/10.1155/2022/5751843
- Jiang X, Du Y, Zheng Y. Evaluation of physical education teaching effect using Random Forest model under artificial intelligence. Heliyon. 2024;10(1):e23576. https://doi.org/10.1016/j.heliyon.2024.e23576
- Li S, Liu T. Performance prediction for higher education students using deep learning. Complexity. 2021;2021:6620684. https://doi.org/10.1155/2021/6620684
- Alnasyan B, Basheri M, Alassafi MO, Alnasyan K. Kanformer: An Attention-Enhanced Deep Learning Model for Predicting Student Performance in Virtual Learning Environments. Social Network Analysis and Mining. 2025;15:25. https://doi.org/10.1007/s13278-025-01446-7
- Lu Y, Tong L, Cheng Y. Advanced Knowledge Tracing: Incorporating Process Data and Curricula Information via an Attention-Based Framework for Accuracy and Interpretability. Journal of Educational Data Mining. 2024;16(2):58-84.