本プロトコルでは、デジタル保存および創造的な文化遺産の活用を目的とした、非物質文化遺産のパターンのセマンティックセグメンテーション、再構成、および芸術的スタイル合成のためのディープラーニングワークフローについて解説します。ここでは、トランスフォーマーベースの特徴抽出、敵対的再構成、および空間適応的な画像生成を用いています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
研究記事
ディープラーニングフレームワークを用いた無形文化遺産パターンのセマンティックセグメンテーション誘導再構築および芸術的スタイル合成
この記事について
サマリー
要約
深層学習ベースの画像合成技術の進展に伴い、無形文化遺産(ICH)パターンのデジタル保存と再構築がますます注目を集めています。既存のSegCycle-SPADEベースのアプローチは、伝統工芸パターンの構造的なセグメンテーションと芸術的な再構築において可能性を示してきましたが、データセットの多様性の不足、文化的意味論の組み込み不十分、および再構築時における構造的なパターン特徴の保持不足などの制限が残っています。これらの課題を解決するため、本研究ではICHパターン種類のセグメンテーションおよび芸術的再構築に向けた、改良版SegCycle-SPADEフレームワークを提案します。モチーフの境界とパターン領域を正確に特定するために、TransformerベースのセグメンテーションモデルであるSegFormerを採用しています。さらに、文化的に重要なモチーフを強調し、特徴表現を向上させるために、Cross-Attention Cultural Feature Fusion Moduleを導入しました。パターンの変換と再構築にはCycleGANを用い、セグメンテーションマップと生成画像間の意味的一貫性を維持するための芸術的スタイル合成にはSpatially-Adaptive Denormalization(SPADE)を使用しています。モデルの汎用性と芸術的多様性を高めるため、本フレームワークは苗族 Batikの文化的モチーフデータセットとWikiArtデータセットの両方を用いて学習されています。実験結果から、提案されたアテンション誘導型SegCycle-SPADEフレームワークは、既存の生成敵対的ネットワーク(GAN)ベースの再構築手法と比較して、セグメンテーション精度と文化遺産パターンの再構築性能を向上させることが実証されました。提案されたフレームワークは、人工知能を用いた文化遺産の記録、再構築、および伝統的なパターンデザインの芸術的再生のための拡張可能なソリューションを提供します。
概要
文化遺産は、慣習、言語、信仰などの無形要素と、芸術作品、建築物、書面記録などの有形要素の両方を含み、人類の歴史、創造性、そしてアイデンティティの根本的な現れです1。遺産保存は、コミュニティが自らの起源と再びつながることを可能にし、次世代が共通の文化的記憶から恩恵を受けられるようにすることを目的としています。また、異文化間の理解や、多様な伝統と慣習への評価、そして異なる歴史的叙述の認識を促進します。これらの文化資産は、前世代の価値観、視点、経験を理解する助けとなり、現代の社会的アイデンティティの形成と文化的連続性に寄与します。文化遺産保存の基本原則は図1に示されています。
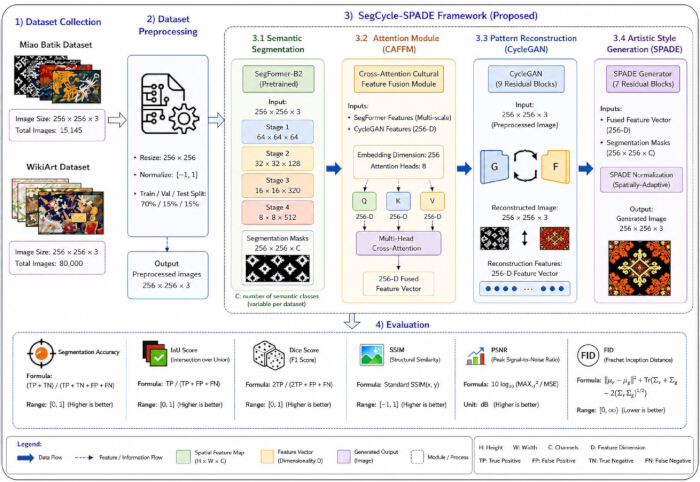
図 1. SegCycle-SPADEフレームワークを用いた文化遺産パターンの再構成に関する概念的な概要。無形文化遺産パターンの再構成および強化のために提案されたアプローチの概略図。ワークフローには、Miao BatikおよびWikiArtデータセットからのデータセット収集、画像前処理、SegFormer-B2を用いたセマンティックセグメンテーション、Cross-Attention Cultural Feature Fusion Module (CAFFM)を用いた特徴融合、CycleGANを用いたパターン再構成、SPADEを用いた芸術的スタイルの合成、およびセグメンテーションと再構成の指標を用いた最終評価が含まれる。矢印は、フレームワーク全体におけるデータおよび特徴表現の流れを示している。こちらのリンクをクリックして、この図の拡大版を表示してください。
人間社会の集合的記憶と文化的遺産は、無形文化遺産(ICH)に体現されており、これは芸術的表現と文化的アイデンティティのための重要な媒体としての役割を果たしている。しかし、ICHはグローバル化とデジタル化の影響により、大きな課題に直面している2,3,4。熟練した職人の減少や現代市場への適応力の限界により、絶滅の危機にある多くのICHの慣習には、保存と発展のための新たなアプローチが必要とされている5,6。ICH研究の重要な領域であるサステナブルデザインは、文化、社会、環境の統合的な発展を重視しており、ICHを継続的に保存するための実践的な道筋を提供する。サステナブルデザインの手法を通じて、現代社会のニーズに適応させながら、ICHを活性化させることが可能となる7,8。
本研究において、「無形文化遺産パターン」という用語は、潜在的な無形文化価値を伝え、保存する視覚的なモチーフ表現を指します。したがって、提案されたフレームワークは、これらのモチーフの視覚的形態を再構築すると同時に、それらに付随する文化情報を保存および記録することを目的としています。
苗族の刺繍とバティック(ろうけつ染め)は、中国の重要な無形文化遺産(ICH)であり、鳥、蝶、祖先のトーテムなどの象徴的なモチーフを通じて、苗族コミュニティの歴史、信仰、伝統を反映しています9。これらのモチーフは儀礼用の衣服や祭事の慣習に深く組み込まれており、地域の文化的および経済的な発展に寄与しています10,11。デジタル技術、特に人工知能(AI)とディープラーニング(DL)の進歩は、文化遺産の保存、分析、復元、および記録に新たな機会をもたらしました。中国で最も良好に保存されているバティック伝統の一つである貴州苗族のバティックは、苗族の文化的知識、信仰、風習、および儀式を伝承するための重要な媒体となっています12,13,14,15,16。
近年の研究により、文化遺産の保存およびパターンの再構成におけるディープラーニング(DL)の可能性が示されており、U-NetやDeepLabV3+と比較して、セグメンテーション精度(画素精度 = 88.6%、平均IoU [intersection over union] = 78.1%)および再構成性能の向上が達成されている。しかしながら、依然としていくつかの課題が残っている。既存の敵対的生成ネットワーク(GAN)ベースの手法では、複雑なパターンにおける微細な構造的詳細の保持に苦慮することが多い。17、一方で、データセットの多様性の不足が、文化的な領域にわたるモデルの汎化性能を制限している18さらに、CycleGANなどの画像間変換モデルでは、セグメンテーションマップと生成画像との間で意味的な一貫性を維持できない場合があります。19また、アテンションメカニズムが欠如していると、再構成の際に文化的に重要なモチーフの詳細が失われる可能性があります。20したがって、効果的な脳内出血(ICH)パターンの再構成には、トランスフォーマーベースのセグメンテーション、アテンション誘導型特徴学習、およびマルチデータセットトレーニングを統合した高度なフレームワークが必要である。
苗族刺繍のデジタル化と生成AIの急速な進歩により、文化遺産保存のための新たな機会が生まれています。新興の深層生成モデルの一種である拡散モデルは、その強力なコンテンツ生成能力により、コンピュータビジョンタスクにおいて顕著な性能を示しています21,22,23,24,25。逆拡散プロセスを通じて、モデルはノイズを含む表現から元の入力データを徐々に再構成することを学習します26,27,28。また、先行研究では、文化遺産の保存と普及のために、3次元再構成およびコンピュータ支援設計(CAD)技術の適用についても検討されてきました。
畳み込みニューラルネットワーク(CNN)やGANは、画像生成および特徴保持において優れた性能を発揮しますが、受容野の制限、モード崩壊、および学習の不安定性といった課題に依然として直面しています29。SegFormerやSegmenterなどのTransformerベースのアーキテクチャは、グローバルなコンテキストや意味的関係の把握に長けていますが、計算負荷が高く、微細なディテールの再現に苦慮することがあります。Stable Diffusionなどの拡散モデルは強力な画像生成能力を示しますが、生成されるデザインの構造的および芸術的な特性を精密に制御することが困難な場合が多くあります。さらに、既存のアプローチの多くは独立した学習戦略を採用しているため、セグメンテーション成分と生成成分の間で効果的な情報共有や協調的な最適化が行われず、結果として構造的な正確さと芸術的な真正性の間にトレードオフが生じています30。
潜在拡散モデルやStable Diffusionなどの最近の拡散ベースモデルは、高品質な画像合成を実現していますが、反復的なデノイジングが必要であるため、計算コストと推論時間が増大します。さらに、専門的な条件付けメカニズムなしでは、微細な文化的モチーフや構造的な一貫性を維持することが依然として困難です。Transformerベースの生成モデルは、グローバルな文脈関係を効果的に捉えることができますが、多くの場合、大規模なデータセットと膨大な計算リソースを必要とします。対照的に、提案されたSegCycle-Spatially Adaptive Denormalization(SegCycle-SPADE)フレームワークは、SegFormerベースのセグメンテーション、クロスアテンションによる特徴融合、CycleGANによる再構成、およびSPADEガイド付き合成を組み合わせることで、明示的な構造的ガイダンスを提供し、これによりモチーフの保存、意味的な一貫性、および文化遺産パターンの制御可能な再構成を向上させます。
最新のセマンティックセグメンテーション手法の多くは、U字型アーキテクチャを持つ完全畳み込みニューラルネットワーク(FCNN)に依存しています31。エンコードステージでは、一連の畳み込みおよびダウンサンプリング操作を通じて、大きな受容野を持つ深い特徴量が抽出されます。デコードステージでは、アップサンプリングによって空間解像度が段階的に復元され、最終的にピクセルレベルのセマンティック予測が可能になります。スキップ接続は、異なるエンコーダーレベルからの高解像度情報をデコーダーに直接統合することを可能にし、ダウンサンプリング時の空間情報の損失を補い、幅広いアプリケーションにおけるセグメンテーション性能を向上させます32。
近年のGANベース、CNNベース、および拡散ベースの手法は、画像生成や文化遺産の復元において有望な結果を示していますが、意味的な一貫性の維持、微細な構造モチーフの保存、および多様な文化的パターンにわたる再現可能な再構築の確保に苦慮することが多くあります。既存のアプローチの多くは、セグメンテーション、再構築、およびスタイル合成を個別のプロセスとして扱っており、その結果、文化的に重要な要素の喪失や出力の一貫性の欠如を招く可能性があります。この手法上のギャップを埋めるため、本研究では、SegFormerベースの意味的セグメンテーション、新規のCross-Attention Cultural Feature Fusion Module (CAFFM)、CycleGANベースの再構築、およびSPADE誘導型スタイル合成を統合した、統一的なSegCycle-SPADEフレームワークを提案します。構造的なセグメンテーション情報と生成的な特徴学習を明示的に統合することで、提案するフレームワークは、文化的な真正性と芸術的な質の双方を維持しながら、無形文化遺産(ICH)のモチーフについて、より信頼性が高く、意味的に一貫し、かつ再現可能な再構築を可能にします。
本研究では、現在の文化遺産復元アプローチにおける3つの主要な限界を特定した。(i) GANベースの復元手法における微細な構造モチーフの保存不足、(ii) 小規模またはドメイン固有のデータセットによる学習に起因する汎用性の限界、および(iii) 画像間変換フレームワークにおけるセグメンテーション出力と生成画像間の不十分な意味論的一貫性である。さらに、セグメンテーション、復元、およびスタイル合成は一般的に個別のプロセスとして扱われており、復元過程で文化的に重要な要素が失われる原因となっている。提案するSegCycle-SPADEフレームワークは、Transformerベースの意味論的セグメンテーション、クロスアテンション特徴融合、CycleGAN復元、およびSPADEガイド付き芸術的合成を統合的なアーキテクチャ内で組み合わせることにより、これらの限界を解消し、無形文化遺産(ICH)パターンの復元におけるモチーフの保存、意味論的一貫性、および芸術的な真正性を向上させる。
本研究の主な目的は、無形文化遺産(ICH)パターンの意味論的セグメンテーション誘導型芸術的再構成のための、強化されたSegCycle-SPADEフレームワークを開発することである。このフレームワークは、正確な文化的モチーフのセグメンテーションのためのSegFormer、パターン再構成のためのCycleGAN、およびスタイル一貫性のある芸術的合成のためのSPADEを統合している。特徴表現を改善し、微細な構造的詳細を保持するために、セグメンテーション特徴と生成特徴の間の効果的な相互作用を促進するCAFFMを導入した。Miao BatikおよびWikiArtデータセットで学習させた結果、提案したフレームワークは、再構成の真正性、スタイルの一貫性、および文化的に重要なモチーフの保持能力を向上させた。
本研究では、セマンティックセグメンテーション、アテンション誘導型特徴融合、パターン再構成、およびスタイル合成を統一的なアーキテクチャ内で組み合わせることにより、無形文化遺産(ICH)パターンの芸術的再構成のための新しいSegCycle-SPADEフレームワークを提案します。本研究の主な貢献は以下の通りです。第一に、SegFormerを統合することで、新しいセマンティックセグメンテーション誘導型再構成フレームワークを開発し、複雑な文化的モチーフや構造的要素の正確な抽出と保存を可能にしました。第二に、新しいCAFFMを導入し、セグメンテーション特徴と生成表現を効果的に融合させることで、文化的モチーフと芸術的スタイルパターンの間の長距離相関をモデルが捉えられるようにしました。第三に、提案されたCAFFMは、文化的に重要な要素の保存性を高めると同時に、再構成された遺産パターンの視覚的リアリズムと構造的一貫性を向上させます。第四に、文化パターンの再構成にCycleGANを、セグメンテーション誘導型の芸術的合成にSPADEを統合することで、生成された出力におけるセマンティックな正確さとスタイルの真正性の両方を確保しました。第五に、汎用性と芸術的な多様性を向上させるため、文化パターンの学習には苗族 Batik 文化モチーフデータセットを、芸術的スタイルの表現にはWikiArtデータセットを用いてモデルを学習させました。WikiArtは、苗族の文化遺産製品に直接適用するターゲットスタイルとしてではなく、多様な視覚的コンテキストにおけるフレームワークの汎用能力、特徴学習の堅牢性、およびスタイル制御の有効性を評価するための補助データセットとして機能します。最後に、既存のGANベースの文化遺産再構成手法と比較して、提案するSegCycle-SPADEフレームワークがセグメンテーション精度、再構成品質、およびスタイルの整合性の向上を達成したことが実験結果により示されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
提案されたSegCycle-SPADEのフレームワークは、セマンティックセグメンテーション、アテンションによる特徴量強化、生成的再構成、および芸術的スタイル合成を通じて、伝統的な文化遺産のパターンを再構成し改善するように設計されています。本研究では、Miao BatikデータセットおよびWikiArtデータセットを含む、公開されている文化遺産および芸術画像データセットを利用しました。本研究において、ヒトの被験者、患者データ、個人情報、動物被験者、または臨床記録は含まれていないため、機関倫理委員会の承認およびインフォームドコンセントは不要でした。まず、評価にはMiao Batik文化モチーフデータセットとWikiArtデータセットが利用されます。Miao BatikデータセットはQuan et al. (2024)32で記述されており、伝統的な苗族(Miao)のバティックモチーフの注釈付き画像15,148枚が含まれています。データセット作成者によって提供された既存のアノテーションを直接使用し、本研究において追加の手動アノテーションは作成していません。次に、リサイズ、正規化、デノイジング、およびセグメンテーションマスクの作成によって画像の前処理が行われます。正確な前処理パラメータは、「データ前処理」の項で説明しています。提案されたフレームワークでは、データのセマンティックセグメンテーションにSegFormer-B2と呼ばれるTransformerベースのモデルを利用します。この手法は、文化モチーフの主要領域を検出し、その構造を学習するように設計されています。セグメント化された特徴量は、その後アテンションメカニズムを通じて強化され、文化モチーフに関連する重要な情報が強調され、無関係な情報は破棄されます。アテンションメカニズムの設定は、CAFFMの項で説明しています。強化された特徴量はその後CycleGANに渡され、サイクリック学習を通じて損傷した構造が再構成されます。トレーニング中、元のMiao Batik画像にランダムなマスキングおよび部分的遮蔽操作を適用することで、不完全なモチーフサンプルを人工的に作成しました。これらの劣化処理により、劣化した文化遺産 artifacts で一般的に見られるモチーフ領域の欠損や構造的損傷をシミュレートしました。得られた不完全な画像はCycleGAN再構成モジュールの入力として使用され、対応する元の画像が再構成ターゲットとして機能しました。再構成された文化遺産パターンは、その後SPADEを通じて強化され、生成されたセグメンテーションマップに基づいて芸術的な強化が行われます。提案されたフレームワークの性能は、定量的なセグメンテーションおよび画像品質指標を用いて評価され、再構成された文化モチーフの視覚的な真正性は定性的に評価されました。視覚的な真正性は、生成された文化パターンの目視検査を通じて評価され、独立した定量的な指標としては使用されませんでした。評価は、対応する参照文化モチーフに対するモチーフの保存、意味的一貫性、文化的特性、構造的コヒーレンス、および芸術的な外観に重点を置きました。モデル性能の定量評価は、Segmentation Accuracy、IoU、Dice Coefficient、Structural Similarity Index Measure (SSIM)、Peak Signal-to-Noise Ratio (PSNR)、およびFréchet Inception Distance (FID) を用いて行われました。図2に、提案されたSegCycle-SPADEフレームワークの全体的なワークフローを示し、本研究で使用した評価指標をまとめています。
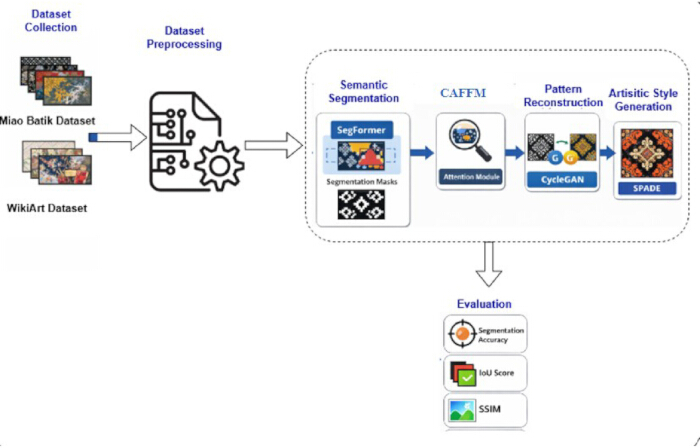
図 2. 提案するSegCycle-SPADEフレームワークの全体的なアーキテクチャワークフロー。SegCycle-SPADEワークフロー全体の概要。Miao BatikおよびWikiArtデータセットの画像は前処理が行われた後、SegFormer-B2を用いたセマンティックセグメンテーション、CAFFMを用いた特徴量強化、CycleGANを用いたパターンの再構成、およびSPADEを用いた芸術的スタイルの生成へと処理される。モデルの性能は、Segmentation Accuracy、Intersection over Union (IoU)、Dice Coefficient、Structural Similarity Index Measure (SSIM)、PSNR、Fréchet Inception Distance (FID)を用いて評価され、視覚的な真正性は定性的に評価される。こちらをクリックして、この図の拡大版を表示してください。
文化遺産のパターン再構成のためのSegCycle-SPADEフレームワークは、図2に示すように、正確なモチーフのセグメンテーション、再構成、および芸術的強化のために、複数の深層学習(DL)コンポーネントを統合するように設計されています。多様な文化パターンと芸術的スタイルを提供するために、Miao Batik文化モチーフデータセットとWikiArtデータセットの画像が使用されます。まず、SegFormerベースのセマンティックセグメンテーションモジュールを用いて画像を処理し、背景から文化モチーフを特定し、輪郭を抽出します。全体のアーキテクチャは4つの主要なステージで構成されています。第一に、SegFormerモデルが文化パターン画像からセマンティックセグメンテーションマップを抽出します。第二に、CAFFMがセグメンテーション特徴と生成表現を統合し、特徴学習を強化します。第三に、CycleGANモジュールが融合された特徴表現を用いて文化パターンを再構成します。最後に、SPADEモジュールが、セグメンテーション誘導合成を通じて構造的な整合性を維持しながら、スタイル的に強化された出力を生成します。洗練された特徴マップは、その後CycleGAN再構成モジュールによって処理され、劣化させたパターンを対応する完全な形式にマッピングすることで、不完全な文化モチーフを復元することを学習します。不完全なモチーフサンプルは、元のMiao Batik画像にランダムなマスキングおよび部分的遮蔽操作を適用することで生成され、これにより、損傷した文化遺物に一般的に見られるパターンの欠損領域や構造的劣化をシミュレートしました。各劣化画像は、トレーニング中の再構成ターゲットとして機能する対応する元画像とペアにされました。この戦略により、CycleGANモジュールは、セマンティックな整合性と文化的に重要な特性を維持しながら、欠損したモチーフ構造の復元を学習することが可能になりました。最終的に、SPADEジェネレーターは、生成されたセグメンテーションマップに基づいて画像合成を行うことで、視覚的に強化された芸術的な出力を生成し、これにより芸術的強化プロセス全体を通じて文化モチーフの構造的完全性が維持されます。
提案されたSegCycle-SPADEフレームワークには、以下のステップが含まれます。
ステップ 1:データセットの収集
文化的パターンの学習と芸術的スタイルの生成という目的を達成するために、2つのデータセットを使用した。伝統的な文化的パターンの情報を提供するために、Miao Batik Cultural Motif Datasetを使用した。このデータセットはZenodo (https://doi.org/10.5281/zenodo.20807658) を通じて公開されており、アノテーション済みの伝統的なミャオ族ろうけつ染めモチーフの画像15,148枚が含まれている。データセット作成者によって提供された既存のアノテーションをそのまま使用し、本研究において追加の手動アノテーションは行わなかった。また、芸術的スタイル生成のための多様な芸術的スタイルの情報を提供するためにWikiArtデータセットを使用し、これを公開リポジトリであるWikiArt (https://www.wikiart.org/) から取得した。
ステップ 2:データの前処理
すべての画像に対し、リサイズ、正規化、およびノイズ除去による前処理を行った。セマンティックセグメンテーションの段階をサポートするため、元のデータセットソースから得られた既存の文化的モチーフのアノテーションを使用した。本研究の一環として、追加のアノテーションやラベルの付け直しは行わなかった。
ステップ 3:SegFormerを用いた意味論的パターンセグメンテーション
文化的なモチーフのセグメンテーションには、SegFormerモデルを使用した。SegFormerの具体的なバックボーンおよび初期化戦略については、以下に述べる。 SegFormerを用いたセマンティックパターンセグメンテーション サブセクション。具体的には、セマンティック・モチーフ・セグメンテーションのために、ImageNetで事前学習済みのMIT-B2バックボーンを持つSegFormer-B2アーキテクチャを採用した。このモデルは、伝統的な文化パターンの複雑な構造的詳細を維持しつつ、グローバルなコンテキスト情報を効果的に抽出することができる。
ステップ 4:CAFFM
CAFFMは、意味論的セグメンテーションの特徴と生成的表現を組み合わせることで、フレームワークが構造的モチーフの特性と芸術的スタイルの情報の両方を学習することを可能にします。CAFFMの統合に関する詳細は、CAFFMのサブセクションで説明します。このモジュールは、SegFormerベースの意味論的セグメンテーション段階と生成的再構成段階の間に配置され、マルチヘッド・クロスアテンションを通じて、セグメンテーション由来の構造的特徴と再構成特徴を融合させます。このプロセスにより、文化的モチーフの保存性が向上し、再構成された出力のリアリズムが高まります。
ステップ5:パターン再構成(CycleGAN)
融合された特徴は、その後CycleGANモジュールによって処理され、文化的なパターン構造が再構成されます。CycleGANのアーキテクチャおよび学習設定については、以下で説明します。 CycleGANを用いたパターンの再構成 サブセクション。再構成モジュールは2つのジェネレータと2つのディスクリミネータで構成されており、9つのレジデュアルブロックを備えたレジデュアルネットワーク・ジェネレータアーキテクチャを採用し、PatchGANディスクリミネータを使用し、敵対的損失およびサイクル整合性損失を用いて学習されています。この構成により、双方向のドメインマッピングが可能となり、不完全な文化パターン構造の再構成が促進されます。
ステップ6:芸術的スタイルの生成(SPADE)
その後、再構成されたパターンをSPADEモジュールで処理し、セグメンテーション誘導型の芸術的スタイル合成を行います。SPADEジェネレーターの構成については、以下に記述します。 SPADEを用いた芸術的スタイルの生成 サブセクション。本モジュールは、SPADE残差ブロック、空間適応型正規化層、およびSegFormerセグメンテーションマップとCAFFM特徴表現から導出された意味的条件付けを採用している。画像生成をセグメンテーションマップに基づいて条件付けることで、合成された出力は、芸術的なスタイルの特性を取り入れつつ、元の文化的モチーフとの構造的な整合性を維持している。
ステップ 7:性能評価
提案されたフレームワークは、セグメンテーション精度、IoU、Dice係数(Dice)、SSIM、PSNR、およびFIDを含む、複数のセグメンテーションおよび画質評価指標を用いて評価されました。実験の一貫性を評価するため、すべての実験を異なる乱数シードを用いて5回繰り返し、結果を平均値 ± 標準偏差として報告しています。統計的有意性は対応のあるt検定を用いて評価し、有意水準はp < 0.05としました。
データセットの収集
提案するSegCycle-SPADEのフレームワークでは、文化的なパターンの理解とスタイルの学習のために2つのデータセットが採用されています。本フレームワークで用いられる1つ目のデータセットは、苗族(Miao) Batikの文化的モチーフデータセットです。このデータセットには、苗族の芸術に用いられる動物、植物、幾何学図形などのモチーフを含む伝統的な苗族 Batikの画像が含まれています。このデータセットには豊かなテクスチャ情報を持つ画像が含まれており、これらは一般に文化遺産の保存にとって重要です。SegCycle-SPADEのフレームワークで用いられる2つ目のデータセットは、WikiArtデータセットです。このデータセットには、一般的に異なるスタイルに分類される膨大な数の芸術作品が含まれています。このデータセットは、芸術作品の強化に有用な複雑なスタイルの学習に用いられます。本データセットにはHD画質の芸術作品が80,000点含まれており、27種類の異なるデザインがあるため、DL(ディープラーニング)ベースのスタイル生成や変換タスクに非常に有用です。
苗族バティックデータセット:
苗族バティックデータセット(https://doi.org/10.5281/zenodo.20807658)は、文化的に重要なモチーフを描いたバティックパターンの画像15,148枚で構成されています。これらの画像には、動物モチーフ(例:蝶や魚)、植物ベースのパターン、文化的な象徴性を持つ幾何学モチーフなど、さまざまな伝統的なデザインが含まれています。このデータセットは、パターンの再構成中にセグメンテーションモジュールがモチーフの境界を正確に特定し、維持することを可能にする真正な文化的構造を提供するため、提案されたフレームワークの重要な構成要素となります(表1)。本研究において、文化的に重要なモチーフとは、苗族の文化遺産に関する文献で一般的に記録され、データセットのアノテーション内で表現されている象徴的な視覚要素(鳥、蝶、花柄、祖先のトーテムなど)を指します。これらのモチーフは、単に出現頻度や空間構成に基づくのではなく、記録された文化的な重要性と、伝統的な苗族のバティックおよび刺繍デザインにおける繰り返し現れる特性に基づいて選定されました。専門家の指導によるモチーフのアノテーションおよびセグメンテーションラベルは、元の苗族バティックデータセットのソースから取得し、本研究で直接使用しました。著者による追加の手動アノテーション、ラベルの再割り当て、または専門家指導によるアノテーション手順は行っていません。データセット作成者によって提供された既存のアノテーションを、セマンティックセグメンテーションの学習および評価に利用しました。
| パラメータ | 概要 |
| データセット名 | 苗族バティック文化文様データセット |
| データセットソース | Zenodoリポジトリ (DOI: 10.5281/zenodo.20807658) |
| ドメイン | 無形文化遺産 (ICH) / テキスタイル文様解析 |
| 総画像数 | 15,148枚の画像 |
| 画像タイプ | 伝統的な苗族バティックテキスタイルパターンのデジタル画像 |
| パターンのカテゴリー | 動物モチーフ、植物モチーフ、および幾何学モチーフ |
| 文化的背景 | 中国貴州省の苗族文化 |
| 元の画像解像度 | 前処理前に、RAWスキャンまたは写真として撮影された高解像度画像(通常、短辺が1,000ピクセル以上) |
| トレーニング解像度 | 前処理において、画像を256 × 256ピクセルにリサイズした。 |
| アノテーションの利用可能性 | データセット作成者によって提供された既存のセグメンテーションアノテーションを、変更せずにトレーニングおよび評価に使用した。本研究において、追加の手動アノテーション、リラベリング、または専門家による確認手順は行われていない。 |
| 本研究における応用 | 文化的モチーフのセグメンテーション、特徴抽出、モチーフ保持、およびパターンの再構築 |
表1:苗族バティック文化パターンデータセットの特性。セマンティックセグメンテーション、文化パターン分析、およびモチーフ再構成に使用された苗族バティック文化モチーフデータセットの概要。この表では、データセットの出典、画像特性、モチーフカテゴリー、文化的起源、画像解像度、および提案されたSegCycle-SPADEフレームワークにおける役割について記述している。
WikiArtデータセット:
WikiArtデータセット [https://www.wikiart.org/] は、Table 2 に示す27種類の異なる芸術スタイルからなる80,000枚以上の画像を包含する、広く利用されている大規模なデジタルアートリポジトリである。これらのスタイルには、ルネサンス美術、印象派、キュビスム、シュルレアリスムなどが含まれる。本データセットは、セグメンテーションプロセスから得られた構造情報を維持しつつ、SPADEモジュールが文化的に豊かなパターンを生成することを可能にする知識を提供するため、提案されたフレームワークにおいて非常に重要である。本データセットは、学習用に56,000枚、検証およびテスト用に12,000枚の画像で構成されている。データセット内の画像は、DLモデルの効果的なトレーニングに寄与する。
| パラメーター | 概要 |
| データセット名 | WikiArtデータセット |
| データセットソース | WikiArtリポジトリ (https://www.wikiart.org/) |
| ドメイン | デジタルアートおよび絵画 |
| 総画像数 | 約80,000点の美術品 |
| トレーニング画像 | 56,000 |
| 検証画像 | 12,000 |
| テスト画像 | 12,000 |
| 芸術様式 | ルネサンス、印象派、キュビスム、シュルレアリスム、表現主義、写実主義、抽象芸術を含む27の芸術様式 |
| 元の画像解像度 | 元の画像の解像度は、作品やソースによって異なります。前処理において、画像は256 × 256ピクセルの一定の解像度にリサイズされました。 |
| トレーニング解像度 | 芸術的スタイルの学習およびセグメンテーション誘導画像合成に先立つ前処理において、画像を256 × 256ピクセルにリサイズした。 |
| データセットの分割 | 固定乱数シード42を用いた層化ランダム分割(トレーニング用70%、検証用15%、テスト用15%) |
| スタイルサンプリング戦略 | トレーニング、検証、およびテストのサブセットにおいて27の芸術スタイルの分布を維持するため、層化比例抽出法を採用した。 |
| 本研究における応用 | 芸術的スタイルの学習、スタイルの表現、およびセグメンテーション誘導型芸術的合成 |
表2:WikiArtデータセットの特性。芸術的なスタイルの学習およびスタイルガイド付き画像合成に使用されたWikiArtデータセットの概要。本表では、データセットのソース、画像の分布、芸術スタイルの網羅範囲、データセットの分割、画像解像度、および提案されたSegCycle-SPADEフレームワーク内での適用について記述する。
Miao Batikデータセットには、苗族の伝統的な文化的モチーフを表す15,148枚の画像が含まれています。32 このデータセットはZenodo (https://doi.org/10.5281/zenodo.20807658) を通じて公開されています。モデルのトレーニングに先立ち、すべての画像を視覚的に検査し、256 × 256 pixelsにリサイズおよび正規化を行い、破損したサンプルや重複したサンプルのスクリーニングを実施しました。品質管理スクリーニングの結果、除外された画像はなく、したがって15,148枚のすべての画像がその後の解析に使用されました。データセットの分割の再現性を確保するため、固定ランダムシード42を用いて、データセットをトレーニング用(70%)、検証用(15%)、およびテスト用(15%)のサブセットにランダムに分割しました。WikiArtデータセットは公式のWikiArtリポジトリ (https://www.wikiart.org/) から取得し、27の芸術スタイルにわたる80,000点以上の芸術作品が含まれています。スタイル学習の実験では、トレーニングに56,000枚、検証に12,000枚、テストに12,000枚の画像を使用しました。
データの前処理
提案されたSegCycle-SPADEフレームワークの学習前に、一貫した画像品質と正確な特徴表現を確保するため、苗族 batik 文化モチーフデータセットおよびWikiArtデータセットに対していくつかの前処理ステップを実施した。ガウスデノイジング、正規化、一定の入力解像度へのリサイズ、および画像品質の検証を含む同一の基本的な前処理パイプラインを両方のデータセットに適用した。ただし、フレームワーク内における各データセットの役割は異なっていた。WikiArtデータセットは芸術的スタイルの学習と合成に使用され、一方で苗族 batik データセットは主に文化モチーフのセグメンテーションと再構成に使用された。これらのタスク固有の役割以外に、データセット固有の前処理の変更は行わなかった。DLモデルによる一貫した処理を確実にするため、まず画像を固定解像度にリサイズした。このステップは、両データセットの画像がソースによって解像度が異なっていたため必要であった。リサイズにより計算効率が向上し、次元の不整合が学習に影響を与えることを防いだ。2番目の前処理ステップは正規化であり、学習中の勾配更新を安定させるためにピクセル値を標準化された範囲にスケーリングした。その後、文化モチーフの構造を妨げる可能性のあるノイズを低減させるため、ガウスフィルタリングを用いて画像を処理した。苗族 batik データセットについては、元のデータセットソースから直接得られた既存の文化モチーフセグメンテーションマスクを、セマンティックセグメンテーションの学習および評価のために修正なしで使用した。本研究のために特異的に新しいセグメンテーションマスクを作成することはなかった。
特に断りのない限り、確立された手法を記述する方程式は先行研究から引用して改変しており、適宜出典を明記している。提案するCAFFMおよび複合的なSegCycle-SPADE最適化フレームワークを記述する方程式は、本研究のために著者らが開発したものである。
データセットからの入力画像を式1で表します:
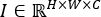 (1)
ここで、H、W、およびCはそれぞれ画像の高さ、幅、およびカラーチャンネル数を表します。すべての画像は、式 2に示すように、固定次元H′ × W′にリサイズされます:
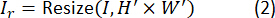
ここで、Irはリサイズ後の画像です。正規化された画素値は、式 3に従って計算されます:
 (3)
これにより、学習手順の安定化が図られます。ノイズフィルタリングは、図に示すようにガウスフィルタを用いて行います。 式4:
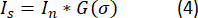
ここで、G(σ)はガウスフィルター、*は畳み込みを表します。標準偏差σ = 1.0の5 × 5カーネルガウスフィルターを使用しました。エッジアーティファクトを低減するため、境界ピクセルにはリフレクティブパディングを適用しました。ノイズ除去プロセスは、スケーリングおよび正規化の前に、画像の読み込み直後に実行されました。研究全体で前処理を統一するため、Miao BatikおよびWikiArtデータセットのすべての画像に同一のフィルター設定を適用しました。Miao Batikデータセットにおいて、セグメンテーションマスクは式5に従って作成されます:

ここで、MはSegFormerモデルを誘導するために使用されるセグメンテーションマスクです。
前処理パイプラインは、図3に示すように、Miao BatikデータセットおよびWikiArtデータセットからの画像取得から始まります。トレーニングにおいてデータ拡張の手法は採用していません。リサイズ、正規化、ガウスデノイジング、およびセグメンテーションマスクの作成を含む前処理の後、画像は提案するSegCycle-SPADEフレームワークのトレーニング、検証、およびテストに直接使用されました。前処理パイプラインの最初のステップでは、画像を固定サイズにリサイズし、DLモデルがより効率的に画像を処理できるようにします。2番目のステップでは正規化を行い、ピクセル値を標準化された数値範囲に変換してモデルの収束を促進します。3番目のステップではノイズ除去を行い、不要なノイズを取り除いてパターン認識を向上させます。加えて、Miao Batikデータセットについては、文化的なモチーフ領域をアノテーションし、提案モデルのセグメンテーションモジュールで使用するマスクを生成することで、生成過程において文化的モチーフが保持されるようにしています。この段階の最終的な出力は、提案モデルのセグメンテーションおよび生成モジュールのトレーニングに使用可能な、クリーンなデータセットとなります。
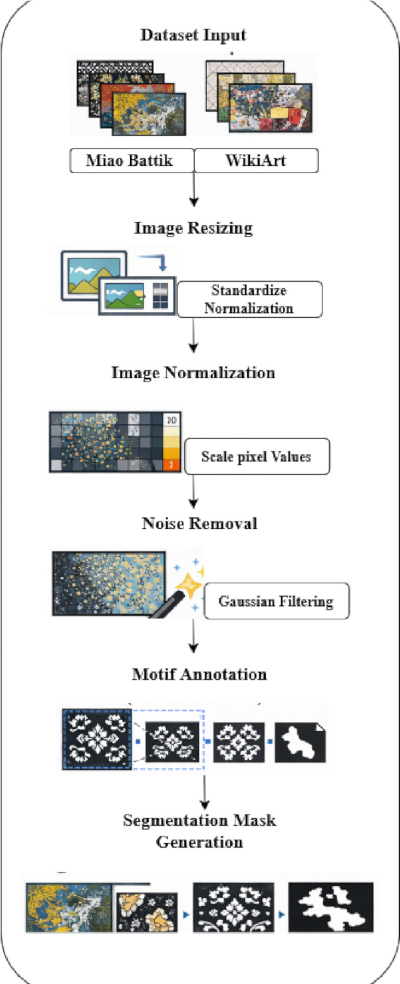
図 3. 文化遺産画像のデータ前処理パイプライン。モデル学習前に適用される画像前処理手順を示すワークフロー。このパイプラインには、データセットの取得、画像のリサイズ、正規化、ガウスノイズ除去、既存の文化的モチーフのアノテーション、およびセグメンテーションマスクの作成が含まれる。処理後の画像とマスクは、セマンティックセグメンテーションおよびパターン再構成の入力として使用される。こちらのリンクをクリックして、この図の拡大版を表示してください。
モデルのトレーニング前に、すべての画像に対して品質管理プロセスを実施した。Miao Batikデータセットには15,148枚の画像が含まれていた。破損したサンプル、重複サンプル、および低品質なサンプルについては、元のデータセット作成者によって既に対処されていたため、本研究の品質管理スクリーニングにおいて追加で除外された画像はなかった。その結果、15,148枚すべての画像が解析に使用された。前処理において、画像はRGB形式で読み込まれ、バイリニア補間を用いて256 × 256ピクセルにリサイズされた。ピクセル値は255で除算することにより、[0, 255]の範囲から[0, 1]の範囲にスケーリングされた。その後、赤、緑、青の各チャンネルに対して、それぞれ[0.485, 0.456, 0.406]の平均値と[0.229, 0.224, 0.225]の標準偏差値を用いて、チャンネルごとの正規化を適用した。前処理パイプラインには、画像の読み込み、RGB変換、リサイズ、ピクセル値のスケーリング、正規化、およびテンソル変換が含まれていた。必要に応じて、DLモデルとの互換性を維持するために、グレースケール画像を3チャンネルのRGB形式に変換した。前処理後、画像はトレーニング、検証、およびテストのサブセットに分割された。セマンティックセグメンテーション、特徴融合、モチーフ再構成、およびSPADEベースの芸術的合成を含むSegCycle-SPADEフレームワークのすべてのステージにおいて、256 × 256ピクセルの一定の入力解像度を使用した。
SegFormerを用いた意味論的パターンセグメンテーション
この前処理ステップの後、クリーニングおよび正規化された苗族バティック文化モチーフデータセットおよびWikiArtデータセットの画像が、提案されたSegFormer-B2のフレームワークに基づく意味論的セグメンテーションモジュールに供給されます。このステップの目的は、伝統的な文様に存在する文化モチーフを正しく特定し、分離することです。提案されたSegFormerのフレームワークは、階層的Transformerエンコーダーと軽量なMLPデコーダーを組み込んだTransformerアーキテクチャに基づいており、複雑な伝統的文様からグローバルなコンテキスト情報と詳細な構造情報の両方を正確に捉えます。モデルはまず、入力画像から複数のスケールで特徴表現を抽出し、続いてデコーダーを通じてこれらの表現を融合させることで、正確なセグメンテーションパターンを生成します。これにより、伝統的な画像内のパターンが、幾何学模様、花模様、象徴的模様などのモチーフに正しくセグメンテーションされ、構造的な完全性を維持したまま背景から分離されます。この構造情報は、その後のSegCycle-SPADEフレームワーク内でのパターン生成段階で使用されます。
前処理済みの入力画像を次のように表す。 式 6:
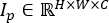 (6)
SegFormerエンコーダーは、画像をパッチに分割し、式71に示すように、トランスフォーマー層を用いて階層的な特徴を抽出します。
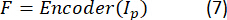
ここで、Fはトランスフォーマーエンコーダーから得られたマルチスケール特徴マップを表します。これらの特徴は、モチーフ領域における局所的なテクスチャパターンと大域的な文脈関係の両方を符号化しています。SegFormerモデルは、式 8で定義されるように、異なるスケールの特徴マップを抽出します。
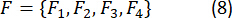
マルチスケール表現を用いることで、文化的なモチーフ内にある異なるサイズのパターンの検出が容易になります。最終的に、これらの特徴は、以下に示すMLPデコーダーを用いて統合されます。 式91:
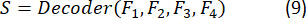
ここで、Sは最終的に予測されたセグメンテーションマップを表します。
SegFormer-B2バックボーンは、ImageNetで事前学習させた重みを使用して初期化し、その後、文化的なモチーフのセグメンテーションを行うためにMiao Batikデータセットでファインチューニングしました。事前学習済みのチェックポイントは、公式のSegFormer実装から取得しました。具体的には、ファインチューニングの前に、公式のSegFormerリポジトリから提供されたImageNet-1K事前学習済みMIT-B2チェックポイント(mit_b2.pth)を使用してSegFormer-B2バックボーンを初期化しました。この事前学習済み重みは、SegFormerの著者らによって公開されたMIT-B2バックボーンに対応しており、セマンティックセグメンテーション学習の初期化モデルとして機能しました。その他のタスク固有のレイヤーは、学習前にPyTorchのデフォルトの重み初期化手順を用いて初期化しました。
アーキテクチャには、オーバーラップパッチ埋め込みを備えた4ステージの階層的Transformerエンコーダが採用されています。初期ステージでは、パッチサイズを7 × 7、ストライドを4に設定しました。4つのエンコーダステージにおける埋め込み次元は、それぞれ64、128、320、512でした。これら4つのステージにおけるマルチヘッド自己アテンションヘッド数は1、2、5、8であり、対応するエンコーダの深さは3、4、6、3レイヤーでした。エンコーダから抽出されたマルチスケール特徴量は、軽量なall-MLPデコーダを用いて集約されました。最終的なセグメンテーションマップを作成する前に、デコーダはすべてのエンコーダステージからの特徴量を単一の埋め込み空間に投影しました。すべてのTransformerブロックでは、活性化関数としてGaussian Error Linear Unit (GELU)を使用しました。汎化性能の向上と過学習の抑制のため、トレーニング中には0.1のドロップアウト率を適用しました。
トレーニングフェーズにおいて、SegFormerフレームワークは両方のデータセットから前処理済みの画像を受け取ります。Miao Batikデータセットの画像には、セグメンテーションモデルの教師あり学習のためのラベルとして機能するモチーフ領域が含まれています。Transformerエンコーダは画像全体を処理し、画像構成要素間の長距離相関を捉えます。これは、空間的に分散したモチーフを含む伝統的なバティックパターンにおいて特に重要です。階層的特徴抽出メカニズムは、繰り返される幾何学的なテクスチャなどの局所的な構造を同時に捉えます。MLPデコーダは、これらの抽出された特徴を処理し、モチーフ領域を強調したセグメンテーションマスクを生成します。この段階で生成されたセグメンテーションマップは、その後、アテンションモジュールおよびパターン再構成段階への構造的入力として使用され、これにより生成されるパターンの真正性の維持に寄与します。
文化的モチーフは、その視覚的および文化的特性に基づいて、セマンティックセグメンテーションのために異なるクラスに分類されました。セグメンテーションのタクソノミーは、動物モチーフ(例:蝶、魚、鳥、およびその他の象徴的な動物相)、植物モチーフ(例:花、葉、蔓、および植物パターンの文様)、幾何学モチーフ(例:反復形状、縁取り、および抽象的な幾何学構造)、およびモチーフ以外の領域を表す背景領域で構成されました。各ピクセルを定義済みのクラスのいずれかに割り当てるために、ピクセルレベルのセグメンテーションマスクが使用されました。整数ラベルは次のようにエンコードされました:ラベル 0 = 背景、ラベル 1 = 動物モチーフ、ラベル 2 = 植物モチーフ、ラベル 3 = 幾何学モチーフ。セグメンテーションアノテーションおよびモチーフラベルは、元の苗族バティック(Miao Batik)データセットソースから直接取得しました。本研究では、追加の手動アノテーション、ラベルの再割り当て、境界の検証、または専門家による確認手順は行っていません。データセット作成者によって提供された既存のアノテーションを、変更せずにトレーニングおよび評価に使用しました。
文化モチーフセグメンテーションのためのSegFormerモデルは、図4に示すように、Miao BatikデータセットおよびWikiArtデータセットから得られた前処理済み画像をトランスフォーマーベースのメカニズムを用いて処理し、文化的なパターン領域を正確に検出します。まず、伝統的な文化モチーフを含む入力画像がSegFormerモデルに提供されます。Transformerエンコーダーが、画像パッチからグローバルなコンテキスト情報とローカルな構造的特徴の両方を抽出します。得られたマルチスケール特徴はセグメンテーションデコーダーに提供され、そこではMix Feed-Forward Networkを利用して特徴表現を精緻化し、モチーフ検出精度を向上させます。SegFormerモデルの出力はセグメンテーションマスクであり、無関係な背景情報を抑制しつつ、文化的パターンに対応するピクセルを強調します。こうして分離された文化パターンは、その後のSegCycle-SPADEフレームワークの段階における構造的なガイダンスとして機能します。
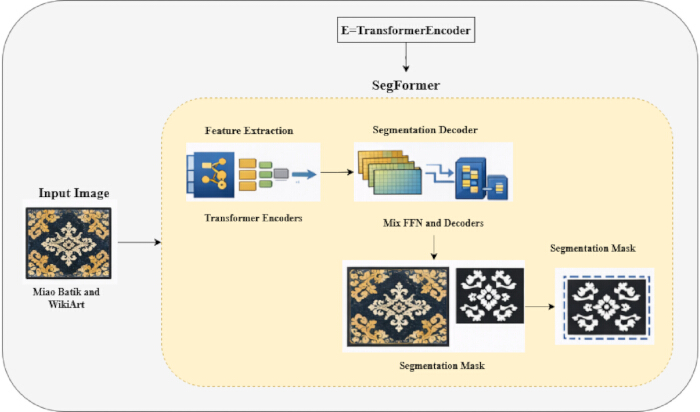
図4SegFormer-B2を用いた文化的モチーフのセマンティックセグメンテーション 文化的なモチーフ抽出に使用され、Miao Batikデータセットのみで学習させたSegFormer-B2セマンティックセグメンテーションモジュールのアーキテクチャ。このフレームワークは、マルチスケール特徴抽出のためのTransformerベースのエンコーダーと、モチーフマスクを生成するための軽量なセグメンテーションデコーダーで構成されている。本モデルは、「動物」「植物」「幾何学模様」「背景」の4つのセマンティッククラスを予測し、得られたセグメンテーションマスクによって、無関係な背景情報を抑制しつつ、文化的に重要なモチーフ領域を特定する。これらのセグメンテーション出力は、提案するSegCycle-SPADEフレームワークの後続ステージである特徴融合、再構成、および芸術的合成のための構造的なガイダンスを提供する。 こちらの図の拡大版を表示するには、ここをクリックしてください。
提案されたフレームワークでは、新しいセグメンテーションアノテーションを作成する必要はありません。Miao Batikデータセットは、既存の公開ソースから取得されており、モデルの学習にはデータセット作成者が提供した関連モチーフ情報が使用されました。学習プロセスを通じて、SegFormerモデルがセマンティックセグメンテーションマップを生成しました。その結果、本研究では追加の手動アノテーションソフトウェア、アノテーションガイドライン、またはアノテーションの品質管理手順を必要としませんでした。
CAFFM
セマンティックセグメンテーションの特徴と生成的な再構成の表現との間の相互作用を改善するため、本研究ではCAFFMも提案した。SegFormer-B2エンコーダーがCAFFMモジュールにセマンティック特徴マップを提供し、CycleGANの再構成ステップが生成的特徴マップを提供する。まず、線形投影層を用いて、両方の特徴ストリームを共通の埋め込み空間に投影する。クロスアテンション計算のために、生成された特徴テンソルを用いてクエリ(Q)、キー(K)、およびバリュー(V)の表現を作成する。次に、マルチヘッドクロスアテンションを用いて、構造的モチーフ情報と芸術的スタイル要素との間の関係をモデル化する。その後、融合された特徴表現に対して、レイヤー正規化、残差接続、およびGELU活性化関数を用いたフィードフォワード層を適用する。SPADEベースの合成ステージがCAFFMモジュールの出力を受け取ることで、芸術的な一貫性を損なうことなく、文化的に意味のあるテーマを保持することが可能となる。
特徴量の互換性を保証するため、まず入力特徴量を線形投影層を用いて、埋め込み次元256の共有埋め込み空間に投影します。次に、意味的な構造情報と生成的なスタイルの表現との相互接続を、8つのアテンションヘッドを持つマルチヘッド・クロスアテンション(MultiHead Cross-Attention)メカニズムを用いてモデル化します。クロスアテンションの計算には、特定の線形変換層によって生成されるクエリ(Q)、キー(K)、バリュー(V)ベクトルを使用します。学習の安定性を高め、特徴量の整合性を維持するために、残差接続とレイヤー正規化(Layer Normalization)を採用し、融合された特徴表現をさらに強化します。その後、ガウス誤差線形ユニット(GELU)活性化関数を備えたフィードフォワードネットワークを適用し、非線形特徴学習を改善します。このモジュールによって次元256の出力特徴表現が生成され、創造的な合成のために他のステージに送られます。CAFFMは、クロスアテンションベースの融合手法を用いることで、芸術的なスタイルデータと文化的モチーフ構造を正常に組み合わせることができ、これにより再構成された文化遺産パターンのモチーフ保持能と視覚的な一貫性が向上します。
提案されたシステムにおいて、構造的特徴はMiao Batikデータセットから導出され、スタイル的特徴はWikiArtデータセットから学習されます。Miao Batikデータセットの画像を用いてSegFormerセグメンテーションネットワークから導出した特徴マップをFs、WikiArtの画像を用いてスタイル特徴抽出ブランチから導出した特徴マップをFaと定義します。提案するCAFFMは、クロスアテンションメカニズムを用いてこれら2つの特徴ドメインを結合し、文化的なパターンの構造的およびスタイル的な依存関係の両方を学習します。表3に、埋め込み次元、正規化レイヤー、活性化関数、アテンションヘッドの構成を含むすべてのアーキテクチャ特性を示します。入力画像サイズが256 × 256ピクセルの場合、SegFormer-B2エンコーダーは64 × 64 × 128サイズのセマンティック特徴マップを生成し、スタイル特徴抽出ブランチは64 × 64 × 128サイズの特徴マップを生成しました。両方の特徴マップは、クロスアテンション融合の前に、学習可能な線形レイヤーを通じて次元256の共有埋め込み空間に投影されました。
| パラメータ | 構成 |
| 提案フレームワーク | SegCycle-SPADE |
| セマンティックセグメンテーションモデル | SegFormer-B2 |
| SegFormerエンコーダステージ数 | 4 |
| 重みの初期化 | ImageNet-1K学習済みSegFormer-B2 (MIT-B2バックボーン) |
| チェックポイントソース | 公式NVIDIA SegFormerリポジトリ (https://github.com/NVlabs/SegFormer); チェックポイント: segformer.b2.512x512.ade.160k |
| ファインチューニング戦略 | Miao Batikデータセットを用いたエンドツーエンドのファインチューニング |
| パッチ埋め込みサイズ | 7 × 7 |
| パッチストライド | 4 |
| 埋め込み次元 | 64, 128, 320, および 512 |
| エンコーダ深度 | 3, 4, 6, および 3 |
| アテンションヘッド数 | 1, 2, 5, および 8 |
| デコーダタイプ | All-MLPデコーダ |
| 活性化関数 | GELU |
| ドロップアウト率 | 0.1 |
| 特徴量強化モジュール | クロスアテンション文化特徴量融合モジュール (CAFFM) |
| CAFFM埋め込み次元 | 256 |
| CAFFMアテンションヘッド数 | 8 |
| CAFFM融合スケール | 4 |
| 再構成モデル | CycleGAN |
| スタイル生成モデル | SPADE |
| 文化データセット | Miao Batikデータセット |
| スタイルデータセット | WikiArtデータセット |
| Miao Batik画像数 | 15,148 |
| WikiArt画像数 | 約 80,000 |
| 入力画像解像度 | 256 × 256 pixels |
| カラーフォーマット | RGB |
| 補間手法 | バイリニア補間 |
| ノイズ除去手法 | ガウスフィルタリング |
| ガウスカーネルサイズ | 5 × 5 |
| ガウスシグマ (σ) | 1 |
| 正規化範囲 | [0, 1] |
| バッチサイズ | 16 |
| エポック数 | 100 |
| オプティマイザ | Adam |
| 学習率 | 0.0002 |
| Adamパラメータ | β₁ = 0.5, β₂ = 0.999, ε = 1 × 10⁻⁸, weight decay = 0 |
| 損失関数 | セグメンテーション損失、敵対的損失、サイクル一貫性損失、再構成損失、モチーフ保存損失、およびスタイル一貫性損失 |
| データセット分割戦略 | トレーニング / バリデーション / テスト |
| トレーニングセット | 70% |
| バリデーションセット | 15% |
| テストセット | 15% |
| 乱数シード | 42 |
| 評価指標 | セグメンテーション精度、IoU、Dice係数、SSIM、PSNR、およびFID |
| プログラミング言語 | Python 3.8.10 |
| ディープラーニングフレームワーク | PyTorch 1.10.0 |
| ハードウェアプラットフォーム | NVIDIA RTX 3090 GPU (24 GB VRAM), Intel Core i7 (第11世代), 32 GB RAM |
| 動作環境 | Ubuntu 20.04 LTS |
表3:実験設定およびモデル構成。提案されたSegCycle-SPADEフレームワークの実装および評価に使用した、アーキテクチャ構成要素、学習設定、前処理設定、データセット、最適化パラメータ、評価指標、および計算環境の概要。
アテンションモジュールは、まず、以下を用いて特徴マップをクエリ、キー、およびバリューの表現にマッピングします。 式10:
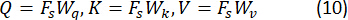
ここでは、 Wq, Wk、および Wv は学習可能な重み行列です。アテンション重みは、クエリベクトルとキーベクトルの類似性に基づいて、以下を用いて計算されます。 式1117:
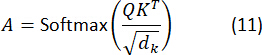
ここでは、 dk はキーベクトルの次元数です。強化された特徴表現は、アテンション重みとバリュー行列を次のように乗算することによって算出されます。 式 12:
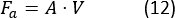
ここで、Faはフィーチャマップの強化された特徴表現です。この強化された特徴表現は、元のセグメンテーション特徴と、アテンションメカニズムを用いて得られた強化特徴を式 13を用いて組み合わせることで算出されます:
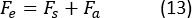
ここでは、 Fe は、パターンの再構成に使用される強化特徴マップである。CAFFMは、異なるスケールの文化的モチーフの特徴を抽出するために、マルチスケール・クロスアテンション機構によって拡張されている。ここで、 Fsi スケールにおけるセグメンテーション特徴量を表す i一方、 Faj 同一スケールにおける芸術的スタイルの特徴を表します。最終的な特徴表現は、以下を用いて定義されます。 式14:
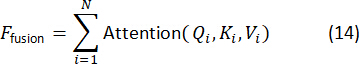
ここで、Qi、Ki、およびViはそれぞれスケールiにおけるクエリ、キー、およびバリュー行列を表し、Nは特徴スケールの数を表します。本研究ではN = 4とし、これは入力画像サイズの1/4、1/8、1/16、および1/32の空間解像度で抽出された特徴マップに対応しています。これらのマルチスケール特徴表現は、再構成および芸術的合成の前に、学習可能なアテンション重みを用いて融合されました。以上の拡張により、本手法はグローバルな文化的モチーフやテクスチャを抽出して文化的パターンを再構成することが可能になります。提案するSegCycle-SPADEシステムにおいて、CAFFMはSegFormerベースのセグメンテーション段階とSPADEベースの創造的合成段階の間に配置されています。まず、CycleGANがスタイルおよびパターンに関する情報を含む再構成特徴を同時に生成し、SegFormer-B2が文化的モチーフの構造的特性を描写するセマンティック特徴マップを復元します。CAFFMモジュールはこれら2つの特徴ストリームを受け取り、クロスアテンションベースの融合を用いて構造的表現と芸術的表現の間の関係性を特定します。セマンティックな一貫性と構造的特徴を維持しつつ、文化的に真正なパターンを生成するために、得られた融合特徴マップはその後、セグメンテーション誘導型の創造的合成を行うSPADEモジュールへと送られます。
CycleGANを用いたパターンの再構成
アテンションベースの特徴量強調ステージが完了すると、特徴マップには強調された文化的モチーフ構造が含まれます。しかし、特徴マップには依然として不完全または損傷したパターン領域が含まれている可能性があります。したがって、パターンの再構成という課題に対処するため、提案するフレームワークではCycleGANモデルを利用します。提案するフレームワークにおいて、2つのドメインは元の文化的モチーフパターンと再構成された文化的モチーフパターンとなります。前ステージで得られた強調特徴量を用いて、CycleGANモデルは構造的な整合性を維持しながら文化的パターンの再構成を行います。これにより、幾何学模様、花柄、象徴的な模様などの文化的パターンがその空間的配置を維持することが保証されます。元の苗族ろう染(Miao Batik)画像に対して、ランダムなマスキングおよび部分的遮蔽操作を行い、不完全または損傷した文化的モチーフを生成しました。これらの劣化処理は、劣化が進んだ文化遺産に一般的に見られるパターンの欠損領域や構造的損傷をシミュレートしたものです。劣化画像は再構成モジュールの入力として使用され、対応する元の画像は性能評価および再構成品質評価のための参照画像として使用されました。この戦略により、モデルは意味的な整合性と文化的特性を維持しつつ、欠損したモチーフ構造の復元を学習することが可能となりました。
Xを不完全な文化的パターンのドメインとし、Yを再構成された文化的パターンのドメインとします。2つのジェネレータは、式15を用いて双方向マッピングを実行するように学習します:
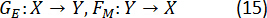
ここでは、モチーフ構造の再構成にGEを、パターンを元のドメインにマッピングすることにFMを使用します。再構成されたパターンが現実的であることを保証するために、敵対的損失が用いられます(式 16)30
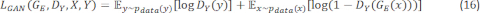
ここで、DYは実パターンと再構成パターンを区別するために用いられるディスクリミネータであり、GE(x)は生成された再構成パターンを表します。また、CycleGANは文化的なモチーフの構造的レイアウトを保持するために、サイクル一貫性を強制します(式 17)30。
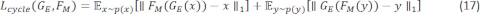
最終的な損失関数は、式 1830を用いて定義されます:
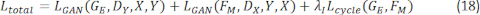
ここで、λiはサイクル一貫性損失の重み係数を示し、元のCycleGANの定式化と同様に、トレーニング中は10に設定されました。この値は、敵対的学習と、ソースドメインおよびターゲットドメイン間の再構成の一貫性のバランスをとるために選択されました。
CycleGAN再構成モジュールは、双方向の画像変換を行うための2つの生成器(generator)と2つの識別器(discriminator)で構成されています。各生成器は、初期の7 × 7畳み込み層、それに続く2つのダウンサンプリング畳み込み層、9つの残差ブロック(residual block)、および2つのアップサンプリング層からなる残差ネットワークアーキテクチャに従っています。入力層では特徴抽出を強化するために7 × 7カーネルを使用していますが、それ以外のすべての畳み込み演算には3 × 3のカーネルサイズを採用しています。トレーニングの安定性を向上させるため、各畳み込み層の後にインスタンス正規化(Instance Normalization)が適用され、生成器ネットワーク全体でReLU活性化関数が使用されています。出力層では、正規化された画像出力を生成するためにTanh活性化関数を用いています。識別器は、カーネルサイズ4 × 4の畳み込み層が連なり、特徴チャンネル数が段階的に増加する70 × 70のPatchGANアーキテクチャに従っています。識別器では、特徴の識別能と敵対的学習を向上させるために、インスタンス正規化とLeakyReLU活性化(負の傾き = 0.2)が採用されています。CycleGANモジュールは、前処理済みの文化的なモチーフ画像を入力として受け取り、再構成されたパターン表現を生成し、これをセグメンテーション特徴量と統合するためにCAFFMへ転送します。CycleGANのトレーニングは、Adamオプティマイザ(β₁ = 0.5, β₂ = 0.999)を使用し、初期学習率0.0002で実施されました。学習率は最初の100エポックまで維持され、その後、残りのトレーニング期間にわたって線形にゼロまで減衰させました。識別器のトレーニングを安定させるため、以前に生成された50枚の画像を格納するリプレイバッファを使用しました。生成器と識別器は1:1の更新比率で更新され、各トレーニングイテレーションにおいて、1回の生成器の更新後に1回の識別器の更新が行われました。
CycleGANの再構成プロセスは、Figure 5のCAFFMメカニズムを用いて得られた強調済み特徴マップに基づいています。これらの特徴マップには、前段階のセグメンテーションおよびCAFFMから得られた、強調された文化的モチーフが含まれています。特徴マップは、第1のジェネレーターGEへの入力として使用されます。第1のジェネレーターGEは、文化的パターンを再構成するために必要なマッピングを学習します。その後、出力はディスクリミネーターDYに送られ、本物の文化的パターンと再構成されたパターンの判別が行われます。ディスクリミネーターDYは、ジェネレーターGEが現実的な出力を生成するのを支援します。再構成中に文化的パターンが歪まないようにするため、第2のジェネレーターFMがサイクル一貫性マッピングを実行します。第2のジェネレーターFMは、出力を元のドメインに逆写像します。その後、出力はディスクリミネーターによって評価され、リアリズムが確認されます。最終的な出力は、提案されたSegCycle-SPADEフレームワークの次段階である、芸術的なスタイル生成のためのSPADEモジュールへと転送されます。
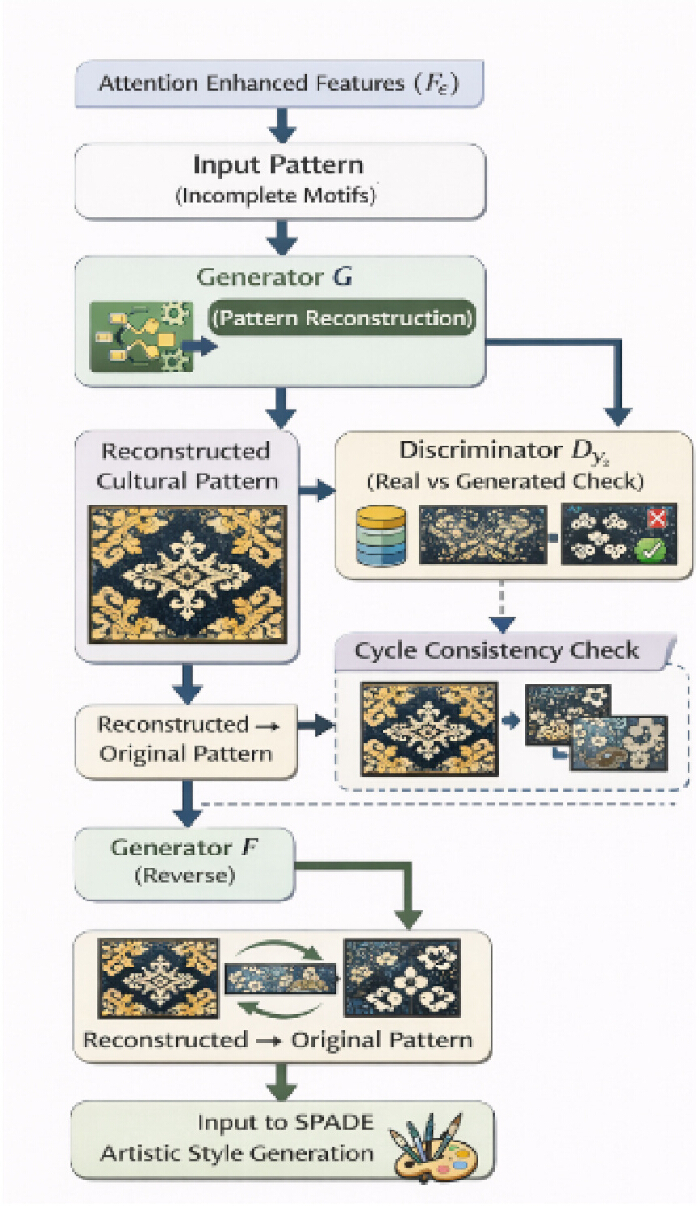
図5CycleGANベースのパターン再構成ワークフロー。 CycleGAN再構成モジュールのワークフロー。不完全な文化的モチーフを再構成するため、アテンション強化特徴表現がジェネレーターネットワークへの入力として提供される。ディスクリミネーターは、再構成された出力と参照パターンを比較して評価し、一方でサイクル一貫性マッピングが双方向画像変換における構造的完全性を維持する。再構成されたモチーフは、その後、芸術的なスタイル合成のためにSPADEモジュールへ送られる。 こちらの図の拡大版を表示するには、ここをクリックしてください。
SPADEを用いた芸術的スタイルの生成
続いて、再構成された文化的モチーフをSPADEモジュールにかけ、芸術的スタイルを生成します。SPADEモジュールの主な目的は、モチーフの構造的レイアウトを損なうことなく、再構成された文化的モチーフに視覚的に豊かな芸術的スタイルのテクスチャを加えることです。SPADEモジュールは、画像生成に画像セグメンテーションの概念を利用した条件付き画像生成技術です。SegFormer-B2によって生成されたセマンティックセグメンテーションマスクから、あらかじめ定義されたモチーフクラスに対応するマルチチャネルセマンティックマップがエンコードされました。SPADEジェネレーターは、これらのエンコードされたマップを条件付け入力として受け取ります。各SPADEレイヤー内の畳み込み層でセマンティックマップを処理することにより、空間適応的なスケーリング(γ)およびバイアス(β)パラメータが生成されました。これにより、ジェネレーターはこれらのパラメータを正規化された特徴活性化に適用することで、芸術的合成の間、モチーフの境界、構造的レイアウト、およびセマンティック情報を維持することができました。条件付けプロセスはSPADEジェネレーターの複数のレイヤーで実行されるため、セマンティックガイダンスは高レベルの構造再構成と低レベルのテクスチャ合成の両方に影響を与えることができました。その結果、生成された芸術的パターンは、セグメンテーション段階で特定された文化的モチーフの構造を維持しつつ、WikiArtデータセットから得られたスタイル特性を取り入れることができました。
ルネサンス、印象派、キュビスム、表現主義、シュルレアリスム、写実主義、抽象芸術など、27の異なる芸術カテゴリーの作品を含むWikiArtデータセットを、芸術的スタイルの理解のための主要なリソースとして使用しました。モデルに多様な創造的特徴を提示し、スタイルの汎化性能を高めるため、トレーニング中はさまざまなカテゴリーからスタイル画像をランダムに選択しました。スタイルバイアスを軽減するため、データセットはトレーニング、検証、テストのサブセットに分割され、各芸術カテゴリーが均衡して配置されるようにしました。全27カテゴリーの表現を均等にするため、層化抽出法を採用しました。元のクラス分布を維持しつつ、各カテゴリーのサンプルをトレーニング、検証、およびテストのサブセットに比例的に割り当てました。WikiArt画像から抽出されたスタイル特性と、CycleGANによって生成された再構成特徴を統合するために、CAFFMモジュールを使用しました。合成ネットワークが、セグメンテーションマップから得られた意味構造や文化的モチーフの境界を維持しつつ、芸術的特性を転送できるように、得られた融合表現をSPADEジェネレーターに条件付け情報として提供しました。このスタイル条件付け手法により、提案したフレームワークは、構造的およびスタイル的に一貫した表現を持つ、文化的に真正な芸術的パターンを生成することが可能になりました。
SPADEはまた、セグメンテーションマップに依存する空間適応的パラメータを導入しています。これらのパラメータは、以下に示すように定義できます。 式191:
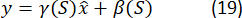
ここで、γ(S)は空間的に変動するスケールパラメータであり、β(S)は空間的に変動するバイアスパラメータである。これらのパラメータにより、ジェネレータは画像内の意味的な領域に応じて異なるテクスチャやスタイルを生成することができる。最終的な文化芸術作品は、式 20に示すように定義できる:
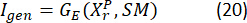
ここで、GEはSPADEジェネレーター、XrPは再構成されたパターン、SMはセグメンテーションマップを表します。最終的な作品は、文化的なモチーフの構造的完全性を維持しつつ、芸術的な外観を向上させています。提案されたSegCycle-SPADEアーキテクチャを最適化するために、セマンティックセグメンテーションの精度、文化的モチーフの保持、パターンの再構成品質、および芸術的スタイルの整合性のバランスをとる複合損失関数が使用されました。全体の学習目標を確立するために、セグメンテーション損失(Lseg)、敵対的損失(Ladv)、サイクル一貫性損失(Lcycle)、再構成損失(Lrecon)、モチーフ保持損失(Lmotif)、およびスタイル一貫性損失(Lstyle)の加重混合が用いられました。全損失関数は式21に定義されています:
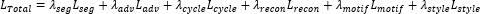 (21)
入力された文化的モチーフと再構成されたモチーフとの間の構造的一貫性を保証するため、サイクル一貫性損失係数を10に設定しました。また、モチーフのきめ細やかな特徴を維持し、視覚的な精度を高めるため、再構成損失係数を5に設定しました。芸術的合成において文化的に不可欠な構造パターンの保存を強調するため、モチーフ保存損失には係数2を用いました。意味的なモチーフ構造を過度に歪ませることなく芸術的なスタイル転送を促進するため、スタイル一貫性損失係数を1に調整しました。写実的な画像生成と正確なモチーフセグメンテーションの寄与度のバランスを維持するため、セグメンテーション損失と敵対的損失には等しい重みを割り当てました。スタイル一貫性損失の算出には、WikiArtデータセットの特徴ベースのスタイル表現を使用しました。具体的には、深層特徴マップから抽出したGram行列の相関を用いて、芸術的なスタイルの特性を捉えました。スタイル損失の算出には、式22に示すように、ターゲットとなるスタイル画像と生成された画像のGram行列間のフロベニウスノルムの差を用いました。
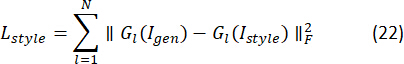
ここでは、 Gl グラム行列は、~から計算されますか 申し訳ございませんが、翻訳対象の原文が提供されておりません。翻訳するテキストをご提示ください。th フィーチャーレイヤー I遺伝子 生成された芸術的画像を表し、 Iスタイル WikiArtデータセットからのターゲットスタイル画像を表し、 F はフロベニウスノルムを表します。この定式化により、提案されたフレームワークは、文化的モチーフの構造的および意味的な整合性を維持しつつ、芸術的な特性を保持することが可能になります。
CAFFMモジュールによって生成された融合特徴表現は、提案フレームワークの芸術的合成コンポーネントとして機能するSPADEモジュールの条件付け入力として使用されます。SPADEジェネレーターは、潜在特徴次元が256チャネルの7つのSPADE残差ブロックで構成され、256 × 256ピクセルの解像度で出力画像を生成します。SegFormer–CAFFMモジュールから得られたセマンティックセグメンテーションマップは、SPADE残差レイヤー全体を通して条件付け入力として使用されます。SPADEレイヤーは、各残差ブロック内の活性化関数の前に適用され、セグメンテーションに基づいたセマンティックな条件付けを可能にします。連続的なアップサンプリングと畳み込み演算を通じて、潜在特徴表現が段階的に精緻化され、セマンティックな一貫性とモチーフ構造を維持しながら、高解像度の芸術的パターンが生成されます。ジェネレーター全体にLeakyReLU活性化関数が使用され、出力レイヤーには正規化された画像を生成するためにTanh活性化関数が適用されます。
アルゴリズムとワークフロー
SegCycle-SPADEフレームワークは、セマンティックセグメンテーション、特徴融合、パターンの再構築、および芸術的なスタイル合成を、単一のトレーニングパイプライン内に統合しています。ワークフローは、画像のサイズ変更、正規化、ノイズ除去、およびセグメンテーションマスクの作成を含む、データセットの取得と前処理から始まります。前処理済みの画像は、その後、SegFormer-B2セグメンテーションネットワークを用いて処理され、セマンティックモチーフ表現が抽出されます。得られたセグメンテーション特徴は、CAFFMを通じて再構築特徴と融合され、構造的なモチーフ情報と芸術的な特徴表現との相互作用が可能になります。融合された特徴マップは次にCycleGAN再構築モジュールに供給され、セマンティックな一貫性を維持しながら、不完全な文化的モチーフ構造を復元します。再構築されたパターンは、その後、セグメンテーション誘導型の芸術的合成を行うSPADEジェネレーターに提供され、モチーフの境界と構造的な正当性を維持しつつ、スタイルの強化が行われます。トレーニング中、モデルパラメータは式21および22で記述される複合損失関数を用いて最適化され、これによりセグメンテーション精度、モチーフの保存、再構築品質、および芸術的スタイルの整合性がバランスよく調整されます。データセットの読み込み、前処理、モデルの初期化、トレーニングの反復、検証手順、チェックポイントの選択、および最終評価を含む詳細なステップバイステップの実装ワークフローは、補足ファイル1 (Algorithm 1)に記載されています。完全なアルゴリズムワークフローは、バッチサイズ 16、学習率 0.0002、トレーニングエポック数 100 で実装されました。データセットの分割、モデルの初期化、およびすべてのトレーニング実験には、固定の乱数シード 42 が使用されました。再現性を確保するため、このシードは Python、NumPy、および PyTorch の乱数ジェネレーターに一貫して適用されました。Adamオプティマイザは、β₁ = 0.5、β₂ = 0.999、ウェイトディケイなし (weight decay = 0) で設定されました。モデルのチェックポイントは、検証データセットで達成された最高の検証 IoU スコアに基づいて選択されました。
損失関数の最適化
再構成および芸術的合成において文化的モチーフ構造を保持するため、提案するフレームワークでは、セグメンテーション損失、敵対的損失、サイクル一貫性損失、再構成損失、モチーフ保持損失、およびスタイル一貫性損失を組み合わせた複合最適化目的関数を採用しています。完全な数式、重み係数、およびスタイル損失の定義は、以下に示されています。 式21および22 〜の中で SPADEを用いた芸術的スタイルの生成 サブセクション。モチーフ保存コンポーネントは、予測されたモチーフ領域と対応するグラウンドトゥルースのセグメンテーションマスクとの間の構造的な偏差にペナルティを課すことで、再構成プロセス全体を通じて、文化的に重要なパターン構造の保存を促進します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
提案されたSegCycle-SPADEフレームワークは、苗族バティック(Miao Batik)の文化モチーフデータセットとWikiArtデータセットの2つのデータセットを用いて評価されました。苗族バティックデータセットには伝統的な文化遺産画像が含まれており、主にセマンティックセグメンテーションおよび構造再構成タスクに使用されました。一方、WikiArtデータセットには多様な芸術的スタイルが含まれており、芸術的スタイルの学習と生成に使用されました。両データセットの画像は、セマンティックセグメンテーション、CAFFM、パターン再構成、およびSPADEベースの芸術的スタイル生成を含む、SegCycle-SPADEの完全なパイプラインを通じて処理されました。文化モチーフ情報と芸術的スタイル表現を統合することで、本フレームワークは文化的な意味を持ち、視覚的に一貫した出力を生成することが可能になりました。
すべての実験は、Intel Core i7プロセッサとNVIDIA GPUを搭載したGPU対応ワークステーションで実施されました。具体的には、Intel Core i7(第11世代)CPU、...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
伝統工芸の緩やかな喪失に伴い、近年、無形文化遺産(ICH)パターンの保存とデジタル再構築への関心が高まっています。先行研究では、ディープラーニング(DL)に基づく画像処理技術を用いて文化遺産の喪失に対処することが試みられてきました。例えば、Quanら32は、貴州省の苗族バティック文化を対象に、ナレッジグラフとDLに基づく文化遺産保存フレームワークを提案しました。この研究は文化パターンのデジタル再構築に焦点を当てていましたが、その手法は主にナレッジグラフによる表現に依存していました。同様に、FuとRazmjooy16は、文化遺産画像の強調および修復のために、特徴ピラミッドネットワーク(FPN)に基づくフレームワークを提案しました。この手法は画像強調のための効果的な特徴抽出を実現しましたが、不完全な文化パターンに対する画像セグメンテーションによる誘導や、生成的な再構築メカニズムは組み込まれていませんでした。対照的に、提案するSegCycle-SPADEフレームワークは、複数のDLコンポーネントを組み合わせることで、これらの課題を克服しています。ま...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
利益相反:
著者は、競合する利益がないことを宣言します。
謝辞
著者らは、本研究の遂行にあたり、広東工程 Polytechnic および華南師範大学から提供された学術的および機関的な支援に感謝いたします。本研究は、2023年国家社会科学基金一般プロジェクト(No. 23BH161)「(タイトル)」の支援を受けて実施されました。 「デジタル再生博物館:中国古典書画文化遺産の活性化と伝達に関する研究」
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Adam オプティマイザ | PyTorch Optimizer Library | Adam | モデルトレーニング中に使用される最適化アルゴリズム。 |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.3 | ディープラーニング計算のためのGPU加速。 |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | トレーニングと推論を高速化するために使用される深層ニューラルネットワーク加速ライブラリ。 |
| CycleGAN | University of California, Berkeley / オープンソース | Official PyTorch Implementation (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | 文化的なモチーフの再構成に使用される敵対的生成ネットワーク。 |
| ImageNet 学習済み重み | ImageNet / オープンソース | mit_b2.pth (ImageNet-1K Pretrained Checkpoint) | Miao Batik データセットでのファインチューニング前に、SegFormer-B2 バックボーンを初期化するために使用。 |
| Intel プロセッサ | Intel Corporation | Intel Core i7 (第11世代) | 画像の前処理、モデルトレーニングのサポート、および推論に使用されるCPU。 |
| Matplotlib | Matplotlib Development Team | Matplotlib 3.5.1 | トレーニング曲線と評価結果の可視化。 |
| Miao Batik データセット | Zenodo Repository | DOI: 10.5281/zenodo.20807658 | セマンティックセグメンテーションとパターン再構成に使用される、15,148 枚の画像を含む文化的モチーフのデータセット。 |
| NumPy | NumPy Developers | NumPy 1.21.5 | 数値計算およびデータセット処理。 |
| NVIDIA GPU | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | モデルトレーニングと推論に使用されるハードウェアプラットフォーム。 |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | 画像の前処理、リサイズ、補間、およびガウシアンデノイジング。 |
| オペレーティングシステム | Canonical Ltd. | Ubuntu 20.04 LTS | 実験実行環境。 |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | 画像の読み込みと操作。 |
| Python | Python Software Foundation | Python 3.8.10 | 実装と実験に使用されるプログラミング言語。 |
| PyTorch | Meta AI | PyTorch 1.10.0 | モデルトレーニングと推論に使用されるディープラーニングフレームワーク。 |
| 乱数シード | 実験設定 | 42 | データセットの分割、モデルの初期化、および実験の再現性のために使用される固定シード。 |
| Scikit-learn | Scikit-learn Developers | Scikit-learn 1.0.2 | データセットの分割、統計分析、および評価指標。 |
| Seaborn | オープンソースコミュニティ | Seaborn 0.11.2 | 統計データの可視化。 |
| SegFormer-B2 | NVIDIA Research / オープンソース | SegFormer-B2 (MIT-B2 Backbone) | 文化的モチーフのセグメンテーションに使用される Transformer ベースのセマンティックセグメンテーションモデル。 |
| セグメンテーションマスク / アノテーション | Miao Batik データセット | データセットに含まれる | モチーフの分類とトレーニングに使用されるピクセルレベルのセマンティックセグメンテーションラベル。 |
| SPADE | NVIDIA Research / オープンソース | Official PyTorch Implementation (https://github.com/NVlabs/SPADE) | 芸術的なパターンの生成に使用されるセグメンテーション誘導型画像合成モデル。 |
| TorchVision | Meta AI | TorchVision 0.11.1 | PyTorch と併用される画像処理ユーティリティおよびデータセット変換。 |
| WikiArt データセット | WikiArt | https://www.wikiart.org/ | スタイル学習と合成に使用される、27 の芸術スタイルにわたる 80,000 点以上の芸術作品を含む芸術スタイルデータセット。 |
参考文献
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。