本研究では、中国をテーマにしたナラティブを翻訳する英語専攻者の意思決定および修正行動を調査し、キーストローク・ロギング記録と弾幕コーパスを統合することで、テキストの顕著性が処理努力と翻訳品質にどのように影響するかを明らかにします。
この記事について
サマリー
要約
中国をテーマとしたナラティブが国際的に流通する機会が増えるにつれ、中国語から英語への翻訳は、単なる言語的な転移ではなく、意味の交渉が行われる場となっています。学生翻訳者にとっての主な課題は、単なる語彙の選択にとどまりません。文化的に飽和した参照、評価的なスタンス、およびナラティブ上のポジショニングを、ソースコンテクスト外の読者に向けたいかに表現するかを決定することにあります。本研究では、中国をテーマとしたナラティブを翻訳する英語専攻の学生72名のリアルタイムな意思決定と修正行動を調査しました。プロセス・プロダクト設計を用いた本研究では、Translog-IIで収集したキーストローク・ロギングデータ、翻訳プロダクトの評価、および補助的な弾幕(タイム同期コメント)コーパスを統合しました。なお、弾幕コーパスは、セグメントレベルの言語的困難さを直接的に測定するものではなく、オーディエンスにとっての顕著性を示すレイヤーとして扱いました。翻訳プロセスについては、一時停止時間、修正頻度、修正箇所、およびステージ分布に基づいて分析し、プロダクトの質については、専門家による評点と文化関連セグメントのターゲットコーディングを通じて評価しました。また、Bilibiliの動画24本から得られた18,642件の弾幕コメントのコーパスを用いて、公的に顕著なナラティブテーマと文化的に敏感な表現を特定しました。その結果、文化的な負荷が高く評価的に密度の高いセグメントでは、一時停止時間が長くなり、再帰的な修正が増加し、プロセス中盤でのリフォーミュレーションがより頻繁に起こることが示されました。質の高い翻訳は、総修正回数の多さではなく、ディスクールレベルおよび文化適応レベルでの選択的かつ戦略的にタイミングを計った修正に関連していました。弾幕で顕著なナラティブのトリガーと、高い負荷がかかった翻訳セグメントとの重複は、オーディエンスにとっての顕著性と翻訳者の処理負荷が収束した証拠であると解釈され、因果関係を示すものではありません。本研究は、修正行動を文化的に埋め込まれたナラティブ翻訳に結びつけることで翻訳プロセスの研究を前進させ、異文化間コミュニケーションにおける翻訳者トレーニングへの示唆を提供します。
概要
近年、中国関連の言説の翻訳は、比較的専門的な関心事から、国際コミュニケーションにおける中心的な課題へと移行している。1このような翻訳において問われているのは、単なる命題内容の転移ではなく、政治的なポジショニング、文化的フレーミング、およびターゲット層の設定を伴うパブリック・ナラティブの再分節化である。中国の政治的ディスクールの翻訳に関する研究により、この点はますます明確になっている。すなわち、中国国外の読者に向けた翻訳において、語彙、モダリティ、および文章上の強調点に関する選択は、中国が国外でどのように語られ、解釈されるかという選択そのものになるのである。2問題をそのように定義すると、成果物のみに焦点を当てたアプローチでは不十分になります。完成した翻訳は、何が選択されたかを示すことはできますが、いつ不確実性が生じ、どこで再定式化が始まり、競合する解決策がどのように検証され、そして放棄されたかを示すことはできないからです。3.
これらの限界は、翻訳研究において経験的な翻訳プロセス研究が重要な一翼を担うようになった理由を説明しています。この研究手法では、最終的なテキストから間接的に推論するのではなく、プロセス追跡ツールを用いて、休止、削除、挿入、および意思決定の時間的形状を捉えます4。これは、産出物、社会学的、文化的、またはコーパスベースのアプローチを排除するものではなく、むしろ翻訳上の決定が刻一刻と形成される過程に関するエビデンスを加えるものです。近年の研究では、単一の休止を記述することから、翻訳を時間的に構造化された活動としてモデル化することへと移行しています。例えば、「躊躇(hesitation)―方向付け(orientation)―フロー(flow)」というタクソノミーでは、翻訳行動を、不確実性、探索、および流暢な産出の間でパターン化された交互作用として扱い、タスクの特定の箇所がなぜ不安定になり、再定式化が誘発されるのかを説明しています5。この転換は、言語能力、専門知識、および戦略的コントロールが同時に発達しつつある学生による翻訳において、特に重要となります6。
アイトラッキングとキーストローク・ロギングを組み合わせたエビデンスにより、初学者の翻訳者は注意を均等に配分せず、中国語から英語への翻訳において、ターゲットテキストの作成がしばしば認知負荷の主要な要因となることが示されています7。その結果、成果物における局所的な表現の問題に見えるものは、実際にはリアルタイムのプロセスにおける注意と努力のより広範な再編成を反映している可能性があります8。近年のエビデンスではさらに、学生翻訳者が表面上は同様の適切さを持つテキストを作成しても、それに要した努力量、不確実性、および自己モニタリングの量には大幅な差があることが示唆されています。満足のいく最終的な訳文であっても、プロセスに敏感な測定手法でしか捉えられない、不安定または非効率な意思決定経路に基づいている場合があります9。さらに、比較研究により、翻訳の専門性には、一時停止、検索、ドラフトの継続、あるいは修正のための差し戻しをいつ行うかという、安定したメタ認知的コントロールが含まれていることが示されています10。
推敲こそが、この潜在的な認知プロセスが最も顕著に現れる時点である。翻訳者は推敲を通じて、以前の表現に立ち戻り、代替案を検討し、問題が語彙的なものか、構文的なものか、談話的なものか、あるいは文化的なものかを判断する。したがって、推敲は単なる最終段階の仕上げとしてではなく、翻訳者の能力向上の核心的な指標として扱うべきである。より優れた成果は、制作過程で代替案がいかに統合されたかに結びついており、効果的な推敲とは、単なる修正の積み重ねではなく、選択的で戦略的なタイミングで行われ、より高度なテキスト上の要求に応えるものであることが示されている11,12,13。
出典となるテキストが、中立的な情報提供の一節ではなく中国を中心としたナラティブである場合、意思決定と修正の複雑さはより顕著になります。このようなテキストは、文化的に飽和した前提、歴史的に位置付けられた表現、そして明示的な説明よりも共有された背景に意味を依存する評価的な手がかりに頻繁に依拠しています14,15,16。テキストの難易度は、処理の粒度そのものを変化させます。文化的または評価的な密度を持つナラティブテキストを扱う際、翻訳者はより小さな単位で作業し、非線形な操作を行い、局所的な再構築を繰り返し行うことを余儀なくされます8。学生翻訳者にとっての中心的な課題は、文化的な固有性を損なうことなく、元のディスクロス・コミュニティ外の読者のために、その暗黙的な背景をどの程度まで展開または再構成するかを決定することにあります。
本研究は、3つの具体的な課題に基づいている。第一に、休止時間、長時間休止の頻度、カーソルの中断、辞書参照といった翻訳プロセスの指標は、改訂のタイポロジーとは別に検討されることが多く、意思決定のプレッシャーが後のリフォーミュレーション(言い換え)としてどのように顕在化するのかを把握することが困難である。第二に、中国に焦点を当てたナラティブでは、翻訳者が文化的負荷、評価的密度、および圧縮された背景的含意を同時に処理する必要があることが多いにもかかわらず14,15,16、文化特有のナラティブ・カテゴリーは、一般的な学術的または解説的なテキストに比べてプロセスベースの注目度が低い。本研究において、文化的負荷とは文化依存的な参照や共有された前提の密度のことを指し、評価的密度とは明示的または暗示的なスタンス表明、感情的な強度、および価値を伴うフレーミングを指す。また、ナラティブの圧縮とは、背景情報、因果関係、または社会的ポジショニングが、短いテキスト範囲にどの程度凝縮されているかの度合いを指す。第三に、翻訳タスクは通常、テキスト内部の分析のみに基づいて設計されており、困難であると特定されたセグメントが、デジタル流通において公衆の注目を集める点と一致しているかについては、ほとんど考慮されていない。弾幕(動画に同期したコメント)は、パラテキストおよび参加型言説として機能し、視聴者が何に注目し、異議を唱え、再解釈したかを浮き彫りにすることができる17,18。しかし、弾幕の顕著性は、セグメントレベルの言語的困難さを直接的に代替するものではなく、視聴者のエンゲージメントを示す意味レベルの指標として扱う必要がある。
これらの空白を埋めるため,本研究では,英語専攻の学生が中国をテーマにしたナラティブを中国語から英語に翻訳する際,どのように意思決定を行い,修正を加えるかを検討します。翻訳プロセスのデータとデジタルオーディエンスのディスクルースを同一の分析枠組みに取り入れることで,学生翻訳者がどこで苦労するのかだけでなく,なぜそのような苦労が特定の種類のナラティブな意味に集中するのかを明らかにすることを目的としています。
具体的に、本研究では以下の4つのリサーチクエスチョンに取り組みます。(1) 英語専攻者の中国語から英語への中国関連ナラティブの翻訳において、どのような意思決定パターンが特徴的に見られるか。(2) 文化的な負荷やナラティブの密度が異なるセグメント間で、修正行動はどのように変化するか。(3) 修正行動のどの次元が高い翻訳品質と関連しているか。(4) danmu(弾幕)のディスコースで特定された文化的に顕著なポイントは、翻訳中に最大の処理負荷が生じるセグメントと重複しているか。
これに伴い、本研究では単一の分析シーケンスを用いて、相互に関連する4つの仮説を検証します。H1では、文化的負荷が高いセグメントは、負荷が低いセグメントよりも、ポーズ時間が長く、意思決定の不確実性が高く、修正頻度が多くなると想定しています。H2では2つの経路を区別し、評価密度が高まると遅延修正が増加し、ナラティブの圧縮が進むとディスクルスレベルの言い換えが増加すると予測しています。H3では、翻訳の質は、総修正回数のみよりも、修正の選択性とタイミングによってより強く説明されると予測しています。そしてH4では、視聴者の注目度と翻訳者の処理負荷の連合的収束として、弾幕で顕著なセグメントが高負荷の翻訳セグメントと重複すると予測しています。
プロトコル
ヒト被験者を対象としたすべての手法は、機関のガイドラインに従って実施され、Hanshan Normal Universityの機関審査委員会(IRB)または人間研究倫理委員会の承認を得た。実験に先立ち、すべての参加者からインフォームドコンセントを得た。
概念的枠組みと研究デザイン
本研究では、視聴者が生成する弾幕コメントが字幕翻訳にどのような影響を与えるかを調査するため、補助的なディスクール・レイヤーを伴うプロセス・プロダクト研究デザインを採用した。分析フレームワークには、テキスト上の特性、翻訳プロセスの指標、および翻訳品質の結果を統合した。具体的には、弾幕の密度に反映される視聴者の注意が、翻訳者の認知リソースを特定のテキスト特徴へと向けさせたか、また、この注意の配分がその後の翻訳品質に影響を与えたかについて検討した。
このフレームワークを運用するために、本研究ではまず、「文化的負荷」、「評価密度」、「叙事圧縮」、および「弾幕顕著性」の4つの次元に基づいたセグメントレベルのテキスト特徴量を設定しました。文化的負荷とは、適応または説明を必要とする文化特有の言及の存在を指します。評価密度は、セグメント内における感情的または態度的な負荷を持つ言語の集中度を測定したものです。叙事圧縮は、字幕の制約下で意味内容がどの程度凝縮されたかを捉えたものです。弾幕顕著性は、同期した弾幕コメントの量によって定量化され、各字幕セグメントに向けられた視聴者の注意の度合いを表します。従来の翻訳困難度の測定尺度とは異なり、弾幕顕著性は、テキスト固有の複雑さではなく、社会的に分散した注意を反映しています。視聴者のエンゲージメントが高いセグメントが、必ずしも翻訳がより困難であるとは限らず、むしろ視聴体験におけるコミュニケーション上の重要性が高まっている地点であることを示しています。
分析フレームワークは、相互に関連する3つのデータセットで構成されました。参加者レベルのデータセットには、個々の人口統計学的特性および翻訳の専門知識が含まれています。プロセス・プロダクトデータセットでは、各字幕セグメントを、キーストロークログから抽出した行動指標および専門家による翻訳品質評価に紐付けました。弾幕データセットには、字幕のタイミングに同期した視聴者のコメントが含まれており、そこから弾幕のサリエンス値が算出されました。これらのデータセットは参加者およびセグメントの識別子を介して連携されており、翻訳された各字幕セグメントについて、翻訳者の特性、認知処理行動、視聴者の注目度、および翻訳結果を同時に分析することが可能となりました。最終的な統合データベースは、216件の完全な翻訳セッションと3,168件の「参加者・テキスト・セグメント」観察データで構成され、その後のプロセス・プロダクト分析の経験的な基盤となりました。
参加者のスクリーニングおよび背景プロファイリング
サンプルは、中国南部の公立大学から募集した英語専攻の学生72名で構成され、学部2年、3年、4年に均等に分配されました(各学年24名)。参加者は全員、英語のライティングおよび翻訳の正式な指導を受けている中国語を母国語とする話者でした。翻訳学習者集団内での比較可能性を確保するため、英語圏の国に6ヶ月以上居住した経験がある者、またはプロの翻訳者資格を保有している者は除外されました。参加者は、翻訳経験、文化的親近感、または第二言語習熟度に基づいて個別の実験群に層別化されませんでした。その代わりに、学年、直近の英語能力試験のスコア、以前の翻訳コースの履修状況、中国関連の文化的トピックに対する自己評価による親近感、および週平均のバイリンガル実践への取り組み時間が記録され、統計モデルにおける参加者レベルの共変量として組み込まれました。この説明により、査読中に指摘された参加者数の不整合も解消されます。原稿と再現データセットの両方に、72名の参加者、216回のタスクセッション、および3,168個のセグメントレベルの観察結果が含まれています。
ソーステキストの選択とタスクの構築
翻訳教材として、本研究のために特別に作成された、現代中国に焦点を当てた3つの物語形式のテキストを使用した。これは、実際の公的なディスクールを反映させると同時に、著作権で保護された資料の複製を避けるためである。各テキストは205〜225字の中国語で構成されているが、内部的な特性は体系的に異なっている。テキストAは、文化的な負荷が中程度で構文が比較的単純な、春節の帰省に関する物語である。テキストBは、端午節の思い出を綴ったものであり、文化特有の表現や暗示的な背景知識の密度が高い。テキストCは、農村部のライブストリーミングと電子商取引に関する物語であり、濃密な評価言語と圧縮された叙述的ポジショニングを特徴とする。
テキストは節の境界を用いて系統的に分節化され、続いて意味単位の境界で分節化されました。これにより、3つの翻訳タスク全体で44個の分析可能単位が得られました(表1)。正式なコーディングに先立ち、コーディングマニュアルを用いて、文化的負荷、評価密度、および叙述的圧縮を1~5の順序尺度で定義しました。本実験に参加していない学生12名を対象としたパイロットスタディにより、意図した難易度の調整、タスク指示の明確さ、およびキーストローク整合のための分節境界の安定性が確認されました。
補助コーパスの構築とサリエンスマッピング
公的に顕著なナラティブ上の手がかりを特定するため、2023年1月から2025年12月の間にアップロードされた24本のBilibili動画から補助的な弾幕コーパスを構築した。動画の選定基準は、ソーステキストに表れている3つの意味領域のいずれかに合致していること、視聴回数が50,000回を超えていること、弾幕による相互作用が活発であること、および時間同期したコメントの書き出しとテーママッピングが可能であることとした。重複の削除に加え、絵文字、擬音語によるフィラー、および無関係な断片をフィルタリングした後、最終的なコーパスは18,642件のコメントで構成された。
コンテンツ語は、原文に関連するキーワードアンカーを用いて標準化およびクラスタリングされました。その後、正規化されたキーワードクラスターの頻度、対応するテーマクラスター内でのコメント集中度、および平均的な評価強度の加重複合に基づき、各原文セグメントに連続的な弾幕サリエンススコアが割り当てられました。この手順により、直接的な語彙の一致ではなく、意味クラスターレベルで翻訳者の処理負荷と視聴者のサリエンスを比較することが可能になります。弾幕は実験的な翻訳タスクそのものではなく、オンライン動画に対する視聴者の反応を反映しているため、弾幕サリエンスは原文セグメントの言語的な困難さの直接的な証拠ではなく、視聴者のエンゲージメントを示す外部指標として解釈されます。
実験手順およびデータキャプチャ
翻訳セッションは、標準化されたハードウェア、ソフトウェア、およびインターネット接続環境が整った管理下のコンピュータ実習室にて、個別に実施されました(図 2)。国際的な読者が理解しやすい英語を作成することを強調する5分間のオリエンテーションの後、キーボードへの慣れによる影響を最小限に抑えるため、参加者は3分間の英語タイピング・ウォーミングアップを行いました。3つの翻訳タスクはTranslog-IIを用いて順次提示され、疲労や順序効果による潜在的な影響を参加者間で均等に分散させるため、ラテン方格法を用いてタスクの提示順序をカウンターバランスさせました。各テキストに割り当てられた最大時間は20分とし、タスク間には5分間の休憩時間を設けました。
組み込みの二言語辞書の使用は許可されましたが、機械翻訳システムおよび外部検索エンジンの使用は禁止されました。すべてのキーストローク、一時停止、およびカーソルの動きは自動的に記録され、非線形な修正エピソードを確認するために同期的な画面録画によって補完されました。各タスクの完了後、参加者は自己報告による難易度評価を行い、これは境界線上のコーディング事例の解釈を支援するためだけに使用されました。
プロセスの測定と変数のコーディング
キーストローク記録を、事前に定義されたセグメント構造に合わせて調整しました。アライメントエピソードは、セグメントに対応するターゲット言語の最初のキーストロークから始まり、参加者が確実に次のセグメントへ移行した時点で終了しました。重複する修正箇所については、タイムスタンプ付きのカーソル追跡記録を用いて再割り当てを行いました。
意思決定行動は、最初のセグメント翻訳前の初回休止時間、セグメント内平均休止時間、2秒を超える休止の頻度、辞書参照回数、および線形的なドラフティングからの逸脱を示すカーソルベースの中断回数の5つの指標を用いて定量化した(表2)。修正行動は、タイミングと機能の2つの次元に沿って分類した。タイミングでは、即時の局所的な修正と、ドラフティングが現在のセグメントを超えて進んだ後に行われた遅延修正を区別した。機能的コーディングでは、修正を表面的な修正(意味的変化のない形式レベルの訂正)、意味的修正(語彙的または構文的な修正)、ディスクルスレベルの修正(節の関係性や一貫性の調整)、および文化的適応修正(ターゲット読者を意識した再定式化)に分類した。訓練を受けた2名のコーダーが、判定前に各修正エピソードを独立して分析し、各イベントに単一の主要な機能カテゴリーを割り当てた。コーディングされたすべての指標において、評価者間信頼性は強固であった。Cohen’s ĸは、修正機能のカテゴリーコーディングにおいて相当な一致を示した(ĸ = 0.84, p < 0.001)。順序尺度のテキストレベル変数については、級内相関係数(ICC、二元混合効果モデル、絶対一致)により、文化的負荷(ICC = 0.86)、評価密度(ICC = 0.78)、およびナラティブ圧縮(ICC = 0.82)において高い信頼性が示された。初期のコーディングの不一致は、その後、共同判定を通じて解決した。
翻訳品質評価
翻訳の質は、博士レベルのトレーニングを受け、翻訳指導において豊富な経験を持つ2名の評価者によって、プロセスデータとは独立して評価された。評価者は、参加者の身元およびプロセス指標を伏せた状態で、意味的な正確性、言語的な流暢さ、叙述の一貫性、文化的表現、およびレジスターの適切性の5つの次元に均等に配分された100点満点のルーブリックを適用した(表3)。評価者間の得点差が8点を超えた場合は、共同レビューと合意による再採点が行われ、判定後の平均値が最終的な翻訳品質スコアとして使用された。再現用資料において評価者間信頼性を透明に報告できるよう、判定前の評価記録が保持された。
統計モデリング
解析は、3つの連続した段階で進められた。まず、学年グループおよびテキストタイプにおけるすべての変数を要約するため、記述統計量を算出した。次に、テキスト内にネストされたセグメントの構造および個々の参加者からの反復観測を考慮し、混合効果回帰モデルを用いてセグメントレベルの処理負荷を分析した。初回ポーズ時間および修正頻度を含む従属変数を、参加者の習熟度を制御した上で、文化的負荷、評価密度、ナラティブ圧縮、および弾幕の顕著性の関数としてモデル化した。統計的な透明性を高めるため、予測変数の相関、分散拡大係数(VIF)による診断、95%信頼区間、効果量の推定値、およびモデル適合度指標を算出した。
最後に、全体の修正頻度に対する修正タイミングおよび修正機能の予測的な寄与度を評価するため、翻訳品質のモデリングを行った。弾幕が顕著なセグメントと労力が大きい翻訳セグメントの重複については、各分布の上位20%、標準化された複合労力指数、および偶然の一致分析を用いて評価した。探索的因子分析および構造方程式モデリングは実施していない。したがって、付随する図は概念的、記述的、または回帰ベースの要約としてのみ提示している。
結果
翻訳セッションの全体的なプロファイル
全72名の参加者が、標準化された実験条件下で3つの翻訳タスクを完了し、計216回の完全な翻訳セッションが得られました。セグメントの整合後、最終的な分析データセットは3,168件の「参加者・テキスト・セグメント」の観察単位で構成されました。サンプル全体の1テキストあたりの平均タスク完了時間は998.4 sであり、学年および原文の間で明確な差が認められました(表4、図3)。したがって、原稿および付随するデータのいずれにおいても、サンプルサイズは一貫してn = 72名として支持されており、サブセットを要約する図表がある場合は、それらのサブセットを明記する必要があります。
4年生は2年生よりも、翻訳タスクをより迅速に、かつ中断回数を少なく完了しました。この差は処理速度にとどまりませんでした。4年生のグループは、平均初回ポーズ時間がより短く、長いポーズの回数が少なく、修正総数も少なかった一方で、翻訳品質スコアは最高値を示しました。対照的に、2年生は最も多くの修正を行いましたが、その大部分は表層的な修正や即座に局所的な訂正を行うものでした。上級生は、遅延修正および文化的適応修正の割合が高く、優れた翻訳パフォーマンスは、修正量の多さよりも、選択的な修正戦略に関連していることが示されました。
3つのソーステキスト間の差異も同様に顕著であった。テキストAでは、完了時間が最も短く、長いポーズの回数が最も少なく、修正密度も最も低かった。テキストBとCはいずれも、より大きな処理負荷を強いたが、そのメカニズムは異なっていた。テキストBでは文化に関連する修正イベントの数が最も多く、一方でテキストCでは談話レベルの修正頻度が最も高く、セグメント内平均ポーズ時間も最長であった。したがって、処理の困難さの原因はテキストによって異なっていた。テキストBでは、困難さは文化特有の言及や暗黙の背景的想定に集中していたが、テキストCでは、主にナラティブの圧縮や評価的なポジショニングに関連していた。
一元配置分散分析により、翻訳品質の合計点において学年間に有意な差があることが確認され、F (2, 69) = 31.84, p < 0.001、効果量は大きかった(参加者レベルの平均スコアに基づく η2 ≈ 0.48)。事後比較の結果、4年生は3年生よりも有意に高いスコアを獲得し、さらに3年生は2年生よりも高い成績を収めていた。同様の傾向が、初回のポーズ時間、長時間ポーズの頻度、および修正遅延率においても観察された。総合的に見て、これらのベースラインの知見は、その後の分析に向けた2つの重要な点を裏付けている。第一に、3つのソーステキストは、単にトピックの内容が異なるだけでなく、処理の困難さが異なっていたことである。第二に、翻訳品質の向上は、単なる処理負荷の軽減ではなく、翻訳プロセスの再構成に関連していたことである。
テキストの顕著性が意思決定および修正行動に及ぼす影響
セグメントレベルのテキスト特性が処理負荷を予測するかを判断するため、初回ポーズ時間、長時間ポーズ頻度、総修正密度、および遅延修正密度について混合効果モデルを推定した。文化的負荷、評価密度、ナラティブ圧縮、および弾幕の顕著性を固定効果として投入し、参加者とセグメントをランダム切片として組み込んだ(表5; 図4)。予測変数のスクリーニングにより、問題となる多重共線性の不在が確認され、すべての分散拡大係数(VIF)の値は、保守的な閾値である2.5を十分に下回っていました(最大VIF = 1.45)。モデルの適合度および説明分散の割合を評価するため、マージナルおよびコンディショナルR2 すべての混合効果モデルに対して値が算出された(周辺R2 0.08から0.19の範囲であり、条件付きR2 (0.46から0.64の範囲)。ランダム効果(参加者およびセグメントの切片)の完全な分散成分および対応するモデル適合度指標の詳細については、〜に記載されている。 表 5係数推定値は、単独ではなく95%信頼区間とともに解釈されます。 p-値のみ。
文化負荷(Cultural load)は、すべてのモデルを通じて最も強く、かつ一貫した影響を示しました。初回ポーズ(first-pause)モデルにおいて、文化負荷スコアが1ユニット増加するごとに、初回ポーズの持続時間が0.91 s増加しました(b = 0.91, SE = 0.12, 95% CI [0.67, 1.15], p < 0.001)。また、文化負荷は、長期ポーズ(long-pause)の頻度(b = 0.19, SE = 0.04, 95% CI [0.11, 0.27], p < .001)および総修正密度(total revision density)(b = 0.27, SE = 0.06, 95% CI [0.15, 0.39], p < .001)を有意に増加させました。したがって、文化負荷の高いセグメントは、初期処理を遅延させるだけでなく、その後の言い換え(reformulation)の可能性を高めることが示されました。
ナラティブ圧縮においても、同様に強固ではあるが異なる影響パターンが示されました。これは談話レベルの修正の強い予測因子であり(b = 0.31, SE = 0.07, 95% CI [0.17, 0.45], p < .001)、セグメント内の平均ポーズ時間を有意に増加させました(b = 0.58, SE = 0.14, 95% CI [0.31, 0.85], p < .001)。実用的には、膨大な背景情報を短いテキスト範囲に凝縮したセグメントは、即座の語彙置換を促す可能性が低く、より広範な構造的再検討を必要とする可能性が高いことを示しています。
評価密度の影響も有意に認められたが、その主な効果は初期の判断潜時ではなく、遅延修正(delayed revision)に現れていた。遅延修正モデルにおいて、評価密度は正の係数を示した(b = 0.23, SE = 0.05, 95% CI [0.13, 0.33], p < .001)。対して、最初のポーズ時間への影響は比較的わずかであった(b = 0.34, SE = 0.13, 95% CI [0.09, 0.59], p = 0.010)。これらの知見は、評価の手がかりが、初期翻訳時の処理におけるボトルネックとして常に認識されていたわけではないことを示唆している。むしろ、初期草案が作成された後にのみ問題となることが多く、それによって翻訳者がスタンス、トーン、あるいは物語上の適切さといった問題に立ち返ることになったと考えられる。
テキスト内部の変数を制御した後も、弾幕の顕著性(salience)は重要な予測因子であり続けました。これは、最初のポーズ時間(b = 0.36, SE = 0.14, 95% CI [0.09, 0.63], p = 0.011)と総修正密度(b = 0.17, SE = 0.06, 95% CI [0.05, 0.29], p = 0.006)の両方を有意に予測しました。その効果量は文化的負荷(cultural load)やナラティブ圧縮(narrative compression)よりも小さいものの、一貫して寄与していることから、弾幕コーパスにおいてより大きな公衆の注目を集めるセグメントは、翻訳時の処理負荷が高くなる傾向があることが示唆されます。この知見は、弾幕の頻度が直接的に翻訳の困難さを引き起こしている証拠というよりも、意味的な顕著性を示す収束的な証拠であると解釈されます。
修正動作と翻訳精度
その後の解析では、翻訳の質が、修正の総量によってより適切に説明されるのか、あるいは修正の時期的および機能的な特性によって説明されるのかを検討した。品質モデル(表5)から明確な結果のパターンが得られた。修正の総数は翻訳の質を有意に予測しなかったが(b = 0.04, 95% CI [-0.06, 0.14], p = 0.412)、修正のタイミングと修正機能はどちらも有意な予測因子であった。具体的には、遅延修正率(b = 1.12, 95% CI [0.39, 1.85], p = 0.003)、談話レベルの修正(b = 1.76, 95% CI [0.96, 2.56], p < 0.001)、および文化的適応の修正(b = 2.04, 95% CI [1.14, 2.94], p < 0.001)はすべて、翻訳の質と正の相関を示した。対照的に、表層的な修正は、わずかではあるが統計的に有意な負の相関を示した(b = -0.63, 95% CI [-1.18, -0.08], p = 0.028)。
これらの知見は、修正回数のみでは、生産的なリフォーミュレーション(言い換え)と不安定なドラフティング(下書き段階の試行錯誤)を区別できないことを示しています(図5)。翻訳スクリプトの質的な検討により、この解釈が裏付けられました。スコアの低い翻訳では、修正が局所的な語彙の置換や文法的な訂正に集中する傾向があり、中国語の叙述的な手がかりと英語の修辞的フレーミングとの間の深い不一致は解消されていませんでした。一方、スコアの高い翻訳では、後段階の修正において、情報の構造を再編成し、選択的な明示化を行い、あるいは国際的な読者のアクセシビリティを高めるために評価的な表現を調整するといった操作が頻繁に見られました。「この表現は非常に中国的である」、「背景の説明が必要である」、「海外の視聴者はこの言及を理解できない可能性がある」といった代表的な翻訳済み弾幕コメントは、対応するセグメントクラスターに関連する、文化的に顕著な視聴者の懸念事項の例を示しています。これらの例はあくまで解釈を容易にするために提示されたものであり、参加者の意図の証拠として解釈されるべきではありません。
弾幕の顕著性と翻訳ボトルネックの重複
最終分析では、弾幕コーパスにおいて公的に顕著なセグメントが、翻訳中に最大の処理負荷を発生させたセグメントと重複しているか examined 検討した。各セグメントについて、初回ポーズ時間、長時間ポーズの頻度、および修正密度を標準化して合算し、複合的な負荷指標を算出した。この複合負荷指標に基づいた上位20%のセグメントを、弾幕の顕著性によってランク付けされた上位20%のセグメントと比較した。
重複は相当なものであり、最も努力量が高い9つのセグメントのうち6つが、最も弾幕的に顕著な9つのセグメントの中にも現れ、重複率は66.7%に達しました。上位20%の比較はわずか9つのセグメントのみを対象としていたため、ウィルソン信頼区間は比較的広く(95% CI 約 35.4%–87.9%)なりました。それにもかかわらず、正確な偶然重複分析によれば、ランダムな割り当てにおいて6つ以上のセグメントが重複することは考えにくいことが示されました(p ≈ .001)。セグメントレベルでは、弾幕的な顕著性と複合的努力指数との間に正の相関が認められました(Spearman's ρ = 0.41, p = 0.006)。重複したセグメントの多くはテキストBおよびCに発生しており、文化的に埋め込まれた参照、デジタル起業、および評価的なポジショニングに集中していました。これらの知見は、パブリックディスコースが、物語の意味が特に顕著になる箇所を示す外部指標として機能することを示唆していますが、その関係性は因果関係ではなく相関関係にとどまっています。
まとめると、これらの知見は、中国を題材としたナラティブの翻訳における処理努力がセグメント特異的であり、主に文化的負荷、ナラティブの圧縮度、および評価密度の影響を受けることを示している。翻訳の質は、全体的な修正量ではなく、遅延的に行われ、ディスクルスに敏感で、かつ文化的に方向付けられた修正戦略に依存している。最後に、高い処理努力を要した翻訳セグメントと弾幕で注目度の高かったナラティブ上のポイントとの間に見られた整合性は、視聴者の注目度と翻訳者の処理努力との間に連想的な関係があることを支持しており、弾幕による注目度自体が翻訳の困難さを引き起こすとまでは示唆していない。
データの可用性:
すべての生データ、キーストローク・ロギング・ファイル、処理済みのセグメントレベルの観察結果、セッションレベルの観察結果、弾幕ビデオのメタデータ、および最初に表示された5,000件の弾幕コメントは、再現データセット・ワークブックに提供されています。18,642件のコメントを含む完全な弾幕コメントファイルは、データセット・パッケージとともに保存されています。データセットは、Zenodoリポジトリ(https://doi.org/10.5281/zenodo.19289665)からアクセス可能です。
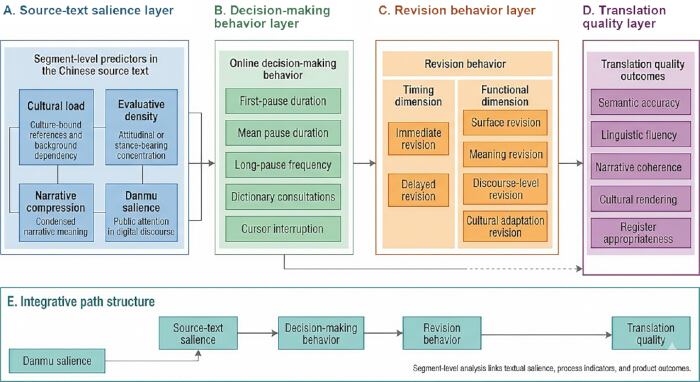
図 1: 本研究の概念的枠組み。 (A) 文化的な負荷、評価密度、ナラティブ圧縮、および弾幕サリエンスを含む、セグメントレベルのテキスト予測因子。 (B) 初回ポーズ時間、平均ポーズ時間、長時間ポーズ頻度、辞書参照、およびカーソル中断を含む、オンラインでの意思決定行動を操作化するために使用されたプロセス指標。 (C) 修正タイミングと修正機能に基づく、修正行動の二次元分類。 (D) 翻訳品質を評価するために使用された5つの次元:意味的正確性、言語的流暢さ、ナラティブの整合性、文化的表現、およびレジスターの適切性。 (E) 原文のサリエンス、意思決定行動、修正行動、および翻訳品質の間の関係を示す全体的な分析枠組み。ここで、弾幕サリエンスは意味的な視聴者の顕著性の外部指標として機能する。本研究では、探索的因子分析(EFA)または構造方程式モデリング(SEM)は実施しておらず、提示もしていない。 この図の拡大版を表示するには、ここをクリックしてください。
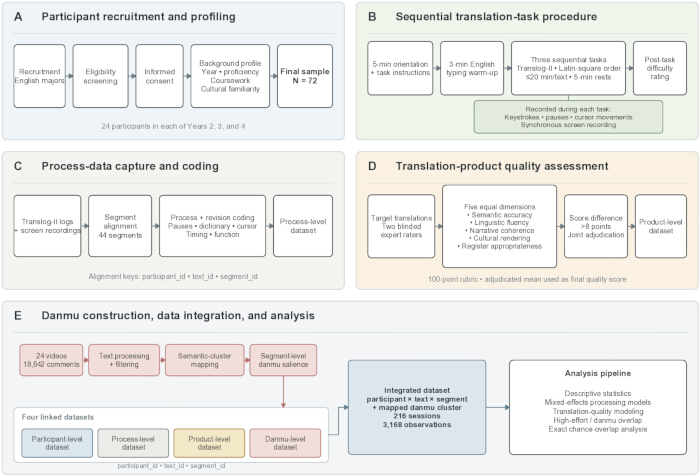
図 2: データ収集およびデータアライメントのワークフロー。 (A) 参加者の募集、適格性スクリーニング、インフォームドコンセント、および背景情報の収集。 (B) 標準化された実験条件下での、Translog-IIを用いた3つの翻訳タスクの実施。 (C) キーストローク、ポーズ、カーソル移動、修正エピソード、および同期された画面録画を含むプロセスデータの収集。 (D) 翻訳成果物の専門家によるブラインド評価と、それに続くスコアリングの不一致に関する裁定。 (E) 補助的な弾幕(danmu)コーパスの構築、および参加者、テキスト、セグメント、プロセス、成果物レベルのデータセットとのアライメントによる、推論分析に使用される最終的な統合データセットの生成。こちらのリンクをクリックして、この図の拡大版を表示してください。
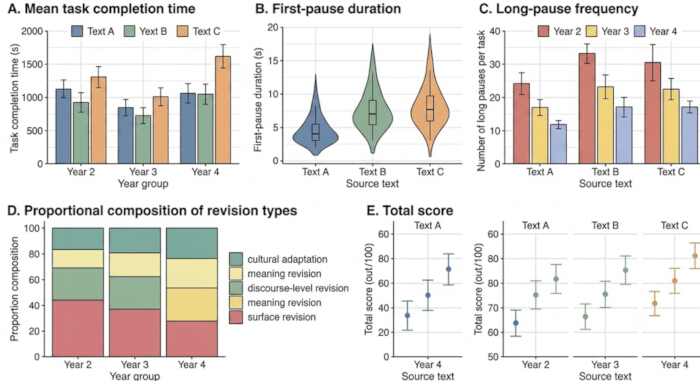
Figure 3: 学年およびソーステキスト別のプロセスおよびプロダクト尺度の分布。(A) ソーステキストおよび学年別の平均タスク完了時間。(B) 3つのソーステキストにおける初回休止時間の分布。(C) ソーステキストおよび学年別の長時間休止頻度。(D) 表面的修正、意味的修正、談話レベルの修正、および文化的適応修正を含む、学年別の修正カテゴリーの比例分布。(E) 各ソーステキストに対する学年別の翻訳品質合計スコア。全体として、これらのパネルは、学年が高くなるにつれて処理の中断が少なくなり、より選択的な修正戦略が用いられ、翻訳品質が向上すること、また、テキストBおよびCはテキストAよりも処理負荷が高いことを示している。こちらのリンクをクリックして、この図の拡大版を表示してください。
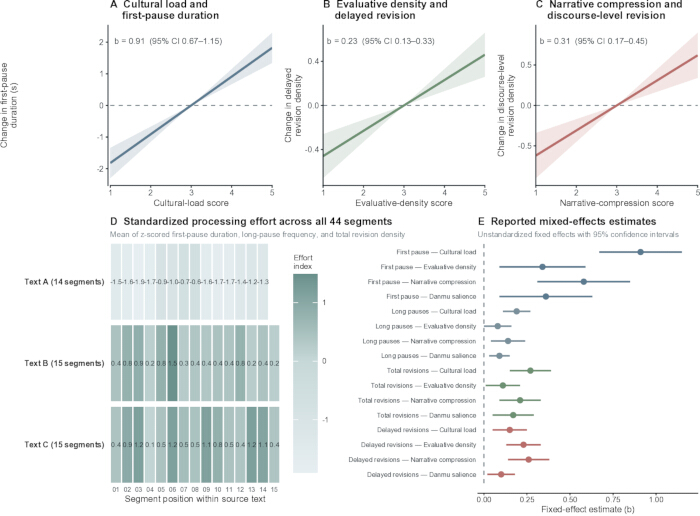
図4: セグメントレベルのテキストの顕著性が翻訳プロセスの行動に及ぼす影響。 (A) 初回ポーズ時間に対する文化的負荷の適合周辺効果。 (B) 遅延修正密度に対する評価密度の適合周辺効果。 (C) ディスコースレベルの修正密度に対する叙述的圧縮の適合周辺効果。 (D) すべての原文セグメントにおける標準化された処理負荷指標のヒートマップ(原文別にグループ化)。 (E) 混合効果回帰モデルから推定された標準化固定効果係数。本図は、異なるテキスト特性がそれぞれ異なる処理経路を活性化させ、文化的負荷、評価密度、および叙述的圧縮が、部分的に異なるメカニズムを通じて躊躇や修正に寄与していることを示している。 この図の拡大版を表示するには、ここをクリックしてください。
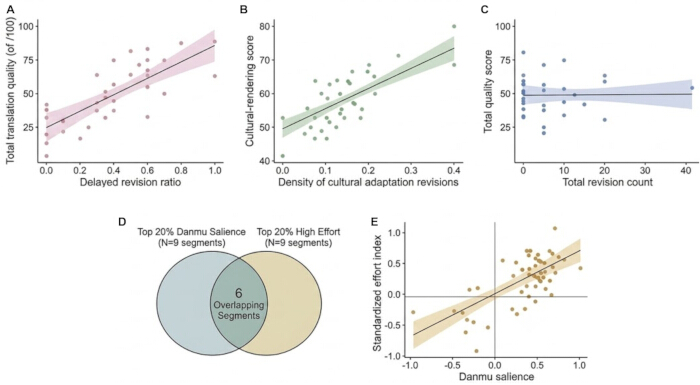
図 5: 翻訳プロセス、翻訳品質、および弾幕の顕著性の関係。(A) 遅延修正率と翻訳品質総合スコアの関連性。(B) 文化適応への修正と文化表現スコアの関係。(C) 総修正回数と全体的な翻訳品質の関連性であり、修正量のみでは予測価値が限定的であることを示している。(D) 弾幕の顕著性が高い上位 20% のセグメントと、翻訳労力が高い上位 20% のセグメントの重複。(E) 弾幕の顕著性と標準化された処理労力指標のセグメントレベルでの関連性。これらのパネルを総合すると、優れた翻訳パフォーマンスは、単なる修正量ではなく、戦略的なタイミングで機能的に焦点を当てた修正に関連していること、また、公に顕著な物語セグメントは翻訳のボトルネックと一致する傾向があることが示されている。ここをクリックして、この図の拡大版を表示してください。
| テキストID | ナラティブのトピック | 漢字 | セグメント数 | 文化的負荷スコア (1–5) | 評価密度スコア (1–5) | ナラティブ圧縮スコア (1–5) | 予測困難度 | バリデーションノート |
| テキスト A | 春節の帰省物語 | 212 | 14 | 3 | 2 | 3 | 中程度 | 参加者ではない学生12名を対象にパイロットテストを実施した |
| テキスト B | 端午節の記憶に関する叙述 | 219 | 15 | 5 | 3 | 4 | 高 | 非参加学生12名を対象にパイロットテストを実施した |
| テキストC | 農村ライブ配信と郷土開発のナラティブ | 223 | 15 | 4 | 5 | 4 | 高 | 非参加者の学生12名を対象にパイロットテストを実施した |
表 1:ソーステキストのプロファイルとセグメント構造。
| 変数 | レベル | 操作的定義 | 測定単位 |
| 初回ポーズ時間 | セグメント | セグメント開始から目的言語の最初の該当キーストロークまでの時間 | 秒 |
| セグメント内平均休止時間 | セグメント | セグメント内におけるすべての休止の平均持続時間 | 秒 |
| 長休止頻度 | セグメント | 2秒以上の休止回数 | 計測 |
| 辞書照会 | セグメント | セグメント処理中のディクショナリウィンドウ活性化回数 | 計数 |
| カーソルの断続的な動作 | セグメント | 安定した完了に至るまでに、カーソル操作によって線形ドラフティングから逸脱した回数 | 計数 |
| 即時改訂 | セグメント | 起稿前に行われた修正が、現在のローカルテキスト領域を超えています。 | 計数 / 密度 |
| 遅延再手術 | セグメント | 下書きが後半のテキスト領域まで進んだ後に行われた修正 | 数 / 密度 |
| 表面修正 | 校閲機能 | 意味的な変化を伴わない形式レベルの修正 | 数 / 密度 |
| 意味の修正 | 校閲機能 | 意味表現に影響を及ぼす語彙的または構文的な変更 | 計数 / 密度 |
| 談話レベルの推敲 | 校閲機能 | 節の関係性、一貫性、または情報の順序の調整 | カウント / 密度 |
| 文化的適応の修正 | 校閲機能 | ターゲット層に合わせたリフレーミング、または文化固有の意味の明確化 | 計数 / 密度 |
| 複合努力指数 | セグメント | 初回ポーズ持続時間、長時間ポーズ頻度、および修正密度の標準化複合指標 | zスコア |
| 弾幕の顕著性 | セグメント / 意味的クラスター | 正規化されたキーワードクラスター頻度、コメント集中度、および評価強度に基づく、重み付き意味論的クラスタープロキシ | 連続スコア |
表2:プロセス変数の操作的定義。
| 評価項目 | スコア範囲 | 採点重点 |
| 意味的正確性 | 1-20 | 原文の意味への忠実さ、転送内容の精密さ、および重大な歪みのなさ |
| 言語的流暢さ | 1-20 | 文法的な正しさ、自然さ、慣用的な表現、および文章レベルの読みやすさ |
| 叙述の一貫性 | 1-20 | 情報の流れ、節の連結、展開、およびテキストの安定性 |
| 文化的表現 | 1-20 | 文化依存的な言及の処理、明示化、フレーミング、および解釈のしやすさ |
| レジスターの適切性 | 1-20 | 想定読者への適合性、スタイルの妥当性、およびトーンの制御 |
表3:翻訳品質評価ルーブリック
| セクション | 変数 | 2年次 (n = 24), 平均 ± SD | 3年次 (n = 24), 平均 ± SD | 4年次 (n = 24), 平均 ± SD |
| 参加者レベルのセッションプロファイル | タスク完了時間 (sec) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| 参加者レベルのセッションプロファイル | 平均初回ポーズ時間 (sec) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| 参加者レベルのセッションプロファイル | タスクあたりの長時間ポーズ回数 | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| 参加者レベルのセッションプロファイル | タスクあたりの総修正回数 | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| 修正構成 | 遅延修正率 | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| 修正構成 | 談話レベルの修正率 | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| 修正構成 | 文化的適応修正率 | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| 修正構成 | 表層修正率 | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| 成果物の品質 | 総品質スコア | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| 成果物の品質 | 文化的表現スコア | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
表 4:プロセスおよび製品変数の記述統計。
| アウトカム変数 | 予測因子 | b | 標準誤差 | 95%信頼区間 | t/z | p |
| 初回の休止時間 | 文化的負荷 | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| 初回ポーズ時間 | 評価密度 | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| 初次ポーズ持続時間 | ナラティブ圧縮 | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| 初発休止時間 | 弾幕の顕著性 | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| 長休止頻度 | 文化的負荷 | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| 長休止頻度 | 評価密度 | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| 長時間休止頻度 | ナラティブ圧縮 | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| 長時間休止頻度 | 弾幕の顕著性 | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| 全改訂密度 | 文化的負荷 | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| 全改訂密度 | 評価密度 | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| 全改訂密度 | ナラティブ圧縮 | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| 全改訂密度 | 弾幕の顕著性 | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| 遅延修正密度 | 文化的負荷 | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| 遅延修正密度 | 評価密度 | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| 遅延改訂密度 | ナラティブ圧縮 | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| 遅延改訂密度 | 弾幕の顕著性 | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| 総合品質スコア | 全修正 | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| 総合クオリティスコア | 遅延修正率 | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| 総合品質スコア | 談話レベルの修正 | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| 総合品質スコア | 文化的適応に伴う修正 | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| 総合品質スコア | 表面修正 | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| 総合品質スコア | 学年 | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
表5:セグメントレベルのプロセス挙動および翻訳品質を予測する混合効果モデル。
ディスカッション
本研究の結果は、中国をテーマとした叙述の中国語から英語への翻訳における困難さが、テキスト全体に均等に分布しているわけではないことを示している。むしろ、文化的参照、評価的なスタンス、および凝縮された物語的意味が収束するセグメントに集中している。これは、翻訳の困難さが語彙不足によるものではなく、プロセスに基づいたものであるという視点を支持するものである。翻訳プロセスの実証的研究では、翻訳とは、ためらい、方向付け、および産出が不均等に分布する時間的に組織化された活動であることが強調されている19。本研究で観察された労力の集中は、特定のセグメントがより大きな解釈上のプレッシャーを与え、他の部分よりも線形的な下書き作業を著しく妨げることを反映している。仮説検証の結果は次のように要約できる。文化的負荷が初期のためらいと修正密度を増加させたため、H1は支持された。評価的な密度と物語的凝縮は異なる修正経路を通じて作用したため、H2は精緻化された。修正のタイミングと機能が、総修正回数よりも強く品質を予測したため、H3は支持された。そして、弾幕(danmu)の顕著性と高負荷セグメントの間には、因果関係ではなく連想的な重複が認められたため、H4は支持された。
修正行動に関して、データは、総修正回数が翻訳の質を予測するものではないことを明らかにしている。むしろ、遅延的な修正、ディスクルスレベルの修正、および文化的適応のための修正が、パフォーマンス向上を導く主因となっている。この区別は、修正が単なる繰り返しの局所的な修正ではなく、構造化された再評価として実行された場合にのみ生産的であることを示唆している。タスクが困難になった際に初学者翻訳者が努力の配分を変えることを示すアイトラッキングおよびキーストローク・ロギングの研究と整合するように、本研究における成績優秀な学生は、単に活動的であったわけではない7。彼らは暫定的な解決策を選択的に中断し、後の段階でそれらを再評価し、物語上の適合性や文化的適合性に向けた修正を行った。その結果、同程度の最終スコアが大きく異なるプロセス軌跡から得られることが多いため、成果物のスコアだけでは翻訳者のパフォーマンスを説明するには不十分である9。
この現象は、努力の転換(effort conversion)という視点から最もよく理解できます。得点の低い翻訳では、認知的な努力が局所的なレベルにとどまっていました。つまり、学生は途中で立ち止まり、語彙の置き換えや冠詞の調整などは行ったものの、原文の含意と訳文の構成との間にあるより深い不整合を解消することはできませんでした。対照的に、得点の高い解答では、努力がターゲット読者に向けてテキストを最適化するための構造的な決定へと転換されていました。学生のポストエディット性能に関する研究と並行して、これらの結果は、プロセスの努力が自動的に有益になるわけではなく、その価値は解釈可能なテキストの改善へと転換されるかどうかにかかっていることを裏付けています20。
さらに、異なるテキスト特性はそれぞれ異なる処理メカニズムを活性化させます。文化的負荷は、初期の躊躇と修正密度の増加に確実に寄与した一方で、ナラティブの圧縮は談話レベルの修正を強く予測しました。この区別により、翻訳プロセスにおいて困難なセグメントがそれぞれ異なる形で現れる理由が明確になります。すなわち、あるものは初期の定式化段階で認知的なアクセスを妨げ、またあるものは、より広範な談話にわたる一貫性の維持においてのみ問題となるということです。困難なテキストほど処理単位が小さくなり、中断が密になることを示した研究と一致して、これらの知見は、圧縮された文化的・評価的な意味が、翻訳者に局所的な表現とグローバルなナラティブのフレーミングの間での反復的な往復を強いることを強調しています8。
本研究の重要な手法的な貢献は、視聴者のディスクール層として弾幕のサリエンス(顕著性)を統合した点にある。労力の大きい翻訳セグメントと弾幕のサリエンスが高いセグメントとの間に大幅な重複が見られることは、学生が直面するボトルネックが、デジタル流通において視聴者の高い関心を引く点としばしば一致していることを示している。これにより、翻訳の困難さと参加型ディスクールを、2つの構成概念を混同させることなく結びつけることができた。弾幕コメントは、ビデオを介した流通において視聴者が何に注目し、あるいは何に異議を唱えるかを明らかにする一方、キーストロークおよび修正記録は、学生翻訳者が原文の意味的に関連するセグメントをどのように処理するかを明らかにする。したがって、最も妥当な解釈は「共通の手がかり」による説明である。すなわち、文化的に負荷の高い参照、圧縮された背景的仮定、および評価的なポジショニングが、視聴者の注意を引きつけると同時に、翻訳者の処理負荷を高める可能性があるということである21。
教育学的観点から見ると、この重複は、中国に焦点を当てたナラティブが、即時性、分かりやすさ、および聴衆との整合性といった相反する優先事項に支配され、意味が公的にかつ迅速に交渉される文脈で流通していることを示唆している22。したがって、翻訳者教育は、校正を単なる一般的な校閲段階として捉えるのではなく、機能的かつ時間的に戦略的な介入を強調する方向へと移行しなければならない。観察されたボトルネックは、単に用語のみによって生じたことは稀であり、ナラティブの意味が文化的に根ざした前提条件、関係性のフレーミング、および聴衆への選択的なアクセスに依存している箇所で発生していた。中国の民族ナラティブ文学の普及と同様に、これらのナラティブを転移させるには、単なる語彙的な忠実さを超えて、より広範なグローバルな流通のために地域の文化的意味をどのように再構成すべきかを判断することが求められる23。この手法は、キーストロークログ、画面録画、および聴衆のディスクルス例を用いることで、学生が単純な語彙の置換ではなく、どのセグメントに明示化、順序の変更、文化的フレーミング、またはレジスターの調整が必要であるかを特定できるようにし、翻訳者教育に応用することができる。
これらの知見の解釈には、いくつかの限界がある。第一に、弾幕のサリエンス(顕著性)は視聴者のエンゲージメントを示す意味的クラスターのプロキシ(代替指標)であり、言語的な困難さを直接的に測定したものではないため、本研究の相関設計では、公的なサリエンスと翻訳上の労力の間の因果関係を立証することはできない。今後の研究では、文化的な負荷、評価的な密度、および物語的な圧縮を実験的に操作し、因果経路を検証することが考えられる。第二に、サンプルが1つの大学の翻訳見習い学生に限定されており、参加者の経験、文化的親近感、および第二言語習熟度は、完全な層化抽出ではなく統計的に制御されていた。専門翻訳者や複数の機関の学生、またより幅広い習熟度レベルを対象とした再現研究を行うことで、一般化可能性が高まるだろう。第三に、原文はタスクを調整するために研究者が作成し、パイロットテストを行ったものであるが、今後の研究では、実際の公開テキストや独立した教材開発パネルを用いたさらなる検証を含めるべきである。第四に、文化的負荷、評価的な密度、物語的な圧縮、および修正機能のコーディングは、透明性のある操作的定義、独立したコーダーによる記録、および裁定済みのコーディングファイルとともに検証可能な評定者間信頼性に依存している。また、今後の研究では、キーストローク・ロギングにアイトラッキング、回顧的インタビュー、思考発話プロトコル、またはポストエディットタスクを組み合わせることで、修正決定の根底にある認知メカニズムを三角測量的に分析できる可能性がある。
最終的に、本研究は中国に関する物語の中国語から英語への翻訳における、学生のパフォーマンスのプロセス的な根拠を明らかにしています。キーストローク・ロギングデータ、成果物の評価、およびデジタル・オーディエンスのディスクールを関連付けることで、翻訳のボトルネックが、公的に機微な意味を持つ物語の箇所で発生することが示されました。異文化間翻訳における決定的な要因は、単なる修正の量ではなく、解釈的な再構成を必要とするセグメントを認識し、オーディエンスに適した安定した解決策が策定されるまで戦略的に完了を遅らせる翻訳者の能力であると考えられます。
開示事項
著者らは 開示すべき事項はありません。
著者貢献
Weijia Chen:概念化、方法論、形式的解析、調査、原案執筆。
Chunming Wu: 研究デザイン、形式的解析およびデータ処理手順に関する指導、ならびに査読者のコメントに応じた修正案の検討およびフィードバック。
謝辞
本研究は、Hanshan Normal Universityからの2つの助成金による財政的支援を受けて実施されました。具体的には、「Theory and Practice of Chinese–English Translation II」に関する2023年度第一級学部課程(オフライン第一級コース)プログラム(承認番号:YHS [2023] 172)の段階的な研究成果を構成しています。さらに、本研究は「Chinese–English Translation」のカリキュラムベースの思想政治教育モデルコースとして指定された、2025年度教育品質および教育改革プロジェクト(承認番号:YHSJ〔2025〕126)の支援を受けています。著者らは、本研究の完了に向けて提供された機関による支援に深く感謝いたします。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Bilibili弾幕コーパス | Bilibili | 24 videos; 18,642 comments;https://www.bilibili.com | 補助弾幕コーパスの構築およびセグメントレベルの弾幕顕著性の算出 |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | データのクリーニング、コーディングの整理、および予備的なデータ管理 |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | 混合効果モデルの構築、相関分析、および図の作成 |
| 画面録画ソフトウェア | Laboratory workstation | Local workstation utility; no catalog number | 非線形修正エピソードの検証およびプロセスデータのバックアップ |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | 記述統計、ANOVA、および基本的な統計分析 |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | 翻訳タスク中のキーストローク・ロギングならびにポーズ、カーソル移動、修正エピソードの記録 |
参考文献
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.