本手法では、制御されたクラウド環境内で合成ヘルスケアデータセットを活用し、安全なヘルスケアクラウドデータ移行を可能にする、包括的な説明可能な人工知能(XAI)ベースのフレームワークを提示します。その結果、ゼロトラストセキュリティ、時間ベースのアクセス制御、および説明可能な異常検知を組み合わせ、移行の透明性とセキュリティをサポートするプロトタイプが構築されました。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
ヘルスケアシステムにおいて、クラウドへのデータ移行がますます増加していますが、同時にデータ転送時がセキュリティ上の最大のリスクとなる局面も増えています。本論文では、合成ヘルスケアデータセットと制御されたクラウド環境を用いた、説明可能な人工知能(XAI)ベースのセキュアなクラウドデータ移行のための再現可能なプロトコルについて記述します。開発したフレームワークは、ゼロトラストアーキテクチャ、時間的最小権限、暗号化通信、集中監視、および説明可能な異常検知を統合し、より安全で透明性が高く、監査可能な移行を実現します。テストには、28個のリレーショナルテーブルにわたる約2,000万件のレコードで構成される10 GBの合成電子健康記録データセットを使用しました。移行プロセスは、Amazon web services (AWS) 上でPostgreSQLデータベースとプライベート仮想ネットワークを用いて実施されました。異常検知にはIsolation Forestが利用され、セキュアなイベント解釈にはShapley additive explanations (SHAP) が用いられました。このフレームワークは、資格情報の露出時間、インシデント検知時間、異常検知精度、移行レイテンシ、およびデータ完全性などの指標を用いて、10回の独立した移行試行で評価されました。テストした構成において、資格情報の露出時間は24 hから1 hに短縮され(95.8%の削減)、異常検知の精度は97.4%、インシデント検知時間は約15 minまで短縮され、チェックサム検証によって100%のデータ完全性が維持されました。一方で、セキュリティ対策を強化したことにより、平均移行レイテンシは11%増加しました。これらの結果は、ヘルスケアデータの管理において、説明可能なAIをセキュアなクラウド移行ワークフローに統合することの有効性を示しています。
概要
クラウドコンピューティングは現在、世界中のヘルスケアシステムに不可欠な要素となっており、拡張可能なストレージや計算リソースの提供に加え、クラウドを介した健康記録の交換、意思決定システムのサポート、およびヘルスケア分析の実現を可能にしています1,2,3。多くの医療機関が情報システムを刷新する中で、旧来のオンプレミスシステムに保持されていた機密性の高い健康データをクラウドへ移行することは、極めて重要なステップとなっています4。適切な移行は、データの検索を容易にし、より効率的な運用を可能にし、より高度なインテリジェンスを備えた分析をサポートしますが、同時に、データをある場所から別の場所へ移動させることで生じる、極めて深刻なセキュリティおよびプライバシーのリスクを無視することはできません5。
移行フェーズは、プロセスの性質上、ヘルスケアデータがシステムやネットワークを介して能動的に移動されるため、データライフサイクルの中で極めて脆弱な局面であることで知られています6。さらに、移行フェーズにおいては、認証情報のハッキング、不正アクセス、データの傍受、操作スキーム、さらにはデータ損失などの脅威にさらされる可能性があります6,7。患者情報は極めて機密性が高く、そのため規制およびセキュリティ対策に対する最高レベルの準拠が求められるため、ヘルスケア環境はこうしたリスクに対してより脆弱です8,9。移行ワークフローがセキュアであり、かつ観測可能にならなければ、データの機密性、完全性、および責任を保証することは不可能です10,11。
クラウドセキュリティを向上させるため、多くのセキュリティフレームワークや標準が開発されてきました。例えば、米国国立標準技術研究所(NIST)のゼロトラストアーキテクチャは、ユーザー、デバイス、およびサービスの常時検証を基本としており12、一方でクラウド導入フレームワークは、ガバナンス、アイデンティティ管理、暗号化、およびモニタリングに関する指針を提供しています13。実際、今日のクラウドセキュリティ手法は、自動化、Infrastructure-as-Code(コードによるインフラ定義)、および継続的なモニタリングに重点を置いています14,15。これらのアプローチは価値あるセキュリティ原則に基づいたものですが、多くの場合、移行プロセスそのものではなく、一般的なクラウド展開および運用環境を対象としています16。実際には、アイデンティティ管理、安全なデータ転送、検証、モニタリング、および移行後のハードニングを組み合わせた、安全なヘルスケアクラウドデータ移行ワークフローを実行するための、段階的で詳細かつ再現可能な手順はほとんど示されていません17。
機械学習による異常検知は、クラウド環境のセキュリティ監視における有用な技術として認識されています。これにより、システム活動の異常や潜在的なセキュリティインシデントを検出することが可能です18。しかし、多くの異常検知手法はクローズドなシステムであり、セキュリティイベントがフラグ立てされた根拠についての説明を提供できないという課題があります19。システムによる決定を説明できないことは、管理者の信頼性を低下させ、監査を困難にし、高度に規制されたヘルスケア環境における自動セキュリティ決定の価値を減少させます20。SHapley Additive exPlanations (SHAP) や Local Interpretable Model-agnostic Explanations (LIME) などの説明可能な人工知能 (XAI) 手法は、機械学習の予測に対する明確な説明を提供するだけでなく、セキュリティ監視システムにおける理解、責任、および信頼性を向上させます21,22。
クラウドセキュリティと説明可能なAI(explainable AI)は大きな進歩を遂げましたが、統合を目的とした安全な移行制御と説明可能なセキュリティ監視を組み合わせた、再現性のある実験プロトコルは依然として不足しています23。既存の研究の多くは、暗号化、アクセス制御、異常検知、またはクラウドガバナンスなど、単一のコンポーネントのみを扱っており、体系的に実装、評価、および再現が可能な統合された手法を提示しているものは皆無です24。さらに、ゼロトラストセキュリティ原則、一時的な最小権限、集中型オブザーバビリティ、および説明可能な異常検知を、単一のヘルスケアクラウド移行ワークフローに統合しようと試みた研究はほとんどありません25,26
本論文では、この空白を埋めるために、ヘルスケアシステムにおける安全なクラウドデータ移行のための説明可能なAI(Explainable AI)ベースのフレームワークを導入します。提案されたアーキテクチャは、ゼロトラストモデル、時間制限付きアクセス、安全な通信、中央集中型のロギングおよびモニタリング、そしてSHAPに基づく解釈可能な異常検知を、適切に順序立てられた移行プロセスの中で活用しています27,28。このプロトコルは、実験条件下で安全なヘルスケアデータの移行を実装、モニタリング、および評価するためのステップバイステップのガイドです。セキュリティコントロールとAIによる解釈可能なモニタリングを統合することで、提案されている本フレームワークは、移行ライフサイクル全体における透明性、監査可能性、およびセキュリティのレベルを向上させることを目的としています29,30。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、セキュアなクラウドデータ移行の実験的評価のために生成された完全合成のヘルスケアデータセットを使用しました。実際の患者データ、保護健康情報(PHI)、または個人を特定可能なヘルスケア記録は使用していません。したがって、施設審査委員会(IRB)の承認およびインフォームドコンセントは不要でした。本研究で使用したすべての材料は、材料表に含まれています。
1. 概要
- ソースレイヤー、移行ハブレイヤー、ターゲットレイヤー、ネットワークレイヤー、アイデンティティおよびアクセス管理レイヤー、オブザーバビリティレイヤー、および説明可能なAIレイヤーで構成されるセキュアなクラウド移行環境を構築します。
- セキュアなヘルスケアデータの移行をサポートするため、すべてのコンポーネントを隔離されたクラウド環境内にデプロイします。すべてのシステムコンポーネント間に暗号化された通信チャネルを確立します。
- データセットの準備、環境設定、アーキテクチャのデプロイ、セキュアな移行、異常モニタリング、および移行後の検証という手順でプロトコルを実行します。提案する説明可能なAI駆動型セキュアクラウドデータ移行フレームワークの全体アーキテクチャを図1に示します。
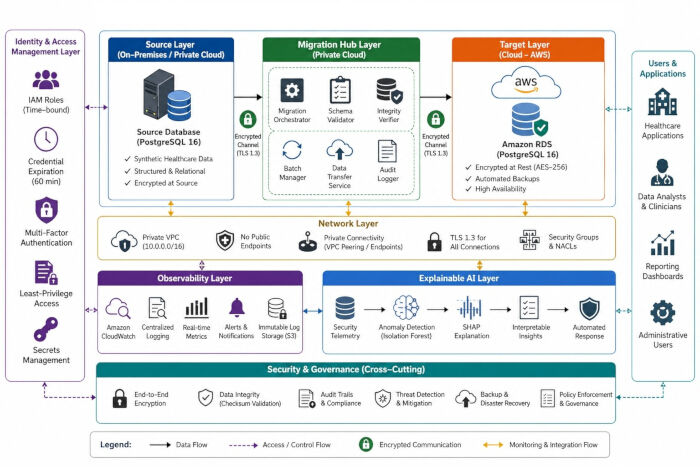
図 1:ヘルスケアシステム向けの説明可能な人工知能(XAI)有効化セキュアクラウドデータ移行フレームワークの全体アーキテクチャ。本フレームワークは、アイデンティティおよびアクセス管理レイヤー、ソースデータベースレイヤー、移行ハブレイヤー、ターゲットクラウドデータベースレイヤー、ネットワークセキュリティレイヤー、オブザーバビリティレイヤー、説明可能AIモニタリングレイヤー、および横断的なセキュリティおよびガバナンスサービスで構成される。このアーキテクチャは、時間的最小権限アクセス制御、TLS 1.3暗号化通信、チェックサムベースの整合性検証、継続的なセキュリティモニタリング、およびSHAPベースの説明可能性を統合し、セキュアで透明性が高く、再現可能なヘルスケアデータベース移行を実現する。本図は、著者がMicrosoft PowerPoint (Microsoft 365) を使用して作成した。こちらのリンクをクリックして、この図の拡大版を表示してください。
2. 計算環境の構築
- 計算環境の構築
- セキュアなクラウドデータ移行および説明可能なAI(XAI)ベースのモニタリングに必要な計算リソースを準備する。
- 材料表に記載されているすべてのハードウェア、ソフトウェア、クラウドサービス、データベース、セキュリティツール、および機械学習ライブラリをインストールし、設定する。移行実験を開始する前に、すべての必要コンポーネントが正常に動作していることを確認する。
- クラウド環境の設定
- ヘルスケアデータの移行に適したセキュアなクラウド環境を構築する。ソースシステム、移行ハブ、およびターゲットシステム間でシームレスな通信を行うため、プライベートVPCを設定する。データの保存時だけでなく、転送時にも強力な暗号化を使用する。
- 材料表に記載されている詳細に従って、ターゲットデータベースおよび移行サービスを準備する。
- アイデンティティおよびアクセス管理(IAM)を設定し、モニタリングおよびロギングサービスを構築する。
3. データセットの準備と記述
- 材料表に記載されているFaker Pythonライブラリを用いて、合成ヘルスケアデータセットを生成します。患者の年齢、性別、民族、地理的場所などの人口統計学的属性を、事前定義された確率分布を用いて設定してください。
- 現実的な臨床的関係性を維持しつつ、診断、検査結果、薬剤、アレルギー、処置、および入院歴を含む臨床情報を生成してください。
- 事前定義された受診頻度分布に従って、個々の患者に複数の受診を割り当てることで、縦断的な患者エンカウントを生成します。
- 時系列のイベント順に基づき、入院、臨床検査、薬剤投与、退院サマリー、および監査ログのタイムスタンプを生成します。
- 事前定義されたデータ品質分布に従って、臨床的に現実的な欠損値、重複レコード、および外れ値観測値を導入する。
- すべての個人識別情報を、Fakerライブラリを用いて生成した合成値に置換してください。データセットをエクスポートする前に、参照整合性と論理的整合性を検証してください。検証済みデータセットをPostgreSQL互換のSQL形式でエクスポートしてください。データセットは、現実的なヘルスケア移行シナリオをサポートするように構成してください。生成されたデータセットの特性は、以下にまとめられています。 表1.
- データベースのリレーションを定義します。patientテーブルの主キーとしてPatient_IDを割り当てます。patient、visit、laboratory、medication、およびaudit-logの各テーブル間に外部キーリレーションを構築します。移行を開始する前に、すべてのテーブルにわたって参照整合性を検証してください。
- 現実的なヘルスケアデータの特性をシミュレートします。患者の年齢は正規分布を用いて生成してください。受診頻度はポアソン分布を用いて生成してください。現実世界の電子健康記録(EHR)における不完全性をシミュレートするため、5%の割合で欠損値を導入してください。移行前に、すべての患者識別子をハッシュ値に置換してください。生成されたすべてのレコードが、事前定義されたスキーマ制約に準拠していることを検証してください。
- 移行前に、スキーマの一貫性、参照整合性、欠損値、重複レコード、および定義済みの品質制約を確認し、生成されたデータセットを検証してください。
| パラメータ | 値 |
| データセットの種類 | 合成ヘルスケアEHRデータセット |
| データセットサイズ | 10 GB |
| 総レコード数 | 2,000万件 |
| テーブル数 | 5つのコアテーブル、28のリレーショナルテーブル |
| 患者レコード | 5,000,000 |
| 受診レコード | 10,000,000 |
| 検査結果 | 4,000,000 |
| 投薬レコード | 3,000,000 |
| 監査ログ | 5,000,000 |
| 主キー | Patient_ID |
| 欠損値率 | 5% |
| 年齢分布 | 正規分布 |
| 受診頻度 | ポアソン分布 |
| 整合性しきい値 | <0.1% の違反 |
表1:プロトコルの検証に使用した合成ヘルスケアデータセットの特性。本表では、セキュアな移行実験を再現するためのデータベースサイズ、リレーショナルテーブル数、総レコード数、患者属性、臨床変数、および検証特性など、データセットの概要を示しています。
4. システムアーキテクチャの展開
- ソース層、マイグレーションハブ層、ターゲット層、ネットワークセキュリティ層、オブザーバビリティ層、および説明可能なAI層からなるセキュアなクラウド移行アーキテクチャを構築します。本研究で用いた展開済みのシステムアーキテクチャを図2に示します。
- 本フレームワークは6つの動作層で構成されており、移行プロセス中に順次その機能を実行します。第1層であるソース層には、合成ヘルスケアデータベースが含まれています。
- マイグレーションハブは、スキーマ抽出、暗号化データ転送、整合性検証、および移行オーケストレーションを担います。ターゲット層は、移行されたデータベースがAmazon RDS PostgreSQLに保存される場所です。
- ネットワークセキュリティ層は、プライベートVPCエンドポイント、TLS 1.3暗号化、セキュリティグループ、およびネットワークアクセス制御リストを使用して、すべての通信を保護します。
- オブザーバビリティ層は、Amazon CloudWatchを用いて、認証ログ、移行ログ、データベースアクティビティログ、およびセキュリティイベントを常時収集します。
- 説明可能なAI層は、収集されたセキュリティテレメトリを取得し、Isolation Forestアルゴリズムで処理して、検出されたアノマリーに対するSHAPベースの説明を生成します。すべてのアーキテクチャ層は、移行ワークフロー全体を通じて認証されるプライベートネットワークチャネルを介して相互に通信します。
- 移行前にセキュアなアクセスとデータの可用性を確保するため、ソースデータベース環境を展開し、検証します。
- 合成ヘルスケアデータセットを含むPostgreSQL 16データベースをセットアップします。患者情報、受診詳細、検査結果、薬剤記録、および監査ログをソースデータベースに保持させます。
- データベースへのアクセスを、許可された移行サービスおよび管理者ユーザーのみに制限します。移行操作を開始する前に、データベースの可用性と接続性を検証します。
- スキーマ抽出、暗号化データ転送、および移行オーケストレーションを調整するようにマイグレーションハブを構成します。
- プライベートな仮想プライベートクラウド(VPC)内に専用の移行サーバーを展開します。スキーマ抽出、データ転送、および検証活動を調整するための移行オーケストレーションサービスを構成します。
- ソース環境とターゲット環境の間の互換性を検証するために、スキーマ検証サービスを有効にします。転送中および転送後に移行データの妥当性を検証するために、整合性検証サービスを有効にします。移行タスクを実行する前に、マイグレーションハブとデータベースシステム間の通信を確認します。
- ターゲット層を展開します。ターゲットデータベース環境としてAmazon RDS PostgreSQL 16を展開します。自動バックアップおよびリカバリサービスを有効にします。ターゲットデータベース内に保存されるデータに対してAES-256暗号化を有効にします。
- ネットワークセキュリティを構成します。移行リソースに関連付けられたすべてのパブリックIPアドレスを無効にします。VPC内のプライベートエンドポイント経由の通信のみを許可します。ネットワークアクセス制御リスト(NACL)とセキュリティグループを構成します。システムコンポーネント間のすべての通信にTLS 1.3暗号化を有効にします。公開アクセス可能なエンドポイントが残っていないことを検証します。
- セキュリティイベント、移行ログ、およびシステムパフォーマンスメトリクスを継続的に収集するための集中監視を構成します。
- Amazon CloudWatchのロギングおよびモニタリングサービスを有効にします。認証ログ、移行ログ、データベースアクティビティログ、およびセキュリティイベントログを収集します。ログの保持期間を365日に構成します。監査およびコンプライアンス要件をサポートするために、不変ログストレージを有効にします。リアルタイムのメトリクス収集とアラート生成を確認します。
- リアルタイムのアノマリー検出を行い、解釈可能なセキュリティ説明を生成するように、説明可能なAI環境を構成します。
- モニタリング環境内にアノマリー検出サービスを展開します。移行中に生成されるセキュリティテレメトリを処理するように、説明可能なAIフレームワークを構成します。ソース、マイグレーションハブ、ターゲットデータベース、およびモニタリングサービスからのセキュリティテレメトリストリームを接続します。
- リアルタイムのアノマリー検出とSHAPベースの説明生成を有効にします。移行実験を開始する前に、テレメトリデータの取り込みが正常に行われていることを検証します。
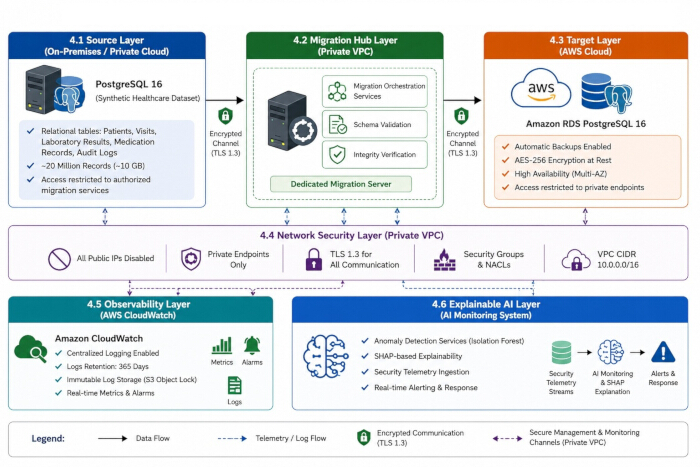
図 2: セキュアなヘルスケアクラウド移行フレームワークの展開アーキテクチャ。 展開環境は、合成ヘルスケアデータセットを含むソースPostgreSQLデータベース、プライベート仮想プライベートクラウド(VPC)内の専用移行ハブ、Amazon RDS PostgreSQLターゲットデータベース、ネットワークセキュリティレイヤー、Amazon CloudWatchによる集中型オブザーバビリティ、および説明可能な人工知能(Explainable Artificial Intelligence)モニタリングレイヤーを示している。すべての通信は、TLS 1.3暗号化で保護されたプライベートエンドポイントを通じて行われる。本図は、著者がMicrosoft PowerPoint (Microsoft 365)を用いて作成した。 こちらのリンクをクリックして、本図の拡大版を表示してください。
5. 安全な移行ワークフロー
注意:脅威モデリング、スキーマ転送、セキュアなデータ移行、移行検証、および移行後のハードニングを実行することで、セキュアな移行ワークフローを遂行してください。
- 移行プロセスを開始する前に、潜在的なセキュリティ脅威を特定し、適切な緩和策をマッピングします。
- 移行資産、潜在的な攻撃ベクトル、および現実的なサイバー攻撃シナリオを特定します。
- 認証トークンの侵害による認証情報の窃取、不正な管理権限へのアクセスを含む内部攻撃、以前に傍受された認証リクエストを標的としたリプレイ攻撃、暗号化された通信チャネルの傍受を試みる中間者(MITM)攻撃、移行中のデータベース構造の変更を目的としたスキーマ改ざん、および不正な管理権限の取得を目的とした特権昇格攻撃について評価します。
- 一時的な最小特権の認証情報管理を用いることで、認証情報の窃取および特権昇格攻撃を防止するのに十分であるかを確認します。TLS 1.3で暗号化された通信が、リプレイ攻撃および中間者攻撃から保護されていることを検証します。
- アイデンティティおよびアクセス管理(IAM)ポリシーによって、不正な管理アクセスが防止されていることを検証します。継続的な監査ログによって、セキュリティに関連するすべての移行活動の記録が保持されていることを検証します。SHA-256チェックサムによる確認で、スキーマまたはデータの不正な変更を検出できることを確認します。
- 説明可能な異常検知フレームワークが、不審な移行活動を特定でき、かつ解釈可能なセキュリティ説明を提供できることを検証します。特定された各脅威に対してセキュリティコントロールマップを作成します。データベースの移行を開始する前に、特定されたすべての脅威が十分に緩和されていることを検証します。著者は、脅威モデルとセキュリティコントロールをTable 2にまとめています。
- データベーススキーマを転送します。ソースのPostgreSQLデータベースからスキーマ定義を抽出します。ターゲットデータベース環境とのスキーマ互換性を検証します。テーブル構造、主キー、外部キー、インデックス、および制約を確認します。検証済みのスキーマ定義をターゲットデータベースにデプロイします。データを転送する前に、スキーマのデプロイが成功したことを確認します。
- 移行活動を継続的にモニタリングしながら、暗号化された通信チャネルを通じてヘルスケアデータを安全に移行します。
- 移行バッチサイズを1トランザクションあたり10,000レコードに設定します。TLS 1.3を用いて暗号化通信チャネルを確立します。仮想プライベートクラウド(VPC)内のプライベートネットワークエンドポイントを通じてデータを転送します。
- 失敗したトランザクションに対して、最大3回までの自動リトライ試行を有効にします。
データ転送のスループットを100 MB/sから150 MB/sの間に維持します。転送プロセス全体を通じて、移行活動を継続的にモニタリングします。すべての移行イベントを集中管理された監査ログに記録します。
- チェックサム、レコード数、およびデータベース構造を比較して、移行の完全性と整合性を検証します。
- 移行前にすべてのソーステーブルのSHA-256ハッシュ値を生成し、移行後にすべてのターゲットテーブルのSHA-256ハッシュ値を生成します。ソースとターゲットのチェックサム値を照合します。ソースとターゲットのデータベースの行数をクロスチェックします。スキーマ、テーブル間の関係、およびデータベース制約の一貫性を確認します。チェックサム値、レコード数、およびスキーマ構造がすべて同一である場合にのみ、移行が成功したとみなします。
- データ移行の正常完了後、一時的な権限を削除し、セキュリティコントロールを最終確定させます。
- 移行完了後、直ちにすべての一時的な移行認証情報を取り消します。サービスアカウントから昇格させた移行権限を削除します。監査ログとセキュリティモニタリング記録をアーカイブします。
- バックアップ手順が正常に完了したことを検証します。一時的な移行サーバーおよびサポートリソースを廃止します。移行後の環境について最終的なセキュリティレビューを実施します。移行結果と検証結果を文書化します。本研究で用いられた完全なセキュア移行ワークフローをFigure 3に示します。
| 脅威シナリオ | セキュリティコントロール | 検出方法 | 軽減 |
| 認証情報の窃取 | 時間的最小権限(Temporal Least Privilege: TLP) | IAMログ | 自動資格取消 |
| 内部攻撃 | ロールベースアクセス制御 (RBAC) | 監査ログ + SHAP | セッションの終了 |
| リプレイアタック | TLS 1.3 + ノンス検証 | ネットワークモニタリング | 重複リクエストの拒否 |
| 中間者攻撃(Man-in-the-Middle: MITM) | TLS 1.3暗号化 | 証明書の検証 | 暗号化通信 |
| スキーマ改ざん | SHA-256チェックサムおよびスキーマ検証 | 整合性検証 | 検証済みスキーマを復元する |
| 権限昇格 | IAMポリシーの適用 | セキュリティログ | 特権の剥奪 |
表2: 提案された移行フレームワークにおける脅威モデルおよびそれぞれのセキュリティ対策この表は、ゼロトラストセキュリティ原則、暗号化、アイデンティティ管理、整合性検証、モニタリング、および説明可能な異常検知に基づいた、主要な代表的セキュリティ脅威とそれに対応する緩和メカニズムの概要を示しています。
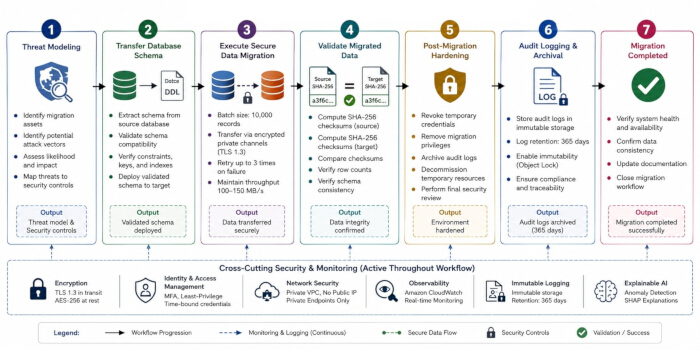
図 3: 提案するセキュアなクラウドデータベース移行プロトコルのワークフロー。本プロトコルは、脅威モデリング、スキーマ転送、セキュアなデータベース移行、移行データの検証、移行後のハードニング、監査ログ記録およびアーカイブ、移行完了の7つの連続したステージで構成される。セキュリティモニタリング、暗号化通信、アイデンティティ管理、不変ログ記録、および説明可能な異常検知が、移行ワークフロー全体を通じて維持される。この図は、著者らがMicrosoft PowerPoint (Microsoft 365)を用いて作成した。こちらのリンクをクリックして、この図の拡大版を表示してください。
6. 説明可能なAIモニタリングの設定
注:プロセスの概要は、移行セキュリティ特性の特定、異常検知モデルの構築、移行アクションが疑わしいタイミングの認識、そしてSHAP解釈手法による説明可能な結果の出力という流れになります。
- 異常検知および説明可能性分析に必要なセキュリティテレメトリ機能を抽出して前処理します。
- データベースサーバー、認証サーバー、アプリケーションサーバー、およびネットワーク監視システムからセキュリティログを収集します。移行に関連するすべてのイベントを中央ログリポジトリに集約します。重複レコードと不完全なエントリを削除します。協定世界時(UTC)を使用して、すべてのログソース間でタイムスタンプを同期させます。
- 移行操作中の各ユーザーのアクセス頻度を算出します。各アカウントに関連付けられたログイン失敗回数を記録します。移行セッション全体を通してソースIPアドレスの変化を監視します。
- ログイン開始から終了までのユーザーセッション時間を測定します。移行活動中のインバウンドおよびアウトバウンドのデータ転送量を算出します。Min-Max正規化を用いて、抽出したすべての機能を正規化します。
- 表3に、異常検知および説明可能性分析に使用したセキュリティ機能を示します。
- 準備したセキュリティ機能データセットを用いて、Isolation Forestモデルのトレーニングと検証を行います。
- データセットを分割します。データセットをトレーニングセット(70%)、検証セット(15%)、テストセット(15%)にランダムに分割します。すべてのサブセットにおいて、正常イベントと異常イベントの分布が一定に保たれるようにします。
- 説明可能なAIモデルの選択。ラベル付きトレーニングデータを必要とせずに異常な移行活動を効率的に検知できるため、Isolation Forestアルゴリズムを選択します。このアルゴリズムを用いて、特徴空間を再帰的にランダムに分割し、異常な観測値を孤立させます。
- SHAP TreeExplainerを適用して、各セキュリティ機能が異常予測に与える寄与度を定量化し、セキュリティ監視プロセスの透明性を向上させます。
- 異常検知モデルを構成します。Isolation Forestモデルを初期化します。表4に記載されたパラメータを使用してモデルを構成します。
- 異常スコアの算出および機能寄与度の説明に使用する数学的定式化を定義します。
- 式1に示すように、各移行イベントのセキュリティ機能ベクトルを定義します。
xi = [x1 , x2, x3, x4, x5 ] (1)
ここで、x1はアクセス頻度、x2はログイン失敗回数、x3はIPアドレス変更頻度、x4はセッション時間、x5はデータ転送量を示します。 - 移行ログからセキュリティ機能を抽出します。モデルトレーニングの前にすべての機能値を正規化します。式2を用いて、各移行イベントのIsolation Forest異常スコアを算出します。
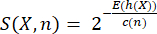 (2)
ここで、S(X,n)は観測値Xの異常スコア、Xはセキュリティ機能ベクトル、E(h(X))は観測値Xの期待経路長、c(n)は二分探索木における不成功検索の平均経路長、nはトレーニングサンプルの総数を示します。正規化係数は式3に示すように算出されます。
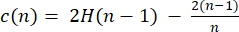 (3)
ここで、H(n-1)は第(n-1)調和数を示します。 - あらかじめ定義した決定しきい値より大きい異常スコアを持つ移行イベントを、異常として分類します。
- SHAP(SHapley Additive exPlanations)を適用して、各セキュリティ機能の異常予測への寄与度を説明します。式4を用いて、機能iのSHAP値を算出します。
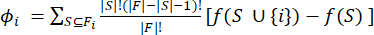 (4)
ここで、(F)は完全な機能セット、(S)は機能のサブセット、(f(.))はIsolation Forestの予測関数を示します。 - 式5を用いて平均絶対SHAP値を計算し、グローバルな機能重要度を算出します。
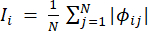 (5)
ここで、(N)は移行イベントの総数を示します。 - 平均絶対SHAP値に基づいてセキュリティ機能の順位付けを行います。グローバルおよびローカルな機能重要度を視覚化するために、SHAPサマリープロット、依存性プロット、およびフォースプロットを生成します。
- 式1に示すように、各移行イベントのセキュリティ機能ベクトルを定義します。
- トレーニングデータセットを用いてIsolation Forestモデルをトレーニングします。検証データセットを用いてモデル性能を評価します。必要に応じて、コンタミネーションしきい値を変更します。最高の性能を示したモデル構成を保存します。モデル性能を検証し、精度(accuracy)、適合率(precision)、再現率(recall)、F1スコア、およびROC-AUCなどの指標を決定します。後の比較のために、モデル性能の測定値を記録します。
- トレーニング済みモデルを適用して、異常な移行イベントを特定し、不審な活動を分類します。
- 異常予測を実行します。トレーニング済みIsolation Forestモデルをテストデータセットに適用します。すべての移行イベントの異常スコアを生成します。
- 不審な活動を特定します。移行イベントが典型的であるか、あるいは異常であるかを判定します。あらかじめ設定された異常レベルを超えるイベントを不審なものとしてマークします。セキュリティ精査のための異常ドキュメントを作成します。
- 異常検知プロセスの完了により、異常スコアが算出され、移行イベントが正常または異常としてラベル付けされ、ROC分析を通じて検知有効性が測定され、主要なセキュリティ異常が特定されます。設計されたプロセスによって生成された出力例を図4に示します。
- 検知された異常をカテゴリ分けします。異常を、認証異常、ネットワーク異常、セッション異常、およびデータ転送異常に分類します。説明分析のために異常ラベルを保持します。
- 検知性能を評価します。これまでに記録されたセキュリティインシデントを確認します。次に、それらをリファレンスとして、検知された異常を評価し、どちらが真の異常であったかを判断します。異常の検知率と偽陽性率を決定します。再現性を確保するため、検知精度のドキュメントを公式に記録します。
- SHAPベースの説明を生成し、個々のセキュリティ機能が異常予測にどのように寄与しているかを解釈します。
- SHAP環境を構成します。トレーニング済みIsolation Forestモデルをロードします。SHAP TreeExplainerを初期化します。異常検知モデルと説明可能性フレームワークの統合が正常に行われたかを確認します。
- バックグラウンドサンプルを選択します。トレーニングデータセットから代表的なサンプルを1,000個ランダムに選択します。選択したサンプルをSHAPバックグラウンドデータセットとして使用します。SHAP値を算出します。検知されたすべての異常についてSHAP値を計算します。異常予測に対する個々の機能の寄与度を測定します。さらなる分析のためにSHAP出力を保存します。
- グローバルな説明を生成します。全体的な機能重要度を示すSHAPサマリープロットを作成します。平均絶対SHAP値に基づいたSHAPバーチャートを生成します。影響力の強い機能についてSHAP依存性プロットを作成します。
- ローカルな説明を生成します。代表的な異常移行イベントを選択します。SHAPフォースプロットおよびウォーターフォールプロットを作成します。各異常の原因となった機能の寄与を視覚化します。
- 解釈プロセス中に生成された代表的な説明可能性出力を図5に示します。これらの視覚化により、グローバルな機能重要度、機能寄与度のランキング、影響力のあるセキュリティ機能間の依存関係、および個々の移行異常に対するローカルな説明が示されます。
- セキュリティ機能の順位付けを行います。すべての機能の平均絶対SHAP値を算出します。異常検知への寄与度に基づいて機能の順位を付けます。移行セキュリティに影響を与える最も影響力のあるセキュリティ指標を特定します。SHAPベースの機能重要度ランキングの要約を表5に示します。
- 説明の一貫性を検証します。5回の独立した実験ランでSHAP分析を繰り返します。説明の安定性と一貫性を測定します。繰り返しの分析においても機能ランキングが安定していることを確認します。
注:表6に、説明可能な異常検知において遭遇しやすい一般的な問題と、推奨される修正策を示します。
| 特徴 | 概要 | 目的 |
| アクセス頻度 | 移行期間中のユーザーアクセスリクエスト数 | 異常なアクセス挙動の検知 |
| ログイン失敗回数 | 認証失敗回数 | ブルートフォース攻撃または不正アクセスの試行を特定する |
| IPアドレスの変更 | 送信元IPアドレスの変更頻度 | 不審なネットワーク動作の検出 |
| セッション時間 | 移行期間中におけるユーザーセッションの長さ | 異常なセッションアクティビティの特定 |
| データ転送量 | 移行中に転送されたデータ量 | 異常なデータ移動または流出の検出 |
表3:説明可能な異常検知に使用されたセキュリティテレメトリ機能。 この表は、データベース移行中に監視されたセキュリティ機能、その意味、測定方法、およびそれらが異常検知と説明可能性分析にどのように寄与したかを示している。
| パラメータ | 値 | 概要 |
| アルゴリズム | アイソレーションフォレスト | 異常検知モデル |
| 推定器数 | 100 | アイソレーションツリーの数 |
| コンタミネーション | 0.02 | 期待異常割合 |
| 最大サンプル数 | 自動 | 樹あたりに使用した試料数 |
| 乱数シード値 | 42 | 再現性シード |
| ブートストラップ法 | 偽 | 非復元抽出 |
| トレーニングセット | 70% | モデル訓練データ |
| 検証セット | 15% | ハイパーパラメータの検証 |
| テストセット | 15% | 最終モデル評価 |
表4:セキュアなデータベース移行中の異常検知に使用したIsolation Forestの構成。この表は、データセットの分割方法、コンタミネーションレベル、エスティメーター数、乱数シード、および評価セットアップなど、トレーニングにおけるIsolation Forestモデルのハイパーパラメータ設定の詳細を示している。
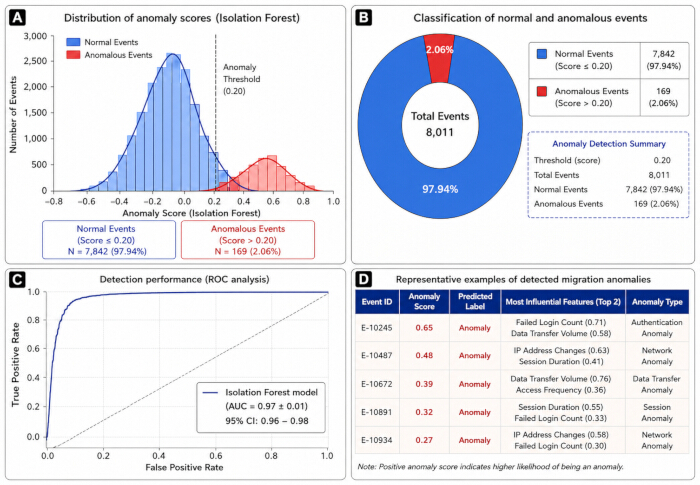
図 4: セキュアなクラウドデータ移行時における異常検知フレームワークの代表的な出力結果。 (A) 異常しきい値を示すIsolation Forest異常スコアの分布。 (B) 移行イベントの正常および異常カテゴリへの分類。 (C) Isolation Forestモデルの性能を示す受信者動作特性(ROC)曲線 (AUC = 0.97 ± 0.01)。 (D) 異常スコア、予測ラベル、影響力のあるセキュリティ特性、および異常カテゴリを示す代表的な異常移行イベント。本図は著者によりPython 3.11 (Matplotlib 3.9)を用いて作成され、Microsoft PowerPoint (Microsoft 365)を用いて整形された。 こちらのリンクをクリックして、本図の拡大版を表示してください。
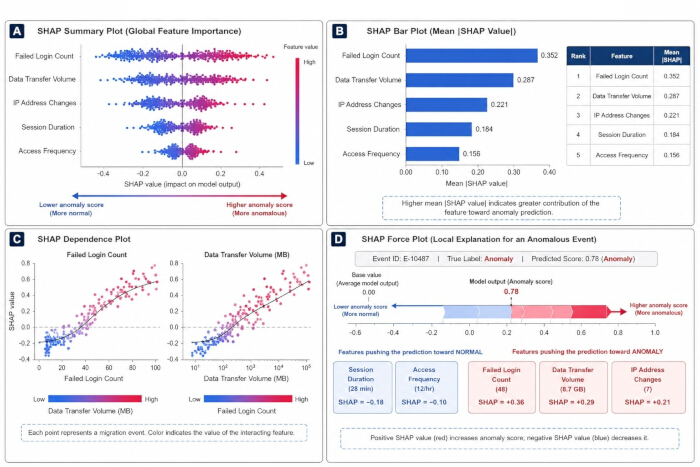
図 5: アノマリー解釈の過程で生成されたSHAPベースの説明可能性出力の例。 (A) グローバルに最も重要な特徴量を強調するSHAPサマリープロット。 (B) 平均絶対SHAP値に基づくセキュリティ特徴量のランキング。 (C) ログイン失敗回数とデータ転送量がアノマリー予測にどのように影響するかを示すSHAP依存性プロット。 (D) 代表的な異常マイグレーションイベントに対するローカルな説明を提供するSHAPフォースプロット。 これらのチャートは、提案されたアノマリー検出モデルのグローバルおよびローカルな解釈可能性を示している。 この図は、著者らがPython 3.11 (Matplotlib 3.9) を使用して作成し、Microsoft PowerPoint (Microsoft 365) を使用して整形した。 ここをクリックして、この図の拡大版を表示してください。
| 順位 | 特徴 | 平均絶対SHAP値 | 結果の解釈 |
| 1 | ログイン失敗回数 | 0.352 | 異常活動の最も影響力のある指標 |
| 2 | データ転送量 | 0.287 | 異常検知への強力な寄与 |
| 3 | IPアドレスの変更 | 0.221 | 不審なネットワーク動作を示す |
| 4 | セッション時間 | 0.184 | 異常なユーザセッションに関連するもの |
| 5 | アクセス頻度 | 0.156 | 異常なアクセスパターンの反映 |
表5:セキュリティテレメトリデータのSHAP特徴量重要度スコア。この表は、平均絶対SHAP値に基づくセキュリティ特徴量のランキングを示し、アノマリ予測に対するそれぞれの寄与度を概説しています。
| 号 | 考えられる原因 | 推奨される溶液 |
| わずかな異常を検出 | 汚染パラメータが低すぎます | 汚染閾値を上げ、モデルを再学習させる。 |
| 高い偽陽性率 | ノイズが多い、または不整合な移行ログ | モデルのトレーニング前に、ログデータをクリーニングし、セキュリティ機能を正規化します。 |
| 不安定なSHAP説明 | 不十分なバックグラウンド試料 | SHAPで使用する代表的な背景サンプルの数を増やします。 |
| 異常検知精度の低下 | 特徴量の不均衡または不適切な前処理 | 特徴量の正規化、バランシング、および品質管理手順を適用する。 |
| モデル収束の遅延 | 大規模なデータセットまたは限られた計算リソース | ハイパーパラメータを最適化するか、GPUまたは並列処理を利用してください。 |
| コミュニケーション不全 | モニタリング中のネットワークの不安定性 | 安全な通信チャネルを確認し、同期を繰り返します。 |
| 不足しているセキュリティ機能 | 不完全なログ収集 | 特徴抽出の前にログソースを検証し、特徴量データセットを再生成してください。 |
表6:説明可能な人工知能(XAI)ベースのセキュアなデータベース移行におけるトラブルシューティングガイド。 この表では、一般的な実装上の問題、考えられる原因、診断サイン、推奨される対処法、およびプロトコルの実行と再現性の結果として期待される成果について要約して示します。
7. 性能評価
注:このセクションでは、ベースラインの移行フレームワークと、提案するゼロトラスト説明可能AIベースの移行フレームワークを比較するために使用した実験手順について説明します。性能評価には、同一の実験条件下でのセキュリティ、異常検知能力、移行効率、および統計的検証が含まれます。
- 公正なパフォーマンス比較を可能にするため、ベースライン環境と提案環境の両方を同一の条件下で構成する。
- 従来のマイグレーション環境を構成する。有効期間が24 hを超える長期的な静的認証情報を設定する。データベースアクセスのためのパブリックネットワークエンドポイントを有効にする。AIベースの異常検知および説明可能性メカニズムを無効にする。従来のセキュリティログを使用して、マイグレーション活動を手動で監視する。後のパフォーマンス比較のためにマイグレーションイベントを記録する。
- ゼロトラスト・マイグレーションフレームワークを構成する。マイグレーション完了後に自動的に期限が切れる、一時的な最小権限認証情報を有効にする。すべてのパブリックネットワークエンドポイントを無効にする。セキュアチャネルを用いたプライベートネットワーク通信を有効にする。
- 学習済みIsolation Forest異常検知モデルをデプロイする。モデル解釈のためにSHAP TreeExplainerを有効にする。マイグレーションプロセス全体を通じて自動セキュリティ監視を構成する。実行前に、すべてのマイグレーションコンポーネント間のセキュア通信を確認する。
- フレームワークの再現性を評価するため、制御された条件下でマイグレーション実験を繰り返し行う。
- マイグレーション実験を実施する。ベースライン環境と提案環境の両方について、10回の独立したマイグレーション実験を行う。すべての実験を通じて、ハードウェア、ソフトウェア、およびネットワーク構成を同一に維持する。
- 各実験回で10 GBのヘルスケアデータをマイグレーションする。同一のワークロード条件下ですべての実験を繰り返す。すべての実験において、セキュリティイベント、マイグレーションログ、異常検知出力、および実行時間を記録する。
- マイグレーションの整合性を検証する。マイグレーション前後にSHA-256チェックサムを算出する。各マイグレーション実験後に、完全なデータ整合性を確認する。チェックサムの検証結果を記録する。
- 比較評価のため、セキュリティ、マイグレーション、および異常検知に関する定量的指標を算出する。
- セキュリティパフォーマンスを測定する。認証情報の露出時間を測定する。マイグレーション中に露出した認証情報の数を算出する。インシデント検知時間を測定する。パブリックネットワークへの露出時間を記録する。
- 異常検知パフォーマンスを評価する。異常検知の正解率、適合率、再現率、F1スコア、および受信者動作特性曲線下面積(AUC)を算出する。マイグレーションパフォーマンスを評価する。総マイグレーション遅延時間を測定し、マイグレーションスループットを算出する。セキュリティメカニズムによって導入された通信オーバーヘッドを記録する。
- 統計的検証を行う。すべてのパフォーマンス指標の平均値と標準偏差を算出する。95%信頼区間を計算する。ベースラインフレームワークと提案フレームワークを比較するために、対応のあるStudentのt検定を行う。統計的有意性をp < 0.05として検討する。実験比較中に得られた代表的なパフォーマンス評価結果を図6に示す。
- 表7に、ベースラインと提案マイグレーションフレームワークとの定量的パフォーマンス比較をまとめる。
表8に、セキュアなデータベースマイグレーション中に発生した一般的な実装上の問題、その考えられる原因、および推奨される修正措置をまとめる。
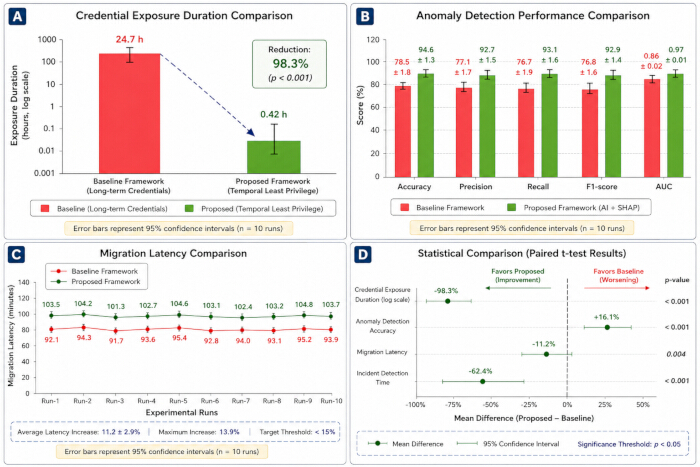
図 6: ベースラインの移行フレームワークと、提案されたゼロトラストおよび説明可能なAI(xAI)搭載セキュアクラウド移行フレームワークとの性能比較。 (A) 長期認証情報と時間的最小権限認証情報を用いた、認証情報の露出時間の比較。 (B) 正解率(accuracy)、適合率(precision)、再現率(recall)、F1スコア、およびAUCを含む、異常検知の性能指標の比較。 (C) 10回の独立した実験ランにおける移行レイテンシの比較。レイテンシの増加が事前定義された許容しきい値を下回っていることを示している。 (D) 対応のあるt検定を用いた主要性能指標の統計的比較。平均差と95%信頼区間を示している。エラーバーは10回の独立した実験ランからの95%信頼区間を表す。この図は、著者がPython 3.11 (Matplotlib 3.9) を用いて作成し、Microsoft PowerPoint (Microsoft 365) で整形した。 この図の拡大版を表示するには、ここをクリックしてください。
| パフォーマンス指標 | ベースラインフレームワーク (平均 ± SD) | 提案フレームワーク (平均 ± SD) | 改善度 | 95% 信頼区間 | p値 |
| 認証情報の露出時間 (h) | 24.70 ± 1.32 | 0.42 ± 0.18 | 98.3% 減少 | 23.6–24.9 | <0.001 |
| 異常検知精度 (%) | 72.4 ± 2.1 | 94.6 ± 1.3 | +22.2% | 20.8–23.5 | <0.001 |
| 適合率 (%) | 68.1 ± 2.5 | 92.7 ± 1.5 | +24.6% | 23.1–26.0 | <0.001 |
| 再現率 (%) | 70.3 ± 2.4 | 93.1 ± 1.6 | +22.8% | 21.4–24.2 | <0.001 |
| F1スコア (%) | 69.2 ± 2.2 | 92.9 ± 1.4 | +23.7% | 22.3–25.0 | <0.001 |
| AUC | 0.78 ± 0.03 | 0.97 ± 0.01 | +0.19 | 0.17–0.21 | <0.001 |
| マイグレーション遅延 (min) | 87.6 ± 3.2 | 97.4 ± 2.9 | 11.2% オーバーヘッド | 8.9–10.7 | 0.002 |
| データ整合性 (%) | 99.8 | 100.0 | 0.2% 改善 | 0.1–0.3 | 0.031 |
| パブリックネットワークへの露出 | 有効 | 排除済み | 100% 排除 | N/A | <0.001 |
表7:ベースラインおよび提案されたセキュアなデータベース移行フレームワーク:パフォーマンス比較。本表は、プロトコルの検証中に定量的に評価された、資格情報の露出期間、異常検知の有効性、移行レイテンシ、データの整合性、およびセキュリティ上の改善点を示している。
| 号 | 考えられる原因 | 推奨溶液 |
| 移行認証失敗 | 有効期限切れまたは無効な一時的認証情報 | 移行を再開する前に、一時認証情報を再生成し、IAMポリシーを検証してください。 |
| 高い移行レイテンシ | ネットワークの混雑または帯域幅の不足 | ネットワークルーティングを最適化し、トラフィックの少ない時間帯に移行をスケジュールし、エンドポイントの接続性を検証してください。 |
| 偽陽性の異常アラート | 不適切なアイソレーションフォレストのコンタミネーション閾値 | 検証データセットを用いてコンタミネーションパラメータを調整し、モデルを再学習させる。 |
| 不安定なSHAPによる説明 | 不十分または代表性のない背景サンプル | SHAPのバックグラウンドサンプルサイズを増加させ、代表性のあるサンプリングを確保してください。 |
| データ整合性の不一致 | 中断された移行または破損したデータ転送 | SHA-256チェックサム値およびソースとターゲットの一貫性を検証した後、マイグレーションを再実行してください。 |
| セキュアエンドポイント接続失敗 | ファイアウォールまたはTLS構成エラー | SSL/TLS証明書、ファイアウォールルール、およびプライベートエンドポイントの設定を確認してください。 |
| 異常検知精度の低下 | 不完全な特徴抽出または不適切な前処理 | 特徴量エンジニアリングを見直し、セキュリティ特徴量を正規化し、モデルを再学習させてください。 |
| モデルの収束に関する問題 | 不適切なハイパーパラメータ | 学習パラメータを調整し、導入前にモデルの性能を検証してください。 |
表8:セキュアなヘルスケアデータベース移行のトラブルシューティングガイド。この表には、セキュアな移行プロトコルを確実に実行するために、頻出する移行エラー、その考えられる原因、推奨される是正措置、および期待される結果が記載されています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
実験概要
提案された説明可能な人工知能(XAI)搭載のセキュアなクラウドデータ移行プロトコルの評価には、28のリレーショナルデータベーステーブルに分散し、合計10 GBに及ぶ約2,000万件の電子健康記録(EHR)レコードで構成される合成ヘルスケアデータセットを使用した。実験は、Amazon RDS PostgreSQL 16、プライベートなVirtual Private Cloud(VPC)ネットワーク、TLS 1.3暗号化通信、および集中監視サービスを用いたAmazon Web Services(AWS)クラウド環境で実施した。再現性を確保し実験的なバイアスを最小限に抑えるため、同一のハードウェア、ソフトウェア、ネットワーク、およびワークロード条件下で10回の独立した移行実験を行った。報告されたすべてのパフォーマンス値は、10回の実験 runsの平均値である。統計的有意性は、Shapiro-Wilk検定(p < 0.05)を用いて正規性を検証した後、対応のあるStudent's t-検定を用いて評価した。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究では、ゼロトラストセキュリティ原則、時間ベースの最小権限アクセス制御、説明可能な人工知能(XAI)、および継続的なセキュリティモニタリングを組み込んだ、再現可能で安全なクラウドデータベース移行プロトコルを、制限された実験的セットアップにおいて開発しました。本論文の目的は新しい移行アルゴリズムを提示することではありません。したがって、著者は主に、研究者や実務者が明確に規定された手順に従って、安全なヘルスケアデータベースの移行を実行、評価、および再現できるようにするための標準化されたワークフローを提示します。本プロトコルの実装を成功させるには、いくつかの非常に重要なステップを慎重に遂行することが不可欠です。移行前に、移行対象となる資産、攻撃者の侵入経路、および有効なセキュリティコントロールのセットを正確に把握するための高精度な脅威モデリングが非常に有効です。データ転送前に、構造的な不整合やスキーマドリフトを避けるため、データベーススキーマの検証を完了させる必要があります。移行に関しては、時間的最小権限の原則に従って一時的な認証情報を生成し、通信の安全性を確保するために暗号化プロトコルTLS 1.3を使用し、セキュリティモニタリングと監...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者らは、本研究で報告された内容に影響を及ぼし得る競合する金銭的利益、商業的関係、または個人的関係がないことを宣言します。また、開示すべき利益相反はありません。本研究で提示された方法論を再現するために必要なすべての資料は、GitHubリポジトリで公開されています。リポジトリのURLは https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration です。なお、本リポジトリには合成的に生成されたベンチマークデータのみが含まれており、実際の患者情報、保護されるべき保健情報、または個人を特定できるヘルスケア記録は一切含まれていません。
謝辞
著者らは、本プロトコルの開発および評価において、それぞれの所属機関から得られた制度的支援に感謝いたします。また、提案されたセキュアなクラウドデータ移行フレームワークの実験的検証を支えた、機関の計算設備およびクラウドコンピューティングリソースの使用に感謝いたします。
本研究に外部資金による支援はありません。本研究は、著者の所属機関より提供された機関研究施設および計算リソースを用いて実施されました。公的、商業的、または非営利の資金提供機関からの助成金や財務的支援は受けていません。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| AES暗号化 | NIST | AES-256 | 保存データの暗号化 |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | ターゲットデータベース |
| クラウドプラットフォーム | Amazon Web Services | AWS | クラウドインフラストラクチャ |
| CloudWatch | Amazon Web Services | 最新安定版 | モニタリングおよびロギング |
| Docker | Docker Inc. | 27.0 | コンテナ化 |
| Faker | Faker Developers | 30.0 | 合成データ生成 |
| GPU | NVIDIA | RTX 4090 | 24 GB VRAM |
| Matplotlib | Matplotlib Developers | 3.9 | 可視化 |
| NumPy | NumPy Developers | 1.26 | 数値処理 |
| オペレーティングシステム | Canonical | Ubuntu 22.04 LTS | システム環境 |
| Pandas | PyData | 2.2 | データ処理 |
| PostgreSQL | PostgreSQL Global Development Group | 16 | ソースデータベース |
| Python | Python Software Foundation | 3.11 | プログラミング言語 |
| Scikit-learn | Scikit-learn Developers | 1.5 | 機械学習 |
| SHAP | SHAP Developers | 0.46 | 説明可能なAI |
| Terraform | HashiCorp | 1.8 | インフラストラクチャプロビジョニング |
| TLS | IETF | TLS 1.3 | 転送データの暗号化 |
| 仮想プライベートクラウド | Amazon Web Services | VPC | プライベートネットワーク環境 |
| ワークステーション | Dell/HP | NA | Intel Xeon Gold 6226R, 64 GB RAM, 1 TB SSD |
参考文献
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。