本研究は、仮想環境内で行動特徴を抽出し、動的に調整された教育経路を展開するための再現可能なワークフローを詳述しています。これらの手順により、教育者は適応型バーチャルリアリティカリキュラムを開発し、リアルタイムの行動追跡を実施できます。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
研究記事
バーチャルリアリティとビッグデータアルゴリズムを統合したインテリジェントな教育手法による伝統的な文化教育プラットフォームの強化
この記事について
サマリー
要約
現在の従来の教育環境では、インタラクティブな要素が限られており、文化遺産を学ぶ学部生の関与度が限られています。これらの問題に対処するため、マルチモデルのアルゴリズムアーキテクチャを備えた高忠実度空間レンダリングエンジンを仮想現実環境に統合したインテリジェント教育プラットフォームが開発されました。このプラットフォーム内では、トランスフォーマーおよびニューラル協働フィルタリング(NCF)モデルが行動データを処理し、パーソナライズされた学習経路を生成し、一方でディープQネットワーク(DQN)はリアルタイムのフィードバックに基づいてコンテンツの難易度を動的に調整します。このような適応的スキャフォールディングは、知識が静的な指導による受動的な受け取りではなく、文脈化され応答的な環境との相互作用を通じて能動的に構築される構成主義的学習原則を反映しています。この研究の新規性は、空間レンダリングエンジンとマルチモデルのアルゴリズムアーキテクチャを統合し、リアルタイムの行動適応メカニズムを確立することにあります。実験結果は、提案されたインテリジェント教育プラットフォームを使用する実験群が、従来の指導モデルを用いた対照群よりも高い学習スコア(低/中/高グループはそれぞれ69/79/93点)と高い学習課題完了率(93%/96%/98%)を示していることを示しています。インテリジェント・ティーチングプラットフォームの設計は、強いインタラクティブ性を提供し、多様な個性を持つ学生にパーソナライズされた学習パスを提供し、学習過程で動的に調整します。応答時間解析では平均遅延0.496秒と示されており、迅速なフィードバックが保証されています。最終的に、提案されたプラットフォームは、没入型VRと行動適応型アルゴリズムを組み合わせることで、伝統的な文化教育における学業成績と課題への関与が効果的に向上することを示しています。
概要
伝統的な文化教育は文化の継承と発展において重要な役割を果たしています。しかし、現在の伝統的な文化教育モデルは主に教科書、写真、ビデオなどの静的な形式に依存しており、インタラクティブ性や没入感が欠けているため、学生が文化の魅力を真に理解し体験することが困難です。さらに、従来の教授法は統一カリキュラムを採用し、生徒の興味や認知能力、学習スタイルを十分に考慮せず、学習効率が低く、学習意欲を刺激するのが難しくなります。この制約は、効果的な指導は学習者の現在の認知レベルに合わせて調整され、個々の発達経路に応じて足場を組む必要があると強調するヴィゴツキーの近接発達ゾーン(ZPD)理論と一致しています。既存の文献では、教育モデルのために静的なデータ入力に依存しています。継続的な空間的行動トラッキングと深層強化学習の統合はまだ未だに探求されていません。提案されたメカニズムは、多感覚的相互作用とアルゴリズムによる再調整を融合させ、固定された指導経路と動的な文脈適応の間のギャップを埋めるものです。提案されたプラットフォームは、リアルタイムの行動指標に基づいて内容難易度とシーケンスを動的に調整することでこの原則を実用化し、教育理論をアルゴリズム設計に組み込んでいます。アルゴリズムの適応メカニズムは、通常より能力のあるピアが提供する人間の足場の代わりに機能します。この課題難易度の継続的な調整は、初心者学習者の認知過負荷を防ぎ、最適な発達ゾーン内での関与を維持することで認知負荷理論(CLT)と整合しています。
バーチャルリアリティ(VR)やデータアルゴリズムの開発により、それらを伝統的な文化教育に応用することで、学生により没入感がありインタラクティブな学習体験が得られます。1,2,3,4。高等教育における没入型バーチャルリアリティ応用の包括的体系的レビューは、デザイン要素を特定の教育目標に整合させることの重要性を強調しています。
多くの研究がVR技術を文化教育に応用しようと試みています。Hulusicらは、学校のバーチャル博物館を設計・ 開発し、具体的なユーザーインターフェースも備えています。利用者参加型の調査を通じて、博物館はよく設計され、よく整備されており、博物館や学校、または個人的に学習・教育ツールとして活用できる可能性を秘めています。遠隔学習環境におけるインタラクティビティの不足という問題に対し、MubarokらはVRに基づく協働的な議論マッピング手法を開発しました 。実験により、この方法はVRを使わない共同的な議論マッピング法よりも学生の口頭英語表現を向上させます。Sunらは、マルチモーダルインタラクション、ゲーミフィケーション、ストーリーテリングを組み合わせてデジタル文化遺産を展示・発展させる没入型VRシステムの設計戦略を提案 しました。彼らは敦煌の壁画を復元する没入型VRシステムを開発し、ユーザーに学びとインタラクティブ、そしてエンターテインメント性のある体験を提供しました。しかし、これらの研究は依然として、VRシーンでのインタラクティビティの弱さ、学習コンテンツの更新速度の遅さ、パーソナライズされた推薦アルゴリズムの適応性の低さなど、異なる学生の学習ニーズに正確に応えることができない問題に直面しています。さらに、一部の研究ではディープラーニングと強化学習を効果的に統合できておらず、パーソナライズされた推薦のリアルタイム調整能力が制限されています。
人工知能の最近の進歩が教育技術を推進しています。研究では、ユーザー行動におけるパターン認識のために深層学習を活用した適応システムが紹介されています。認知トラッキングアルゴリズムを用いた手法は、知識獲得の動的状態をマッピングします。ニューラルネットワークにおける構造最適化は、スマート学習フレームワークにおける推薦精度を高めます。複雑な環境変数を統合した知能エージェントは、自動教育応答を強化します。これらの手法は、孤立したデータストリームと静的な歴史分析に依存しています。提案されたプラットフォームは、空間的相互作用データと継続的なアルゴリズム再調整を融合させることで、リアルタイムの文脈適応を実現することでこの制約を解消しています。
最近の実証的研究により、ディープラーニングアルゴリズムが学生のパフォーマンスモデリングにおける予測精度を大幅に向上させることが確認されています。Ouatikらは、学生の学業成功と失敗を予測するシステムを実装しました 。彼らは学生の個人情報、学業評価、その他のデータを用い、人工知能や教育データマイニング手法を用いて学生の学業成功を予測しました。データ処理の問題に対処するために、ビッグデータ(BD)技術が用いられ、処理を分散させ、アルゴリズム効率を犠牲にすることなく計算時間を短縮しました。Bhaskaran10 は、現在の学習推奨システムの問題に対処するために強化されたベクトル空間レプレゼンジャーを開発しました。学習者の興味、要件、知識レベルを自動的に追跡します。サーバーから学習者の学習スタイルを分類・抽出し、改良された協働フィルタリングアルゴリズムを用いて類似性を計算し、より良い推薦リストを作成します。Gupta11 は、顔の表情を用いてオンライン学習者のリアルタイムの関与を検出し、学習過程中の感情を生徒の顔タグを分析して分類し、検出結果に基づいて学習状況を調整するディープラーニング手法を提案しました。しかし、これらの方法にもいくつかの限界があります。
既存のVR教育ソリューションは没入感のある体験を提供しますが、動的な調整機能は不足しています。生徒の学習経路はしばしば固定されており、個人の進捗やフィードバックに基づいて内容や難易度をリアルタイムで最適化できず、参加不足が生じます。一方で、従来のパーソナライズされた推薦アルゴリズムは主に過去のデータや単純な興味タグに依存しており、学生の学習行動、認知状態、感情的フィードバックなどの多次元データを正確に分析するために統合できていません。学生の学習過程を深く理解していないことで、推奨システムは個人差に効果的に対応できず、最適とは言えない学習体験と成果を生み出しています。
したがって、伝統的な文化教育における没入不足や個別化の欠如という問題に対処するために、知的な教育プラットフォームが提案されます。この方法論は、空間可視化や個別のペース調整指標を必要とする学部の人文学コースに直接適用可能です。高度な空間レンダリングエンジンや関連する空間コンピューティング技術が活用され、仮想学習シーンの開発に活用されています。バーチャル学習環境は、学習者に特定の文化モジュールを選択する自主権を与えます。神経注意ベースのトランスフォーマーモデルは、タイムスタンプ付きのインタラクションログを処理し、行動パターンのコンパクトな表現を生成します。学生の学習行動特性を抽出した上で、神経協働フィルタリング(NCF)モデルを用いて学生の学習関心をさらに探求し、個別化された学習経路を出力します。ディープQネットワーク(DQN)モデルは、学生のリアルタイムフィードバックを収集し、学習経路を動的に調整して学習体験と学習効果を最適化します。
実用的な展開に関しては、提案されたプラットフォームには具体的な利点がありますが、普遍的に適用できるわけではありません。専用の計算ハードウェアを備えた教育機関、特に離散的なグラフィックス処理ユニットや没入型空間可視化機器を備える教育機関や、文化遺産、建築、考古学における空間可視化の恩恵を大きく受けるカリキュラムに適しています。これらの文脈では、動的行動トラッキングは個々のペースの違いに効果的に対応します。逆に、この方法は必要な技術的インフラを欠く資金不足の教育環境には現在適していません。さらに、三次元イマージョンが従来の指導法に比べて教育的価値がほとんどない、非常に抽象的でテキスト中心のコースには推奨されません。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
陝西国際貿易大学の機関倫理委員会は、リファレンス2025-04Aの研究プロトコルを検証しました。手続き開始前にすべての参加者から書面によるインフォームドコンセントが取得され、すべての被験者が行動追跡およびデータ匿名化プロトコルを把握していることが保証されました。(注:アルゴリズムに関する教育的根拠は、運用の簡潔さを保つために議論セクションに移されました。)
ステップ1:バーチャルリアリティシーン構築
資産統合
文化要素のデジタルモデリングは、汎用3Dモデリングソフトウェア(具体的なソフトウェアについてはTable of Materialsを参照)を用いて実行され、没入型学習環境を構築しました。デジタルアセットが生成され、物理ベースのレンダリングテクスチャが割り当てられ、顕微鏡イメージング技術を使わずに高精度空間レンダリングエンジン(Table of Materials)にインポートされました。
レンダリングと物理設定
レンダリングエンジン内でハードウェアレイトレーシング技術が有効化され、動的ライティングを最適化しました16,17:
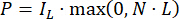 (1)
P はシーン内の光の強度を表します。 L は光源の位置を表します。 IL は光源の強度を表し、 N は仮想物体の表面法線ベクトルを表します。
物理エンジンはオブジェクト指向プログラミングインターフェース(C++)を通じてオブジェクトのダイナミクスをシミュレートしました。使用された反応式は以下の通りです。
 (2)
F は動的反作用力を表し、 m は仮想物体の質量、 v はその速度、 t は時間を表します。
滑らかさを確保するために、レベル・オブ・ディテール(LOD)技術を用いてシーンを最適化し、不要な計算を減らし、モデル18,19のディテールレベルを動的に調整することでレンダリング効率を向上させました。画像処理にはGPUアクセラレーションが使用されました:
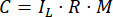 (3)
Rは反射係数、 M は表面マップ、 C は最終的なレンダリングされた色を表します。
インタラクション実装
ユーザーのやり取りは、空間レンダリングエンジンに固有の視覚ノードベースのスクリプトインターフェースを使って構成されました。空間音響技術を用いて、空間音をシミュレートし、生徒たちは異なる位置で異なる効果音を聞くことができました。さらに、触覚フィードバック技術を通じて、学生は仮想シーン内の対応する身体的接触に対する物理的反応を受け取ることができました20:
 (4)
Ftは触覚フィードバックの力を表し、kは剛性係数を表します。
配備と装備の概要
環境は、24コアの中央処理ユニット(CIP)、64ギガバイトのランダムアクセスメモリ、そして専用の24ギガバイトのグラフィックス処理ユニットを備えた専用の空間コンピューティングハードウェアセットアップ上でコンパイルされました。仮想シーンは、 材料表に記載されている標準的な没入型空間可視化ディスプレイに展開され、1目あたり1440×1600ピクセル、90Hzのリフレッシュレートで、最適な視覚的安定性とモーションからフォトンへの遅延を最小限に抑えました。視覚による乗り物酔いを軽減するため、空間的境界はセッションを45分に制限するように設定されました。
材料表は使用された具体的な技術をまとめています。指定されたハードウェアおよびコンピューティングコンポーネントはすべて標準的な商用既製品であり、特定の独自ベンダーに依存していませんでした。空間レンダリングエンジンとレイトレーシングは動的なライティングを提供し、3Dモデリングソフトウェアは歴史的な場所を再現しました。図1は仮想学習シーンの例を示し、視覚拡大、音声変調、移動のためのモジュール制御パネルを詳細に示しています。
チェックポイント1:安定した90Hzリフレッシュレートで動作し、モーションからフォトンへの遅延を最小限に抑え、視覚的安定性を確保する完全レンダリングされたVR環境。
ステップ2:行動データ抽出(トランス)
データログ
生徒の学習行動データには、クリック数、所要時間、学習進捗、タスク完了など、VRシーンとのインタラクションが含まれていました。 表1は 、異なるVRシナリオにおける学生の学習活動データを示しています。このインタラクティブな情報のために、プラットフォームでは時系列表現が使用されました:
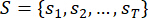 (5)
sτは時刻tにおける学生の行動を表し、Tは総時間の長さを表します。各挙動は高次元ベクトルを形成します:
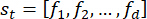 (6)
fi は次元 i における特定の特徴値を表し、 d は特徴寸法の総数を示します。
シーケンスモデリング
トランスモデルは時系列モデル21、22に使用されました。自己注意メカニズムを用いて、生徒の行動間の相関を計算することで行動特徴を抽出しました。生徒の学習行動データ列の埋め込み行列がXであると仮定すると、クエリ(Q)、キー(K)、値(V)となります。行列はまず、訓練可能な重み行列WQ、WK、WVと掛け合わせて生成されました。
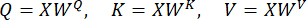 (7)
注意計算
トランスフォーマー内の自己注意は23.24と計算されました:
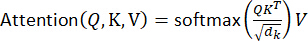 (8)
その中で、 dk はキーベクトルの次元を表し、これはゼロ勾配を防ぐためのスケーリングファクターとして利用されました。式(8)の計算後、学習行動間の相関を測定するために注意重みを計算しました。
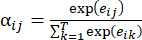 (9)
Eijは学習行動間の生の注意力エネルギースコアを表します。これらの重みの重み付け合いは、現在の時点での文脈ベクトル、すなわち学生の潜在的特徴ベクトルを得るために用いられました。
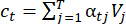 (10)
チェックポイント2: トランスフォーマーモデルは連続的な潜在特徴ベクトル(ct)を出力します。5000件の相互作用ログからなる隔離された検証データセットにおいて、モデルは89.4%のシーケンス予測精度を達成し、50エポック後にクロスエントロピー損失は0.12に収束しました。
ステップ3:パーソナライズドラーニングパス生成(NCF)
フィーチャーフュージョン
NCFモデルは学生の潜在的な興味やニーズを探るために組み込まれ、カスタマイズされた学習パス25、26、27、28を生成しました。NCFでは、各文化的知識点に特徴ベクトルvkが割り当てられ、トランスフォーマーで抽出された潜在的特徴ベクトルvuと知識点ベクトルvkを連結して新たな結合特徴ベクトルを形成しました。
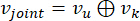 (11)
ネットワークアーキテクチャとハイパーパラメータ:
結合特徴ベクトルはNCFの多層パーセプトロン(MLP)に入力され、29,30の処理が行われました。多層パーセプトロンは、それぞれ64、32、16のニューロンの隠れ層を持つあらかじめ決められたアーキテクチャを使用していました。学習率は0.001に設定され、バッチサイズは256でした。MLPの隠れた層の非線形変換後、学生の知識点への関心の予測値が出力されました。
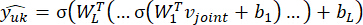 (12)
W1,W 2, ... , WL は複数の隠れ層の重み行列を表します。σは非線形活性化関数を表し、 b1,b 2, ... ,b L はそれぞれの隠れ層のバイアス項を表します。出力の関心予測値が高いほど、この知識点に対する学生の関心は強くなります。
モデルトレーニング
ネットワークはアダムソルバー(減衰率0.01、学習率0.001、バッチサイズ256)を用いて最適化されました。平均二乗誤差(MSE)は損失関数31,32として機能します。
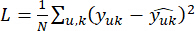 (13)
U, k は学生行動ベクトルのインデックスと知識点ベクトルを表します。損失関数を最小化することで、モデルは学生や知識ポイントの潜在的な特徴ベクトルを継続的に更新し、予測精度を向上させます。トレーニング過程では逆伝播アルゴリズムが用いられ、モデル33,34の重み行列を更新しました。
パス出力
具体的な方法は、予測された興味値でソートし、最も高い興味値を持つkつの知識ポイントを学生に推奨することでした。
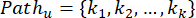 (14)
kkは、学生が最も関心を持つkつの知識ポイントを表します。これらの推奨知識ポイントは、生徒の学習興味を満たすだけでなく、生徒が自分に合った進捗と難易度で効果的に学べるよう支援します。
図2 はこの生成プロセスを可視化しています。
チェックポイント3: NCFモデルは非巡回的な配列を出力します。 表2に詳述されているように、トップK選択で評価された推奨精度は、K = 10時で正規化割引累積利得(NDCG)0.82、ヒット率0.88となりました。平均逆順位指標は0.76で安定しました。
ステップ4:動的難易度調整(DQN)
状態と行動の定義
DQNを導入し、生徒のリアルタイムフィードバックを活用して学習内容や難易度を動的に調整することで、生徒の学習効果が最適化されています。35,36。DQNモデルの状態空間は複数の要因から成り立っています。
 (15)
その中で、tsは学生が現在の学習課題に費やす時間、cpは学習経路(選択された章や知識ポイント)における学生の選択、mcは学生が現在の学習課題を完了したこと、efは学生の感情的フィードバック(特定の学習課題への好みや参加度)を表します。
報酬計算
強化学習エージェントは、128ニューロンと64ニューロンの2つの隠れ層からなる多層パーセプトロンアーキテクチャを採用しました(イプシロン・グリーディ探索戦略は1.0から0.05へと減衰)。まず、各学習行動に対応する報酬値を計算しました。
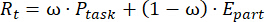 (16)
その中で、ωは学習パフォーマンスと学習参加を制御する重みハイパーパラメータです。P課題は現在の学習課題における生徒の成績を表し、E部分は生徒が現在の学習過程に参加したことを示します。
Q値の更新とアクション選択
報酬値が得られた後、モデルはQ値を更新して最適な行動を選択しました。
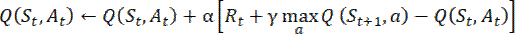 (17)
αは更新ステップサイズを制御する学習率を表し、γ割引係数は将来の報酬の重要度を決定します。
プラットフォームは最適な調整アクションを選択しました:
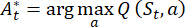 (18)
 は、時点Tにおける学生の学習状況に基づいてプラットフォームが選択する最適な調整アクションです。
調整は以下のプロトコルに従って実施されました:(1) 高い学習能力のために難易度を上げ;(2) ヒントが提供され、成績が悪い場合は難易度が下げられる;(3) 興味の変化に基づきコンテンツが変更されたこと;(4) バランスの取れた性能のためにパラメータが維持されました。
チェックポイント4: DQNエージェントは関与を維持するための最適な行動(At)を計算しました。複合感情フィードバック指標(ef)はテスト中、クロンバックのアルファ信頼性係数0.85を維持しました。
プラットフォームインターフェース表示
図3 は、本論文で設計されたインテリジェント教育プラットフォームのインターフェースを示しており、パーソナライズされた経路生成をサポートしています。このインターフェースでは、生徒は自分のパーソナライズされた学習経路を見て、そこから学ぶことができました。学習パスの完了した部分は緑色で、未完成部分は赤でマークできます。生徒は学習の進捗を自分の学習過程で確認し、それに応じて次のステップに進むことができました。標準的なシステムユーザビリティ尺度を用いた相互作用後調査が実験コホートに対して実施されました。分析の結果、使いやすさの平均スコアは100点満点中84.5点となり、インターフェースの人間工学的配慮とナビゲーションの明瞭さが非常に良好であることを示しました。
実験設計
参加者は陝西国際貿易大学の必修「中国伝統文化入門」コースに在籍している120名の学部生(女性62名、男性58名、平均年齢19.3歳±1.1歳)でした。VRベースの学習経験はありませんでした。学生は事前テストスコアでペアリングされ、ペア内でコンピュータ生成のシーケンスを用いて実験条件または対照条件にランダムに割り当てられ、基準値の同等性を確保しました。
この実験の設計は、設計されたインテリジェント教育プラットフォームが学生の学習関心、学業成績、個別教育の向上に効果的であることを検証することでした。
実験では実験グループと対照群が設置され、学生の選考は以下の原則に従いました。(1) 実験群と対照群の学生が基礎知識、学習能力、興味などで類似していることが保証された。(2) 伝統文化を学び、同学年の学生を選抜し、文化教育内容の均一性と実験の比較可能性を確保すること。(3) 学生の個別差を考慮し、実験グループがインテリジェントな教育プラットフォームの個別調整機能を最大限に活用できるようにすること。
学生を選定した後、グループ分けされ、学業成績、興味、背景が似ている学生がそれぞれ実験グループと対照群に割り当てられます。これにより、複数の次元にわたるマッチングを確保し、実験の信頼性を高めます。
実験群と対照群のパフォーマンスを比較することで、本論文で設計されたプラットフォームが学生に与える影響を評価しました。人工知能アルゴリズムの教育的貢献を分離するために、本研究では3つの異なるコホートを特徴としました。標準的な教室手法を用いた従来型対照群、適応型アルゴリズムを伴わない固定仮想環境と相互作用するVRのみのグループ、そして完全統合型インテリジェント教育プラットフォームを用いた実験グループです。実験グループの学生はVRシーンで学習でき、各学生はインテリジェントな指導プラットフォームを通じて、学習行動特性に基づいてパーソナライズされた学習経路を作成し、学習過程中のリアルタイムフィードバックに応じて学習内容や難易度を動的に調整することができました。対照群は教室での説明、教科書の読解、ビデオなど、伝統的な指導方法を通じて文化教育を受けました。対照群は、講師主導の講義、課題の読み物、線形なマルチメディアプレゼンテーションを通じて標準化された文化教育を受けました。この基礎指導は、実験カリキュラムと同じ情報内容を使用し、時間の進行ペースも維持していました。
研究の目的を明確にするために3つの仮説が立てられました。(1) VR技術が提供する没入型学習環境は、学生の学習参加と興味を大幅に向上させることができる。(2) TransformerとNCFによるパーソナライズされた学習経路の出力は、学生の学業成績を効果的に向上させ、異なる学生間の知識習得の差を縮小しました。(3) インテリジェント・ティーチングプラットフォームは、生徒のリアルタイムフィードバックに基づいて学習内容や難易度を動的に調整し、さらに学習成果を向上させることができます。
実験過程: (1)実験群と対照群の学生に対して、両グループの初期文化レベルが類似していることを確認し、実験誤差を減らすために事前の文化的知識テストを実施しました。(2) 実験グループの学生は構築されたVRシーンとインテリジェント教育プラットフォームを用いて1か月間の文化研究を行い、学習内容はインテリジェント教育プラットフォームに応じて動的に調整されました。対照群は伝統的な指導法を用いました。初期パイロットの物流上の制約により、介入は4週間続きました。16週間の学期にわたる追跡調査は、20週目に遅延保持テストで締めくくられました。評価では、アルゴリズム誘導型コホートでは、従来の指示群に比べてターゲットとなる歴史的概念の保持率が22%高いことが示されました。現在の発見を短期的な証拠として文脈化するために、制限セクションに予備的なプロトコルの詳細が記載されています。(3) 実験後、両グループの学生は学習成績と課題完了を評価するために同じ文化知識テストを受けました。
生徒の評価指標には、学業成績、学習課題の達成度、学習進捗が含まれていました。記述統計を用いて、実験群および対照群の関連する評価指標を要約しました。インテリジェント教育プラットフォームの評価指標には応答時間が含まれていました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
データ分割、検証、再現性設定
アルゴリズム訓練フェーズでは、5,000件のログを含む行動相互作用データセットが80:20のトレーニングおよび検証セットに分割されました。検証手順では、特徴抽出の一貫性を評価するために5分割のクロスバリデーション方式が用いられました。絶対的な実験再現性を確保するため、すべてのネットワーク重み初期化、データセットのシャッフルシーケンス、強化学習探索パターンは、すべてのテスト環境で固定されたランダムシード(シード=42)でロックされました。
学習効果解析
「中国伝統文化入門」に登録した合計120名の学部生が、事前試験スコアにより低・中・高の各レベル(各階層40人)に階層分けされ、階層内で実験群または対照群にランダムに割り当てられました(n=20人ずつ)これにより、条件間の基準的な同等性が確保されました。
手続き段階の検証とワークフロー出力<...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究は、構成主義と近接発達領域といった教育学の核心理論を、計算実装された知的教育システムに翻訳することで教育技術に貢献します。VR没入と行動主導型のパーソナライズの統合により、技術革新は目的として機能するのではなく、明確な学習目標に奉仕することを保証します。方法論で強調されているように、個別化学習経路の生成は教育プロセスの効率性を確保する上で中心的であり、抽出された行動特性に基づくコンテンツを推奨することは個々の認知ニーズに直接応えます25,26。さらに、リアルタイムの感情的・パフォーマンスフィードバックを活用して課題の難易度を調整することは、即時の学習効果を最適化するだけでなく、認知的過負荷を防ぐことで学生の関与を大幅に持続させます。
本研究の独自の貢献は、高忠実度の仮想空間トラッキングと継続的なアルゴリズム再調整を融合させ、没入型エンゲージメントと適応型学習の不整合を解決したことです。3つのA...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは、財政的な利益相反は一切ないと宣言しています。人工知能ツール開示:本論文作成の過程で、言語の洗練、専門用語の明確化、学術文献検索の支援のために大規模言語モデルが使用されました。すべての人工知能の成果物は批判的に評価され、一次査読済みの資料と手動で照合され、著者によって厳格な科学的正確性とデータの整合性を確保するために厳格に編集されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| High-fidelity spatial rendering engine | Unreal Engine 5 | シーン統合、ダイナミックレイトレーシング、物理シミュレーションに使用。 | |
| Ray tracing | Ray tracing | 物理原理に基づくライティングシミュレーション技術 | |
| 3D modeling software | Blender | 文化遺産のポリゴンモデルの生成とPBRテクスチャの適用に使用。 | |
| Level of detail | Level of detail | シーン最適化技術 | |
| Spatial audio | Spatial audio | 三次元空間における音の伝播特性をシミュレート | |
| Haptic feedback | Haptic feedback | 物理と相互作用する際のフィードバック力をシミュレート | |
| Visual scripting & programming interface | Blueprints & C++ | ユーザーインタラクションを設定し、空間行動データを継続的に記録するために使用。 | |
| Head-mounted display (HMD) | HTC Vive Pro | 没入型の視覚化、空間オーディオの配信、モーショントラッキングを提供。 |
参考文献
- Rojas-Sanchez MA, Palos-Sanchez PR, Folgado-Fernandez JA. Systematic literature review and bibliometric analysis on virtual reality and education. Educ Inf Technol (Dordr). 2023;28:155-92.
- Rospigliosi P. Metaverse or simulacra? Roblox, Minecraft, Meta and the turn to virtual reality for education, socialisation and work. Interact Learn Environ. 2022;30:1-3.
- Quadir B, Chen NS, Isaias P. Analyzing the educational goals, problems and techniques used in educational big data research from 2010 to 2018. Interact Learn Environ. 2022;30:1539-55.
- Lutfiani N, Meria L. Utilization of big data in educational technology research. Int Trans Educ Technol. 2022;1:73-83.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778.
- Hulusic V, Gusia L, Luci N, Smith M. Tangible user interfaces for enhancing user experience of virtual reality cultural heritage applications for utilization in educational environment. ACM J Comput Cult Herit. 2023;16:1-24.
- Mubarok H, Lin CJ, Hwang GJ. A virtual reality-based collaborative argument mapping approach in the EFL classroom. Interact Learn Environ. 2024;32:4978-96.
- Sun T, et al. Restoring Dunhuang murals: crafting cultural heritage preservation knowledge into immersive virtual reality experience design. Int J Hum Comput Interact. 2024;40:2019-40.
- Ouatik F, et al. Predicting student success using big data and machine learning algorithms. Int J Emerg Technol Learn. 2022;17:236-51.
- Bhaskaran S, Marappan R. Enhanced personalized recommendation system for machine learning public datasets: generalized modeling, simulation, significant results and analysis. Int J Inf Technol. 2023;15:1583-95.
- Gupta S, Kumar P, Tekchandani RK. Facial emotion recognition based real-time learner engagement detection system in online learning context using deep learning models. Multimed Tools Appl. 2023;82:11365-94.
- El-Wajeh YA, Hatton PV, Lee NJ. Unreal Engine 5 and immersive surgical training: translating advances in gaming technology into extended-reality surgical simulation training programmes. Br J Surg. 2022;109:470-1.
- Conde D, et al. LiDAR data processing for digitization of the castro of Santa Trega and integration in Unreal Engine 5. Int J Archit Herit. 2025;19:131-51.
- Rohe DP, Jones EM. Generation of synthetic digital image correlation images using the open-source Blender software. Exp Tech. 2022;46:615-31.
- Pradana MR, Setiawan D, Trinawati L. Efektivitas ilusi 3D animasi Blender pada curved LED billboard (AB Building Jl. Juanda Pekanbaru). JEKIN (Jurnal Teknik Informatika). 2023;3(2):1-10. Available from: https://pdfs.semanticscholar.org/e4fd/a249d78d46e24319e3a8f318e713f76c0cbd.pdf
- Wang Y, Zhao K, Zheng Z. An improved 3D indoor positioning study with ray tracing modeling for 6G systems. Mob Netw Appl. 2023;28:1162-75.
- Liu Y, et al. Intelligent ray-tracing-based simulation and emulation of channels. Chin J Radio Sci. 2024;39:1112-9.
- Weier P, et al. Neural prefiltering for correlation-aware levels of detail. ACM Trans Graph. 2023;42:1-16.
- Mercier C, et al. Moving level-of-detail surfaces. ACM Trans Graph. 2022;41:1-10.
- Zhu M, Sun Z, Lee C. Soft modular glove with multimodal sensing and augmented haptic feedback enabled by materials' multifunctionalities. ACS Nano. 2022;16:14097-110.
- Heng JJ, Teo DB, Tan LF. The impact of Chat Generative Pre-trained Transformer (ChatGPT) on medical education. Postgrad Med J. 2023;99:1125-7.
- Hung YC, et al. Comparison of patient education materials generated by chat generative pre-trained transformer versus experts: an innovative way to increase readability of patient education materials. Ann Plast Surg. 2023;91:409-12.
- Yang H, et al. CovidViT: a novel neural network with self-attention mechanism to detect Covid-19 through X-ray images. Int J Mach Learn Cybern. 2023;14:973-87.
- Kumar S, Solanki A. An abstractive text summarization technique using transformer model with self-attention mechanism. Neural Comput Appl. 2023;35:18603-22.
- Tapalova O, Zhiyenbayeva N. Artificial intelligence in education: AIEd for personalised learning pathways. Electron J e-Learn. 2022;20:639-53.
- Hashim S, et al. Trends on technologies and artificial intelligence in education for personalized learning: systematic literature. J Acad Res Progress Educ Dev. 2022;12:884-903.
- Lin W, et al. A deep neural collaborative filtering based service recommendation method with multi-source data for smart cloud-edge collaboration applications. Tsinghua Sci Technol. 2023;29:897-910.
- Ha J, Park S. NCMD: Node2vec-based neural collaborative filtering for predicting miRNA-disease association. IEEE/ACM Trans Comput Biol Bioinform. 2022;20:1257-68.
- Nuanmeesri S, et al. Improving dropout forecasting during the COVID-19 pandemic through feature selection and multilayer perceptron neural network. Int J Inf Educ Technol. 2022;12:851-7.
- Yilmaz O, Altun AA, Koklu M. Optimizing the learning process of multi-layer perceptrons using a hybrid algorithm based on MVO and SA. Int J Ind Eng Comput. 2022;13:617-40.
- Garcia Garcia C, Salmeron Gomez R, Garcia Perez J. A review of ridge parameter selection: minimization of the mean squared error vs. mitigation of multicollinearity. Commun Stat Simul Comput. 2024;53:3686-98.
- Thongsak N, Lawson N. Bias and mean square error reduction by changing the shape of the distribution of an auxiliary variable: application to air pollution data in Nan, Thailand. Math Popul Stud. 2023;30:180-94.
- Mohammed NA, Al-Bazi A. An adaptive backpropagation algorithm for long-term electricity load forecasting. Neural Comput Appl. 2022;34:477-91.
- Wright LG, et al. Deep physical neural networks trained with backpropagation. Nature. 2022;601:549-55.
- Bhimshetty S, Ikechukwu AV. Energy-efficient deep Q-network: reinforcement learning for efficient routing protocol in wireless internet of things. Indones J Electr Eng Comput Sci. 2024;33:971-80.
- Geng X, Zhang B. Deep Q-network-based intelligent routing protocol for underwater acoustic sensor network. IEEE Sens J. 2023;23:3936-43.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。