本研究では、異文化コンテキストにおける英語ライティングの転移能力を向上させるため、DeepSeekに基づいた階層的なプロンプト最適化フレームワークを開発しました。3段階のプロンプトチェーンと、英語専攻者60名を対象とした準実験を通じて、対照群と比較して実験群に有意な改善が見られたことが示されました。
この記事について
サマリー
要約
従来の英語ライティング指導において、言語転移の体系的な育成が軽視されており、既存のプロンプトフレームワークが教室での指導に適していないという課題を解決するため、本研究ではDeepSeekモデルに基づいた階層的な転移トレーニングシステムを構築した。このシステムは、文、段落、談話、文化という4つの段階的なタスク階層で構成され、すべてのタスクはトリプル形式で定義されている。構文、構造、文化、レジスター、論理をカバーする5次元のタスクライブラリを構築し、学生の実際のライティング草案からターゲットとなるプロンプトを自動生成した。モデルの混合専門家(MoE)アーキテクチャと統合し、複雑な課題を「意味の再構成」、「言語的修正」、「文化的適応」という3つの連続的なフェーズに分割する入れ子状のプロンプトチェーンを開発した。準実験的研究デザインを採用し、ある大学の英語専攻2年生60名を募集し、実験群と対照群にそれぞれ30名ずつ割り当て、3回のトレーニングラウンドにわたる3週間の段階的な介入を行った。実験後の結果から、実験群の文化転移スコアが2.8から4.5に上昇したのに対し、対照群の上昇はわずか0.3であった。また、教師による評価の平均点は、実験群では59.1から74.4に向上したが、対照群では60.1から64.9への上昇にとどまった。AIスコアリングと教師評価の相関係数の大部分は0.8を超え、参加者の90%以上がAIによる書き換えおよび構造最適化機能を支持した。本試行のサンプルサイズは小さいものの、この最適化アプローチは大学の英語ライティングクラスへの導入において実現可能である。
概要
異文化コンテクストにおける英語ライティング教育において、非ネイティブの英語学習者は、言語知識から実践的な応用へと移行する際に、転移能力の不足という課題に直面することが多い1,2。学生はある程度の文法や語彙の基礎を備えているものの、文型、構造、および文化的表現を実際のライティングに効果的に変換することに苦労しており、その結果、定型的な言語出力や思考の限定化を招き、最終的にライティング全体の質に影響を及ぼしている3。加えて、言語構造、論理構成、および語用論的規範における異文化間の差異が、ライティング転移の複雑さをさらに悪化させている4。近年、大規模言語モデル(LLM)はライティング教育に新たな技術的支援を提供している5。DeepSeekなどのインテリジェントなライティングツールは、言語生成および再構成において強力な能力を示している。しかし、教育現場では、それらのツールは主に表面的な言語修正に限定されており、転移能力の育成を中心とした教育プロセスに深く統合されるには至っていない。これらのツールには、教育目標への方向性と生成挙動の制御可能性が欠けている6,7。普及しているAI支援ライティングアプリケーションの多くは、その機能を表面的な文法エラーの修正に限定しており、体系的な転移能力の育成を目標としていないため、モデルの出力に対する教育的な制御が不十分である。
ESLライティング支援に関する既存の研究は、主に3つのカテゴリーに分類されます。すなわち、従来のプロンプト駆動型のライティングフィードバック、汎用的なAIによる推敲介入、およびマニュアル中心の転移学習です。第一に、一般的なプロンプトエンジニアリングの研究では、階層的な転移教育目標との整合性を図ることなく、質疑応答やテキスト書き換えの技術的な最適化が優先されています8,9。第二に、一般的なChatGPTベースのESL指導は、層状の構文的、構造的、および異文化間の転移能力の育成よりも、ライティング全体の正確性の向上に焦点を当てています10。第三に、模倣や対照ライティングに依存する従来の転移ペダゴジー(教育法)では、インテリジェントツールに支えられたクローズドループのフィードバックが不足しています11。先行研究とは異なり、本研究では、多層的な指導目標に沿った転移指向の階層的プロンプトをカスタマイズし、サンプル駆動型のプロンプト自動生成ワークフローを構築することで、モデルによる生成、教師によるフィードバック、および学生による修正を組み合わせた独自のクローズドループ訓練メカニズムを形成します。
先行研究では、言語文化的な相違、モデル固有の構造的制約、および断片的な教室での実践をまたぐ潜在的な関連性が仮説として立てられているが、このような因果関係は既存の実証研究において十分に検証されておらず、本論文で検証すべき中心的な研究仮説となっている12,13。本論文で言及しているDeepSeekの固有の特性に関しては、そのオープンなインストラクションインターフェースおよびMoEベースのエキスパートルーティング設計が、既存のモデル技術レポートや応用言語研究において記録されている。これらの文書化されたモデル特性に基づき、本研究では、複雑な異文化間転移タスクを分解するためのネストされたプロンプトチェーンを構築し、差別化された転移課題のための動的なサブモデルスケジューリングルールを開発する。構造化された転移能力の開発を中心に据え、本研究ではDeepSeekのターゲットを絞ったプロンプト最適化を探索し、大規模言語モデルを汎用的なテキスト編集ツールから、大学英語ライティング指導のための専門的な転移トレーニングシステムへと変換させることを目指す。
第二言語ライティング研究の分野において、転移現象は長らく中心的なトピックとなってきました14,15。伝統的な言語転移理論は、主に母語が目標言語の習得プロセスに与える正および負の転移効果に焦点を当てており、特に音声、語彙、統語論が重視されてきました16。Mirzayev Eは、英語を第二言語とする(ESL)ライティング指導において、第一言語からの負の転移が、学生のライティング能力の発達を制限する主要な要因であり続けていると指摘しました17。研究範囲の拡大に伴い、学術界では次第に文章構造の転移へと関心が広がっています18。中間言語によるライティングでは、複数の要因により、言語的な誤りや化石化がしばしば見られます19。同時に、認知転移理論への注目も高まっています20。この理論は、ライティングプロセスにおける認知的な構成や表現パターンの違いを強調しています。例えば、西洋のライティングは直線的な推論と明示的な論理を重視しますが、中国の伝統的な手法は螺旋的なアプローチと意味的な曖昧さを好む傾向にあります。この二者の間には大きな緊張関係が存在します。したがって、言語転移は単なる言語単位の変換だけでなく、より深いレベルでの思考構造や文化的表現規範の適応および変容を伴うものであり、これは現在の英語ライティング指導における重要な課題となっています21。
転移能力の育成において、既存の研究では、学習者が目標言語の転移メカニズムを理解し応用できるように、模倣作文22、対照作文23、翻訳訓練24などの戦略がしばしば採用されている。模倣作文は基礎的な談話能力の構築に役立つが、構造的な硬直化を招きやすい。対照作文は言語スタイルや文化的な意識を向上させることができるが、系統的なタスクの階層化や個別化されたフィードバックに欠けている。翻訳訓練は文化的比喩の認識を促進できるが、指導がなければ意味の逸脱や語用論的な不適切さを招きやすい。上述の戦略は主に手本による提示や経験的な指導25に依存しており、転移戦略の明示的な構築や系統的なフィードバックメカニズムを欠いているため、言語習熟度や認知スタイルの個人差に適応させることが困難である。一部の研究では、多様な作文タスクを通じて転移訓練を拡張しようと試みているが26,27、指導プロセスにおいて「転移目標―言語生成―戦略フィードバック」というクローズドループがまだ形成されていない。そのため、転移戦略の内面化効果は限定的であり、実際の作文タスクにおける学生の転移能力の発達は依然として不十分である28。
大規模言語モデル技術の発展に伴い、言語教育におけるその補助的な潜在能力がますます注目を集めています29。ChatGPT (Chat Generative Pre-trained Transformer)30やDeepSeek31に代表される生成AIツールは、文章の推敲、言語の書き換え、言語調整などのシナリオで広く利用されてきました。Diasamidzeらは、ChatGPTを使用したESL(第二言語としての英語)学習者が、文法的な正確さ、語彙の豊かさ、および文章構成能力の点において、従来の教授法を用いたグループよりも優れた成果を上げたことを明らかにしました32。しかし、既存のアプリケーションの多くは表層的な言語処理に限定されており、転移目標に関する体系的なガイダンスが不足しています。Ranadeは、現在の教育現場におけるプロンプトベースのプロジェクトの多くが汎用的なテンプレートに基づいており、生成されたコンテンツに文脈への適応性やタスク固有性が欠けていることを指摘しました33。さらに、主流のモデル学習はオープンコーパスに依存しており、中国語と英語の文化的表現の違いに関する深いモデリングがなされていません。そのため、生成されたテキストに文化的な不適切さや不自然な語用論が生じやすく34,35、これが異文化間ライティング転移教育への深い応用を制限しています。
プロトコル
倫理的承認
実験に先立ち、著者は大学から承認(承認番号:NBCC-ETH-2026-037)を得て、すべての学生参加者にインフォームドコンセント文書を配布した。すべての学生に対し、研究目的、実験手順、およびデータ使用規定について明確に説明を行った。参加は自発的なものであり、参加者はいつでも研究への参加を撤回することができた。プライバシー保護のため、すべての個人データおよび記述作品は匿名化され、学術的な分析のみに使用された。全60名の参加者は、研究に参加する前に同意書に署名した。参加者は、同一の高等職業大学における2つの並行した英語ライティングの2年生クラスから、便宜的サンプリングを用いて募集された。組み入れ基準は、CET-6に合格し、スコアが > 425名で、今学期の欠席はなく、直近2回のユニット記述テストの得点が平均的であった。除外基準は、授業外での市販の英語AIライティングソフトの長期的な利用、および重度の失読症とした。
すべての連続的なアウトカム変数のばらつきは、平均値 ± 標準偏差(SD)として報告した。すべての分析は、1グループあたり n = 30 名(実験群 vs. 対照群)、合計 N = 60 名のサンプルサイズで実施した。縦断的な反復測定データについては、反復測定分散分析(RM-ANOVA)を用いて、群と時間の主効果、および群と時間の交互作用を検討した。個々の時点における事後ペア比較には、独立標本t検定を用いた。対照群には、従来のライティング指導に加え、汎用的で無料のカスタマイズされていないAIライティングツール(階層的なプロンプトや転移指向のテンプレートなし)を提供した。指導時間、ライティングタスク、フィードバックの頻度、およびトレーニングテキストは、本研究で使用したカスタマイズ済みのネストされたプロンプトチェーンおよび5レベルのタスクライブラリ介入がない点を除き、実験群と同一とした。実験群では、DeepSeekモデルに基づいた指導法を用いてライティング指導を最適化し、これにはネストされたプロンプトチェーンによるガイダンス、異文化適応アウトプット、および「生成-省察-再生成」メカニズムが含まれていた。対照的に、対照群では従来の教授法または最適化されていないAI支援ツールを用いた。これら2群の教育効果を比較することにより、大規模言語モデルに基づいた転移トレーニング法が、学生のライティング転移能力の向上に有効であることが検証された。
研究の全体像
本研究は、学生の英語ライティングにおける転移能力の向上と、効果的な指導設計手法の開発を目的とし、特にDeepSeekの教育的利用への適応に焦点を当てた。まず、モデルのプロンプトを再設計するための指導最適化戦略を提案した。これにより、統語構造、段落の論理構成、文化的表現など、ライティング指導における複数の転移目標に対する生成出力の整合性が向上した。次に、教師によるライティング課題を、構造化された目標指向型のプロンプトテンプレートに変換した。その後、指導課題とモデルの動作との間にマッピング関係を構築した。これにより、モデルの制御性が向上し、生成されるコンテンツが教育学的に適切であることが保証された。最後に、「生成ーリフレクション(省察)ー書き換えー再生成」というクローズドループ形式の転移トレーニングプロセスを開発した。このプロセスにより、学生はモデルのサポートを受けて転移戦略を特定し、言語表現を能動的に洗練させることが促進された。繰り返しのイテレーションを通じて、学生の言語間および文化間のライティング転移能力が継続的に強化された。文構造変換の手順を図1A–Dに示す。
AI支援ライティングトレーニングシステムの完全な動作ロジックを明確にし、再現性を向上させるため、全体の実施ワークフローを表1にまとめました。ここには、生の入力、教師による介入、プロンプトの適用、学生の活動、最終的な出力、および対応する評価基準を含むコアとなる連携プロセスが含まれています。
転移指向型タスク構築戦略
本研究では、英語ライティングにおける転移能力の育成に焦点を当てました。浅いレベルから深いレベルへと進む転移タスクの経路を構築し、学生が多層的な言語転移戦略を体系的に習得し実践できるよう指導しました。この経路構造全体を記述するため、4つのレベルからなるタスクセットとして定義しました。
T = {T1,T2,T3,T4} (1)
T1 は文レベルの転移タスクを表しており、短文の拡張、能動態・受動態の切り替え、節の置換など、基本的な文法構造の操作に焦点を当て、学生が多様な文構造の手法を習得することを目的としています。T2 は段落レベルの転移タスクであり、段落内における情報の構成と接続に注意を向けさせ、主文の抽出や文間論理の調整を通じて、段落の構造的な明快さと表現の一貫性を向上させる訓練を行います。T3は談話レベルのタスクを表し、章全体の論理的レイアウトや議論のリズムへとさらに拡張し、段落の順序調整や構造的な並置関係の最適化を行うことで、完全な議論体系を備えた英文記事を構築するように学生を導きます。T4 は文化レベルの転移タスクであり、含みを持たせた言い回しや意味的なヒントなど、母国語のライティングにおける潜在的な文化的表現特性を特定し、それらをターゲット言語の文化に適合する直接的な表現や論理的に明示的な形式へと変換することを学生に求めます。その進化プロセスをFigure 2に示します。タスク設計の操作性と評価を高めるため、本研究では各レベルのタスクをさらにトリプル形式として定義しました。
Ti = (Si,Gi,Ei) (2)
Sj はタスクの入力サンプルを、Gi はターゲットとなる転移操作を、そしてEi は補完的な評価基準を表します。この構造化された表現により、タスクの各レベルが前レベルの戦略の習得に基づいて構築され、対応するサンプル、ターゲットの説明、およびパフォーマンス基準が備わっていることが保証され、転移パスを着実に前進させるメカニズムが提供されました。転移トレーニングシステムの構築プロセスにおいて、タスクタイプの体系的な網羅と指導指示の効率的な管理を実現するため、本研究ではライティング転移における共通の言語変換次元に基づいた、5種類の転移目標をカバーする構造化タスクライブラリを構築しました。このタスクライブラリは、正式に次のように表現されました:
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj は、統語的転移、構造的転移、文化的転移、レジスター転移、および論理的転移という5つの転移次元に対応しており、各次元に関連付けられたタスクセットTDj はその操作サブセットを表します。タスクライブラリの開発プロセスにおいて、まず著者は、多数の実際の学生の作文サンプルに基づき、一般的な転移の困難さと言語エラーのタイプを要約および分類しました。そして、実際の教育ニーズと評価基準と組み合わせることで、異なる転移タイプを機能領域に分け、各タスクの核心的なトレーニング目標と操作モードを確立しました。各タスクは、以下のトリプル構造として抽象的に表現されました:
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,jはタスクの入力サンプルを、Gi,jはタスクの転移ターゲット記述を、そしてCi,jはタスクの評価および制御次元を表します。構文転移タスクにおいて、本研究では、文の接続、節の入れ子構造、受動態への変換、および関連概念を網羅し、単純なものから困難なものへと進む文再構成シーケンスを設計し、学生の文拡張能力および文法変換能力の向上を目指しました。構造転移タスクでは、主文の書き換え、支持文の整理、および因果関係や例示関係の再構築を通じて、パラグラフ論理の最適化、情報組織化の強化、および論理構築能力の向上に焦点を当てました。文化転移タスクは、異文化コーパスに基づき、含みのある表現や婉曲表現などの語用論的な乖離をターゲットとしています。ここでは、文化的適応力の向上を促進するため、実際の文脈に近い表現変換を設計しました。レジスター転移タスクでは、口語表現を学術的な言語に変換し、レジスターを切り替える戦略を習得するように学生を指導しました。論理転移タスクでは、推論チェーンの構築と表現の明快さの確保に焦点を当て、接続詞の使用、論理関係の明確化、およびパラグラフ間の移行に関するトレーニングを実施しました。
本研究では、学生の実際のライティングサンプルに基づき、教授タスクと密接に結びついたプロンプト生成プロセスを開発し、指示の適切性と生成コンテンツの実用性を高めることを目的とした。このプロセスは教師主導で行われ、教師は教授プロセスの中で、冗長な文章、混乱した構造、不適切な文化的表現といった典型的な転移問題に焦点を当て、代表的な学生のテキスト断片を選出した。その後、教師はシステムインターフェースを通じてサンプルに転移タイプをアノテーションし、トレーニング目的を明確にした。アノテーション情報の受信後、システムは転移タスク識別モジュールを自動的に起動した。次いで、入力内容を事前定義されたタスクライブラリおよびプロンプトテンプレートライブラリと照合した。この照合プロセスでは、転移タイプ、言語的特徴、テキスト構造などの要因が考慮された。これらの要因に基づき、システムは最も適切なテンプレートを選択して初期プロンプトを生成した。また、システムは構造化された強化処理をサポートしていた。教師によるアノテーションは、モデルが容易に解釈できる標準化された形式に変換された。モデルが教師の意図と学生の疑問の両方を正確に理解できるよう、関連する指導上のヒントがプロンプトに組み込まれた。指示の柔軟性と制御性を向上させるため、システムには教師支援モジュールが組み込まれた。このモジュールにより、教師は指導ガイダンスの修正、コンテキスト設定の調整、およびトーンやスタイルのカスタマイズを行うことで、プロンプトを洗練させることが可能となった。その結果、教師は生成プロセスをより高度に制御でき、さまざまな教育シナリオへの適応力を高めることができた。
Deepseekコマンド最適化メカニズム
英語ライティングの転移訓練における実務的なニーズに基づき、本研究では5種類の転移指向型プロンプトテンプレートを開発した。これらのテンプレートは、大規模言語モデルの生成挙動を誘導および制御するように設計されている。構造的転移テンプレートは、段落構成とディスクール構造に焦点を当てたものである。これにより、学生が「導入ー本論ー結論」などの構造を採用し、アイデアの論理的な流れを改善することで、テキストを再構成することを支援した。統語的転移テンプレートは、文レベルの複雑さを重視した。受動態、並行構造、複文など、多様な文法構造の使用を促し、記述表現の洗練度を高めることを目的とした。文化的転移テンプレートは、ライティングにおける文化的な適切さを扱った。母国語や自文化の影響を受けた表現を、英語圏の文脈においてより自然で受け入れられやすい形式に適応させるよう学生を誘導した。レジスター転移テンプレートは、スタイルの適応とレジスター制御に焦点を当てた。これにより、学生が異なる執筆目的、読者、およびジャンルに応じて言語使用を調整することを支援した。論理的転移テンプレートは、論理構成の強化を目的とした。因果関係、比較対照、並行展開などの関係性を効果的に活用することを促進し、それによって一貫性と論証の厳密さを向上させた。これら5つのテンプレートを合わせることで、ライティング転移の主要な次元を網羅した。これらは、指導タスクの設計とモデルベースのテキスト生成の両方に対して、構造化された指導的サポートを提供した。
各テンプレートタイプは、異なる教育場面における汎用性と適応性を確保するため、統一された形式に従って作成されました。テンプレートは4つの核となる要素で構成されています。1つ目は「指導ターゲット」であり、要求される転移タスクを明確に示しました。2つ目は「サンプル入力」であり、指導の効果を裏付けるコーパスの根拠として、実際の言語断片を学生に提供しました。3つ目は「ターゲット出力」であり、学生が比較しモデル調整に利用できるよう、転移後の理想的な言語出力の標準的なスタイルを示しました。4つ目は「使用上の提案」であり、そのテンプレートに適用可能な言語レベル、テキスト形式、および使用戦略を解説し、生成の制御と指導効果を高めるための調整可能なパラメータプロンプトを提供しました。
プロンプトテンプレートの設計論理と実践的な適用をさらに具体的に示すため、転移指向プロンプトの代表的な5つの例を以下に提示します。すべてのテンプレートは、指示ターゲット、サンプル入力、ターゲット出力、および使用上の提案からなる統一フレームワークに準拠していました。学生は、単純な文章の拡張、文形式(能動態・受動態)の変換、および節の埋め込みを行うよう指導され、構文上の多様性を高める練習を行いました。例えば、学生によるドラフトの「I study English writing. It is very important for cross-cultural communication」に対し、最適化された出力は「Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication」となりました。このプロンプトは、基本的な構文再構築と文形式の変換に重点を置いた、中程度の難易度の英語学科2年生向け文レベルトレーニングに適していました。もう一つのプロンプトタイプは文化転移を対象としており、母国語の文化的思考の影響を受けた Chinglish 表現を特定し、西洋の文化的規範に準拠した自然な英語の語用論的表現に書き換えることを目的としていました。学生の文章「Many people think you must work hard if you want to succeed」を例にとると、修正版は「People generally believe that diligence is the key to success」となりました。このプロンプトは、潜在的な中国語の思考パターンを排除し、英語の文脈における明示的な表現を育成することに重点を置いた文化レベルの転移トレーニングに適用されました。
本研究ではまた、学生が作成したパラグラフの草案を統合入力として受け取り、連続的なフェーズで動作する3段階の入れ子構造(ネステッド)プロンプトチェーンを開発した。第1フェーズは意味的な再構成であり、プロンプトによって、提示されたパラグラフの文章を並べ替え、アイデアの論理的順序を最適化し、明確なトピックセンテンスを持つ完全なパラグラフを形成することが参加者に求められた。第2フェーズは言語的な修正であり、修正後のパラグラフを正式な学術的英語に書き換え、口語的な単語を置換し、複文や受動態の構造を適切に使用することが求められた。第3フェーズは文化的適応であり、プロンプトに従って、テキスト内の文化的・語用論的な表現を確認し、母国語による文化的干渉を取り除き、英語の異文化間ライティングの慣習に合うように内容を推敲した。以上の例は、単一プロンプトテンプレートと入れ子構造プロンプトチェーンの動作モードを十分に実証したものである。これに基づき、本研究ではDeepSeekのMoEアーキテクチャを組み合わせた完全な段階的プロンプトチェーンを設計した。
生成コントロールとタスク応答の深度における単回プロンプトの限界を克服するため、本研究では、段階的かつ連続的な特性を持つネストされたプロンプトチェーン構造を設計し、階層的なガイダンスと複雑な翻訳タスクの段階的な生成を可能にしました。このメカニズムは、完全な翻訳タスクをいくつかのサブゴールに分解し、それぞれのサブゴールに対応するプロンプトテンプレートを設計したものです。これらは、意味の再構築、言語スタイルの調整、および文化的・語用論的な適応という論理的順序で直列に接続され、文脈依存性を伴う生成チェーンを形成しました。本研究では、標準的なオープンAPIを介してDeepSeekにネストされたプロンプトチェーンの最適化を実装しました。DeepSeekモデルは、自動バックエンドエキスパートルーティングシステムを備えたMixture of Experts (MoE) アーキテクチャをネイティブに採用しており、これは外部プロンプトから独立した固有の内部推論モジュールとして機能します。カスタマイズされた多段階プロンプトは、モデル入力のコンテンツ特性のみを調整しました。最適化された入力に組み込まれた意味的、形式的、および文化的な要求に応じて、モデル固有のMoEルーティングメカニズムが、テキスト生成中に最も適切なエキスパートモジュールを自律的に活性化させました。意味的な再編成、スタイルの調整、および文化的適応に焦点を当てた3段階のプロンプト設計は、入力テキストを洗練させるのみであり、モデル内部のエキスパート選択および割り当てロジックを妨げるものではありませんでした。
運用プロセスの点では、本システムは教師によってアップロードされた学生のテキストを受信し、ターゲットとなるアノテーションを転送し、入れ子状のチェーン構造を有効にするかどうかを自動的に判定しました。有効な場合、システムは3つのステージを順に実行しました。第1ステージは意味的再編成であり、構造転送テンプレートを呼び出して段落構成と論理的な手がかりを最適化しました。第2ステージは言語スタイルの調整であり、言語テンプレートを用いて口語表現を学術的な書き言葉に変換しました。第3ステージは文化的適応であり、文化転送テンプレートを呼び出してターゲット言語の文化に適合しない表現を特定および置換し、より自然なテキストを生成しました。
各生成ラウンドでは、前ラウンドの出力を入力として使用し、意味的な一貫性を確保するためにコンテキストベクトルのキャッシュを保持しました。教師は、テンプレートの選択、指示の修正、シーケンスの調整など、システムインターフェース内でプロンプトチェーンの構造をカスタマイズしました。また、システムは「テンプレート組み合わせパッケージ」機能をサポートしており、教師がタスクを再利用したり一括で割り当てたりすることが容易になりました。さらに、システムには動的な中断およびフィードバックメカニズムが組み込まれており、各生成後に中間結果が提供されました。教師はそれ以降の指示をリアルタイムで注釈付けまたは調整し、「生成-調整-再生成」という教育のクローズドループを形成しました。
モデルの生成と評価
DeepSeekモデルに基づいたテキスト生成および評価プロセスにおいて、本研究では、構文の複雑さ、構造の標準化、および談話の一貫性の3つの側面から生成されたテキストを体系的に分析し、定量的に評価するための多次元自動採点メカニズムを構築した。テキストの特徴抽出と自動評価には、spaCy依存構文解析器およびCoreferee共参照解析拡張モジュールを採用した。spaCy依存構文解析器を用いて英語テキストの構文構造を解析し、平均文長や入れ子構造の節の数などの主要指標を抽出することで、構文の複雑さの定量的な分析を可能にした。spaCyフレームワーク内で動作するCoreferee共参照解析拡張モジュールは、主にテキスト内の内部的な参照関係を特定し、談話の参照的一貫性を評価することで、ライティング品質の自動採点に向けた技術的支援を提供した。ネットワーク制限のため、前述の海外オープンソースウェブサイトへのアクセスは不可能であった。
まず、システムは構文的な複雑さを評価しました。平均文長、節の埋め込み深度、文の多様性などの特徴量を抽出しました。これらの特徴量は、依存構造解析および深い構文木モデリングを通じて取得されました。その結果に基づき、学生が単純な文パターンからより複雑な構造へと適切に移行できているかをシステムが判定しました。次に、システムは段落の構成を評価しました。BERTベースのテキスト表現と分類モデルを組み合わせ、トピック文、支持文、結びの文を含む段落の主要構成要素を特定しました。その後、段落構造マップを作成し、構成が英語のアカデミックライティングの慣習に従っているかを確認しました。第三に、システムは文章の一貫性を評価しました。論理的な接続詞の使用状況、文間の意味的な整合性、およびテキスト全体における照応関係の質を検証しました。これらの指標を用いて、論理展開の明快さとアイデアの円滑な進行を評価しました。トピックの一貫性を測定するため、システムはベクトルベースの表現を用いて意味的類似度を算出しました。照応の一貫性は共参照解析の手法を通じて評価され、これにより意味的な乖離や曖昧な指示の削減を図りました。最後に、すべての次元からのスコアを統合し、統一されたスコアリングベクトルにまとめました。結果を標準化して包括的な評価システムを構築することで、異なるライティングサンプル間での信頼性の高い比較を可能にしました。
手動評価フェーズにおいて、本研究では、教員による評価の妥当性と指導フィードバックの効果を高めるため、転移行動の明快さ、表現の自然さ、および文化的適応性の3つの側面からなるライティング転移トレーニング用の3次元スコアリングシステムを開発した。このシステムは補助機能を組み合わせることで、定量的なスコアリングと定性的なコメントを有機的に統合させている。転移行動の次元では、教員はあらかじめ設定されたタスク目標に基づき、学生がテキストの書き換えにおいて転移戦略をどのように使用したかを判定した。システムは、原文と生成されたバージョンの並列比較ビューを提供し、文の調整や構造の再構築といった操作が、要求される転移タイプを効果的に反映しているか教員が判断できるよう支援した。
自然な表現の評価では、言語出力の流暢さと真正性に重点が置かれました。教師はシステムによって生成された言語指標を用いて、文章が英語ネイティブスピーカーの表現習慣に準拠しているか、また文法構造、単語のコロケーション、文章のリズムが自然で適切であるかを評価しました。また、アノテーションを通じて問題点を指摘し、代替表現を提案しました。文化適応性の次元では、異文化間語用論の適切性に重点が置かれました。教師は、意味的な曖昧さ、修辞的な矛盾、または漠然とした価値判断など、ソース言語の文化的な干渉に起因する不適切な表現がテキストに含まれていないかを確認する必要がありました。システムは一般的な文化的逸脱語の例を提示し、教師がコメント欄で修正の根拠や文化的背景の要件を説明することをサポートすることで、学生の文化的転移への意識と表現の正確性の向上を導きました。各次元は5段階でスコアリングされ、自由記述のアノテーションおよび提案入力モジュールが含まれていました。最終的な評価結果はレーダーチャートとして提示されました。
評価効率を向上させ、実際の教室での活用を支援するため、本研究ではAIベースのスコアリングと教師による評価を組み合わせた協調的評価メカニズムを開発しました。本システムでは、まずDeepSeekによって生成されたテキストの多次元評価を行います。自動スコアリングモジュールを通じて、構文の複雑さ、段落構成、テキストの一貫性などの主要な側面を評価します。スコアリング結果は、教師用インターフェースにリアルタイムで表示されます。教師は各次元の詳細なスコアを確認し、専門的な判断や生徒の転移パフォーマンスへの理解に基づいて、必要に応じてそれらを調整します。また、自動スコアリングでは捉えきれないフィードバックや指導上の提案を提供するため、テキストに直接、的を絞ったコメントを追加します。各評価次元には5段階の評価スケールを採用しました。インターフェースには、パーソナライズされたフィードバックを容易にするための自由形式のテキスト注釈および推奨モジュールも含まれています。評価結果はレーダーチャートで可視化され、教師はさまざまな転移次元における生徒の強みと弱みを迅速に特定できるようになっています。
さらに、本システムでは、指導目標に合わせて特定の次元の重み付けや総合スコアを教師が調整することが可能でした。この機能により、最終的な評価において生徒の実際のパフォーマンスや学習ニーズをより正確に反映させることができました。手動レビューの完了後、システムは機械生成された評価データと教師が生成した評価データを自動的に統合しました。その後、視覚的なフィードバックレポートが作成されました。このレポートには、転移パフォーマンスのレーダーチャートとバージョン追跡チャートが含まれていました。これらの視覚化により、複数回にわたるテキスト生成と修正を通じた生徒の転移能力の変化が明確に示され、学習進捗の継続的なモニタリングが可能となりました。
転移学習プロセス
本研究では、完全な転移トレーニングプロセスを設計した。まず、教師が指導目標と学生の実際のレベルに基づいて特定の英語ライティング課題を割り当て、トレーニングの転移タイプと重点を明確にした。次に、システムが教師の設定した課題に基づき、対応するプロンプト命令を自動的に生成し、DeepSeekモデルを呼び出してライティングの初稿を作成させ、これを学生のリライティングおよび転移トレーニングの基本資料とした。初稿を受け取った後、学生はテキストに反映されている転移の特徴を能動的に特定し、学習した転移戦略を用いて、構文構造、段落構成、および文化的表現の適切性を向上させるために、目的を持って内容をリライティングする必要があった。リライティングの完了後、教師は学生が提出したテキストに対して詳細なレビューを行い、転移戦略の有効性を強調し、改善のための具体的な提案とライティング指導を提供した。教師のフィードバックに基づき、DeepSeekモデルを再度呼び出して最適化されたバージョンを生成し、学生がテキストをさらに洗練させ、転移戦略の実践を深めることを支援した。最終的に、学生は最終稿の提出を完了し、転移認知表への記入、自己評価、および転移方法とその効果のまとめを行い、メタ認知能力の向上とライティング転移スキルの内面化を促進した。本研究のために設計された転移認知表をTable 2に示す。
すべての項目において、1(習得していない)から5(完全に習得している)までの1~5段階の評価尺度を採用しました。自己評価データは3回の連続トレーニング後に収集されました。スコアリングのベンチマークは、5次元タスクライブラリにおける事前定義された移送操作基準に基づいています。
結果
実験計画法の指導
本研究では、DeepSeekの基本的なオープンソース版を使用し、プログラム呼び出しにはプラットフォームのオープンAPIインターフェースを利用した。5種類のプロンプトテンプレートテキスト、4段階のタスク例エントリ、転移アノテーションカテゴリタグ、および作文誤りテンプレートの照合マッピングルールの完全なセットは、補足付録にまとめられている。システムの呼び出しパラメータは、温度係数0.7で固定されており、生成される長さは作文の問題形式に基づいて動的に制限された。また、「意味の再構築 > スタイルの調整 > 文化的適応」という固定された順序に厳格に従い、ネストされたプロンプトチェーン呼び出しを実行した。モデルの出力は、教室での教育に効果的なテキストを指導者が手動で選択した。
本研究では、5年以上の経験を持つ大学での英語ライティング専任講師3名に、手動スコアリングへの参加を依頼した。すべての採点者は、本採点に先立ち標準化トレーニングを受け、評価次元、5段階評定システム、文化的転移、構文、ディスクルス、およびその他の採点詳細について習熟し、採点前のキャリブレーションを完了した。すべての学生のエッセイは、2名の講師によってブラインドおよびダブルブラインド形式で独立して採点された。2名の採点者のスコアに1点(5点満点中)を超える差があった場合は、3人目の上級講師が裁定を行い、2つの有効なスコアの平均値をそのサンプルの最終的な手動スコアとした。評価段階では、異なる研究目的に応じて2つの採点者グループが関与した。本実験におけるすべての学生のライティングサンプルに対しては、5年以上の指導経験を持つ大学の英語ライティング専任講師3名がブラインドでのダブルスコアリングを行い、5段階評価でスコアの不一致が1点を超えた場合に3人目の上級講師が裁定役を務めた。対照的に、評価基準の評価者間の一貫性を検証するために別途実施された級内相関係数(ICC)を用いた評価者間信頼性テストには、5名の採点者が参加した。採点者数の違いは、それぞれ異なる機能的要件に起因する。すなわち、3名のコア講師が実験データの実際的な採点を保証し、拡大された5名の採点者パネルが評価システム全体の信頼性についてより強固な根拠を提供した。
構文の複雑さ、BERTによる文章構造スコアリング、および意味的類似性は、すべて0~5点の範囲でスコア化されました。各次元のウェイトは、外国語ライティングの教育および研究基準に従い、構文に0.35、文章構造に0.35、論理と文化に0.3と設定されました。これらのウェイト値は、同分野における成熟したライティング定量評価システムに基づいています。AI自動採点モジュールは、あらかじめ分類された15編のモデルエッセイに基づく閾値を用いて調整されました。人間による採点は、統一された5段階評価スケールに従って行われました。正式な評価に先立ち、機械採点と人間による校正を組み合わせた事前実験による検証が行われました。
教育タスクは、「構文-構造-文化」の3段階の転移目標に沿って、それぞれ1週間とする3回のトレーニングラウンドで実施されました。第1ラウンドでは、構文の多様性と表現の正確性を向上させるために文レベルの書き換えを行い、第2ラウンドでは、段落の構成と論理的整合性を高めるために段落レベルの構造再構築を行い、第3ラウンドでは、異文化間の語用論的な意識と表現の適応力を強化するために文化レベルの転移を行いました。事前テスト、3回の連続したトレーニングラウンド、および事後テストを通じて同一の参加者から収集された反復測定データに基づき、群(実験群 vs 対照群)の主効果、測定時期の主効果、およびトレーニング期間中のスコア変化が2つのグループ間で異なるかを示す群×時期の交互作用効果を検証するため、主要な統計的手法として反復測定分散分析(RM-ANOVA)を採用しました。球面性の仮定はMauchlyの検定で検証し、球面性が満たされない場合はGreenhouse-Geisser補正を適用しました。独立標本t検定は、個別の時点におけるグループ間の事後ペア比較のみに使用し、スコアリングの一貫性の確認にはPearson相関を、効果量の定量化にはCohen's dをそれぞれ使用しました。
すべての統計解析は、データ収集前にあらかじめ規定されていた。2群間におけるライティング指標の事前・事後比較には独立標本t検定を用い、主要な帰無仮説として、ライティングの転移パフォーマンスに群間差がないと想定した。AIによる自動採点と教師による手動評価の間の線形関連性を定量化するためにピアソン相関分析を用い、群間比較の標準化効果量としてCohen’s dを算出した。すべての仮説検定において有意水準はα = 0.05に設定し、すべての検定統計量とともに95%信頼区間を算出した。すべての統計計算にはSPSS 26.0を使用した。全参加者が3ラウンドのトレーニングおよび関連する評価をすべて完了したため、学生のテストスコアおよびアンケートデータセットに欠損値は発生せず、したがって欠損値に対する代入やケースの削除は不要であった。
評価指標システムの構築
英語ライティングの転移トレーニングにおける学生のパフォーマンスを包括的に評価するため、本研究では「構文・構造・文化」という3レベルの転移目標をカバーし、言語能力、モデルへの反応、指導フィードバック、および自己認識を統合した多次元評価システムを構築し、6つのコア指標を設定した。まず、「ライティング転移指数」は、構文の多様性、構造の明快さ、および文化的適応性をカバーする総合評価指標であり、定量分析のためにシステムの自動採点と教師による手動採点を組み合わせた。 「構文複雑性スコア」では、自然言語処理技術を用いて、平均文長、節の入れ子レベル数、動詞句の使用頻度などの特徴を抽出し、学生の文章の豊かさと複雑さを評価した。「学術的スタイルの適合性」分析では、NLP(自然言語処理)モデルに基づき、受動態の使用割合とフォーマルな語彙の割合を検討し、テキストが英語学術ライティングのスタイル規範に準拠しているかを確認した。さらに、本研究では主観的評価の次元を導入し、教師へのアンケートを通じてモデルが生成した提案の受容性と実用性に関するフィードバックを収集し、AI支援指導の実際の影響を評価した。「教師による添削スコアの変化」は、実験前後の学生のエッセイに対する教師のスコアを比較することで、AI支援指導がライティングの質の向上に与えた影響を反映した。最後に、「転移能力に関する学生の自己評価」では、転移認知表を用いて、構造、構文、文化などの次元における習熟度を学生自身に自己評価させ、それによってメタ認知能力と省察能力を高めた。各指標の具体的な説明とデータソースをTable 3に示す。
統語的および文体的な指標は、依存構造解析およびBERTベースの分類を用いて自動的に算出され、正規化されたスコアは0から5の範囲で設定しました。手動評価には5段階評価尺度を使用しています。統語的複雑性の計算式では、総単語数/節数を基本の分母として使用しました。生データのソースは、登録した全60名の学生による事前テストおよび事後テストの作文です。
実験結果と解析
統語的転移、構造的転移、および文化的転移という3つの次元における学生の総合的なパフォーマンスの差を直感的に提示するため、 図3 実験群と対照群の学生における、実験前後の平均ライティング転移指数の比較: 図3 統語的転移、構造的転移、および文化的転移の3つの次元における、実験群と対照群の平均スコアの差が示された。実験群は、実験後に各次元において転移能力の有意な向上を示し、レーダーチャートの外円が内円よりも著しく大きくなっている。これは、DeepSeekモデルに基づいた指示最適化手法が、学生の英語ライティング転移能力の開発を促進する上で正の効果を持つことを示している。対照的に、対照群の各種転移能力指標は、実験前後で比較的変化がなかった。全体的な向上は限定的であり、従来の教授法やシステム指示を最適化していないAI支援ツールは、転移トレーニングにおける役割が限定的であることを示唆している。多次元的な言語転移において、学生の学習ポテンシャルを効果的に刺激することは困難であった。
実験群における構文転移、構造転移、および文化転移の次元での平均ライティング転移指数は、実験前はそれぞれ3.0、2.9、2.8であったが、実験後には4.3、4.1、4.5へと上昇し、それぞれ1.3、1.2、1.7の増加を示した。これは、提案した指導法が異なるレベルの転移において良好な介入効果を有していたことを示している。対照群の実験前のスコアは3.0、3.0、2.9であった。実験後、これらの値はそれぞれ3.4、3.3、3.2に上昇したが、これらは実験群のスコアよりも有意に低かった。特に注目すべきは、文化転移の次元において実験群が最も顕著な改善を示し、2.8から4.5へと1.7ポイント増加したことであり、これは対照群の0.3ポイントの増加よりも有意に高かった。この結果は、提案された指導法が、学生が英語の文化的表現規範を特定し、それに適応することを支援する上で重要な役割を果たすことを示唆している。これは言語形式の調整に反映されただけでなく、学生の異文化間語用論的意識の向上や、ターゲット言語の文化的表現習慣に対する理解の深化にも反映されていた。言語転移は主に、構文の複雑さや言語スタイルの適応などの側面に現れていた。本研究では、自動NLP技術を用いて学生のライティングテキストの詳細な分析を行い、主要な言語特徴を抽出した。そして、教師による採点と組み合わせることで、3回にわたるタスクを通じて学生の言語転移能力の変化を体系的に評価した。
構文上の複雑さと言語スタイル
構文の複雑さに関しては、各ラウンドのタスクにおいて指定されたライティング課題を完了した後に学生が作成したテキストの、平均文長および節の入れ子レベル数を記録した。これら2つの指標は、言語表現の複雑さを測定するために広く用いられている。これらは、図4に示すように、学生の文の多様性と構造的組織化能力の発達レベルを効果的に反映していた。
統語的複雑性の経時的変化において、実験群は3回のタスクを通じて明確な上昇傾向を示し、転移トレーニングが学生の言語構造表現能力を効果的に促進したことが反映された。平均文長の観点からは、実験群はタスク1の12.5語からタスク3の16.1語へと増加し、3.6語の増加となった。これは、同期間における対照群のわずか0.9語の増加(12.4語から13.3語)よりも有意に高かった。同様に、節の入れ子構造の層数で測定した構造的複雑性の次元においても、実験群は1.8層から2.7層へと増加したが、対照群は1.7層から1.9層への緩やかな増加にとどまった。2群間の統語的複雑性の差に統計的有意性があるかを確認するため、本研究では独立サンプルt検定を用い、タスクの3段階における平均文長および節の入れ子層数を分析した。その結果、平均文長において実験群と対照群の間に有意な差が認められ、t(58) = 4.23, p < 0.001, Cohen’s d = 0.98 であった。また、節の入れ子層数においても有意な差が認められた(t(58) = 3.15, p = 0.002, Cohen’s d = 0.78)。この比較により、体系的な転移トレーニングが学生の複文構築能力を向上させただけでなく、文法構成戦略の習得を強化したことが示された。特にタスクの第3段階において、実験群の学生は多層的な節や複雑な文構造の使用においてより高い柔軟性を示した。これは、彼らの言語転移が「機能的」レベルから、より「戦略的」なレベルへと著しく移行したことを反映している。転移指向のトレーニング経路は、学生の統語的転移スキルを継続的に向上させ、従来の教授法で頻繁に見られた単文形式のライティングや固定的な表現パターンの限界を効果的に克服した。言語スタイルの適応に関しては、実験前後の学生の執筆テキストを抽出し、NLPモデルを用いて、フォーマルな語彙の割合と受動態の使用頻度を、学術的な言語スタイルの適合性を評価するための核心的な指標として算出した。これらの指標は、学生が英語ライティングにおいてターゲットとするスタイルに適応するための言語意識と表現能力を備えているかを示している。関連する結果をFigure 5に示す。
図5は、タスク前後における実験群と対照群のアカデミックスタイルの適合性の変化を示しており、主にフォーマルな語彙の割合と受動態の使用頻度という2つの核心的な指標に焦点を当てている。全体として、DeepSeekモデルに基づいた転移トレーニングを完了した後、実験群のアカデミックスタイルへの適応能力は著しく向上し、学生の言語規範に対する意識とアカデミックスタイルへの適応能力を養う上でのこの教授法の有効性が実証された。フォーマルな語彙の割合に関しては、実験群はタスク前の0.42からタスク後には0.56へと、比較的大幅に増加した。対照的に、対照群は0.43から0.48へとわずかに増加したのみであり、改善は限定的であることが示唆された。この結果は、体系的なプロンプト指導とモデルからのフィードバックを受けた後、実験群の学生が執筆プロセスにおいてアカデミックスタイルの要件を満たすフォーマルな語彙を使用する傾向が強まり、彼らの言語スタイルが英語のアカデミックライティングの基準に徐々に近づいたことを示している。受動態の使用頻度については、実験群はタスク前の0.18からタスク後の0.27へと大幅に増加し、0.09の増加を示したが、対照的に、対照群は0.02の増加にとどまった。
上記の変化が統計的に有意であるかをさらに検証するため、本研究ではタスク前後のデータに対して独立標本t検定を実施した。その結果、実験群においてフォーマルな語彙の割合に有意な改善が見られ、t(58) = 3.89, p < 0.001, Cohen's d = 0.92であった。また、受動態の使用頻度の増加も有意であり、t(58) = 4.56, p < 0.001, Cohen’s d = 1.05であった。これは、実験群の学生が言語スタイルの適応において大幅な進歩を遂げたことを示しており、この進歩は偶然ではなく、体系的なプロンプトガイダンスとモデルフィードバックの相乗効果による結果であると考えられた。
統計学的検証
さらに、教育現場におけるAI生成コンテンツの信頼性をより詳細に検証するため、本研究では異なるプロンプトタイプにおけるAI生成コンテンツと教師作成コンテンツの平均スコアを比較しました。両者の整合性は、ピアソン相関係数を算出することで評価しました。関連する比較結果を表4に示します。表4は、転移指向型の5種類のプロンプトにおけるAI生成コンテンツと教師によるスコアの整合性を示しています。平均スコアの観点からは、全体的にAIのスコアは教師のスコアよりもわずかに低い結果となりました。それでも、ほとんどのタスクタイプにおいてその差は許容範囲内であり、DeepSeekモデルがライティング転移タスクの評価において高い安定性と参照価値を有していることが示されました。構文転移プロンプトでは、教師の平均スコアが4.1に対しAIスコアは4.0であり、両者の差はわずか0.1でした。構造的および論理的転移プロンプトにおいても、AIスコアは教師のスコアをわずか0.1点下回るのみであり、言語構造の度合いが高く明確な規則を伴うこれらのタスクにおいて、モデルが教師の評価基準をより適切にシミュレートできることが示されました。対照的に、文化的転移およびレジスター転移プロンプトにおけるスコアリングの乖離は比較的顕著であり、AIスコアはそれぞれ3.6および3.7で、教師のスコアより0.2低くなりました。これは、意味的な含意や文化的語用論など、主観性の高いタスクを扱う際にAIが依然として一定の限界を持っていることを反映しています。評価者間信頼性はICC(n = 5人の評価者)を用いて評価しました。手動スコアリングの全体的なICCは0.86であり、各次元のICCは0.82から0.89の範囲にあり、評価者間で十分な一致が見られました。
ピアソン相関係数をさらに分析した結果、さまざまなプロンプト下でのスコアの一貫性が高いレベルにあることが明らかになり、AIによるスコアが数値面で教師の判断に近いだけでなく、採点傾向においても良好な線形関係を示していることが示されました。その中でも、構文転移プロンプトの一貫性係数が0.87と最も高く、構造転移および論理転移プロンプトもそれぞれ0.83と0.85であり、構文の複雑さ、段落構成、および論理的な一貫性に関するAIの評価結果が教師の判断と非常に一致していることが示されました。これは、これらのタスクが明確な目的と定量化可能な言語的特徴を持っており、モデルによる認識と安定した判断が容易であったためと考えられます。領域転移プロンプトの相関係数は0.81でした。わずかに低下したものの、依然として強力な評価能力を示しており、AIがスタイル適応のレベルで一定程度の判断力を備えていることが示されました。一方、文化転移プロンプトの一貫性係数は0.79にとどまり、他のタイプよりも低い値となりましたが、依然として許容範囲内でした。
教育現場における異なる種類のプロンプトの適用可能性と、教師による受容度を調査するため、プロンプト応答満足度アンケートを作成した。5名の英語教師(T1〜T5)に、図6に示す5段階評価(非常に不満から非常に満足まで)を用いて、5種類のプロンプトによる生成提案を評価してもらった。5名の教師による5種類のプロンプトへのスコアには多少のばらつきがあるが、全体的な評価は高かった。その中でも、「構文転移(syntactic transfer)」と「文化転移(cultural transfer)」のプロンプトが平均4.0と最も高く、教育における高い実用性と適応性が反映されていた。対照的に、「レジスター転移(register transfer)」プロンプトのスコアは相対的に低く、平均はわずか2.4であり、T4やT5などの一部の教師は最低評価をつけた。これは、教育的な活用におけるガイダンスと適応性に依然として改善の余地があることを示している。
個人レベルでは、教師の採点傾向に明らかな違いが見られました。T1の総合スコアは正の値であり、AI支援ライティングに対する受容度が高いことが示されましたが、T5のスコアは複数のプロンプト次元、特に「レジスター転換」と「論理転換」において低い値となりました。この違いは、教師の指導経験、言語的な好み、またはAIツールへの習熟度に関連している可能性があり、今後のプロンプト設計においては、異なる教師グループの受容性を高めるためにパーソナライズされた適応メカニズムを検討する必要があることが示唆されました。AI支援指導が学生のライティング品質の向上に及ぼす実際の影響をさらに検証するため、本研究では、教師が評価した実験群と対照群の総合スコアの実験前後の変化を比較しました。比較結果を図7に示します。
図7に示すように、実験前後に教師が評価した実験群と対照群の総合スコアには有意な差が認められた。全体として、DeepSeekモデルに基づく指導最適化ティーチング・インターベンションの後、実験群の総合スコアは有意な上昇傾向を示した。対照的に、対照群のスコア変化は比較的緩やかであった。実験前の実験群の教師による平均スコアは59.1点であったが、実験後は74.4点へと大幅に上昇し、15.3点の増加となった。これは、AI支援教育が学生のライティングの質に肯定的な影響を与えたことを示している。箱ひげ図からは、実験群のスコアの分布範囲も拡大したことが観察された。特に、実験後のスコアボックスは実験前よりも有意に高く、最大値および最小値の両方が上昇しており、学生の全体的なレベルが大幅に向上したことが示唆される。一方、対照群のスコア変化は比較的限定的であった。実験前の対照群の平均スコアは60.1点であり、実験後は64.9点となり、4.8点の増加にとどまった。この増加幅は実験群よりもはるかに低く、対照群のスコアリングボックスは実験前後でほとんど変化しなかったことから、伝統的な教授法や最適化されていないAI支援ツールでは、ライティングの質の向上に対する効果が限定的であることが示された。
さらに本研究では、転移認知テーブルを用いて、構造調整、文章変換、文化的表現などの分野における能力開発について、学生に3回の自己評価を行わせ、学生のメタ認知意識の変化傾向と転移戦略の習得状況を考察しました。結果は Figure 8に示されています。Figure 8に示す学生の転移能力に関する自己評価のレーダーチャートデータによると、3回のタスクにおける構造的転移、統語的転移、文化的転移、レジスター転移、論理的転移の5つの次元における学生の自己評価は、継続的な上昇傾向を示しました。これは、DeepSeekモデルに基づく指導最適化のティーチング・インターベンションにより、学生の転移戦略を利用する能力が著しく向上したことを示しています。第1回目のタスクでは、学生の自己評価スコアは概して低い値でした。5つの次元のうち、「構造的転移」と「論理的転移」のスコアはそれぞれ3.2および3.0であり、一方で「文化的転移」と「レジスター転移」は2.5および2.7であり、学生が転移戦略の特定と利用においてまだ未熟であったことを示しています。第2回目のタスクまでに各項目のスコアは向上し、「構造的転移」は3.8、「統語的転移」は3.5、「論理的転移」は3.7に上昇しました。これは、教師の指導とモデルからのフィードバックによる支援により、学生が基本的な転移操作の要点を徐々に習得し、それを実際のライティングに適用し始めたことを示しています。第3回目のタスクでは、学生の自己評価スコアが大幅に増加し、「構造的転移」と「論理的転移」はそれぞれ4.5および4.3に達し、他の次元でも4.0点以上に安定しました。これは、複数回の転移トレーニングが学生の言語形態制御およびテキスト構築能力の向上に持続的な効果をもたらしたことを示しています。この段階で、学生は転移戦略の理解、実行、および省察の間に、基本的な認知クローズドループを形成していました。教師によるフィードバックに加え、本研究では実験群の全学生にAI支援ライティング機能に関する満足度調査アンケートを配布し、計30件の有効な回答を回収しました。このアンケートでは、「書き換えの提案」、「構造の最適化」、「文化的プロンプト」という3つの機能モジュールにおけるAIのパフォーマンスを評価し、学生に5段階の基準に従って選択肢を選択させました。結果はTable 5に示されています。
表5に示すAI支援ライティング機能に関する学生満足度調査の結果によると、実験群の学生は、書き換え提案、構造の最適化、および文化的プロンプトの3つの機能モジュールにおけるAIのパフォーマンスについて、概して肯定的な評価をしました。これは、ライティング訓練の効率向上と指導支援の質を高める上で、AI支援ライティングシステムが良好な応用展望を持っていることを示しています。全体として、「書き換え提案」と「構造の最適化」の2つの機能項目では、90%以上の学生が「非常に満足」または「満足」と回答しました。中でも「書き換え提案」の満足度が最も高く91%に達しており、構文の再構築や言語的なブラッシュアップにおけるAIの能力を学生が高く認めていることが分かります。対照的に、「文化的プロンプト」機能への満足度は相対的に低くなりましたが、それでも83%に達しました。これは、異文化表現の指導においてAIがある程度の複雑さと主観性を伴うものの、母国語による文化的干渉を特定し調整する際の支援としての役割は、ほとんどの学生に認められていることを示しています。不満点については、3つの機能すべてにおいて「不満」または「非常に不満」を選択した学生の割合は5%未満であり、AI支援機能がほとんどの利用シーンにおいて優れたユーザビリティと受容性を備えていることが示されました。注目すべき点として、「文化的プロンプト」の項目で「普通」と評価した学生の割合が比較的高く、文化的な適応問題に対処する際、現在のAIは学生の期待を完全には満たしていない可能性があり、依然として改善の余地があることが示唆されました。総合的な分析により、DeepSeekベースの指示最適化手法が、特に言語形式のサポートという点において、学生から広く認められたことが明らかになりました。
反復測定分散分析(RM-ANOVA)
グループ(被験者間因子:実験群 vs. 対照群)および時間(被験者内因子:事前テスト、タスク1、タスク2、タスク3、事後テスト)、ならびにそれらの相互作用が学生の英語ライティング転移パフォーマンスに及ぼす影響を検討するため、二元配置反復測定分散分析(RM-ANOVA)を実施した。モークリーの検定の結果、球形仮定が棄却されたため(p < 0.05)、Greenhouse–Geisserの補正を適用して被験者内効果の自由度を調整した。すべての分析は、1グループあたりn = 30名の参加者に基づいて行われた。結果を表6に示す:
Greenhouse–Geisser補正を用いた反復測定分散分析の結果、すべての測定次元において、群、時間、および群 × 時間の交互作用の有意な主効果が認められた(p < 0.001)。総合転移指数については、有意な群の効果(F(1,58) = 76.32)に加え、有意な時間の効果(F(2.14,124.12) = 92.75)および有意な群 × 時間の交互作用(F(2.14,124.12) = 68.49)が観察され、総合的な転移パフォーマンスの時間的変化が群間で有意に異なることが示唆された。
同様に、統語的転移(syntactic transfer)においても、群(Group)(F(1,58) = 52.18)、時間(Time)(F(2.11,122.38) = 71.26)、および群×時間の交互作用(Group × Time interaction)(F(2.11,122.38) = 45.73)に有意な効果が見られ、群および測定時点によって統語的転移能力の発達パターンが異なることが示された。構造的転移(Structural Transfer)についても、群(F(1,58)=48.65)、時間(F(2.09,121.22) = 67.81)、および交互作用(F(2.09,121.22) = 41.36)に有意な効果が認められ、群に依存した軌跡を伴う一貫した改善が反映されていた。特筆すべきは、文化的転移(Cultural Transfer)において最も強い効果が示されたことであり、有意な群の効果(F(1,58) = 81.44)、顕著な時間の効果(F(2.07,119.96) = 98.52)、および強固な群×時間の交互作用(F(2.07,119.96) = 79.27)が認められ、この次元において最も実質的かつ分化した成長パターンがあることが示唆された。全体として、すべての指標で統計的に有意な効果が示され、介入が時間の経過とともに転移の発達に安定的かつ分化した影響を及ぼしたことが確認された。
データの可用性:
本研究で生成または分析されたすべてのデータは、本論文に含まれています。評価の生データは付録表1に記載されています。
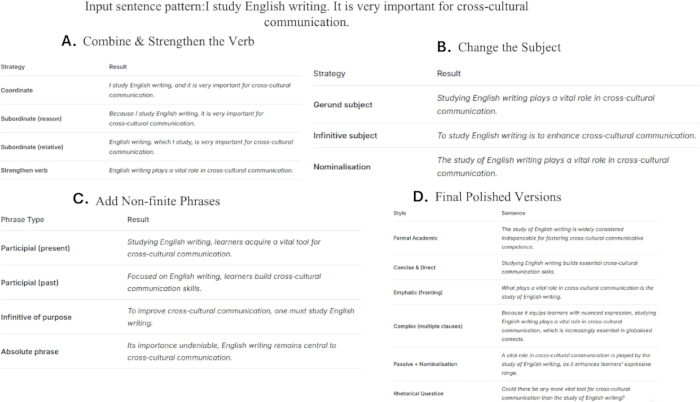
図 1: 文構造変換の手順。(A) 文構造を改善するための、動詞の結合および強化の戦略。(B) 動名詞、不定詞、名詞化された主語を含む、代替的な主語の変換。(C) 文の多様性と簡潔さを高めるための非定形句の使用。(D) 学術的なスタイルと異文化間の英語表現の向上が示された、ブラッシュアップ後の最終版の例。ここをクリックして、この図の拡大版を表示してください。
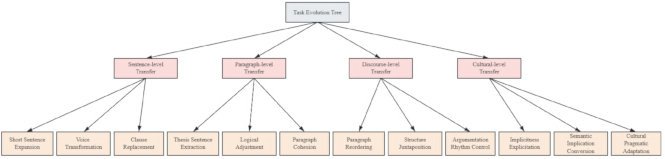
図 2: タスク進化ツリー図。文、段落、談話、そして文化的レベルに至る4段階の転移タスクの漸進的な構造を示している。ここをクリックして、この図の拡大版を表示してください。
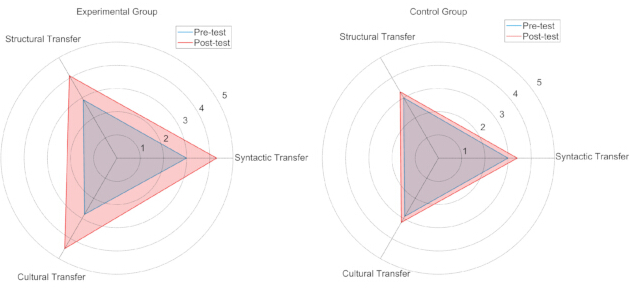
図 3: 実験前後のライティング転移能力の比較。レーダーチャートは、構文的、構造的、および文化的転移の次元における実験群と対照群の事前テストおよび事後テストのスコアを示している。こちらのリンクをクリックして、この図の拡大版を表示してください。
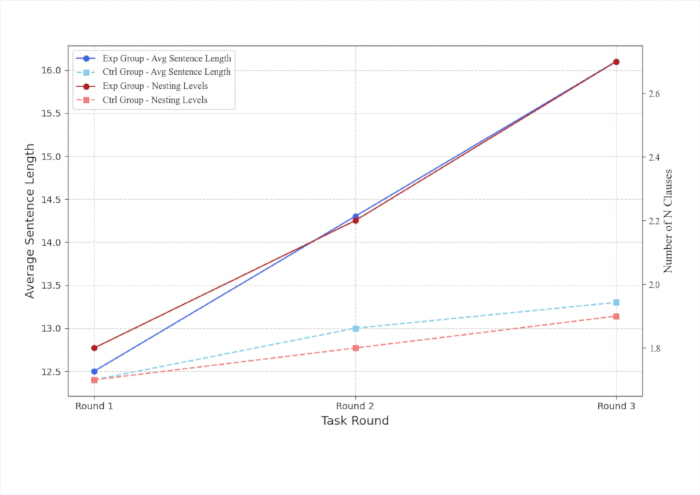
図 4: 構文複雑性の傾向線チャート。 3つのトレーニングタスクにおける平均文長と節の入れ子層の変化を示している。この図の拡大版を表示するには、ここをクリックしてください。
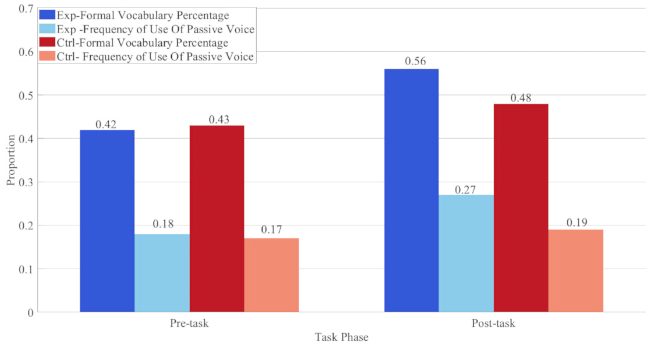
図 5: 学術用語のマッチング。 この図は、介入前後におけるフォーマルな語彙の割合と受動態の頻度の変化を示しています。こちらのリンクをクリックして、この図の拡大版を表示してください。
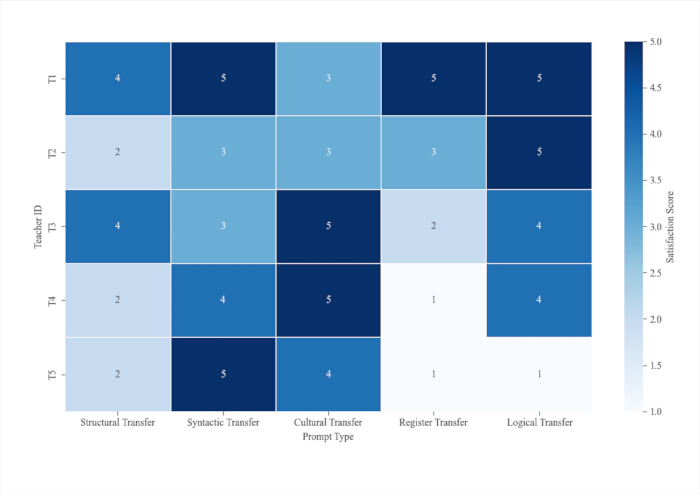
図 6: プロンプト応答満足度ヒートマップ。参加した教師による5種類のプロンプトテンプレートの評価をここにまとめる。こちらのリンクをクリックして、この図の拡大版を表示してください。
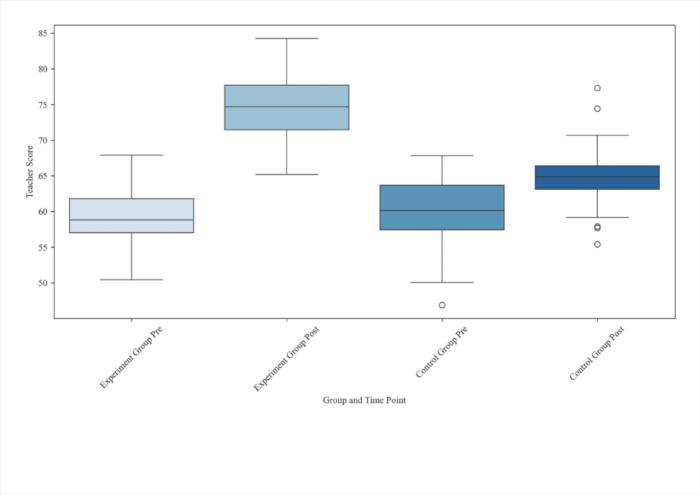
図 7: 教師による評価の変化を示す箱ひげ図。この箱ひげ図は、実験前後の2つのグループにおける教師評価によるライティングスコアの分布と全体的な変化を示しています。こちらのリンクをクリックして、この図の拡大版を表示してください。
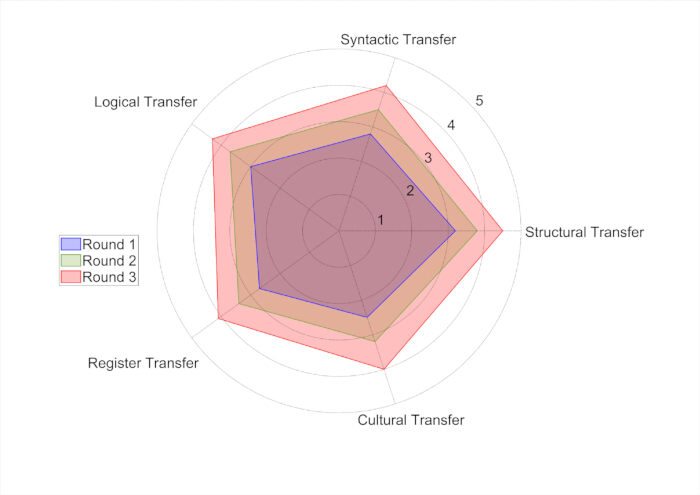
図 8: 学生による転移能力の自己評価レーダーチャート。 3回のトレーニングラウンドにおける、5つの転移次元にわたる学生の自己評価スコアを示している。こちらのリンクをクリックして、この図の拡大版を表示してください。
| 入力 | 教員の操作 | プロンプトの種類 | 学生の操作 | 出力 | 評価基準 |
| 学生による元の執筆草稿(文/段落/エッセイ) | 1. 転移タイプとタスクレベルをラベル付けする 2. 必要に応じてプロンプトのパラメータを調整する | 単一転移プロンプト / 3段階ネスト型プロンプトチェーン | 1. 転移戦略を学習する 2. AIのフィードバックに基づいて草稿を修正する 3. 自己評価を完了する | AIによる修正テキスト + 学生による最終修正草稿 | 構文の複雑さ、構造的な合理性、文化的適切さ、論理的な一貫性、レジスター(言語使用域)の標準化(0–5尺度) |
表 1:ワークフロー概要表。この表は、AI支援による英語ライティング転移トレーニングの完全な運用ワークフローをまとめたものであり、入力資料、教師および学生の操作、プロンプトの種類、最終的な出力、および対応する評価基準を網羅しています。
| プロジェクトカテゴリ | 目次 |
| ミッション目的の理解 | 今回のライティングタスクにおける移行目的について、構造的な調整、文化的適応、および言語変換といった観点から簡潔に説明してください。 |
| 採用された移行戦略 | 採用した移行戦略をすべて選択してください(複数選択可): |
| 構造調整 | |
| 文章変換 | |
| 言語切り替え | |
| 文化的発現 | |
| 論理的結合の強化 | |
| その他:_______ | |
| 例と手順の書き換え | 書き換え後の文章を1〜2文選択し、書き換え前後のバージョンを提示した上で、変更の理由と意図した転移目標を説明してください。 |
| 直面した困難および疑問点 | 移行中に直面した課題や、特定の表現について疑問に思った点があれば記述してください。 |
| 自己評価スコア (5点満点中) | 以下の3つの観点から、ご自身のテキスト書き換えについて評価してください。 |
| • 戦略適用の正確性 (/5) | |
| • 表現の自然な流暢さ (/5) | |
| • カルチャーフィット (/5) | |
| 今後のライティング改善目標 | 次回のトレーニングで強化または最適化したい転移性を簡潔に記述してください。 |
表 2:転移認知テーブル。 ライティング転移戦略に関する学生の自己評価には、1~5の評価尺度(1 = 未習得、5 = 完全に習得)が採用されている。
| 指示薬名 | 概要 | データソース |
| 書き換え指数(0~5) | 構文、構造、文化の3つのレベルを網羅し、言語転移能力を包括的に測定する定量的指標。 | システムによる自動採点 + 教師による手動採点 |
| 構文複雑度スコア | 平均文長、節の埋め込み数、動詞句の豊かさなどを含む。 | NLP自動解析 |
| 学術的スタイルの適合 | 英語の学術的ライティング基準に準拠していますか? | 自然言語処理モデルの判定 |
| プロンプト回答への満足度 | モデルが生成した提案に対する教師の受容性と実践的評価 | 教師用アンケート |
| 教員レビューによる採点変更 | ライティングの質の向上を反映させるための、実験前後の教師によるスコアの比較 | 教師評価記録 |
| 学生による転移能力の自己評価 | 学生は、異なる転移次元における自身の習得度を自己評価する。 | 移行意識調査フォームに記入してください |
表3:評価指標、説明、およびデータソースの概要 本表では、本研究における各主要評価指標の定義、測定方法、および元のデータソースを明確にしています。
| プロンプトの種類 | 教員の平均評価 | AIスコア平均値 | ピアソン相関係数 |
| 構造転移 | 4 | 3.9 | 0.83 |
| 統語的転移 | 4.1 | 4 | 0.87 |
| 文化的伝播 | 3.8 | 3.6 | 0.79 |
| レジスタ転送 | 3.9 | 3.7 | 0.81 |
| 論理転送 | 4.2 | 4.1 | 0.85 |
表 4: AI生成コンテンツと教員による評価の整合性の比較。 結果は、異なるプロンプト形式におけるAI生成コンテンツと教員による評価の間の整合性を示している。
| 機能項目 | 非常に満足 | 満足した | 一般的に | 不満のある | 非常に不満 |
| 書き換え案 | 66% | 25% | 7% | 1.50% | 0.50% |
| 構造最適化 | 60% | 30% | 7% | 2% | 1% |
| 文化的ヒント | 55% | 28% | 12% | 3.50% | 1.50% |
表5:AI支援機能に対する学生の満足度に関する調査統計AIによる書き換え、構造の最適化、および文化的プロンプト機能に対する学生の満足度の分布を統計的に示している。
| 測定 | 群F(df) | 時間 F(df)GG | 群 × 時間 F(df)GG | p |
| 総合転写指数 | 76.32 (1, 58) | 92.75 (2.14, 124.12) | 68.49 (2.14, 124.12) | <0.001 |
| 構文転移 | 52.18 (1, 58) | 71.26 (2.11, 122.38) | 45.73 (2.11, 122.38) | <0.001 |
| 構造転移 | 48.65 (1, 58) | 67.81 (2.09, 121.22) | 41.36 (2.09, 121.22) | <0.001 |
| 文化的伝播 | 81.44 (1, 58) | 98.52 (2.07, 119.96) | 79.27 (2.07, 119.96) | <0.001 |
表6:反復測定分散分析(ANOVA)の結果概要。ライティング転移の全体的なパフォーマンスおよびその3つの下位次元に関する二元配置反復測定分散分析の結果であり、群の主効果、時間の主効果、および群と時間の交互作用を示している。略語:GG = Greenhouse–Geisser補正。
補足表 1:生データの評価。本研究のすべての解析に使用された生データが含まれています。こちらのリンクからファイルをダウンロードしてください。
ディスカッション
本研究では、異文化間英語ライティング転移教育のため、DeepSeekのMoEアーキテクチャに基づいた多層的な指示最適化フレームワークを構築した。文レベルから文化レベルまでを網羅する4段階の漸進的タスクと、5つのカテゴリーからなる標準化タスクライブラリを核とし、実際の学生のライティングサンプルに基づく自動プロンプト生成を実現し、複雑な異文化適応タスクを分解するための3段階のネスト型プロンプトチェーンを確立した。テキストの推敲に限定された従来の汎用的なプロンプト設計とは異なり、提案するソリューションはプロンプトの構成を言語転移教育の目標と密接に結びつけ、モデルによる生成、教師によるアノテーション、そして学生による反復的な修正というクローズドループの教育フローを構築している。学問的進展の観点から、本研究は第二言語習得におけるプロンプトエンジニアリングの実践的境界を拡大し、大規模言語モデルのパラメータ特性をEFL教室での標的トレーニングに組み合わせるための定量的なテンプレート構築パスを提供した。また、AI補助環境下における異文化間語用論的転移研究の実証的根拠を豊かにし、構文的な負の転移エラーのみに焦点を当てた既存の研究知見36,37を補完するものである。
経験的な準実験データにより、実験群において構文的、構造的、および文化的転移の指標全般にわたる明らかな向上が確認されたが、研究結果の汎用性を制限するいくつかの固有の制約が存在する。研究条件の制限により、本研究では評価者の盲検化を行わない非ランダム化クラス群分けを採用しており、また全サンプルを単一大学の英語専攻者から選出したため、スコアの変動における学習者の自律的な学習意欲や教師の長期的な指導習慣による干渉を排除することが困難である。加えて、本介入は3週間のみであり、短期的なトレーニングプログラムに留まっている。全参加者を1つの職業大学から募った単一施設サンプリング設計と相まって、観察された正の効果が長期的な教育実践において完全に安定しているとは限らない。したがって、本研究の結果は慎重に解釈されるべきであり、これらの結論を異なる種類の大学や、より長い教育サイクル、あるいは言語習熟度の異なる学生グループに直接的に一般化することは不適切である。
実際の教育展開において、現在のプロンプト最適化システムとDeepSeekモデルの組み合わせには、顕著な限界と典型的な失敗事例が見られます。文化およびレジスターの転移タスクに関して、微妙な文化的含意やコンテキストに依存するスタイル上の要求があるテキストを処理する際、モデルが語用論的に不適切な表現や、硬直したスタイル変換結果を生成することがあります38,39。また、長く複雑な段落に含まれる潜在的なネイティブの文化的思考を正確に特定できず、 resultingly、Chinglish表現の修正が不完全になる場合があります。自動採点においては、極めて主観的な文化的語用論項目に対するAI評価の一貫性が著しく低下し、修辞的表現や異文化間の含意における微細な差異を効果的に区別することができません。さらに、3段階のネストされたプロンプトチェーンは、複数回の反復生成において意味的な逸脱を起こしやすく、意味再構成の第1段階で発生したエラーが、その後の言語的修正および文化的適応のステップで継承され、増幅される傾向があります40,41。
今後の開発動向としては、3つの実践的な観点からさらなる改善を行うことができる。第一に、英語専攻以外の学生や異なる語学習得レベルの学生からライティングコーパスを収集してタスクライブラリの規模を拡大し、多様な学習者グループに対するテンプレートの適合性を強化することである。第二に、軽量なDeepSeekサブモジュールの継続的なファインチューニングを組み合わせることで、AIによる文化転移スコアリングに存在する偏差を低減させることである。今回の統計では、AIによるスコアリングは教師による評価と比較して一貫性が低いことが判明している。第三に、プロンプト最適化システム全体を従来のオンライン外国語学習プラットフォームに組み込み、プロンプトルールの継続的な反復最適化に向けた長期的なデータの自動蓄積を実現することである。多言語文化コーパスのリソースが継続的に充実することで、提案した技術フレームワークは、今後の研究においてバイリンガル翻訳教育や異文化コミュニケーションコースへと応用範囲を広げることが期待される。
開示事項
著者らは、金銭的な利益相反がないことを宣言します。
謝辞
本研究は、浙江省教育計画プロジェクト2026「デジタルおよびインテリジェントなエンパワーメント下における高等職業教育教師の教育能力フレームワークの再構築および促進戦略に関する研究」(プロジェクト番号:ZWT26024、承認番号:2026SCG360)の支援を受けて行われました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| BERT 学習済み言語モデル | https://github.com/google-research/bert | テキスト表現、段落構造の認識、意味的類似度の算出、およびテキスト分類により、記述内容の自動採点をサポートする。 | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | テキストの照応関係を特定し、談話の照応的一貫性を評価することで、記述品質の自動採点を支援する。 |
| DeepSeek 大規模言語モデル | DeepSeek AI | https://chat.deepseek.com/ | MoEモデルアーキテクチャに基づき、指示の最適化とプロンプトチェーンの設計を行った。モデルは固定パラメータ(温度係数 0.7)を使用し、生成長は質問形式に応じて動的に制限される。 |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | 英文の依存構文構造を解析し、平均文長や入れ子構造の節の数などの指標を抽出して、構文の複雑さを定量化する。 |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | 反復測定分散分析 (RM-ANOVA)、独立サンプルt検定、ピアソンの相関分析、効果量 (Cohen’s d) の算出、および信頼性 (ICC) 検定などの統計解析を実施した。 |
参考文献
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.