このプロトコルは、公開されたトランスクリプトミックデータセットと大腸上皮細胞の検証を統合し、炎症性腸疾患、大腸がん、膵腺癌に関連する共通バイオマーカーとしてS100Pを特定します。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
研究記事
炎症性腸疾患、大腸がん、膵臓腺癌における共通バイオマーカーとしてのS100P:統合トランスクリプトミック解析
* These authors contributed equally
この記事について
サマリー
要約
炎症性腸疾患(IBD)は大腸がん(CRC)および膵腺癌(PAAD)のリスク増加と関連していますが、これらの疾患に共通する分子的特徴はまだ完全には解明されていません。本研究は、統合トランスクリプトム解析と実験的検証を通じて、IBD、CRC、PAADに関連する共通遺伝子および生物学的経路を特定することを目的としました。IBD、CRC、PAADの遺伝子発現データセットは、がんゲノムアトラスおよび遺伝子発現オムニバスデータベースから取得されました。加重遺伝子共発現ネットワーク解析および差異発現解析を用いて、疾患関連および共通遺伝子の特定が行われました。遺伝子オントロジーおよび京都遺伝子・ゲノム百科事典(解析は、強化された生物学的機能や経路の探求に用いられました。免疫細胞浸透は、RNA転写産物の相対サブセットの推定による細胞型同定を用いて評価されました。一般的な遺伝子の診断性能を評価するために、受講者の動作特性分析が実施されました。S100Pの細胞分布を調べるために単細胞RNAシーケンス解析が行われました。さらに、S100Pダウンレギュレーションの効果は、リポ多糖(LPS)刺激された大腸上皮細胞で評価されました。合計162の疾患関連遺伝子と4つの一般的な遺伝子が同定されました。機能豊か解析では、インターロイキン17シグナル伝達経路を含む免疫および炎症関連経路の有意な濃縮が示されました。免疫浸潤解析では、IBD、CRC、PAADの複数の免疫細胞集団で同様の傾向が見られました。単細胞解析では、これら3つの疾患すべてにおいて上皮細胞におけるS100P発現の上昇が認められました。S100Pのダウンレギュレーションにより、LPS刺激された大腸上皮細胞の増殖能力が回復し、炎症性サイトカイン発現が減少しました。統合トランスクリプトミクス解析により、S100PがIBD、CRC、PAADに関連するバイオマーカーであることが特定され、これらの疾患に共通する免疫関連の特徴が浮き彫りになりました。
概要
炎症性腸疾患(IBD)は、潰瘍性大腸炎やクローン病を含む消化管に影響を与える免疫関連疾患のスペクトルを代表します。IBDの病因は非常に複雑で、粘膜免疫異常、細菌叢の乱れ、遺伝的感受性を含みます。IBDは発症率の増加と大きな経済的負担を伴う世界的な健康問題であり、その増加する有病率は大きな注目を集めています。重要なのは、IBD患者は大腸がん(CRC)3 および膵腺癌(PAAD)4の発症リスクが有意に高まることです。この関連は十分に記録されていますが、IBD、CRC、PAAD間の遺伝的なクロストークはまだ完全には解明されていません。
これまでの研究では、IBD、CRC、PAADが共通の病原性プロセスを共有していることが強く示唆されています。しかし、特異的かつ感度の高い診断バイオマーカーは依然として不足しており、共通の病原性メカニズムも完全には解明されていません。幸いにも、ハイスループットシーケンシング技術の急速な進歩と普及により、IBD、CRC、PAAD患者の多数のトランスクリプトミックデータセットが公開され、これらの疾患間の分子相互関係の体系的な調査が可能となりました。
本研究では、IBD、CRC、PAAD患者のハイスループットシーケンスデータを用いて、加重遺伝子共発現ネットワーク解析(WGCNA)および差別発現解析を用いて疾患関連および共有遺伝子を特定しました。これらの遺伝子はさらに調査され、IBD、CRC、PAAD間の共通シグナル伝達経路の可能性を特定しました。さらに、これらの共通遺伝子の診断価値も評価しました。単細胞RNAシーケンシング(scRNA-seq)解析により、主要遺伝子S100Pが主に上皮細胞で発現していることが示されました。最後に、IBDにおけるS100Pの生物学的役割を調査しました。
結論として、本研究はIBD、CRC、PAADに関連する共通の診断バイオマーカーおよび生物学的経路を特定し、これらの疾患の共同予防と治療に関する貴重な臨床的知見を提供することを目指しました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、がんゲノムアトラス(TCGA)および遺伝子発現オムニバス(GEO)からの公開された非特定データセット、ならびに確立された商業細胞株を用いました。新規募集されたヒト参加者、特定可能な患者情報、患者由来サンプルは含まれていません。すべての分析は、関連する機関ガイドラインおよび公開データベースの利用規約に従って実施されました。したがって、本研究には追加の倫理的承認やインフォームド・コンセントは必要ありませんでした。
データソース
IBDコホート(GSE179285;プラットフォーム:GPL6480およびGSE24287;プラットフォーム:GPL6480)、CRCコホート(TCGA-CRC;プラットフォーム:Illumina HiSeq 2000およびGSE87211;プラットフォーム:GPL13497)、およびPAADコホート(GSE128735;プラットフォーム:GPL20301およびGSE62452;プラットフォーム:GPL6244)のRNA-seqデータは、TCGAおよびGEOからダウンロードされました。すべてのデータセットは2025年12月5日にアクセスされました。
各データセットでは、サンプルを厳密に2つのサブグループに分け、疾患病変・腫瘍組織が症例群、対応する非病変の正常組織が対照群として割り当てられました。具体的には、IBDコホートにはIBD患者の腸粘膜サンプルが297件、健康な個人からは正常腸粘膜サンプルが56件含まれていました。CRCコホートには841の原発性大腸腫瘍組織と、211の適合する正常な大腸上皮組織が含まれていました。PAADコホートは114のPAAD腫瘍組織と106の正常膵臓実質組織で構成されていました。
同じ疾患カテゴリー内のすべてのデータセットは一様に統合されました。limmaパッケージの正規化BetweenArrays関数を適用し、クロスサンプル分位数正規化を行い、プラットフォーム間バッチ効果を効果的に排除し、異なるデータセット間で遺伝子発現値を標準化し、その後の差分発現解析に備えました。
IBD、CRC、PAAD関連遺伝子および一般的な遺伝子のスクリーニング
まず、IBD、CRC、PAADのコホートからLIMMAパッケージを用いて差分発現遺伝子(DEGs)をスクリーニングし、元の P 値はBenjamini-Hochberg偽発見率(FDR)法で補正しました。IBD、CRC、PAADのコホートでは、スクリーニング基準は|logFC|> 0.4、 P < 0.05。さらに、WGCNAはすべての遺伝子に対して実施され、最小モジュール遺伝子閾値100(ソフト閾値パワー=0.90;ネットワークタイプ=符号付き)でした。その結果、3つのコホートで共通のDEGおよびモジュール遺伝子が同定されました。両方の方法で一貫して同定された遺伝子は共通遺伝子として定義され、残りの遺伝子は関連遺伝子として分類されました。
PPIと機能豊化分析
これらの解析は疾患関連遺伝子に対して行われました。タンパク質間相互作用(PPI)解析はSTRINGデータベースを用いて行われました(相互作用スコア>0.40)。機能豊か解析には、clusterProfiler、enrichplot、orgを用いて行われたGene Ontology(GO)および京都Genes and Genomes百科事典(KEGG)解析が含まれます。Hs.eg.dbパッケージ(P < 0.05およびFDR調整後の q 値[ベンジャミニ–ホッホバーグ法]<0.05)。
免疫マイクロ環境プロファイリング
CIBERSORTは、デフォルトのLM22シグネチャマトリックス7を用いて遺伝子発現データから免疫細胞浸透レベルを推定する信頼性の高いアルゴリズムです。本研究では、CIBERSORTアルゴリズムを用いてIBD、CRC、PAADの各コホートサンプルにおける免疫細胞浸透の程度を推定し、これら3つの疾患における免疫微小環境の共通特性を探りました。分析は1,000回の置換で各サンプルの P 値を算出し、混合表現ファイルには分位数正規化(QN = TRUE)を適用しました。CIBERSORT P 値<0.05のサンプルのみが後続解析のために保持され、デコンボリューション結果の信頼性が保証されました。
共通遺伝子の診断価値の評価
IBD、CRC、PAADコホートにおける共通遺伝子の診断価値は、rのpROCパッケージを用いた受講者動作特性(ROC)解析を用いて評価されました。感度と特異度の最適なトレードオフはROC曲線を用いて可視化されました。
qRT-PCR、細胞トランスフェクション、コロニー形成アッセイ
qRT-PCRおよび細胞トランスフェクションは、先行研究8,9,10に基づいて実施されました。一時的トランスフェクションは、メーカーの指示に従いjetPRIMEトランスフェクション試薬(ポリプラス、中国)を用いて行われました。細胞はトランスフェクション混合物と6時間インキュベートされ、その後培地は完全なDMEMに置き換えられました。その後の実験はトランスフェクションから48時間後に行われました。
簡単に、TRIzol試薬を用いて全細胞RNAを抽出しました。RNAはPrimeScript RT Master Mixを用いて逆転写されcDNAに変換されました。定量PCRはTB Green qPCRを用いて実施されました。βアクチンは発現正規化の内部参照遺伝子として用いられました。生物学的実験は三つに分けて行われました。プライマー配列とsiS100P配列は、 以前の研究で確認できます。
NCM460、FHC、HCT116、SW116、PANC1、BXPC2細胞は 材料表に記載されているように得られました。すべての細胞株は細胞同定とマイコプラズマ検査を受けました。
実験中、すべての細胞は3〜5世代にわたって伝達されました。すべての細胞は胎児用牛血清10%とペニシリン・ストレプトマイシン1%を含む完全なDMEMで培養されました。
コロニー形成アッセイは、以前の研究で説明された通りに実施されました。簡単に言えば、6ウェルプレートの各ウェルに 1,000 個の細胞がシードされ、10日間培養された後、実験は終了しました。細胞は4%のパラホルムアルデヒドで固定され、0.1%の結晶バイオレットで染色され、ImageJを用いてコロニー数えました。
scRNA-seqデータに基づく共通遺伝子の解析
IBDデータセット(GSE214695)、CRCデータセット(GSE166555)、PAADデータセット(GSE154778)からのscRNA-seqデータは、前回の研究で記述された通りに前処理されました8,13。生カウント行列は、limma::averepsを用いた重複遺伝子記号の平均発現で折りたたみました。初期のフィルタリングにより、少なくとも3つの細胞および少なくとも50個の固有の転写産物を含む細胞で検出された遺伝子が保持されました。ミトコンドリア転写物の割合が50個未満>検出された遺伝子を除去した。ログ正規化はスケールファクター10,000で行われ、その後分散安定化変換を用いて、主成分解析(PCA)前にZスコア標準化された上位1,500の高変動遺伝子を特定しました。クラスター定義マーカー遺伝子は、log2(fold変化)>0.5、検出分数≥ターゲットクラスターでの検出分数0.25、調整済みP値<0.05を用いてフィルタリングしました。
簡単に言うと、データの前処理はSeuratパッケージを使い、セルタイプの注釈はSingleRパッケージ(バージョン2.6.0)を使って行われました。セルクラスタリングは、PCA次元1–20に基づくk近傍グラフ構築とt-SNE埋め込みを用いてSeuratで実施されました。次に、共通遺伝子の異なる細胞型における分布と発現レベルを調べました。
IBDモデルの構築
先行研究14によると、リポ多糖(LPS)は正常なヒト大腸上皮細胞(FHCおよびNCM460)で炎症を誘導するために用いられ、炎症を模倣するIBDモデルを生成しました。生物学的実験は三つに分けて行われました。細胞は通常、37°Cの加湿インキュベーターで5%のCO2で培養しました。細胞コンフルンが約50%〜70%に達した時点で、培養培地を新鮮な完全培地に交換し、細胞は12時間の10 ng/mL LPSで処理されました。車両対照として、同量の無菌リン酸塩緩衝生食塩水(PBS)が使用されました。培養体積は6ウェルプレートで1ウェルあたり2 mLでした。処理後、培地を除去し、細胞を予備冷却した無菌PBSで2回洗浄し、その後の解析のために細胞を収集しました。
統計解析
すべてのバイオインフォマティクス解析はRソフトウェア(バージョン4.1.2)を使用して実施されました。2つのグループ間の比較は学生の t検定を用い、複数グループ間の比較は一方分散分析(ANOVA)を用いて行われました。相関解析はスピアマン法を用いて行われました。すべての細胞実験は少なくとも3回繰り返し行われ、データは平均±標準偏差(SD)として提示されています。 P 値またはFDR<0.05は統計的に有意とみなされました。NS(新星)は重要ではありません。 P < 0.05(*)、 P < 0.01(**)、 P < 0.001(***)です。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
IBD、CRC、PAADにおけるDEGs
まず、IBDコホート(GSE179285およびGSE24287)、CRCコホート(TCGA-CRCおよびGSE87211)、およびPAADコホート(GSE128735およびGSE62452)を統合し、PCAおよび遺伝子発現密度プロットを用いて統合評価しました。結果は、異なるデータセット間のバッチ効果が統合後に効果的に除去されることを示しました(図1A–F)。
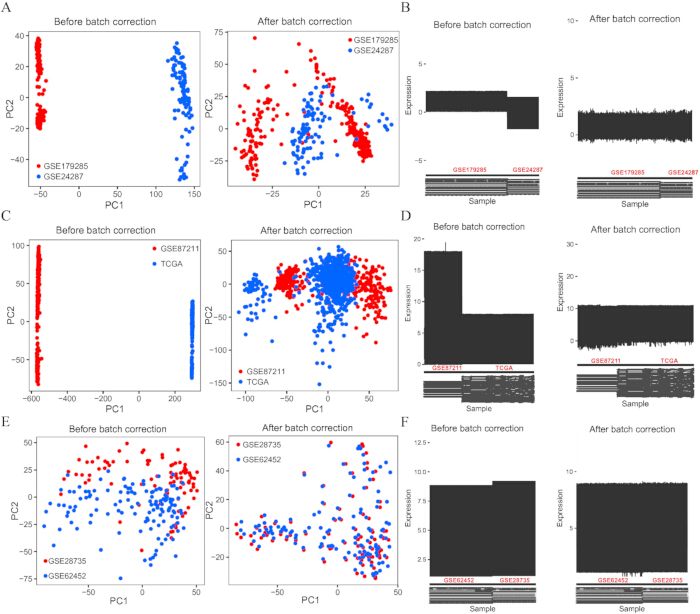
図1。炎症性腸疾患(IBD)、大腸がん(CRC)、膵腺癌(PAAD)コホー...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
これまでの研究では、免疫関連の消化器疾患であるIBDが、神経変性疾患17、多発性硬化症18、筋萎縮性側索硬化症19、子宮内膜症20、関節リウマチ2、ホジキンリンパ腫21、CRC22、PAAD23など、いくつかの疾患と関連していることが強調されています。IBDは一般的にCRC24 およびPAAD23の発症リスクを高めると考えられています。これらの疾患間の疫学的関連は報告されていますが、共通する分子特性はまだ完全には解明されていません。本研究では、バルクトランスクリプトミクスデータセット、scRNA-s...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
利益相反:
著者たちは競合する利害関係を一切認めていない。
謝辞
著者らは中国国家重点研究開発計画(助成金番号2023YFB3210400)からの財政支援を感謝します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| BXPC2 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human pancreatic adenocarcinoma cell line |
| CIBERSORT | N/A | N/A | Immune cell infiltration analysis |
| clusterProfiler package | Bioconductor | v4.8.0 | Gene Ontology (GO) and Kyoto Encyclopedia of Genes and Genomes (KEGG) enrichment analyses |
| Dulbecco's Modified Eagle Medium (DMEM) | Thermo Fisher Scientific | 11965092 | Cell culture medium |
| Fetal bovine serum (FBS) | Thermo Fisher Scientific | A5256701 | Cell culture supplement |
| FHC cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human normal colonic epithelial cell line |
| GEO dataset (GSE128735) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for pancreatic adenocarcinoma |
| GEO dataset (GSE154778) | Gene Expression Omnibus (GEO) | N/A | Public single-cell RNA sequencing dataset for pancreatic adenocarcinoma |
| GEO dataset (GSE166555) | Gene Expression Omnibus (GEO) | N/A | Public single-cell RNA sequencing dataset for colorectal cancer |
| GEO dataset (GSE179285) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for inflammatory bowel disease |
| GEO dataset (GSE214695) | Gene Expression Omnibus (GEO) | N/A | Public single-cell RNA sequencing dataset for inflammatory bowel disease |
| GEO dataset (GSE24287) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for inflammatory bowel disease |
| GEO dataset (GSE62452) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for pancreatic adenocarcinoma |
| GEO dataset (GSE87211) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for colorectal cancer |
| ggplot2 package | CRAN | v3.4.2 | Data visualization |
| HCT116 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human colorectal cancer cell line |
| ImageJ | National Institutes of Health (NIH) | v1.8.0 | Colony counting |
| jetPRIME Transfection Reagent | Polyplus | 101000046 | Cell transfection |
| Lipopolysaccharide (LPS) | Beyotime Co., Ltd | S1735 | Induction of an inflammation-mimicking IBD cell model |
| limma package | Bioconductor | v3.54.0 | Differential expression analysis |
| NCM460 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human normal colonic epithelial cell line |
| org.Hs.eg.db package | Bioconductor | v3.23.1 | Gene annotation for enrichment analysis |
| PANC1 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human pancreatic adenocarcinoma cell line |
| Penicillin–streptomycin | Thermo Fisher Scientific | 15140-122 | Antibiotic supplement for cell culture |
| pheatmap package | CRAN | v1.0.12 | Heatmap visualization |
| pROC package | CRAN | v1.19.0.1 | Receiver operating characteristic (ROC) analysis |
| PrimeScript RT Master Mix | Takara Bio | RR036A | Reverse transcription of RNA into cDNA |
| Primer sets for qRT-PCR | Tsingke Biotech Co., Ltd | N/A | Primer sequences reported in Reference 11 |
| R software | R Foundation for Statistical Computing | v4.1.2 | Statistical and bioinformatics analyses |
| Seurat package | CRAN | v4.0 | Single-cell RNA sequencing data preprocessing and analysis |
| siS100P | Tsingke Biotech Co., Ltd | N/A | Small interfering RNA targeting S100P |
| SingleR package | Bioconductor | v2.6.0 | Cell type annotation for single-cell RNA sequencing |
| STRING database | STRING Consortium | N/A | Protein-protein interaction analysis |
| SW1116 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human colorectal cancer cell line |
| TB Green qPCR Mix | Takara Bio | RR430B | Quantitative real-time PCR |
| TCGA-CRC dataset | The Cancer Genome Atlas (TCGA) | N/A | Public colorectal cancer transcriptomic dataset |
| TRIzol reagent | Invitrogen | 15596-026 | Total RNA extraction |
| WGCNA package | CRAN | v1.73 | Weighted gene co-expression network analysis |
参考文献
- Xu R, Du W, Yang Q, Du A. ITGB2 related to immune cell infiltration as a potential therapeutic target of inflammatory bowel disease using bioinformatics and functional research. Journal of cellular and molecular medicine. 2024;28(15):e18501.
- Sun HW, Zhang X, Shen CC. The shared circulating diagnostic biomarkers and molecular mechanisms of systemic lupus erythematosus and inflammatory bowel disease. Frontiers in immunology. 2024;15:1354348.
- Faye AS, Holmer AK, Axelrad JE. Cancer in inflammatory bowel disease. Gastroenterology clinics of North America. 2022;51(3):649-66.
- Yu J, et al. Risk of hepato-pancreato-biliary cancer is increased by primary sclerosing cholangitis in patients with inflammatory bowel disease: A population-based cohort study. United European gastroenterology journal. 2022;10(2):212-24.
- Xia B, et al. Identification of potential shared gene signatures between gastric cancer and type 2 diabetes: A data-driven analysis. Frontiers in medicine. 2024;11:1382004.
- Luo Y, et al. Exploring the molecular mechanism of comorbidity of type 2 diabetes mellitus and colorectal cancer: Insights from bulk omics and single-cell sequencing validation. Biomolecules. 2024;14(6).
- Newman AM, et al. Robust enumeration of cell subsets from tissue expression profiles. Nature methods. 2015;12(5):453-7.
- Sun W, et al. Construction and validation of a novel senescence-related risk score can help predict the prognosis and tumor microenvironment of gastric cancer patients and determine that STK40 can affect the ROS accumulation and proliferation ability of gastric cancer cells. Frontiers in immunology. 2023;14:1259231.
- Hong J, et al. A zinc metabolism-related gene signature for predicting prognosis and characteristics of breast cancer. Front Immunol. 2023;14:1276280.
- Man KF, et al. CREB1-BCL2 drives mitochondrial resilience in RAS GAP-dependent breast cancer chemoresistance. Oncogene. 2025;44(16):1093-105.
- Zhou H, et al. S100P promotes trophoblast syncytialization during early placenta development by regulating YAP1. Frontiers in endocrinology. 2022;13:860261.
- Zhou C, et al. Novel exosome-associated LncRNA model predicts colorectal cancer prognosis and drug response. Hereditas. 2025;162(1):79.
- Hong J, et al. Integrative PANoptosis-focused omics analysis uncovers GSDMC as a candidate biomarker in breast cancer. Frontiers in Cell and Developmental Biology. 2026;Volume 14 - 2026.
- Qiu C, et al. Hsa_circ_0004662 accelerates the progression of ulcerative colitis via the microRNA-532/HMGB3 signalling axis. Journal of cellular and molecular medicine. 2025;29(6):e70430.
- Schmid F, et al. Calcium-binding protein S100P is a new target gene of MACC1, drives colorectal cancer metastasis and serves as a prognostic biomarker. British journal of cancer. 2022;127(4):675-85.
- Arumugam T, Simeone DM, Van Golen K, Logsdon CD. S100P promotes pancreatic cancer growth, survival, and invasion. Clinical cancer research: an official journal of the American Association for Cancer Research. 2005;11(15):5356-64.
- Zong J, et al. The two-directional prospective association between inflammatory bowel disease and neurodegenerative disorders: A systematic review and meta-analysis based on longitudinal studies. Frontiers in immunology. 2024;15:1325908.
- Yaqubi K, et al. Inflammatory bowel disease is associated with an increase in the incidence of multiple sclerosis: A retrospective cohort study of 24,934 patients. European journal of medical research. 2024;29(1):186.
- Li CY, et al. Genome-wide genetic links between amyotrophic lateral sclerosis and autoimmune diseases. BMC medicine. 2021;19(1):27.
- Shigesi N, et al. The association between endometriosis and autoimmune diseases: A systematic review and meta-analysis. Human reproduction update. 2019;25(4):486-503.
- Sonnenberg A, Duong HT, McCarty DJ, El-Serag HB. Concurrence of inflammatory bowel disease with multiple sclerosis or Hodgkin lymphoma. European journal of gastroenterology & hepatology. 2023;35(12):1349-53.
- Chacon-Millan P, et al. A combination of microarray-based profiling and biocomputational analysis identified miR331-3p and hsa-let-7d-5p as potential biomarkers of ulcerative colitis progression to colorectal cancer. International journal of molecular sciences. 2024;25(11).
- Everhov Å H, et al. Inflammatory bowel disease and pancreatic cancer: A Scandinavian register-based cohort study 1969-2017. Alimentary pharmacology & therapeutics. 2020;52(1):143-54.
- Contran N, et al. Colorectal cancer and inflammatory bowel diseases share common salivary proteomic pathways. Scientific reports. 2024;14(1):17711.
- Sun W, et al. Osthole pretreatment alleviates TNBS-induced colitis in mice via both cAMP/PKA-dependent and independent pathways. Acta pharmacologica Sinica. 2017;38(8):1120-8.
- Li SY, et al. Diosgenin exerts anti-tumor effects through inactivation of cAMP/PKA/CREB signaling pathway in colorectal cancer. European journal of pharmacology. 2021;908:174370.
- Castro-Pando S, et al. Pancreatic epithelial IL17/IL17RA signaling drives B7-H4 expression to promote tumorigenesis. Cancer immunology research. 2024;12(9):1170-83.
- Kayed H, et al. FXYD3 is overexpressed in pancreatic ductal adenocarcinoma and influences pancreatic cancer cell growth. International journal of cancer. 2006;118(1):43-54.
- Wang H, et al. Mesenchymal stem cells ameliorate DSS-induced experimental colitis by modulating the gut microbiota and MUC-1 pathway. Journal of inflammation research. 2023;16:2023-39.
- Li W, et al. MUC1-C drives stemness in progression of colitis to colorectal cancer. JCI insight. 2020;5(12).
- Murthy D, et al. The MUC1-HIF-1α signaling axis regulates pancreatic cancer pathogenesis through polyamine metabolism remodeling. Proceedings of the National Academy of Sciences of the United States of America. 2024;121(14):e2315509121.
- Sun W, et al. TRIM47 regulates energy metabolism via glycolytic reprogramming to drive hepatocellular carcinoma progression and represents an efficient therapeutic target. Adv Sci (Weinh). 2026;13(17):e16996.
- Sun W, et al. METTL4 enhances GLI1 translation through m(6)Am modification to promote tumor progression as a therapeutic target for hepatocellular carcinoma. J Adv Res. 2026.
- Yuan Y, et al. RNA nanotherapeutics for hepatocellular carcinoma treatment. Theranostics. 2025;15(3):965-92.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。