このプロトコルは、331人の従業員におけるエージェントAIの技術的特性が認知的余剰、心理的安全性、AIと人間のタスク再配分にどのように関連しているかを調査する調査ベースのワークフローを説明しています。部分最小二乗構造方程式モデリングと多グループ分析は、リーダーとスタッフの役割に基づく違いを明らかにします。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
本研究は、エージェントAIの技術的特性が組織内の従業員の心理状態や行動反応とどのように関連しているかを検証します。ジョブ需要-資源(JD-R)理論と資源保存(COR)理論を活用し、エージェントAI技術特性(AITC)を自律的な計画、マルチツールのオーケストレーション、積極的なフィードバックからなる高次構造として概念化し、これらの特性が認知的余剰や心理的安全性の向上に関連するジョブリソースとして機能すると提案します。これらはAIと人間のタスク再配分に関連しています。さらに、これらの関係がリーダーとスタッフの間で異なるかどうかも調査します。目的的非確率サンプリングを用いて研究パネルから募集された参加者に対し、オンライン調査プラットフォームを通じて横断的かつ匿名のオンライン調査を実施しました。対象は現在または以前にAI関連の職務経験がある成人に限定され、スクリーニング・注意確認回答の結果、331名の従業員(リーダー171名、スタッフ160名)が最終的に抽出されました。すべての構成要素は、エージェントAIの文脈に適応した検証済みスケールで7ポイントリッカートスケールで測定されました。データは部分最小二乗構造方程式モデリング(PLS-SEM)を用いて分析され、二次構造には2段階アプローチを適用し、直接的および間接効果のために5,000件の再サンプルを用いたブートストラップ法、リーダーとスタッフの比較には多グループ解析(MGA)を用いました。測定モデルは妥当性と妥当性を示し、構造的な結果は理論化されたリソース獲得モデルと整合していました。AITCは認知的余剰、心理的安全性、タスク再配分と正の関連があり、リーダー間のメディエーション経路やAITC資源の関連性が強まりました。技術的パフォーマンスではなく心理的メカニズムに焦点を当てることで、本研究は新興のエージェントAI研究を拡張し、役割差別化されたAI採用戦略に対する実践的な示唆を提供します。
概要
エージェントAIの普及は、産業や組織生活における人工知能の役割を再定義しています 1,2。エージェントAIとは、変化する環境を認識し、推論メカニズムを通じて独立して目標を設定し、最小限の人間の監督で一連の行動を指揮する高度な人工知能の形態と定義できます 3,4。従来のAIや従来の生成AIツールと3つの点で区別されます。主体システムは事前プログラムされたルールを実行するのではなく、最小限の人間の介入で目標を追求するため、自律性(5,6)。コア機能、なぜなら彼らの目的は単一のタスクではなく複雑なワークフローの自動化だからです。そしてアーキテクチャは、単一のモデル7に依存するのではなく、複数の大規模言語モデル、アプリケーションプログラミングインターフェース(API)、エージェントを調整するためです。これらの能力は、本研究で検証された定義的な技術的特性に基づいています。自律計画(AP)とは、ユーザーの目標が与えられた上で、システムが独立してそれをサブタスクに分解し、制約が10変更されるたびに計画を修正することを意味します。例えば、従業員が一行の指示を出しても、実行可能な多段階プロジェクト計画を受け取ることができます。マルチツールオーケストレーション(MTO)とは、システムが外部ツールやAPIを選択、シーケンスし、統合することを意味します。1、11、12;例えば、ウェブ検索、ドキュメントエディタ、データ分析ツールを組み合わせて、一貫したレポートを作成することなどです。プロアクティブフィードバック(PF)とは、システムが10,13の質問を受ける前に誤り、欠落情報、リスクの高い仮定をフラグ付けすることを意味します。例えば、タスク実行中に従業員に検証やコンプライアンスチェックポイントをリマインダーさせることです。私たちはこれら3つの特性に焦点を当てており、これらは総称してエージェントAI技術特性(AITC)と呼ばれます。これらは日常業務におけるエージェントAIと従来のAIを区別する機能的能力だからです。透明性、制御可能性、説明可能性といった属性はAI信頼に一般的に重要ですが、エージェントパラダイムに特有のものではなく、将来の研究の境界条件として扱い、焦点となる次元としては扱いません。
職場でのエージェントAIの急速な普及にもかかわらず、既存の文献は主にその技術的アーキテクチャ、運用効率、タスク自動化能力に焦点を当てており、これらの特性が従業員の心理状態や行動反応をどのように再形成するかにはあまり注目していません(14,15).この省略は重要です。なぜなら、人間とAIの間でタスクを再割り当てすることは単なる技術的調整ではなく、心理的・組織的に組み込まれたプロセスだからです。従業員は既存のワークフローに挑戦し、役割の境界を再定義し、知能システムとの新しい協働形態を受け入れなければなりません(16,17)。こうした変化は、単に高度な技術が利用可能だからといって自動的に起こるものではありません。したがって、本研究の目的は三つあります。すなわち、AITCが認知的余剰、心理的安全性、AIと人間のタスク再配分に関連する雇用資源として機能するかどうかを検証すること。認知的余剰と心理的安全性の媒介および連続的な媒介役割を調査すること;また、これらの構造的な関係がリーダーとスタッフの間で異なるかどうかを探ることです。この研究の新規性は三つあります。第一に、エージェントAIの技術的特性—自律的な計画、マルチツールのオーケストレーション、積極的フィードバック—をJD-Rフレームワーク内のより高度なジョブリソースとして概念化・運用し、AI導入を単なる区別のない文脈として扱うのではありません。第二に、AIと人間のタスク再配分を、汎用的なジョブ作成やトップダウンのデジタルトランスフォーメーションとは異なる、ドメイン特有の技術的なタスク作成の形態として導入します。第三に、私たちの知る限り、エージェントAIのリソース生成関連がリーダーとスタッフ間で体系的に異なるという初の多グループ証拠を提供しています。
理論的根拠は、ジョブ需要資源理論(JD-R)と資源保存理論(COR)を統合しています。JD-R理論は、すべての仕事は仕事の要求、すなわち持続的な努力を必要とする身体的・感情的・認知的側面と、要求を減らし目標達成を支援し、自己成長を促す職務資源から成ります。そのバランスはエンゲージメント、幸福感、パフォーマンスを形作ります18,19。COR理論は動的なメカニズムを加えます。個人は価値ある資源を獲得・保持・保護しようと努力し、蓄積された資源は既存の資源を再投資してさらなる資源を得るための利得スパイラルを開始します。この共同視点から、AITCは単なる技術的特徴ではなく、新たな形態の職務資源として概念化できます。計画や診断分析といった反復的で認知的に負担の大きい作業を吸収することで、エージェントシステムは要求を減らし、従業員の認知エネルギーと時間を節約します(15,23)。私たちは認知余剰(CS)を、日常的な作業が技術に委譲されることで得られる認知的エネルギーと裁量時間の貯蔵庫であり、それを集団参加、協働、新たな価値の創造に再投資できるものと定義しています。したがって、CSは感情的・動機付け状態である仕事への関与や単なる時間的可用性とは概念的に区別されます。なぜなら、CSはCORの意味で個人資源の可換可能なストックを指すからです(20,24)。CSはまた、仕事から失われたエネルギーを回復することに関わる心理的離脱や回復、そして十分な時間があるという主観的知覚を示す時間の豊かさとも区別されます。CSとは、仕事中に再投資可能な自由な認知能力を指します。CORの観点から言えば、蓄積されたCSは疲労や燃え尽きを緩和することで職業上の福祉を支える資源獲得を表し、一方で追加の日常的需要による吸収は資源損失を示す20,23,24となります。節約された時間が実際に余剰に変わるかどうかは、AIリテラシー、追加の要求で節約時間を吸収できる業務負荷の基準、組織文化など個々の特性によります。したがって、資源-獲得経路を仮定ではなく検証すべき仮説として扱います。
H1:AITCはCSと正の関連があります。
心理的安全性(PS)とは、自分の職場環境が人間関係のリスクを取るのに安全であると信じることと定義されており、例えばミスを認めたり、助けを求めたり、現状に挑戦したりすることを指します。心理的安全性はしばしばチームレベルの雰囲気として研究されてきましたが、本研究は個人レベルの認識として概念化し測定しており、個人レベルの調査設計と一致しています(27,28)。エージェントシステムが学習志向のフィードバックや支援ツールを提供する場合、実験や誤りの暴露にかかる対人コストは減少するかもしれません。なぜなら、従業員は自分の作業を他者に提示する前にテストし修正できるからです(26,28)。しかし、逆のダイナミクスも十分にあり得ることを認めています。エージェント系システムが監視や責任追及のために展開される場合、認識される対人リスクや不信感は29,30増加する可能性があります。ここで検討する特徴は評価的ではなく補助的な性質であるため、正の関連を仮説を立てつつ、この両側性の可能性を重要な境界条件として扱います。
H2:AITCはPSと正の関連があります。
私たちはAIと人間のタスク再配分(AHTR)を、従業員が自発的にタスクを自分自身とAIシステムの間で再分配し、日常業務をAIに委譲しつつ、自身の戦略的・創造的な責任を拡大することと定義しています。私たちはAHTRを、分野特化型の求人作成の形態として位置づけています。ティムズとバッカーのJD-Rモデルでは、ジョブ作成はジョブリソースの増加、課題要求の増加、障害要求の減少を含みます17,31;WrzesniewskiとDuttonの類型論では、課題、関係性、認知クラフティング32を含みます。AHTRは技術を通じて実行されるタスク作成に最も近いもので、日常業務をAIに委ねることで同時に障害を減らし、新たなジョブリソースを動員します。これは、トップダウンによる組織再設計ではなく、裁量的かつ従業員主導のタスク境界変更を捉えているため、一般的なデジタルトランスフォーメーションの成果よりも狭いものです。私たちは、タスク再配分を関係的・認知的クラフティングよりも優先します。なぜなら、タスクの再分配は従業員とエージェントシステム間の最も即時的な行動的インターフェースであり、早期導入時に直接観察できるからです。一方、関係的・認知的クラフティングは通常、下流の適応として現れます(31,32)。従来の研究でAI導入を一般的なジョブ作成の文脈的前提として扱っていたのに対し、私たちは再割り当て自体をフォーカルクラフティング行動としてモデル化しています。このような再配分は既存のワークフローを乱すため、従業員は十分な認知的資源を持ち、仕事を再設計し、心理的に安全だと感じて対人リスクを受け入れる可能性が高いと感じます(16,34)。COR理論のゲインスパイラル論理の中で、心理的安全性は認知的余剰の蓄積を保護し増幅する文脈的資源としても機能します。
H3:胸結核はAHTRと正の関連があります。
H5: PSはAHTRと正の関連があります。
H6:PSはCSと正の関連があります。
H9: AITCはAHTRと正の関連があります。
これらの議論を統合することで、AITCは認知的余剰と心理的安全性という資源獲得経路を通じて、直接的だけでなく間接的にAHTRと関連していることが期待されています。
H4:CSはAITCとAHTRの関係を媒介します。
H7:PSはAITCとAHTRの関係を媒介します。
H8: PSとCSはAITCとAHTRの関係を順次媒介します。
最後に、従業員はエージェントAIを一律に解釈し反応しているわけではありません。ギブソン、クーパー、コンガーは、リーダーとチーム間の知覚距離を、同じ組織目標に関する認知的不一致として説明し、情報アクセス、説明責任、リスク曝露、職務経験の非対称性に根ざしています。この見解を踏まえると、リーダーとスタッフはAI導入に関して構造的に異なる立場にいます。リーダーは戦略的責任を持ち、AIを生産性やデータ駆動型の意思決定のための拡張志向のリソースとして捉える傾向があるのに対し、スタッフは自動化に関連する職務の不安定さや学習過負荷にさらされやすい傾向があります20,30.これらのパターンは、どちらのグループの固定された傾向よりも、経験的に検証すべき傾向として扱います。このような役割に基づく不一致は、AITC、CS、PS、AHTR間の関係に不均一なパターンを生み出す可能性がありますが、これらのグループの違いを明示的に捉える実証的研究は限られています。
H10a:AITCとCSおよびPSの関連性は、リーダーやスタッフによって異なります。
H10b:PSとCSのAHTRとの関連性は、リーダーやスタッフによって異なります。
以下のプロトコルは、参加者の募集とスクリーニングから調査実施、データクリーニング、測定検証、構造モデル推定、媒介分析、多グループ分析(MGA)(図1)に至るまでの全ワークフローを説明しており、この手順を独立して再現できるようにします。研究モデルは 図2に示されています。AITCはAP、MTO、PFからなる二次構造としてモデル化され、CSとPSを通じてAHTRに直接的・間接的に関連し、PSもCSに関連しています。リーダーとスタッフの役割の違いはMGAを通じて検証されます。
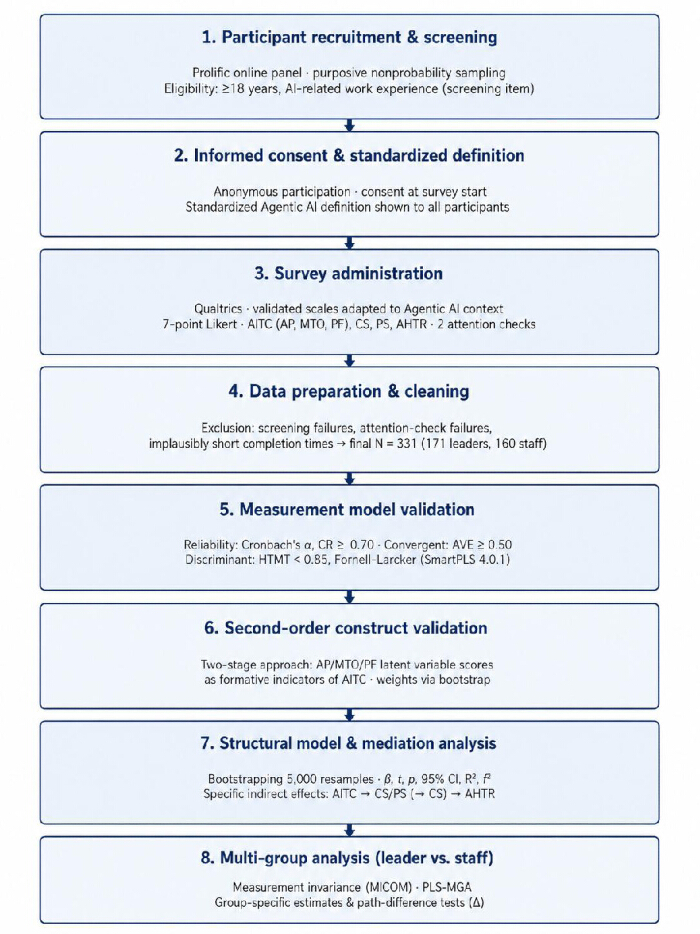
図1。全体的な研究設計ワークフロー。 研究プロトコルの完全な図。参加者はオンラインパネルを通じて目的的非確率サンプリングを用いて募集され、AI関連の職務経験のスクリーニングが行われました。対象となる回答者は、すべての構成要素を7ポイントリッカート尺度で測定する匿名調査に回答しました。データクリーニング(スクリーニング失敗、注意チェック失敗、不合理なほど短い完了時間の除去;最終N=331)を経て、測定モデルが検証されました(信頼性:クロンバックα、複合信頼性;収束妥当性:平均分散抽出;判別妥当性:HTMTおよびFornell-Larcker)、2段階構成要素は2段階アプローチで検証され、構造モデル、媒介経路、リーダーとスタッフの多グループ分析は5,000人で推定されましたブートストラップ再サンプル。 この図の拡大版はこちらをクリックしてご覧ください。
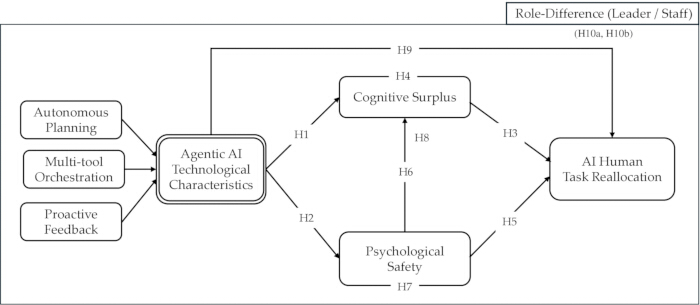
図2。提案された研究モデル。 仮説関係の概念モデル。エージェントAIの技術的特性(AITC)は、自律的計画(AP;目標をサブタスクに分解し計画を修正するシステムの能力)、マルチツールオーケストレーション(MTO;複数のツールやAPIを選択・順序付け・統合する能力)、およびプロアクティブフィードバック(PF;意図せずにエラーやリスクを指摘する能力)からなる二次構造であり、認知的余剰(CS;認知エネルギーと裁量時間の貯蔵庫)と正の関連があると仮説されています日常業務がAIに委譲されると解放される)、心理的安全(PS;職場環境が対人リスクテイクに安全であるという認識)、およびAIと人間のタスク再配分(AHTR;従業員が自発的にタスクを自分とAIの間で再分配すること)(H1、H2、H9)です。CSおよびPSはAHTR(H3, H5)、PSとCS(H6)、およびCSとPSが個別かつ順次にAITC-AHTR関係(H4, H7, H8)を媒介する正の関連があると仮定されています。矢印は仮説化された構造経路を表し、H10a/H10bは、複数グループ解析で検証された仮説上のリーダーとスタッフの差を示します。 この図の拡大版はこちらをクリックしてご覧ください。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
すべての手技は、aSSIST大学および東亜大学における人間参加者を対象とした研究の倫理基準に従って実施されました。すべての回答は収集時に匿名化され、個人を特定できる情報は一切収集されなかったため、aSSIST大学の機関審査委員会は、大韓民国生命倫理安全法第15条および執行規則第13条に基づき、本研究を完全な審査の対象外と判断しました。調査は、参加が現在AIプロジェクトに従事・関与している個人に限定されていること、研究目的、参加の任意性、回答の匿名性、データの意図された利用方法を説明する情報・同意ページで始まりました。明確に同意した回答者のみがアンケートに進みました。同意ページは 補足ファイル1に記載されています。
サンプルサイズの決定
データ収集前に、線形多重回帰族に対してG*Power 3.1.9.7(RRID: SCR_013726)を用いて事前検出力分析が行われ、モデル内の単一の内因性構成要素に向けられた予測変数の最大数を指定しました。本研究では、AHTRは3つの構成要素(AITC、CS、PS)によって予測されます。効果量は中程度(f2 = 0.15)、α = 0.05、統計的検出力0.80で、必要な最小サンプル数は77例でした。G*Powerプロトコルの出力は 補足ファイル2に提供されています。PLS-SEM36の最小サンプルサイズは逆平方根法を用いてクロスチェックされ、約155ケースが標準化経路係数を検出するために5%の有意水準で約0.20、80%の検力を検出します。最後に、リクルート目標は間接効果のブートストラップとスプリットサンプル多群分析を支援するために、両方の最小値を大幅に超えるように設定されました。最終サンプル(N=331;リーダーN=171、スタッフn=160)は各サブグループ内の最低サンプル要件を満たしました。
参加者募集と選考
参加者はオンライン研究パネルを通じて目的的非確率抽出法を用いて募集されました。つまり、サンプルは一般集団から無作為に選ばれるのではなく、事前に実質的な基準(現在または過去のAI関連の職務経験)を満たす回答者に意図的に限定されました。対象は18歳以上の回答者に限定されました。AI関連の職務経験は、メインアンケートの前に提示される「以下の中であなたの現在の状況を最もよく表すものはどれですか?」というスクリーニング項目を通じて実務化されました。現在雇用中でAI関連の仕事に従事していると答えた回答者のみが進み、残りの選択肢(雇用されているがAI業務に関与していない、雇用されていないが以前に関与している、雇用されていない、雇用されていない、関与していない)は即時スクリーニングがトリガーされました。データ収集は2026年2月8日10時28分から13時30分の単一セッションで行われ、参加者はプラットフォームの公正な報酬方針に従い、1時間あたり6.98ポンドで報酬を受け取りました。重複参加はプラットフォームの一意参加者識別子と重複回答防止設定によって防げました。各段階での回答者数は記録され、包括・除外のワークフローを文書化しました。537件の回答が記録されました。151題はスクリーニング問題で除外され(残り386)、注意チェック(直線走行を含む)に失敗したため40名が退場(残り346名)、15個は約180秒未満の不合理なほど短い完成時間で除去され、最終サンプルN=331が得られました。
標準化された定義と調査の指示
参加者には、この調査がエージェントAIが組織やそのメンバーにどのような影響を与えるかを調査していると説明されました。調査開始時に、すべての参加者には導入部で示された定義と一致するエージェントAIの簡単な標準化定義が示されました。これは自律的な計画、マルチツールのオーケストレーション、そして限定的な人間の監督なしに目標指向の行動を実行する積極的なフィードバックを特徴とする高度なAIシステムです(図1、ステップ2)。応募資格は、現在雇用されておりAIプロジェクトに関わっている回答者に限定され、アンケート回答の関連的な業務上の根拠となりました。別途理解度チェックの項目は含まれていませんでした。したがって、標準化された定義は検証された理解チェックではなく、文脈的な指向として機能しました。参加者は、組織の文脈でこのようなエージェントAIシステムを実際に使用または扱った経験に基づいて、すべての質問に答えるよう指示されました。
測量機器の開発と管理
このアンケートは、Agentic AIの組織文脈に適応した検証済みの測定尺度から開発されました。表1はすべての項目、そのソーススケール、記述統計を示しています。AP、MTO、PF項目は最近のエージェントAI概念化7,8から適応されています。生成AI認知資源研究からのCS項目37;PlompらのPS項目38;そして、タスク再配分に適応されたJD-Rベースのジョブクラフティングスケール17.39のAHTR項目。すべての構成要素は7点リッカート尺度で測定され、1(「強く異なる」)から7(「強く一致」)までの範囲で評価されました。調査は、同意ページ、スクリーニング、AITC項目(AP、MTO、PF)、CS、PS、AHTR、人口統計・対照の特徴をカバーするブロックに構成されました。また、このツールには本モデルの範囲を超えた追加の尺度(AIリテラシーや役割幅の自己効力感)が含まれており、ここでは分析されず、透明性のために報告されました。この調査はオンライン調査プラットフォーム上で実施されていました。戻るボタンは無効化され、回答者が以前の回答を修正できないようにされ、項目はブロック内で一定の順序で提示されました。中央値は7分44秒でした。2つの指示回答注意力チェック項目が調査フローの分岐として埋め込まれ、不正回答すると調査が終了しました。(i) 事実確認「AIはアーティチョーク情報の略称ですか?」(正解:いいえ)、(ii)回答が「強く反対」から「強く同意」までの7点リッカート尺度で記録されたことを確認する尺度理解チェック。本格的な管理前に、124名の回答者を対象にパイロットテストが実施され、調査項目の明瞭さ、全体の調査流れ、完了期間、質問票の実現可能性を評価しました。回答期間が異常に短いものを特定し、調査期間が対象回答者に適切かどうかを確認しました。パイロットテストでは文言修正が必要な問題は示されず、本調査前に文言の変更も行われませんでした。さらに、パイロットデータはPLS-SEMを用いて予備検証手順として分析され、指標の性能、構成の信頼性、収束的妥当性、判別妥当性、共線性、提案された構造的関係の妥当性を評価しました。結果は、この機器がメインサーベイに適していることを支持しました。
| 構成要素 | アイテム | 質問 | 平均 | STDEV | VIF | 出典 | |||
| AITC(アメリカ人・商業・成人 | AP | AP1 | 目標を提示すると、AIはそれを達成するための多段階の計画を作成するのを助けてくれます。 | 5.81 | 0.9 | 1.44 | Abou Ali, M.ら(2025);Sapkota, R., 他 (2025) | ||
| AP2 | 制約や要件が変わったときには、AIは計画を修正できます。 | 5.75 | 0.99 | 1.37 | |||||
| AP3 | AIは複雑な作業を手順を説明せずに管理しやすいサブタスクに分解します。 | 5.33 | 1.37 | 1.33 | |||||
| MTO | MTO1 | AIは複数のツールやアプリ(例:検索、ドキュメント、データツール)を組み合わせてタスクを完了できます。 | 5.69 | 1.11 | 1.5 | ||||
| MTO2 | AIは適切なツールを提案し、それらを正しい順序で使って成果物を生成します。 | 5.36 | 1.04 | 1.64 | |||||
| MTO3 | AIは異なるツールの出力を一つの一貫した結果に統合する手助けをします。 | 5.61 | 1.01 | 1.63 | |||||
| PF | PF1 | AIは私の作業における誤りや欠落情報、リスクの高い前提を積極的に指摘してくれます。 | 4.9 | 1.44 | 1.68 | ||||
| PF2 | AIは私が明確にフィードバックを求める前に改善点を提案します。 | 5.07 | 1.38 | 1.85 | |||||
| PF3 | AIは再作業を防ぐためのチェックポイント(例:検証、コンプライアンス、品質)を思い出させてくれます。 | 5.02 | 1.4 | 1.6 | |||||
| コンピュータサイエンス | CS1 | AIを使うことで、より複雑で意味のある仕事に集中できる精神的エネルギーが解放されました。 | 5.59 | 1.28 | 2.07 | リウ、Y.、シェン、F.、リウ、R.(2025年) | |||
| CS2 | AIを使ったことで、戦略的思考や問題解決に使える時間が増えました。 | 5.61 | 1.23 | 2.38 | |||||
| CS3 | ルーティンタスクからの負担が大幅に減り、新しい取り組みに集中できる余裕ができました。 | 5.42 | 1.28 | 2.23 | |||||
| CS4 | AIが繰り返しの作業を処理してくれるので、仕事の終わりに精神的に疲れを感じにくいです。 | 5.15 | 1.5 | 1.91 | |||||
| 追伸 | 追伸1 | 私の職場では、AIを新しい方法で活用することに関連するリスクを取ることは安全です。 | 4.74 | 1.37 | 1.52 | Plompら(2019年) | |||
| 追伸2 | 私のマネージャーはAIの実験を奨励し、ミスにも寛容です。 | 4.52 | 1.61 | 1.68 | |||||
| PS3 | AIの使い方について懸念があれば、私は気軽に声を上げられます。 | 5.48 | 1.24 | 1.32 | |||||
| PS4 | 同僚たちは、AIとの新しいやり方を試すことを支持してくれます。 | 5.26 | 1.32 | 1.48 | |||||
| PS5(除外) | AIの革新的な活用を提案すれば、負の影響を恐れません。 | 4.47 | 1.59 | 1.23 | |||||
| AHTR | AHTR1 | 私は意図的にルーチン業務(例:データ入力やレポートのフォーマット)をAIに移し、より価値の高い作業に集中できるようにしています。 | 5.12 | 1.35 | 1.68 | ティムズ、M.、バッカー、A. B.(2010年);Li, W. ほか(2024年) | |||
| AHTR2 | 以前は手作業でやっていたタスクをAIで処理する機会を積極的に探しています。 | 5.58 | 1.28 | 1.84 | |||||
| AHTR3 | AIを使い始めてからは、より戦略的または創造的な新たな責任や拡大した責任を担うようになりました。 | 5.18 | 1.3 | 1.58 | |||||
| AHTR4(除外) | どのタスクをAIが担当し、どのタスクを自分が担当すべきか、マネージャーと交渉しています。 | 4.09 | 1.65 | 1.23 | |||||
| AHTR5 | 私はルーティン業務をAIに再割り当てし、より意味のある作業に専念できるようにして仕事を再設計しました。 | 4.92 | 1.35 | 1.67 | |||||
表1:測定項目、情報源、記述統計、完全な共線性評価。 完全な調査機器。各項目は構成要素(AITC寸法AP、MTO、PF;CS;追伸;AHTR)、項目コード、文言、平均、標準偏差(STDEV)、完全な共線分散インフレ係数(VIF;値<3.3は共通の方法分散汚染の欠如を示す)、およびそれを適応したソーススケール。すべての項目は7ポイントリッカート尺度(1=強く反対、7=強く同意)で測定されました。PS5とAHTR4は、外部負荷が低いため、測定モデル評価時に除外されました。AITC = エージェントAI技術特性;AP = 自律的計画;MTO = マルチツールオーケストレーション;PF = 積極的フィードバック;CS = 認知余剰;PS = 心理的安全;AHTR = AIと人間のタスク再割り当て。 この表をダウンロードするには、こちらをクリックしてください。
データ準備とクリーニング
生の回答はCSV形式でエクスポートされました。スクリーニング基準または注意チェック項目のいずれかに該当しない症例は除外され、またデータが著しく欠如している回答(強制回答設定で調査内の欠落を最小限に抑えた)回答も除外されました。各段階での除外カウントはプロトコル第2節に記録されています(記録537件→保持件331件)。保持されたデータは一貫性を検証し、不注意反応パターンのスクリーニングを行い、注意チェックで直線反応を除去し、約180秒未満の不合理な完成時間を持つ応答は除外しました。その後、変数を解析のために符号化しました(例:役割:リーダー=1、スタッフ=0;性別:男性=1、女性=0)。 表2に記載されているように、産業などのカテゴリ別コントロールはk-1指標でダミーコード化され、最終データセットはPLS-SEMソフトウェアにインポートされました。すべての変数をアイテムテキスト、コーディング、構成にマッピングするコードブックが 補足ファイル2として提供されています。
測定モデルの評価
PLS-SEMソフトウェアを用いて、各観測項目を潜在構成に割り当て、すべての一次構成要素(AP、MTO、PF、CS、PS、AHTR)を反射的に指定しました。AITCはAP、MTO、PFからなる二次構成要素として指定され、2段階アプローチ40、41、42で推定されました。まず一次構成要素に対して潜在変数スコアを取得し、その後(AP_LVS、MTO_LVS、PF_LVS)をAITCの形成指標として用いました。PLSアルゴリズムはパス重み付け方式で実行され、最大3,000回の反復と10−7の停止基準が適用されました。内部整合性信頼性は、Cronbachの43のαおよび複合信頼度(CR)閾値0.70に対して評価され、新興研究文脈における短尺度の0.5–0.6 α値をわずかに許容範囲と扱いました。収束妥当性は平均分散抽出(AVE)閾値0.50に対して評価されました。判別妥当性は異形質-単一形質比(HTMT <0.85、保守的閾値)45 およびフォーネル・ラーカー基準44を用いて評価されました。信頼性または収束妥当性基準が満たされない場合は、外部負荷を検査し、性能の低い指標は内容の妥当性を保持しつつ削除し、すべての削除とその理由が記録されました。本研究では、PS5とAHTR4は低い外負荷のため除外され、PSとAHTRの収束妥当性が向上しました。
構造モデルと媒介分析
構造的経路は研究モデルに従って指定され(図2)、予測変数構成要素間の共線性は、モデル内分散インフレ因子(VIF < 5.0)36および全共線性VIFs(<3.3)46,47を用いて検証されました。経路有意性は、パーセンタイル信頼区間と両側検定を用いて5,000件の再サンプルを用いてブートストラップで推定し、標準化された経路係数(β)、標本平均(M)、標準偏差(STDEV)、t値、p値、95%信頼区間、R2、効果量(f2)が報告されました。標本外予測力はPLSpredictを用いて10折り10回繰り返し評価しました。各内因性指標について、Q2予測(>0は予測関連性を示す)を検証し、PLS-SEMの予測誤差(RMSEおよびMAE)を線形モデル(LM)ベンチマーク48と比較しました。媒介解析では、AITCがCS、PS、そして連続的なPS →CS経路を通じてAHTRに与える間接効果を指定し、各間接効果をブートストラップ分布(5,000件の再サンプル)で評価し、95%信頼区間がゼロで間接効果が有意と判断されました。
多群解析
回答者は自己申告した組織役割に基づいてリーダーグループとスタッフグループに分類されました(役割:リーダー=1、スタッフ=0; 表2);リーダーグループはチームリーダー/スーパーバイザー、マネージャー/部門長、経営幹部/上級リーダーで構成され、スタッフグループはスタッフレベルの従業員で構成されていました。経路係数比較前に、複合モデル測定不変性(MICOM)手順45を用いてグループ間の測定不変性が確立されました。ステップ1(構成不変性)はグループ間で同一のモデル仕様によって満たされ、ステップ2(合成不変性)はすべての構成要素で支持され、元の相関は5%分位数以上で、非有意な置換p値(AHTR c = 0.999, p = 0.524;AITC c = 0.954、 p = 0.205;CS c = 1.000、 p = 0.800;PS c = 0.976, p = 0.073)、部分測定不変性の確立と多群比較の正当化(MICOMの全結果は 補足ファイル3に記載)。その後、モデルは各グループごとに個別に推定され、ブートストラップベースのPLS-MGAを用いて経路差を検証しました。各経路のリーダーとスタッフの差(Δ)に対して一尾および二尾のp値が報告されました。グループごとの経路係数、t値、p値はすべての直接および間接経路について報告され、各グループ間の違いの大きさも含まれていました。
報告、検証、トラブルシューティング
信頼性、妥当性、構造的、媒介、MGAの出力はすべてまとめられました。結果表はエクスポートされました。報告されたすべての統計は、表、図、テキスト間で一貫性を確保するためにソフトウェア生成の出力と照合されました。トラブルシューティングのために、以下のガイドラインが適用されます:多くの回答がスクリーニングや注意チェックに不合格の場合は、適格要件を明確にし、調査指示を明確にすること;信頼性(CR < 0.70)または収束妥当性(AVE < 0.50)の基準が満たされない場合は、外部負荷を見直し、理論的カバレッジを維持しつつ弱い指標を除去します。共線性(閾値を超えるVIF)が特定された場合、構成条件の仕様を再評価し、冗長な指標を排除します。媒介やグループ効果が有意でない場合は、サンプルの十分性を再検討し、解釈前に操作化を構築します。そして、推定値を安定させるために、十分な数のブートストラップ再サンプル(例:5,000件)を用いましょう。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
参加者の特徴
表2は 最終サンプルの人口統計的特徴を示しています(N=331)。サンプルは男性65.0%、女性35.0%で構成され、リーダー(51.7%、n = 171)とスタッフ(48.3%、n = 160)の比較的バランスの取れた分布でした。最も多い年齢層は30歳未満(46.5%)、次いで31歳から40歳(32.0%)、76.4%が学士号または大学院の学位を取得していました。回答者は、テクノロジーと通信(46.2%)を中心とした多様な業界や、さまざまな規模の組織から集まっていました。このプロファイルは、AI関連の業務に積極的に従事する従業員に焦点を当てた研究の意図的な方針と一致しています。
| 特徴 | カテゴリー | 周波数(n) |
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究では、エージェントAIの技術的特性が従業員の心理的資源やタスク再配分行動とどのように関連し、これらの関係が組織の役割間で異なるかを検証しました。331人のAI経験者を対象とした横断調査とPLS-SEMを媒介および多グループ分析を用いた結果は、理論化されたリソース獲得モデルと一致しました。AITCは認知余剰、心理的安全性、AIと人間のタスク再割り当てと正の関連を示し、認知的余剰と心理的安全性がAITC-AHTRの関係を個別かつ連続的に媒介しました。また、AITCと両方の資源変数との関連は、リーダー間でスタッフよりも有意に強いものでした。
この発見は三つの理論的な意味を持ちます。まず、彼らはJD-R理論をエージェントAIの文脈に拡張し、技術的特性をツールではなく職務資源として扱います。強いAITC-CSの関連性(β = 0.485)は、自律的な計画、マルチツールのオーケストレーション、積極的なフィードバックが認知的エネルギーと裁量時間を節約し、従業員が再投資できるという見解と一致しています 15,23,24
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは利益相反を一切認めていない。
生成AIツール(ChatGPT、OpenAI)が言語編集に使用され、すべての内容は著者によってレビュー・検証され、AI支援編集がセクション間で用語やトーンの変化をもたらしていないことも確認されました。
謝辞
この研究はaSSIST大学の研究資金によって支援されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Prolific | Prolific | https://www.prolific.com/ | オンライン調査パネルプロバイダー |
| Qualtrics | Qualtrics, LLC | https://www.qualtrics.com/ | 調査コーディング |
| SmartPLS | SmartPLS GmbH | バージョン 4.0.1, https://www.smartpls.com/ | PLS-SEM分析 |
参考文献
- Chawla C, Chatterjee S, Gadadinni SS, Verma P, Banerjee S. Agentic AI: The building blocks of sophisticated AI business applications. Journal of AI, Robotics & Workplace Automation. 2024;3(3):196–210.
- Lu C, et al. The AI scientist: Towards fully automated open-ended scientific discovery. arXiv [Preprint]. 2024. arXiv:2408.06292. Available from: https://arxiv.org/abs/2408.06292.
- Xie J, Chen Z, Zhang R, Wan X, Li G. Large multimodal agents: A survey. arXiv [Preprint]. 2024. arXiv:2402.15116. Available from: https://arxiv.org/abs/2402.15116.
- Du H, Thudumu S, Vasa R, Mouzakis K. A survey on context-aware multi-agent systems: Techniques, challenges and future directions. arXiv [Preprint]. 2024. arXiv:2402.01968. Available from: https://arxiv.org/abs/2402.01968.
- Acharya DB, Kuppan K, Divya B. Agentic AI: Autonomous intelligence for complex goals - a comprehensive survey. IEEE Access. 2025;13:18912–18936.
- Calegari R, Ciatto G, Mascardi V, Omicini A. Logic-based technologies for multi-agent systems: A systematic literature review. Auton Agent Multi Agent Syst. 2021;35(1):1.
- Sapkota R, Roumeliotis KI, Karkee M. AI agents vs. Agentic AI: A conceptual taxonomy, applications and challenges. Inf Fusion. 2026;126:103599.
- Abou Ali M, Dornaika F, Charafeddine J. Agentic AI: A comprehensive survey of architectures, applications, and future directions. Artif Intell Rev. 2025;59(1):11.
- Buyya R. Agentic artificial intelligence (AI): Architectures, taxonomies, and evaluation of large language model agents. arXiv [Preprint]. 2026. arXiv:2601.12560. Available from: https://arxiv.org/abs/2601.12560.
- Nisa U, Shirazi M, Saip MA, Pozi MSM. Agentic AI: The age of reasoning - a review. J Autom Intell. 2025. doi:10.1016/j.jai.2025.08.003.
- Singh A, Ehtesham A, Kumar S, Khoei TT. Enhancing AI systems with agentic workflows patterns in large language model. In: 2024 IEEE World AI IoT Congress (AIIoT); Seattle, WA; 2024:527–532.
- Zeng A, et al. AgentTuning: Enabling generalized agent abilities for LLMs. In: Findings of the Association for Computational Linguistics: ACL 2024; Bangkok, Thailand; 2024:3053–3077.
- Liu X, Zhang L, Wei X. Generative artificial intelligence literacy: Scale development and its effect on job performance. Behav Sci (Basel). 2025;15(6):811.
- Wooldridge M, Jennings NR. Intelligent agents: Theory and practice. Knowl Eng Rev. 1995;10(2):115–152.
- Masterman T, Besen S, Sawtell M, Chao A. The landscape of emerging AI agent architectures for reasoning, planning, and tool calling: A survey. arXiv [Preprint]. 2024. arXiv:2404.11584. Available from: https://arxiv.org/abs/2404.11584.
- Sha C, Chai T. When digital-AI transformation sparks adaptation: Job crafting and AI knowledge in job insecurity contexts. Front Psychol. 2025;16:1612245.
- Tims M, Bakker AB. Job crafting: Towards a new model of individual job redesign. SA J Ind Psychol. 2010;36(2):1–9.
- Bakker AB, Hakanen JJ, Demerouti E, Xanthopoulou D. Job resources boost work engagement, particularly when job demands are high. J Educ Psychol. 2007;99(2):274–284.
- Bakker AB, Demerouti E, Sanz-Vergel A. Job demands-resources theory: Ten years later. Annu Rev Organ Psychol Organ Behav. 2023;10(1):25–53.
- Hobfoll SE, Shirom A. Conservation of resources theory: Applications to stress and management in the workplace. In: Golembiewski RT, ed. Handbook of Organizational Behavior. 2nd ed. Marcel Dekker; New York; 2000:57–80.
- Hobfoll SE. Conservation of resources: A new attempt at conceptualizing stress. Am Psychol. 1989;44(3):513–524.
- Hobfoll SE, Halbesleben J, Neveu JP, Westman M. Conservation of resources in the organizational context: The reality of resources and their consequences. Annu Rev Organ Psychol Organ Behav. 2018;5(1):103–128.
- Bakker AB, Demerouti E. Job demands-resources theory: Taking stock and looking forward. J Occup Health Psychol. 2017;22(3):273–285.
- Shirky C. Cognitive Surplus: How Technology Makes Consumers into Collaborators. Penguin Press; New York; 2010.
- Edmondson A. Psychological safety and learning behavior in work teams. Adm Sci Q. 1999;44(2):350–383.
- Zhao G, Kumar N, Wang C, Liu Z. Bridging the AI gap: How AI-oriented leadership empowers non-technical employees in AI-based innovation engagement. Leadersh Organ Dev J. 2026;47(3):498–514.
- Edmondson AC, Lei Z. Psychological safety: The history, renaissance, and future of an interpersonal construct. Annu Rev Organ Psychol Organ Behav. 2014;1(1):23–43.
- Kim BJ, Kim MJ, Lee J. The dark side of artificial intelligence adoption: Linking artificial intelligence adoption to employee depression via psychological safety and ethical leadership. Humanit Soc Sci Commun. 2025;12(1):1–14.
- Cardon PW, Ma H, Fleischmann C. Recorded business meetings and AI algorithmic tools: Negotiating privacy concerns, psychological safety, and control. Int J Bus Commun. 2023;60(4):1095–1122.
- Raisch S, Krakowski S. Artificial intelligence and management: The automation-augmentation paradox. Acad Manage Rev. 2021;46(1):192–210.
- Tims M, Bakker AB, Derks D. Development and validation of the job crafting scale. J Vocat Behav. 2012;80(1):173–186.
- Wrzesniewski A, Dutton JE. Crafting a job: Revisioning employees as active crafters of their work. Acad Manage Rev. 2001;26(2):179–201.
- Grant AM, Parker SK. Redesigning work design theories: The rise of relational and proactive perspectives. Acad Manag Ann. 2009;3(1):317–375.
- Liu Q, Tian Q, Li X, Tan H. How does organizational AI adoption affect employees’ job crafting behaviors? An approach-avoidance perspective. Front Psychol. 2025;16:1690238.
- Gibson CB, Cooper CD, Conger JA. Do you see what we see? The complex effects of perceptual distance between leaders and teams. J Appl Psychol. 2009;94(1):62–76.
- Hair JF, et al. Partial Least Squares Structural Equation Modeling (PLS-SEM) Using R: A Workbook. Springer; Cham; 2021:1–56.
- Liu Y, Sheng F, Liu R. Generative AI adoption and employee outcomes: A conservation of resources perspective on job crafting, career commitment, and the moderating role of liking of AI. Humanit Soc Sci Commun. 2025;12:1376.
- Plomp J, Tims M, Khapova SN, Jansen PG, Bakker AB. Psychological safety, job crafting, and employability: A comparison between permanent and temporary workers. Front Psychol. 2019;10:974.
- Li W, et al. Embracing artificial intelligence (AI) with job crafting: Exploring trickle-down effect and employees’ outcomes. Tour Manag. 2024;104:104935.
- Gaskin J, Godfrey S, Vance A. Successful system use: It’s not just who you are, but what you do. AIS Trans Hum Comput Interact. 2018;10(2):57–81.
- Marakas G, Johnson R, Clay PF. The evolving nature of the computer self-efficacy construct: An empirical investigation of measurement construction, validity, reliability and stability over time. J Assoc Inf Syst. 2007;8(1):2.
- Loch KD, Straub DW, Kamel S. Diffusing the Internet in the Arab world: The role of social norms and technological culturation. Global Information Systems. 2008;143–175.
- Nunnally JC. Psychometric Theory. 2nd ed. McGraw-Hill; New York; 1978.
- Fornell C, Larcker DF. Evaluating structural equation models with unobservable variables and measurement error. J Mark Res. 1981;18(1):39–50.
- Henseler J, Ringle CM, Sarstedt M. A new criterion for assessing discriminant validity in variance-based structural equation modeling. J Acad Mark Sci. 2015;43(1):115–135.
- Kock N. Common method bias in PLS-SEM: A full collinearity assessment approach. Int J e-Collab. 2015;11(4):1–10.
- Kock N, Lynn GS. Lateral collinearity and misleading results in variance-based SEM: An illustration and recommendations. J Assoc Inf Syst. 2012;13(7):2.
- Shmueli G, et al. Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. Eur J Mark. 2019;53(11):2322–2347.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: A critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879–903.
- Podsakoff PM, MacKenzie SB, Podsakoff NP. Sources of method bias in social science research and recommendations on how to control it. Annu Rev Psychol. 2012;63(1):539–569.
- Harman HH. Modern Factor Analysis. 3rd ed. University of Chicago Press; Chicago; 1976.
- Podsakoff PM, Organ DW. Self-reports in organizational research: Problems and prospects. J Manage. 1986;12(4):531–544.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。