提案されたMSCNN-LSTMフレームワークは、スポーツビデオのアクション認識に向けて、マルチスケールの空間的特徴抽出と時間的シーケンスモデリングを統合したものであり、ベンチマークのスポーツアクションデータセットにおいて競争力のある分類性能を達成しつつ、詳細な空間的特徴と時間的な動作パターンを捉えます。
研究記事
長短期記憶(LSTM)ベースの時間的モデリングを用いたマルチスケール畳み込みネットワークによるスポーツ動画のアクション認識
この記事について
サマリー
要約
スポーツビデオにおける動作認識は、複雑な運動ダイナミクス、遮蔽、およびクラス内の高い変動性により、依然として困難な課題です。CNN-BiLSTMや転移学習ベースのモデルを含む既存のディープラーニングアプローチは、人間の活動認識において有効性を示していますが、急速で多様な動きを伴うスポーツシーンでは性能が制限される可能性があります。既存の多くの手法は単一スケールの畳み込みフィルタに依存しており、詳細な動きと大まかな動きの両方の特性を同時に効果的に捉えることができない場合があります。この制限に対処するため、本研究では、スポーツビデオの動作認識に向けた、Long Short-Term Memory (LSTM) ネットワークを統合したマルチスケール畳み込みニューラルネットワーク (MSCNN) を提案します。MSCNNは、並列畳み込みカーネルを通じて複数の受容野で空間的表現を抽出し、詳細な動きの特徴とコンテキスト上の動きの特徴の両方を学習することを可能にします。これらの特徴は、その後LSTMによって処理され、連続するフレーム間の時間的依存性と動作の連続性が捉えられます。UCF11、UCF Sports、およびJHMDBのベンチマークデータセットを用いて実験的な評価を行いました。提案したMSCNN-LSTMモデルは、それぞれ98.3%、95.4%、81.7%の分類精度を達成し、本研究で評価した比較手法を上回りました。アブレーション解析により、マルチスケール特徴抽出と時間的モデリングが全体的な性能に寄与することがさらに実証されました。これらの知見は、スポーツビデオの動作認識において、空間情報と時間情報を組み合わせる提案フレームワークの有用性を示しています。
概要
人間の行動認識は、インテリジェント監視、異常検知、アクションベースのオーディオビジュアル検索、ヘルスケアにおける患者モニタリングなど、現実世界のさまざまな領域で幅広く応用されています1,2。特に監視システムやソーシャルメディアプラットフォームからのビデオストリームにおけるアクション認識は、異常検知やイベント理解において大きな可能性を秘めています3。ビデオ解析における人間の動作は、手や脚などの異なる身体部位を観察することで識別されます。静止画とは異なり、単一のフレームだけではアクションを表現するのに不十分な場合が多くあります4。例えば、サッカーと縄跳びの初期ポーズは、単一のフレームでは同様に見えることがあります。これらのアクションの違いは、身体の動きのパターンや周囲の環境との相互作用を捉えた一連のフレームを通じて観察することで明確になります5,6,7。本稿で使用されている略語は、可読性を向上させ、用語の一貫性を確保するために表1にまとめています。
| 略称 | 正式名称 |
| 人工知能 | 人工知能 |
| AUC(曲線下面積) | 曲線下面積 |
| 双方向LSTM(BiLSTM) | 双方向長短期記憶 |
| 畳み込みニューラルネットワーク | 畳み込みニューラルネットワーク |
| CUDA | Compute Unified Device Architecture |
| F1スコア | 適合率と再現率の調和平均 |
| GPU(グラフィックス処理装置) | グラフィックス処理装置 |
| HAR | 人間の行動認識 |
| JHMDB | 統合ヒト動作データベース |
| 長短期記憶(LSTM) | 長短期記憶 |
| mAP-T | 時間的平均適合率(Temporal Mean Average Precision) |
| MCC | マシューズ相関係数 |
| マルチスケール畳み込みニューラルネットワーク | マルチスケール畳み込みニューラルネットワーク |
| ROC(受信者動作特性) | 受信者動作特性 |
| 三重糖鉄寒天培地(TSI) | 時間的安定性指標 |
| UCF | セントラルフロリダ大学 |
| ビデオRAM | ビデオランダムアクセスメモリ |
表1:本稿で使用した略語一覧研究全体を通じて使用された一般的な略称およびアクロニムと、それらに対応する正式名称。
高速かつ正確なスポーツビデオの分類は、幅広いアプリケーションにおいて重要です。8,9,10、スポーツアナリティクス、イベント検出、コンテンツベース検索、およびレコメンデーションシステムを含む11,12,13スポーツ関連のビデオコンテンツが急速に増加するにつれ、従来の分析フレームワークの限界がますます顕著になっています。14その結果、スポーツ活動の複雑さと動的な特性に対処できる堅牢なアプローチへの需要が高まっています。従来のスポーツビデオ分類手法は、主にオプティカルフローやHOG(Histogram of Oriented Gradients)などの手作業で設計された記述子に依存し、スポーツビデオ内の動作パターンや活動を特徴づけてきました。15.
静止画像の分類において顕著な成功を収めているConvNetは、ビデオ解析にも適用されています。しかし、ビデオには動的な時空間情報が含まれているため、行動認識はより困難な課題となっています。現在のディープラーニングベースのアプローチは、一般的に2ストリームネットワーク16、3D畳み込みネットワーク、および計算効率の高いアーキテクチャの3つのグループに分類できます。オプティカルフローから時間情報を学習するために、2ストリームネットワークは追加のConvNetを採用していますが17,18、この手法は計算コストが高くなります。C3D、I3D、R3Dなどの3D畳み込みアーキテクチャは、時間情報を直接的にモデル化できますが、パラメータ数が大幅に増加するため、最適化がより困難になります。計算効率の高い手法では、分解された3D演算を検討することでモデルの複雑さを低減しようとしています。
さらに、CNNは局所的な空間的特徴を抽出でき、LSTMは時間的なコンテキスト情報を捉えることができるため、ハイブリッドモデルはセンサ入力から時空間的な動作パターンを効果的に学習できます。CNNと回帰型ニューラルネットワークのアーキテクチャを組み合わせた近年の研究では、有望な結果が得られています18,19,20。しかし、LSTMはシーケンス処理中に情報を圧縮するため、特徴抽出時に混入したノイズが認識性能に影響を及ぼす可能性があります。この問題に対処するため、いくつかの研究ではアテンションメカニズムが導入されています21,22。アテンションメカニズムにより、モデルは認識タスクに最も関連性の高い特徴に焦点を当てることができ、それによって分類性能が向上します。
CNNベースの特徴抽出を組み合わせた深層双方向LSTMモデルは、人間の行動認識において有望な結果を上げていますが、これらのフレームワークをスポーツビデオの動作認識に拡張する場合、いくつかの課題が残っています。第一に、既存のCNN-LSTMアーキテクチャは単一スケールの畳み込み特徴抽出を採用することが多く、スポーツシーンにおける選手と物体の同時運動など、複数の空間的・時間的解像度で発生する動作を捉える能力が制限される可能性があります。3D CNN23や2ストリームCNNを含むマルチスケール畳み込みネットワークは、異なるスケールで空間的および運動的なキューを捉える重要性を示していますが、この概念はLSTMベースのハイブリッドシステムでは十分に探索されていません。第二に、従来の多くのCNN-BiLSTMモデル24は主に短期的な時間的依存性に焦点を当てており、チームスポーツに共通する長範囲の運動の連続性や物体間の相互作用が十分に表現されていない可能性があります。MobileNetV2やResNetなどの転移学習ベースのアプローチの多くは、静止フレームの特徴に依存しており、時間的アテンションメカニズムや適応的マルチスケール特徴融合を完全には活用していません25。さらに、既存モデルの多くは主にUCF11やJHMDBなどのベンチマークデータセットで評価されています。SoccerNetやFineGymなど、複雑なカメラモーションや活動パターンを捉えたより新しいスポーツ特化型データセットは、依然として十分に研究されていません。これらの限界は、スポーツビデオの動作認識において、きめ細やかな空間表現と長範囲の時間的依存性の両方をより適切に捉えるために、LSTMまたはBiLSTMネットワークなどの時間的メモリモジュールと統合されたマルチスケール畳み込み特徴抽出フレームワークの必要性を強調しています。
さらに、CNNは局所的な空間的特徴を抽出でき、一方のLSTMは時間的コンテキストをモデル化できます。そのため、ハイブリッドCNN-RNNアーキテクチャは、人間の行動認識において有望な性能を示しています26,27。近年の研究では、人間の行動認識を向上させるために、相補的な学習戦略を組み込むことで従来のCNN–LSTMフレームワークを拡張しています。例えば、タスクに関連する特徴を強調し、情報の少ない表現を抑制するためのアテンションメカニズムが導入され、これにより認識性能が向上しています28。また、行動認識と時間的セグメンテーションタスクを共同で最適化するマルチタスク学習を採用し、学習効率と特徴表現を向上させたアプローチもあります29。これらの進展にもかかわらず、きめ細やかな空間的・時間的特徴が常に効果的に捉えられているとは限らないため、既存の手法では視覚的に類似した動作を区別する能力が依然として限定的である可能性があります。表2に、既存のアプローチの長所と限界をまとめます30。
| 参考文献 / 年 | 使用方法 | データセット | 性能指標 | 主な強み | 限界点 |
| Hassanら(2024年)1 | KFDI(キーフレーム動的画像) | UCF11 | 正確度:85.3% | 効率的なキーフレーム選択と動的画像表現の向上。 | フレーム選択の誤差に敏感であり、時間的なモデリングに限界がある。 |
| Zhouら(2023年)24 | 拡張CNN + BiLSTM + 残差ブロック | UCF11, UCFスポーツ | 正解率:UCF11:89、UCF Sports:92.2% | 空間的および時間的な学習を統合し、マルチスケールの情報を捕捉します。 | 計算負荷が高く、小規模なデータセットでは過学習のリスクがある。 |
| Ullahら(2025)34 | 局所・全域特徴量 + QSVM | UCF11 | 正確度:82.6% | ハンドクラフト特徴量とディープ特徴量を組み合わせることで、堅牢な認識を実現します。 | 手動での調整が必要であり、拡張性に限界がある。 |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11、UCF50、UCF101、およびJHMDB | 精度:UCF11:97.73%;UCF50:98.81%;UCF101:98.46%;JHMDB:83.38% | 長距離の空間的および時間的依存性を捉えます。 | 高い計算コストとデータ要件。 |
| Su et al. (2024)23 | 3D-CNN | UCF11 | 正確度:85.1% | エンドツーエンドの時空間特徴学習 | 高いメモリおよびGPU要件。 |
| Karuppannanら(2024)35 | ディープオートエンコーダー + CNN | UCF11 | 正確度:96.2% | コンパクトな特徴表現を学習します。 | 限定的な長期時間的モデリング。 |
| Sahooら (2020)36 | HAR-Depth | KTH、UCF sports、JHMDB、UCF101、およびHMDB51 | 正解率:KTH:97.67%、UCF Sports:95.00%、JHMDB:73.13%、UCF101:92.97%、HMDB51:69.74% | 効果的な深さベースの時間的学習。 | 正確な深度推定と広範な前処理が必要である。 |
表2:スポーツビデオの動作認識における既存のディープラーニング手法の比較。データセット、手法の特徴、利点、および制限を含む代表的なディープラーニングアプローチの要約であり、提案するMSCNN-LSTMフレームワークによって解決される研究上のギャップを強調している。
オーディオ同期によって駆動される顔アニメーションのためのフレームワークが提案されており、Facial Denoiser Model (FDM) と Local-to-global Latent Diffusion Model (LG-LDM) を組み合わせることで、感情表現豊かな顔アニメーションを生成します。詳細な3次元の顔面形状と微妙な表情の変化を再構成するために、Emotion-centric Vector Quantized Variational Autoencoder (EVQ-VAE) が採用されました31。また、遮蔽条件下でターゲットのセグメンテーション、局在化、遮蔽推論、およびマルチターゲットの把持ポーズ推定を行うために、双眼ステレオビジョンを用いた遮蔽認識ロボット把持フレームワークが開発されました32。さらに、グリッド投影と適応的ビン分割を用いた点群からの地面抽出のための2段階フレームワークが導入されており、グリッドベースの特徴分析による粗い抽出の後、標高と曲率の確率を用いて地面と障害物の境界を精緻化しています33}
ディープラーニングに基づく行動認識は大幅に進展していますが、既存の手法では、急速な動作、カメラの動き、複数の選手間の相互作用など、スポーツビデオの高い変動性と複雑さに対応することが依然として困難です。従来のCNNまたはLSTMベースのモデルの多くは、単一の空間スケールで動作するため、局所的なモーションパターンと大域的なモーションパターンの両方を効果的に捉えることが難しい場合があります。さらに、長時間にわたるシーケンスや重複するアクションにおいて時間的な一貫性を維持することは、依然として課題となっています。転移学習の手法によって特徴抽出は向上しましたが、スポーツ特有のデータセットへの適応については、まだ十分に研究されていません。
本研究は、マルチスケールの空間的特徴抽出とLSTMベースの時間的モデリングを統合し、詳細な空間的特徴と長期的な時間的依存性の両方を捉えることで、スポーツビデオの動作認識のためのマルチスケール畳み込みニューラルネットワーク・長短期記憶(MSCNN-LSTM)フレームワークを開発し、評価することを目的としています。提案されたフレームワークは、相補的な畳み込みカーネルとマルチレベルの特徴融合を採用し、困難な条件下における複雑なスポーツ動作の表現力を向上させています。その性能は、UCF11、UCF Sports、およびJHMDBのベンチマークデータセットを用いて、正解率(accuracy)、適合率(precision)、再現率(recall)、F1スコア、時間平均適合率(mAP-T)、時間安定性指標(TSI)、Cohenのカッパ係数(κ)、マシュー相関係数(MCC)、およびROC曲線下面積(AUC)によって評価されました。実験結果は、本研究で評価した他の手法と比較して競争力のある性能を示しており、スポーツ解析、アスリートのパフォーマンスモニタリング、自動イベント検出、およびスポーツビデオ理解における本フレームワークの有用性を強調しています。
プロトコル
本研究では、マルチスケール畳み込みニューラルネットワーク(MSCNN)と長短期記憶(LSTM)ネットワークを統合した、スポーツビデオのアクション認識のための2段階ディープラーニングフレームワークを採用した。モデルの開発および評価には、公開されているベンチマークデータセットであるUCF1、UCF Sports、およびJHMDBを使用した。ヒト参加者から新たなデータを収集することはなく、個人を特定できる情報へのアクセスや処理も行わなかった。本研究は、公開された匿名化データセットの二次分析であり、ヒトの直接的な参加を伴わないため、機関の倫理承認およびインフォームドコンセントは不要であった。
ワークフローは、フレームサンプリングと時間的正規化で構成され、続いてMSCNNモジュールを用いて特徴抽出が行われました。抽出された特徴は、その後、時間的モデリングのためにLSTMネットワークで処理され、マルチクラス分類レイヤーに送られました。最終的に、選択したベンチマークデータセットを用いてモデルの学習と評価が行われました。図1 に、提案したフレームワークの全体的なアーキテクチャを示します。
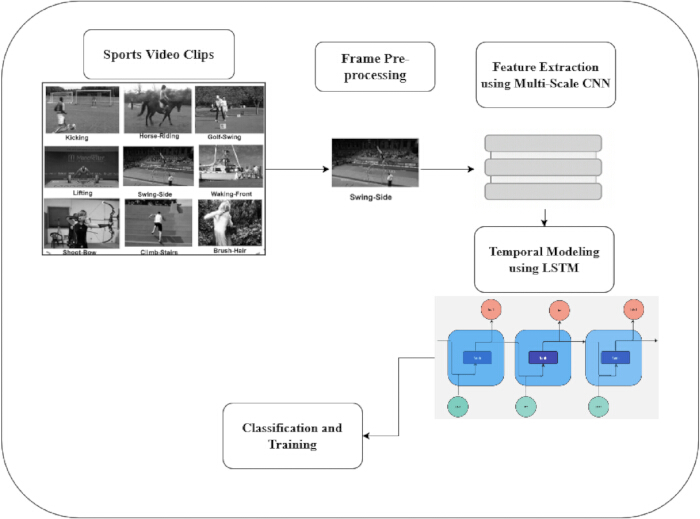
図1スポーツビデオのアクション認識に向けた、提案するMSCNN-LSTMフレームワーク。 ビデオの前処理、マルチスケール空間特徴抽出、時間的シーケンス学習、および動作分類を示す全体的なワークフロー。 この図の拡大版を表示するには、ここをクリックしてください。
図 1は、ハイブリッドMSC-NN-LSTMアーキテクチャに基づいた、提案するスポーツビデオ動作認識フレームワークのワークフローを示しています。このプロセスは、キック、乗馬、ゴルフスイングなど、さまざまな競技動作を含むスポーツビデオクリップから始まります。前処理段階で、未加工のビデオは個々のフレームに分解され、フレームのクロッピング、標準化、およびモデル入力への準備が行われます。前処理されたフレームはその後、特徴抽出のためにMSCNNモジュールに供給されます。マルチスケール畳み込みアーキテクチャは、異なる受容野で空間的特徴をキャプチャし、スポーツビデオフレームから局所的および文脈的な情報の両方を抽出することを可能にします。抽出された特徴ベクトルは、次にLSTMネットワークによって処理され、連続するフレーム間における時間的依存性と動作の展開がモデル化されます。最終的に、分類および学習モジュールが学習された時空間表現を用いて、各ビデオクリップの動作カテゴリを予測します。提案フレームワークは4つの連続したステップで構成されており、まずUCF1 (YouTube Actions)、UCF Sports、およびJHMDBベンチマークデータセットを用いたデータ収集と前処理から始まります。各スポーツビデオはフレームのシーケンスに変換され、環境変動に対する堅牢性を高めるために、リサイズ、正規化、および回転、反転、クロッピングによるデータ拡張が行われました。前処理されたフレームは、提案するマルチスケール畳み込みニューラルネットワーク(MSCNN)によって処理され、3 × 3、5 × 5、および 7 × 7 カーネルを持つ並列畳み込みブランチが、相補的な局所的および文脈的な空間的特徴を抽出しました。これらのマルチスケール特徴は、バッチ正規化とマックスプーリングを用いて連結および精緻化され、コンパクトな特徴表現が生成されました。得られたフレームレベルの特徴は、その後、連続するフレーム間の時間的依存性をモデル化するためにLong Short-Term Memory (LSTM) ネットワークに提供されました。最終的なLSTM出力はフラット化され、ReLU活性化関数を持つ全結合層を通過した後、Softmax分類器によって動作カテゴリが予測されました。ネットワークは、過学習を抑えるために、クロスエントロピー損失関数とドロップアウト正則化を用いたAdamオプティマイザを使用して学習されました。最終的に、モデルの性能は、正解率、適合率、再現率、およびF1スコアを用いて、UCF1、UCF Sports、およびJHMDBベンチマークデータセットで評価されました。
1. データ収集および前処理
本研究では、スポーツおよび人間の動作に関する3つの公開ベンチマークデータセットを使用した。これらのデータセットには、カメラの動き、視点、背景の複雑さが異なる現実世界のスポーツ映像が含まれている。具体的には、約25名から記録された1,168本のYouTubeビデオから収集された1のアクションカテゴリー(1アクションあたり複数のサンプルあり)を含むUCF1 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php)を利用した。Joint-Annotated Human Motion Database (JHMDB)34,35には、21のアクションクラスと928本の注釈付きビデオが含まれている。UCF Sportsデータセットは、放送ソースからキャプチャされた解像度720 × 480 pixelsの10のアクションクラスと150本のビデオシーケンスで構成されている (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php)。
これらのデータセットは、個人競技と団体競技の両方を網羅しており、提案するMSCNN-LSTM動作認識フレームワークを評価するための時間的持続時間と視覚的スケールの多様性を提供しています。データ品質のスクリーニングプロセスの一環として、UCF1、UCF Sports、およびJHMDBデータセットについて、破損したビデオ、重複ファイル、およびアノテーションが不完全なクリップの有無を調査しました。これらの除外基準に該当するサンプルは特定されなかったため、利用可能なすべてのビデオを後続の解析に使用しました。その後、一貫したランダム分割戦略を用いて、データセットをトレーニング(70%)、検証(15%)、およびテスト(15%)のサブセットに分割しました。図2に、トレーニングと評価に使用した代表的な画像を示します。
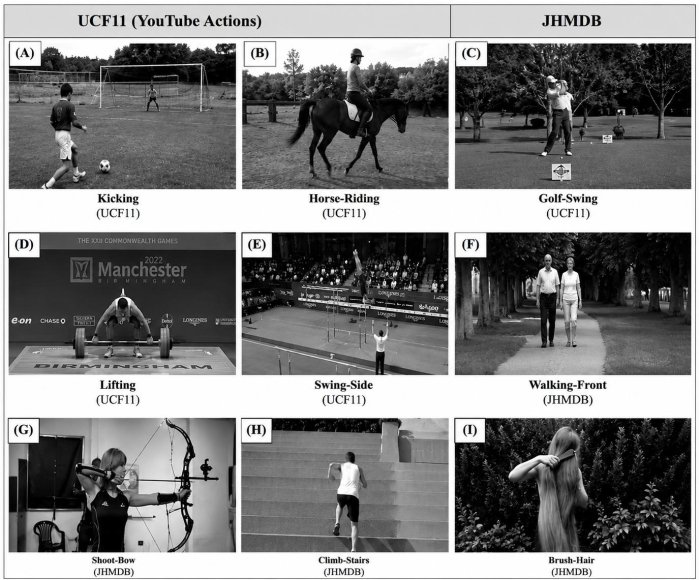
図 2ベンチマークのスポーツ動作認識データセットから抽出した代表的なフレーム。 パネル(A–DUCF1(YouTube Actions)データセットの例をパネル(に示します。E–H)はUCF Sportsデータセットからのものであり、パネル(I–LJHMDBデータセットからのフレーム。これらのフレームは、アクションクラス、視点、背景、照明条件、および動作の複雑性のバリエーションを示している。 この図の拡大版を表示するには、ここをクリックしてください。
提案した行動認識モデルは、Table 3に要約されているUCF1、UCF Sports、およびJHMDBのベンチマークデータセットを用いて評価した。これらのデータセットは、多様な動作パターンと困難な環境条件を網羅している。UCF1(YouTube Actions)データセットには、さまざまな照明、視点、背景条件下で取得された1クラスのスポーツ動作が含まれている。UCF Sportsデータセットは、プロの放送から得られた150本のフィールドスポーツビデオで構成されており、現実的な動作シーケンスを特徴としている。JHMDBデータセットは、21のきめ細かな行動カテゴリーに対して詳細な人体動作アノテーションを提供しており、時空間的な行動認識のベンチマークデータセットとして機能する。これらのデータセットを合わせて、スポーツおよび人体動作のシナリオにおけるモデル性能の評価に使用した。ネットワークの学習にはAdamオプティマイザを使用し、エポック数は10、バッチサイズは32、初期学習率は0.01、損失関数にはクロスエントロピー損失を用いた。最終評価には、検証損失が最小となったモデルを選択した。すべての実験では、乱数シードを42に固定した。収束を改善するために早期終了(Early stopping)およびプラトーでの学習率減少を適用し、LSTMの学習中は勾配爆発を防ぐためにしきい値5.0で勾配クリッピングを行った。提案したMSCNN-LSTMモデルの学習可能なパラメータ数は約1,50万個であった。実装に使用したハードウェアおよびソフトウェア構成はTable 4に要約されている。クラス分布は十分に均衡していたため、追加のクラス重み付けやリサンプリング処理は適用しなかった。比較モデルは、元の研究で報告されたハイパーパラメータを用いて実装し、可能な限り学習設定を統一した。性能値は、異なる乱数初期化による5回の独立した試行の平均値 ± 標準偏差として報告した。提案モデルと比較モデルとの間の差は、有意水準 p < 0.05 の対応のあるt検定を用いて評価した。
| データセット | クラス数 | 動画数 | 解像度 (px) | ※ソーステキストが提供されていません。翻訳する原文を入力してください。 | 概要 |
| UCF1 (YouTubeアクション) | 11 | 1168 | 可変 (≈ 320×240) | セントラルフロリダ大学 | スポーツにおける1種類のヒトの動作(バスケットボールのシュート、ダイビング、ゴルフのスイング、サッカーのリフティングなど)が含まれています。ビデオはYouTubeから収集されており、照明、視点、背景に大きな変動があります。 |
| UCFスポーツ | 10 | 150 | 720×480 | UCF スポーツアクションデータセット | 実際のテレビ放送映像(BBC、ESPN)から記録された、ダイビング、乗馬、ゴルフスイング、ランニング、ウェイトリフティングなどのスポーツ活動を含んでいます。 |
| JHMDB | 21 | 928 | 320×240 | マックス・プランク知能システム研究所 | キャッチ、ジャンプ、ヘアブラシ、シュート、ランニングなどの日常活動およびスポーツ活動を含み、動作およびポーズ解析のための関節アノテーションが付随している。 |
表3:トレーニングおよび評価に使用したベンチマークデータセットの特性。アクションクラス数、ビデオサンプル数、データセットの特性、ならびにモデルのトレーニング、検証、テストにおける役割を含む、UCF11、UCF Sports、およびJHMDBデータセットの概要。
| 使用したパラメータ | 概要 |
| プログラミング言語 | Python 3.8.18 [4] |
| ディープラーニングフレームワーク | TensorFlow 2.15.0 [1] |
| GPUアクセラレータ | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| 中央処理装置 | Intel Core i9 @ 3.5 GHz × 16コア |
| オペレーティングシステム | Windows 1 |
| メモリ (RAM) | 64 GB DDR4 |
| 最適化アルゴリズム | Adam (学習率 = 0.001) |
| バッチサイズ | 32 |
| エポック数 | 100 |
| 活性化関数 | ReLU(CNN層)、Softmax(出力層) |
| 脱落率 | 0.5 |
表4:提案するMSCNN-LSTMモデルのシミュレーション環境およびハイパーパラメータ構成。ハードウェア仕様、ソフトウェア環境、オプティマイザ設定、学習率、バッチサイズ、エポック数、入力次元、およびモデルのトレーニングと評価に使用されたその他のハイパーパラメータ。
2. 前処理
トレーニングの前に、各生のビデオは時間順のフレームシーケンスに変換され、その後、正規化、時間的サンプリング、およびデータ拡張が行われました。各入力ビデオは V まずフレームのシーケンスに変換され、4Dテンソルとして表現された。 V ∈ RT×H×W×C、ここで T フレーム数であり、 H × W i はフレームインデックスを示し、 C はカラーチャネル数(RGBの場合は3)を表します。前処理パイプラインは、フレーム抽出、空間的なリサイズ、それに続く固定解像度へのセンタークロップまたはランダムクロップで構成されました(H′, W′)、画素ごとの強度正規化、および、ランダムな反転、スケーリング、カラージッタリングを含むオプションのデータ拡張を、特徴抽出の前に行った。具体的に、強度正規化は、式(1)に示す標準得点正規化などのいずれかとして実装された。
 (1)
ここで μ および σ はトレーニングセットを用いて算出されたチャンネル平均および標準偏差であり、または式(2)に示すような最小最大スケーリングとして適用されます。
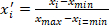 (2)
正規化後、各フレームは F̃t ∈ RH′×W′×C′ として表され、得られたビデオテンソルは V′ ∈ RT×H′×W′×C として表された。マルチスケール畳み込みフロントエンドでは、異なるカーネルサイズを用いていくつかの2次元(または初期の時空間畳み込みの場合は3次元)畳み込みを適用することで、複数の受容野空間特徴マップを取得する。その後、各フレームまたは短いビデオクリップに対して時間的特徴表現を生成し、LSTMモジュールへと転送した。原著論文では、MobileNetV2を適用した後に時間的モデリングとしてDeep BiLSTMを用いているが、上述の前処理パイプラインは、マルチスケール畳み込み + LSTMへの置換とも完全に互換性がある。
3. サンプリングおよび時間的正規化
ビデオの長さTはデータセット間およびデータセット内で異なるため、マルチスケール畳み込み + LSTM に、フレーム数または短いスニペット数として固定の入力長Nを与えるために、フレームを均等にサンプリングするか、時間的にリサンプリングします。均等なフレームインデックスは、式 (3) のように計算できます。
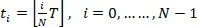 (3)
したがって、サンプリングされたフレームシーケンスはVs = {F̃t0, …, F̃tN−1}となります。より高い時間的忠実度が求められる場合は、線形時間補間を行います。すなわち、式(4)に従って算出される任意の再サンプリングされた分数時間 τ ∈ [0, T−1] に対して補間を行います。
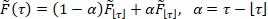 (4)
リサンプリングされたシーケンス Vs が正確に N フレームを持ち、滑らかな動きが維持されるようにします。あるいは、短い連続クリップによるサンプリング(時間ウィンドウ長 w、ストライド s)を行うことで、各クリップ Cj ∈ RT×H′×W′×C かつ j = 0, …, ⌊(T − w)/s⌋ となるクリップテンソルの集合が得られます。ネットワーク内部での時間的正規化には、マルチスケールでの単純な時間プーリングが有効です。マルチスケール畳み込みによって生成された時間特徴シーケンス X = {x1, …, xN} が与えられたとき、式(5)のようにプーリングされた特徴を適用します。
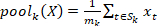 (5)
ここで、Skはスケールkに対する時間的サポート(例:Skは重複しないブロックまたは拡張されたインデックス)であり、mk = |Sk|である。
特徴抽出に先立ち、すべてのビデオは24 × 24ピクセルにリサイズされ、25 frames per secondでサンプリングされました。すべての実験において、シーケンス長は32 framesで固定しました。データ拡張の手法として、ランダムクロッピング(scale = 0.8–1.0)、ランダム回転(±15°)、ランダム水平反転(probability = 0.5)、および輝度調整(±20%)を採用しました。ピクセル値の標準化には、ImageNetの平均値 [0.485, 0.456, 0.406] および標準偏差 [0.29, 0.224, 0.25] を使用しました。時間的サンプリングには、すべてのビデオシーケンスに対して均等なフレーム選択を用いました。32 frames以上の長いビデオは、一定のシーケンス長を維持するために均等にトリミングまたはサンプリングし、32 frames未満のビデオにはゼロパディングを適用しました。これらの設定は、トレーニングおよび評価を通じて一貫して使用されました。
4. MSCNNを用いた特徴抽出
スポーツビデオにおけるアクションの空間的表現を向上させるため、マルチスケール畳み込みニューラルネットワーク(MSCNN)を採用しました。単一のカーネルサイズに依存する従来の畳み込みニューラルネットワークでは、複数の空間スケールで特徴を捉える能力に限界がある場合があります。一部のスポーツアクションは視覚的に類似した特性を示すため、単一スケールの畳み込みアーキテクチャで局所的特徴と大域的特徴を同時に捉えることは困難な場合があります。この制限に対処するため、提案するフレームワークでは、異なるサイズの畳み込みカーネルを利用してマルチスケールな特徴抽出および特徴融合を行います。
提案されたネットワークアーキテクチャでは、チャネル間の情報を整理し、入力特徴マップの次元数を削減するために1 × 1畳み込みカーネルが使用されました。さらに、これらの層は、追加の特徴変換と非線形表現を導入することで、ネットワークの表現能力を高めています。異なるサイズの畳み込みカーネルにより、複数のスケールでの空間情報の抽出が可能になります。また、学習の安定性を向上させるため、重み付きマルチスケール特徴融合の後に逐次正規化が行われます。深いネットワークの学習における勾配消失および勾配爆発の問題を軽減するため、提案されたアーキテクチャでは、残留接続とLSTMベースの時間的モデリングが採用されています。
マルチスケール設計により、異なる空間解像度で特徴を捉えるネットワーク能力が強化され、特徴表現能力が向上します。さらに、従来のN × N畳み込みカーネルは、N × 1および1 × Nの畳み込み操作に分解されます。MSCNNモジュールで採用されているN × 1および1 × Nの畳み込みは、個々のビデオフレームから相補的な方向性およびマルチスケールの空間特徴を捉えるように設計されています。これらの畳み込み操作は、異なる受容野スケールでパターンを抽出することにより、空間的な特徴表現を強化します。続いて、連続するフレーム間の時間的関係がLSTMモジュールによってモデル化され、MSCNNで抽出された特徴のシーケンスを処理することで、動作認識のための長期的な時間依存性を学習します。
各スポーツビデオ V = {F1, F2, …, FT} は、T 枚のフレームに分解されます。例えば、選手のポーズ、モーションブラー、ボールの軌跡などの空間的変動をエンコードするために、カーネルサイズ 3 × 3、5 × 5、7 × 7 に対応する 3 つの異なるスケール s ∈ {1, 2, 3} の畳み込みブランチを動作させます。各ブランチは、式 (6) のように特徴マップを抽出します。
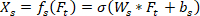 (6)
ここで、Wsおよびbsはスケールsにおける畳み込み重みとバイアスであり、σはReLU活性化関数です。マルチスケール融合層は、式(7)のように特徴量を集約します:
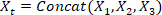 (7)
この融合特徴テンソルには、微細な動きの手がかりと、グループ活動などの広範囲なコンテキスト情報の両方が埋め込まれています。図 3 では、MSCNN 特徴抽出モジュールのみを示しています。時間的モデリングおよび分類に使用される LSTM 層(256 個の隠れユニット)、全結合層(128 個のニューロン)、およびドロップアウト層(0.5)は、図 4 に個別に示されています。
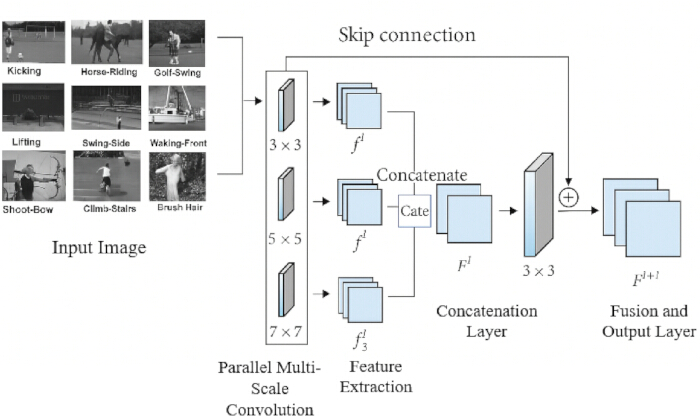
図3提案するマルチスケール畳み込みニューラルネットワーク(MSCNN)特徴抽出モジュール。 カーネルサイズが3 × 3、5 × 5、および7 × 7である3つの並列畳み込みブランチが、相補的なマルチスケール空間特徴を抽出し、これらはLSTMネットワークによる時間的モデリングの前に融合される。 この図の拡大版を表示するには、ここをクリックしてください。
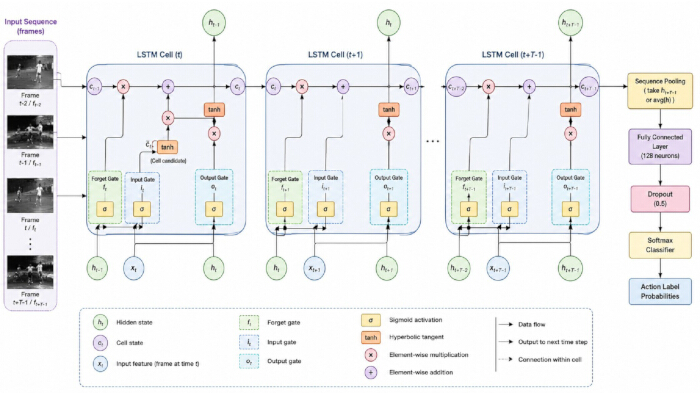
図 4スポーツビデオのアクション認識に向けた提案LSTMアーキテクチャ。 LSTMモジュールは、連続するビデオフレームにわたる入力ゲート、忘却ゲート、および出力ゲートの操作を通じて、時間的依存性をモデル化します。 この図の拡大版を表示するには、ここをクリックしてください。
図3 スポーツビデオのアクション認識のために提案されたマルチスケール畳み込みニューラルネットワーク(MSCNN)特徴抽出モジュールを示す。入力ビデオフレームは、3 × 3、5 × 5、7 × 7のカーネルサイズを持つ3つの畳み込みブランチを介して並列に処理され、各ブランチに64個のフィルタを配置することで、相補的な細粒度および粗粒度の空間特徴を抽出する。出力はバッチ正規化、ReLU活性化、および2 × 2のマックスプーリングを用いて精緻化された後、連結され、128個のフィルタを持つ1 × 1の畳み込みによって融合される。残差スキップ接続により、低レベルの空間情報が保持され、勾配フローが改善される。融合された特徴マップは平坦化され、時間的モデリングのために256個の隠れユニットを持つLSTM層に送られ、続いて128個のニューロンを持つ全結合層、ReLU活性化、および0.5のドロップアウト率を経て、Softmax層による最終的な分類が行われる。マルチスケール特徴マップ(f1申し訳ございませんが、翻訳対象となるソーステキストが提供されておりません。翻訳が必要な英文をご提示ください。, f2l、および f3l)を連結し、融合表現(F申し訳ございませんが、翻訳対象のソーステキストが提供されておりません。翻訳が必要な英文をご提示ください。)、さらに3 × 3の畳み込みによって精緻化され、後続層のための出力特徴マップを生成した。この階層的アーキテクチャにより、複数の受容野において相補的な空間特徴を学習することが可能となり、スポーツアクション認識の性能が向上した。
5. LSTMを用いた時系列モデリング
ビデオエッジにおける時間ベースの推移をモデル化するために、集約された特徴シーケンスをLSTMシステムに提供し、動的な依存関係と動作の連続性を捉えました。まず、各入力ビデオについて、フレームごとのマルチスケールCNN特徴を抽出しました。ビデオフレームをI1、…、ITとします。各フレームtおよび各スケールsに対して、マルチスケール畳み込みエンコーダーは特徴ベクトルft(s) ∈ Rdを生成します。次に、式(8)に示すように、射影+連結または加重和のいずれかによって、各スケールを単一のフレーム記述子に統合します。
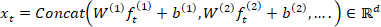 (8)
次に、時間動態をモデル化するために、シーケンス {xt}tT=1をLSTMに入力します。標準的なLSTMの表記法では、時刻 t におけるゲートと状態は式 (9) から (13) に示されます:
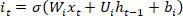 (9)
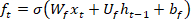 (10)
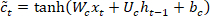 (11)
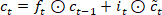 (12)
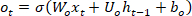 (13)
ここでσはシグモイド活性化関数、⊙は要素ごとの積を表します。双方向LSTMアーキテクチャを用いて過去と未来の両方の時間的コンテキストを捉えることも可能ですが、提案されたフレームワークでは、連続するビデオフレーム間の時間的依存性をモデル化するために標準的なLSTMを採用しています。この設計上の選択は、本研究で提示するMSCNN-LSTMアーキテクチャと整合しています。クリップの処理後、クリップ表現(例:最終隠れ状態または時間的プーリング)が取得されました:z = Poolt(vt)。
図 4は、スポーツ動作認識のために提案されたLSTMアーキテクチャのワークフローを示しています。ネットワークはビデオフレームまたはCNNで抽出された特徴のシーケンスを受信し、それを連続するタイムステップ(t−2、t−1、およびt)にわたって処理します。各LSTMセルは、ネットワーク内の情報フローを制御する入力ゲート、忘却ゲート、および出力ゲートで構成されています。入力ゲートは新しい情報をセル状態に組み込み、忘却ゲートは不要な時間情報を破棄し、出力ゲートは次のタイムステップに伝播される隠れ状態を生成します。セル状態は長期的な時間依存性を保持し、隠れ状態は短期的な時間情報を捉えます。逐次処理の後、LSTMの出力がプーリングされて時間的特徴表現が生成され、それが全結合層とSoftmax分類器に渡されて、対応するスポーツ動作が予測されます。ネットワークは、Adamオプティマイザーを用い、バッチサイズ32、初期学習率0.01、交差エントロピー損失関数を使用して10エポックの間トレーニングされました。最終的な評価には、検証損失が最も低いモデルが選択されました。再現性を確保するため、すべての実験は固定ランダムシード42を使用して行われました。収束を改善するために、早期停止とプラトーでの学習率低減が採用され、LSTMのトレーニング中は勾配爆発を防ぐためにしきい値5.0の勾配クリッピングが適用されました。提案されたMSCNN-LSTMモデルには、約1,50万個の学習可能パラメータが含まれています。
最終的なクラススコアおよび確率は、式(14)にあるように、線形層とsoftmaxを用いて算出されます:
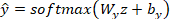 (14)
式(15)に従い、ラベル付きクリップに対するクロスエントロピー損失を最小化することで学習を行います:
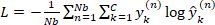 (15)
ここで、Nbはバッチサイズ、Cはクラス数、y(n)はワンホット形式の正解ラベルである。正則化(xtまたはLSTM出力へのドロップアウト、ウェイトディケイ)を適用する。また、長いスポーツシーケンスにおける安定性を高めるために、勾配クリッピングを適用している。
結果
提案したMSCNN-LSTMモデルは、多様なスポーツアクション、視点、および動作パターンを含むUCF1(YouTube Actions)、UCF Sports、およびJHMDBデータセットを用いて学習および評価が行われました。クラス分布は十分に均衡していたため、追加のクラス重み付けやリサンプリング手順は適用しませんでした。比較モデルは、元の研究で報告されたハイパーパラメータを用いて実装し、可能な限り学習設定を統一しました。結果は、異なるランダム初期化による5回の独立した試行の平均値 ± 標準偏差として報告しました。提案モデルと比較モデルとの差は、有意水準 p < 0.05 で対応のある t 検定を用いて評価しました。
図 5は、3つのデータセットにおける分類精度の比較である。MSCNN-LSTMモデルが最高の精度を達成し、UCF1で98.3%、UCF Sportsで95.4%、JHMDBで81.7%に達した。これらの値は、Dilated CNN–BiLSTM、Two-Stream LSTM、およびViT-ReTモデルによって得られた値を上回った。JHMDBにおける精度の低下は、低解像度のビデオにおいてきめ細やかな動作を認識することの困難さがより大きいことを反映している。
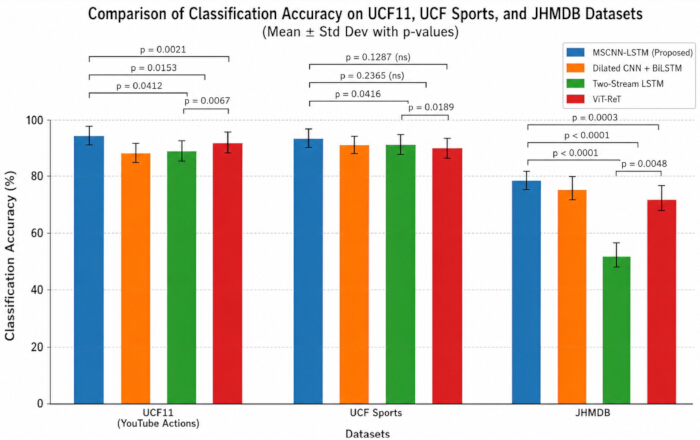
図5スポーツビデオデータセットにおける異なるディープラーニングモデルの分類精度(%)の比較。 UCF1、UCF Sports、およびJHMDBデータセットにおけるMSCNN-LSTM、ViT-ReT、Two-Stream LSTM、およびDilated CNN + BiLSTMの分類精度。結果は5回の独立した試行(n = 5)の平均値 ± 標準偏差として報告されている。エラーバーは1標準偏差を示す。統計的有意性は、両側対応のある t-試験(p < 0.05). この図の拡大版を表示するには、ここをクリックしてください。
提案されたモデルは、すべてのデータセットにおいて最高の適合率を達成し、UCF1で約96%、UCF Sportsで93%、JHMDBで78%の値を示した(図 6)。再現率はそれぞれ約95%、94%、7%であり(図 7)、対応するF1スコアは約95.5%、93.5%、7.5%であった(図 8)。これらの結果は、本モデルがアクションクラスの正確な識別と偽陽性予測の抑制との間で、良好なバランスを維持していることを示した。
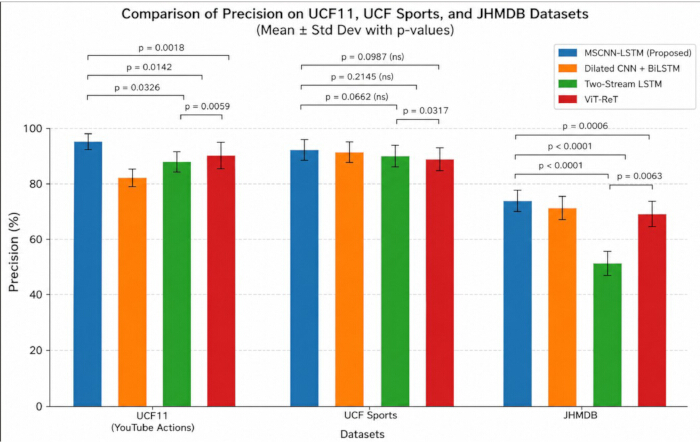
図6スポーツビデオデータセットにおける異なるディープラーニングモデルの適合率(%)の比較。 精度値は、5回の独立した試行(n = 5)における平均値 ± 標準偏差(SD)として報告している。エラーバーは1標準偏差を示す。統計的有意性は、両側対応のある t-試験 (p < 0.05). こちらの図の拡大版を表示するには、ここをクリックしてください。
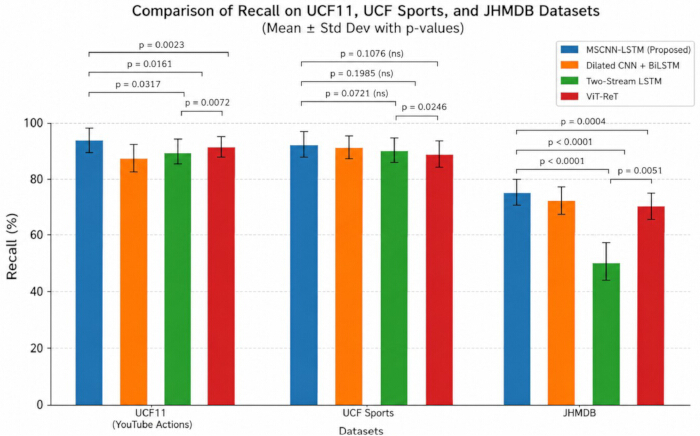
図7スポーツビデオデータセットにおける異なるディープラーニングモデルの再現率(%)の比較。 回収率は5回の独立した試行(n = 5)の平均値 ± 標準偏差(SD)として報告している。エラーバーは1標準偏差を表す。統計的有意性は、両側対応のあるt検定を用いて評価した。 t-試験(p < 0.05). こちらの図の拡大版を表示するには、ここをクリックしてください。
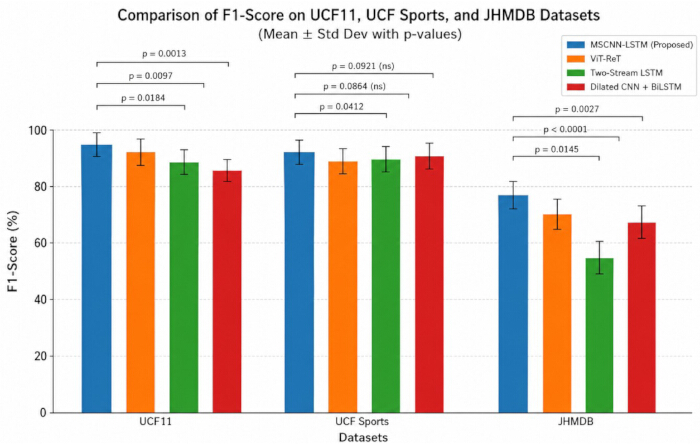
図8スポーツビデオデータセットにおける異なるディープラーニングモデルのF1スコア(%)の比較。 F1スコアは、5回の独立した試行(n = 5)の平均値±標準偏差(SD)として報告している。エラーバーは1標準偏差を表す。統計的有意性は、両側対応のある t-試験(p < 0.05). こちらの図の拡大版を表示するには、ここをクリックしてください。
表5に、Cohenのカッパ係数およびMatthews相関係数の結果を示す。UCF1において、提案モデルはκ = 0.96、MCC = 0.96を達成し、ViT-ReTのκ/MCC値(0.92/0.92)、Two-Stream LSTM(0.90/0.90)、およびDilated CNN–BiLSTM(0.87/0.87)を上回った。UCF Sportsにおいて、MSCNN-LSTMはκ = 0.95、MCC = 0.94を達成し、ViT-ReT(0.90/0.90)、Two-Stream LSTM(0.8/0.89)、およびDilated CNN–BiLSTM(0.84/0.85)によって得られた対応する値を上回った。JHMDBにおいて、提案モデルはκ = 0.83、MCC = 0.84を達成し、ViT-ReTの0.74/0.75、Two-Stream LSTMの0.70/0.71、およびDilated CNN–BiLSTMの0.71/0.72と比較して高い値を示した。これらの結果は、提案モデルにおいて予測ラベルと正解ラベルの間でより強い一致が見られたことを示している。
| モデル | データセット | コーエンのカッパ係数 (κ) | マシューズ相関係数 (MCC) |
| Dilated CNN + BiLSTM [4] | UCF1 (YouTube Actions) | 0.87 ± 0.01 | 0.8 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Two-Stream LSTM [38] | UCF1 (YouTube Actions) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.8 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF1 (YouTube Actions) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| 提案する MSCNN–LSTM | UCF1 (YouTube Actions) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
表 5: 異なるディープラーニングモデル間におけるCohenのkappa (κ) およびMatthews相関係数 (MCC) の比較。UCF1、UCF Sports、およびJHMDBデータセットにおけるMSCNN-LSTM、ViT-ReT、Two-Stream LSTM、およびDilated CNN + BiLSTMの性能比較。値が高いほど、予測ラベルと正解ラベルの一致度が高く、分類の信頼性が高いことを示す。値は5回の独立した実行 (n = 5) による平均値 ± 標準偏差 (SD) として報告されている。
図 9 に受信者動作特性曲線を示します。提案した MSCNN-LSTM は、UCF1 で 0.975、UCF Sports で 0.961、JHMDB で 0.937 の AUC 値を達成しました。一貫して高い AUC 値が得られたことは、複雑さの異なるデータセット間において、アクションクラス間の強力な識別能を有していることを示しています。
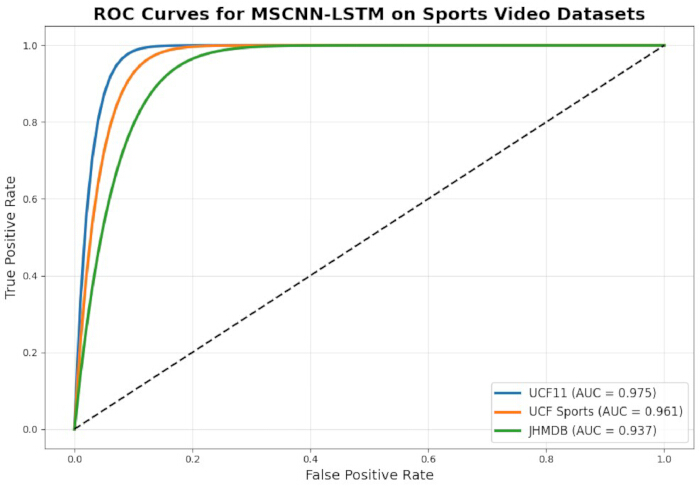
図9提案されたMSCNN-LSTMモデルの受信者動作特性(ROC)曲線。 UCF1、UCF Sports、およびJHMDBデータセットのROC曲線であり、真陽性率と偽陽性率のトレードオフを示している。曲線下の面積(AUC)は、分類しきい値全体におけるモデルの識別性能を要約したものである。 この図の拡大版を表示するには、ここをクリックしてください。
時間的パフォーマンスの結果を表6にまとめる。UCF1において、提案モデルはmAP-T 98.3%、フレームレベル精度 96.5%、TSI 0.95を達成した。UCF Sportsにおける対応する値は、それぞれ95.4%、94.0%、0.93であった。JHMDBにおいて、本モデルはmAP-T 81.7%、フレームレベル精度 78.9%、TSI 0.8を達成した(表7)。これらの値は比較モデルによって得られた値よりも高く、短期間および長期間の両方のアクションシーケンスにわたって、時間的な一貫性と予測の安定性が向上したことを示した。
| 方法 | データセット | mAP-T (%) | フレームレベル精度 (%) | 時間的安定性指標 (TSI) |
| 拡張CNN + BiLSTM4 | UCF1 (YouTubeアクション) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCFスポーツ | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| 2ストリームLSTM38 | UCF1 (YouTube アクション) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCFスポーツ | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF1 (YouTube アクション) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCFスポーツ | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF1 (YouTube アクション) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCFスポーツ | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
表 6: スポーツビデオのアクション認識における時間的パフォーマンス指標の比較。ベンチマークデータセットにおける、異なるディープラーニングモデルのTemporal Segmentsにおける平均適合率(mAP-T)、フレームレベルの精度、および時間的安定性指数(TSI)の実験結果。数値は5回の独立した試行(n = 5)の平均値 ± 標準偏差(SD)として報告されている。
| 構成 | マルチスケール畳み込みニューラルネットワーク (MSCNN) | 長短期記憶 (LSTM) | 正確度 (%) | F1スコア (%) | mAP-T (%) |
| CNNのみのベースライン | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| MSCNNのみ | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| 提案されたMSCNN-LSTM | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
表7:提案するMSCNN-LSTMフレームワークのアブレーション研究。同一のトレーニングおよび評価設定におけるMSCNNおよびLSTMコンポーネントの性能への寄与。値は5回の独立した試行(n = 5)の平均値 ± 標準偏差(SD)として報告されている。
図10、図1、図12は、それぞれUCF1、UCF Sports、およびJHMDBの行正規化済み混同行列を示している。3つの行列すべてにおいて明確な対角優位性が認められ、ほとんどのアクションクラスが正しく識別されたことが示された。対角線以外で発生した限定的な誤識別は、主に視覚的または動作的特性が類似しているアクション間で起こった。JHMDBの行列では、より困難なデータセットであるため、観察された定量的なパフォーマンスの低下と一致して、クラス間の混同が比較的大きく現れた。
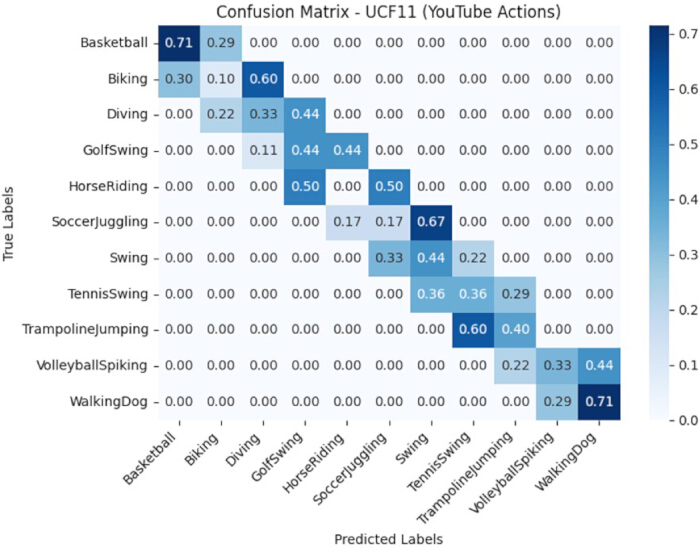
図10UCF1データセットにおける、提案するMSCNN-LSTMモデルの行正規化混同行列。 各行は1に正規化されており、対角成分は全体の分類精度(別途報告)ではなく、クラスごとの再現率を表している。 こちらの図の拡大版を表示するには、ここをクリックしてください。
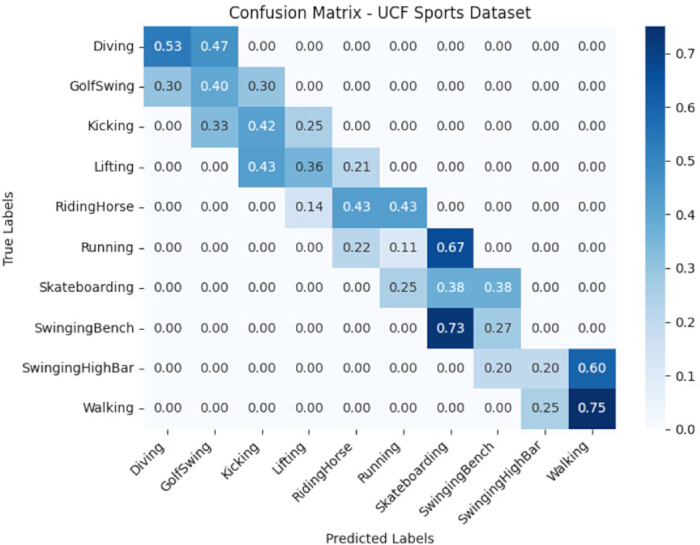
図1UCF Sportsデータセットにおける提案MSCNN-LSTMモデルの行正規化混同行列。 各行は1に正規化されており、対角成分は全体の分類精度ではなくクラスごとの再現率を表している。なお、全体の分類精度については別途報告している。 この図の拡大版を表示するには、ここをクリックしてください。
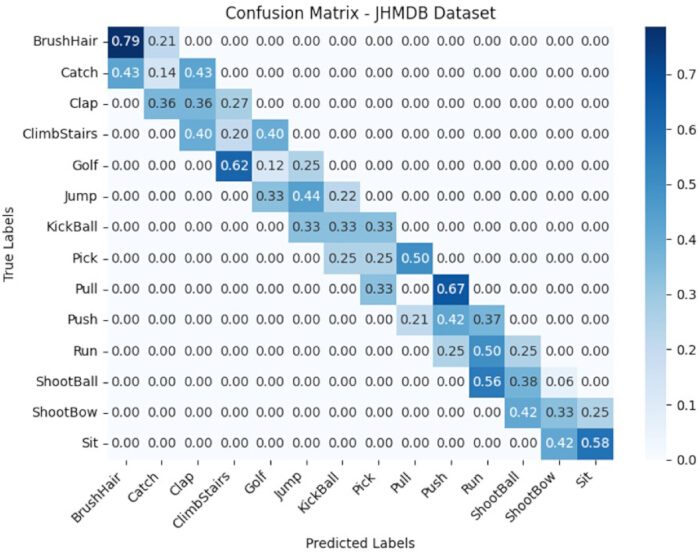
図12JHMDBデータセットにおける提案MSC-NN-LSTMモデルの行正規化混同行列。 各行は1に正規化されており、対角成分は全体の分類精度ではなくクラスごとの再現率を表している。なお、全体の分類精度は別途報告されている。 この図の拡大版を表示するには、ここをクリックしてください。
全体として、提案されたMSCNN-LSTMフレームワークは、分類、一致度、識別能、および時間的安定性の指標において、評価した比較モデルを一貫して上回りました。この結果は、マルチスケール空間特徴抽出とLSTMベースの時間的モデリングを組み合わせることで、動作の複雑さ、画像品質、および視点条件が異なるデータセット全体において、スポーツアクション認識が向上するという仮説を裏付けるものでした。
データの利用可能性:
本研究で分析したデータセットは、以下のソースから公開されています:UCF11 (YouTube Actions) データセット (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) および UCF Sports データセット (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php)。本研究の再現性を確保するため、実験に使用した前処理パイプライン、データセットの分割(訓練/検証/テスト分割の生成)、実装ファイル、設定ファイル、および補足ドキュメントは Zenodo リポジトリに保存されており、https://doi.org/10.5281/zenodo.21020947 で公開されています。
ディスカッション
提案されたMSCNN-LSTMフレームワークは、UCF11、UCF Sports、およびJHMDBのベンチマークデータセットにおいて、評価した他のアプローチを一貫して上回る性能を示しました。Dilated CNN-BiLSTM、Vision Transformerアーキテクチャ、および3D CNNに基づく従来の手法は、効果的な時空間特徴学習を実証していますが、高い計算複雑性、膨大な学習要件、あるいはきめ細やかな動作パターンの表現不足といった制限がある可能性があります23,24,25。対照的に、提案したフレームワークは、マルチスケールの空間特徴抽出とLSTMベースの時間的モデリングを統合しており、局所的な動作の詳細と長距離の時間的依存性の両方を捉えることが可能です。この統合により、複雑なスポーツ動作の認識が改善され、クラス間の混同が軽減し、特に難易度の高いJHMDBデータセットにおいて時間的一貫性が向上しました。これらの知見は、提案したフレームワークが、評価したCNN、再帰型、およびTransformerベースのアプローチと比較して、空間情報と時間情報のバランスが取れた表現を提供したことを示しています。
理論的観点から、MSCNN-LSTMフレームワークは、マルチスケール特徴融合と系列的な時間学習への統一的なアプローチを提供した36,37。階層的受容野を利用することで、異なるスケールでの空間情報の抽出が可能になり、一方でLSTMが連続するビデオフレーム間の依存性をモデル化した。この設計は、時間的なモデリングを行う前に局所的およびコンテキスト的な空間情報を保持することで、従来のCNN-LSTMパイプラインを拡張したものである。多様なアクションクラス、動作パターン、およびカメラ視点を含むデータセット全体で一貫した性能が得られたことは、提案したアーキテクチャの堅牢性をさらに裏付ける結果となった。
実用的な観点から、本フレームワークは、自動スポーツ分析、アスリートのパフォーマンス評価、イベント検出、およびスポーツビデオの理解において有用である可能性を示しました。しかし、導入前に、実際の運用条件下でのさらなる検証が必要です。本アーキテクチャは高い認識性能を達成しましたが、リソース制約のあるデバイスやクラウドベースの分析プラットフォームへの適合性については、計算コスト、推論時間、メモリ要件、および消費電力をさらに評価して確認する必要があります。
アブレーション研究により、MSCNNとLSTMの各コンポーネントが相補的に寄与していることが示されました。MSCNNは、複数の受容野スケールで表現を学習することで空間的な特徴抽出を改善し、一方でLSTMは、連続するフレーム間の動作依存性を捉えることで時間的なモデリングを強化しました。完全なMSCNN-LSTM構成において最高の性能が達成されたことは、マルチスケールの空間的特徴抽出と時間的シーケンスモデリングが共同して、行動認識の向上が得られたことに寄与したことを示しています。
全体として、提案されたMSCNN-LSTMフレームワークは、スポーツビデオの動作認識において、空間的および時間的な表現学習を効果的に組み合わせました。UCF11、UCF Sports、およびJHMDBデータセットを用いた評価では、評価対象となった他のディープラーニング手法と比較して性能の向上が示されました。これらの結果は、マルチスケール畳み込み特徴をLSTMベースの時間的モデリングと統合することで、複雑なスポーツ動作の認識精度が向上するという仮説を支持するものでした。それにもかかわらず、汎用性と実世界への適用性を確立するためには、より大規模で多様な、あるいはクロスドメインのデータセットによる検証が必要です。
いくつかの限界を考慮する必要がある。第一に、評価は公開されているベンチマークデータセットに限定されており、現実世界のスポーツ環境の多様性と複雑さを完全に代表しているとは限らない。第二に、固定されたトレーニング、検証、およびテスト用のパーティションが使用されたが、データセットのバイアスや意図しないデータリークを完全に排除することはできなかった。第三に、報告された性能は、データセットの構成、モデルの初期化、前処理の手順、およびトレーニング設定によって変動する可能性がある。さらに、マルチスケール畳み込みおよび時間的モデリングコンポーネントにより計算要件が増加しており、リソースが制限されたデバイスへの展開に影響を及ぼす可能性がある。また、本フレームワークは外部データセットやリアルタイムの運用シナリオを用いて評価されていない。
Transformerベースのビデオモデルは、大規模な行動認識データセットにおいて高い性能を示していますが、多くの場合、膨大な計算リソースと広範な訓練データを必要とします。提案されたMSCNN-LSTMフレームワークは、マルチスケールの空間的特徴抽出と回帰的な時間的モデリングを組み合わせることで、代替的なアプローチを提供します。今後の課題として、データセットをまたいだ検証、リアルタイム推論、計算の最適化、不確実性の推定、および提案したマルチスケールCNN-LSTMフレームワークにTransformerベースのアテンションメカニズムを統合したハイブリッドアーキテクチャについての検討が挙げられます38。
開示事項
著者は利益相反がないことを宣言します。
謝辞
本研究は、マレーシア国立大学(Universiti Kebangsaan Malaysia)情報科学技術学部の人工知能技術センター(CAIT)にて実施されました。著者は、提供された組織的支援および研究施設に深く感謝いたします。本研究は、公的機関、営利企業、または非営利の資金提供機関から特定の資金援助を受けていません。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | 深層学習モデルのトレーニングおよび推論に使用 |
| Intel Core i9 プロセッサ | Intel Corporation | 16-Core, 3.5 GHz | データの前処理および計算に使用 |
| システムメモリ | Generic | 64 GB DDR4 RAM | 大規模なビデオ処理をサポート |
| Python プログラミング言語 | Python Software Foundation | Version 3.8.18 | 実装に使用した主要なプログラミング言語 |
| TensorFlow | Version 2.15 | モデル開発に使用した深層学習フレームワーク | |
| オペレーティングシステム | Microsoft Corporation | Windows 11 | モデル開発および実験用 |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | モデルトレーニングの GPU 加速用 |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | 深層ニューラルネットワーク加速ライブラリ |
| OpenCV | Open Source | Version 4.8.1 | ビデオフレームの抽出および前処理用 |
| NumPy | Open Source | Version 1.24.4 | 数値計算および配列処理用 |
| Scikit-learn | Open Source | Version 1.3.2 | 性能評価および統計分析用 |
| Matplotlib | Open Source | Version 3.7.5 | 実験結果の可視化用 |
| UCF11 データセット | University of Central Florida | Public Dataset | スポーツ動作認識のベンチマークデータセット |
| UCF Sports データセット | University of Central Florida | Public Dataset | スポーツ動作認識のベンチマークデータセット |
| JHMDB データセット | Max Planck Institute for Informatics | Public Dataset | 人間の動作およびアクション認識のベンチマークデータセット |
参考文献
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543