本研究は、シフトウィンドウ階層型トランスフォーマーエンコーダで捕捉された階層的視覚特徴と、線分検出によって生成されるマンハッタン3Dバウンディングボックスの事前深度を密接に結合し、複雑な屋内シーンの高精度な意味再構築を実現するアルゴリズムを提案します。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
複雑な屋内シーンにおける家具の遮蔽による意味的予測の不連続性や物理的境界歪みに対処するため、本論文は建物構造の事前分布を活用した意味解析手法を提案します。このスキームは、シフトウィンドウ階層型トランスフォーマーエンコーダを用いてマルチスケールの視覚特徴を抽出し、勾配方向整合線分検出アルゴリズムを組み合わせてマンハッタン3Dバウンディングボックスを構築します。このバウンディングボックスは符号付き距離場(SDF)に変換され、離散的な幾何学的輪郭を連続物理ポテンシャル場に符号化します。構造誘導型クロスアテンション機構により、視覚信号が実際の3D直交幾何学的境界に整列し、遮蔽された領域で特徴の連続性を回復します。スーパーピクセルノードから構成された空間隣接グラフはグラフ畳み込みネットワーク(GCN)を駆動し、特徴を集約し、物理的な荷重を支える平面内での巨視的な意味的整合性を確保します。ピクセルレベルのクロスエントロピー損失とカスタム設計の構造的一貫性損失の組み合わせにより制約が強化され、境界外の予測にペナルティが加わります。複数の独立した実験では、結合上の平均交差(mIoU)が標準偏差0.2%で68.7%に達し、構造境界F1スコアは標準偏差0.3%で76.4%に達し、提案モジュールの堅実な性能を裏付けています。単一の画像ノードサイズが256の場合、平均推論時間は61msのままでした。
概要
屋内シーン画像意味解析は、三次元空間認知および知的空間推論課題において重要な位置を占めています。1,2。実際の物理的環境における視覚的特徴抽出は、複雑な空間レイアウトによって大きく妨げられることが多いです。3.大規模な家具の遮蔽による建物基礎構造の意味的不連続性と物理的境界歪みの解消は空間認知研究において重要です。雑多な物体からの干渉を正確に除去し、同じ壁と床の物理的な連続性を回復することは、三次元シーン再構築とグローバル空間論理解析の精度を直接決定します。大規模な家具閉塞による意味的不連続性と提案された建物事前指導の構造修復効果は図1に示されており、表1Aの遮蔽された赤緑青(RGB)入力、図1Bのベースラインマスク歪み、図1Cの構造事前修理結果が同じ屋内シーン条件下で比較されています。
空間論理推論の精度要件を満たすために、現在の主流のピクセル駆動型視覚ネットワークは複雑な屋内環境を扱う際に多くの障害に直面しています。屋内空間はしばしば密度の高い家具や散らかった家具で満たされており、画像における低レベルの視覚的境界信号の著しい喪失を引き起こしています。従来の特徴抽出メカニズムは局所的な二次元の色やテクスチャ応答に過度に依存しており、三次元人工構造の剛直交法則のマクロな理解が欠けています。局所受容野のこの制限により特徴伝播が容易に中断され、閉塞11を越えてグローバルトポロジーを拡張することが困難になります。現在、オクルージョンや干渉によって引き起こされる意味的予測の不連続性と物理的境界の深刻な歪みという根本的な問題を解決することが緊急に求められています。
閉塞や干渉による建物基礎の構造的欠陥に対処するため、学術コミュニティはさまざまな的を絞った介入措置を開発しました。クロスモーダル特徴集約ネットワークは、赤・緑・青(RGB)画像の解析を支援するために、空間知覚における単一の視覚モダリティの本質的な欠点を効果的に補うために、深度マップやテキストプリアーを導入します14,15。境界知覚と適応的コンテキスト選択フレームワークは、特徴デコード段階に物理的な輪郭強化戦略を注入し、複雑なシーンにおける予測結果のエッジフィットを大幅に向上させます。GCNと特徴相互作用メカニズムに基づく推論モデルは、ノードレベルの接続を構築することで、均質領域における特徴の滑らかさとマクロ意味論的一貫性を大幅に向上させます(18,19)。明示的なマンハッタン構造事前分布を視覚的特徴抽出パイプラインに統合することで、幾何学的一貫性境界が強制され、広範囲な前景オブジェクト遮蔽による特徴不連続性の課題に対処します。
建築インフラに伴う意味的予測の欠陥や物理的境界の深刻な歪みという根本的な課題に対処するため、アーキテクチャの事前処理を取り入れた閉ループ結合メカニズムに基づく意味解析フレームワークが提案されます。このフレームワークは、単純な工学的パイプラインを超え、連続した幾何学的ポテンシャル場と離散的な視覚的特徴多様体の間に双方向のマッピングアライメントを確立し、構造法則を通じて遮蔽誤差を修正する非自明な相乗効果を形成します。この方式は、マルチスケールの視覚バックボーンネットワークと消点推定に基づく線分検出アルゴリズムに依存し、マンハッタン3Dバウンディングボックスを並列で表現する局所的な外観特徴と直交辺の事前分布を取得し、それらをSDFに変換します。このアルゴリズムは構造誘導型クロスアテンション機構を採用しており、視覚的特徴をクエリベクトルとして用い、SDFの特徴をドット積計算のキーと値として扱うことで、視覚信号を特徴空間内の実際の3D幾何学的境界と一致させます。スーパーピクセルノードと空間共平面の辺特徴から構成された空間隣接グラフがGCNに入力され、ノード間の特徴集約とメッセージ伝達が行われます。エンドツーエンドのパラメータ最適化プロセスは、ピクセルレベルのクロスエントロピーとカスタム構造的整合性損失関数を共同で用いており、これは建築前境界を越える予測ピクセルを厳密に制約しペナルティします。完全なセマンティック解析パイプラインは 図2にまとめられており、RGB画像入力、幾何学的事前抽出、クロスアテンションアライメント、スーパーピクセルグラフ推論、セマンティックマスクデコードを統一アーキテクチャ内で結びつけています。
初期のシーン解析ネットワークは局所的な外観テクスチャを捉えるために畳み込み操作に依存していましたが、局所受容野の制限により、大規模ターゲット21,22の意味的整合性が不十分でした。これまでの研究では、ビジュアルトランスフォーマーアーキテクチャの自己注意モジュールを応用し、グローバルな文脈情報を抽出し、長距離ピクセル関連特徴を構築しています。クロスモーダルマルチビュー特徴集約戦略は、深さマップ点群とテキストコマンド入力を融合させてシーンの三次元幾何学的空間特徴を抽出します。特定のドメインを標的とした特徴融合のためのハイブリッド注意機構は徐々に成熟しています。特徴相互作用ブリッジを構築することで、多スケールの視覚信号伝送におけるエネルギー損失と特徴の疎度を大幅に低減し、複素構造解析の堅牢性を向上させました。最先端のエンコーダ設計は、グローバルおよび局所的特徴と共に高周波領域の空間詳細を統合・推論することで、高い類似度を持つ細かな意味カテゴリを識別するネットワークの能力を強化し、屋内解析の精度を向上させます(27,28)。セマンティックセグメンテーションアーキテクチャの最近の進展は、計算効率と空間知覚の最適化に貴重な参考資料を提供しています。高密度予測および多スケール文脈集約用に設計されたモデルは、複雑な背景から細かい幾何学的特徴を抽出します。特徴デカップリングおよび相乗融合戦略は、境界領域における意味的な曖昧さに対応します。軽量な注意メカニズムとゲート付き集約モジュールはパラメータ分布を最適化し、局所的な構造詳細を保持しつつ推論を加速させます。これらの効率的なアーキテクチャ設計の実装は、屋内シーン解析における非ユークリッド位相的推論演算の計算オーバーヘッドを削減するための理論的指針を提供します。
建物構造事先解析と3Dレイアウト推定を用いて局所的な視覚解析誤差を修正します。これまでの研究では、屋内建物の直交および平行幾何学的特徴を推論制約として抽出し、屋内背景の混雑によるネットワーク予測バイアスを低減させています(30,31)。既存の手法では、線分検出アルゴリズムや画像アブレーションポイント解析技術を用いてマンハッタン3Dバウンディングボックスを生成し、部屋の物理的境界をマッピングし、基礎となる視覚的特徴の局所化を支援しています。境界認識モジュールとマルチスケールコンテキストの共同アーキテクチャは、高次元特徴デコードプロセスに事前の構造情報を暗黙的に埋め込み、ネットワークは実際の物理的輪郭に密接に一致するセマンティックマスクを出力させ、物体エッジのギザギザやぼやけを効果的に改善します33.境界増強特性を持つ半教師ありまたは弱監督型損失関数設計は広く検討されています。空間的位相規則に違反する独立したピクセル分類挙動を罰するために厳密な数学的公式に依拠し、勾配最適化の源から最終的なセグメンテーション結果の幾何学的な滑らかさと構造的完全性が保証されます。
いくつかの研究では、グラフニューラルネットワークを用いて視覚的特徴のクロスドメイン集約や高次元空間35における位相的関係の推論を行っています。スーパーピクセルセグメンテーションアルゴリズムは、色応答やテクスチャの特徴が似ている隣接ピクセルブロックを独立接続ノードに事前集約します。スーパーピクセルセグメンテーションアルゴリズムは、画像レベルでグラフ構造の計算冗長性を圧縮し、画像36の基本的な幾何学的位相を保持します。GCNは高次元ノード特徴ベクトルと空間的近接を表す隣接行列を基盤とし、空間領域37,38における物理的連結グラフに沿った多スケール視覚情報の効率的な方向伝送とインタラクティブな融合を駆動します。時間情報強化モジュールとハイブリッド多スケールスキップ接続機構の適用により、多層ディープメッセージパッシング39の過程で生成されるノード特徴の過度な平滑化や均質化を抑制します。マルチスケールグラフウェーブレット変換技術と疑似ラベル要素学習最適化戦略は、ノード特徴更新式の背景ノイズ対策メカニズムを最適化し、同じ意味属性を持つ特徴が複雑ネットワークトポロジー40で協調応答モードを維持できるようにします。グラフベースの推論メカニズムは、正則ピクセルグリッドを非ユークリッド位相空間にマッピングし、不規則な建物構造や内部要素の特徴集約計算を行います。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
ネットワークトレーニング前に、屋内RGBシーンデータセットとその意味論的注釈が作成されました。大規模な屋内3DデータセットおよびRGB-D屋内シーンデータセット(材料 表参照)は、それぞれの公式リポジトリから取得されました。家具の遮蔽、照明の変化、壁の境界の遮断、複雑な空間配置を含む屋内取得シーンは、ターゲット解析シナリオに合わせて保持されました。セマンティックラベルはインデックス付き単一チャネルPNG注釈マスクに変換され、すべてのRGB画像とセマンティックマスクは512ピクセル×512ピクセルにリサイズされました。トレーニング中にオンラインデータ増強が適用され、0.5の確率でランダムな水平反転、0.8から1.2のランダムな明るさのスケーリング、−10°から+10°のランダム回転で構造レイアウト分布を広げました。RGBチャンネルは平均値0.485、0.456、0.406、標準偏差0.229、0.224、0.225で正規化されました。大規模な屋内3Dベンチマークは、本研究で使用された公式リリース区分に従い、1201のトレーニングシーンと312の検証シーンをモデル開発および検証に含みました。RGB-Dの屋内シーンベンチマークは公式の評価プロトコルに従い、795枚のトレーニング画像と654枚のテスト画像を用いました。これら2つの公開ベンチマークに対しては、追加のパーセンテージに基づく分割は適用されませんでした。
シフトウィンドウ階層型トランスフォーマーの視覚バックボーンネットワーク(材料表参照)は、ムービングウィンドウトランスフォーマーエンコーダバックボーンとして初期化されました。パッチ埋め込みサイズは4×4ピクセルとして設定されました。4つの階層段の埋め込み寸法は128、256、512、1024に設定され、4段の変圧器ブロック数は2、2、18、2に設定されました。局所的な注意ウィンドウのサイズは7×7に設定され、注意の頭部数は4、8、16、32に設定されました。非線形連続活性化関数はすべての多層パーセプトロン層内で使用されました。空間的ダウンサンプリングは、各階層的ステージ後に2のストライドでパッチマージ処理によって実施されました。コアネットワークアーキテクチャと畳み込み推論モジュールのハイパーパラメータは表1にまとめられています。
その後、入力特徴マップに対してシフトウィンドウ自己注意特徴抽出が行われました。各特徴図は、空間寸法が7×7の重複しないローカルウィンドウに分割されていました。通常の窓の注意とシフトウィンドウの注意は、隣接するシフトウィンドウの変圧器ブロック間で交互に行われていました。サイクリックシフト距離は3ピクセルに設定され、各局所注意ウィンドウ内に相対位置バイアス符号化が適用されました。局所的な視覚的特徴は、マルチヘッドの自己注意によって集約され、階層的かつ多スケールの特徴表現が生成されました。
マンハッタン構造事前解析は屋内RGB画像から抽出されました。構造的なエッジセグメントは勾配方向整合性の線分検出アルゴリズムを用いて検出されました。支配的な構造方向は、消失点推定に基づくランダムサンプルコンセンサス(RANSAC)アルゴリズム(材料 表参照)によってクラスタリングされました。3つの互いに直交するマンハッタン方向を再構成し、マンハッタン3次元バウンディングボックス表現を生成しました。再構築された構造境界は、各ピクセルから最も近い境界線分までの最小ユークリッド距離を計算することでSDFマップに変換されました。
構造誘導型クロスアテンション特徴は、視覚的特徴とSDF事前指標が得られた後に生成されました。視覚的特徴多様体は、二重打点帽Rの線形変換行列Wの部分Q元を通じてクエリテンソルQに写し、二重打点帽Rの構成行列Wの部分Q元を形成行列 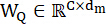 にマッピングしました。連続距離場の事前処理は、変換行列
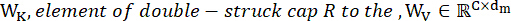 を通じてキーテンソルKと値テンソルVにマッピングされ、モデル次元は512に設定されました。マルチヘッド変調は射影空間を8つの独立した部分空間に分割し、各ヘッドの次元は64でした。空間配置は、離散ピクセル座標を連続ポテンシャル場に投影し、ドット積類似度行列を変調するための明示的な加法的空間バイアスとして構造親和行列Sを生成しました。視覚的特徴テンソルがクエリソースとして用いられたのは、意味解析では各視覚位置が幾何学的事前空間から構造的に一貫した証拠を積極的に取得する必要があるからです。SDFの事前データは、マンハッタンのレイアウトから派生した連続した境界距離と内外構造手がかりを保存するため、鍵および価値のソースとして使用されました。ドット積項は意味的な外観と幾何学的事前分布との互換性を測定し、加法的構造項λSは同じ物理面上または建築的輪郭に近いピクセルに注意の重みを移しました。係数λは抽出された構造事前比への信頼度を表し、剛直交制約が注意分布にどの程度組み込まれているかを制御しました。この定式化は家具の閉塞による境界を越えた特徴拡散を減らし、マンハッタン以外のレイアウトでも適応的緩和を保持しました。構造誘導型注意分布は式1に従って計算されました。
式1: 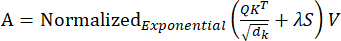
ここで、Aは構造誘導アシスタント集約行列、Qは視覚的特徴から生成されるクエリテンソル、KはSDF事前特徴から生成されるキーテンソル、Vは構造的事前表現から生成される値テンソル、dkはキーテンソルの特徴次元、λは局所領域の幾何学的信頼度を特定し、非マンハッタン空間における剛直交制約を緩和するために用いられる適応構造的重み付け係数を表します。レイアウト、SはSDF親和行列を示します。dkによる分割により注意ロギットのスケールが安定し、大きな特徴寸法が過剰に集中する注意重みを生み出すのを防ぎました。正規化指数関数(材料 表参照)は、変調された類似度スコアを正規化された空間分布に変換し、各ピクセルが意味的および幾何学的整合性に基づいて構造的な事前情報を集約できるようにしました。この設計は、視覚的外観と建築的境界の事前先が直接的な特徴の連結ではなく注意レベルで融合する理由を説明しています。
スーパーピクセルトポロジーグラフは、構造アライメントされた特徴マップから構築されました。特徴マップは空間領域生成アルゴリズムを用いてセグメント化されました。スーパーピクセル数は256、コンパクトネス係数は10、ガウス平滑係数は1.0、反復数は10に設定されました。クラスタリング時に距離指標の重みを特徴色空間距離に対して1.0の一定比率に設定することで空間的近接制約が適用され、密集したクラッター境界間で均一なノード生成を維持しました。均質な意味応答を持つピクセルはスーパーピクセルノードに集約されました。グラフの辺は空間隣接関係、SDF親和性強度、共平面幾何学的整合性制約に基づいて構築されました。構造親和行列と位相的結合性の構築過程は 図3に示されており、SDFガイダンスがどのようにグラフレベルの空間関係へと変換されたかを示しています。
このグラフの定式化は、密なピクセル単位の推論を均質な構造領域上のノードごとの空間的推論に変換するために導入されました。各スーパーピクセルノードは類似した意味応答と空間的連続性を持つ局所領域を表し、各辺は隣接性、距離-場親和性、共平面整合性制約に従う特徴伝送の信頼できる経路を表していました。この設計により、孤立したノイズの多いピクセルの影響を減らし、閉塞された壁、床、天井の領域が物理的に隣接するノードからのメッセージを受け取ることを可能にしました。したがって、エッジ構成は連続SDFガイダンスと離散非ユークリッドグラフ推論との間の数学的な架け橋として機能しました。
3層グラフ畳み込み推論ネットワークは、隠れた特徴寸法が512、256、128に設定されました。グラフ畳み込み層はノードの空間的関係に基づいてグラフ構造に特徴の平滑化を行いました。自己ループ隣接はメッセージパッシング時に各ノードの元の状態を保持し、小さな構造領域の特徴が周囲の大きな領域によって消去されるのを防ぎました。対称正規化により、隣接行列要素はノード次数の逆平方根の積でスケーリングされ、高次数ノードと低次数ノードが伝播中に比較可能な数値大きさで寄与するようにしました。フィードフォワード伝搬は局所的空間集約を行い、各ノード状態が隣接する共平面クラスタから高次元特徴を吸収し、その後要素ごとの非線形整形関数を適用しました。この定式化により、グラフ畳み込み層は、無関係なオブジェクトの境界を無制限に平滑化するのではなく、物理的に意味のある屋内平面に沿った意味拡散を近似することになりました。グラフノードの特徴は式2に従って評価されました。
式2: 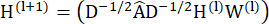
高密度ピクセル特徴からスーパーピクセルノードへの投影、グラフ畳み込みメッセージの通過、座標のバックプロジェクションは 図4に示されており、正則画像グリッドから非ユークリッドトポロジー、そして再び高密度セマンティック表現への特徴集約経路を明確にしています。 図4A の濃いピクセル特徴から 図4Bのスーパーピクセルノードへの投影、 図4Cのグラフ畳み込みメッセージの通過、 図4D の座標バックプロジェクションにより、通常の画像グリッドから非ユークリッド位相、そして再び濃密な意味的表現への特徴集約経路が明確になります。
ここで H(l) は l 番目のグラフ畳み込み層のノード特徴テンソル、Â は自己ループ接続を持つ隣接行列、D は隣接行列に対応する次数行列、W(l) は第lグラフ畳み込み層の学習可能な重み行列、σ は整正線形単位活性化関数を表します。ÂH(l)という用語は隣接するスーパーピクセルノードの特徴を集約し、D−1/2 およびD−1/2 は異なる接続密度を持つノードの寄与をバランスさせた。学習可能な行列W(l)は集約されたノードの特徴を新しい意味空間に投影し、グラフ層が構造的一貫性と通常の空間的近接性を区別できるようにしました。非線形活性化により、特徴集約後の同一面領域と非同一平面領域の応答差が保持されました。
意味分割の特徴はグラフ推論の後に解読されました。デコーダは3段階のバイリニア補間アップサンプリングとクロスレイヤースキップ接続融合操作を用いて構築されました。浅い空間エンコーダの特徴は、チャネルごとに融合することで高レベルの意味解碼機能と連結されました。特徴分解能は元の画像サイズに戻され、最終的な意味確率予測マップは1×1畳み込み層を通じて生成されました。
完全な意味解析ネットワークは、デカップリングされた重み減衰最適化器( Table of Materials参照)を用いて訓練されました。両方の公開ベンチマークで初期学習率は0.0001、重み減衰係数は0.01、バッチサイズは8に設定されました。第1モーメント減衰率は0.9、第2モーメント減衰率は0.999、数値安定性イプシロン係数は1×10⁻8に設定されました。検証損失は各エポックの終わりに監視され、検証セットのmIoUが増加した際にチェックポイントが保存されました。ネットワークは減衰検出力0.9の多項式学習率減衰戦略を用いて300エポックにわたり訓練されました。異なるランダムシード初期化を用いて5回の独立したトレーニングランを実施し、統計的に厳密な評価ベースラインを確立しました。ネットワークはピクセルレベルのクロスエントロピー損失と構造的整合性損失を用いて共同最適化されました。すべての実験は高容量並列計算ハードウェアを搭載したコンピューティングプラットフォーム上で行われ、詳細なハードウェア情報は 材料表に報告されました。
ジョイント最適化はクラス確率テンソルの空間的勾配の大きさを計算することで幾何学的境界整列を強制しました。構造的一貫性損失は正則化器として用いられ、空間予測勾配のノルムに連続SDF値を掛け合わせました。数学的な理論として、意味カテゴリの変更は実際の建築的輪郭付近に集中し、SDFがゼロに近づく一方で、平らな壁、床、天井の内部は滑らかな意味応答を維持するべきだというものでした。大きな予測勾配が構造境界から遠く離れた場合、距離場項はペナルティを増やし、均質な物理平面内での偽意味的遷移を抑制しました。予測勾配がゼロ距離等高線付近に現れた場合、ペナルティは限定的であり、建築的境界に沿った正当なクラス遷移を保持しました。意味遷移領域は、式3で示されるSDFの零距離輪郭に一致するように制約されていました。
式3: 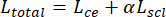
ここで、Ltotal は最終的な最適化目的関数、Lce はピクセルレベルの交差エントロピー損失、Lscl は構造的一貫性のペナルティ損失、αは構造的損失の重み付け係数を表します。クロスエントロピー項は注釈マスクを用いたピクセルレベルの意味的監督を提供し、構造的整合性項は建築的事前処理を用いた幾何学的正則化を課しました。重み付け係数はカテゴリ認識と境界整合のバランスα、局所ラベルの精度や剛性構造輪郭の過剰学習を防ぎます。この共同目標は、視覚的意味論、物理的境界の整合性、訓練可能なネットワークパラメータを統一された最適化ターゲットの中で結びつけました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
実験装置
本研究では、大規模な屋内3DデータセットとRGB-D屋内シーンデータセットという2つの標準的な屋内シーン解析データセットを用いて、性能評価とモデルのチューニングを行いました。大規模な屋内3Dデータセットは、リアルにスキャンされた複雑な物理空間シーンと高解像度RGBビューを含み、高精度でピクセル単位の3Dポイントクラウドセマンティックラベルや2D空間投影セグメンテーションマスクを提供します。その本質的に現実的な物理空間グリッド再構築データと直交平面特性は、抽出分岐におけるマンハッタン3Dバウンディングボックスを正確に構築するための幾何学的真理比較基準を確立しています。RGB-D屋内シーンデータセットは、家具や雑多なものに隠れた屋内奥行き画像を含み、ネットワークのグローバルな論理推論の正確さと遮蔽に対する堅牢性をテストするために使用されます。
このアルゴリズムはmIoUを用いて予測された意味分布と真の意味分布の空間的重な...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本論文のアルゴリズムは、シフトウィンドウ階層型トランスフォーマーエンコーダで捕捉される階層的視覚特徴と、線分検出によって生成されるマンハッタン3Dバウンディングボックスの事前深度を密接に結合し、複雑な屋内シーンの高精度な意味再構成を実現しています。構造誘導型クロスアテンション機構により、視覚信号がSDFによってキャリブレーションされた真の幾何学的境界に一致し、局所的に遮蔽された領域42の低層構造の連続性を回復します。トポロジーグラフは、反復的な局所クラスタリングアルゴリズムによって生成されたスーパーピクセルノードを用いて構築され、GCNが物理的な共平面制約の下で特徴集約を行うように駆動し、巨視的意味分布43の整合性を確保します。実験結果は、この手法がユニオン比の平均交差を68.7%、標準偏差0.2%、実用的な工学的価値、構造境界F1スコア76.4%、標準偏差0.3%、平均推論時間61msを達成していることを示しており、境界再構築の精度を最終的な推
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは、財政的な利益相反は一切ないと宣言しています。
謝辞
資金提供:陝西省重点研究開発プログラム(プログラム番号2024CY2-GJHX-76)。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
参考文献
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。