本プロトコルでは、臨床意思決定支援のために、FHIRベースの臨床データと検索拡張生成(RAG)およびマルチエージェント大規模言語モデルを統合した、相互運用可能なウェブプラットフォームの実装について説明します。このワークフローにより、再現可能なデプロイメント、標準化されたデータ統合、および人工知能(AI)支援による医療データ解析の評価が可能になります。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
研究記事
大規模言語モデルに基づいた医療データ分析のための相互運用可能なウェブプラットフォーム:臨床意思決定支援のためのプロトコル
この記事について
サマリー
要約
臨床的な意思決定は、断片化された電子健康記録や、不均一なヘルスケア情報システム間の限定的な相互運用性によって妨げられることが頻繁にあります。本記事では、Fast Healthcare Interoperability Resources (FHIR) 標準を介して臨床データを統合し、検索拡張生成 (RAG)、大規模言語モデル (LLMs)、およびマルチエージェント臨床推論フレームワークを組み合わせて、医療データ分析および臨床意思決定支援を実現する、相互運用可能なウェブプラットフォームを実装するためのステップバイステップのプロトコルを提示します。本プロトコルでは、計算環境の構成、臨床データセットの前処理、FHIRベースのデータ統合、ベクトルデータベースの構築、検索設定、プロンプトエンジニアリング、マルチエージェントのオーケストレーション、およびシステム評価を含む完全なワークフローについて説明します。代表的な結果は、不均一なデータソース間での意味的相互運用性を向上させつつ、臨床的に関連性があり文脈的に一貫した回答を生成する本プラットフォームの能力を示しています。システム性能は、BLEU、ROUGE、BERTScore、およびコサイン類似度を含む、相補的な定量的および意味的指標を用いて評価されました。提案された手法のワークフローの再現性を評価するために、公開されており完全に匿名化されたベンチマークヘルスケアデータセットを用いて定性的評価が行われました。提案されたアーキテクチャは、標準化されたヘルスケア相互運用性と検索強化言語モデルを組み合わせることで、文脈推論を改善し、ハルシネーションを低減させ、再現可能なAI支援臨床ワークフローを支援します。本プロトコルは、臨床意思決定支援、医療データ分析、および今後のトランスレーショナルリサーチに向けた、相互運用可能でプライバシーに配慮したインテリジェントなヘルスケアシステムの実装を目指す研究者および開発者に、拡張可能で再現可能なフレームワークを提供します。
概要
健康情報は、病院、診断センター、検査室、外来クリニックなどで日常的に生成されますが、多くの場合、不均一な情報システム間に分散したままとなっています。この断片化は相互運用性を制限し、包括的な患者記録へのタイムリーなアクセスを妨げており、臨床ケア、データ統合、およびヘルスケア管理における持続的な課題となっています1,2,3,4.
このような断片化による影響は、患者情報へのタイムリーなアクセスに依存する臨床ワークフローにおいて特に顕著になります。医療従事者が完全かつ統合された診療録を回収できない場合、臨床評価がより困難になり、不完全な意思決定のリスクが高まるとともに、特に救急現場におけるケア提供の効率が低下します5,6。
人工知能(AI)、特に大規模言語モデル(LLM)の最近の発展により、ヘルスケアアプリケーションで利用可能な計算アプローチの範囲が広がっています。これらのモデルは、診断支援、臨床的なトリアージ、意思決定支援などのタスクにおいて研究されてきました。例えば、Jahanら5はバイオメディカルタスクにおけるLLMの活用を評価し、Taylorら7はデジタルメンタルヘルススクリーニングのための微調整済みモデルを調査し、専門的な臨床現場において心強い結果を報告しています。
LLMの応用は、より専門的な臨床領域にも拡大しています。Songら49はじん肺の診断への活用を検討し、Chienら8はインフォーマルケアギバーのワークロードパターンの分析にこれらのモデルを適用しました。眼科分野では、Xueら9が緑内障診断のための質問応答システムを提案し、Tanら3 およびWuら10は、ハイブリッド診断システムや中医学のコンサルテーションにおけるLLMの利用について報告しています。
LLMの利用は直接的な臨床応用にとどまりません。Zhangら11は、メンタルヘルスのシナリオにおける感情認識への応用を調査し、一方でSarzaeimら12は、公衆衛生関連の分析にも寄与し得るインテリジェント警察システムについて検討しました。これらの研究は、ヘルスケアに関連するさまざまな領域において、LLMベースのアプローチが幅広く適用可能であることを示しています。
LLMはヘルスケアへの応用の可能性を広げたものの、臨床環境への統合には、依然として技術的、組織的、および規制上の重要な課題が伴います。実用的な導入には、適切な計算インフラストラクチャ、効果的なデータガバナンス、ならびに一般データ保護規則(GDPR)やブラジル一般データ保護法(LGPD)などの規制枠組みへの準拠が必要です。これらの枠組みは、AI支援ヘルスケアシステムにおけるプライバシー、信頼性、およびアルゴリズムのバイアスに関する問題に対処しつつ、機密性の高い健康情報の安全かつ倫理的な処理に関する要件を定めています13,14。
電子健康記録(EHR)、医療画像システム、モノのインターネット(IoT)デバイスを含む、不均質なヘルスケアデータソース間の相互運用性は、AI支援ヘルスケアソリューションを展開する上での大きな技術的課題であり続けています。このような背景から、HL7 FHIRのような標準化された相互運用性フレームワークは、意味的な一貫性を維持し、拡張可能な統合をサポートしながら、異なるシステム間で臨床情報を交換するための構造化されたメカニズムを提供します。
本研究では、異種混合の臨床環境における医療データ分析を支援するため、大規模言語モデル(LLM)とヘルスケア相互運用性標準を統合した、相互運用可能なウェブプラットフォームを提示します。提案するアーキテクチャは、HL7 FHIRベースのデータ統合、検索拡張生成(RAG)、およびマルチエージェント処理フレームワークを組み合わせることで、ブラジル一般データ保護法(LGPD)を含む適用可能なデータ保護要件への準拠を維持しつつ、コンテキストを考慮したAI支援分析を提供します。
本プロトコルでは、確立されたヘルスケア相互運用性標準を用いて、不均一な臨床データを統合するための相互運用可能なアーキテクチャについて記述します。また、大規模言語モデルおよび小規模言語モデル(LLMsおよびSLMs)に基づいたマルチエージェント処理パイプラインの実装について詳述し、あわせて、提案したプラットフォームの動作を評価するための定量的指標と定性的分析を組み合わせた評価フレームワークについて解説します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、ヒト参加者の募集、特定可能な患者記録へのアクセス、および動物を用いた実験は行われていません。プロトコルは、手法の妥当性確認のために、公開されており完全に匿名化されたデータセットのみを用いて開発および評価されました。個人の健康情報へのアクセスや処理は行われていません。したがって、機関審査委員会(IRB)または研究倫理委員会の承認は不要でした。本プロトコルは、将来的な臨床データの活用を想定し、ブラジル一般データ保護法(LGPD)を含む適用可能なデータ保護原則に準拠して開発されました。
データセットの選択と前処理
提案されたプロトコルは、手法の妥当性を検証するため、構造化された電子健康記録(EHR)、臨床的な質疑応答データ、および医療画像データセットで構成される、公開済みの完全に匿名化された臨床データセットを用いて評価されました。プラットフォームへの統合前に、データセットには、データの正規化、不整合または不完全なレコードの削除、HL7 FHIRリソースへのマッピング、テキストクリーニング、検索用チャンクへのセグメンテーション、およびベクトルインデックス作成のための埋め込み生成を含む、標準化された前処理手順が適用されました。これらの前処理ステップにより、異種データソース間での意味的な一貫性が確保され、適用可能なデータプライバシー原則への準拠を維持しつつ、相互運用性が促進され、提案されたワークフローの再現性が可能となりました。
データセットは、人工知能およびデジタルヘルスの研究で一般的に使用されている、公開ベンチマークリポジトリから取得しました。これらのデータセットは、構造化された電子健康記録(EHR)、非構造化された臨床ナラティブ、臨床的な質疑応答タスク、および医療画像のメタデータを含む、不均一な臨床情報を代表するように選択されました。特定の臨床コホートを評価するのではなく、本プロトコルでは、さまざまなヘルスケアデータセットに適応可能な、再現可能な実装ワークフローを実証することに焦点を当てています。これらのベンチマークデータセットの多様性により、相互運用性パイプライン、検索拡張生成(RAG)、およびマルチエージェント推論フレームワークを、複数の臨床データモダリティにわたって検証することが可能になります。
実験環境の構成
制御可能かつ再現可能な条件下で相互運用可能なプラットフォームを評価するため、実験環境を構成した。このアーキテクチャは、医療データ解析のための単一の処理パイプラインにまとめられたデータ取り込みモジュール、相互運用レイヤー、大規模言語モデル(LLM)、および評価コンポーネントで構成されている。図1に、臨床データの取り込みから診断結果の生成に至るまでの完全なワークフローを示す。
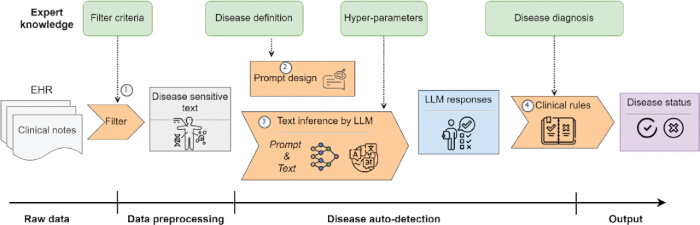
Figure 1: 生の臨床データから疾患状態の出力に至る処理パイプラインを示すシステム全体のワークフロー。 プロセスは電子健康記録(EHR)の取り込みから始まり、続いてデータフィルタリングと前処理を行い、疾患に関連する情報を抽出します。構造化プロンプト設計段階では、専門知識、疾患の定義、およびハイパーパラメータを統合し、大規模言語モデル(LLM)との効果的な対話を可能にします。LLMはテキスト推論を実行してコンテキストに応じた回答を生成し、その後、臨床ルールを通じて評価され、最終的な疾患状態が決定されます。このワークフローは、臨床的意思決定を支援するためのデータ前処理、知識駆動型プロンプティング、およびAIベースの推論の統合を強調しています。こちらのリンクをクリックして、この図の拡大版を表示してください。
ヘルスケア相互運用性アーキテクチャ
バックエンドのインフラストラクチャは、プラットフォーム構成要素間の通信をサポートするため、RESTful APIに基づいたモジュール式アーキテクチャを採用しています(図2)。このアーキテクチャは、構造化された電子健康記録(EHR)、医師のメモ、および医療画像システムから得られたメタデータを含む、不均一な臨床情報に対応しています。これらのデータは複数のソースおよびフォーマットに由来するため、標準化されたデータモデル、特にFast Healthcare Interoperability Resources(FHIR)フレームワークを通じて相互運用性を実現しています15,16,17。.FHIRの採用により、分散型ヘルスケア環境における拡張性と柔軟性を維持しながら、構造化された情報交換が可能になります。また、医療機関で広く利用され続けているレガシーな臨床システムとの統合を容易にするため、HL7ベースの通信メカニズムも組み込まれました16,17。
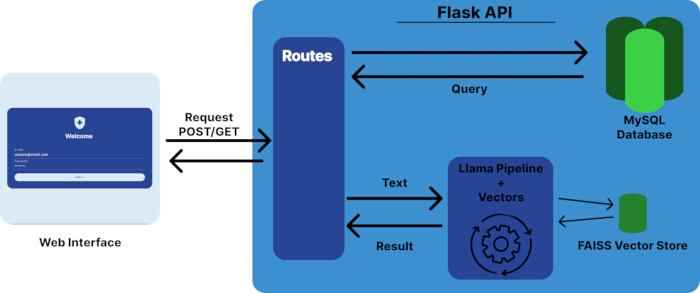
図2提案された相互運用可能なプラットフォームのシステムアーキテクチャウェブインターフェースは、HTTP POST/GETリクエストを用いたFlask APIを通じてバックエンドと通信します。APIは、ルーティング、クエリ処理、および構造化・非構造化データの双方のデータソースとの相互作用を管理します。構造化された臨床データはMySQLデータベースに保存され、検索操作のための類似性検索はFAISSベースのベクトルストアによってサポートされます。LLaMAベースのパイプラインは、テキスト入力を処理し、ベクトル表現を用いて回答を生成することで、検索拡張生成(RAG)を可能にします。このアーキテクチャは、ウェブサービス、データベース管理、ベクトル検索、および大規模言語モデルの推論を統合した単一のシステムであることを特徴としています。 この図の拡大版を表示するには、こちらをクリックしてください。
マルチエージェント・ワークフローの設定
マルチエージェントアーキテクチャは、ワークフローの異なる段階を担当する専門的な機能エージェントで構成されています。まず、前処理エージェントがデータの正規化とFHIRマッピングを行い、続いて検索エージェントがベクトルデータベース内でのセマンティック検索を担当します。推論エージェントは、取得したコンテキストをLLMと統合して回答を生成し、検証エージェントは、最終的な回答が返される前に出力の一貫性とフォーマットを確認します。エージェントの協調は逐次的なオーケストレーション戦略に従っており、各エージェントの出力が次の段階への入力となることで、再現性とモジュール性を備えた実装を実現しています。
臨床データの統合
データ統合レイヤーは、複数の臨床ソースから情報を集約し、ダウンストリーム処理に向けて準備します。前処理には、不均一なデータセット全体の意味的整合性を向上させるためのデータの正規化、トークナイゼーション、およびエンティティアライメントが含まれます。臨床情報は構造や品質が多様であるため、これらの操作によってノイズを低減し、AIモデルとの相互作用を容易にします。また、図315,16,17に示すように、異なるデータ形式を調和させ、処理パイプラインとの互換性を維持するために、構造化マッピング戦略が適用されました。
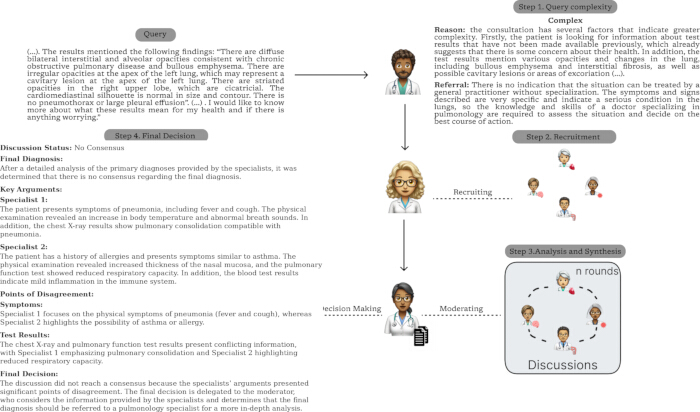
Figure 3: マルチエージェント臨床推論プロセスの詳細例. この図は、臨床クエリが複雑性の評価、専門家のリクルートメント、協調的議論、そして最終的な意思決定という複数の段階を経てどのように分析されるかを示している。このプロセスは、クエリの複雑性に基づいて推論戦略を動的に適応させるシステムの能力を実証しており、臨床意思決定支援シナリオにおける効率性と診断精度の両方を向上させる。 こちらのリンクから、この図の拡大版をご覧いただけます。
検索増強生成(Retrieval-Augmented Generation)パイプラインの設定
検索拡張生成(RAG)は、情報の検索と大規模言語モデルの生成能力を組み合わせることで、コンテキストを考慮した分析を提供するために組み込まれています。ユーザーのクエリは、エンべディングモデルを用いてベクトル表現に変換され、意味的な類似性検索を用いてベクトルデータベースと照合されることで、最も関連性の高いコンテキストの一節が検索されます。検索されたドキュメントは、LLMによる推論の前に元のクエリと結合されます。この戦略は、回答生成中にコンテキスト情報を提示するのに役立ち、ヘルスケアを含む知識集約型のアプリケーションにおいて、事実の一貫性の向上とハルシネーションの低減に関連していることが示されています18,19. 図 1 および 図 3 に、全体的な検索ワークフローと対応する推論プロセスを示します。
各ユーザーリクエストにおいて、最終的なプロンプトは、元のクエリとベクトルデータベースから取得された最も関連性の高いコンテキスト的に関連のある一節を組み合わせることで動的に構築されます。取得された情報は推論前のコンテキスト証拠として組み込まれ、これにより言語モデルは意味的な一貫性を維持し、根拠のない生成を抑制しながら、取得したヘルスケア知識に基づいた回答を生成することが可能になります。
プロンプトエンジニアリングとマルチエージェント推論
本プロトコルには、回答生成時におけるコンテキスト解釈を向上させるための構造化プロンプティング戦略が組み込まれている。これらのプロンプティング手法は、高度な推論メカニズムと相まって、複雑な臨床シナリオにおける推論プロセスを導く一助となり、近年の文献で報告されている進展とも整合している。20.
このアーキテクチャには、データ検証、コンテキストフィルタリング、臨床推論サポート、および出力検証など、処理パイプライン内で個別の機能を実行する特化モジュールで構成されるマルチエージェントフレームワークが含まれています。このモジュール化された構成により、タスクを逐次的または並列的に実行することができ、さまざまな処理要件に対する柔軟性が提供されます(図 4)。これらの活動を複数のエージェントに分散させることで、単一の言語モデルへの依存度が低減し、より堅牢な処理ワークフローがサポートされます。このアーキテクチャ戦略は、分散型人工知能およびインテリジェントシステム設計における最近の進展と一致しています21,22。
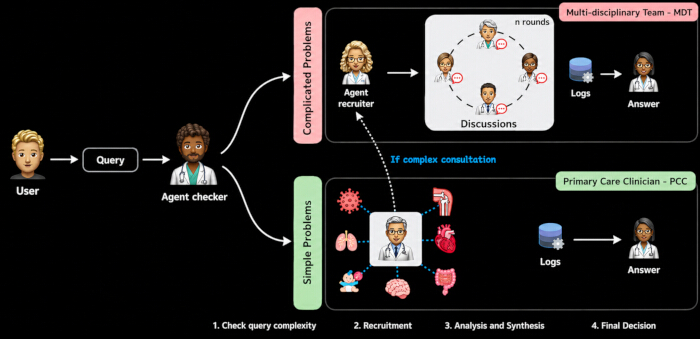
図 4: 臨床推論のためのマルチエージェント意思決定フレームワーク。プロセスはユーザーのクエリから始まり、クエリの複雑性を評価する責任を持つエージェントチェッカーによって評価されます。複雑なケースでは、システムが専門エージェントによる多職種チーム(MDT)を動的に招集し、反復的なディスカッションラウンドを通じて問題を分析し、知識を統合した上で最終的な決定を下します。より単純なケースでは、クエリはプライマリケア臨床医(PCC)エージェントによって処理され、より迅速な回答生成が可能になります。この適応型アーキテクチャは効率性と分析的深度のバランスを取り、ヘルスケアアプリケーションにおける意思決定の質とシステムの拡張性を向上させます。こちらのリンクをクリックして、この図の拡大版を表示してください。
性能評価
システムの性能評価は、生成された出力の言語的品質と意味的一貫性の両方を捉える相補的な指標を用いて行われました。n-gramの重複に基づく構文的類似性を測定するためにBLEUを適用し23、一方でROUGEを用いて、特に要約および情報抽出タスクにおける再現率とコンテンツのカバレッジを評価しました24。意味的類似性はBERTScoreで評価し、トランスフォーマーベースのモデルから得られるコンテキスト埋め込みを用いて、生成テキストと参照テキストを比較しました25。さらに、モデルの確信度を調べるためのパープレキシティと、意味的なコヒーレンスを調べるためのコサイン類似性の分析も併せて行いました26,27。
選択した評価指標は、語彙的分析と意味的分析を組み合わせることで、システム性能に関する相補的な視点を提供します。この組み合わせは、語彙的な類似性と同様に文脈的な解釈が重要となるヘルスケアアプリケーションにおいて特に有用です。本プラットフォームは、クラウドベースおよびローカル展開の両方をサポートする制御された計算環境で評価されました。機密性の高い臨床情報を処理する際に、データのプライバシー要件をサポートし、外部サービスへの依存度を低減させるため、LLMのローカル実行をオプションとして組み込みました。この展開戦略はデータ保護フレームワークと互換性があり、さまざまな運用環境に適応させることが可能です4.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
生成された出力の言語的な正確性と意味的な一貫性の両方を検討するため、定量的指標と定性的解析を併用してシステム性能を評価した。この評価戦略では、語彙的および意味的な尺度を組み合わせることで、ヘルスケア関連の言語生成タスクにおけるモデルの挙動をより広範に特徴付けている。
表1に、BLEU、ROUGE、およびBERTScoreを用いて得られた定量的な結果を示します。これらの指標は、語彙的な類似性、情報の網羅性、および意味的な整合性など、生成されたテキストの相補的な側面を評価するものであり、自然言語処理の研究において広く用いられているため選定しました。
| 判定モデル | プロンプト | ピアソン相関係数 | RMSE | MA... |
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究で提示された評価は、公開されており完全に匿名化されたヘルスケアベンチマークデータセットを用いて行われた手法的な検証である。本研究の目的は、臨床的な有効性ではなく、再現可能な実装プロトコルを実証することであるため、医療従事者の参加や患者の募集を伴う前向き臨床検証は実施していない。
本研究の結果は、ヘルスケア相互運用性標準と大規模言語モデルを組み合わせることで、不均一な臨床情報を統合するための実用的なフレームワークが提供されることを示唆している。提案されたアーキテクチャは、FHIRやHL7を含む構造化データ交換メカニズムとAIベースの言語処理を、現在のデジタルヘルスシステムの発展に合致した統一的なワークフローに統合するものである15,16,17。
提案されたワークフローの重要な側面は、マルチエージェントアーキテクチャ内への検索拡張生成(RA...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者らは、本原稿で報告された研究に影響を及ぼす可能性のある競合する金銭的利益や個人的な関係がないことを宣言します。生成人工知能(AI)ツールは、言語編集、文法修正、および原稿の可読性向上の支援のみに使用されました。すべての科学的内容、研究デザイン、手法、データ解析、結果の解釈、および編集上の決定は、著者らによって作成、検証、承認されており、著者らが本原稿の内容に全責任を負います。
謝辞
著者らは、本研究の開発を支えた研究環境および技術的な議論を提供してくださったセアラ連邦大学(UFC)の組み込み・分散システム研究室(LESC)に感謝いたします。また、本研究全体を通じて使用したオープンソースソフトウェア、相互運用性標準、および公開データセットの開発者および維持管理者の皆様に感謝申し上げます。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | バージョン 1.8.0 | 検索拡張生成(RAG)パイプラインにおける類似性検索に使用されるベクトルデータベース。 |
| FHIR標準 | HL7 International | リリース 4 (R4) | 構造化された臨床データ交換のために採用されたヘルスケア相互運用性標準。 |
| フラスコ | パレットプロジェクト | バージョン 3.0.3 | RESTfulバックエンドAPIを実装するために使用されたPythonウェブフレームワーク。 |
| HL7規格 | HL7 International | バージョン 2.x | 病院情報システムとの相互運用性のために使用されるレガシー・メッセージング・プロトコル。 |
| HTTP REST API | カスタム実装 | 該当なし | フロントエンド、バックエンド、データベース、およびAIサービス間のRESTful通信レイヤー。 |
| LangChain | LangChain Inc. | バージョン 0.3.x | LLM、プロンプトエンジニアリング、および検索拡張生成(Retrieval-Augmented Generation)のワークフローを統合するために使用されるフレームワーク。 |
| LangGraph | LangChain Inc. | バージョン 0.2.x | マルチエージェントによる臨床推論ワークフローをオーケストレーションするために使用されたフレームワーク。 |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | バージョン3.1 | 臨床推論および自然言語生成に用いられる大規模言語モデル。 |
| MySQL Community Server | Oracle Corporation | バージョン 8.0 | 構造化された臨床データを保存するために使用されるリレーショナルデータベース。 |
| Ollama | Ollama Inc. | バージョン 0.9.x | 患者のプライバシーを保護しながら大規模言語モデルを実行するために使用されるローカル推論エンジン。 |
| Python | Python Software Foundation | バージョン 3.11 | プラットフォーム全体の構築に使用したプログラミング言語。 |
| PyTorch | Linux Foundation | バージョン 2.4 | 大規模言語モデルの推論に使用されるディープラーニングフレームワーク。 |
| 検索拡張生成(RAG)パイプライン | カスタム実装 | 翻訳対象のテキストが提供されておりません。翻訳する英文をご提示ください。 | コンテキストに応じた応答生成のため、セマンティック検索とLLM推論を組み合わせたAIフレームワーク。 |
| センテンス・トランスフォーマー | Hugging Face Inc. | all-MiniLM-L6-v2 | 意味論的なドキュメント検索のための高密度ベクトル表現を生成するために使用される埋め込みモデル。 |
| Ubuntu Linux | Canonical Ltd. | バージョン 24.04 LTS | 開発および実験的評価に使用したオペレーティングシステム。 |
| Visual Studio Code | Microsoft Corporation | バージョン 1.100 | ソフトウェアの実装およびデバッグに使用される統合開発環境。 |
参考文献
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。