本プロトコルでは、意味的コンポーネント解析、トポロジーモデリング、デュアルストリーム特徴エンコーディング、および構造誘導融合を統合することで、構造を認識した衣服表現を生成します。これにより、コンピュータビジョンおよびアパレル研究者は、色やテクスチャではなく、コンポーネントの構成やシルエットのレイアウトに基づいた衣服の検索やデザインリファレンスの比較を行うことが可能になります。
この記事について
サマリー
要約
衣類の画像検索手法では、色やテクスチャが重視される傾向があり、外観が似ていても構成要素の配置が異なる衣類の間で混同が生じることがあります。本研究では、衣類画像検索およびデザイン参照比較のための、構成要素を考慮した特徴学習プロトコルを提案します。このプロトコルは、衣類の意味的な領域をパースして画像レベルの衣類構成要素グラフを構築し、外観と構成要素間の関係を並列にエンコードし、構造的一貫性、構造的関係、および構造的識別の各損失を用いて両方の表現を融合させます。DeepFashion2の画像を512 x 512ピクセルに標準化し、HRNet-W48でパースし、ResNet-50とグラフ畳み込みでエンコードした後、構造的な検索とクラスタリングを通じて評価を行いました。完全なモデルにより、構造的一貫性指標0.81、構造的識別指標0.71、Recall@5 89.2%、平均適合率(mAP)86.4%、およびシルエット係数0.74を達成しました。本プロトコルは、表面的な外観が衣類の構造を正確に表現していない場合に、衣類構造の検索、構造比較、および相違箇所の特定を可能にします。
概要
アパレル業界へのコンピュータビジョンと人工知能の統合が進むにつれ、衣類画像の解析は、基本的な認識タスクからデザイン重視の解析や意思決定支援へと徐々に拡大しています1,2。アパレルデザインのプロセスにおいて、デザイン案の区別は、単なる外見上の違いよりも構造的な構成や構成要素間の関係性に依存するため、デザイン支援におけるアパレル画像特徴量の構造的な表現力が、解析の有効性を左右する重要な要因となります3,4。しかし、既存の視覚的解析手法の多くは依然としてテクスチャ、色、およびグローバルな輪郭を主な特徴量として依拠しており、デザインプロセスにおける衣服の階層構造や構成の違いを体系的に解析することが困難です5,6。したがって、デザイン解析の客観性と一貫性を向上させるためには、アパレルデザイン支援に向けた構造認識型の画像特徴量学習手法を開発することが重要です7。本プロトコルは、衣服が類似した色、テクスチャ、またはグローバルな輪郭を共有しているが、構成要素の組織化、接続パターン、または空間的レイアウトが異なる場合に適しています。このような条件下では、外見中心の表現では構造的に異なるデザインが特徴空間上で近接して配置される傾向があり、検索やデザイン比較の信頼性が低下します。本プロトコルは、衣服構成要素間の関係性が構造的検索、デザイン評価、および局所的な差異解析の主要な根拠となるタスクに対処します。
データスケール、モデルの複雑さ、およびタスクの多様性の点において、衣類画像の自動解析および理解に関する現在の研究は著しい進歩を遂げています8,9。しかし、実際のアプリケーションでは、衣類の構造情報はセグメンテーションや検出の結果に暗黙的に含まれていることが多く、特徴学習段階の統合的なモデリングでは考慮されていません。その結果、特徴空間において異なる構造設計間の安定した区別が欠如しています10,11。衣類構成要素間の空間的関係、階層的制約、およびトポロジー構造が明示的にエンコードされていないため、特徴表現がデザインレベルでの構造的な差異を反映させることが困難となっています12,13。明示的な構造モデリングの欠如は、デザイン支援シナリオにおける衣類画像特徴の解析粒度と意思決定の信頼性を制限しており、より深い意味理解を備えたインテリジェント設計システムの開発にとって大きな障壁となっています14。
衣服の画像特徴学習および分析を支援するため、関連研究ではいくつかの技術的な方向性が探索されてきた15。セマンティックセグメンテーションやガーメントパース(衣服解析)の手法により、ピクセルレベルのアノテーションを通じて衣服の領域や構成要素の精緻な描写が可能となり、構造情報の抽出に向けた基盤が提供されている16,17。画像クエリによる衣服検索手法では、トポロジーと色・テクスチャの融合、グローバルおよびローカルのアテンションアライメント、ガーメントパース、マルチスケールおよびマルチグラニュラリティ表現、そして特徴選択を伴うレジデュアルアテンションなどが導入されてきた。これらの手法は、カタログ検索、消費者から店舗へのマッチング、クロスドメイン製品検索、および電子商取引における視覚検索を対象としている。各手法は視覚クエリに基づいて衣服画像をランキングするため、その適用設定はデザイン参照検索と密接に関連しているが、特徴融合の過程で型指定された構成要素の隣接関係や垂直方向の順序関係は保持されていない18,19,20。一方で、デザインやレコメンデーションのシナリオに関する研究では、マルチモーダル融合、関係モデリング、およびスタイル分析が徐々に導入され、衣服の視覚的特徴の適用範囲が拡大している21,22。これらの手法はそれぞれのタスクにおいて進展を見せているものの、その核心となる特徴は依然として大部分の外観記述に基づいており、構造情報が特徴学習のための本質的な制約として一様にモデル化されていない。そのため、構造的な整合や構造比較を必要とする衣服デザイン支援のニーズを満たすことは困難である23。
衣類デザイン支援における構造的差別化能力の不足に対処するため、本論文では衣類構造の知覚に基づく画像特徴学習手法を提案する。この手法は、衣類解析結果と主要な構造情報を衣類画像の入力段階に組み込み、衣類構成領域、空間関係、および階層的接続を共同でモデル化する。構造関係のエンコーディングと視覚的な特徴アライメントにより、衣類の制約を特徴学習プロセスに明示的に統合し、視覚的な外観と構造的な一貫性の両方を保持した表現を生成する。この特徴は、統一された空間内で衣類の構造的な差異を特徴づけ、その後の構造的類似性分析、構造的クラスタリング、およびデザイン支援の意思決定のための安定した基盤を提供し、これにより既存の手法における構造モデリングの欠如に起因する特徴の混同問題を軽減する。構造情報を緩やかに接続された補助属性として扱う一般的な視覚検索戦略とは異なり、本フレームワークはトポロジー関係を中心とした特徴変調メカニズムを構築している。このメカニズムは、学習された表現が可視的な衣類領域の構成に従うことを促進し、同時にテクスチャ主導の応答を低減させる。各グラフノードは画像レベルのセマンティック領域を表し、各グラフ関係は画像平面における可視的な隣接関係または正規化された相対位置を記述する。得られたエンべディングは、異なる衣類画像間での構成要素のレイアウトやシルエット構成の比較を可能にする。これらの領域および関係は、縫製パターンのピース、シーム接続、構築上のランドマーク、またはグレーディングパラメータではない。外観駆動型の検索手法と比較して、本プロトコルは構造情報をダウンストリームの解析結果として扱うのではなく、特徴学習を通じて明示的な構成要素のトポロジーを保持する。構造的な手がかりを補助的な入力としてのみ導入するアプローチと比較して、デュアルストリームエンコーディングとトポロジー一貫性のある融合により、テクスチャ主導の応答を抑えつつ幾何学的関係を保持する。結果として得られる表現は、衣類構造の検索、構造的クラスタリング、デザインリファレンスの選別、および局所的なデザイン差異分析をサポートし、同時に衣類デザインプロセスにおいて解釈可能な構成要素レベルのエビデンスを提供する。本プロトコルに関連する研究領域は、衣類画像の特徴学習、衣類構造のモデリング、構造認識表現、およびアパレルデザイン支援のための視覚分析にわたる。
特徴表現のレベルにおいて、衣類画像の研究は長らく外観モデリング、深層特徴抽出、およびマルチスケール表現に焦点を当ててきました24,25。初期の研究では、畳み込みニューラルネットワークを用いて、分類、検索、および類似性マッチングタスクのための衣類画像のエンドツーエンドモデリングが行われました26,27。その後、異なる視野角、ポーズ、および撮影条件による衣類画像間の差異を緩和するために、マルチスケール特徴融合およびクロスドメイン学習が導入されました28,29。検索タスクにおいては、特徴の識別能と計算効率を向上させるために、アテンションメカニズムと特徴圧縮戦略が用いられました30,31。これらの手法は信頼性の高い外観識別を実現していますが、その特徴学習プロセスは依然としてグローバルな視覚情報に重点を置いており、衣服内部の構造に関する体系的な表現に欠けています32。構成的ファッション検索手法は、参照画像とテキストによる修正指示をさらに組み合わせていますが、そのクエリモダリティは本研究で検討している画像のみのプロトコルとは異なります。これらは関連する商用検索の方向性としてレビューされますが、追加のテキスト入力があると制御された画像クエリ評価ができなくなるため、定量的比較には含まれていません。
衣服の画像解析が外見の識別から構造的な理解へと移行するにつれ、衣服の構成要素、幾何学的関係、およびトポロジカルな接続のモデリングに焦点を当てた研究が増えています33。セマンティックセグメンテーションネットワークは、特徴投影とマルチアテンションメカニズムを通じて、衣服の構成要素レベルの解析を実現しており、構造情報の抽出のための信頼性の高い基盤を提供しています34,35。キーポイント検出および構造トポロジーモデリングの手法は、衣服の外形と局所構造との関係をさらに特徴づけ、衣服の幾何学的特徴を表現するモデルの能力を向上させました36,37。いくつかの研究では、衣服構成要素間の関係をモデリングするためにグラフ構造と関係推論ネットワークが導入され、それによって詳細な認識とクロスドメイン検索の性能が向上しました38,39。これらの研究により、視覚的解析における構造情報の重要な役割が検証されましたが、構造は主に補助的な特徴または中間結果として利用されており、構造的制約を核とした特徴学習システムはまだ開発されていません40。
アパレルデザイン支援において、これらの進展はデザインの推奨、スタイル分析、インタラクティブシステムの構築、および構造指向のデザイン評価を支えてきました41。レコメンデーションシステムの研究では、視覚的特徴とユーザーの好みを統合することで、アパレルのマッチングやパーソナライズされた推奨を実現しています42。デザイン支援に関する研究では、生成モデル、スタイルモデリング、および人間とコンピュータの協調メカニズムを組み合わせることで、インテリジェントなデザインサポートの新たな道を模索してきました43。バーチャル試着、サイズ測定、およびスタイル転送に関する研究は、デザインから生産プロセスに至るまで、アパレル視覚分析の適用範囲を広げました。これらの研究によってアパレルデザイン支援の技術的形態は豊かになりましたが、その核心となる視覚的特徴は依然として主に外観に依存しており、分析のためのデザイン構造の統一された表現が不足しています。対照的に、本論文では衣服の構造を特徴表現の核心的な制約として扱い、アパレルデザイン支援における構造分析のための視覚的表現手法を提示します。
このような進展があるにもかかわらず、近年のジェネレーティブデザインの手法では、構造的条件を拡散プロセス内での緩やかな空間ガイダンス行列として扱うことが多い。現代の構造解析フレームワークでは、トポロジーを主要な視覚的埋め込み空間とは別の補助的な意味論的ラベルとして表現している。提案するフレームワークは、コンポーネントレベルでの視覚的特徴学習を明示的に変調させる、グラフ事前分布に基づくトポロジー制約を定義することで、このメカニズムを変更する。マルチレベルの一貫性目的関数は、画像レベルでのコンポーネント配置が類似している衣服を特徴空間内で近接させ、一方で可視領域の構成が異なる衣服を分離させるように促す。この目的関数は、評価された検索設定におけるテクスチャへの依存性を低減させるが、素材、ポーズ、または背景の変化に対する不変性を確立するものではない。本プロトコルは、入力画像に十分に可視化された個別の衣服が含まれており、意味論的なコンポーネントが識別可能な境界を保持しており、かつ分析目的が粗いカテゴリー認識ではなくコンポーネントレベルの構造比較を必要とする場合に選択されるべきである。本手法は、構造に敏感な視覚分析に従事するコンピュータビジョン研究者、アパレルデザイン研究者、およびデジタル衣服開発チームを対象としている。色や素材の認識のみに焦点を当てたタスクや、衣服のトポロジーが大部分的に隠れている画像には適していない。以下のプロトコルでは、データセットの準備と意味論的確率マッピングから、幾何学的関係の構築、デュアルストリーム特徴エンコーディング、構造ガイド付き融合、および一貫性に基づく最適化までのワークフローを提示する。ワークフロー全体の概要はFigure 1にまとめられている。
プロトコル
本研究では、公開されている衣類画像データセットを使用しており、ヒト被験者の募集、個人情報の収集、動物実験、および生物学的材料の使用は行っていない。そのため、機関の倫理承認およびインフォームド・コンセントは適用されない。
1. ソフトウェア環境とプロジェクト設定
- リリースされたプロジェクトファイルを十分なストレージ容量があるディレクトリに配置し、プロジェクトのルートディレクトリでターミナルを開きます。
- conda env create -f environment.yml を実行してソフトウェア環境を作成します。conda activate garment_structure を実行して環境を有効化します。
- python --version、conda --version、pip show numpy、pip show torch、pip show torchvision、および nvidia-smi を実行します。コマンドの出力結果をすべて software_versions.txt に保存します。
- 前処理、トレーニング、推論、効率測定、および評価には、記録した同一の環境を使用してください。HRNet-W48 チェックポイントのファイル名と SHA-256 値、ImageNet 学習済み ResNet-50 重みの識別子と SHA-256 値、DeepFashion2 のリリースソース、およびソースコードリポジトリの識別子を同じファイルに記録します。
- プロジェクトルートディレクトリの下に、data_raw、data_processed、parser_outputs、structural_priors、feature_outputs、checkpoints、logs、および evaluation_results の各ディレクトリを作成します。
- configs/protocol.yaml を開きます。dataset_root に DeepFashion2 ディレクトリを、parser_checkpoint に学習済み HRNet-W48 チェックポイントのパスを、output_root にプロジェクト出力ディレクトリを入力します。
- input_height を 512、input_width を 512、batch_size を 32、structural_categories_per_batch を 8、samples_per_category を 4、random_seed を 42、feature_dimension を 512、structural_constraint_weight を 1.0、structural_relationship_weight を 0.5、structural_discrimination_weight を 1.0、および separation_threshold を 0.3 に設定します。
- オプティマイザをミニバッチ確率的勾配降下法に設定します。initial_learning_rate を 0.0001、momentum を 0.9、weight_decay を 0.0005、max_epochs を 120、learning_rate_schedule を multi-step decay、および learning_rate_decay_factor を 0.1 に設定します。リリースされた設定で使用されている検証済みの減衰エポックを learning_rate_milestones に入力します。
- python tools/export_experiment_tables.py --config configs/protocol.yaml --output evaluation_results を実行します。完全なモデル設定を model_setting_statistics.csv にエクスポートします。エクスポートされたファイルに、入力画像サイズ、入力フォーマット、バッチ構成、オプティマイザ、学習率、学習率スケジューラ、エポック数、重み減衰、モメンタム、オーグメンテーション確率、特徴量次元、構造損失重み、分離しきい値、乱数シード、チェックポイント選択ルール、および独立試行回数が記録されていることを確認してください。
- 期待される結果:ソフトウェア環境が依存関係のエラーなく起動し、software_versions.txt に環境記録が含まれ、すべての出力ディレクトリが存在し、configs/protocol.yaml に有効な絶対パスと数値設定が含まれていることを確認します。
注意:データ処理、モデルトレーニング、推論、および評価の間は、同一の環境と設定ファイルを使用してください。学習済みチェックポイントごとに configs/protocol.yaml のコピーを保存してください。
トラブルシューティング:パッケージが利用不可であるために環境作成が停止した場合は、不完全な環境を削除し、environment.yml のパッケージチャネルを確認して、環境を再作成してください。nvidia-smi が GPU を報告しない場合は、モデルトレーニングを停止し、グラフィックスドライバと CUDA ランタイムを復旧させてください。実行中にディレクトリエラーが表示された場合は、相対パスを絶対パスに置き換え、output_root の書き込み権限を確認してください。
2. 入力画像の受入、データセットの構築および前処理
- JPG、JPEG、またはPNG拡張子のファイルのみを使用してください。単一の主要な衣類を含む8ビットRGB画像を使用してください。
- 幅および高さが512ピクセル以上であり、識別可能な主衣類が1着含まれる8ビットRGB画像を保持する。衣類の前景が画像全体の面積の15%未満である場合、衣類マスクの境界の5%超が画像端と一致している場合、副次的な衣類領域が主衣類面積の10%を超える場合、推定遮蔽領域が主衣類マスクの20%を超える場合、またはラプラシアン応答の分散が100未満である場合は、その画像を除外する。
- excluded_samples.csvに、画像識別子、測定値、適用された除外ルール、およびアノテーションパスを記録してください。
- 構造的なラベル付けおよびデータ分割を行う前に、DeepFashion2のソース画像に入力許容ルールを適用する。受理および拒否されたすべての画像識別子、元のデータセット分割、衣服アノテーション識別子、ソースペア識別子、前景領域比率、境界接触比率、遮蔽比率、ぼけスコア、および最終的な保持ステータスをdata_filtering_manifest.csvに記録する。
- python tools/prepare_data.py --config configs/protocol.yaml を実行してください。
- データセットのアノテーションから衣類のバウンディングボックスを読み取ります。画像の境界を超えない範囲で、バウンディングボックスの幅と高さの5%分だけ領域を拡張します。
- 衣類領域をクロップし、元の縦横比を維持したままゼロパディングを加えて正方形の画像とし、パディング後の画像を512 x 512ピクセルにリサイズする。
- リサイズした画像を、浮動小数点数を持つRGBテンソルに変換します。各ピクセル値を255で除算します。
- 赤、緑、青の各チャンネルを、平均0.485、0.456、0.406、および標準偏差0.229、0.224、0.225で正規化します。
- 学習画像には、0.5の確率で水平反転を、0.2の確率でランダム消去を適用する。検証画像およびテスト画像には、決定論的なクロッピング、パディング、リサイズ、および正規化のみを適用する。
- 7チャンネルのコンポーネントマップならびに共有境界行列と垂直順序行列が生成された後、python tools/assign_structural_levels.py --config configs/protocol.yaml を実行する。保持されたすべての画像について、アクティブノード数、連結成分数、分岐ノード数、独立サイクル数、および最長の有向垂直順序パスを算出する。分岐ノードは、共有境界グラフにおいて少なくとも3つの他のアクティブノードと接続しているアクティブノードと定義する。
- グラフが連結しており、独立サイクルを含まず、分岐ノードを含まず、かつ垂直順序パスの最大長が2エッジ以下である場合はS1を割り当てる。グラフが連結しており、独立サイクルを含まず、分岐ノードをちょうど1つ含み、かつ垂直順序パスの最大長が2エッジ以下である場合はS2を割り当てる。グラフが連結しており、独立サイクルを含まず、かつ少なくとも2つの分岐ノードを含むか、または3エッジ以上の垂直順序パスを持つ場合はS3を割り当てる。グラフが連結しており、独立サイクルをちょうど1つ含み、かつ垂直順序パスの最大長が2エッジ以下である場合はS4を割り当てる。グラフが少なくとも2つの独立サイクルを含むか、または1つの独立サイクルと共に3エッジ以上の垂直順序パスを持つ場合はS5を割り当てる。
- S5、S4、S3、S2、S1の順でルールを適用し、算出されたグラフ統計量、割り当てられたレベル、およびルール識別子をstructural_level_manifest.csvに保存します。
- 保存されたコンポーネントマスクとリレーション行列から、予備的なS1–S5ラベルを自動的に生成する。コンポーネントグラフに複数の連結成分が含まれる場合、衣服前景内の最大コンポーネント確率の平均値が0.60未満である場合、アクティブなコンポーネントが衣服前景の1%未満を占める場合、または境界接触幅を1ピクセルから2ピクセルに変更した後に割り当てられた構造レベルが変化した場合に、そのサンプルを構造的に曖昧であるとマークする。
- 曖昧なサンプルはすべて2名の著者に提出し、ソース画像、コンポーネントマップ、共有境界行列、垂直順序行列、および予備グラフを独立して検査させる。2名の検査結果が一致した場合は、そのラベルを保持する。不一致が生じた場合は3人目の著者に提出し、多数決による決定を最終ラベルとする。レビュー後も安定したコンポーネント関係が回復しなかったサンプルは除外する。自動ラベル、レビューラベル、不一致の理由、最終ラベル、および除外ステータスをstructural_label_audit.csvに記録する。
- 保持されたすべてのソースファイルのSHA-256値を算出し、正規化された衣服のクロップ画像から64ビットの知覚ハッシュを算出する。SHA-256値が同一の画像は、同一の完全重複グループに配置する。知覚ハッシュのハミング距離が4以下の画像については、それらが同一の衣服個体に由来することを確認した後、同一の近似重複グループに配置する。
- 同じDeepFashion2ソースペア識別子または衣類識別子を共有するすべての画像を、一つのソースグループに統合してください。ファイルハッシュ、知覚ハッシュ、ソース識別子、および重複グループ識別子をduplicate_group_manifest.csvに保存してください。
- データ分割は、個々の画像レベルではなく、ソースグループレベルで実施してください。完全重複グループ、近似重複グループ、およびソース同一性グループは、すべて完全に一つのサブセットに割り当てます。分割後、すべてのサブセット間ペアを確認し、検出されたすべての同一性競合、ハッシュ競合、および知覚ハッシュ競合をleakage_audit.csvに書き出してください。leakage_audit.csvに未解決のサブセット間レコードが含まれなくなるまで、マニフェストの再構築を繰り返してください。
- ソースグループを最終的なS1~S5ラベルによって層別化し、検証済みの配分に従ってグループ全体をトレーニング、検証、およびテストのサブセットに割り当てます。 表1すべての構造レベルおよびサブセットについて、正確な画像数とソースグループ数を報告してください。
- フィルタリング前のデータセットではなく、最終的に保持されたコホートから、実際のトレーニング、検証、およびテストの割合を算出してください。パラメータ学習、しきい値決定、構造レベルのルール調整、またはチェックポイント選択の間は、検証画像、テスト画像、除外された曖昧な画像、または重複グループに属する画像を使用しないでください。
- 処理済みの画像をdata_processed/imagesに保存します。train_manifest.csv、validation_manifest.csv、test_manifest.csv、pair_manifest.csv、およびstructural_level_manifest.csvをdata_processed/manifestsに保存します。
- 処理済みマニフェストから、最終的な構造ラベル、レビューステータス、重複グループ識別子、ソースグループ識別子、およびサブセットラベルを読み取ります。S1からS5までの自動的に承認されたサンプル数、手動でレビューされたサンプル数、曖昧さによる除外数、重複による除外数、ソースグループ数、トレーニング画像数、バリデーション画像数、およびテスト画像数をカウントします。
- 実現したサブセット比、平均有効ノード数、平均分岐ノード数、平均独立サイクル数、平均垂直順序深度、および平均型付きエッジ数を算出してください。完全な統計データを evaluation_results/dataset_statistics.csv に保存してください。
- 期待される出力:承認されたすべての画像が、サイズ512 x 512ピクセルの8ビットRGB画像であり、1つのフィルタリング記録、1つの最終的な構造レベルラベル、1つのソースグループ識別子、1つの重複グループ識別子、1つのサブセットラベル、および1つの有効なアノテーションパスを持つことを確認してください。曖昧なサンプルすべてに完全なレビュー記録があることを確認してください。ソース識別子、完全重複グループ、近似重複グループ、または衣服の識別子が、複数のサブセットにわたって出現していないことを確認してください。train_manifest.csv、validation_manifest.csv、test_manifest.csv、およびdataset_statistics.csvにおける画像数が一致していることを確認してください。
注意:data_rawにある元の未処理画像を保存してください。検証用またはテスト用の画像にランダムな拡張を適用しないでください。
トラブルシューティング:クロッピングによって襟、袖、裾、またはズボンの裾が除去された場合は、元のアノテーションを復元し、保持する境界マージンを拡大してください。衣類が伸びているように見える場合は、リサイズ前に正方形のパディングが適用されているか確認してください。処理後の画像が1チャンネルまたは4チャンネルである場合は、ソースファイルを8ビットRGBに変換し、前処理を再実行してください。サブセット間で重複した識別子が発生した場合は、トレーニング前にすべてのサブセットマニフェストを再構築してください。
3. 前景制限視覚コンポーネントのパースおよび確率マッピング
- python tools/parse_components.py --config configs/protocol.yaml を実行する。
- parser_checkpoint から学習済みの HRNet-W48 衣類セマンティック解析チェックポイントをロードする。チェックポイントが、データセットのアノテーションマッピングで定義された衣類構成要素のカテゴリを出力することを確認する。セマンティック解析ネットワークを評価モードに切り替え、勾配計算を無効にする。
- train_manifest.csv、validation_manifest.csv、および test_manifest.csv から処理済み画像を順に読み込む。
- 各入力画像から7チャンネルのセマンティックレスポンステンソルを1つ抽出し、ワークフロー全体を通じて K を 7 に設定する。カテゴリ順序は、Upper Trim Region、Neckline Region、Bodice Region、Left Lower-Garment Region、Right Lower-Garment Region、Middle Lower-Garment Region、Hem Region の固定順とする。確率マップ、コンポーネント行列、グラフ行列、特徴行列、マニフェスト、および可視化ファイルにおいて、この順序を維持する。
- チャンネル方向に softmax を適用し、セマンティックコンポーネント確率マップ P を生成する。すべての K チャンネルにわたる確率の合計が、各ピクセルにおいて 0.0001 の許容誤差範囲内で 1 になることを確認する。
- データセットのアノテーションから衣類前景マスクをロードし、512 x 512 の処理済み画像に合わせる。衣類前景の外側にあるすべてのコンポーネントの確率を 0 に設定する。前景マスク内部のコンポーネント確率をチャンネル方向に沿って再正規化する。
- すべての活性コンポーネント領域が衣類前景の内部に留まっていることを確認する。色付けされたコンポーネント領域が周囲の壁、床、カーテン、またはその他の背景領域に及んでいる場合は、解析サンプルを棄却する。棄却された画像識別子と解析エラーを parsing_quality_log.csv に記録する。
- すべてのコンポーネントについて前景カバー率を算出し、断片化した領域やサポートされていない孤立領域を持つコンポーネントに目視検査用のマークを付ける。
- セマンティックレスポンステンソルを parser_outputs/logits に保存する。確率マップを parser_outputs/probability_maps に保存する。色分けされたコンポーネントプレビューを parser_outputs/previews に保存する。
- 期待される出力:承認された各画像が、空間サイズ 512 x 512 pixels の 7 チャンネル前景制限確率マップを1つ、7 チャンネルセマンティックレスポンステンソルを1つ、およびプレビュー画像を1つ生成することを確認する。チャンネルインデックス 1 から 7 が、ステップ 3.4 で定義された固定コンポーネント順序に従っていることを確認する。すべての色付けされたコンポーネント領域が衣類前景の内部に留まっており、背景ピクセルのコンポーネント確率が 0 であることを確認する。ファイル識別子がソースマニフェストの対応するエントリと一致することを確認する。
注意:構造モデリング中は、衣類前景内の連続的なコンポーネント確率を保持すること。得られた領域を視覚的解析領域として扱う。それらの境界を、縫い目、裁断線、パターンピースの輪郭、ダーツ、切り込み、またはグレーディング基準として解釈してはならない。
トラブルシューティング:すべてのチャンネルがほぼ均一な確率を示す場合は、parser_checkpoint、RGB チャンネル順序、および画像正規化を確認する。あるコンポーネントがサブセット全体で欠落している場合は、アノテーションインデックスと解析出力チャンネルインデックスを比較する。コンポーネントの色が背景に及んでいる場合は、グラフ構築前に前景マスクの整合性、補間設定、およびアノテーション座標を確認する。視覚的領域が複数の無関係な衣類領域にまたがっている場合は、そのサンプルを解析失敗としてマークし、構造的事前分布の生成から除外する。チャンネル確率の合計が 1 にならない場合は、空間方向ではなくチャンネル方向に softmax を適用する。出力ファイルが不足している場合は、解析ログで最終的に処理された識別子を特定し、次の識別子から解析を再開する。
4. 画像レベルのコンポーネント幾何学および空間関係のモデリング
- 各画像について、浅い視覚特徴テンソルと対応する確率マップPをロードする。
- すべての空間特徴ベクトルに、対応する意味的コンポーネントに割り当てられた確率を乗算する。
- 空間次元にわたって重み付き特徴ベクトルを合計し、その合計をコンポーネントの全確率質量で除算する。
- 確率質量がゼロのコンポーネントには、ゼロベクトルと非活性ノードインジケータを割り当てる。
- すべての活性コンポーネント埋め込みにL2正規化を適用し、固定された意味的コンポーネント順に従って埋め込みをスタックする。
- 前景制限付き確率分布から、各視覚コンポーネントの画像平面における水平および垂直の中心座標を算出する。座標を画像の幅と高さで正規化する。
- 同じ正規化座標系を用いて、各視覚コンポーネントの画像平面における水平および垂直の広がりを算出する。これらの値は、処理済み画像における可視領域の範囲を記述するためのみに使用する。
- 固定されたコンポーネント順に従って7つのグラフノードを作成し、非活性コンポーネントはゼロノードとして保持する。前景コンポーネントマスク間の8近傍接触を用いて、7 x 7の共有境界行列を構築する。Upper Trim RegionからNeckline Regionへ、Neckline RegionからBodice Regionへ、Bodice Regionから各下衣(lower-garment)領域へ、そして各下衣領域からHem Regionへという固定関係を用いて、7 x 7の垂直順序行列を構築する。すべての有効な関係を双方向に保存する。
- グラフ畳み込みの前に、すべての活性ノードにセルフループを追加し、非活性ノードに接続される関係はゼロのままにする。
- 意味的コンポーネントのすべての順序付けられたペアについて、相対的な中心変位と相対的な空間分散を算出する。ペアごとの幾何学的値をスタックして、幾何学的関係テンソルを形成する。
- 正規化されたコンポーネント埋め込みのすべてのペアについて、内積を算出する。得られた類似度行列に行方向のsoftmaxを適用し、その値を関係重みとして使用する。
- 幾何学的関係テンソルに corresponding な関係重みを乗算し、すべてのコンポーネントについて重み付き関係を集約する。
- コンポーネント埋め込み行列、コンポーネント中心行列、空間分散行列、共有境界行列、垂直順序行列、セルフループ行列、関係重み行列、非活性ノードマスク、コンポーネントラベルマッピング、および構造的事前表現をstructural_priorsに保存する。適用可能な場合は、すべての行列を7行7列で保存する。前景制限付きコンポーネントマップから画像レベルの衣服コンポーネント・トポロジー事前表現までの完全な構築プロセスをFigure 2に示す。
- 前景制限付き確率マップ、コンポーネント中心行列、型付き隣接行列、非活性ノードマスク、およびコンポーネントラベルマッピングから、各可視化サンプルのコンポーネントグラフオーバーレイを生成する。
- 各活性ノードを対応するコンポーネント中心に配置する。共有前景境界には実線を、定義済みの垂直順序関係には破線を引く。
- 各グラフオーバーレイを、ソース画像識別子を用いてstructural_priors/visualizationsに保存する。ソース画像パス、確率マップパス、コンポーネント中心パス、型付き隣接パス、非活性ノードマスクパス、意味解析チェックポイント識別子、およびグラフオーバーレイパスをcomponent_graph_visualization_manifest.csvに記録する。
- 期待される出力:すべての画像で、K行のコンポーネント埋め込み行列、K行K列の型付き隣接行列、K行K列の関係重み行列、K個の値を持つ非活性ノードマスク、および1つの画像レベル構造的事前表現が生成されていることを確認する。選択されたすべての可視化サンプルで、活性ノードが対応する衣服領域内に留まっているコンポーネントグラフオーバーレイが生成されていることを確認する。
注:すべての行列、マニフェスト、グラフ、特徴ファイル、およびグラフオーバーレイにおいて、同一の視覚コンポーネント順を維持すること。コンポーネント中心、空間的な広がり値、およびグラフ関係を、画像平面における衣服領域記述子として扱う。コンポーネントグラフを人間のポーズスケルトンとして解釈したり、そのノードを解剖学的な関節座標から導出したりしてはならない。これらの記述子を、縫い目の長さ、曲率半径、ダーツ分量、切り込み位置、目地の方向、グレーディング増分、またはパターンピース寸法に変換してはならない。
トラブルシューティング:行列に非数値が含まれている場合は、確率質量の分母と座標の正規化を点検すること。関係重みが1つのコンポーネントに集中している場合は、softmaxの前に類似度行列から行の最大値を差し引くこと。画像間でグラフノードの数が異なる場合は、非活性コンポーネントが削除されず、ゼロベクトルとして存在し続けているかを確認すること。
5. デュアルストリーム構造認識特徴エンコーディング
- ImageNetで事前学習済みのResNet-50の重みをロードし、最終的なプーリング層と分類層を削除します。
- 正規化された各衣類画像をResNet-50に通し、configs/protocol.yamlのappearance_stageで定義されたバックボーンステージから外観テンソルを抽出します。512 x 512ピクセルの入力画像に対して、選択したバックボーンステージによって生成されるステージ名、出力チャネル数、および出力空間次元を確認します。すべてのトレーニング、推論、アブレーション、および比較ランで同じステージを使用してください。
- バイリニア補間を用いて、セマンティック確率マップを外観特徴テンソルの空間サイズにリサイズします。外観特徴テンソルにリサイズ後の各コンポーネント確率マップを乗算し、その後、空間次元にわたって重み付き応答を集計します。
- すべてのコンポーネント外観エンベディングを、configs/protocol.yamlで定義されたチャネル再校正層に通します。層の種類、入力次元、出力次元、削減比、活性化関数、およびパラメータ共有ルールを記録します。得られた7つのコンポーネントベクトルを固定されたセマンティック順序でスタックし、外観特徴行列を形成します。
- すべての幾何学的関係ベクトルを構造投影層に通し、出力次元を512に設定します。関係重み行列と非活性ノードマスクを用いてコンポーネントグラフを構築します。
- 入力次元512、出力次元512のグラフ畳み込み層を2層適用します。各グラフ畳み込み層の後にバッチ正規化を適用し、続いてLeakyReLUを適用します。LeakyReLUで使用した負の傾き(negative-slope)の値を記録します。各層の後に非活性ノードマスクを適用し、非活性コンポーネントの特徴量をゼロとして保持します。
- 正規化されたコンポーネントエンベディングを用いてセマンティックアライメントを適用し、得られたベクトルをスタックして構造特徴行列を形成します。
- 期待される出力:各画像から1つの外観特徴行列と1つの構造特徴行列が生成されることを確認します。両方の行列がK行512列であることを確認してください。
注:非活性コンポーネントはゼロベクトルとして保持し、構造的事前構築時に設定されたコンポーネント順序を維持してください。
トラブルシューティング:2つの特徴行列の行数が異なる場合は、セマンティックカテゴリのマッピングと非活性ノードの処理を確認してください。行列乗算で次元エラーが報告される場合は、構造投影の出力と外観チャネルの次元がいずれも512であることを確認してください。すべての活性コンポーネントで構造特徴がゼロのままである場合は、グラフエッジと関係重みが現在のバッチに追加されているか確認してください。
6. 構造ガイド付き特徴融合
- 図3に示す構造誘導型特徴融合シーケンスを適用します。構造特徴行列を融合重みレイヤーに通し、configs/protocol.yamlのfusion_activationで宣言された活性化関数を適用します。活性化関数の名前、入力次元、出力次元、および7つのコンポーネントノード間でパラメータが共有されているかどうかを記録します。
- 生成された構造重み行列がK行512列であることを確認します。
- 外観特徴行列に構造重み行列を要素ごとに乗算します。
- 変調された外観行列と構造特徴行列をチャネル次元に沿って結合します。
- 各コンポーネントについて、512次元の変調外観ベクトルと512次元の構造ベクトルを結合し、1024次元のベクトルを形成します。結合されたベクトルを融合投影レイヤーに通し、次元を1024から512に削減します。
- 残差接続を通じて、元の構造特徴行列を投影行列に加算します。
- 融合されたコンポーネントベクトルを固定された意味的順序でスタックし、平坦化された構造認識表現にL2正規化を適用します。
- 構造重み行列、変調外観行列、融合コンポーネント行列、および最終的な構造認識表現をfeature_outputsに保存します。
- 期待される出力:すべての画像から、K行512列の融合コンポーネント行列が1つと、ソース画像識別子にリンクされた正規化構造認識特徴ベクトルが1つ生成されることを確認します。
注:応答の可視化および局所的な差分分析のために、構造重み行列と融合コンポーネント行列を保持してください。
トラブルシューティング:融合値が増大し続ける場合は、活性化出力と正規化レイヤーを検査してください。すべての構造重みが同じ値に近づく場合は、構造特徴が画像間で変動しているか、および融合レイヤーが勾配を受け取っているかを確認してください。特徴ファイルと画像識別子が一致しない場合は、トレーニングまたは検索評価の前に出力マニフェストを再構築してください。
7. モデルのトレーニングと一貫性の最適化
- configs/seeds.yamlに記録されている5つのランダムシード値をロードします。各ランでは、Python、NumPy、PyTorch CPU操作、およびすべてのCUDAデバイスに対して同じランダムシードを設定します。決定論的アルゴリズムを有効にし、cuDNNベンチマークモードを無効にして、対応するランディレクトリに正確な5つのシード値を記録します。
- 処理済みのトレーニングマニフェスト、ペアマニフェスト、確率マップ、および構造的事前分布をロードします。
- 8つの構造カテゴリーと、各カテゴリーから外観が異なる4つのサンプルを用いて、すべてのトレーニングバッチを構成します。
- 同じ構造的事前分布を共有する正例サンプルペアから、構造的一貫性損失を計算します。
- コンポーネント特徴量間のペアワイズ距離から、構造的関係一貫性損失を計算します。
- 不均一な構造を持つ負例サンプルペアから構造的識別損失を計算し、0.3の分離しきい値を適用します。
- 外観目的関数、構造的一貫性目的関数、構造的関係目的関数、および構造的識別目的関数を、configs/protocol.yamlに保存されている重みで結合します。3つの構造的目的関数によって制御される特徴空間の最適化プロセスを図4に示します。
- python train.py --config configs/protocol.yamlを実行します。ステップ1.8で定義された初期学習率、モーメンタム、重み減衰、エポック数、減衰係数、および減衰エポックを用いて、ミニバッチ確率的勾配降下法によりすべての学習可能パラメータを更新します。トレーニングログにエポックごとの学習率を記録します。
- エポックごとに、総損失、外観損失、構造的一貫性損失、構造的関係損失、構造的識別損失、学習率、構造的一貫性指数(SCI)、構造的識別指数(SDI)、およびRecall@5を記録します。
- エポックごとにvalidation_manifest.csvでモデルを評価します。最高の検証SCIに関連付けられたチェックポイントをcheckpoints/selected_model.pthに保存します。
- 記録した5つのランダムシードを用いて、トレーニングを5回繰り返します。各設定ファイル、トレーニングログ、および選択されたチェックポイントを個別のランディレクトリに保存します。
- 期待される出力:各ランでトレーニングログ、検証ログ、エポックレベルのメトリックファイル、および1つの選択されたチェックポイントが生成されていることを確認します。選択されたチェックポイントが、テスト性能ではなく検証性能に基づいていることを確認してください。
注意:すべてのモデル比較およびアブレーション実験において、同一のトレーニング、検証、およびテストマニフェストを使用してください。
トラブルシューティング:損失が非数値(NaN)になった場合は、トレーニングを停止し、コンポーネントの確率質量を検査し、学習率を10分の1に下げて、最新の有効なチェックポイントから再開してください。トレーニング損失が減少しているにもかかわらず検証SCIが変化しない場合は、グラフ伝搬および融合パラメータに勾配が伝達されているかを確認してください。グラフィックスメモリが不足した場合は、バッチサイズを下げ、勾配蓄積を通じて実効バッチサイズを32に維持してください。ラン間で検証性能が激しく変動する場合は、記録されたランダムシードとデータマニフェストの順序を確認してください。
8. 推論、検索、クラスタリング、および出力の検証
- python infer.py --config configs/protocol.yaml --checkpoint checkpoints/selected_model.pth を実行してください。すべてのテスト画像に対して、確率マップ、構造的事前分布、外観特徴行列、構造的特徴行列、統合コンポーネント行列、および最終的な特徴ベクトルを生成します。
- すべての推論出力をfeature_outputs/testに保存し、それらのパスをtest_feature_manifest.csvに記録してください。すべてのクエリ特徴量とすべてのギャラリー特徴量の間のコサイン類似度を算出します。ギャラリーの識別子を類似度の降順にソートしてください。各クエリに対して上位5つの結果をevaluation_results/retrieval_results.csvに保存します。
- 可視化のために選択された各検索サンプルについて、クエリ画像の入力済み隣接行列、関係重み行列、コンポーネント中心行列、非活性ノードマスク、コンポーネントラベルマッピング、および融合コンポーネント行列をロードしてください。構造認識モデルによって生成された最高ランクの結果についても、同様のファイルをロードしてください。
- 保存されたコンポーネント中心および型付き隣接行列から、クエリコンポーネントグラフおよび検索画像コンポーネントグラフをレンダリングします。モデル推論時に使用された固定のコンポーネント順序および関係タイプを維持してください。
- 入力された隣接行列をカテゴリカル行列として描写してください。非活性、共有境界、および垂直順序の関係に対して、それぞれ個別の行列値を使用してください。水平軸および垂直軸には、コンポーネントラベルマッピングに格納されているコンポーネント識別子をラベルとして付けてください。
- クエリ融合成分行列と検索画像融合成分行列にL2正規化を適用します。すべてのクエリ成分とすべての検索画像成分の間でコサイン類似度を算出します。得られたKを保存します。 × K成分対応行列をevaluation_results/structural_retrieval_evidenceへ。
- 局所差分解析のために選択されたすべてのリファレンス・ターゲット対について、両方の画像の型付き隣接行列、コンポーネント中心行列、空間分散行列、関係重み行列、および統合コンポーネント行列をロードする。
- 入力された2つの隣接行列間の絶対差を計算する。固定されたコンポーネント順序を用いて、コンポーネント中心の変位、空間的分散、および関係重みの絶対差を計算する。得られたトポロジー差分行列と幾何学的関係差分行列をevaluation_results/structural_difference_evidenceに保存する。
- 2つの統合コンポーネント行列の対応する行間のL2距離を算出する。コンポーネントレベルの距離を正規化し、それらをターゲットコンポーネントグラフのノードに割り当てる。関係重みの正規化された差に応じてエッジの幅を太くする。得られた統合後のコンポーネント差分グラフを保存する。
- 画像識別子、マトリックスパス、グラフパス、コンポーネント順序、チェックポイント識別子、および可視化出力パスをstructural_visualization_manifest.csvに記録してください。すべての構造可視化は、記録されたファイルからプログラムによって生成し、グラフノード、グラフエッジ、またはマトリックス値を手動で追加しないでください。
- 最終的な特徴ベクトルに対して5つのクラスターでK-Meansを適用し、クラスター割り当て結果をevaluation_results/cluster_assignments.csvに保存します。python evaluate.py --config configs/protocol.yaml --feature_dir feature_outputs/test を実行してください。
- 各ランについて、SCI、SDI、Recall@5、平均適合率 (mAP)、およびシルエット係数を算出する。SCIを用いて、同一の構造ラベルを共有する正規化特徴量の凝集度を評価し、SDIを用いて、異なる構造ラベル間の分離度を評価する。Recall@5を用いて、短い検索リストに関連する構造的一致が含まれているかを確認し、mAPを用いて、ギャラリー全体におけるランキングの質を評価する。シルエット係数は、クラスタリング解析のみに使用する。
- 5回の独立した試行における算術平均および標本標準偏差を算出すること。すべての手法および指標について、試行ごとの5つの値を保持すること。比較対象の手法に基づいた最小最大正規化、ランク正規化、またはリスケーリングは適用しないこと。同一の乱数シードで得られた結果を用いて対応のあるt検定を行い、検定統計量および正確な両側有意確率を記録すること。
- 処理済みテスト識別子の数、特徴量ファイル、検索レコード、およびクラスター割り当てを比較してください。評価結果を報告または解釈する前に、すべての不一致を解消してください。
- すべてのテスト画像に、完全な推論レコードが1つ、検索リストが1つ、クラスター割り当てが1つ、および評価入力セットが1つ存在することを確認してください。可視化のために選択されたすべての検索ケースに、クエリコンポーネントグラフ、検索画像コンポーネントグラフ、型付き隣接行列、および融合コンポーネント対応行列が存在することを確認してください。
- すべての構造的差異ケースに、トポロジー差異行列、幾何学的関係差異行列、融合後コンポーネント差異グラフ、空間差異ヒートマップ、およびレスポンスオーバーレイが存在することを確認してください。すべての可視化ファイルが、structural_visualization_manifest.csvを通じてソース行列にリンクされていることを確認してください。可視化された各ケースについて、純粋なヒートマップ、ターゲット画像オーバーレイ、前景マスク、および最大レスポンス領域の座標を保存してください。
- 支配的な高応答領域が衣服のフォアグラウンドと重複し、かつ対応する型付き隣接関係の変化、幾何学的関係の変化、および融合後のコンポーネント間距離の根拠によって支持される場合にのみ、計算された差分応答を受け入れる。最強の応答が主に衣服のフォアグラウンド外にある場合は、パーシング出力、コンポーネントグラフ、および融合記録を検査すること。
注:テストセットでの推論には、検証セットから選択したチェックポイントを使用してください。テストセットの指標に基づいてチェックポイントを選択したり、置き換えたりしないでください。推論および視覚化の際にグラフと行列を生成するときは、同一のコンポーネント順序、非活性ノード規則、関係タイプエンコーディング、および正規化プロセスを使用してください。
トラブルシューティング:すべてのテスト画像の処理が完了する前に推論が停止した場合は、推論ログで最後の識別子を確認し、その次の識別子から再開してください。検索結果が色の類似性に支配されている場合は、構造的事前分布(structural-prior)および融合(fusion)の出力を検査し、チェックポイントの読み込みが成功しているかを確認してください。評価において識別子の重複が報告された場合は、test_feature_manifest.csvを再作成し、重複レコードを削除してから再計算を行ってください。K-Meansで空のクラスターが生成された場合は、特徴量の正規化を確認し、記録済みの乱数シードを用いてクラスタリングを再実行してください。
9. 比較モデル評価
- python compare_models.py --config configs/protocol.yaml を実行してください。
- 同一のトレーニング、検証、およびテストマニフェストを用いて、ResNet-50、Part-based Convolutional Baseline (PCB)、GCN、FashionGraph、Swin Transformer、CLIP、色とテクスチャを融合したトポロジー特徴ヒストグラム、Attention-Guided Cascade Network、MMFL-Net、FARE-RNET、および提案手法のトレーニングと評価を行う。
- すべての手法において、同一の画像サイズ、前処理操作、学習エポック数、有効バッチサイズ、評価クエリ、および指標の実装を使用してください。
- ResNet-50にグローバル平均プーリングを保持する。PCBに水平ストリップアライメントを適用する。GCNに固定的な画像レベルの衣服グラフを適用する。FashionGraphに属性誘導動的グラフ推論を適用する。Swin TransformerおよびCLIPの標準的な画像エンコーダを使用する。トポロジー、色、およびテクスチャ記述子を用いて、色・テクスチャ融合トポロジー特徴ヒストグラムを実装する。衣服パースを備えたグローバルおよびローカル特徴ブランチを用いて、アテンション誘導カスケードネットワークを実装する。マルチスケールおよびマルチグラニュラリティ特徴ブランチを用いて、MMFL-Netを実装する。残差アテンション、特徴選択、および拡張コンテキストエンコーディングを用いて、FARE-RNETを実装する。
- すべての比較手法において、画像クエリブランチのみを使用してください。学習可能なすべての手法を共通のトレーニングマニフェストで再学習させ、共通の検証マニフェストからチェックポイントを選択してください。すべてのテストクエリに対して、ランキング形式のギャラリーリストを生成してください。
- 元の次元が異なる場合は、登録済みの学習可能な線形レイヤーを通じて、学習済みエンベディングをすべて512次元に投影する。コサイン類似度によるランキングの前にL2正則化を適用する。すべての手法において、同一のクエリ・ギャラリー割り当ておよびメトリック実装を使用する。
- すべての比較手法において、同一の5つのランダムシードを用いて繰り返し実験を行う。SCI、SDI、Recall@5、mAP、およびシルエット係数の平均値と標本標準偏差を報告する。各指標について、同一のランダムシード下で得られた結果を用い、提案手法とすべての比較手法との間で両側対応のあるt検定を行う。5回の試行ごとの値、検定統計量、自由度、および正確な値を記録する。 pevaluation_results/comparison_metrics.csv 内の -値。
- すべての手法について、SCI、SDI、Recall@5、mAP、およびシルエット係数を算出してください。すべてのランレベルおよび集計値を evaluation_results/comparison_metrics.csv に保存してください。
- comparison_metrics.csvに、すべての比較手法について同一の指標フィールドと同一回数の独立試行が含まれていることを確認してください。
注:比較手法間において、データパーティション、指標コード、またはクエリ・ギャラリーの割り当てを変更しないでください。
トラブルシューティング:比較モデルが512以外の特徴量次元を出力する場合は、指標計算の前に単一の登録済み線形投影層を追加し、その層を対応するモデルと共に学習させてください。一般的な学習率でモデルが収束しない場合は、そのモデルの公開済みの実装で指定されている学習率を使用し、それ以外のすべての実験条件は維持してください。手法固有の設定はすべて比較ログに記録してください。
結果
報告されたすべての実験は、表2および材料表に記載されたハードウェアおよびソフトウェア環境を用いて実施されました。前処理、トレーニング、推論、および評価を通じて、同一バージョンのグラフィックスドライバー、CUDA、cuDNN、Python、NumPy、PyTorch、およびtorchvisionが使用されました。ハードウェアおよびソフトウェア環境の詳細は、表2および材料表にまとめられています。表1には、処理済みのトレーニング、検証、およびテストデータセットと、画像レベルのトポロジー統計がまとめられています。表2には、すべての比較手法に使用された共通の設定がまとめられています。
比較評価結果
比較評価は、「プロトコル」セクション7〜9で規定された、一般的なデータ分割、前処理操作、トレーニング制御、および指標の定義に従って行われた。 表3 一般的な視覚エンコーダー、部位アラインメントモデル、グラフベースの衣類表現、クロスドメイン・ファッション検索ネットワーク、トポロジーおよび外観融合手法、ならびにECサイト向け視覚検索手法を、すべて同一の画像クエリプロトコルを用いて評価し、比較します。ドメイン固有の手法には、色およびテクスチャ融合を伴うトポロジー特徴ヒストグラム(TFH-CT)、アテンションガイド付きカスケードネットワーク(AGC-Net)、マルチスケールおよびマルチグラニュラリティ特徴学習ネットワーク(MMFL-Net)、およびエグレット群最適化を用いた残差ネットワークによるファッション検索(FARE-RNET)が含まれます。すべての評価指標は、 表3 同一のランダムシード、トレーニングマニフェスト、検証マニフェスト、テストマニフェスト、クエリ・ギャラリー割り当て、および指標の実装を用いて5回の独立した試行を行い、その平均値と標本標準偏差として報告されている。ペアを組んだ p-同一の乱数シード条件下で各手法を提案手法と比較することにより、SCI、SDI、Recall@5、mAP、およびシルエット係数の値を個別に算出した。これらの結果は、その後の構造可視化、検索、クラスタリング、および設計指向解析のための定量的な根拠となる。
代表的なプロトコルの結果と解釈
保存されたパースファイルおよびグラフファイルから再構成された画像レベルのコンポーネントグラフにおいて、すべての活性ノードが対応する衣類領域内に配置され、図5Cに示すように、型指定隣接行列に記録されたリレーションタイプが保持されていれば、プロトコルの実行は成功したといえます。構造を考慮したレスポンスは、図5Dに示すように、衣類の前景に集中している必要があります。Figure 6Eは期待される検索結果を示しており、提案手法によって赤い背景の影響が低減され、無関係な赤い物体ではなく上半身の衣類が検索されています。図6B–Gはまた、検索ランキングが画像レベルのコンポーネントリレーションおよび融合後のコンポーネント対応によって支持されていることを示しています。この結果は、袖の長さや局所的なトポロジーには依然として個体差があるものの、大まかな衣類カテゴリーの回復を反映しています。
代表的な失敗例として、図 5Bにおけるテクスチャ主導の活性化、図 6の上段における背景色による検索、および図 7における残留背景活性化が挙げられます。図 7については、支配的な応答が拡大した下半身のシルエットと右側の衣類境界に従っている一方で、隣接する背景領域に活性化が残留しているため、部分的な局在化であると解釈されます。トポロジー差分行列、幾何学的関係差分行列、融合後コンポーネント差分グラフ、および空間応答が、一貫した衣類領域を特定した場合にのみ、その局在化は構造的に裏付けられているとみなされます。行列やコンポーネントに相当する変化を伴わない空間的なホットスポットは、構造的な根拠ではなく、視覚的な干渉であることを示しています。
プロトコルの実行は、承認されたすべての画像から、正規化された意味確率マップ、K行K列のリレーション行列、K行512列の外観および構造特徴行列、および正しい画像識別子に紐付けられた有限の融合特徴ベクトルが生成された場合に有効であると見なされます。視覚的な検査により、トポロジーが衣類の構成部品に従っていること、前景の応答が背景の応答を上回っていること、および検索結果が背景色ではなく衣類のカテゴリーと構造に基づいて導出されていることを確認する必要があります。確率マップの断片化、コンポーネントノードの欠落、非数値行列、拡散した背景応答、または色に支配された検索結果は、実行の失敗を示しており、パース、グラフ構築、特徴融合、またはチェックポイントのロードの検証が必要です。
画像レベルでの衣服構成要素の応答に関する視覚的解析
図5では、同一の衣類画像を用いて、ResNet-50のベースラインとコンポーネント認識モデルを比較しています。図5Bは、外観ベースラインのクラス活性化マップ(CAM)を示しています。図5Cは、プロトコルのセクション3および4で生成された、前景制限確率マップ、コンポーネント中心行列、型付き隣接行列、非活性ノードマスク、およびコンポーネントラベルマッピングから再構成された、画像レベルの衣類コンポーネントグラフを示しています。図5Dは、融合表現の活性化応答を示しています。図5Cの生成にあたり、人間の姿勢推定器や人間の関節アノテーションは使用されていません。
ベースラインの応答は、図5Bに示すように、下衣の局所的なテクスチャ領域に集中しており、衣類全体の境界に一貫して沿っていませんでした。図5Cでは、各ノードは活性化した衣類コンポーネント領域の中心に対応し、各エッジは共有された前景境界または定義済みの垂直方向の順序関係を表しています。このグラフは衣類領域の構成を反映したものであり、人間の解剖学的な関節を表すものではありません。構造を認識した応答は、図5Dに示すように、ほとんどの背景領域で活性化を低く抑えつつ、主要な衣類の前景をカバーしていました。これらの結果は、コンポーネントグラフと特徴融合モジュールによって、評価画像におけるテクスチャ主体の活性化が抑制されたことを示しています。
衣類の構造的類似性分析およびデザイン参照結果
図6に、検索ランキングと、その解釈に用いられた構造的根拠を示します。図6Bのクエリコンポーネントグラフは、活性化された衣類領域とその型定義された関係を記録しており、図6Cの行列は、グラフ伝播に提供された関係パターンを示しています。図6Dのベースラインの結果では、依然として赤色の外見的な手がかりが支配的です。図6Eの構造認識結果では、異なる色や背景においても上半身の衣類カテゴリーが維持されています。図6Fの最高ランクの結果におけるコンポーネントグラフにより、クエリグラフとの直接的な比較が可能となり、図6Gの対応行列は、同じ識別子を共有するコンポーネントが構造誘導融合後も整列したままであるかを示しています。対角線上の対応は、欠損ノードや変化したグラフ関係と合わせて解釈されるべきです。グラフの一致を伴わない強い外見的類似性は、構造的な検索の成功とはみなされません。
検索された衣類は大まかなカテゴリーは維持しているが、袖の構成や局所的なコンポーネント間の関係性に相違が見られるため、きめ細かな対応関係は不完全である。提案手法は、表3に報告されている通り、Recall@5で89.2%、mAPで86.4%を達成した。これらの定量的数値はランキング性能を示す一方、図6B–Gは、その解釈を支持する中間的な構造的根拠を提示している。したがって、検索結果としての結論は、テストしたクエリにおいて、背景色の干渉に対する耐性が向上し、画像レベルのコンポーネント構成が強化されたことに限定される。
構造的差異に対する応答および設計解析サポート
図7Hの純粋な差分応答ヒートマップは、支配的な応答がターゲット画像の拡大された下半身のシルエットと右側の衣服の境界に集中していることを示しています。図7Iのオーバーレイでは、最強の応答が主要な衣服の前景と一致し続けている一方で、隣接するカーテンや壁の領域における弱い活性化が残留背景干渉として残っていることがわかります。空間応答は、図7C–Gに示されているコンポーネントグラフおよび行列のエビデンスと併せて解釈されるべきです。高応答の衣服領域が、隣接関係の変化、幾何学的関係の変化、および融合後のコンポーネント間距離パターンと一致する場合にのみ、その応答は有効な構造的差分として扱われます。
構造的な差異は、図 7Eに示されるタイピングされた隣接関係の変化、または図 7Fに示される幾何学的関係の変化に伴い、図 7Gにおけるコンポーネント間距離の増加および図 7H,Iにおける前景整列空間応答が認められた場合にのみ受理される。拡大した下半身領域と右側の衣服境界は、このステージ横断的基準を満たしている。カーテンおよび壁面における活性化は、コンポーネントノード、関係パターン、または融合コンポーネント距離の変化に対応しておらず、したがって非構造的な残留干渉として棄却される。この結果は画像レベルの差異局在化を支持するが、縫製パターンや構造パラメータの変動を立証するものではない。
特徴の空間分布および構造クラスター分析
潜在特徴空間の分布を分析することで、衣類の構造的意味論を識別するモデルの能力が明らかになります。この分析では、構造的事前知識によって、異なるトポロジー構成を持つ衣類が個別の特徴多様体に整理されるかどうかを検証します。テストセットから、半袖トップス、パンツ、スカート、ロングコート、ドレスの5つの代表的な構造カテゴリーを選択しました。高次元の特徴ベクトルは、t-distributed stochastic neighbor embedding (t-SNE) を用いて2次元平面に投影されました。特徴空間における構造的意味論の構成を特性化するため、類似サンプルの凝集性と非類似サンプルの分離性を評価しました。構造認識特徴空間のt-SNE分布を図 8に示します。
図8Aに示すように、t-SNE投影により、隣接するカテゴリー間の重複が限定的な5つの主要な特徴領域が形成されました。これら5つのカテゴリー領域に対応する代表的なサンプルを図8Bに示します。表3に報告され、図8で可視化されている通り、0.81というSCIは同じ構造ラベルを共有するサンプルの凝集性を反映し、0.71というSDIは異なる構造ラベルを持つサンプル間の分離度を反映しています。これらの指標は特徴空間の分布の尺度として解釈されるべきであり、誤警報率を直接的に規定するものではありません。図8Aに示すように、半袖トップスとスカートは投影された特徴空間において異なる主要領域を占めていましたが、少数のサンプルは隣接するカテゴリーの境界付近に留まっていました。パンツとドレスについても、隣接カテゴリーからの明確な分離が認められました。この分布は、グラフ事前分布が、完全なクラスター分離をもたらすことなく、カテゴリーレベルの構造的組織化に寄与したことを示しています。この評価では、表現の質と検索の有効性を分けて検討しています。SCIは、同じ構造ラベルを共有する衣服が学習された特徴空間において凝集しているかを評価し、SDIは、異なる構造ラベルを持つ衣服が分離しているかを評価します。これらの指標は、プロトコルの構造的表現の目的に対応しています。Recall@5は、構造的に関連する衣服が検索結果の上位5件以内に現れるかを測定し、mAPはすべての関連ギャラリーサンプルにおけるランキングの質を測定します。これらの指標は、デザイン参照検索の目的に対応しています。SCIとSDIで既に特徴空間の組織化が特性付けられているため、シルエット係数はクラスタリング性能の評価のみに使用されました。
図9は、手法間の正規化を行わない、代表的な4つの手法における5回の試行の生の結果を示している。図9Aは元のスケールでのSCIおよびSDIを、図9BはパーセンテージとしてのRecall@5およびmAPを示している。個々の試行マーカーと標準偏差の誤差線は、単なる集計ランキングではなく、モデルトレーニングに伴う変動を示している。外観ベースのベースラインは0.62のSCIを達成したが、提案手法は0.81のSCIおよび0.71のSDIを達成した(表3および図9A)。SCIおよびSDIの結果は、評価設定において、ラベル内でのより強い凝集性とラベル間のより強い分離性が得られたことを示している。提案手法は89.2%のRecall@5および86.4%のmAPを達成した(表3および図9B)。これらの検索指標は異なるランキング特性を評価するものであり、SCIおよびSDIとは別に解釈される。4つの指標すべてで手法の順位が一致していることは、表現の品質と検索性能が整合していることを示しているが、4つの評価次元において相対的な改善度が同一であることを意味するものではない。
アブレーション実験および構造モジュールの有効性分析
アブレーション実験では、完全なモデルと、構造的事前知識(structural prior)または融合モジュール(fusion module)を削除したバリアントを比較しています。これら3つの構成すべてで同じ参照画像とターゲット画像を使用しているため、背景応答と局在化の集中度を直接比較することが可能です。構造的事前知識のないバリアントでは、画像レベルの衣類コンポーネントグラフとその関係制約を削除し、外見特徴の抽出を畳み込みバックボーンのみに依存させています。非融合バリアントでは、グラフ推論は維持していますが、特徴ピラミッドを削除し、高レベルのセマンティック特徴のみを使用しています。可視化された差分ヒートマップから、ノイズ抑制と境界定義における各モジュールの具体的な役割が明らかになります。異なるモジュール構成における構造的差分応答の定性的な比較を図10に示します。
図10C–Eの応答マップは、共通の応答スケールと同一のオーバーレイ設定を用いて描画された。構造事前分布(structure prior)のないバリアントでは、図10Cに示すように、左側の背景および無関係な環境領域周辺に強い活性化が見られた。フュージョンモジュール(fusion module)のないバリアントでは、衣服外の応答の一部は減少したが、図10Dに示すように、下衣および右側の周辺領域にわたる広範な分散が依然として保持されていた。完全なモデルでは、図10Eに示すように、支配的な応答が主たる衣服の前景に向けてさらに収束した。図10Fは、非フュージョンバリアントと完全なモデルの間で、前景に限定された応答の差を直接的に可視化しており、完全なモデルが主要な衣服に沿った応答を維持しつつ、残留する側方への分散を抑制していることを示している。これらの結果は、構造事前分布が主に環境ノイズを減少させ、フュージョンモジュールが応答の集中度と構造的な整合性をさらに向上させたことを示唆している。図10E は、背景活性化の完全な除去ではなく、相対的な改善を表している。
表4に、構造事前知識(structure prior)なし、融合モジュール(fusion module)なし、および完全なモデルにおけるSCI、SDI、Recall@5を示す。構造事前知識を除去すると、SCIは0.81から0.65に低下し、Recall@5は89.2%から74.5%に低下した。融合モジュールを除去すると、SDIは0.71から0.64に低下し、Recall@5は89.2%から85.1%へと4.1パーセントポイント低下した。これらの結果は、構造事前知識が構造的一貫性と検索に大きな影響を及ぼす一方で、特徴融合外観情報と構造情報の整合性を向上させることを示している。
効率分析では、完全モデルとResNet-50ベースラインの計算コストを比較している。ResNet-50ベースラインでは2,560万個のパラメータと41億回の浮動小数点演算が必要であった。一方、完全な構造認識モデルでは2,930万個のパラメータと54億回の浮動小数点演算が必要であった。1画像あたりの平均推論時間は、ベースラインで15ミリ秒、完全モデルで22ミリ秒であり、7ミリ秒の増加となった。この結果は、時間を要するワークフローに本プロトコルを導入する際に考慮すべき、測定可能な計算コストが存在することを示している。表5)構造制約の重みは、最終的なテスト評価の前に検証用スプリットを用いて決定した。構造制約の重みを0.1、0.3、0.5、0.8、1.0、1.2、1.5、および2.0として、検証用Recall@5を検討した。それ以降のすべてのトレーニングおよびテストにおいて、重みを1.0に固定した。 図11 バリデーションに基づく構造拘束ウェイト1.0の選択について記録している。
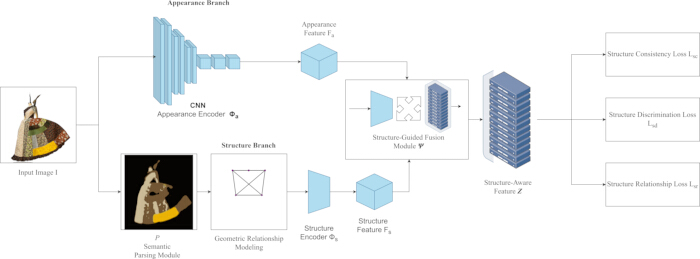
図 1: 構造認識型衣服画像特徴学習プロトコルの全体的なワークフロー。入力された衣服画像は、外観特徴ブランチと、セマンティックパースおよび空間グラフモデリングを用いる構造特徴ブランチによって処理される。これら2つの表現は、構造誘導型フュージョンモジュールで処理され、最終的な構造認識特徴が生成される。構造一貫性損失、構造識別損失、および構造関係損失が共同で特徴空間を制約する。本図は、特徴学習全体を通じて衣服の外観とコンポーネントのトポロジーがどのように統合されるかを示している。こちらをクリックして、この図の拡大版を表示してください。
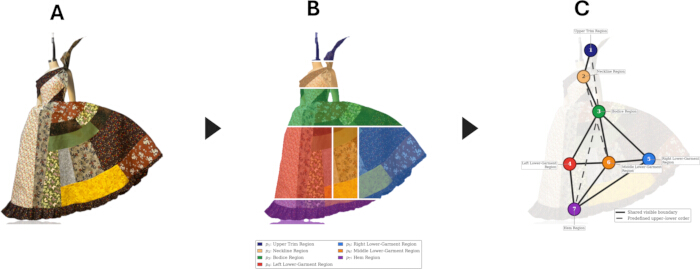
図 2: 画像レベルの衣類コンポーネントトポロジーの事前構築。 (A) 入力された衣類画像 I。(B) 前景に限定された視覚的コンポーネントマップ P。ここでは7色の色で画像レベルの衣類領域が示されている。すべての背景ピクセルはコンポーネントチャネルから除外される。(C) 画像レベルのコンポーネント関係グラフ G。ノードは可視化された衣類領域を表し、実線のエッジは共有された前景境界を、破線の関係は事前定義された垂直方向の順序を表す。このマップとグラフは、画像の検索および視覚的構造の比較を支援する。これらは、縫製パターンのピース、シームの形状、ダーツ構造、グレーディングパラメータ、または裁断指示を表すものではない。この図の拡大版を表示するには、ここをクリックしてください。
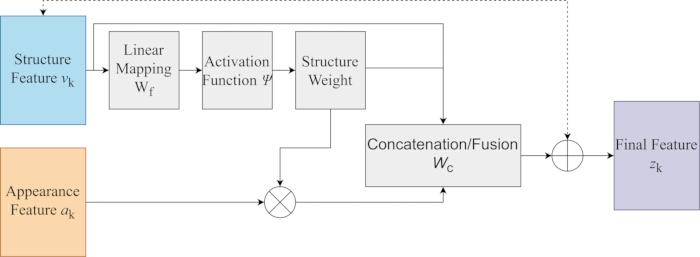
図 3: 構造ガイド付き特徴融合モジュール。 構造的特徴は、線形写像と活性化関数 Ψ によって変換され、構造重みが生成されます。この構造重みは、要素ごとの乗算を通じて外観特徴を変調させます。変調された外観特徴と構造的特徴は結合され、Wc によって投影された後、残差構造特徴が加算されて最終的なコンポーネント特徴が生成されます。本図は、最終的な融合の前に構造情報が外観特徴の重み付けを制御することを示しています。こちらのリンクをクリックして、この図の拡大版を表示してください。
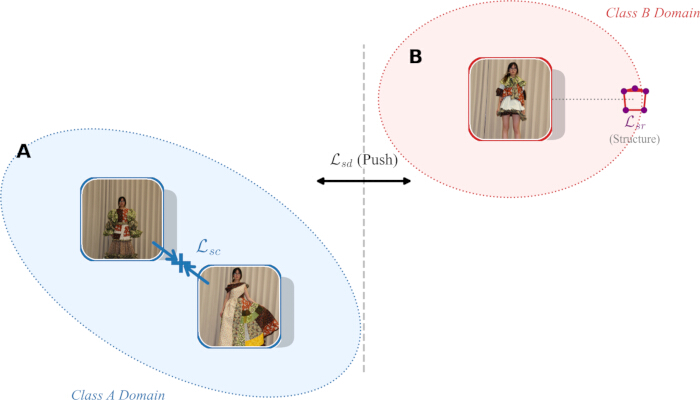
図4構造的一貫性制約下における特徴空間の最適化。 (A) 構造的一貫性損失(structure consistency loss)によって、同じ構造クラスに属するサンプル同士が近づけられる一方で、構造関係損失(structure relationship loss)によって、それらの内部成分間の関係性が維持されます。 (B) 異なる構造クラスのサンプルは、構造識別損失によって互いに遠ざけられます。この図は、3つの構造的目的関数が共同して、クラス内の凝集性とクラス間の分離性をどのように向上させるかを示しています。 この図の拡大版を表示するには、ここをクリックしてください。
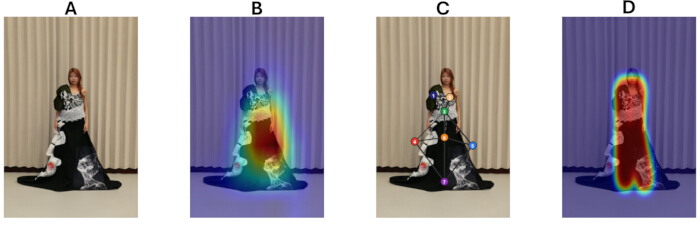
図5代表的な衣類の特徴量応答およびコンポーネントグラフによる可視化。 (A) 入力衣服画像。 (B) ResNet-50外観ベースラインのクラス活性化応答。 (C) 画像レベルの衣類コンポーネントグラフは、プロトコルのセクション3および4で保存された、前景制限コンポーネントマップ、コンポーネント中心行列、型指定隣接行列、非活性ノードマスク、およびコンポーネントラベルマッピングから再構成された。ノードは活性な衣類領域を表し、実線エッジは共有された前景境界を、破線エッジは定義済みの垂直方向の順序関係を表している。 (D) 統合されたコンポーネント認識表現の活性化応答。この比較は、テクスチャ主導の活性化と衣類領域ガイドによる活性化の違いを示している。 この図の拡大版を表示するには、ここをクリックしてください。
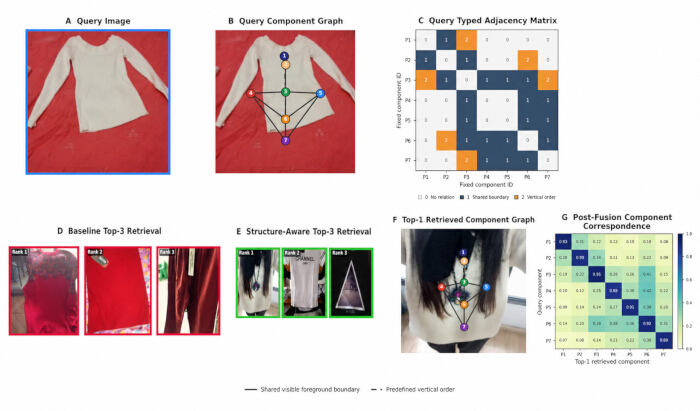
図6赤色背景干渉下における想起結果および中間構造的根拠 (A) クエリ画像 (B) クエリコンポーネントグラフは、保存されたコンポーネント中心と入力された隣接行列から生成されます。 (C) クエリとして入力された隣接行列であり、行列の値によって非活性な関係、共有された前景境界、および事前定義された垂直方向の順序関係を区別する。 (D) 上位3件の検索結果は、外観ベースラインによって生成された。 (E) 上位3つの結果は、構造認識表現によって導き出された。 (F) 最高ランクの構造認識結果のコンポーネントグラフ。 (G) クエリと最高ランクの結果との間の、融合後のコンポーネント対応行列。対角線上の高い対応は、同一の識別子を持つコンポーネント間の一致を示し、弱またはずれた応答は、コンポーネント構成の欠落または不一致を示す。検索結果において、大まかな上半身のカテゴリーは維持されているが、袖の構成および局所的なトポロジーにおける完全な一致には至っていない。 こちらの図の拡大版を表示するには、ここをクリックしてください。
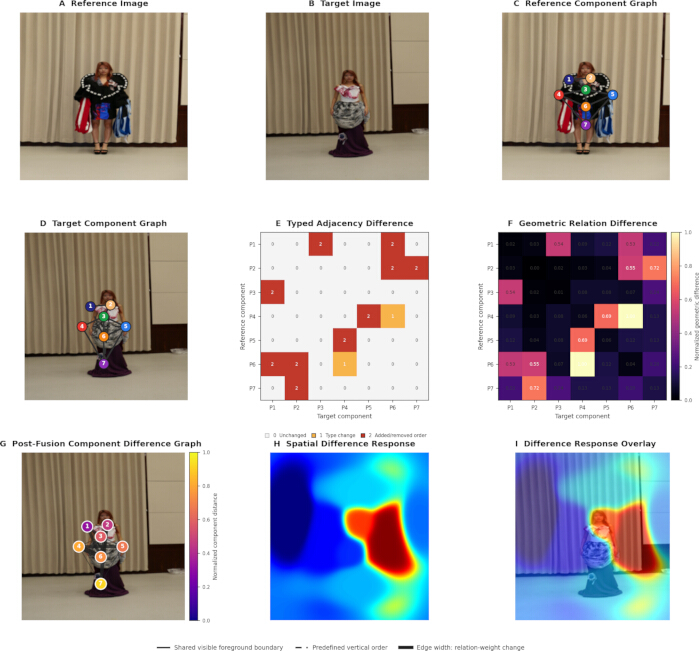
図7: 画像レベルの衣服トポロジーから空間的応答に至る構造的差分の追跡。 (A) リファレンス画像。 (B) ターゲット画像。 (C) リファレンスコンポーネントグラフ。 (D) ターゲットコンポーネントグラフ。両グラフは、保存されたコンポーネント中心と型付き隣接行列から再構成されている。 (E) 型付き隣接差分行列。 (F) 幾何学的関係の差分は、コンポーネント中心の変位、空間的分散、および関係ウェイトの変化から導出される。 (G) フュージョン後のコンポーネント差分グラフ。ノードの強度は対応する融合コンポーネントベクトル間の正規化距離を表し、エッジの幅は関係ウェイトの変化を表す。 (H) 純粋な空間的差分応答ヒートマップ。オーバーレイと同じ固定応答スケールを用いてレンダリングされている。 (I) ターゲット画像にオーバーレイされた応答。隣接関係の変化、幾何学的関係の変化、コンポーネント間距離の変化、および前景に整合したヒート応答が一貫している場合にのみ、構造的差分として認められる。コンポーネントや関係の根拠がない背景の活性化は、有効な衣服構造の差分ではなく、残留干渉として処理される。こちらのリンクをクリックして、この図の拡大版を表示してください。
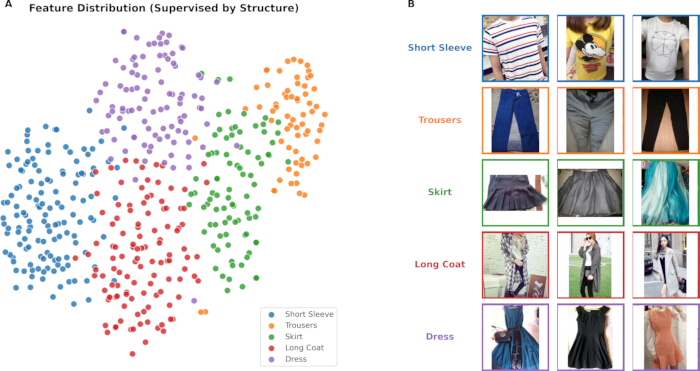
図 8: 構造を考慮した特徴空間クラスタリング。 (A) 半袖トップス、パンツ、スカート、ロングコート、およびドレスのt-SNE投影。5つのカテゴリーが主要な特徴領域を形成しており、境界付近での重複は限定的である。(B) 5つの衣類カテゴリーに割り当てられた代表的なテスト画像。枠線の色は(A)のカテゴリー色に対応している。本図は、隣接するカテゴリー領域付近に少数のサンプルを保持しつつ、カテゴリーレベルの構造的組織化を示している。こちらをクリックして、この図の拡大版を表示してください。
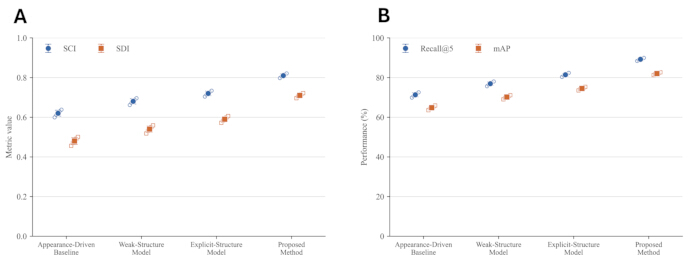
図 9特徴空間の構造および検索ランキングの目的関数における、生パフォーマンスの比較。 (A) 外観駆動ベースライン、弱構造モデル、明示的構造モデル、および提案手法におけるSCIおよびSDI。 (B) 同一の4つの手法におけるRecall@5およびmAP。大きなマーカーは5回の独立した試行における算術平均を、エラーバーは標本標準偏差を、小さなマーカーは試行ごとの結果を示している。SCIとSDIは0から1までの固定スケールで表示され、Recall@5とmAPは0から100までの固定パーセントスケールで表示されている。最小最大正規化および手法間のリスケーリングは適用されていない。 この図の拡大版を表示するには、ここをクリックしてください。
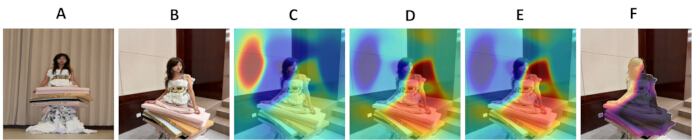
図10異なるモジュール構成下における構造的差異の応答。 (A) 参照画像 (B) ターゲット画像 (C) 先行構造を持たないバリアントの応答。 (D) 融合モジュールを持たない変異体の応答。 (E) 完全なモデルの応答。 (C–E) 同一の正規化応答スケール、カラーマップ、およびオーバーレイ設定を用いてレンダリングされています。 (F) 非融合バリアントと完全モデルとの間における、前景限定の絶対応答差。完全モデルは、主要な構造領域外の残留拡散を低減しつつ、衣類に沿った主たる応答を維持している。この比較により、構造事前分布が衣類外の干渉を低減し、さらに融合モジュールが構造応答をより鮮明にすることが示されている。 この図の拡大版を表示するには、ここをクリックしてください。
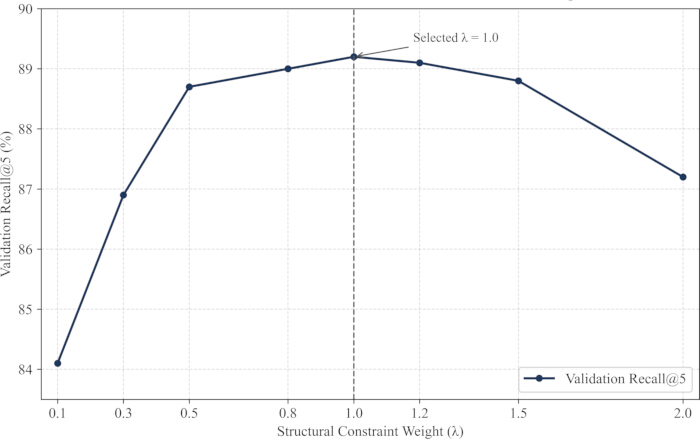
Figure 11: バリデーションに基づく構造制約ウェイトの選択。構造制約ウェイトを0.1、0.3、0.5、0.8、1.0、1.2、1.5、および2.0としたときのValidation Recall@5を示す。各点は5回のバリデーションランの算術平均を表し、各エラーラインは標本標準偏差を表す。最終的なテスト評価の前に、ウェイトは1.0に固定された。本図はパラメータ選択の手順を記録したものであり、独立したアーキテクチャ上の寄与を構成するものではない。こちらのリンクをクリックして、この図の拡大版を表示してください。
表1:衣服サブセットS1からS5におけるデータセットの割り当ておよび画像レベルのトポロジー統計。 本表は、各構造レベルにおけるトレーニング、検証、テスト、および合計の画像数とともに、平均セマンティックコンポーネント数、アクティブノード数、型付きエッジ数、およびアノテーション済み画像平面ランドマーク数を報告している。すべての数値は処理済みデータマニフェストから生成されたものである。トレーニング、検証、およびテストの画像数は、構造レビュー、重複グループ制御、およびリーク検査後の最終サブセットマニフェストから取得され、トポロジー統計は、モデル評価時に適用されたものと同じコンポーネント順序および関係定義を用いて最終グラフレコードから算出された。 こちらをクリックしてファイルをダウンロードしてください。
表2:プロトコル全体で使用された計算環境、入力設定、オーギュメンテーション、表現、最適化、損失、および再現性の設定。 この表には、正確なオペレーティングシステム、プロセッサ、搭載メモリ、グラフィックス処理ユニット、グラフィックスメモリ、グラフィックスドライバー、CUDA、cuDNN、Python、NumPy、PyTorch、およびtorchvisionのバージョンとともに、画像サイズ、バッチ構成、オプティマイザー、学習率スケジュール、エポック数、乱数シード、表現次元、および構造的目的関数の重みが記載されています。各値は、software_versions.txt、configs/protocol.yaml、または対応するトレーニング記録にリンクされています。こちらをクリックしてファイルをダウンロードしてください。
表3:一般的な視覚表現モデル、グラフベースの衣服モデル、およびドメイン固有のファッション検索手法の定量的比較。 本表は、同一のデータ分割および評価プロトコルの下での11の手法における検索フォーカス、クエリモダリティ、SCI、SDI、Recall@5、mAP、およびシルエット係数を示す。各指標は、5回の独立した試行における平均値と標本標準偏差として報告されている。報告されたp値は、同一の5つのランダムシードを用いて得られた結果に基づき、各比較手法と提案手法を比較した両側対応t検定から算出された。提案手法を基準行としている。こちらのリンクからファイルをダウンロードしてください。
表4:構造的事前知識および特徴融合モジュールの切除実験結果構造的事前知識を用いないバリアント、融合モジュールを用いないバリアント、および完全なモデルにおけるSCI、SDI、およびRecall@5を報告する。構造的事前知識を除去すると、SCIとRecall@5が大幅に低下する一方、融合モジュールを除去するとSDIと応答の整合性が低下する。完全なモデルは、これら3つの指標すべてにおいて最高値を記録している。こちらのリンクからファイルをダウンロードしてください。
表5:ResNet-50ベースラインと完全な構造認識モデルの計算効率。本表は、表2および材料表に記載されたハードウェアおよびソフトウェア環境下における、学習可能パラメータ数、画像あたりの浮動小数点演算数、および画像あたりの平均推論時間を報告している。両モデルともに、同一の画像解像度、推論バッチ設定、前処理操作、および計測手順を用いている。完全なモデルは、ベースラインと比較して、パラメータ数が3.7 million、浮動小数点演算数が1.3 billion、画像あたりの推論時間が7 milliseconds増加している。こちらのリンクからファイルをダウンロードしてください。
ディスカッション
最も重要なプロトコルの段階は、衣服を保存するための前処理と、前景に限定した意味的コンポーネントのパース(解析)である。コンポーネントの中心、空間分散値、共有境界関係、垂直順序関係、関係の重み、および融合表現は、すべてパースの出力から導出される。境界の漏れ、コンポーネント領域の統合、コンポーネント領域の欠落、および不適切なチャネル割り当ては、グラフ構築および特徴融合を通じて伝播する。これらのエラーにより、グラフファイルの次元は有効であっても、表現されたコンポーネント間の関係が元の衣服と矛盾した状態になる可能性がある。したがって、構造的事前知識を承認する前に、確率マップ、前景制限、コンポーネントのプレビュー、およびパース品質の記録を確認しなければならない。
グラフの構築および特徴融合には、セマンティックコンポーネントの固定された順序が必要です。グラフは、前景の衣服コンポーネントと、それらの画像平面上の関係から導出されます。検索および差異局在化の図は、単に最終的なランキング画像やレスポンスヒートマップを表示するのではなく、構造的な処理パスを提示するものです。型定義済み隣接行列は個別のコンポーネント関係を記録し、幾何学的関係行列は正規化された空間配置を記録し、融合後のコンポーネント行列は検索および局在化に使用される表現を記録します。構造的な結論は、これらの中間表現が最終的な視覚的出力と一致する場合にのみ受け入れられるべきです。コンポーネントグラフでは、解剖学的ランドマーク、ヒトの関節座標、またはポーズ推定ネットワークは使用しません。グラフのオーバーレイは、そのノードと関係タイプが保存されたコンポーネントファイルおよび隣接ファイルから再現された場合にのみ受け入れられるべきです。非アクティブなコンポーネントは、非アクティブノードインジケータを伴うゼロベクトルとして保持されるべきであり、外観および構造特徴行列は、融合前にそれぞれK行512列でなければなりません。これらのチェックにより、ノードの不整合や次元エラーがモデルの挙動として誤認されることを防ぎます。
トラブルシューティングは、無効な中間出力が最初に現れた段階から開始してください。確率マップが一様である場合は、チェックポイント、正規化、またはカテゴリインデックスのエラーが考えられます。構造行列が非数値である場合は、確率の分母が無効であるか、座標スケーリングに問題があります。応答が拡散している場合や、色の影響が支配的な検索結果が得られる場合は、構造事前分布が弱い、融合に失敗している、あるいはチェックポイントの読み込みが正しくないことを示しています。トレーニングログで、グラフおよび融合層における勾配と、検証に基づいたチェックポイントの選択を確認する必要があります。視覚的なヒートレスポンスを単独で構造的な結論として使用してはいけません。保存された前景マスク、入力された隣接関係の変化、幾何学的関係行列、および融合後のコンポーネント差分グラフと照らし合わせて確認する必要があります。衣服の前景以外に残留活性が見られる場合は、検証された構造的な差異ではなく、応答の特異性が限定的であることを示しています。
外観主導の検索と比較して、本プロトコルでは距離学習の前にコンポーネントのトポロジーを導入しています。弱い構造的制約や固定トポロジーのグラフモデルと比較して、意味的な関係重みにより、現在の衣服に合わせてグラフ伝播を適応させることができます。完全なモデルでは、Table 3に報告されている通り、SCI 0.81、SDI 0.71、Recall@5 89.2%、mAP 86.4%、およびシルエット係数 0.74を達成しました。追加の構造モジュールにより、Table 4に報告されている通り、パラメータ数は25.6 millionから29.3 millionへ、推論時間は1枚あたり15ミリ秒から22ミリ秒へと増加しました。本プロトコルの技術的な貢献は、画像レベルの衣服コンポーネントグラフの構築、外観とコンポーネント関係の並列エンコーディング、構造ガイド付き特徴融合メカニズム、および構造的一貫性、関係性、識別性の目的関数にある点です。Figure 11に報告されている検証スイープは、固定の学習係数を決定するためだけに行われたものであり、ネットワークアーキテクチャや目的関数の設計への貢献として提示されるものではありません。
本プロトコルは、深刻な遮蔽、衣服の重なり、ソース画像の小ささ、ポーズの変動、複雑な背景、および可視化された構成が固定された7領域スキーマに準拠しない衣服に対して依然として敏感です。非対称なデザイン、取り外し可能なレイヤー、密なドレープ、多層のボトムス、および重なり合った装飾領域は、複数の意味的領域を統合させたり、現在のグラフ定義に存在しないコンポーネント関係を導入したりする可能性があります。遮蔽は、アクティブなコンポーネントを抑制し、その確率重心をシフトさせ、有効な共有境界関係を排除することがあります。図6は、大まかな上半身カテゴリーの回復は見られるものの、袖のトポロジーの一致が不完全であることを示しており、図7および10では、隣接する背景領域に応答が保持されています。これらの結果は、テンソルの次元とグラフの接続性が有効であっても、意味的に正しい構造的解釈が保証されるわけではないことを示しています。したがって、本研究は、デザインワークフローの効率化やパターンパラメータの直接的な推定ではなく、画像ベースの検索、クラスタリング、および差異の局在化を支持するものです。本研究におけるすべての定量的実験は、保持され構造的に再ラベル付けされたDeepFashion2コホートを用いて実施されています。現在の結果は、異なる衣服分類、アノテーション基準、文化的衣類カテゴリー、画像ソース、または取得環境を持つ独立したデータセット全体における堅牢性を立証するものではありません。別のデータセットへ移行する場合、7つのコンポーネントチャネルの再マッピングおよび型定義された関係スキーマの再構築が必要になる可能性があります。したがって、報告された結論は、評価されたデータ分布および画像レベルのコンポーネント定義に限定されます。
これらの制限範囲内において、本プロトコルは、セマンティックパース、幾何学的関係のモデリング、デュアルストリームエンコーディング、および構造ガイド付きフュージョンを通じて、衣服画像からコンポーネントを認識した表現を得るための再現可能なシーケンスを提供します。今後の検証では、異なるアノテーションシステム、衣服カテゴリー、ポーズ、および背景条件を持つ独立した衣服データセットを使用します。また、現在の7領域マッピングが、非対称、レイヤード、取り外し可能、または文化的に固有な衣服構造に対して拡張が必要かどうかも検討します。手書きのデザインスケッチ、生地をまたいだバリエーション、およびパラメータ化されたパターン調整は、タスク固有のデータと評価手順を必要とする個別の応用方向として残されています。専門的なユーザビリティおよびデザインレビューの効率については、定義された参加者、評価基準、および統計的手順を備え、別途文書化されたヒト被験者研究が必要です。
開示事項
著者らに申告すべき利益相反はありません。
謝辞
本研究は、第14次5ヵ年計画における省レベルの重点学部教育改革プロジェクト(第2次募集)の、「『三統合・三融合』共同構築モデルに基づく『衣服・アパレルデザイン』の教育改革と探究」(プロジェクト番号:JGZD2024096)というプロジェクトの支援を受けて実施されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| 中央処理装置 | Intel Corporation | Intel Core i9-13900K、24コア、32スレッド、最大5.80 GHz | |
| Conda | Anaconda, Inc., anaconda.com | Miniconda3 23.11.0 | |
| CUDA Toolkit | NVIDIA Corporation, developer.nvidia.com | CUDA 11.8 | |
| cuDNN | NVIDIA Corporation, developer.nvidia.com | cuDNN 8.9.7 | |
| DeepFashion2データセット | 香港中文大学、github.com/switchablenorms/DeepFashion2 | 公式DeepFashion2リリース、バージョン1.0 | |
| グラフィックス処理装置 | NVIDIA Corporation | NVIDIA GeForce RTX 4090, 24 GB GDDR6X | |
| HRNet-W48 セマンティックパース チェックポイント | HRNetプロジェクト、github.com/HRNet/HRNet-Semantic-Segmentation | hrnet_w48_garment_parser_7class.pth, プロジェクトチェックポイント バージョン1.0 | |
| ImageNetで事前学習済みのResNet-50重み | PyTorch Foundation, pytorch.org | ResNet50_Weights.IMAGENET1K_V2 | |
| Matplotlib | Matplotlib開発チーム、matplotlib.org | バージョン 3.8.2 | |
| NumPy | NumPy開発者、numpy.org | バージョン 1.26.4 | |
| NVIDIAグラフィックスドライバー | NVIDIA Corporation | バージョン 546.33 | |
| OpenCV-Python | OpenCVチーム、opencv.org | バージョン 4.8.1.78 | |
| オペレーティングシステム | Microsoft Corporation | Windows 11 Pro 23H2, 64ビット, OSビルド 22631.3155 | |
| Pandas | Pandas開発チーム、pandas.pydata.org | バージョン 2.1.4 | |
| Python | Python Software Foundation, python.org | バージョン 3.10.13 | |
| PyTorch | PyTorch Foundation, pytorch.org | CUDA 11.8対応 Version 2.1.2 | |
| PyYAML | PyYAMLプロジェクト、pyyaml.org | バージョン 6.0.1 | |
| scikit-learn | scikit-learn 開発者、scikit-learn.org | バージョン 1.3.2 | |
| SciPy | SciPy開発者、scipy.org | バージョン 1.11.4 | |
| ソースコードリポジトリ | 原稿とともに提出された補完ソースコードアーカイブ | 衣類トポロジープロトコル、バージョン1.0 | |
| 保存装置 | サムスン電子 | Samsung 990 PRO NVMe SSD, 2 TB | |
| システムメモリ | Kingston Technology | Kingston FURY Beast DDR5, 64 GB, 2 × 32 GB, 5600 MHz | |
| torchvision | PyTorch Foundation, pytorch.org | CUDA 11.8対応 バージョン 0.16.2 | |
| ワークステーション | カスタム構築のディープラーニング用ワークステーション | Intel Core i9-13900K、NVIDIA GeForce RTX 4090、64 GBメモリ、2 TB NVMe SSD |
参考文献
- Xiang Z, Zhu C, Qian M, Shen Y, Shao Y. FashionSegNet: a model for high-precision semantic segmentation of clothing images. Vis Comput. 2024;40:1711-1727. doi:10.1007/s00371-023-02881-3.
- Sun K, Zhang J, Zhang P, Yuan K, Li G. TsrNet: a two-stage unsupervised approach for clothing region-specific textures style transfer. J Vis Commun Image Represent. 2023;91:103778. doi:10.1016/j.jvcir.2023.103778.
- Yang N, Ma X. Enhanced composed fashion image retrieval with a multi-hop reasoning framework. Sci Rep. 2025;15:32217. doi:10.1038/s41598-025-17402-6.
- Karthika Priya D, Sathyabama B. FARE-RNET: fashion cloth retrieval via Egret Swarm Optimization-based Convolutional Attention Module integrated ResNet. Int J Comput Intell Syst. 2026;19:29. doi:10.1007/s44196-025-00979-1.
- Köktürk Güzel BE. Efficient image retrieval in fashion: leveraging clustering and principal component analysis for search space reduction. Erzincan Univ J Sci Technol. 2024;17:638-649. doi:10.18185/erzifbed.1500279.
- Zhang X, Sun H, Ma J. Research on clothing image retrieval combining topology features with color texture features. Mathematics. 2024;12:2363. doi:10.3390/math12152363.
- Abbas W, Zhang Z, Asim M, Chen J, Ahmad S. AI-driven precision clothing classification: revolutionizing online fashion retailing with hybrid two-objective learning. Information. 2024;15:196. doi:10.3390/info15040196.
- Shirkhani S, Mokayed H, Saini R, Hum YC. Study of AI-driven fashion recommender systems. SN Comput Sci. 2023;4:514. doi:10.1007/s42979-023-01932-9.
- Balloni E, Pietrini R, Frontoni E, Mancini A, Paolanti M. OutfitAI: shop the outfit with a deep learning-based intelligent expert system. Multimed Tools Appl. 2025;84:40195-40214. doi:10.1007/s11042-025-20753-x.
- Kachbal I, El Abdellaoui S. Computer vision for fashion: a systematic review of design generation, simulation, and personalized recommendations. Information. 2026;17:11. doi:10.3390/info17010011.
- Saranya MS, Geetha P. Cross-domain fashion cloth retrieval via novel attention-guided cascade neural network and clothing parsing. Comput Vis Image Underst. 2023;235:103777. doi:10.1016/j.cviu.2023.103777.
- Ning T, Gao Y, Han Y. Segmentation of ethnic clothing patterns with fusion of multiple attention mechanisms. Complex Intell Syst. 2024;10:5759-5770. doi:10.1007/s40747-024-01457-5.
- Jiang A, Liu L, Fu X, Liu L, Peng W. Clothing hierarchical feature representation and association learning for cross-modal fashion retrieval. J Comput Aided Des Comput Graph. 2025;37:654-667. doi:10.3724/SP.J.1089.2023-00263.
- An H, Lee KY, Choi Y, Park M. Conceptual framework of hybrid style in fashion image datasets for machine learning. Fash Text. 2023;10:18. doi:10.1186/s40691-023-00338-8.
- Adel M, Mohammed AM, Elsaid AH, Abdelatey A. Deep learning for new fashion product demand prediction: integrating visual similarity and demand correction in cold-start scenarios. Int J Data Sci Anal. 2026;22:9. doi:10.1007/s41060-025-00888-8.
- Tang Y, Ye D, Tao F, Du G. Enhanced group relation learning via aligned attention masking for fashion product captioning. J King Saud Univ Comput Inf Sci. 2025;37:170. doi:10.1007/s44443-025-00195-z.
- Lyu X, Li X, Zhang Y, Lu W. Two-stage method for clothing feature detection. Big Data Cogn Comput. 2024;8:35. doi:10.3390/bdcc8040035.
- Tang G, Yu F, Li H, Shi Y, Liu L, Peng T, et al. ClothSeg: semantic segmentation network with feature projection for clothing parsing. J Vis Commun Image Represent. 2023;97:103980. doi:10.1016/j.jvcir.2023.103980.
- Cao S, Chai W, Hao S, Zhang Y, Chen H, Wang G. DiffFashion: reference-based fashion design with structure-aware transfer by diffusion models. IEEE Trans Multimedia. 2024;26:3962-3975. doi:10.1109/TMM.2023.3318297.
- Hou J, Lu Y, Yang Y, Liu Z. PDN: a priori dictionary network for fashion parsing. Appl Sci. 2024;14:3509. doi:10.3390/app14083509.
- Moratelli N, Barraco M, Morelli D, Cornia M, Baraldi L, Cucchiara R. Fashion-oriented image captioning with external knowledge retrieval and fully attentive gates. Sensors. 2023;23:1286. doi:10.3390/s23031286.
- Islam T, Miron A, Liu X, Li Y. Deep learning in virtual try-on: a comprehensive survey. IEEE Access. 2024;12:29475-29502. doi:10.1109/ACCESS.2024.3368612.
- Yan H, Zhang H, Liu L, Zhou D, Xu X, Zhang Z, et al. Toward intelligent design: an AI-based fashion designer using generative adversarial networks aided by sketch and rendering generators. IEEE Trans Multimedia. 2023;25:2323-2338. doi:10.1109/TMM.2022.3146010.
- Xie Z, Zhou Z, Wang Z, Ding H, Ma L. Multi-scale spatial feature-guided cloth landmark estimation. J Comput Aided Des Comput Graph. 2022;34:1763-1771. doi:10.3724/SP.J.1089.2022.19189.
- Jiang J, Wu D, Deng H, Long Y, Tang W, Li X, et al. HAIGEN: towards human-AI collaboration for facilitating creativity and style generation in fashion design. Proc ACM Interact Mob Wearable Ubiquitous Technol. 2024;8:107. doi:10.1145/3678518.
- Danner M, Brake E, Kosel G, Kyosev Y, Rose K, Rätsch M, et al. AI-assisted pattern generator for garment design. Commun Dev Assem Text Prod. 2024;5:195-206. doi:10.25367/cdatp.2024.5.p195-206.
- Bao C, Zhang X, Chen J, Miao Y. MMFL-net: multi-scale and multi-granularity feature learning for cross-domain fashion retrieval. Multimed Tools Appl. 2023;82:37905-37937. doi:10.1007/s11042-022-13648-8.
- Yang G. Clothing design style recommendation using optimized semantic-preserved generative adversarial network. J Electr Syst. 2024;20 Suppl 3:2396-2409. doi:10.52783/jes.3064.
- Wang Z, Tao X, Zeng X, Xing Y, Xu Z, Bruniaux P. Design of customized garments towards sustainable fashion using 3D digital simulation and machine learning-supported human-product interactions. Int J Comput Intell Syst. 2023;16:16. doi:10.1007/s44196-023-00189-7.
- Wu J, Huang Y, Gao M, Gao Z, Zhao J, Zhang H, et al. A two-stream hybrid convolution-transformer network architecture for clothing-change person re-identification. IEEE Trans Multimedia. 2024;26:5326-5339. doi:10.1109/TMM.2023.3331569.
- Khalid M, Keming M, Hussain T. Design and implementation of clothing fashion style recommendation system using deep learning. Rom J Inf Technol Autom Control. 2021;31:123-136. doi:10.33436/v31i4y202110.
- Wang Y, Liu L, Fu X, Liu L. MCCP: multi-modal fashion compatibility and conditional preference model for personalized clothing recommendation. Multimed Tools Appl. 2024;83:9621-9645. doi:10.1007/s11042-023-15659-5.
- Ma J, Sun H, Yang D, Zhang H. Personalized fashion recommendations for diverse body shapes and local preferences with contrastive multimodal cross-attention network. ACM Trans Intell Syst Technol. 2024;15:82. doi:10.1145/3637217.
- Yu Z, Zhao Y, Hong B, Jin Z, Huang J, Cai D, et al. Apparel-invariant feature learning for person re-identification. IEEE Trans Multimedia. 2022;24:4482-4492. doi:10.1109/TMM.2021.3119133.
- Peng D, Liu R, Lu J, Zhang S. Unsupervised multi-modal modeling of fashion styles with visual attributes. Appl Soft Comput. 2022;115:108214. doi:10.1016/j.asoc.2021.108214.
- Mathews A, Sejal N, Venugopal KR. Analysis of content based image retrieval using deep feature extraction and similarity matching. Int J Adv Comput Sci Appl. 2022;13:646-655. doi:10.14569/IJACSA.2022.0131277.
- Zhang C, Ji X, Cai L. Clothing recommendation with multimodal feature fusion: price sensitivity and personalization optimization. Appl Sci. 2025;15:4591. doi:10.3390/app15084591.
- Zhao M, Gao S, Ma J, Zhang Z. Joint clothes image detection and search via anchor-free framework. Neural Netw. 2022;155:84-94. doi:10.1016/j.neunet.2022.08.011.
- Fontanini T, Ferrari C. Would your clothes look good on me? Towards transferring clothing styles with adaptive instance normalization. Sensors. 2022;22:5002. doi:10.3390/s22135002.
- Kim S, Moon H, Oh J, Lee Y, Kwon H, Kim S. Automatic measurements of garment sizes using computer vision deep learning models and point cloud data. Appl Sci. 2022;12:5286. doi:10.3390/app12105286.
- Chang YH, Zhang YY. Deep learning for clothing style recognition using YOLOv5. Micromachines. 2022;13:1678. doi:10.3390/mi13101678.
- de Medeiros Dantas IJ, Curth M, Freire AG. Exploring databases for training models in machine learning in the fashion industry. DAT J. 2024;9:157-174. doi:10.29147/datjournal.v9i2.877.
- Zhu S, Zou X, Qian J, Wong WK. Learning structured relation embeddings for fine-grained fashion attribute recognition. IEEE Trans Multimedia. 2024;26:1652-1664. doi:10.1109/TMM.2023.3284593.