本研究では、MetaFormerによる特徴抽出と、融合前のクロスモーダルアライメントのための双方向フローマッチングを用いた、ハイパースペクトルおよびLiDARによる土地被覆分類の2段階フレームワークを提示します。3つの公開ベンチマークデータセットによる評価の結果、固定されたベンチマークプロトコルの下で競争力のある分類性能が実証されました。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
マルチモーダルリモートセンシング分類は、都市マッピングや環境モニタリングなどのアプリケーションにおいて重要な役割を果たしています。しかし、センシングモダリティ間での不均一な特徴分布は、特徴のミスマッチや意味的な不整合を引き起こし、マルチモーダル融合の有効性を制限する可能性があります。畳み込み、グラフベース、アテンションベース、対照学習、輸送指向、およびシーケンスベースの手法を含む既存のマルチモーダル融合アプローチは、相補的な情報を活用できますが、モダリティ固有の特徴分布を十分に整合させられない場合があります。本研究では、マルチモーダルフローマッチングを通じてこの課題に対処する2段階のマルチモーダル分類フレームワークであるFlowErsを提案します。本研究の作業仮説は、特徴融合の前にペアとなる特徴分布の相違を低減させることで、固定されたベンチマークプロトコル下での土地被覆分類が改善されるというものです。第1段階では、モダリティ固有のMetaFormerエンコーダーが、ハイパースペクトルイメージング(HSI)および光検出および測距(LiDAR)データから階層的な表現を抽出します。次に、マルチモーダルフローマッチングモジュールが、双方向平均二乗誤差目的関数を用いて、ペアとなる特徴分布を共有潜在表現へと輸送するための時間条件付き速度場を学習します。第2段階では、事前学習済みの整合モジュールを再利用してマルチモーダル表現を整合させた後、軽量な融合ヘッドがピクセル単位の分類を行います。3つの公開ベンチマークデータセットによる評価の結果、固定ベンチマーク分割において最大97.56%の全体正解率(OA)が実証されました。性能は個々の土地被覆クラスによって異なり、本研究ではクラス固有の限界およびクラス不均衡が集計指標に与える影響について議論します。現在の評価は、反復実行による統計分析や計算プロファイリングを伴わない固定分割実験に限定されています。今後の課題として、統計的堅牢性、計算効率、および地域間汎化性能について調査します。
概要
リモートセンシング画像を用いた精密な土地利用・土地被覆(LULC)分類は、都市開発、環境モニタリング、災害管理、持続可能な開発など、幅広い実世界でのアプリケーションにおいて不可欠です1。近年、ハイパースペクトル画像(HSI)、光検出および測距(LiDAR)、合成開口レーダー(SAR)を含むマルチモーダル・リモートセンシングデータの利用可能性が高まっています。この利用可能性の向上により、詳細な土地被覆分類におけるリモートセンシングの能力が大幅に拡張されました2。これらのセンシングモダリティは、地表の異なる、かつ相補的な特性を捉えます。HSIは物質組成を特徴づけるための豊かな分光情報を提供し、一方でLiDARは正確な構造および標高情報を提供します3。これらの異種データソースを統合することで、単一のモダリティよりも識別力が高く、ノイズに強く、意味的に包括的な特徴表現を生成することが可能になります4。
それにもかかわらず、マルチモーダルデータを効果的に活用することは、依然として長年の課題となっている5。主な困難は、センシングモダリティ固有の不均一性に起因しており、空間解像度、ノイズ特性、統計分布、および特徴のセマンティクスがそれぞれ異なる6。例えば、同一の地被オブジェクトであっても、HSIでは高次元の分光シグネチャとして、LiDARでは希薄な幾何学的構造として表現される場合がある7。その結果、モダリティ固有の特徴はしばしば異なる特徴多様体上に存在することになり、直接的な特徴融合は非効率であるか、あるいは誤った結果を導く可能性がある。さらに、畳み込み、アテンション、およびTransformerベースの手法を含む多くの既存のマルチモーダル融合アプローチは、異なるセンサから抽出された特徴がすでに空間的およびセマンティックに整列していることを暗黙的に前提としている8。しかし、この前提は実際のアプリケーションでは有効でないことが多い。単純な特徴の結合やピクセル単位の融合では、クロスモーダルな不一致を十分に捉えることができず、最適化の不安定化や汎化性能の低下を招く可能性がある。また、アテンションベースの融合手法は特徴間の相互作用を改善するが、大規模または高解像度の地被分類に必要とされる長距離のクロスモーダル依存性のモデリングには限界がある可能性がある9。したがって、互換性のない埋め込みが相補的な情報の統合を制限し得るため、不均一な特徴表現の効果的なアライメントは、マルチモーダルリモートセンシングにおける主要な課題として残っている。
この課題に対処するため、クロスモーダルアライメントを条件付き特徴量輸送問題として定式化します。Flow matchingは、異種の特徴量分布間の連続的かつ可逆的なマッピングを学習するための、数学的根拠に基づいたフレームワークを提供します10。これは、常微分方程式(ODE)によってパラメータ化された時間依存速度場を通じて、ある分布を別の分布へと輸送し、それによって特徴量多様体間の連続的な変換を促進します11。確率的なノイズ摂動や敵対的学習による暗黙的な分布マッチングに依存する拡散ベースのモデルとは異なり、flow matchingは構造化された特徴量空間間の決定論的かつ双射的な変換を学習します12。これらの特性により、flow matchingは、HSI、LiDAR、SARがそれぞれ地球表面の相補的な特性を捉える高次元特徴量多様体を表すマルチモーダルリモートセンシングに適しています13。したがって、flow matchingは、特徴量アライメント中の幾何学的整合性を促進しつつ、連続的な特徴量輸送を通じてクロスモーダルな対応関係を確立するための原理的なアプローチを提供します。適切な正則性の仮定の下で、ODEフローは可逆的なマッピングを提供できますが、本研究では厳密な可逆性と物理的な解釈可能性についての経験的な評価は行っていません。本研究の作業仮説は、特徴量の融合前にペアとなる特徴量分布の不一致を減少させることで、固定されたベンチマーク分割における総合的な土地被覆分類が改善されるというものです。
これらの検討を踏まえ、提案されたフレームワークであるFlowErsは、2段階のアーキテクチャの中にフローベースのアライメント段階を組み込んでいます。第1段階では、各モダリティの特徴多様体をアライメントさせるために、双方向フローネットワークを学習させます。具体的には、モダリティ固有のMetaFormerバックボーンが階層的な特徴エンベディングを抽出し、フローマッチング目的関数を最適化することで、モダリティ固有の特徴分布間でサンプルを輸送します。このプロセスにより、特徴空間間に滑らかで可逆的な変換が提供され、同一のセマンティッククラスに属する表現が、共有潜在ドメイン内でより密接にアライメントされるよう促されます。第2段階では、事前学習済みのフローアライナーを凍結し、新しいマルチモーダル入力を変換した後、軽量な分類器によって融合させます。この分離された学習戦略により、幾何学的なアライメントとセマンティックな分類が切り離され、2つの段階で相補的な目的関数を最適化することが可能になります。アライメントモジュールは、特徴融合の前に特徴分布の不一致を低減することを目的としており、体積保存の保証が実証されたことを主張するものではありません。さらに、FlowErsはマルチモーダル融合のための明示的な特徴輸送定式化を提供していますが、レジストレーションエラーに対する堅牢性は本研究では個別に評価されていません。
本研究の主な貢献を以下にまとめる。まず、マルチモーダルな土地被覆分類のための2段階フレームワークとしてFlowErsを導入した。提案するフレームワークでは、まずMetaFormerエンコーダーを用いてモダリティ固有の特徴を抽出し、その後、軽量な特徴融合の前にフローベースのモジュールを通じてアライメントを行う。この分離された設計により、異なるセンシングモダリティ間での柔軟性を維持しつつ、効率的な最適化が可能となる。加えて、本研究ではマルチモーダルリモートセンシングにおけるペア同士のクロスモーダル特徴アライメントのための特徴輸送メカニズムとして、条件付きフローマッチングを調査した。双方向フローモジュールは、特徴融合の前にペアとなる特徴表現に対して相反する速度ターゲットを予測し、これによりマルチモーダル統合に先立つ明示的なアライメント戦略を提供する。さらに、提案したフレームワークを3つの公開ベンチマークデータセットで評価し、提供された固定ベンチマーク分割において最大97.56%の全体正解率(OA)を達成した。また、クラスレベルの限界および今回の評価範囲についても明記している。
フローマッチングの最近の進展により、拡散モデル、エネルギーベースモデル、および輸送ベースモデルを統合する強力な生成モデリングフレームワークとしての地位が確立されました。拡散モデルのように確率的な軌道をシミュレートするのではなく、フローマッチングでは、学習可能な速度場を通じて、ガウスノイズなどの単純な事前分布をターゲットとなるデータ分布へと輸送する決定論的なODE(常微分方程式)を学習します15。この定式化により、スコア推定と密度進化が直接的に関連付けられ、その結果、確率軌道がより滑らかになり、学習ダイナミクスがより安定します。フローマッチングの主な利点は、その決定論的かつ計算効率の高い定式化にあります。Rectified flowモデル16は、輸送軌道をほぼ直線的なパスへとさらに簡素化し、数値的安定性を向上させ、比較的少ない積分ステップで高品質なサンプル生成を可能にしました。整合性モデル(consistency models)17を含むその後の研究では、拡散モデルから着想を得た目的関数をコンパクトなフローベースのフレームワークに組み込むことで、効率的な推論を行いながら、同等またはそれ以上のサンプル品質を実現しています。加えて、フローベースの学習では事前学習済みの拡散モデルのバックボーンを活用できるため、サンプリングコストを抑えつつ、大規模な生成事前分布を利用することが容易になります。最近の研究では、フローマッチングが幅広いアプリケーションに拡張されています。例えば、Huら18は、フローマッチングを用いた制御可能で合成可能な画像編集のために、Transformerバックボーンと潜在空間操作について調査しました。その他のアプリケーションには、画像合成19、軸受の故障診断20、およびマルチターゲット・マルチシームのロボット溶接21が含まれます。総じて、これらの研究は、フローマッチングが高解像度かつ条件付きの画像合成を超えて適用可能であること、またドメイン汎化の可能性を秘めた確立された理論的基盤を提供していることを示しています。連続的で決定論的な輸送マップを学習することで、フローマッチングは効率性、制御可能性、および生成忠実度のバランスを実現します。そのODEベースの定式化は、現代的な生成モデリングに対する統合的な視点を提供し、マルチモーダルデータ表現や特徴アライメントを伴うアプリケーションのための理論的基礎となります。
マルチモーダルリモートセンシング分類は、HSI(ハイパースペクトル画像)、マルチスペクトル画像、LiDAR、およびSARからの相補的な情報を統合することで、個別のセンシングモダリティの限界を克服することを目指しています。初期のフュージョン手法は、手作業で設計された特徴量やサポートベクターマシン(SVM)などのカーネルベースのアルゴリズムに依存していましたが、高次元性や不十分なクロスモーダル相互作用によって制限されていました22。ディープラーニングの進展により、早期フュージョン、中間フュージョン、後期フュージョンを含む構造化されたフュージョン戦略が可能となり、中でも特徴レベルのフュージョンは、情報の統合と計算コストのバランスを実用的に維持できる手法となっています23。畳み込みニューラルネットワーク(CNN)は局所的な空間・分光情報を効果的に抽出できる一方、Transformerベースのアーキテクチャは、計算コストは高いものの長距離の依存関係をモデル化できます24。その結果、両アプローチの相補的な強みを組み合わせたハイブリッドCNN-Transformerアーキテクチャがますます普及しています。代表的な例としては、クロススケール相互作用を通じてコンテキスト情報を強化する隣接スケールフュージョン法25や、適応的アテンションメカニズムを用いて浅いCNN特徴量と深いTransformer表現を組み合わせるマルチレベルフレームワーク26などが挙げられます。総じて、これらの研究は、特徴量の冗長性を排除しセマンティック表現を向上させるために、効果的なクロススケールおよびクロスモーダル相互作用が重要であることを強調しています。
近年の開発では、マルチモーダル学習のための相補的な戦略も模索されています。例えば、エビングハウスの忘却曲線に導かれたフレームワークなどの低ランク表現手法は、冗長な情報を抑制しつつ多様体構造を維持することで、過学習を低減します27。並行して、実用的なアプリケーションにおけるプライバシーと通信の制約に対処するため、分散型マルチモーダル学習が研究されています。例えば、FedFusionは浅い特徴量を低ランク部分空間に投影することで、連合マルチモーダル学習を可能にします28。総じて、これらの研究は3つの相補的な研究方向を示しています。すなわち、局所的および大域的な特徴モデリングをバランスさせるためのハイブリッドCNN–Transformerアーキテクチャ、冗長性とノイズを低減するための低ランク学習、そしてスケーラブルでプライバシーを保護する展開のための分散学習です。それにもかかわらず、モダリティの不均衡、ラベル付きデータの可用性の制限、モデル圧縮と分類精度のトレードオフなど、重要な課題が依然として残っています。これらの課題が、軽量で汎用性の高いマルチモーダル融合フレームワークへの継続的な研究を促してきました。近年のマルチモーダルアライメント手法では、クロスモーダルアテンション、対照学習、グラフベース融合、ドメイン適応、および分布マッチング戦略も取り入れられています。対照的に、FlowErsはマルチモーダルアライメントをペアリングされた時間条件付き特徴輸送として定式化しており、既存の手法に代わる普遍的な代替策ではなく、相補的なアライメント戦略として提示されています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、リモートセンシングによる土地被覆分類のために、公開されているベンチマークデータセット(Houston2013、Augsburg、MUUFL)のみを使用しました。ヒトへの参加、動物実験、または新たに収集された生物学的試料は含まれていません。したがって、機関の倫理承認は不要でした。
研究概要
提案されたFlowErsフレームワークは、2段階の学習戦略を通じてマルチモーダルな土地被覆分類を行います。その全体的なワークフローは図1A–Cに示されています。このフレームワークは主に3つのコンポーネントで構成されています。(i) 異種センシングモダリティから階層的な特徴表現を抽出するMetaFormerベースのエンコーダ、(ii) モード間特徴分布を明示的に整合させるマルチモーダル・フローマッチング(MFM)モジュール、および (iii) 融合された特徴表現から土地被覆カテゴリーを予測する軽量な分類ヘッドです。全体のワークフローでは、まずモダリティ固有の特徴を抽出し、次に条件付きフローマッチングを通じて共有潜在空間内でこれらの特徴を整合させ、最終的に整合されたマルチモーダル表現を用いてピクセル単位の土地被覆分類を行います。
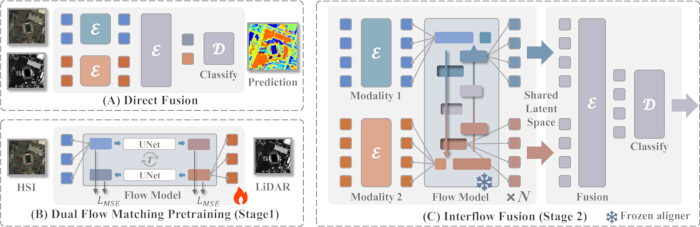
図1: 提案するマルチモーダル地被類分類のためのFlowErsフレームワークの概要。 (A) 従来の直接的な特徴融合。ハイパースペクトル画像 (HSI) および LiDAR データから抽出されたモダリティ固有の特徴を、分類前に直接連結する方法。 (B) ステージ1:双方向マルチモーダルフローマッチング事前学習。時間条件付き U-Net が、平均二乗誤差損失を用いて不均一な特徴分布を整列させ、モダリティ固有の特徴表現間の連続的な双方向特徴輸送を学習する。 (C) ステージ2:インターフロー融合。事前学習済みのフローマッチングモジュールを凍結して再利用し、軽量な特徴融合およびピクセル単位の地被類分類の前に、モダリティ固有の特徴表現を整列させる。 E:エンコーダ、 D:デコーダ、 T:時間埋め込み、平均二乗誤差損失、 S:共有潜在表現。 こちらのリンクをクリックして、この図の拡大版を表示してください。
提案されたフレームワークでは、2段階のトレーニング戦略を通じて、特徴量のアライメントと意味論的な分類を分離しています。第1段階では、モダリティ固有の特徴量多様体間の双方向特徴量転送を学習させるために、MFMモジュールをトレーニングします。第2段階では、事前学習済みのフローアライメントモジュールを固定して再利用し、軽量な特徴量融合および分類を行う前に、マルチモーダルな特徴量表現のアライメントを行います。このデカップリング設計により、アライメントモジュールと分類ネットワークが相補的な目的関数を最適化することが可能になり、マルチモーダル融合前の特徴量分布の不一致を低減できます。
理論的概要
フローマッチングは、2つの確率分布間の連続的な決定論的変換を学習する、近年提案された生成モデリングのパラダイムです。ノイズ摂動を通じて確率性を導入する拡散ベースのモデルとは異なり、フローマッチングは、ある確率分布を別の確率分布へと連続的に輸送する学習可能な速度場を直接パラメータ化します。この連続輸送の定式化により、ODE(常微分方程式)を介した特徴量のアライメントが可能となり、異なるセンシングモダリティからのペアとなる特徴表現を、特徴融合の前に共有の軌道に沿って進化させることができます。本研究では、MetaFormerエンコーダによって抽出されたモダリティ固有の埋め込み間の双方向的な特徴輸送を学習するために、条件付きフローマッチングを採用しています。モデルは、補間された特徴表現における予測速度場とターゲット速度場の差を最小化する条件付きフローマッチング目的関数を用いて学習されます。完全な数学的定式化、理論的導出、支配方程式、および学習目的関数は、Supplementary File 1に記載されています。
問題の定式化
マルチモーダルリモートセンシングデータを用いた土地被覆分類では、HSIやLiDARなどの異種センシングモダリティから意味的表現を学習させることが必要となります。これらのモダリティは、それぞれ異なるセンシング特性を有しています。HSIは数百のチャンネルを持つ豊かな分光情報を取得しますが( )、一方でLiDARは比較的少ないチャンネルで詳細な構造情報を提供します(
 )。分光情報の豊かさと構造情報の希薄さというこの不均衡は、特徴分布において大きなドメインギャップを生じさせ、単純な特徴融合では最適ではなく、潜在的に不安定になる可能性があります。
形式的に、マルチモーダル入力のペアが与えられたとき、 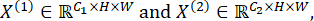 、目的は式 1に従ってピクセル単位のセマンティックマップを予測することである。
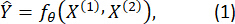
ここで、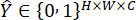 はワンホットエンコードされたラベルテンソルであり、C は地表被覆カテゴリの総数を、θはすべての学習可能なモデルパラメータを表します。Houston2013データセットの画像サイズは349 × 1905ピクセルで、144のハイパースペクトル(HSI)バンドと1つのLiDARバンドで構成されています。Augsburgデータセットの画像サイズは1152 × 480ピクセルで、224のHSIバンドと1つのLiDARバンドで構成されています。MUUFLデータセットの画像サイズは325 × 220ピクセルで、64のHSIバンドと2つのLiDARバンドで構成されています。すべてのデータセットにおいて、入力画像パッチはトレーニング前に32 × 32ピクセルにリサイズされました。
従来のマルチモーダルアプローチでは、連結やアテンションメカニズムを通じてモダリティ固有の特徴を融合させており、異なるモダリティが互換性のある特徴空間に存在することを暗黙的に前提としています。しかし、リモートセンシングデータにおいては、モダリティ固有の統計分布や空間・分光特性が大幅に異なるため、この前提が成り立つことはほとんどありません。
この不一致を明確に解消するために、フローマッチングモジュール を導入する。このモジュールは
 によってパラメータ化され、モダリティ固有の特徴多様体間の連続的な双方向変換を学習する。具体的には(式 2)、
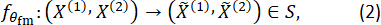
ここで、Sはモダリティ固有の特徴表現が幾何学的に整列される共有潜在空間を表します。その後、整列された特徴表現は融合され、式 3に従って次のように分類されます:
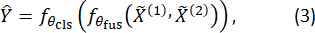
ここでは、 および
 は、それぞれ特徴融合モジュールと分類モジュールを表します。この定式化により、FlowErsフレームワーク全体が定義されます。提案されたフレームワークは、単に暗黙的な統計的特徴融合に頼るのではなく、マルチモーダルな特徴融合と意味論的予測の前に、モダリティ固有の特徴表現を共有潜在空間へと継続的に輸送する、明示的なフローベースの整合メカニズムを導入しています。
MetaFormerエンコーダー
FlowErsは、各センシングモダリティから有益かつ幾何学的に一貫した特徴表現を学習する軽量なモダリティ固有のエンコーダを用いて、クロスモーダル特徴アライメントを実行します。図2に示すように、各モダリティはMetaFormerアーキテクチャに基づく独立したエンコーダによって処理されます。MetaFormerは、セルフアテンションを明示的に計算することなく、トークンミキシングとチャネル変換を分離することで、基本的なTransformer設計を汎用化しています。この設計により、高次元のHSIの効率的な処理が可能になると同時に、LiDARのような低チャネルのモダリティへの適応性も維持されています。
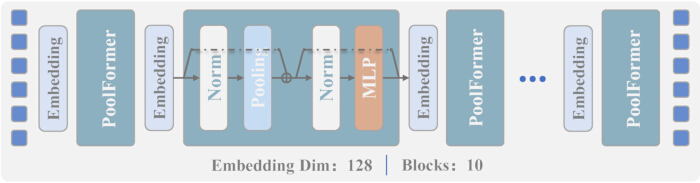
図 2: 提案されたFlowErsフレームワークで使用される、モダリティ固有のMetaFormerエンコーダーのアーキテクチャ。 エンコーダーは、embeddingブロックとPoolFormerブロックを繰り返し適用することで、モダリティ固有の入力を階層的な特徴表現に変換します。各PoolFormerブロックは、正規化、プーリングベースのトークンミキシング、残差加算、正規化、および多層パーセプトロン(MLP)で構成されています。得られた階層的な特徴表現は、クロスモダリティの特徴アライメントのためにマルチモーダルフローマッチングモジュールに転送されます。Norm:正規化、MLP:多層パーセプトロン。 こちらのリンクから、この図の拡大版をご覧いただけます。
各モダリティ  に対して、MetaFormer エンコーダ
 、 は、入力
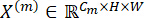 を潜在特徴表現の階層(式 4)へと変換します。
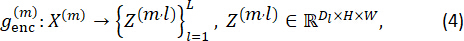
ここで、Lはエンコーダステージの総数を表し、Dlはステージlにおける埋め込み次元を表します。MetaFormerエンコーダは3つのステージ(N = 3)で構成され、埋め込み次元はそれぞれ64、128、256です。各ステージにおけるPoolFormerブロックの数は、原稿に記載されている漸進的な階層構造に従い、それぞれ2、6、2となります。
各エンコーダーは1から始まります。 × 入力チャネルを共通の埋め込み空間に投影する1つの畳み込み(式 5):
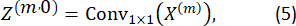
この投影層の後に、L個のMetaFormerブロックが積層されます。各ブロックは2つの残差演算で構成されています。(i) コンテキスト情報を集約するための空間プーリングによるトークンミキシング、および (ii) 分光空間的な特徴表現を精緻化するための多層パーセプトロン(MLP)によるチャネル変換です。これらの演算は、式6および式7を用いて次のように表されます。
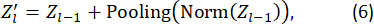

ここで、Pooling(·)は平均プーリングに基づく空間コンテキスト集約を表し、MLP(·)はGELU活性化関数とドロップアウト正則化を組み込んだ2層の畳み込みフィードフォワードネットワークを表します。
エンコーダーは、連続するステージを通じて埋め込み次元が段階的に増加する階層構造を採用しています(例:64  128 256)。この漸進的な設計により、深い層ほどより豊かな空間・スペクトル情報をエンコードすることが可能になり、学習された特徴の表現能力が向上します。実装には、3 × 3 のプーリングカーネル、128 の MLP 隠れ次元、および 0.1 のドロップアウト率を使用しています。MetaFormer エンコーダー内のすべての畳み込み層は、ストライド 1、パディングなしの 1 × 1 カーネルを使用しています。プーリング演算子には、ストライド 1、パディング 1 の 3 × 3 平均プーリングを使用しています。エンコーダー全体にバッチ正規化(BatchNorm2d)が適用されています。MLP は隠れ次元 128 を持ち、活性化関数として GELU を採用し、ドロップアウト率は 0.1 としています。3 つのエンコーダーステージには、それぞれ 2、6、2 個の PoolFormer ブロックが含まれており、これらのアーキテクチャ設定はすべてのステージに一貫して適用されています。
Transformerベースのエンコーダーと比較して、MetaFormerエンコーダーは、セルフアテンションに伴う2次計算コストを排除し、特徴抽出時のモダリティ特有のバイアスを低減します。そのプーリングベースのトークンミキサーは局所的な空間コンテキストを効率的に集約し、その後のクロスモーダルアライメントはフローマッチングモジュールによって行われます。その結果、エンコーダーによって生成される最高レベルの特徴表現は、マルチモーダル特徴アライメントに向けて、意味的に有益で幾何学的に一貫した入力を提供します。
マルチモーダル・フローマッチング
特徴抽出後の主な課題は、異なる特徴多様体上に存在する、異なるセンシングモダリティに由来する異種の特徴表現をアライメントすることです。 と
 を直接連結させた場合、特徴分布の不一致やモダリティ固有のバイアスのため、性能が低下することが多くあります。FlowErsでは、図 1Bに概念的に示されているように、2つの特徴空間間の連続的な双方向変換を学習するMFMモジュールを導入することで、この課題に明示的に対処しています。
MetaFormerエンコーダーによって抽出された特徴表現を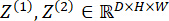 とします。補間時間
 によってパラメータ化された連続フロー場を、式 8を用いて次のように定義します:
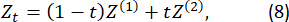
ここで、t = 0 はソースモダリティに、t = 1 はターゲットモダリティに対応します。
フローマッチングモデルは、 時間条件付きU-Netとして実装されており、この補間軌道に沿った変換を制御する瞬時速度場を予測します。各フロー予測器は、3つのダウンサンプリングブロック(64 128 256 512) および、それらに対応する3つのアップサンプリングブロック (512 256 128 64) 3を使用して × 3回の畳み込み、バッチ正規化、および整流線形ユニット(ReLU)活性化関数で構成される。中間時間埋め込みの次元数は、それぞれ128、256、512、256、128である。時間埋め込みには、固定された正弦波状の位置エンコーディングを使用する。ODE積分は、固定ステップサイズの前向オイラー法を用いて行われる。学習時の積分ステップ数は6に設定され、一方、推論時はデフォルトで5ステップの積分が用いられた。実際の積分ループの反復回数は、以下のように計算される。 
予測速度場は次式で与えられる。 式9 翻訳対象のテキストを提供してください。
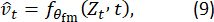
ここで、 は予測された瞬時速度を示します。モデルは変位
 を近似するように学習し、それによってモダリティ固有の特徴空間間の連続的な変換を促進します。学習目的は、以下のように時間条件付き双方向平均二乗誤差(MSE)損失として定式化されます(式 10)。
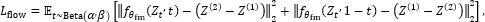 (10)
指定されたベータ分布からt をサンプリングすることで、モデルを中間補間状態にさらすことができるが、厳密なサイクル一貫性が確立されるわけではない。拡散ベースのアライメント手法とは異なり、提案されたフローマッチング定式化は決定論的であり、推論時の確率的サンプリングを必要とせず、ラベル付きデータとラベルなしデータの両方を用いて学習することが可能である。
学習済みフローモデルは、その後、モダリティ固有の特徴表現を共有潜在空間 S に投影する決定論的なアライメント演算子として機能します。アライメント済み表現は、次のように得られます(式 11):
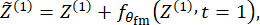
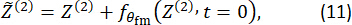
ここでは、  および
 は、アライメント済みの特徴表現を示しています。フローベースのアライメントは、最初の2つのエンコーダステージ(ステージ1および2)からの中間特徴表現に適用され、埋め込み次元はそれぞれ 64 および 128 です。最高レベルのエンコーダ特徴(ステージ3、埋め込み次元 256)は、フローマッチングモジュールでは処理されません。代わりに、これらの特徴は直接結合され、マルチモーダル予測のために分類器に渡されます。
この双方向アライメント機構は、連続的なフローフィールドを通じて、モダリティ固有の特徴表現を共有潜在空間へと段階的に輸送します。その結果、マルチモーダル特徴融合の前に、およびがより密接にアライメントされ、後続の分類に向けた意味的に一貫し、幾何学的に互換性のある特徴表現が提供されます。
トレーニングパイプライン
FlowErsは、図1(B,C)に示す2段階のトレーニング戦略を通じて、ラベル付きデータとラベルなしデータの両方を活用しつつ、安定したクロスモーダルアライメントを維持します。第1段階では、教師なしフローマッチングを通じて、モダリティ不変アライメントモジュールを学習させます。第2段階では、事前学習済みのフローアライメントモジュールを再利用しながら、アライメントされた潜在表現を用いて教師あり分類を行います。
ステージ1: 教師なしフロー事前学習
マルチモーダル画像ペアが与えられたとき、 モダリティ固有の特徴表現
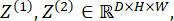 をMetaFormerエンコーダーを用いて抽出します。中間特徴表現は、式 8で定義される補間を用いて生成されます。ここで、
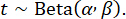 フローマッチングモジュール
 は、クラスラベルを使用せずに、式 10で定義される双方向時間条件付き目的関数を最小化することで最適化されます。この段階では、フローマッチングパラメータ
 のみが更新され、教師あり分類の前に、ラベル付きおよびラベルなしの両方のサンプルから幾何学的整合性を考慮した対応関係をモデルが学習することを可能にします。ステージ1(フローマッチング事前学習)は、AdamWオプティマイザを用い、学習率 1 × 10⁻4、ウェイトディケイ 1 × 10⁻2、およびコサインアニーリング学習率スケジューラを使用して実施されました。バッチサイズは、Houston2013およびTrentoデータセットでは16、AugsburgおよびMUUFLデータセットでは32を使用しました。フローマッチングモジュールは、ラベル付きおよびラベルなしの両方のサンプルを用いて2,000エポックの間事前学習されました。乱数シードは3407に固定されました。すべての実験は、単一のNVIDIA A100 GPU(80 GBメモリ)上のPyTorchを用いて実施されました。
ステージ 2: 共有アライナーを用いた教師あり分類
学習済みフローマッチングモジュールは教師あり学習中に再利用され、すべての特徴レベルではなく、最初の2つのエンコーダステージに適用される。整列された特徴表現は、その後、分類ヘッドを用いて融合され、ピクセルごとの予測が生成される。教師あり最適化では、マスク付きクロスエントロピー損失(式12):
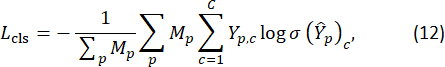
ここで、Mはラベルマスクを、Yはワンホットエンコードされた正解ラベルを、 σ(·)はソフトマックス関数を表します。ステージ2(教師あり学習)では、事前学習済みのフローマッチングモジュールは完全に凍結されたままであり、固定されたクロスモーダルアライメントオペレーターとして機能しました。事前学習済みの重みはステージ2の開始時にロードされ、教師あり学習中は更新されませんでした。最適化されたのはMetaFormerエンコーダと分類器のパラメータのみです。教師あり学習はAdamWオプティマイザを用いて行われ、データセット固有の学習率は、1 × 10⁻4 (Houston2013)、1 × 10⁻3 (Augsburg)、1 × 10⁻2 (MUUFL)、1 × 10⁻5 (Trento)としました。ウェイトディケイは、MUUFLでは5 × 10⁻2、それ以外のすべてのデータセットでは1 × 10⁻2に設定しました。バッチサイズはデータセットに応じて16または32を採用しました。モデルは、コサインアニーリング学習率スケジューラを用いて、100エポック (Houston2013およびMUUFL)、200エポック (Augsburg)、20エポック (Trento)学習させました。損失関数には、平均リダクションを用いたCrossEntropyLossを使用しました。早期終了は適用せず、代わりにテストセットで最高の全体正解率 (OA)を達成したモデルチェックポイントを最終モデルとして選択しました。2段階学習手順の完全な実装ワークフローは、補足ファイル S1 (Algorithm S1)にまとめられています。
この分離トレーニング戦略では、幾何学的アライメントと意味的識別のプロセスが切り離されています。ステージ1では、モデルはフローマッチング目的関数を用いて、連続的な双方向特徴写像を学習します。ステージ2では、事前学習済みのアライメントモジュールが、マルチモーダル特徴融合の前段階として共通の特徴輸送操作を提供し、同時に分類ネットワークがアライメント済み潜在空間からクラス識別的な表現を学習します。事前学習済みアライナーを再利用することで、融合前の整合した特徴アライメントが促進されますが、これが汎化性能の向上を独立して保証するものとして提示されているわけではありません。
実験データセット
提案されたフレームワークは、3つの代表的なマルチモーダルリモートセンシングベンチマークデータセットであるHouston201329、Augsburg30、およびMUUFL31を用いて評価されました。
Houston2013データセットは、IEEE GRSS Data Fusion Contestの一環として公開されました。これは米国ヒューストンの多様な都市景観を表しており、住宅地、道路、植生、水域など、15の土地被覆クラスが含まれています。このデータセットには、可視光から近赤外線スペクトルにわたる144の分光バンドを持つHSIと、空間解像度2.5 mのシングルバンドLiDAR由来デジタル表面モデル(DSM)が含まれています。複雑な都市のテクスチャと、クラス内における分光特性の大きな変動により、このデータセットを用いた正確な土地被覆分類は困難な課題となっています。
Augsburgデータセットは、ドイツの密集した市街地で取得されました。このデータセットは、400–1000 nmの波長範囲をカバーする224のスペクトルバンドを持つハイパースペクトル画像と、位置合わせ済みのLiDAR標高データで構成されています。データセットには、建造物、裸地、アスファルト、植生、影など、空間分解能2 mでアノテーションされた17種類の土地被覆クラスが含まれています。Houston2013と比較して、Augsburgはより強いスペクトル相関と高いクラス多様性を示しており、クロスモーダルな特徴アライメントおよび汎化性能を評価するための困難なベンチマークとなります。
MUUFL Gulfportデータセットは大学キャンパス内で収集されたものであり、豊かな植生と小規模な人工構造物が混在する準都市環境を表しています。このデータセットには、ノイズ除去済みの64バンドハイパースペクトル画像と、標高および強度情報からなるデュアルバンドLiDAR計測値が含まれています。また、11種類の土地被覆クラスが含まれており、微細な空間的詳細、混合画素、および多様な照明条件が見られるため、小物体分類に向けたマルチモーダル特徴融合の評価に適しています。
これら3つのベンチマークデータセットを合わせることで、空間解像度(1–2.5 m)、分光次元数(64–224 バンド)、シーンの複雑さ、および土地被覆組成における大幅な変動を網羅しています。その結果、マルチモーダル土地被覆分類手法の有効性と汎用性を評価するための多様なベンチマークが提供されます。各データセットの主な特性はTable 1にまとめられています。3つのデータセットすべてにおける訓練/テストの分割は、元のデータ提供者が提供した公式のベンチマーク分割に対応しています。具体的には、Houston2013データセットでは、2013 IEEE GRSS Data Fusion Contestの公式分割を使用しており、訓練サンプル2,832個、テストサンプル12,197個で構成されています。Augsburgデータセットでは、公式に提供されているmask_trainおよびmask_testアノテーションを使用し、訓練サンプル4,538個、テストサンプル47,896個を得ています。MUUFLデータセットでは、公式のtrain_test_gt.mat分割を使用しており、訓練サンプル28,645個、テストサンプル24,283個が含まれています。各データセットについて、ラベル付きピクセルを中心に32 × 32ピクセルの画像パッチを抽出し、個別の訓練またはテストサンプルとしました。追加のデータ分割やリサンプリングは行っていません。
| 特性 | Houston2013 | アウクスブルク | MUUFL |
| HSI画像サイズ(ピクセル) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| LiDAR画像サイズ(ピクセル) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| HSIスペクトルバンド | 144 | 224 | 64 |
| LiDARバンド | 1 | 1 | 2 |
| HSI波長範囲 | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| LiDAR波長範囲 | 該当なし | 該当なし | 該当なし |
| 空間分解能(HSI) | 2.5 m | 2.0 m | 0.54 m × 1.00 m |
| 空間分解能(LiDAR) | 2.5 m | 2.0 m | 0.60 m × 0.78 m |
| 土地被覆クラス数 | 15 | 17 | 11 |
表1: 評価に使用した3つのマルチモーダルリモートセンシングベンチマークデータセットの特性。 本表は、提案するFlowErsフレームワークの評価に使用したHouston2013、Augsburg、およびMUUFLベンチマークデータセットの画像次元、分光特性、空間分解能、および地表被覆クラス数をまとめたものである。
実装の詳細
FlowErsフレームワークはPyTorchで実装され、80 GBのメモリを備えたグラフィックスプロセッシングユニット(GPU)を用いて学習および評価が行われました。学習はバッチサイズ16で100エポック実施されました。オプティマイザにはAdamWを採用し、初期学習率を1 × 10⁻⁴、ウェイトディケイを1 × 10⁻²に設定しました。学習期間を通じて学習率を更新するため、コサインアニーリング学習率スケジューラを使用しました。モデルの汎化性能を向上させ、過学習を抑制するために、0.1のドロップアウト率を適用しました。教師あり最適化には、クロスエントロピー損失関数を使用しました。再現性を確保するため、すべての実験は固定ランダムシード3407を用いて初期化されました。提供された訓練/テスト分割データを使用し、別途検証用分割は作成しませんでした。各入力パッチは、学習前に32 × 32ピクセルにリサイズされました。データ拡張、明示的な画像レジストレーション補正、または追加のデータローダーによる正規化は適用していません。負のラベルに関連付けられたピクセルは、教師あり損失の計算から除外されました。欠損ピクセルまたはノイズの多いピクセルの処理に関する個別の評価は行っていません。
評価指標
分類性能を評価するために、広く採用されている3つの評価指標(OA、平均精度(AA)、およびKappa係数(k))を使用しました。OAは全サンプル中の正しく分類されたサンプルの割合を測定し、AAはすべての土地被覆クラスにおける平均分類精度を表し、Kappa係数は偶然の一致を考慮した後の予測分類とリファレンス分類の一致度を定量化します。これら3つの指標のすべての値が高いほど、分類性能が良いことを示します。表2–6に記載されているすべての値は、乱数シード3407を使用して得られた固定分割点推定値です。信頼区間、統計的有意性検定、またはp値は報告していません。
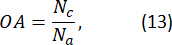
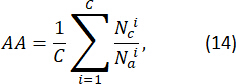
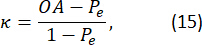
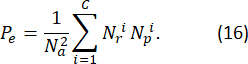
ここで、Nc およびNaは、それぞれ正しく分類されたサンプルの総数と評価されたサンプルの総数を示します。  および
 は、それぞれi番目のクラスにおける正しく分類されたサンプル数と全サンプル数を示します。Kappa係数の算出において、Pe は偶然に一致が生じる確率を示し、
 および
 は、それぞれi番目のクラスにおけるリファレンスサンプル数と予測サンプル数を示します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
提案されたFlowErsフレームワークの全体的な評価ワークフローを、以下に示します。 図1、2段階のマルチモーダル分類戦略をまとめたものである。MetaFormerエンコーダーに基づくモダリティ固有の特徴抽出プロセスは、に示されている。 図2、また、評価に使用した3つのベンチマークデータセットの主な特性を以下にまとめる。 表1その後、MUUFL、Houston2013、およびAugsburgのベンチマークデータセットを用い、OA、AA、およびKappa係数を用いて分類性能を評価した(κ)はプロトコルセクションで定義されています。
他手法との比較
提案したフレームワークを包括的に比較するため、いくつかのベンチマークマルチモーダル分類ネットワークを含めた。DFINet32は、深度方向クロス...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究では、2段階の学習戦略を通じてクロスモーダルな特徴アライメントと意味的分類を分離する、マルチモーダルリモートセンシングフレームワークであるFlowErsを提案します。提案するフレームワークでは、不均一なモダリティ固有の特徴を直接融合させるのではなく、マルチモーダル融合および分類の前に、条件付きフローマッチングを用いて特徴表現のアライメントを最初に行います。この設計は、HSIとLiDAR間の不均一な特徴分布という長年の課題に対処するものです。これらのセンシングメカニズムの違いは、従来の連結ベースまたはアテンションベースの融合戦略の有効性を制限することがよくあります23,26,35,36,37,38,
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
利益相反:
著者らは、利益相反がないことを宣言します。
謝辞
本研究は、陝西省自然科学基金プロジェクト(Shaanxi A)の助成を受けた。&F大学(助成番号:ZK25-38)および陝西省教育庁(助成番号:24JK0734)。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| AdamW オプティマイザ | PyTorch Foundation | PyTorch に同梱 | モデルの最適化に使用。PyTorch 2.5.0 を使用した。 |
| Augsburg ベンチマークデータセット | Hu J et al. (Earth System Science Data, 2022); Remote Sensing Technology, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | モデル評価に使用した公開マルチモーダルリモートセンシングベンチマークデータセット。 |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | GPU加速によるモデルの学習および推論に使用。 |
| グラフィックスプロセッシングユニット (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | モデルの学習および評価に使用。 |
| Houston2013 ベンチマークデータセット | IEEE Geoscience and Remote Sensing Society Data Fusion Contest | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | モデル評価に使用した公開ハイパースペクトル画像および LiDAR ベンチマークデータセット。 |
| MUUFL Gulfport ベンチマークデータセット | University of Florida (Gader P et al., Technical Report REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | モデル評価に使用した公開ハイパースペクトル画像および LiDAR ベンチマークデータセット。 |
| オペレーティングシステム | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | モデルの開発、学習、および評価に使用した計算環境。 |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | FlowErs モデルの実装、学習、および評価に使用したディープラーニングフレームワーク。 |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | 計算ワークフローの実装および実行に使用したプログラミング言語。 |
参考文献
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。