本研究では、トランスクリプトミクス、機械学習、および免疫浸潤解析を統合し、慢性閉塞性肺疾患(COPD)における潜在的な診断バイオマーカーおよび調節ネットワークを特定するための再現可能なバイオインフォマティクス・パイプラインを提示します。
研究記事
診断用バイオマーカーとしてのUPP1:COPDにおける統合バイオインフォマティクスおよび免疫浸潤解析からの知見
* These authors contributed equally
この記事について
サマリー
要約
COPDは、持続的な気流制限と慢性炎症を特徴とする進行性呼吸器疾患であるが、その病態形成におけるN4-アセチルシチジン(ac4C)RNA修飾の役割はほとんど解明されていない。本研究は、公開データベースからac4C関連遺伝子(ac4C-RGs)を系統的にスクリーニングし、COPDにおけるそれらの調節ネットワークを調査することを目的とした。これにより、特定の遺伝子とac4C修飾との間の直接的な調節関係を前提とせずに、さらなるメカニズム研究のための潜在的なバイオマーカーを同定することを目指した。トランスクリプトームプロファイルから変動発現遺伝子(DEGs)を同定し、加重遺伝子共発現ネットワーク解析(WGCNA)を適用して主要な共発現モジュールを明らかにした。DEGs、有意なモジュール、およびac4C-RGsの間でクロス解析を実施した。LASSO回帰、XGBoost、およびランダムフォレストアルゴリズムを用いて主要遺伝子をスクリーニングし、その後、ロジスティック回帰に基づく診断モデルを構築した。モデルの性能は、受信者動作特性(ROC)曲線分析、95%信頼区間を伴う曲線下面積(AUC)、キャリブレーション曲線評価、および決定曲線分析(DCA)によって評価した。合計160個の重複遺伝子が同定され、6つのハブ遺伝子(PTRF, PRKCDBP, UPP1, TOR3A, FAM168B, B4GALT2)が3つの機械学習アルゴリズムすべてによって一貫して選択された。診断モデルは良好な識別能を示し、AUCはトレーニングセットで0.766、内部テストセットで0.759、外部検証セットで0.723であった。調節ネットワーク解析により、潜在的なceRNA軸および転写因子の相互作用が示唆され、免疫浸潤プロファイリングにより、主要遺伝子と複数の免疫細胞サブセットとの間に有意な相関があることが明らかになった。薬物-遺伝子相互作用解析および分子ドッキングにより、フルオロウラシル、カペシタビン、および5-ベンジルアサイロウリジンがUPP1に対して良好な予測結合親和性を示す可能性が示された。結論として、PTRF, PRKCDBP, UPP1, TOR3A, FAM168B, B4GALT2がCOPDにおける潜在的なac4C関連バイオマーカーとして同定され、これらが免疫および代謝調節に関与している可能性があり、将来的な機能研究および治療探索の基盤を提供することが示された。
概要
COPDは、肺胞および気道構造の異常に起因する進行性の気流制限を特徴とする、慢性的かつ不均一な呼吸器疾患である1,2。プロテアーゼとアンチプロテアーゼの不均衡、酸化ストレス、慢性炎症、および細胞老化がCOPDの核心的な病態生理学的機序であり、これらが肺組織の構造的破壊と機能障害を引き起こす3,4。さらに、COPDは長期間の喫煙、環境汚染、職業的曝露、呼吸器感染症、および遺伝的感受性を含む複数のリスク要因の影響を受ける5,6。COPDは世界経済に大きな負担を強いており、2020年から2050年まで、年間で世界GDPの0.111%を占めると予測されている7。気管支拡張薬、吸入ステロイド薬、呼吸リハビリテーション、長期酸素療法などの現在の治療戦略によって症状を緩和させることは可能だが、疾患の進行を停止させることは依然として困難である。臨床的な不均一性が顕著であるため、患者の転帰は大きく異なる8。したがって、COPDの管理を強化し患者の生存率を向上させるためには、新しい診断バイオマーカーおよび予後指標が急務となっている。
RNA修飾とは、RNA分子の化学的な変化を指し、これによりRNAの構造と機能が変化して遺伝子発現が調節されます9,10。一般的なRNA修飾には、N6-メチルアデノシン(m6A)、シュードウリジン(Ψ)、5-メチルシトシン(m5C)、およびac4Cが含まれます11。ac4C修飾は、mRNAの安定性の維持およびmRNA翻訳の促進において重要な役割を果たしています12,13。NAT10は、ac4C修飾を触媒することが知られている唯一の真核生物酵素であり、その活性はこの修飾の形成に不可欠です14。酸化ストレス、細胞老化、炎症、およびac4C修飾の間には強い相関があることが研究で示されています。例えば、炎症性腸疾患(IBD)患者の大腸組織におけるCD4+ Tリンパ球では、NAT10レベルが著しく上昇しています15。NAT10はケモカインであるCCL2およびCXCL1のac4Cアセチル化を促進し、それによってマクロファージや好中球の浸潤を促進させ、炎症性損傷を悪化させます16。酸化ストレス下でac4Cレベルが著しく増加することから、酸化ストレスに対する細胞応答にはac4C修飾が関与している可能性があります。さらに、NAT10はac4C修飾を介してTGFB1 mRNAを安定化させることにより、PM2.5誘発性の肺線維症を促進し、それによって上皮間葉転換を引き起こします17。しかし、COPDにおけるac4C修飾の役割についてはほとんど解明されておらず、この分野におけるさらなる研究の必要性が浮き彫りになっています。
本研究では、COPD患者と対照群の間のDEGを同定するためにGEOデータベースを利用した。次に、マルチオミクスデータ18からまとめられた既報のac4C-RGリストをDEGと統合し、重複する候補を同定した。ac4C修飾はCOPDにおける重要なプロセスである炎症および酸化ストレスに影響を与えることが知られているため、ac4C調節ネットワークに関連する遺伝子がCOPDにおいて調節不全に陥っているという仮説を立てた。ただし、重複した遺伝子はNAT10の直接的な基質やac4Cによって直接制御される遺伝子ではなく、ac4C関連ネットワークに関連する候補として検討した。複数の機械学習アルゴリズムを用いて主要遺伝子をスクリーニングし、続いて診断モデルの構築と検証を行った。その後、COPDの病態生理に関与する関連パスウェイを決定し、潜在的な標的薬を予測した。最終的に、RT-qPCRアッセイを実施して主要遺伝子の発現レベルを確認し、COPDの病態生理に関する予備的な知見および治療探索の潜在的な方向性を提示した。
プロトコル
機関審査委員会(IRB)による声明
本研究はヘルシンキ宣言に準拠して実施されました。プロトコルは深圳市羅湖区中医院倫理委員会によって承認され(承認番号:2024-LHQZYYYXLL-KY-039)、すべての参加者から登録前に書面によるインフォームドコンセントを得ました。本プロトコルで使用した研究ツールおよび材料の詳細は、材料表に記載されています。
データソースおよび処理
COPD関連の遺伝子発現データセットをGene Expression Omnibus (GEO) から取得した。トランスクリプトームデータセットとしてGSE54837データセットを、検証セットとしてGSE112811データセットを使用した(表1)。ac4C-RGは文献18から収集した。COPD群と対照群の間で変動的に発現している遺伝子(DEG)をRパッケージのlimmaを用いて特定した。|log2FC| > 0 かつ p < 0.05 の場合を、DEGとして統計的に有意であると見なした。遺伝子発現変化の全体的な分布を可視化するために、ボルケーノプロットを作成した。
WGCNAの構築
COPD関連モジュールの特定のため、Rを用いてGSE54837データセットにWGCNAを実施した。ネットワーク構築に先立ち、平均連結法およびユークリッド距離を用いたhclust関数による階層的クラスタリング分析を通じて、外れ値サンプルを特定し除外した。最適なソフトしきい値パワー(β スケールフリートポロジー適合指数R = 10となるように選択した。2 ≥ 0.85とし、スケールフリー・トポロジーと平均接続性のバランスを調整した。隣接行列を構築し、これをトポロジカル・オーバーラップ行列(TOM)に変換した。遺伝子モジュールは、動的ツリー切断アルゴリズム(deepSplit = 2, minClusterSize = 50)を用いて特定した。固有遺伝子相関を持つモジュールは > その後、mergeCloseModules関数を用いて0.75で統合した。次いで、モジュール固有遺伝子(module eigengenes)と臨床形質(COPDの状態、年齢、性別、喫煙状況)との相関をピアソン相関係数を用いて算出し、以降の解析に向けたCOPD関連モジュールを特定した。
重複遺伝子のスクリーニング、濃縮解析およびPPIネットワーク解析
DEGs、MEsalmonモジュール遺伝子、およびac4C-RGsの間で重複する遺伝子を特定するため、Rパッケージのggvennを用いてベン図を作成した。重複遺伝子の機能濃縮解析は、RパッケージのclusterProfilerを用い、Gene Ontology (GO)およびKyoto Encyclopedia of Genes and Genomes (KEGG)データベースを使用して行った。重複遺伝子間におけるタンパク質レベルの相互作用を解析するため、STRINGデータベース(https://string-db.org/)からタンパク質相互作用(PPI)情報を取得した。得られたPPIネットワークの可視化には、Cytoscapeソフトウェアを使用した。
機械学習を用いた重要遺伝子の同定
3つの機械学習手法、すなわち最小絶対収縮選択演算子(LASSO)回帰、極端勾配ブースティング(XGBoost)、およびランダムフォレスト(RF)を適用した。LASSO回帰はglmnetパッケージを用いて実装し、10分割交差検証によって最適なペナルティパラメータλを決定した。type.measureパラメータは"deviance"に、familyパラメータは"binomial"に設定した。交差検証による偏差を最小化するλmin基準を用いて最適なλを選択した結果、17個の遺伝子が抽出された。XGBoostはxgboostパッケージを用い、ハイパーパラメータをnrounds = 100、max_depth = 6、eta = 0.3、subsample = 0.8、colsample_bytree = 0.8、およびeval_metric = "logloss"として実行した。特徴量の重要性をgain指標でランキングし、上位30個の遺伝子を選択した。ランダムフォレストはrandomForestパッケージを用い、ntree = 200として実装した。特徴量の重要性をジニ係数の平均減少量でランキングし、上位30個の遺伝子を選択した。これら3つの機械学習法によって選択された遺伝子の積集合を求めることで、以降の解析のための鍵となる遺伝子を特定した。
リスク予測のためのロジスティック回帰モデルの構築と評価
GSE54837データセットを、トレーニングセット(70%)とテストセット(30%)にランダムに分割した。トレーニングセットを用い、主要遺伝子の発現レベルを入力特徴量として、MASSパッケージのglm関数を使用してロジスティック回帰モデルを構築した。モデルの性能は、pROCパッケージで作成したROC曲線を用いて評価した。AUCの95%信頼区間は、2,000回のブートストラップ反復により算出した。モデルのキャリブレーションは、1,000回のブートストラップ再標本化(rmsパッケージ)により作成したキャリブレーション曲線を用いて評価した。また、dcaパッケージを用いてDCAを実施し、さまざまな閾値確率における正味の臨床的有用性を評価した。個別のリスク推定を容易にするため、rmsパッケージのnomogram関数を用いてノモグラムを構築した。
回帰方程式は以下の通りでした:
logit(P) = 0.5823 + 0.6010 × UPP1 - 0.6563 × PTRF + 0.3853 × B4GALT2 - 0.3972 × FAM168B + 0.1848 × PRKCDBP - 0.4787 × TOR3A. (1)
ここで、PはCOPDの予測確率を表し、各係数は対応する遺伝子発現値がCOPDの対数オッズに寄与する度合いを表します。
発現解析、GeneMANIAネットワークおよび分子調節ネットワーク
GSE54837データセットにおけるCOPD群と対照群の遺伝子発現レベルを、ウィルコクソン順位和検定を用いて比較した。発現レベルの分布を可視化するためにggplot2パッケージを用いてボックスプロットを作成し、中央値、四分位範囲(IQR)、および個々のデータ点を重ねて表示した。遺伝子ネットワークの構築および機能的相互作用の予測にはGeneMANIAを使用した。検索はデフォルトのパラメータ(種 = Homo sapiens、最大関連遺伝子数 = 20)で実行した。得られたネットワークをダウンロードして可視化し、エッジの色で相互作用の種類を示した。転写後調節機構を調査するため、競合性内因性RNA(ceRNA)ネットワークを構築した。6つの主要遺伝子を標的とするmiRNAを、2つの独立したデータベースであるDIANA-microT(スコア ≥ 0.8)およびmiRanda(スコア ≥ 140、エネルギー ≤ −20 kcal/mol)を用いて予測した。両方のデータベースで特定されたmiRNAの積集合を用いてmiRNA-mRNAペアを構築した。続いて、これらのmiRNAを標的とするlncRNAをStarBaseデータベースを用いて予測した。lncRNA-miRNA-mRNA調節ネットワークを構築し、Cytoscapeを用いて可視化した。転写調節関係は、ChIP-X Enrichment Analysis Version 3 (ChEA3)を用いて予測した。TFが予測された各主要遺伝子について、濃縮スコアが最も高い上位10個の転写因子を選択した。TF-ターゲット調節ネットワークをCytoscapeで構築した。
遺伝子セット濃縮解析および免疫細胞浸潤評価
各キー遺伝子の生物学的機能を調べるため、clusterProfilerパッケージを用いて遺伝子セット濃縮解析(GSEA)を実施した。各キー遺伝子について、中央値に基づいてサンプルを高発現群と低発現群に分けた。これら2群間の差分的発現解析をlimmaを用いて行い、得られた遺伝子リストを符号付きlog₂ fold-changeによって順位付けした。GSEAは、GO生物学的プロセス用語にはgseGO関数を、KEGGパスウェイにはgseKEGG関数を用い、パラメータとしてminGSSize = 10、maxGSSize = 500、pvalueCutoff = 0.05、nPerm = 1,000を設定して実施した。28種類の免疫細胞の相対的な存在量は、GSVAパッケージに実装されている単一サンプル遺伝子セット濃縮解析(ssGSEA)を用いて推定した。28種類の免疫細胞のマーカー遺伝子で構成される精選された遺伝子セットシグネチャー行列を、先行文献19から取得した。各サンプルに対して、method = "ssgsea"、ssgsea.norm = TRUE、kcdf = "Gaussian"としてgsva関数を適用した。ssGSEA濃縮スコアと6つのキー遺伝子の発現レベルとの間のSpearman相関係数を、cor.test関数を用いて算出した。p 値はBenjamini-Hochberg法を用いて多重検定補正した。相関行列は、pheatmapパッケージを用いてヒートマップとして可視化した。
薬剤予測、分子ドッキング、および疾患関連解析
DrugBankデータベースを用いて、主要遺伝子を標的とする潜在的な治療化合物を特定した。予測される薬物・遺伝子相互作用を可視化するため、Cytoscapeを用いて「主要遺伝子標的薬物」相互作用ネットワークを構築した。結合親和性を評価するため、CB-Dock2プラットフォームを用いて分子ドッキングを実施した。ヒトUPP1の3Dタンパク質構造は、Protein Data Bank(PDB ID: 7B8T)から取得した。薬物の分子構造(SMILES形式)はPubChemから取得した。ドッキングはAutoDock Vinaエンジンを用いて行い、出力結果を結合自由エネルギー(ΔG, kcal/mol)によってランク付けした。ドッキング複合体はPyMOLを用いて可視化した。主要遺伝子と環境暴露に関連するヒト疾患との関連性は、Comparative Toxicogenomics Database(CTD)を用いて調査した。各遺伝子を個別に検索し、最も強く関連している上位10疾患を抽出してレーダーチャートで可視化した。
RT-qPCRプロトコル
深セン市羅湖区中医院において、8名のCOPD患者および8名の健常対照者から末梢静脈血サンプルを採取した。COPDは、気管支拡張薬投与後のFEV1/FVC < 0.70と定義されるGlobal Initiative for Chronic Obstructive Lung Disease (GOLD)基準に基づいて診断した。対照群は、呼吸器疾患の既往がなく、肺機能検査が正常(FEV1% 予測値 ≥ 80% かつ FEV1/FVC ≥ 0.70)である、年齢および性別を一致させた健常ボランティアで構成した。患者のベースライン情報はTable 2に示している。血液RNA抽出キットを用いて、COPD血液サンプルから全RNAを抽出した。cDNA合成については、提供されたプロトコルに従い、ゲノムDNA除去機能付きのcDNA合成キットを用いて500 ngの全RNAを逆転写した。得られたcDNAを150 ng/μLに希釈した。
リアルタイムPCRシステムを用い、SYBR GreenベースのqPCRマスターミックスを使用してRT-qPCRを実施した。10 μLの各反応液には、2x SYBR Greenマスターミックス 5 μL、フォワードおよびリバースプライマー(10 μM)各 0.5 μL、希釈済みcDNA(15 ng/μL)1 μL、およびヌクレアーゼフリー水 3 μLを含有させた。サイクル条件は、95 °Cで5分間の初期変性後、95 °Cで10秒、60 °Cで30秒を40サイクル繰り返し、最後に増幅の特異性を確認するために60 °Cから95 °Cまで融解曲線分析を行った。すべての反応はテクニカルトリプリケートで実施した。内部標準遺伝子にはβ-actinを用いた。各標的遺伝子のプライマー効率は標準曲線の希釈系列を用いて検証し、90%から110%の範囲であった。遺伝子発現レベルはβ-actinで標準化し、相対的発現量は2-ΔΔCt法を用いて算出した。COPD群と対照群との統計学的比較には、Mann-Whitney U検定を用いた。
統計解析
ネットワークの視覚化にはCytoscapeを使用し、統計解析にはRソフトウェアを使用した。特に断りのない限り、2群間の比較において、非正規分布データにはMann-Whitney U検定を、正規分布データにはStudent's t検定を用いた。p < 0.05を統計的に有意とみなした。
結果
重複遺伝子の同定、濃縮分析、およびPPIネットワークの構築
GSE54837データセットから、発現上昇した1,675個および発現低下した1,696個を含む、計3,371個の発現変動遺伝子(DEG)が同定された。最も有意に発現上昇および低下した上位10遺伝子を以下に示す。 図1AGSE54837データの階層的クラスター分析を行った(補足図1A)、そしてスケールフリーのネットワークトポロジーを確保するために、ソフト閾値べき(soft-thresholding power)として10を適用した(図1B)。遺伝子共発現モジュールは、最小モジュールサイズを50遺伝子としてダイナミックツリーカット法を用いて構築し、各モジュールに異なる色が割り当てられた(付随図1B)。eigengene相関を持つモジュール > 0.75をその後統合した(付随図 1C, 図1C)、その結果14個の独立したモジュールが得られた。モジュールの固有遺伝子(eigengene)と臨床的特徴とのピアソン相関分析に基づいたところ、MEsalmonモジュール(5,226個の遺伝子で構成)がCOPDと最も有意な正の相関を示した(r = 0.35, p = 7 x 10⁻8, 図1D)。ベン図解析により、3,371個の変動発現遺伝子(DEG)、5,226個のMEsalmonモジュール遺伝子、および2,118個のac4C関連遺伝子(ac4C-RG)の間で、160個の重複遺伝子が同定された(図1E). これら160個の遺伝子の機能濃縮分析を行ったところ、有意なGO用語として、一本鎖RNA結合、mRNA代謝プロセスの調節、およびRIG-Iシグナル伝達経路が含まれていることが示された(図1F)。さらに、KEGG解析により、これらの遺伝子が主にFcガンマ受容体介在性食細胞作用、mRNA監視経路、および局在性接着に濃縮されていることが示された(図1G)。重複遺伝子のPPIネットワークは、118個のノードと196個のエッジを含んでいた(図1H).
COPDにおける6つの鍵遺伝子の同定
160個の重複候補の中から潜在的なキー遺伝子をさらに特定するため、3つの機械学習アルゴリズムを適用した。まずLASSO回帰を適用し、交差検証を用いて最適なペナルティパラメータ(λ)≈ 0.091を決定した(図2A)。係数プロファイルプロットにより、最適なλ値において17個の遺伝子が保持されたことが示された(図2B)。XGBoost解析では、ゲインが最も高い上位30個の遺伝子が特定され、そのうちPTRF、WBP11、およびLDOC1Lが高い予測能を示した(図2C)。同様にRFアルゴリズムを用いて、ジニ重要度スコアに基づき上位30個の遺伝子をランク付けしたところ、PTRF、RFX5、およびPRKCDBPが最も予測能の高い遺伝子に含まれていた(図2D)。これら3つの手法で選択された遺伝子の積集合解析により、PTRF、PRKCDBP、UPP1、TOR3A、FAM168B、およびB4GALT2の6つの共通するキー遺伝子が特定された(図2E)。
診断モデルの構築および主要遺伝子の発現解析
GSE54837データセットの70%をトレーニングセットとして使用し、6つの主要遺伝子を組み込んだロジスティック回帰モデルを構築した。ROC曲線分析では、トレーニングセット、内部テストセット、外部検証セットにおいて、それぞれ0.766 (95% CI: 0.691–0.8417)、0.759 (95% CI: 0.6368–0.8817)、0.723 (95% CI: 0.6085–0.8596) のAUCを示し、中程度の診断能であることが示された (Figure 3A–C)。キャリブレーション分析により高い信頼性が確認され、DCA(決定曲線分析)では、トレーニングセット (Figure 3D–E) および検証セット (Figure 3F–G) の両方において、広範な閾値確率で明確な正味の臨床的有用性が示された。各遺伝子の寄与を可視化し、個別化されたリスク推定を容易にするためにノモグラムを作成した (Figure 3H)。発現解析の結果、COPDサンプルにおいてB4GALT2、PRKCDBP、UPP1は有意に上昇しており、一方でFAM168B、PTRF、TOR3Aは低下していた (Figure 3I)。
COPDにおける主要遺伝子の調節ネットワークおよび機能解析
特定されたハブ遺伝子に最も関連性の高い上位20個の遺伝子からなる機能的相互作用ネットワークを、GeneMANIA解析を用いて構築した(図 4A)。接続の大部分は物理的相互作用であり、次いで共発現相関および共有タンパク質ドメインであった。機能注釈により、核塩基含有低分子異化過程、ヌクレオシド異化過程、および細胞膜ラフトなどのプロセスにおいて有意な濃縮が示された。転写後調節について、DIANA-microTおよびmiRandaデータベースからのmiRNA予測を交差させることで検討し、8つの重複するmiRNAを同定した(図 4B)。続いて、lncRNA-miRNA-mRNA調節軸を構築した。サンキーダイアグラムによると、同定されたmiRNAのうち、ともにFAM168Bの調節に関連する2つのmiRNAが、7つのlncRNAによって標的となることが予測された。残りの5つのハブ遺伝子については、このような調節相互作用は同定されなかった(図 4C)。転写調節については、ChEA3プラットフォームを用いてさらに探索し、B4GALT2、UPP1、FAM168B、およびTOR3Aの上流転写因子(TF)を予測した。各遺伝子のTF上位10個を選択し、TF-標的調節ネットワークを構築した(図 4D)。6つの主要遺伝子の生物学的機能を調べるためにGSEAを実施した。UPP1は、ジアシルグリセロール代謝過程やプリンヌクレオシド三リン酸生合成過程などの生物学的プロセス、ならびにプロテアソームやシトクロムP450による異物代謝などのパスウェイにおいて有意に濃縮されていた(図 4E–F)。残りの5つの主要遺伝子の濃縮結果は、付随図 2A–Jに示されている。
COPDにおけるUPP1の免疫浸潤および薬剤標的の予測
ssGSEAアルゴリズムを用いて、コントロール群およびCOPD群における28種類の免疫細胞の浸潤レベルを評価しました。COPD患者では、メモリーB細胞、骨髄由来抑制細胞、および活性化樹状細胞において、エンリッチメントスコアが有意に高いことが示されました。対照的に、1型ヘルパーT細胞、活性化B細胞、および未熟B細胞では、エンリッチメントスコアが有意に低い結果となりました(図5A)。なお、ssGSEAはトランスクリプトームデータに基づいた免疫細胞の相対的なエンリッチメント推定値を提供するものであり、免疫細胞の割合を直接測定したものではないことに留意してください。相関分析により、6つの主要遺伝子が免疫細胞サブセットと異なる相関パターンを示すことが明らかになりました。具体的には、UPP1、PRKCDBP、B4GALT2は、メモリーB細胞、活性化樹状細胞、および骨髄由来抑制細胞の浸潤レベルと正の相関を示し(Spearman ρ > 0.4, p < 0.05)、一方でPTRF、TOR3A、FAM168Bは、1型ヘルパーT細胞および活性化B細胞と負の相関を示しました(Spearman ρ < −0.3, p < 0.05)。完全な相関行列をヒートマップに示しています(図5B)。薬剤予測分析の結果、6つの候補遺伝子のうち、小分子との相互作用が予測されたのはUPP1のみでした。データベースから、UPP1と相互作用する可能性のある化合物として、フルオロウラシル、カペシタビン、5-benzylacyclouridineを含む3つの化合物が同定されました(図5C)。これらの化合物は主に腫瘍学または実験的設定で使用されており、COPDへの関連性についてはさらなる調査が必要です。結合自由エネルギーの計算により、5-benzylacyclouridineが最強の結合親和性を示し、予測される結合親和性が比較的高いことが示唆されました(表3)。これら3つのすべての化合物について分子ドッキング視覚化を行ったところ、UPP1と良好な予測結合コンフォメーションを示し、これは実験的な検証ではなく計算上のドッキング予測と一致していました(図5D–F)。さらに、CTD分析により、6つの主要遺伝子のすべてが、出生前暴露の後遺症、体重減少、肝腫大、炎症を含むさまざまな疾患表現型と強く関連していることが示されました(図5G–L)。
臨床検体における主要な診断遺伝子のRT-qPCRによる検証
主要遺伝子の発現レベルを検証するため、8名のCOPD患者および8名の対照被験者から血液サンプルを採取した。なお、サンプルサイズが限られているため、本解析は予備的な検証とみなした。図6A–Fに示すように、COPDサンプルではPTRF、TOR3A、FAM168Bが有意にダウンレギュレートされており、一方でPRKCDBPとUPP1は有意にアップレギュレートされていた。これはバイオインフォマティクス解析で観察された傾向と一致している。対照的に、B4GALT2の発現については、2群間に有意な差は認められなかった。この不一致は、サンプルサイズの制限、またはデータセットと臨床検体との間のサンプルタイプの違いに起因する可能性がある。
データ可用性声明:
すべてのRNAシーケンシングデータはGene Expression Omnibusデータベース(GEO, https://www.ncbi.nlm.nih.gov)から取得し、GSE54837をトレーニングセット、GSE112811を検証セットとして選択しました。本解析に使用したコードは、https://doi.org/10.5281/zenodo.21771476 から入手可能です。
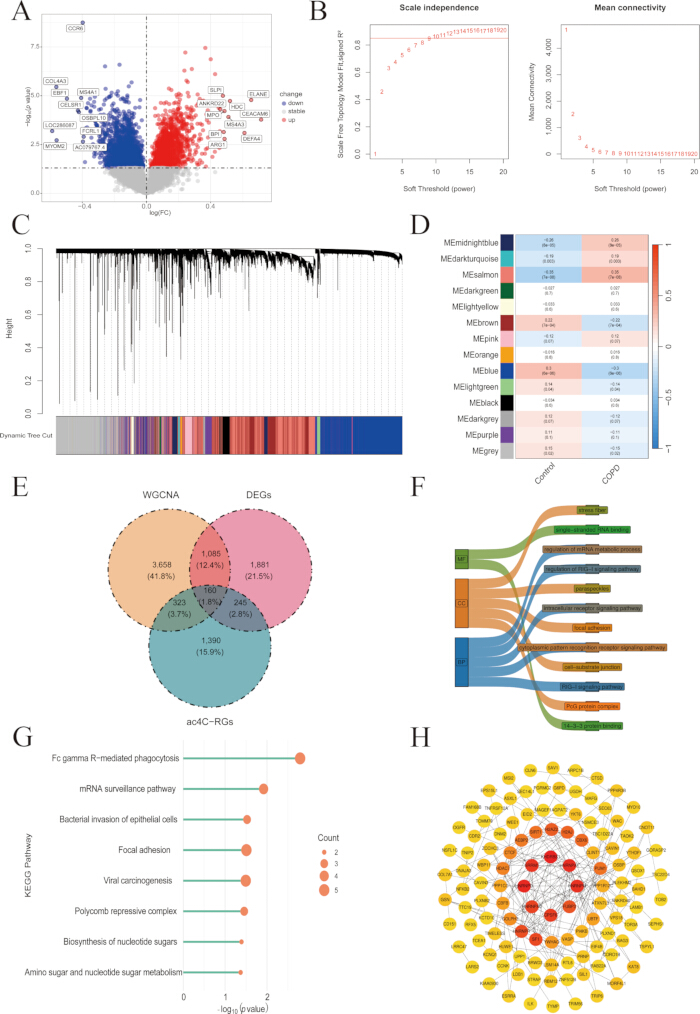
図 1重複遺伝子の同定、濃縮解析、およびPPIネットワークの構築。 (A) GSE54837データセットにおける発現変動遺伝子(DEG)のボルケーノプロット。(B)ソフトしきい値スクリーニング。(C) モジュールのクラスタリングデンドログラム(マージ後)(D) モジュールと形質間の相関を示すヒートマップ。 (E) 重複遺伝子を特定するためのベン図。 (FGO濃縮解析のマルベリーダイアグラムであり、MF、CC、およびBPにおける共通遺伝子の主な濃縮結果を示している。G) KEGGシグナリングパスウェイ濃縮解析のロリポップダイアグラム。バブルの大きさは濃縮された遺伝子数を示す。(H) 重複遺伝子のPPIネットワーク。ノードはタンパク質を、エッジはタンパク質間相互作用を表す。略語:DEGs = 発現変動遺伝子、PPI = タンパク質間相互作用、GO = 遺伝子オントロジー、MF = 分子機能、CC = 細胞成分、BP = 生物学的プロセス、KEGG = 京都遺伝子・ゲノム百科事典、ac4C-RGs = N4-アセチルシチジン関連遺伝子。 この図の拡大版を表示するには、ここをクリックしてください。
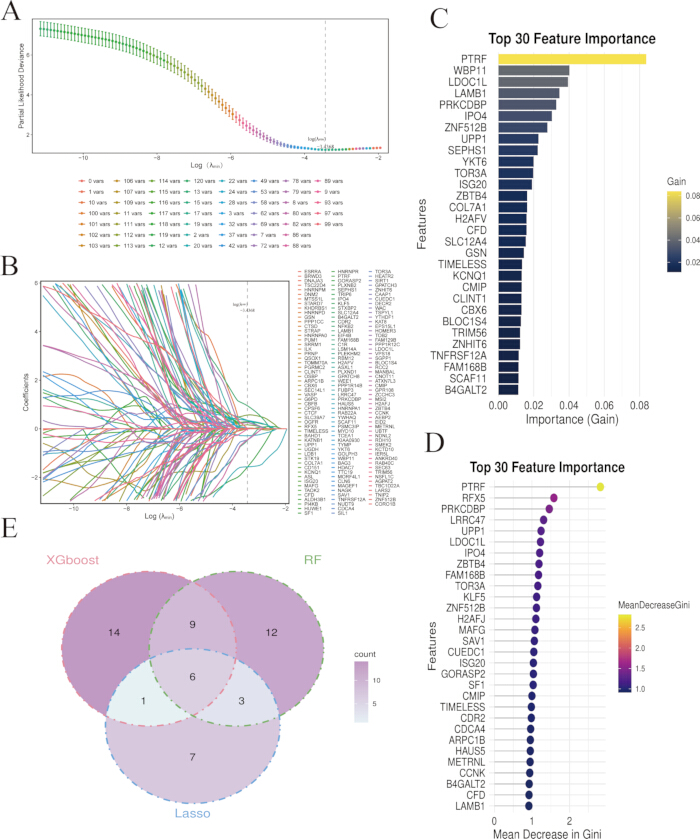
図 2: COPDにおける6つの主要遺伝子の特定。 (A) LASSOクロスバリデーション曲線。 (B) LASSO回帰係数のパス図。λが増加するにつれて、重要でない遺伝子の係数が0に収束する。 (C) XGBoost特徴量重要度ランキング。x軸はゲイン値、y軸は遺伝子名、色の濃さは重要度を示す。 (D) RF特徴量重要度ランキング。x軸はGini指数の平均減少量を示す。 (E) 3つのアルゴリズムのクロス解析によって得られた重複遺伝子のベン図。略語:LASSO = least absolute shrinkage and selection operator、XGBoost = extreme gradient boosting、RF = random forest。 こちらのリンクをクリックして、この図の拡大版を表示してください。
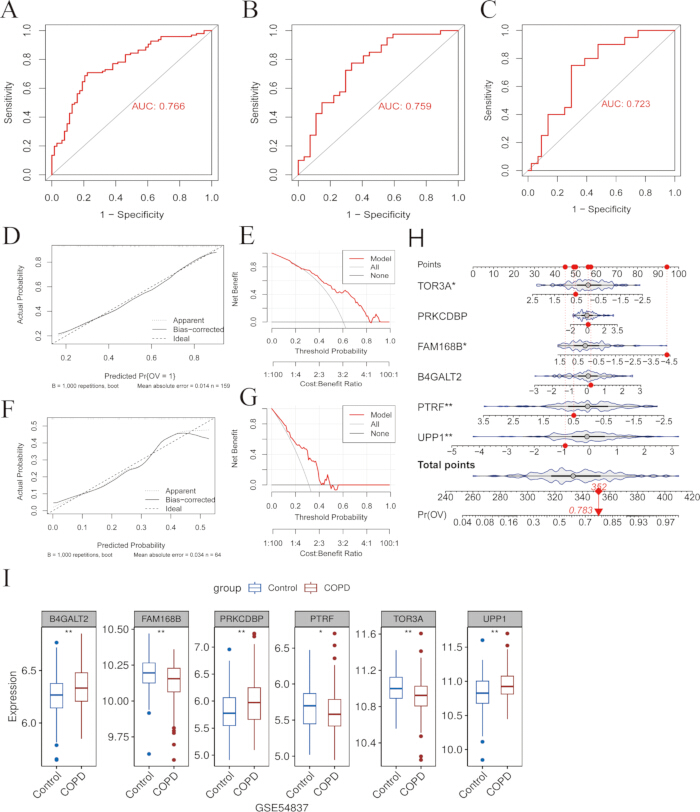
図 3: 診断モデルの構築と主要遺伝子の発現解析。 (A) トレーニングセットのROC曲線。 (B) 内部テストセットのROC曲線。 (C) 外部検証セットのROC曲線。 (D) トレーニングセットのキャリブレーション曲線。 (E) トレーニングセットのDCA。 (F) 外部検証セットのキャリブレーション曲線。 (G) 外部検証セットのDCA。 (H) 6つの主要遺伝子のノモグラム。個々のCOPDリスクを予測するために、各遺伝子に対応するスコアが割り当てられている。 (I) GSE54837データセットにおけるCOPDおよびコントロールサンプルにおける6つの主要遺伝子の発現解析。略語:ROC = 受信者動作特性;AUC = 曲線下面積;DCA = 決定曲線分析;COPD = 慢性閉塞性肺疾患。 ここをクリックして、この図の拡大版を表示してください。
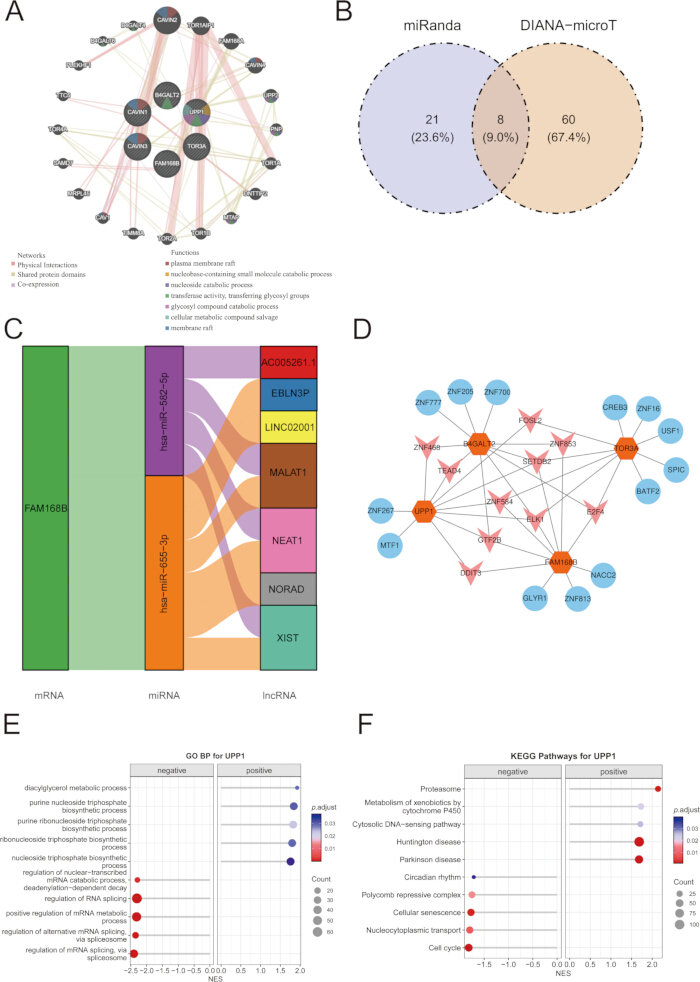
図 4: COPDにおける鍵遺伝子の制御ネットワークと機能的意義。 (A) 6つの鍵遺伝子のGeneMANIA解析結果。線の色は遺伝子間の相関を示し、ノードの色は異なる機能カテゴリーを示す。 (B) DIANA-microTおよびmiRandaデータベースのクロス解析によるベン図。 (C) ceRNA制御ネットワークのマルベリーダイアグラム。 (D) 潜在的な転写因子制御ネットワーク。青色のノードは転写因子を、オレンジ色のノードは標的遺伝子を表す。 (E) UPP1の単一遺伝子GSEA濃縮解析(GOを含む)。 (F) UPP1の単一遺伝子GSEA濃縮解析(KEGGを含む)。略語: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. こちらのリンクから、この図の拡大版を表示できます。
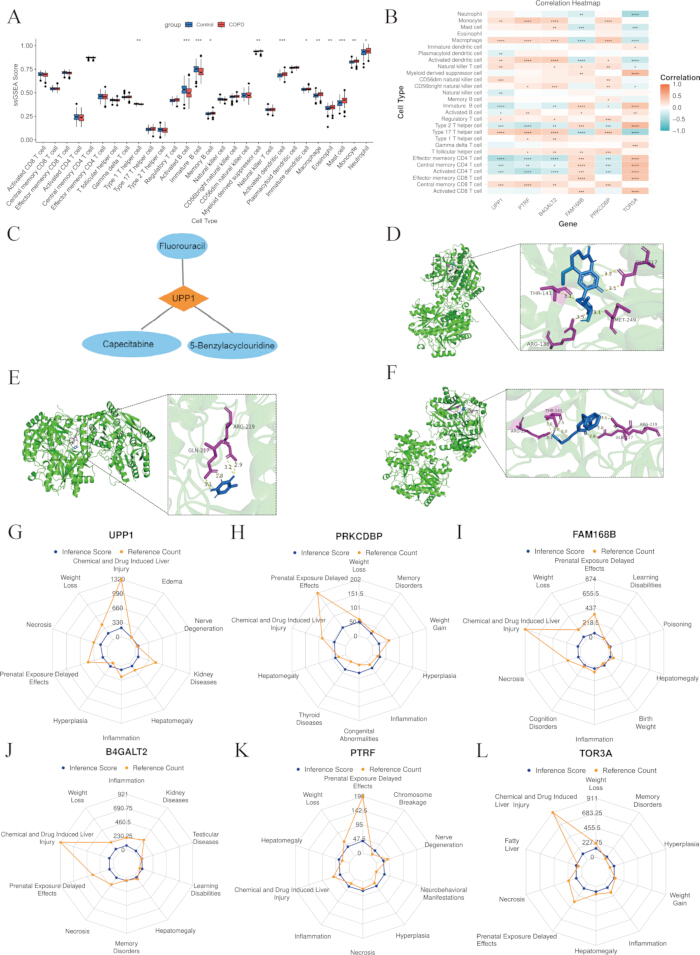
図 5: COPDにおける主要遺伝子の免疫浸潤および薬剤ターゲットの予測。 (A) 群間における免疫細胞量の差。 (B) 免疫細胞と主要遺伝子の相関ヒートマップ。 (C) 主要遺伝子と予測薬剤の相互作用ネットワーク。 (D) fluorouracilとUPP1の分子ドッキング。 (E) capecitabineとUPP1の分子ドッキング。 (F) 5-benzylacyclouridineとUPP1の分子ドッキング。各化合物について、左図は全体のドッキング配座を、右図は局所的な結合相互作用を示す。 (G) B4GALT2のCTD解析。 (H) FAM168BのCTD解析。 (I) PRKCDBPのCTD解析。 (J) PTRFのCTD解析。 (K) TOR3AのCTD解析。 (L) UPP1のCTD解析。 この図の拡大版を表示するには、ここをクリックしてください。
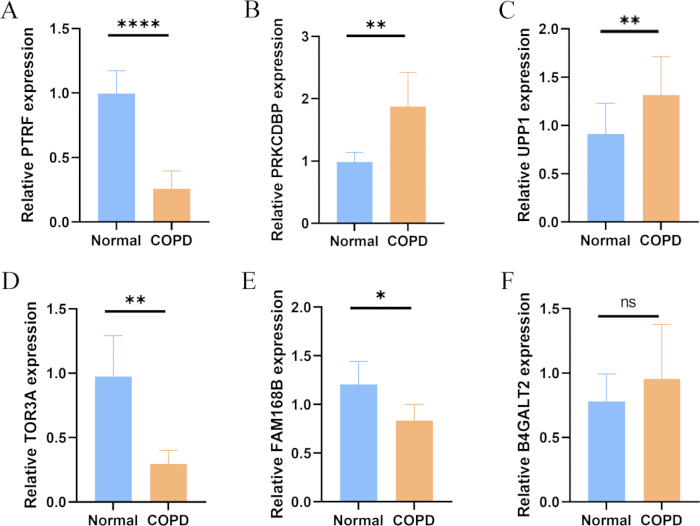
図 6: COPDおよびコントロールサンプルにおける主要遺伝子発現のRT-qPCRによる検証。(A>) PTRFの相対発現量。(B>) PRKCDBPの相対発現量。(C>) UPP1の相対発現量。(D>) TOR3Aの相対発現量。(E>) FAM168Bの相対発現量。(F>) B4GALT2の相対発現量。ns = 有意差なし、p > 0.05; * p < 0.05; ** p < 0.01; *** p < 0.001; **** p < 0.0001。略称:RT-qPCR = 逆転写定量PCR。 こちらのリンクをクリックして、この図の拡大版を表示してください。
補足図1:GSE54837データセットのサンプルおよび遺伝子モジュールのクラスタリング。 (A) GSE54837データセットのサンプルクラスタリング図。(B) マージ前のモジュールクラスタリングデンドログラム。distinctなモジュールを特定するため、dynamic tree cut法を用いて遺伝子をグループ化した。(C) モジュール固有遺伝子(eigengenes)の階層的クラスタリングデンドログラム。発現パターンが類似しているモジュールを、固有遺伝子の類似性に基づいてクラスタリングした。こちらをクリックしてファイルをダウンロードしてください。
付随図2:GSEA濃縮分析。(A) PRKCDBPのGO解析。(B) PRKCDBPのKEGG解析。(C) PTRFのGO解析。(D) PTRFのKEGG解析。(E) TOR3AのGO解析。(F) TOR3AのKEGG解析。(G) FAM168BのGO解析。(H) FAM168BのKEGG解析。(I) B4GALT2のGO解析。(J) B4GALT2のKEGG解析。略語:GO = Gene Ontology、KEGG = Kyoto Encyclopedia of Genes and Genomes。こちらをクリックしてファイルをダウンロードしてください。
| データセット | 対照 | 患者 | シーケンシングプラットフォーム |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
表1:本研究で使用した遺伝子発現データセット。モデル開発および内部テストに使用したGSE54837データセットと、外部検証に使用したGSE112811データセットの特性。
| 患者 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| 性別 (女/男) | M | M | M | F | M | M | M | M |
| 年齢(歳) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| 喫煙状況 | はい | はい | 禁煙(2年) | いいえ | はい | はい | はい | 禁煙(5年) |
| パックイヤー(喫煙指数) | 1日あたり20本 / 30年間 | 1日あたり15 / 35年 | 1日あたり20 / 50年 | 1日20本 / 40年間 | 1日あたり30回 / 40年間 | 1日あたり15 / 40年 | 1日あたり20本 / 30年間 | |
| COPD群 | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
表2:研究参加者のベースライン特性。RT-qPCR検証に含まれたCOPD患者および健康対照群のベースラインの人口統計学的および臨床的特性。
| 分子名 | 遺伝子 | スコア(kcal/mol) |
| 5-ベンジルアサイクルウリジン | UPP1 | -9.6 |
| カペシタビン | UPP1 | -6.1 |
| フルオロウラシル | UPP1 | -5.5 |
表3:UPP1と候補化合物の分子ドッキング結果。
UPP1とフルオロウラシル、カペシタビン、および5-benzylacyclouridineの相互作用に関する予測分子ドッキング結果(結合親和性を含む)。
ディスカッション
主にメッセンジャーRNA(mRNA)および転移RNA(tRNA)で起こる保存されたRNA修飾であるac4Cは、mRNAの安定性と翻訳効率を向上させます20。NAT10は、ac4C修飾を媒介することが知られている唯一のRNAアセチルトランスフェラーゼです21。研究により、COPD患者の肺上皮細胞においてNAT10がアップレギュレートされていることが示されています。NAT10のノックダウンは、ミトコンドリア機能およびトランスクリプトーム応答を阻害します22。統合的なマルチオミクス解析に基づき、本研究ではCOPDと密接に関連する6つの主要遺伝子を特定し、診断モデルを構築しました。このモデルは中程度の診断性能を示し、さらなる調査に向けた潜在的な価値があることが分かりました。詳細な解析により、これらの遺伝子が転写調節、ceRNAネットワーク、および免疫微小環境において重要な役割を果たしていることが明らかになりました。さらに、潜在的な標的薬が予測され、COPDの病態生理に関する知見が提供されるとともに、個別化精密治療戦略の開発が促進されました。我々は、WGCNAおよび差異発現解析を用いて、COPDで差異発現しており、かつ以前に発表されたac4C関連遺伝子リストに含まれている遺伝子を特定しました。重要な点として、これらの遺伝子はac4C調節ネットワークとの関連に基づいて選択されており、NAT10やac4Cアセチル化へのメカニズム的な関連性が証明されているわけではないことに注意が必要であり、結果として計160個の候補遺伝子が抽出されました。機械学習アルゴリズムを通じて、6つの主要遺伝子(PTRF、PRKCDBP、UPP1、TOR3A、FAM168B、B4GALT2)が特定されました。そのうち、PTRFはIL-33-ZBP1を介したマクロファージのネクロプトーシスを調節することで、ハウスダストマイト(HDM)誘発性気道炎症において重要な役割を果たしており、COPDのような慢性炎症性肺疾患に関与している可能性が示唆されています23。Laiら24は、外因性ウリジン投与がNrf2/SLC7A11/GPX4経路を介してマクロファージのフェロトーシスを抑制し、それによって敗血症による急性肺傷害を軽減することを実証しました。ウリジン代謝の主要酵素であるUPP1のアップレギュレーションが急性肺傷害モデルの肺組織で観察されましたが、その正確な役割、およびこのアップレギュレーションが保護反応であるのか、あるいは組織損傷の結果であるのかについては、さらなる解明が必要です。しかし、この知見は、UPP1がCOPDなどの炎症性肺疾患の病態生理学的プロセスと潜在的な関連を持つ可能性を示唆しており、さらなる調査を正当化するものです。残りの4つの主要遺伝子は肺関連疾患における研究が少ないですが、他の疾患における機能および今回の知見に基づき、それらがCOPDの病態に寄与しうる潜在的な経路を仮定しています。
6つの主要遺伝子に基づき、COPD診断モデルを構築し、その優れた予測性能を検証しました。発現解析の結果、COPDではUPP1、B4GALT2、およびPRKCDBPが有意に上昇し、一方でFAM168B、PTRF、およびTOR3Aが著しく低下していることが示されました。データセット解析ではB4GALT2の上昇が認められましたが、RT-qPCRによる検証では有意な差は見られませんでした。この不一致は、サンプルサイズの制限、コホートの不均一性、および公共データセットと臨床血液サンプルの間のサンプルソースの違いに起因すると考えられます。遺伝子セット富化解析により、これらの主要遺伝子がRNAスプライシングおよびmRNAプロセシング、ならびに細胞周期やニコチン依存などのパスウェイに有意に富化していることが明らかになりました。不可逆的な細胞周期停止は細胞老化の主要なメカニズムとして認識されており、これがCOPDの病態生理に大きく寄与している可能性があります25,26。さらなる解析により、DNA損傷によって誘導される老化関連分泌表現型(SASP)が、慢性炎症の維持と肺組織損傷の悪化を通じて、COPDの持続的な進行を促進する可能性が示唆されました27。先行研究においても、ニコチン依存とCOPDの根底にある遺伝的関連性がレビューされています28。喫煙はCOPDの主要なリスク要因ですが、喫煙者のごく一部しかこの疾患を発症しないことから、COPDとニコチン依存の両方において遺伝的要因が重要な役割を果たしていることが示唆されます。Liuら29は、COPDおよび肺高血圧症(PH)におけるRNA結合タンパク質(RBPs)の役割をまとめ、mRNAスプライシングと転写後遺伝子発現の調節を通じて肺血管リモデリングや炎症反応に関与していることを強調し、バイオマーカーおよび治療標的としての潜在的な可能性を明らかにしました。要約すると、本研究で同定された主要遺伝子および関連パスウェイは、COPDの病態生理に関する理解を深めるだけでなく、将来的な診断バイオマーカーの開発や標的治療戦略の構築に向けた強固な基盤を提供するものです。
ceRNAネットワークには、lncRNA、circRNA、mRNAを含む様々なRNA種が関与しており、これらが共通のmiRNAに競合的に結合することで、相互的な調節関係を形成し、遺伝子発現に影響を及ぼします30。この複雑なネットワークは数多くの生理学的および病理学的プロセスに関与しており、遺伝子調節機構や、癌や慢性炎症性疾患などの疾患の病態解明に寄与しています。例えば、Wangらは11種類のlncRNA、5種類のmiRNA、および16種類のmRNAからなるceRNA共発現ネットワークを構築し、そのコアサブネットワークがCOPDにおける免疫細胞比率の変化および肺機能に関連していることを明らかにしました31。同様に、Zhangら32は、男性喫煙者の末梢血単核球に基づいたcircRNA-miRNA-mRNA ceRNAネットワークを構築し、発現異常のあるcircRNAおよびCOPDに関連する主要なパスウェイを特定しました。我々の共発現ネットワーク解析により、主要遺伝子は主に物理的相互作用、共発現、および共通のタンパク質ドメインを通じて機能的な結合を形成しており、複数の代謝関連パスウェイに有意に濃縮されていることが明らかになりました。これらの知見に基づき、我々はさらに転写因子(TF)-標的調節ネットワークおよびmiRNA-lncRNA-mRNA調節軸を構築しました。これらの結果は、COPDにおいて、主要遺伝子がlncRNA、転写因子、およびmiRNAが関与する多層的なメカニズムを通じて協調的に調節されている可能性を示唆しています。
免疫浸潤は、組織内または血液中における免疫細胞の分布と活性を示すことで、免疫状態を反映します。これに基づき、計算機スクリーニングを用いて潜在的な候補薬を予測し、次に分子ドッキングシミュレーションを行って標的タンパク質との結合親和性と安定性を評価しました。これらの解析を合わせることで、新規治療薬の同定が促進され、疾患メカニズムに関するより深い知見が得られます。本研究では、6つの主要遺伝子がほとんどの免疫細胞浸潤と正の相関を示しました。薬剤予測により、UPP1とフルオロウラシル、カペシタビン、および5-benzylacyclouridineとの間の潜在的な相互作用が特定され、分子ドッキングによって後者が最強の結合親和性を持つことがさらに確認されました。特筆すべき点として、フルオロウラシルとカペシタビンは主に抗腫瘍剤として使用されており、本研究ではCOPDに対する検証済みの治療選択肢としてではなく、データベースで予測されたUPP1相互作用化合物として同定されました。先行研究では、重度の気道閉塞例においてフルオロウラシルの局所投与が気道の開通性を改善させる可能性があることが報告されています33。しかし、他のエビデンスでは、フルオロウラシルとカペシタビンが、特に肺疾患を既往に持つ患者において肺毒性を誘発する可能性が示唆されています34。したがって、COPDに対するこれらの薬剤の潜在的な関連性については、さらなる実験的検証と安全性確認が必要です。さらに、CTD解析により、6つの主要遺伝子のすべてが複数の病理学的プロセスに関連していることが示されました。総じて、免疫浸潤、薬剤予測、および分子ドッキングの統合解析は、COPDの精密治療のための新たな分子標的と理論的根拠を提供し、それに関連する薬剤の開発と臨床応用を促進するものです。
それにもかかわらず、いくつかの限界を認める必要がある。本研究は比較的限られたサンプルソースを持つ公開データセットに依存しており、これがバッチ効果やモデルの過学習を招いた可能性がある。RT-qPCRによる検証は少人数のコホートで実施されており、B4GALT2の発現に認められた不一致は、コホートの不均一性の可能性を示唆している。加えて、免疫浸潤および薬剤予測解析は計算科学的な手法であり、さらなる実験的検証が必要である。さらに、探索段階のバイオインフォマティクス研究であるため、我々の診断モデルは主に95%信頼区間を伴うAUC値を用いて評価された。公開データセットの後ろ向きな性質およびサンプルサイズの制限により、感度、特異度、予測値、および詳細なキャリブレーション統計量などの包括的な性能指標は十分に評価されていない。したがって、本モデルは概念実証ツールとして捉えるべきであり、その臨床的有用性については、より大規模な前向きコホートでのさらなる検証が必要である。
統合的なバイオインフォマティクスおよび機械学習解析を通じて、本研究ではCOPDに有意に関連する6つの主要遺伝子を特定しました。強固な診断モデルを構築し、複数のコホートにおいて信頼性の高い予測性能を実証しました。機能解析により、これらの遺伝子が転写および転写後調節、免疫細胞浸潤、ならびにニコチン依存および細胞周期に関連するパスウェイを含む重要な調節ネットワークに関与していることが明らかになりました。薬剤予測および分子ドッキング解析により、UPP1が有望な治療標的であることが浮き彫りになり、いくつかの候補化合物が強い結合親和性を示しました。総じて、これらの知見はCOPDの病態生理に関する理解を深め、将来的な治療法開発および精密医療戦略のための貴重な分子標的を提供するものです。
開示事項
著者は利益相反がないことを宣言します。本研究に参加したすべての被験者からインフォームドコンセントを得ました。
謝辞
本研究に不可欠な臨床施設および行政的支援を提供していただいた深セン市羅湖区中医院に感謝いたします。最後に、本研究に参加したすべての患者様および健康なボランティアの方々に感謝申し上げます。皆様のご協力はこの研究にとって不可欠なものでした。本研究は、深セン市医学三名プロジェクト(No. SZZYSM202401018)、羅湖区重点専門分野基金(No. LX202402021)、および羅湖区重点専門分野基金(No. LX202302064)の支援を受けて実施されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| β-actin プライマー | Tsingke | N/A | Forward: 5’-CATGTACGTTGCTATCCAGGC-3’ Reverse: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| B4GALT2 プライマー | Tsingke | N/A | Forward: 5’-GGGCAGACTGCTGATCGAG-3’ Reverse: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Online | 分子ドッキング |
| clusterProfiler | Bioconductor | v4.14.6 | 濃縮解析 |
| Cytoscape | Cytoscape Consortium | v3.8.3 | ネットワーク可視化 |
| DrugBank | University of Alberta | Online | 薬剤予測 |
| FAM168B プライマー | Tsingke | N/A | Forward: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Reverse: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | LASSO回帰 |
| GSVA | Bioconductor | v1.52.3 | ssGSEA解析 |
| Hifair III 1st Strand cDNA Synthesis Supermix | YEASEN | 11141ES | cDNA合成 |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | qPCR増幅 |
| limma | Bioconductor | v3.54.0 | 変動発現解析 |
| LightCycler 480 II System | Roche | LightCycler 480 II | リアルタイムPCR |
| PTRF プライマー | Tsingke | N/A | Forward: 5’-GGGCCGTAGACCAGATCCA-3’ Reverse: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| PRKCDBP プライマー | Tsingke | N/A | Forward: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Reverse: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| R software | R Foundation | v4.4.2 | 統計計算 |
| randomForest | CRAN | v4.7 | ランダムフォレスト |
| RNA isolater MolPure Blood RNA Kit | YEASEN | 19241ES50 | RNA抽出 |
| STRING database | EMBL | Online | PPIネットワーク |
| TOR3A プライマー | Tsingke | N/A | Forward: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Reverse: 5’-CCCGTCCCGATACAGGTTC-3’ |
| UPP1 プライマー | Tsingke | N/A | Forward: 5’-CTGTCAGTCATGGTATGGGCA-3’ Reverse: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA | CRAN | v1.72 | 共発現ネットワーク |
| xgboost | CRAN | v1.7 | XGBoostアルゴリズム |
参考文献
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.