本プロトコルでは、多次元トランスクリプトームデータと機械学習を統合し、拡張型心筋症における老化およびミトコンドリア関連遺伝子を特定することで、バイオマーカーの探索および分子サブタイピングを行います。
この記事について
サマリー
要約
拡張型心筋症(DCM)は、左室拡大と収縮不全を特徴とし、ミトコンドリア機能不全および免疫炎症活性化に関連しています。しかし、DCMにおける加齢に関連した分子シグネチャーやミトコンドリア調節経路については、まだ十分に解明されていません。本研究では、Gene Expression Omnibusデータベースから6つのバルクトランスクリプトームデータセットと1つの単一細胞RNAシーケンシングデータセットを解析しました。データの正規化、バッチ補正、および細胞型アノテーションの後、差異発現解析、加重遺伝子共発現ネットワーク解析、およびタンパク質相互作用ネットワーク構築を用いて、加齢およびミトコンドリアに関連する候補遺伝子を同定しました。さらに、Lasso回帰(least absolute shrinkage and selection operator regression)、ランダムフォレスト、およびサポートベクターマシン再帰的特徴消去法を用いて、コア遺伝子のスクリーニングを行いました。また、DCMにおける心臓免疫微小環境を特徴づけるため、免疫細胞浸潤、細胞間相互作用、および分子サブタイプ解析を実施しました。その結果、合計66個の加齢関連遺伝子と16個のミトコンドリア関連遺伝子がDCMに関連しており、主に低酸素誘導因子-1(hypoxia-inducible factor-1)シグナリング、酸化還元リン酸化、および一酸化窒素合成酵素関連パスウェイに濃縮していることが分かりました。機械学習および単一細胞RNAシーケンシング解析により、SERPINE1、TGFB2、CYBB、およびTLR2がコア遺伝子として同定されました。CYBBとTLR2は単球およびマクロファージで高発現しており、一方でSERPINE1とTGFB2は主にストロマ細胞で発現していました。免疫ランドスケープ解析では、DCMサンプルにおいて炎症性マクロファージの活性化の増加と細胞間相互作用の変化が認められました。コア遺伝子の発現に基づき、DCMサンプルは血管内皮細胞増殖因子(vascular endothelial growth factor)シグナリングおよび一次胆汁酸生合成にそれぞれ関連する2つの分子サブタイプに分類されました。本プロトコルは、DCMにおける候補バイオマーカーおよび分子サブタイプを同定するための統合的な枠組みを提供するものです。
概要
拡張型心筋症(DCM)は、左室拡大と収縮機能不全を特徴とする心筋疾患です。これは心不全の原因として世界で3番目に多く、心臓移植の最大の適応疾患となっています1。人口ベースの研究では、成人約250人に1人の割合で発症すると推定されており、男性でより高い有病率を示し、症例の相当数が単一遺伝子変異に起因しています2。これらの知見は、遺伝的感受性と環境因子の両方がDCMの発症および進展に関与していることを示唆しています。
DCMの病態生理には、炎症性活性化、酸化ストレス、心筋細胞のアポトーシス、および線維化促進シグナルの調節不全を含む、相互に関連したプロセスが関与しています。腫瘍壊死因子-α(tumor necrosis factor-α)のプロモーター変異を含む炎症性遺伝子多型は、ウイルス性DCMへの感受性と関連していることが報告されています3。また、酸化ストレスの増大は、ヒトDCMのサブタイプにおける心筋細胞死および左室機能不全と関連しています4。さらに、Wnt/β-cateninおよびカルシニューリン/活性化T細胞核因子(calcineurin/nuclear factor of activated T cells)シグナルの異常活性化は、心筋肥大と間質性線維化を促進し、それによって疾患の進行に寄与します5,6。心筋細胞はエネルギー需要が高いため、ミトコンドリア機能不全もDCMの重要な構成要素となります。ミトコンドリアのバイオジェネシス、カルシウム恒常性、ミトファジー、およびミトコンドリアDNAの完全性の崩壊は、酸化的にリン酸化を損ない、進行性の心機能不全に寄与する可能性があります7,8,9,10。
これらのメカニズムに関する知見があるものの、依然として重要な知識の空白が存在します。特に、DCMの発症および進行過程におけるミトコンドリアの構造的リモデリングとバイオエナジェティクス機能不全との間の時間的および因果関係は、十分に定義されていません11。これまで、いくつかの治療戦略が研究されてきました。幹細胞治療は、パラクリン効果、細胞保護効果、および免疫調節効果を通じて再生能力を示していますが、細胞源、投与経路、および移植後の生存率の最適化が依然として必要です12。アデノ随伴ウイルスを用いたデリバリーやCRISPRベースのゲノム編集を含む遺伝子治療アプローチも、潜在的な精密治療戦略となります。しかし、心臓への向性、ベクターの免疫原性、および長期的な安全性に関する制限は未解決のままです13。
Gene Expression Omnibus (GEO) などのリポジトリから得られる公開トランスクリプトームデータセットは、DCM のバイオマーカー探索に広く利用されています。これらのリソースは、多施設共同臨床コホートへのアクセスを可能にし、費用対効果が高く再現性のある調査を支援し、データセット間の統合を通じて統計的パワーを向上させることができます14。また、トランスクリプトームプロファイリングにより、ゲノムワイドな候補遺伝子のスクリーニング、分子サブタイピング、およびパスウェイレベルの解析が可能になります15。しかし、公開データセットには、技術的なバッチ効果、臨床的および病因的な不均一性、因果推論能力の限界、ならびに不完全な縦断的または予後情報といった固有の制限があります16。したがって、公開トランスクリプトームデータセットから得られた知見は、仮説の生成や候補バイオマーカーの優先順位付けに最も適しており、独立したコホートや実験モデルを用いた検証が必要となります。
DCMに関する多くのバイオインフォマティクス研究は、主に差次的発現解析に依存していますが、これは偽陽性の結果を生成する可能性があり、心臓組織内の遺伝子共発現ネットワークや細胞の不均一性を十分に特徴付けることはできません。これらの制限に対処するため、本研究では相補的な手法を組み合わせた統合的解析戦略を採用しました。バルクトランスクリプトーム解析により、症例対照比較に適した組織レベルの発現プロファイルを得ることができます。加重遺伝子共発現ネットワーク解析(WGCNA)は、表現型形質に関連する遺伝子モジュールを特定し、個々の差次的発現遺伝子ではなく、機能的に関連する遺伝子セットの優先順位付けを可能にします。タンパク質-タンパク質相互作用(PPI)ネットワーク解析は、ネットワークトポロジーに基づいて接続性の高い遺伝子を特定します。統合データセット全体から候補バイオマーカーを特定するために、最小絶対収縮選択演算子(LASSO)回帰、ランダムフォレスト、およびサポートベクターマシン-再帰的特徴消去という3つの機械学習アルゴリズムが用いられました¹⁷。その後、単一細胞RNAシーケンシング(scRNA-seq)を用いて、細胞型特異的な発現パターンおよび細胞間相互作用ネットワークを検討しました18。
拡張型心筋症(DCM)において、ミトコンドリア機能不全と加齢に伴う分子変化はそれぞれ個別に研究されてきましたが、疾患に関連する転写変化における両者の複合的な関連性は十分に解明されていません。本研究では、複数のバルクトランスクリプトームおよびscRNA-seqデータセットを統合し、DCMにおける加齢およびミトコンドリア関連のハブ遺伝子を同定し、心臓の免疫微小環境を特性化し、同定された遺伝子に基づいた分子サブタイプを検討しました。この統合的なアプローチを用いることで、候補バイオマーカーの優先順位を決定し、その後のメカニズム解明および検証研究の基礎を提供しました。
プロトコル
すべての動物実験の手順は、河南省中医学大学第二附属病院の実験動物倫理委員会によって審査および承認されました(承認番号:HNSZYYYJS2023011150)。すべての手順は、「実験動物福祉の倫理審査指針(GB/T 35892-2018)」および、代替(Replacement)、削減(Reduction)、洗練(Refinement)の3R原則に従って実施されました。本研究で使用した試薬、データベース、ソフトウェア、および機器は、以下の通りです。 材料一覧表.
1. データリソースおよび実験材料
自発的に拡張型心筋症(DCM)表現型を示す体重 25 ± 2 g のSPFグレードのCTNTR141Wトランスジェニック雄マウスをモデル群として使用した。対照群として、体重 25 ± 2 g の同週齢のSPFグレードのC57BL/6J雄マウスを使用した。各群のマウス数は12匹とした。すべての動物は、有効な実験動物生産ライセンスを有する施設から入手し、温度 22 ± 2 °C、相対湿度 40%–60%、12時間の明暗周期のSPFグレードのバリア環境下で飼育し、滅菌済みのフードと水に自由にアクセスできるようにした。1週間の馴化期間の後、すべてのマウスをさらに4週間同じ条件下で維持し、その後、心機能評価およびサンプル採取を行った。実験開始時のマウスの週齢は6~8週であった。マウスは深い麻酔をかけた後、頸椎脱臼により安楽死させた。
DCM患者の左室心筋組織に関する7つの公開トランスクリプトームデータセットをGene Expression Omnibus (GEO)19データベースから取得した。これらのデータセットには、6つのバルクトランスクリプトームデータセットと、1つの単一細胞RNAシーケンシング (scRNA-seq) データセットであるGSE145154が含まれていた。分析にはCD45陽性画分とCD45陰性画分の両方が含まれた。また、クラスタリングの前にCD45陽性細胞画分とCD45陰性細胞画分を統合した。Harmony統合における主要なバッチ変数としてサンプルIDを使用した。GSE145154からは、正常左室およびDCM左室のサンプル、具体的にはGSM4307515、GSM4307516、GSM4307520、およびGSM4307521を含めた。本研究で使用したデータセットは、GSE145154、GSE5406、GSE42955、GSE57338、GSE79962、GSE116250、およびGSE141910であった。DCM以外のすべてのサンプルを除外し、対照サンプル (Control group) とDCMサンプル (DCM group) のみを採用した。品質管理後に削除されたサンプルはなかった。組み込まれたGEOデータセットのサンプル情報は以下の通りである:GSE5406は102サンプル(対照16、DCM 86)、GSE42955は17サンプル(対照5、DCM 12)、GSE57338は231サンプル(対照136、DCM 95)、GSE79962は20サンプル(対照11、DCM 9)、GSE116250は51サンプル(対照14、DCM 37)、GSE141910は322サンプル(対照161、DCM 161)であった。
2. バルクトランスクリプトームデータの前処理
6つのバルクデータセットの未処理の発現マトリックスおよび臨床アノテーションファイルを、GEOqueryパッケージ20を用いてダウンロードした。Affymetrixマイクロアレイデータセットについては未処理のCELファイルを、RNA-seqデータセットについては未処理のカウントマトリックスを取得した。マイクロアレイデータの背景補正、クオンタイル正規化、および発現量の算出は、affyパッケージ21に実装されているRobust Multi-array Average(RMA)アルゴリズムを用いて行った。
RNA-seqのカウントデータは、edgeRパッケージ22のTMM(trimmed mean of M-values)法を用いて正規化し、log₂変換したCPM(counts per million)値に変換しました。プローブ識別子は、プラットフォーム固有のアノテーションファイルを使用して公式の遺伝子シンボルに変換しました。複数のプローブが同一の遺伝子にマッピングされた場合は、発現量の平均値を算出しました。
svaパッケージ23のComBatアルゴリズムを用いて、データセット間の技術的なバッチ効果を除去した。データセットのソースおよび検出プラットフォームをバッチ要因として指定した。バッチ効果除去の有効性を評価するため、バッチ補正の前後に主成分分析を行った。
3. 単一細胞トランスクリプトームデータの前処理および細胞アノテーション
GSE145154の遺伝子発現マトリックスをSeuratにインポートし、Seurat version 524を用いてSeuratオブジェクトを構築した。以下の閾値を用いて低品質の細胞を除外した:1細胞あたりの検出遺伝子数が200~6,000個、総固有分子識別子(UMI)数が500超、およびミトコンドリア遺伝子の割合が25%未満。これらの品質管理閾値から外れた細胞は、低品質または破裂した細胞として除外した。我々は、上述の品質管理閾のみを用いて低品質細胞を除外した。
NormalizeData関数を用い、スケール因子10,000でログ正規化を行った。vst法を用いたFindVariableFeatures関数により、変動性の高い上位3,000個の遺伝子を選択した。ScaleDataを用いてデータをスケーリングし、次いで線形次元削減のために主成分分析を実施した。
バッチ効果の補正は、RunHarmony関数を用いてHarmonyアルゴリズム25により行い、グループ化変数としてサンプル識別子を指定した。FindNeighborsおよびFindClusters関数を用いて、上位15個の主成分に基づき細胞のクラスタリングを行った。クラスタリングには、解像度0.15のLeidenアルゴリズムを使用した。非線形次元圧縮および可視化には、t-SNE(uniform manifold approximation and projection)を用いた。
細胞型の注釈付けは、カノニカルマーカー遺伝子およびSingleRパッケージ26を用いた自動注釈付けにより行われました。マーカー遺伝子は以下の通りです:B細胞:IGKC、MS4A1、CD79A;心筋細胞:TNNI3、MYL2、ACTC1;血管内皮細胞:VWF、PECAM1、EGFL7;マクロファージ:C1QC, C1QB、C1QA;単球:S100A8、S100A9、G0S2;ナチュラルキラー細胞:NKG7、GNLY、CCL5;平滑筋細胞:MYL9、TAGLN、ACTA2;ストローマ細胞:FBLN1、LUM、DCN;およびT細胞:CD3E、CD3G、CD3D。
4. 発現変動解析および遺伝子セット濃縮スコアリング
limmaパッケージを用いて線形モデルを構築した。27 DCM群と健康対照群の間で遺伝子発現を比較するため。P値が < 0.05であり、かつ1.5倍を超える絶対的なフォールド変化(これは絶対的なlogに相当する)₂ フォールドチェンジが0.58より大きいものを、有意に差次的に発現していると定義した。
各サンプルにおける老化関連およびミトコンドリア関連の遺伝子セットの濃縮スコアを算出するため、シングルサンプル遺伝子セット濃縮解析(ssGSEA)を実施した28。DCM群と健康対照群の間の濃縮スコアの差はウィルコクソン順位和検定を用いて評価し、P値 < 0.05 を統計的に有意とみなした。
単一細胞レベルにおいて、加齢関連およびミトコンドリアのモジュールスコアをSeuratのAddModuleScore関数を用いて算出した。群間のモジュールスコアの差は、Wilcoxon順位和検定を用いて評価した。
加齢関連遺伝子シグネチャーをCellAgeデータベース(https://genomics.senescence.info/cells/)から取得し、ミトコンドリア関連遺伝子セットをGeneCards(https://www.genecards.org/)から取得した。スコアリングに使用した完全な遺伝子リストは、Supplementary File 1に記載している。
5. 重み付き遺伝子共発現ネットワークの構築
バルクトランスクリプトームデータにおいて発現分散が最も高い上位5,000個のタンパク質コード遺伝子を、ネットワーク構築のために保持した。複数のソフトしきい値べき(soft-thresholding powers)におけるスケールフリー・トポロジー適合指数を算出するため、pickSoftThreshold関数を適用した。最適なしきい値は、R値が2 0.9を超える値。したがって、ソフトしきい値処理のべき乗は β 後続のネットワーク解析には、= 5 が採用された。
最小モジュールサイズを30として、blockwiseModules関数を用いて符号付き重み付き共発現ネットワークを構築した。各モジュールの固有遺伝子(eigengene)と、老化関連またはミトコンドリア濃縮スコアとの間でピアソン相関係数を算出した。絶対相関係数が0.4を超え、P < 0.001であるモジュールを、有意に関連するモジュールとみなした。
有意に関連するモジュール内の遺伝子を、発現変動遺伝子と交差させ、DCM関連の老化候補遺伝子およびDCM関連のミトコンドリア候補遺伝子を同定しました。
6. 機能濃縮分析
clusterProfilerパッケージ29を用いて、候補遺伝子に対してGene Ontology (GO)およびKyoto Encyclopedia of Genes and Genomes (KEGG)パスウェイ分析を含む機能濃縮分析を行った。GO濃縮分析では、生物学的プロセス、細胞成分、分子機能の3つの標準カテゴリーを対象とした。
すべての解析は、ヒト種のアノテーション、P値補正のための偽発見率(FDR)、および0.05のq値しきい値を用いて行われた。遺伝子セットは10〜500遺伝子のサイズ範囲に制限され、FDRが < 0.05を統計的に有意であると定義した。最後に、GOエンリッチメントの結果を可視化した。 〜経由で グループ棒グラフを用い、一方でKEGGエンリッチメントの結果はバブルプロットを用いて表示した。
7. PPIネットワークの構築とハブ遺伝子のスクリーニング
候補遺伝子をSTRINGデータベース(バージョン11.5)30に入力し、生物種をHomo sapiensに、相互作用の信頼度閾値を複合スコア0.7超に設定した。切り離されたノードは非表示にし、相互作用データをタブ区切り値形式でエクスポートした。
相互作用データは可視化のためにCytoscape version 3.9.1にインポートされた31。ノードのトポロジカルスコアは、CytoHubbaプラグイン32を用い、Degree、最大近傍成分(maximum neighborhood component)、および最大クリーク中心性(maximal clique centrality)の3つのアルゴリズムを使用して算出された。
ネットワーク内のコア機能モジュールは、MCODEプラグイン33を用い、次数カットオフ 2、k-core 2、ノードスコアカットオフ 0.2、最大深度 100というデフォルトパラメータで特定した。3つのトポロジーアルゴリズムすべてで上位10位以内にランクされた遺伝子と、MCODEコアサブネットワーク内の遺伝子を共通抽出することで、最終的なタンパク質相互作用ハブ遺伝子を特定した。
8. 機械学習に基づくコア遺伝子の選別と診断モデルの構築
再現性と表現のバランスを確保するため、統合されたバルク転写液データセットを、固定ランダムシード(seed = 123456)を用いて、トレーニングセットと検証セットに7:3の比率でランダムに分割した。この分割は、両セット間でクラス比率を一定に保つため、疾患グループ(DCM vs. コントロール)による層化抽出を行った。分割に先立ち、異なるデータセットソースに由来するバッチ効果をsvaパッケージを用いて補正し、統合されたサンプルを単一のコホートとしてランダム割り当てに用いた。
候補遺伝子をスクリーニングするために、3つの機械学習アルゴリズムを適用した。まず、LASSOロジスティック回帰を実施した。 〜経由で glmnetパッケージのcv.glmnet関数345分割交差検証による二値分類モデルを構築し、評価指標としてAUCを採用した。lambda.minにおいて係数が非ゼロであった遺伝子を候補遺伝子として抽出した。
次に、randomForestパッケージ35を用いて、500本の決定木を持つランダムフォレスト分類モデルを構築した。各分割時にサンプリングされる変数の数は、全特徴量の数の平方根に設定した。ジニ係数に基づいて遺伝子の重要度を定量化し、重要度スコアの高い上位10遺伝子を保持した。
第三に、caretパッケージ36のrfe関数を用いてSVM-RFE解析を実施した。特徴量数は1〜10の範囲で設定し、モデルのトレーニングには5分割交差検証を採用した。最終的に、交差検証における精度が最適であった遺伝子サブセットを選択した。
3つすべてのアルゴリズムによって特定された遺伝子を、DCMにおける最終的なコア加齢およびミトコンドリア関連遺伝子として定義しました。その後、決定木、勾配ブースティングマシン、ブースト一般化線形モデル、k近傍法、ロジスティック回帰、ニューラルネットワーク、部分的最小二乗法、ランダムフォレスト、サポートベクターマシン、および極端な勾配ブースティングの10種類の分類アルゴリズムを用いて、診断モデルを構築しました。
pROCパッケージ37を用いて、受信者動作特性(ROC)曲線を作成した。トレーニングセットおよび検証セットにおける診断性能を評価するため、曲線下面積(AUC)、正診率、感度、および特異度を算出した。
各コア遺伝子がモデルの予測に与える寄与度を算出するため、SHapley Additive exPlanations(SHAP)解析を実施した38。サマリープロットおよびサンプルごとのウォーターフォールプロットを作成した。検証セットにおいて曲線下面積(AUC)が0.8を超える最終的な診断モデルを、診断性能が良好であると定義した。
9. 細胞間コミュニケーションの推論
心臓微小環境における細胞間コミュニケーションネットワークをCellChatパッケージ39を用いて推論した。CellChatDB.humanデータベースを使用してCellChatオブジェクトを構築した。identifyOverExpressedGenesを用いて発現変動リガンドおよび受容体を同定し、identifyOverExpressedInteractionsを用いて有意な相互作用ペアをフィルタリングした。
細胞型間の通信確率はcomputeCommunProbを用いて算出した。全細胞型レベルの通信ネットワークはaggregateNetを用いて集約した。各細胞型のペア間の相互作用数および通信強度は、ヒートマップと棒グラフを用いて定量化および可視化した。
10. 免疫細胞浸潤の定量化
single-sample gene set enrichment analysis28および免疫細胞シグネチャー遺伝子セット40を用いて、各バルクサンプルの28種類の免疫細胞タイプの濃縮スコアを算出した。DCM群と健康対照群の間で免疫細胞濃縮スコアを比較するために、Wilcoxon順位和検定を用いた。P < 0.05を統計的に有意とみなした。
コア遺伝子の発現レベルと免疫細胞の濃縮スコアとの関連性を評価するために、ピアソン相関分析を実施した。P < 0.05 のすべての相関を統計的に有意であると見なした。
11. 分子サブタイプ分類のためのコンセンサスクラスタリング
コア遺伝子の発現プロファイルを用いて、DCMサンプルの教師なしコンセンサスクラスター解析を行った。 経由で ConsensusClusterPlusパッケージ41クラスタリングパラメータは、最大クラスター数を6、リサンプリング回数を1,000回、リサンプリング比率を0.8に設定した。クラスタリングにはユークリッド距離を用いたPAM法(Partitioning Around Medoids)を採用し、再現性を確保するために固定の乱数シードを使用した。
デルタエリアプロットおよびコンセンサスクラスター安定性スコアに基づき、最適なサブタイプ数を決定した結果、最終的に K = 2 と特定された。さらに、主成分分析を行い、2つの分子サブタイプが明確に分離していることを検証した。
サンプル特異的なKEGGパスウェイの濃縮スコアを算出するために、遺伝子セット変動解析(Gene set variation analysis)42を適用した。サブタイプ間でのパスウェイ活性化の差を検出するためにlimmaパッケージ27を使用し、P値が0.05未満の場合を統計的に有意と定義した。
12. 超音波心エコーによる心機能評価
マウスを麻酔した。 〜経由で 1%ペントバルビタールナトリウム(30 mg/kg)を腹腔内投与し、恒温手術台の上で仰臥位に固定した。胸部の除毛後、前胸部に超音波用カップリングジェルを均一に塗布した。
小動物用超音波診断装置を用い、左室乳頭筋レベルにて2次元ガイド下Mモード心エコー検査を実施した。左室拡張末期径、収縮末期径、駆出率、および短軸的短縮率を測定するため、安定した心周期を3回連続でキャプチャした。すべての心エコー評価は、専門の超音波検査士によってブラインドで実施された。
各群から3匹のマウスをランダムに選択して心エコー検査を行い、その後、心筋組織の採取およびELISA測定のためにこれら計6匹を屠殺した。残りの実験動物については、別途並行してラボアッセイを実施したが、そのデータは本研究には含めていない。
13. 心筋組織の採取、タンパク質抽出、および酵素結合免疫吸着法(ELISA)
心エコー検査による評価の後、マウスを深い麻酔下で安楽死させた。続いて、心臓組織を迅速に採取した。 経由で 正中胸骨切開を行い、左心室心筋を氷上で摘出した。単離した組織は、心腔内に残存する血液を除去するため、氷冷リン酸緩衝生理食塩水で十分に洗浄した。滅菌フィルターペーパーで余分な液体を吸い取った後、サンプルを直ちに液体窒素で急冷凍結し、−80 °C その後のタンパク質抽出に用いる。その際、凍結融解を繰り返すことは厳禁とする。
凍結した心筋組織を重量測定し、氷上で約1 mm3の断片に細切した。組織を、プロテアーゼ阻害剤およびホスファターゼ阻害剤を含む氷冷RIPA溶解バッファー中で、組織10 mgあたり100 µLの標準比率で溶解させた。サンプルを氷上で機械的に完全にホモジナイズし、完全な細胞溶解を行うため30分間インキュベートした。
溶解物を4 °Cで12,000 × gにて15分間遠心分離した。得られた上清を酵素フリーのチューブに回収し、製造元のプロトコルに従って bicinchoninic acid タンパク質定量キットを用いて全タンパク質濃度を定量した。すべてのサンプルを溶解バッファーを用いて同一のタンパク質濃度に標準化した。
心筋溶解液中における4つのハブ遺伝子のタンパク質発現レベルを、対応する酵素結合免疫吸着法(ELISA)キットを用いて測定した。段階希釈した標準試料および正規化した組織溶解液を、あらかじめコーティングされたマイクロプレートに、1ウェルあたり100 µLずつ、デュプリケート(2連)で添加した。プレートを室温で2時間インキュベートし、キット付属の洗浄バッファーで十分に洗浄した。
各ウェルに酵素標識抗体を添加し、室温で1時間インキュベートした後、十分に洗浄した。次に基質発色溶液を加え、プレートを暗所、室温で20分間インキュベートした。停止液を用いて呈色反応を停止させ、全波長マイクロプレートリーダーを用いて450 nm(参照波長:570 nm)で吸光度を測定した。
14. 統計解析
すべての統計解析およびデータの可視化は、R version 4.2.3を用いて行った。各標的遺伝子(TGFB2、SERPINE1、CYBB、TLR2)のELISA濃度測定について、まずShapiro-Wilk検定を適用し、Control群とDCM群のデータの正規性を個別に評価した。続いて、F検定を用いて2群間の分散の均質性を評価した。群間比較の方法は、分散の均質性検定の結果に基づいて決定した。分散が均質である場合(P ≥ 0.05)は、群間の平均値を比較するために対応のないStudent's t-testを採用し、分散が不均一である場合(P < 0.05)は、補正されたWelch's t-testを解析に利用した。すべての検定は両側検定とし、統計的有意性の閾値はP < 0.05に設定した。データは、個々のデータ点をジッター表示して重ね合わせたボックスプロットとして可視化した。すべての検定のP値および実施したt-testの種類は、各プロットに詳細に記載した。
結果
データのプリプロセッシングおよび差分的発現解析
6つのバルクトランスクリプトームデータセットすべてに対し、ダウンストリーム解析の前に標準的なプリプロセッシングおよびバッチ効果の補正を行った。マイクロアレイデータはrobust multi-array averageアルゴリズムを用いて正規化し、RNA-seqカウントデータはtrimmed mean of M-values法を用いて正規化した。データセットのソースおよび検出プラットフォームに関連する技術的なバッチ効果を除去するために、ComBatアルゴリズムを適用した。主成分分析の結果、補正前はサンプルがデータセットソースごとにクラスター化していたが、補正後はバッチによる明確な分離は見られず、より均一に分布していることが示された。
拡張型心筋症(DCM)群と健康対照(HC)群との間の差分的発現解析をlimmaパッケージを用いて行った。最も有意に差分的に発現した上位20遺伝子のヒートマップでは、2群間で発現プロファイルが分離していることが示された(図1A)。P値 < 0.05 および |log₂ fold change| > 0.58 の閾値を用いて、計1,473個の差分的発現遺伝子が同定された。このうち、DCM心筋サンプルにおいて819遺伝子が発現上昇し、654遺伝子が発現低下していた(図1B)。
次に、単一サンプル遺伝子セット濃縮解析を用いて、各サンプルにおける加齢関連およびミトコンドリア関連遺伝子セットの濃縮スコアを算出した。いずれのスコアも、DCM群とHC群の間で有意に異なっていた(図 1C)。
加重遺伝子共発現ネットワーク解析
加齢関連およびミトコンドリア濃縮スコアに関連する遺伝子モジュールを特定するため、加重遺伝子共発現ネットワーク解析を実施した。バルクデータセットにおいて発現分散が最も高い5,000個のタンパク質コード遺伝子を用いてネットワークを構築した。ソフトしきい値パワー β = 5 において、スケールフリートポロジー適合指数が R2 = 0.9 を超え、スケールフリーネットワークの基準を満たした(図 1D)。
階層的クラスタリングとモジュール統合により、3つの遺伝子モジュールが特定されました。これら3つのモジュールはすべて、老化関連スコアと有意に相関していました。ターコイズ色のモジュールが、老化関連スコアと最も強い相関を示しました(r = 0.69, P < 0.001)。ミトコンドリアスコアについては、青色および灰色のモジュールが有意に相関しており、青色モジュールが最も強い関連性を示しました(r = 0.56, P < 0.001; 図 1E)。したがって、老化関連遺伝子のスクリーニングにはターコイズ色のモジュールが、ミトコンドリア関連遺伝子のスクリーニングには青色モジュールが選択されました。
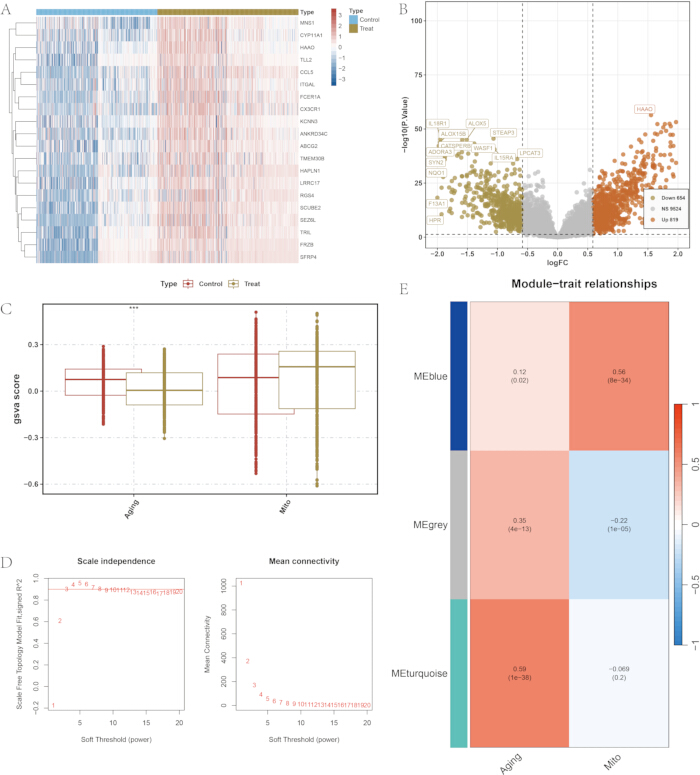
図 1: 差分的発現解析および加重遺伝子共発現ネットワークの構築。 (A) 拡張型心筋症 (DCM) 群と健康対照 (HC) 群の間で最も有意に差分的発現を示した上位20遺伝子のヒートマップ。 (B) 全ての差分的発現遺伝子のボルケーノプロット。赤色は発現上昇遺伝子、緑色は発現低下遺伝子、灰色は有意でない遺伝子を示す。閾値は P value < 0.05 および |log₂ fold change| > 0.58 とした。 (C) 加齢関連およびミトコンドリア関連遺伝子セットに対するシングルサンプル遺伝子セット濃縮解析スコアのボックスプロット。 (D) 加重遺伝子共発現ネットワーク解析のためのソフト閾値選択。異なるソフト閾値パワーにおけるスケールフリートポロジー適合指数と平均接続度を示す。 (E) モジュール固有遺伝子と加齢関連およびミトコンドリアスコアとの相関を示すヒートマップ。こちらのリンクをクリックして、この図の拡大版を表示してください。
老化およびミトコンドリア関連候補遺伝子の同定
変動的に発現した遺伝子、選択した加重遺伝子共発現ネットワーク解析(WGCNA)モジュールの遺伝子、および対応するリファレンス遺伝子セットを交差させることで、候補遺伝子を同定した。この解析により、66個のDCM関連老化候補遺伝子(図 2A)と16個のDCM関連ミトコンドリア候補遺伝子(図 2B)が同定された。
Gene Ontology濃縮分析により、老化関連候補遺伝子が、一酸化窒素シンターゼ生合成やコラーゲン含有細胞外マトリックス構築を含む生物学的プロセスに濃縮されていることが示されました(図2C)。ミトコンドリア関連候補遺伝子は、ミトコンドリア内膜や呼吸鎖複合体を含む、ミトコンドリアエネルギー代謝に関連する用語に濃縮されていました(図2D)。
Kyoto Encyclopedia of Genes and Genomes解析により、老化関連の候補遺伝子が、低酸素誘導因子-1、ホスホイノシチド3-キナーゼ-プロテインキナーゼB、および最終糖化産物-最終糖化産物受容体シグナル伝達経路に濃縮していることが示された(図 2E)。ミトコンドリア関連の候補遺伝子は、酸化的にリン酸化などの経路に濃縮していた(図 2F)。
DCM群とHC群における老化関連候補遺伝子66個の差分的発現パターンを、発現ヒートマップを用いて可視化した(図2G)。また、ミトコンドリア関連候補遺伝子16個の発現パターンを、ボックスプロットを用いて可視化した(図2H)。
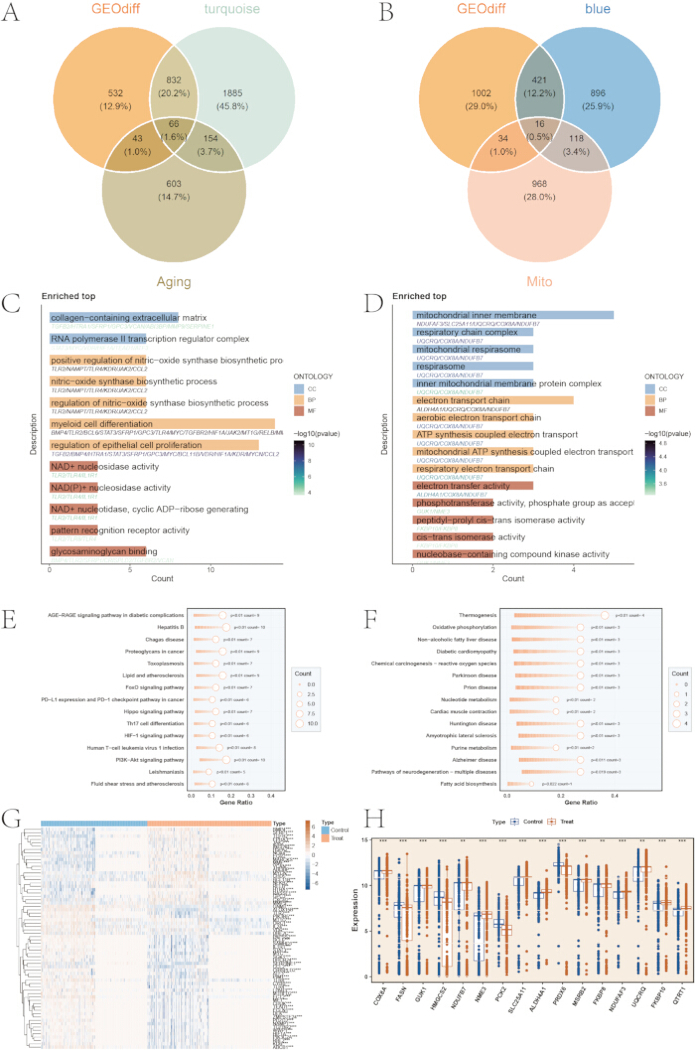
図 2: 候補遺伝子のスクリーニングおよび機能濃縮解析。 (A) 発現変動遺伝子、加重遺伝子共発現ネットワーク解析(WGCNA)モジュール遺伝子、および老化関連リファレンス遺伝子セットの積集合を示すベン図。 (B) 発現変動遺伝子、加重遺伝子共発現ネットワーク解析(WGCNA)モジュール遺伝子、およびミトコンドリア関連リファレンス遺伝子セットの積集合を示すベン図。 (C) 老化関連候補遺伝子のGene Ontology濃縮解析。 (D) ミトコンドリア関連候補遺伝子のGene Ontology濃縮解析。 (E) 老化関連候補遺伝子のKyoto Encyclopedia of Genes and Genomes(KEGG)パスウェイ濃縮解析。 (F) ミトコンドリア関連候補遺伝子のKyoto Encyclopedia of Genes and Genomes(KEGG)パスウェイ濃縮解析。 (G) DCM群およびHC群における老化関連候補遺伝子 66 個の発現ヒートマップ。 (H) DCM群およびHC群におけるミトコンドリア関連候補遺伝子 16 個の発現ボックスプロット。 こちらのリンクをクリックして、この図の拡大版を表示してください。
単一細胞RNAシーケンシングデータセットの細胞型アノテーション
単一細胞レベルでの検証に、GSE145154単一細胞RNAシーケンシングデータセットを使用した。品質管理フィルタリング、ログ正規化、およびHarmonyによるバッチ補正の後、異なるサンプルの細胞は、サンプル特有の分離が見られない状態で均一多様体近似および投影(UMAP)空間に分布した。上位15個の主成分と0.15のクラスタリング解像度を用いて、細胞を9つのクラスターに分割した(図3A)。
標準的なマーカー遺伝子およびSingleRを用いた自動アノテーションにより、マクロファージ、ナチュラルキラー細胞、T細胞、B細胞、内皮細胞、平滑筋細胞、単球、ストローマ細胞、心筋細胞の9つの主要な細胞型が同定された(図3B)。細胞型特異的なマーカー遺伝子の発現パターンから、これらのアノテーションが裏付けられた(図3C)。
AddModuleScore関数を用いて各細胞のミトコンドリアモジュールスコアを算出したところ、拡張型心筋症群と健康対照群の間で有意な差が認められた(P < 2.22 × 10⁻16; 図 3D)。老化関連モジュールスコアについても、これら2群間で有意な差が認められた(P < 2.22 × 10⁻16; 図 3E)。ミトコンドリアスコアをUMAP(uniform manifold approximation and projection)空間に投影したところ、高スコアは主に心筋細胞で観察された(図 3F)。対照的に、老化関連の高スコアは主にマクロファージで観察された(図 3G)。
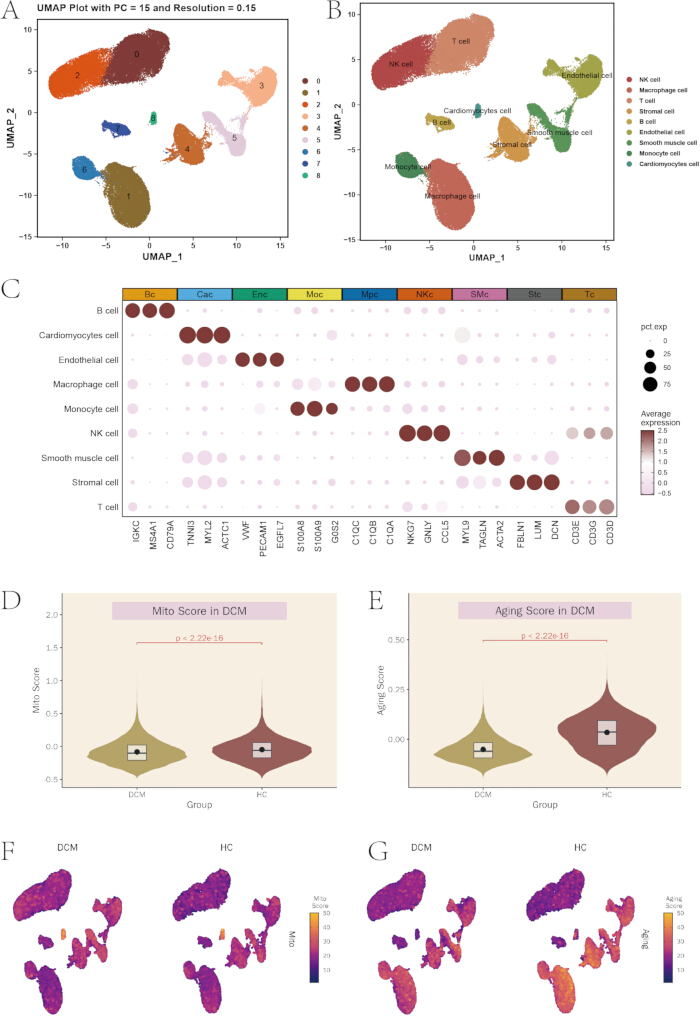
図 3: 単一細胞トランスクリプトームのアノテーションおよびモジュールスコア解析。 (A) 最初の15個の主成分と0.15のクラスタリング解像度を用いて生成された細胞クラスターのUniform Manifold Approximation and Projection(UMAP)プロット。 (B) アノテーション済み細胞型のUMAPプロット。 (C) 各細胞型における標準的なマーカー遺伝子の発現を示すバブルプロット。 (D) DCM群およびHC群におけるミトコンドリアモジュールスコアのバイオリンプロット。 (E) DCM群およびHC群における老化関連モジュールスコアのバイオリンプロット。 (F) 細胞全体におけるミトコンドリアモジュールスコアの分布を示すUMAPプロット。 (G) 細胞全体における老化関連モジュールスコアの分布を示すUMAPプロット。 こちらのリンクをクリックして、この図の拡大版を表示してください。
タンパク質相互作用ネットワークの構築
老化関連の候補遺伝子66個とミトコンドリア関連の候補遺伝子16個を合わせたセットをSTRINGデータベース(version 11.5)に入力し、結合スコア > 0.7 という高信頼度閾値を用いてタンパク質相互作用ネットワークを構築した。構築したネットワークをCytoscapeにインポートし、可視化およびトポロジー解析を行った(図 4A)。
次数、最大クリーク中心性、最大近傍コンポーネント、およびMCODE解析を用いて、高接続ノードとコアサブネットワークを特定しました。これらの手法によって特定されたサブネットワークを図 4B–Eに示します。
Degree、最大クリーク中心性、および最大近傍コンポーネントによってランク付けされた上位10個の遺伝子を、MCODEコアサブネットワーク内の遺伝子と交差させました。この解析により、TGFB2、TLR2、SERPINE1、CYBB、KDR、TLR4、HIF1A、CCL2、MMP9、CXCR2の10個の候補遺伝子が特定されました。
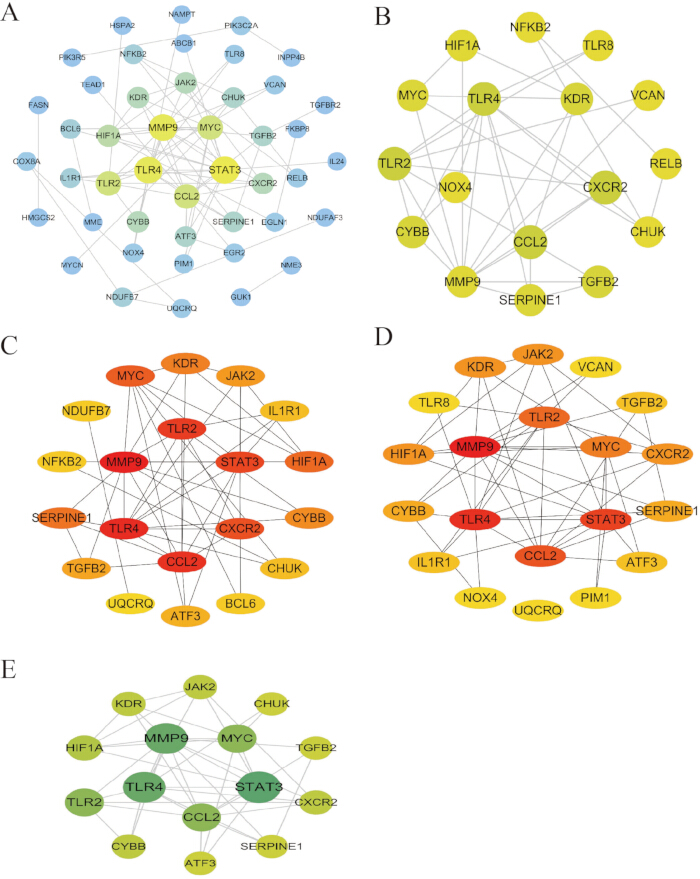
図 4: タンパク質間相互作用ネットワークの構築とハブ遺伝子のスクリーニング。
(A) 候補遺伝子のタンパク質間相互作用ネットワーク全体。 (B) MCODEを用いて特定されたコアサブネットワーク。 (C) maximal clique centralityを用いて特定されたコアサブネットワーク。 (D) maximum neighborhood componentを用いて特定されたコアサブネットワーク。 (E) Degreeを用いて特定されたコアサブネットワーク。 こちらのリンクをクリックして、この図の拡大版を表示してください。
機械学習を用いたハブ遺伝子のスクリーニング
10個のタンパク質相互作用候補からハブ遺伝子をスクリーニングするために、LASSO(least absolute shrinkage and selection operator)ロジスティック回帰、ランダムフォレスト、およびSVM-RFE(support vector machine-recursive feature elimination)の3つの機械学習アルゴリズムを適用した。すべての解析は、固定ランダムシード(set.seed(12345))および5分割交差検証を用いて実施した。LASSOモデルでは、最適ラムダ(lambda.min)において係数が非ゼロであった遺伝子を候補として保持した(図 5A)。
サポートベクターマシン-再帰的特徴消去(SVM-RFE)モデルでは、10個の特徴量を含めた場合に最高クロスバリデーション精度の0.859が達成され(図 5B)、対応する最小誤り率は0.141であった(図 5C)。500本の決定木を用いたランダムフォレストモデルでは、アウトオブバッグ(OOB)誤り率の安定した収束が示された(図 5D)。ジニ係数に基づく遺伝子重要度ランキングでは、TGFB2、TLR2、SERPINE1、およびCYBBが上位にランクされた(図 5E)。3つのアルゴリズムすべてで選択された遺伝子の共通部分は、最終的な4つのハブ遺伝子であるCYBB、SERPINE1、TGFB2、およびTLR2となった(図 5F)。
各ハブ遺伝子がモデルの予測にどの程度寄与しているかを評価するため、SHapley Additive exPlanations(SHAP)解析を実施した。平均絶対SHAP値は、TGFB2が0.249で最も高く、次いでSERPINE1が0.103、CYBBが0.083、TLR2が0.078であった(図6A)。サマリープロットは、サンプル全体における遺伝子寄与の分布と方向を示した(図6B)。ディペンダンスプロットは、個々の遺伝子値とモデルへの寄与との関係を明らかにし(図6C)、サンプルごとのウォーターフォールプロットは、個々の予測に対する各遺伝子の寄与を示した(図6D)。
その後、4つのハブ遺伝子に基づいた診断分類モデルを、10種類の分類アルゴリズムを用いて構築した。トレーニングセットにおいて、ほとんどのアルゴリズムで0.85以上の曲線下面積(AUC)値が得られた(図 6E)。内部検証セットにおいても、ほとんどのアルゴリズムで0.78以上の曲線下面積(AUC)値が得られた(図 6F)。
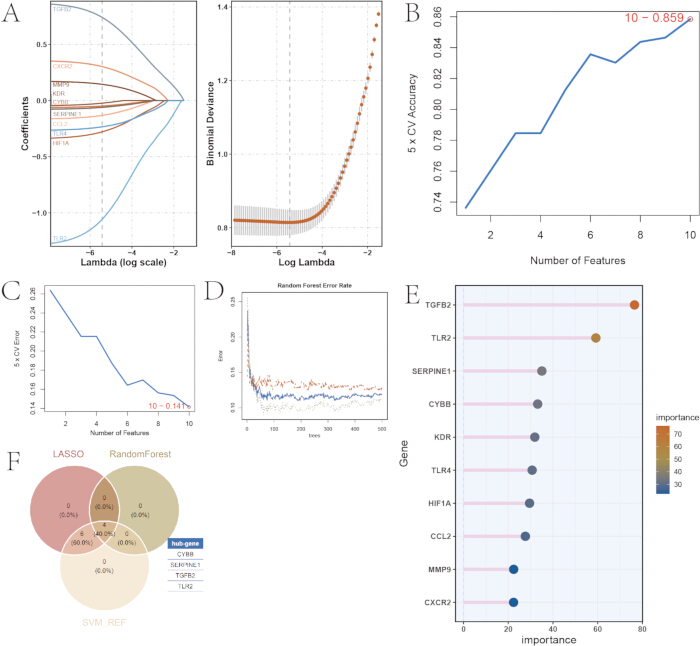
図 5: 機械学習を用いたハブ遺伝子のスクリーニング。 (A) LASSO(Least absolute shrinkage and selection operator)回帰係数の軌跡と最適なラムダの選択。 (B) サポートベクターマシン-再帰的特徴消去(SVM-RFE)モデルのクロスバリデーション精度曲線。 (C) サポートベクターマシン-再帰的特徴消去(SVM-RFE)モデルのクロスバリデーションエラー曲線。 (D) ランダムフォレストモデルのアウトオブバッグ(OOB)エラー率曲線。 (E) ランダムフォレストモデルにおけるジニ係数に基づく遺伝子の重要度ランキング。 (F) 3つの機械学習アルゴリズムによって同定されたハブ遺伝子を示すベン図。 この図の拡大版を表示するには、ここをクリックしてください。
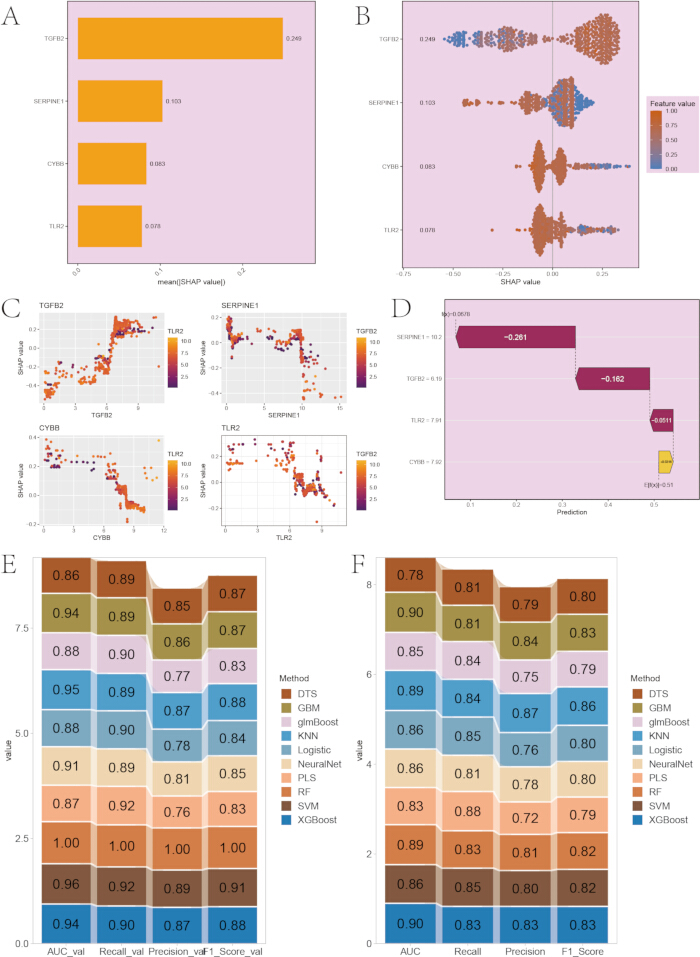
Figure 6: 診断モデルの評価およびSHapley Additive exPlanations(SHAP)分析。 (A>) 4つのハブ遺伝子におけるSHapley Additive exPlanationsの平均絶対値。(B>) 遺伝子の寄与度の分布と方向を示すSHapley Additive exPlanationsサマリープロット。(C>) 各ハブ遺伝子のSHapley Additive exPlanations依存性プロット。(D>) 代表的なサンプルのSHapley Additive exPlanationsウォーターフォールプロット。(E>) トレーニングセットにおける10種類の分類アルゴリズムの診断性能ヒートマップ。(F>) 検証セットにおける10種類の分類アルゴリズムの診断性能ヒートマップ。こちらのリンクをクリックして、この図の拡大版を表示してください。
シングルセルレベルでの検証および細胞間相互作用解析
4つのハブ遺伝子の発現パターンをシングルセルレベルで評価した。細胞型の分布解析により、CYBBおよびTLR2は単球およびマクロファージで高く発現していたのに対し、SERPINE1およびTGFB2は主にストローマ細胞で発現していることが示された(図 7A)。
バイオリンプロットにより、拡張型心筋症群と健常対照群の間でCYBBの発現に有意な差があることが示されました(図 7B)。SERPINE1(図 7C)、TGFB2(図 7D)、およびTLR2(図 7E)についても、群間で有意な差が認められました。これら4つの遺伝子はすべて、健常対照群と比較して拡張型心筋症群で有意に発現が上昇しており、各比較において P < 0.0001 でした。
CellChatおよびリガンド・受容体データベースを用いて、心臓微小環境における細胞間コミュニケーションネットワークを推定した。細胞間相互作用の数および全体的な強度は、拡張型心筋症群と対照群の間で異なっていた(図 7F)。また、細胞型間でのコミュニケーション強度の差も観察された(図 7G)。単球、マクロファージ、心筋細胞、およびストローマ細胞が、このコミュニケーションネットワークの主要な構成要素であった。
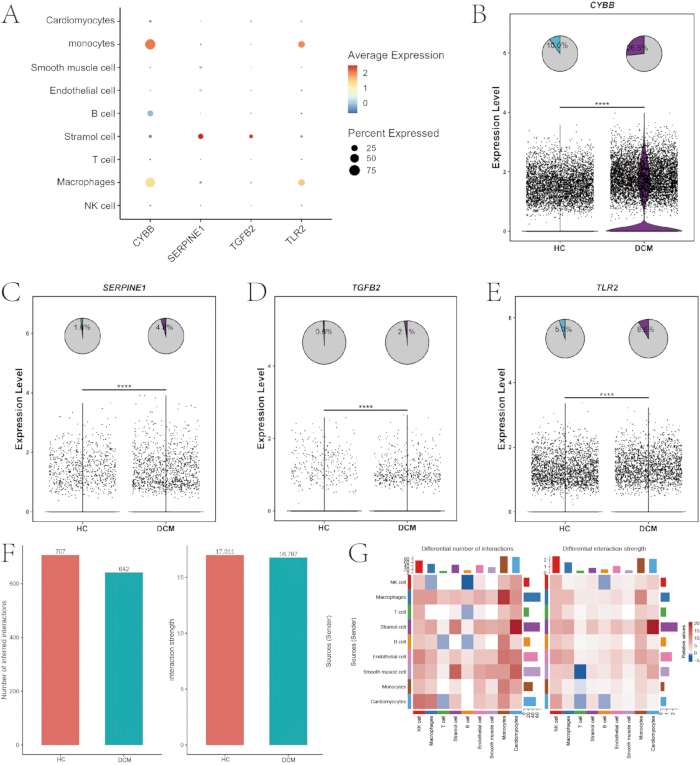
図 7: ハブ遺伝子のシングルセル検証および細胞間相互作用解析。 (A) 各細胞型における4つのハブ遺伝子の発現を示すバブルプロット。 (B) DCM群およびHC群におけるCYBB発現のバイオリンプロット。 (C) DCM群およびHC群におけるSERPINE1発現のバイオリンプロット。 (D) DCM群およびHC群におけるTGFB2発現のバイオリンプロット。 (E) DCM群およびHC群におけるTLR2発現のバイオリンプロット。 (F) 細胞間相互作用の数と全体的な強度を示す棒グラフ。 (G) 群間における細胞間コミュニケーションの強度の差を示すヒートマップ。 こちらのリンクから、この図の拡大版をご覧いただけます。
免疫細胞浸潤解析
シングルサンプル遺伝子セット濃縮解析(ssGSEA)を用いて、各バルクサンプルについて28種類の免疫細胞サブセットの濃縮スコアを算出した。ほとんどの免疫細胞種の豊富さは、拡張型心筋症群と健康対照群の間で有意に異なっていた(図 8A)。
次に、ハブ遺伝子の発現量と免疫細胞の濃縮スコアとの関係を評価するために、ピアソン相関分析を行った。CYBBの発現は、複数の免疫細胞型の存在量と有意に相関していた(図 8B)。同様の相関がSERPINE1(図 8C)、TGFB2(図 8D)、およびTLR2(図 8E)でも観察された。CYBB、SERPINE1、およびTLR2は、単球やマクロファージを含むいくつかの自然免疫細胞集団と正の相関を示した。
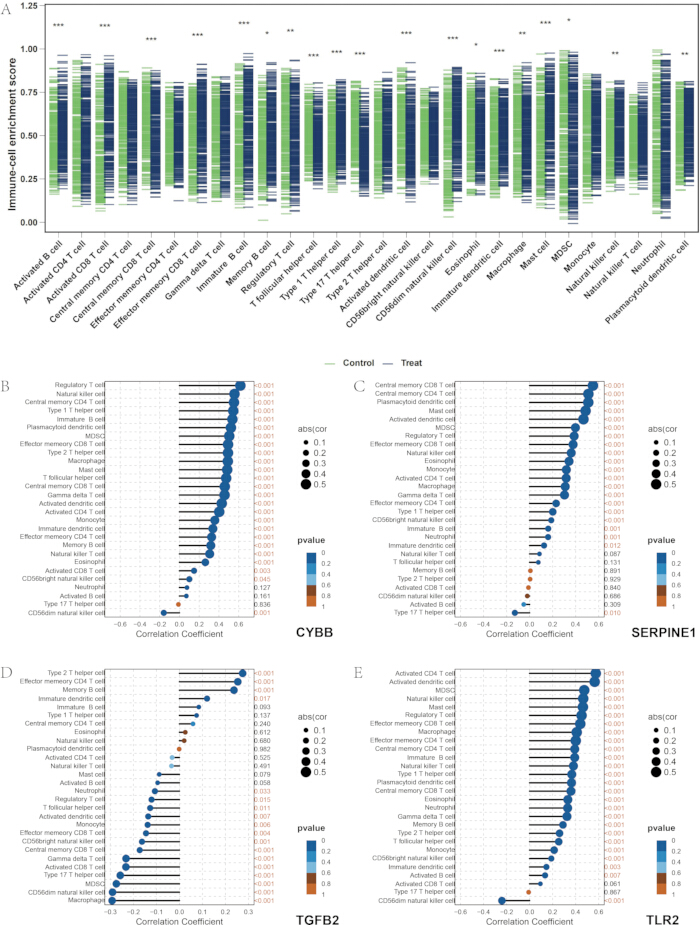
図 8: 免疫細胞浸潤および相関分析。 (A) DCM群およびHC群における28種類の免疫細胞の濃縮スコアの箱ひげ図。(B) CYBB発現量と免疫細胞数との相関を示すロリポッププロット。(C) SERPINE1発現量と免疫細胞数との相関を示すロリポッププロット。(D) TGFB2発現量と免疫細胞数との相関を示すロリポッププロット。(E) TLR2発現量と免疫細胞数との相関を示すロリポッププロット。こちらのリンクをクリックして、この図の拡大版を表示してください。
拡張型心筋症の分子サブタイプ分類
4つのハブ遺伝子の発現プロファイルに基づき、拡張型心筋症サンプルに対して非教師ありコンセンサスクラスター分析を行った。コンセンサスクラスター行列により、K = 2 での分離が支持された(図 9A)。デルタエリアプロットにより、最適なクラスター数は K = 2 であることがさらに支持され、サンプルは C1 と C2 の2つの分子サブタイプに分類された(図 9B)。
CYBB、SERPINE1、およびTLR2の発現レベルは、2つのサブタイプ間で有意に異なっていた(図 9C)。また、複数の免疫細胞サブセットの量もサブタイプ間で異なっていた(図 9D)。遺伝子セット変動解析(GSVA)の結果、C1サブタイプでは血管内皮増殖因子シグナル伝達経路が相対的に活性化していたのに対し、C2サブタイプでは一次胆汁酸生合成および糖スフィンゴ脂質生合成が濃縮されていた(図 9E)。主成分分析(PCA)では、2つのサブタイプに割り当てられたサンプル間の分離が示された(図 9F)。
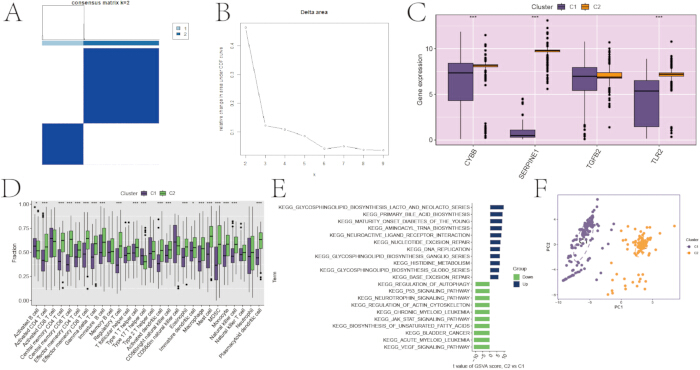
Figure 9: 拡張型心筋症の分子サブタイプ分類のためのコンセンサスクラスタリング。 (A) K = 2におけるコンセンサスクラスタリング行列。 (B) 最適なクラスター数を決定するために用いられたデルタエリアプロット。 (C) 2つの分子サブタイプにおけるハブ遺伝子発現のボックスプロット。 (D) 2つの分子サブタイプにおける免疫細胞存在量のボックスプロット。 (E) 2つの分子サブタイプ間で差次的に濃縮されたKyoto Encyclopedia of Genes and Genomes(KEGG)パスウェイのヒートマップ。 (F) 2つの分子サブタイプの分離を示す主成分分析(PCA)プロット。 ここをクリックして、この図の拡大版を表示してください。
In vivo 拡張型心筋症マウスモデルを用いた検証
in vivo 検証には、自発的な拡張型心筋症表現型を有する CTNTR141W トランスジェニックマウスを使用した。年齢を一致させた野生型 C57BL/6J 対照マウスと比較して、トランスジェニックマウスでは左室拡張末期径が有意に増加し、左室駆出率が低下しており、心室拡大および収縮不全と一致する結果となった(図 10A)。
左心室心筋組織から全タンパク質を抽出し、ビシンコニン酸法による全タンパク質の標準化を行った後、4つのハブ遺伝子がコードするタンパク質の濃度を酵素結合免疫吸着法(ELISA)で測定した。すべての測定は2連(duplicate)で実施した。標準曲線の相関係数(R2)は0.99以上であり、2連ウェル間の変動係数は10%未満であった。対照群とDCM群の間の統計的有意性は、F検定で評価した分散の等質性に応じて、Studentのt検定またはWelchのt検定を用いて評価した(正規性はShapiro-Wilk検定で確認した)。拡張型心筋症(DCM)マウスでは、対照群と比較して、4つのハブ遺伝子すべてに対応する心筋タンパク質レベルが有意に上昇していた(図 10B)。ELISAによる検証には、各群に3つの生物学的レプリケート(個別のマウス)を含めた。ELISAによる検証のため、1群につき3つの独立した生物学的レプリケートを含めた。これらの知見は予備的なものと考えており、より大規模なコホートでの確認が必要である。
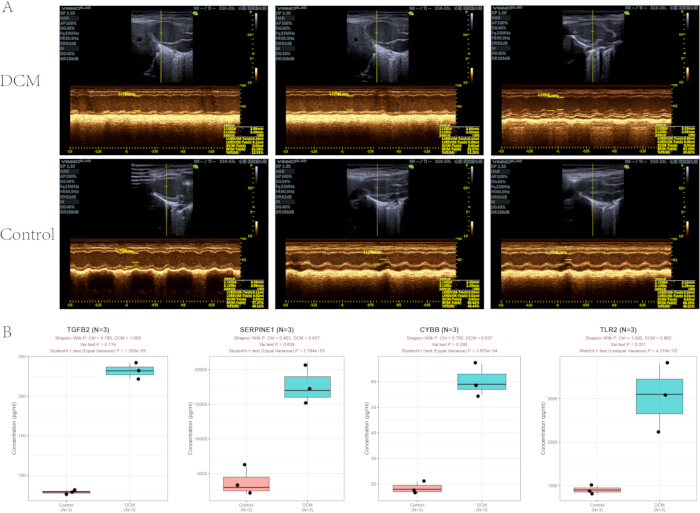
Figure 10: CTNTR141Wトランスジェニック拡張型心筋症マウスモデルにおけるin vivo検証。 (A) CTNTR141WトランスジェニックDCMマウスおよび野生型対照マウスの代表的なMモード心エコー画像。 (B) マウス左心室心筋組織における4つのハブ遺伝子由来タンパク質のELISA定量。ボックスプロットは、対照群およびDCM群のタンパク質濃度を示している(各群 n = 3 生物学的反復)。各ボックスプロットにおいて、ボックス内の実線の水平線は中央値を表し、ボックスの上端および下端は第75および第25パーセンタイル(四分位範囲、IQR)を表す。上下のひげは、1.5 × IQR 範囲内の外れ値ではない最大および最小データポイントまで伸びている。個々の黒い実点は、単一動物からの独立した生物学的反復に対応する。y軸は絶対タンパク質濃度を示しており、TGFB2およびCYBBは pg/mL、TLR2およびSERPINE1は ng/mL である。2群間の統計学的比較は、Studentのt検定(等分散)またはWelchのt検定(不等分散)を用いて行われ、正規性はShapiro-Wilk検定で、分散の均一性はF検定で検証した。制限事項:n = 3 の反復から得られたELISAの結果は予備的な探索的知見であり、今後サンプルサイズを拡大して検証することが必要である。 この図の拡大版を表示するには、ここをクリックしてください。
データの可用性:
本研究で解析した6つのバルク転写解析データセットおよび1つのシングルセルRNAシーケンシングデータセットは、Gene Expression Omnibusデータベースにて、アクセッション番号GSE5406、GSE42955、GSE57338、GSE79962、GSE116250、GSE141910、およびGSE145154で公開されています。シングルセル解析には、GSE145154のサンプルGSM4307515、GSM4307516、GSM4307520、およびGSM4307521が含まれています。本研究中に生成または解析されたその他すべてのデータ、および計算コードは、本公開論文とその補足情報ファイルに含まれています。具体的には、補足ファイル1に、完全な老化およびミトコンドリア関連遺伝子リスト、28細胞免疫シグネチャー、カスタム解析スクリプト、正規化された転写解析データマトリックス、ELISAアッセイのソースデータ、およびすべての原稿図の根拠となる未加工ソースデータが記載されています。
補足ファイル 1:老化およびミトコンドリア関連遺伝子セット、免疫シグネチャー、解析スクリプト、正規化済みトランスクリプトームデータ、および図のソースデータ。こちらのリンクからファイルをダウンロードしてください。
ディスカッション
統合的な多層ワークフローにより、バルクトランスクリプトームのメタ解析、重み付き遺伝子共発現ネットワーク構築、アンサンブル機械学習、シングルセル・トランスクリプトームによる検証、およびin vivo動物モデルによる検証を組み合わせた。老化およびミトコンドリアに関連する4つのハブ遺伝子CYBB、SERPINE1、TGFB2、TLR2が、拡張型心筋症(DCM)の診断バイオマーカー候補として特定された。マイクロアレイおよびRNAシーケンシングプラットフォームを含む、Gene Expression Omnibusリポジトリからの6つの独立した左心室トランスクリプトームデータセットを統合することで、単一データセットによるバイアスを軽減し、解析の統計的根拠を強化した43,44,45。事前定義された老化関連およびミトコンドリア遺伝子セットを組み合わせた重み付き遺伝子共発現ネットワーク解析により、単なる差分的発現解析への依存ではなく、形質に関連する機能モジュールの特定が可能となった46。アンサンブル機械学習によって、個々の特徴量選択手法に伴うアルゴリズム固有のバイアスを軽減し47,48、SHapley Additive exPlanations解析を用いて、各ハブ遺伝子がモデル予測に寄与する度合いを定量化した49。バルク心筋トランスクリプトーム、シングルセル・トランスクリプトーム、およびトランスジェニックマウスモデルを用いた検証により、選択した遺伝子の細胞分布および心筋タンパク質レベルをさらに特性化した50。
残存するデータセット特有の変動が、発現変動解析やモジュールと形質の関連性に影響を及ぼす可能性があるため、統合解析においてバッチ補正は極めて重要なステップでした。したがって、データセットのソースと検出プラットフォームをComBatモデルのバッチ因子として含めました。主成分分析プロットにおいてデータセット依存のクラスターが残存している場合は、補正が不十分であり、系統的なバイアスが存在する可能性を示します44。また、重み付き遺伝子共発現ネットワークの構築には、ソフト閾値パワー(soft-thresholding power)が重要でした。スケールフリートポロジー適合指標がR2 > 0.9となる最小値を採用した結果、β = 5となりました。この値が低すぎるとモジュールが断片化し、機能的な情報が得られなくなる可能性があり、逆に高すぎると遺伝子間の接続性が弱まり、モジュールと形質の相関解析における統計的検出力が低下する恐れがあります46。心筋細胞は代謝活性が高いため、シングルセル解析の品質管理閾値を心臓組織に合わせて調整しました。心筋細胞を保持しつつ、破裂した細胞や低品質の細胞を除去するため、ミトコンドリア遺伝子の割合を25%未満とし、検出遺伝子数を200–6,000とする厳格なフィルタリング戦略を実施しました50。繰り返し行う機械学習解析間のばらつきを抑えるため、データセットの分割、モデルのトレーニング、および交差検証には、set.seed(12345)として固定された乱数シードを使用しました47。
動物実験において表現型の安定性を維持するためには、ジェノタイプ確認、標準化された飼育環境、および一貫した心エコー測定が重要でした。CTNTR141Wトランスジェニックマウスは、規定の馴化および給餌期間後に、左室拡大と収縮機能不全を発症します51。非トランスジェニック個体を除外し、表現型の誤分類を防ぐため、群分け前のジェノタイプ確認が必要です。心エコー測定は、左室乳頭筋のレベルで一貫して行い、3回連続した安定した心周期の平均値を測定値として採用してください。撮像位置や麻酔深度の変動は、左室駆出率の測定値にばらつきを生じさせる可能性があります51。酵素免疫測定法(ELISA)の品質は、標準曲線の相関係数 R2 ≥ 0.99、および重複ウェル間の変動係数(CV) < 10%を用いて評価しました。標準曲線の直線性が不十分であるか、重複測定値に不一致がある場合、タンパク質濃度の推定に系統誤差が生じる可能性があります。
ワークフローの実施中に、いくつかの解析上の問題が発生する可能性があります。ComBat補正後もバッチ間の分離が持続する場合、バッチ変数と臨床因子の間の共線性、低発現遺伝子のフィルタリング不足、またはモデル化されていない技術的変動が反映されている可能性があります。利用可能な場合は、年齢や性別などの臨床共変量を保護変数として含めることができ、ノイズを軽減するために、サンプルの70%超で発現がゼロである遺伝子を除去することがあります44。残留した分離が認められる場合は、removeBatchEffectによる追加の補正を検討してください。差分的発現遺伝子の数が予想外に多かったり少なかったりする場合は、サンプルの不均一性、正規化、外れ値、および閾値選択を評価する必要があります27。モジュールと形質の相関が低い場合は、分散閾値、ソフト閾値パワー、および極端な形質値の再評価によって対処できます。最も変動の大きい遺伝子数を5,000から7,500に拡大するか、単一サンプル遺伝子セット富化分析を遺伝子セット変動解析に置き換えることで、モジュールの検出精度が向上する可能性があります46。タンパク質間相互作用ネットワークにおいて孤立したノードが過剰に存在する場合は、STRINGの信頼度閾値の調整または候補遺伝子セットの拡大が必要となる場合があります30。機械学習の性能が低い場合は、トレーニングセットと検証セットの間の分布の違い、特徴量の冗長性、またはグループ間の不均衡が影響している可能性があります。層化抽出、冗長な特徴量の削減、または少数クラスのオーバーサンプリングにより、これらの影響を軽減できる可能性があります47。シングルセルクラスタリングが曖昧な場合は、Harmony補正、主成分の選択、およびマーカー遺伝子の注釈を再評価する必要があります50。
いくつかの限界を考慮する必要がある。トランスクリプトームデータセットは公開リポジトリから遡及的に取得されたため、元の研究デザインや臨床的な共変量を制御することができなかった。データセット間での臨床アノテーションは不完全であり、多くのデータセットで病因、投薬歴、患者年齢、および長期的な転帰に関する詳細な情報が欠落していた。これらの限界により、選定した遺伝子と予後、治療反応、または暦年齢との関連性を評価することができなかった52。また、バッチ補正を行った後でも、残留的な技術的変動が残っている可能性がある。解析は主にメッセンジャーRNAの発現に基づいており、エピゲノム、プロテオーム、またはメタボロームの統合データは含まれていない。その結果、タンパク質の活性、翻訳後調節、および上流のメカニズムを特定することはできなかった。単一細胞データセットは1つのみ含まれており、DCMの病因による細胞の不均一性の評価は限定的であった50。CTNTR141Wトランスジェニックモデルは、主に心臓トロポニンT変異に関連する遺伝性DCMを代表するものであり、特発性、ウイルス性、または虚血性の疾患形態を再現していない可能性がある51。また、マウスとヒトの種差が直接的な臨床への応用を制限している。タンパク質レベルでの検証はマウスの心筋組織に限定されており、大規模な臨床コホートでの検証や既知のバイオマーカーとの比較は行われなかった。4つのハブ遺伝子はDCMに特異的なものではなく、他の心血管疾患や炎症性疾患においても変動する可能性がある。さらに、候補遺伝子の選定は、あらかじめ定義された老化関連遺伝子セットおよびミトコンドリア遺伝子セットに基づいていた。この仮説駆動型の戦略では、選択したリファレンスセット外の遺伝子が除外される可能性があり、また3つの機械学習アルゴリズムの積集合をとることで、単一の手法でのみ同定された遺伝子が省略される可能性がある48。
この解析フレームワークは、今後のDCMにおける分子サブタイピング、バイオマーカーの検証、およびマルチオミクス研究を支援する可能性があります。4つの遺伝子パネルは、診断またはサブタイピングツールとして評価される前に、独立した末梢血または心筋コホートで検証される可能性があります。C1およびC2サブタイプは異なる免疫および代謝パスウェイプロファイルを示しており、サブタイプ特異的な生物学的特徴のその後の検証の基礎となります15。選択された遺伝子は、分子ドッキング、細胞、および機能研究において検討される可能性があります。TLR2およびCYBBは炎症性シグナリングおよび活性酸素種の産生に関連しており、一方でTGFB2およびSERPINE1は線維化および心リモデルに関連しています53。プロテオミクス、メタボロミクス、エピゲノミクス、ゲノムワイド関連解析、およびメンデルランダム化データとの統合により、調節関係および潜在的な因果関係の評価に役立つ可能性があります54。また、疾患特異的なデータセットおよびリファレンス遺伝子セットを置き換えることで、このワークフローを肥大型心筋症、虚血性心筋症、および心不全のトランスクリプトーム研究に適応させることが可能です45。今後、トランスポザーゼアクセス可能クロマチンシーケンシング(ATAC-seq)などのシングルセルアッセイや空間トランスクリプトミクスを組み込むことで、細胞調節や空間的発現に関するさらなる情報が得られる可能性があります。マクロファージにおける老化関連シグネチャーおよび心筋細胞におけるミトコンドリアシグネチャーの濃縮が観察されたことは、心疾患における炎症およびミトコンドリアプロセスに関する過去の報告と一致していました55,56,57。
本研究には、認めるべきいくつかの限界がある。特に、タンパク質定量に使用した市販のELISAキットは、血清試料中の標的タンパク質の検出について公式にバリデーションされていた。本研究では、血清の代わりに心筋組織溶解物を検出マトリックスとして採用した。実験データの信頼性と比較可能性を確保するために、アッセイ全体を通して一貫した試料前処理および実験操作手順を厳格に実施したが、これらのELISAキットにおける心筋組織溶解物試料に対するメーカーの公式なバリデーションが不足していることは、タンパク質定量結果に潜在的なわずかな偏差をもたらす可能性がある。したがって、血清特異的なELISAキットを心筋組織溶解物に適用したことは、本研究の手法的な限界となる。
開示事項
著者は競合する利害関係がないことを宣言します。
謝辞
Gene Expression Omnibusデータベースを通じて提供された公開データに感謝いたします。また、原稿に対する建設的なコメントをいただいた査読者および編集者に感謝いたします。本研究は、省級部門レベル科学研究プロジェクト(助成金番号:2021JDZX2026)「Yiqi Huoxue処方が動脈硬化性血管リモデリングを軽減するメカニズム」の支援を受けたものです。 経由で KLF2-Nrf2を介した炎症調節
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Aquasonic Clear 超音波ジェル | Parker Laboratories, Inc. | Mar-34 | 小動物の心エコー図検査に使用。 |
| BCA タンパク質定量アッセイキット | Thermo Fisher Scientific | 23227 | 検出波長 562 nm、測定範囲 20–2,000 µg/mL。マウス心臓溶解液の総タンパク質定量に使用。 |
| CellAge データベース | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | 老化関連遺伝子シグネチャーの情報源。 |
| CytoHubba(Cytoscape プラグイン) | Cytoscape App Store | Version 0.1 | タンパク質相互作用ネットワークにおけるノードトポロジースコアリングに使用。 |
| Cytoscape | Cytoscape Consortium | Version 3.9.1 | タンパク質相互作用ネットワークの可視化に使用。 |
| 全波長マイクロプレートリーダー | Thermo Fisher Scientific | Multiskan FC | ELISA アッセイにおける吸光度の測定に使用。 |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | トランスクリプトームデータセット取得のための公共リポジトリ。 |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | ミトコンドリア関連遺伝子セットの情報源。 |
| Halt プロテアーゼおよびホスファターゼ阻害剤カクテル、100×、EDTAフリー | Thermo Fisher Scientific | 78441 | 4 °C で保存。使用直前に RIPA バッファーに 10 µL/mL の割合で添加。 |
| 液体窒素 | 地域の研究用ガス供給業者 | 該当なし | 心筋組織の急速凍結に使用。 |
| SPF 級 C57BL/6J 雄マウス(6–8 週齢、25 ± 2 g) | Beijing Vital River Laboratory Animal Technology Co., Ltd. | 該当なし | 動物生産ライセンス番号 SCXK (Jing) 2021-0006。正常対照として使用。 |
| SPF 級 CTNTR141W トランスジェニック DCM 雄マウス(6–8 週齢、25 ± 2 g) | Institute of Laboratory Animal Science, Chinese Academy of Medical Sciences | 該当なし | 動物生産ライセンス番号 SCXK (Jing) 2021-0065。自然発症 DCM モデルとして使用。 |
| MCODE(Cytoscape プラグイン) | Cytoscape App Store | Version 2.0.2 | タンパク質相互作用ネットワークにおけるコア機能サブネットワークの同定に使用。 |
| マウス CYBB ELISA キット | Biogradetech | A-QEK09250-96wells | 本研究において、マウス心筋組織溶解液中の CYBB を測定するために使用。 |
| マウス PAI-1 ELISA キット | EK-BIO | ML30970 | 本研究において、マウス心筋組織溶解液中の PAI-1(SERPINE1 由来タンパク質)を測定するために使用。 |
| マウス TGF-β2 ELISA キット | ElaBoX | SEKM-0036 | 本研究において、マウス心筋組織溶解液中の TGF-β2 を測定するために使用。 |
| マウス TLR-2 ELISA キット | Solarbio | SEKM-0163 | 本研究において、マウス心筋組織溶解液中の TLR-2 を測定するために使用。 |
| リン酸緩衝生理食塩水(PBS)、pH 7.4、カルシウム・マグネシウムフリー | Biological Industries | 02-024-1ACS | 滅菌済み 1× 溶液。4 °C で保存。組織の洗浄および希釈に使用。 |
| R パッケージ: caret | CRAN | Version 6.0-94 | サポートベクターマシンを用いた再帰的特徴消去に使用。 |
| R パッケージ: CellChat | CellChat developers | Version 1.6.1 | シングルセル RNA シーケンシングデータからの細胞間コミュニケーション推論に使用。 |
| R パッケージ: clusterProfiler | Bioconductor | Version 4.8.3 | 機能濃縮解析に使用。 |
| R パッケージ: ConsensusClusterPlus | Bioconductor | Version 1.64.0 | 教師なしコンセンサスクラスター分析に使用。 |
| R パッケージ: edgeR | Bioconductor | Version 3.42.4 | TMM(Trimmed Mean of M-values)法による RNA シーケンシングデータの正規化に使用。 |
| R パッケージ: GEOquery | Bioconductor | Version 2.68.0 | Gene Expression Omnibus からのデータダウンロードに使用。 |
| R パッケージ: glmnet | CRAN | Version 4.1-8 | LASSO ロジスティック回帰に使用。 |
| R パッケージ: limma | Bioconductor | Version 3.56.2 | 差分的発現解析および統計モデリングに使用。 |
| R パッケージ: pROC | CRAN | Version 1.18.5 | ROC(受信者動作特性)曲線解析に使用。 |
| R パッケージ: randomForest | CRAN | Version 4.7-1.2 | ランダムフォレスト機械学習に使用。 |
| R パッケージ: Seurat | CRAN | Version 5.0.1 | シングルセル RNA シーケンシングデータ解析に使用。 |
| R パッケージ: SingleR | Bioconductor | Version 2.2.0 | 自動細胞型アノテーションに使用。 |
| R パッケージ: sva | Bioconductor | Version 3.48.0 | ComBat によるバッチ効果補正に使用。 |
| 冷却遠心機 | Sigma-Aldrich | SIGMA 3-K | 心筋組織溶解液の遠心分離に使用。 |
| RIPA 溶解・抽出バッファー | Thermo Fisher Scientific | 89900 | Ready-to-use 1× 溶液。4 °C で保存。使用前にプロテアーゼおよびホスファターゼ阻害剤を添加。 |
| 小動物超音波画像診断システム | VINNO Technology Co., Ltd. | VINN06LAB | 心機能の心エコー図評価に使用。 |
| ペントバルビタールナトリウム | Sinopharm Chemical Reagent Co. | 20040428 | 滅菌生理食塩水を用いて 1% 溶液(10 mg/mL)として調製。30 mg/kg で腹腔内投与し、麻酔に使用。 |
| STRING データベース | STRING Consortium | Version 11.5 | タンパク質相互作用ネットワークの構築に使用。 |
| TGrinder H24 組織ホモジナイザー | TIANGEN | OSE-TH-01 | RIPA バッファー中で 6.0 m/s、30–60 秒間、2–3 サイクル行い、マウス心筋組織を均質化するために使用。 |
| 定温動物プラットフォーム/小動物用加温手術台 | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | 心エコー図検査中にマウスを 37 °C に維持するために使用。動作範囲:室温 ~ 50 °C。 |
参考文献
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740