本研究では、コードブック活性化希少性(Codebook Activation Rarity: CAR)を解析することで、大腸がんの組織病理画像における異常を検出する教師なしディープラーニングフレームワークであるRareCodeを提示します。本手法は、ラベル付きのトレーニングデータを用いることなく、事前スクリーニングを支援できる可能性を秘めています。
この記事について
サマリー
要約
組織病理画像における教師なし異常検知では、再構成誤差を測定する再構成ベースの手法が広く研究されてきましたが、組織テクスチャ固有の不均一性により、これらの手法では微細な意味レベルの病理学的変動を捉えられないことが多々あります。この制限を解決するため、本研究では、ベクトル量子化に基づいたフレームワークであるRareCodeを提案します。これは、検知パラダイムをピクセルレベルの再構成から拡張し、意味レベルのコードブック活性化解析を組み込んだものです。核心となる革新性は、コードブック活性化希少性(Codebook Activation Rarity: CAR)スコアリングにあります。これは、正常サンプルのみを用いたトレーニング中に各コードブックエントリの活性化頻度をプロファイリングし、推論時に低頻度の活性化を異常の指標としてフラグを立てることで、再構成誤差に意味レベルの識別能を補完させる手法です。この単一スケールのCARメカニズムに基づき、さらにマルチスケール階層コードブック(Multi-scale Hierarchical Codebook: MHC)モジュールを導入しました。これは、学習可能な融合重みを伴う異なるサイズのコードブックを用いて、粗い組織レベルの構造から微細な細胞レベルの詳細に至るまでの病理学的パターンを捉えます。このマルチスケール設計を活用することで、各コードブックの粒度で階層的な異常ヒートマップが生成され、病理医に対し、異常がどこで、どの構造レベルで発生しているかを示す、解釈可能で多次元的な視覚的局在化の手がかりを提供します。深圳市人民病院から得られた臨床アノテーション付きの大腸がん組織病理画像データセットを用いた5回交差検証の結果、RareCodeは曲線下面積(AUC)96.82%を達成し、ベースライン手法を上回りました。クラス別の解析では、炎症の検知(AUC = 94.30%、特異度 = 60.44%)よりも、がんの検知(AUC = 99.44%、特異度 = 94.21%)においてより高い性能が示されました。これらの知見は、CAR解析が組織病理学的異常検知のための有望な教師なしアプローチであり、大腸がん診断における臨床的な事前スクリーニングに寄与する可能性があることを示唆しています。
概要
大腸がんの信頼性の高い組織病理学的スクリーニングは、特に炎症性病変と悪性腫瘍の形態が重複している場合に、専門家によるアノテーションと手動レビューに制約される傾向にあります1,2。こうした制約から、網羅的な異常アノテーションを必要とせず、正常組織から学習する教師なし計算手法が求められています3,4。
診断需要と利用可能な病理学的な専門知識との間の不均衡が増大しており、米国の病理医1人あたりの診断負荷は、病理医の労働力が減少し続ける中で、わずか10年で40%以上増加しています。この状況から、自動化された組織病理学的スクリーニングの臨床的な緊急性が強調されています5。大腸がん(CRC)において、組織的なスクリーニングプログラムは死亡率を29-68%減少させると関連していますが6、手動による病理学的レビューの能力は依然として労働力の可用性によって制限されています。優先的にレビューすべき疑わしい症例を確実に特定する自動事前スクリーニングシステムは、この負担を軽減し、診断のターンアラウンドタイムを改善するのに役立つ可能性があります。しかし、このようなシステムを導入するには、真陽性を逃さないための高い感度と、過剰な偽警報を防ぐための十分な特異度の両方が必要となります7。
教師なし異常検知(UAD)は、異常なトレーニングラベルを必要とせずに正常組織の分布をモデル化できるため、医療画像解析においてますます重要になっています83,9,10。オートエンコーダー、変分オートエンコーダー、敵対的生成ネットワーク、およびメモリ拡張バリアントを含む再構成ベースのモデルは、再構成誤差を通じて異常を特定しますが、高容量のデコーダーは依然として異常領域を高精度に再構成してしまう可能性があります11,12,13,14,15,16,17。PatchCoreやPaDiMなどの特徴量ベースの手法は、事前学習済みの表現を利用しますが、自然画像から学習された特徴量は、組織病理学における微視的な異型性を完全には捉えられない可能性があります18,19,20,21。病理学特化型の基盤モデルや拡散ベースの異常検知器は強力な代替手段となりますが、データ要件や計算コストが、ハイスループットスクリーニングへの直接的な適用を制限する場合があります22,23。EvoAAE24やMoARNN-AM25などの最近の自動化および進化的手法は、異常検知における適応的なモデル最適化の価値をさらに示していますが、それらの適用コンテキストは組織病理画像解析とは異なります。対照的に、ベクトル量子化(VQ)ベースの手法は、恒等写像を抑制できる離散的なコードブック制約を課しますが、既存のVQベースのアプローチは依然として主に空間的な再構成誤差に依存しており、コードブックの活性化パターンに含まれる意味情報を十分に活用できていません26,27。
前述の手法は一般的な領域において有望な性能を示しているものの、複雑な組織病理学的シナリオへの適用には特有の課題がある。組織病理学的画像は、複数の構造レベルにわたる複雑な組織の不均一性を特徴としている28。実際、画像解析は通常、組織切片から抽出された局所的な画像パッチに対して行われ、病理診断は本質的にクロススケールである。すなわち、病理医は低倍率で腺管および組織の形態を評価し、同時に高倍率で核の多形性や核分裂像を検討する29。我々は、現在のアプローチにおける3つの主要な限界を特定した。第一に、病理学的異常と正常組織は、染色のスタイルや局所的なテクスチャなどの低レベルの視覚的特徴において高い類似性を示すため、再構成ベースの手法では、正常サンプルと異常サンプルの両方がセマンティックレベルで同様の再構成品質を生成し、微細な異常の検出に失敗することがある。第二に、既存手法の多くは単一スケールの特徴抽出を採用しており、組織レベルと細胞レベルの両方で異常な特徴を同時に捉えることが困難である30,31。第三に、主流の手法はピクセルレベルのヒートマップを生成できるが、異常の階層的属性を直感的に捉えることができず、臨床診断の補助としてのモデルの有用性が制限されている。
上述の課題を解決するために、コードブックの活性化パターンと、複数の抽象化レベルにおける階層的な特徴表現を探索するUADフレームワークであるRareCodeを提案します。このフレームワークは、主に3つのコンポーネントで構成されています。(1) コードブック活性化希少度(CAR)スコアリングメカニズム:正常サンプルのみで学習したエントリの活性化頻度に基づいて希少度スコアを算出し、セマンティックレベルで正常サンプルと異常サンプルを区別します。これにより、従来の空間的な再構成誤差を補完する判別信号を提供します。(2) マルチスケール階層的コードブック(MHC)融合アーキテクチャ:容量の異なるコードブックを採用することで、粗い構造パターンからきめ細かな細胞の詳細に至るまで、複数の粒度レベルで病理学的特徴を捉え、学習可能な重みを用いて適応的な融合を実現します。(3) 階層的解釈可能局在化モジュール:マルチスケールアーキテクチャを活用して異なる粒度の異常ヒートマップを生成し、病理医にマルチスケールでセマンティックに解釈可能な診断リファレンスを提供します。
本研究の主要な仮説は、正常な大腸組織病理画像のみでトレーニングされたコードブックから導出されたコードブック活性化頻度プロファイルが、ピクセルレベルの再構成誤差を超えた異常に関連する意味情報をエンコードし、これらの相補的な信号をマルチスケールで統合することで、代表的なUAD手法と比較して、がん組織や炎症組織を含む画像と正常な画像との判別能が向上し、それが主にAUCによって評価されるということである。この仮説を検証するため、臨床的にアノテーションされたCRCデータセットを用いて5分割交差検証によりRareCodeを評価し、アブレーション解析および局在化解析を実施して、その中核構成要素の寄与と解釈可能性を検討した。
プロトコル
本研究は深セン市人民病院臨床研究倫理委員会の承認を得て実施した。's病院(承認番号:LL-KY-2025300-01)。本研究は患者との直接的な接触や介入を伴わず、既存の組織病理画像および臨床資料を用いた後ろ向き研究であったため、倫理委員会によりインフォームドコンセントの要請が免除された。すべての臨床データおよび組織病理画像は解析前に匿名化されており、本研究では個人を特定できる情報は一切使用されていない。本研究で使用されたすべてのデータは、機関および国の研究委員会が定める倫理基準に従って取り扱われた。
フレームワークの概要
提案されたUADフレームワークRareCodeの全体構造を示している。 図1このフレームワークは、並列二重ブランチ構造を採用している。各512×512の入力画像に対して、オーバーラップしない32×32および64×64のパッチをそれぞれ細尺度および粗尺度の入力として抽出する。64×64のパッチはネットワークに入力される前に32×32にリサイズされ、両ブランチが同じエンコーダー・デコーダー入力サイズを共有しつつ、異なる受容野を保持するようにする。各ブランチのエンコーダーは抽出された特徴を潜在空間にマッピングし、MHCモジュールが離散化制約を課す。その後、デコーダーは量子化された特徴から画像を再構成し、空間領域における再構成誤差を計算する。次に、CAR機構がコードブックの活性化頻度をプロファイリングすることで、意味レベルの異常度を測定する。最後に、モデルは再構成スコアとCARスコアを重み付きで統合し、画像レベルの異常スコアを得る。RareCodeフレームワークは正常サンプルのみを用いてエンドツーエンドで学習され、異常のアノテーションは不要である。二重ブランチ構造は、局所的な細胞レベルの特徴とより広範な腺構造の両方を捉えるために用いられた。MHCモジュールは、これらの特徴を異なる容量を持つコードブックでモデル化するために使用された。
エンコーダー・デコーダー構造
RareCodeは、細尺度ブランチと粗尺度ブランチそれぞれに対して、構造的に独立したエンコーダとデコーダを構成する。各ブランチは同じエンコーダ・デコーダ設計を用いるが、パラメータは共有しない。エンコーダは4つの畳み込みブロックからなり、各ブロックには3×3畳み込み、バッチ正規化、ReLU活性化関数、およびドロップアウトが含まれる。チャンネル幅は64から128、次に256へと増加し、最終的な特徴マップはフラット化され、64次元の潜在表現(latent embedding)へ射影される。デコーダは、完全結合の射影層に続いて4つの転置畳み込み層を備え、エンコーダと対称的な構造を持つことで、各パッチをネットワークの元の入力サイズに再構成する。再構成誤差は、入力パッチと再構成されたパッチ間の平均二乗誤差として計算される。このエンコーダ・デコーダ構造に離散的なコードブック制約を組み合わせることにより、RareCodeは正常組織のコンパクトな表現を学習し、推論時にその逸脱度を測定する。
マルチスケール階層型コードブック
複数の抽象化レベルで病理学的特徴を捉えること—広範な組織のパターンから局所的な細胞の変動まで—MHCモジュールはK個の離散的なコードブックを用いる  容量が異なる n1, n2, ..., nK最終的なFourScales構成では、各ブランチはそれぞれ64、128、256、および512個のエントリをもつ4つのコードブックを含み、各コードブックエントリは64次元の埋め込み表現を持つ。各符号化されたパッチ特徴量について、ユークリッド距離に基づいて最も近いコードブックエントリが選択される。その後、異なるコードブックから得られた量子化出力は、コードブック間で正規化された学習可能な重みを用いて融合される。より小さいコードブックは、より強い圧縮制約により、局所的な変動を抽象化した粗い粒度の原型的パターンを符号化すると期待されるのに対し、より大きなコードブックは、より特定の構造的特徴を捉える細かい粒度の特徴を保持する。各コードブックについて
 、ここで ek(i)
 Rd k番目のコードブックにおけるi番目の埋め込みベクトルを示し、連続的特徴量は最近傍探索により離散的なコードブック空間にマッピングされる(式1および2)。
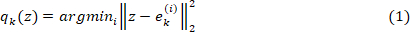

マルチスケール特徴の適応的融合を実現するため、学習可能な重みを導入する。ソフトマックス正規化後、各コードブックからの量子化出力に対して重み付き和が計算される(式3)。
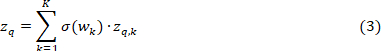
ここで σ(·)はソフトマックス関数を表し、重みが以下の条件を満たすことを保証する。 Σk σ(wk)=1 である。この設計により、モデルは入力特徴の意味内容に基づいて、異なる粒度のコードブックの寄与比率を自動的に調整できるようになる。
コードブックの学習を最適化するために、標準的なVQ損失関数(式4)を採用する:
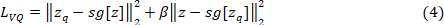
sg[·] はストップ勾配操作を示す。 β = 0.25はコミットメント損失の重み係数である。第1項はコードブックベクトルがエンコーダ出力に向かって移動するように促し、第2項はエンコーダ出力が対応するコードブックベクトルと一貫性を保つように促す。マルチスケールVQの完全な仕組みは以下の通りである。 図2.
コードブック活性化の希少性スコアリング
CARは、正常な学習サンプルから推定されたコードブック活性化統計に基づいて、意味レベルの異常を測定する。モデルの学習後、すべての正常な学習画像をデータ拡張なしでエンコーダおよびMHCモジュールに通した。各ブランチおよび各コードブックについて、各パッチ特徴量の割り当てインデックスを記録し、各コードブックエントリへの割り当て回数をカウントした。このカウント値を正規化して、そのコードブックに対する活性化頻度分布を得た(式5):

推論時、各テスト画像に対して、同じパッチ抽出、符号化、および最近傍コードブック割り当ての手順を適用した。割り当てられた各コードブックエントリについて、レアリティスコアは、正常な訓練セット内でのその活性化頻度の負の対数として計算される(式6):

ここで ε 数値安定性のための小さな定数である。したがって、低頻度のコードブックエントリはより高いレアリティスコアを受け取り、対応するパッチ特徴が学習された正常組織分布と一致しない度合いが高いことを示唆する。パッチレベルのレアリティスコアは、各画像内で、および細スケールおよび粗スケールのブランチ間で平均化され、画像レベルのレアリティ応答が得られた。
活性化頻度の希少性を補完するために、パーセンタイルに基づく量子化距離スコア(式7)も計算する:
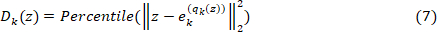
このスコアは、各符号化された特徴ベクトルとその最も近いコードブックエントリとの間のユークリッド距離から算出される。距離の分布は正常な学習サンプルから推定され、テストサンプルの距離はパーセンタイルスコアに変換される。パーセンタイルスコアが大きいほど、符号化された特徴を学習された正常なコードブックプロトタイプを用いて表現することがより困難であることを示す。
最終的なCARスコアは、学習可能なコードブック重みを用いて、すべてのコードブックにわたる活性化の希少性と量子化距離を組み合わせたものである(式8)。
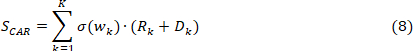
表現学習と異常スコアリングの間の一貫性を保つために、マルチスケール特徴融合に使用されたのと同じ正規化されたコードブック重みをスコアレベル融合に適用する。得られたCARスコアは画像レベルで計算され、その後再構成スコアと組み合わせて最終的な異常スコアを算出する。全体のCARスコア算出機構は以下の通りである。 図3.
最終的な異常スコアの計算
空間領域の再構成誤差と意味レベルのCARスコアを融合する。融合の前には、両方のスコアを極端な外れ値の影響を低減するため、パーセンタイルに基づく最小-最大正規化を用いて個別に正規化する。最終的な画像レベルの異常スコアは、次式で定義される(式9):
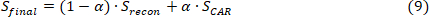
ここで S再構成 正規化された平均二乗再構成誤差を示し、ピクセル空間におけるサンプルの再構成品質を反映する; SCAR 上記のCARスコアは、意味レベルの異常度を捉えるものである。ハイパーパラメータ α [0,1]は2つのコンポーネント間の相対的重み付けを制御し、最適な値は検証セット上で決定される。
訓練目的
RareCodeフレームワークは、正常サンプルのみを使用してエンドツーエンドで学習される。総合的な学習損失は、以下の要素から構成される(式10):

各用語の定義は以下のとおりである。再構成損失: 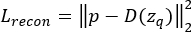 、入力パッチ間の平均二乗誤差を測定する p 再構成されたパッチ D(zq)の後で量子化を行います。この損失は32に対して個別に適用されます × 32パッチブランチ(
 )および64 × 64パッチ分岐
 空間的スケールの両方において特徴を効果的に学習できるようにするため。
データセットの説明
RareCodeを評価するために、ヘマトキシリン・エオシン(H&E)で染色された大腸組織切片の画像からなる、臨床的にアノテーションされた大腸がん(CRC)組織病理学的画像データセットを用いて実験を行った。&E)、深セン市人民より得られた's病院。このデータセットのすべての画像は実際の臨床症例に由来する。画像は40倍の拡大率でデジタル化され、元の解像度は1024 × 1024ピクセル。アノテーションの信頼性と品質を確保するため、すべてのサンプルカテゴリラベルは、二重盲検プロトコルに従って、2名以上の上級専門病理医が共同で検討し、確認した。
組織病理学的特徴に基づき、データセットは正常組織(1,226枚の画像)、がん(1,215枚の画像)、および炎症(1,214枚の画像)の3つのクラスに分類された。二値UAD設定では、がんおよび炎症のサンプルを異常とみなし、正常サンプルを基準分布とした。この定式化は、形態学的に正常な症例と、さらなる病理学的検討を要する症例とを区別するという、目的とするトリアージタスクを反映している。
すべてのH&E染色画像を512にリサイズした × ネットワーク入力として使用される前に、512ピクセルに変換した。評価には層別5分割交差検証を用いた。各分割において、正常サンプルをまず訓練用、検証用、および保持されたテスト用のサブセットに分割した。RareCodeは訓練用の正常サンプルのみを用いて学習した。検証用サブセット(これも正常サンプルのみを含む)は、モデル選択、ハイパーパラメータの調整、および融合重みの選択に使用した。 α保持検定セットは、未観測の正常サンプルおよび癌や炎症を含む異常サンプルから構成され、最終的な性能評価にのみ使用され、モデルの学習、ハイパーパラメータ選択、または α 選択。代表的なカテゴリ、データセットの構造、および検証プロトコルを示している。 図4.
実装の詳細
提案されたRareCodeフレームワークおよび比較用ベースラインは、PyTorchを用いて実装した。すべての実験は、NVIDIA GeForce RTX 4060 Ti GPU(16 GB)を1台搭載したワークステーション上で実施した。ネットワークアーキテクチャの構成において、異なる空間範囲の特徴を捉えるために、二重ブランチアーキテクチャにより、2つのスケール(32)で非重複パッチを処理する × 32ピクセル(受容野が小さく、局所的なテクスチャパターンを捉える)および64 × 64ピクセル(受容野が大きく、より広範な空間的コンテキストを捉える)です。両方のブランチエンコーダが生成する連続特徴埋め込みの次元数は、一様に64に設定されています。MHCモジュールでは、各ブランチに対して容量の異なる4つのコードブックを構成し、離散プロトタイプの数をそれぞれ64、128、256、512とします。
最適化中に、ネットワークはバッチサイズ8で50エポックにわたりエンドツーエンドで学習させた。重みの更新にはAdamWオプティマイザを用い、初期学習率は5 × 過学習を防ぐため、重み減衰(weight decay)も採用した。さらに、学習の収束を安定させるためにコサインアニーリング学習率スケジュールを用い、後期の学習段階でのより精緻な最適化を可能にした。パッチサイズおよびコードブックサイズは、マルチスケール表現と計算コストのバランスを考慮して選定した。最終的なFourScales構成はアブレーション分析によって裏付けられている。 α テストセットの評価の前に、検証セット上で選択された。
デコーダーの複雑さに関するアブレーション実験では、FourScales構成に基づく複雑なデコーダーの変種を実装した。この変種は、同じデータ分割、コードブックサイズ、学習エポック数、オプティマイザー、学習率、検証結果に基づく α 選択、および評価指標をFourScalesモデルとしている。基本的なデコーダーは、マルチスケールのデプスワイズ畳み込みブロックと畳み込みブロックアテンションモジュール(CBAM)を含むEMCADスタイルのデコーダーに置き換えられた。最初の3つの転置畳み込みによるアップサンプリング段階のそれぞれの後で、並列に3 × 3, 5 × 5、および7 × 7回の深度方向畳み込みを適用した後、1 × 1点ごとの融合、バッチ正規化、ReLU活性化、残差接続、およびCBAMアテンション。CBAMには、平均プーリングおよび最大プーリング記述子に基づくチャネルアテンションと、7×7のカーネルサイズを用いた空間アテンションが含まれる。 × 7層の畳み込み。最終段階では転置畳み込みとシグモイド活性化関数を用いて、32を再構築した × 32パッチ
結果
ベースライン手法との比較
RareCodeフレームワークを評価するため、再構成ベースの手法(CAE)を含む、代表的な複数のUAD手法をベースラインとして選定した。32, 変分オートエンコーダー (VAE)12, SAE33, 平均絶対誤差34, PatchSAE35)、メモリ拡張再構成(MemAE36)、知識蒸留(STFPM37)、合成異常生成(DRAEM38)、および事前学習済み特徴抽出(PatchCore18ベースラインの選定では、同等の計算予算およびデータ想定(ラベルのない正常トレーニングサンプルのみへのアクセス)の下で訓練または適用可能な手法に焦点を当て、性能の差が事前学習データの規模の差ではなく、手法上の寄与を反映するようにした。公正な比較を期するため、すべての手法を同一の5分割データ分割、前処理パイプライン、評価指標、および計算環境を用いて評価した。モデルは、正常トレーニングサンプルのみを用いた同一のUADプロトコル下で訓練し、ハイパーパラメータと閾値は検証セットで選定し、最終的な性能はホールドアウトテストセットのみで評価した。 表1 5回交差検証の結果を要約し、 図5 マルチメトリックのレーダーチャートによる比較を提供します。
〜に示されているように 表1 および 図 5、RareCodeはCRCデータセットにおいて良好な検出性能と統計的安定性を達成した。AUCに関しては、RareCode(96.82 ± (0.23%)は、MemAE(94.97%)を含む複数の再構成ベースのベースラインモデルを上回る性能を示している。 ± 0.81%)。統計解析により、RareCodeがすべての再構成ベースのベースラインを上回ることが確認された(対応のあるt検定、 p < 0.05)であり、MemAEに対する改善は統計的に有意であった (p < 0.01)。RareCodeは性能のばらつきが小さく(標準偏差0.23%)、クロスバリデーションにおける安定性が一貫していることを示している。合成アノマリーに基づいたDRAEMの効果が限定的であったことは、単純なテクスチャオーバーレイ戦略では、複雑な病理学的異型を十分にシミュレートできないという事実を反映していると考えられる。
特異度に関しては、RareCodeは58.24 ± 5.99%を達成し、偽陽性率の低減においてすべての比較手法を上回った。これは、再構成のみのベースライン(NoCAR、33.76%)に対して約25パーセンテージポイントの向上に相当し、偽陽性の低減に対するCARメカニズムの寄与を実証している。自然画像の事前学習済み特徴量に依存するSTFPMおよびPatchCoreの特異度が低いことは、自然画像と病理組織画像との間のドメインギャップを部分的に反映している可能性がある。特に、STFPMとDRAEMは特異度のばらつきが大きく(±33.53%および±7.09%)、フォールドごとの特異度がほぼゼロから中程度まで及んでおり、実運用における信頼性に懸念がある。
クラス別の検出性能
がんサンプルおよび炎症サンプルをそれぞれ正常サンプルと比較することで、クラス別の解析を行った(表 2)。RareCodeは、炎症の検出(AUC = 94.30 ± 0.44%, recall = 96.55 ± 0.78%, specificity = 60.44 ± 4.34%)よりも、がんの検出(AUC = 99.44 ± 0.12%, recall = 98.13 ± 0.29%, specificity = 94.21 ± 2.22%)において高い性能を達成した。これらの結果は、RareCodeが炎症性変化よりも悪性異常に対してより強力な識別能を示す可能性があり、一方で炎症と正常の境界が、全体的な特異度の低下に大きく寄与していることを示唆している。
アブレーション解析
RareCodeフレームワーク内の主要コンポーネントの寄与を調べるため、CARメカニズムとMHCモジュールが検出性能に与える影響を評価するアブレーション実験を実施した。結果は表3に詳しく記載されている。図6Aに示すように、再構成のみのベースラインにCARを追加したことで、AUCは92.81%から95.92%に向上し、マルチスケールコードブック融合によりさらにAUCは96.82%に増加した。図6Bは、CARが特異性も向上させたことを示しており、NoCARベースラインの33.76%から、完全なFourScalesモデルでは58.24%に増加した。これらの結果は、コードブック活性化の希少性とマルチスケール融合の相補的な価値を裏付けている。
さらに、FourScales構成を用いてデコーダーの複雑性に関するアブレーション解析が行われました。図に示されるように、 表3マルチスケール深度別畳み込みブロックと畳み込みブロックアテンションモジュール(CBAM)を備えた複合デコーダー変異体は、基本のFourScalesモデルよりも低いAUC(95.17 ± 0.44% 対 96.82 ± (0.23%)。この結果は、現在のVQ-AEに基づくRareCodeの設定において、デコーダーの容量を増やしても異常検知性能は向上せず、コードブックで制約された表現の有効性を低下させる可能性があることを示唆している。
階層的空間応答解析
RareCodeによって生成された空間応答を調べるため、パッチレベルの再構成誤差およびコードブック希少性マップを画像レベルで集計し、正常サンプルと異常サンプルの間で比較した。画像レベルの応答の分離度を定量化するために、エネルギー比、Cohen's d、およびAUCを用いた。詳細な結果は表4、図7、および図8に示されている。
結果から、すべてのスケールにおけるコードブックの希少性スコアが、異常サンプル(エネルギー比 > 1)において応答の上昇を示すことが明らかになりました。容量の小さいコードブック(Codebook 64)は、より強力な局在レベルの識別能(AUC 78.79%)を達成しました。これは、圧縮率が高くなるほど、正常組織の典型的パターンからの逸脱に対してより感度の高い、より抽象的なプロトタイプパターンの学習が促進されるという予測と一致しています。再構成誤差のみでも十分な異常検出能力(AUC 93.31%)を有していますが、CARスコアは意味的な頻度次元からの相補的な信号を提供します。
図7の定性的検討により、がん検体における反応の亢進が、不規則で密集した腺管、核の腫大、過染色性、偽重層化、および上皮極性の消失と重複していることが示されました。炎症検体では、歪んだ陰窩や高密度の炎症細胞浸潤の周囲でより強い反応が観察されました。低容量のコードブックはより広範な構造的偏差を捉える傾向があるのに対し、高容量のコードブックはより局所的な細胞レベルの反応を生成しました。これらの知見は定性的な形態学的解釈を提供するものであり、ピクセルレベルの検証を行うものではありません。
融合パラメータの解析
融合重み α は、最終的な異常スコアに対する空間再構成誤差と CAR スコアの寄与のバランスを調整します。各フォールドにおける最適な α 値は、検証セットを用いたグリッドサーチ(ステップサイズ 0.05)によって決定され、その結果を表 5および 図 9に示します。最適な α 値は主に 0.85-0.95 の範囲に集中しており、平均値は 0.90 ± 0.05 でした。最適構成において、本モデルはテストセットで平均 AUC 96.82 ± 0.23% を達成しました。最適重みが比較的高くなったこと(約 0.90)は、最終的な検出において再構成誤差よりも CAR スコアの方がより大きく寄与しており、再構成誤差が補助的な局所制約を提供していることを示唆しています。感度解析における α = 0 の設定(AUC = 93.29%)と比較して、検証セットで選択された融合設定では AUC が約 3.53 パーセントポイント向上しました。
まとめると、本研究では、従来の生成モデルで課題となっていたアイデンティティマッピング問題を軽減することを目的とした、組織病理画像における教師なし異常検知のためのRareCodeフレームワークを提案します。CARメカニズムはピクセルレベルの再構成誤差への過度な依存を低減し、MHCモジュールは複数の粒度で階層的な特徴表現を提供することで、異なる抽象化レベルでの補完的な異常識別を可能にします。CRCデータセットを用いた実験により、RareCodeは96.82%のAUCを達成したことが示されました。クラス別の解析では、効果的ながん検知(AUC = 99.44%)が確認され、炎症よりもがんに強い識別能を示したことから、炎症と正常組織の重複が依然として主要な課題であることが示唆されました。アブレーション研究により、VQによる離散的な意味的特徴とマルチスケールの組織形態表現を統合することで、検知性能が向上することが確認されました。RareCodeの高い再現率(98.40%)と中程度の特異度(58.24%)は、疑わしい組織病理画像を優先順位付けするための一次スクリーニングツールとしての可能性を示唆していますが、病理医のワークロードに対する実際の効果については、今後のワークフロー評価による検証が必要です。
データの利用可能性:
本研究で使用されたCRC病理組織画像データセットは、機関の倫理承認(承認番号:LL-KY-2025300-01)に基づき、深セン市人民病院から提供されました。患者のプライバシーおよび機関のデータ共有ポリシーにより、本データセットは公開されておりません。責任著者への合理的な請求に基づき、機関の承認およびデータ利用合意書を条件として、アクセスが許可される場合があります。RareCodeフレームワークのソースコードは、https://github.com/XL-alg/RareCode で公開されています。
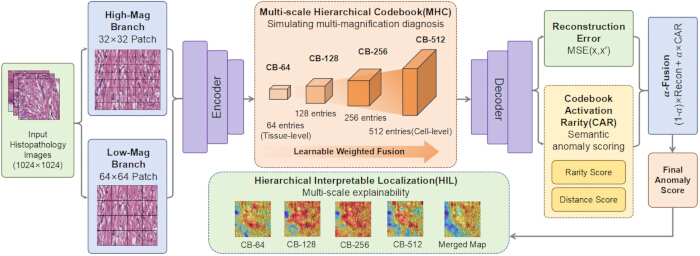
図1RareCodeフレームワークの全体的なアーキテクチャとデータフロー。 A 512 × 512 H&H&E染色された組織病理学的画像は、重複のない32個の領域に分割される。 × 32および64 × 64個のパッチを、微細スケールおよび粗いスケールの入力として使用する。2つのブランチでパッチを潜在埋め込みにエンコードし、マルチスケール階層コードブック(MHC)離散化を適用した後、パッチを再構成して再構成誤差スコアを算出する。同時に、コードブック活性化希少性(CAR)メカニズムにより、正常な訓練サンプルから学習したコードブック活性化頻度プロファイルに基づき、意味的な希少性を推定する。正規化された再構成スコアとCARスコアを統合して最終的な画像レベルの異常スコアを生成し、パッチレベルの応答を画像平面に逆投影することで、階層的な局在化を行う。 こちらの図の拡大版を表示するには、ここをクリックしてください。
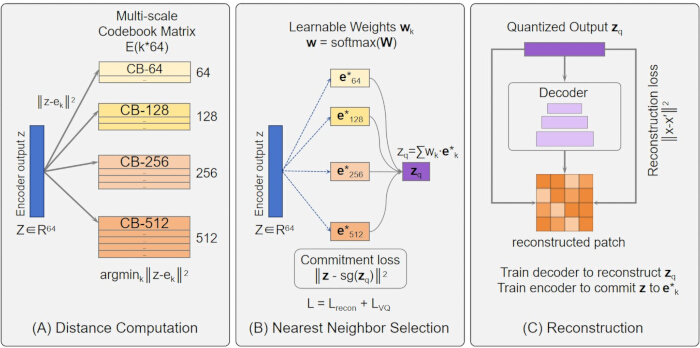
図 2: マルチスケールベクトル量子化メカニズム。 (A) エンコーダ出力特徴量とコードブック埋め込みベクトルの間の距離計算。(B) 64、128、256、および 512 の容量を持つコードブック間での最近傍選択と加重融合。(C) 転置畳み込みデコーダによる量子化特徴量からの再構成。ここをクリックして、この図の拡大版を表示してください。
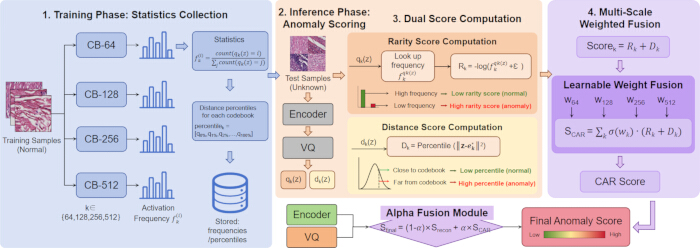
図3CARスコアリング機構 この図は4つの段階を示しています。段階1:活性化頻度の統計が、正常なトレーニングサンプルのみに基づいて算出されます。段階2:テストサンプルが、エンコーダーおよびベクトル量子化を通じて活性化インデックスと距離を取得します。段階3:トレーニングセットの頻度プロファイルに基づいて、希少性スコアと距離スコアが算出されます。段階4:各コードブックスケールのスコアが、学習可能な重みを通じて統合され、最終的なCARスコアが生成されます。 こちらの図の拡大版を表示するには、ここをクリックしてください。
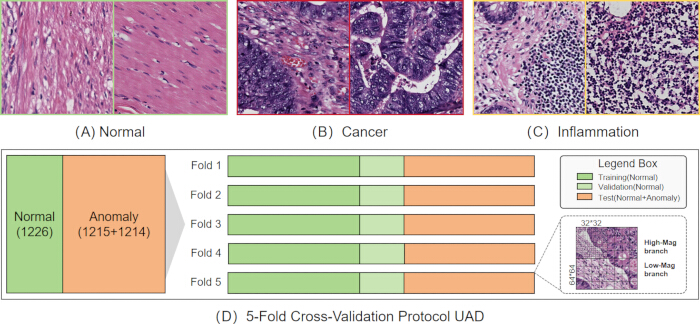
図4CRCデータセットの構成および実験プロトコル。 (A–C代表的なH&正常大腸組織、大腸癌、および大腸炎症のH&E染色組織病理学的画像。DUAD(未知の異常検知)における5分割交差検証プロトコル。ここでは、正常サンプルをトレーニングおよび検証に使用し、ホールドアウトされた正常サンプルおよび異常サンプルをテストに使用した。画像は40倍の倍率でデジタル化され、32 x 32および64 x 64のパッチに処理された。緑、黄緑、オレンジは、それぞれトレーニングセット、検証セット、テストセットを示す。 こちらの図の拡大版を表示するには、ここをクリックしてください。
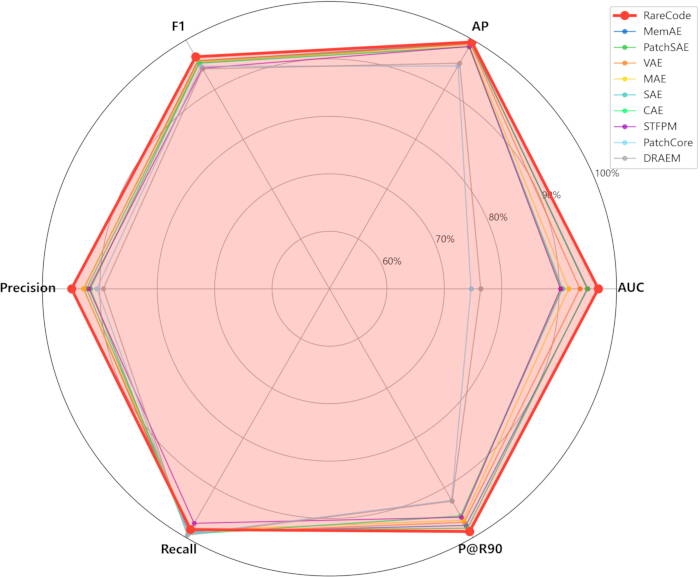
図 5: 異常検知手法のマルチメトリック比較レーダーチャート。AUC、平均適合率(AP)、F1スコア、適合率、再現率、および再現率90%における適合率(P@R90)において、RareCodeをベースライン手法と比較したレーダーチャート。すべての値は5分割交差検証における平均パフォーマンスを示す。この図の拡大版を表示するには、ここをクリックしてください。
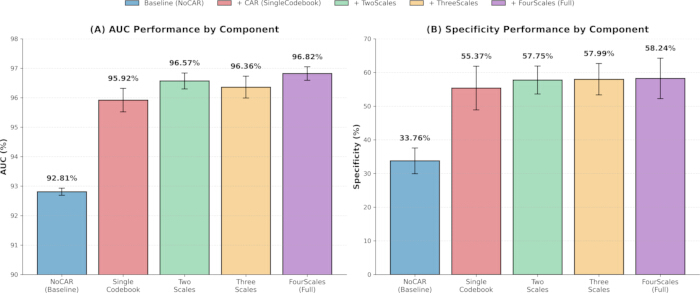
図6アブレーション解析コンポーネントの漸増的寄与度分析。 (A) 再構成のみのベースライン(NoCAR)から、シングルコードブック、そしてマルチスケール構成へと段階的に向上するAUC性能の比較。B) CARメカニズムによる偽陽性減少の効果を示す特異度性能の比較。すべてのエラーバーは、5分割交差検証における標準偏差(SD)を表す。 こちらの図の拡大版を表示するには、ここをクリックしてください。
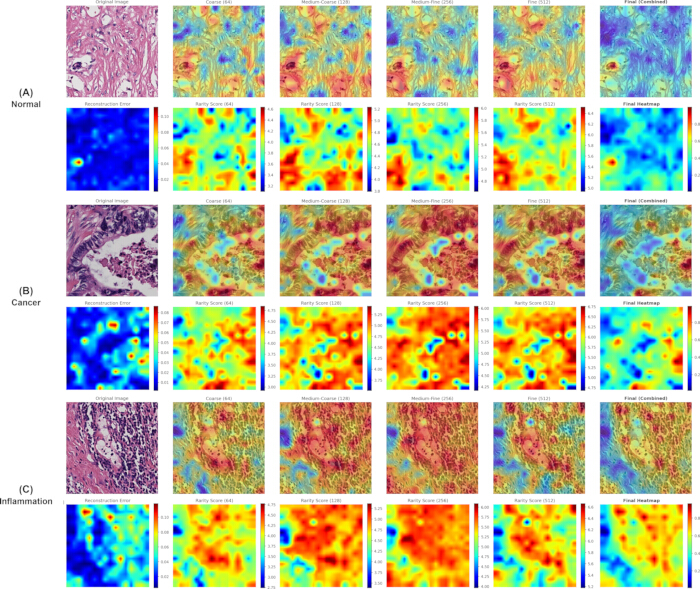
図7マルチスケールコードブック階層的局在化ヒートマップ 代表的な例を以下に示します。 (A) 正常な、 (B) がん、および (C) 炎症サンプルの例。各行には、元画像、オーバーレイ、再構成誤差マップ、異なる容量(64、128、256、512)のコードブックから得られた希少性スコアマップ、および最終的な統合局在化マップが含まれている。容量の小さいコードブックは、より強力な圧縮抽象化を通じて粗い粒度のパターンを強調し、一方で容量の大きいコードブックはより微細な構造的詳細を保持する。高反応領域は、定性的に癌または炎症に関連する組織病理学的特徴と一致しているが、ピクセルレベルのエキスパートによるアノテーションを用いて検証は行われていない。 こちらの図の拡大版を表示するには、ここをクリックしてください。
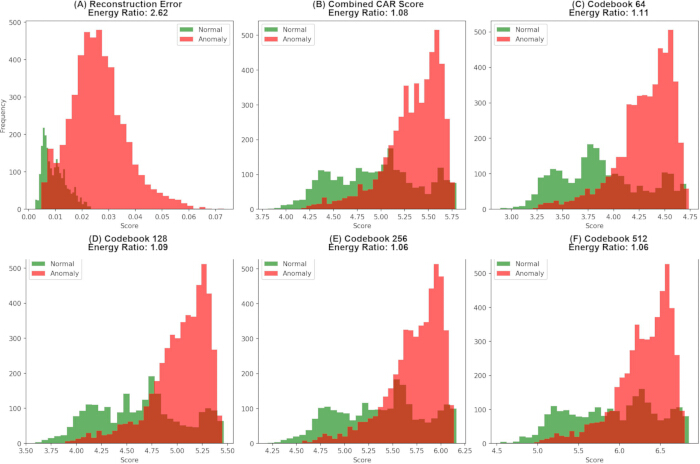
図8: 異なるスコアタイプの分布ヒストグラム。 再構成誤差(A)、複合CARスコア(B)、Codebook 64(C)、Codebook 128(D)、Codebook 256(E)、およびCodebook 512(F)における、正常サンプルと異常サンプルのスコア分布をヒストグラムで比較している。緑色と赤色のヒストグラムは、それぞれ正常サンプルと異常サンプルを示す。この図の拡大版を表示するには、こちらをクリックしてください。
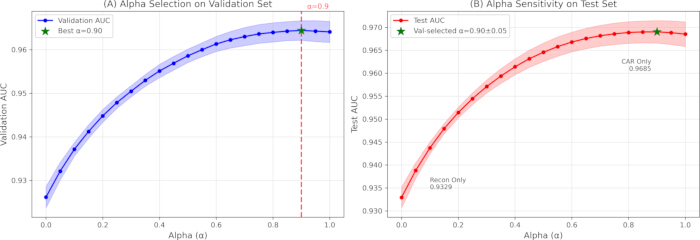
図 9: Alphaパラメータの感度分析。 (A) αの選択に使用された検証セットのAUC。(B) 異なるα値におけるテストセットのAUC。検証によって選択されたα値は0.85から0.95の範囲であり、平均値は0.90 ± 0.05で、表 5と一致している。αを[0.70, 1.00]の範囲で変化させた際のAUCの変動は0.5%未満であり、広いパラメータ範囲にわたって安定した性能を示す。 ここをクリックして、この図の拡大版を表示してください。
| 方法 | AUC (%) | AP (%) | F1 (%) | 精密度 (%) | 再現率 (%) | 特異度 (%) | P@R90 (%) |
| コンピュータ支援工学 | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| SAE(重篤な有害事象) | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| 変分オートエンコーダー | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| 平均絶対誤差 | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| PatchSAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| PatchCore | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| レアコード | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
表1:ベースライン手法との比較結果(5回交差検証)。CRCデータセットにおけるRareCodeおよび9つのベースラインUAD手法の検出性能。評価指標はAUC、平均精度(AP)、再現率(recall)、特異度(specificity)、F1スコア、再現率90%における精度(P@R90)、および精度(precision)である。すべての値は5回交差検証における平均値±標準偏差(SD)を示す。太字の値は、各指標における最高性能を示す。
| カテゴリー | AUC (%) | AP (%) | F1 (%) | 再現率 (%) | 特異度 (%) |
| 癌 | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| 炎症 | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
表2:異常サブタイプ別のクラス当たり検出性能。正常サンプルに対する癌および炎症サンプルのRareCode検出性能の個別評価。AUC、AP、F1スコア、再現率、特異度を含むクラス当たりの指標は、クラス固有の最適しきい値を用いて算出した。
| バリアント | コードブック構成 | CAR | AUC (%) | AP (%) | F1 (%) | 特異度 (%) | P@R90 (%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| SingleCodebook | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| TwoScales | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| ThreeScales | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| FourScales | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + 複雑なデコーダー | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
表3:アブレーション解析の結果。コンポーネントを段階的に追加したRareCode構成の性能比較:再構成のみのベースライン(NoCAR)、シングルコードブックCAR(SingleCodebook)、およびマルチスケール構成(TwoScales、ThreeScales、FourScales)。また、FourScales構成を用いたデコーダーの複雑性に関する追加のアブレーション解析も含まれている。評価指標には、AUC、平均精度(AP)、F1スコア、特異度、およびリコール90%における精度(P@R90)が含まれる。
| スコア形式 | エネルギー比 | コーエンのd | AUC (%) |
| 再構成誤差 | 2.623 | 2.006 | 93.31 |
| 複合CAR | 1.078 | 1.002 | 74.85 |
| コードブック 64 | 1.109 | 1.207 | 78.79 |
| コードブック128 | 1.085 | 1.067 | 76.19 |
| コードブック 256 | 1.065 | 0.916 | 72.80 |
| コードブック 512 | 1.064 | 0.833 | 70.38 |
表4:局在化由来の応答の画像レベル解析。 画像平均再構成誤差およびコードブックの希少性の応答を、エネルギー比、Cohen's d、およびAUCを用いて正常サンプルと異常サンプルの間で比較した。
| 折り畳み | 最適 α | 検証AUC (%) | テストAUC (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| 平均値 | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
表5:各フォールドにおける最適なα値。各交差検証フォールドの検証セットに対してグリッドサーチ(ステップサイズ 0.05)を用いて決定した最適な融合重みα。平均値および標準偏差(SD)を併記。
ディスカッション
これらの結果は、コードブックの活性化パターンが空間再構成誤差を補完する情報を提供し得ることを示唆しています。NoCARから完全なFourScalesモデルへの改善は、CARスコアリングによる寄与の可能性を裏付けており、選択された融合重みは、意味論的な希少性が最終的なアノマリースコアにおいて重要な役割を果たす可能性があることを示しています。考えられる理由の一つとして、CRC関連の異常は核の異型から腺管構造の崩壊まで、異なる形態学的スケールに及ぶため、複数の粒度での特徴表現が有効である可能性が挙げられます14。現在のモデルは、同一の倍率レベルで32 × 32および64 × 64パッチを用いて異なる空間範囲を捉えていますが、今後、ホールスライドイメージ(WSI)処理フレームワークと統合することで、階層的なスライドレベル解析がさらに促進される可能性があります39。
臨床的には、RareCodeは自律的な診断システムというよりも、事前スクリーニング用のトリアージツールとして検討するのが最適であると考えられる。高い再現率(98.40%)は、異常例の見落としリスクが比較的低いことを示唆しており40、一方で中程度の特異度(58.24%)は、教師なし学習の設定において炎症性変化と正常組織を区別することの困難さを反映している可能性が高い。がん特異的な特異度がより高い(94.21%)ことは、臨床的に最も重要なサブタイプにおいて誤警報の頻度が低い可能性をさらに示唆している。これらの性能特性は、専門家による評価が必要な症例の優先順位付けを行い、病理学的レビューを効率化するための事前スクリーニングツールとしてRareCodeを利用できる可能性を支持している5,6。
クラスごとの結果は、トリアージにおけるRareCodeの潜在的な役割をさらに裏付ける可能性があります。炎症よりも癌において相対的に高い性能が得られたことは、極性の喪失、核多形性、間質の線維形成など、悪性組織でしばしば見られるより顕著な構造的および細胞学的偏差を反映している可能性があります14,39。対照的に、炎症性変化は良性組織の変動とより密接に重複する場合があり、これが炎症特異的な特異度の低さの一因となっていると考えられます。したがって、全体的な特異度は慎重に解釈されるべきであり、癌検出は決定的な自律診断ではなく、臨床的に重要なユースケースとして機能させるべきです。
RareCodeの潜在的な不具合モードは、その1クラス学習という目的に照らして解釈されるべきである。このモデルは疾患特有のカテゴリーではなく正常組織のパターンを学習するため、再生上皮、線維化、壊死、または顕著な炎症などの非腫瘍性変化に対しても、高いアノマリースコアが付与される可能性がある。逆に、軽微な異形成や、正常に近い腺構造を持つ高分化癌では、反応が弱くなる可能性がある。また、染色のばらつき、組織の折り畳み、切片作成時のアーティファクト、ピンボケ、画像圧縮などの技術的要因が、再構成誤差やコードブックの活性化頻度に影響を及ぼす可能性がある。これらの検討事項から、臨床応用には画像品質の管理、染色のハーモナイゼーション、スキャナーを考慮したキャリブレーション、および多施設共同検証が必要であることが示唆される39,41。
ベースライン比較の範囲。本研究における実験的評価は、同等のデータおよび計算上の想定の下で動作する方法、具体的に、外部の事前学習コーパスを必要とせず、小規模なラベルなし正常サンプルのみを使用してエンドツーエンドで学習可能な方法に焦点を当てています。この範囲には、教師なし異常検知における主要なパラダイムである、再構成ベース(CAE, VAE, SAE, MAE, PatchSAE)、メモリ拡張型(MemAE)、知識蒸留(STFPM)、合成データ拡張(DRAEM)、および事前学習済み特徴マッチング(PatchCore)が含まれます。2つのカテゴリの方法を直接的なベースラインに含めなかったことを明記します。第一に、病理特化型の基盤モデル(UNI, CONCH, CTransPath)は、数百万枚の精選された病理画像による事前学習を活用しており、その性能上の優位性は主に異常検知メカニズムではなく、事前学習データの規模と多様性に起因します。したがって、直接比較を行うと、事前学習データの寄与と検知手法の寄与が混在してしまいます。ImageNetで事前学習されたバックボーンを使用しているSTFPMとPatchCoreの性能が不十分であったことは、汎用的な事前学習済み特徴を組織病理学的シナリオに適用した際のドメインギャップの影響を経験的に示しており、病理特化型の事前学習がこのギャップを埋める可能性があることを示唆しています。第二に、拡散モデルベースの異常検知法は有望ではあるものの、推論時に大幅に高い計算オーバーヘッド(通常、数百回の反復的なデノイジングステップが必要)を伴い、処理効率が実用的な要件となるハイスループットな臨床スクリーニングワークフローへの適用が制限されます。今後の課題として、現在のエンドツーエンド学習済みエンコーダを病理特化型の事前学習済みエンコーダに置き換えてRareCodeアーキテクチャに組み込むことで、CARメカニズムの解釈性の利点を維持しつつ、検知性能をさらに向上させることができるかを検証します。
いくつかの制限事項を認める必要がある。第一に、検証は単一施設のCRCデータセットに限定されており、今後、施設、スキャナー、および染色プロトコルをまたいだ多施設共同での評価が必要である。第二に、癌特異的な特異度は心強い結果であったが、全体の特異度は炎症と正常組織の境界によって影響を受けたままであった。第三に、ピクセルレベルのエキスパートによるアノテーションが得られなかったため、DiceおよびIoUを算出することができず、局在化の評価は定性的な可視化と、集約された空間応答の画像レベル分析に限定された。第四に、階層的ヒートマップが診断精度やレビュー効率を向上させることができるかどうかを判断するには、正式な読影試験が依然として必要である。最後に、RareCodeは現在、パッチレベルおよび画像レベルの解析を行っており、WSIレベルでの展開には、追加の処理フレームワークとの統合が必要となる39,41,42.
今後の研究では、WSI処理フレームワークとの統合後、公開ベンチマークおよび多施設共同コホートを用いてRareCodeを評価すべきである。前向きな読影研究を行うことで、診断精度、レビュー時間、および観察者間一致度への潜在的な影響を評価できる可能性がある42。さらなる方向性としては、計算効率の向上、多クラスのアノマリーサブタイピングへのモデル拡張、およびスライドレベルの診断に向けた多インスタンス学習の統合が挙げられる28,39。
開示事項
著者らは、本論文で報告された研究に影響を及ぼしたと考えられる既知の競合する金銭的利益または個人的な関係がないことを宣言します。本研究の作成において、原稿の言語および可読性の向上、ならびにデータ可視化コードの生成を支援するためにChatGPTを使用しました。本ツールの使用後、必要に応じて内容を確認および編集し、出版された論文について全責任を負います。
謝辞
本研究は、Yong Dai Academician's Workstation (Diagnostic Technology for Autoimmune Diseases) (Wan Ke Science and Technology [2023] No. 317)、Hefei National Research Center for Health Science and Technology Joint Research Center for Occupational Medicine and Health Open Fundの大学院生イノベーション基金プロジェクト (No.OMH-2023-04)、および安徽省の臨床・トランスレーショナル研究プロジェクト (No.202427610020132) の支援を受けて行われました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| GeForce RTX 4060 Ti GPU | NVIDIA | 翻訳対象のテキストが提供されていません。翻訳する原文を入力してください。 | 16 GB VRAM。すべての実験にシングルGPUを使用(RRID:SCR_022858) |
| Matplotlib | Matplotlib開発チーム | バージョン 3.8.4 | データの視覚化および図の作成 (RRID:SCR_008624) |
| NumPy | NumPy開発者 | バージョン 1.26.4 | 数値計算および配列操作 (RRID:SCR_008633) |
| pandas | pandas開発チーム | バージョン 2.2.3 | データの整理および表形式の結果処理 (RRID:SCR_018214) |
| ピロー | Python Imaging Library / Pillow コントリビューター | バージョン 10.3.0 | 画像の読み込みと前処理 |
| Python | Python Software Foundation | バージョン 3.12.3 | モデル開発およびデータ解析に使用されたプログラミング言語 (RRID:SCR_008394) |
| PyTorch | Meta Platforms, Inc. | バージョン 2.7.0+cu118 | モデルの実装および学習に使用したディープラーニングフレームワーク (RRID:SCR_018536) |
| scikit-learn | scikit-learn開発者 | バージョン 1.4.2 | 交差検証、学習データとテストデータの分割、および評価指標 (RRID:SCR_002577) |
| SciPy | SciPy開発者 | バージョン 1.13.1 | 統計解析 (RRID:SCR_008058) |
| torchvision | PyTorchプロジェクト | バージョン 0.22.0+cu118 | 画像の前処理とデータ変換 |
| tqdm | tqdm開発者 | バージョン 4.66.4 | トレーニングおよび評価の進捗モニタリング |
参考文献
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.