本プロトコルでは、匿名化された学部生のウェルビーイングに関する質問票データの処理において、生データの書き出しと回答のスクリーニングから、尺度のスコアリング、信頼性の検証、回帰診断、図表ソースの確認、そして可視化可能な解析出力に至るまで、構造化され監査可能なワークフローを実演します。
この記事について
サマリー
要約
質問票を用いた研究は、学生のウェルビーイングを調査するために広く利用されていますが、生の回答から分析可能な変数、統計表、および視覚的出力に至る手順上の経路は、十分に文書化されていないことが多くあります。本プロトコルでは、複数のリッカート尺度セクションを用いて収集された、匿名化された学部生のウェルビーイングに関する質問票データを処理するための、構造化され監査可能なワークフローを提示します。このワークフローは、倫理承認、同意書の作成、質問票の設定、および生データのエクスポートから始まり、その後、回答のスクリーニング、重複回答の確認、欠損データの処理、項目のコーディング、逆転項目の得点付け、信頼性の評価、記述統計分析、相関分析、対照群比較、回帰モデリング、診断チェック、および可視化用ソースの作成へと進みます。例として用いる質問票には、Depression Anxiety Stress Scales-21、Tuckman Procrastination Scale、Psychological Sense of School Membership Scale、高次思考測定に関する文献、および主観的ウェルビーイング尺度の文書に基づき、出典が明記され研究に合わせて調整された尺度セクションを使用しています。項目レベルの回答をどのように追跡可能な分析出力に変換できるかを示すため、例として尺度レベルの変数に負の感情、学業的先延ばし、学校への帰属感、高次思考、および主観的ウェルビーイングを使用します。代表的な出力には、スクリーニングフロー表、デモグラフィック要約、記述統計および範囲確認統計、内部整合性の推定値、相関行列、対照比較結果、回帰係数、残差および影響度の診断、および図表用ソースファイルが含まれます。本プロトコルでは、事前に規定された決定ルール、リンクされた尺度マップ、分析前スクリーニングログ、逆転得点の検証、および図表のための数値ソースの検証を重視しています。新しい心理測定尺度を提案したり、測定モデルを検証したり、因果関係を立証したりするのではなく、本手法は、質問票ベースの学部生のウェルビーイングデータをスクリーニング、得点化、分析、および可視化する必要がある研究者に、実用的で監査可能な手順を提供します。このワークフローは、分析前に尺度マップ、倫理承認、得点ルール、回答スクリーニングの閾値、および可視化用ソースファイルが定義されていれば、関連する質問票ベースの研究に適応させることが可能です。
概要
主観的ウェルビーイングは、学生が自らの生活、感情的な経験、社会的関係、および学習環境における日常的な機能をどのように評価しているかを反映するため、学生を対象とした研究において重要なアウトカムとなります。高等教育における学生のウェルビーイングは、単なる人生への満足度や心理的苦痛のみに限定されるものではなく、多次元的なものです1。したがって、研究者が感情的、行動的、社会的、認知的、およびウェルビーイングに関連する経験を同一の分析枠組みの中で検討する必要がある場合、アンケートデータは引き続き有用な手段となります。
アンケートデータの価値は、選択した構成概念だけでなく、生の回答をどのように分析変数に変換するかによっても決まります。多くの研究では、生の記録を最終的な表や図に結びつける中間的な決定プロセスを示すことなく、尺度スコア、相関行列、群間比較、または回帰モデルを報告しています。欠損回答の処理が一貫していなかったり、逆転項目のコーディングに誤りがあったり、重複した提出分がデータセットに残っていたり、不注意な回答が有効な観測値として扱われたりすることがあります。したがって、欠損データの処理に関する決定は、不可視な事後的なステップとして扱うのではなく、計画し、記録し、報告されるべきです2。また、オンラインアンケートデータでは、回答速度が速すぎるケース(speeding)、直線的な回答(straight-lining)、矛盾した回答、その他の低努力な回答パターンが、記述統計、信頼性推定値、および観察された関連性を歪める可能性があるため、回答の質に関する明確なルールが必要です3。
本プロトコルの新規性は、アンケートの生データのエクスポートから最終的な統計的・視覚的アウトプットに至るまで、連鎖的な監査証跡(オーディットトレイル)を構築している点にあります。具体的には、このワークフローでは、完成した尺度マップ、分析前のスクリーニングログ、逆転項目のスコアリングチェックポイント、スコアリング検証ログ、図表のための数値ソース検証、および各表や図をソースファイルに結びつける監査トレースが追加されています。これにより、本手法は標準的なアンケートデータのクリーニング、尺度のスコアリング、信頼性テスト、または視覚化の手法とは明確に区別されます。単にアンケートデータがクリーニングおよび分析されたと述べるのではなく、本プロトコルでは、どのファイルがロックされ、どのファイルがスクリーニングされ、どのルールが適用され、どの尺度スコアが生成され、そしてどの検証済み数値テーブルが各視覚的アウトプットの作成に使用されたかを具体的に規定しています。
このワークフローでは、負の感情、学業的先延ばし、学校への帰属感、高次思考、および主観的幸福感という5つの尺度レベルの変数を含む、匿名化された大学生のアンケートデータを用いて実演します。これらの構成概念は、構造化され監査可能な1つのワークフロー内で、感情的、行動的、学校環境的、認知的、およびアウトカム指向の例を提供するために選定されました。学業的先延ばしは、大学生におけるうつ、不安、ストレス関連のアウトカムを含む、後のメンタルヘルスの問題に関連していることが示されています4。また、学生集団において学校への帰属感と主観的幸福感は密接に関連しており、帰属感および幸福感に関する指標を同一のアンケート処理フレームワークに含めることを支持しています5。ただし、本プロトコルにおいて、これらの構成概念は因果的な心理モデルを構築するためではなく、ワークフローを実演するために使用されています。
このプロトコルの中心的な特徴は、データ処理に関する決定を実質的な解釈から分離している点にある。スケールマップは分析前に作成し、回答品質の基準はスケールスコアリング前に固定し、逆転項目のスコアリング検証は統計検定前に完了させ、図表は数値ソーステーブルの確認後にのみ作成する。リッカート形式の回答尺度では、項目の文言、回答アンカー、スコアリングの方向、および統計処理の間で慎重な整合性を図る必要があるため、この順序が重要となる6。また、本プロトコルでは、モデルの複雑さよりも、透明性のある前処理とスコアリング検証を優先させている。学生による研究においては、予測モデルや多変数モデルが有用な場合があり7、また、検証済みの数値行列に基づいたグラフィカルな要約は解釈を向上させることができるが8、そのどちらも入力変数の透明な準備に依存している。そのため、本ワークフローでは、相関分析、対照群比較、回帰モデリング、診断チェック、および可視化を、必須の実質的な主張としてではなく、例示的なモジュールとして使用している。
本プロトコルは、匿名化された学生のウェルビーイング・データの処理に向けた実用的なアンケート処理ワークフローを必要とする研究者を対象としています。オンラインプラットフォームから項目レベルのアンケート回答がエクスポートされ、リッカート尺度形式の項目から尺度レベルの変数を算出する必要があり、かつ、透過性の高い記述統計、相関分析、群間比較、回帰分析、診断、および可視化可能なアウトプットの作成を目的とする場合に適しています。本プロトコルは、因果関係の立証、新規尺度の妥当性検証、確認的因子分析の代替、測定不変性検定の代替、あるいは項目応答理論や潜在変数モデリングの代替を目的としたものではありません。本プロトコルの寄与は手続き的な点にあり、アンケートの記録から報告用の表や図に至るまでの経路を、可視化され、再現可能で、監査可能なものにすることにあります。この焦点は、オンライン調査データの質9、回帰分析および影響度のチェック10、および監査可能なアンケートベースの分析ワークフロー11に関する現在の関心事と一致しています。
プロトコル
ヒト参加者を対象とした本研究は、貴州開放大学航空学院の倫理委員会によって審査および承認されました(承認番号:GZOU-EDU-2024-015)。本研究は、匿名かつ自発的なアンケート形式を採用しており、参加者へのリスクが最小限であるため、倫理的免除の対象になると委員会により判断されました。すべての参加者は、アンケートに回答する前に電子的なインフォームドコンセントを提供し、不利益を被ることなくいつでも回答を中断することができました。一部の項目で、負の感情、ストレス、孤独感、無力感、不満、またはそれに関連するウェルビーイングの経験について尋ねているため、不快感を覚えた参加者のために、同意ページおよびアンケートの最終ページに研究者および所属機関の連絡先を記載しました。本プロトコルで使用したデータセットは、スクリーニング、スコアリング、分析、および可視化の前に匿名化されました。アンケートの全文は以下に提供されています。 補足ファイル 1.
1. 質問票、倫理関連資料、およびワークフロー資料の作成
- アンケートのプログラミングを行う前に、適格集団、研究設定、アンケートの構成概念、および計画している解析出力を定義してください。
- 対象集団、募集経路、質問票の内容、推定所要時間、匿名性の保護、データ保存方法、同意撤回の手順、参加者へのサポート情報、および計画している解析内容を網羅した倫理審査申請書を作成してください。
- データ収集を開始する前に、倫理承認書または免除申請書、同意説明文、募集文、アンケートのバージョン、参加者支援情報、および計画されたワークフローをプロジェクトフォルダに保存してください。
- 対象集団を、18歳以上で現在高等教育機関に在籍し、質問紙の内容を理解でき、かつインフォームド・コンセントを提供することが可能なフルタイムの学部生と定義する。
- リクルート前に除外基準を定義する。同意を拒否した回答者、ターゲット集団の定義を満たさない回答者、重複して回答した回答者、欠損データの閾値を超えた回答者、またはステップ1.4で説明した複合的な無効回答基準に該当する回答者を除外する。
- インフォームド・コンセントの声明文をアンケートの冒頭に配置してください。そこには、研究目的、参加の自発性、所要時間(約12分)、匿名性の保護、同意撤回権、データの利用計画、研究者の連絡先、およびサポート窓口の連絡先を記載してください。
- 学生番号、国民識別番号、携帯電話番号、個人のメールアドレス、寮の住所、またはその他の個人識別子を含む、直接的な個人特定情報を収集しないでください。
- アンケートを、インフォームドコンセント、人口統計学的情報、ネガティブ感情項目、学業先延ばし項目、学校への帰属感項目、高次思考項目、および主観的ウェルビーイング項目の順に構成してください。
- アンケートを作成する前に、使用する測定尺度を選択してください。本プロトコルでは、ネガティブ感情の評価に21項目のDepression Anxiety Stress Scales-21を、学業先延ばし傾向の評価に16項目のTuckman Procrastination Scaleを、学校への帰属感の評価に18項目のPsychological Sense of School Membership Scaleを使用しました。また、高次思考については既報の高次思考測定文献から改変した20項目の高次思考項目セットを用い、主観的ウェルビーイングについては大学生向け研究用の20項目の主観的ウェルビーイング尺度を用いて評価しました。12,13,14,15,16.
- アンケートを作成する前に、確定した尺度マップを準備してください。これには、構成概念名、元の尺度名、元の引用文献、言語バージョン、許諾または承認状況、翻訳または適応の手順、項目コード、項目の文言、回答範囲、回答アンカー、得点方向、逆転項目の有無、最終的な尺度レベルの変数、および採点ルールを含めてください。
- 出典となる測定尺度、引用文献、妥当性の根拠、および適応または翻訳の状態が文書化されている場合にのみ、項目セットを妥当性が確認された尺度として記述してください。著者によって作成された項目セット、または研究固有の項目セットを特定し、 表1 および 補足ファイル 1.
- データ収集を開始する前に、測定フレームワークを確定させてください。翻訳または翻案された尺度を使用する場合は、被験者の募集を開始する前に、翻訳、レビュー、整合性の確認、およびパイロットチェックを完了させてください。
- ロック済みの質問票ファイル、スケールマップ、生データ書き出しチェックリスト、スクリーニングログ、スコアリング検証ログ、解析ログ、図表ソーステーブルテンプレート、および解析構文またはスクリプトファイルを含む、ワークフロー監査パッケージを作成してください。
- すべてのワークフロー・アーティファクトにバージョン管理されたファイル名を使用してください。
- 各監査ファイルに必要な列を定義してください。
- スクリーニングログには、レコードID、スクリーニング基準、フラグ状態、除外状態、除外理由、判定日、およびレビュー者のイニシャルが記録されます。
- 尺度マップには、構成概念名、尺度の出典、項目コード、項目の文言、回答範囲、回答アンカー、逆転項目の有無、最終変数名、スコアリングルール、および使用許諾または翻案状況が含まれます。
- スコアリング検証ログには、項目コード、元の値の範囲、再コード化後の値の範囲、逆転項目の算出式、範囲チェック結果、不一致ステータス、修正内容、および修正日が含まれます。
- 図表ソーステーブルには、図番号、パネル番号、ソーステーブル、プロットされた変数、表示された統計量、サンプルサイズ、および検証ステータスが含まれています。
- アンケートのプログラミングを開始する前に、以下の解析ワークフローを定義してください:調査の実施、生データのエクスポート、回答のスクリーニング、尺度の得点化、信頼性の評価、記述統計解析、相関分析、高低群の比較、回帰モデリング、診断チェック、および可視化の準備17.
- ソフトウェアのメニューパスではなく、意思決定、操作、および検証アウトプットを中心にプロトコルを構成してください。
- 機関およびジャーナルのポリシーで許可されている場合は、質問票ファイル、スケールマップ、スクリーニングログテンプレート、スコアリングログテンプレート、解析構文またはスクリプトファイル、および図のソーステーブルを含むワークフローリソースを提供してください。
注: 図1 アンケートの作成から、生データの書き出し、回答のスクリーニング、尺度の得点化、統計解析、診断チェック、そして可視化出力までの工程を示しています。 表1 各構成概念について、使用した測定尺度、項目数、回答範囲、採点枠組み、逆転項目の処理ルール、許諾または改変の状況、および最終的な尺度レベルの変数を報告する。
2. 質問紙の設定と配布
- アンケートプラットフォームが、同意ゲート(consent gating)、必須項目、重複投稿の確認、タイムスタンプの取得、および回答所要時間の記録に対応していることを確認してください。
- 記載されているオンライン調査プラットフォームを使用して、アンケートを作成します。 材料一覧表確定したスケールマップに従って、アンケートをプログラミングしてください。
- 調査リンクを公開する前に、プログラムされた質問票と確定したスケールマップを項目ごとに照合してください。修正箇所はすべてスタディログに記録してください。
- インフォームド・コンセントの項目を、最初の必須項目として設定してください。参加者が「参加に同意しません」を選択した場合、アンケートを自動的に終了するように設定してください。
- ステップ1.8で確定した順序に従い、人口統計学的属性および心理尺度セクションをプログラミングしてください。尺度マップと一致するアイテムコードを使用してください。
- 倫理的承認または免除によって許可されており、かつ参加者が不利益なく辞退できる場合に限り、必要に応じて心理尺度の項目を必須回答に設定してください。強制回答が許可されていない場合は、データ収集前に欠損データの処理ルールを記録してください。
- 各尺度セクションの前に回答アンカーを表示し、各尺度内でアンカーの一貫性を維持してください。18.
- 調査プラットフォームにこの機能がある場合は、重複した回答の送信を無効にしてください。重複回答の確認に必要な、匿名化されたデバイス、ブラウザ、プラットフォーム、または送信識別子は保持してください。
- 提出時間および完了所要時間の自動記録を有効にします。
- アンケートの回答期間を暦日で7日間に設定するか、または倫理委員会によって承認された収集期間を適用してください。
- 承認済みの機関のリクルートチャネルを通じて、アンケートのリンクを送信してください。すべての参加者に対し、同一の書面による指示を提供してください。
- あらかじめ指定した収集期間の終了後、アンケートを締め切ってください。
注:スタディログ内の募集文言、アンケートへのリンク、開始日および終了日、プラットフォーム設定、同意文言、アンケートの最終バージョン、およびプラットフォームからのエクスポート設定はそのまま保持すること。
3. 生データの書き出しと保存
- 収集期間の終了後、すぐに完了したアンケート回答をスプレッドシート形式でエクスポートする。
- 最初にエクスポートしたファイルを、ロックされた生データセットとして保存する。このファイルは編集してはならない。
- スクリーニング、スコアリング、および解析用に作業コピーを1つ作成する。ファイル名には日付、バージョン番号、およびプロジェクト識別子を含める。
- エクスポートされたファイルに、回答者1人につき1行、および人口統計学的変数、アンケート項目、タイムスタンプ変数、プラットフォーム変数、または派生プラットフォームフィールド1つにつき1列が含まれていることを確認する。
- ロックされた生データセット、作業コピー、スケールマップ、アンケートファイル、スタディログ、スクリーニングログ、スコアリング検証ログ、解析ログ、図のソーステーブル、および構文またはスクリプトファイルを、パスワード保護されたプロジェクトフォルダに保存する。
- データセットに直接的な個人識別情報が含まれていないか確認する。解析前に、作業コピーから予期しない識別フィールドを削除し、フィールド名、削除理由、削除日、および担当レビュー担当者をスタディログに記録する。
- 参加者レベルのデータを共有または公開する前に、間接的な識別可能性を確認する。性別、年齢、学年、機関カテゴリー、および専攻分野カテゴリーの組み合わせによって作成される小規模な人口統計学的セルを確認する。セルに含まれる回答者が5人未満である場合は、カテゴリーを統合するか、セルを秘匿するか、集計データのみを提供する。
- 参加者レベルのデータの利用可能性、倫理的またはプライバシー上の要件による制限の有無、あるいは集計ワークフローデータセットへの置き換えの有無など、データの可用性ステータスをスタディログに記録する。
- データクリーニングの前にスクリーニングログを作成する。元のサンプルサイズ、スクリーニング基準、フラグを立てたレコード数、削除したレコード数、保持したレコード数、除外理由、判定日、およびレビュー担当者のイニシャルを記録する。
- 統計解析の前に解析トレースファイルを作成する。ソフトウェア名、ソフトウェアバージョン、オペレーティングシステム、ファイル名、データバージョン、スクリプトまたは構文のバージョン、および各解析実行日を記録する。
注意:ロックされた生データセットは検証のみに使用すること。すべてのスクリーニング、スコアリング、および解析は作業コピーを用いて行うこと。
4. 回答のスクリーニングおよび解析データセットの構築
- スケールレベルのスコアを算出する前に、あらかじめ規定された除外ルールおよび品質管理ルールを適用してください。
- 以下の順序で、ワーキングコピーにスクリーニングルールを適用してください:同意ステータス、適格性、重複投稿、欠損データ、回答所要時間、直線的回答、範囲外の値、および複合的な回答品質指標。
- 各スクリーニング操作の後、フラグを立てたレコード数、削除したレコード数、および保持したレコード数をスクリーニングログに記録してください。作業ファイルの以前のバージョンを上書きしないでください。
- インフォームドコンセントの項目が「いいえ」とマークされているか、または未回答であるすべてのレコードを削除してください。
- ステップ1.4で定義された選択基準を満たさないすべてのレコードを削除します。
- 匿名回答識別子、提出時刻、プラットフォームの重複提出フラグ、および繰り返される回答パターンを用いて、重複提出のスクリーニングを行う。
- 重複したエントリが検出された場合は、後の完全な回答を保持することを支持する記録上の理由がない限り、最初に完了した提出分を保持してください。
- 尺度スコアを算出する前に、すべての回答品質ルールを適用してください。 表2 ワークフローで使用される除外しきい値、フラグ立てしきい値、根拠、文献的根拠、および感度分析計画についてまとめる。
- 欠損データのスクリーニングを行う。全尺度項目の20%以上に欠損がある回答者は除外する。単一の項目のみが欠損している場合は、その尺度の少なくとも80%が回答されている場合に限り、当該回答者の同尺度における平均スコアで補完する。人口統計学的変数については、その変数がどの解析においても使用されない場合を除き、補完を行わない。
- 尺度項目の欠損値が20%を超えたため除外された回答者数と、尺度内平均値代入法を適用した回答者数を記録する。今回のデータセットでは、尺度項目の欠損値が20%を超えたため4名の回答者が除外され、21名の回答者に対して、孤立した37件の欠損項目への尺度内平均値代入が行われた。
- 回答時間にスクリーニングを行い、180秒未満で完了した回答にフラグを立てる。この値は自動的な除外ルールではなく、スピード回答(speeding)のフラグとして扱う。
- 直線的な回答パターンがないかスクリーニングを行う。すべてのリッカート尺度項目において、90%以上の項目で同じ選択肢が選ばれている場合にフラグを立てる。この値は、自動的な除外ルールではなく、回答パターンのフラグとして扱うこと。
- 重複投稿の証拠、不可能なタイムスタンプ、異なる投稿間での回答文字列の繰り返し、またはプラットフォームのメタデータとアンケート内容との矛盾など、その他の低負荷指標(low-effort indicators)をスクリーニングしてください。
- 少なくとも2つの品質管理指標が、極端に短い回答完了時間と直線的な回答パターンの組み合わせ、重複提出の証拠、あるいは不可能なプラットフォームメタデータなどの無効な回答を示唆する場合にのみ、フラグが立てられた回答を削除してください。19.
- 保持された場合も含め、フラグが立てられたすべてのレコードを記録してください。現在のデータセットでは、回答完了時間に基づいて19件の回答にフラグが立てられました。 < 180秒、8件の回答が~としてフラグを立てられました >90%の直線的な回答(straight-line responding)が見られたほか、2つ以上の回答品質指標に該当したため13件の記録が除外された。
- 範囲外の値がないかスクリーニングを行う。負の感情の項目が1~4の範囲内であること、学術的先延ばし、学校への帰属感、および高次思考の項目が1~5の範囲内であること、そして主観的ウェルビーイングの項目が1~6の範囲内であることを確認する。
- 元のエクスポートデータに明らかにフォーマットエラーがある場合にのみ、値を修正してください。心理学的スコアが異常に高い、あるいは低いように見えても、それが有効な数値である場合は変更しないでください。
- 提出済み質問票、同意および適格性による除外、重複による除外、欠損データによる除外、回答品質フラグ、統合品質管理による除外、個別項目の補完、維持された分析ケース、および最終的な分析サンプルサイズを報告するスクリーニングフロー表を作成してください。
- ロックされたスクリーニングログを使用してスクリーニングフロー表を完成させ、スクリーニング決定のエクスポート済み監査記録を保持してください。現在のデータセットにおけるスクリーニングフローは以下の通りです。提出されたアンケート、 n = 448; 同意または適格性による除外、 n = 6。重複した投稿は削除した。 n = 5;以下の理由で除外された記録: >尺度項目の20%の欠損、 n = 4;2つ以上の回答品質指標により除外された記録、 n = 13、最終解析データセット n = 420.
- 保持された記録を解析データセットとして保存してください。ファイル名には新しいバージョンを付与し、スクリーニングログを解析データセットと共に保存してください。
注意: 記録された回答品質の問題がない限り、有効な極端なスコアは保持してください。
5. 心理尺度をスコアリングする
- 回答のスクリーニングが完了し、分析用データセットが保存された後にのみ、項目レベルの回答を尺度レベルの変数に変換してください。
- ロックされた質問票の回答アンカーおよびスケールマップの採点ルールに従って、すべてのリッカート尺度形式の項目をコーディングしてください。
- 元の項目変数は変更せず、リコードまたは逆転項目については、別途、派生変数を作成してください。
- 固定スケールマップおよび対応する元の測定尺度または採点マニュアルに従って、各スケールを採点してください。
- 主観的幸福感のスコアを算出する前に、指定された主観的幸福感の項目を逆転得点化してください。1〜6の回答尺度の場合、各逆転項目を「7マイナス元のスコア」として算出し、導出された変数名の末尾に _R を付加してください。
- 主観的幸福感を算出する際は、元の変数ではなく、逆スコア化した変数を使用してください。
- 各尺度レベルのスコアを、保持された項目の平均値として算出する:負の感情、学業先延ばし、学校への帰属感、高次思考、および主観的幸福感。
- 最終的な尺度レベルの変数名を、ネガティブ感情、学業先延ばし、学校への帰属感、高次思考、および主観的ウェルビーイングとして定義してください。
- 各尺度レベルの変数の最小値および最大値を、その理論的な応答範囲と照らし合わせて検証してください。スコアが期待される範囲外にある場合は、コーディング、逆転項目の処理、および欠損値の処理を再確認してください。
- 推論分析を行う前に、各尺度の方向性が尺度マップと一致していることを確認してください。高得点が、その構成概念の意図した方向性を反映している必要があります。
- 分析前に逆転項目のスコアリング監査を実施すること。ランダムに抽出したレコードのサブセット、または可能であればすべての逆転項目について逆転スコアを再計算し、その監査結果をスコアリング検証ログに記録すること。
- スコアリングエラーが検出された場合は、導出変数を修正し、影響を受けた尺度スコアを再生成し、スコアリング検証ログを更新した上で、修正後の解析データセットに基づき、すべての後続解析および図表のソーステーブルを再実行してください。
注意:相関分析、群間比較、回帰モデリング、または可視化を行う前に、逆転項のスコアリングおよび範囲確認を必須のチェックポイントとして実施してください。
6. 内部一貫性と記述特性の評価
- ロックされたスケールマップで定義された項目変数を用いて、各尺度の内部一貫性、修正項目合計相関、および記述統計量を算出する。
- 各尺度のCronbach’s alpha、項目数、有効サンプルサイズ、修正項目合計相関、および項目削除時アルファ値を記録する。
- 本ワークフローでは、許容可能な最小信頼性の閾値としてCronbach’s alpha 0.70を使用する。項目を削除する前に、項目の文言、得点の方向性、逆転項目の処理、構成概念との整合性、および元の尺度のドキュメント20を確認すること。
- 解析環境でサポートされている場合は、補完的な信頼性推定値としてMcDonald’s omegaを算出する。2つの推定値によって信頼性の解釈が異なる場合は、Cronbach’s alphaと共にomegaを報告すること。
- 修正項目合計相関が負の値または極めて低い項目については、削除を検討する前に内容を精査する。まずは、コーディング、逆転スコア処理、または構成概念との整合性に問題がないかを確認すること。
- Cronbach’s alphaを上昇させるためだけに項目を削除してはならない。項目の削除は、採点マニュアル、項目の文言、修正項目合計相関、概念的な適合性、および文書化された採点検証に基づいて正当化される必要がある。
- 平均、標準偏差、最小値、最大値、歪度、および尖度を含む、5つの尺度レベル変数すべての記述統計量を算出する。
- 各尺度において、得可能な最小点および最大点に回答者が集中している割合を記録し、フロア効果またはシーリング効果を確認する。
- 信頼性推定値、項目合計診断結果、記述統計量、および採点に関する決定事項を解析ログに記録する。
注:Cronbach’s alphaは信頼性のチェックポイントとして使用されるものであり、完全な心理計量学的妥当性検証の手順ではない。正式な測定評価が必要な場合は、本ワークフローに加えて、McDonald’s omega、確認的因子分析、測定不変性検定、項目応答理論モデル、またはその他の潜在変数法を併用すること。
7. 相関分析の実施
- 検証済みの5つの尺度レベル変数(ネガティブ感情、学業的先延ばし、学校への帰属感、高次思考、および主観的ウェルビーイング)を使用してください。
- ピアソン相関を算出する前に、尺度レベルの変数ペアごとの分布および二変量散布図を確認してください。
- 変数がほぼ連続的なスコア変動を示しているか、深刻な歪度があるか、非線形関係にあるか、または影響力のある外れ値パターンがあるかを確認してください。
- 記述的な関連性分析の前提条件が満たされている場合に、すべてのスケールレベル変数のペアについて、ピアソン相関係数および両側p値を算出する。
- 相関係数を記録する。 p各変数ペアにおけるp値、サンプルサイズ、および相関の方向。
- 相関係数は小数点以下3桁まで記載してください。
- 各係数の方向性を尺度マップと比較してください。係数が意図した構成概念の方向性と矛盾している場合は、項目のスコアリングを再確認してください。
- 検証済みの相関行列を、「代表的な結果(Representative Results)」セクションにおける相関ヒートマップの数値ソーステーブルとして保存してください。
- 分布が著しく歪んでいる場合、順序尺度での感度が必要な場合、または散布図から単調だが非線形な関連性が示唆される場合は、スピアマン相関を用いて分析を繰り返し、関連性の方向性と相対的な大きさを比較してください。
- ピアソンおよびスピアマンの結果が、同じ実質的な解釈に至ったかどうかを記録してください。
注: 相関分析を、記述的な関連性の確認およびスコアリング方向の監査の両方として利用してください。
8. 主観的幸福度の高群および低群の作成
- クリーニングおよびスコアリング済みの分析用データセットを使用してください。グループ構成のために、生データのエクスポートファイルに戻ってはいけません。
- 回帰モデリングの主要アウトカムには、連続値の主観的幸福感スコアを用いてください。「高・低」のグループ分けは、対照的なプロファイルの比較にのみ使用してください。
- 回答者を主観的幸福度スコアの高い順に並べ替えます。
- あらかじめ規定した27%の極端群ルールを適用し、主観的幸福度の高群および低群を定義する。この閾値の設定根拠を(〜に)記録する。 表2 および解析ログ。
- 上位27%の回答者を主観的幸福度高群に、下位27%の回答者を主観的幸福度低群に割り当てる。
- 記述統計、相関分析、男女比較、および回帰モデリングにおいては、全解析データセットの中央46%を保持するが、高低対比分析からはこれらの症例を除外する。
- 「主観的ウェルビーイング群」という名前のグループ変数を作成します。上位グループを「高」、下位グループを「低」、それ以外の回答者を「中」とコード化します。
- 高群および低群に意図した数の症例が含まれていることを確認してください。27%の境界線でスコアの同点(タイ)が発生した場合は、事前に規定されたタイ処理ルールを適用し、その決定を解析ログに記録してください。
- タイスコア(同点)やサンプルサイズの少なさにより、27%の境界線でグループ分けが不安定になる場合は、感度分析を行ってください。三分位グループ分けなど、あらかじめ指定した別のルールを用い、解釈に変更がないか報告してください。
注:高低グループ分けは記述的な対比手順です。主要な回帰モデルにおける連続的な主観的幸福感スコアに代わるものであってはなりません。
9. 主観的幸福感の高い群と低い群の比較
- 分析データセットをフィルタリングし、主観的ウェルビーイングのグループ化変数において「高」または「低」とコード付けされた回答者のみを保持する。
- 「高」グループと「低」グループについて、ネガティブ感情、学業先延ばし、学校への帰属感、および高次思考を比較する。
- グループ比較を行う前に、各変数のグループ別分布、サンプルサイズ、および分散の等質性を確認する。
- 分布と分散の仮定が許容範囲内である場合は、独立標本t検定を用いる。分散の等質性の仮定が支持されない場合は、ウェルチのt検定を用いる。
- グループ平均、標準偏差、平均差、t値、自由度、p値、および95%信頼区間を記録する。
- 各グループ差についてCohen’s dを算出し、p値とともに効果量を解釈する。
- 各グループ差の方向性が、構成概念の定義および相関行列と一致しているかを確認する。
- 検証済みのグループ比較表を、グループ比較の視覚化のための数値ソースとして保存する。
- この分析を、極端な主観的ウェルビーイング・プロファイル間の対比として報告する。
注意:高低グループの比較を因果関係の証拠として解釈してはならない。
10. 性差の検討
- ハイ・ローグループフィルターを解除し、完全な分析データセットに戻します。
- 性を、因果的な暴露因子としてではなく、記述的なグループ化変数として使用します。
- 女性の回答者と男性の回答者について、負の感情、学業的先延ばし、学校への帰属感、高次思考、および主観的幸福感を比較します。
- 比較を行う前に、グループごとのサンプルサイズ、欠損値、分布、および分散の等質性を確認します。
- 前提条件が満たされている場合は、独立標本t検定を使用します。等分散性の仮定が支持されない場合は、ウェルチのt検定を使用します。
- グループ平均、標準偏差、平均差、t値、自由度、p値、95%信頼区間、およびCohenのd値を記録します。
- 性の差を記述的に解釈し、効果量をp値とともに報告します。
- 性の比較結果を、事後的な除外、尺度の修正、または因果関係の解釈を正当化するために使用しないでください。
注:性の比較は、この横断的アンケートワークフローにおける記述的なサブグループチェックとして含まれています。
11. 回帰モデルの推定
- 主観的幸福感を従属変数として使用する。
- 負の感情、学業的先延ばし、学校への帰属感、および高次思考を、尺度レベルの同時投入予測変数として使用する21。
- 尺度得点化の過程で作成された連続尺度レベルの変数を使用する。連続的な主観的幸福感のスコアを、高低のグループ分け変数に置き換えないこと。
- 同時投入法による重回帰分析を用いて、主モデルを適合させる。
- 非標準化係数、標準化係数、標準誤差、t値、p値、95%信頼区間、R2、自由度調整済みR2、許容度(tolerance)、および分散拡大係数(VIF)を記録する。
- 深刻な多重共線性がないと判断する閾値として、分散拡大係数が5.00未満であることを用いる。
- 二変量散布図、偏回帰プロット、または成分+残差プロットを確認し、予測変数と主観的幸福感との関連がおおよそ線形であるかを評価する。
- ダービン・ワトソン統計量を用いて、残差の独立性を評価する。
- 残差のQ-Qプロットを用い、サンプルサイズに応じて適切な正規性検定を行い、残差の正規性を評価する。
- 標準化予測値に対する標準化残差のプロットを用いて、等分散性を評価する。
- 診断チェックのため、標準化残差、標準化予測値、レバレッジ値、およびクックの距離を保存する。
- 4つの心理学的予測変数に加えて、サンプル記述で報告された人口統計学的変数(性別、年齢、学年、機関カテゴリー、および専攻分野カテゴリー)が利用可能で十分に分布している場合は、これらを含む補足的な調整モデルを推定する。
- 主モデルと補足的な調整モデルを比較する。人口統計学的調整後も、4つの心理学的予測値の方向、大きさ、および統計的解釈が安定しているかどうかを記録する。
- 検証済みの主モデルの標準化係数および95%信頼区間を、「代表的な結果」セクションの係数プロットのための数値ソーステーブルとして保存する22。
注: 回帰係数は因果関係ではなく、条件付きの関連として解釈すること。人口統計学的調整モデルは、利用可能な背景変数を考慮した後でもワークフローの結論が安定しているかを評価するための感度分析に使用される。
12. 回帰モデルの診断
- 適合させた回帰モデルの標準化残差を確認する。標準化残差の絶対値が 3.00 を超えるケースにフラグを立てる。
- 影響力のある観測値について、レバレッジ値とクックの距離を確認する。
- クックの距離が 4/n(n は分析サンプルサイズ)を超える観測値を、潜在的に影響力があるとしてフラグを立てる。1.00 を超えるクックの距離は、唯一のスクリーニング境界ではなく、深刻な影響がある参照しきい値として扱う。
- 残差対予測値プロットを確認し、非線形性、分散の不均一性、および異常なクラスターがないかを確認する。
- 残差 Q-Q プロットおよび残差の正規性検定の結果を確認する。正規性の評価が、記述的な関連性分析のための線形モデルの使用を支持しているかどうかを記録する。
- ダービン・ワトソン統計量を記録し、残差の独立性が許容範囲内であるかを判断する。
- フラグを立てたすべてのケースについて、スクリーニングログ、スコアリング検証ログ、および適格性基準に照らしてレビューする。
- フラグを立てたケースが有効な観測値であり、データ入力エラー、スコアリングエラー、重複投稿、適格性違反、または記録された回答品質の問題を反映していない場合は、そのまま保持する。
- 監査証跡によって、記録された手続き的エラー、適格性エラー、コーディングエラー、スコアリングエラー、またはデータ入力エラーが特定された場合にのみ、フラグを立てたケースを修正または削除する。
- 記録された修正を行った後、回帰モデルを再実行し、係数、信頼区間、R2、自由度調整済み R2、および診断出力を元のモデルと比較する。
- クックの距離が 4/n を超えるケースを除外してモデルを再適合させ、影響感度チェックを行う。実質的な解釈が変化するかどうかを報告する。
- 標準化残差によってフラグを立てたケース数、クックの距離が 4/n を超えてフラグを立てたケース数、最大クックの距離、ダービン・ワトソン統計量、および残差の正規性と線形性のチェックによる結論を含め、最終的な診断決定を分析ログに記録する。
注: モデルの適合度を向上させるためだけに影響力のあるケースを削除してはならない。削除または修正は、監査証跡に基づいた記録済みの理由に基づく必要がある。
結果
回答スクリーニング後に作成された分析データセット
回答スクリーニングのワークフローにより、提出された448件の質問票から、匿名化された420件の学生記録からなる分析データセットが作成された。スクリーニングログには、各判定ポイントが記録された。同意または適格性要件を満たさなかったため6件の記録が削除され、重複して提出された5件が削除された。また、すべての尺度項目の20%以上に欠損があったため4件の記録が除外され、2つ以上の回答品質指標に該当したため13件の記録が除外された。回答にかかった時間について、19件の回答にフラグが立てられた。 <180秒間で、8件の回答が~としてフラグを立てられました。 >90%の直線的な回答(ストレートライン・レスポンディング)が認められ、21名の回答者に対して、孤立して欠損していた37項目について尺度内平均値代入法を適用した。最終的な解析データセットには、直接的に個人を特定できる参加者情報は含まれず、欠損データの除外基準を超えたケースはなく、また、保持されたすべての項目回答は事前に定義された回答範囲内に収まっていた。スクリーニングのフローは、以下にまとめられている。 表3.
抽出されたサンプルには、女性回答者275名と男性回答者145名が含まれており、解析データセットのそれぞれ65.5%と34.5%を占めていた。平均年齢は20.1 ± 1.2歳であった。回答者は学部1年から4年までの4つの学年に分かれており、サンプルに占める割合は、1年次が27.1%、2年次が27.4%、3年次が25.5%、4年次が20.0%であった。また、データセットには3つの機関カテゴリーと5つの専攻カテゴリーが含まれていた。カテゴリーレビュー後、公表されたデモグラフィックセルの回答者数が5名未満となるケースはなかった。解析データセットの人口統計学的特性は表4にまとめられている。
尺度の構築、範囲の検証、および不適切なワークフローの例
項目のコーディングおよび逆転項目のスコアリング後、負の感情、学業的先延ばし、学校への帰属感、高次思考、主観的ウェルビーイングの5つの尺度レベルの変数を算出した。各スコアは理論的な回答範囲内に収まっていた。負の感情のスコアは、1-4の尺度で1.048から3.143の範囲であった。学業的先延ばし、学校への帰属感、および高次思考は、それぞれの1–5の尺度で1.312から4.250、2.333から4.444、2.350から4.850の範囲であった。主観的ウェルビーイングは、1–6の尺度で2.000から5.300の範囲であった。逆転スコアリングの検証により、導出された逆転スコア変数と、最終的な分析データセットにおける確定したスコアリングルールとの間に不一致がないことが確認された。これらのチェックにより、項目のコーディング、逆転スコアリング、欠損項目の処理、およびスコアの集計が、検出可能な範囲エラーなく完了したことが確認された。
このワークフローでは、最終分析前にエラーや疑わしい出力がどのように検出されるかを示す、最適ではない監査例も生成されました。監査の実行中、主観的ウェルビーイングの逆転項目の得点算出に誤りがあることが検出されました。これは、スコアリング検証ログにおいて、元の値、期待される計算式「逆転得点 = 7 - 元の得点」、算出された値、および最終的な尺度範囲が比較されたためです。これにより、算出された変数が修正され、主観的ウェルビーイングの得点が再生成され、その後のすべての記述統計、相関、比較、回帰、診断、および図のソース出力が再実行されました。また、別の中間作業ファイルにおいて、範囲検証の際に範囲外の項目値が特定され、それがロックされた生データの書き出しではなく、スプレッドシートの操作に起因することが突き止められました。有効な極端な回答は変更せず、作業コピーを修正し、その内容を記録しました。さらに、同一尺度内の他の項目よりも修正項目合計相関が低い項目があったため、信頼性の警告がレビューされました。項目の文言、得点の方向、および構成概念との整合性は正しかったため、その項目は保持されました。また、図が検証済みの数値ソーステーブルと一致していないドラフト視覚化の不整合が特定されました。そのため、検証済みテーブルから図を再生成し、図のソースレコードを更新しました。これらの例は、このワークフローが正常な出力を生成するだけでなく、監査証跡を通じてコーディングエラー、範囲の問題、信頼性の警告、図とソースの不整合、および回答品質に関する懸念を検出できることを示しています。
記述統計量および内部一貫性
5つの尺度レベル変数において、利用可能な分散が認められた。負の感情スコアの平均値は2.099 ± 0.391であり、学業先延ばしスコアの平均値は2.639 ± 0.484であった。学校への帰属感および高次思考は、それぞれ3.343 ± 0.390および3.627 ± 0.418と、中程度に高い平均値を示した。主観的幸福感スコアの平均値は3.784 ± 0.543であった。どの尺度においても明らかなフロア効果やシーリング効果は認められず、理論上の最小値または最大値に回答した者の割合は、各尺度ともに2.0%未満であった。
5つの尺度すべてにおいて、内的整合性は許容範囲内であった。Cronbachのα値は0.834から0.899の範囲であり、事前に設定した閾値である0.70を上回った。負の感情がCronbachのα値0.899で最も高い内的整合性を示し、次いで主観的幸福感が0.895であった。McDonaldのω値は0.842から0.906の範囲であり、ωによる推定値でも信頼性の解釈に変わりはなかった。修正項目合計相関の検討により、削除が必要な項目は特定されなかった。記述統計および信頼性推定値は表5に報告されている。
尺度レベル変数間の相関構造
相関行列を、関連性の記述的尺度およびスコアリング方向の確認として用いた。ピアソン相関を算出する前に、尺度の分布と二変量散布図を確認した。どの変数においても深刻な歪度や尖度は認められず、また、記述的なピアソン相関分析を無効にするような強い非線形パターンを示す二変量プロットも認められなかった。主観的幸福感は、ネガティブ感情(r = -0.496)および学業的先延ばし(r = -0.294)と負の相関があり、学校への帰属感(r = 0.481)および高次思考(r = 0.386)と正の相関があった。その他の関連性についても同様のスコアリング論理に従っていた。すなわち、ネガティブ感情は学業的先延ばし(r = 0.270)と正に関連し、学校への帰属感(r = -0.346)および高次思考(r =-0.205)と負に関連していた。学業的先延ばしは、学校への帰属感(r = -0.222)および高次思考(r = -0.134)と負に関連し、学校への帰属感は高次思考(r = 0.310)と正に関連していた。完全なピアソン相関行列を表6に示す。
スピアマンの感度分析を行った結果、すべての変数ペアにおいて方向性の解釈は同一であった。主観的幸福感と4つの予測因との間のスピアマン相関は、負の感情で ρ = -0.502、学業的先延ばしで ρ = -0.301、学校への帰属感で ρ = 0.477、高次思考で ρ = 0.392であった。検証済みのピアソン行列を可視化のための数値ソーステーブルとして使用した。図2Aは、5つの尺度レベル変数全体の相関ヒートマップを示している。図2Bは、主観的幸福感との4つの相関を示している。
高主観的ウェルビーイング群と低主観的ウェルビーイング群を用いた対比的デモンストレーション
27%のグループ分けルールは、現実世界のウェルビーイングプロファイルの実質的な分類としてではなく、対比的なワークフローのデモンストレーションとして使用されました。このルールにより、高主観的ウェルビーイング群に113名、低主観的ウェルビーイング群に113名という同数の2つのグループが作成されました。中間の194名の回答者は、全解析データセットには保持されましたが、この対比比較からは除外されました。境界値での同点によるグループ割り当ての変更はありませんでした。
本モジュールでは、あらかじめ指定したグループ分け変数の生成、分析データセットのフィルタリング、グループ別の記述統計量の算出、前提条件に基づいた適切なグループ間比較の実行、および可視化のための検証済みソーステーブルの書き出しが可能なワークフローであることを示しました。主観的幸福度が高いグループは、低いグループに比べて負の感情が低く(1.864 ± 0.358 vs. 2.335 ± 0.343; 平均差 = -0.472)、学業的な先延ばし傾向も低い(2.455 ± 0.476 vs. 2.801 ± 0.483; 平均差 = -0.346)ことが示されました。学校への帰属意識と高次思考は、主観的幸福度が高いグループでより高く、平均差はそれぞれ 0.454 および 0.351 でした。これら 4 つの比較はすべて有意であり(p < 0.001)、Cohen’s d 値は、負の感情で -1.346、学業的な先延ばしで -0.722、学校への帰属意識で 1.279、高次思考で 0.860 となりました。等分散性の仮定が支持されなかった場合は Welch’s t-test を用い、それ以外の場合は標準的な独立サンプル t-検定を維持しました。これらの出力は、グループがアウトカム変数から作成され、その後に相関のある変数で比較されたものであるため、選択した予測因子が現実世界の学生のウェルビーイング・プロファイルを定義しているという根拠として解釈されるべきではありません。高低グループの比較はTable 7にまとめられています。
性別による記述的比較
性別を記述的なグループ化変数として検討した。女性回答者は男性回答者よりも負の感情スコアの平均値がわずかに高かった(2.129 ± 0.380 vs. 2.042 ± 0.407)。この差は統計的に有意であったが、その大きさは小さかった(p = 0.033; Cohen’s d = 0.224)。学業先延ばし、学校への帰属感、高次思考、および主観的幸福感については、意味のある性別による差は見られなかった。主観的幸福感の平均値は、女性回答者と男性回答者でほぼ同一であった(3.781 ± 0.521 vs. 3.789 ± 0.583; p = 0.887; Cohen’s d = -0.015)。Welchのt検定による感度分析を行っても、性別比較の結果の解釈に変わりはなかった。性差の結果は表8に示されている。
モデル生成と診断チェックの例としての回帰モデル
スコア化された質問票データからモデルを生成、診断、および検証する例として、重回帰モデルを使用しました。主観的ウェルビーイングを従属変数とし、ネガティブ感情、学業的先延ばし、学校への帰属感、および高次思考を尺度レベルの予測変数として同時に投入しました。本モジュールの目的は、係数の抽出、多重共線性のチェック、残差診断、影響度の評価、人口統計学的に調整した感度分析、ならびに図表およびソースの作成方法を提示することです。
このモデルは、主観的ウェルビーイングの分散の中程度の割合を説明し、R2 = 0.411、調整済みR2 = 0.406であった。負の感情が最大の負の標準化係数を示した(B = -0.450、標準化β = -0.324)。学業的先延ばしも負の係数を示した(B = -0.130、標準化β = -0.116)。学校への帰属感と高次思考は、それぞれβ = 0.275およびβ = 0.218の正の標準化係数を示した。適合モデルにおいて、4つの予測因子はすべて統計的に有意であり、負の感情、学校への帰属感、および高次思考はp < 0.001、学業的先延ばしはp = 0.004であった。分散拡大係数(VIF)の値がすべて1.24以下であったため、多重共線性なきことが示された。これらの回帰出力は代表的なモデルチェックの結果であり、学生のウェルビーイングに関する決定的な心理学的説明ではない。表9に完全な回帰出力を示す。
性別、年齢、学年、機関カテゴリー、および学部カテゴリーを4つの心理学的予測因子に追加することで、補足的な人口統計学的調整モデルを推定しました。調整後のモデルでは、R2 = 0.427、自由度調整済み R2 = 0.414となり、同様の分散説明率を示しました。人口統計学的な調整後も、4つの心理学的予測因子の方向性と統計的解釈に変化はありませんでした。人口統計学的調整感度モデルの結果はTable 10にまとめられています。Figure 3Aは、4つの予測因子の標準化係数および95%信頼区間を示しています。Figure 3Bは、標準化予測値、標準化残差、およびクックの距離に基づく診断表示を示しています。
回帰診断およびモデルの保持
回帰診断の結果、適合モデルが単一の影響力のあるレコードによって左右されていることは示されませんでした。二変量および偏回帰プロットでは、強い非線形性は認められませんでした。残差対予測値プロットでは、深刻な不均一分散や特異なクラスタリングは見られませんでした。ダービン・ワトソン統計量は1.93であり、許容可能な残差の独立性が支持されました。残差のQ-Qプロットでは、正規性からの深刻な逸脱は認められませんでした。正式な残差正規性検定では統計的に有意でしたが(W = 0.992, p = 0.031)、Q-Qプロットおよびサンプルサイズに基づき、記述的な関連性分析のために線形モデルを保持することが妥当であると判断されました。
2件のレコードで絶対標準化残差が3.00を超えていた。クックの距離が1.00を超えるレコードはなかった。より感度の高い閾値であるクックの距離 >4/n(ここで n = 420、4/n = 0.0095)を用いたところ、17件のレコードが潜在的な影響値としてフラグ立てされた。最大のクックの距離は0.037であった。フラグが立てられた残差および影響値のケースについて、スクリーニングログ、スコアリング検証ログ、および適格性基準に照らして確認した。データ入力ミス、不正確なスコアリング、重複回答、適格性の不備、または文書化された回答品質の問題を示すものは認められなかったため、これらのケースを最終モデルに保持した。クックの距離 >4/n のケースを除外した影響度感度分析を行った結果、プライマリモデルと同様のワークフロー解釈が得られた。標準化係数の最大絶対変化量は0.026であり、自由度調整済み R2 は0.406から0.405に変化した。診断および感度分析の結果は表11にまとめられている。
解析パイプラインの内部検証
クリーニングおよびスコアリング済みの解析データセットを用い、同一のスコアリングルール、決定閾値、および解析トレースファイルを使用してワークフローを繰り返した。内部一貫性解析、記述統計、相関解析、高低グループ間比較、性別比較、回帰モデリング、診断チェック、および可視化ソースの準備を再度実施した。再現された出力結果は、元の記述統計、相関行列、グループ間比較値、回帰係数、診断出力、および可視化ソースファイルと一致した。これにより、同一の固定解析データセットに適用した際の解析パイプラインの計算安定性が確認された。この検証は、独立した解析者が固定された生データエクスポートからワークフロー全体を適用し、文書化された同一の出力結果を得ることを必要とする独立した手順の再現性を構成するものではない。
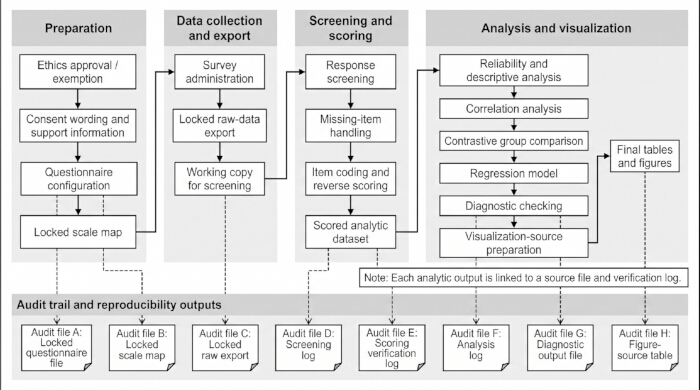
図1質問票に基づく主観的幸福感データの処理ワークフロー。 この概略図は、倫理審査の準備、質問票の設定、調査の実施、生データの書き出し、尺度マップ、スクリーニングログ、スコア付き分析データセット、検証済み分析表、回帰診断、図のソースファイル、および視覚化アウトプットを含む、プロトコルの手順と主要な監査アウトプットを示しています。 この図の拡大版を表示するには、ここをクリックしてください。
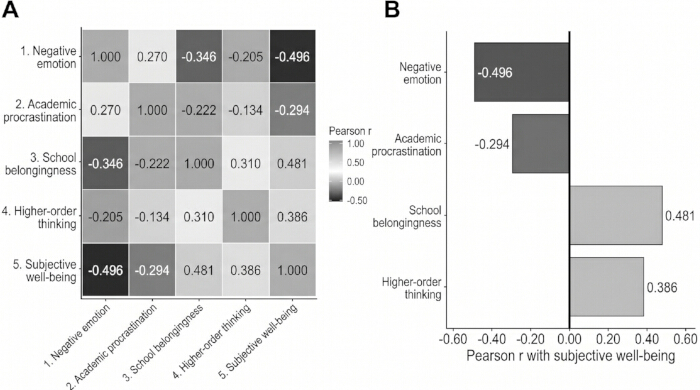
図 2: 尺度レベル変数間の相関構造。 (A) 表 6の検証済み相関行列から作成したピアソン相関ヒートマップ。(B) 同様の検証済みソーステーブルから作成した主観的ウェルビーイングを中心とする相関プロファイル。負の感情、学業的な先延ばし、学校への帰属感、高次思考、および主観的ウェルビーイングの5つの尺度レベル変数すべてを表示している。こちらをクリックして、この図の拡大版を表示してください。
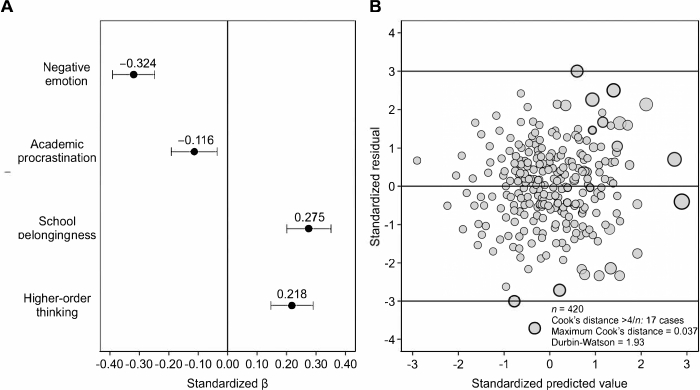
図 3: 回帰係数および診断の可視化。 (A) 表 9 の主要な回帰出力から生成された標準化回帰係数および 95% 信頼区間。(B) 表 11 にまとめられた標準化予測値、標準化残差、およびクックの距離(Cook's distance)の値から生成された回帰診断表示。クックの距離の値が大きいほど、適合モデルに対する潜在的な影響力が大きい観測値であることを示す。こちらのリンクをクリックして、この図の拡大版を表示してください。
表1:質問票の構成と尺度スコアリングの枠組み。この表は、構成概念名、出典となる測定用具、出典文献、適応または文書化の状態、項目番号、回答範囲、スコアの方向、逆転項目の要否、スコアリング方法、最終的な尺度レベルの変数、およびプロトコルにおける役割を含む測定枠組みをまとめたものである。こちらをクリックして、この表をダウンロードしてください。
表2:回答スクリーニングおよび分析的な判定基準この表には、同意スクリーニング、適格性スクリーニング、重複回答の確認、欠損データの処理、回答時間のフラグ立て、直線的な回答の検出、有効な回答範囲、信頼性の評価、高低グループの分類、回帰診断、および感度分析のためにあらかじめ規定された基準が記載されています。こちらのリンクをクリックして、この表をダウンロードしてください。
表3:提出された質問票から最終的な分析データセットまでのスクリーニングフロー。 この表は、各スクリーニングステップにおける提出済み質問票の数、フラグ付きレコード、除外レコード、保持レコード、および検証ソースを報告している。回答完了時間および直線的な回答パターンは、自動的な除外基準ではなく、回答品質のフラグとして扱われた。こちらのリンクをクリックして、この表をダウンロードしてください。
表4:解析データセットの人口統計学的特性。この表は、回答スクリーニング後に保持された匿名化済みの学生記録をまとめたもので、性別、年齢、学部年次、機関カテゴリー、および専攻分野のカテゴリーが含まれています。人口統計学的データのセルは、報告前に間接的な個人特定のリスクについて検討されました。こちらのリンクをクリックして、この表をダウンロードしてください。
表5:5つの尺度レベル変数の記述統計、範囲の検証、および内部一貫性。この表では、負の感情、学業的先延ばし、学校への帰属感、高次思考、および主観的幸福感について、項目数、理論的範囲、観測範囲、平均値、標準偏差、Cronbachのα係数、McDonaldのω係数、およびフロア/シーリング集中度を報告しています。こちらのリンクから本表をダウンロードしてください。
表6:尺度レベル変数のピアソン相関行列。 この表は、ネガティブ感情、学業先延ばし、学校への帰属意識、高次思考、および主観的幸福感の間のピアソン相関係数を示している。この行列は、記述的な関連性の出力およびスコアリング方向の検証ステップとして使用された。こちらのリンクをクリックして、この表をダウンロードしてください。
表7:主観的幸福感の高低グループ間の対比比較。この表では、主観的幸福感スコアの上位27%と下位27%の回答者における、ネガティブ感情、学業的先延ばし、学校への帰属意識、および高次思考を比較しています。この比較は、幸福感プロファイルの実質的な分類ではなく、グループ化および比較のワークフローを示すものです。こちらをクリックして本表をダウンロードしてください。
表8:性別による記述的比較。 この表は、負の感情、学業的先延ばし、学校への帰属感、高次思考、および主観的幸福感に関する性別ごとの記述的比較を示している。性別は記述的なグループ化変数として扱われた。こちらをクリックしてこの表をダウンロードしてください。
表9:主観的幸福感を予測する一次重回帰モデル。 この表は、主観的幸福感を従属変数とし、ネガティブ感情、学業的先延ばし、学校への帰属感、および高次思考を尺度レベルの予測変数として同時に投入した一次回帰モデルを示している。標準誤差、信頼区間、および分散拡大係数の値が含まれている。こちらのリンクから本表をダウンロードしてください。
表10:主観的ウェルビーイングを予測する人口統計学的調整済み回帰感度モデル。この表は、性別、年齢、学部年次、機関カテゴリー、および専攻分野カテゴリーで調整した後の4つの心理学的予測因子を示している。カテゴリー別の人口統計学的変数はダミーコーディングを用いて入力された。標準誤差、信頼区間、および分散拡大係数(VIF)の値が含まれている。この表をダウンロードするには、ここをクリックしてください。
表 11:回帰診断および影響感度チェック。 この表は、標準化残差、クックの距離 > 1.00、クックの距離 > 4/n、最大クックの距離、ダービン・ワトソン統計量、残差Q-Qプロット、残差正規性検定、残差対予測値プロット、線形性チェック、および影響感度分析を含む、残差、影響、およびモデル診断の出力をまとめたものである。こちらのリンクをクリックして、この表をダウンロードしてください。
補足ファイル 1:質問票の構成、尺度の出典、およびスコアリングに関するドキュメント。この補足ファイルでは、5つの質問票構成概念に関する、質問票の提示順序、インフォームドコンセントの文言、人口統計学的変数、出典となった測定尺度に関するドキュメント、項目コード、回答アンカー、適応およびドキュメント化のステータス情報、スコアリングの方向、逆転項目の処理ルール、最終的な尺度レベルの変数構築、欠損項目の処理ルール、回答品質の照合フィールド、範囲検証ルール、および参考文献へのリンクを提供しています。これは、ワークフローにおける尺度のプログラミング、スコアリング、および検証を記録するための質問票/コードブック補足資料として機能します。こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
本プロトコルでは、質問票に基づくウェルビーイング研究において一般的でありながら、報告が不十分なことが多いプロセス、すなわち、生の回答レコードから、スクリーニング済みデータ、スコア化された尺度変数、統計出力、および可視化可能なファイルへの移行を標準化します。本プロトコルの寄与は、新しい主観的ウェルビーイング理論の開発や因果モデルの提案ではありません。その代わりに、このワークフローは、質問票の構成、回答のスクリーニング、尺度のスコアリング、信頼性の確認、記述統計分析、関連性分析、回帰診断、および図のソース検証のための監査可能な経路を提供します。この区別が重要なのは、調査ベースの質問票研究における監査可能性は、統計的な解釈が始まる前に行われることが多い手続き上の決定(どのレコードを保持するか、欠損項目をどのように扱うか、逆転項目をどのように処理するか、数値ソーステーブルを視覚的出力にどのようにリンクさせるかなど)に依存するためです。これらの決定を明確にすることで、尺度ベースの研究における疑わしい測定慣行が軽減され23、より透明性の高い研究文化が促進されます24。
本プロトコルの中心的な特徴は、口頭による説明だけでなく、具体的な監査アーティファクトを使用することである。改訂されたワークフローでは、各構成概念を、そのソースとなる測定尺度、項目範囲、回答アンカー、スコアの方向、逆転項目の処理ルール、最終的な尺度レベルの変数、および適応またはドキュメント化の状態に関する情報に紐付けている。監査証跡には、ロックされた質問票ファイル、ロックされた尺度マップ、ロックされたローデータエクスポート、スクリーニングログ、スコアリング検証ログ、解析ログ、診断出力ファイル、および図表ソーステーブルが含まれる。これらのファイルにより、どのバージョンの質問票が実施され、どのレコードが除外または保持され、どのようにスコアが算出され、どの検証済みテーブルが各図の作成に使用されたかが明確になる。参加者レベルのデータを公開できない場合は、同一の変数構造を持ち、スクリーニングおよびスコアリングログが完了している合成データセットを提供することで、個人を特定できる、あるいは間接的に特定できるレコードにアクセスすることなく、読者が計算ワークフローをテストすることが可能となる。このアーティファクトベースの構造は、再利用可能な研究成果には明確なプロバナンス、構造、およびアクセス条件が必要であるというFAIR原則25に合致している。
代表的な結果は、学生のウェルビーイングの心理学的決定要因に関する実質的な根拠ではなく、ワークフローの出力として解釈されるべきです。主観的ウェルビーイングの高低による比較は、事前に規定されたグループ化ルールをどのように実装し、確認し、報告できるかを示すために含まれたものであり、実際のウェルビーイング・プロファイルの分類として解釈されるべきではありません。同様に、回帰モデルは、スコア化されたアンケートデータをどのようにモデル化し、多重共線性について確認し、残差および影響度診断を用いて評価し、検証済みの図表ソーステーブルにリンクさせるかを示すものです。これは、ネガティブ感情、学業的先延ばし、学校への帰属感、または高次思考が、主観的ウェルビーイングを因果的に決定づけることを立証するものではありません。すべての主要変数が同一の自己記入式アンケートを通じて単一の時点的に収集されたため、共通メソッドバイアス、回答スタイルによる影響、および共有された測定コンテキストを排除することはできません26。
また、このワークフローは完全な心理計量的妥当性の検証に代わるものではありません。クロンバックのα係数、マクドナルドのω係数、観測範囲の確認、項目合計の検討、および逆転項目のスコアリング検証は、監査可能なスコアリングワークフローにおける有用な品質管理ステップですが、これらは因子妥当性、測定不変性、項目反応特性、またはグループ間の比較可能性を確立するものではありません。本質問票を実質的な理論検証に使用する研究では、確認的因子分析、関連する人口統計学的または機関的グループ間での測定不変性テスト、および必要に応じて追加の妥当性確認を実施すべきです27。したがって、本プロトコルは監査可能なデータ処理および報告の枠組みとして理解されるべきであり、含まれる構成概念に対する完全な妥当性検証研究として理解されるべきではありません。
このワークフローは、外部検証を行わず、単一の時点で収集された自己報告式アンケートデータを用い、1名の学部生のサンプルで実証されました。他の集団、分野、機関、言語、および文化的背景への移植性は保証されません。別のコンテキストでこのワークフローを再利用する場合は、スケールマップを機械的にコピーするのではなく、再構築する必要があります。研究者は、項目の由来、翻訳または適応の状態、ウェルビーイング項目の文化的・文脈的依存性、回答アンカー、逆転項目の採点ルール、スコアの解釈、および地域の倫理的要件を確認する必要があります。翻訳および適応の手順には、非公式な文言の変更ではなく、明示的な文書化が必要であり28、教育および心理テストのスコアの解釈は、意図された用途および集団に対する根拠に基づいたままでなければなりません29。
実際的に、このプロトコルは、質問票ベースのウェルビーイング研究におけるデータ処理および報告のための、監査可能なフレームワークとして最も有用です。これにより、研究者は解釈を開始する前に、クリーニング、スコアリング、診断、および可視化に関する決定プロセスを明確にすることが可能になります。今後の応用では、独立したサンプル、異なる機関の設定、縦断的デザイン、および独立して再現を行う分析チーム全般にわたって、このワークフローを検証すべきです。外部妥当性の検証、事前登録された決定ルール、共有された合成データセット、記入済みのスクリーニング・スコアリングログの例、および独立した分析者による再現が行われれば、このワークフローの移植性と信頼性はさらに高まるでしょう。
開示事項
著者らに開示すべき利益相反はありません。
謝辞
著者らは、データ収集に際してアンケート調査に協力してくれた大学生に感謝いたします。また、アンケートの配布、データの整理、結果の検証、および表と図の作成を支援してくださった関係教員およびリサーチ・アシスタントに感謝いたします。本研究は、特定の資金提供を受けていません。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| broom Rパッケージ | CRAN | Rパッケージ | 回帰分析の出力を、構造化された係数表およびモデル要約表に変換するために使用されます。 |
| car Rパッケージ | CRAN | Rパッケージ | 分散拡大係数(VIF)の検証および回帰診断のサポートに使用されます。 |
| うつ・不安・ストレス尺度-21(DASS-21)出典ドキュメント | オーストラリア心理学財団 | Lovibond and Lovibond, 1995 | 負の感情セクションのソースドキュメント。ワークフローでは、最近の負の感情状態評価に合わせた、研究用に調整された文言を使用した。 |
| dplyr Rパッケージ | CRAN | Rパッケージ | データのフィルタリング、リコーディング、グループ化、スクリーニングフローの要約、および解析テーブルの作成に使用されます。 |
| ggplot2 Rパッケージ | CRAN | Rパッケージ | 相関ヒートマップ、主観的幸福感の相関プロット、回帰係数プロット、および診断表示の作成に使用。 |
| 高次思考測定ソースドキュメンテーション | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | 高次思考セクションのソースドキュメント。ワークフローでは、分析的、評価的、省察的、統合的、および根拠に基づいた思考に沿った、研究用に調整されたアイテムセットを使用した。 |
| IBM SPSS Statistics | IBM Corp. | バージョン 29.0.2.0 | 記述統計に使用、Cronbach’α係数、ピアソン相関係数、独立標本t検定およびウェルチのt検定’t検定、重回帰分析、ダービン・ワトソン統計量、標準化残差、レバレッジ値、クックの距離’s距離および分散拡大係数。 |
| psych Rパッケージ | CRAN | Rパッケージ | 心理測定学的要約に使用される、クロンバック’$\alpha$係数の検証、およびMcDonald’s オメガ |
| 学校所属感尺度ソースドキュメンテーション | Wiley | Psychol Sch. 1993;30(1):79-90 | 学校への帰属意識セクションに関するソースドキュメント。ワークフローでは、学校環境における知覚された受容、つながり、サポート、および帰属意識に沿った、研究用に適応させた表現を使用した。 |
| R統計環境 | R Foundation for Statistical Computing | バージョン 4.4.2 | 二次分析検証に使用、McDonald’$\omega$(オメガ)係数、スピアマン相関による感度分析、回帰分析出力の準備、診断出力の準備、および可視化ソースの準備。 |
| readxl Rパッケージ | CRAN | Rパッケージ | スプレッドシート形式のアンケートエクスポートをR検証ワークフローにインポートするために使用します。 |
| 中国市民向け主観的幸福感尺度ソースドキュメンテーション | 科学的 & 学術出版 | DOI: 10.5923/j.ijap.20190905.01 | 主観的幸福感セクションの根拠資料。ワークフローでは、研究に合わせて調整された言い回しを用い、人生の満足度、意味、サポート、進歩、不満、無力感、およびストレスに関連する幸福感の経験に整合させた逆転項目を使用した。 |
| 補足ファイル1:質問票の構成および尺度のドキュメント | 著者 | 補足ファイル 1 | 実施された質問票の構成、構成概念の順序、尺度の出典、項目コード、回答アンカー、採点方向、逆転項目の処理規則、尺度レベルの得点算出方法、およびドキュメントのステータス情報を提供します。 |
| Tuckman先延ばし尺度ソースドキュメンテーション | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | 学術的先延ばしセクションのソースドキュメント。ワークフローでは、学術的な遅延およびタスク延期行動に沿った、研究用に適応させた表現を使用した。 |
| Wenjuanxingオンラインアンケートプラットフォーム | 長沙冉星信息科技有限公司 | ウェブベースのプラットフォーム | 電子同意、アンケートのプログラミング、項目回答の収集、タイムスタンプの取得、完了所要時間の記録、重複送信の確認、および生データの書き出しに使用されます。 |
参考文献
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.