本研究では、物理的なコスト割当に動的なマクロ経済的・技術的調整とXGBoostベースの残差補正を組み合わせた、電力グリッド向けのハイブリッドコスト予測モデルを提案します。2.34%のMAPEを達成した本モデルは、精度と解釈性のバランスを維持しており、料金設定における規制上の透明性へのニーズに対応しています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
世界的なエネルギー転換と継続的な電力市場改革により、電力網企業は、信頼性の高い電力供給と、ますます厳格化する送配電料金規制とのバランスを取ることが求められています。過去のデータ外挿に基づく従来の予算策定手法は、資産運用の物理的根拠を反映できないことが多く、一方でデータ駆動型の機械学習モデルは高い予測精度を達成しますが、規制上のコスト検証に必要な透明性に欠けています。予測精度と解釈性のトレードオフを解消するため、本研究ではコスト定数(コストクォータ)に基づくハイブリッド・コスト予測モデルを提案します。このフレームワークでは、標準化された運用定数を物理的な予算策定のベースラインとして使用し、マクロ経済状況や技術進歩によって駆動される定数の動的な変動メカニズムを組み込んでいます。定数ベースの推定値を超える非線形残差を捉えるためにExtreme Gradient Boosting (XGBoost) を採用し、主要なコスト要因の寄与度を解釈するためにSHAP (Shapley Additive exPlanations) を使用しています。本モデルは、中国のある省級電力網の16年間にわたる匿名化された運用データを用いて評価されました。その結果、平均絶対パーセント誤差 (MAPE) 2.34%を達成し、SARIMAX、単独のXGBoost、およびAttention-LSTMモデルと比較して、予測誤差をそれぞれ61.8%、46.6%、34.1%削減しました。提案されたフレームワークは、工学的なコスト定数の原則と説明可能な人工知能を統合したものであり、正確な長期コスト予測と、規制上の許容コスト検証のための透明性の高い意思決定支援ツールの両方を提供します。
概要
世界的なエネルギー転換により、分散型再生可能エネルギー発電の統合、異常気象の増加、そしてIoT技術の広範な展開が進み、電力グリッドの資産管理と運用手法が再構築されています。これらすべてにおいて、システムの信頼性を確保するためにより高度な運用の柔軟性とメンテナンスリソースが必要とされています1,2。同時に、電気規制当局は、英国のRIIOや米国連邦エネルギー規制委員会(FERC)による収益率審査などの枠組みを通じて、送配電料金の監視を強化しており、コスト正当化における透明性が重視されています3。中国においても同様に、「許容コストに合理的な利益を加算する」規制メカニズムが採用されており、公益事業者はエンジニアリング活動と財務支出の間の明確な関連性を示すことが求められています4。しかし、公益事業者には物理的な資産運用とコスト予測を紐付ける透明性の高い定量的なツールが不足していることが多く、規制上のコスト検証の有効性が制限されています5。
このような環境において、既存の予測アプローチには重大な限界があります6。増分予算編成やARIMAベースのモデルを含む従来の手法は、歴史的なパターンが比較的安定していることを前提としており、経済変動や異常気象による構造的変化が生じた場合には、しばしば十分な性能を発揮しません7。対照的に、LSTMやTransformerアーキテクチャなどの現代的な機械学習モデルは、短期予測において高い予測精度を提供しますが、規制当局による意思決定に必要なエンジニアリング上の解釈可能性に欠けています8,9。近年のハイブリッド予測アプローチでは、統計的手法と機械学習の手法を組み合わせていますが、一般的に電力網の会計システムの根拠となる標準化されたエンジニアリングコスト割当(クォータ)が見落とされています10。これらの限界を解消するため、本研究では、動的な割当の進化と機械学習ベースの残差補正を組み合わせた、割当駆動型のハイブリッド予測フレームワークを提案します。これにより、エンジニアリング上の解釈可能性を維持しつつ、予測精度の向上を実現します。
主要な研究方向の一つは、英国のRPI-Xメカニズムや中国の認可費用検証フレームワーク11を含む、自然独占産業におけるインセンティブ規制に由来しています。これらの研究では、主にデータ包絡分析法(DEA)および確率的フロンティア分析(SFA)を用いて運用効率を評価しています12。先行研究では、料金規制を裏付けるため、設備投資(CAPEX)、運用費(OPEX)、およびコスト効率の間の長期的な関係が検討されてきました13,14。これらのアプローチは貴重なマクロ経済的知見を提供しますが、その出力は通常、年間予算策定に適した金額ベースの予測ではなく、相対的な効率性スコアとして表現されます15,16。さらに、フロンティアモデルは一般的に物理的資産構造や運用条件が比較的安定していることを前提としているため、資産の老朽化、インフラの更新、または急激な需要増加によって引き起こされる急激なコスト変動を捉える能力に限界があります17,18。
2つ目の研究方向は、統計および人工知能ベースの予測モデルに焦点を当てたものである。初期の研究では、コスト予測に重回帰分析や外生変数を含む自己回帰和分移動平均モデル(ARIMAX)が用いられていた19。より最近では、サポートベクター回帰、ランダムフォレスト、XGBoost、LSTM、およびTransformerモデルが、非線形関係や高次元の特徴空間を活用することで、予測性能を大幅に向上させている20,21,22。これらのアプローチでは、電力需要、生産者物価指数(PPI)、気象変数などのマクロ経済指標が頻繁に組み込まれている23。しかし、送電網の運用コストは、単なるマクロ経済変数ではなく、エンジニアリング活動、資産の劣化、メンテナンス計画、および管理上の決定によって生じるものである24。その結果、純粋にデータ駆動型のモデルはしばしば「ブラックボックス」として機能し、規制審査や認可コストの検証において、予測されたコストを説明することを困難にしている25,26。
エンジニアリングコスト定数管理は、この課題に対する潜在的な解決策となります27。活動基準原価計算(ABC)では、日常的な系統運用における労務、資材、設備、およびメンテナンス要件を見積もるために、標準化された運用定数が長らく利用されてきました28。中国の主要な電力会社は、点検、保守、試験、修理、および設備更新活動を網羅する包括的な定数データベースを構築しています。しかしながら、これらのエンジニアリング基準は、主にプロジェクトの精算や監査に使用されており、動的な長期予測には活用されていません29,30。さらに、定数基準は通常数年ごとにしか改定されないため、商品価格の変動、技術進歩、および運用慣行の変化に十分に対応できていません31。また、数百万もの分散した資産に定数システムを適用することは、大規模な予測において重大な計算上の課題となります32。
統計的予測、機械学習、およびエンジニアリングコスト管理における著しい進展にもかかわらず、標準化されたエンジニアリングコスト割当量、動的なマクロ経済調整、および説明可能な機械学習を、規制コスト検証のための統一された予測モデルに効果的に統合した既存のフレームワークは存在しません。動的に進化するコスト割当量とXGBoostベースの残差学習を組み合わせることで、規制上の意思決定に必要なエンジニアリング上の透明性を維持しつつ、長期的な予測精度を向上させることができるという仮説を立てました。この仮説を検証するため、物理的コストモデリング、マクロ経済および技術的調整メカニズム、XGBoost残差補正、およびSHAPベースのモデル解釈を統合した、ハイブリッド型の割当量駆動予測フレームワークを開発しました。提案するアプローチは、現代の電力市場規制における認可コスト検証を支援するために、正確な長期コスト予測と透明性の高い根拠の両方を提供することを目的としています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、中国東部の地方電力網から収集された、匿名化済みの運用および財務データを使用した。すべてのデータは分析前に集約および非識別化されており、個人を特定できる情報や機微な個人レベルの情報は含まれていない。したがって、倫理委員会の承認は不要であった。データのアクセスおよび分析は、適用されるデータ保護規制および電力部門の情報管理に関する機関間の合意に従って行われた。
予測フレームワークの概要
物理ベースの予測アプローチとデータ駆動型の予測アプローチを統合するため、エンジニアリングコストのクォータと機械学習を組み合わせたハイブリッド予測フレームワークを開発しました。単に複数のアルゴリズムを組み合わせるのではなく、物理モデルでベースライン予測を確立し、機械学習で残差誤差を補正するという原則に基づいたフレームワークとなっています。この設計により、予測プロセスが単なる過去のコストの外挿に頼ることなく、電力グリッドの生産および運用活動の根底にある物理的メカニズムに基づいていることが保証されます。
このフレームワークでは、まず電力網資産、標準化された運用活動、および財務コスト勘定の間の階層的なマッピングを確立します。生産・運用コストは、変電所、送電線、配電フィーダー、計量デバイス、デジタル点検設備などの物理的資産が、点検、保守、試験、修理、交換などの日常的な活動中に消費するリソースを金銭的に表現したものとして扱われます。コスト割当は、測定可能なエンジニアリングのワークロードと、それに対応する財務支出を繋ぐ役割を果たします。
図1に示すように、コストクォータは抽象的な財務配分ルールとしてではなく、資産の運用および保守プロセス全体に組み込まれた標準化された会計単位として機能します。最下位レベルの資産ワークロードは標準化された運用クォータに変換され、その後、労務費、資材費、建設設備費、外注サービス費、および緊急用備品を含むコストカテゴリーにマッピングされます。この階層的なマッピングにより、予測プロセス全体を通じてエンジニアリング上の解釈可能性と規制上のトレーサビリティが維持され、静的ベースラインクォータモデルを構築するための物理的な基礎が提供されます。
手法のワークフロー概要
提案する予測フレームワークは、3つの連続したステージで構成されています。(1) アセットレベルのワークロード割当を用いた物理的ベースラインの構築、(2) マクロ経済および技術的な調整によるコスト割当の動的展開、(3) 体系的な非線形効果を捉えるための機械学習ベースの残差補正です。図1に示すように、本フレームワークは、最下層のアセットおよび標準化された運用活動から、生産および運用コストの予測に至る階層的なマッピングを確立します。各ステージの実施詳細は、以下のサブセクションで説明します。
アセットレベルのワークロードに基づく物理的ベースラインコストモデル
電力網の生産および運用コストCtotalは、変電所の運用、送電線の保守、配電ネットワークの管理、カスタマーサービス、および支援システムを含む、複数の事業活動に関連する支出で構成される。本研究では、ベースラインの運用コストは、各標準化された運用活動によって発生するワークロードと、それに対応するコスト割り当てによって決定されると想定している。
静的ベースラインコストは、次のように計算されます:
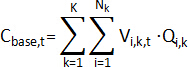 (1)
ここで、Vi,k,tは期間tにおけるビジネスカテゴリーk内のi番目の資産または運用タスクに関連するワークロードを示し、Qi,kはエンジニアリングコスト割当システムによって定義された対応する標準単位コストを表します。ビジネスカテゴリーには、変電所保守、送電線点検、配電ネットワーク運用、顧客サービスなどの主要な運用機能が含まれます。二重総和は、すべての標準化された運用活動のコストを集計し、正常なグリッド運用を維持するために必要な理論的ベースライン支出を推定します。
式(1)は、標準化された運用活動をコスト勘定に直接マッピングすることで、エンジニアリングのワークロードと財務支出の間の物理的な関係を確立しています。純粋な統計的予測モデルとは異なり、この定式化は解釈可能なエンジニアリングベースラインを提供し、それがその後の動的なクォータ調整および機械学習ベースの残差補正の基礎となります。この方程式は、中国の地方電力網企業の運用慣行およびコストクォータシステムに基づいて開発されました。表1に、ワークロード(Vi,k,t)、標準単位コスト(Qi,k)、運用タスク数(Nk)、および業務カテゴリインデックス(k)を含む、式(1)で使用される表記をまとめています。
外部環境の変動下におけるクォータの動的進化メカニズム
標準化されたコストクォータ(Qi,k)は、物理的に解釈可能なベースラインを提供しますが、マクロ経済状況の変化や技術的進歩は考慮されていません。長期的な適用性を向上させるため、物価上昇と技術主導の効率改善の両方に応じてベースラインクォータを調整する動的な進化メカニズムが導入されました。
最初の調整は、マクロ経済的なインフレに起因する調達コストの変化を考慮したものです。送電網の運用および保守は、銅、アルミニウム、ケイ素鋼などの大量資材に大きく依存しており、これらの価格は生産者物価指数(PPI)の変動と密接に関連しています。なぜなら  基準値を10とする指数であり、まず標準化されたインフレ率に変換されます。
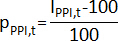 (2)
これに基づき、価格修正関数は  ~と定義される:
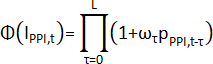 (3)
どこ  の長さのラグ重みベクトルである L 満足させる
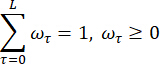
ラグ構造は、マクロ経済的なインフレが電力網サプライチェーン内の調達コストに伝播する際の遅延を表している。PPI指数を標準化されたインフレ率に変換することで、指数値を直接使用することに伴うスケーリングバイアスを回避しつつ、価格変動の累積的な影響を保持できる。式(2)および(3)は、確立されたマクロ経済インフレ調整モデルを適応させたものであり、ラグ構造は電力セクターの調達サイクルに合わせて調整されている3,34。
技術的進歩は、無人航空機による点検、インテリジェントロボティクス、およびデジタルメンテナンス技術などの進展による運用効率の向上を反映したコスト削減係数を通じて組み込まれました。技術調整係数は次のように定義されます:
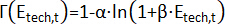 (4)
ここでは、αおよびβは非線形最小二乗法を用いて履歴パネルデータから推定された経験的な弾性係数です。技術進歩因子が常にユニットクォータコストの合理的な削減を表すように、パラメータ推定プロセスでは 0 < Γ(Etech,t) ≤ 1 と制約しています。この因子は主に、成熟した技術の代替による長期的な効率改善を反映していることに留意してください。式(4)は本研究で独自に考案したものであり、エネルギー技術コストに関する文献35,36にある学習曲線の概念を、系統維持管理業務に適応させたものです。新旧システムの並行運用、プラットフォームの統合、通信試験、および追加メンテナンスなど、デジタル設備の導入初期段階で発生し得る追加コストは、ベースラインクォータから強制的に差し引かれるのではなく、後続の機械学習残差補正モジュールによって特定されます:
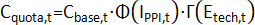 (5)
ここでCは塩基, t 最下層のアセットワークロードおよび標準化された運用コストクォータから算出される静的なベースラインコストを示す。 マクロ価格の変動が資材、設備、および外部サービスの価格に及ぼす波及効果を捉え、Γ(E技術、t)は、技術の成熟後に効率向上に基づいて削減される単位操作・保守コストを反映しています。上述の動的進化メカニズムを通じて、割当基準(クォータ・ベースライン)は静的な会計基準にとどまらず、経済環境や技術的条件の変化に応じて適応的に調整することが可能になります。式(5)は本研究独自のものであり、価格および技術の補正を割当基準の枠組みに統合した新しい手法を表しています。
割当制約下における体系的な非線形残差キャプチャ
複雑な進化的補正を行ったとしても、予測不可能な災害関連の気象変動や、一時的な関税削減期間中の顧客サービス苦情処理コストの増加といった突然の政策指示に直面した場合、クォータモデルは必然的に系統的な偏差を生じさせます。この偏差が、方程式の両辺における残差項となります:
Rt=Cactual,t-Cquota,t (6)
従来の物理法則ではこの側面を説明できないため、機械学習によってこれらの制限に対処することが可能です。高次元の特徴量によって生じる次元の呪いを避けるため、本研究では決定木アンサンブルに基づくXGBoostアルゴリズムを用いて、非線形関係 Rtをモデル化しました37,38。年間の極端な凍結日数 Dice などの気象学的特徴量およびマクロ政策の強度を含む、強攪乱特徴量行列 Xtを定義します。
回帰木で構成される非線形補償器における、予測残差の生成ロジック  として表現できる39:
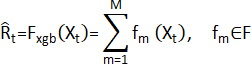 (7)
ここでFは、考え得るすべての分類回帰決定木構造の空間を表します。適合精度と過学習の防止を両立させるため、構造的複雑性に対するペナルティ項を含む正則化目的関数を構築し、m回目の反復においてこれを最小化します:
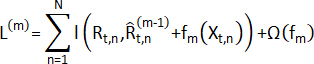 (8)
どこ  は、真の残差と予測残差の差を測定する凸損失関数である。本論文では、異常なピーク支出に対するモデルの堅牢性を高めるため、Huber Lossを採用する。正則化項は
 樹構造の複雑性を制限するために用いられ、次のように定義される:
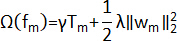 (9)
ここで Tm は m 番目の決定木における葉ノードの数を表し、wm は対応する葉の重みベクトルを表し、γ と λ はそれぞれ葉ノード数のペナルティ係数および重み正則化係数を示します。
最終的な予測式は以下の通りです:
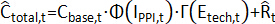 (10)
以下に詳しく展開します:
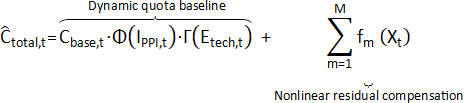 (11)
上記の数式は、提案する予測モデルのクローズドループ構造を数学的に表したものです。最終的な製造および運用コストの需要は、機械学習モデルによって直接生成されるのではなく、機械学習モジュールによって特定された非線形残差補正を動的クォータベースラインに重畳させることで得られます。これらの構成要素のうち、価格および技術要因は主にクォータベースラインの動的な進化を反映し、気候ショック、政策上の混乱、修理イベントの急増など、ルールによって明示的に特徴付けることが困難な要因は、機械学習残差補正モジュールによって捕捉されます。式(10)および(1)はこの研究における独自のものであり、物理的ベースラインとMLベースの残差捕捉を統合した予測フレームワークを構成しています。
図2は、提案モデルの予測結果に明確な階層的生成ロジックがあることを示しています。一方で、ベースラインの割当量は、コスト需要に対する安定し、透明性が高く、監査可能な物理的基盤を提供します。他方で、価格調整、技術的効果、および外部ショックの残差により、モデルは複雑な環境下での動的な変化に適応することが可能になります。予測値を直接出力するブラックボックスモデルと比較して、この分解構造は「なぜコストが上昇または下降するのか」を明確に明らかにすることができ、これにより予算審査や送配電料金規制におけるモデル結果の解釈可能性を向上させることができます。
データソースおよび収集手順
理論的なモデルは、その実用性を実証するために、実証データを通じて厳格に検証される必要があります。電力部門の中核となる財務データには、国家インフラ運営に関する機密情報が含まれているため、本研究では、便宜上E-Gridと呼称する中国東部の典型的な省レベルの電力網から、2010年から2025年までの16暦年連続の、高精度で匿名化された月次会計データを抽出しました。この省は、伝統的な重工業主導の成長からハイエンド製造業へと移行するという典型的な経済サイクルを経験しており、グリッド資産規模の年平均成長率は7.4%に達しています。したがって、そのコスト構造の複雑な進化は、他の急速に発展しているグリッドシステムにとっても潜在的な関連性を有しています。データは、主に以下の3つのソースから得られています。(1) 資産レベルの作業量、点検頻度、および修理イベントを記録した内部の運転・保守ログ、(2) 労務費、材料費、設備費、および外注サービス費にわたる月次コスト明細を提供する財務会計システム、(3) 中国気象局の気象記録および国家統計局のマクロ経済指標を含む外部環境データベースです。
品質管理および欠損データの処理
マルチソースシステムから統合された130以上の初期指標に対し、厳格な品質管理手順が実施されました。全観測データの3%未満であった欠損値については、時間的傾向を持つ連続変数には線形補間法を、カテゴリカル指標には最頻値代入法を用いて処理しました。外れ値の特定には四分位範囲(IQR)法を用い、第3四分位点からIQRの3.0倍を超える値については、データの完全性を維持し極端な値による歪みを軽減するため、9パーセンタイル値でウィンザライズ処理を行いました。
サンプルサイズの検討
本データセットは192件の月次観測データ(2010年1月~2025年12月)で構成されており、そのうち156件(2010年~202年)をトレーニングおよび検証用に割り当て、36件(2023年~2025年)をアウトオブサンプル(サンプル外)テスト用に確保した。このサンプルサイズはディープラーニングの適用には比較的小規模であるが、正則化とツリープルーニング(木の剪定)メカニズムにより、小・中規模の表形式データセットで高い性能を発揮するように設計されたXGBoostアルゴリズムに適している。潜在的な過学習のリスクを軽減するため、(1) 厳格な正則化ペナルティ(γ = 0.1, λ = 1.0)の適用、(2) patienceを50ラウンドとした早期停止(early stopping)、(3) 保守的な木の深さ制限(max depth = 5)を導入した。これらの措置を総合的に講じることで、限られたサンプルサイズであってもモデルの安定性と汎化性能を確保している。
データのセグメンテーションおよびマルチソース異種統合
厳格な検証のため、2010年1月から202年12月までのデータを、クォータ進化係数およびクォータ補正残差ネットワークの学習に使用する156個の観測値を含むトレーニング・検証区間に割り当てました。2023年1月から2025年12月までを、36個の観測値を含むホールドアウト外標本テストセットとして予約しました。なぜこの期間が最終的な検証領域として選ばれたのでしょうか。その理由は、この3年間が新型電力システムの構築加速期と重なり、さらに大規模なエルニーニョ現象に伴う高温イベントや、分散型再生可能エネルギー発電の急速かつ不均一な増加が複合的に発生したためです。これにより、電力網は資材サプライチェーンと修理人員の配置において、かつてない圧力に直面しました。
コストを変動させる要因を科学的に選定し定量的に定義することは、機械学習の残差ネットワークが系統的な変動を効果的に捉えるための基盤となります。本研究では、電力システムにおける標準的な運用コストの管理論理に基づき、過去のキャッシュフローのみに依存する従来の財務予測という単一の次元を突破し、運用の一次ログと外部システムの台帳を用いて、「物理的資産規模」、「運用および保守条件」、「マクロ経済の推移」、「外部気候環境」という4つのコア境界から特徴量エンジニアリングを再構築しました。実際のモデリングプロセスにおいて、マルチソースシステムの統合から得られた130以上の元の指標に対し、ピアソン相関テストを用いて、閾値を |r| > 0.85 と設定し、高い共線性を持つ冗長な変数を排除しました。熟練した電力網エキスパートの事前知識に基づき、最終的に42個のコア入力特徴量を選択し、特徴量行列 Xt を形成しました。入力テンソルの基礎的なデータ構造と分布を明確に示すため、Table 2 では、上記4つの評価次元から12個の代表的なコア特徴量を選択し、観測期間における記述統計をまとめています。
マルチソース特徴システムの空間・トポロジー的根拠をさらに明確にするため、図3に、研究対象となった地方電力網の匿名化された概略トポロジーを示します。この図では、電圧レベル別の変電所、送電回廊、分散型再生可能エネルギー群、負荷中心、および代表的な環境変動ゾーンが重ね合わせて表示されています。このトポロジーは、生産コストおよび運用コストが、資産規模、ネットワーク構造、緊急修理の強度、および外部の気候変動による影響を複合的に受ける理由を説明するのに役立ちます。また、XGBoost補正モジュールで使用される残差駆動変数の空間的な解釈根拠も提供しています。
表2は、異なるビジネス次元にわたる説明変数が、統計的に明確に異なる形態を示すことを示しています。変電所容量や回線長など、企業の内生的な発展ダイナミクスを表す物理的資産変数は、標準偏差が比較的安定しており、歪度(skewness)の値は0.1から0.8の間に集中しています。これらのデータ構造全体は概ね正規分布しており、インフラ建設サイクルにおける電力網の安定した発展という特性を客観的に反映しています。これとは対照的なのが、表の下部に記載されている気象および外部環境の変動変数です。例えば、過去90日間の警報レベルの高温日数の累計および回線遮断影響指数は、それぞれ2.15および2.45という極めて強い右裾を引いた分布(右歪度)を示しています。この典型的なヘビーテイル分布は、実際の電力網の運用および保守において無視できない客観的な課題を裏付けています。つまり、極端な気象災害は年間のタイムラインで見れば発生頻度は比較的低いものの、一度発生すると、修理労力の投入量や予備部品の消費量を指数関数的に増加させることが多いということです。別の視点から見ると、これらのマルチソース特徴量の分布における高い不均一性と極値の歪度は、正規性と等分散性の仮定に基づくARIMAXなどの従来の線形時系列モデルを用いて複雑な電力網コストを追跡することの理論的な限界を明らかにしています。これは、物理的な会計ベースラインを超えて機械学習モジュールを導入することの妥当性をさらに立証するだけでなく、疎な特徴量分布や非線形マッピングを効率的に処理してコスト残差を近似できるXGBoostツリーモデルを本論文で選択したことに対する、強固な統計的根拠を与えるものです。
ハイパーパラメータの最適化および評価システムのセットアップ
特徴量の入力空間を決定した後、モデルのハイパーパラメータの設定は残差近似ネットワークのフィッティング性能に直接的に影響します。XGBoost補正ネットワークは、木の深さ(max depth)、学習率、正則化ペナルティ項など、多くのパラメータを含み、かつこれらのパラメータ間には非線形な相互作用があるため、従来のグリッドサーチでは計算コストが高くなるだけでなく、高次元空間において局所解に陥りやすい傾向があります。そこで本研究では、パラメータチューニングのプロセスに、ベイズ最適化手法であるTree-structured Parzen Estimator(TPE)を導入しました。TPEアルゴリズムは、過去の評価による損失関数のフィードバックを用いて、次回のサンプリング方向を動的に導くことができます。目的変数の事後カーネル密度推定(KDE)を構築することで、パラメータの探索空間を適応的に絞り込み、高い計算コストをかけることなく、モデルがグローバルな最適ハイパーパラメータ構成を近似することを可能にします。TPEの最適化目標は、10回のイテレーションにわたり検証用RMSEを最小化することとし、50ラウンド改善が見られない場合に早期終了とする設定としました。
内部検証セットでパラメータの最適化を完了した後、サンプル外テストセットにおける各モデルの最終的な性能を客観的に評価し、コスト検証に関する規制当局の定量的評価要件を満たすため、本研究では平均絶対パーセント誤差(MAPE)を用いて、予測シーケンスの相対的な偏差を定量化します。同時に、運用における極端なコスト予測失敗を制御するという実用的なニーズに対応するため、より大きな誤差に対してより強力なペナルティを課す平方根平均二乗誤差(RMSE)も導入します。最後に、決定係数R2を用いて、真のターゲット分散に対する回帰全体の説明力を定量化します。
指標の数学的定義は以下の通りです:
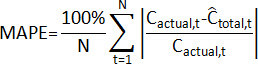 (12)
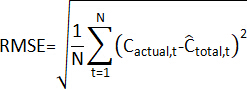 (13)
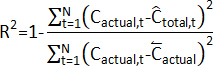 (14)
どこに  期間tにおける実際の生産および運用コストを表し、
 モデルにより予測されたコストを表し、
 はテストサンプルにおける平均実コストを表し、Nはテストセット内のサンプル数を表します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
予測精度のパノラマ次元削減比較
パンデミック後の回復に伴う変動や極端な高温イベントを含む2023〜2025年のサンプル外テストセットを用いて、Tree-structured Parzen Estimator (TPE)で最適化したすべてのモデルを評価したことで、主要な予測アルゴリズムの性能を客観的に比較することができました。厳格かつ包括的な評価を行うため、異なる手法的アプローチを代表する4つのベンチマークモデルを導入しました。具体的には、従来の財務予測を代表する伝統的な指数平滑法、線形季節性時系列モデリングを代表するSARIMAX、割当制限のない純粋なデータ駆動型アプローチを代表する単独のXGBoost回帰、そして長系列予測に広く用いられているアテンション強化型長短期記憶ネットワークであるAttention-LSTMです。
表3に示すように、提案したQuota-MLモデルは、2023〜2025年のサンプル外期間における製造および運用コストの予測において、すべて...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究は、産業コストクォータを機械学習に統合することで、長期的な電力網コスト予測のための解釈可能かつ高精度なフレームワークが提供されることを実証しています。結果から、気候関連の変数、特に極端な高温日と送電線遮断影響指数がコスト残差の主要な要因であることが示されており、公益事業の支出に対する外部攪乱の影響が増大していることが浮き彫りになりました。これらの知見は、天候に関連するコストを単なる付随的な運営費用として扱うのではなく、専用の予備費に組み込み、予測される気候リスクに基づいて予備費を有効活用すべきであることを示唆しています。また、送電線遮断の影響が主要なコスト要因であると特定されたことは、運用上の混乱とコスト変動の両方を軽減する上で、予知保全および状態監視戦略に価値があることをさらに強調しています。
また、分析の結果、デジタルトランスフォーメーションは、導入の初期段階において即座に効率性が向上するのではなく、移行期間中の二重システム運用により、運用コストを増大させる可能性があることが明らかになりました。この知見は、公益事業者がデジタル投資を評価する際、短期的な財務パフォーマンスで...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者全員が、利益相反がないことを宣言します。
著者貢献:
Xiaohui Wangは研究の構想および設計、手法の開発、正式な解析の実施、および原稿の起草を担当した。Tong Liはデータのキュレーション、ソフトウェアの実装、および検証に貢献した。Yanchao Luは手法の開発、調査、およびデータの解釈に貢献した。Quanfeng Lvはリソースの提供、データ収集の監督、および原稿の批判的なレビューを行った。Fan Liuはプロジェクトを監督し、概念化および結果の解釈に貢献し、資金を確保し、原稿を批判的に改訂した。すべての著者が原稿の最終版を確認し、承認した。
謝辞
本研究は、中国国家電網公司の技術プロジェクト「発電および送電コスト配分分析と非同期最適化技術の研究」(プロジェクト番号:520600250029-183-ZN)の支援を受けて実施されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| E-Grid匿名化月次会計データセット | 中国東部の地方電力グリッド | N/A | 物理資産、運転・保守、マクロ経済、および環境データを含む、192の観測値で構成される匿名化された月次生産および運用コストデータセット(2010–2025)。モデル開発(156観測値)およびアウトオブサンプルテスト(36観測値)に使用。 |
| Matplotlibプロッティングライブラリ | Matplotlib development team | 3.5.2 | 原稿の図および、モデル性能プロット、トポロジー可視化、残差診断、レーダーチャート、SHAP関連の視覚的要約を含むグラフィカル出力の生成に使用。 |
| NumPy数値計算ライブラリ | NumPy developers | 1.22.3 | 数値配列操作、行列計算、および再現性制御に使用。該当箇所には固定ランダムシード42を適用。 |
| Pandasデータ操作ライブラリ | pandas development team | 1.4.2 | データのインポート、統合、再構成、フィルタリング、および前処理(欠損値補完、時系列アライメント、モデル入力変数の準備を含む)に使用。 |
| Pythonプログラミング環境 | Python Software Foundation | 3.9.13 | データ前処理、特徴量エンジニアリング、モデルトレーニング、ハイパーパラメータ最適化、予測、統計検定、および性能評価を含む、完全な予測ワークフローの実装に使用したプログラミング環境。 |
| Scikit-learn機械学習ライブラリ | scikit-learn contributors | 1.0.2 | データ前処理、トレーニング・検証データの分割、補助的なモデル評価、およびピアソン相関分析や選択された性能指標の算出を含む統計的手順に使用。 |
| SciPy科学計算ライブラリ | SciPy contributors | 1.9.0 | ピアソン相関分析、および外れ値処理とウィンゾライゼーションを支援する手順を含む統計計算に使用。 |
| Tree-structured Parzen Estimator実装 | Optuna contributors | 3.1.0 | 最大ツリー深さ、学習率、正則化パラメータを含むXGBoostのハイパーパラメータ調整に使用したベイズ最適化実装。Tree-structured Parzen Estimatorは、オープンソースのOptunaパッケージを通じて実装。 |
| XGBoostソフトウェアライブラリ | DMLC / XGBoost contributors | 1.7.1 | 非線形残差補償に使用した決定木ベースのアンサンブル学習ライブラリ。式7–9に記載されている通り、Huber損失とツリー複雑度ペナルティを伴う正則化目的関数を実装。 |
参考文献
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。