このプロトコルは、人間の音声録音からパーキンソン病を分類するための再現可能な量子・古典ハイブリッドワークフローを記述しており、データ前処理、量子回路の実装、モデルトレーニング、独立再現のためのクロスバリデーションを含みます。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
パーキンソン病は進行性の神経変性疾患であり、アクセスしやすく低コストのスクリーニング方法が限られています。持続母音音声記録には、専門的な機器を使わずに取得可能な疾患関連の発声障害に関連する測定可能な音響バイオマーカーが含まれています。このプロトコルは、パラメータ化された量子回路と浅い古典的分類層を組み合わせ、次元削減された音響音声特徴を用いてパーキンソン病を分類する4量子ビット・古典ハイブリッド畳み込みニューラルネットワーク(QI-HCNN)を記述します。また、提案されたアプローチを、縮小特徴セットと全特徴セットの両方で訓練した次元マッチの古典ニューラルネットワークおよび勾配ブースト木分類器と比較してベンチマークしています。31名の個人からなる195件の音声録音からなる公開された非識別データセットを用いて、QI-HCNNは3重層的クロスバリデーションを用いて受信者動作特性曲線下0.78の領域を達成しました。これは、マッチングされた古典的ニューラルネットワークの0.87、縮小機能セットおよび全特徴セットで学習した勾配強化ベースラインの0.94–0.95と比較してのことです。制御されたアブレーション解析により、回路内の2つのエンタングルメント演算のうち1つは設計上測定出力に影響を与えないことが示されましたが、残りのエンタングルメント演算は非エンタングル変種に比べて分類性能を向上させるどころか低下させていました。患者グループによる相互検証では、テストセットに割り当てられた個人によってパフォーマンス推定値が大きく異なることが示されており、限られたコホートサイズを反映しています。したがって、このプロトコルは、完全に指定され独立再現可能な量子古典ベースラインと、現行回路設計の強みと限界のデータに基づく評価を提供し、診断準備の主張を支持するのではなく、将来の研究の方法論的基盤を提供します。
概要
パーキンソン病は、黒質におけるドーパミン作動性ニューロンの進行性喪失によって引き起こされる慢性神経変性疾患であり、世界中で1,000万人以上に影響を及ぼし、公衆衛生上の重大かつ増大する負担となっています。この病気は、振戦、硬直、徐脈などの運動症状だけでなく、睡眠障害や嗅覚喪失などの非運動症状の両方を引き起こします。臨床診断は主に標準化された運動評価尺度を用いた神経学的検査に依存し、利用可能な場合はドーパミントランスポーター画像診断を補完します。しかし、どちらのアプローチも専門的な専門知識とインフラを必要とし、それらが一様に利用可能とは限らず、初期段階の臨床評価は主観的なままです。現在、疾患修飾療法が利用可能でないため、早期発見は主に早期の症状管理と縦断的モニタリングを可能にするため価値があります。このニーズは、臨床評価を補完する、むしろ代替するのではなく、低コストで拡張性が高く非侵襲的なスクリーニングアプローチの開発を促しています。
発声障害はパーキンソン病に関連する最も初期の測定可能な変化の一つであり、しばしば顕在性運動症状に先行します。3.持続的な発音は制御された信号を提供し、ジッター、シマー、調和対雑音比、再帰周期密度エントロピー、デトレンド変動解析などの音響的特徴を抽出できます。これらの機能は繰り返し診断に関連する情報を含んでいることが示されており、消費者向け録音機器4,5で取得可能です。このような記録から導き出された公開されているベンチマークデータセットは、このタスクの標準的なテストベッドとなっており、サポートベクターマシン、ランダムフォレスト、勾配ブースト木など、全特徴セットに古典的な機械学習手法を適用すると、受信機の動作特性曲線下面積値が0.99 6,7,8に近づくと報告されています、分類タスクは、全特徴セットとクラス不均衡の処理に適切な戦略を用いることでほぼ解決に近いことを示唆しています。量子機械学習は、生物医学分類タスクにおける代替的な計算パラダイムとして登場しました。ここでは、パラメータ化された量子回路が重ね合わせやエンタングルメントを用いて比較的少ない訓練可能なパラメータで特徴相互作用を表現し、回路勾配は有限差分近似ではなくパラメータシフトのルールを用いて解析的に計算できます。9.しかし、生物医学応用向けの「量子」または「量子着想」ニューラルネットワークを記述する多くの研究は、シミュレーターや量子ハードウェア上でパラメータ化された量子回路を実行することなく、量子に触発された数学的形式を採用した完全に古典的なアーキテクチャを実装しています。パーキンソン病検出の最近の進展には、ハイブリッド畳み込みニューラルネットワークトランスフォーマーアーキテクチャ11、磁気共鳴画像法(MRI)12の注意ベースのディープラーニング手法、計算効率の高い診断を目的とした軽量畳み込みニューラルネットワーク13も含まれており、人工知能アプローチが複数のデータモダリティに急速に拡大していることを示しています。より広くは、非侵襲的なコンピュータ支援診断は、医療画像のためのハイブリッド機械学習や深層学習パイプラインなど、他の生体医学応用にも成功裏に拡張されています。同じパブリックボイスデータセット上でのディープラーニングアーキテクチャの比較評価は、従来のフルフィーチャークラシックモデルを用いて達成可能な強力な性能をさらに示しています15。
これらの進展は、(i) 真の完全にパラメータ化された量子回路を実行する、(ii)同一の入力特徴を用いて、アーキテクチャ的にマッチした古典的ニューラルネットワークと強力な古典的ベースラインの両方に対してベンチマークされる。(iii)は、小規模な生物医学データセットにおけるバイアスの主な原因、例えばクラスの不均衡、人口統計学的交絡、クロスバリデーション中の患者レベルのデータ漏洩などを明示的に検証するプロトコルを用いて評価されます。
このプロトコルの全体的な目標は、人間の音声録音を用いたパーキンソン病分類のための完全再現可能なQI-HCNNワークフローを提供することです。このプロトコルは、角度符号化を用いた4量子ビットパラメータ化された量子回路、2つの制御非依存層、そしてパラメータシフトルールで最適化された訓練可能な変分層を記述し、浅い古典的分類ヘッドと組み合わせて、公開されている音声録音データセットの4成分主成分表現に適用します。ワークフローは、独立した再現に十分なレベルで、すべての前処理手順、完全な回路構築、古典的なトレーニング構成、評価手順を規定しており、次元マッチングされた古典ニューラルネットワーク、次元マッチングおよび全特徴勾配ブーストツリーベースラインとの比較、制御された回路成分アブレーション、患者グループによるクロスバリデーションによる保留参加者への感度評価、明示的統計的比較が含まれます有意性検定。単に好ましい結果を示すのではなく、プロトコルは個々の回路部品が測定可能な性能向上を示さない場合を透明に報告し、小規模コホートの生物医学分類タスクにおける将来のQI-HCNNアーキテクチャ開発に役立つ再現可能な方法論的枠組みを提供します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
このプロトコルは、公開されている非識別化された第三者の音声録音データセットを使用しています。著者らは新たなヒト-被験者データを収集せず、本研究に対して追加の機関審査委員会(IRB)承認も必要ありませんでした。 「データセット取得および参加者レベルデータ処理 」のセクションで説明されているデータセットは、もともとLittleらによる倫理的承認のもとで収集されたもので、参加者を直接特定する情報は含まれず(匿名化された記録識別子のみ)、研究利用のために公開されています。この公開データセットの二次分析が倫理審査を必要とするかどうかを、あなたの機関方針に従って確認してください。著者の所在機関では、この完全に非識別化され公開アーカイブされたデータセットの後ろ向き二次分析は、IRBの完全な審査対象外と判断されました。
データセット取得と参加者レベルのデータ処理
Littleらによって最初に記述されたパーキンソン病分類データセット(UCI機械学習リポジトリ、データセットID 174)がダウンロードされました。データセットには、31名(パーキンソン病と診断された23名、健康な対照群8名、年齢範囲46〜85歳)からの持続母音/a/発声記録が195件含まれていました。リポジトリはバージョン指定DOIを提供しないため、正確なダウンロード日は資料表に記録・報告されています。データセットはカンマ区切り値(CSV)ファイル(parkinsons.csv)として提供されました。復式化やファイル変換は不要で、ファイルはPandasライブラリのread_csv関数を使って直接インポートされました(材料表参照)。
ダウンロードされたデータセットは、195行24列で構成されており、1つの記録識別子列(フォーマット: phon_R01_S  subject
 _ recording)、22の連続音響特徴列(表1)、および1つのバイナリクラスラベル列(ステータス:1=パーキンソン病;0=健康対照群)で構成されていました。 表1は プロトコル全体ですべての音響的特徴および特徴カテゴリの参照として使用されました。
| カテゴリー | 代表的な特徴 | 臨床的意義 |
| 基本周波数 | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | 発声の平均、最大、最小基本周波数;声帯振動の安定性を反映しています。 |
| ジッター(周波数摂動) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | ピッチ周期の周期ごとの変動は、喉頭運動制御の障害を反映しています。 |
| シマー(振幅摂動) | MDVP:シマー、MDVP:シマー(dB)、シマー:APQ3、シマー:APQ5、MDVP:APQ、シマー:DDA | 信号振幅のサイクルごとの変動、呼吸や不安定な発声の反映。 |
| 騒音対策 | NHR、HNR | ノイズと音声信号の倍音(トーン)成分の比率。 |
| 非線形動力学 / フラクタルスケーリング | RPDE、D2、DFA、spread1、spread2、PPE | 声帯振動に関連する非線形の声帯ダイナミクス、周期性、長距離時間相関の測定。 |
表1:パーキンソン病分類に用いられる音響特徴のカテゴリー。 パーキンソン病分類データセットから抽出された22の音響音声特徴は、基本周波数、ジッター、シマー、ノイズ測定、非線形ダイナミクスの5つの特徴カテゴリーに分類されています。各カテゴリーの代表的な特徴とそれに対応する臨床的意義が記載されています。MDVP(多次元音声プログラム);RAP(相対平均摂動);PPQ(ピッチ周期摂動商);APQ、振幅摂動商;DDP(周期差の差);DDA(振幅の平均絶対差);NHR(騒音対倍音比);HNR(高調波対雑音比);RPDE(再帰周期密度エントロピー);D2、相関次元;DFA(トレンドが減った変動解析)、PPE、ピッチ周期のエントロピー。
各録音に対して、録音名の最後のアンダースコアの前の部分文字列を解析して参加者識別子を抽出しました。例えば、 phon_R01_S01_1 と phon_R01_S01_2 は参加者S01に割り当てられました。その後、参加者識別子は記録識別子ではなく、 評価プロトコル 小節で記述されたすべてのグループ化または一人除外検証手順に使用されました。これは、同じ参加者から取得された録音が音響的に相関しているためです。抽出後、識別子の頻度表が作成され検査され、195の録音すべてが正確に31人のユニークな参加者に割り当てられ、未割り当ての記録が残っていないこと、参加者一人あたりの録音数が元のデータセット文書と一致していることを確認しました。
クラス分布は記録レベル(パーキンソン病記録147件、75.4%;健康対照記録48件、24.6%)および参加者レベル(31名中23名、74.2%、パーキンソン病と診断)の両方で集計されました。両分布は、記録レベルと参加者レベルのクラス不均衡が同一ではなく、後流評価に影響を与えるため報告されました。
元のデータセットに年齢または性別に適合したパーキンソン病および健康対照群が存在しないことは、研究上の制約として記録され、この特徴は元のデータ収集を反映しており、後続の前処理では修正できないため議論に引き継がれました。
前処理パイプライン
すべての前処理手順は、 評価プロトコル 小節で説明されたクロス検証手順の各トレーニングフォールド内で独立して実施されました。最小–最大正規化ステップと主成分解析(PCA)は、各フォールドのトレーニング分割のみを用いてフィッティングされました。フィッティングされた変換は、情報がテストパーティションから前処理パラメータに漏れるのを防ぐため、再フィットせずに対応するホールドアウトテストパーティションに適用されました。
各トレーニングパーティション内の22の生音響特徴は、出力範囲[0, π]の最小最大スケーラーで正規化されました。フィッティングスケーラーは対応するフォールドのトレーニングおよびテスト分割の両方に適用されました(式1)。 式1 は標準的な最小–最大正規化の定式化に従い、本プロトコルで定義されました。最小最大正規化は、scikit-learn(バージョン1.8.0)のMinMaxScalerクラスを用いてfeature_range=(0, π)、copy=True、clip=Falseで実行されました。
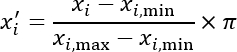 (1)
n_components = 4のPCAモデルは正規化された訓練データのみを用いてフィッティングされました。フィットPCA変換は訓練区とテスト区の両方に適用されました。保持された4つの主成分によって説明される総分散の割合が各折り目ごとに記録されました。ここで報告された分析全体では、4つの保持主成分が総分散の81.5%(それぞれ50.3%、16.3%、9.4%、5.5%)を説明しました。PCAは n_components=4、 svd_solver=「full」、 whiten=False、 random_state=42でPCAクラスを用いて実行されました。
PCAは負の成分スコアを生成する可能性があるため、出力範囲[0, π]の2つ目の最小–最大スケーラーをPCA変換訓練分割を用いて適用しました。この適合したスケーラーはその後、訓練区画と試験区画の両方に適用されました。区間[0, π]の外に位置する変換済みテスト分割値は、スケーラーがトレーニングパーティションのみを用いてフィッティングされていたため、最も近い境界にクリップされました。データセットにはゼロ分散の特徴は存在しませんでした。全195曲の録音におけるすべてのフィーチャーの幅は厳密にポジティブであり、したがって、ゼロによる割り算の条件は生じませんでした。これは、スケールされた出力にNaNも無限値も含まれていないことを確認することで確認されました。
4つの再正規化主成分は、 量子回路構成 小節で説明された角度符号化手順において、量子ビット0、1、2、3の回転角として順次割り当てられました。最初の主成分は量子ビット0、2番目はキュービット1、3番目はキュービット2、4番目はキュービット3に割り当てられました。これにより前処理パイプラインが完了し、処理された古典的特徴量が量子回路に転送されました。2回目の最小–最大スケーリングステップの後、すべての出力値が[0, π]の区間内に収まることが確認されました。浮動小数点の丸めによりわずかにこの範囲から外れたテスト分割値は、NumPy(バージョン2.4.4)のクリップ関数を使って最も近い境界にクリップされました。この手順により、角度符号層への4つの入力すべてが区間[0, π]内で有効な回転角度であることが保証されました。
量子回路の構築
4量子ビット回路は、 材料表 に記載された状態ベクトルシミュレータと、以下に説明するゲート列を用いて構築されました。 補足コーディングファイル1 は、ゲート構築およびパラメータシフト勾配計算のためのすべての補助関数を含む完全な実行可能回路実装として使用されました。 図1 は、音声録音の前処理から4つの回路層、古典的な後処理ヘッド、最終分類までの完全なワークフローを示しています。
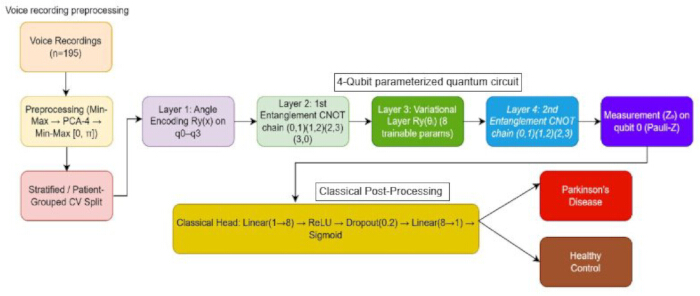
図1。システムアーキテクチャと量子回路のワークフロー。 人間の音声録音からパーキンソン病分類のワークフロー。図は音声録音の前処理、階層化または患者グループ化されたクロスバリデーション、4量子ビットパラメータ化された量子回路の実行、量子ビット0に対する単一量子ビットのパウリ-Z測定、古典的な後処理、そして最終的な二値分類をパーキンソン病または健康対照群として示しています。CNOT(制御非ゲート);PCA(主成分分析)、ReLU、整流リニアユニット。 この図の拡大版はこちらをクリックしてご覧ください。
計算基底状態∣0000で4量子ビットレジスタが初期化されました。
角度符号化層では、前処理パイプラインで生成された4つの角度を用いて、量子ビットiにRy(xi)回転ゲート(i = 0,1,2,3)を適用しました(式2)。式2は、Mitaraiら9のパラメータ化量子回路学習フレームワークと整合するパラメータ化量子回路で用いられる標準的な角度符号化手順を記述し、本プロトコルで定義された特定の4量子ビット構成に適用されました。
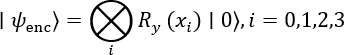 (2)
最初のエンタングルメント層では、制御対象ゲートの円環連鎖が(0,1)、(1,2)、(2,3)、(3,0)の制御-ターゲットの順序で適用されました。
変分層では、8つの訓練可能なパラメータw0からw7までが、平均0、標準偏差0.3の正規分布からの独立サンプリングによって初期化されました。ランダムに選ばれた種は材料表に記録されました。8つの変分量子パラメータはnumpy.random.default_rng(42 + fold_index).normal(0, 0.3, size = 8)を用いて初期化され、fold_indexはゼロベースの折りたたみ数であり、これにより折りたたみごとに特定されながら再現可能な初期化を提供します。各キュービット i = 0,1,2,3 に対して、Rz(wi) ゲートが適用され、その後に Ry(wi+4) ゲート(式3)が適用されました。式3は、Mitaraiらが導入した一般的なパラメータ化された量子回路学習フレームワークと整合する変分(訓練可能な)量子層を記述し、ここでは本プロトコルで定義された特定のゲートシーケンスとパラメータ化を用いて実装されました。
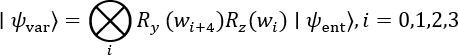 (3)
第2エンタングルメント層では、制御-ターゲットの順序で制御-非ゲートの開鎖が適用されました:(0,1)、(1,2)、および(2,3)。この連鎖は量子ビット0まで閉じられていません。
量子ビット0のパウリ演算子の期待値は  のみ、状態ベクトル内積を用いて計算されました。回路の実行は標準的な数値配列演算(補足符号化ファイル1;qhcnn.py)を用いて実装されたカスタム状態ベクトルシミュレータを使用していました。Complex128の精度(numpy.complex128)が全て使用されました。期待値は状態ベクトルの内積から解析的に計算されました。したがって、ショットベースのサンプリングは行われませんでした。サードパーティの量子コンピューティングフレームワークは必要ありませんでした。もし状態ベクトルシミュレータの代わりにサンプリングベースのシミュレータや量子装置が用いられていたら、キュービット0の計算ベース測定が繰り返し行われ、その結果得られたビット周波数が期待値に変換されていたはずです(式4)。 式4 は標準的な量子力学的期待値の式であり、本プロトコルで定義された単一量子ビットのパウリ観測値に適用されました。ショットベースのサンプリングが行われなかったため、測定誤差の軽減は不要でした。シミュレーターはビッグエンディアン量子ビットのインデックスングを採用しており、キュービット0は状態ベクトルインデックスの最上位ビットに対応していました。この慣習は、正しい期待値が測定されるパウリ観測量の構築時に明示的に考慮されていました。
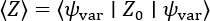 (4)
8つの変分パラメータそれぞれに対する 勾配はパラメータシフト則を用いて計算されました。回路は各勾配計算で各パラメータを2回評価し、1回はθ + π/2、もう1回はθ - π/2で評価されました(式5)。 式5 はMitaraiらが導入した標準的なパラメータシフト規則であり、ここでは 修正なしで適用されています。
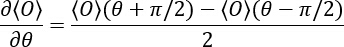 (5)
前述の第2エンタングルメント層は、対象を量子ビット0の制御NOTゲートを適用しませんでした。制御NOTゲートは制御量子ビットの縮小状態を保持するため、第二のエンタングルメント層は訓練可能なパラメータ値に関わらずを変更することはできません。修正プロトコルで第2のエンタングルメント層が測定出力に影響を与えるためには、例えば追加の(3,0)制御NOTゲートでチェーンを閉じることで量子ビット0をターゲットとして含める必要がある。あるいは、単一の量子ビット期待値ではなくマルチキュービットの観測値を測定する必要がある。当初指定された第二のエンタングルメント層はこのプロトコルに保持され、その測定された寄与は結果セクションで明示的に報告されました。なぜなら、この回路挙動は本研究結果の一部であるため、黙って修正されなかったからです。
古典的後処理層
古典的な後処理段階は、 材料表に記載された標準的な配列ベースの数値演算を用いて実装されたフィードフォワードニューラルネットワークで構成されていました。単一のスカラー回路出力  は、完全接続層を用いて8つの隠れユニットにマッピングされ、その後整流線形ユニット(ReLU)で起動されました。トレーニング中、保持確率0.8(ドロップアウト率=0.2)のドロップアウト層が適用されました。8つの隠れた単位は、2つ目の完全連結層を用いて単一の出力単位にマッピングされ、シグモイド活性化関数を適用して最終クラス確率ŷ(式6)を生成しました。 式6 は、現在のプロトコルで使用されている特定の古典的後処理アーキテクチャを定義し、標準的な線形、整流線形ユニット(ReLU)、およびシグモイド演算を含みます。
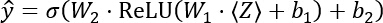 (6)
第一層および第二層の重み行列は、平均0、標準偏差0.5の正規分布から独立サンプリングして初期化され、一方でバイアス項はすべて0に初期化されました。量子変分パラメータの初期化に用いられた同じ乱数生成器インスタンスとシードは、古典層にも用いられ、実行間での再現性を確保しました。具体的には、古典的な重み行列はnumpy.random.default_rng(42 + fold_index).normal(0, 0.5, size=...)で初期化され、すべてのバイアス項はゼロに初期化されました。各クロス検証フォールドの開始時に42 + fold_indexで初期化された単一のシードされた乱数生成器インスタンスが作成され、各プロセスごとに独立したシードストリームを使うのではなく、量子パラメータ初期化、古典的重み初期化、ミニバッチシャッフル、ドロップアウトマスク生成に順次再利用されました。
訓練中、ドロップアウトは、各フォワードパスで新たにサンプリングされたバイナリマスクを生成する逆ドロップアウト慣習を用いて適用され、生存ユニットは1/0.8ずつスケールされました。検証およびテスト中、ドロップアウトは完全に無効化され、推論には全ての非スケールネットワークが使用されました。
結合されたQI-HCNNモデルには33の訓練可能なパラメータが含まれており、8つの量子変動パラメータは量子回路からのもの、25の古典パラメータが含まれていました。古典成分は、第1完全連結層に8つの重みと8つのバイアス、さらに第2の完全連結層に8つの重みと1つのバイアスで構成されていました。重みとバイアステンソルの次元は 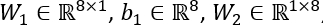 と
 でした。古典的な後処理層は、追加の機械学習フレームワークを用いず、標準的な数値配列演算のみで実装されました。すべての古典的な計算はfloat64(倍精度)演算で行われました。
モデルトレーニング
量子回路構成のサブセクションで説明された量子回路と、古典的ポストプロセッシング層のサブセクションで説明された古典的な後処理層は、単一のエンドツーエンドの訓練可能なモデルに統合されました。33の訓練可能なパラメータすべてが、初期学習率0.01と重み減衰を用いてAdam最適化器を用いて最適化され、古典的な重み行列にのみ適用されたL2ペナルティとして実装されました。アダム最適化器は標準的な数値配列演算を用いて手動で実装され、以下の設定が適用されました:学習率=0.01、β1=0.9、β2=0.999、∈=1×10⁻⁸、重み減衰=1×10⁻⁴。これらは古典的な重み行列にのみ適用され、バイアス項や量子変分パラメータには適用されません。
損失関数として二値クロスエントロピーが用いられました。評価プロトコルの小節で説明されている分割後のクラスバランス手順では、各トレーニングサンプルの損失寄与は、現在のフォールドのトレーニング分割内でクラスの逆周波数によって重み付けされました。不均衡プロトコルでは、均一なサンプル重みが割り当てられました。バイナリクロスエントロピーは、標準的なバイナリクロスエントロピーの定式化を用いて、各ミニバッチ内のすべてのサンプルの平均損失として計算されました。
モデルは16サンプルのミニバッチを用いて30エポックにわたり訓練されました。トレーニングサンプルは各エポック開始時にランダムにシャッフルされ、numpy.random.default_rng(42 + fold_index).permutation(n)を用いてランダムにシャッフルされ、ランダムなサンプル順序が生成されました。トレーニングサンプル数が16で均等に割れない場合、最終的な小さなミニバッチは実際のサイズで保存・処理され、廃棄されませんでした。
研修中に段階的な学習率スケジュールが適用されました。学習率は10回完了するごとに0.7倍に増やされ、特に11期と21期の開始時に適用されました。
8つの量子変分パラメータの勾配は 、量子回路構成 小節で説明されたパラメータシフト規則を用いて計算されました。25の古典パラメータの勾配は、古典層のみを通じた標準的な逆モード微分を用いて計算されました。量子回路の出力 とそのパラメータシフト勾配は、量子回路と古典層の間のインターフェースとして機能しました。33のパラメータすべてが同じAdamオプティマイザーインスタンスで更新されました。
検証に基づく早期停止は使用されませんでした。各モデルは固定された30エポックスケジュールで訓練され、最終エポック終了後にテスト分割の性能が報告されました。すべてのモデルパラメータ(量子変分パラメータ、古典的重み行列、バイアス項)は、各クロス検証フォールドの開始時にフォールド特有のランダムシード(42 + fold_index)を用いて独立して再初期化されました。パラメータはフォールドやベースラインのラン間で共有されませんでした。
計算環境は、プロセッサ、メモリ、ソフトウェアバージョン、折り目ごとのおおよそのウォールクロックトレーニング時間などが材料 表に記録されました。
評価プロトコル
モデル性能は、記録レベルおよび参加者レベルのクロスバリデーション手順、さらにベースラインモデル比較、クラスバランス分析、回路アブレーション実験、統計的有意性検定、特徴重要度分析を用いて評価されました。
一次評価では、195件の音声録音を固定されたランダムシードを用いて3つの層別折りに分割し、各折り目内で録音レベルのパーキンソン病/健康対照比率75.4%/24.6%を保持しました。前節で説明したモデルは2つの折り返しを用いて訓練され、残された折り返しで評価され、この手順を繰り返され、各折りがテスト分割として1回機能するまで繰り返しました。各折り目ごとに、正確さ、正確さ、リコール率、F1スコア、受講者操作特性曲線下面積(AUC–ROC)が計算され、3つの折り目±平均標準偏差として報告されました。主要な三重層的クロス検証は、StratifiedKFold クラスを用いて実装され、 n_splits=3、 shuffle=True、 random_state=42 でした。
二値クラス予測は、古典的な後処理層によって生成された予測クラス確率ŷに0.50の固定確率閾値を適用して生成されました。これらの閾値予測から正確さ、精度、リコール率、F1スコアが計算され、AUC–ROCは閾値なしの連続確率値から直接計算されました。精度、リコール率、F1スコアは zero_division=0の計量関数で計算され、未定義の計測指標には0.0の価値が割り当てられました。報告された実験ではそのような不明な状態は発生しませんでした。
ベースラインモデルは、同じフォールドパーティションと、前処理パイプラインによって生成された同一の4成分前処理特徴表現を用いて評価されました。8つのReLU活性化ユニットからなる1つの隠れ層を含む古典的多層感知器は、ハイブリッドモデルの古典成分にアーキテクチャ的に適合しているが量子回路は含まれず、Adam最適化器で学習され、L2ペナルティは1 × 10⁻⁻4でした。勾配強化された木分類器も同じ4成分表現で訓練され、200の木、最大木深3、学習率0.1、各訓練フォルダル内の逆クラス周波数に等しいクラス重みが付けられました。さらに、2つ目の勾配強化木分類器は、初期の最小–最大正規化後に生成された完全な22特徴表現を用いて訓練され、PCAや量子特徴符号化を適用しませんでした。このモデルは300の木構造、最大木深4、学習率0.05、同じ逆トレーニングフォールドクラス重み付け戦略を用いていました。古典的な多層パーセプトロンのベースラインは、MLPClassifierを用いて実装されました。hidden_layer_sizes=(8,), activation="relu"、ソルバー="adam"、alpha=1 × 10⁻4、batch_size="auto"、learning_rate_init=0.001、max_iter=500、early_stopping=False、shuffle=True、random_state=42。実装で提供されたデフォルトのGlorot(Xavier)一様重み初期化が使用されました。勾配ブーストされた木ベースラインはXGBoost 3.3.0を用いて実装され、目的値=「binary:logistic」、eval_metric = 「logloss」、tree_method = 「auto」、サブサンプル=1.0、colsample_bytree = 1.0、reg_alpha = 0、reg_lambda = 1、random_state = 42で実装されました。
分割後のクラスバランシング効果を評価するため、QI-HCNNモデルに対してサンプル重み付けを有効にした状態で一次クロスバリデーション手順を繰り返しました。バランス重みは、トレイン/テスト分割後の各フォールドのトレーニング分割からのみ計算され、対応するホールドアウトテスト分割からは計算されませんでした。
回路成分アブレーション実験は、量子回路の2つのエンタングルメント層のみを修正しつつ、前処理、訓練、評価のワークフローを4回繰り返し行うことで実施されました。4つの回路バリエーションは以下の通りです:(i) 両方のエンタングルメント層を含む完全な回路;(ii)最初のエンタングルメント層が除去され、2つ目が保持された回路;(iii) 最初のエンタングルメント層を保持し、2番目の層を除去した回路;および(iv)両方のエンタングルメント層が除去された回路。4つの実験すべてで同一のフォールド分割、ランダムシード、訓練構成を維持し、観察された性能差は絡み合い層構成のみに起因すると考えられました。
堅牢性評価として、参加者グループによるクロスバリデーションは、195の記録ではなく31人の参加者を6〜7人の5グループに分割することで実施されました。各反復では、モデルは4つのグループの参加者の録音を用いて訓練され、残りのグループの参加者の録音を使って評価され、同じフォールドのトレーニングおよびテストパーティションの両方に記録を寄与しないことが確認されました。QI-HCNNモデル、古典的多層パーセプトロン、4つの特徴勾配ブーストベースラインにおいて、5つの参加者グループ化された折りたたみの平均±標準偏差として、正確さ、正確さ、想起率、F1スコア、AUC–ROCが報告されました。参加者グループ化のクロスバリデーションは、n_splits GroupKFold クラスを用いて実装され、参加者識別子がグループ化変数として機能しました。GroupKFoldはグループをシャッフルしないため、参加者は実装のデフォルトの決定論的順序に従って割り当てられ、その結果、6人または7人のフォールドがそれぞれに含まれていました。
統計的有意性は、一次評価モデルおよびベースラインモデルで得られた1フォールドAUC–ROC値にウィルコクソン符号付きランク検定を組み合わせて適用することで評価されました。正確なp値と対応するペア観測値が報告されました。なぜなら、この検定の統計的検出力は限られ、利用可能なフォールドが限られているためです。4つのペアワイズAUC–ROC比較が事前に定義されました:(1) QI-HCNNと古典的多層感知器;(2) QI-HCNNとPCAマッチング勾配ブースト樹ベースラインの比較;(3) 古典的な多層パーセプトロンとPCAマッチング勾配ブーストツリーベースラインの比較;(4)不均衡なQI-HCNNモデルと分割後の均衡QI-HCNNモデルの比較。分析が探索的であり、限られた折り目数が統計的検密度を著しく低下させたため、多重比較補正は適用されませんでした。
特徴重要度分析は、22の特徴表現を完全に学習した勾配強化木分類器を用いて実施されました。ゲインに基づく特徴重要度スコアを抽出し、すべての元の音響特徴についてランク付けしました。別に、PCAは報告目的のみでデータセット全体に適合させ、モデル評価時には使用されませんでした。各元の音響特徴に対して、4つの保持された主成分の絶対負荷を合計し、これらの値に基づいて特徴をランク付けしました。両方のランキング方法とそれらの重複が報告されました。ゲインベースの特徴重要度解析では、勾配ブーストされた木の実装で一意の浮動小数点ゲイン値が得られ、同点は発生しませんでした。主成分負荷ランキングでは、合計された絶対負荷値の同点がデータセット内の元の特徴列順序に従って解決されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
本文で報告されたすべての数値は、 図2–8 および 表2–4に示されたものと照合され、同一です。すべての図形は、手作業で作成されるのではなく 、補助コーディングファイル1 に提供されたコードから直接生成され、報告された数値とプロットデータの整合性を確保しました。
一次クロスバリデーションの性能
不均衡トレーニングプロトコルの下で、QI-HCNNモデルは3つの層別交差検証折り返しで、受講者操作特性曲線(AUC–ROC)下の領域は0.782±±0.029、精度は0.7740.029、リコールは0.966±0.048、F1スコアは0.858±0.003、3つの層別交差検証折りたたみで受信者操作特性曲線下面積は0.782±0.022でした(表2)。図2は対応するパーフォールド結果を示していま...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
このプロトコルは、音声録音からパーキンソン病分類を用い、すべてのゲート、パラメータ初期化の選択、前処理ステップ、評価手順が独立した実装に十分なレベルで記述される、完全に再現可能なQI-HCNNアーキテクチャを規定しています。提案された回路は、同一の入力特徴量と同一のクロスバリデーションフォールドパーティションを用いて、アーキテクチャ的にマッチした古典的多層知覚器および勾配強化された木ベースラインと比較してベンチマークされています。このベンチマーキング設計は、制御回路成分アブレーション、患者グループによる堅牢性評価、明示的な統計的有意性検定の導入とともに、量子ラベルアーキテクチャが常に同等の資源を持つ古典的代替案と比較して評価されたり、小規模な生物医学コホートに関連する特定の故障モードを検証されたりしないこのサブフィールドにおける方法論的実践の進展を目的としています10.プロトコルの重要なステップには、情報漏洩を防ぐためのフォールドバイズ前処理、同一個人からの繰り返し記録によるバイアスを最小限に抑える参加者レベルの検証、そし...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
利益相反:
著者らは、この研究に関して競合する財務的または非財務的利害関係はないと宣言しています。
謝辞
この作業は技術的にも財政的にもいかなる機関や組織から資金提供を受けていません。著者らは、本研究で使用された音声録音データセットへの一般公開を提供してくれたUCI機械学習リポジトリの管理者に感謝の意を表します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Adam optimizer | 標準的な数値最適化の実装 | カスタム実装; NumPy 2.4.4 | 量子と古典的なパラメータの最適化; モデルトレーニング |
| バイナリクロスエントロピー損失の実装 | NumPyを使用したカスタム実装 | NumPy 2.4.4; 各ミニバッチで平均(平均減少)をとった損失 | トレーニング損失関数; モデルトレーニング |
| 勾配ブーストツリー分類器 | XGBoostオープンソースのグラディエントブースティングライブラリ | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | PCAマッチおよび全特徴量の古典的ベースライン; 評価プロトコル |
| 機械学習ライブラリ | scikit-learnオープンソース機械学習ライブラリ | scikit-learn 1.8.0 | Min–Max スケーリング、主成分分析、層化交差検証、参加者グループ化された交差検証、多層パーセプトロンベースライン、評価指標 |
| 数値計算ライブラリ | NumPyオープンソース数値計算ライブラリ | NumPy 2.4.4 | コア配列操作、ステートベクターシミュレーション、パラメータ初期化、手動勾配計算 |
| パーキンソン病分類データセット | Little、McSharry、Roberts、Costello、Moroz; UCI機械学習リポジトリを通じて配布 | UCIデータセットID 174; 参加者31人から195件の録音; 2025年6月19日アクセス | 持続的母音音声録音データセットのソース; https://archive.ics.uci.edu/dataset/174 |
| 科学計算ライブラリ | SciPyオープンソース科学計算ライブラリ | SciPy 1.17.1 | ウィルコクソン符号付き順位検定; 評価プロトコル |
| ステートベクターシミュレータ | カスタムステートベクターシミュレータ(サプリメンタリーコーディングファイル1; qhcnn.py) | 純粋なNumPy実装; complex128(二重)精度; 外部バックエンド不要 | 4量子ビットの量子回路の実行; 量子回路構築 |
| 表形式データライブラリ | Pandasオープンソースデータ分析ライブラリ | Pandas 3.0.2 | データセットの読み込み、検査、表形式操作 |
| ワークステーション計算環境 | ローカルCPUワークステーション(クラウドホストLinuxコンテナ) | x86_64 CPU; Ubuntu Linux; Python 3; GPUまたは量子ハードウェアは使用せず; 1フォールドあたりの壁時計時間は約30~60秒 | すべてのトレーニングおよび評価に使用される計算環境; CPUベースのステートベクターシミュレーション; GPUまたは量子ハードウェアは不要 |
参考文献
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。