本論文では、TransformerとPPO強化学習を統合した動的スケジューリング最適化アルゴリズムについて研究し、労働組合活動のスケジューリングにおける頻繁なリソース競合と応答遅延に焦点を当てています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
労働組合活動の管理において、頻繁に発生するリソース割り当ての競合やスケジューリング応答の遅延による組織効率の低下という課題を解決するため、本論文ではTransformerとPPO(Proximal Policy Optimization)を統合した動的スケジューリングアルゴリズムを提案する。具体的な実装では、まず統一的なスケジューリングシナリオモデリング構造を設計し、活動、人員、およびリソースの状態をテンソル入力に変換することで、多次元的な制約の統合を実現した。次に、Transformerのマルチヘッドアテンションメカニズムを用いて、過去の活動リクエストとリソース状態の時系列データをエンコードし、多次元的な時空間特徴を抽出することで、競合リスクに対する知覚能力を高めた。続いて、エンコード結果とPPO戦略ネットワークに基づき、現在の状態からスケジューリングアクションを生成し、複雑な環境に対する戦略の適応性を向上させた。最後に、プルーニング更新とアドバンテージ関数補正メカニズムを通じて、反復過程における戦略の安定性とスケジューリング性能の向上を保証した。実験の結果、タスク密度が1000の場合、スケジューリングアルゴリズムの平均決定時間は0.72s、平均応答遅延は1.59sとなり、高い応答速度と意思決定効率が示された。7つの活動タイプと複雑さのレベルにおいて、リソース競合率は0.05–0.12、平均リソース利用率は0.75–0.86、スケジューリング安定性指標は0.8–0.91であり、頻繁なリソース割り当て競合を効果的に削減し、高いスケジューリング安定性を達成した。高コンカレンシー条件下では、リソースバランス指標と戦略転移堅牢性指標がそれぞれ0.88および0.85となり、タスクの並行負荷に対する良好な適応性が示された。
概要
組合活動では、複数のタスクとリソースの複雑なスケジューリングが行われるため、システムに効率的な動的応答能力が求められます1,2。活動要件は頻繁に変更され、人員や会場リソースの配置も複雑であるため、スケジューリングの競合やリソースの浪費が起こりやすくなります3,4。活動履歴とリアルタイムのリソース状況を正確に把握し、潜在的な競合を特定して対応する能力を向上させることが、組織の運営効率を高める鍵となります5,6。高度な時系列モデリング技術と強化学習アルゴリズムを統合することで、複雑なスケジューリング環境における深い理解と知的な最適化を実現し、リソース利用率の最大化、スケジューリング応答の加速、および組合活動管理のインテリジェントなアップグレードを促進することが可能です。
しかしながら、実務における既存のスケジューリング手法は大部分がルールベースかつ静的であり、頻繁なタスクの変更やリソースの変動に適応できず、その結果、レスポンスタイムの長期化や深刻なリソース競合を招くことが多い。労働組合活動のスケジューリングにおいて、タスクの種類は非常に多岐にわたり、リソースの使用は厳しく制限され、かつ頻繁に変更される。また、活動間の依存関係とリソース間の競争性は、複雑なスケジューリングマップを構成している7,8。実際には、活動スケジュールを人員や会場などのリソースの利用可能な時間枠に効率的に適合させることができず9,10、しばしば競合が発生し、組織運営全体の整合性が損なわれている11,12。スケジューリングシステムは単一の最適化目標に直面しているのではなく、リソース競合の最小化、レスポンス速度の最大化、スケジューリング戦略の安定性、およびタスク完了率といった多次元的な指標のバランスを調整する必要があり13,14、これは典型的な多目的最適化の特性を示している。加えて、労働組合活動には明確なフェーズとサイクルがあり、スケジューリング戦略は、異なるタスク段階における変動するリソース需要構造に動的に適応しなければならない。一度だけ作成された静的な計画では、高頻度で変更が生じる実行環境をサポートすることはできない15,16。既存のスケジューリングロジックでは、過去のタスク動作やリソース状態の変化パターンの深い探索が不足しており、将来に対する正確な予測や戦略の推論を提供することができない17,18。システムのスケジューリング戦略は、急ぎのタスクや一時的なリソース変更への対応が遅く、運用の全体的な持続可能性に影響を及ぼしている19,20。予測可能性、柔軟性、および安定性を備えたスケジューリングシステムの構築は、実務的なアプリケーションにおける重要な技術的要求となっている。そのためには、モデルが高次元の情報知覚、シーケンスメモリ、および戦略移行能力を持ち、マルチタスク環境において堅牢な意思決定とリソースバランスを維持することで、労働組合活動のスケジューリングにおけるインテリジェントで最適な調整を可能にする必要がある。
動的なスケジューリング問題に対して、これまで数多くの研究でさまざまな解決策が提案されてきました。その中でも、ディープラーニングと強化学習の組み合わせは、高い適応性と最適化能力を示しています。一部の研究者は、LSTM(Long Short-Term Memory)21,22を用いて時系列データをモデル化し、強化学習戦略を組み合わせてスケジューリング動作を最適化することで、一定の結果を得ています。また別の研究では、貪欲法に基づくヒューリスティック手法が用いられており、スケジューリング決定の簡便さと効率性が重視されており、これは明確なルールが存在するシナリオに適しています23,24。さらに、Deep Q-Network(DQN)をスケジューリングに適用し、価値関数の近似を通じて戦略の改善を達成した研究もあります25,26。しかし、これらの手法は、複雑に変化する連合活動シナリオに直面した際、長期的な依存関係の捕捉が不十分であること、戦略の更新が不安定であること、また応答遅延が大きいといった課題があり、高密度で多様なタスクのスケジューリングニーズを充足させることは困難です。したがって、効率的な特徴抽出と安定した戦略更新能力を備えたスケジューリングアルゴリズムをいかに構築するかが、現在の研究において突破すべきボトルネックとなっています。
マルチドメインのスケジューリング研究において、Transformerアーキテクチャは、長距離の時間的依存関係を効果的に捉えるマルチヘッド自己アテンション機構により、さまざまな時系列予測およびスケジューリング最適化タスクに適用されてきた27,28。強化学習におけるPPOアルゴリズムと組み合わせることで、目的関数をトリミングすることにより戦略を安定かつ効率的に更新することができ、このアプローチはロボット制御や知的製造などの分野で優れた性能を示している29,30,31。一部の研究では、複雑なリソーススケジューリングのためにTransformerと強化学習の統合が試みられている32。しかし、組合活動の動的スケジューリングにおいては、多様な活動タイプと複雑なリソース制約の組み合わせに対処した研究は少ない。一部の研究では、グラフニューラルネットワークを利用してリソースとタスクの関係をモデル化し、それによってコンフリクト識別の精度を向上させている33,34。また、エッジコンピューティングに基づいたリソーススケジューリングの最適化により、モデルの効率と性能を向上させた研究もある35,36。しかし、これらの手法は依然として時間的なコンテキストに対するモデリング能力が限定的である。これに基づき、本論文では、Transformerを用いて過去の活動およびリソース状態のシーケンスをエンコードし、それをPPOポリシーネットワークと組み合わせることで、コンフリクトリスクに対する高い認識力と、組合活動の変化し複雑なスケジューリングニーズに対応するための安定したスケジューリング戦略の更新を実現することを提案する。
より最近の研究では、クラウドコンピューティングにおけるエネルギー効率のためのVM統合37、セルラーネットワークにおける認証アルゴリズム38、持続可能なクラウドコンピューティングに向けたライブマイグレーションによるVM統合の強化39、待機予測と進化アルゴリズムを用いたトラフィック最適化40、そして最適化と整合性保持を強化したブロックチェーンベースのクラウドストレージ41など、さまざまな視点からリソーススケジューリングの最適化が検討されています。これらの研究はリソース割り当てや最適化アルゴリズムに貴重な知見を提供していますが、主にクラウドインフラストラクチャ、電気通信、またはストレージシステムを対象としており、労働組合活動の管理に固有の多タイプ活動制約、動的な人員・会場リソースの競合、およびリアルタイムのスケジューリング要件には具体的に対応していません。この相違により、労働組合活動の組織的背景に特化した専用のスケジューリングフレームワークの必要性がさらに強調されます。
労働組合活動における既存のスケジューリング手法は、長期的な時空間依存性を捉えきれず、動的な変化の中でポリシーの安定性を維持できないことが多く、その結果、レスポンス時間の遅延や高いリソース競合を招いています。これらの研究上の課題を解決するため、本研究では、Transformerのマルチヘッドアテンションが競合予測のために履歴シーケンスを効果的にエンコードできること、およびクリップされた目的関数を持つProximal Policy Optimization (PPO) が安定し適応的なポリシー更新を保証するという原理に基づいたスケジューリング最適化モデルを提案します。具体的には、Transformerを適用して活動およびリソース状態のシーケンスをエンコードし、重要な時空間特徴を抽出することで競合の先読み能力を高め、さらにPPOを組み合わせることで効率的なスケジューリングアクションの生成と安定した更新を実現します。また、活動、人員、会場をマッピングするための統合制約行列を設計し、複雑な依存関係の認識精度を向上させました。本研究の主な革新性は以下の通りです。(1) 労働組合活動のスケジューリングに特化した時間エンコーディングと強化学習の統合、(2) リスク認識を優先する競合認識アテンションメカニズム、(3) 高い並行性の下で戦略の堅牢性を確保するためのアドバンテージ関数補正を伴うプルーニング更新。多様なタスク密度および複雑性の下で広範な実験を行った結果、本モデルはレスポンス速度、リソース利用率、および安定性の面で既存の手法よりも優れていることが検証され、労働組合活動管理のための実用的かつ拡張可能なインテリジェント・スケジューリングソリューションを提供します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
図 1 は、時系列モデリングと強化学習を統合した組合活動スケジューリングシステムの構造を示しています。入力層では、活動スケジュール、リソースの可用性、および人員の時間枠情報を統合し、制約グラフモジュールを介して多次元のタスク・リソース競合関係行列を構築します。Transformerは、活動およびリソース状態の履歴シーケンスに対してマルチヘッドアテンションエンコーディングを行い、時間的依存性を伴う隠れ状態を生成します。方策モジュールは、このエンコーディング結果を用いてアクション分布と状態推定を生成し、アクションをサンプリングした後にスケジューリング決定を実行します。実行結果は環境にフィードバックされ、リソース状態が更新され、即時報酬が生成されます。これに基づき、最適化モジュールがクリッピング目的関数を構築し、アドバンテージ関数を評価して価値ネットワークの推定値を修正することで、方策のドリフトを制限し、スケジューリング動作の安定した更新を保証します。これらのモジュール間でクローズドデータループが形成されることで、リソース競合への高感度な認識と動的な環境における適応的な戦略更新が実現され、これによりマルチタスクかつ制約の多いシナリオにおける組合活動スケジューリングシステムのインテリジェントな応答能力とリソース配分効率が向上します。
労働組合活動スケジューリングのシナリオモデリング
スケジューリングシステムにおけるすべての活動リクエストは、タイムステップに基づいた個別のスケジューリングシーケンスに整理される。各活動は、明確な開始時間および終了時間、リソースカテゴリ、ステージ、および優先度レベルによって定義される。サイトの使用状況は二次元のタイムスロット行列としてモデル化され、横軸は標準化された時間単位を、縦軸は空間リソース番号を表す。リソースの状態は「利用可能」および「使用中」としてマークされ、静的構造を持つ初期リソース分布マップを形成する。人員のスケジューリング情報は時間・個体識別次元で拡張され、連続的なタイムウィンドウベクトルを構築する。このベクトルの各要素には、人員のタスク遂行・待機状態および部署番号が記録される。すべての入力情報は三次元テンソル構造に統合される。ここで、は離散タイムステップを、はリソースエンティティの数を、は対応するリソース使用属性コード(使用中の可否、活動番号、使用優先度など)を表す。この構造により、スケジューリングシステムは任意の時点でのリソース構成を読み取ることができ、異なるリソース状態タイプの統一的な表現が可能となる。
タスク情報がモデルにリンクされた後、アクティビティの優先順位とリソースの使用期間に基づいてタスク強度ベクトルが設定されます。競合を引き起こす可能性のあるタスクの組み合わせは、タイムウィンドウ重複検出法を通じてマークされます。競合の組み合わせはノードセットに変換され、共有リソースの種類と期間に基づいてエッジセットが構築され、暗黙的な依存関係が明示的に表現されます。最終的に構築されたタスクグラフには、時間順序、リソースの重複、または制約の競合に関する境界情報が含まれており、後続の競合検出およびスケジューリング戦略生成のための構造的根拠となります。この構造は、タスクスケジューリングの動的な性質とリソース状態の継続的な変化を保持し、スケジューリング制約の変化のリアルタイムな認識をサポートします。
衝突検出では、テンソル構造における時間およびリソース次元の疎な重複領域を判断の初期条件として使用します。これにより、スケジューリング対象が重複するタスクペアに対して静的な関係エンコーディング処理を実装します。そして、グラフ構造 G=(V,E,C)を構築します。ここで、Vはアクティブノードの集合を、Eはリソース衝突に基づいて生成されたエッジを、Cはエッジの衝突重みエンコーディング行列を表します。衝突重み関数は、以下の形式で定義されます:
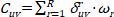 (1)
ここで、Cuvはアクティビティuとvの間のコンフリクト重み、uおよびvはアクティビティのインデックス、Rはリソースタイプの総数、δuvr ∈ {0,1}はリソースrにおいてアクティビティuとvの時間ウィンドウが重複しているか否かを示し、ωrはリソースrのコンフリクト感度重みである。この関数は、コンフリクト強度の分布を定量的に表現しつつ、スケジューリング結果に対するリソースコンフリクトの重要性の違いを考慮し、コンフリクト強度の加重和を算出する。
上記のコンフリクトグラフ構造は、疎行列表現を通じて制約境界行列に変換されます。行列の各項目には、リソースコンフリクトの度合いが含まれています。この行列はスケジューリングの決定プロセスに組み込まれ、タスクを並列にスケジューリングできるかどうかを判断し、アクション遮蔽ロジックはポリシーネットワーク内に配置されます。周期的なアクティビティの集約や高密度のタスクバーストに対処するため、動的更新メカニズムを実装してタスク状態の変化を監視し、リソースの解放または追加に合わせて行列の内容をリアルタイムで修正することで、タスクの進化を通じてスケジューリング境界の連続性と一貫性を確保します。
このコンフリクトグラフ構造を適用することで、スケジューリングシステムは潜在的なリソースのボトルネックやタスクの重複パターンを視覚的にモデル化できるようになり、その結果、複雑な制約シナリオに対する決定ネットワークのデカップリング解析の効率が向上します。スケジューリング動作は、もはやルールベースの論理マッチングに依存しません。その代わりに、制約空間における最適パスを探索し、局所的なリソースコンフリクトとグローバルなタスクマップを動的にバランスさせる能力を高めます。これにより、リソースが変動し、タスクが頻繁に追加または削除される環境においても、システムはスケジューリングの安定性とタスクの一貫性を維持することが可能です。
図2は、タスク競合の重み関係に基づいたネットワーク構造図を示しています。図中の各ノードはスケジューリング対象のタスクを表し、ノード間の線はリソース使用の競合を示しています。エッジの太さは競合の重みを反映しており、競合が深刻であるほど線が太くなります。重みの計算では、リソースの重複を統合し、さまざまなリソースの競合感度を組み合わせて、タスク間の複合的な競合強度を算出しています。グラフ構造から、一部のタスクが密に接続された領域を形成していることが分かり、これはリソース利用における激しい競合があることを示しています。このような局所的な競合凝集現象は、スケジューリングプロセスにおけるリソースボトルネックやタスク遅延の主な原因となり、スケジューリングアルゴリズムはそれに応じて優先順位調整のターゲットを設定できます。ノードの配置には力導向レイアウト戦略を採用して競合度の高いタスクを自動的に集約させており、これによりスケジューリングシステムが重要なタスクグループを特定し、戦略配分を最適化することで、全体的なスケジューリングの一貫性とリソース調整能力を向上させています。
履歴状態シーケンスのエンコード
構築したコンフリクトグラフと制約行列に基づき、次のステップではアクティビティとリソース状態の履歴シーケンスをエンコードし、これらの制約の根底にある時間的パターンを抽出して、その後の意思決定に利用できるようにします。 スケジューリングシナリオにおける核心的な情報は、アクティビティリクエスト、リソースステータスの変更、およびタスクフィードバックレコードで構成されます。これらの情報は、イベント時点、リソース使用識別子、アクティビティ実行ステータスなどの属性に対応する、複数の異種時系列データとなります。処理構造を統一するため、各入力タイプは等長のベクトルシーケンスとしてエンコードされ、時間同期下で状態の整合性を確保するために統一された時間インデックスが設定されます。各時点における入力ユニットは、3組の特徴ベクトルを結合して表現されます。アクティビティ特徴ベクトルはタスクタイプ、優先度、ステージ番号を表し、リソース特徴ベクトルは現在のリソース占有率、残容量、および利用可能なウィンドウ位置を記録し、フィードバック特徴ベクトルは、直前の時点でタスクがスムーズに実行されたか、またリソースコンフリクトや遅延イベントが発生したかについて記述します。
すべての特徴量は線形変換され、同一の次元空間にマッピングされることで、標準化された埋め込み行列 X ∈ ℝT×d が得られます。ここで、T はタイムステップ数を、d は統合された埋め込み次元を表します。時間的構造を保持するため、入力行列に位置エンコーディング行列 P を要素ごとに加算し、位置情報を考慮した入力を作成します。
Z = X + P (2)
Zは最終的な入力シーケンスであり、後続のアテンションメカニズムへの入力として機能します。位置エンコーディングの設計では、将来の情報漏洩を防ぎ、エンコーディング中に因果的な制約が厳格に遵守されるように、固定の正弦および余弦関数のテンプレートを使用しています。以上の構造により、モデルはタスク特性、リソースの状態、および時間的位置を同時に認識することが可能になります。これにより完全な状態メモリの基盤が構築され、後続のアテンションメカニズムに対して高解像度で統一された構造が提供されます。
アテンションモジュールは、入力シーケンスを処理して、複数のタイムステップ間の潜在的な関係性を捉えます。シーケンスを個別に処理するために複数のアテンションヘッドグループが使用され、これにより、異なるタイプの状態遷移パスに対するモデルの感度が向上します。各アテンションヘッドは、入力シーケンスからクエリ行列Q、キー行列K、およびバリュー行列Vを生成し、重み分布行列を算出して、重み付き表現を生成します。シングルヘッドアテンションの出力は以下の通りです:
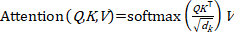 (3)
dk は、ヘッドあたりの特徴量の次元数です。この数式において、 QK⊤ モーメント間の類似性を表し、√dk 数値的安定性を確保するために使用され、ソフトマックス関数によって重みの正規化が行われます。異なるアテンションヘッドはタイムステップの異なる組み合わせに注目し、そこで捉えられる動的な依存関係も多様であるため、タスク競合の前兆、リソース消費パターン、異常なフィードバック傾向などの潜在的なルールの解明に寄与します。
すべてのアテンションヘッドの出力は連結され、線形変換層を通過して統一されたコーディングシーケンスが生成されます。これがスケジューリング戦略生成ネットワークへの状態入力として機能します。このシーケンスには、現在のスケジューリングウィンドウにおけるタスクの動作軌跡、リソースの変化特性、および過去の実行偏差の影響が組み込まれており、スケジューリング動作における高い履歴依存性と特徴表現の疎という問題に効果的に対処しています。また、深層ネットワークの学習安定性と表現保持能力を高めるため、エンコード出力層に残差接続とレイヤー正規化モジュールが組み込まれています。
出力された隠れ状態シーケンスは、時間発展情報を保持するだけでなく、突発的なタスクや一時的なリソースの不一致から生じる変化にも反応し、強力な適応性を実証します。この構造設計により、明示的なルールの定義を回避し、動的なスケジューリング環境の構造化モデリングが可能となり、多目的条件下で大域的な一貫性と局所的な適応性を備えたスケジューリング解を生成する後続のポリシーモジュールをサポートします。
動的スケジューリング戦略の生成
時間的依存関係とリソース競合情報の両方を埋め込んだ符号化済み隠れ状態シーケンスをポリシーネットワークに入力し、現在の環境に適応したスケジューリングアクションを生成します。 エンコーディングモジュールから出力された隠れ状態シーケンスは、スケジューリング戦略ネットワークへの入力として使用されます。各時点における状態ベクトルセットは、タスク特性の推移、リソース使用傾向、および過去のフィードバック軌跡を網羅しており、現在の環境観測表現を構成します。状態表現の次元とタイムウィンドウの長さは固定されており、状態変化の連続性はスライディングアップデートメカニズムを通じて捕捉されます。状態ベクトルをポリシーネットワークに送信する前に、正規化および特徴再構成を行い、入力が高次元空間において安定した数値分布を維持するようにすることで、勾配爆発と収束の変動を抑制します。
方策ネットワーク構造にはデュアルブランチ出力モジュールが採用されており、一方のブランチが行動分布を生成し、もう一方が状態価値関数の推定値を出力します。行動空間は、すべてのスケジューリング可能なタスクと割り当て可能なリソースで構成されています。候補スクリーニングメカニズムにより、不正または冗長な操作の組み合わせがフィルタリングされ、限定的な正当な行動セットが形成されます。方策ブランチは確率分布 π(at|st) を出力し、ここで at はタイムステップにおけるスケジューリング行動を、st は現在の状態入力を表します。実際のスケジューリングのために分布から行動を選択するには、標準化ガウスサンプリングまたはソフトマックスサンプリング戦略が使用されます。もう一方の出力である状態価値関数の推定値は、与えられた状態における長期的な報酬期待値を表し、方策の評価および更新に使用されます。
ポリシーネットワークにおいて、隠れ層は活性化関数とバッチ正規化を適用することで、非線形表現力の向上とネットワーク収束の加速を図っています。意思決定プロセスでは、異なるタスクの実行優先度、リソーススケジューリングコスト、および過去のパフォーマンスをアテンション因子として考慮し、特定の重み行列を介してアクション選択メカニズムに適用することで、適応的に調整可能なポリシー出力フレームワークを構築しています。この設計により、固定的なルールへの依存を回避し、予期せぬ競合や構造的なボトルネックに対処する際の戦略的な柔軟性を高めています。
スケジューリング戦略では、ランダムサンプリングメカニズムを使用して実際の動作シーケンスを生成します。各スケジューリングサイクルにおいて、現在の動作分布から実行可能な動作がサンプリングされ、リソースステータスとタスクノードマークが更新されます。動作の実行後、システムはリソースの変化とタスクの進捗結果に基づいて即時フィードバック報酬を算出し、今回のスケジューリングが全体目標に与えた影響を測定します。報酬の設計は、タスク完了率、リソース利用効率、および競合抑制の程度を含む多次元的な視点から検討されており、包括的な指標を通じて戦略更新モジュールにフィードバックを提供します。
スケジューリングプロセス全体でマルコフ決定過程を構築し、経験的なトラジェクトリサンプリング法を用いて、(st, at, rt, st+1)と表記される状態・行動・報酬のシーケンスを記録します。戦略の最適化はアドバンテージ関数の構築に基づいており、アドバンテージ推定値は以下の形式で定義されます:
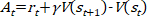 (4)
Atはアドバンテージ値を、rtは現在の即時報酬を、γは報酬割引率を、そしてV(st)とV(st+1)はそれぞれ現在および次の状態における状態価値関数の出力を表します。アドバンテージ関数は、戦略の平均的なパフォーマンスに対する現在の行動の優位性を反映します。これは、その後の戦略改善を導くために使用されます。At > 0である場合は、現在の行動が平均的な期待値よりも優れていることを意味し、その選択確率を高めるべきであり、そうでない場合は選択傾向を低減させるべきです。
戦略の更新プロセスにおいて、過度な更新振幅による戦略の振動を避けるため、ターゲット分布の切り捨て(トランケーション)メカニズムを適用し、新旧戦略間の変化範囲を制限することで、ネットワーク出力の連続性と安定性を維持します。行動分布とフィードバック報酬の間に密接な結合を確立することで、戦略が複雑な制約の変化に即座に反応することを可能にします。このメカニズムは、タスクが頻繁に変化する場合やリソースの不整合が突然発生した場合においても、意思決定の安定性と合理的なリソーススケジューリングを維持し、重複割り当て、リソースの混雑、またはタスクキューのバックログといった問題を効果的に回避します。これにより、スケジューリングシステムは、さまざまなタスク密度やリソース不足の状態においてより良好な動作状態を維持することができ、強力な適応能力を示します。
戦略の反復と安定的な更新メカニズム
生成されたスケジューリング戦略が安定し、繰り返されるトレーニングラウンドで劣化しないことを確実にするため、本サブセクションではクリッピングとアドバンテージ補正を備えた反復更新メカニズムを導入します。 旧戦略と新戦略の間の切り捨て更新間隔を設定し、クリッピング目的関数を用いて戦略のドリフトを制限することで、戦略更新プロセス中のスケジューリングショックを防止します。また、アドバンテージ関数と組み合わせて価値ネットワークを補正し、長期的なスケジューリングの精度を向上させます。
ポリシーネットワークのアクション出力の確率分布は、連続的なスケジューリングの反復過程で激しく変動しやすく、それが不安定な動作や無秩序なリソース割り当てにつながる可能性があります。ポリシードリフトによって引き起こされるスケジューリングショックを緩和するため、新旧ポリシー間の変化範囲を制御する切り捨て更新間隔を設計し、目的関数を精緻化するための制限項を構築します。サンプリングラウンドにおいて過去のポリシー確率を記録し、現在のポリシー確率を用いて比率項を構築します。ポリシーの更新目標は次のように設定されます:
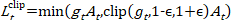 (5)
ここで、gt = πθ(at|st)/πθold(at|st)は、新旧の方策間の確率比を表し、εは方策の更新範囲を制限するクリッピングしきい値です。この比率が境界を超える場合、代わりにクリッピング値が使用されます。これにより、極端なサンプルから過剰な勾配が生成されるのを防ぎ、ネットワークパラメータの調整が設定範囲内に留まるようにします。この構造により、各スケジューリングラウンドにおける出力方策の変更範囲が動的に制限され、密なタスク分布の下でも方策出力の平滑性と一貫性が維持され、スケジューリング動作のジッタ率が大幅に低減されます。
更新プロセスにおいて、アクション分布の多様性を高め、早期収束を抑制するために、ポリシー目的関数に正則化項とエントロピー報酬項が追加されます。各ラウンドのポリシー更新では、経験軌跡サンプルの複数のバッチを使用してローリングトレーニングを行い、それによって状態空間におけるカバレッジの広さを維持します。更新前後の出力アクションシーケンスの確率分布を比較し、分布の偏差率を算出することで、ハードしきい値を用いてポリシーの許容変動範囲をスクリーニングします。このメカニズムは、サイクルをまたぐスケジューリングポリシーの移行に対して境界制御を提供し、リソース状態の激しい変化による過学習を抑制します。
戦略の更新は、価値関数によって提供される状態評価に依存しています。状態価値推定の偏差は、アドバンテージ関数の正確性に直接影響を与え、それによって戦略反復の方向性を変化させる可能性があります。評価精度を向上させるため、マルチタイムシリーズのバックトラッキング機構を構築し、将来の報酬の割引累積値を用いて現在の状態価値を補正します。バックトラッキング報酬には、以下のように定義される一般化アドバンテージ推定(GAE)構造を採用します:
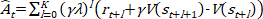 (6)
Âtは補正されたアドバンテージ値、λはバックトラッキング平衡係数、rt+lは(t+l)ステップ目の即時報酬、V(st+l)は価値ネットワークによって出力される状態価値を表します。この構造は、短期的な即時フィードバックと長期的な状態期待値を統合することで、将来のリソース競合、ピーク負荷、およびタスク蓄積に対する戦略の応答予測における偏差を補正します。λはバックトラッキングの深さを制御し、リソースの動的な変動が激しい期間に自動的に調整されることで、突発的な事象に対する価値ネットワークの応答の堅牢性を高めます。
アドバンテージ関数に組み込まれたマルチスケールの時間依存構造により、評価ネットワークによる長期的なリソース傾向のモデル化が可能になります。ポリシー出力の偏差を検出する際は、ポリシー挙動一貫性指標を用いて、ネットワークが評価誤差に対して過剰な反応を示していないかを評価します。フィードバック差分残差項によってポリシーの更新挙動を監視し、学習ターゲットおよび価値関数の重み更新幅を動的に補正します。価値ネットワークとポリシーネットワークを共同で最適化することで、高頻度のスケジューリングによるリソース競合状態の誤判定を防ぎつつ、価値推定がタスク完了目標から逸脱しないようにします。
この安定したポリシー更新メカニズムは、高次元の動的なタスク環境において、ポリシー動作更新の制御可能性と一貫性を効果的に維持し、タスク網羅効率とリソース利用の柔軟性を向上させ、継続的に反復するインテリジェントなスケジューリング構造を形成します。スケジューリング動作により、長期的な進化における局所最適解への陥落を防ぎ、タスクパターンの変化やリソースサイクルの変動に対する全体的な適応力を高めます。
図 3A は、異なる切り捨て閾値条件下におけるトレーニング反復回数の関数としての目的関数値の傾向を示しています。横軸はトレーニング反復回数、縦軸はクリッピング後の目的関数値です。εは0.1、0.2、0.3に設定されており、それぞれ異なるポリシードリフト制御強度を表しています。εの値が小さいほど曲線は変動しにくく、目的関数は安定しています。ε = 0.1の場合、目的関数値全体は0.8から1の間であり、戦略更新の緩やかさと安定性が示されています。一方、εの値が大きくなると変動が顕著になります。ε = 0.3の場合、目的関数値全体は0.65から0.95の間となり、目的関数曲線の振動振幅が大きくなっており、戦略更新プロセスにおいて深刻な逸脱が生じるリスクを反映しています。閾値が小さいほど戦略は安定し、高い制約があるスケジューリング環境に適しています。図 3B は、異なるバックトラッキングバランス係数における一般化アドバンテージ推定(GAE)の変化を示しています。将来報酬のバックトラッキング深度を制御するため、λはそれぞれ0.8、0.9、1.0に設定されています。曲線から、λが高いほどGAEの変動が小さくなり、長期的な傾向がより滑らかになり、複数ステップ後のスケジューリング動作による潜在的な影響をより正確に捉えられることがわかります。λが0.8の曲線は顕著な周期的変動を示しており、これは即時報酬に対してより敏感であり、短期的で突発的なタスクに適していることを示唆しています。対照的に、λ = 1.0は長期的な傾向のモデリングに重点を置いており、周期的タスクのシナリオに適しています。
計算量とスケーラビリティの解析
提案されたTransformer-PPOフレームワークの計算量は、主にTransformerエンコーダとPPOポリシー最適化の2つのコンポーネントによって決定されます。
L個の層、H個のアテンションヘッド、埋め込み次元d、および入力シーケンス長T(過去のタイムウィンドウ)を持つTransformerエンコーダにおいて、フォワードパス1回あたりの時間計算量はO(L·T2·d + L·T·d2)となり、ここでT2の項はセルフアテンションメカニズムに由来します。本実装では、L = 3、H = 4、d = 128とし、Tを100タイムステップに固定しているため、計算負荷は許容範囲内に収まっています。より長い過去のウィンドウを使用する場合、2次項のT2が支配的な要因となりますが、実際には労働組合の活動スケジューリングは通常、有限の過去の期間(例:四半期または1年のローリングウィンドウ)を扱い、タイムステップの解像度を調整することで精度と効率のバランスを取ることが可能です。
PPOコンポーネントにおいて、方策ネットワークと価値ネットワークは軽量なMLP(隠れ層あたり256および128ニューロン)であり、その推論計算量はO(d·m)(mは隠れユニット数)となります。これはTransformerエンコーダと比較して無視できる程度です。学習中の方策更新では、ミニバッチ勾配更新を複数エポックにわたって行い、その計算量はO(B·E·d2)となります。ここで、Bはバッチサイズ、Eは更新エポック数を示します。
拡張性の面において、本フレームワークは3つの好ましい特性を備えています。第一に、アテンションメカニズムはタイムステップ間で並列化できるため、効率的なGPU加速が可能です。第二に、制約行列が固定パラメータとして埋め込まれるのではなく、スケジューリングステップごとに動的に構築されるため、モデルサイズはアクティビティ数やリソース数に依存しません。これにより、学習済みの同一モデルを、再学習させることなく異なる規模の組合せに展開することが可能です。第三に、極めて大規模なシナリオにおいては、トレードオフとして履歴ウィンドウ長 T および埋め込み次元 d を縮小させるか、あるいはスパースアテンションのバリアントを採用することで、O(T2) の計算複雑性を O(T log T) または O(T) に低減させることができます。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
実験データ
本論文で提示するTransformer-PPO動的スケジューリングアルゴリズムの性能を包括的に評価するため、本実験では大手企業組合の過去3年間の活動管理データをベンチマークデータセットとして使用しました。このデータセットには、会議、トレーニング、娯楽など、さまざまな種類の5,000件以上の活動記録が含まれており、会場、設備、人員などの複数のリソースに関するスケジューリング情報が記載されています。各記録には、活動の開始・終了時刻、リソース要件、優先度、および実際の実行状況(コンフリクト事象やリソース利用率を含む)が詳細に記されています。実際のシナリオにおける動的な変化をシミュレートするため、データにさらに10%のランダムなバーストタスクとリソース変更事象(一時的な会場占有や人員の時間枠調整など)を付加し、極めて不確実性の高い環境におけるアルゴリズムの堅牢性を検証しました。連続的な状態シーケンスは、TransformerによるタイミングモデリングおよびPPOポリシー学習のための構造化された入力となります。本実験では、評価が実際のアプリケーションにおける典型的なシナリオを網羅するように、異...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
実験結果により、提案したTransformer-PPOアルゴリズムが、すべての評価指標においてベースライン手法(LSTM-PPO、貪欲法、およびDQN)を一貫して上回ることが実証されました。この優れた性能は、2つの主要な要因に起因しています。第一に、Transformerのマルチヘッド自己注意メカニズムが、アクティビティおよびリソースの状態シーケンスにおける長期的な時間的依存関係を効果的に捕捉し、潜在的な競合をプロアクティブに特定することを可能にしています。これにより、モデルがリソースの競合が発生する前に予測できるため、高複雑度(例:部門間連携や一時的な挿入)の下でも競合率が低く維持されることが説明されます。第二に、PPOにおけるクリップされた目的関数とGAEベースのアドバンテージ補正により、安定した方策更新が保証され、スケジューリング決定の急激な変動が防止され、変動するタスク負荷の下で高い堅牢性が維持されます。
既存のスケジューリング手法と比較して、提案手法は、長いシーケンスにおいて勾配消失問題が発生するLSTMベースのモデルの限界に対処し、動的な環境において汎用性に欠けるgre...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者らは、金銭的な利益相反がないことを宣言します。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | 基本プログラミング言語 |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | ディープラーニングフレームワーク(Transformer/PPO実装) |
| NumPy 1.23 | NumPy Developers | https://numpy.org/doc/stable/release/1.23.0-notes.html | 数値計算ライブラリ |
| Matplotlib 3.5 | Matplotlib Development Team | https://matplotlib.org/stable/users/installing.html | 結果の可視化 |
| 組合活動スケジューリングデータセット | 共同研究企業の内部データベース(匿名化済み) | 機密保持契約のため公開されていません。アクセスに関しては責任著者に問い合わせてください | ある大企業の労働組合における3年間の5,000件以上の活動記録(会議、研修、レクリエーション) |
| NVIDIA A100 GPU | |||
| PyTorch |
参考文献
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。