本研究では、アルツハイマー病、前頭側頭型認知症、および健常対照群を区別するための脳波バイオマーカーについて調査しています。二乗平均平方根、パワースペクトル密度、およびエントロピーの特徴量を用いたランダムフォレストモデルを、説明可能な人工知能(XAI)および効果量分析を用いて解析しました。影響の少ないエントロピー特徴量を除去することで分類性能が向上し、テスト精度94%を達成しました。
この記事について
サマリー
要約
脳波検査(EEG)は、神経変性疾患における脳活動を特性づけるための非侵襲的なアプローチとして研究されてきました。本研究では、マルチドメインEEGバイオマーカーが、アルツハイマー病(AD)、前頭側頭型認知症(FTD)、および健常対照群(HC)を区別できるかどうかを評価しました。公開データセットには、AD患者36名、FTD患者23名、および健常対照群29名の計88名から得られた、閉眼安静時のEEG記録が含まれていました。機械学習による分類のために、マルチドメインEEGバイオマーカーと人口統計学的特徴が抽出されました。EEG由来の特徴量には、二乗平均平方根(RMS)、パワースペクトル密度(PSD)、およびエントロピー指標が含まれています。統合された特徴量セットを用いてランダムフォレスト分類器を学習させ、説明可能な人工知能を用いて解釈を行いました。特徴量の寄与度を評価するために、特徴量の安定性とCohen's d効果量の分析を行い、続いてアブレーション分析を実施しました。その結果、エントロピーベースの特徴量が分類への寄与度が最も低いことが示されました。完全なマルチドメインモデルでは、学習精度96%、テスト精度92%を達成しました。エントロピー特徴量を削除した後、テスト精度は94%に向上しました。これらの結果は、ランダムフォレストの枠組みにおける、選択されたマルチドメインEEGおよび人口統計学的特徴の分類性能を記述したものです。
概要
アルツハイマー病(AD)は、認知機能および運動機能の低下を伴う進行性の神経疾患です。その有病率は加齢とともに大幅に増加し、認知症は高齢者の罹患率および死亡率の主要な原因となっています1,2,3,4,5。診断および疾患分類は依然として困難であるため、認知症に伴う神経生理学的変化を特徴付ける手段として、脳信号の解析が研究されています。
脳波検査(EEG)は、脳の電気活動を記録するための非侵襲的な手法であり、アルツハイマー病およびその他の神経疾患において研究されてきた6,7,8,9,10,11。EEG信号はニューロン活動によって生成される電位を反映しており、頭皮上の複数の部位から非侵襲的に記録される12,13,14。脳活動は一般的に、delta、theta、alpha、beta、およびgammaの周波数帯域を用いて特徴づけられる15。アルツハイマー病は、EEGの徐波化、信号複雑性の低下、および同期性の変化に関連している16。スペクトル解析では、健常対照群と比較して、AD患者においてdeltaおよびtheta活動の増加と、alphaおよびbeta活動の減少が報告されている17,18,19。これまでのEEG分類研究では、ADと健常対照群(HC)、および前頭側頭型認知症(FTD)とHCを区別する高い性能が報告されている。対照的に、ADとFTDの識別は一般的により困難である10,11。
機械学習の手法は、神経疾患に関連するEEG信号のパターンを特定するために用いられてきた20,21。したがって、特徴抽出はEEGに基づいた分類における重要な構成要素となる。先行研究では、スペクトル、時間、複雑性、および機能的結合性の特徴が、機械学習モデルと組み合わせて調査されてきた3,15,22,23。スペクトル特徴は、ADで報告されているアルファ活動の低下やシータ活動の増加など、脳活動における周波数依存性の変化を定量化できるため、特に重要である23,24,25,26。
EEGベースの複数の研究において、特徴量、分類器、および検証戦略のさまざまな組み合わせが評価されてきました。コネクティビティに基づく解析はAD、FTD、およびHCを区別するために用いられてきましたが、報告されている分類性能は、比較対象や特徴量選択の手順によって異なります27。また、フーリエ変換ベースの特徴量についても、AD、軽度認知障害(MCI)、および健康対照群を区別するために評価されていますが、前処理の不足や、検証戦略に関連した過学習の可能性などが限界として挙げられています28。非線形EEG複雑度指標は、AD分類において識別能を示すことが明らかになっており、一部では高い精度、感度、特異度が達成されていますが、MCIへの適用や疾患ステージの識別における有用性は依然として限定的です21。
時間-周波数EEG表現に基づくディープラーニング手法も、AD、MCI、およびHCの多クラス分類に向けて研究されています29。高い分類性能が報告されていますが、小規模または限定的なコホート、クラス不均衡、疾患重症度の不均一性、外部検証の不足、およびモデルの解釈性の低下などの限界があります29。検証戦略も重要な方法論的検討事項です。参加者独立アプローチにより、同一参加者のエポックがトレーニングセットとテストセットの両方に含まれる場合、従来のエポックレベルの交差検証では性能を過大評価する可能性があることが示されています30。この限界は、異なる検証スキームを使用している研究間で分類結果を比較する場合に特に重要となります。
複雑性と接続性の指標がサポートベクターマシン分類器を用いて評価されており、位相ベースの接続性とマルチスケールエントロピーがさまざまなレベルの判別性能を示している31,32。フーリエ変換およびウェーブレット変換に基づく特徴量を用いた別の研究では、AD、MCI、およびHCの比較において性能にばらつきがあることが報告されており、一般的に多クラス分類は二値分類よりも困難なままである14。さらに、エントロピーおよび同期に基づくアプローチでもADと対照群の判別が実証されているが、対照群の特性が観察される効果量に影響を与える可能性がある2。
本研究では、人口統計学的変数としての年齢に加え、EEG周波数帯域から抽出した平方根平均二乗(RMS)、パワースペクトル密度(PSD)、およびエントロピー指標からなるマルチドメインの特徴量セットを評価します。RMSは各周波数帯域内の信号振幅を表し、PSDは周波数領域の電力を表します。エントロピーは信号の複雑性の尺度として導入されています。これらの特徴量はEEG活動の相補的な記述を提供し、ランダムフォレスト分類器を用いて評価されます。さらに、抽出した特徴量の相対的な寄与度を評価するため、特徴量の重要度、特徴量の安定性、説明可能な人工知能(XAI)、および効果量分析について検討します。本研究では、機械学習を用いて、スペクトル、時間、および複雑性に基づく指標を含むマルチドメインEEG特徴量が、アルツハイマー病(AD)、前頭側頭型認知症(FTD)、および健常対照群(HC)を識別する上でどの程度有効であるかを調査します。また、PSD、RMS、およびエントロピー指標を用いた際に、どのEEG周波数帯域の特徴量が分類に最も強く寄与するかを検討します。さらに、PSDやRMSを含む電力ベースの特徴量と、エントロピーベースの特徴量の寄与を比較し、分類モデルに対する年齢の寄与を評価します。
プロトコル
EEGの前処理、特徴抽出、および分類のワークフローの概略図を以下に示す。 図1. 本研究で使用した材料およびソフトウェアは、以下に記載されています。 材料一覧表
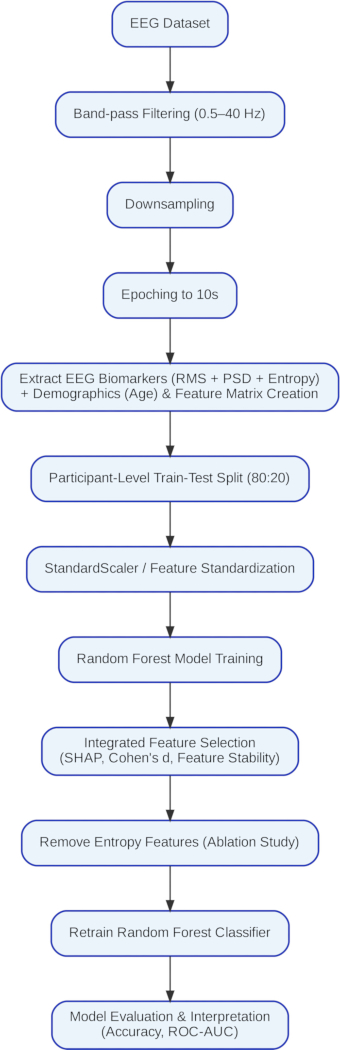
図1: EEGの前処理、特徴抽出、および分類パイプラインのワークフロー。EEGデータの検証、バンドパスフィルタリングと再参照、二乗平均平方根(RMS)、パワースペクトル密度(PSD)、およびエントロピー特徴の抽出、年齢の追加、トレーニング・テストデータの分割、Random Forestモデルの開発、特徴安定性解析、SHAP解析、Cohen’s d 効果量解析、統合的な特徴選択、エントロピー特徴のアブレーション、モデルの再学習、および性能評価を含む、本研究のワークフローの概略図。こちらのリンクをクリックして、この図の拡大版を表示してください。
1. データ収集
公開されている安静時EEGデータセットをOpenNeuroリポジトリ(データセット ds004504、バージョン 1.0.9)から取得した33。参加者のラベルおよび人口統計学的情報を確認した。このデータセットは、アルツハイマー病(AD)患者36名、前頭側頭型認知症(FTD)患者23名、および健康対照群(HC)29名の計88名の参加者で構成されていた。
2. EEG記録のインポート
各参加者のEEG記録をMNE-Pythonライブラリを用いてロードした。各EEGファイルについて、アクセス可能であること、正常にインポートできること、および有効な参加者識別子が含まれていることを確認した。ファイルが欠落しているか破損している記録は除外した。この段階では、元のEEGサンプリング周波数である500 Hzを維持した。その後、本研究において臨床的に関連するすべてのEEG情報を保持しつつ、計算負荷を軽減するために信号をダウンサンプリングした。
3. バンドパスフィルタリング
連続EEG記録は、低域遮断周波数を0.5 Hz、高域遮断周波数を40 Hzとした4次バンドパスフィルタを用いてフィルタリングした。
4. 共通平均リファレンスおよびエポッキング
フィルタリング後のEEG記録に共通平均リファレンス(CAR)を適用した。各タイムサンプルにおいて、利用可能なすべてのEEGチャンネルの平均信号を算出し、各チャンネルから減算した。リファレンス処理後のEEG信号を以降の解析に使用した。各リファレンス済みEEG記録は、MNE-Pythonのmake_fixed_length_epochs()関数を用いて、固定長のエポックに分割した。エポックの期間は10 sとし、オーバーラップは0 sとした。
5. エポックの検証
各参加者について、完全な10 sのエポックのみを保持しました。記録の最後に残った10 s未満のEEGセグメントはすべて破棄しました。保持された各エポックは、その後、特徴量抽出のための個別のサンプルとして使用されました。
6. 特徴量の準備
ソースデータセットに Mini-Mental State Examination (MMSE) のデータが含まれていたが、今回の解析からは除外した。抽出した EEG 特徴量を、participants.csv メタデータファイルから得られた年齢や診断ラベルなどの参加者のデモグラフィック情報と統合した。参加者識別子を共通キーとして使用し、EEG 特徴量のレコードと対応するデモグラフィック情報の両方が揃っている参加者のみを保持した。
マルチドメイン特徴量行列には、5つの二乗平均平方根(RMS)特徴量(delta_rms、theta_rms、alpha_rms、beta_rms、gamma_rms)、5つのパワースペクトル密度(PSD)特徴量(delta_psd, theta_psd, alpha_psd, beta_psd, gamma_psd)、および5つのエントロピー特徴量(delta_entropy, theta_entropy, alpha_entropy, beta_entropy, gamma_entropy)が含まれていました。補完的な人口統計学的変数として年齢を組み込みました。診断グループ間で年齢分布が異なる可能性があるため、人口統計学的な混同を完全に排除することはできませんでした。AD、HC、またはFTDとして定義される診断グループをターゲットラベルとして割り当てました。
7. データの前処理および訓練・テストデータの分割
前処理において、関心のあるEEG周波数情報を保持しつつ計算負荷を軽減するため、記録データのサンプリングレートを500 Hzから250 Hzにダウンサンプリングしました。
データセットは、グループ化分割戦略を用いて、被験者レベルでトレーニング用(80%)とテスト用(20%)のサブセットに分割されました。その後、各参加者に属する予測エポック間で多数決を行うことにより、被験者レベルの予測を得ました。主な評価では、同一参加者のエポックが両方のサブセットに現れるのを防ぐため、被験者レベルのグループ化トレーニング・テスト分割を使用しました。被験者レベルの予測は、各参加者に属する予測エポック間での多数決によって得られました。データセットに欠損値がないか確認し、欠損値がある場合は、適宜削除または補完を行いました。診断ラベルをエンコードしました。トレーニングデータにStandardScalerを適合させ、その後、トレーニングデータとテストデータの両方に適用しました。
8. ランダムフォレストモデルの開発
ランダムフォレスト分類器を、決定木の数を80本、最大木の深さを10、最大特徴量を4、葉ごとの最小サンプル数を5、乱数シード(random state)を42に設定して初期化しました。この分類器を、標準化したトレーニングデータセットを用いて学習させました。
9. モデル評価
トレーニングデータセットとテストデータセットの両方について、クラスラベルの予測を行った。混同行列を作成し、分類レポートとともに、正解率(accuracy)、適合率(precision)、再現率(recall)、およびF1スコアを算出した。トレーニング精度とテスト精度を記録した。
参加者ごとの評価において、特定の参加者のすべてのエポックが、トレーニングセットまたはテストセットのいずれかに排他的に割り当てられていることを確認してください。ランダムフォレスト分類器は、一次分析で使用したものと同じハイパーパラメータを用いてトレーニングされました。
10. 交差検証
追加のモデル評価手順として、shuffle = Trueおよびrandom_state = 30を用いて、5分割層化交差検証を実施した。5つのフォールドにおける平均正解率と標準偏差を算出した。この解析は、主要な被験者レベルのホールドアウト評価とは別に検討した。
11. 特徴量の安定性分析
0から9までの乱数シードを用いてRandom Forestのトレーニングを10回繰り返し、特徴量の安定性を評価しました。各回において、テスト精度と特徴量重要度スコアを記録しました。各予測変数の特徴量重要度スコアの平均値と標準偏差を10回のランにわたって算出し、その安定性に基づいて予測変数をランク付けしました。この分析は、主要な被験者レベルの評価に代わるものではなく、特徴量ランキングの一貫性を評価するために用いられました。
12. 説明可能な人工知能(XAI)解析
学習済みのRandom ForestモデルにSHAP TreeExplainerを適用した。各特徴量がモデルの予測にどの程度寄与しているかを推定するため、SHAP値を算出した。各特徴量について平均絶対SHAP値を算出し、SHAPの寄与度に基づいて特徴量の順位付けを行った。一貫してSHAP値が低い特徴量を特定し、それを特徴量の安定性解析およびCohen’s d解析の結果と比較した。寄与度が一貫して低い特徴量を、その後のアブレーション解析およびモデルの再学習の対象として選出した。
13. 統計的効果量の分析
ADにおける各EEGバイオマーカーについて、Cohen's dを算出した。 対比 健康対照群, アルツハイマー病 対比 前頭側頭型認知症(FTD)、および前頭側頭型認知症(FTD) 対 HCとの比較。効果量の大きさは、小さい効果を0.20、中程度の効果を0.50、大きい効果を0.80とする閾値を用いて解釈した。
14. 統合的な特徴量選択
Random Forestによる特徴量の重要度分析、SHAP分析、およびCohen’s d分析の結果を比較した。特徴量の重要度が低く、SHAPへの寄与度が低く、かつ効果量が小さいことが一貫して認められた予測因子を、削除の候補として特定した。
15. 特徴量のアブレーション解析
探索的なアブレーション解析においてエントロピー特徴量を評価し、RMS、PSD、および年齢を含む削減した特徴量行列を構築した。同じハイパーパラメータを用いてRandom Forest分類器を再学習させた。削減した特徴量セットを用いて、モデルの学習、テスト、交差検証、および受信者動作特性(ROC)解析を繰り返し実施した。
16. ROC解析
クラス確率は、最適化されたランダムフォレスト分類器から得られた。マルチクラスROC曲線は、1つの—対照的に-休息戦略。クラス別の曲線下面積(AUC)値および平均AUCを算出した。
17. 性能比較
完全な特徴量モデルの性能を、エントロピー特徴量のアブレーション後に得られた削減特徴量モデルの性能と比較しました。
結果
Random Forestモデルは、トレーニング精度96%、テスト精度92%を達成した。マクロ平均F1スコアは92%であり、加重平均F1スコアも同様に92%であったことから、3つのクラス間で同等の性能を示した。分類性能はアルツハイマー型認知症(AD)クラスで最も高く、一方で前頭側頭型認知症(FTD)クラスは、表1に示すように、比較的低い性能を示した。
分類しきい値におけるクラス分離を評価するために、受信者動作特性(ROC)解析を用いた。図2に示すように、ROC曲線下面積(AUC)は3つのクラスすべてで0.98を超えており、AD、FTD、および健常対照(HC)群の間で高い分離能があることが示された。
Random Forest分類モデルにおける特徴量の寄与度を評価するため、TreeExplainerを用いたSHAP解析を実施した。図3のサマリーバープロットは、電力スペクトル密度(PSD)、二乗平均平方根(RMS)、エントロピー、および人口統計学的特徴量の相対的な寄与度を示している。SHAP値の絶対値が高い特徴量ほどモデルの予測への寄与が強く、一方でエントロピー関連の特徴量の寄与は比較的低いことが示された。
指定したランダムシードを用いてRandom Forestのトレーニングを繰り返し、特徴量の安定性分析を行った。各実行においてテスト精度と特徴量重要度スコアを記録し、特徴量重要度の平均値と標準偏差を算出した。本分析において、モデルは平均分類精度95%(標準偏差0.17%)を達成した。これらの反復実行は、主に特徴量ランキングの一貫性を評価するために行われ、主要な被験者レベルのホールドアウト評価とは別に検討された。表2に示すように、特徴量安定性分析においてAgeは高い順位にランクされた。また、theta_psdおよびtheta_rmsの特徴量も高い順位となり、一方でalpha_psd、alpha_rms、beta_psd、beta_rmsは中程度の特徴量重要性を示した。
表 3 に示すように、群間差の大きさを評価するために Cohen’s d を算出した。AD患者と健康対照群の間で最も大きな差が認められたのは、アルファ波帯域の減衰(alpha_rms, d = 0.97; alpha_psd, d = 0.87)およびシータ波活動の増加(theta_rms, d = 0.72)であった。これらの知見は、認知症のEEG研究で報告されている皮質緩慢化と一致していた34。エントロピーベースの特徴量は、相対的に小さな効果量を示した。ADとFTDの比較では、主に小から中程度の効果量が得られた。
AD群において、アルファ波帯域の特徴に大きな効果量が認められた。対照的に-HCおよびFTD-対比-HC対照群との比較。AD(アルツハイマー病)について 対 HCでは、報告された効果量はalpha_psdで−0.87、alpha_rmsで−0.97であった。FTDでは 対比 HCでは、アルファ帯域の減衰は−0.73であった。theta_psdの特徴は、ADにおいて0.61の効果量を示した。 対比 HCでは、theta_rmsの効果量は0.72であった。ADではより小さな差が観察された。 対 前頭側頭型認知症
β帯域の特徴は、主に小から中程度のグループ効果量を示した。beta_psdの効果量は、ADで−0.35であった。 対比 HCで-0.41、ADで-0.41 対 FTDにおいては、beta_rmsはほとんどの場合で小さい効果量を示した。ガンマ帯域の特徴は、いくつかの比較において中程度の効果量を示した。FTDにおけるgamma_psdの効果量は0.47であった。 対 HCおよびADに対する0.20 対比 HCである一方、gamma_rmsはFTDに対して0.50の効果量を示した。 対比 HC(ヘモシステリス)
Delta PSDおよびRMSは、ADに対して小さい正の効果量を示した。 対比 HC(それぞれ0.29および0.34)およびFTD 対比 HC(それぞれ0.25および0.25)。ADにおける効果量 対照 FTDはほぼゼロであった。デルタエントロピーは、3つの比較すべてにおいて小さな効果量(0.08、0.20、−0.11)を示した。
特徴量の安定性、SHAP、および効果量分析により、エントロピー特徴量の寄与は比較的低いことが示されました。その結果、エントロピー特徴量を除外し、RMS、PSD、および年齢を保持してアブレーション分析を実施しました。特徴量アブレーション後、ランダムフォレストモデルはトレーニング精度96%およびテスト精度94%を達成しました。この結果は、評価した特徴量選択フレームワーク内での探索的な比較として解釈されました。AD、HC、およびFTDクラスの適合率、再現率、F1スコア、およびサポートを表4に示します。
エントロピー特徴量の除去(アブレーション)前後の性能をTable 5に比較して示します。エントロピーを削除した後、テスト精度は92%から94%に向上しました。クラスごとの変化をTable 6に示します。FTDでは、適合率(precision)が4%向上し、F1スコアが2%向上しました。HC群の再現率(recall)は4%向上しましたが、適合率は2%低下しました。特徴量アブレーション後、マクロ平均および加重平均の性能指標は約1%~2%向上しました。
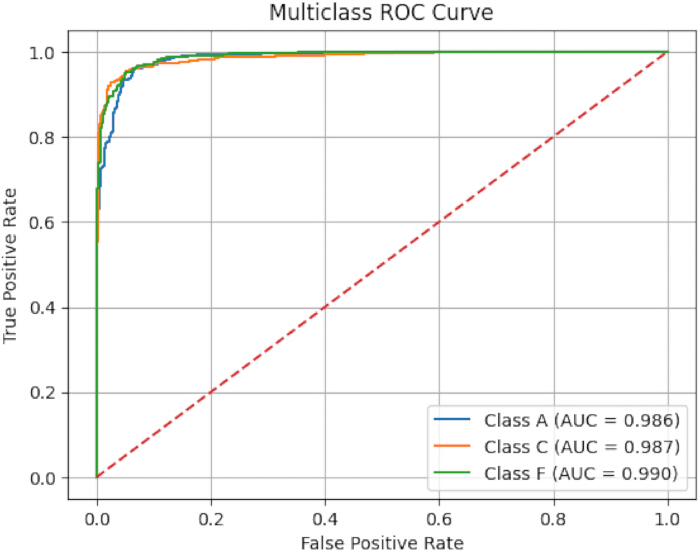
図2アルツハイマー病、前頭側頭型認知症、および健常対照群の受信者動作特性(ROC)曲線。 1対多(one-vs-all)の手法を用いて作成されたマルチクラス受信者動作特性(ROC)曲線対比アルツハイマー病(クラスA)、前頭側頭型認知症(クラスF)、および健常対照群(クラスC)に対する静止状態戦略。各クラスについて曲線下面積(AUC)を算出した。 この図の拡大版を表示するには、ここをクリックしてください。
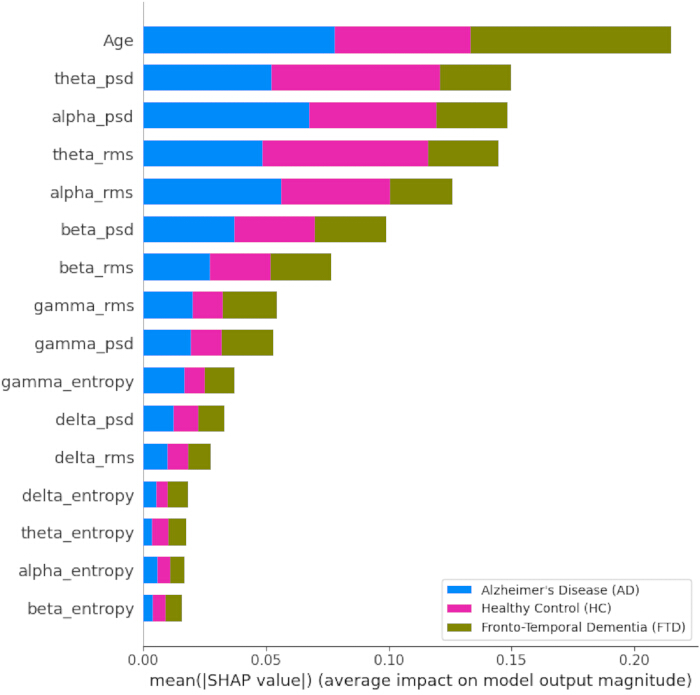
図 3: 学習済みRandom ForestモデルのSHAPサマリー解析。Random Forest分類モデルに対する、EEG由来の特徴量および人口統計学的特徴量の相対的な寄与度を示すサマリー棒グラフ。平均絶対SHAP値を用いて、二乗平均平方根(RMS)、パワースペクトル密度(PSD)、エントロピー、および年齢の特徴量の寄与度を順位付けした。ここをクリックして、この図の拡大版を表示してください。
| 精度 | 再現率 | F1スコア | サポート | |
| アルツハイマー病 | 0.92 | 0.95 | 0.94 | 579 |
| 対照 | 0.93 | 0.92 | 0.93 | 480 |
| 前頭側頭型認知症 | 0.93 | 0.87 | 0.9 | 314 |
| マクロ平均 | 0.93 | 0.92 | 0.92 | 1373 |
| 加重平均 | 0.93 | 0.92 | 0.92 | 1373 |
表1:テストデータの分類レポート。テストデータセットにおけるアルツハイマー病、健常対照群、および前頭側頭型認知症の各クラスの適合率(Precision)、再現率(Recall)、F1スコア、およびサポート数と、マクロ平均および加重平均による性能指標を示している。
| 特徴 | 平均値 | 標準偏差 |
| 年齢 | 0.1966 | 0.0017 |
| θ-PSD | 0.0936 | 0.0027 |
| $\theta_{\text{rms}}$ | 0.0911 | 0.0023 |
| α-PSD | 0.0824 | 0.0022 |
| $\alpha_{rms}$ | 0.0824 | 0.0024 |
| β-PSD | 0.0638 | 0.0013 |
| β-RMS | 0.0629 | 0.0012 |
| ガンマPSD | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| ΔPSD | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| ガンマエントロピー | 0.0326 | 0.0008 |
| αエントロピー | 0.0325 | 0.0006 |
| ベータ・エントロピー | 0.0283 | 0.0009 |
| θエントロピー | 0.0258 | 0.0004 |
| デルタエントロピー | 0.0255 | 0.0005 |
表2:ランダムフォレストモデルの特徴量安定性ランキング。0~9のランダムシードを用いてランダムフォレストの学習を繰り返して得られた、特徴量重要度の平均値および対応する変動性。各ランダムフォレストの実行間における安定性に基づいて特徴量をランク付けした。
| 特徴 | アルツハイマー病 対 HC | アルツハイマー病 対比 前頭側頭型認知症 | 前頭側頭型認知症 〜対〜 HC |
| デルタPSD | 0.293 | -0.069 | 0.253 |
| シータ波PSD | 0.612 | 0.23 | 0.355 |
| α-PSD | -0.869 | -0.219 | -0.64 |
| β-PSD | -0.352 | -0.408 | 0.201 |
| ガンマPSD | 0.201 | -0.326 | 0.468 |
| デルタエントロピー | 0.081 | 0.199 | -0.111 |
| シータエントロピー | 0.208 | 0.033 | 0.163 |
| αエントロピー | -0.061 | 0.071 | -0.137 |
| ベータエントロピー | -0.37 | -0.042 | -0.332 |
| ガンマエントロピー | -0.338 | 0.047 | -0.391 |
| デルタRMS | 0.342 | 0.041 | 0.251 |
| シータRMS | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| ベータRMS | -0.494 | -0.365 | 0.015 |
| ガンマRMS | 0.187 | -0.33 | 0.5 |
表 3:診断グループ間におけるCohen’s d 効果量の比較。アルツハイマー病 対 健康対照群、アルツハイマー病 対 前頭側頭型認知症、および前頭側頭型認知症 対 健康対照群の比較におけるEEGバイオマーカーのCohen’s d 値。
| 適合率 (Precision) | 再現率 (Recall) | F1スコア | サポート数 | |
| アルツハイマー病 | 0.94 | 0.95 | 0.94 | 579 |
| 対照群 | 0.91 | 0.96 | 0.94 | 480 |
| 前頭側頭型認知症 | 0.97 | 0.89 | 0.92 | 314 |
| マクロ平均 | 0.94 | 0.93 | 0.93 | 1373 |
| 加重平均 | 0.94 | 0.94 | 0.94 | 1373 |
表4:特徴量アブレーション後の分類レポート。エントロピー特徴量の削除およびRandom Forestモデルの再学習後における、アルツハイマー病、健康対照群、および前頭側頭型認知症の各クラスの適合率(Precision)、再現率(Recall)、F1スコア、およびサポート。
| 指標 | アブレーション前 | アブレーション後 | 変化 |
| 学習精度 | 0.96 | 0.96 | 0% 変化なし |
| テスト精度 | 0.92 | 0.94 | +2% 向上 |
| マクロ適合率 | 0.93 | 0.94 | +1% 向上 |
| マクロ再現率 | 0.92 | 0.93 | +1% 向上 |
| マクロF1スコア | 0.92 | 0.93 | +1% 向上 |
| 加重適合率 | 0.93 | 0.94 | +1% 向上 |
| 加重再現率 | 0.92 | 0.94 | +2% 向上 |
| 加重F1スコア | 0.92 | 0.94 | +2% 向上 |
表5:特徴量アブレーション前後での性能比較。完全なマルチドメイン特徴量セットと、エントロピー特徴量を削除した後に得られた削減特徴量セットのモデル性能指標の比較。
データの利用可能性:
モデルの開発および解析に使用した処理済みCSVデータセットは、補足ファイル1として提供されています。前処理コードはPythonノートブック(https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing)で、モデル構築および解析コードはhttps://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharingで利用可能です。また、提供されている前処理コードを使用して、処理済みCSVデータセットを再生成することも可能です。
| クラス | 指標 | 適用前 | 適用後 | 変化 |
| アルツハイマー病 | 適合率 | 0.92 | 0.94 | 0.02 |
| 再現率 | 0.95 | 0.95 | 変化なし | |
| F1スコア | 0.94 | 0.94 | 変化なし | |
| コントロール | 適合率 | 0.93 | 0.91 | −2% |
| 再現率 | 0.92 | 0.96 | 0.04 | |
| F1スコア | 0.93 | 0.94 | 0.01 | |
| FTD | 適合率 | 0.93 | 0.97 | 0.04 |
| 再現率 | 0.87 | 0.89 | 0.02 | |
| F1スコア | 0.9 | 0.92 | 0.02 |
表6:特徴量アブレーション前後におけるクラス別のパフォーマンス変化。エントロピー特徴量の除去後における、アルツハイマー病、健康対照群、および前頭側頭型認知症クラスの適合率、再現率、およびF1スコアの変化。
補足ファイル 1:モデル開発および解析に使用した処理済みエポックレベル EEG 特徴量データセット。こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
ランダムフォレスト分類器を用い、電力スペクトル密度(PSD)、二乗平均平方根(RMS)、およびエントロピー指標を含む多ドメイン特徴量を使用して、脳波(EEG)サンプルをアルツハイマー病(AD)、前頭側頭型認知症(FTD)、および健常対照(HC)群に分類した。補完的な人口統計学的変数として年齢を組み込んだ。診断グループ間で年齢分布が異なる可能性があるため、人口統計学的な混同変数の影響を完全に排除することはできず、報告された性能は人口統計学的情報と電気生理学的情報の複合的な寄与を反映している。本解析では、多ドメインEEG特徴量がAD、FTD、およびHC群を識別できる能力を検証し、デルタ波、シータ波、アルファ波、ベータ波、およびガンマ波帯域の特徴量が分類にどのように寄与しているかを評価した35。特徴量の安定性と効果量の解析により、PSDやRMSを含む電力ベースの特徴量が、エントロピーベースの特徴量よりも強く寄与していることが示された。抽出されたEEGバイオマーカーは、リズムの徐波化およびアルファ活動の低下に関連するパターンも反映していた。
先行研究では、異なる機械学習アプローチを用いて、エントロピー、PSD、およびRMSに基づくEEG特徴量が評価されています2,14,27,28,36,37。エントロピーはEEGの複雑性と不規則性を特徴づけるために用いられ、PSDはスペクトル特性を定量化するために用いられてきました2,14,27,28,36。また、RMSは周波数帯域の特徴量として評価されています37。同一の基礎データセットを用いた先行研究では、1被験者抜き交差検証によるPSDベースの二値分類が適用されていました33。それに対し、本解析では、マルチクラス分類フレームワーク内において、アルファ波、ベータ波、ガンマ波、シータ波、およびデルタ波の各帯域におけるRMS、エントロピー、PSDを組み合わせました。同じデータセットを用い、1被験者抜き二値分類戦略で評価された軽量EEGトランスフォーマーでは、83.28%の精度が報告されています。分類タスクおよび検証手順が異なるため、本結果との直接的な数値比較は慎重に解釈されるべきです38
ADとHC、およびFTDとHCを区別する上で、アルファ波帯の特徴が最大の効果量を示し、またシータ波活動の増加もADとHCの識別に寄与しました。ベータ波帯の特徴はグループ間での効果が小さかった一方、エントロピーベースの特徴は識別能が比較的限定的でした。ガンマ波帯の特徴は、FTD versus HCを含むいくつかの比較において中程度の効果を示しました。先行研究では、ADおよび関連する診断比較において、アルファパワーの低下とシータ活動の変化が報告されています23,25,39。エントロピーについても、神経変性疾患における潜在的に有用なバイオマーカーとして記述されており36、その寄与はデータセット、特徴定義、および解析アプローチによって異なる可能性が示唆されています。
これまでのEEG分類研究では、サポートベクターマシンが頻繁に使用されてきた3,21,24,37。本解析で使用したランダムフォレスト分類器は、特徴量の重要度の推定が可能であり、本研究で用いた構造化特徴量セットに適用可能であった40,41。エントロピー特徴量の除去(アブレーション)後、学習精度96%およびテスト精度94%が得られた。エントロピー特徴量の除去によってモデルの性能が向上したことは、安定性、SHAP、および効果量解析においてこれらの特徴量の相対的な寄与度が低いことが観察された結果を支持している。ディープラーニングやトランスフォーマーベースのアプローチもEEG分類に適用されているが、こうしたアプローチは一般的により大規模なデータセットを必要とし、より高次元または系列的な表現向けに設計されている27,39,42,43,44,45。
EEG信号はノイズが多く非定常であるため、構造化された特徴表現を分析する際には、アンサンブル決定木ベースのモデルが堅牢性を提供できます。本研究では、Random Forestモデルへの相補的な入力として、RMS、PSD、エントロピー、および年齢を評価しました。RMSは周波数帯域内の信号振幅を、PSDはスペクトル密度を、エントロピーは信号の複雑性を表しています。解析の結果、評価したフレームワーク内では、PSDとRMSがエントロピーよりも分類に強く寄与することが示されました。年齢もモデルに寄与しましたが、その導入により人口統計学的な混同変数が生じる可能性がありました。今後の研究では、汎用性と分類性能をさらに評価するために、より大規模なデータセットを用いて、追加の人口統計学的変数や、代替となる機械学習またはディープラーニングの手法を検討することが考えられます。
開示事項
本研究で報告された内容に影響を及ぼす可能性のある、既知の競合する利益、個人的関係、金銭的関係、またはその他の活動は申告されていません。
謝辞
本研究で使用した公開EEGデータセット、および研究目的で当該データセットを利用可能にした研究者の貢献に感謝いたします。公的機関、営利企業、または非営利団体からの特定の資金提供は受けていません。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Google Colab | [環境の確認]Colabランタイム | 解析ノートブックの実行に使用されるクラウドベースの計算環境 | |
| MNE-Python | MNE-Pythonプロジェクト | 1.12.1 | EEGの前処理、リファレンスの設定、フィルタリング、およびエポック分割に使用されます。 |
| NumPy | NumPyプロジェクト | (2.0.2) | 数値計算および配列ベースの計算に使用されます |
| OpenNeuro EEGデータセット | OpenNeuro | ds004504, (1.0.9) | AD、FTD、およびHCの記録を含む、公開利用可能な安静時EEGデータセット |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | データ処理およびモデル開発に使用したプログラミング環境 |
| scikit-learn | scikit-learnプロジェクト | 1.6.1 | 前処理、グループ化データ分割、ランダムフォレスト分類、および性能評価に使用される |
| SciPy | SciPyプロジェクト | (1.16.3) | 信号処理および統計計算に使用される |
| SHAP(Shapley Additive Explanations) | SHAPプロジェクト | 0.52.0 | TreeExplainerを用いた説明可能な人工知能分析に使用 |
参考文献
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379