本研究では、主張レベルの検証と適応的な統計的しきい値設定を通じて、大規模言語モデルにおけるハルシネーションを低減するための軽量なフレームワークを提示します。自然言語推論を用いて根拠のない主張を選択的に修正することで、低い応答レイテンシと実用的な展開効率を維持しながら、事実上の正確性を向上させます。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
大規模言語モデル(LLM)は、事実として不正確でありながら言語的に流暢な出力を生成するという、ハルシネーション(幻覚)と呼ばれる重大な傾向があり、これは精度が極めて重要なアプリケーションにおいて深刻なリスクとなります。検索拡張生成や自己整合性サンプリングなどの既存の軽減策は、大幅な推論レイテンシを導入するか、あるいは外部の知識インフラに依存しており、リアルタイム展開における適用性が制限されています。本論文では、LLMの回答をアトミックな事実主張に分解し、独立した事実想起プロンプトを通じて別途生成されたリファレンスと照らし合わせて、抽出された各主張を個別に検証する、軽量な2ステップの主張検証フレームワークを提案します。生成器と検証器は同じ基盤言語モデルを共有していますが、回答生成を事実想起から分離することで、直接的な回答条件付けを減少させ、自然言語推論(NLI)による検証時の確証バイアスを軽減します。また、NLIの信頼度スコア分布に対して τ = µ + kσ と定義される適応的な統計しきい値を適用し、矛盾する主張のみを選択的に修正します。固定された決定境界に依存する従来のNLIベースの手法とは異なり、提案するフレームワークは各回答の信頼度分布に合わせて検証しきい値を動的に適応させ、モデルの再学習を必要とせずに、評価したベンチマーク全体で一貫したパフォーマンスを示しました。TruthfulQAおよびFEVERでの評価において、本フレームワークはTruthfulQAのハルシネーション率を28%から9%に減少させ(相対的に67.9%の削減)、ベースラインのLLMに対してわずか160 msの追加レイテンシしか発生させず、ハルシネーション検出精度においてSelfCheckGPTやFActScoreを上回りました。これらの結果は、本フレームワークが評価ベンチマークにおいて事実の信頼性と回答レイテンシの良好なバランスを提供できることを示していますが、他のドメインや展開設定におけるさらなる検証が必要です。
概要
大規模言語モデル(LLM)は、現代の人工知能システムの基盤的なコンポーネントとして台頭しており、テキスト生成、質問回答、要約、複雑な推論を含む、幅広い自然言語タスクにおいて顕著な能力を示しています1。流暢で文脈的に一貫した回答を生成できる能力により、臨床意思決定支援、法的分析、ソフトウェアエンジニアリング、教育技術などの影響力の大きい領域での導入が加速しています2。しかし、これらの環境における信頼性を損なう、重大かつ根深い制限が存在します。それが「ハルシネーション(幻覚)」であり、モデルが言語的には流暢であるものの、事実として不正確、根拠がない、あるいは完全に捏造された回答を生成することを指します 3。実証研究では、タスクやモデルによって15%から40%以上のハルシネーション率が報告されており、GPT-4のような最先端のシステムであっても、ドメイン固有の評価において測定可能な事実的不一致を示しています2,3。この制限は、誤った出力が誤報、誤診、または欠陥のある意思決定につながる可能性がある、精度が極めて重要なアプリケーションにおいて深刻なリスクをもたらします4。ハルシネーションは、根本的に言語モデリングの確率的な性質から生じます。つまり、LLMは検証済みの事実的知識を検索したり推論したりするのではなく、入力シーケンスの統計的に可能性の高い後続トークンを予測することによって生成を行うためです5。その結果、生成された出力には、もっともらしく聞こえるが不正確な主張が組み込まれたり、根拠のない断定が導入されたり、あるいは意味的には関連しているが事実としては異なる概念が混同されたりすることがあります6。
既存の緩和策では、いくつかのパラダイムを通じてこの問題に取り組んでいますが、それぞれに顕著な限界があります。検索拡張生成(RAG)は、外部から検索したドキュメントに基づいて回答を生成することでハルシネーションを低減しますが、大幅なレイテンシのオーバーヘッドが発生し、整備されたナレッジベースへのアクセスが必要となるほか、専門的なドメインやリソースの少ないドメインにおける検索失敗に対して脆弱なままであります7,8,9。
応答生成器とリファレンス生成器は、いずれも同一の基盤となるGPT-3.5 Turboモデルを用いてインスタンス化されていますが、それぞれ異なるプロンプティング目的と実行コンテキストの下で動作します。応答生成器はユーザーのクエリに対して制約のない回答を生成する一方、リファレンス生成器は、 previously generated response(先に生成された応答)へのアクセスなしに、独立した事実想起タスクを実行します。この分離により、応答による直接的な条件付けの影響が軽減され、主張の検証時における確証バイアスが抑制されます。したがって、本フレームワークでは、生成されたリファレンスを統計的に独立しているのではなく、手順的に独立しているものとして扱います。
近年の研究では、外部リトリーバルや繰り返しの検証に頼ることなく、テキスト生成におけるハルシネーションを低減させる軽量なデコーディング戦略も探索されています。その代表的なアプローチの一つがDecoding by Contrasting Layers (DoLA)であり、これはデコーディング中にトランスフォーマーの中間層と最終層の表現を対比させることで、事実性を向上させます。生成後の検証フレームワークとは異なり、このような手法はトークン生成時に直接介入するため、言語生成プロセスの異なる段階を最適化することになります。これらの相補的な戦略は、ハルシネーションの軽減がデコーディング時または生成後の検証のいずれかによって達成可能であることを示しており、それぞれの手法が計算オーバーヘッド、実装の複雑さ、および事実的な信頼性において異なるトレードオフを提供しています。
自己整合性(Self-consistency)法は、複数の回答をサンプリングし、最も頻出または一貫性のある出力を選択することで事実としての信頼性を向上させますが、計算コストがサンプル数に比例して増大するため、低遅延が求められる運用には適していません8。自己フィードバックループを通じて出力を繰り返し修正する反復的洗練(Iterative refinement)アプローチは、段階的にエラー率を低下させますが、パスを増やすたびに推論時間が大幅に延びることになります9。NLI(自然言語推論)ベースの検証法は、生成された主張と参照テキストとの間の意味的含意(semantic entailment)を評価することで、より的を絞った代替案を提示しますが、既存の実装は固定された決定しきい値に依存しており、自信度の分布、ドメイン、またはモデルの挙動の変化に適応できないという課題があります10,11。総括すると、これらのアプローチは、許容できない計算オーバーヘッドを課すか、外部インフラに依存するか、あるいは汎用的な展開に必要とされる適応性に欠けています。これらのハルシネーション検証アプローチの主な特性の比較を補足表1(Supplementary Table 1)に示します。
本論文では、応答レイテンシを低く抑えつつ、LLMの出力におけるハルシネーションを低減するように設計された、軽量な2ステップの主張検証フレームワークを提案する。第1ステップでは、LLMが初期応答を生成し、それを原子的な事実的主張へと分解する。第2ステップでは、元の生成応答にアクセスしない独立した推論パスを通じて別途生成された事実参照を用いて、自然言語推論(NLI)により各主張を検証し、統計的に導出された信頼度しきい値に基づいて、主張レベルでの「採択」または「修正」の決定を行う。本研究の主な貢献は以下の通りである:(1) 応答生成と事実検証を分離した2ステップの主張レベル検証パイプラインを構築し、外部検索や応答全体の再生成を必要とせずに、各原子的主張の独立した標的型評価を可能にした点。(2) NLI信頼度スコアの分布に基づく適応的な統計的しきい値メカニズム(τ = µ + kσ)を導入し、固定の決定ルールに頼らずに採択と修正の境界を動的に決定することで、多様な信頼度分布における堅牢性を向上させた点。(3) 矛盾していると分類された主張のみに再生成を限定する選択的修正戦略を採用し、応答全体の再サンプリングや反復的な洗練手法と比較して、計算オーバーヘッドを大幅に削減した点。(4) ハルシネーションに特化したベンチマークによる実証的評価を行い、提案フレームワークが応答レイテンシを実用的な展開範囲内に維持しつつ、ハルシネーション率を28%から9%に低減させることを示した点。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
本研究では、ヒト参加者、動物、生物学的試料、または患者データは使用していません。したがって、機関の倫理承認およびインフォームドコンセントは不要でした。
研究デザインの概要
大規模言語モデル(LLM)の出力における事実的信頼性を向上させるため、2段階の検証フレームワークを実装した。この手順は、回答の生成、主張の抽出、独立参照の構築、自然言語推論(NLI)に基づく検証、適応的統計的意思決定、選択的修正、および最終回答の組み立てで構成される。本フレームワークの評価には、TruthfulQAおよびFEVERのベンチマークデータセットを用いた。
全体のワークフロー
ユーザークエリ → 初期回答の生成 → 主張の抽出 → 独立した参照文献の生成 → NLI検証 → 統計的閾値の算出 → 主張の修正 → 最終的な検証済み回答。適応的な主張検証フレームワークの全体的なワークフローを図1に示す。
データセットの準備
817件の事実に基づいた質問を含むTruthfulQAデータセット12をダウンロードし、評価に向けて準備した。 FEVERデータセット13は、「支持(Supported)」、「反駁(Refuted)」、「情報不足(Not Enough Information)」のラベルが付与された185,445件のアノテーション済み主張で構成されており、本評価では、主張、根拠、および正解ラベルのフィールドを持つラベル付き開発データを使用した。各主張は提供された根拠に照らして評価され、検証のための参照結果として元のFEVERラベルを保持した。事実検証用の主張・根拠ペアを含むFEVERデータセットを取得し、前処理を行った。入力される質問と主張は、標準化されたテキスト形式に変換した。実験前に、重複エントリおよび不完全なサンプルを除去した。TruthfulQAは検証用サブセットとテスト用サブセットに分割した。TruthfulQAサンプルの約20%(164件の質問)を閾値の調整に使用し、残りの653件の質問を性能評価用に確保した。FEVERについては、ベンチマークで提供されている主張をそのまま検証単位として使用し、TruthfulQAに適用した回答生成および主張抽出の手順は行わなかった。フレームワークの開発および評価に使用したベンチマークデータセットの特性を表1にまとめる。
初期応答の生成
各クエリをベース言語モデルに送信しました。回答は、温度0.7、top-p 0.9のニュークリアスサンプリングを用いて生成されました。最大出力長は256トークンに制限されました。生成された回答は、後処理や手動修正を行うことなく保存されました。生成されたテキストは、そのまま主張抽出段階へと送られました。
主張の抽出
生成された各回答は、独立して検証可能な事実記述へと分解されました。原子的な主張を特定するために、構造化された分解プロンプトが使用されました。複合的な記述は、最小限の事実単位に分離されました。主観的な意見、文体上の表現、および会話的なフィラーは除去されました。抽出された各主張は、独立した検証単位として保存されました。
例:
元の回答:
「マリ・キュリーはポーランド生まれの物理学者であり化学者で、放射能に関する先駆的な研究を行いました。」
抽出された主張:(1) マリー・キュリーはポーランド生まれである;(2) マリー・キュリーは物理学者であり化学者であった;(3) マリー・キュリーは放射能の研究を行った。
単離参照構築:
抽出されたすべての主張に対し、独立した事実参照が生成されました。検証モデルには元のユーザークエリのみが提供されました。確証バイアスを避けるため、生成された元の回答へのアクセスは制限されました。簡潔で根拠に基づいた回答を促すために、事実想起プロンプトが使用されました。生成された参照は、その後の検証のために保存されました。
自然言語推論の検証
各主張と参照文献のペアを、事前学習済みのNLIモデルに投入しました。NLIモデルは、その関係性を「含意(Entailment)」、「中立(Neutral)」、「矛盾(Contradiction)」のいずれかに分類しました。これら3つのクラスすべてに対する信頼確率を記録しました。その後、符号付きの検証スコアを割り当てました。含意の場合は正の値、中立の場合は0、矛盾の場合は負の値としました。閾値算出のため、すべての検証スコアを収集しました。
適応的統計閾値の算出
NLIモデルによって算出される検証信頼度は、クエリごとに生成される主張の数、意味的な複雑さ、および信頼度の分布が異なるため、回答によって大きく変動します。固定のグローバルしきい値を用いる方法は、すべての回答が同様の信頼度プロファイルに従うことを前提としていますが、実際にはそのようなケースは稀です。この変動に対応するため、提案されたフレームワークでは、各回答の検証スコアの平均値と標準偏差を用いて、回答ごとに個別に判定境界を推定します。平均値は回答全体の信頼度レベルを反映し、標準偏差は抽出された主張間の信頼度値の分散を捉えます。この適応的な定式化により、すべての入力に対して単一のしきい値に依存するのではなく、回答固有の不確実性に合わせて採択基準を調整することが可能になります。
すべての署名済み検証スコアの平均値(µ)および標準偏差(σ)を算出した。
適応的決定しきい値は次のように算出されました:

ここで、τは適応しきい値を表し、µは検証スコアの平均、σは標準偏差、kは感度パラメータを表します。
感度パラメータは0.7に初期化されました。スコアが+τ以上のEntailment(含意)として分類された主張は受理されました。スコアが−τ以下のContradiction(矛盾)として分類された主張は、修正対象としてマークされました。スコアが(−τ, +τ)の範囲内にある主張は、中立として保持されました。
選択的な請求項の補正
NLIモデルが主張と参照文献のペアを「矛盾(Contradiction)」と分類し、かつ対応する符号付き検証スコアが適応閾値基準 si ≤ -τ を満たした場合にのみ、その主張は修正のために転送されました。したがって、修正の決定はNLIのクラスラベルと回答固有の統計的閾値によって共同で決定されました。si ≥ τ で「含意(Entailment)」と分類された主張は受理され、一方で -τ < si < τ の範囲に収まる主張は中立として扱われ、修正せずに保持されました。この複合的な基準により、意味的な矛盾と十分に強い負の検証根拠の両方を示す主張にのみ修正が適用されることが保証されました。
反応の再構成
承認および修正されたクレームを元の順序で配置しました。可読性を維持するため、文の区切りを復元しました。必要に応じて軽微な文法調整を行いました。組み立てられた出力結果を、最終的な検証済み回答として保存しました。
性能評価
本フレームワークは、次の4つの指標を用いて評価されました:(1) 正解率(Accuracy):検証後に事実として正しいまま維持された回答の割合。(2) F1スコア(F1 Score):ハルシネーション検出の適合率と再現率の調和平均。(3) 回答レイテンシ(Response Latency):クエリの送信から検証済み回答の生成までの総処理時間。(4) ハルシネーション率(Hallucination Rate)
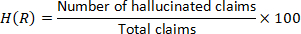
レイテンシは、繰り返し測定による平均実行時間として報告した。個々のランごとのレイテンシ値は保持しなかったため、標準偏差および信頼区間は算出していない。
ベンチマーク固有の正解性評価
TruthfulQAについては、最終的に検証された回答を、ベンチマークの人間に検証済みの正解リファレンスおよび不正解リストと比較しました。事実に関する主張が、承認された回答情報と一致し、かつ特定された不正解の回答パターンに該当する内容が含まれていない場合に、その回答を正解としてカウントしました。FEVERについては、最終的な出力に含まれる各主張を、関連する根拠および元のFEVERアノテーションに照らして評価しました。「Supported」の主張は事実として検証済みとして扱い、「Refuted」の主張は不正解としてカウントしました。「Not Enough Information」のケースは、肯定的な事実根拠として扱うのではなく、判定不能として保持しました。得られた主張レベルの判定を各ベンチマーク全体で集計し、報告されたAccuracy(正解率)およびHallucination Rate(ハルシネーション率)を算出しました。
実験環境
本フレームワークはPython 3.9を用いて実装されました。データ処理操作は、数値および表形式の解析ライブラリを使用して行われました。NLIモデルは、追加のファインチューニングなしで推論モードで動作しました。実験は、Intel Core i5プロセッサ、16 GB RAM、および64ビットオペレーティングシステムを備えたワークステーションで実行されました。低レイテンシ動作を確保するため、すべての評価はシングルパス推論設定で実施されました。データセットおよびベースライン手法間で一貫した評価を確保するため、すべての実験は同一のハードウェアおよびソフトウェア構成を用いて行われました。
期待される結果
本プロトコルは、根拠が不十分な可能性がある主張を特定し、強く矛盾する主張を選択的に修正に回すことで、主張レベルの検証判定を生成するように設計されています。期待される出力は、実験的評価で観察されたパフォーマンスに従い、事実上の不整合を減らし、かつ追加の処理オーバーヘッドを限定的に抑えた検証済みレスポンスです。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
初期応答の生成
ベースラインの言語モデルは、両方のベンチマークデータセットからの質問に対して、流暢で文脈に即した回答を生成しました。しかし、詳細な検証により、いくつかの回答に根拠のない事実誤認を含む記述があることが明らかになりました。TruthfulQAデータセットでは、ベースラインシステムのハルシネーション率は28%であり、FEVERデータセットでは26%のハルシネーション率が観察されました。これらの結果から、高い事実信頼性が求められるアプリケーションにおいて、単なる直接的な言語生成だけでは不十分であることが確認され、以降のすべての検証手順における比較対象となるベースライン条件が確立されました。
主張の抽出
主張抽出の手順により、生成された回答を独立して検証可能な事実単位に正常に分解することができた。TruthfulQAからの回答には平均3.2個の原子レベルの主張が含まれていたが、FEVERのサンプルは...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
提案されたフレームワークは、繰り返しサンプリングや外部検索を回避しつつ、事実検証の性能を向上させました。TruthfulQAにおいて、ハルシネーション率はベースラインのLLMの28%から、完全なフレームワークを用いた場合は9%まで低下し、一方で正解率は0.72から0.87へと向上しました。FEVERにおいては、ハルシネーション率が26%から10%に低下し、正解率は0.74から0.89に上昇しました。これらの比較は、あらゆる導入条件下での普遍的な優位性の証拠としてではなく、本研究で用いた実験設定および実装の範囲内で解釈されるべきです。本フレームワークは、独立した事実参照と選択的な修正を用いて、生成後の主張レベルの検証を行い、外部知識への根拠付け、繰り返しの推論、および軽量な生成後検証の間でトレードオフを実現しています。回答生成器と参照生成器は、どちらも基盤として同じGPT-3.5 Turboモデルを使用していますが、異なるプロンプティング目的と独立した実行コンテキストの下で動作します。参照生成器は元のクエリのみを受け取り、以前に生成された回答にはアクセスしません。したがって、これら2つの生成プロセスは統計的にではなく手続き的に独立しており...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者は、開示すべき利益相反がないことを宣言します。
謝辞
著者らは、本研究を遂行するために必要な学術的環境および計算リソースを提供した所属機関に対し、心より深く感謝いたします。また、提案したフレームワークの包括的な評価を可能にした、本研究で使用した公開ベンチマークデータセットの開発者および維持管理者に感謝いたします。さらに、本研究の質と明快さを向上させるのに役立った建設的なフィードバックをいただいた同僚および査読者に感謝いたします。また、実験、データ分析、および結果の可視化を容易にしたソフトウェアライブラリおよびツールを提供したオープンソースの研究コミュニティにも謝意を表します。彼らの継続的な取り組みは、自然言語処理および信頼できる人工知能の研究を大きく前進させました。なお、本研究において外部からの資金的な援助または助成金は受けていないことを宣言いたします。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| FEVERベンチマークデータセット | FEVER Shared Task (Thorne et al.) | https://fever.ai/dataset/fever.html | 評価に使用された、主張と根拠のペアからなる公開事実検証データセット |
| GPT-3.5 Turbo (大規模言語モデル) | OpenAI | Model ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | OpenAI APIを通じてアクセスし、応答生成器および独立した参照生成器の両方として使用 |
| NumPy | NumPy Developers (オープンソース) | https://numpy.org/ | NLI検証スコアの平均および標準偏差を含む統計計算に使用した数値計算ライブラリ |
| Openai (Python APIクライアントライブラリ) | OpenAI | https://github.com/openai/openai-python | GPT-3.5 Turboへのプロンプト送信および完了回答の取得に使用したPythonクライアントライブラリ |
| pandas | pandas Development Team (オープンソース) | https://pandas.pydata.org/ | データセットの前処理および結果処理に使用した表形式データ分析ライブラリ |
| 学習済み自然言語推論 (NLI) 分類モデル | Hugging Faceモデルハブ (MicrosoftのDeBERTa-v3-largeアーキテクチャに基づいたモデル) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | ファインチューニングなしで推論モードで使用し、各主張と参照のペアを含意、中立、または矛盾に分類 |
| Python | Python Software Foundation | Version 3.9; https://www.python.org/downloads/release/python-390/ | 検証フレームワークの実装に使用した基幹プログラミング言語 |
| SciPy | SciPy Developers (オープンソース) | https://scipy.org/ | 実験結果の統計分析をサポートするために使用した科学計算ライブラリ |
| Transformers (Hugging Face Transformersライブラリ) | Hugging Face | https://github.com/huggingface/transformers | 学習済みNLIモデルのロードおよび実行に使用したPythonライブラリ |
| TruthfulQAベンチマークデータセット | Lin, Hilton, および Evansにより当初リリース | https://github.com/sylinrl/TruthfulQA | 閾値調整および評価に使用された、817件の事実指向の質問からなる公開ベンチマーク |
| ワークステーションコンピュータ | 原稿に記載なし (メーカー/モデルを確認してください) | Intel Core i5プロセッサ; 16 GB RAM; 64ビットオペレーティングシステム | 同一構成で全ての実験を実行するために使用したハードウェア |
| 注:上記に記載されたすべてのURLは、本表の作成日時点で有効であることが確認済みです。 |
参考文献
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
再版と許可
この記事は公開されました
動画は近日公開