本論文では、二重に構築されたセッショングラフに基づくgated-slot linear attentionを採用した、セッションベース推薦のための新しいモデルであるgated-slot linear attention graph neural networksを提案します。本モデルは推薦の精度と効率を向上させ、3つの公開データセットにおいてSOTAを上回る性能を示しています。
この記事について
サマリー
要約
セッションベース推薦(SBR)システムは、現在のセッション内での行動シーケンスに基づき、ユーザーが次にインタラクトする可能性の高いアイテムを予測することを目的としています。Transformerのアテンションメカニズム(例:GC-SAN)を活用した最近の手法は、従来の手法よりも優れた性能を示していますが、セルフアテンションの計算コストが二次関数的に増大するため、計算負荷と空間複雑性の増大という課題があります。これらの制限に対処するため、線形アテンションに学習可能なゲーティングメカニズムと、gated-slot attentionに着想を得たスロットベースのメモリ更新戦略を統合したGSLA4Rec(gated‑slot linear attention graph neural networks for session‑based recommendation)という新しいモデルを提案します。具体的に、GSLA4Recではまず、セッション内のアイテム遷移を捉えるためのセッショングラフと、セッション間の協調信号をエンコードするためのネイバーグローバルグラフの2つのグラフを構築し、局所的およびグローバルなコンテキスト情報の両方をモデル化します。提案手法の中核となるgated-slot linear attentionメカニズムは、(1) ゲーティングユニットを用いて、長いセッションにおける無関係または冗長なインタラクションからのノイズを抑制し、(2) スロットユニットを利用してコンパクトなセッション表現を動的に保存および更新することでメモリオーバーヘッドを削減し、(3) セルフアテンションを線形アテンションに置き換えることで線形時間複雑性を実現します。これらのコンポーネントを組み合わせることで、進化するユーザーの関心を捉える際の予測精度と効率が大幅に向上します。Diginetica、Tmall、NowPlayingを含む複数の公開ベンチマークデータセットを用いた広範な実験により、GSLA4Recが推薦性能において既存のSOTA SBR手法を一貫して上回ることが実証され、GSLAメカニズムの有効性が確認されました。
概要
オンラインサービス(電子商取引、短尺動画プラットフォーム、ニュースフィードなど)の急速な発展に伴い、情報オーバーロードの問題がますます顕著かつ深刻になっています。レコメンダーシステム1,2は、ユーザーの行動データを深く分析することで、パーソナライズされた精緻な情報プッシュサービスを提供します。しかし、匿名アクセス、未ログインユーザー、プライバシー保護、短いインタラクション時間などを特徴とする多くの実用的なアプリケーションにおいて、協調フィルタリング3や行列分解4,5といった従来の推薦手法では、推薦アルゴリズムの適用可能性が大幅に制限されます。これらの課題を解決するために、SBR6,7,8,9が登場しました。SBRは、ユーザーの現在のセッション内におけるインタラクションシーケンスデータに着目し、次に興味を持つ可能性のある地点を予測します。このパラダイムは、長期的なユーザー履歴データへの依存を回避できるだけでなく、短期的な動的関心の変化を鋭敏に捉えることができるため、電子商取引、短尺動画、音楽推薦などのシナリオにおいて独自の応用価値を示しています。
初期の手法は主にマルコフ連鎖5,10,11,12に依存して、セッションシーケンス内のアイテム間の遷移確率をモデル化していました。これらの手法は一次のシーケンス依存性を捉えることはできましたが、ユーザーの関心における複雑な高次依存性や非線形ダイナミクスの特性評価は限定的であり、複雑なシナリオにおけるモデルの有効性が制限されていました。ディープラーニング技術13,14の発展に伴い、ニューラルネットワークベースの手法がSBRに広く適用されるようになりました。GRU4REC15は、リカレントニューラルネットワーク14 (RNNs) をセッションベース推薦に適用した最初の手法であり、シーケンス内の時間的依存性を効果的に捉えました。NARM16は、アテンションメカニズムをRNNsに統合することで、コアユーザーの関心をマイニングする能力をさらに強化しました。STAMP17は、多層パーセプトロン (MLPs) とアテンションメカニズムを組み合わせて、ユーザーの短期的な関心の捕捉に重点を置きました。これらの手法はシーケンスモデリングにおいて一定の進展を遂げたものの、長期依存性の処理の困難さやノイズへの感度といった課題に依然として直面していました。
近年、グラフニューラルネットワーク(GNN)18,19,20,21は、SBRタスクに新たな視点をもたらしました。SR-GNN22などのモデルは、セッショングラフ(SG)を構築することで複雑な遷移関係を明示的にモデル化し、推薦精度の大幅な向上を実現しています。しかし、既存のGNNベースの手法の多くは、個々のセッション内でのグラフ構築とメッセージパッシングを行っており、グローバルなアイテム相関情報を効果的に活用できていません。この課題に対処するため、GCE-GNN23は、近傍グローバルグラフ(NGG)を構築し、セルフアテンションメカニズムを用いてグローバルセマンティクスとセッショングラフを統合することで、アイテムの重要性を適応的に重み付けし、大幅なパフォーマンス向上を達成しました。それにもかかわらず、既存のGNNベースの手法には依然として2つの大きなボトルネックが存在します。第一に、セルフアテンションメカニズムの計算複雑性がセッション長に対して二次関数的に増大するため、長いセッションを処理する際に膨大な計算オーバーヘッドが発生することです。第二に、従来のGNNは情報集約時にアイテムの重要性を動的に調整する能力に欠けており、ノイズと重要な行動を区別することが困難であり、それが表現品質に影響を及ぼしていることです。
これらの課題に対処するため、本論文ではセッションベース推薦のためのゲート付きスロット線形アテンショングラフニューラルネットワーク(GSLA4Rec)を提案する。(1) ゲーティングを通じてノイズをフィルタリングし、セッションスロットに重要な意味情報を保存するゲート付きスロットメカニズムを設計することで、モデルの堅牢性を高め、ストレージオーバーヘッドを削減する。(2) 線形アテンションメカニズムを導入し、長距離依存性をモデリングする能力を維持しつつ、計算複雑性を O(N2) から O(N)(Nはセッション長)に削減する。(3) 3つの公開ベンチマークデータセット(Diginetica、Tmall、NowPlaying)を用いて広範な実験を行い、GSLA4Recが既存のSOTA手法を大幅に上回ることを示し、特に長いセッションやスパースなシナリオにおいて明確な優位性を実証する。
プロトコル
セッションベース推薦の体験
セッションベースの推奨は、SBR、グローバルコンテキスト学習、およびGSLAという3つの観点から検討することが可能です(材料表を参照)。本研究では、ヒト被験者および動物は関与していません。本研究で使用したすべての実験データセットは公開されており、補足ファイル:GSLA4Rec. zipとして提出されています。
セッションベース推奨
セッションベース推薦(SBR)は、マルチターン自然言語対話を通じてユーザーと相互作用し、ユーザーの好みを動的に把握してパーソナライズされた推薦を提供する人工知能システムでした。SBRは、従来の手法からディープラーニングベースおよびハイブリッドアプローチへと進化し、その後、大規模言語モデル(LLM)ベースのソリューションへと発展しました。
従来のセッションベース推薦
従来のSBR(順序ベース推薦)は、通常、マルコフ連鎖に基づく手法や協調フィルタリングによって表現されていました。前者は、ユーザー固有の確率遷移行列を分解することで推薦を生成します。例えば、Guy Shani24は、対応する行列を分解して推薦を生成するマルコフ決定過程に基づく推薦手法を提案しました。また、Wanrong Gu25は、マルコフ連鎖に購入時間間隔を統合することで、推薦性能を向上させました。後者は、行列分解を通じて隣接するインタラクションアイテム間の潜在的な順序関係を抽出することで推薦を生成します。例えば、Sarwar B1は、ユーザーの過去の行動(スコアやクリックなど)に基づいてアイテム間の類似度を算出し、ユーザーの過去の好みに一致するアイテムを推薦しました。もしユーザーAがアイテムaを好み、アイテムcがaと非常に類似している場合、システムはAにcを推薦します。Rendle S5は、行列分解とマルコフ連鎖を組み合わせた順序推薦モデルであるFPMCを提案し、隣接するインタラクションアイテム間の潜在的な順序関係を捉えました。しかし、このような従来のSBRは隣接アイテム間の順序関係に焦点を当てていたため、複雑な依存関係をモデル化することが困難でした。
ディープラーニングを用いたセッションベース推薦
ディープラーニングを用いたセッションベース推薦(SBR)は、畳み込みニューラルネットワーク(CNN)26,27,28,29、RNN、およびGNNを含む段階を経て進化してきました。CNNベースのSBRでは、畳み込みやプーリングなどの操作を利用して各セッションコンテキストの表現を学習し、それを後続の推薦に使用します。Caser30では、ユーザーが最近インタラクトしたL個のアイテムを埋め込み層を介してd次元ベクトルに変換し、時間軸および潜在空間にマッピングされた「画像」として扱う埋め込み行列を形成しました。その後、ポイントレベル、スキップなしのユニオンレベル、1回スキップありのユニオンレベルという3つのシーケンスパターン畳み込みフィルタを用いてシーケンシャルパターンを学習し、SBRのパフォーマンスを向上させました。Tuanら31は、3D畳み込みカーネルを用いてセッションのクリックストリームとコンテンツ特徴量を一律にモデル化し、時空間的なコンテンツ統合表現を構築しました。
RNNは、シーケンシャルデータの処理に特化して設計されたニューラルネットワークアーキテクチャの一種であった。その核心となる概念は、長短期記憶(LSTM)ネットワークなどの再帰的構造を通じて、時間的な依存関係を捉えることであった。13 およびゲート付き回帰ユニット(GRU)32、そして自然言語処理(NLP)などの分野で広く利用されていました。33, 音声認識34テキスト翻訳35, 旅行36,37犯罪38, および将来のトレンド予測39 (例:トラフィック)40, 株式市場41,42、および気象学43Hidasiらによって提案されたGRU4Recは、SBR研究における画期的な成果であり、SBRに初めてRNNを導入し、GRUを用いてユーザーの系列的な行動パターンを捉えることで、パーソナライズされた推薦を実現しました。
GNNs44は、グラフ構造データ内の複雑な関係性をモデル化する上で強力な表現力を示しており、一部の研究者はセッション内またはセッション間の複雑な遷移をモデル化するためにGNNsを導入した。GNNsのモデルアーキテクチャの違いに基づき、SBR向けのGNNsベースの手法は、一般的にゲート付きグラフニューラルネットワーク(GGNNs)45、グラフ畳み込みネットワーク(GCNs)46、およびグラフアテンションネットワーク(GATs)47に分類される。SR-GNNは、セッションシーケンスを有向グラフとして表現し、GGNNsを用いてセッション内の複雑なアイテム遷移関係を捉え、さらにアテンションメカニズムを組み合わせて最終的なセッション埋め込みを得ることで、推薦性能を向上させた、SBRにGNNsを適用した最初の手法であった。Chen L48は、構造化属性と非構造化キーワードを組み合わせて多次元的な製品関連性をモデル化するマルチビューGNNsフレームワークを提案し、SBRの精度を向上させた。Driss E49は、カプセルグラフニューラルネットワークを採用して複雑なアイテム特徴を捉え、SBRの予測精度を高める革新的なセッション推薦システムを設計した。
前述のディープラーニング手法は、SBRの研究範囲を広げ、パフォーマンスを効果的に向上させましたが、依然としていくつかの制限がありました。主に以下の点に現れています。1) 新しく出現したアイテムや非常に疎なセッションにおいて、グローバルなコンテキストが不足しているため、モデルが正確な予測を行うことが困難であったこと。2) すべての履歴セッションに含まれるグローバルなパターンを活用できなかったことです。
ハイブリッド・セッションベース推薦
ハイブリッド・セッションベース推薦は、協調フィルタリング、ディープラーニング、アテンション機構など、異なる手法の強みを統合することでSBRの性能を向上させています。GC-SAN50は、SR-GNNに基づいたセルフアテンション機構を組み込むことで、セッション内における重要なアイテムのインタラクション情報をより適切に捉えています。FGNN51は、マルチヘッドアテンション機構を通じて近接アイテムからの情報をさらに集約し、ターゲットアイテムの多様な関係性を学習しました。SR-HetGNN52は、異種グラフを用いたSBRに分類されます。複数タイプのアイテム(ユーザー、アイテム、セッション)と多重関係のエッジ(クリック、購入、共起、属性関連付け)を導入することでグローバルな知識ネットワークを構築し、単一のアイテムシーケンスという制限を打破しました。これは近年、匿名ユーザーの行動やセッションをまたいだ興味の関連性をモデル化するための重要な手法となっています。KGSR-SAP53は、アイテムを多重関係のエッジで接続して知識グラフを構築し、多様なユーザー・アイテム間インタラクションを記述することで、グローバルグラフが1種類のエッジ(ユーザー・アイテム間インタラクション)しか含まないことによる情報損失の問題を解決しました。Wang ZH54は、拡散ベースのセッション推薦モデルであるDiffSBRを提案しました。これはノイズ除去をシミュレートすることで信頼性の高い次項アイテムの好みを生成し、動的なユーザー・クリックシーケンスのモデル化を改善しています。Qiao ST55は、マルチビュー意図学習とLLMアライメントを組み合わせたSBRフレームワークを構築しました。これにより、多様な視点からユーザーの潜在的な意図を掘り起こし、言語モデルを活用して意味的特徴をアライメントさせることで、推薦性能のさらなる向上を実現しました。
グローバルコンテキスト
「セッションを単独で閲覧する」という欠点を克服するため、研究者は、グローバル情報を利用して現在のセッションの表現能力を高めることで、従来のSBRにおけるデータ疎性、コールドスタート、およびセマンティックギャップなどの問題を解決できることに気づきました。同時に、グローバルコンテキストを構築する際、ノイズ干渉を最小限に抑えつつ、グローバル情報を単一のセッションに統合することが求められました。CSRM56は、現在のセッションと隣接セッション間の協調情報を統合し、外部メモリエンコーダ(OME)を用いて協調情報から協調的意図を抽出することで、セッションレベルの表現を最適化しました。CA-TCN57は、クロスセッションを意識した時間畳み込みネットワークモデルを提案し、グローバルグラフとセッションコンテキストグラフを構築して、アイテムおよびセッションに対するクロスセッションの影響をシミュレートしました。同時に、時間畳み込みネットワーク(TCN)は拡張畳み込みを通じて受容野を拡大し、層数によって指数関数的な長さのシーケンスをカバー(受容野 = )することで、RNNの勾配消失問題を解決しました。Chen58は、ハイパーグラフニューラルネットワークに基づくSBR手法(SR-HGNNs)を提案しました。これは、混合次数(低次および高次)の伝播とアテンションメカニズムを統合することで、短いセッションにおける従来のGNNの過剰平滑化問題を解決し、異なる伝播次数の重要性を区別し、依存関係をより正確に捉えてノイズ干渉を回避できるものです。GCE-GNNは、多次の共起アイテムペアを用いて無向重み付きグラフを構築し、アイテムの共起頻度をカウントしてセッション内でのアイテムの重要性を反映させました。AGNN-GC59は、クロスセッションのアイテム遷移関係を用いてグローバル協調グラフを構築し、グローバルグラフ内でのアイテム遷移確率を計算してセッション内での興味の変化を反映させました。DA-GCN60は、最短経路を用いて隣接行列を更新し、動的重み付きグラフを構築することで、グローバルグラフの共起頻度とアイテム間の経路距離を計算しました。以上の文献に着想を得て、本論文では、近傍ベースの手法、すなわちJaccard類似度係数を用いて類似セッションを算出することでグローバルグラフを構築することを提案しました。これにより、グローバル情報を活用するだけでなく、ノイズ(無関係なアイテム)をフィルタリングし、グローバルコンテキストを正確に構築するという目的を達成し、後続のSBRアルゴリズムのための強固な基礎を築きました。
ゲート付きスロット線形アテンション
従来のトランスフォーマー61は、以下のように、シーケンス全体にわたる全結合アテンション操作が必要なため、高い時空間計算複雑性を伴っていました:
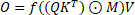 (1)
ここで、Q、K、V ∈ RN×dは入力項目の線形変換であり、M = {Mij = 1 if i ≥ j, o.w. −∞ }は将来の情報漏洩を防ぐための因果マスクであり、⊙は要素ごとの積を、fは活性化関数softmaxを表した。
線形アテンション62を実現するための最も直接的なアイデアは、活性化関数であるsoftmaxを削除することでした。しかし、活性化関数softmaxを単純に削除すると、線形アテンションは確実に潜在的な問題を引き起こします。すなわち、ニューラルネットワークの強力な表現力が失われ、複雑な現実世界の問題を解決できなくなることです。
有界メモリ制御を備えたスロット線形アテンション
活性化関数softmaxを保持する必要があるという想定の下、KとVはそれぞれK̃、Ṽ ∈ Rm×dへと圧縮されました。メモリネットワークの観点からは、K̃とṼはシーケンスとともに長さが増加するメモリスロットを持っており、すなわちスロット数 m = Nとなっていました。もしmが固定されていれば、線形化は明らかに可能です。Bounded-memory Control63に着想を得て、長さNの入力項目の各トークンを、m個のスロットに競合的に書き込む必要があるとしました。
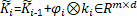 ,
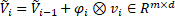 ,
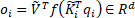 (2)
ここで、fは活性化関数softmaxであり、φiは以下のようにキー値kiを制御するための有効入力を制御するベクトルであった。
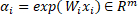 ,
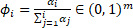 (3)
ここで、(φi)jはi番目のトークンからj番目のスロットへの書き込み強度を表しており、これは累積ソフトマックス関数を用いて算出されました。
効率的な線形計算を実現するために、式(2)を式(4)へと書き換え、{οi|i=1T, qi, ki, vi)|i=1T}を用いてqi、ki、viからοiを算出(式4)し、2パスの逐次計算を採用した:
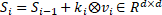 ,
 (4)
したがって、SLA操作を導き出すことができます:
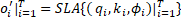 ,
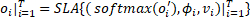 (5)
oi′ ∈ ℝmであり、οi ∈ ℝdである。したがって、SLAはハードウェア効率の高い線形時間チャンク単位の学習を実現できる64。
ゲート付きスロット線形アテンション
有界メモリ制御を備えたスロット線形アテンションは、計算量および空間的な複雑さを低減できる可能性があります。しかし、情報の蓄積はセッションインタラクションにノイズ情報を混入させる可能性もあるため、情報を選択的に保持および忘却するためのデータ依存的な減衰が非常に重要であり、この選択的メカニズムは近年の選択的状態空間モデル65で再検討されています。データ依存性を備えたGSLAは、次のように表現できます:
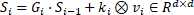 ,
 (6)
ここでは、減衰ゲートは外積形式 Gi = αi ⊗ βi、αi, βi ∈ [0,1]d によってパラメータ化されました。以下では、通常 βt = 1 と設定し、行列乗算を用いることで、GSLAを次のような等価な形式で記述することも可能です64:
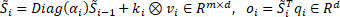 (7)
αi と ki がそれぞれ忘却ゲートと入力ゲートを表す場合、ゲート付きRNNに関する文献に基づき、これら2つのゲートを ki = 1 − αi として結合させることが可能です。GSLAは、式(8)に示すように、2パスの逐次計算で定式化できることが明らかになりました。この2次構造はブロック並列トレーニングをサポートしてトレーニング効率を向上させ、また、2次構造の中間にsoftmax操作を挿入することで、有限スロットメモリのモデリング能力が高められました。
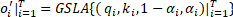 ,
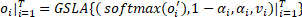 (8)
セッションデータの変換
問題の定義
与えられたセッションシーケンスをS = {v1s, v2s, ⋯, vns}とし、ここでvisはi番目にクリックされたアイテムを表します。このシーケンス内におけるユーザーのクリック動作を分析することで、システムはユーザーが次に興味を持つ可能性のあるアイテムvn+1sを予測しました。
グラフの構築
セッショングラフの構築
セッション S = {v1s, v2s, ⋯, vns} に対して、有向グラフ Gs = (Vs, εs) を構築した。ここで、Vs は与えられたセッション S のアイテム集合であり、εs = {eijlocal|vi, vj, vi, vj ∈ Vs} は与えられたセッション S のエッジ集合である。ε(vi-1s, vis) は、このセッション内で連続してクリックされたアイテムを表す。エッジ eijlocal は、ein、eout、ein-out、eself の4つのタイプに分類できる。シーケンス内に同一のアイテムが繰り返し現れる可能性があるため、各エッジの重み付け値を集計した。
現在のセッション s = [v1, v2, v4, v2, v3]は、~に示されるように、SGに変換された。 図1A.
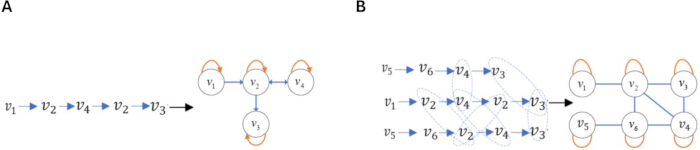
図 1: インタラクティブアイテムのグラフ構造への変換。(A) セッションをグラフに変換することによるセッショングラフ(SG)構築の模式図。(B) 多くのセッションを1つのグラフに結合することによる近傍グローバルグラフ(NGG)構築の模式図。本図はVisioを用いて完全にカスタマイズされた要素で作成されました。著作権のある外部グラフィックリソースは使用されていないため、第三者の著作権ライセンスは不要です。図の著作権は著者に帰属し、受理時にジャーナルの著作権規定に従います。この図の拡大版を表示するには、ここをクリックしてください。
ネイバー・グローバルグラフの構築
現在のセッション S に基づき、クロスセッション形式で現在のセッションの表現学習を強化するために、対応するNGG Gg = (Vg, εg) を構築した。Vg は Gg 内のすべてのアイテムを含むアイテムセットであり、εg = {eijglobal|vi, vj, vi, vj ∈ Vg} は Gg のエッジセットである。ε(vi-1g, vig) は、NGG Gg において直接的に相互作用するアイテム vi-1g と vig を表す。このプロセスは、近傍セッションの取得とNGGの構築という2つのステップで構成される。
隣接セッションの取得
データセット全体を通じて、現在のセッションと共起するアイテム数が最大であるセッションを探索した。共起回数が上位N件のセッションを選択し、候補隣接セッション集合Sを構築した。その後、式(9)に示すように、Jaccard類似度係数を用いて、現在のセッションcuと候補集合Sから得られたセッションSr ∈ Sとの間の類似度を算出した。
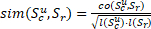 (9)
ここで、co(Scu, Sr)はScuとSrの両方に同時に出現する項目の数を表し、l(Scu)およびl(Sr)はそれぞれScuとSrの長さを表しており、ScuとSrは現在のセッションと隣接セッションを示しています。ある閾値(ハイパーパラメータとして設定可能)を下回る類似度のセッションは除外され、残りのセッションが現在のセッションに対する隣接セッション集合Nsを構成しました。
Neighborグローバルグラフの構築
隣接セッション集合 Ns に基づいて、図1Bに示されるようにNGGを構築した。隣接行列の構築において、2つのアイテム(vi, vj)間に相互作用があった場合、対応するエントリ Aij を1に設定し、そうでない場合は0に設定した。さらに、アイテム間の相互作用は無向として処理し、セルフループを付加した後、表1に示すように正規化を行った。
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
表1:近傍グローバルグラフの正規化隣接行列。この表は、構築された近傍グローバルグラフにおけるノード間の重み付き接続を示す正規化隣接行列である。
セッションベース推薦アルゴリズムの設計
このセクションでは、提案された革新的なモデルであるGSLA4Recについて詳しく説明します。GSLA4Recは、SGとNGGの共同特徴表現にGSLAメカニズムを導入することで、SBRのパフォーマンスを向上させました。
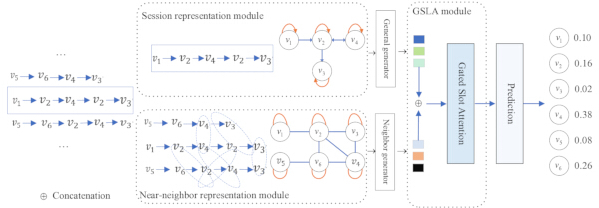
図 2: GSLA4Recフレームワーク。このフレームワークは、セッショングラフと近傍グローバルグラフの構造学習を統合し、ゲーティングメカニズムによってインタラクションノイズをフィルタリングし、メモリスロットメカニズムによってストレージと効率のバランスをとり、線形アテンションメカニズムによってアイテムの関連性を捉えることで、ユーザーの次のクリック嗜好を予測します。この図はVisioを用いて完全にカスタマイズされた要素で作成されました。著作権のある外部グラフィックリソースは使用されていないため、第三者の追加の著作権ライセンスは不要です。図の著作権は著者に帰属し、採択時にジャーナルの著作権規定に従います。GSLA4Recは、SBRのためのgated-slot linear attention graph neural networksを表します。こちらのリンクから、この図の拡大版をご覧いただけます。
図 2に、GSLA4Recのフレームワークを示す。本フレームワークは主に以下の4つのコンポーネントで構成される:1) セッションレベルのアイテム表現:SGにGNNsモデルを適用し、現在のセッション内におけるセッションレベルのアイテム埋め込みを学習する。2) 近傍グローバルレベルのアイテム表現:NGGに基づき、GRUを用いて各アイテムの近傍埋め込みを再帰的に組み込むことで、全セッションにわたるグローバルレベルのアイテム埋め込みを学習する。3) GSLA:学習したセッションレベルおよびグローバルレベルの両方のアイテム表現を集約することで、現在のセッションにおけるユーザーの嗜好をモデル化する。4) 予測層:候補アイテムに対する予測確率を出力する。これら4つのコンポーネントについて、以下に詳細を述べる。
セッションの表現
SBRにおいて、ユーザーのインタラクション行動を理解することは極めて重要でした。この目的を達成するため、セッション表現学習のためのSGおよびNGGを構築し、ユーザーのインタラクション行動を包括的に把握することで、ユーザーのより真正な意図を捉えることを目指しました。
セッションレベルのアイテム表現
図1AのSGに基づき、SGの特徴を抽出するために重み付き双方向グラフアテンション(Weighted Bidirectional Graph Attention; WBGAT)法を採用した。この手法は、標準的なGATメカニズムに基づきエッジの重みと項目の方向性(インネイバーおよびアウトネイバー)を導入したものであり、重要なエッジを強化し、双方向の依存関係を捉える効果を実現した。これにより、非対称な項目関係や相互作用の強度に関する従来のGATの欠点が解消された。計算プロセスは以下の通りである:
まず、項目の入次数正規化ウェイトを算出します。
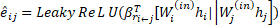 (10)
ここで、eijはアイテムjの特徴からアイテムiへの1次近傍重みを示し、 はアイテムiとアイテムjの間の関係を、β* ∈ ℝdは重みベクトルを、hiおよびhjはそれぞれアイテムiおよびjの表現を、Wi(in) ∈ ℝd*dおよびWj(in) ∈ ℝd*dは学習可能なパラメータを、||は結合操作を表している。異なる入次数関係を区別するために、2つの重みベクトル、すなわちrinとrin-selfを学習させた。活性化関数にはLeakyReLUを採用した。
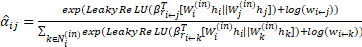 (11)
異なるアイテム間で係数を比較可能にするため、アテンション重みはsoftmax関数によって正規化されました。Ni(in)をアイテムiの1次イン隣接セットとし、 をSGにおける有向エッジ(i←j)のイン隣接重みとすると、この手法により、エッジ重みの対数をとり、それを元のアテンションスコアeijに加算することで、グラフ構造固有の接続強度情報を保持しつつ、アイテムの特徴量間の相関をモデルに学習させることが可能となりました。
次に、アイテムの出次数正規化重みを算出します。
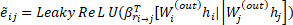 (12)
ここで、ẽijはアイテムjの特徴からアイテムiへの1次アウトネイバー重みを示し、 はアイテムiとjの間の関係であり、2つの重みベクトル、すなわちroutとrout-selfを学習させた。
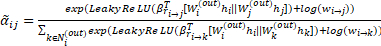 (13)
ここで、Ni(out)はアイテムiの1次出隣接集合であり、 はSGにおける有向エッジ(i→j)の出隣接重みである。
第三に、情報の集約です。アイテム i の1次入次数および出次数のエンベディングに重み付けを行い、それらを合算することで、アイテムの更新されたエンベディングを取得できます。
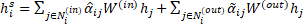 (14)
 およびα̃ijはそれぞれアイテムiの入次数ウェイトと出次数ウェイトを表し、
 は更新されたアイテムiの表現を表す。
近傍グローバルレベル項目表現
近年の研究では、グローバルグラフを構築することでデータ表現を強化し、それによってSBRの性能を向上させることができるという点について一貫して合意されており、これは疑いの余地がありませんでした。しかし、グローバルにデータを強化すると、ノイズなどの無関係な情報が導入される可能性もあります。提案モデルでは、ノイズを最大限に抑えつつグローバルなデータ拡張を実現するために、近傍グローバルグラフを構築しました。
図1BのNGGおよび表1の正規化隣接行列に基づき、現在のセッションおよびその隣接セッションをNGGに変換し、GGNNs45法を用いてNGGの特徴を抽出しました。NGGにおけるアイテムベクトルの学習プロセスを式(15)に示します。
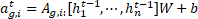
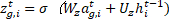
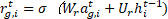
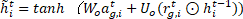
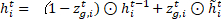 (15)
W ∈ ℝd×2dは制御重みを、zg,iおよびrg,iはそれぞれ更新ゲートとリセットゲートを表す。 [h1t-1, ⋯, hnt-1]はセッションsにおけるすべてのアイテムベクトルのリストを表す。σ(x) = 1/(1 + e-x)はロジスティックシグモイド関数であり、⊙は要素ごとの積を、hi ∈ ℝdはゲート更新後のベクトルを表す。隣接行列As ∈ ℝn×nは隣接するセッション間のアイテム間の接続性を示し、As,i: ∈ ℝ1×nは隣接行列におけるアイテムvs,iに対応する列ブロックAsを表す。現在のセッションs = [v1, v2, v4, v2, v3]について、NGGおよび正規化隣接行列をそれぞれFigure 1BおよびTable 1に示す。
項目の表現
アイテム表現は、式(16)に示すように、セッションレベルのアイテムベクトルと近傍グローバルレベルのアイテムベクトルを合算することで得られました:
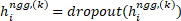
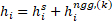 (16)
過学習を軽減するために、グローバルレベルの近傍アイテム表現にドロップアウトを適用しました。
ゲート付きスロット線形アテンション
本論文におけるゲート付きスロット線形アテンション(GSLA)は、有界メモリ制御とデータ依存ゲート機構を備えた線形アテンションを統合したものである。一方で、アテンションベースコントローラ(ABC)モデルの有限メモリスロット機構を継承し、本来はシーケンス長に伴って増加するキー・バリューペアを固定数のスロットに圧縮し、各スロットを競合的書き込みによって更新することで、Transformerのグローバルアテンションにおける計算複雑性の問題に対処した。他方で、GLAと同様のきめ細かなゲート機構を導入し、忘却ゲート αi を通じて入力データが履歴情報の保持率を動的に調整するようにすることで、ABCにおいて忘却機構が欠如していたために生じていたノイズの問題を解決した。
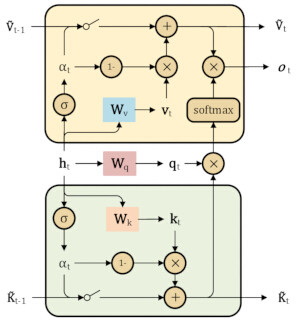
図 3: GSLA の概略図。入力ベクトルは、それぞれクエリベクトル、キーワードベクトル、およびバリューベクトルにマッピングされ、その後、有界メモリ制御を備えた線形アテンションとデータ依存ゲート機構によって処理され、更新されたクエリベクトル、キーワードベクトル、バリューベクトル、および出力ベクトルが得られる。この図は Visio を使用し、完全にカスタマイズされた要素を用いて自作したものである。著作権で保護された外部のグラフィックリソースは使用していないため、追加の第三者著作権ライセンスは不要である。図の著作権は著者が所有しており、受理後はジャーナルの著作権規定に従うものとする。GSLA は gated-slot linear attention を表す。この図の拡大版を表示するには、ここをクリックしてください。
図 3で具体的に実装されているように、入力ベクトルはクエリベクトル、キーベクトル、およびバリューベクトルに個別にマッピングされました64:
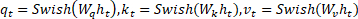 (17)
ここで、Wq、Wk、Wv ∈ ℝd×dは、それぞれクエリ、キー、バリューに対応する変換重み行列を表し、htはセッション入力シーケンスにおけるt番目のタイムステップにおける埋め込みベクトルを示した。Swish関数はSwish(x) = x · σ(x)と定義され、自己ゲート付き活性化関数である。ここでσはシグモイド関数であり、この関数は複数のディープラーニングタスクにおいて従来のReLU活性化関数よりも優れた性能を示した。
GSLAでは、入力データに応じて忘却ゲート αi と入力ゲート 1 − αi を利用し、i番目のメモリスロット内の情報を動的に更新しました。そのプロセスは以下の通りです64:
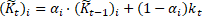 (18)
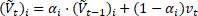 (19)
ここで、K̃t および Ṽt はタイムステップ t におけるキーベクトルスロットとバリューベクトルスロットを表し、K̃t-1 および Ṽt-1 はタイムステップ t−1 におけるキーベクトルスロットとバリューベクトルスロットを表します。忘却ゲートは αi = σ(Wαht)1/τ であり、ここで Wα ∈ ℝd は変換重み行列、σ はシグモイド関数、そして τ は忘却ゲートのソフトネスを制御するために用いられる減衰係数(通常は 8 に設定)です。これにより、GSLA は過去情報の忘却率をスムーズに調整することが可能になります。すなわち、αi が大きいほど GSLA は過去情報に依存し、αi が小さいほど GSLA は現在の入力に重点を置きます。
t番目のステップにおけるキーベクトルスロット K̃t およびバリューベクトルスロット Ṽt は、式(20)および(21)65に示すように行列形式で記述されました:
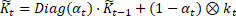 (20)
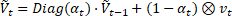 (21)
次に、2次特性を持つGSLA(式(8)を参照)を用いて、各タイムステップ i ∈ [1, …, T] に対する出力 oi |i=1T を算出した。各タイムステップの出力に線形変換を適用し、結果 h̃t を得た。最終的に、セッションシーケンス内の全アイテムの表現の平均値を計算し、動的メモリ更新を伴うセッション埋め込み S̃e を生成した。
 (22)
 (23)
ここで、otはタイムステップtにおけるGated-Slotの出力を表し、h̃tはotに線形変換を適用した結果を示しています。S̃eは、全タイムステップにおけるh̃tの平均値を示しています。
予測層
得られたセッション表現 S̃e とアイテム i の初期埋め込みに基づき、内積演算を行い、各候補アイテム hi のスコアを算出した。その後、ソフトマックス関数を用いて、候補アイテム i の推薦確率を求めた:
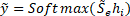 (24)
ここで、ỹは候補アイテムの推奨確率を、hiは候補アイテムのベクトルを表し、モデルの学習にはクロスエントロピー損失関数が用いられた。
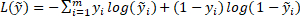 (25)
ここで、yは正解ラベルのワンホットエンコーディング表現である。
結果
データセットと前処理
本実験では、モデルの性能を評価するために、実際のアプリケーションシナリオにおける実取引データから得られた3つの公開SBRデータセットを選定した。CIKM Cup 2016コンペティションから抽出されたユーザーの取引およびクリックレコードを含むDiginetica、Tmallプラットフォームのユーザーログであり、ユーザーの閲覧および購入行動を記録したTmall、そして音楽プラットフォームにおけるユーザーの再生履歴に関する音楽レコードを含むNowplayingである。これらのデータセットはSBR研究で広く使用されており、モデルの有効性と適用性を包括的に評価することが可能である。
データ前処理段階において、データ品質の一貫性を確保するためにデータセットの標準化を行いました。具体的には、長さが 2 未満のすべてのセッションをフィルタリングして除外し、出現回数が 5 回未満のアイテムを削除しました。さらに、各セッション S = {v1, v2, ..., vn} に対して、モデルの学習およびテスト用に複数の部分列を生成しました。これらの部分列は、([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn) という形式をとりました。上述の前処理を完了した後、データセットに対して統計分析を実施し、その詳細情報を表 2に提示しました。
| データセット | Diginetica | Tmall | Nowplaying |
| クリック数 | 982961 | 818479 | 1367963 |
| 訓練データ | 719470 | 351268 | 825304 |
| テストデータ | 60858 | 25898 | 60417 |
| アイテム数 | 43097 | 40728 | 60417 |
| 平均長 | 5.12 | 6.69 | 7.42 |
表2:データセットの説明。 この表は、クリック数、トレーニングおよびテストサンプル数、アイテム数、平均セッション長を含む、Diginetica、Tmall、およびNowplayingデータセットの統計をまとめたものである。
実験設定
パラメータの設定
実験の公平性を確保するため、GSLA4Recモデルのパラメータを事前設定すると同時に、3つのデータセットを処理するための前処理手法を採用した。バッチサイズについては、DigineticaおよびNowlayingデータセットでは150に、Tmallデータセットでは300に設定した。本モデルのパラメータは、平均0、標準偏差0.1のガウス分布を用いて初期化した。次元数は100に設定し、オプティマイザーにはAdamを使用し、初期学習率を0.001に設定した。学習率は3エポックごとに0.1倍し、NVIDIA TITAN V GPUおよびPyTorch 1.11.0 (cu113)を用いて、計30エポックの学習を行った(~を参照) 材料一覧表)で最良の値を採用するため、近傍セッションをフィルタリングするための閾値を0.5に設定した。 L2 実験では正則化が適用されました。各データセットについて、取引時間でソートしたデータの最後の10%をテストセットとして選択し、残りの10%と80%をそれぞれ検証セットおよびトレーニングセットとしてランダムに選択しました。GSLAのメモリスロット数は、{0, 1, 2, 3, 4, 5}のいずれかの値に設定されました。
評価指標
本論文では、P@N(Precision@N, N = 10/20)およびMRR@N(Mean Reciprocal Rank@N, N = 10/20)を採用しました。P@Nは、上位N件の推奨結果に含まれる正解の推奨割合を測定するために使用され、MRR@Nは、正解プロジェクトの平均逆順位を算出するために使用されました。MRR値が高いほど、ソート性能が優れていることを示します。
パフォーマンスの分析
GSLA4Recモデルの有効性を、技術開発の異なる段階を代表するベースラインと比較して評価した。初期には、FPMC5のようにマルコフ連鎖に基づいてシーケンシャルな効果を予測するなどの機械学習手法がSBRに用いられていた。その後、人工知能の発展に伴い、深層学習がSBRに広く適用されるようになった。例えば、GRU4Rec10はRNNに基づいており、GRUを複数層に積み重ねることでSBRをモデル化し、SBRを最適化するための専用の損失関数を設計した。NARM16は、ユーザーの主な関心を捉えるためにAMを導入し、次に推奨される可能性のあるアイテムの最終的な埋め込み表現を生成した。STAMP17は、AMで強化された多層パーセプトロンを採用し、ユーザーの一般的関心と即時的関心を同時に捉えた。近年では、強力な非ユークリッドデータ学習能力を持つことから、グラフニューラルネットワークもSBRに広く利用されている。例えば、SR-GNN22は、SBRに初めてGNNを適用し、GGNNを通じて複雑なアイテム遷移関係を取得し、AMと組み合わせてユーザーの即時的関心に焦点を当てた。GCE-GNN23は、GATを利用して局所的および大域的なコンテキストにおけるアイテム転移関係を取得し、RPEとソフトAMを通じてセッション表現を生成した。S2-DHCN66は、セッションデータをハイパーグラフとライングラフに変換し、自己教師あり学習を活用してSBRを強化した。
近年、SBRの性能を向上させるために包括的なアプローチが採用されています。例えば、GC-SAN50は、GNNと多層自己アテンションネットワークを組み合わせ、短期および長期の依存関係をモデル化することで推薦性能を向上させました。TASRec67は、異なるタイムスタンプにおける動的グラフスナップショットのシーケンスを構築することで時間情報を組み込み、CT-GNN68は、時間情報を組み合わせたGNNを採用してアイテム間の追加的な時間的関連情報を学習しました。CORE69は、アイテムの共起情報と時間情報を融合させて最終的なセッション表現を取得し、RESTC70は、対照学習の一様性とアライメント特性に着想を得た時空間相互作用パターンを提案しました。COTRec66,71は、2つのセッショングラフビューに対する自己教師あり学習と共トレーニングを採用してSBRのデータ希薄性を解決し、RAIN71は、エッジマスキングと構造再構成を活用し、エッジインジケーターを共同で学習させることでノイズエッジを明示的に特定して排除し、これによりSBRの精度と堅牢性を大幅に向上させました。
| データセット | Diginetica | 天猫 | 再生中 | ||||||||||
| メソッドクラス 認証 | 指標 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| 機械学習 | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| ディープラーニング | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| ディープラーニング | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| ディープラーニング | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| グラフニューラルネットワーク(GNN) | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| グラフニューラルネットワーク(GNN) | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| グラフニューラルネットワーク(GNN) | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN+Attention(グラフニューラルネットワーク+アテンション) | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNNs+Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNNs+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNNs+Tem | コア | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNNs+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNNs+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNNs+ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNNs+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| 標準偏差 | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| p値 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| T推論 | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
表3:3つのデータセットにおける性能比較。 この表は、Diginetica、Tmall、およびNowplayingデータセットを用い、P@10、P@20、MRR@10、およびMRR@20に関して、GSLA4Recを機械学習、ディープラーニング、GNNベース、アテンションベース、時系列、およびその他の推薦手法と比較したものである。GSLA4Recについては、SDおよびp値も報告している。
GSLA4Recモデルの性能を検証し、ランダムな要因による性能向上の偶然性を排除するため、テストセットに対して複数回のグループ分け実験と統計解析を行った。具体的には、テストセットを1バッチあたり150セッションのグループに分け、乱数シード法を用いて30回繰り返した。すべてのグループ分け実験の平均結果と時間消費を、それぞれGSLA4Recモデルの性能と推論時間として算出した。さらに、GSLA4Recモデルの標準偏差(SD)と統計的有意性のt検定を算出し、性能向上の安定性と確実性を検証した。Table 3に、3つのデータセットにおける提案モデルであるGSLA4Recの性能、SD、p値、およびTinferenceを、ベースラインモデルと比較して示した。下線付きの数値は最良のベースライン手法を示し、各評価指標において最高の性能を示したモデルを黒い太字で表記した。
1) 機械学習による推薦手法:SBRタスクにおいて、従来のFPMC法は最低のパフォーマンスを示しました。これは主に、マルコフ連鎖モデルがアイテム間の複雑な遷移パターンを捉えられなかったためです。 2) ディープラーニングによる推薦手法:GRU4REC、NARM、STAMPなどのモデルはシーケンスモデリングアプローチを採用し、一定の性能向上を達成しました。その中でも、NARMとSTAMPはGRU4RECよりも優れた推薦結果を示しましたが、これは主にNARMがユーザーの主要な関心を捉えるためのアテンションメカニズムを導入したためです。 3) GNNによる推薦手法:SBRへのGNNの導入は、著しい性能向上をもたらしました。例えば、セッションシーケンスをグラフ構造に変換してアイテムの空間的な構造情報を捉える手法を先駆けて導入したSR-GNNは、STAMPに代表されるディープラーニング手法を0.36–4.64%上回り、シーケンシャルデータの処理におけるグラフ構造の空間的優位性を実証しました。S2-DHCNは、アイテム間の高次依存関係を捉えるためにデュアルチャネルハイパーグラフ畳み込みを採用し、表現力を高めるために自己教師あり対照学習を組み合わせました。これにより、ペア間の関係のみをモデル化し情報が不十分であるという従来のGNNの限界を解消し、STAMPに代表されるディープラーニング手法を1.30–7.04%上回る性能を示しました。GCE-GNNは、単一セッションの情報とグローバルセッションの情報を効果的に統合することで、STAMPに代表されるディープラーニング手法を1.46–7.60%、SR-GNNを0.88–5.85%上回り、グローバルなコンテキスト情報を組み込んだグラフ構造手法がSBRの性能を大幅に向上させられることを示しました。 4) GNN+アテンションメカニズムによる推薦手法:TASRecは、時間認識メカニズムを導入することで、ユーザーの行動シーケンスにおける短期的な嗜好と長期的な嗜好をより正確に捉えることを目的としました。その性能は、ディープラーニング手法を0.73–5.91%、SR-GNNモデルを0.30–2.31%上回りましたが、GCE-GNNモデルよりは0.59–3.84%劣っていました。GC-SANは、セッションシーケンスから変換されたグラフ構造とマルチヘッド自己アテンションメカニズムを組み合わせることで、セッション内の局所的な依存関係と長期的な依存関係の捕捉に成功しました。その性能はSR-GNNモデルと同等か、あるいはわずかに上回りましたが、TASRecおよびGCE-GNNの両モデルよりは劣っていました。このことは、アテンションメカニズムの導入がSBRの性能を効果的に向上させ得るものの、その向上幅はグローバル情報の活用によるものほど顕著ではないことを示唆しており、グローバルなコンテキスト情報の重要性を改めて裏付ける結果となりました。 5) GNN+時間エンコーディングによる推薦手法:CT-GNNは、グラフ構造と時間エンコーディングを初めて組み合わせることで、「空間構造」と「時間的ダイナミクス」を同時に捉え、GC-SANモデルを0.55–3.82%上回りました。COREは、グローバルセッションからアイテムの共起頻度を統計的に分析することで長期的な嗜好を、また現在のセッションに対して時間的な位置重み付けを設計することで短期的な意図をそれぞれ捉え、これらの共起情報と時間情報を融合して最終的なセッション表現を得ました。その性能は、TASRecモデルを0.25–9.58%、GC-SANモデルを0.67–11.56%上回り、TmallデータセットにおいてはGCE-GNNモデルに対して3.64–5.74%の大幅な向上を示しました。RESTCは、空間的なグラフ構造のみに焦点を当てて時間情報を無視している点や、時空間融合が不十分であるといった従来のGNNの問題を解決するため、時空間GNNに基づく対照学習モデルを導入しました。その性能はCOREモデルを0.39–3.31%、GCE-GNNモデルを0.28–7.56%上回り、時間エンコーディングと対照学習の両方がSBRの性能を効果的に高めることを示しました。RAINは、エッジマスキングと構造再構築技術を利用して、ノイズとなるエッジを明示的に識別して排除するためのエッジインジケーターを共同で学習させ、RESTCモデルに近い性能を達成しました。
提案されたモデルであるGSLA4Recは、グローバルなコンテキスト情報とゲート付きスロット線形アテンション(gated-slot linear attention)メカニズムを統合することで、ノイズをフィルタリングし計算複雑性を低減させながら、ユーザーのコンテキスト情報を効果的に捉えることができます。本モデルはすべてのデータセットにおいて性能向上を示し、最良の性能を示した2つのベースラインであるRESTCモデルを0.54–2.31%、GCE-GNNモデルを0.83–10.18%上回りました。これは特に、SBRにおけるロングセッションシナリオの逐次的な依存関係の処理において顕著であり、(具体的にはTmallおよびNowplayingデータセットにおいて、GCE-GNNと比較してそれぞれ10.18%および4.73%の向上、RESTCと比較してそれぞれ1.44%および2.31%の向上を示しました)。要約すると、提案されたGSLA4Recモデルは、ユーザーコンテキストの抽出とノイズフィルタリングのために効率的なグラフ構築を組み込んでおり、その性能はすべてのデータセットにおいて一貫してSOTAを上回りました。
効率の分析
~に示されているように 図4Digineticaデータセットを用いた実験結果では、提案手法であるGSLA4Recが、1エポックあたりの学習時間においてベースラインよりも高速な学習速度を達成した。すべての実験はNVIDIA TITAN V GPU上で実行され、消費メモリは約9300MBであった。STAMP、NARM、GRU4Recを含む深層学習ベースのモデルは効率的に動作したが、パフォーマンスは最も低かった。GNN(グラフニューラルネットワーク)および自己注意機構に基づくTASRecおよびGC-SANモデルはパフォーマンスを向上させたが、大幅な時間を要するという課題があった。S2GNNに基づくDHCNおよびCOREは計算時間をわずかに増加させたが、全体的なパフォーマンスは著しく向上し、特に提案したGSLA4Recモデルでは大幅な性能向上が見られた。その主な理由は、GSLA4Recモデルがベースラインよりもグラフ構築に要する時間が短かったことに加え、固定メモリスロットを備えた2パスのゲート付き線形アテンション機構を採用していたためである。 m、その結果、線形時間計算量となる O(Ldm)。この設計は、標準的な自己注意(self-attention)よりも大幅に効率的であった。 O(L2d)一方で、softmaxで強化されたスロット読み出しを通じて、強力な記憶容量を維持しています。表の最下行に示すように、統計的推論時間を同期させるため、テストセットを用いて性能試験を実施しました。 表3GSLA4Recモデルの効率性の優位性を実証し、〜を回避した "偽の高精度だが利用不可" そして、有効性と効率性の真のトレードオフを実現することである。
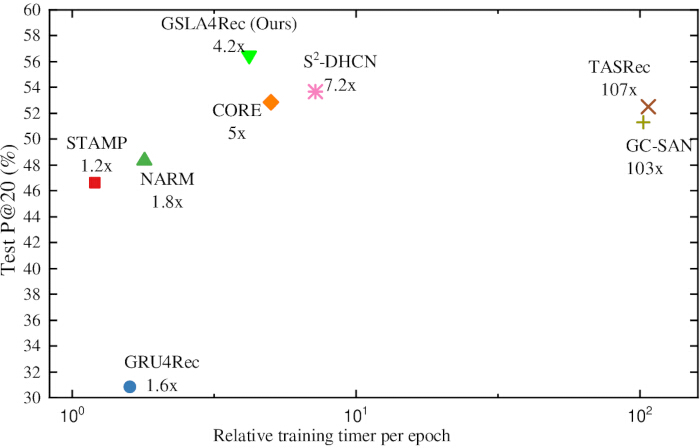
図4: DigineticaにおけるGSLA4Recの実行時間あたりのパフォーマンス。本図は、Digineticaを用い、NVIDIA TITAN V GPU上で動作させた提案手法のGSLA4Recおよびベースラインモデルのエポックあたりの相対的なトレーニング時間を示しており、GSLA4Recがベースラインモデルよりも高速なトレーニング速度を達成したことを示している。本図はOriginProを用いてすべての要素を完全にカスタマイズし、自作したものである。著作権で保護された外部のグラフィックリソースは使用しておらず、したがって第三者による追加の著作権ライセンスは不要である。図の著作権は著者らに帰属し、受理後はジャーナルの著作権規定に従うものとする。GSLA4Recは、SBRのためのgated-slot linear attention graph neural networksを表す。こちらのリンクをクリックして、本図の拡大版を表示してください。
まとめると、線形複雑度のゲート付きスロット・アテンションを備えた提案モデルGSLA4Recの効率性は、すべてのデータセットにおいて一貫してSOTAを上回りました。特に、GSLA4RecはTmallおよびNowplayingデータセットにおけるロングセッション推奨シナリオで大幅な性能向上を達成し、優れた系列依存性モデリング能力を示しました。
アブレーション実験の解析
SG、NGGおよびGSLAの影響
SG、NGG、ゲーティングメカニズム、メモリスロット、および線形アテンションが現在のSBRに与える影響を評価するため、Diginetica、Tmall、およびNowplayingデータセットを用いてアブレーション研究を実施した。GSLA4Rec‑NotSGではNGGエンコーディングを保持しつつSG特徴量エンコーディングを除外した。GSLA4Rec‑NotNGGではNGGエンコーディングを破棄し、SGのみに基づいた特徴抽出を行った。GSLA4Rec‑NotGMではGSLA内のゲーティングメカニズムのみを削除した。GSLA4Rec‑NotMSではGSLAのメモリスロットのみを排除した。そしてGSLA4Rec‑NotLAではGSLAの線形アテンションモジュールのみを省略した。
| データセット | Diginetica | Tmall | 再生中 | |||
| 測定項目 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
表4:GSLA4Recアブレーション実験の性能。 この表は、Diginetica、Tmall、およびNowplayingデータセットにおいて、個々のモデルコンポーネントを削除した後のGSLA4Recのアブレーション性能を、P@20およびMRR@20を用いて評価し報告したものである。
表4は、異なるデータセットにおけるアブレーション研究の結果を示しており、すべての性能指標がフルモデルと比較して低下しました。近傍グローバルセッショングラフエンコーディングを削除した場合(GSLA4Rec-NotNGG)の性能低下は、セッショングラフ特徴エンコーディングを削除した場合(GSLA4Rec-NotSG)よりも顕著でした。GSLAのいずれかのサブモジュールを削除しても性能は低下し、その低下の程度は、線形アテンション、メモリスロット、ゲーティングメカニズムの順に高いことが分かりました。この理由は、SBRにおける各アイテムの重要性が明らかに異なり、アイテム間の連想記憶が必要であるためです。以上のことから、GSLAが本論文のモデルにおける重要な部分であることが確認されました。
異なる凝集方法の影響
異なる情報集約手法がGSLA4Recモデルの性能に与える影響を評価するため、以下の3つの古典的な情報集約手法を検討した:1) Average Pooling:SGおよびNGGによって生成されたベクトルに対して平均プーリング操作を行う手法、2) Vector Concatenation:SGおよびNGGによって生成されたベクトルを連結する手法、3) Vector Summation:SGおよびNGGによって生成されたベクトルを合算する手法。結果をTable 5に示す。Vec-Sumを用いたGSLA4Recは、Diginetica、Tmall、およびNowplayingにおいて最高の性能を達成した。対照的に、Mean-poolingはすべてのデータセットにおいて低い結果となった。平均集約および連結集約の性能が劣ったのは、過剰なパラメータによる過学習が生じ、モデル全体の性能が低下したためであると考えられる。
| データセット | Diginetica | 天猫 | 再生中 | |||
| 測定項目 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| 平均プーリング | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| ベクトル結合 | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| ベクトル和 | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
表5:異なる集約手法の影響。 この表は、Diginetica、Tmall、Nowplayingの各データセットにおいて、平均プーリング、ベクトル結合、およびベクトル加算がGSLA4Recの性能(P@20およびMRR@20)に及ぼす影響を比較したものである。
ハイパーパラメータ設定の解析
異なるメモリスロットサイズの影響
メモリスロットは以前のタイムステップからの情報を保存し、これは時間的依存性を伴うタスクにおいて特に重要でした。本セクションでは、メモリスロットサイズ m = [0, 1, 2, 3, 4, 5] がSBRの性能に与える影響を調査しました。表6に示す実験結果から、メモリスロットサイズ m を3に設定したとき、3つのデータセットすべてにおいて指標 P@20 および MRR@20 が最適に機能したことが示されました。これは、適度なメモリスロットサイズがモデルの推奨精度とランキング品質を効果的に向上させたことを示唆しています。メモリスロットサイズが小さすぎると、十分な履歴情報を記憶できず、ユーザーの短期的な興味に偏る傾向があります。一方で、メモリスロットサイズが4以上に増加すると、モデルが過剰な履歴情報を保存し、より重要な現在の入力情報を軽視して履歴上の興味に過度に依存するため、推奨性能が低下します。
| データセット | Diginetica | 天猫(ティーモール) | 再生中 | |||
| 測定項目 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
表6:異なるメモリスロットサイズの影響。 この表は、Diginetica、Tmall、およびNowplayingデータセットを用いて、異なるメモリスロット構成(m0~m5)におけるGSLA4RecのパフォーマンスをP@20およびMRR@20で報告したものである。
異なるドロップアウト率の影響
過学習を防ぐため、ドロップアウト正則化を導入した。セッションレベルのアイテムベクトルと近傍グローバルレベルのアイテムベクトルを加算する前に、近傍グローバルレベルのアイテムベクトルhingg,(k)におけるニューロンの出力をランダムにドロップさせることで、GSLA4Recモデルの堅牢性と汎化性能を向上させた。
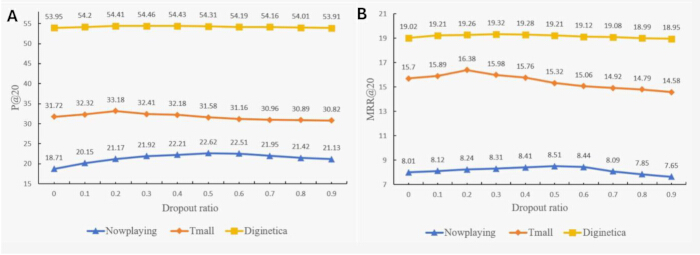
図 5: 異なるドロップアウト率におけるGSLA4Recの性能。(A>) Nowplaying、Tmall、およびDigineticaデータセットにおける、異なるドロップアウト率でのGSLA4RecのP@20、および(B>) MRR@20。ドロップアウト率の増加に伴い、性能は当初上昇し、その後低下した。これは、モデルの堅牢性と汎化能力を示している。GSLA4Recは、セッションベース推薦(SBR)のためのゲート付きスロット線形アテンショングラフニューラルネットワークである。本図はOriginProを用いて、すべての要素を完全にカスタマイズして自作した。著作権のある外部グラフィックリソースは使用していないため、第三者の追加の著作権ライセンスは不要である。図の著作権は著者に帰属し、受理後はジャーナルの著作権規定に従うものとする。こちらのリンクから、この図の拡大版をご覧いただけます。
図5A–Bは、式(16)における異なるドロップアウト率がモデルの性能に与える影響を示している。実験結果から、ドロップアウト率が低い場合はモデルの性能が低いことが示されたが、ドロップアウト率が高くなるにつれてモデルの性能は徐々に向上し、最適なレベルに達した。具体的には、最適なドロップアウト率は、Digineticaデータセットで0.3、Tmallデータセットで0.2、Nowplayingデータセットで0.5であった。ドロップアウト率がこれらの最適値を超えると、モデルの性能は低下し始めた。これは主に、過剰なニューロンのドロップアウトによって、モデルがセッションデータから重要な特徴を効果的に学習できなくなったためである。
異なる埋め込みサイズの影響
最適なモデル性能を維持しつつ、計算オーバーヘッドを可能な限り最小限に抑えるため、異なる埋め込み次元 d がGSLA4Recモデルの性能に与える影響を調査しました。図6A–Bに示すように、3つの公開データセットであるDiginetica、Tmall、およびNowplayingにおいて、埋め込み次元 d が10–40のとき、GSLA4Recモデルの性能は低い結果となりました。しかし、d の値が増加するにつれてモデルの性能は急速に向上し、d の値が80から120の範囲にあるときに性能指標は安定する傾向にありました。その後、d がさらに増加し続けると、大きな埋め込み次元による過学習が原因で、性能は実際には低下しました。したがって、アイテム埋め込みベクトルの次元は最終的に100に設定されました。
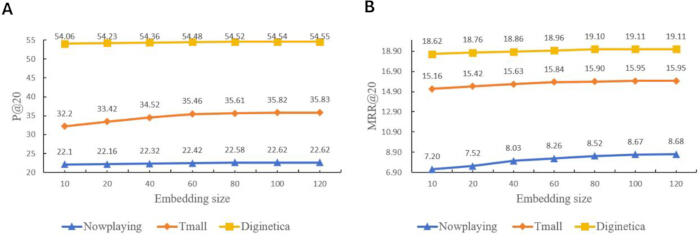
図 6: 異なる埋め込みサイズにおける GSLA4Rec のパフォーマンス。Nowplaying、Tmall、および Diginetica データセットにおける、異なる埋め込みサイズでの GSLA4Rec の (A) P@20 および (B) MRR@20。モデルのパフォーマンスは、埋め込みサイズの増加に伴い段階的に向上し、最終的にプラトーに達した。GSLA4Rec:セッションベース推薦(SBR)のためのゲート付きスロット線形アテンショングラフニューラルネットワーク。この図は OriginPro を使用し、すべての要素を完全にカスタマイズして自作したものである。著作権で保護された外部のグラフィックリソースは使用しておらず、したがって第三者の著作権ライセンスは不要である。図の著作権は著者が所有しており、受理後はジャーナルの著作権規定に従うものとする。ここをクリックして、この図の拡大版を表示してください。
セッション時間の違いによる影響
3つの実世界のSBRデータセット(Diginetica、Tmall、Nowplaying)において、セッションごとの長さが異なることは周知の通りである。異なるセッション長におけるベースラインと比較したGSLA4Recモデルの堅牢性を検証するため、DigineticaおよびTmallのすべてのセッションを、それぞれ1〜6の短グループ(S)、7〜12の中グループ(M)、12より長い長グループ(L)の3つのグループに分割した。MRRは正解結果のランキング品質をより適切に反映できるため、手法の性能検証にはP@20ではなくMRR@20を採用した。Figure 7A–Bは、異なるセッション長において、GSLA4RecモデルがシーケンスベースのベースラインであるNARM、GNNベースのベースラインであるSR-GNN、対照学習で拡張されたGNNベースラインのS2-DHCN、および時空間ベースラインのRESTCを上回ったことを示している。同時に、アイテムの遷移が長期にわたるとユーザーの好みの把握が困難になるため、すべての手法においてシーケンス長の増加に伴い性能が低下することも観察されたが、提案したGSLA4RecモデルはGated-slotメカニズムによって無関係なアイテムを除去できるため、ベースラインと比較して性能低下の速度が最も緩やかであった。長グループにおいて、GSLA4Recの性能はNARMモデルをDigineticaで6.3、Tmallで8.85それぞれ上回った。
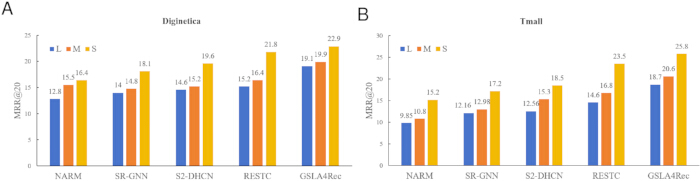
図 7: 異なるセッション長におけるGSLA4Recの性能。(A>) Diginetica および (B>) Tmall データセットにおける、異なるセッション長のグループ間でのGSLA4Recおよびベースラインモデルの性能をMRR@20を用いて評価した結果。セッション長のグループは L、M、S と表記される。GSLA4Rec:セッションベース推薦(SBR)のためのゲート付きスロット線形アテンション・グラフニューラルネットワーク。この図はOriginProを用いて、すべての要素を完全にカスタマイズして作成した。著作権のある外部グラフィックリソースは使用していないため、第三者の著作権ライセンスは不要である。図の著作権は著者に帰属し、受理後はジャーナルの著作権規定に従うものとする。ここをクリックして、この図の拡大版を表示してください。
結論
本論文では、SBRのためのグローバルコンテキスト・ゲート付きスロット線形アテンションネットワークを提案します。SGとNGGを組み合わせ、ゲート付きスロット線形アテンションメカニズムを導入することで、セッションシーケンス内の重要なアイテムに焦点を当て、長期的および短期的な依存関係を捉え、ノイズを効果的に低減し、計算量を削減することが可能になります。実験結果により、本手法が3つの公開データセットにおいて優れた推薦精度と効率性を示し、特に長期的な依存関係のモデリングタスクにおいて非常に優れていることが確認されました。
データの可用性:
本研究の結果を裏付ける3つの一般的な公開データセット(Diginetica、Tmall、Nowplaying。URLは材料表(Table of Materials)に記載)は、インターネット上で公開されています。同時に、広く利用されているこれら3つの公開データセットおよび本研究のソースコードは、補足フォルダ:GSLA4Rec.zipとして提供されています。こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
ベースラインと比較して、GSLA4Recモデルは、性能と効率の両面で改善を達成している。その理由は主に3つある。第一に、NGGにゲーティング機構を適用することで、データのスパース性が緩和され、ノイズが効果的にフィルタリングされる。第二に、メモリスロット機構により、ハイパーパラメータを介して記憶容量と効率のバランスが調整される。 m 調整。第三に、線形アテンション機構はアイテム間の相関を計算する O(N)複雑さははるかに低く、 O(N2)61GSLA4Recモデルはユーザーに過度に依存している。' 相互作用の配列を処理し、アイテムの多様なモード特性を無視する48一方、NGG構築法は動的な調整機能を持たず、固定されたジャカード閾値を使用しており、メモリスロット m 適応的な調整性を達成できない65.
GSLA4Recモデルは、SGを構築する&NGG およびゲーテッド・スロット線形アテンションを採用し、特に匿名セッション推薦に適している39 ECサイトやオンラインストリーミングプラットフォームにわたります。ECプラットフォームでは、このモデルはユーザーの属性情報に依存せず、閲覧、クリック、カートへの追加などの行動を捉えることで、ユーザーに適した商品を推薦します。本論文で使用したDigineticaおよびTmallのデータセットは、EC推薦のためのデータセットです。短編動画や音楽ストリーミングプラットフォームにおいては、本手法がユーザーの行動を分析します' 再生シーケンスからユーザーの暗黙の好みを推定し、コンテンツの要約を更新してユーザーの維持を図り、視聴時間を延長する。本論文で使用したデータセット「Nowplaying」は、音楽推薦データセットである。
ゲート付きスロット線形注意アーキテクチャを置き換えることができる代替ソリューションが存在する。新たに登場したMamba65 状態空間モデルに基づくアプローチは代替手法として、選択的な状態記憶領域と線形計算複雑性という特徴を持ち、線形複雑性と長系列の適合能力の両立を図り、LLMと組み合わせることが可能である55 強化フレームワークは、ユーザーを抽出する' 元のインタラクションログから暗黙の意図を抽出することで、高い推薦性能と効率を実現している。今後の課題として、GSLA4Recの複数の観点からの最適化が考えられる:固定されたジャカードフィルタリングを置き換える動的NGGの構築、異なる長さのセッションに自動的に対応できる可変メモリスロットの実装、推薦精度の向上のためのユーザのマルチモーダル情報の統合などである。さらに、LLM強化モデルの支援を受けて55、ユーザー' 相互作用の系列から暗黙の意図を抽出でき、ノイズの多い会話データもより正確にフィルタリングできる72.
開示事項
著者らは、本論文に報告された研究に影響を及ぼす可能性のある、既知の競合する金銭的利益または個人的な関係がないことを宣言します。
謝辞
著者は、査読プロセスにおける思慮深いフィードバックと提案をくださった査読者の方々と、丁寧にご指導いただいた博士課程の指導教官であるJiang Nan教授に感謝いたします。本研究は、中国国家自然科学基金(Grant No.6217072713およびGrant No.62061019)、2025年度江西省無人センシングシステムおよび人工知能技術工学研究のオープンリサーチトピック、および江西省先進電子材料・デバイス重点研究室(No.2024SSY03012)の支援を一部受けて実施されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | なし | CUDA 11.3は、2021年にNVIDIAからリリースされた並列コンピューティングプラットフォームおよびプログラミングモデルのバージョンであり、GPU加速アプリケーションのパフォーマンス向上と開発の柔軟性を高めることを目的としています。 |
| Diginetica | Diginetica | なし | Digineticaは、2016年CIKM(International Information Retrieval Conference)Cupの公式コンペティションデータセットであり、検索コンテキストを伴うeコマースにおけるパーソナライズされた商品検索の問題を解決するためのCIKMアルゴリズムコンペティションで使用されました。現在は、セッションベース推薦(SBR)分野において最も主流な標準eコマースベンチマークデータセットとなっています。 |
| Nowplaying | Zenodo | なし | これは、"# nowplaying"タグのツイートマイニングに基づいて構築された大規模な音楽リスニング行動データセットであり、主に音楽対話推薦、コンテキスト認識推薦、および感情相関分析の研究に使用されます。 |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | なし | OriginProは、OriginLab Corporationによって開発された商用の専門的な科学作図およびデータ解析ソフトウェアであり、論文レベルのチャート作成、データ統計、曲線フィッティング、信号処理などに一般的に使用されます。本論文では、OriginProを用いて実験比較図、折れ線グラフ、および棒グラフを作成しています。 |
| PyTorch 1.11.0 | PyTorch Foundation | なし | PyTorchは、2016年にFacebookによってリリースされた、機械学習およびディープラーニングのためのオープンソース・ディープラーニングフレームワークです。主に自動微分を実装し、動的計算グラフを導入することで、モデル構築の柔軟性を高めています。 |
| TITAN V GPU | NVIDIA | なし | NVIDIA TITAN Vは、2017年末にNVIDIAから発売されたフラッグシップグラフィックスカードであり、主にハイパフォーマンスコンピューティングおよび人工知能分野を対象としています。 |
| Tmall | Tmall | なし | IJCAI 2015 Alibaba Tmall Recommendation Competitionより、Alibaba Tianchiが機密処理済みの実際のTmallオンラインログを公開しました。これはSBR分野における3つの標準データセット(Diginetica、Yoocoose、Tmall)の一つであり、中国のeコマースシナリオにおいて好んで使用される評価セットです。 |
| visio 2021 | Microsoft | なし | Visioは、Microsoftが開発したベクター描画ソフトウェアであり、科学研究論文におけるモデル構造図、フローチャート、フレームワーク図、ネットワークトポロジー図の作成、および論文図版用のベクター図の出力に使用されます |
参考文献
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.