本プロトコルでは、気象ベースのデータセットの作成と、砂嵐、霧、雨、雪を含むイラクの多様な環境条件下における自由空間光通信の大気減衰を予測するための、機械学習、ディープラーニング、およびハイブリッドモデルの系統的な評価について記述します。
この記事について
サマリー
要約
自由空間光通信(FSO)システムは、高帯域幅、セキュリティの向上、およびライセンス不要の運用を可能にしますが、散乱や吸収による大気減衰に伴う性能低下の影響を強く受けます。特に、高温で埃っぽく、霧や雨が不規則に発生するイラクのような環境では、減衰予測の精度がさらに重要となります。本研究の目的は、イラクのさまざまな気象条件下におけるFSO通信システムの大気減衰予測において、機械学習、ディープラーニング、およびハイブリッドモデリング手法の性能を評価することです。快晴、霧、雨、砂嵐、雪の5つの気象レジームについて、確立された物理伝搬モデルを用いて1,500サンプルの合成データセットを作成しました。6つの機械学習手法(Random Forest [RF]、Extreme Gradient Boosting、Light Gradient Boosting Machine、Support Vector Regression、Linear Regression、K-Nearest Neighbors)、6つのディープラーニングアーキテクチャ(Multilayer Perceptron、Deep Neural Network、Long Short-Term Memory [LSTM]、1次元Convolutional Neural Network [CNN]、CNN–LSTM、Attention-based Network)、および3つのハイブリッドアプローチからなる計15の予測モデルを系統的に評価しました。その結果、RFが最高の性能を示し(R2 = 0.9654、root mean square error = 1.324 dB/km)、ディープラーニングアプローチ(最高 R2 = 0.7766)およびハイブリッド手法(最高 R2 = 0.9571)を上回りました。Shapley Additive exPlanationsを用いて特徴量の重要度を分析したところ、粉塵濃度(67.3%)と視程(21.2%)が最も影響力のある要因であることが分かりました。RFは学習および推論において大幅に高速でしたが、統計検定の結果、RFと最高性能のハイブリッドアプローチとの間に有意な差は認められませんでした(p = 0.083)。従来の機械学習手法の性能は、既知の物理伝搬理論と一致しており、過酷な環境条件下におけるFSO通信システムの大気減衰推定において非常に効率的であることが証明されました。ただし、これらの結論は合成データに基づいたものであり、実際の運用のFSOシステムに適用する前に、実大気観測による検証が必要であることを強調します。
概要
自由空間光(FSO)通信ネットワークは、一般的に高い容量と優れたセキュリティを提供しますが、散乱および吸収による大気減衰が通信距離を制限する主要な要因となります1。本研究では、高温、砂嵐、不規則な降雨といった困難な環境にあるイラクにおいて、FSO信号の減衰を評価するための機械学習、ディープラーニング、およびハイブリッドアプローチについて詳細な分析を提供します2。
FSO通信システムは、数百メートルから数キロメートルの距離にわたって100 Gbpsを超えるデータレートを実現し4、高帯域幅のワイヤレス接続を実現するための有望なソリューションの一つとして台頭しています3。FSOリンクは、従来の無線周波数システムとは異なり、可視光および赤外線スペクトルで動作するため、免許不要での運用、電磁干渉への耐性、狭いビーム広がりによるセキュリティの向上、および大きな帯域幅容量といった利点があります5。これらの特徴により、FSOはバックホールアプリケーション、建物間リンク、災害復旧ネットワーク、および光ファイバーの敷設コストが極めて高いラストマイル接続において魅力的な技術となっています6。しかし、散乱、ビーム偏向、および吸収による通信7,8は、可用性と性能の面で環境条件に大きく依存します。この課題は、自由空間光通信システムにおける主要な制約の一つです。気象条件により、減衰レベル(dB/km)には大きな変動が生じます。快晴条件下では減衰が0.5 dB/km未満となる一方、激しい霧が発生すると、1550 nmで減衰が≥50 dB/kmに達することがあります(1550 nmで視程50 m未満の場合に最大50 dB/kmの減衰値を予測するKim霧モデルを使用した場合)9,10。また、激しい雨は、降雨強度に応じて最大20–30 dB/kmの減衰を引き起こす可能性があります(Carbonneauモデルによる予測)11。したがって、信頼性の高いリンク設計、ネットワーク計画、および適応型伝送戦略には、減衰の正確な予測が必要です。従来の手法は、霧に対するKimモデル12、雨に対するCarbonneauモデル13、およびエアロゾル粒子に対するミー散乱理論14などの物理的な伝搬モデルに基づいています。しかし、これらのモデルは優れた理論的根拠を提供しますが、実際には常に得られるとは限らない正確な大気パラメータに依存していることが多く、また、同時に発生する複数の気象現象間の複雑な相互作用を考慮していないことが頻繁にあります15。
イラクにおける極端な環境変動は、自由空間光通信システムの展開に大きな課題をもたらします。伝送状況は、少量の降雨や散発的な霧の発生によってさらに複雑になります。また、冬季の気温は氷点下まで下がり、夏季の気温は 50 °C を超えることがあります16。標準的な波長として一般的に利用される 1550 nm などのスペクトルにおいて、現地で「al-haboob」と呼ばれる砂嵐は視程を 100 meters 未満に制限し、20dB/km を超える減衰値を引き起こします17。イラクおよびその他の中東諸国で FSO システムを正常に展開するためには、これらの多様な環境条件下でシステムの性能を正確に推定できる信頼性の高い予測モデルを構築することが不可欠です18。
機械学習の新たな展開は、従来の物理ベースのモデリング手法に代わる実行可能な代替手段を提示しています。機械学習の手法が、減衰と大気要因の間の複雑な非線形相関を直接学習できる能力を持つことで、従来の解析モデルが見落とす可能性のある微小な相互作用の検出が可能になります19。さまざまな気候予測タスクにおいて、ランダムフォレスト(RF)や勾配ブースティング戦略は強力なパフォーマンスを実証しています20。同様に、ディープラーニングの手法は、自然言語処理、コンピュータビジョン、および時系列予測において顕著な成功を収めています21。しかし、これらのアプローチは、特に限定的なデータセットや変動の激しい気象条件下におけるFSO減衰予測については、十分に探索されていません22。このギャップを埋めるため、本研究では、イラクの大気条件下でのFSO信号減衰を予測するための機械学習、ディープラーニング、およびハイブリッドアプローチの詳細な調査を提示します。これは、よく知られた物理伝搬モデルに基づいた、適切に設計された合成データセットを構築することで達成されます23。支配的な予測変数が少ない中規模の表形式環境データセットにおいては、決定木ベースのアンサンブル手法の予測性能が、複雑なディープラーニングアーキテクチャを上回ると我々は仮説を立てています。主な目的は、(1) 管理されたシミュレーション環境において予測手法を比較するためのベースライン手法を確立すること、(2) 大気減衰を予測するための最適なアルゴリズム戦略を特定すること、および (3) 特徴量の重要性とモデルの解釈性を評価し、減衰に最も影響を与える環境要因についての知見を得ることであり、本研究では合成データを使用していますが、将来の課題として想定されている実世界の実験測定による後の検証のための基礎を築いています。さらに、減衰に影響を与える最も重要な環境要因を決定するために、特徴量の重要性と解釈性の分析が組み込まれています。
プロトコル
本研究では、ヒトの被験者や脊椎動物の使用、または組織のサンプリングは行っていません。本研究に使用されたすべてのデータは、物理伝搬モデルと公開されている気象パラメータを用いて合成的に生成されました。したがって、機関審査委員会(IRB)または施設動物ケアおよび使用委員会(IACUC)による倫理承認は不要でした。
物理伝搬理論に基づくデータセットの生成。本データセットは、イラクの大気条件下における自由空間光通信システムの、1暦年(2024年)分の1時間ごとの大気状態を模倣して構築されました。1時間あたり1,500サンプルの合成データベースを作成しました。
まず、地域的な傾向に基づき、気象条件をランダムに割り当てた:快晴 (54.3%)、砂塵 (24.9%)、霧 (10.5%)、雨 (7.4%)、雪 (2.8%)。次に、気象条件に応じて、各サンプルに該当する物理的な減衰モデルを適用した。すなわち、快晴にはBeer-Lambert法、霧にはKimモデル、雨にはCarbonneau理論、砂塵嵐にはMie散乱理論を用いた。第三に、FSOシステムのパラメータを次のように設定した:送信電力 20 dBm、波長 1550 nm、伝送距離 3 km、送信開口部 2.5 cm、受信開口部 20 cm。第四に、各サンプルの減衰量を dB/km で算出した。最後に、全データセットをランダムに、1,200個のトレーニングサンプル (80%) と300個のテストサンプル (20%) に分割した。シミュレーション条件には、砂嵐に伴う高濃度の砂塵、豪雨、および −4.89°C から 47.99°C までの温度変化が含まれる。気象条件とパラメータ分布は、2020年から2024年の期間のイラクの気候記録に基づいて選定した。5つの気象レジーム(快晴、霧、雨、砂塵嵐、雪)を選んだのは、これらがイラクにおけるFSO減衰に影響を与える大気条件の全範囲をカバーしており、特に中東では砂塵嵐が非常に一般的であるためである。イラク全域で収集された気象学的な履歴データを用いて、各気象条件の確率分布を作成した。その結果、分布は以下のようになった:快晴が 54.3%(支配的な状態)、砂塵が 24.9%(イラクの砂嵐問題を代表)、霧が 10.5%(イラク北部の冬に頻出)、雨が 7.4%(イラク特有の少ない降水量)、雪が 2.8%(時として北部の山岳地帯で発生)。関連する気象パラメータは、各気象条件に対して次のような確率分布を用いてモデル化した:温度は、イラクの季節的な極値に基づき、−4.89°C から 47.99°C の間で正規分布(平均 28.55±11.18°C)を用いてモデル化した。湿度は、0% から 100% までの一様分布(平均 42.01±25.56%)を用いてモデル化した。視程は、砂塵嵐時の頻繁な低視程イベントを考慮し、0.05 km から 29.99 km の間の対数正規分布(平均 13.10±10.91 km)を用いてモデル化した。砂塵濃度は、低濃度の確率が高く、極端な砂塵イベントに対してロングテールを持つ 0 から 4.96 mg/m3 の間の指数分布(平均 0.74±1.30 mg/m3)を用いてモデル化した。
通信システムは、送信電力 20 dBm、波長 1550 nm、最大伝送距離 3 km、送信開口径 2.5 cm、および発散損失を補正するための受信開口径 20 cmで設計されました。FSOシステムのパラメータは、すべてのサンプルで共通の固定パラメータと、データセット生成時に変更される可変パラメータの2つのグループに分けられました。全1,500サンプルにおいて、送信電力(20 dBm)、動作波長(1550 nm)、送信開口(直径 2.5 cm、効率 0.7)、および受信開口(直径 20 cm、効率 0.7)のパラメータを固定しました。これらのパラメータは、FSOシステムハードウェアの物理的な仕様であり、気象条件によって変化しないため、固定されました。データセットは、温度(−4.89°Cから 47.99°C)、湿度(0%から 100%)、視程(0.05 kmから 29.99 km)、粉塵濃度(0から 4.96 mg/m3)、および気象条件(快晴、霧、雨、塵、雪)のパラメータを変化させた1,500個のサンプルで作成されました。これらのパラメータは、2020年から2024年までのイラクの気候記録から導出された確率分布に基づいて変更されました。各サンプルについて、特定の気象条件と可変パラメータの組み合わせに応じ、対応する物理的減衰モデルを用いて減衰値(dB/km)を算出しました。
物理的減衰は、雨にはCarbonneauモデル、晴天にはBeer–Lambert則、塵にはMie散乱理論、霧にはKimモデルを用いてモデル化した24。Beer-Lambert則は、分子散乱と吸収が支配的であり、それらが距離とともに指数関数的に減少する晴天条件下に適用される25。1550 nmにおける消散係数 α は、空気分子によるレイリー散乱および大気ガスによる吸収に起因する26。Kimモデルは霧に特化したモデルであり、霧の液滴サイズ分布から導出された経験的係数を通じて、減衰と視程を関連付ける。波長依存の指数 q はMie散乱を考慮したものである27。Carbonneauモデルの主要なパラメータは降雨強度 R である。雨による減衰は雨滴の大きさと密度に依存し、係数は1550 nmで経験的に導出され、特に光波長に合わせて校正されている28。Mie散乱理論は塵のある条件下に適用可能である。これは、塵の粒子径(半径 0.1–100 μm)が波長(1550 nm)と同程度であり、中東の塵における複素屈折率 m = 1.55–0.005i に散乱と吸収の両方が含まれているためである29。以下の物理的減衰モデルを、それぞれの方程式およびパラメータ設定を用いて実装した。
快晴条件下では、Beer-Lambertの法則が用いられました:
Aクリア = 10×ログ₁₀(e(α×d)) (1)
ここで、αは消衰係数であり(晴天時の1550 nmにおいて、0.02 dB/kmを中心とし±0.005 dB/kmの変動を持つ正規分布を用いて変化させた)、dは伝送距離(3 kmで固定)である。霧の条件下では、次の式を用いてKimモデルを実装した:
Afog = 10×ln(10)/V×(λ/550)−q (2)
ここで、Vは視程(0.05kmから10kmまで変化させた)をkm単位で、λは波長(1550nmに固定)をnm単位で、qは以下のように計算される粒子径分布係数である:V>50 kmの場合はq=1.6、6(1/3)、0.5
Arain=0.023×R0.93 (3)
ここでRは降雨強度(mm/h)であり、(イラクの降雨記録に基づき0.25から50mm/hの間で変化させた)。砂嵐の状況については、Mie散乱を用いた消散効率の関係式を使用した:
Adust=10×log₁₀(e(τ×L)) (4)
ここで、τ=∫₀^∞ πr2Qext(r,λ,m)N(r)drであり、rは粒子半径(イラクの塵の組成に基づき0.1–100μm)、QextはMie理論を用いて算出された消散能、λ=1550nm、m=1.55–0.005iは中東の塵の複素屈折率、そしてN(r)は幾何平均半径2.5 μm、標準偏差2.0の対数正規分布を用いてモデル化された粒子径分布である。減衰モデルは、降雪条件下において次のように実装された:
Asnow = 0.1×S0.75 (5)
ここでSは降雪強度(0.5~15 mm/h)をmm/hで表したものである。この経験式は、既存の文献における研究に基づいて選定された。30ここでは、雪の結晶の粒径分布にミー散乱理論を適用し、雪の中を伝搬する光の減衰モデルが開発されました。この方程式は、降雪率0.5~15 mm/hの範囲で有効であり、一般的な雪の結晶の直径を1~10 mmとする乾燥雪条件を想定しています。係数0.1および指数0.75は、1550 nmにおける雪のミー散乱計算への曲線適合から得られたものです。このモデルは乾燥雪に対しては妥当な推定値を提供しますが、減衰特性が変動し得る湿雪や混合降水については調整されていません。本手法は計算効率が高く、FSOに関する文献でも頻繁に引用されており、さらにイラク北部(1月および2月のクルディスタン地域)で予測される降雪状況に適しているため、本研究で採用されました。数値計算にはNumpyを用い、すべてのモデルをPython 3.9で実装しました。ランダムに選択された気象条件およびサンプリングされた環境データに合致するモデルを使用して、各サンプルの減衰値を算出しました。得られた気象分布は、快晴条件が814件(54.27%)、砂塵イベントが375件(25.00%)、霧イベントが157件(10.47%)、雨イベントが111件(7.40%)、および降雪イベントが43件(2.87%)でした。
2020年から2024年の間に、イラクの複数の地域(バグダード、バスラ、モスル、ラマディ)にある気象観測所から収集された過去の気象情報を調査し、気象状況の割合を算出した。元のデータは、イラク運輸省およびイラク気象地震局(IMOS)より提供された。データには、各日の現在の気象条件を記録した日々の気象記録が含まれていた。これらの記録から抽出された具体的な特性には、気温(日最低、最高、平均)、相対湿度、視程、降水量、および砂嵐の発生状況が含まれる。IMOSデータの一部は、イラク政府のオープンデータポータル(https://www.motrans.gov.iq/)からアクセス可能であるが、本研究で使用した特定の記録は、中央リポジトリに公開保存されていない。気象条件の割合およびパラメータ値を算出するために使用した気候情報は、表1にまとめられている。快晴日は、降水がなく、視程が10 kmを超え、砂塵活動がない日と定義され、記録された1,825日のうち54.27%を占めた。砂嵐の日(完全な砂嵐(視程 < (視程1km未満)および懸濁ダスト(視程1〜5km)が全日数の25.00%を占めており、イラクの乾燥および半乾燥気候において砂嵐の発生頻度が高いことが示された。ダストによる視程低下を除き、水滴の懸濁によって視程が1km未満となった日は霧の日として分類した。霧の日の割合は10.47%であり、主に冬季のイラク北部地域で観測された。雨の日は、測定可能な降水があった日であり、 >0.1 mm未満は7.40%であり、これはイラクの年間平均降水量が150~200 mmと少ないことに一致していた。降雪日(凍結降水が累積した日)は全日数の2.87%を占め、1月と2月の北部山岳地帯(クルディスタン地域)に限定されていた。これらの割合は、後にデータセット作成におけるランダムサンプリングの確率重みとして使用された。したがって、この合成データセットは、イラクの環境における各気象条件の実際的な出現頻度を反映している。
合成データ生成におけるバイアスの検討事項
バイアスを最小限に抑えるために、いくつかの対策を講じました:
(1) 分布の選択:ソースとなる気候データの統計的特性に基づいて確率分布を選択した。気温は、IMOSによって記録された平均値および標準偏差を持つ正規分布とした。湿度は、観測範囲全体(0-100%)において一様分布とした。視程については、砂嵐時に低視程イベントが頻繁に発生することを考慮し、対数正規分布に従うと想定した。粉塵濃度は指数分布に従い、低濃度での確率が高く、極端な粉塵イベントにおいて長い裾を持つ分布とした31。これは、イラクで観測された粉塵イベントの頻度と一致していた32
(2) 気象条件の割合:2020年から2024年までの全4地域における1,825件の日次観測データからなるIMOS記録を分析した結果、その割合は、快晴54.3%、黄砂24.9%、霧10.5%、雨7.4%、雪2.8%であった。降水のない日、視程 >視程が10 km以上で、ダスト活動が認められない日を快晴日と定義した。砂塵嵐が発生した日には、全日砂塵嵐(視程が <1 km) および浮遊塵(視程1~5 km)。霧の日とは、視程が1 km未満であり、かつその原因が水滴の浮遊(塵ではない)である日と定義した。雨の日とは、測定可能な降水があった日と定義した。 >0.1 mm。降雪日は、累積の凍結降水があった日と定義した。33.
(3) パラメータの範囲:パラメータの範囲は、IMOSの記録で観察された極値に基づいた。温度は−4.89 °C(モスル、冬)から47.99 °C(バスラ、夏)まで、視程は0.05 km(激しい砂嵐時)から29.99 km(快晴時)まで、そして粉塵濃度は0から4.96 mg/m3(激しいハブーブ発生時に観察された最大粉塵濃度に基づく)の範囲とした34。
(4) 独立性の仮定:環境パラメータが独立してサンプリングされたと想定しました。これは、大気変数が相互に相関している(例:高濃度の粉塵はしばしば低い視認性と相関する)現実世界の条件を簡略化したものです。体系的なモデル比較のための制御されたシミュレーション環境を提供するため、この独立性の仮定を採用しました35。これらの想定がもたらす影響については、「考察」の項で述べています。
(5) 層化分割:訓練データとテストデータの分割は、気象条件のカテゴリー(快晴、霧、雨、砂塵、雪)に基づいて層化して行われ、訓練セットおよびテストセットにおける各気象条件の割合が元のデータセットの分布と一致するようにしました。これにより、希少な気象条件(特に2.87%の雪)に関してテストセットに不均衡が生じないようにしています36。
決定論的なターゲット生成の確認
ここで見られた高い予測性能は、モデルが合成ターゲット値を生成するために使用された決定論的な物理方程式を学習、あるいは近似したことによる部分的な影響である可能性があることを指摘しておくことが重要である37。測定ノイズや装置誤差、モデル化されていない物理現象が含まれる現実世界の実験的測定とは異なり、合成データセットは入力特徴量と減衰ターゲットとの間に、ノイズのないクリーンな関係を提供している。これは、減衰値が入力パラメータに基づき、物理的な伝搬モデル(Beer-Lambert法、Kimモデル、Carbonneauモデル、およびMie散乱理論)から直接計算されたためである。したがって、定量的な性能指標(R2、RMSE、MAE)は、方程式から導出された合成データに対する性能を示すものであり、ノイズを含む観測データや実験データにおける期待性能として解釈されるべきではない。これらの結果は、主に制御されたシミュレーション環境におけるモデリング手法の比較評価として捉えられるべきである38。
モデルトレーニング用の完全な特徴量セット
トレーニングデータセットには、モデル学習用の入力特徴量が10個含まれていました:
1. 温度 (°C)
2. 湿度 (%)
3. 視程 (km)
4. 粉塵濃度 (mg/m3)
5. 降雨強度 (mm/h)
6. 降雪率 (mm/h)
7. 風速 (m/s)
8. 大気圧 (hPa)
9. 月(数値、1~12)
10. 季節(ワンホットエンコーディング:春、夏、秋、冬)
重要な補足説明:気象条件(快晴、霧、雨、塵、雪)は、データセット分割時の層別化のためのカテゴリ変数として使用されており、いずれのモデルの入力特徴量にも含まれていません。SHAP解析には、上述した10個の特徴量のみが含まれています。季節変数はワンホットエンコーディング(春、夏、秋、冬の4カテゴリ)されており、SHAP解析においては、ワンホットエンコードされた季節変数の寄与度を季節間で合算し、単一の季節寄与度として算出しました。この合算値は、減衰の予測に対するすべての季節関連変数の総寄与度を表しています。サマリー図を作成する前に、ワンホットエンコードされた4つの季節列を特定し、各サンプルのSHAP値を合計しました。この手法により、複合カテゴリ変数としての季節のモデル利用が、SHAP解析と整合することが保証されます。
物理的メカニズムを通じて光減衰に直接影響を与える主な環境要因は、特徴量1~6であった。補助的な気象要因として特徴量7および8(風速および気圧)を追加したことは、空気の安定性やエアロゾルの分散に影響を与えることで、減衰に間接的な影響を及ぼす可能性がある。大気状態の季節変動を考慮するため、時間的記述子として特徴量9~10(月および季節)を含めた。すべてのモデルにおいて、減衰値(dB/km)をターゲット変数として使用した。データセットの主要統計量には、温度(28.55°C ± 11.18°C)、湿度(42.01% ± 25.56%)、視程(13.10 ± 10.91 km; 範囲: 0.05–29.99 km)、粉塵濃度(0.74 ± 1.30 mg/m3; 最大値: 4.96 mg/m3)、減衰(4.80 ± 7.20 dB/km; 範囲: 0.09–50.93 dB/km)、動作範囲(5.74 ± 1.97 km)、および信号対雑音比(64.88 ± 15.07 dB)が含まれていた。動作範囲およびSNRは、標準的なFSOリンクバジェット方程式を用いて減衰値から算出した。
動作範囲の算出
動作範囲(km)は、リンクバジェット方程式を用いて算出しました:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
ここで:Prx = 受信電力(最小感度の −30 dBm に設定);Ptx = 送信電力(20 dBm に固定);Gt = 送信アンテナ利得(開口サイズから算出);Gr = 受信アンテナ利得(開口サイズから算出);λ = 波長(1550 nm);R = 距離 (km);A = 大気減衰量 (dB/km)(物理モデルから算出)。
送信機および受信機の利得:送信機利得(Gt)は、Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi として算出した。受信機利得(Gr)は、Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi として算出した。送信開口部の直径は 2.5 cm、効率は 0.7 であった。受信開口部の直径は 20 cm、効率は 0.7 であった。各減衰値に対して達成可能な最大リンク距離を決定するため、方程式を R について反復的に解いた。
信号対雑音比(S/N比)の算出
dB単位のSNR(信号対雑音比)は、以下の式を用いて算出した:
SNR=Prx−10×log₁₀(kTB)−NF (7)
ここで、Prx = 受信電力(dBm、リンクバジェットから算出)、k = 1.38×10⁻23 J/K(ボルツマン定数)、T = 290 K(受信機温度)、B = 109 Hz(受信帯域幅、1 GHz)、NF = 3 dB(受信機雑音指数)とする。ノイズフロアは次のように算出した:
10 × log10(kTB) ≈ −84 dBm (8)
各サンプルについて、適切な物理モデルを用いて減衰量Aを算出した後、リンクバジェットからRを求めることで動作範囲を導出し、その範囲における受信電力PrxからSNRを算出した。
天候別の動作範囲の値:動作範囲は天候条件によって異なり、快晴(7.12 ± 1.85 km)、霧(5.81 ± 1.92 km)、雪(5.42 ± 1.56 km)、雨(3.81 ± 0.98 km)、および砂塵(3.72 ± 1.08 km)であった。今回の計算では3 dBのマージンは適用しておらず、動作範囲はシステムマージンを含まない理論上の最大範囲を示している。報告された動作範囲(5.74 ± 1.97 km)は、すべての天候条件における総合平均である39。
固定伝送距離:物理的な減衰モデルにおける伝送距離は3 kmに設定されました。これは減衰計算が行われたリンク距離です。報告されている動作範囲は、リンクバジェット方程式を用いて算出された理論上の最大距離であり、固定の3 kmの伝送距離とは異なる場合があります。気象条件ごとの減衰値として、快晴(0.27±0.06 dB/km)、霧(1.88±1.92 dB/km)、雪(6.45±2.54 dB/km)、雨(13.58±6.32 dB/km)、および塵(13.10±7.32 dB/km)を記録しました。本論文で報告されているすべての定量値は、特に断りのない限り、平均値 ± 標準偏差(SD)として示しています40。
ランダムフォレストの交差検証R2は0.960±0.007と報告されています。温度(−4.89から47.99°C)、視程(0.05から29.99km)、粉塵濃度(0から4.96 mg/m3)、および減衰量(0.09から50.93dB/km)などの特定のケースでは、範囲(最小値から最大値)を文章で記載しています。データセットは、テスト用(300サンプル、20%)とトレーニング用(1,200サンプル、80%)のサブグループに分割されました。トレーニング・テスト分割には層化ランダムサンプリングを用いました。トレーニングセット(80%)およびテストセット(20%)における各気象条件の割合が元のデータセットの分布と一致するように、気象条件のカテゴリー(快晴、霧、雨、粉塵、雪)に基づいた層化を行いました。具体的には、1,500サンプルのうち1,200(80%)を学習セットに、300(20%)をテストセットに割り当てました。元の比率を維持しながら、気象条件の各カテゴリーからランダムにサンプルを選択しました。快晴のサンプル814件(54.27%)のうち651件をトレーニングに、163件をテストに、粉塵のサンプル375件(25.00%)のうち300件をトレーニングに、75件をテストに、霧のサンプル157件(10.47%)のうち126件をトレーニングに、31件をテストに、雨のサンプル111件(7.40%)のうち89件をトレーニングに、22件をテストに、そして雪のサンプル43件(2.87%)のうち34件をトレーニングに、9件をテストに割り当てました。再現性を確保するため、各層内でのランダムサンプリングにはランダムシード42を使用しました。この層化アプローチを採用した理由は、テストセットにおいて稀な気象条件(特に2.87%の雪)の表現が不均衡になることを防ぐためであり、そうしなければ、それらの条件に対する性能評価が信頼できないものになる可能性があるためです。
機械学習モデルの評価
放射基底関数カーネルを用いたサポートベクター回帰(SVR、C = 100)、K-近傍法(KNN; k = 10、距離重み付けあり)、RF(決定木数200、最大深さ = 20)、Extreme Gradient Boosting(XGBoost; 推定器数200、最大深さ = 10、学習率 = 0.1)、Light Gradient Boosting Machine(LightGBM; 推定器数200、最大深さ = 10、学習率 = 0.1)、およびベースラインとしての線形回帰を含む6つの機械学習手法を評価した。すべての機械学習およびディープラーニングモデルにおいて、最も重要なパラメータについてハイパーパラメータ調整を行い、指定のないパラメータについてはデフォルト値を維持した。機械学習モデルについては、トレーニングセットに対して5分割交差検証を用いたグリッドサーチにより、以下のパラメータを明示的に調整した:1) Random Forest:決定木数(検証範囲:50, 100, 150, 200, 250)および最大深さ(検証範囲:10, 15, 20, 25, 制限なし)とし、最適値として決定木数200、深さ20を選択した。2) XGBoost:推定器数(検証範囲:100, 150, 200, 250)、最大深さ(検証範囲:6, 8, 10, 12)、および学習率(検証範囲:0.05, 0.1, 0.2)とし、最適値として推定器数200、深さ10、学習率0.1を選択した。3) LightGBM:同一の調整範囲を用い、結果として推定器数200、深さ10、学習率0.1となった。4) SVR:正則化パラメータC(検証範囲:1, 10, 50, 100)およびカーネル係数gamma(検証範囲:‘scale’, ‘auto’, 0.1, 0.01)を調整し、最適値としてC = 100およびRBFカーネルを選択した。5) KNN:近傍数k(検証範囲:3, 5, 7, 10, 15)を調整し、最適値としてk = 10および距離重み付け投票を有効とした。
これらのモデルのその他のすべてのパラメータは、scikit-learnで定義されているデフォルト値のままとしました(バージョンについては材料表を参照してください。例:Random Forest:bootstrap=True, min_samples_split=2, min_samples_leaf=1;XGBoost:subsample=1.0, colsample_bytree=1.0, gamma=0)。ディープラーニングモデルについては、アーキテクチャ(層の数および層あたりのユニット数)とドロップアウト率(20%)を、検証セットを用いた反復的な実験を通じて手動で調整しました。一方、オプティマイザー(Adam)、初期学習率(0.001)、早期停止のパシェンス(20 epochs)、および学習率減少パラメータ(factor 0.5, patience 10)は、文献における標準的な慣行に基づいて設定し、すべてのディープラーニング実験において固定しました。
気候データのソース
2020年から2024年の間にイラク国内の複数箇所(バグダッド、バスラ、モスル、ラマディ)の気象観測所で収集された歴史的な気象情報を利用して、天候状態の割合と変数の分布を算出した。生データは、イラク運輸省およびイラク気象地震局(IMOS)より提供された。データには、各日の支配的な大気状態を詳述した日次の気象記録が含まれている。これらの記録から得られた具体的な変数には、気温(日次最低、最高、平均)、相対湿度、視程、降水量、および砂嵐の発生回数が含まれる。IMOSのデータの一部はイラク政府のオープンデータポータル(https://www.motrans.gov.iq/)を通じて入手可能であるが、本研究で使用した特定の記録は、中央リポジトリに公開保存されていない。天候条件の割合およびパラメータ範囲を決定するために使用した気候データの概要を表1に示す。
ハイパーパラメータの調整およびすべての機械学習モデルの性能評価のため、訓練セット(1,200サンプル)に対して5分割交差検証を用いました。すべての入力変数(気温、湿度、視程、粉塵濃度、降雨強度、降雪強度、風速、気圧)は、標準化(Zスコア正規化)によって特徴量スケーリングを行いました:x_scaled = (x − μ)/σ(ここでμとσは訓練セットの平均および標準偏差)。データリークを避けるため、各交差検証フォールド内での標準化は、訓練フォールドの統計量のみを用いて行いました。決定木ベースのモデル(Random Forest、XGBoost、LightGBM)はスケール不変性を持っていますが、すべての機械学習モデル間で一貫性を持たせるため、同様の標準化を適用しました。ディープラーニングモデルには、訓練セットの最小値と最大値に基づいて特徴量を[0, 1]の範囲にスケーリングするMin-max正規化を使用しました:x_scaled = (x−x_min)/(x_max−x_min)。入力値に境界を設けることでニューラルネットワークの収束が速くなるため、この手法を採用しました。テストセットは訓練セットから得られたパラメータを用いてスケーリングし、モデル選択やハイパーパラメータの調整には使用しませんでした。
決定係数(R2)、平均平方二乗誤差(RMSE)、平均絶対誤差(MAE)、クロスバリデーションR2、および学習時間を含む完全なパフォーマンス指標を記録した。すべての機械学習およびディープラーニングモデルの学習時間は、高速なモデル(線形回帰、KNN、SVR、ランダムフォレスト、XGBoost、LightGBM)については秒(s)、低速なモデル(ディープラーニングアーキテクチャ)については分(min)で報告している。公平な比較を確実にするため、すべてのモデルは同一の計算環境で学習させた41。
学習時間はPythonのtimeモジュールを使用して測定されました。つまり、データ読み込みおよび前処理に要する時間を除き、モデル適合関数の開始から終了までの経過実時間を指します。ディープラーニングモデルの学習時間とは、早期終了(early stopping)に至るまで、すべてのエポックを完了するのにかかった時間のことです。これには、順伝播、逆伝播、および検証チェックが含まれます。一貫した時間測定を得るため、すべての実験は、他に計算負荷の高いプロセスが動作していないシステム状態で実施されました。記載されている時間は、5回の独立した試行の平均値(標準偏差)です42。
ディープラーニングモデルの評価
GPU加速を用いて、多層パーセプトロン(MLP; 64-32-16)、バッチ正規化を用いたディープニューラルネットワーク(DNN; 128-64-32-16)、長短期記憶ネットワーク(LSTM; 64-32ユニット、シーケンス長 = 10)、1次元畳み込みニューラルネットワーク(1D-CNN)、CNN-LSTMハイブリッドモデル、およびアテンションベースネットワークの6つのディープラーニングアーキテクチャを評価した。すべてのディープラーニングモデルは、Keras APIを備えたTensorFlowを使用して実装し、GPU加速を用いて実行した(ハードウェアおよびソフトウェアのバージョンについては材料表を参照)。1D-CNNアーキテクチャは、3つの畳み込み層(フィルター数64、128、256、カーネルサイズ3、ReLU活性化関数、パディング='same')、2つのMaxPooling1D層(プールサイズ2)、1つのGlobalAveragePooling1D層、128ユニットのReLU活性化Dense層、ドロップアウト層(0.2)、およびDense出力層(1ユニット、線形活性化関数)で構成され、学習可能なパラメータの合計は約245,000であった。CNN-LSTMハイブリッドアーキテクチャは、5つの特徴量を持つ10タイムステップの入力シーケンスを受け取り、2つのConv1D層(フィルター数64および128、カーネルサイズ3、ReLU、パディング='same')、1つのMaxPooling1D層(プールサイズ2)、2つのLSTM層(64および32ユニット、return_sequences=False)、ドロップアウト層(0.2)、Dense層(32ユニット、ReLU)、およびDense出力層(1ユニット、線形活性化関数)を使用し、学習可能なパラメータの合計は約198,000であった。アテンションベースネットワークでは、4つのヘッド(キーおよびバリューの次元は64)を持つマルチヘッドアテンションメカニズムを使用し、入力を64次元に投影した後、スケールドットプロダクトアテンション(式:Attention(Q, K, V) = softmax(QKT/√d_k)V)、残差接続、レイヤー正規化、フィードフォワードネットワーク(128→64ユニット)、グローバルアベレージプーリング、ドロップアウト(0.2)、Dense層(32ユニット、ReLU)、およびDense出力層(1ユニット、線形活性化関数)を構成し、学習可能なパラメータの合計は約167,000であった43。
すべてのモデルで、早期停止(patience = 20)、学習率の低減(factor = 0.5、patience = 10)、ドロップアウト(20%)、およびAdamオプティマイザ(learning rate = 0.001)を使用しました。すべてのディープラーニングモデルにおいて、バッチサイズは32サンプルに設定し、最大トレーニングエポック数は早期停止(patience = 20、最良の重みを復元)を伴い200回とし、損失関数には平均二乗誤差(MSE)を用いました。トレーニングデータと検証データの分割は以下の通りです。元の1,200個のトレーニングサンプル(80/20のトレーニング・テスト分割後)のうち、80%(960サンプル)をトレーニングに、20%(240サンプル)を検証に使用しました。分布を維持するため、トレーニング・検証分割は気象条件によって層化しました。検証セットは、早期停止、学習率の減衰、および過学習のモニタリングにのみ使用され、これらの自動化された手順以外のモデル選択やハイパーパラメータ調整には一切使用されませんでした。機械学習モデルについては、別途検証セットを確保せず、代わりに1,200個のトレーニングサンプルを用いて5分割交差検証を行い、ハイパーパラメータの調整および性能推定を行いました44。
LSTMおよびCNN–LSTMアーキテクチャ評価の正当性
メインのデータセットは独立して生成された気象サンプルで構成されていますが、以下の理由からLSTMおよびCNN–LSTMアーキテクチャの検証も行いました。(1) 現実世界の気象条件は時間的な自己相関を持っており、シーケンスベースのモデルを検証することで、そのような依存関係を捉えることが予測精度の向上に寄与するかどうかを判断できるため。(2) 気象予測に関する近年の研究において、気象パラメータの時間的推移をモデリングするためのシーケンシャルアーキテクチャの潜在的な有用性が示されているため34。(3) 多様なアーキテクチャを検証することで、手法的なアプローチの包括的な比較が可能となり、それが本研究の主要な貢献となるため。(4) CNN–LSTMハイブリッドアーキテクチャは、空間的な特徴抽出と時間的なモデリングを組み合わせており、複数の気象変数間の複雑な相互作用を捉える上で有益である可能性があるため45。
逐次モデル入力のためのデータフォーマット
逐次的なアーキテクチャ(LSTMおよびCNN–LSTM)では、入力データはスライディングウィンドウ法を用いて、独立したサンプルから擬似シーケンスへと再構成された。具体的には、まず物理的な一貫性を維持するため、1,200個の学習サンプルを気象条件のカテゴリーごとにグループ化した。各気象カテゴリー内において、サンプルを生成されたタイムスタンプ(2024年のカレンダー年の模擬1時間ごとの観測値)に従って並べた。その後、長さ10のスライディングウィンドウを適用し、10個の連続したタイムステップ(各ステップに温度、湿度、視程、粉塵濃度、降水強度の5つの特徴量を含む)からなる入力シーケンスを作成し、11番目の時点における減衰量を予測した。th タイムステップ。この手法により、シミュレーションによる観察結果の時系列順序を維持しつつ、シーケンシャルモデルが時間的依存性を学習することが可能になります。テストセットの構造は、ウィンドウサイズと特徴量セットが同一である点を除き、同様に構成されました。このような擬似的なシーケンシャル構造化は、手法上の簡略化であり、現実世界の時間的ダイナミクスを反映しているわけではないことを認識しています。この点については、考察セクションで制限事項として記述しています。
ハイブリッドアプローチの評価
3つのハイブリッドアプローチを検討しました。1つ目のアプローチは、Random Forest、XGBoost、およびDeep Neural Networkモデルからの予測を等しい重み(各モデルに1/3の重みを割り当て)で平均化するVoting Ensembleであり、最終的な予測は以下のように計算されました:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
追加のハイパーパラメータを導入することを避け、個々のモデルに対するバイアスなしにベースラインのアンサンブル性能を評価するため、等重量配分を採用しました。2つ目のアプローチでは、Ridgeメタ学習器によるスタッキングを用いました。ベース学習器には、Random Forest、XGBoost、およびDeep Neural Network(Attentionベース)を使用しました。スタッキングの手順は2段階で構成されています。まず、各ベース学習器を1,200サンプルの全トレーニングセットで5分割交差検証を用いて学習させ、アウトオブフォールド予測を生成し、1,200×3サイズの新しいメタ特徴量行列(1サンプルあたり各ベースモデルから1つの予測値)を作成しました。次に、これらのメタ特徴量を用いて、元の減衰値をターゲットとするRidge回帰メタ学習器(L2正則化パラメータ alpha=1.0)を学習させ、ベース学習器の最適な組み合わせ重みを学習させました。最終的なスタッキング予測は以下の通りです:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
ここで、重み w は Ridge メタ学習器によって学習されました。3番目のアプローチは、霧条件下におけるサンプルに対して、ニューラルネットワークの予測結果の 70% と Kim モデルからの予測結果の 30% を組み合わせた物理情報ニューラルネットワーク(Physics-Informed Neural Network)でした。この組み合わせは、以下の式を用いた固定重み平均によって行われました:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
ここで、ŷneuralはAttentionベースのニューラルネットワークの出力であり、ŷKimは視認性の入力に基づきKim霧モデルから算出された減衰量である。非霧サンプルの場合、物理部分は0に設定され、モデルは純粋なニューラルネットワークとして実行された。重み(ニューラル70%、物理30%)は、検証セット(テストセットではない)を用いた予備実験において、90:10、80:20、70:30、60:40、および50:50の重みの組み合わせを検証した結果に基づき固定された。70/30の分割が選択されたのは、これが最高の検証R2を示し、かつ予測を正則化して物理的に不可能な出力を回避するための十分な物理的制約をKimモデルから維持できたためである。これは特に、Kimモデルが確立された理論的な減衰限界を提供する霧の状態において有効であった。
特徴量の重要度および解釈可能性の解析
不純度ベースの特徴量重要度(分散減少量)を用いたランダムフォレストモデルを使用して、10個すべての入力特徴量の重要度ランキングを抽出した。解析の結果、ダスト濃度(67.3%)と視程(21.2%)が最も重要な予測因子であり、合計で予測重要度の88.5%を占めることが示された。3番目に重要な特徴量は降水強度(6.0%)であり、次いで風速(2.1%)、温度(1.5%)、湿度(0.9%)、月(0.5%)、季節(0.3%)、降雪強度(0.1%)、気圧(0.1%)の順であった。時間的特徴量(月および季節)の重要度スコアが低いことは、大気減衰の季節変動が、時間的なパターン単体ではなく、主に基礎となる環境パラメータによって捉えられていることを示している。
環境要因と減衰の間の関係を評価するために、SHAP (Shapley Additive exPlanations) 解析を実施した。SHAPの実装には、Random Forest、XGBoost、LightGBMを含む決定木ベースのモデルに特化して最適化されたSHAPライブラリのTreeExplainerモジュールを使用した(バージョンについては材料表を参照)。SHAP解析の設定は以下の通りである。学習済みRandom ForestモデルをTreeExplainerに渡し、モデル出力の条件付き期待値に基づく介入的(周辺的)特徴量アトリビューション手法を用いてSHAP値を算出した。テストセットの全300サンプルに対してSHAP値を算出し、300 × 10(サンプルあたりの特徴量ごとに1つのSHAP値)の行列を作成した。各特徴量において、SHAP値はベースライン(モデルの平均予測値)に対する予測への寄与度を表している。負のSHAP値は予測値の下方へのシフトを示し、正のSHAP値はその特徴量が減衰の予測値を押し上げたことを示した。寄与の強さはSHAP値の絶対値によって示された。各特徴量のSHAP値の分布(ビースウォームプロットを使用)、影響の方向(特徴量とSHAP値の相関)、および特徴量重要度のランキングを、サマリープロットを用いてすべて可視化した。すべてのSHAP可視化の作成には、SHAPライブラリの内蔵プロット関数である、ビースウォームプロット用のshap.summary_plot()およびグローバルな特徴量重要度用のshap.bar_plot()を使用した。
ワンホットエンコーディング済み変数の処理:まず、季節変数をエンコードするために4つのバイナリ列(spring、summer、autumn、winter)を使用しました。SHAP解析においてサンプルごとに単一の「季節」寄与度を作成するため、これら4つのワンホットエンコーディング済み変数の寄与度を、各季節カテゴリーのSHAP値を加算することで統合しました。このグループ化を行うため、ワンホットエンコードされた季節グループに対応するすべての列を特定し、各サンプルのSHAP値を抽出して、それらを要素ごとに合計しました。これにより得られた統合SHAP値が、減衰予測に対する季節の全体的な寄与度を表します。この手法により、SHAPサマリープロットに単一の「季節」行を表示することが可能となり、複合的なカテゴリ変数としての季節というモデルの使用法との整合性が保証されます。統合された数値の方が季節の総寄与度をより分かりやすく表現できるため、季節のSHAP値は各季節カテゴリーごとに個別に表示しませんでした。
結果
合成データセットの特徴は、以下にまとめられています。 図1A–Fデータセットには、快晴、砂塵、霧、雨、および降雪の条件が含まれていた。 (図1A)、サンプルは高温乾燥期および低温湿潤期にわたって分布しており(図1B)および昼間と夜間の期間(図1C)。異なる気象条件下における温度、湿度、および視程の分布を(図/表)に示します。 図1D–F.
機械学習モデルは、大気減衰の推定において強力な予測性能を示した(Figure 2A–D; Table 3)。評価したモデルの中で、RFが全体的に最も高い性能を達成し、テストR2は0.9654、RMSEは1.324 dB/kmであった(Figure 2A; Table 3)。RFは予測誤差を1.5 dB/km未満に維持しつつ、観測された変動の96.54%を説明した。XGBoostも良好な性能を示し(Figure 2C)、次いでLightGBMであった(Figure 2B)。モデルの堅牢性は5分割交差検証によって裏付けられ、RFは交差検証R2 0.960 ± 0.007を達成した(Figure 2D)。対照的に、K-Nearest NeighborsはトレーニングR2が1.000、テストR2が0.7341となり、過学習の兆候を示した。一方、線形回帰は中程度の予測性能であった(Figure 2A; Table 3)。
上述の10個の入力特徴量に関する特徴量の重要度分析を図3Aに示します。相対的な重要度スコアの順位は、ダスト濃度(67.3%)、視程(21.2%)、降雨強度(6.0%)、風速(2.1%)、気温(1.5%)、湿度(0.9%)、月(0.5%)、季節(0.3%)、降雪強度(0.1%)、気圧(0.1%)の順となっています。変数「気象条件」はデータセットの層別化に使用されていますが、これは複数の基礎的な物理パラメータを表すカテゴリカルな複合変数であり、その影響は個別の環境特徴量によって捉えられるため、特徴量の重要度分析には含まれていません。特徴量の重要度および解釈可能性の分析により、減衰と最も強く関連する環境変数が特定されました(図3A,B)。ダスト濃度(67.3%)、視程(21.2%)、および降雨強度(6.0%)で、総予測重要度の94.4%を占めていました(図3A)。さらにSHAP分析により、ダスト濃度の増加および視程の低下が、減衰予測の上昇に関連していることが示されました(図3B)。
ディープラーニングモデルは、機械学習アプローチよりも予測性能が低いことを示した(Figure 4A–D)。最も高い性能を示したディープラーニングモデルであるAttention-based networkは、R2が0.7766、RMSEが3.362 dB/kmであった(Figure 4A)。再帰型アーキテクチャは特に性能が悪く、LSTMおよびCNN–LSTMモデルはいずれもR2値がほぼゼロとなり、RMSE値は7.19 dB/kmを超えた(Figure 4B)。LSTMおよびCNN-LSTMアーキテクチャの性能が相対的に低かったこと(R2 = それぞれ0.0110および0.0109、RMSE = それぞれ7.193 dB/kmおよび7.196 dB/km)は、入力データの擬似的なシーケンシャルな性質により、大気条件の真の時間的ダイナミクスを完全には捉えられていないことで部分的に説明できる。
逐次的な依存関係が強く明確に定義されているリアルタイムの時系列アプリケーションとは異なり、本研究のデータセットは、主に人工的に時間的順序を付与した独立したサンプルで構成されていました。これらのアーキテクチャの予測性能が低かったことは、スライディングウィンドウ法によって抽出された時間情報が不十分であったか、あるいは実際の大気の進化を代表していなかったことを示唆しています(図 4C)。このことは、このような性質のデータセットに対しては、複雑なシーケンスベースのディープラーニングモデルよりも、よりシンプルな機械学習アプローチの方が適しているという我々の結論を裏付けるものです。すべてのディープラーニングアーキテクチャの検証性能を図 4Dにまとめます。
機械学習、ディープラーニング、およびハイブリッドアプローチの性能は、図 5A,B および 表 3 にまとめられています。ハイブリッド手法の中では、Voting Ensembleが R2 0.9340、RMSE 1.827 dB/km を達成しました (図 5A,B; 表 3)。Ridge メタラーナーによるスタッキングは、R2 0.9571、RMSE 1.473 dB/km を達成し (図 5A,B; 表 3)、RF の性能に匹敵しましたが、学習時間に大幅に時間を要しました。Physics-Informed Neural Network は R2 = 0.8269、RMSE = 2.960 dB/km を達成し (図 5A,B; 表 3)、ディープラーニングモデルよりも優れた性能を示しましたが、最良の機械学習アプローチには及びませんでした。RF と Stacking Ensemble モデルの統計的比較では、予測性能に有意な差は認められませんでした (表 3; 対応のある t 検定: t = −1.74, p = 0.083)。したがって、RF が数値的に最高の R2 を達成したものの、最良のハイブリッドアプローチとの差は統計的に有意ではありませんでした。
全体として、これらの結果は、機械学習アプローチによってイラクの気象条件下での大気減衰を正確に予測できるという仮説を支持するものである。RFは一貫して最高の予測性能を示し(Figure 2A,B; Table 3)、特徴量の重要度およびSHAP解析により、減衰に影響を及ぼす支配的な環境要因として粉塵濃度と視程が特定された(Figure 3A,B)。
検証データの声明:すべてのモデル評価は、「方法」セクションで詳述されている合成データセットを用いて行われました。モデルの検証において、大気減衰に関する実験データや観測データは使用されていません。合成データセットは、イラクの気候記録に基づく確率分布から選択された気象パラメータを用い、既知の物理的伝搬モデル(Beer-Lambert法、Kimモデル、Carbonneauモデル、およびMie散乱理論)を使用して作成されました。「方法」セクションで述べられているように、強力な予測性能は、モデルの学習、またはターゲット値の生成に使用された決定論的な物理方程式の近似を部分的に反映している可能性があります。したがって、定量的性能指標(R2、RMSE、MAE)は、方程式から導出された合成データに対する性能を表しており、運用上のFSOシステムの絶対的な性能保証としてではなく、制御されたシミュレーション環境におけるモデリング手法間の相対的な比較として解釈されるべきです。このアプローチは、予測モデリング手法(表2に記載)の比較評価のための制御環境を提供しますが、実際のイラクの気象条件下での実際のFSO減衰測定による検証に代わるものではありません。
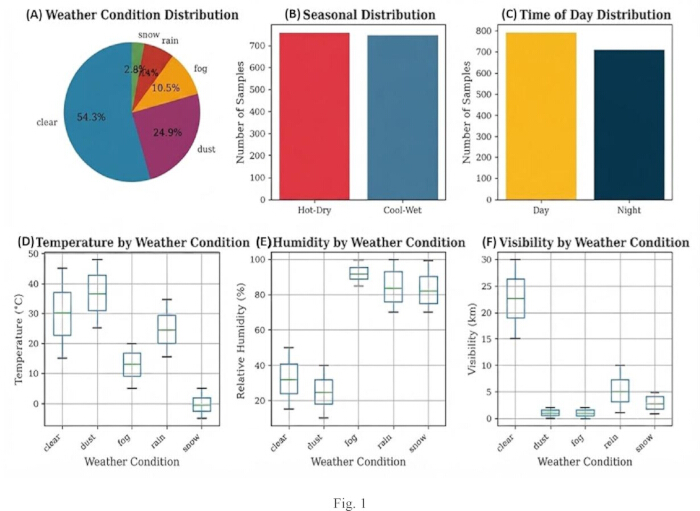
図1: 大気減衰モデリングに使用した合成データセットの特性および環境変数。 (A) 快晴、塵、霧、雨、雪を含む、データセットに含まれる気象条件の分布。 (B) 高温乾燥期および低温湿潤期におけるサンプルの季節分布。 (C) 日中および夜間の条件下で収集されたサンプルの分布。 (D) 各気象条件における温度分布。 (E) 各気象条件における湿度分布。 (F) 各気象条件における視程分布。ボックスプロットは、中央値(中心線)、四分位範囲(ボックス)、および最小値と最大値(ひげ)を示す。温度は°C、湿度は%、視程はkmで表記されている。ここをクリックして、この図の拡大版を表示してください。
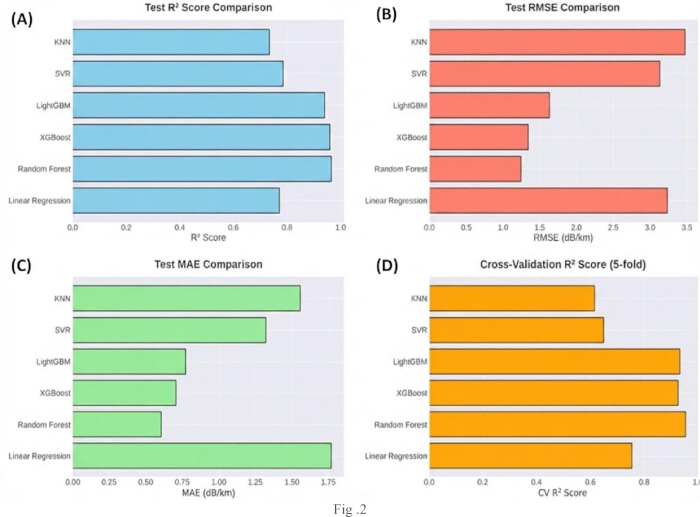
図2大気減衰予測における機械学習モデルの性能比較。 (A決定係数(R²)の検定2線形回帰、ランダムフォレスト、Extreme Gradient Boosting (XGBoost)、Light Gradient Boosting Machine (LightGBM)、サポートベクター回帰 (SVR)、および K-近傍法 (KNN) を含む、評価した機械学習モデルのスコア。B) 各機械学習モデルのテスト平方根平均二乗誤差(RMSE)値。 (C) 各機械学習モデルの平均絶対誤差(MAE)値を検証する。 (D) 交差検証決定係数 (R^2)2) は5分割交差検証を用いて得られたスコアである。Rが高いほど2 値が小さく、RMSEおよびMAEの値が低いほど、予測性能が向上していることを示す。RMSEおよびMAEの単位はdB/kmである。 こちらの図の拡大版を表示するには、ここをクリックしてください。
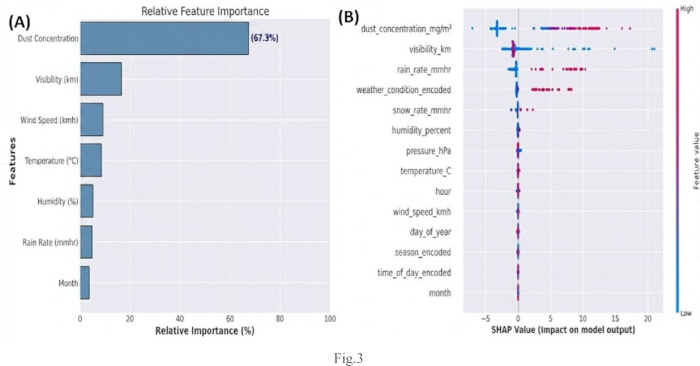
図 3: 大気減衰予測における特徴量重要度およびモデル解釈性分析。 (A) ランダムフォレストモデルによる相対的不純度ベースの特徴量重要度ランキングであり、10個のすべての環境変数および時間変数が減衰予測に与える寄与度を示している。最も影響力のあった特徴量は粉塵濃度 (67.3%) であり、次いで視程 (21.2%)、降雨強度 (6.0%)、風速 (2.1%)、温度 (1.5%)、湿度 (0.9%)、月 (0.5%)、季節 (0.3%)、降雪強度 (0.1%)、気圧 (0.1%) の順であった。相対的重要度は、モデル全体の重要度に対する割合(%)である。 (B) 個々の特徴量がモデル予測に与える影響を示す SHapley Additive exPlanations (SHAP) サマリープロット。SHAP 行列は 300 個のテストセットサンプル (300 × 10 特徴量) に対して算出された。ワンホットエンコーディングされた季節変数 (元は春、夏、秋、冬の 4 つのバイナリ列) については、4 つのカテゴリを合算してサンプルあたりの単一の「季節」寄与値を算出した。各点は1つのサンプルを表し、カラースケールは特徴量の値が低い (青) から高い (赤) までの範囲を示している。正の SHAP 値は予測される減衰の増加を、負の SHAP 値は予測される減衰の減少を示している。こちらのリンクから、この図の拡大版を表示してください。
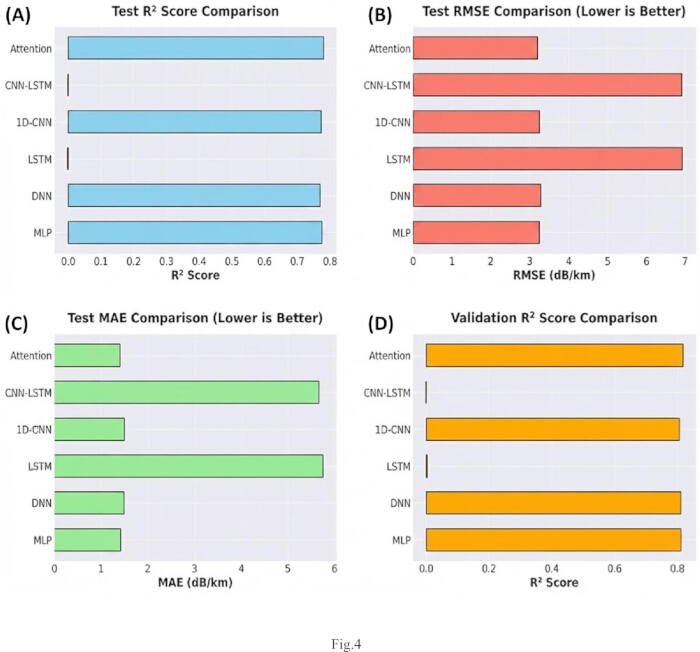
図 4: 大気減衰予測におけるディープラーニングモデルの性能比較。 (A) 多層パーセプトロン (MLP)、ディープニューラルネットワーク (DNN)、長短期記憶 (LSTM)、1次元畳み込みニューラルネットワーク (1D-CNN)、畳み込みニューラルネットワーク・長短期記憶 (CNN–LSTM)、およびアテンションベースモデルを含む、評価対象のディープラーニングアーキテクチャのテスト決定係数 (R2) スコア。 (B) 各ディープラーニングモデルのテスト平均二乗誤差平方根 (RMSE) 値。 (C) 各ディープラーニングモデルのテスト平均絶対誤差 (MAE) 値。 (D) 評価対象のディープラーニングモデルの検証決定係数 (R2) スコア。R2 値が高く、RMSE および MAE 値が低いほど、予測性能が向上していることを示す。RMSE および MAE の単位は dB/km である。 こちらのリンクをクリックして、この図の拡大版を表示してください。
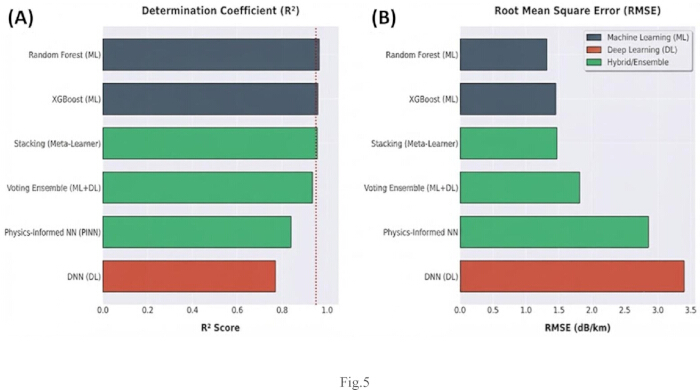
図 5: 大気減衰予測における機械学習、ディープラーニング、およびハイブリッドモデルの性能比較。 (A) Random Forest、Extreme Gradient Boosting (XGBoost)、Deep Neural Network (DNN)、Voting Ensemble、Stacking、および Physics-Informed Neural Network モデルを含む、代表的な機械学習、ディープラーニング、およびハイブリッドアプローチの決定係数 (R2) 値。(B) 同モデルの平均二乗二乗根誤差 (RMSE) 値。モデルは、機械学習 (ML)、ディープラーニング (DL)、およびハイブリッド/アンサンブル手法の3つのカテゴリーで色分けされている。R2 が高く、RMSE 値が低いほど、予測性能が向上していることを示す。RMSE は dB/km で表記されている。こちらのリンクから、この図の拡大版を表示できます。
| 気象条件 | 割合 | 温度範囲 | 湿度範囲 | 視認範囲 | 主要パラメータ範囲 |
| 快晴 | 54.27% (814サンプル) | −4.89から 47.99°C | 0–100% | >10 km | — |
| ダスト | 25.00% (375サンプル) | 10–45°C | 10–60% | 0.05–5 km | 粉塵:0–4.96 mg/m³3 |
| 霧 | 10.47%(157サンプル) | -5から 20°C | 70–100% | 0.05–1 km | — |
| 雨 | 7.40% (111サンプル) | 5–30°C | 60–100% | 1–10 km | 降水量:0.25–50 mm/h |
| 雪 | 2.87% (43サンプル) | −10から 5°C | 50–100% | 0.5–5 km | 降雪量:0.5–15 mm/h |
表 1:大気減衰予測における機械学習モデルの性能指標。
| モデル | テスト R2 | RMSE (dB/km) | MAE (dB/km) | CV R2 | トレーニング時間 (s) |
| ランダムフォレスト | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| サポートベクター回帰 (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| 線形回帰 | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-最近傍法 (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
表 2:特定のディープラーニング、ハイブリッド、および機械学習モデルの比較評価。
| モデル | カテゴリー | テスト R2 | RMSE (dB/km) | 順位 |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | ハイブリッド | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | ハイブリッド | 0.934 | 1.827 | 5 |
| Physics-Informed Neural Network | ハイブリッド | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
表 3:評価した各モデルの計算効率(学習および推論)の比較。
データの 可用性:
すべての入力特徴量(温度、湿度、視程、粉塵濃度、降雨率、降雪率、風速、気圧、月、季節、および気象条件)とターゲット変数(dB/km単位の減衰量)を含む1,500サンプルの完全な合成データセットは、本論文の補足ファイルとしてhttps://doi.org/10.5281/zenodo.21792999で提供されています。データセットは、各サンプルが1行となり、すべての計算変数(動作範囲およびSNR)が含まれる形式で構成されています。
データ生成スクリプト(物理モデルの実装)、前処理および特徴量スケーリング用の関数、すべての機械学習モデルの実装、すべてのディープラーニングモデルの実装、評価および視覚化用のスクリプト、ならびにハイパーパラメータ調整および交差検証の手順を含む完全な実装コードについても、補足ファイルとして提供される予定です。
気候データのソース:合成データの分布を定義するために使用した気候データは、2020年から2024年までの期間を対象として、イラク気象地震局(IMOS)およびイラク運輸省から取得しました。気象条件の割合およびパラメータ範囲を決定するために使用した気候データの概要は、付録表1に示しています。本研究で使用した特定のIMOS記録は、中央リポジトリに公開アーカイブされていませんが、IMOSに直接請求することが可能です。再現性を確保するため、要約統計量および導出された確率分布を付録資料に提供しています。
リポジトリ情報:ソースコードおよびデータセットは、パブリックリポジトリ(Zenodo)に https://doi.org/10.5281/zenodo.21792999 で公開されています。
ディスカッション
イラクの気象条件下で動作するFSO通信システムにおける大気減衰を予測するため、本研究では機械学習、ディープラーニング、およびハイブリッド手法を評価した。大気による影響は、リンク性能と可用性に影響を及ぼす主要な課題の一つであり続けているため、近年の評価ではFSOシステムにおける予測モデリングの重要性が高まっていることが強調されている21。結果として、従来の機械学習アプローチ、特にRFおよびXGBoostが高い予測精度を示し、場合によっては数値的にディープラーニングやハイブリッド手法を上回ることが示された。しかし、統計検定ではRFと最良のハイブリッドアンサンブル(Stacking)との間に有意な差(p=0.083)は認められず、このデータセットにおいては両アプローチで同様の結果が得られることを意味している。我々の知見は、中規模のサンプルサイズで支配的な予測変数が少数である表形式の環境データに対しては、決定木ベースのアンサンブル手法が依然として非常に高性能であることを示唆している。特徴量の重要度分析により、粉塵濃度と視程が減衰の主な要因であり、これらが予測能力の大部分を説明していることが示された。この結果は、霧、粉塵、エアロゾル、および大気汚染が光信号の伝搬に重要な影響を与えることを示した先行研究と一致している22,23,24,25。同様の知見は環境モニタリングアプリケーションにおいても報告されており、機械学習モデルは、少数の非常に情報量の多い変数を含むデータセットから利益を得ることが多い26,27,28,29,30,31,32。さらに、SHAP分析により、個々の環境パラメータが減衰予測に与える影響を定量化することで、モデルの解釈性が向上した。
ディープラーニングモデルの性能が低かったことは、いくつかの要因に起因すると考えられます。複雑なニューラルアーキテクチャをトレーニングするには、データセットのサイズが比較的限定的であり(https://doi.org/10.5281/zenodo.21792999 参照)、また環境変数の特徴量の重要度が非常に集中していました。先行研究では、ディープラーニング手法は一般的に、大規模なデータセット、階層的な特徴量構造、および複雑な非線形表現から恩恵を受けることが示されています33,34,35,36,37。対照的に、本研究で使用した減衰データセットには、支配的な予測変数が限られた数しか含まれておらず、リカレントアーキテクチャに必要な時間的依存性が欠けていました。LSTMおよびCNN–LSTMモデルの性能が悪かったことは、本アプリケーションにおいて逐次学習メカニズムが大きな利点をもたらさない可能性を示唆しています。
大気減衰の予測因子として、粉塵濃度(67.3%)と視程(21.2%)が支配的であることは、いくつかの要因に起因すると考えられます。第一に、1550 nmにおける分子散乱および吸収は、粉塵粒子によるミー散乱によってかき消されるためです。ミー理論において、消散効率Q_extは粒子濃度に非常に敏感であり、中〜高濃度の領域では減衰は粉塵濃度とほぼ線形に比例します。第二に、イラクでは頻繁に砂嵐が発生しており(気候記録において全日数の25.00%)、その結果、4–30 dB/kmの減衰値が生じます。これは、霧(10.47%、0.5–10 dB/km)や雨(7.40%、2–25 dB/km)とは対照的です。粉塵による減衰の変動性がより大きいため、モデルが学習するためのより強力な信号が得られます。第三に、粉塵濃度の指数分布(0.4–4.96 mg/m3)が、広範囲の減衰値を生成するためです。極端な粉塵イベントにおけるロングテールが、正確な予測に重要な高い減衰値をもたらします。第四に、ミー散乱モデルは粉塵濃度に対して(概ね線形という)単純な依存関係を持っており、これはKimモデルにおける視程と霧の減衰の間のより複雑な関係に比べて、決定木ベースのモデルで近似しやすいためです。第五に、中東におけるFSOにとって砂嵐は最も困難な環境条件の一つであるため、この知見は実用的な意義を持ちます。砂嵐発生時の正確な予測は、システムの信頼性の高い運用のために不可欠です。
本知見は、大気減衰予測におけるアルゴリズム選択のための実用的な指針を提供することで、FSO通信の研究を前進させるものである。正確な減衰予測は、ネットワーク計画、適応的リンク管理、および中東などの困難な環境における光通信システムの信頼性の高い展開にとって不可欠である23,28,30,36。さらに、この手法は、空気伝搬、大気モニタリング、および光ネットワークの性能評価を含む他の環境予測問題にも適用可能であると考えられる38,39,40。より大規模な実データセット、精緻なアンサンブル学習手法、転移学習フレームワーク、あるいはより複雑な物理学に基づいたアーキテクチャなどが、この概念を検証するためのその他の手法として挙げられる41,42,43,44,45。
結論の範囲と一般化に関する問題
本研究の結論は、主に確立された物理的な伝播モデル(Beer-Lambertの法則、Kimモデル、Carbonneauモデル、およびMie散乱理論)から生成された合成データセットに基づいています。この手法上のアプローチは、我々の知見の適用範囲と汎用性に関して、いくつかの影響を及ぼします:
シミュレーションデータから得られた結論:(1)大気減衰予測における機械学習、ディープラーニング、およびハイブリッドアプローチの比較性能ランキング。(2)モデル化された条件下において、光学減衰の主要な環境予測因子として粉塵濃度と視程が特定されたこと。(3)ディープラーニングアーキテクチャに対する、決定木ベースのアンサンブル手法の計算効率上の優位性。(4)モデルの予測を説明するための、特徴量の重要度およびSHAP分析による解釈性。
実世界での確認を要する結論:(1)評価モデルによって得られた R2 および RMSE の絶対値は、合成データセットの固有の特性に依存しており、ターゲットの生成に使用された決定論的な物理方程式をモデルが学習した結果を反映している可能性がある。(2)最良のモデルである Random Forest が、未知の実世界の気象条件に適用可能であることはまだ証明されていない。(3)得られた知見を、イラクに設置された運用上の FSO ユニットに適用するためには、フィールド検証が必要である。(4)特定された特徴量の重要度ランキングが、フィールド測定条件下でも堅牢であることを確認する必要がある。
方程式から導出された合成データにおける性能と、ノイズを含む観測データまたは実験データにおける性能を区別することが重要です。合成データセットは、入力特徴量と減衰ターゲットとの間にノイズのないクリーンな関係を提供するため、測定ノイズ、機器誤差、およびモデル化されていない物理現象を含む実世界のデータで得られるよりも高い予測性能指標を示す可能性があります。本研究で提示した結果を検証し、提案した手法の真の汎用性を評価するために、今後の研究ではイラクの気象条件下での実世界のFSO減衰測定データの取得に取り組むことを推奨します。
モデルの汎化性能に対する合成データの影響
本研究において合成データを使用したことによる影響は、モデルの汎用性の観点から慎重に検討されるべきです。
合成アプローチの利点:本データセットは、確立された物理伝搬モデルを用いることで、物理的に整合性があり、確立された理論的枠組みに基づいています。気象パラメータは、データセットにイラクの実際の気象条件の統計的特性を反映させるため、イラクの気象記録から抽出されました。これにより、フィールド測定における混乱変数(測定誤差、機器の校正、データ記録の不足など)を回避できるだけでなく、制御された設定の下でモデリング手法を体系的に検討することが可能になります。
汎用性における限界:本合成データセットには、以下を含む実際のの大気減衰の完全な複雑さを捉える上での限界があります:(1) 同時に発生する複数の大気現象の相互作用、(2) 大気パラメータの非線形および非定常的な挙動、(3) サンプリング分布では捉えきれない長期的な気候変動、(4) FSO伝搬に大きな影響を与える可能性のある局所的な微気候効果、および(5) 現実世界のデータ収集に固有のノイズと不確実性。
合成データ生成におけるバイアスの検討 環境パラメータの独立サンプリングという仮定(「方法」を参照)は、現実世界の状況を過度に単純化したものです。現実には、大気変数は相互に相関する傾向があります(例:高濃度の粉塵は視程の低さと相関する傾向がある)。系統的なモデル比較を行うための制御されたシミュレーション環境を構築するため、独立性の仮定を採用しました。しかし、この手法では大気パラメータ間の相互作用の複雑さを完全に捉えきれない可能性があります。そのため、テストセットにおいて稀な条件下(特に2.87%の積雪)の表現が不均衡になる可能性を最小限に抑えるため、層化抽出法(トレーニングセットとテストセットにおける気象条件の比率を維持する方法)を採用しています。
決定論的なターゲット生成:本研究で観察された高い予測性能は、ターゲット値の生成に使用された決定論的な物理方程式をモデルが学習したことで、部分的に説明できる可能性があります。対照的に、現実世界の実験データには、測定ノイズ、計器誤差、およびモデル化されていない物理現象が含まれており、予測をより困難にします。したがって、定量的な性能指標(R2、RMSE、MAE)は、運用上のFSOシステムに対する絶対的な性能保証としてではなく、制御されたシミュレーション環境における手法間の相対的な比較として解釈されるべきです。
したがって、合成データの物理的な一貫性により、モデルの性能ランキングに関する比較結果は堅牢である可能性が高いと考えられますが、絶対的な性能指標(R2、RMSE、MAE)を、実際のFSOシステムの期待される性能を示すものとして捉えるべきではありません。イラクのさまざまな気象条件下で得られた実験的な大気減衰測定値を用いて、現実世界の設定に対するモデルの汎化性能を検証する必要があります。
留意すべき制限事項がいくつかあります。第一に、本研究は現場での観測ではなく、既知の物理伝搬モデルを用いて生成された合成データセットに依存しています。前述の通り、運用中のFSOシステムに対する絶対的な性能保証を提供するのではなく、定量的な性能指標(R2、RMSE、MAE)は、制御されたシミュレーション環境におけるアプローチ間の相対的な比較として捉えられるべきです。第二に、データセットの規模により、標準モデルおよびディープラーニングモデルが堅牢な特徴表現を十分に学習できていない可能性があります。第三に、減衰予測を優先したため、接続可用性、ポインティングエラー、乱流誘起フェージングなどの他のFSO性能指標は考慮されていません。第四に、気象条件の割合を算出するために2020年から2024年までの履歴データを使用しましたが、これはイラクの気候パターンの年次変動を正確に反映していない可能性があります。第五に、CNN–LSTMおよびLSTMモデルの擬似的なシーケンシャル入力データ構造は手法上の簡略化であり、実世界のアプリケーションにおける時間的ダイナミクスを十分に捉えられていない可能性があります。結果を評価する際は、これらの制限が知見の汎用性に影響を及ぼす可能性があるため、考慮する必要があります。
推奨される優先事項:実世界での検証。イラクの気象条件下での実際のFSO減衰測定値を収集・分析することが、今後の最も重要な研究経路です。これには以下の事項が含まれるべきです:(1) イラクの様々な地域(例:バグダッド、バスラ、モスル、ラマディ)にFSOテストベッドを設置し、地域的な気候変動を記録すること。(2) FSO設置場所で校正済み機器を使用し、大気パラメータ(温度、湿度、視程、粉塵濃度)を同時に測定すること。(3) 極端な気象イベント(砂嵐、濃霧、豪雨)中の減衰を記録すること。(4) 収集したデータを公開し、再現性と比較研究を可能にすること。(5) 季節変動を捉えるため、少なくとも1年間の完全なサイクルにわたってモニタリングを継続すること。このような実証的な検証により、モデルの汎用性を評価し、本研究で構築された予測手法を強化する機会が得られます。
生成されたモデルを検証および強化するために、今後の研究では、イラクの気象条件下で得られた実際のFSO測定値の組み込みに焦点を当てるべきである。また、関連する大気データセットを活用した転移学習戦略、変化する環境条件に適応するオンライン学習プログラム、および測定データと物理モデルを組み合わせたハイブリッドな実験・シミュレーション戦略を検討することも有用である。さらに、説明可能なAIや高度な物理ベースの学習アプローチを研究することで、空気減衰の根底にあるメカニズムをより詳細に解明し、次世代の予測システムのレジリエンスを強化できる可能性がある。
開示事項
利益相反:著者らは、利益相反がないことを宣言します。
謝辞
著者らは、本研究に関して外部からの資金提供を受けていないことを宣言します。イラク、バグダッド地区のInternational Applied and Theoretical Research Center (IATRC) に感謝の意を表します。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | ディープラーニング学習用GPU加速ライブラリ |
| cuDNN | NVIDIA Corporation | 8.6.0 | GPU加速型ディープニューラルネットワークライブラリ |
| GPU(グラフィックス・プロセッシング・ユニット) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | GPU加速によるディープラーニング学習に使用 |
| CPU(中央処理装置) | Intel Corporation | Core i9-13900K、24コア/32スレッド | すべてのモデルのトレーニングおよび評価に使用するワークステーションプロセッサ |
| システムメモリ (RAM) | 該当なし | 64 GB DDR5, 5200 MHz | ワークステーションメモリ |
| Keras API | オープンソース(TensorFlowの一部) | TensorFlow 2.11.0に同梱 | すべてのディープラーニングアーキテクチャに使用されるハイレベルディープラーニングAPI |
| LightGBM | オープンソース (Microsoft) | 3.3.5 | 勾配ブースティングフレームワーク |
| NumPy | オープンソース (NumFOCUS) | 1.23.5 | 数値計算ライブラリ |
| オペレーティングシステム | Canonical Ltd. | Ubuntu 22.04 LTS | ワークステーション用オペレーティングシステム |
| Python | Python Software Foundation | 3.9 | すべてのデータ生成およびモデリングに使用されたプログラミング言語 |
| scikit-learn | オープンソース | 1.2.2 | 機械学習ライブラリ(RF、SVR、KNN、線形回帰、交差検証、スケーリング) |
| SHAP (SHapley Additive exPlanations) | オープンソース | 0.41.0 | モデル解釈可能性ライブラリ、TreeExplainerモジュール |
| TensorFlow | オープンソース (Google) | 2.11.0 | 全6種類のDLアーキテクチャに使用されたディープラーニングフレームワーク |
| XGBoost | オープンソース | 1.7.5 | Extreme Gradient Boostingライブラリ |
参考文献
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.