本プロトコルでは、連合学習によるプライバシー保護、マルチモーダル・トランスフォーマー、拡散モデルに基づくデータ拡張、グラフベースの個別化薬剤推奨、および説明可能な人工知能(XAI)を統合した、マルチモーダル糖尿病インテリジェンス・フレームワークであるFedMediFormer-XAIを提案します。これにより、正確な予測、透明性の高い意思決定、および個別化された糖尿病管理を実現します。
方法論記事
FedMediFormer-XAI:糖尿病に対する拡散増強を用いた連邦マルチモーダル・トランスフォーマーおよびグラフベースの薬剤推奨システム
この記事について
サマリー
要約
糖尿病管理は、断片化されたヘルスケアデータ、プライバシーへの懸念、説明性の低さ、および個別化された治療ガイダンスの不足といった多くの課題に直面しています。本研究では、連邦学習、マルチモーダルTransformer、拡散ベースのデータ増強、薬剤推奨のためのグラフニューラルネットワーク(GNN)、および糖尿病インテリジェンスのための説明可能な人工知能(XAI)を統合した、適切かつ統一的なフレームワークであるFedMediFormer-XAIを導入します。このシステムは、臨床記録、集団健康指標、持続血糖測定データ、眼底画像、ウェアラブルセンサーの測定値、薬理情報など、多様なヘルスケアデータタイプを利用します。合成サンプルを生成しクラス不均衡に対処するために拡散モデルが使用され、非常に異なるデータソース間の関係を学習するためにマルチモーダルTransformerアーキテクチャが採用されています。連邦学習により、生の患者データを共有することなく、プライバシーを保護した方法でモデルの協調的なトレーニングが可能になります。GNNコンポーネントは、個別化された薬剤推奨のために患者-薬剤間および薬剤-薬剤間の相互作用を捉えます。SHapley Additive exPlanations(SHAP)、アテンション可視化、Integrated Gradients、および反事実的推論などの説明可能性手法により、予測および推奨結果の透明な解釈が提供されます。代表的な実装において、提案されたフレームワークは、正解率94.2%、適合率93.1%、再現率92.8%、F1スコア92.9%、マシューズ相関係数(MCC)0.88、および受信者動作特性曲線下面積(AUC-ROC)0.96を達成しました。グラフベースの推奨モジュールは、適合率 = 0.89、再現率 = 0.84、および正規化割引累積利得(NDCG) = 0.91を達成しました。本プロトコルは、マルチモーダルTransformer、連邦学習、拡散ベースの増強、グラフベースの推奨、および説明可能な人工知能を用いて、不均一なヘルスケアデータを統合するための構造化されたアプローチを提供します。報告された計算結果は、糖尿病予測および個別化された薬剤推奨における本フレームワークの可能性を示しており、連邦設計によって分散型データ処理がサポートされています。臨床的有用性、汎用性、および実世界での適用性を確立するためには、今後の多施設共同臨床評価が必要です。
概要
糖尿病は、人類に影響を及ぼす主要な慢性代謝疾患の一つであり、長期的な影響や患者の治療にかかる莫大な費用とともに増加し続けているため、重大な公衆衛生上の問題となっています1,2。ある報告によると、現在、世界中で5億3,700万人以上の成人が糖尿病と共に生きており、この数値は今後数十年間で大幅に増加すると予想されています3。高血糖状態が制御されない場合、冠動脈疾患4、腎機能障害5、神経障害6、視力喪失7、脳卒中8などの深刻な合併症を引き起こします。したがって、極めて早期の段階で疾患を認識し、患者の状態を定期的にモニタリングし、高度な医療アプローチを通じてトレーニングを提供することが、患者がより健康な生活を送ることを支援し、ひいては国家のヘルスケアシステムの費用を削減するために必要なステップとなります9,10
今日、電子健康記録(EHR)、ウェアラブルデバイス、持続血糖測定(CGM)システム、網膜イメージング技術、およびモバイルヘルスアプリケーションの利用が急速に普及しており、分析可能な大量の不均一なヘルスケアデータが生成されています11。これらの多様なデータ収集ツールは、人体、疾患の異なる段階における機能能力、患者のさまざまな治療法に対する反応、および実生活における行動に関する多様な情報を提供できます12。人工知能(AI)は、極めて複雑なデータの処理、糖尿病の予測、疾患のモニタリング、および医師の臨床決定の支援において、最適な解決策であることが証明されています13。さらに、ランダムフォレスト、サポートベクターマシン、勾配ブースティング法を含む機械学習アルゴリズムは、糖尿病リスクの評価において優れた結果を示しています14。より最近では、ディープラーニングアーキテクチャによって、自動的な特徴抽出が可能になり、多様なヘルスケアアプリケーションにおいて予測性能が向上しています15。
マルチモーダル学習法を用いることで、構造化された臨床記録、生理学的測定値、網膜画像、および行動指標を単一の予測フレームワークに統合し、糖尿病に関するインテリジェンスが大幅に向上しました16。複数の情報源を利用することで、マルチモーダルモデルは、各モダリティを個別に検討した場合には見えてこないパターンを特定することが可能です17。近年、Transformerベースのモデルは、多様な種類のヘルスケアデータから長距離依存性と文脈的関係を非常に効果的に学習しています18。しかし、クラスの不均衡、データの欠損、データの不均一性、および汎用性の限界といった問題が、臨床現場におけるマルチモーダルAIシステムの普及を依然として妨げています19。
これらの進展があるものの、既存の糖尿病インテリジェンスシステムの多くは、依然として異なる機関からの患者データを単一のリポジトリに統合することを本質的に必要とする集中型学習フレームワークに依存しています20。このような手法は、患者のプライバシー、データの保管、サイバーセキュリティ、および規制遵守に関する紛争をすでに引き起こしています21。実際、法的および倫理的な検討事項により、医療提供者が機密性の高い患者データを共有する能力はしばしば制限されています22。このような背景から、実際の患者データを共有することなく共同モデルのトレーニングを可能にする連合学習(フェデレーテッドラーニング)が、実行可能な解決策となりつつあります23。分散最適化と安全なパラメータ集約を通じて、連合学習は地理的に分散したデータセットから得られる知識を活用し、プライバシーが保護された健康分析を可能にします24。それにもかかわらず、通信オーバーヘッド、クライアントの不均一性、および収束の安定性は、依然としてヘルスケア分野における連合学習の主要な課題となっています25。
現在使用されている糖尿病インテリジェンスシステムのさらなる欠点は、透明性の欠如と個別化療法のサポートが不十分であることです。多くのディープラーニングモデルはブラックボックスのように機能し、これは予測や推奨の根拠を理解したい臨床医にとって問題となります26。SHAP、Integrated Gradients、アテンションの可視化、反事実的推論などの説明可能な人工知能(XAI)の手法は、モデルの透明性と臨床医の信頼を高める大きな可能性を秘めていることが証明されています27。さらに、グラフニューラルネットワーク(GNN)は、患者と薬剤、および薬剤間の相互作用を捉えるための最も高度なツールとなっており、個別化された薬剤推奨や薬剤安全性評価を可能にしています28。また、新しい拡散モデルにより、本物の合成ヘルスケアデータの生成や、クラス不均衡への対処のためのソリューションが導入されています29。
トランスフォーマー、連合学習、拡散モデルベースの合成データ生成、グラフニューラルネットワーク、および説明可能な人工知能は、それぞれヘルスケアアプリケーションにおいて有望な結果を示していますが、これらを単一の再現可能な糖尿病インテリジェンスフレームワークに統合した例は限られています。既存のアプローチでは、通常これらの構成要素が個別に扱われており、個別化された治療推奨を伴わないプライバシー保護学習、分散型トレーニングを伴わないマルチモーダル予測、あるいはグラフベースの臨床意思決定支援を伴わない説明可能性に焦点が当てられています。拡散モデルはクラスバランスの調整をサポートでき、トランスフォーマーアーキテクチャは不均一なヘルスケアモダリティ間の関係性を学習できますが、これらの相補的な技術を統合するための標準化されたプロトコルは依然として不足しています。したがって、本研究では、マルチモーダル予測、拡散ベースのデータ拡張、連合最適化、グラフベースの個別化薬剤推奨、および説明可能な人工知能を再現可能なワークフロー内で組み合わせた統合的な手法プロトコルを提示し、今後の臨床検証および実用化に向けた基盤を提供します。
患者レベルのマルチモーダルデータセットが利用可能であると想定する研究とは異なり、本プロトコルでは、直接的な患者のマッチングを行うことなく、不均一な公開データセットを統合します。データソースごとに独立したモダリティ特異的モデルをトレーニングし、潜在的な特徴量埋め込みをクロスモーダルアテンションメカニズムを通じて結合します。この設計により、方法論的な厳密さを維持しながら、多様なヘルスケアリポジトリにわたるマルチモーダルな知識の統合が可能になります。
提案されたプロトコルは、主に、異なるリポジトリや施設に不均一なデータソースが存在し、データの直接的な集約が制限されている分散型ヘルスケアAI環境における手法開発を目的としています。現在の実装では、モダリティ固有のデータセットは独立しており、患者レベルでの照合はなされていません。したがって、マルチモーダル統合は、直接的な患者レベルの対応ではなく、学習された表現レベルで実行されます。実用的応用には、適切にリンクされたマルチモーダル患者データ、参加施設間での一貫した前処理およびアウトカム定義、適切な計算インフラストラクチャ、ならびに適用される倫理的、プライバシー的、および規制上の要件への準拠が必要です。
本論文では、予測、推奨、および説明性の機能を統合し、プライバシーを保護した糖尿病インテリジェンスを可能にする連合マルチモーダル・トランスフォーマー・フレームワークであるFedMediFormer-XAIを提案します。本フレームワークは、クラス不均衡に対処するための拡散ベースのデータ拡張、糖尿病予測のためのマルチモーダル・トランスフォーマー学習、共同モデル開発のための連合学習、グラフニューラルネットワークに基づく個別化薬剤推奨、および臨床決定を透明な方法でサポートするための説明可能AI(XAI)手法を統合したものです。提案されたFedMediFormer-XAIフレームワークの全体的なアーキテクチャとワークフローを図1に示します。
提案されたFedMediFormer-XAIフレームワークの主な貢献は以下の通りである:(1) 連合学習、マルチモーダルtransformer、拡散ベースのデータ拡張、グラフニューラルネットワークに基づくパーソナライズされた薬剤推奨、および説明可能な人工知能を、糖尿病インテリジェンスのための単一の再現可能なワークフロー内に統合した統一プロトコルを提示した。(2) 生の患者データを共有することなく、シミュレーションされた分散ヘルスケアクライアント間での協調的なモデルトレーニングを可能にするプライバシー保護連合学習戦略を開発した。(3) 構造化された臨床記録、持続血糖測定データ、眼底画像、および人口統計学的健康指標から相補的な表現を共同で学習するためのマルチモーダルtransformerアーキテクチャを導入した。(4) 元のトレーニングデータの統計的特性を維持しつつ、クラス不均衡を軽減しモデルの堅牢性を向上させるために、拡散ベースの合成データ生成を組み込んだ。(5) パーソナライズされた薬剤推奨および相互作用を考慮した治療ランキングのために、患者・薬剤間および薬剤・薬剤間の関係をモデル化するGraphSAGEベースの不均一グラフ学習モジュールを採用した。(6) モデルの透明性を高め、解釈可能な予測および推奨出力を提供するために、SHapley Additive exPlanations (SHAP)、Integrated Gradients、アテンション可視化、および反事実的説明を含む複数の説明可能な人工知能技術を統合した。(7) 予測評価、連合学習評価、推奨評価、説明可能性分析、臨床医中心の評価、外部検証、および再現性評価を含む包括的な検証プロトコルを提供した。
プロトコル
本研究で使用したすべてのデータセットは、公開リポジトリから取得したものであり、匿名化された患者情報が含まれています。これには、Pima Indians Diabetes Dataset、CDC Diabetes Health Indicators Dataset、OhioT1DM Dataset、APTOS 2019 Blindness Detection Dataset、Drug Review Dataset、およびDrug-Drug Interaction Datasetが含まれます。直接的な患者の募集、介入、検体採取、または個人を特定できる健康情報へのアクセスは行われていません。本研究は、手法の開発および検証を目的とした、公開済み匿名化データセットの二次分析に限定されており、そのようなデータの使用に関する施設内の規定に従って実施されました。本プロトコルに記載されている人間中心の評価は、今後の実装を想定したものであり、本研究では実施されていません。この評価を行う研究者は、施設倫理委員会の適切な承認を得て、すべての参加者から書面によるインフォームド・コンセントを取得し、適用される施設規定、データ利用合意書、および国内法を遵守する必要があります。
1. 計算環境の構築
- 主要なプログラミング環境としてPython 3.11をインストールする。深層学習モデルの開発およびトレーニング用に、PyTorch 2.3とTensorFlow 2.15をインストールする。Transformerベースのアーキテクチャを実装するため、Transformersライブラリ(v4.45)をインストールする。
- グラフニューラルネットワークの構築とトレーニングをサポートするため、PyTorch Geometric(v2.5)をインストールする。説明可能性および特徴量アトリビューション分析を行うため、SHAP(v0.47)とCaptum(v0.8)をインストールする。
- 数値計算、データ前処理、および機械学習ユーティリティとして、NumPy、Pandas、Scikit-learnをインストールする。画像処理および可視化タスクのため、OpenCVとMatplotlibをインストールする。薬剤相互作用グラフを構築・分析するためにNetworkXをインストールする。
- ハードウェア加速計算を可能にするため、CUDA Toolkitおよび互換性のあるNVIDIA GPUドライバーをインストールする。少なくとも32 GBのシステムメモリを備えたNVIDIA RTX 4090 GPUをセットアップする。結果の再現性を確保するため、トレーニング、検証、およびテストの乱数シードを42に設定する。使用するソフトウェアライブラリのインストール状態と互換性を確認する。分析に使用したソフトウェアバージョン、ハードウェア仕様、およびモデル構成パラメータを記録する。
2. データセットの準備と前処理
- 必要な臨床、生理学的、画像および薬理学的データセットをダウンロードし、モダリティ別のリポジトリに整理して、その整合性を確認する。データセットの特性、予測ターゲット、および統合レベルが、指定された通りであることを確認する。 表1および表2ワークフローは以下に示されています。 図2.
- 重複したレコード、無効なレコード、不整合なレコード、および必須変数が欠落しているレコードを削除する。該当する各データセットを、患者間で独立したトレーニング(70%)、検証(15%)、およびテスト(15%)のサブセットに分割する。中央値による補完、Min-Maxスケーリング、およびカテゴリカルエンコーディングの適合はトレーニングサブセットのみを用いて行い、適合させた変換をそのまま検証サブセットおよびテストサブセットに適用する。合成データの生成はトレーニングサブセットに対してのみ行う。分割およびリーケージの防止について、以下に従って検証する。 付随表1
- グルコース値、食物摂取量、インスリン投与量、身体活動量、および睡眠データをインポートします。タイムスタンプを標準化し、イベントを一定の間隔に整合させ、未記録のグルコース値を線形補間します。連続的な記録を固定長のウィンドウに分割し、zスコア正規化を適用して、テンポラル・トランスフォーマー(temporal transformer)の入力データを生成します。
- 網膜眼底画像を読み込み、破損または読み取り不可能なファイル、重複画像、ラベルが欠落している画像、および深刻なアーチファクトがある画像や網膜視野の視認性が不十分な画像を除去する。
- 保持した画像を224にリサイズする × 224ピクセルとし、ピクセル強度を[0, 1]に正規化し、コントラスト制限適応的ヒストグラム均等化(CLAHE)を適用する。
- ランダム回転を用いて学習画像を拡張する ±15°確率0.5での水平反転、0.9~1.1の範囲でのランダムズーム×、および内部の輝度調整 ±20%。検証用またはテスト用画像には確率的なデータ拡張を適用しないでください。処理済みの画像をVision Transformerのトレーニング用に保存します。
- データセット統合戦略にまとめられている通りに、モダリティ固有の表現を統合します。 表2共通の患者識別子が利用できない場合、独立したリポジトリ間で患者レベルの直接的なマッチングを行わないでください。
- 患者識別子がリポジトリ間で共有されていないため、各公開データセットを独立したモダリティ特有のデータセットとして保存してください。
- 対応するデータセットを用いて、モダリティ固有の特徴抽出器を独立してトレーニングする:(a) 臨床記録 → TabTransformerエンコーダー、(b) 集団健康指標 → TabTransformerエンコーダー、(c) 持続血糖測定 → テンポラル・トランスフォーマー;(d) 網膜底写真 → ビジョン・トランスフォーマー;(e) 薬理学的データ → GraphSAGEモジュール
- 各モダリティから潜在的な特徴量埋め込みを独立して抽出します。生の患者記録を統合するのではなく、提案するクロスモーダルアテンション融合モジュールを介して、学習済みの潜在的埋め込みのみを融合させます。
- 独立したパブリックデータセット間で、人工的な患者のマッチングが行われないようにしてください。前処理、データ拡張、およびモデル開発の全過程において、各データセットで独立した訓練、検証、およびテスト用パーティションを維持してください。
- 統合されたマルチモーダル特徴表現を保存し、後続の予測、連合学習、説明可能性、および個別化薬剤推奨に利用する(図2).
3. 拡散ベースのデータ拡張を行う
- TabDDPMを用いて、構造化された表形式の臨床およびポピュレーションヘルスデータセットに拡散ベースのデータ拡張を適用します。情報漏洩を防ぐため、前処理済みのトレーニングパーティションのみから合成サンプルを生成してください。モデルの設定は以下に従って行います。 付録表2.
- Adamオプティマイザー(学習率 = 1)を用い、最大500エポックまでTabDDPMをトレーニングします。 × 10⁻4(バッチサイズ = 256)。バリデーションロスが20エポック連続して0.001以上改善しなかった場合に、早期終了(early stopping)を適用する。過小代表クラスに対して合成サンプルを生成する。
- コルモゴロフ–スミルノフ(KS)統計量、ジェンセン・シャノン(JS)ダイバージェンス、ワッサースタイン距離、特徴量別の相関分析、およびダウンストリームの分類性能を用いて、合成データの品質を評価する。ヒストグラムのオーバーラップ、カーネル密度推定、およびペアごとの相関係数を用いて、オリジナルと合成した特徴量の分布を比較する。
- クラスごとの特徴分布が元のトレーニングデータと一貫している場合にのみ、合成サンプルを採用する(KS検定、 p > 0.05; イェンセン・シャノン発散 < 0.10)であり、不自然な臨床値を含まないものである。承認されたサンプルを元のトレーニングデータセットと組み合わせ、クラスバランスが調整されたデータセットを生成する。拡張ワークフローは以下に示す。 図3.
- オリジナルの訓練データセットと拡張後の訓練データセットを用いて糖尿病予測モデルを再学習させ、合成データの検証を行う。Accuracy(正解率)、F1スコア、MCC(マシュー相関係数)、およびAUC-ROCを比較し、モデルの汎化性能の変化と分布バイアスを評価する。
4. マルチモーダルTransformerモデルの開発
図に示されるように、構造化臨床データ、CGMシーケンス、および網膜底像用のモダリティ固有のエンコーダーを備えたマルチモーダルTransformerを構成します。 図4. 糖尿病の予測およびグラフベースの個別化薬剤推奨のため、クロスモーダルアテンションを用いて得られた表現を統合する。
- クリニカルエンコーダーの開発
- TabTransformerエンコーダーアーキテクチャを初期化します。正規化された臨床変数および人口統計学的健康指標を入力します。トランスフォーマーのアテンションメカニズムを用いて、コンテキスト化された特徴表現を生成します。
- TabTransformerエンコーダを、32個の構造化臨床入力変数、埋め込み次元128、トランスフォーマー層4層、アテンションヘッド8個、フィードフォワード次元512、ドロップアウト率0.20、およびガウス誤差線形ユニット(GELU)活性化関数で構成します。
- 患者の属性間の関係性を捉える潜在的な臨床埋め込みを学習します。得られた臨床埋め込みを、マルチモーダル統合のために保存します。
- 持続血糖測定エンコーダーの開発
- テンポラル・トランスフォーマー・エンコーダーを初期化する。持続血糖測定シーケンスと生理学的測定値をこれに入力する。セルフアテンション機構を用いて、時間的依存性をエンコードする。
- テンポラル・トランスフォーマーを、シーケンス長96タイムステップ、サンプリング間隔15分、埋め込み次元128、トランスフォーマー層数4、アテンションヘッド数8、正弦波位置エンコーディング、およびドロップアウト率0.20に設定する。
- 患者の血糖動態を反映するシーケンシャル埋め込みを生成します。次段階の融合プロセスのために、これらの時間的埋め込みを保持しておきます。
- ビジョン・トランスフォーマー・エンコーダーの構築
- Vision Transformerアーキテクチャを初期化します。前処理済みの網膜底像を入力します。画像を固定サイズのパッチに分割します。
- 入力画像解像度を224に設定してVision Transformerを構成してください。 × 224ピクセル、パッチサイズ16 × 16ピクセル、埋め込み次元768、12個のトランスフォーマーブロック、12個のアテンションヘッド、および0.10のドロップアウト率。
- パッチレベルの特徴表現を生成します。網膜病変および疾患関連バイオマーカーを示す視覚的特徴を抽出します。マルチモーダル融合のために画像埋め込みを保持します。
- クロスモーダル融合の実行
- 臨床データ、CGM、およびVision Transformerの各エンコーダーから潜在表現を抽出し、独立した線形投影とそれに続くレイヤー正規化(Layer Normalization)を用いて、それぞれを共通の256次元潜在空間に投影する。
- 投影されたモダリティトークンを連結し、学習可能なモダリティタイプ埋め込みを追加して、マルチヘッド・クロスモーダルアテンションを適用することで、臨床データ、CGM、および網膜の表現間での情報交換を可能にする。アテンションブロックは、8つのヘッド、256次元のモデル空間、1,024次元のフィードフォワード層、GELU活性化関数、0.10のドロップアウト、残差接続、およびレイヤー正規化で構成する。
- 各モダリティ固有のトークングループを平均プーリングし、得られた表現を結合する。結合後の768次元ベクトルを512次元の統合マルチモーダル表現へと投影し、後続の説明可能性およびアブレーション解析のために、アテンションウェイトと融合表現を保持する。
- 統合された表現を、糖尿病予測モジュールおよびGraphSAGEベースの薬剤推奨モジュールに転送します。独立したデータセット間で人為的な患者レベルのマッチングを行わず、融合プロセス全体を通じて、元のモダリティ固有のトレーニング、検証、およびテスト用パーティションを維持します。
- モデルパラメータの要約に基づき、マルチモーダル・トランスフォーマーを構成します。 付随表 3.
5. フェデレーション学習の設定
- 患者レベルのデータを交換することなく、地理的に分散した医療機関間で協調的なモデル訓練を可能にするため、連合学習(federated learning)フレームワークを構成する。各参加機関において、ローカルで利用可能なデータを用いてローカルモデルの最適化を行う。保護されたモデルパラメータのみを中央アグリゲーションサーバーと共有する。マルチモーダルモデルの協調的な開発を可能にしつつ、患者のプライバシーを保護する。
- マルチモーダルデータセットを分離し、複数の連合クライアントに分散させることで、異なる医療機関がデータを共有せずに協調するシナリオを模倣する。
- 連合学習ネットワークを、10台の参加病院クライアント、1台の中央アグリゲーションサーバー、1通信ラウンドあたり5回のローカルエポック、100回の通信ラウンド、80%のクライアント参加率、各通信ラウンドでのランダムなクライアント選択、および1ラウンドあたり最低8台の参加クライアントとして構成する。
- データがローカルかつ機密に保持されるよう、各クライアントに特定の機関に属するデータセットを割り当てる。マルチモーダル訓練データを、ディリクレ分布に基づいた非独立同一分布(non-IID)戦略を用いて10台の模擬病院クライアント間で分割し 、不均一なクラス分布、人口統計学的構成、およびクライアントデータセットサイズを生成する。
- 再現性を確保するため、固定ランダムシードを使用する。得られたクライアントレベルの分布を確認し、これらの分割を連合訓練を通じて維持する。検証およびテストデータセットは、クライアントの分割とは独立して保持する。
- 中央アグリゲーションサーバーから受信したグローバルモデルパラメータを用いて、各ローカルクライアントを初期化する。クライアントのローカル訓練データを用いて、ローカルマルチモーダルTransformerを5エポック訓練する。学習率 1 × 10⁻4 のAdamWオプティマイザーを用いてローカルモデルを最適化する。
- ローカル訓練の完了後、ローカルモデルパラメータの更新量を計算する。中央アグリゲーションサーバーへ送信する前に、ローカルモデルパラメータを保護する。グローバルアグリゲーションのため、保護されたローカルモデルパラメータを中央アグリゲーションサーバーに送信する。
- すべての参加病院クライアントから保護されたモデルパラメータを受信する。アグリゲーション前に、受信したモデル更新量の整合性を検証する。Federated Averaging (FedAvg) アルゴリズムを用いてローカルモデルの重みを集約する。集約されたモデルパラメータを用いて、グローバルマルチモーダルTransformerを更新する。
- 更新されたグローバルモデルパラメータを参加病院クライアントに再配布する。100回の通信ラウンドが完了するか、または定義された収束基準が満たされるまで、ローカル訓練とグローバルアグリゲーションの手順を繰り返す。
- 指定されたセキュアアグリゲーションメカニズムとAES-256暗号化を用いて、送信されるモデルパラメータを保護する。デジタル証明書を用いて参加クライアントを認証する。
- Transport Layer Security (TLS) 1.3を用いて暗号化通信チャネルを確立する。各通信ラウンドの完了後、集約されたグローバルモデルパラメータのみを保持する。
- 生データの露出、不正な共有、メンバーシップ推論、およびモデル反転アセスメントを用いて、プライバシーとセキュリティを評価する。メンバーシップ推論については、攻撃のAUC-ROCをランダムベースライン(0.50)と比較する。反転については、網膜画像に対しては構造的類似性指標 (SSIM) およびピーク信号対雑音比 (PSNR) を用い、数値的特徴量に対しては正規化再構成誤差を用いて評価する。
- サーバーが集約前の個々のクライアント更新量にアクセスできないことを確認し、セキュアアグリゲーションを検証する。AES-256/TLS 1.3による保護を検証し、暗号化されていないモデル更新量の送信が行われていないことを確認する。
- 適用可能な場合は、連合構成と中央集権構成の間でプライバシー指標を比較し、Supplementary Table 4に指定された指標を報告する。
- ローカルTransformer訓練の計算複雑性を O(N × L × d2) と推定する。ここで N はサンプル数、L はTransformer層の数、d は埋め込み次元を表す。
- 連合アグリゲーションの計算複雑性を、1通信ラウンドあたり O(K × P) と推定する。ここで K は参加クライアント数、P は訓練可能なモデルパラメータ数を表す。
- 各通信ラウンドにおいて、参加クライアントと中央アグリゲーションサーバーの間で、保護されたモデルパラメータのみを交換する。モデルサイズ、参加クライアント数、および通信ラウンド数に基づいて通信オーバーヘッドを算出する。
- パラメータ交換のオーバーヘッドを、対応するマルチモーダルヘルスケアデータセットを転送する場合の推定コストと比較する。連合学習フレームワークを Supplementary Table 4 にまとめられたパラメータに従って構成する。連合学習のワークフローとパラメータアグリゲーションプロセスは、Figure 5 に示されている。
6. 個別化薬剤推奨モジュールの構築
- 薬理学的データ、薬剤データ、患者治療データ、および薬物相互作用データを計算環境にインポートする。患者、薬剤、疾患、検査、および臨床的リスク因子のノードを含む異種ヘルスケアグラフを構築する。
- 患者-疾患、患者-薬剤、疾患-薬剤、薬剤-薬剤相互作用、および患者-検査の関係をグラフのエッジとして定義する。モデルのトレーニング前に、グラフ構造を検証し、重複、無効、または切断された関係を削除する。
- 患者ノードを、年齢、性別、BMI、HbA1c、血糖値、血圧、および糖尿病罹患期間を用いて表現する。薬剤ノードを、薬剤クラス、作用機序、投与量、投与頻度、および既知の副作用を用いて表現する。
- 疾患ノードを、疾患の重症度、疾患ステージ、および関連する合併症を用いて表現する。GraphSAGEのトレーニング前に、カテゴリ属性をエンコードし、連続的なノード特徴量を正規化する。
- 前処理済みのノード特徴量を用いてノード埋め込みを初期化する。近傍集約中、各ターゲットノードに対して最大25個の近傍ノードをサンプリングする。平均集約を用いて近傍ノード表現を集約する。集約された近傍表現を用いてターゲットノードの埋め込みを更新する。
- 各GraphSAGEレイヤーの後に、整流線形ユニット(ReLU)活性化関数を適用する。得られたノード埋め込みを正規化する。近傍集約の手順を3つのGraphSAGEレイヤーにわたって繰り返す。
- GraphSAGEモデルを、隠れ次元 256、埋め込み次元 128、3つのGraphSAGEレイヤー、近傍サンプリングサイズ 25、ドロップアウト率 0.30、学習率 1 × 10⁻4、バッチサイズ 512、最大トレーニングエポック数 100 に設定する。Adamオプティマイザーを用いてモデルを最適化する。
- トレーニング済みGraphSAGEモデルから、患者固有の埋め込みを算出する。候補薬剤の埋め込みを算出する。患者の表現と候補薬剤の表現との間の適合性スコアを計算する。予測された適合性スコアに従って候補薬剤をランク付けする。
- 利用可能な薬物相互作用情報を利用して、禁忌または潜在的に不安全な薬剤を特定し、削除する。適格な薬剤のうち、ランクの高い上位5つの薬剤をパーソナライズされたTop-5推奨薬として返す。
- BPR(Bayesian Personalized Ranking)損失を用いて推奨モデルをトレーニングする。臨床的に適切な薬剤に、適合性の低い候補薬剤よりも高いスコアを割り当てるようにランキング目的関数を最適化する。
- 各薬剤推奨に寄与している影響力のある近傍ノードおよび臨床的に関連するグラフ関係を特定する。推奨に寄与する患者、疾患、検査、および薬剤関連の特性について、特徴量属性スコアを算出する。
- 各パーソナライズされた薬剤推奨に寄与する関係を示す、視覚的なグラフベースの説明を生成する。GraphSAGE推奨モデルを、付録表5にまとめられたパラメータに従って構成する。グラフベースのパーソナライズされた薬剤推奨ワークフローを図6に示す。
7. 説明可能性の評価を行う
- SHAP解析の実施
- 学習済みのマルチモーダルtransformerとホールドアウトテストデータセットを計算環境にロードする。
- 学習済み予測モデルと、糖尿病アウトカムクラスに基づいた層化乱数サンプリングを用いてトレーニングデータセットからのみ選択した100個のトレーニングサンプルの背景サンプルを使用して、SHAPエクスプレイナーを初期化する。背景サンプルにおいて完全なトレーニングパーティションの近似クラス分布を維持し、再現可能なサンプル選択を確実にするために固定乱数シード42を使用する。選択したテストサンプルのSHAP値を計算する。
- SHAP値の絶対値からグローバルな特徴量重要度を算出し、グローバルおよびローカルなSHAP可視化を生成し、算出された値を後続の定量的および統計的分析のために保持する。
- Integrated Gradients解析の実施
- ホールドアウトテストデータセットから、代表的な正解分類サンプルおよび誤分類サンプルを選択する。Integrated Gradientsを計算する前に、モダリティ固有のベースライン入力を定義する。正規化された臨床的およびCGM数値特徴量には、正規化された特徴量の寄与がゼロであることを表すゼロベースラインを使用し、正規化された網膜画像入力にはゼロ値のベースライン画像を使用する。
- ベースラインと元の入力間の100の補間ステップを用いて、Integrated Gradientsのアトリビューションスコアを計算する。得られたアトリビューションスコアを正規化し、特徴量およびモダリティ間での比較を可能にする。アトリビューション可視化を生成し、個々のモデル予測に寄与している影響力のある臨床的、時間的、および画像的特徴を特定する。
- アテンション可視化の実施
- 代表的なテストサンプルについて、学習済みのtransformer層からアテンション行列を抽出する。対応するアテンションヘッド全体の平均アテンションウェイトを計算する。アテンションヒートマップを生成し、臨床的、時間的、および網膜画像表現間のクロスモーダル相互作用を可視化する。予測時に高いアテンションウェイトを受け取っている支配的な臨床的、時間的、および網膜特徴を特定する。
- ランダムに選択したホールドアウトテストサンプルについて、学習済みマルチモーダルtransformerからアテンションウェイトを抽出し、対応する臨床特徴、CGM時間的、網膜空間的、およびクロスモーダルのアテンション分布を可視化する。
- 反実仮想的説明(Counterfactual Explanations)の生成
- ホールドアウトテストデータセットから代表的な患者レコードを選択する。反実仮想サンプルを生成する前に、変更可能な患者特徴量に対する臨床的に許容される範囲と制約を定義する。連続量特徴量は観察されたトレーニングデータの範囲に制限し、カテゴリ量特徴量はトレーニングデータで観察された有効なカテゴリに制限する。年齢や性別を含む不変の人口統計学的特性は変更しない。
- 事前定義された臨床的および特徴量ドメインの制約を維持しつつ、許可された変更可能特徴量のみを最小限に変更して反実仮想サンプルを生成する。観察されたトレーニングデータの範囲外の値、無効なカテゴリ状態、または不変特徴量への変更を含む反実仮想サンプルは除外する。予測アウトカムを変化させるために必要な、臨床的に妥当な最小の特徴量変更を特定する。
- 変更された特徴量、元の値、反実仮想値、および対応するモデル予測の変化を報告する。説明可能性評価のワークフローはFigure 7に示されており、代表的なアテンション可視化および反実仮想的説明の出力はSupplementary Figure 1に提示されている。
- 説明品質の評価
- 生成された説明と予測モデルの挙動との一致度を定量化するためにフィデリティ(Fidelity)を計算する。少量の入力摂動の下で繰り返し説明を生成し、得られたアトリビューションパターンを比較することで安定性(Stability)を計算する。臨床的に類似したテストサンプルのために生成された説明を比較することで一貫性(Consistency)を評価する。
- 各説明に実質的に寄与している特徴量の数または割合を決定することでスパース性(Sparsity)を計算する。アトリビューションされた特徴量が対応するモデル出力を十分に説明しているかどうかを判断するために完全性(Completeness)を評価する。入力特徴量の制御された摂動後のアトリビューションスコアの変化を測定することで感度(Sensitivity)を評価する。
- 特徴量アトリビューションと観察されたモデル予測の変化との不一致を定量化するためにインフィデリティ(Infidelity)を計算する。後続の統計分析のために、すべての定量的説明可能性メトリクスを記録する。
- 前向きな臨床医による検証の実施
- 将来の前向き臨床検証に向けて、臨床専門家を募集する前に適切な施設倫理委員会の承認を得る。倫理的承認を得た後、内分泌専門医6名、糖尿病専門医3名、臨床薬理学者3名の計12名の臨床医を募集し、評価を開始する前にすべての参加者からインフォームドコンセントを得る。
- 臨床医による評価のために、代表的なモデル予測とそれに対応する説明をランダムに選択する。選択した説明を、標準化された評価形式を用いて、参加する各臨床医に個別に提示する。
- 各臨床医に、5段階のリッカート尺度を用いて、説明の有用性、臨床的関連性、解釈可能性、および信頼性を評価させる。匿名化された臨床医の評価値を記録し、ステップ7.7で指定された相互評価者間一致度および対応する統計量を計算する。
- 統計分析の実施
- 統計的比較検定を選択する前に、定量的評価スコアの分布を評価する。適切に応じて、正規分布するペア測定値には対応のあるt検定を、非正規分布するペア測定値にはウィルコクソン符号付順位和検定を適用する。
- 参加した臨床医間の相互評価者間一致度を定量化するためにFleiss' kappaを計算する。主要な説明可能性および臨床医評価メトリクスの95%信頼区間を計算する。統計的有意性のしきい値をp < 0.05に設定する。
- 算出された検定統計量、信頼区間、p値を、対応する評価結果とともに報告する。Supplementary Table 6にまとめられた基準に従って、説明可能性メトリクスを評価し報告する。
8. モデル性能の評価
- FedMediFormer-XAIを、ロジスティック回帰、ランダムフォレスト、XGBoost、TabTransformer、Vision Transformer、Temporal Transformer、および集中型マルチモーダルTransformerと比較し、正解率(accuracy)、適合率(precision)、再現率(recall)、F1スコア、MCC、およびAUC-ROCを用いて評価する。
- 提案フレームワークと一貫した比較を行うため、各ベースライン評価において、同一の事前定義されたトレーニング、検証、およびテスト戦略を実行する。
- 独立した実験ランを通じてモデル評価を繰り返し、各ランで得られたパフォーマンス指標を記録する。正解率、適合率、再現率、F1スコア、MCC、およびAUC-ROCの平均値、標準偏差(SD)、および95%信頼区間(CI)を算出する。パフォーマンス結果を、平均値 ± SDおよび対応する95% CIとして報告する。
- FedMediFormer-XAIと各ベースラインモデルとの間のペア性能差の正規性を評価する。正規分布に従うペア測定値にはペアt検定を、非正規分布のペア測定値にはウィルコクソンの符号付き順位検定を適用する。統計的有意性の閾値を p < 0.05 に設定する。
- 観測された性能差の統計的有意性と不確実性を定量化するため、対応する検定統計量、p値、および95%信頼区間を報告する。
- モデルが最終的に収束するまでのすべての通信ラウンド数を取得する。連合学習中のグローバルモデルのパフォーマンスを監視する。通信ラウンドの時間経過に伴い収束がどのように変化するかを検討する。
- パラメータ集約がどの程度有効に機能しているかを確認する。分散学習が予測性能にどのような影響を与えるかを調査する。連合学習と集中学習の結果を比較する。
- 通信ラウンドを通じた連合収束性を評価し、連合予測性能と集中予測性能を比較する。薬剤推奨の評価には、Precision@5、Recall@5、およびNDCG@5を用いる。
- 適格な候補薬剤プールから、対応する患者において正の患者-薬剤相互作用として観察されない薬剤を選択することで、ネガティブサンプル(薬剤サンプル)を生成する。既知の正の相互作用およびすべての禁忌薬をネガティブサンプリングプールから除外する。推奨トレーニングのため、ネガティブ対ポジティブのサンプリング比率を1:1に固定し、再現可能なネガティブサンプル選択のために固定ランダムシード42を使用する。
- ホールドアウト評価データのみを使用して、各患者の関連アイテムセットを構築する。患者 u の関連アイテムセット Ru を、ホールドアウトされた正解レコードにおいて正の患者-薬剤基準を満たす薬剤の集合として定義する。Ru の構築にモデルの予測を使用しない。ランキングを行う前に、候補推奨セットから禁忌薬を削除する。
- 各評価患者について、ランク付けされた適格薬剤の上位5件を生成する。Precision@5を、推奨された5つの薬剤のうち、患者の関連アイテムセット Ru に属する薬剤の割合として算出する。Recall@5を、患者の関連薬剤のうち、5つの推奨の中で回収された割合として算出する。推奨薬剤の段階的な関連性を用いてNDCG@5を算出し、臨床的に適切な薬剤には高い関連性を、非関連の薬剤にはゼロの関連性を割り当てる。すべての評価患者にわたって指標を集計し、平均 Precision@5、Recall@5、および NDCG@5 を報告する。
- モデル評価前に推奨の正解(グランドトゥルース)を構築し、ホールドアウトされた患者-薬剤相互作用を推奨トレーニングデータから分離して保持する。GraphSAGEのトレーニング、ネガティブサンプリング、または候補ランキングにおいて、テストセットの薬剤相互作用、テストセットのラベル、または将来の治療情報を使用しない。
- Fidelity(忠実度)を測定し、説明がモデルの動作とどの程度一致しているかを確認する。複数回の検証を通じて、説明の安定性を評価する。医師向けの基準に基づき、Comprehensibility(理解しやすさ)を判定する。
- 異なるデータタイプ間で説明がどの程度一貫しているかを調査する。生成された説明の臨床的価値を確認する。本研究全体で使用される評価指標は、付録表7にまとめられている。
9. 前向き臨床医師検証を実施する
- ステップ7.6~7.8に記載されたリクルート、評価、データ収集、および統計解析の手順に従い、適切な倫理承認とインフォームドコンセントを得た後、前向き臨床医バリデーションを実施する。参加者の構成、評価基準、比較条件、および計画された統計解析を含む前向き臨床医バリデーションのデザインは、付録表8にまとめられている。
10. バリデーションおよび再現性の評価を行う
- 完全なFedMediFormer-XAIフレームワークから個々のコンポーネントを系統的に削除し、データセットの分割、前処理手順、トレーニング設定、および評価基準を同一に維持したまま、アブレーション研究を行う。フルモデル、および拡散増強、連合学習、GraphSAGEベースの薬剤推奨、マルチモーダル融合をそれぞれ除いた構成について評価を行う。
- Accuracy、Precision、Recall、F1-score、MCC、およびAUC-ROCを用い、アブレーション構成と完全なFedMediFormer-XAIフレームワークを比較する。各性能指標の変化を定量化し、フレームワークの各構成要素の寄与度を決定する。検証結果を内部テストの結果と比較し、汎化性能を評価する。統計的有意性検定を行い、観察された性能差の信頼性を判定する。
- 互換性のある入力変数およびアウトカム定義を持つ独立した外部データセットが利用可能な場合は、それを用いてフレームワークの汎用性を評価してください。内部テストデータセットに使用したものと同じ前処理および評価手順を適用し、得られた性能指標を内部テストの結果と比較してください。
- 繰り返しの実験ランにわたって統計的有意性解析を行う。統計検定の前に、対になった性能差の正規性を評価する。正規分布に従う対測定値には対応のあるt検定を適用し、正規分布に従わない対測定値にはウィルコクソンの符号付順位検定を適用する。統計的有意性の閾値をpに設定する。 < 0.05.
- 正解率(Accuracy)、適合率(Precision)、再現率(Recall)、F1スコア、MCC、およびAUC-ROCの平均値と95%信頼区間を算出してください。主要なモデル比較における対応する検定統計量、p値、および信頼区間を報告してください。報告された実験を再現するために必要なすべてのモデルパラメータ、前処理手順、学習設定、および評価プロトコルを文書化してください。
- 報告された実験に使用したソースコード、設定ファイル、評価スクリプト、および学習済みモデルの仕様を保存すること。モデルの学習、実験設定、乱数シード、および評価結果の詳細な記録を維持すること。
- 利用可能な再現性資料の完全性と一貫性を検証してください。記載された方法および材料が、実験ワークフローを独立して再現するために十分な情報を提供しているかを確認してください。
- 本研究で使用された再現性リソースおよびバリデーション手順について要約します。 補足表9主要なフレームワーク構成要素の寄与度を評価するための、アブレーション研究の手順および評価基準を記録してください。
結果
予測性能分析
FedMediFormer-XAIは、評価した単一モーダルモデルおよび従来のベースラインモデルと比較して、予測性能の向上を示した。拡散ベースのデータ拡張により少数クラスの表現が改善され、その結果としての予測性能を表3にまとめる。繰り返し実行による評価では、評価したすべてのモデルにおいて安定した予測性能が示された。FedMediFormer-XAIは、正解率 94.20 ± 0.34% (95% CI: 93.78–94.62)、適合率 93.10 ± 0.30% (95% CI: 92.73–93.47)、再現率 92.80 ± 0.28% (95% CI: 92.45–93.15)、F1スコア 92.90 ± 0.28% (95% CI: 92.55–93.25) となり、最高の総合性能を達成した。また、本モデルは MCC 0.88 ± 0.02 (95% CI: 0.86–0.90) および AUC-ROC 0.96 ± 0.01 (95% CI: 0.95–0.97) を達成した。次いで高い総合性能を示したのは集中型のマルチモーダル・トランスフォーマーであり、単一モーダルおよび従来の機械学習モデルは比較的低い予測性能を示した。これらの結果は、マルチモーダル表現学習を連合最適化と組み合わせることで、糖尿病の分類性能が向上し、より安定することを示唆している。
アブレーション研究
拡散増強、連合学習、GraphSAGEに基づく薬剤推奨、およびマルチモーダル融合の寄与度を評価するために、コンポーネントごとのアブレーション分析を行った。完全なFedMediFormer-XAIフレームワークは、5回の独立した実行において、正解率 94.20 ± 0.34%、適合率 93.10 ± 0.30%、再現率 92.80 ± 0.28%、F1スコア 92.90 ± 0.28%、MCC 0.88 ± 0.02、およびAUC-ROC 0.96 ± 0.01を達成した。拡散増強を削除すると、正解率は 91.80 ± 0.42%まで低下し(2.40パーセンテージポイントの減少に相当)、F1スコアとAUC-ROCはそれぞれ 90.30 ± 0.38% および 0.94 ± 0.01 に低下した。この低下は、少数クラスの表現および予測の堅牢性に対する拡散ベースの増強の寄与を示している。
連合学習を除外した結果、正解率は93.10 ± 0.37%となり、完全なフレームワークと比較して1.10パーセンテージポイントの低下を示しました。また、適合率、再現率、F1スコア、MCC、AUC-ROCも、それぞれ92.20 ± 0.34%、91.80 ± 0.32%、92.00 ± 0.33%、0.86 ± 0.02、0.95 ± 0.01に低下しました。この比較により、予測性能に対する連合構成の寄与が実証されました。
GraphSAGEベースの個別化薬剤推奨コンポーネントを除去したところ、糖尿病予測性能への影響は比較的小さく、正解率は 93.80 ± 0.35%、F1スコアは 92.60 ± 0.30% に低下しました。対応する MCC および AUC-ROC は、それぞれ 0.87 ± 0.02 および 0.96 ± 0.01 でした。この結果は、GraphSAGE が糖尿病の分類性能を直接的に決定することよりも、主に個別化された薬剤推奨に寄与していることを示しています。
マルチモーダル融合を排除した際に最大の低下が観察されました。正解率は87.60 ± 0.55%まで低下し、6.60パーセントポイントの減少となりました。同時に、適合率、再現率、F1スコア、MCC、およびAUC-ROCは、それぞれ86.80 ± 0.51%、85.90 ± 0.54%、86.30 ± 0.52%、0.76 ± 0.03、0.91 ± 0.01まで低下しました。この結果は、臨床データ、CGM、および網膜の各モダリティからの相補的な情報を共同でモデリングすることの重要性を示しています。
連合学習分析
連合学習フレームワークにより、生の患者データの分散管理を維持しつつ、分散したクライアント間での協調的なモデルトレーニングが可能となった。トレーニング中、各クライアントのローカルモデルは個別にファインチューニングされ、Federated Averaging法を介して統合された。100回の通信ラウンドを経てグローバルモデルは収束し、その予測性能は集中学習と同等に維持された。連合学習フレームワークは、クライアント間のデータ分布が不均一であるにもかかわらず、通信ラウンドを通じて安定した収束を示した。保護されたパラメータ交換により分散データ処理が維持され、同時にグローバルモデルは集中学習のベースラインに対して競争力のある予測性能を保持した。表 4は、集中学習と連合学習の実装を比較したものである。連合学習は通信オーバーヘッドのため追加のトレーニング時間を必要としたが、集中学習に匹敵する予測性能を維持した。
データセットレベルのパフォーマンス分析
異なるヘルスケアモダリティにおける汎用性を評価するため、各データセットで個別にパフォーマンスを評価しました。マルチモーダルFedMediFormer-XAIモデルは、評価したすべてのデータセットにおいて、強力かつ概して競争力のあるパフォーマンスを示しました。具体的には、Pima Indians Diabetes、CDC Diabetes Health Indicators、OhioT1DM、およびAPTOS 2019の各データセットにおいて、それぞれ91.8%、93.1%、92.4%、94.2%の正解率を達成しました。APTOS 2019データセット単体では、マルチモーダルモデルよりもわずかに高い正解率(94.7%)と適合率(93.9%)を記録しましたが、提案したマルチモーダルアプローチはすべてのデータセットで競争力のあるパフォーマンスを維持し、最高レベルのデータセットAUC-ROCに匹敵する0.96のAUC-ROCを達成しました。データセットレベルにおける全体的な結果を表5に示します。単一のデータセットでは、網膜画像解析を単独で使用した際に最高のパフォーマンスが得られましたが、マルチモーダル融合は最も安定し、バランスの取れた予測をもたらしました。
個別化薬剤推奨分析
グラフニューラルネットワークに基づく推奨コンポーネントは、薬剤の効果情報および薬物相互作用データを用いて評価され、学習された患者・薬剤適合性スコアに基づいて候補薬剤をランク付けし、推奨生成時に禁忌となる組み合わせを除外しました。不均一グラフ形式の採用と、患者・薬剤間および薬剤・薬剤間の相互作用のモデリングを徹底することで、個別化された薬剤選択と安全性評価を支援することができました。GraphSAGE推奨モデルは、患者、疾患、検査所見、および薬剤間の複雑な関係性を効果的に捉えました。個別化された推奨は、グラフ近傍分析と特徴量アトリビューションを通じて臨床的に意味のある説明を維持しつつ、高いランキング性能を示しました。
表6に示される通り、パーソナライズされた薬剤推奨モジュールの評価には、Precision@5、Recall@5、およびNDCG@5が用いられました。これらの指標は、GraphSAGEベースの推奨モジュールによって生成された上位5件のパーソナライズ薬剤推奨の関連性とランキング品質を定量化するものです。この推奨システムは、precision = 0.89、recall = 0.84、NDCG = 0.91という高いランキング性能を達成しました。
説明可能性解析
本フレームワークでは、マルチモーダル予測の解釈をサポートするために、SHAP、Integrated Gradients、アテンション可視化、および反事実的説明(counterfactual explanations)を組み込んでいます。SHAPは特徴量レベルの寄与度を定量化するために、Integrated Gradientsは予測を入力特徴量に帰属させるために、アテンション可視化はモダリティ全体にわたるモデルの注視点を検討するために、そして反実例的説明は代替的な予測に関連する特徴量の変化を特定するために使用されました。図 8 は、学習済みFedMediFormer-XAIモデルから生成された代表的なモデル由来のSHAPサマリープロットを示しており、図 9 は、学習済みトランスフォーマーから抽出された代表的なアテンション可視化を示しています。これらの図は、提案されたアーキテクチャの概略図ではなく、モデル評価から得られた出力を表しています。
図 8に、特徴量重要度の集計レベルでのランキングを示します。SHAP値の絶対値が高い特徴量ほど、モデルの予測への影響力が強く、また既存の臨床知識ともよく一致していました。
図9は、ランダムに選択されたホールドアウトテストサンプルについて、学習済みFedMediFormer-XAIモデルから直接抽出した代表的なアテンションの可視化を示しています。これらの可視化には、臨床的特徴のアテンション、CGMの時間的アテンション、網膜の空間的アテンション、および3つのモダリティ間のクロスモーダルアテンションが含まれます。アテンションの可視化により、モデルが複数のモダリティにわたって学習したアテンションの配分がさらに実証されました。選択されたサンプルでは、臨床的特徴の中でHbA1c、糖尿病罹患期間、および年齢に対して比較的高いアテンションが示され、CGMアテンションマップでは、顕著な血糖変動が見られるいくつかの期間が強調されました。網膜アテンションマップでは、モデルの表現に寄与している特定の画像領域が特定され、クロスモーダルアテンション行列では、モーダル内およびモーダル間の両方のアテンションパターンが示されました。図9に示すように、モデルから導出された代表的なアテンションマップは、ホールドアウトテストサンプルにおける特定の血糖時間的パターン、影響力のある臨床変数、および診断に関連する網膜画像領域を強調しています。
人間中心の評価結果
予測のみの条件および予測と説明を併用する条件において、臨床医の信頼性、解釈可能性、ユーザビリティ、臨床的有用性、および説明の関連性を評価するための、前向きな人間中心の評価プロトコルを設計しました。提案された評価には、内分泌専門医、糖尿病専門医、および臨床薬理学者が参加し、施設倫理委員会の適切な承認とインフォームドコンセントを得て実施されます。本評価は将来の前向きな実施を目的としているため、本プロトコルでは臨床医レベルのアウトカムスコアは報告していません。
表 7 に、提案された前向き臨床医評価デザインと、説明が臨床医の信頼性、解釈可能性、および知覚された有用性に及ぼす影響を評価するための事前定義基準をまとめています。この前向き評価では、事前定義されたリッカート尺度基準を用いて、説明が伴う場合と伴わない場合におけるモデル予測に対する臨床医の評価を比較します。提案された前向き人間中心の説明可能性評価フレームワークを図 10に示します。
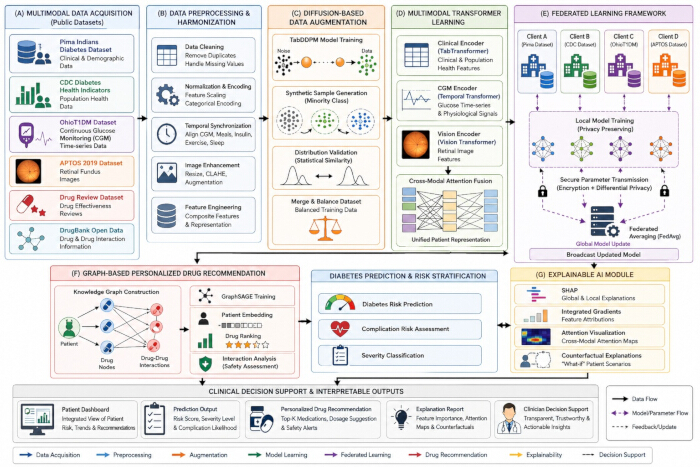
図 1: FedMediFormer-XAIフレームワークの全体構成。FedMediFormer-XAIフレームワークの概略図。マルチモーダルデータの収集と前処理、拡散モデルに基づくデータ拡張、モダリティ固有のトランスフォーマー学習、連合学習によるモデルトレーニング、GraphSAGEに基づく個別化薬剤推奨、および説明可能性分析のプロセスを示す。本フレームワークは、糖尿病の予測、個別化された投薬推奨、および解釈可能なモデル出力を生成する。こちらのリンクをクリックして、この図の拡大版を表示してください。
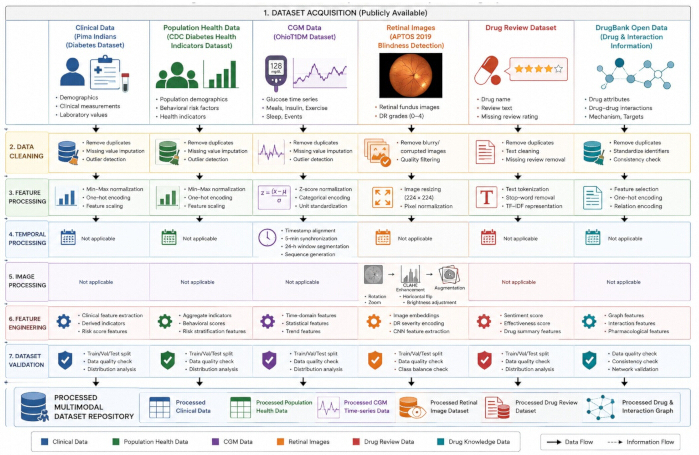
図 2: マルチモーダルデータセットの取得および前処理パイプライン。FedMediFormer-XAIで使用されるマルチモーダルデータセットの取得および前処理の概略ワークフロー。臨床データおよび公衆衛生データ、CGM記録、網膜画像、薬理情報は、モダリティ別の品質管理、前処理、正規化、エンコーディング、および拡張を経て、ダウンストリーム解析のためのモデル投入可能な表現へと変換される。こちらのリンクをクリックして、この図の拡大版を表示してください。
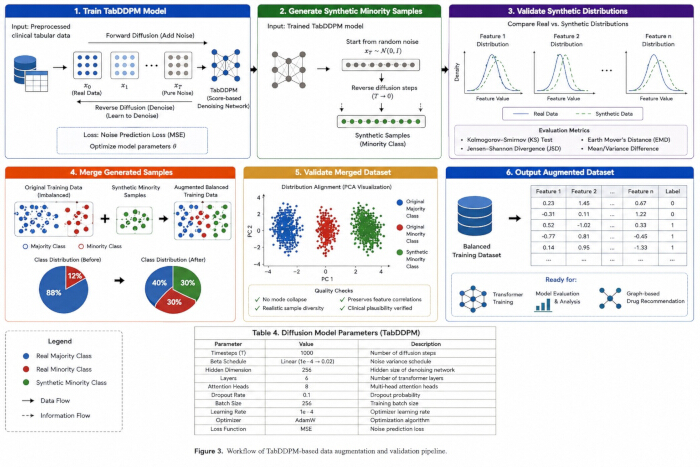
図 3: 拡散ベースのデータ増強ワークフロー。TabDDPMを用いた構造化テーブル学習データの拡散ベース増強に関する概略ワークフロー。生成されたサンプルは、クラスバランスを改善するために元の学習データと統合される前に、品質および分布の類似性の評価を受ける。 この図の拡大版を表示するには、ここをクリックしてください。
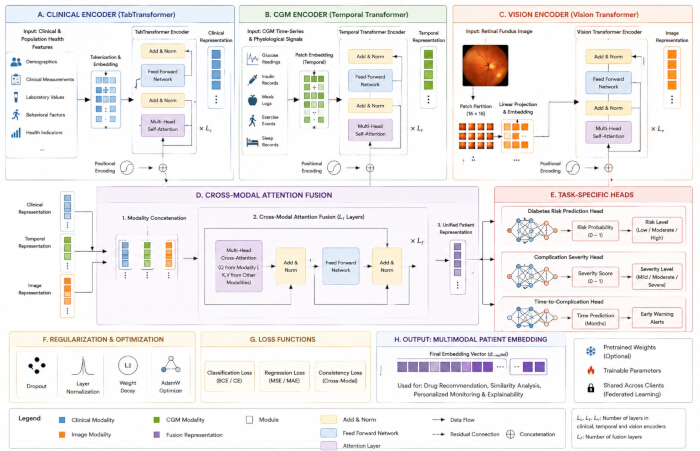
図 4: 提案されたマルチモーダル・トランスフォーマー・フレームワークのアーキテクチャ。構成要素は、(A) 臨床データ用のTabTransformerエンコーダー、(B) CGMデータ用の時間的トランスフォーマー・エンコーダー、および(C) 網膜画像用のビジョン・トランスフォーマー・エンコーダーからなる。 (D) 各モダリティ固有の表現は、クロスモーダル・アテンションを通じて統合され、統一されたマルチモーダル表現が生成される。 (E) タスク固有の予測ヘッドがモデルの出力を生成する。 (F) 正則化および最適化コンポーネントがモデルのトレーニングをサポートし、 (G) 分類、回帰、およびクロスモーダル一貫性損失が最適化プロセスをガイドする。得られたマルチモーダル表現は、後続の予測、推奨、および説明可能性タスクをサポートする。こちらのリンクをクリックして、この図の拡大版を表示してください。
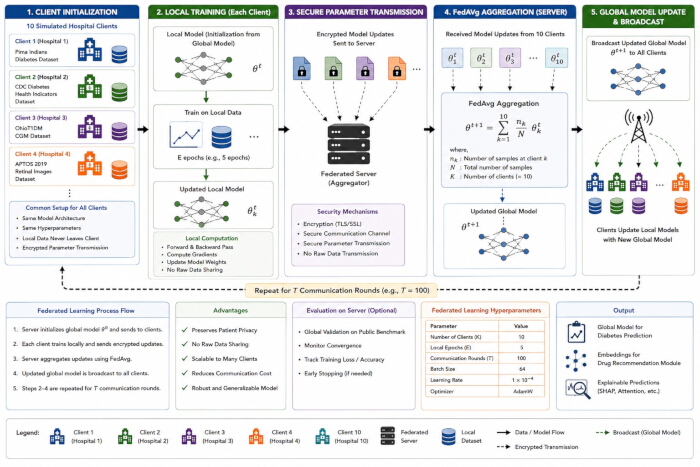
Figure 5: 連合学習の通信フレームワーク。分散した病院クライアント間での連合トレーニングの概略ワークフロー。各クライアント固有のデータを用いてローカルのマルチモーダルモデルをトレーニングし、保護されたモデル更新情報を中央サーバーに送信してFederated Averaging(連合平均化)を行います。集約されたグローバルモデルは、次回の通信ラウンドに向けて各クライアントに再配布されます。また、このフレームワークは、安全なパラメータ交換、およびプライバシー、通信、計算要件の評価についても示しています。こちらのリンクをクリックして、この図の拡大版を表示してください。
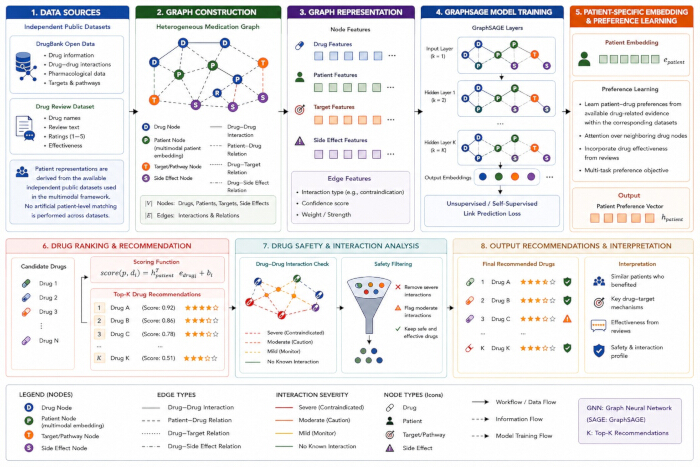
Figure 6: グラフベースの個別化薬物推奨ワークフロー。GraphSAGEに基づく個別化薬物推奨の概略ワークフロー。薬理学的データおよび患者表現データは、関連するヘルスケアエンティティと関係性を含む異種グラフに整理される。GraphSAGEは患者と薬物の表現を学習し、これを用いて患者と薬物の適合性スコアを算出し、候補薬剤をランキングする。最終的なTop-K推奨を生成する前に、禁忌または安全でない薬物組み合わせがフィルタリングされ、グラフベースの情報が推奨内容の解釈をサポートする。こちらのリンクをクリックして、この図の拡大版を表示してください。
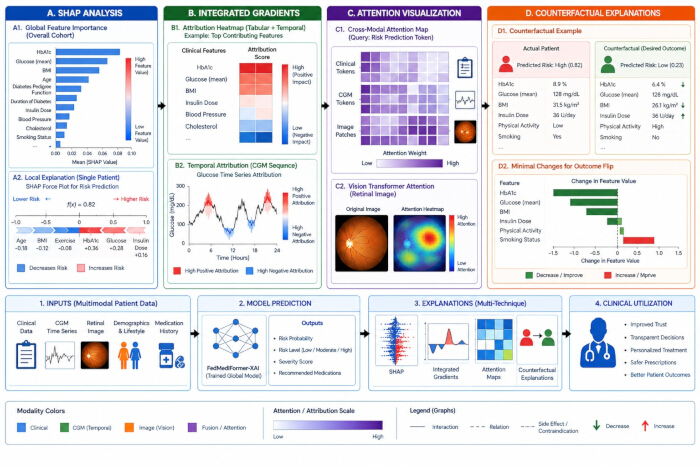
図 7: 説明可能性評価フレームワーク。説明可能性ワークフローの概略図。(A) SHAP解析によりグローバルおよびローカルな特徴量の寄与度を評価し、(B) Integrated Gradientsによりアトリビューションベースの説明を提供し、(C) アテンションの可視化により影響力のある特徴量とモダリティ間の相互作用を特定し、 (D) 反事実的解析により予測結果の変化に関連する特徴量の変化を特定する。得られた説明出力は、モデルの予測の解釈と個別化された推奨事項を支援する。こちらのリンクをクリックして、この図の拡大版を表示してください。
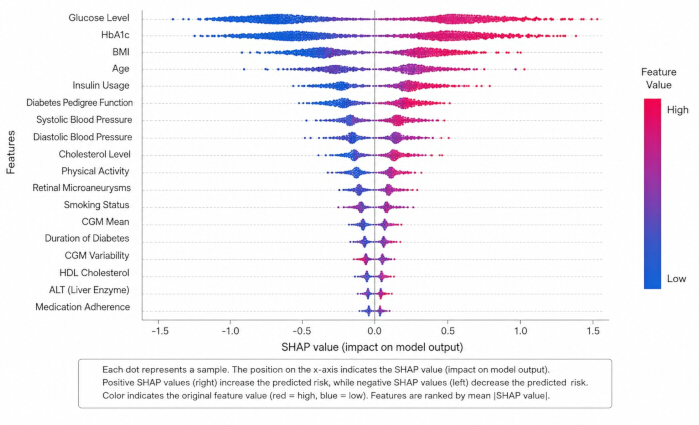
図8学習済みFedMediFormer-XAIモデルによって生成された、代表的なモデル由来のSHAP特徴量重要度解析SHAPサマリープロットは、評価されたサンプルにおけるSHAP値の分布を、平均絶対SHAP寄与度に基づいてランク付けされた特徴量とともに示しています。正のSHAP値は、予測される糖尿病リスクを高める方向に寄与していることを示し、負の値は、予測リスクを下げる方向に寄与していることを示します。色は対応する特徴量の値を表しており、値が高い場合は赤色で、低い場合は青色で表示されます。このプロットは、概略図ではなく、実際のモデルから導出された説明可能性の出力を表しています。 この図の拡大版を表示するには、ここをクリックしてください。
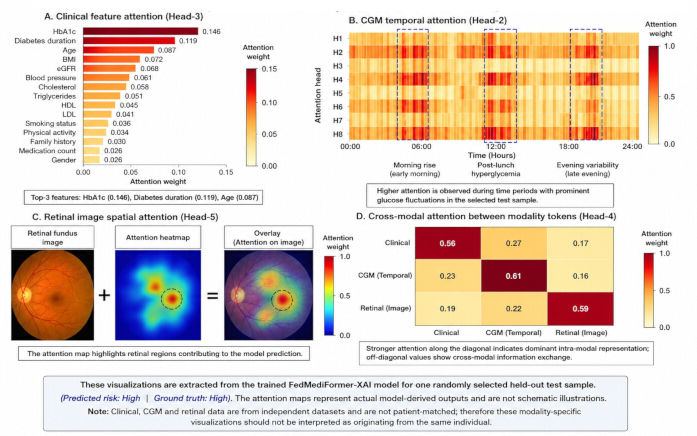
図 9学習済みFedMediFormer-XAIモデルにより生成された、ランダムに選択した1つのホールドアウトテストサンプルにおける代表的なアテンション出力。 (A) マルチモーダル・トランスフォーマーのアテンションヘッドから得られた臨床的特徴のアテンション。臨床的特徴に割り当てられた相対的なアテンション重みを示す。 (B) CGMシーケンスにおける時間的アテンション。モデルが高いアテンションを向けた時間帯を示している。 (C) 元画像、アテンションヒートマップ、およびアテンションオーバーレイを含む、網膜眼底画像の空間アテンション。 (D) 臨床データ、CGM、および網膜の各モダリティトークン間のクロスモーダルアテンションであり、モーダル内およびモーダル間の情報重み付けを示している。表示されている可視化結果は、学習済みモデルによって生成されたモデル出力である。アテンションウェイトは選択したテストサンプルについて示されており、これらはモデルのアテンションパターンとして解釈されるべきであり、臨床的な因果関係の独立した指標として解釈してはならない。 この図の拡大版を表示するには、こちらをクリックしてください。
| データセット | データ型 | 試料/記録 | 特徴/内容 | 目的 | 一般公開 |
| ピマ・インディアン糖尿病データセット | 臨床表形式 | 768人の患者 | 8つの臨床変数 | 糖尿病リスク予測 | 公開 |
| CDC 糖尿病健康指標 | ポピュレーションヘルス | 253,680件のレコード | 人口統計学的特性、ライフスタイル、健康指標 | 集団リスク分析 | 公開 |
| OhioT1DMデータセット | CGM時系列データ | 12名の被験者 | グルコース、インスリン、食事、運動、睡眠 | 時間的糖尿病モデリング | 公開 |
| APTOS 2019 失明検知 | 網膜画像 | 3,662枚の画像 | 重症度ラベル付き眼底写真 | 糖尿病網膜症解析 | 公開 |
| 薬剤レビューデータセット | 薬理学的 | 215,063件のレビュー | 薬剤の有効性、評価、レビュー | 薬剤推奨 | 公開 |
| DrugBank オープンデータ | 薬剤ナレッジグラフ | 数千種類の薬剤 | 薬物相互作用、標的、パスウェイ | グラフの作成 | 一般/学術アクセス |
表1:データセットの特性。本研究で使用した公開データセットの概要。データセットの種類、サンプルサイズ、データのモダリティ、特徴量の内容、目的、および入手可能性を含む。
| データセット | モダリティ | 予測ターゲット | 融合レベル |
| ピマ・インディアンの糖尿病 | 臨床 | 糖尿病の分類 | 特徴量埋め込み |
| CDC 糖尿病健康指標 | ポピュレーションヘルス | 糖尿病リスク予測 | 特徴量埋め込み |
| OhioT1DM | 持続血糖測定 | 血糖値変動予測 | 特徴量埋め込み |
| APTOS 2019 | 網膜眼底画像 | 糖尿病網膜症の解析 | 特徴量埋め込み |
| 薬剤レビュー + DrugBank | 薬理学的 | 薬剤推奨 | グラフ埋め込み |
表2:マルチモーダルデータセット統合戦略。マルチモーダル糖尿病インテリジェンスに使用されたデータセットの概要であり、データのモダリティ、予測ターゲット、およびモダリティ固有の表現が統合されるレベルが含まれている。臨床データ、人口統計学的健康データ、持続血糖測定データ、および網膜画像データは特徴量埋め込みとして表現され、一方で薬理学的情報はパーソナライズされた薬剤推奨のためにグラフ埋め込みを介して統合されている。
| モデル | 正解率、平均 ± 標準偏差 (95% CI) | 適合率、平均 ± 標準偏差 (95% CI) | 再現率、平均 ± 標準偏差 (95% CI) | F1スコア、平均 ± 標準偏差 (95% CI) | MCC、平均 ± 標準偏差 (95% CI) | AUC-ROC、平均 ± 標準偏差 (95% CI) |
| Random Forest | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| Temporal Transformer | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| Centralized Multimodal Transformer | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
表3:糖尿病の予測性能。正解率、適合率、再現率、F1スコア、MCC、およびAUC-ROC指標を用いた、FedMediFormer-XAIとベースラインの機械学習および深層学習モデルの予測性能の比較。
| 指標 | 集中型学習 | 連合学習 |
| 正確度 (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| プライバシー保護 | いいえ | はい |
| 生データの共有が必須です | はい | いいえ |
| コミュニケーションラウンド | 該当なし | 100 |
| トレーニング時間(時間) | 4.8 | 5.6 |
| 規制遵守 | 中程度の | 高 |
表4:連合学習と集中学習のパフォーマンス比較。予測性能、生データの共有要件、通信ラウンド数、およびトレーニング時間に関する、集中学習と連合学習の実装の比較。
| データセット | 正解率 (%) | 適合率 (%) | 再現率 (%) | AUC-ROC |
| Pima Indians Diabetes Dataset | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC Diabetes Health Indicators | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM Dataset | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 Blindness Detection | 94.7 | 93.9 | 93.5 | 0.96 |
| マルチモーダル融合 (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
表5:データセットレベルの結果。個々のデータセットおよびマルチモーダル融合設定における性能分析。結果は、全体の予測性能に対する異なるデータモダリティの寄与を示している。
| 指標 | 値 |
| Precision@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| 薬物相互作用検出の精度 | 0.95 |
| 推奨カバレッジ | 0.88 |
| 平均逆順位 (MRR) | 0.86 |
| 安全コンプライアンススコア | 0.94 |
表6:個別化薬剤推奨の性能。ランキング指標、相互作用検出精度、推奨カバレッジ、および薬剤安全性評価を用いたグラフベースの個別化薬剤推奨の評価。
| 評価基準 | 提案された評価設計 |
| 臨床医の信頼 | 5段階リッカート尺度による評価 |
| 解釈可能性 | 5段階リカート尺度評価 |
| 臨床的意義 | 5段階リッカート尺度による評価 |
| 解説の有用性 | 5段階リッカート尺度による評価 |
| 知覚された有用性 | 5段階リッカート尺度による評価 |
| 評価者間一致度 | 前向き評価後に算出されるFleiss' kappa(フライスのカッパ係数) |
| 統計学的比較 | データ収集後、適宜、対応のある統計検定を行う |
| 参加者 | 倫理委員会の承認およびインフォームドコンセントを得た12名の臨床医 |
| 評価状況 | 前向き評価/今後の評価 |
表 7:提案される人間中心の評価基準。FedMediFormer-XAIによる説明の有用性、臨床的関連性、解釈可能性、信頼性、およびユーザビリティを評価するための、臨床医中心の評価フレームワーク(案)。評価には、標準化された5段階のリッカート尺度による評価、Fleiss' kappaを用いた評価者間一致度の算出、予測のみの条件と予測および説明を併用した条件との統計的比較、および95%信頼区間が含まれる。臨床医による評価は、適切な施設倫理委員会の承認およびインフォームドコンセントを得た後にのみ実施されるべきである。
付随表1:データセット検証戦略。再現性と信頼性の高いモデル評価を確保するため、データセットの分割、検証手順、クラスバランス調整戦略、および品質管理措置を実施した。こちらをクリックしてファイルをダウンロードしてください。
補足表2:拡散モデルのパラメータ。TabDDPM拡散モデルの設定構成であり、トレーニングパラメータ、最適化設定、潜在次元、ノイズスケジューリング戦略、および合成サンプルの生成仕様が含まれる。こちらをクリックしてファイルをダウンロードしてください。
補足表3:マルチモーダル・トランスフォーマーの設定臨床、時間、および画像エンコーダ、埋め込みおよび融合次元、アテンションヘッド、オプティマイザー、学習率、バッチサイズ、トレーニングエポック数、早期停止基準、および統合トレーニング損失を含む、マルチモーダル・トランスフォーマー・アーキテクチャの構成。 こちらのファイルをダウンロードするには、ここをクリックしてください。
補足表4:連合学習の設定。参加病院数、通信ラウンド数、ローカル学習エポック数、クライアント参加率、集約アルゴリズム、オプティマイザ、学習率、暗号化方法、通信プロトコル、および生データ共有ポリシーを含む、プライバシー保護連合学習に使用されたパラメータ。こちらをクリックしてファイルをダウンロードしてください。
補足表5:GraphSAGEの設定。グラフの種類、隠れ層および埋め込み次元、グラフ層の数、近傍サンプリングサイズ、オプティマイザー、学習率、バッチサイズ、トレーニングエポック数、BPR(Bayesian Personalized Ranking)損失、および上位推奨薬剤数を含む、異種グラフベースのGraphSAGEを用いたパーソナライズ薬量推奨モジュールの設定。こちらをクリックしてファイルをダウンロードしてください。
補足表6:説明可能性の評価指標。FedMediFormer-XAIフレームワークの説明可能性を評価するために用いられた定量的および人間中心の指標。これらの指標は、説明の忠実度(fidelity)、安定性(stability)、一貫性(consistency)、疎性(sparsity)、完全性(completeness)、感度(sensitivity)、不忠実度(infidelity)、評定者間合意、および臨床医が認識する説明の質を評価する。こちらのリンクからファイルをダウンロードしてください。
補足表7:評価指標。フレームワークの性能、堅牢性、ランキング品質、および解釈可能性を評価するために、予測、連合学習、レコメンデーション、および説明可能性の指標が用いられています。こちらのリンクからファイルをダウンロードしてください。
補足表8:人間中心の評価設計。参加者グループ、評価条件、評価基準、および統計分析手順を含む、臨床医中心の評価研究の設計。 こちらをクリックしてファイルをダウンロードしてください。
補足表9:再現性アセット。提案されたFedMediFormer-XAIフレームワークの再現性を担保するために必要なデータセット、実装仕様、設定ファイル、評価手順、ドキュメント、および実験記録の要約。 こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
主要な知見の解釈
代表的な結果から、マルチモーダルTransformer学習、連合学習、拡散モデルベースのデータ拡張、グラフニューラルネットワークベースの薬剤推奨、および説明可能な人工知能を、統合的な糖尿病インテリジェンスフレームワークに組み込むことが可能であることが示されました。臨床記録、集団健康指標、持続血糖測定データ、眼底画像、および薬理情報を統合することで、提案されたFedMediFormer-XAIフレームワークは、解釈可能かつ分散型のモデル開発を支援しつつ、強力な予測性能を実証しました。このマルチモーダル学習法により、異なるヘルスケアモダリティから有益な特徴を抽出することができ、糖尿病予測の精度向上とパーソナライズされた治療推奨につながりました。
連合学習の利点
提案されたフレームワークの主な貢献の一つは、分散型の共同モデル構築を可能にする連合学習の統合である。連合学習は、生の患者データを直接共有することなく、複数の機関がモデルのトレーニングに参加できる点で、従来の集中型学習手法とは異なる。主な知見により、連合学習は分散的なデータ処理をサポートしつつ、集中型学習に匹敵する予測精度を維持することが示された。この機能は、機関のポリシーやプライバシー要件によってデータ共有が制限されるヘルスケアのシナリオにおいて特に重要である。
説明可能性分析
説明可能性の評価により、SHAP分析、Integrated Gradients、アテンション可視化、および反事実的説明のすべてが、モデルの挙動に関する臨床的に意義のある知見を導き出せることが明らかになった。グローバルな説明とローカルな説明は、臨床的な観点から見た上位の予測因子(すなわち、血糖値、BMI、年齢、インスリン投与パターン、および網膜異常)について概ね一致していた。また、アテンション可視化により、トランスフォーマーアーキテクチャが臨床的に関連のある時間的特徴および画像的特徴に注目していることが示された。これらのアプローチは、モデルの予測と特徴量の寄与について補完的な解釈を提供することで、透明性を向上させる。
パーソナライズされた薬剤推奨解析
本研究では、患者と薬剤、および薬剤間の関係性をモデル化し、パーソナライズされた薬剤推奨を行うGNNベースの推奨モデルを提案します。実際に、異種グラフトポロジーを用いることで、治療効果パターンの習得と薬剤投与の安全性の考慮の両立が可能となりました。本研究で得られた優れた薬剤推奨結果は、疾患予測を超えて、パーソナライズされた治療支援基盤に向けた糖尿病インテリジェンスシステムの開発におけるグラフベース学習手法の有用性を示しています。
人間中心の評価
本フレームワークには、説明可能性が臨床医の信頼、解釈可能性、ユーザビリティ、および知覚される臨床的有用性に及ぼす影響を評価するための、前向きな人間中心の評価プロトコルが組み込まれています。提案された評価では、標準化された評価基準を用いて、「予測のみ」の条件と「予測と説明の両方」がある条件を比較します。施設倫理委員会の適切な承認とインフォームドコンセントを得た後、この評価を実施することで、臨床医の受容性と生成された説明の実用的な有用性に関する経験的根拠が提供される予定です。
成功かつ再現可能な実装のための重要なステップ
提案されたプロトコルのいくつかの段階では、再現性を確保するために特に注意が必要です。データセットの前処理および分割では、患者レベルでの分離を維持し、データリークを防止する必要があります。また、連合学習においては、指定された非IIDのクライアント分布を保持しなければなりません。クロスモーダル融合では、定義された潜在次元、アテンション構成、モダリティタイプ埋め込み、正規化、および最終プロジェクションを維持する必要があります。拡散ベースのデータ拡張では、一貫した前処理とトレーニングパラメータを使用し、GraphSAGEベースの推奨では、一貫した患者・薬剤表現、相互作用スクリーニング、関連項目の定義、およびTop-Kランキング基準を維持する必要があります。説明可能性分析では、固定されたSHAPバックグラウンドサンプル、Integrated Gradientsのベースライン、アテンション抽出手順、および臨床的に許容される反事実的制約を使用してください。実装依存の変動を最小限に抑えるため、ソフトウェアのバージョン、乱数シード、モデル構成、データセットの分割、および評価パラメータを文書化する必要があります。
限界
本研究の結果を解釈する際には、いくつかの限界を考慮する必要があります。第一に、本フレームワークは公開データセットを用いて開発および評価されたため、現実世界のヘルスケア集団や臨床環境の多様性を完全に代表していない可能性があります。第二に、連合学習はシミュレーションによる病院クライアントを用いて評価されましたが、独立した医療機関を含む大規模な検証は実施されていません。第三に、連合学習を導入することで通信および計算のオーバーヘッドが増加し、リソースが制限された環境におけるスケーラビリティに影響を及ぼす可能性があります。最後に、本研究で採用した説明可能性の手法は主に事後的な解釈手法であり、複雑なモデルの挙動を完全に捉えきれていない可能性があります。
提案された人間中心の検証プロトコルでは、内分泌科医、糖尿病専門医、および臨床薬理学者からなる12名の臨床専門家による初期パネルを検討しています。このサンプルサイズは、決定的な臨床的妥当性の検証ではなく、ユーザビリティと解釈可能性の予備評価を目的としています。専門家パネルが比較的小規模であるため、統計的な検出力や汎用性が制限される可能性があります。したがって、今後の前向き研究では、多様な臨床現場や専門分野を代表する、より大規模な多施設共同の臨床医コホートを組み込む必要があります。
提案されたフレームワークの主な制限は、臨床データ、CGM、網膜イメージング、および薬剤関連のモダリティが、患者単位で一致したマルチモーダル記録ではなく、独立した公開データセットから派生している点です。したがって、クロスモーダル融合コンポーネントは、同一患者に対する同時マルチモーダル測定から得られたエビデンスとしてではなく、相補的なモダリティ表現を統合するための手法的なフレームワークとして解釈されるべきです。ソースデータセット間での集団特性、取得プロトコル、特徴量の分布、および疾患定義の違いにより、分布の不一致が生じる可能性があり、学習されたクロスモーダル関係が真の患者レベルの関連性をどの程度表しているかが制限される可能性があります。本プロトコルでは、独立したデータセット間での人為的な患者レベルのマッチングを明示的に避けていますが、この設計により、患者固有のマルチモーダル相互作用の直接的な評価が制限され、臨床的な汎用性に影響を及ぼす可能性があります。そのため、報告されたマルチモーダル性能は、前向きに収集された患者一致マルチモーダルコホートでの検証と同等であるとは解釈されるべきではありません。今後の研究では、同一患者からの同期された臨床、CGM、網膜、および治療情報を含む、より大規模で独立して収集されたデータセットを用いて、本フレームワークを検証する必要があります。
トラブルシューティングとプロトコルの修正
提案されたプロトコルの実施において、いくつかの実用的な検討事項が影響を及ぼす可能性があります。少数クラスの代表性が低い場合にクラス不均衡が生じると、予測性能が低下することがありますが、この課題は拡散ベースの拡張およびリサンプリング戦略によって軽減できます。欠損値や不整合なデータフォーマットはモデルの安定性に影響を与える可能性があるため、厳格な前処理手順によって対処する必要があります。クライアントのデータセットに大幅な異質性がある場合、連合学習の収束が不安定になることがあります。ローカル学習のエポック数、学習率、および集約頻度を調整することで、安定性を向上させることができます。また、特に大規模なマルチモーダルデータセットやトランスフォーマーアーキテクチャを処理する場合、ハードウェアの制限が学習効率に影響することがあります。そのような場合は、バッチサイズやモデルの複雑さを低減することで、再現性を維持しつつ計算上の実現可能性を高めることができます。
今後の展望
今後の研究では、パーソナライズされた疾患シミュレーションおよび治療計画のためのデジタルツイン技術の統合に焦点が当てられる可能性があります。大規模なマルチモーダル・ヘルスケアデータセットでトレーニングされた基盤モデルは、表現学習とモデルの汎用性をさらに向上させる可能性があります。因果推論による説明可能性の手法を用いれば、相関ベースの説明を超えて、疾患メカニズムや治療効果についてより深い洞察を得られる可能性があります。さらに、強化学習アプローチによって、適応的な治療の最適化や動的な薬剤推奨戦略をサポートできる可能性があります。これらの進歩により、糖尿病インテリジェンスシステムの臨床的有用性とパーソナライゼーション能力がさらに向上すると考えられます。なお、AIによって生成された予測や薬剤推奨は、専門的な臨床判断に代わるものではなく、意思決定支援ツールとして検討されるべきです。ヘルスケアAIシステムを責任を持って倫理的に展開するためには、適切な人間による監視が引き続き不可欠です。
結論
FedMediFormer-XAIは、糖尿病インテリジェンスに向けたマルチモーダル学習、連合学習、個別化薬剤推奨、および説明可能性を統合した再現可能なフレームワークを提供します。代表的な結果により提案されたワークフローの実現可能性が裏付けられましたが、臨床展開の前には、患者一致マルチモーダルデータセットを用いたさらなる検証、より大規模な臨床設定での検証、および前向きな臨床医による評価が必要です。
開示事項
著者らは、本研究で報告された内容に影響を及ぼしうる金銭的な利害関係、利益相反、または個人的な関係がないことを宣言します。人工知能ツールは、本論文の作成過程における言語の洗練、原稿の構成、フォーマット、および編集を支援する目的のみに使用されました。すべての科学的内容、研究デザイン、手法、データ分析、結果の解釈、および結論は、著者らによって作成、検証、および承認されました。著者らは、本原稿に提示された内容の正確性、完全性、および独創性について全責任を負います。
謝辞
著者らは、本研究で使用した公開データセットおよびオープンソースソフトウェアリソースの開発者および維持管理者に謝意を表します。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| AES暗号化 | NIST | AES-256 | 保存データの保護 / 連合学習における保護されたモデルパラメータの暗号化 |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | 2019 Release | 網膜底写真データセット;公開済みかつ匿名化済み;https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Version 0.8 | モデルの解釈可能性およびアトリビューション分析 |
| CUDA Toolkit | NVIDIA | Version 12.2 | GPU加速計算 |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015 Release | 集団健康指標;公開済みかつ匿名化済み;https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | Public Release | 網膜画像データセット;公開済みかつ匿名化済み;https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| デジタル証明書 | - | - | 連合学習におけるクライアント認証 |
| Drug Interaction Dataset | Kaggle | Public Release | 薬物相互作用グラフデータ;公開済みかつ匿名化済み;https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Dataset 462 | 薬物有効性およびレビューデータセット;公開済みかつ匿名化済み;https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Version 3.9 | 可視化 |
| MTS Diabetes Dataset | Kaggle | Public Release | ウェアラブルセンサー / 糖尿病予測データセット;公開済みかつ匿名化済み;https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Version 3.3 | 薬物相互作用グラフの構築および分析 |
| NumPy | NumPy Developers | Version 1.26 | 数値計算 |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | モデルのトレーニングおよび推論;システムメモリ32 GB以上 |
| OhioT1DM Dataset | Ohio University | Public Release | 持続血糖測定データセット;公開済みかつ匿名化済み;https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Version 4.10 | 画像処理 |
| Pandas | PyData | Version 2.2 | データ処理および前処理 |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Dataset 34 | 臨床糖尿病予測データセット;公開済みかつ匿名化済み;https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Version 3.11 | 主要プログラミング環境 |
| PyTorch | Meta AI | Version 2.3 | ディープラーニングモデルの開発およびトレーニング |
| PyTorch Geometric | PyG Team | Version 2.5 | グラフニューラルネットワークの構築およびトレーニング |
| Scikit-learn | Scikit-learn Developers | Version 1.5 | 機械学習ユーティリティおよび評価 |
| セキュア集約メカニズム | - | - | 連合学習におけるローカルモデルパラメータの保護された集約 |
| SHAP | SHAP Developers | Version 0.47 | 説明可能なAIおよび特徴量アトリビューション分析 |
| TensorFlow | Version 2.15 | ディープラーニングモデルの開発およびトレーニング | |
| Transformers | Hugging Face | Version 4.45 | Transformerベースのアーキテクチャ実装 |
| Transport Layer Security | IETF | TLS 1.3 | 連合パラメータ交換のための暗号化通信チャネル |
| ワークステーション | Generic | - | 計算環境;システムメモリ32 GB以上 |
参考文献
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.