本研究では、シナリオ実験と脳波測定を統合し、専門家およびコンパニオンとしての役割提示が、さまざまな医療タスクのコンテキストにおいて信頼とどのように関連しているかを検討します。
この記事について
サマリー
要約
オンライン医療AIは、バックエンドの分析ツールから患者向けのサービスインターフェースへと進化しており、適切に調整された信頼(calibrated trust)が設計およびガバナンスにおける重要な課題となっています。本研究では、役割一致理論(role congruity theory)に基づき、専門家としての役割提示(expert role framing)とコンパニオンとしての役割提示(companion role framing)が、さまざまな医療タスクの文脈において信頼とどのように関連しているかを検証しました。研究1では、2(役割:専門家 vs コンパニオン)× 2(タスク:疾患相談 vs 健康相談)のシナリオ実験(N = 300)を実施しました。専門家としての役割提示は知覚された専門性を高め、コンパニオンとしての役割提示は社会的実在感を高めました。これら2つの知覚は、同時に投入した際にそれぞれ独立して全体的な信頼と関連していました。専門性を介した間接的な関連はタスクの文脈によって条件付けられていましたが、直接的なブートストラップ比較では、全体的な信頼に関する2つの調整媒介指標に有意な差は認められませんでした。測定診断の結果、知覚された専門性と認知的信頼、および社会的実在感と感情的信頼の間に大幅な重複があることが示され、解釈には注意が必要であることが分かりました。研究2では、39組のペア観察において、EEGを用いて専門家およびコンパニオンとして提示された記述を比較しました。専門家としての役割提示では、前頭正中線シータ波のERSが高まり、基線補正後のFCz-F6シータ波ΔPLVの負の値が小さくなりました。一方で、条件レベルの行動データでは、信頼率、応答時間、または未回答率に信頼できる差は見られませんでした。これらのEEG所見は、探索的なプロセスレベルの相関関係であり、条件付き間接モデルを神経科学的に検証したものではありません。総じて、役割の手がかりは、排他的ではない能力志向の評価と関係志向の評価を形成するように見受けられます。役割設計においては、単に信頼を最大化させるのではなく、能力の境界、不確実性の伝達、リスクに基づく警告、および適切なエスカレーションを通じて、適切に調整された依存関係を支援すべきであると考えられます。
概要
現在の医療AIは、画像認識、病理分析、創薬などのバックエンドアプリケーションから、患者向けのサービスインターフェースまで幅広く展開しています。業界分析では、ヘルスケアAI市場は2033年まで継続的に成長すると予測されています1。大規模言語モデルにより、医療AIシステムは健康に関する質問への回答、検査結果の解釈、情報の要約、そして自然言語による推奨事項の提示が可能となりました2。この転換は、ユーザーとテクノロジーとの関係性を変化させます。バックエンドの分析ツールは臨床医や組織によって評価されますが、患者向けインターフェースは、その役割、根拠、不確実性、および限界をユーザーに伝えなければなりません。医療AIは、診断アシスタント、かかりつけ医のインターフェース、あるいは健康管理コンパニオンとして現れる可能性があり、それぞれがユーザーによるシステムのサービスアイデンティティの理解に影響を与えます。これらのシステムが病状相談や日常的な健康管理への関与を深めるにつれ、信頼は単なるテクノロジーへの態度以上の意味を持つようになります。信頼は、ユーザーが情報を開示するか、推奨事項を信頼できると考えるか、システムと対話するか、そして健康指導に基づいて行動するかどうかに影響します。したがって、信頼はデジタルヘルスプラットフォームにとって設計およびガバナンスにおける中心的な課題となります。
技術的な能力だけでは、ユーザーが医療AIを信頼でき、受け入れられるものであると判断するかどうかは決まりません。ヘルスケア用対話エージェントに関するレビューでは、その実装はインタラクションの質、臨床的妥当性、透明性、および展開条件に依存することが示されています3。また、医療AIにおける信頼できる根拠に関する近年の研究においても、主張が意図された用途に適した根拠によって裏付けられていない限り、モデルの性能だけでは不十分であると論じられています4。患者が、流暢な言語表現のみから信頼性を推測するのではなく、能力の限界や不確実性、および推奨の根拠を特定できなければならないため、透明性は不可欠です5。同様に、情報システム研究では、AI支援診断の導入を、解釈可能性、プライバシー保護、およびインターフェースの手がかりが共同して受容性を形成する信頼構成の問題として捉えています6。これらの検討事項は、言語モデルのインターフェースにとって重要です。流暢さは回答を理解しやすくしますが、システムが臨床的知識を備えているか、その推奨がユーザーの状況に適用可能か、また、いつ資格を持つ臨床医へのエスカレーションが必要になるかという問題は未解決のままとなります。重要な問いは、医療AIが回答を生成できるかどうかだけでなく、ユーザーが適切な信頼レベルでその回答を評価できるかどうかです。
医療AIに対する信頼は、タスクのコンテキストによって変動します。医療AIへの抵抗に関する研究では、ユーザーは、アルゴリズムでは個々の固有性を考慮できないと信じているため、リスクの高い意思決定においてアルゴリズムによる推奨を拒絶する場合があることが示されています7。しかし、この抵抗感は普遍的なものではありません。アルゴリズム評価の研究によれば、タスクが客観的であり、ルールが明確な場合には、人々はアルゴリズムによる判断を好む傾向があることが示唆されています8。オンライン健康相談において、AIが生成するアドバイスのパーソナライズの度合いや丁寧さは、信頼と導入に影響を与えます9。また、従来型の相談、デジタル相談、およびAIベースの相談を比較した離散選択研究においても、形式によって好みや信頼への期待が異なることが判明しています10。人間とAIのチーム体制は、人間の専門知識からAIサポート付きのサービス体制へと信頼を転移させることで、抵抗感を軽減できる可能性があります11。したがって、医療AIへの信頼は、知覚されたリスク、タスクの要求、コミュニケーションスタイル、およびシステムの評価の相互作用を通じて構築されます。疾患相談では、不確実性、起こりうる喪失、診断結果、およびエラーのコストが顕在化します。一方、健康相談は食事、運動、睡眠、服薬遵守、および予防管理に関するものであることが多く、そこでは持続的な相互作用や関係性に基づいたアクセスのしやすさがより大きな重要性を持つ場合があります。その結果、ユーザーが長期的な健康管理ではなく、疾患の可能性について助けを求めている場合、同じインターフェース上の手がかりであっても異なる解釈がなされる可能性があります。
ロールフレーミングは、これらの期待を伝えることができるインターフェース機能の一つです。医療AIは、専門的な権威、構造化された推論、臨床的境界、および能力の根拠を強調する「専門家」として、あるいは共感、安心感、社会的支援、および継続性を強調する「コンパニオン」としてフレーミングされる可能性があります。この区別は、社会的知覚の2つの次元である有能さと温かさに関連していますが、単に有能なシステムか温かいシステムかの選択ではありません12。コミュニケーションスタイルとエージェンシーのフレーミングは、対話エージェントの評価に影響を与えます13。モバイル医療アプリケーションにおいて、社会的キューとプライバシーへの懸念は、信頼および行動意図に複合的に影響します14。ヘルスケア対話エージェントにおける擬人化されたキューは、社会的存在感、信頼、および受容性を高める可能性がありますが、同時にシステムの能力を超える期待を抱かせる可能性もあります15。人間とAIのチームに関する研究では、温かさと有能さが、異なる形態の受容性を予測することがさらに示されています16。リスクの高いタスクにおいて、信頼はチームのロール、タスクのコンテキスト、およびパフォーマンス違反の適合性に依存します17。チャットボットの社会的ロールとパフォーマンスの一貫性も、信頼の構築と修復に影響を与えます18。したがって、専門家としてのキューとコンパニオンとしてのキューは、単に対話のトーンを変えるのではなく、異なる評価基準を顕在化させる役割を果たします。
2つの課題が残っている。第一に、能力指向および関係性指向のキューの妥当性が、医療タスクの要求事項によってどのように変化するかについて、研究による説明がなされていない。AIに対する人間の信頼に関するレビューでは、文脈依存性が強調されているが、専門家としてのキューとコンパニオンとしてのキューが、疾患相談と健康相談においてどのように機能するかは明確にされていない19。第二に、医療AIにおける信頼に関する研究は自己報告に依存しており、役割に基づいた評価に関連する処理についての証拠は限られている。また、プライバシー、透明性、責任、およびバイアスも、フロントエンドの役割キューの解釈を制約している20,21。これらの課題に対処するため、本研究では、役割キューと文脈的に顕著な要求事項との整合性によって評価が行われるとする役割一致理論(role congruity theory)を用いる22。研究1では、ランダム化された2(役割:専門家 vs. コンパニオン)x 2(タスク:疾患相談 vs. 健康相談)のシナリオ実験(N = 300)を行い、役割のフレーミング、タスクの文脈、および知覚されたプロフェッショナリズムと社会的存在感を通じた並行的な間接的関連性を検討する。研究2では、別の被験者内EEG実験(N = 39)を行い、専門家およびコンパニオンとしてフレーミングされた記述に対するテータ波帯活動を比較する。研究1では行動上の関連性と文脈的な調整効果を評価し、研究2では条件付き間接モデルの神経学的検証ではなく、探索的なプロセスレベルの比較を行う。
理論的枠組みと仮説の構築
医療AIにおけるロールフレーミング
医療AIは、疾患のリスク、治療の推奨、責任、および倫理的境界が関わる、リスクの高い環境で運用されます23。したがって、フロントエンドの言語表現によって、能力、エビデンス、および責任の境界がユーザーにとってどの程度明確になるかが決まるため、ロールフレーミングが重要となります。同様に、透明性に関する研究では、医療AIシステムは能力の限界とエビデンスベースを提示すべきであることが強調されています5。エキスパート形式の回答は、専門用語、構造化された推理、境界条件の提示、および行動の推奨を通じて能力を伝えますが、コンパニオン形式の回答は、共感、安心感、および協調的な表現を通じて関係的なサポートを伝えます。これらの手がかりは単なるインターフェースの装飾ではなく、ユーザーがシステムを評価する際に適用する基準を形成します24,25。擬人化は社会的反応を誘発する可能性がありますが、非現実的な期待を抱かせ、責任の境界を曖昧にする可能性もあります26,27。人間とAIのチームおよびチャットボットに関する研究では、温かさ、能力、ロールとコンテクストの適合性、および社会的役割とパフォーマンスの一貫性が、受容性と信頼感に影響を与えることがさらに示されています16,17,18。本研究において、ロールの一貫性とは、AIの回答によって伝達される手がかりと、コンサルテーションタスクにおいて顕在化する評価上の要求との整合性を指します22。
二経路の信頼:知覚された専門性と社会的存在感
役割の一致性は、個別の主観的な構成概念として測定されるのではなく、観察された役割とタスクの交互作用から推論されます。したがって、この解釈は実験的な交互作用に結びついており、参加者が役割への適合感を意識的に報告したことを意味するものではありません。信頼には、能力や信頼性に関する認知的判断と、関係性の安全性や快適さに関する感情的判断が含まれます28,29,30。医療AIの利用において、ユーザーはシステムが健康に関する意思決定をサポートできるか、およびシステムとの対話が十分に安全で親しみやすいと感じられるかの両方を評価します。エキスパートとしてのフレーミングは、能力重視の評価をより顕著にするはずです。臨床意思決定支援に関する研究からのエビデンスは、システムの推論に関する説明や情報が、信頼と依存に影響を与えることを示しています31。オンライン健康相談では、パーソナライズ化や配慮も信頼や受容に関連しています9。知覚された専門性は、信頼に関連する能力重視の評価を捉えるものです25。同様に、オンライン健康相談に関する研究では、情報のソースの信頼性がユーザーの健康上の提案の受容に関連することが特定されています32。したがって、本研究では、エキスパートとしてのフレーミングが、より高い知覚された専門性と関連しているかどうかを検証します。
H1:コンパニオン的な役割は、専門家スタイルの医療AIと比較して、知覚される専門性が低くなる。
コンパニオンとしてのフレーミングは、関係性に基づいた評価をより顕著にさせるはずである。社会的プレゼンスとは、システムが人間であるという信念ではなく、メディアを介したインタラクションにおいて知覚される対人的な質を指す33。これは、オンラインサービスやヘルスケア用対話エージェントにおけるインタラクションの質、信頼、および受容性と関連している15,34。
社会的存在感は、自己開示に伴う心理的コストを軽減し、オンライン相談における情報交換を促進する可能性があります32。したがって、本研究では、コンパニオン・フレーミングがより高い社会的存在感と関連しているかどうかを検証します。
H2:専門家としての役割は、コンパニオン形式の医療用AIと比較して、社会的実在感が低くなる。
知覚された専門性と社会的プレゼンスは、信頼に対する並列で非排他的な関連性として扱われます。ハイリスクなオートメーションへの適切な依存は、単に信頼を最大化することではなく、システムの機能、境界、およびタスクの要件に依存します35。
H3:知覚された専門性と社会的プレゼンスは、同時にモデル化された場合に、それぞれ信頼を正に予測する。
タスクコンテクストの調整効果
同一の役割キューであっても、医療タスクによって心理的な重要性が異なる場合があります。タスク・テクノロジー適合性は、役割キューがタスクの要件と一致しているかどうかを検討するためのコンテキスト上の根拠を提供します36。疾患相談では、不確実性、喪失リスク、およびエラーコストが高くなるため、専門性、正確性、および明確な境界線が特に重要となります7,37。したがって、専門的なキューは、伴走者のようなキューよりも、これらの要求に密接に適合している必要があります。健康相談は、長期的な健康管理、行動の持続性、および相互作用の継続性に焦点を当てています。AIベースの臨床意思決定支援および健康対話エージェントに関するレビューでは、コンテキスト情報、実行可能性、相互作用、および実装条件の重要性が強調されています3,38,39。
本研究では、専門家とコンパニオンの間で認識される専門性の差は、健康相談よりも疾患相談においてより大きくなると予測しています。また、社会的存在感に関する交互作用が有意でなかったことを、不変性の根拠として扱うことはしません。仮説は以下のように提案されます:
H4:タスクの文脈は、専門家の役割が知覚されるプロフェッショナリズムに与える影響を著しく調整する。この影響は、健康相談よりも病気相談においてより強くなる。
プロトコル
研究概要
本研究はヘルシンキ宣言に準拠して実施され、オンラインシナリオ実験とEEG実験の両方を対象として、華僑大学倫理委員会(M2025021)の承認を得た。すべての参加者からインフォームドコンセントを得ており、完了後に謝礼を支払った。
本論文は、2つの相補的な研究で構成されています(図1を参照)。研究1は、役割のフレーミングおよびタスク文脈の効果を推定し、測定構造を評価し、知覚された専門性と社会的存在感を通じた並行条件付き間接関連性を検証する、ランダム化2 × 2シナリオ実験です。研究2は、専門家としてフレーミングされた発言とコンパニオンとしてフレーミングされた発言の下でのシータ波活動を比較する被験者内EEG実験であり、探索的なプロセスレベルの比較として解釈されます。これらの研究は、異なるレベルにおける行動的および神経的なエビデンスを提供するものであり、単一の漸進的なメカニズムとして扱われるものではありません。
研究1:シナリオ実験
参加者および設計
研究1では、役割のフレーミング(専門家 vs. 伴走者)とタスクの文脈(疾患相談 vs. 健康相談)を用いた、バランスのとれた2 × 2の被験者間計画を採用した。当初のG*Powerによる計算では、中程度の分散分析(ANOVA)の効果量(f = 0.25)、α = .05、検定力 = .80を想定し、最低128人の参加者が的に示されていた40。この計算は条件付き間接効果に合わせて調整されたものではないため、調整された媒介分析の検定力の根拠としてではなく、当初のリクルート基準として報告されている。N = 300で4つのセルに均等に割り当てた場合の感度分析では、α = .05において、f = 0.162(部分η2 = .026)の交互作用を検出するための検定力が80%であることが示された。
さらに、300例のSPSSアンケートデータセットを用いて、調整された媒介指標に対する事後シミュレーションベースの検定力分析を実施しました。シミュレーションでは、経験的な残差を再サンプリングすることにより、適合させた並列媒介モデルから1,000個の均衡な2 × 2サンプルを生成しました。各シミュレーションデータセットには、500回のケース再サンプリングによるパーセンタイル・ブートストラップ信頼区間を用いました。信頼区間がゼロを含まない推定確率は、プロフェッショナリズム指標で.698、社会的存在感指標で.157、およびこれら2つの指標間の直接的な差で.279でした。この分析は、観察された係数、残差分布、およびモデル仕様に基づいた条件付きのものであり、事前のサンプルサイズの正当化を行うものではありません。事後シミュレーションベースの検定力分析の詳細は、付録表S1に提示しています。
Credamoを通じて300名の参加者を募集し、4つの条件にランダムに割り当てた(各群 n = 75)。サンプルには男性109名(36.3%)と女性191名(63.7%)が含まれ、年齢層は21-30歳が43.7%、31-40歳が41.3%であり、69.7%が学士号を保持していた。必要な質問項目はすべて回答された。専用のアテンションチェック項目や事前登録された完了時間の除外基準は設けず、参加者の除外は行わなかった。完了時間の中央値は268 s(範囲 = 67-1,894 s)であった。極端に速い回答への感度を評価するため、完了時間が下位5パーセンタイル(<125 s)の回答を除外した事後ロバストネス分析(保持数 n = 285)を実施した。操作チェックの詳細な統計量および完了時間の感度分析は、Supplementary Table S2に報告している。
実験刺激および手順
刺激材は、タスクシナリオの導入文とAI医師による対話回答で構成され、計4組の実験セットとした。疾病相談シナリオでは、参加者に夜間の反復的な胸部圧迫感と動悸があり、即座に受診が必要か不安に感じている状況を想定させた。健康相談シナリオでは、参加者に概ね健康な状態で、個別の食事および運動計画を求めている状況を想定させた。各タスクカテゴリーに1つのシナリオを割り当てたため、得られた結論はこれら2つのシナリオに限定され、すべての疾病および健康相談に一般化されるものではない。
使用した4つのアンケートのスクリーンショットにはすべて同じアイコンが使用され、システム名としてMedical AI (DiagnosPro) が表示されており、これにより条件間で表示上のアイデンティティを一定に保ちました。専門家フレームの回答では、構造化された分析、リスクまたは根拠に関する記述、指示的な表現、および明確な行動推奨が用いられました。一方、コンパニオンフレームの回答では、共感、安心感を与える言葉、協調的な表現、および柔軟な提案が用いられました。したがって、この操作は、役割に一致したコミュニケーションと情報的手がかりのパッケージを提示したものであり、役割のフレーミングを、具体性、実行可能性、確実性、医学的詳細、または感情的サポートから切り離して単独で操作したものではありません。共通の名前であるDiagnosProもまた、すべての条件において専門家としての手がかりを伝えた可能性があります。刺激物の完全なセットはSupplementary File 1に記載されています。
参加者はまずインフォームドコンセントの説明書を読み、その後、4つの実験条件のいずれかにランダムに割り当てられた。シナリオと対話刺激を読んだ後、自身の回答に基づいたアンケートに回答した。アンケートは操作チェックから始まり、続いて、知覚された専門性、社会的存在感、信頼感、および人口統計学的属性の測定を行った。手続きには約15分かかった。
すべての尺度では7段階のリッカート法による採点を用い、1を「強く同意しない」、7を「強く同意する」とした。知覚された専門性は、「この医療AIは医学的なアドバイスを提供することが可能である」、「この医療AIは非常に専門的に見える」、「この医療AIは医学分野のエキスパートである」という3つの項目で測定した(α = .883)41。社会的存在感は、「この医療AIとの相互作用において、人間味を感じた」、「この医療AIとの相互作用により、親近感を感じた」、「この医療AIは相互作用において社交的に見えた」という3つの項目で測定した(α = .932)42。認知的信頼は、「この医療AIはアドバイスを提供するために必要なスキルを備えているため、信頼できる」、「この医療AIが提供するアドバイスの正確性に自信がある」、「この医療AIは私の健康問題を扱う十分な能力を持っている」という3つの項目で構成した(α = .837)。感情的信頼は、「この医療AIは温かさと配慮を感じさせる」、「この医療AIは私の健康を気にかけているように見えるため、信頼することで安心感を得られる」、「この医療AIが意図的に私に有害なことをすることはないと信じている」という3つの項目で構成した(α = .700)。総合的な信頼は、これら6つの信頼項目の平均値とした(α = .784)。これらの指標は、互いに排他的な構成概念としてではなく、能力志向、対人関係、認知的信頼、感情的信頼、および総合的信頼の成果として分析した。
分析は4つのステップで進められた。第一に、確認的因子分析を用いて、提案された4因子モデルと、2因子および1因子の代替モデルを比較し、複合信頼性、平均分散抽出量、潜在相関、およびHTMT(heterotrait-monotrait)比を検討した。第二に、完全な2 × 2 要因モデルを用いて、知覚されたプロフェッショナリズム、社会的実在感、認知的信頼、感情的信頼、および総合的な信頼に関する主効果と交互作用を、セル平均、信頼区間、および部分 η2とともに推定した。推定周辺平均と95%信頼区間を図2に示す。第三に、PROCESS 4.2 betaのモデル7を用い、知覚されたプロフェッショナリズムと社会的実在感を並列媒介変数として同時に投入し、5,000回のパーセンタイル・ブートストラップ標本を用いて分析した43。役割フレーミングは1 = エキスパート、2 = コンパニオンとしてコード化し、タスクコンテキストは1 = 疾患相談、2 = 健康相談としてコード化された。共通再サンプリング・ブートストラップを用いて、調整媒介の2つの指標を直接的に対比させた。第四に、認知的信頼と感情的信頼を探索的なアウトカムとして個別に分析した。媒介変数とアウトカムが同時に測定されたため、これらの推定値は因果的な心理メカニズムとしてではなく、媒介と整合する間接的な関連性として解釈される。
研究2:EEG実験
参加者
研究2では40名の参加者を募集した。少なくとも1つの実験条件において、アーチファクトにより汚染された試行が30%を超えた参加者1名を除外したため、最終的なEEG解析の対象者は39名となった。この基準により、保持されたすべての参加者が各条件において少なくとも70%の試行に寄与していることが保証された。すべての参加者から書面によるインフォームドコンセントを得ており、実験後に謝礼を支払った。人口統計学的情報は、保持されたすべてのEEG記録と紐付けることができなかったため、最終的なEEGサンプルについての要約は行っていない。
実験刺激および手順
本実験は、被験者内計画を用い、標準的なEEG研究室にて実施され、刺激提示にはE-Prime 2.1を使用した。参加者は、医療AIシステムとの対話を想像し、それぞれの医療相談シナリオにおいてシステムに対する信頼度を評価するよう指示された。実験では、エキスパート型およびコンパニオン型などの変異を含め、医療AIシステムの認識される役割を操作した。
計40個の中国語の文章刺激を作成した。「専門家型」条件には、「医療AI専門家」で始まる刺激を20個含め、「コンパニオン型」条件には、「医療AIコンパニオン」で始まる並行的な刺激を20個含めた。医療シナリオは、病歴の聴取、検査報告書の分析、心拍データの評価、遺伝子検査の解釈、疾患リスクの判定、治療計画の推奨といった専門的な診断機能と、体調への配慮、睡眠の質の確認、不安の軽減、健康データの記録、治療遵守の促進、日常的な健康アドバイスの提供といった支援的な健康管理機能の両方を網羅した。したがって、各条件は意味内容と複雑さにおいても異なっており、独立した刺激のマッチングや事前テストは実施されていない。
本実験に先立ち、参加者は短い練習ブロックを行いました。各試行は500 msの注視点から始まり、続いて300–500 msのランダムな空白区間と、1,600 ms提示される医療AIに関する記述が表示されました。その後、参加者はFキー(信頼する)またはJキー(信頼しない)を押すことで、自身のペースで二肢の信頼判断を行いました(図3を参照)。専門家フレームとコンパニオンフレームの記述はランダムな順序で提示されました。E-Primeのタスクログにより、1つのタスクレコードにつき80回の本試行(専門家フレーム40回、コンパニオンフレーム40回)が行われ、各役割につき20種類のユニークな記述が2回ずつ提示されたことが示されました。
行動タスクデータ
最終的なEEGサンプルとして選出された39名の参加者のうち、38名分の行動タスクデータが利用可能であった。1名の参加者のE-Primeタスク記録は利用不能であったため、行動分析ではN = 38とした。詳細な行動結果およびサンプルの内訳は付録表S3に記載されている。信頼はFキーによる反応として、非信頼はJキーによる反応としてコード化した。無回答または記録された反応時間が0 msの場合は欠損値としてコード化した。信頼率は回答があった試行間で算出し、反応時間は回答があった試行の平均をまとめた。解析に使用可能な神経データには条件ごとに集計された指標は含まれていたが、試行レベルのEEG指標や、各行動記録とEEG記録を紐付ける検証済み識別子は含まれていなかった。したがって、EEGと信頼判断の試行レベル混合モデルの推定は行わなかった。
EEGの記録と解析
電極と皮膚間のインピーダンスを 5 kOhm 未満に維持するため、導電性電解質ゲルの Quik-Gel を使用した。デバイスのデフォルトのオンラインリファレンスは FCz とし、サンプリングレートは 1,000 Hz とした。両側乳様突起の平均によるオフラインリファレンス処理は、CURRY の組み込みリリファレンス機能を用いて行った。FCz は保持され、新しいリファレンスに基づいて自動的に再構成されており、カスタムの再構成コマンドやスクリプトは使用しなかった。その後のオフライン処理は、MATLAB R2020b の EEGLAB44 および ICLabel45 を用いて行った。データは 500 Hz にダウンサンプリングし、0.1 から 40 Hz のバンドパスフィルタをかけた。不良チャネルおよび著しく汚染されたデータセグメントは目視によって特定して除去し、自動補完や自動セグメント除去しきい値は適用しなかった。その後、EEGLAB のデフォルトの runica 実装(Infomax ICA)を使用し、ICLabel がアーチファクトクラス(例:眼球、筋肉、心拍、ラインノイズ、またはチャネルノイズ活動)に 0.70 以上の確率を割り当てたコンポーネントを除去した。いずれかの条件においてアーチファクトで汚染された試行が 30% を超えた参加者は除外し、各条件で少なくとも 70% の試行が保持されるようにした。エポックの範囲は −1,000 から 1,996 ms とした。機能的結合解析のために、前処理後のデータをさらに 250 Hz にダウンサンプリングし、位相同期推定の前に P7、P8、F7、F8 を含む末梢電極を除外した。
前頭正中線の頭皮部位で記録されたシータ活動は、認知制御の要求に伴う計算処理に関連していることが示されている46。また、内側および外側の前頭部電極部位間のシータ帯位相同期も、制御に関連する処理中の協調動作に関連している47。特に、FCzやF6などの部位間におけるシータ帯位相同期の増強は、葛藤やエラーの検出後に観察されている48。これらの頭皮測定値は認知制御にのみ特有のものではないため、ここでは単一の認知メカニズムの直接的な読み取り値ではなく、収束的なプロセス指標として扱う。
まず、刺激後800~1,000 msのウィンドウ内において、4~8 Hz帯域の前頭正中線シータ事象関連同期(ERS)を定量化しました。ERSは時間周波数解析を用いて算出され、相対的なパワー変化は刺激前−500~−200 msのベースラインに対して計算されました。正の値はパワーの増強(同期)を、負の値はパワーの抑制(脱同期)を示します。次に、前処理済みデータを250 Hzにダウンサンプリングし、P7、P8、F7、F8を含む周辺電極を除外した後、機能的結合度を推定しました。FCzとF6の間のシータ帯域位相ロック値(PLV)を算出する前に、短時間フーリエ変換(STFT)を適用しました。ベースライン補正後のPLV変化(ΔPLV)は、刺激前−600~−200 msのベースラインに対して算出されました。生のPLVは0から1の範囲に限定されるため、負のΔPLV値は負の位相ロックではなく、ベースラインに対する減少を意味します。これらの頭皮上の測定値は、制御に関連する処理および前頭前野の協調に関連する探索的なパターンとして解釈されており、特定の認知プロセスや神経源を直接的に特定するものではありません。
結果
研究1:シナリオ実験の結果
測定モデル。4因子モデルは2因子および1因子の代替モデルよりも適合度が良かったが、絶対適合度はまちであった:χ2(48) = 23.93, p < .01; CFI = .935; TLI = .91; RMSEA = .1; SRMR = .140。標準化負荷量は.382から.937の範囲であった。合成信頼性は、知覚された専門性が.86、社会的存在感が.932、認知的信頼が.840、感情的信頼が.709であり、対応するAVE値はそれぞれ.72、.821、.636、.474であった。判別妥当性は限定的であった:HTMT値は知覚された専門性と認知的信頼の間で.935、社会的存在感と感情的信頼の間で.926であった。したがって、条件付きプロセス分析の結果は慎重に解釈し、次元別の信頼性分析は探索的なものとする(表1)。
操作チェック。専門家フレーミングの参加者(n = 150, M = 5.57, SD = 1.18)は、コンパニオンフレーミングの参加者(n = 150, M = 3.21, SD = 1.76)よりも、医療用AIをより専門家らしいと評価した。分散が異なっていたため(F = 47.42, p < .01)、ウェルチの検定を用い、t(259.90) = 13.63, p < .01, 平均差 = 2.36, 95% CI [2.02, 2.70]であった。疾患条件の参加者(n = 150, M = 2.51, SD = 1.53)は、健康条件の参加者(n = 150, M = 5.98, SD = 1.2)よりも予防健康志向の評価が低かった(F = 10.96, p = .01;Welch’s t(284.11) = −21.70, p < .01, 平均差 = −3.47, 95% CI [−3.79, −3.16])。分散が不均一な場合、ウェルチの自由度は N − 2 と一致しない。なお、すべての分析において N = 30 を使用した。
実験条件別の記述統計。エキスパート・フレーミングでは、疾病相談および健康相談における知覚された専門性の平均値はそれぞれ 5.69 (SD = 0.83) と 5.85 (SD = 0.63)、社会的存在感の平均値は 4.28 (SD = 1.54) と 4.25 (SD = 1.64)、そして全体的な信頼感の平均値は 5.45 (SD = 0.86) と 5.28 (SD = 0.87) であった。コンパニオン・フレーミングでは、対応する疾病および健康相談の平均値は、知覚された専門性で 4.52 (SD = 1.47) と 5.25 (SD = 0.94)、社会的存在感で 5.68 (SD = 1.07) と 5.93 (SD = 0.74)、全体的な信頼感で 5.30 (SD = 1.02) と 5.61 (SD = 0.64) であった。表 2 に、すべての条件別信頼区間および完全な要因検定の結果を示す。
完全要因分析の結果。知覚された専門性は、役割フレーミングの主効果 F(1, 296) = 56.92, p < .01, partial η2 = .161、タスクコンテキストの主効果 F(1, 296) = 14.37, p < .01, partial η2 = .046、および役割 × タスクの交互作用 F(1, 296) = 5.89, p = .016, partial η2 = .020 を示した。社会的存在感は、役割フレーミングの主効果 F(1, 296) = 105.57, p < .01, partial η2 = .263 を示したが、タスクの主効果 F(1, 296) = 0.59, p = .42 および交互作用 F(1, 296) = 0.84, p = .359 はともに有意ではなかった。後者の結果は、調整効果が検出されなかったことを示すものであり、タスク間での同等性を立証するものではない。認知的信頼については、役割 × タスクの交互作用が有意であり F(1, 296) = 5.60, p = .019, partial η2 = .019 であった。一方、感情的信頼における対応する交互作用は有意ではなかった F(1, 296) = 3.48, p = .063, partial η2 = .012。総合的な信頼は、役割フレーミングの主効果 F(1, 296) = 0.81, p = .369 およびタスクの主効果 F(1, 296) = 0.55, p = .459 を示さなかったが、役割 × タスクの交互作用は有意であった F(1, 296) = 5.78, p = .017, partial η2 = .019。疾患相談において、総合的な信頼はコンパニオンフレーミングとエキスパートフレーミングの間で差がなかった(平均差 = −0.15, SE = 0.14, t(296) = −1.06, p = .28, 95% CI [−0.42, 0.13])。健康相談においては、コンパニオンフレーミング下で総合的な信頼が高かった(平均差 = 0.3, SE = 0.14, t(296) = 2.34, p = .020, 95% CI [0.05, 0.60])。
並列条件付き間接関連。知覚された専門性と社会的存在感を同時に投入したところ、両者とも全体的な信頼と正の相関を示した:それぞれ b = 0.4872, SE = 0.0258, p < .01, 95% CI [0.4294, 0.5460]、および b = 0.3293, SE = 0.0208, p < .01, 95% CI [0.2762, 0.3829] であった。役割フレーミングの直接的な関連は有意ではなかった(b = 0.0119, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361])。専門性の間接関連は、病気相談において −0.5695 (95% bootstrap CI [−0.7687, −0.3851])、健康相談において −0.2923 (95% bootstrap CI [−0.428, −0.1634]) であった。社会的存在感の間接関連は、病気相談において 0.4625 (95% bootstrap CI [0.3165, 0.6091])、健康相談において 0.532 (95% bootstrap CI [0.385, 0.7383]) であった(Table 3)。知覚された専門性を介した調整媒介指数は 0.272 (95% bootstrap CI [0.0594, 0.5035]) であったのに対し、社会的存在感を介した指数は 0.0907 (95% bootstrap CI [−0.0984, 0.308]) であった。これらの指数間の直接的なブートストラップ対比は有意ではなかった(difference = 0.1864, 95% bootstrap CI [−0.0856, 0.47])。したがって、結果は専門性による間接関連の文脈的な調整を支持するが、2つの関連において統計的に異なる文脈的な調整があることは立証しなかった。
信頼感の次元に関する探索的分析。認知的信頼について、専門性と社会的プレゼンスによる調整媒介指数のコントラストは正であり、差 = 0.3707、95% ブートストラップ CI [0.0493, 0.696] であった。感情的信頼については、対応するコントラストは支持されなかった(差 = 0.02、95% ブートストラップ CI [−0.3421, 0.3127])。両方の媒介変数は、両方の信頼次元との正の相関を維持しており、これは排他的な効果ではなくクロスパス的な効果であることを示唆している。HTMT値が高いことから、これらの結果を認知的メカニズムと感情的メカニズムの決定的な分離として解釈すべきではない。
事後的な調整媒介分析の検定力。適合モデルおよび残差リサンプリングの仮定の下で、パーセンタイル・ブートストラップ信頼区間がゼロを含まない推定確率は、プロフェッショナリズム指数で.698、社会的存在感指数で.157、およびそれらの直接的な差で.279であった(1,00回のシミュレーション、1シミュレーションあたり50回のブートストラップ・リサンプル)。これらの観察デザインに基づく推定値は、支持されたプロフェッショナリズム指数および有意ではなかった直接的な対比が、文脈的な調整が異なるという決定的な証拠として解釈されるべきではない理由を説明している。
完了時間の堅牢性。125 s未満の回答15件を除外したところ、285例が残った。全般的な信頼感の交互作用は有意なままであり(p = .029)、プロフェッショナリズム指数の支持も維持され(95% bootstrap CI [0.0242, 0.4827])、調整された媒介指数のコントラストは非有意なままであった(95% bootstrap CI [−0.1027, 0.4506])。主要な結論は、回答時間が最も速い上位5%の結果に依存していなかった。
研究2:EEGの結果
前頭正中線におけるシータ波ERS。最終的な解析サンプル(N = 39)において、4–8 Hz、80–1,00 msウィンドウにおけるシータ波ERSは、コンパニオンフレーミング(M = −0.042, SD = 1.215)よりもエキスパートフレーミング(M = 0.2948, SD = 0.8218)で高く、平均差 = 0.369, 95% CI [0.0125, 0.614], t(38) = 2.10, p = .042, Cohen’s dz = 0.37, partial η2 = .104であった。報告された2つの対応のあるEEGアウトカムに対するHolm補正後のp値は.042であった。この差は、このタスクウィンドウにおけるシータ帯域処理の相違を示しているが、シータ波ERS単独では特定の心理学的プロセスを特定するものではない。
FCz-F6のベースライン補正済みシータ波PLV変化(ΔPLV)。最終的な解析サンプル(N = 39)において、シータ波のΔPLVは、コンパニオン・フレーミング(M = −0.0350, SD = 0.0473)よりもエキスパート・フレーミング(M = −0.01, SD = 0.0546)において負の値が小さかった。平均差 = 0.0239, 95% CI [0.058, 0.0420], t(38) = 2.68, p = .01, Cohen’s dz = 0.429, partial η2 = .159。報告された2つのペアードEEGアウトカムにおけるHolm補正後のp値は.02であった。このパターンは、エキスパート・フレーミング下でベースラインからのシータ波位相の一貫性の減少がより小さかったことを示しているが、これのみでより強い前頭前野の制御や特定の認知メカニズムが確立されるわけではない(図4および表4を参照)。
行動タスクの結果。分析した38件のタスク記録において、信頼反応率は、エキスパート・フレーミング条件下で83.1% (SD = 15.8%)、コンパニオン・フレーミング条件下で82.4% (SD = 17.5%)であり、平均差 = 0.7 percentage points, 95% CI [−0.9, 2.4], t(37) = 0.91, p = .371, dz = 0.147であった。平均反応時間は、それぞれ828.7 ms (SD = 204.6) および 826.1 ms (SD = 208.9) であり、平均差 = 2.5 ms, 95% CI [−14.0, 19.1], t(37) = 0.31, p = .758, dz = 0.050であった。無反応率は、それぞれ6.3% (SD = 7.4%) および 5.2% (SD = 6.3%) であり、平均差 = 1.1 percentage points, 95% CI [−1.0, 3.1], t(37) = 1.05, p = .302, dz = 0.170であった。
データ可用性ステートメント:
匿名化された研究1のアンケートデータ、前処理済みのEEGファイル、および研究2を裏付ける集計済みEEG出力ファイルは、Open Science Framework (OSF)(https://doi.org/10.17605/OSF.IO/JKSP7)で公開されている。補足資料には、完全な実験刺激(補足ファイル 1)、操作チェック、追加の行動解析、事後パワー解析、および補足的な手法に関する情報。
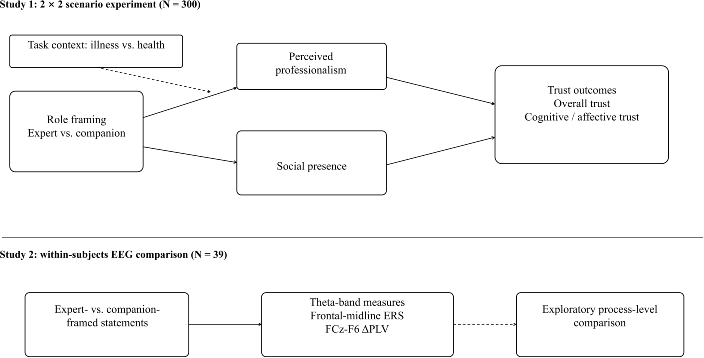
図1研究フレームワーク 研究1は、役割のフレーミング、タスクのコンテキスト、および知覚された専門性と社会的プレゼンスを介した並行的な間接関連性を検討する2 × 2のシナリオ実験(N = 30)である。研究2では、専門家フレーミングおよびコンパニオンフレーミングの言明に関する探索的な脳波(EEG)比較を行っている(N = 39)。なお、研究2では条件付き間接モデルの直接的な検証は行っていない。 こちらの図の拡大版を表示するには、ここをクリックしてください。
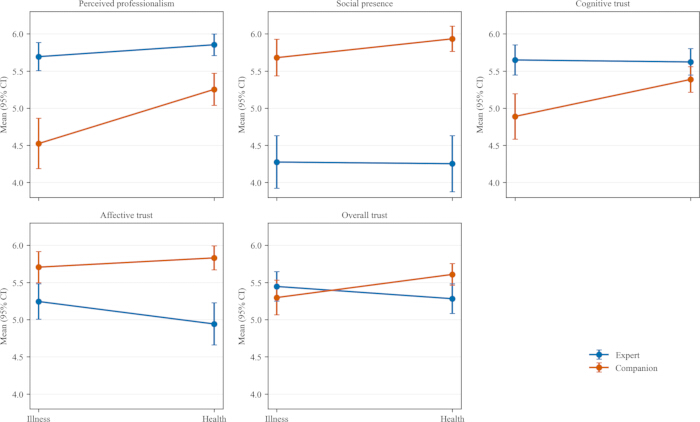
図2知覚された専門性、社会的実在感、認知的信頼、感情的信頼、および総合的信頼に関する、役割提示 × タスク文脈のプロット。 点は各セルの平均値を、エラーバーは95%信頼区間を示している(n = 各セルあたり75)。 こちらの図の拡大版を表示するには、ここをクリックしてください。
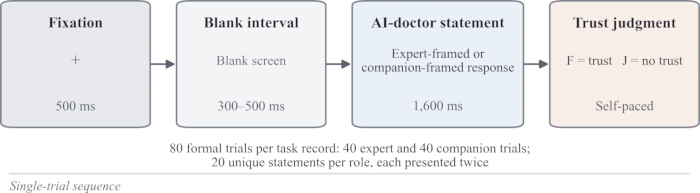
図3研究2における単回試行シーケンス。 各試行は、50 msの注視点提示、30~50 msのランダムなブランク期間、1,600 msの専門家またはコンパニオンとして構成されたAI医師による記述、および自己ペースによる二値の信頼性判断で構成された。E-Primeのタスクログによれば、1つのタスク記録あたり80回の正式な試行が行われており、役割フレーミング条件ごとに40試行、さらに各条件につき20種類の固有の記述がそれぞれ2回ずつ提示された。 こちらの図の拡大版を表示するには、ここをクリックしてください。
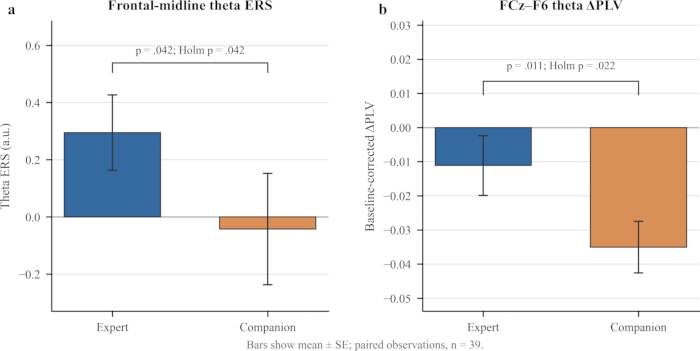
図4医療AIの役割提示(ロールフレーミング)が前頭正中線シータ波ERSおよびFCz-F6シータ・デルタ波PLVに及ぼす影響。 (A) 前頭部正中線シータ波イベント関連同期 (B)ベースライン補正後のFCz-F6間シータ波位相同期値(ΔPLV)の変化。負の値は刺激前ベースラインからの減少を示す。棒グラフはn = 39の平均値 ± 標準誤差(SE)を示す。対応のあるt検定の結果、シータ波のERSでp = .042、ΔPLVでp = .01であった。報告されたこれら2つのアウトカムに対するホルム補正後のp値は、それぞれ.042および.022であった。略語: こちらの図の拡大版を表示するには、ここをクリックしてください。
表1:研究1における測定モデルの診断。本表は、知覚されたプロフェッショナリズム、社会的存在感、認知的信頼、および情緒的信頼に関する標準化負荷量、Cronbachのα、合成信頼性、平均分散抽出量、潜在相関、およびHTMT値を報告している。N = 30。4因子モデルは代替案よりも適合していたが、RMSEAおよびSRMRは絶対適合度の低さを示し、2つのHTMT値が.90を超えていた。略語:CR = 合成信頼性;AVE = 平均分散抽出量;HTMT = ヘテロトレイト-モノトレイト比。こちらのリンクから本表をダウンロードしてください。
表2:研究1における4条件の記述統計および完全な2 × 2 要因設計検定。セル内の数値はn、平均、標準偏差、および95%信頼区間を示し、要因検定はF、p、および部分 η2を示している。N = 300、各セル n = 75。役割のフレーミングは 1 = 専門家、2 = 伴走者としてコード化し、タスクのコンテクストは 1 = 疾患、2 = 健康相談としてコード化した。係数および信頼区間は非標準化である。こちらをクリックしてこの表をダウンロードしてください。
表3:研究1における並行条件付き間接関連。N = 30。役割フレーミングは1 = 専門家、2 = パートナーとしてコード化し、タスクコンテキストは1 = 疾患相談、2 = 健康相談としてコード化された。知覚された専門性と社会的存在感を同時に投入した。推定値は非標準化であり、パーセンタイル・ブートストラップ信頼区間には5,0回の再サンプリングを用いた。本表には、条件付き間接関連、調整媒介の両方の指標、およびそれらの直接的なブートストラップ対比が含まれている。全体的な信頼に対する2つの調整媒介指標間の直接対比は0.1864、95% CI [-0.0856, 0.47]であった。こちらをクリックしてこの表をダウンロードしてください。
表 4:研究 2 におけるペアリングされた EEG 結果。最終分析サンプルの N = 39 のペアリングされた観測値。本表は、前頭正中線シータ ERS およびベースライン補正済み FCz-F6 シータ ΔPLV について、条件別の平均値、ペアリングされた平均差、95% 信頼区間、ペアリングされた t 検定、Cohen’s dz、部分 η2、および Holm 補正後の p 値を報告している。Holm 補正は報告された 2 つのペアリングされた EEG 結果のみを対象としており、電極、周波数帯域、または時間窓にわたる記録されていない広範な探索を再構成するものではない。こちらをクリックして本表をダウンロードしてください。
補足ファイル1:研究1で使用した実験刺激。 このファイルには、病気相談および健康相談のシナリオで使用された、専門家フレームおよびコンパニオンフレームによる医療AIの回答の完全なテキストが含まれています。中国語の原文と英語訳の両方が提供されています。こちらをクリックしてファイルをダウンロードしてください。
補足表S1. 調整された媒介モデルに対する、事後シミュレーションに基づく検出力分析。 こちらをクリックしてファイルをダウンロードしてください。
付随表 S2. 研究1における操作チェックの統計量および完了時間の感度分析。 こちらをクリックしてファイルをダウンロードしてください。
補足表 S3. 研究2における行動タスクの結果、サンプル数、および記述統計。 こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
理論的意義
これら2つの研究は、異なるレベルでのエビデンスを提供しています。研究1では、ランダム化シナリオ実験を通じて役割とタスクの関連性および並行的な間接的関連性を特定し、一方で研究2では、探索的なプロセスレベルのEEG比較を行っています。したがって、これらの研究は、単一の漸進的なメカニズムではなく、役割に基づいた評価の限定的な説明を支持するものです。本知見は、役割の手がかりとタスクにおいて顕著な評価要求との整合性としてコングルイティ(適合性)を扱うことで、役割コングルイティ理論を医療AIに拡張するものです22。この解釈は、能力-温かさの内容や、タスク-テクノロジー適合性とは異なります。アルゴリズム回避およびアルゴリズム好意の知見は、役割と能力の手がかりがタスクに適合しているかどうかの、コンテキスト依存的な評価として理解することができます49,50。
また、結果は、ロールフレーミング、知覚された専門性、社会的存在感、および信頼の間の、排他的ではない並行的な関連性を支持しています。専門性は認知的信頼と重複し、社会的存在感は感情的信頼と重複するため、本エビデンスは分化された評価内容を支持しますが、完全に分離された2つのメカニズムを支持するものではありません。知覚された専門性における役割とタスクの交互作用は、提案された役割適合性(role-congruity)の説明と一致しています。エビデンスは専門性との関連における文脈的な調整を支持していますが、統計的に非対称な文脈的メカニズムや、社会的存在感パスにおける不変性を立証するものではありません。
EEGの知見は、探索的なプロセスレベルの視点を提供するものである。専門家による枠付けがなされた陳述には、明確なシータ波帯域のパターンが伴っていたが、条件間で意味的内容や複雑さも異なっており、条件レベルの行動においては信頼度に信頼できる差は見られなかった。したがって、EEGによる測定は、明確な認知制御または信頼メカニズムを立証するものではない。神経科学的な知見は、仮説生成のためのものとして扱うべきである。研究2では、タスクの文脈の操作、知覚された専門性や社会的存在感の測定、および試行レベルのEEG指標と信頼判断との関連付けが行われていない。そのため、EEGの結果は条件付き間接モデルを検証するのではなく、それを補完するものである。
これらの知見は、最大限の依存ではなく、適切な依存を行うことと整合しています。自動化システムへの依存は、システムの能力、限界、およびタスクの要件に合わせて調整されるべきです35。関連研究では、調整された信頼と依存をサポートし得る適応的な認知メカニズムについて述べられています51。NeuroISの視点は、時間的に分解されたプロセスを検討する際に、行動学的根拠を補完するものとして神経学的指標を用いることを支持しています52。また、先行するfMRI研究においても、オンライン上の信頼判断中の神経活動が、対象や文脈によって異なることが示されています53。
経営上の示唆
オンライン医療プラットフォームにおける実用的な示唆は、単なる信頼の最大化ではなく、調整された依存(calibrated reliance)である。ロールキューはタスクの要求に合わせて整合させる必要があり、不確実性の伝達、明確な能力の限界、リスクに基づく警告、および資格を持つ臨床医へのエスカレーションと組み合わせるべきである。
診断、異常結果の解釈、医学的助言、またはトリアージに関わる高リスクのモジュールでは、能力志向のキュー(手がかり)を用いることで、不当な権威を付与することなく、エビデンスとアクションの境界をユーザーが認識するのに役立つ可能性があります。食事、運動、睡眠、アドヒアランス、および情緒的サポートなどの緊急性の低いモジュールでは、関係性志向のキューを用いることで、誤った安心感や不適切な擬人化を招くことなく、エンゲージメントを促進できる可能性があります。
ロール設計は、固定的なパーソナリティ設定ではなく、モジュール式でシナリオベースであるべきです。ロール構成は、説明、プライバシープロンプト、リスクラベル、およびエスカレーションメカニズムと統合される必要があります。ガバナンス研究では、信頼できるフロントエンドのロールキューがバックエンドのリスクを隠蔽することがないよう、透明性、説明責任、バイアス管理、およびプライバシーを統合して設計する必要性が強調されています6,20,21。
研究の限界と今後の展望
研究1は実際のコンサルテーションではなく、シナリオを用いた実験である。各条件について、長さ、単語の頻度、可読性、正確性、実行可能性、感情価、覚醒度、リスク、親しみやすさ、または複雑性の観点から、独立した事前テストは行われていない。今後の研究では、複数のシナリオ、中立的なシステム名、コンテンツを一致させた刺激、独立した操作または時間的に分離した測定、ならびに参加者レベルおよび刺激レベルの変量効果を用いるべきである。
研究2ではプロセスレベルのEEGエビデンスが得られたが、最終的な39名のデモグラフィック連携は不完全であり、EEG刺激文は文長、単語頻度、可読性、感情価、覚醒度、知覚リスク、親しみやすさ、および複雑さに関して独立した照合や事前テストが行われていなかった。また、明示的な役割ラベルが要求特性を生じさせた可能性がある。本研究では、機能的結合の事前定義された指標として、ベースライン補正済み位相ロック値(ΔPLV)を用いた。加重位相ラグ指数(wPLI)は体積伝導の影響を受けにくいが、元の解析パイプラインには含まれていなかった。今後の研究では、wPLIやその他の相補的な結合指標を用いて、本結果が再現されるかを確認すべきである。得られた神経データは条件ごとに集約されており、試行レベルの信頼判断と結びつけることができないため、試行レベルのEEG-行動混合モデルの推定は行わなかった。また、頭皮PLVは共通参照および体積伝導の影響を受けやすい。これらの制限があるため、神経科学的な知見は探索的なものに留めるべきであり、固有の認知制御または信頼メカニズムの証拠として解釈すべきではない。
開示事項
著者らに申告すべき利益相反はありません。
本論文の作成において、著者は言語表現の改善にChatGPTを使用しました。当該ツールおよびサービスの利用後、著者は必要に応じて内容を検討・編集し、出版物の内容について全責任を負います。
謝辞
本研究プロジェクトは、中華人民共和国国家社会科学基金一般項目(助成番号:22BGL006)の支援を受けて実施されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Credamo オンライン調査プラットフォーム | Credamo (Jianshu), China | 該当なし | 研究1で使用したオンラインアンケート、ランダム割り当て、および参加者募集プラットフォーム。 |
| CURRY リリファレンシング機能 | Compumedics Neuroscan, USA | バージョン指定なし | FCzオンラインリファレンスから両側乳様突起平均への組み込みオフラインリリファレンシング。FCzは新しいリファレンスに基づいて自動的に再構成された。 |
| EEG電極キャップ(64チャンネル) | Compumedics Neuroscan (Compumedics Limited), Australia | モデル/カタログ番号指定なし | 連続EEG記録に使用した64チャンネルAg/AgCl電極キャップ。 |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 2023.0 | EEGの前処理および独立成分分析に使用したMATLABツールボックス。 |
| E-Prime | Psychology Software Tools, Inc., USA | Version 2.1 | 研究2における刺激提示および反応収集。 |
| G*Power | Heinrich Heine University Dusseldorf, Germany | Version 3.1.9.7 | 研究1における当初の事前サンプルサイズ計算、交互作用感度分析、および事後モデルベース検出力分析。 |
| IBM SPSS Statistics | IBM Corp., USA | Version 27 | PROCESSマクロを実行するために使用した統計環境。 |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 1.7 | アーチファクト独立成分を分類するために使用したEEGLABプラグイン。 |
| MATLAB | The MathWorks, Inc., USA | Release R2020b | EEGの処理および分析に使用した計算環境。 |
| SPSS用PROCESSマクロ | Andrew F. Hayes, Canada | Version 4.2 beta | 研究1において、知覚された専門性と社会的存在感を並列媒介変数として同時に投入したモデル7を使用し、5,000個のパーセンタイルブートストラップサンプルを用いた。 |
| Quik-Gel 導電性電解質ゲル | Compumedics Neuroscan (Compumedics Limited), Australia | カタログ番号指定なし; 32 oz | EEG記録中の電極-皮膚間インピーダンスを低減するために使用した導電性ゲル。 |
| SynAmps2 EEGアンプ | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; カタログ番号指定なし | 64チャンネル記録用に構成された64-256チャンネルEEGアンプ。 |
参考文献
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.