本研究では、データ拡張、前処理、およびハイブリッドモデルのカスタマイズ(中間融合)を用い、DenseNet121とEfficientNetB7の特徴融合能力を強化したアプローチであるFusionNetXを提案しました。5つの公開データセットを用いた脳腫瘍の分類において、98.77%から99.89%という結果を達成し、複数の評価パラメータにおいて優れた性能を示しました。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
脳腫瘍は世界で最も致死率の高い疾患の一つと考えられており、誤診は患者の生命を危険にさらし、生存率を低下させます。ディープラーニングベースの手法、特に畳み込みニューラルネットワークを用いた磁気共鳴画像法(MRI)は、脳の内部構造の詳細な検査を可能にし、優れた学習および予測能力を提供するため、この課題を克服する上で極めて重要です。脳腫瘍の正確な診断へのニーズは依然として高く、そこで、訓練可能および非訓練可能層を含むカスタマイズされたファインチューニング・ハイパーパラメータを用い、事前学習済みモデルであるDenseNet121とEfficientNetB7の強みを活用した、強化された特徴融合ベースのDLモデル(FusionNetX)を提案します。提案したFusionNetXモデルを、公開されている5つの脳腫瘍データセット(Br35H、Figshare、Sartaj、Masoud、Balanced Brain Tumor)に適用しました。画像品質の向上および、リサイズとデータ拡張による過学習の抑制のために、いくつかの前処理ステップを適用しました。正解率、損失、陽性予測値、陰性予測値、真陽性率、真陰性率、F1スコア、偽陰性率、偽陽性率などのさまざまな性能評価指標を用いて評価した結果、提案モデルFusionNetXは、Br35Hで99.33%、Figshareで99.13%、Masoudで99.89%、BBT-Datasetで99.19%、Sartajで98.77%の正解率を示しました。さらに、提案したFusionNetXモデルの重要性を実証するために、5つの脳腫瘍データセットを用いてレートフュージョンおよびアテンションベースの融合による評価を行ったところ、すべてのデータセットにおいて0.3%から1.9%の向上が見られ、大幅に優れた結果となりました。さらに、受信者動作特性曲線(ROC曲線)を算出した結果、およびさまざまな性能評価指標による結果から、提案したFusionNetXモデルが脳腫瘍を正確に検出し予測でき、医療従事者が適時に判断を下すのに寄与することが示されました。
概要
癌はその深刻さと進行速度のため、現代において人体で最も致死率の高い疾患となっています。脳腫瘍、乳癌、肺結節、腎癌などの多様な癌性疾患が人体で発見されており、それが死亡率の上昇を招いています。癌は、体内の細胞や組織が異常に増殖することで発生します。 癌が転移すると、他の臓器に損傷を与え、より危険な状態になります1。脳はあらゆる身体機能を制御しているため、脳へのいかなる損傷も全身に広範な影響を及ぼす可能性があります。 それが、脳腫瘍や脳癌が人間にとって極めて致命的である理由です2。さらに、脳腫瘍は大きく分けて良性と悪性の2つのカテゴリーに分類されます。「良性」とは基本的に癌ではないことを意味し、周囲の環境を整えることで解決可能な脳内の問題にすぎません。一方、悪性の場合、その転移性により危険であると考えられます。異常な細胞や組織が身体の他の部位へ移動、あるいはそこから移動することで、他の臓器をも乱し、体内での癌の発生確率を高めるためです3。
また、米国脳腫瘍協会および世界保健機関(WHO)によれば、下垂体腫瘍、髄膜腫、およびグリオーマの3つが脳がんの主要なカテゴリーとされています4。グリオーマは、脳内のニューロンに栄養を供給するグリア細胞から発生します。下垂体腫瘍は、脳の底部に位置し、さまざまな身体機能を司る下垂体から始まります。一方、髄膜腫は、脳と脊髄を囲む膜を保護する髄膜から発生します。さらに、診断目的で体内の部位を検査するために、X線、コンピューター断層撮影(CT)スキャン、磁気共鳴画像法(MRI)など、複数の医学的画像診断法が一般的に使用されています5,6。各画像診断法にはそれぞれ長所と短所があります。MRIは、体内の軟組織や細胞、特に脳の詳細な画像を提供する画像診断法です。がんは体内の異常な組織や細胞を伴いますが、MRIはこれらの異常の詳細な画像を提供するため、脳腫瘍やがんの診断においてより有用な画像診断法となります。加えて、MRIは体内解剖構造の検査中に有害な放射線を発生させないため、他の画像診断法よりも安全です。
さらに、脳腫瘍に関連する診断上の課題に対処するために、機械学習(ML)、画像処理(IP)、ディープラーニング(DL)を含む多くの計算手法が採用されており、それぞれのアプローチが画像診断装置で撮影された画像に適用されて癌の診断が行われています7。これらの手法は、画像内の異なるオブジェクトの潜在的なパターンや構造を学習し、患部のパターンを特定することで癌を診断します。各計算手法には、診断プロセスにおいてそれぞれ長所と短所があります。MLおよびIPベースの手法では手動で設計された特徴量(handcrafted features)を抽出しますが、これは特に大規模なデータセットにおいて、予測の不正確さや誤診を招くことが多いです8。手動の特徴抽出の問題を克服するため、一般的に畳み込みニューラルネットワーク(CNN)ベースのモデルと呼ばれるディープラーニングベースのモデルへの移行が進んでおり、これらのモデルは画像から最適な特徴を学習し自動的に抽出することで、腫瘍を正確に診断します。DLベースの手法は、大規模なデータから複雑なパターンを学習・抽出してより正確な結果を出す能力があるため、現在、人体における疾患の診断、特に脳腫瘍、乳癌、肺癌、およびその他の疾患の早期かつ正確な検出のために、医学的画像診断で一般的に使用されています9。DLモデルで直面する主な問題は、より多くのリソースの消費とデータサンプリングであり、これは転移学習10(TL)と呼ばれる別のディープラーニングベースの手法によって克服されます。TLでは、学習済みモデルを使用して疾患を診断することで、時間とリソースを節約します。大規模なデータセットからテクスチャ、色、エッジなどの基本的な特徴をあらかじめ学習した学習済みモデルにより、健康問題の早期かつ正確な診断が可能になります。これらのモデルは、モデルを活用し、ハイパーパラメータおよび学習可能・学習不能な層を追加することで、これまで見たことのない新しいデータセットに転移させることができます11。脳腫瘍の分類に関して相当量の研究が行われており、Table 112,13,14,15,16,17,18,19,20,21,22,23に、アプローチ、データセット、および結果を含むこれらの研究の詳細を示します。しかしながら、堅牢な特徴抽出のために2つの転移学習モデルを組み合わせ、スムーズなトレーニングとテストを保証するために正則化手法を調整した手法を採用した研究はまだありません。提案手法の詳細な評価により、異なる脳腫瘍の特徴にわたるモデルの性能に関する洞察が得られます。
| 参考文献 | 手法 | データサンプル | 結果 | 限界点 |
| 12 | カスタマイズ済みCNN | Br35H | 正解率 = 97.45%, | 結果には依然として改善の余地があります。独自に構築したCNNを使用するのではなく、既存のCNNモデルを修正して使用することが望ましいと考えられます。 |
| 損失 = 0.1141%、 | ||||
| 再現率 = 98.09%, | ||||
| F1スコア = 97.69% | ||||
| 適合率 = 97.29%, | ||||
| 拡張Br35H | 正解率 = 98.99% | |||
| 適合率 = 98.90%, | ||||
| 損失 = 0.0570%、 | ||||
| 再現率 = 98.91%, | ||||
| F1スコア = 99.04% | ||||
| 13 | 特徴融合DNNモデル | Br35H | 正解率 = 98.22%、 | 結果には依然として改善の余地があり、カスタムモデルを使用するのではなく、特徴融合には既存のモデルを使用する必要がある。 |
| FNR = 1.77% | ||||
| 感度 = 98.2% | ||||
| F1スコア = 98% | ||||
| 特異度 = 98%, | ||||
| Figshare | 精度 = 98.01%、 | |||
| 感度 = 96.03%、 | ||||
| F1スコア = 96%、 | ||||
| 特異度 = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | SGDを用いたAlexNet | Br35H | 正確度 = 98.79%, | それでも、結果にはさらなる改善の余地があり、異なるデータサンプルを用いていくつかの高度なCNNベースのモデルを検証する必要もあります。 |
| MCR = 1.20%, | ||||
| 感度 = 98.98%, | ||||
| 特異度 = 98.58%, | ||||
| F1スコア = 98.82% | ||||
| 15 | InceptionV3 | Figshare | 正解率 = 98.89% | 著者らは、3つの腫瘍クラスを含むFigshareデータセットを使用した。彼らはこれらを分類するのではなく、腫瘍の有無を分類したが、結果の改善および腫瘍クラスのカテゴリー化における改善の余地が依然として残っている。 |
| 感度B = 95.28%、 | ||||
| 感度M = 94.47% | ||||
| 16 | 最適化済みResNet50 | Figshare | 正解率 = 99.03%, | 結果にさらなる改善が見られたため、他の性能評価パラメータを算出する必要がありました。 |
| 再現率 = 99%、 | ||||
| F1スコア = 99% | ||||
| 17 | Res-BRNet | Br35H | 正解率 = 98.22%, | 結果にはまだ改善の余地があります。 |
| 感度 = 98.11%, | ||||
| 精度 = 98.22%, | ||||
| Figshare | F1スコア = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | 正確度 = 99.18%, | 結果にわずかな改善が見られ、脳腫瘍に関連するデータセットをさらに検証する必要がある。 |
| 再現率 = 99.11%, | ||||
| F1スコア = 99.08, | ||||
| 精度 = 99.07%、 | ||||
| サルタージ | 正解率 = 97.24% | |||
| 再現率 = 97.58%, | ||||
| F1スコア = 97.28%、 | ||||
| 適合率 = 97.06%, | ||||
| 19 | CNN-SVM | 膠芽腫 | 精度 = 98.02% | SVMを用いた既存のモデルを適用する必要があるが、結果には依然として改善の余地がある。 |
| F1スコア = 98.31% | ||||
| 適合率 = 98.09%、 | ||||
| 感度 = 98.53%、 | ||||
| 特異度 = 97.30% | ||||
| サルタージュ | 正解率 = 96.83%, | |||
| 適合率 = 95.36%, | ||||
| 感度 = 94.73%、 | ||||
| 特異度 = 97.56%, | ||||
| F1スコア = 95% | ||||
| 20 | ファインチューニング済みEfficientNetB3 | Figshare | 正解率 = 98.70% | 結果を改善するために、前述のEfficientNetB3のバリアントが必要である。 |
| サルタージュ | 正解率 = 97.50% | |||
| 21 | InceptionV4 | マスード | 正解率 = 98.7% | さらなるデータセットを用いることで、結果のいくつかの改善が必要であった。 |
| 精度 = 99%、 | ||||
| 感度 = 98% | ||||
| 特異度 = 99%、 | ||||
| F1スコア = 99.1% | ||||
| 22 | VGG16 | マスード | 精度 = 98% | より多くのディープニューラルネットワークモデルを検討し、結果を改善する必要がある。 |
| 23 | MFR-CNN | マスード | 正解率 = 94% | 本提案手法では、複雑なアーキテクチャが用いられています。 |
| 再現率 = 96%、 | ||||
| F1スコア = 96%、 | ||||
| 精度 = 96%、 |
表1:最新の研究に関する比較検討。本表には、既存の研究、そのアプローチ、データサンプル、結果、および限界がまとめられています。こちらをクリックして本表をダウンロードしてください。
表 1 では、既存の手法について概説し、結果の向上における限界や、既存のDLモデルを使用する必要性、およびさまざまな統計パラメータに対する性能評価について、異なる脳腫瘍データセットでより優れた性能を発揮する効率的なフレームワーク内での検討について強調しています。
研究目的と問題提起
手動による判定は時間がかかり、観察者間でのばらつきが生じるため、MRIによる脳腫瘍型の迅速かつ正確な分類は、臨床的な意思決定において極めて重要です。現在の自動脳腫瘍分類におけるディープラーニング(DL)アプローチの多くは、単一のバックボーンネットワークまたは単純な決定レベルの融合に基づいており、複数の学習済みアーキテクチャから得られる相補的な特徴表現を十分に活用できていません。また、多くの場合、単一のデータセットでのみ検証されており、汎用性に対する信頼性が制限されています。
本研究プロジェクトは、相補的な特徴表現を活用することでMRIから堅牢な脳腫瘍分類を可能にするデュアルバックボーンDLフレームワーク(EfficientNetB7およびDenseNet121)を用い、ヒトの脳における脳がんを診断するための完全かつ正確な手法の開発および提供を目的としています。また、複数の独立した公開データセットを用いて、本フレームワークの堅牢性を評価します。このアプローチは、放射線科医や救急救命士が脳腫瘍を迅速かつ効果的に診断することを支援し、早期の認識と分類を可能にすることで患者の生命を救うことに寄与します。
特定の研究課題を解決し、本研究プロジェクトの目的または目標を達成するために、以下の研究上の問いと、それらの問いに対するアプローチを定義します。1) 脳腫瘍の分類において、2つの学習済みバックボーンネットワークの特徴量レベル(中間)での統合は、決定レベル(後期)の統合やアテンションベースの統合手法よりも優れているか。2) 提案システムは、独立して取得された多くの脳腫瘍MRIデータセットにおいて、一貫した分類性能を提供できるか。
本研究の範囲は、公開されている5つの脳腫瘍MRIデータセット(Br35H、Figshare、Sartaj、Masoud、BBT-Dataset)を用いた画像レベル(2D MRIスライス)の分類に限定されており、データセット間ではなく個別に評価を行い、メソッドセクションに記載された特定のアーキテクチャ、前処理パイプライン、および実験構成を用いています。本研究には、患者レベルの検証や臨床展開環境での試験は含まれていません。
本研究の主な貢献は以下の通りです。1) 最適化されたハイパーパラメータを持つDenseNet121およびEfficientNetb7を含む、2つの事前学習済みモデルを利用することで、より優れた特徴抽出を実現したこと。2) 2つの事前学習済みモデルから連結された特徴量と、高度な正則化手法を統合した革新的なモデルアーキテクチャを構築し、堅牢な性能を実現したこと。3) 学習サンプルの多様性を高めてより汎用的かつ特異的な特徴を学習させるための効果的なデータ拡張戦略を適用し、過学習の問題を克服したこと。4) 提案モデルの性能を、精度(accuracy)、誤分類率(misclassification rate)、適合率(precision)、陰性的中率(negative predictive value)、感度(sensitivity)、特異度(specificity)、F1スコア(F1-Score)、偽陰性率(false negative rate)、および偽陽性率(false positive rate)を含む様々な統計的評価パラメータに焦点を当てて、公開されている5つの異なる脳腫瘍データセットで評価したこと。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
世界で最も脅威となる疾患の一つに脳腫瘍があります。正確な診断は患者の生存率を高める上で有益です。しかし、脳腫瘍を早期に検出できる高精度な診断システムが依然として求められています。この課題を解決するため、DenseNet121およびEfficientNetB7モデルに基づき、最適化されたハイパーパラメータと微調整されたレイヤーを用いたハイブリッド二重ディープラーニングメカニズムによる、より信頼性の高い早期脳腫瘍検出手法が提案されました。提案手法では、2D MRI画像を入力とし、二値分類データセットBr35Hについては「腫瘍あり」か「腫瘍なし」かの予測を、他の4つの多クラス分類データセットについては腫瘍のカテゴリー分類を出力します。したがって、本セクションでは、Figure 1に示すように、データの収集から最終出力まで、データの取得、データの前処理、データの分割、モデルの選択、特徴抽出、腫瘍の予測、および提案モデルの評価を含む、提案手法の主要な手順について解説します。
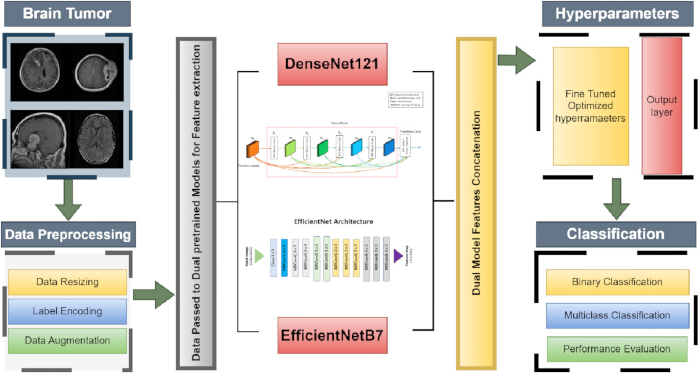
図1提案される手法のワークフロー。 この図は、提案モデルの全体的なアーキテクチャを示しており、そこにはデータ収集と前処理、特徴抽出のための2つの学習済みモデル、それらの特徴量の結合、および腫瘍の分類と種類の特定に向けたハイパーパラメータの微調整が含まれています。 この図の拡大版を表示するには、ここをクリックしてください。
データ収集
あらゆる実験研究において、最初のステップはデータ収集です。本研究では、脳腫瘍検出の診断に多くの研究者がすでに使用している、Br35H24、Figshare25、Sartaj26、Masoud27、およびオープンソースライブラリのKaggle28からの脳腫瘍MRI画像ベースのデータセットを含む、5つの異なる公開データセットを選択しました。Br35Hデータセットには、健常および不健常(腫瘍)の脳画像の2つのクラスで構成される3,0枚の画像があり、各クラスに1,50枚ずつ含まれています。一方、Figshareデータセットは3,064枚の画像で構成され、腫瘍のタイプに基づいて3つのグループに分かれています。具体的には、神経膠腫(glioma)が1,426枚、髄膜腫(meningioma)が708枚、下垂体腫瘍(pituitary tumor)が930枚です。Sartajデータセットには、神経膠腫(926枚)、髄膜腫(937枚)、下垂体腫瘍(901枚)、および健常または腫瘍なし(50枚)の4つの腫瘍クラスに分類された3,264枚の画像があります。さらに、Masoudデータセットも4つの異なる腫瘍クラスで構成されており、これらの画像は前述の3つのデータセットから取得された合計7,023枚の画像からなり、さらに神経膠腫(1,621枚)、髄膜腫(1,645枚)、下垂体腫瘍(1,757枚)、および健常または腫瘍なし(2,0枚)に分類されています。最後に選択したデータセットはMRI画像ベースのデータセットであり、これも合計5,248枚の画像を含む4つのクラスで構成されています。これらは、神経膠腫画像1,312枚、髄膜腫画像1,312枚、下垂体腫瘍画像1,312枚、および健常または腫瘍なし画像1,312枚というように腫瘍タイプ別にさらに分割されており、すでに腫瘍タイプごとに均等に分割されたバランスの取れたデータセットとして扱われています。
データの前処理
データ取得後の次のステップは前処理であり、これは結果を向上させ、データから最適な特徴を抽出して学習する計算手法に有用であり、より精度の高い結果を導き出すために不可欠です。最初に行った手順は画像のリサイズです。クラスや画像サイズが異なる(同一データセット内であっても腫瘍クラスによって異なる)5つの公開データセットを選択し、モデルの解釈と学習を向上させるために、すべて一律に224 x 24にリサイズしました。さらに、すべてのデータセットにデータ拡張を適用し、異なる角度から追加サンプルを生成することで、DLモデルによる特徴抽出と学習を改善しました。このため、すべての画像に7%の回転範囲を適用し、最大7度まで回転させました。さらに、すべての画像に水平および垂直方向へ5%のランダムシフトを適用し、元の画像に対して高さと幅を5%シフトさせました。その後、元の画像に対して10%のズームインを行い、最後にすべての画像を水平および垂直方向に反転させました。データ拡張29を行う主な理由は、元のデータサンプルのさまざまな変換バージョンでトレーニングすることにより、過学習を克服し、モデルの汎化性能を向上させることです。データセットをトレーニング用と検証用に分割する前に、ラベルエンコーディングを適用しました。これにより、トレーニングおよび検証中の損失計算が容易になり、モデルがラベルを正しく処理するためにデータサンプルがより不可欠な形式となります。さらに、データセットをトレーニングセットと検証セットに80%対20%の比率30で分割しました。Table 2に、データサンプルの全体的な分布と、トレーニングおよび検証の比率を示します。
| データセット | 腫瘍クラス | 画像総数 | トレーニング用画像数 | 検証用画像数 |
| Br35H | 正常 | 150 | 120 | 300 |
| 腫瘍 | 150 | 120 | 30 | |
| 画像総数 | 30 | 240 | 60 | |
| Figshare | 神経膠腫(グリオーマ) | 1426 | 141 | 285 |
| 髄膜腫 | 708 | 56 | 142 | |
| 下垂体腫瘍 | 930 | 74 | 186 | |
| 画像総数 | 3064 | 2451 | 613 | |
| Sartaj | 神経膠腫(グリオーマ) | 926 | 741 | 185 |
| 髄膜腫 | 937 | 749 | 18 | |
| 腫瘍なし | 50 | 40 | 10 | |
| 下垂体腫瘍 | 901 | 721 | 180 | |
| 画像総数 | 3264 | 2611 | 653 | |
| Masoud | 神経膠腫(グリオーマ) | 1621 | 1297 | 324 |
| 髄膜腫 | 1645 | 1316 | 329 | |
| 腫瘍なし | 20 | 160 | 40 | |
| 下垂体腫瘍 | 1757 | 1405 | 352 | |
| 画像総数 | 7023 | 5618 | 1405 | |
| Balanced brain tumor dataset (BBT-Dataset) | 神経膠腫(グリオーマ) | 1312 | 1050 | 262 |
| 髄膜腫 | 1312 | 1050 | 262 | |
| 腫瘍なし | 1312 | 1050 | 262 | |
| 下垂体腫瘍 | 1312 | 1050 | 262 | |
| 画像総数 | 5248 | 420 | 1048 |
表2:データセットの分布 この表は、脳腫瘍データセットにおけるクラスごとの合計、トレーニング用および検証用の画像数の統計を示しています。.
Br35Hデータセットは30枚の画像で構成されており、そのうち240枚がトレーニング用に、600枚が検証用に選出されました。Figshareデータセットは3064枚の画像で構成されています。全画像のうち、2451枚がトレーニング用に選出され、残りの613枚が検証用に割り当てられました。Sartajデータセットは計3264枚の画像があり、261枚がトレーニングに、残りの653枚が検証に使用されました。Masoudデータセットは計7023枚の画像があり、そのうち5618枚がトレーニングに、残りの1405枚が検証に使用されました。BBTデータセットは計5248枚の画像で構成されています。全画像のうち、420枚がトレーニング目的で検討され、残りの1048枚が検証目的で検討されました。さらに、以下の 図2に、さまざまな脳腫瘍の画像を示します。
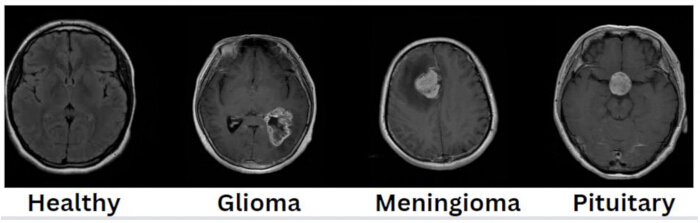
図2腫瘍型を含む脳腫瘍画像。 このデータセットには、正常な脳組織の画像4枚と、神経膠腫(グリオーマ)、髄膜腫、下垂体腫瘍の腫瘍画像3枚が含まれています。 この図の拡大版を表示するには、ここをクリックしてください。
提案モデル
前処理段階の後、次のステップは脳腫瘍の分類にのみ有効な学習モデルを提案することです。この目的のため、特に脳腫瘍の分類に適した効率的な学習モデルが提案されました。具体的には、DenseNet12131,32およびEfficientNetB73を含む、新規で効率的なハイブリッド特徴融合ベースの事前学習済みモデルが提案されています。これらのモデルを用いて画像から特徴を抽出し、さらに抽出された特徴を連結して、学習可能層および非学習可能層を含む異なる微調整済みハイパーパラメータに渡し、脳腫瘍を正確に診断します。これは、前述の関連セクションで議論した5つの異なる公開データセットで実装されました。さらに、DenseNet121モデルは2017年にGao Huangらによって開発され、121の層で構成されています。このモデルの主な目的は、特徴の再利用を最大化し、勾配消失問題を回避することに重点を置くことでした34。このモデルの層は高密度ブロック(dense blocks)に整理されており、各ブロックには特徴を抽出して学習する複数の畳み込み層が含まれています。各層は、それ以前のすべての層からの特徴マップを入力として受け取り、その出力はそれらの層の出力に接続され、同一ブロック内の後続の層にフィードフォワード方式で入力として渡されます。さらに、高密度ブロック間には遷移層が追加されており、各遷移層は1 × 1畳み込み層、BatchNormalization層、および2 × 2平均プーリング層で構成され、特徴マップを削減してモデルの複雑さを制御します。さらに、分類のためにグローバル平均プーリング層の前に、SoftMax活性化関数(AF)を備えた最終層が追加されます。DenseNet121モデルの基本設計を下のFigure 334に示します。
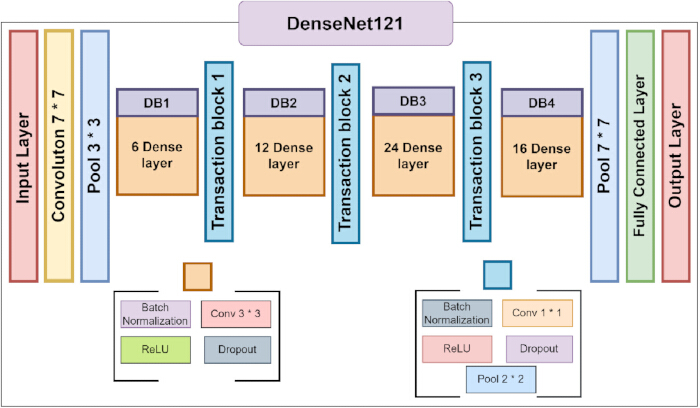
図3DenseNet121のアーキテクチャ詳細34. この図は、すべての高密度ブロック(dense block)および遷移ブロック(transition block)を含む、DenseNet121モデルのアーキテクチャの詳細を示しています。 この図の拡大版を表示するには、ここをクリックしてください。
さらに、EfficientNetB7モデルは2019年にTanとLeeによって考案されました。これはEfficientNetファミリーに属し、B0からB7までのバリエーションがあり、より少ないパラメータ数と処理能力で他を凌駕することを主目的としています。モデルの幅(層ごとのチャンネル数)、深さ(層の数)、および解像度はすべて、このモデルの核となる機能である複合スケーリング(compound scaling)を通じて微調整が可能です。さらに、このモデルはMBConv(mobile inverted bottleneck convolutional)ブロックで構成されています。MBConvブロックは、チャンネルを拡張する1 × 1畳み込み拡張層、各チャンネルに個別に畳み込みを適用する深度分離畳み込み(depthwise separable convolution)、およびチャンネル数を元に戻す1 × 1畳み込み投影層を備えています。さらに、各MBConvブロックは、チャンネルごとの特徴を再校正してネットワークが最も重要な特徴に集中できるようにするSqueeze and Excitation(SE)ブロック35で構成されています。さらに、シグモイド関数やその他の活性化関数(AF)の代わりにSwish関数が使用されています。Swish関数は負の値を許容することでReLUよりも優れた性能を発揮し、勾配の流れを改善します。また、分類目的のために、グローバル平均プーリング層の前にSoftMax AFを備えた最終出力層が追加されています。図 435にEfficientNetB7モデルの基本設計を、図 5に推奨されるモデルアーキテクチャを示します。
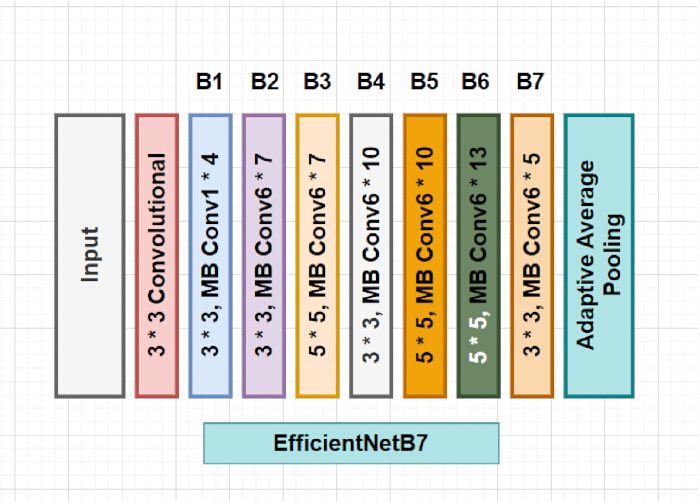
図 4EfficientNetB7のアーキテクチャ詳細35. この図は、すべてのモバイル逆ボトルネック畳み込みブロックを含む、EfficientNetB7モデルのアーキテクチャの詳細を示しています。 この図を拡大して表示するには、ここをクリックしてください。
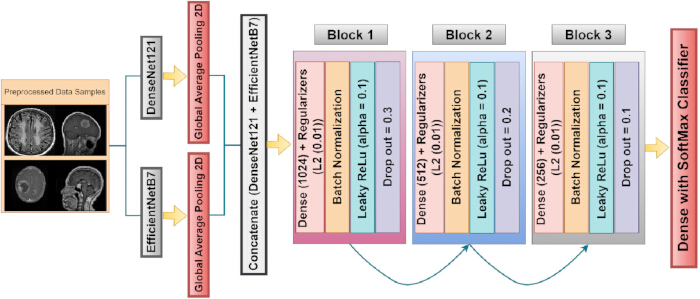
図5提案されたハイブリッド融合モデルアーキテクチャ。 提案されたアーキテクチャは、前処理済みの画像が特徴抽出器に渡される仕組みを示している。この特徴抽出器は、異なるハイパーパラメータを持つ3つのカスタマイズされたブロックと、それに続く出力層で構成されている。 こちらの図の拡大版を表示するには、ここをクリックしてください。
さらに、事前学習済みのDenseNet121およびEfficientNetB7モデルから、まず特徴量を抽出しました。事前学習済みモデルの更新された重みを学習済みモデルにロードし、モデルが再学習されるのを防ぐために、モデルの訓練不可能なベース層を凍結しました。これにより、モデルが過去の最適な知識を保持し、新たなデータサンプルに照らしてそれを適応させることで収束を改善し、追加の層の学習と高度な特徴量の抽出に集中させることができます。以下の式1および2に、DenseNet121およびEfficientNetB7モデルの動作を示します。
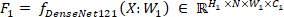 (1)
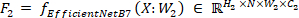 (2)
上記の式1および2は、特徴抽出に関する事前学習済みモデルの動作を示しています。F1は事前学習済みDenseNet121モデルによって生成された出力特徴マップを表し、F2は入力画像(Xで表記)に処理を適用することで事前学習済みEfficientNetB7モデルによって生成された出力特徴マップを表します。さらに、W1およびW2は、それぞれDenseNet121およびEfficientNetB7モデルの最初のブロックおよびレイヤーに関連付けられた学習可能なパラメータまたは重みです。また、∈ RN ×H1×W1×C1および∈ RN ×H2×W2×C2は、それぞれDenseNet121およびEfficientNetB7モデルの出力特徴マップの次元を表しており、その次元はH1 ×N×W1×C1およびH2 ×N×W2×C2となります。ここで、Nは画像のバッチサイズを表し、16として検討されました。さらに、H1×W1はDenseNet121モデルにおける画像の高さと幅をそれぞれ表し、H2×W2はEfficientNetB7モデルにおける画像の高さと幅を表し、24 × 24のサイズが選択されています。C1およびC2は、それぞれDenseNet121およびEfficientNetB7モデルのカラーチャネルを表します。EfficientNetB7から2560チャネル、DenseNet121から1024チャネルの出力特徴マップを得た後、グローバル平均プーリング2D36レイヤーを出力特徴マップに適用し、すべての空間次元の平均を単一のベクトルとして取ることで空間次元を削減します。これにより、解釈可能な特徴という観点から、より優れた特徴抽出とパターン認識のために次層へ渡すことが容易になります。
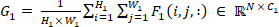 (3)
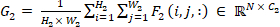 (4)
上記の式3および4は、それぞれDenseNet121およびEfficientNetB7モデルに適用されたグローバル平均プーリング2Dレイヤーの動作を示しており、ここで  および
 プールされた出力が単純な合計ではなく平均となるように、両モデルの全空間的な位置の数で合計を割ることで正規化する手順を示しています。
 および
 は、特徴マップの空間次元における総和を表し、一方で iおよび j これらは単に高さと幅をそれぞれ反復処理し、両方のモデルの特徴マップを合算するためのものです。さらに、 F1(i, 入力がありません。翻訳するテキストをご提示ください。, :) および F2(i, j, :) は、特定の空間位置における特徴マップの値を表します(i, 申し訳ございませんが、翻訳対象となるソーステキストが提供されておりません。「j」という一文字のみが入力されています。翻訳が必要な英文テキストをご提示ください。DenseNet121およびEfficientNetB7の両モデルにおいて、それぞれすべてのチャネルにわたって(適用されます)。このプーリング操作により、各画像における最も重要な特徴を保持しつつ、空間情報をよりコンパクトで正確な表現へと集約します。さらに、グローバル平均プーリング層の出力を連結して各サンプルの単一の特徴ベクトルを生成します。これは、異なるモデルからの特徴を融合させ、両モデルの強みを活用することで性能を向上させるためによく用いられる手法であり、その仕組みを式5に示します。
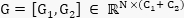 (5)
上記の式5は、2つの異なるモデルの特徴ベクトル [G1, G2] の結合手順を示しており、ここで G1 はDenseNet121モデルの特徴ベクトルを、G2 はEfficientNetB7モデルの特徴ベクトルを表します。結合された特徴ベクトルの形状は RN ×(C1+ C2) で表され、N は並行して処理されるサンプル数であるバッチサイズを、(C1+ C2) はモデル1および2から得られる特徴量の総数(約3584)を表し、これらは並行して処理されます。また、結合された出力特徴ベクトルは G で表されます。さらに、より複雑な特徴の抽出、汎化性能の向上、および過学習の防止を図り、より正確で効率的な結果を得るために、融合モデルを修正する3つの異なるブロックを追加しました。各ブロックは異なるニューロン数を持つ全結合層で構成されており、第1ブロックの全結合層は1024個のニューロンを持ち、広範囲の特徴やデータ内のより一般的なパターンを捉えることに重点を置いています。一方、第2ブロックの全結合層は512個のニューロンを持ち、次元を削減してより特定のパターンに焦点を当てることで、特徴を具体的に精緻化します。第3ブロックの全結合層は256個のニューロンを含み、最も関連性の高い特徴とパターンのみが出力層に伝わり、より適切なタスクを遂行できるように、特徴をさらに具体的に蒸留します。さらに、各ブロックのすべての全結合層にL2正則化37アプローチを追加し、大きな重みにペナルティを課すことで過学習を防止していますが、これによりモデルはより複雑になります。また、各ブロックの後にドロップアウト層38を導入し、ブロック1、2、3においてそれぞれニューロンの30%、20%、10%をランダムに無視させることで、単一のニューロンに依存しない、より堅牢な特徴をネットワークに開発させます。さらに、学習プロセスを安定させるために、各全結合層の後にBatchNormalization39層を適用し、活性化が安定した範囲内に留まるようにし、学習段階における勾配消失や勾配爆発などの問題の回避を支援します。加えて、このBatchNormalization層は、損失関数的に滑らかなランドスケープを形成することで学習プロセスを加速し、モデルの収束を早め、オプティマイザーがグローバルミニマムに到達しやすくしました。さらに、各ブロックにおいて非線性を生成するためにleaky ReLU活性化関数40を使用しており、これによりモデルは複雑なパターンを学習できます。leaky ReLUは他の活性化関数と比較して、負の入力に対してゼロではない小さな勾配を許容することで、ニューロンが不活性になることを防ぐという利点があります。さらに、以下の式6は、ハイブリッド融合モデルに統合された異なるブロックの動作を示しています。
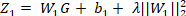 (6)
連結ベクトルを得た後、Gは1024個のニューロンを持つブロック1の全結合層(dense layer)に送られます。ここでは、重み行列W1が入力ベクトルGを1024次元の出力ベクトルに変換し、出力ベクトルの各要素は入力特徴量の線形結合となります。さらに、バイアスベクトルb1が出力の1024個の各要素に加えられることで、モデルは入力特徴量の出力を独立してシフトさせることが可能になります。また、L2正則化項 λ||W1||22によって大きな重みにペナルティを課し、モデルが単一のニューロンに過度に依存することを抑制することで、過学習を回避します。ここで、ニューラルネットワークにおける特定の層の重み行列をW1とし、||W1||22は重み行列W1のL2ノルムの2乗を表し、λは適用される正則化の度合いを制御する正則化パラメータであり、すべてのブロックで0.1に設定されています。連結ベクトルGから渡された入力に対して全結合層およびL2正則化を適用した後の新しい特徴表現をZ1とし、これは式6に示されています。
ブロック1の密層からの出力をZ1として得た後、学習プロセスを加速させるためにBatchNormalization層を適用しました。その仕組みを以下の式7に示します。
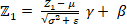 (7)
σ2はバッチ全体における最終層Z1の出力の分散を表し、μは出力Z1の平均であり、これは最初の全結合層の1024個の各ニューロンに対して個別に計算されます。一方、εは数値的安定性を確保し、ゼロ除算を防ぐために組み込まれた微小な定数です。正規化された出力は、学習可能なスケールパラメータγによってモデル側で調整でき、また学習可能なシフトパラメータβによって正規化出力をシフトさせることができます。最終的に、全結合層の出力にBatchNormalization層を適用することで、正規化出力Z1により、異なる層の間で活性化関数の分布が一貫し、トレーニングの安定化と高速化に寄与します。BatchNormalizationの後、正規化出力Z1はleaky ReLU活性化関数を通過し、ネットワークに非線形性を導入することで、データ内の複雑なパターンの学習を可能にします。ReLUや他の活性化関数ではなくleaky ReLUが選択されました。leaky ReLUはReLU関数の修正版であり、ReLU活性化関数のように負の値を0にするのではなく、小さな負の値も考慮することで「dying ReLU問題」を克服しています。その動作は、以下の式8に示されています。
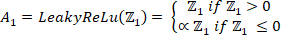 (8)
ここで、Z1はBatchNormalization層の出力であり、非線形処理を行うためにLeaky ReLUへの入力として渡されます。また、∝は関数の負の部分の傾きを決定するために使用される小さな定数です。さらに、A1は非線形処理を適用した後に得られる出力を示しています。最終的に、Leaky ReLu活性化関数から入力として受け取った出力A1にドロップアウト層が適用され、これは式9に示されています。
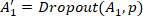 (9)
ここで、A1は最後のReLu活性化関数から受け取った元の活性化関数の出力であり、pはドロップアウト率である。ドロップアウト率は0から1の間で変動し、ニューロンの一部をドロップさせるため、3つのブロック層に対してそれぞれ0.3、0.2、0.1として選択された。さらに、A1′はドロップアウト層を適用した後の修正された出力を示し、ここでは一部のニューロンが0に設定されている。これを使用する主な利点は、共適応を抑制するとともに、過学習の問題を防止することである。さらに、ブロック1からの出力A1′は、より抽象的な特徴を抽出するために再び次のブロックに渡され、ブロック1と同じパラメータが適用される。ただし、密層のニューロン数が1024ではなく512であり、ドロップアウト率が0.3ではなく0.2であるという点を除き、その他の動作シーケンスは同一であり、これは以下の式10から13に記述されている。
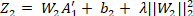 (10)
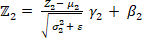 (11)
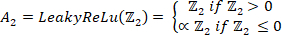 (12)
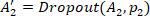 (13)
ブロック1から以下の出力を得た後、 A1′ これは、512個のニューロンを持つブロック2の密層(全結合層)に供給され、そこでは重み行列が W2 入力ベクトルを変換します A1′ 512次元の出力ベクトルに変換され、出力ベクトルの各要素は入力特徴量の線形結合となります。さらに、その b2 その後、バイアスベクトルが出力の512個の各要素に加えられ、これによりモデルは入力特徴量の出力を独立してシフトさせることができます。さらに、以下のL2正則化も適用されます:λ||W2||22 大きな重みにペナルティを課すことで、モデルがこの特定のブロック内の特定のニューロンに過度に依存することを防ぎ、過学習を抑制します。ここで、 W2 $W$はニューラルネットワークにおける特定の層の重み行列であり、$\lambda$は正則化の度合いを制御する正則化パラメータであり、ここでは0.1として適用されています。 Z2 式10に示すように、ブロック1から渡された入力に全結合層(dense layer)およびL2正則化を適用した後の新しい特徴表現となります。
さらに、トレーニングプロセスを加速させるため、新しい特徴量 Z2 にBatchNormalization層を適用しました。ここで、σ22 はバッチ全体の分散を、μ2 は出力 Z2 の平均を表します。また、ε は数値的安定性を確保するために組み込まれた小さな定数であり、γ はモデルが出力を調整できるようにする学習可能なスケールパラメータ、β はモデルが出力をシフトさせることを可能にする学習可能なシフトパラメータです。最終的に、式1に示すBatchNormalization層を適用した後、正規化された出力 Z2 はleaky ReLU AFを通過し、式12に示すネットワーク内の非線形性を生成しました。ここで、Z2 はBatchNormalization層の出力であり、非線形性を実行するための入力としてLeaky ReLUに渡されます。一方、A2 は非線形性を適用した後に得られる出力を示しています。
最後に、式13に示すように、Leaky ReLU活性化関数から入力として受け取った出力A2にドロップアウト層を適用します。ここで、A2は最後のReLU活性化関数から得られた出力であり、p2はニューロンの一部をドロップさせるためにこのブロックで0.2に設定されたドロップアウト率です。さらに、A2′はドロップアウト層を適用し、一部のニューロンが0に設定された後の修正済み出力を示しています。その後、ブロック2からの出力A2′は、より抽象的な特徴をさらに抽出するために再び第3ブロックに渡されます。第3ブロックでは、ブロック2と同様のパラメータが適用されますが、全結合層のニューロン数が512ではなく256であること、およびドロップアウト率が0.2ではなく0.1であるという点が異なります。その他の操作シーケンスは同一であり、以下に示す式14から17に記述されています。
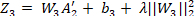 (14)
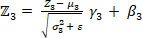 (15)
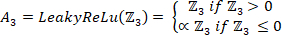 (16)
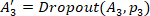 (17)
ブロック2から得られた出力A2′は、256個のニューロンを持つブロック3の全結合層(dense layer)に渡されます。ここで、重み行列W3が入力ベクトルA2′を256次元の出力ベクトルに変換し、出力ベクトルの各要素は入力特徴量の線形結合となります。さらに、バイアスベクトルb3が出力の256個の各要素に加えられ、これによりモデルは入力特徴量の出力を独立してシフトさせることができます。また、L2正則化も適用されており、λ||W3||22によって大きな重みにペナルティを課すことで、モデルが単一のニューロンに過度に依存することを抑制し、過学習を回避させます。ここで、W3はニューラルネットワーク内における特定層の重み行列であり、正則化の程度は正則化パラメータλによって制御され、ここでは0.01に設定されています。ブロック3から渡された入力に全結合層およびL2正則化を適用した後の新しい特徴表現がZ3となり、これは式14に示されています。
さらに、トレーニングプロセスを加速させるために、新しい特徴量Z3にBatchNormalization層を適用しました。ここで、σ32はバッチ全体の分散を表し、μ3は出力Z3の平均を示します。また、εは数値的安定性のために加えられる小さな定数です。正規化された出力は、学習可能なスケールパラメータγ3を用いてモデルによって調整され、学習可能なシフトパラメータβ3を用いてシフトされます。最終的に、式15に示されるBatchNormalization層を適用した後、正規化された出力Z3はleaky ReLU活性化関数を通過し、ネットワークに非線形性を導入します(式16を参照)。ここで、Z3はBatchNormalization層の出力であり、非線形性を実行するための入力としてLeaky ReLUに渡されます。一方、A3は非線形性を適用した後に得られる出力を示しています。
最後に、式17に示すように、Leaky ReLU活性化関数から入力として受け取った出力 A3 にドロップアウト層を適用します。ここで、A3 は最後のReLU活性化関数から得られた出力であり、p3 はドロップアウト率です。このブロックでは、一部のニューロンをドロップさせるため、ドロップアウト率に 0.1 を選択しました。さらに、A3′ はドロップアウト層を適用した後の修正後の出力を示しており、ここでは一部のニューロンが 0 に設定されています。
さらに、ブロック3 A3′からの出力は、分類のために最後の全結合層を通過します。この層のニューロン数 K は、データセットにおける実際のクラス数に相当し、以下の方程式18に記述されています。
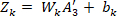 (18)
厚い層に連結された重み行列は、 Wk、256次元ベクトルを変換する役割を担う A3′ 〜の中へ k次元ベクトルであり、これは前のブロックから学習された特徴量を表し、出力として得られます。さらに、 bk バイアスベクトルを表し、入力がゼロのときでも活性化関数がゼロ以外の出力を出すように予測を調整し、 Zk は、活性化関数を適用する前の最終層の出力であり、各クラスに対するロジットを生成し、最後にSoftMax(ソフトマックス関数)を適用します。41 ロジットを変換する分類器が適用された Zk 各クラスの確率に変換され、これは式19および20に示されています。
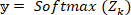 (19)
 (20)
i番目のクラスの予測確率をyiで表し、Kをクラス数、Zk, iをi番目のクラスのロジット、eZk, iをi番目のクラスのロジットの指数関数で表します。yはすべての可能なクラスの確率分布を示し、確率の総和が1になることを保証します。以下の表3に、再現性と性能向上のために採用したアーキテクチャの詳細を含む、提案するハイブリッドモデルの学習に使用したハイパーパラメータの詳細を示します。
| ハイパーパラメータ | 提案モデル (FusionNetX) |
| 画像サイズ | 224 × 224 |
| バックボーンアーキテクチャ | BBA1およびBBA2として、学習済みのEfficientNetB7およびDenseNet121を使用する |
| データ拡張 | 回転範囲 = 7, |
| 幅/高さ – シフト範囲 最大0.05 | |
| ズーム範囲を0.01まで上げ、 | |
| 水平/垂直反転 | |
| データ分割比率 | 層化抽出法を用い、random_state = 42に固定して、訓練データに80%、検証データに20%を割り当てる。 |
| 特徴抽出および統合 | 各バックボーンの出力に対してグローバル平均プーリングを適用し(BBA1は2560、BBA2は1024)、これらを融合させることで3584次元の結合特徴ベクトルを得ます。 |
| 全結合ブロックの構成 | 3つの全結合ブロックと1つの出力層で構成。各ブロックには、L2正則化(λ=0.01)、バッチ正規化(BatchNormalization)、LeakyReLU(α=0.01)、ドロップアウト(それぞれ0.3、0.2、0.1)、および隠れ層の次元(それぞれ1024、512、256)が含まれる。フュージョンヘッドにスキップ接続は導入していない。 |
| 活性化関数 | Leaky ReLU & ソフトマックス |
| オプティマイザーと学習率 | 学習率スケジューラを使用せず、0.001に固定したAdam。 |
| 損失関数 | スパースカテゴリカルクロスエントロピー |
| バッチサイズ | 16 |
| エポック | 各データセットにつき10エポックに固定 |
| 使用したプラットフォーム | TensorFlowおよびKerasプラットフォームを搭載し、P10 GPUと16GBのVRAMを備えたKaggle Notebook。 |
表 3:提案モデルの学習に使用したハイパーパラメータおよび提案するアーキテクチャの詳細。この表では、提案モデルの構造的・建築的な詳細とともに、微調整されたパラメータおよび実装環境を示します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
本セクションでは、Br35H、Figshare、Sartaj、Masoud、およびBalanced Brain tumorの5つの脳腫瘍オープンソースデータセットを用いて、提案するデュアル特徴融合モデルをテストした結果について詳述する。性能は、正解率42,43,4、誤分類率(MCR)45、陽性的中率(PPVとも呼ばれる)としての適合率46、陰性的中率(NPV)、感度または再現率として知られる真陽性率(TPR)47、特異度として知られる真陰性率(TNR)、F1スコア48、偽陰性率(FNR)、および偽陽性率(FPR)を含む、異なる統計的性能評価パラメータに関して評価を行う。以下の数式は、上述の性能評価パラメータを数学的に表したものである。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
結論として、提案モデルは次のように機能しました。まず、画像サイズは224 × 224に設定されました。これは、重要な情報をすべて保持しつつ、あらゆるディープラーニングモデルがデータサンプルから適切な特徴を抽出および学習するための適度なサイズです。さらに、データサンプルをより多様な方向に生成し、モデルが異なる平面や角度から特徴を抽出する上で重要な役割を果たすデータ拡張を実施しました。回転範囲は7%、幅と高さのシフト範囲は0.05、ズーム範囲は0.01に設定しました。また、水平および垂直方向の反転も適用し、データを異なる角度に移動およびズームさせました。加えて、バランスの取れたアプローチを確保するため、データセットをトレーニング用に80%、検証用に20%に分割し、シャッフルには固定の乱数シード(random_state = 42)を使用しました。次に、提案モデルに係数(λ)0.01のL2正則化を適用しました。これにより、トレーニング中の大きな重みにペナルティを課すことで過学習を防ぎ、汎化性能を高め、損失関数の平滑化と重み大きさの低減を実現しました。さらに、提案モデルの全3ブロックの全結合層(ニューロン数1024、512、256)に対し、それ...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者は開示すべき事項はなく、利益相反はありません。さらに、原稿および図の作成にAIツールは使用されていません。
謝辞
著者は、サウジアラビア王国リヤドのヌーラ・ビント・アブドゥルラマン王女大学の研究者支援プロジェクト(PNURSP2026R192)およびヌーラ・ビント・アブドゥルラマン王女大学による支援に感謝いたします。また、本研究に寄与した研究参加者および各機関に感謝申し上げます。
資金提供:
本研究は、韓国政府(MSIT)の資金提供による韓国研究財団(NRF)の助成金(No. RS-2023-00218176)および順天香大学研究基金の支援を受けて行われました。また、サウジアラビア王国リヤドのヌーラ・ビント・アブドゥルラフマン王女大学の研究者支援プロジェクト(PNURSP2026R192)による支援も受けています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Br35H 脳腫瘍データセット | Kaggle (データセット寄稿者) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | 公開データセット;バイナリ分類(腫瘍あり / なし) MRI画像 300枚 |
| Figshare 脳腫瘍データセット | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | 公開データセット;マルチクラス(神経膠腫、髄膜腫、下垂体腫瘍) MRI画像 3064枚 |
| Sartaj 脳腫瘍分類 MRI データセット | Kaggle (Sartaj Bhuvaji によるデータセット) | https://doi.org/10.34740/kaggle/dsv/12745533 | 公開データセット;マルチクラス(神経膠腫、髄膜腫、腫瘍なし、下垂体腫瘍) MRI画像 3264枚 |
| Masoud 脳腫瘍 MRI データセット | Kaggle (Masoud Nickparvar によるデータセット) | https://doi.org/10.34740/kaggle/dsv/14832123 | 公開データセット;マルチクラス(神経膠腫、髄膜腫、腫瘍なし、下垂体腫瘍) MRI画像 7023枚 |
| BBT-Dataset (脳腫瘍データセット) | Kaggle (データセット寄稿者) | https://doi.org/10.34740/kaggle/dsv/6758053 | 公開データセット;バランス調整済みマルチクラス脳腫瘍 MRI画像 5248枚 |
| Python | Python Software Foundation | https://www.python.org | プログラミング言語、バージョン 3.10.13 |
| TensorFlow / Keras | Google / TensorFlow 開発者 | https://www.tensorflow.org | ディープラーニングフレームワーク;モデルの構築、学習、および評価、バージョン 2.15.0 |
| EfficientNetB7 (学習済み) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | ImageNet 学習済みバックボーン;特徴抽出 |
| DenseNet121 (学習済み) | Keras Applications | https://keras.io/api/applications/densenet/ | ImageNet 学習済みバックボーン;特徴抽出 |
| scikit-learn | scikit-learn 開発者 (NumFOCUS) | https://scikit-learn.org | ラベルエンコーディング、訓練・テスト分割、評価指標(分類レポート、混同行列、ROC/AUC) |
| OpenCV (cv2) | OpenCV チーム | https://opencv.org | 画像の読み込みおよびリサイズ |
| NumPy | NumPy 開発者 (NumFOCUS) | https://numpy.org | 数値計算および配列操作 |
| pandas | pandas 開発チーム (NumFOCUS) | https://pandas.pydata.org | データの整理および指標の表作成 |
参考文献
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。