本記事では、清代の中国輸出絵画43点における女性の反復的な表現を調査するための、人間による監督付きコンピューターワークフローを提示します。コーパス内のパターンは、7つの人間による参照カテゴリーと反復的な視覚的手がかりによって特徴付けられますが、得られた知見は抽出された画像に限定されており、清代の社会的実態や歴史的な受容を測定するものではありません。
この記事について
サマリー
要約
本研究では、1757年から191年にかけて制作された清代中国の輸出絵画43点のコーパスを用い、女性のアイデンティと階級を示す視覚的記号の反復的な表現について調査した。ワークフローは、予備的なラベリングのためのCLIP ViT-B/32、Segment Anything Model (SAM)を用いた局所化、次元削減およびクラスタリング、そして2人の独立したコーダーによる手動の図像学的コーディングを組み合わせたものである。CLIPラベルは予備的な整理に使用され、SAMは局所化の補助として機能し、判定を経て確定した人間によるコーディングが参照カテゴリとして提供された。集計結果により、エリート/美人 (n = 12)、労働 (n = 72)、家事 (n = 64)、召使 (n = 58)、儀式/婚礼 (n = 45)、市場 (n = 43)、芸能 (n = 39) の7つの人間参照カテゴリが特定された。予備的な計算機ラベリングは、43点中356点(82.2%)の絵画で人間参照ラベルと一致し、カテゴリレベルの再現率は73.3%から88.4%の範囲であった。これらのカテゴリの視覚的プロファイルを特徴づけるために、衣服、空間設定、物体、姿勢、および描写された社会関係の反復的な組み合わせを用いた。433件のケースレベルのAI・人間ラベルペアを評価した結果、包括的なカテゴリレベルの適合率、再現率、F1スコアが得られ、あわせて分類パターンを詳述する混同行列が作成された。クラスター検証により、選択したクラスタリング手法が支持され、導出されたクラスターと人間が定義した参照カテゴリとの間の対応関係が実証された。全体として、衣服、空間設定、物体、姿勢、および社会関係の反復的な組み合わせは、サンプリングされたコーパス内にパターン化された絵画的タイポロジーが存在することを示している。これらの知見は、清代中国の輸出絵画における視覚的表現を特徴づけるものであるが、法的地位、実際の生活体験、市場需要、あるいは歴史的な国外での受容を直接的に測定したものとして解釈されるべきではない。
概要
清代の中国輸出絵画は、18世紀後半以降、広州やその他の収集拠点と欧米の買い手とを結ぶ商業的および文化的ネットワークの一部を構成していました1,2,3,4,5。商人、旅行者、外交官、宣教師、そしてコレクターたちは、これらの絵画を携帯可能な商品、土産物、視覚情報の源、さらには場所、職業、生産、風習、社会的な類型を表現するものとして入手しました。したがって、これらの絵画の流通は、中国の工房の慣行と外部市場の期待の両方を反映していました。
海外からの需要は、認識しやすい主題、連作形式、繰り返されるモチーフ、そして収集して比較できる場面を好みました。工房側は販売に合わせて媒体、規模、構図、主題を調整し、一方で買い手は、職業、儀式、室内、庭園、街路、そして絵画的な社会層の明快な描写を好む傾向にありました。広東の工房によるシーンの反復的なバリエーションは、絵師や助手が海外のパトロン向けにどのように図像や西洋の絵画的技法を適応させたかをさらに証明しています1,2,3,4,5。市場の需要が、何が生産され保存されるかに影響を与えた可能性がありますが、今回のコーパスは、個々の買い手の好みや反応を直接的に測定するものではありません。
したがって、これらの絵画は日常生活の包括的な記録ではなく、選択的かつ媒介された資料として捉えるべきである。描かれた場面は、工房の慣習、市場での選択、美術館による収集、カタログ化、およびデジタル化を通じて、社会的慣習を理想化、単純化、標準化、あるいは翻案している可能性がある1,2,3,4,5。歴史的な解釈においては、絵画の中で直接的に観察可能な特徴と、描かれた人物、制作条件、および後世の鑑賞者が作品に付与した意味に関する推論とを区別しなければならない。
女性の姿は、この区別を検討するための重点的な手段となります。衣服、髪型、姿勢、空間的設定、所持品、活動、および他の人物との関係性により、女性は、エリート/美、家庭的、奉仕的、労働的、市場的、演出的、そして儀礼的/婚礼的といったカテゴリーを含む、視覚的に繰り返し現れる役割に分類することができます。これらのカテゴリーは、絵画的パターンの分析的な記述であり、それ自体が法的な地位、富、職業、民族、BannerまたはHanへの帰属、道徳的性格、あるいは実生活におけるアイデンティを確定させるものではありません。
デジタル美術史学とコンピュータビジョンは、デジタル化された視覚コレクションの大規模な比較を促進すると同時に、計算モデルに組み込まれた前提条件の批判的な検討を可能にします6,7。視覚と言語のモデルは、繰り返し現れる視覚的モチーフの特定と整理に寄与しますが、現代のモデルの語彙を歴史的な非西洋の画像に適用する場合、文化的なバイアスが重要な制限となります8。中国の伝統絵画に関する同様の計算研究においても、定量的なパターン検出と歴史的知見に基づく解釈を組み合わせることの価値が示されています9。
本研究では、次の3つの問いに取り組む:(1) コーパスには、判定済みの人間によるコード付けに基づいたどの女性アイデンティ・カテゴリーが表現されているか? (2) 衣類、空間的設定、物体、姿勢、および社会的関係のどのような組み合わせが、これらのカテゴリーを特徴づけているか? (3) 全体的な完全一致精度(exact-match accuracy)およびカテゴリーレベルの再現率(recall)は、7つのカテゴリー間でどのように異なるか? 本ワークフローは、伝統的な中国絵画への計算論的アプローチ9を活用しているが、歴史的な主張は、サンプリングされた画像および記録された分析結果に限定している。
本研究の目的とする貢献は、歴史記述学的な側面と技術的な側面の双方にあります。コーパス規模での比較を行うことで、繰り返し現れる絵画的フォーミュラ(定型表現)を特定でき、その後、詳細な歴史分析を通じてそれらをコンテクスト化することが可能になります。このアプローチにより、画像の出現頻度を社会的な普及度の根拠としたり、視覚的な類似性を歴史的な同一性の証明としたりすることなく、ジェンダー、階級、日常生活の表現、および異文化間の接触に関する研究に知見を提供することができます。
プロトコル
研究デザインおよび解析単位
各絵画またはカタログレコードを1つの解析単位として扱った。メタデータのレビュー、予備的な計算機による整理、独立した手動コーディング、および美術史的解釈を組み合わせたコーパスベースの観察的デザインを採用した。研究期間は1757年から1911年と定義し、この期間内で組み入れ基準および除外基準を適用した。歴史的な美術品およびそれに関連するカタログメタデータの解析を行った。期間の長さが異なる日付間隔における分布を比較する場合、カウントを間隔の期間で正規化した。また、解釈においては、生存バイアスおよび収集バイアスの可能性を考慮した。
コーパスの構築と選定
候補となるレコードを、引用した博物館カタログ、デジタルアーカイブ、および出版済みカタログから抽出した。各候補レコードについて、機関名、タイトル、日付または期間、媒体、登録番号またはカタログ番号、安定したソースURL、取得日、および権利表記を保持した。対応する画像ファイルの法的再配布が不可能な場合でも、ソースリンクは保持した。報告されたスクリーニング手順では、まず612枚の候補画像から開始した。このうち、1757–191年の期間外であるか輸出絵画の伝統に該当しないため85枚を除外し、近代の複製画、不鮮明な記録、または被写体が不適切なため58枚を除外し、識別可能な女性像が欠けているか画像解像度が不十分なため29枚を除外し、メタデータが不十分なため7枚を除外した。最終的な分析コーパスは43件のレコードで構成された。
メタデータの標準化および画像の前処理
最終的な分析コーパスに含まれる各絵画には、QEP_001からQEP_433までの固定のQEP識別子が割り当てられた。所蔵機関、登録番号、作品名、制作日、媒体または材料、原産地、ソースリンク、および利用可能なカタログ説明を含む、関連する美術館のメタデータを保持した。視覚分析のために、暫定的なAIラベル、判定済みの人間によるカテゴリー、女性像の数、年齢層、姿勢、服装、空間的設定、関連オブジェクト、および社会的関係を記録した。各絵画は、「エリート/美」、「家庭」、「召使」、「労働」、「市場」、「芸能」、「儀式/婚礼」の7つの主要カテゴリーのいずれかに分類された。複数の女性像が含まれる場面では、視覚的な目立ちやすさと物語的な中心性に基づいて焦点となる人物を特定した。単一の女性像が支配的でない場合は、描かれている主要な活動と場面全体の文脈に基づいて主要カテゴリーを割り当てた。カテゴリーが重複する場合は、服装や外見のみよりも、描かれた活動と場面の文脈を優先して解決した。曖昧なケースについては、両方のコーダーが独立してレビューし、合意を通じて解決した。元の画像はJPEGまたはPNG形式で保存した。ウェブページの境界線、カタログのフレーム、または画像以外の余白のみをクロップした。描画内容は、再構成、再配色、強調、または修復を行わなかった。
CLIPベースの予備ラベル付け
画像とテキストの類似性の予備解析には、CLIP ViT-B/32画像エンコーダーを使用した9。アイデンティの候補用語には、エリート女性、家庭内女性、女性奉公人、働く女性、市場の女性、女性パフォーマー、花嫁、儀式を行う女性が含まれた。シーンの用語には、中国の室内、庭園、街の市場、作業場、茶の生産、繊維作業、儀式のシーンが含まれた。各画像について、プロンプトテンプレートの完全なセット、その順序、プロンプトのアンサンブル、テキスト正規化の手順、判定ルール、信頼度スコア、およびタイ(同点)の結果が保存された。
Python 3.10、PyTorch 2.0.1、およびOpenAI CLIPパッケージで実装されたOpenAI CLIP ViT-B/32モデルを用い、すべての画像に対して一貫して完全なプロンプトリストを適用した。推論は、CUDA対応GPUを使用し、バッチサイズ32、FP32精度で実行した。各画像は24 × 24ピクセルにリサイズおよびセンタークロップされ、ViT-B/32モデルに関連付けられた前処理変換を用いてRGBチャンネルを正規化した。テキストプロンプトは、上述のアイデンティおよびシーン記述子を用いて構築し、CLIPテキストエンコーダーでエンコードした。正規化された画像埋め込みとテキスト埋め込みの間でコサイン類似度を算出し、最も高い類似度スコアを示したプロンプトを暫定的なAIラベルとして割り当てた。後での人間によるレビューのため、すべての候補ラベルの類似度スコアを保持した。固定乱数シードとして42を使用し、同一の前処理手順、プロンプトテンプレート、および判定ルールを全43枚の絵画に適用した。
SAMを用いた局在化
人物、衣類、家具、道具、儀礼用具、および建築領域を人間の視覚的検査のために局在化させる目的で、Segment Anything Model (SAM)を厳格に利用した。SAMは分類パイプラインには関与していないことを強調しておく。SAMによるマスク、クロップ、および派生した特徴量は、CLIPによるラベル付けおよびクラスタリングプロセスから切り離されており、これによりSAMの適用が分類性能に影響を与えたり、それを誇張させたりすることなく、局在化の補助を提供したことが保証されている。
視覚的要素のローカライゼーションを精緻化するために、必要に応じて手動のポイントプロンプトまたはバウンディングボックスを適用した。女性の人物、衣服、家具、道具、儀式用具、および建築要素に対してSAMマスクを生成し、各セグメンテーション結果について適切な領域がカバーされているか視覚的に検査した。得られたマスクは、関連する図像学的特徴の特定および確認に活用したが、CLIPラベリングやカテゴリー割り当てには使用しなかった。
次元削減およびクラスタリング
CLIP画像埋め込みを算出し、コサイン距離を用いたUMAPにより2次元可視化を行った10。クラスタリングに使用した表現を、その前処理手順、次元数、および距離の定義とともに記録した。
コーパス内の再帰的な視覚的グループを特定するために、画像特徴表現に対してK-means法および階層的クラスタリングを適用した1。k = 5–9におけるK-meansの候補解を、シルエット係数およびDavies–Bouldin指数を用いて評価した。K-means++による初期化を用い、n_init = 10、max_iter = 30、tol = 1 × 10⁻4、random_state = 42とした。階層的クラスタリングは、平均リンク法とコサイン距離を用いた凝集型クラスタリングにより実施した。候補解を定量的な検証指標、クラスターの安定性、および美術史的な解釈可能性に基づいて比較し、再帰的な視覚パターンの最も一貫した表現が得られたものを最終的なクラスター解として選択した。得られた433枚の各絵画へのクラスター割り当てを保持し、後の人間によるコーディングカテゴリーとの比較に使用した。
手動コーディング、トレーニング、および判定
2名のコーダーが、主要カテゴリー、図像数、年齢層、姿勢、服装、空間的設定、物体、および社会的関係を網羅したバージョン管理済みのコードブックを用いて、全43枚の画像を独立してレビューした。判定前に、コーダーごとの記録を保持した。コーダーは美術史および視覚分析に関する適切な背景知識を有しており、標準化されたコーディングマニュアルと絵画コーパスからの代表的な例を用いてトレーニングを受けた。正式なコーディングに先立ち、7つのアイデンティカテゴリーと5つの視覚的手がかり次元の一貫した解釈を促進するため、30枚の絵画を用いたキャリブレーション演習を実施した。
正式なコーディングにおいて、2名のコーダーは、互いのコーディング決定、暫定的なAIラベル、およびクラスター割り当てについて盲検化された状態で、適格なすべての絵画を独立して評価した。コーダー間信頼性はCohenのカッパ係数を用いて評価された。主要なアイデンティカテゴリーにおける観測カッパ値は0.8であり、カテゴリー別の視覚的キュー変数は0.79から0.92の範囲にあり、コーダー間で強い一致が示された。不一致については、議論と合意を通じて解決し、判定後のカテゴリーおよび視覚的キューコードをその後の解析のために記録した12。判定前のラベルも保存された。
AIと人間の合致度および性能推定
判定済みの人間によるカテゴリーを基準とし、絵画1点につき1つの予備的なAIラベルを用いて記述的な比較を行った。全体の完全一致精度は356/43 (82.2%) と算出された。カテゴリー再現率は、AIと人間の完全一致数を、各カテゴリーにおける人間基準のサポート数で除して算出した。カテゴリーサポート数、完全一致数、不一致数、および対応する分母を明記して報告した。
AIと人間による43件のケースレベルのペアラベルに基づき、ターゲットクラスの偽陽性、カテゴリー別の適合率、再現率、およびF1スコアを算出した。また、対角線以外の分類パターンを分析するために完全な混同行列を作成し、これを不一致レビュー、エラー分類の文書化、および判定ルールの策定に活用した。
再現性パッケージおよび材料
計算ワークフローおよび支援研究材料は、バージョン管理されたリポジトリに整理されました。この再現性パッケージは、前処理、CLIP解析、SAM局在化、UMAP、クラスタリング、一致度解析、および図の生成のためのスクリプトに加え、マニュアルコーディング用のコードブック、設定ファイル、依存関係情報、ケースレベルの派生出力、および画像ソースと権利情報のマシン読み取り可能なインベントリを含むように設計されました。アーカイブされた研究材料には、再現性と再利用を容易にするために永続的識別子が割り当てられました。
メタデータの整理および管理にはMicrosoft Excel 2021を使用した。計算解析では、予備的な視覚言語ラベリングにCLIP ViT-B/32を、視覚要素の局在化にSAMを、次元削減にコサイン距離を用いたUMAPを、そして探索的なパターン解析にK-meansおよび階層的クラスタリングを使用した。クラスタリングの結果はシルエット係数とDavies–Bouldin指数を用いて評価し、コーダー間の合致度はCohen's kappaを用いて算出した。再現性を確保するため、ワークフロー全体で使用したソフトウェア環境、モデル構成、計算設定、および乱数シードを記録した。
結果
コーパスの構築と記述的構成
図1は、コーパスの4つのパネルによる概要を示している。図1Aは、612件の候補レコードから433件の保持レコードに至るまでの報告されたスクリーニングプロセスを示している。図1Bは、メディアおよびフォーマットの代表的な例を表示している。図1Cは、4つの日付間隔における件数を示し、図1Dは、コーパスのソースとメディアの構成をまとめたものである。日付間隔が不均等な期間にわたっているため、これらの件数はサンプリングされたコーパスの構成を記述するものであり、歴史的な生産率として解釈されるべきではない。
表 1にコーパスの集計特性をまとめる。博物館コレクションが302件、デジタルアーカイブが81件、出版されたカタログが50件であった。媒体は、輸出用水彩画(n = 176)、髄紙画(n = 112)、輸出用アルバムの頁(n = 83)、人物画(n = 41)、およびその他の形式(n = 21)に分類された。メタデータは、完全(n = 288)、部分的(n = 118)、または最小限(n = 27)に分類された。女性像は、中心的(n = 214)、副次的(n = 102)、または複数(n = 117)に分類された。各分類ブロックは、全433件のレコードで構成されている。
予備的なAIラベルと人間による参照カテゴリー
表2は、433枚の絵画における予備的なAI生成ラベルと人間による参照カテゴリーの集計一致度をまとめており、付録表1には、対応する症例レベルの予備的AIラベル、コーダーによる分類、判定後の人間による参照カテゴリー、一致状況、およびクラスター割り当てが記載されています。 全体として、AIと人間による参照ラベルは356枚の絵画で一致し、完全一致精度は82.2%でした。カテゴリーレベルの再現率は、各カテゴリーにおける人間による参照サポートに対するAIと人間の完全一致の割合として算出しました。
カテゴリーレベルの再現率は、儀式・結婚式の場面の 73.3% (33/45) から、エリート・美容の 88.4% (99/112) の範囲でした。再現率は、労働の 84.7% (61/72)、演技の 82.1% (32/39)、家事の 79.7% (51/64)、奉仕者の 79.3% (46/58)、および市場の 79.1% (34/43) でした。全体として、完全一致率は 356/433 (82.2%) でした。ケースレベルのペアを評価することにより、全 7 カテゴリーにおける適合率と F1 スコアを算出することができ、適合率は 74.5% から 89.2%、F1 スコアは 0.75 から 0.88 の範囲となりました。ターゲットクラスの偽陽性と非対角パターンの詳細を示す包括的な混同行列を Supplementary Figure 1 に示します。
報告された計算パターンの概要
図2は、報告された4つの計算解析ディスプレイを示している。図2Aは、視覚的な局在化と確認に使用されるカラーセグメンテーションオーバーレイを適用した9枚の絵画のギャラリーである。図2Bは、報告されたCLIP画像埋め込みのUMAP散布図であり、C1–C7のラベルが付いた密度等高線が示されている。図2Cは、報告された絵画数(塗りつぶしの点)とカテゴリーレベルの再現率(白抜き円)を比較しており、図2Dは、同じラベルに基づいてグループ化された代表的な絵画のギャラリーを示している。クラスター検証により、選択されたクラスタリング解が支持され、シルエットスコア0.54およびDavies–Bouldin指数0.92が得られた。クラスターと人間によるカテゴリーのマッピングは強い整合性を示し、導出された各クラスターは、主に個別の人間基準カテゴリーに対応していた。
表3に、7つのヒト基準カテゴリーの根拠に対応するサンプルサイズを持つ、報告された7つの計算プロファイルを示します。カテゴリー別クラスターの分割表は付録表2に提供されており、判定された7つのヒト基準カテゴリーのクラスターC1~C7における分布が示されています。これらのケースレベルのクラスター割り当てを分析した結果、計算によるクラスター化によって、7つのヒト基準カテゴリーと密接に対応する視覚的構造が回収されたことが実証されました。
視覚的手がかりの関連性と解釈的統合
表4に、人間によるコーディングに基づいた7つのカテゴリーを特徴付けるために使用した、定性的な視覚的手がかりのプロファイルをまとめます。これらのプロファイルは、服装、空間的設定、姿勢、物体、および社会関係の間で見られる反復的な関連性を記述したものです。これらは定量的なクロス集計から導出されたものではないため、法的地位、民族性、社会的因果関係、または観客の受け止め方を立証するものではありません。
図3 コード化された視覚的特徴の記述的・定量的要約を、解釈的な概念モデルと統合する。 図 3A 判定された7つのヒト参照カテゴリーおよびそれぞれのサンプルサイズを示します。 図3B これらのカテゴリーと、衣服、空間的設定、物体、姿勢、社会関係という5つの次元にわたるコード化された視覚的マーカーとの間の相対的な関連性を示しています。表示されている関連性の強さは、各ヒューマンリファレンスカテゴリー内のケースレベルのアノテーションから算出されました。 図3C コード化された観察結果から導き出された加重フローを用いて、人間参照カテゴリー、視覚的標識次元、およびクラス含意アーキタイプの間の関係を要約する。これらの定量的な関係は、サンプリングされた絵画における反復的な表象パターンを特徴付けるものであり、歴史的な人口統計学的または社会的な分布の推定値として解釈されるべきではない。 図3D 概念的な異文化間解釈モデルを提示しており、実証的に検証された因果経路ではなく、歴史的知見に基づいた解釈的枠組みとして理解されるべきである。
視覚的パターンの統合的解釈
コーパス全体を通じて、7つの女性のアイデンティティ・カテゴリーは、服装、空間的設定、物体、姿勢、および社会的関係の繰り返し現れる組み合わせによって特徴付けられていた。これらの組み合わせは、サンプリングされた絵画内における定型的な視覚的慣習の記述的な根拠となった。ジェンダー、階層、および異文化間の媒介に関する歴史的解釈は、推論的なままであった。
総合的に見て、集計結果から7つの人間基準の女性アイデンティティカテゴリーと、それらを特徴付けるために用いられる5つの共通次元(衣服、空間的設定、物体、姿勢、社会的関係)が特定されました。予備的なAIラベルは、433枚の絵画のうち356枚(82.2%)において判定済みの人間カテゴリーと一致し、カテゴリーレベルで最も低い再現率は儀式/婚礼シーン(73.3%)で観察されました。これらの知見は、コーパスの記述的な整理と比較を支持するものでした。ケースレベルのAI・人間ラベルにより、カテゴリーレベルの適合率およびF1値の推定が可能となりました。また、別途行ったクラスター分析により、7つの人間基準カテゴリーに対応する構造が特定されました。それにもかかわらず、これらの計算上の知見は視覚的表現の慣習を特徴付けるものであり、歴史的な社会的現実や観客の受容に関する因果関係を立証するものではありません。
データの可用性:
メタデータ、ソース情報、およびスクリーニング記録を含む本研究を支持するデータは、Zenodo(https://doi.org/10.5281/zenodo.21130291)を通じて利用可能です。
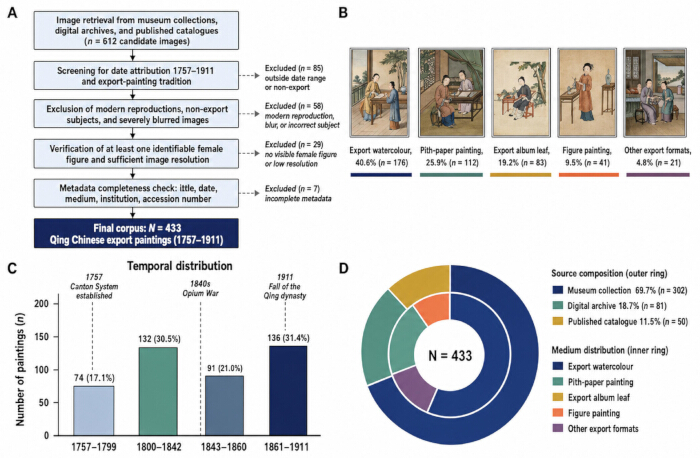
図 1: 433点の絵画サンプルにおけるコーパス構築と記述的構成。 (A) 612点の候補画像の逐次スクリーニングにより、適格な絵画433点が選出された。除外基準は、研究期間外または輸出画の伝統に属さない絵画 (n = 85)、近代の複製画、ぼやけた画像、または主題が不適切なもの (n = 58)、特定可能な女性像がない画像または解像度が不十分なもの (n = 29)、およびメタデータが不十分な記録 (n = 7) であった。 (B) 5つのメディアおよびフォーマットの代表例:輸出水彩画 (40.6%, n = 176)、pith-paper painting (25.9%, n = 112)、輸出アルバムリーフ (19.2%, n = 83)、人物画 (9.5%, n = 41)、およびその他の輸出フォーマット (4.8%, n = 21)。 (C) 4つの年代区分におけるサンプル絵画の分布。 (D) コレクションソース (外輪) とメディア/フォーマット (内輪) の分布。パーセンテージは全サンプル (N = 433) に基づき、小数点第1位まで四捨五入している。 こちらのリンクをクリックして、この図の拡大版を表示してください。
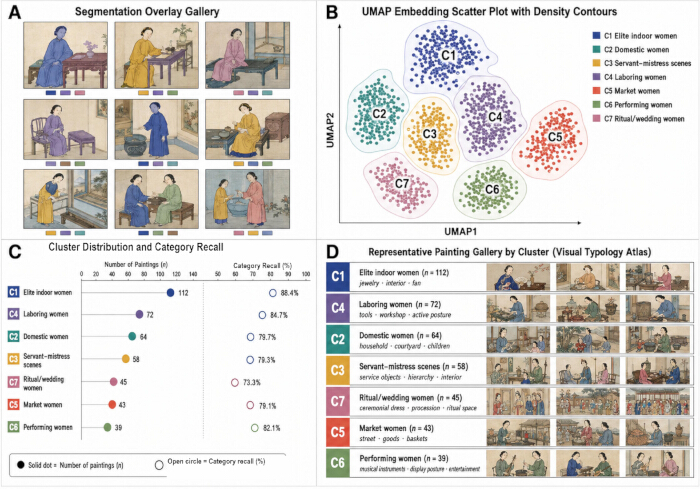
図2報告されたセグメンテーション、埋め込みの可視化、クラスター分布、カテゴリー再現率、および代表的な絵画。 (Aレビュー用に、図または視覚的要素を局所化するために使用された、色付きセグメンテーションオーバーレイを伴う9枚の絵画のギャラリー。B) 密度等高線およびラベルC1–C7を付した、報告されたCLIP画像埋め込みのUMAP散布図。(C) 絵画の報告数(塗りつぶし円、上軸)とカテゴリー想起率(白抜き円、下軸)。カテゴリー想起率は、完全一致数を人間によるリファレンスサポート数で除して算出している。信頼区間およびエラーバーは表示していない。(DC1~C7のラベルでグループ化された代表的な絵画のギャラリー。画像は、それぞれのクラスター重心への近接性に基づいて選択されている。略語:AI = 人工知能、CLIP = Contrastive Language–Image Pre-training、SAM = Segment Anything Model、UMAP = Uniform Manifold Approximation and Projection、C1~C7 = 報告されたラベル1~7。 この図の拡大版を表示するには、ここをクリックしてください。
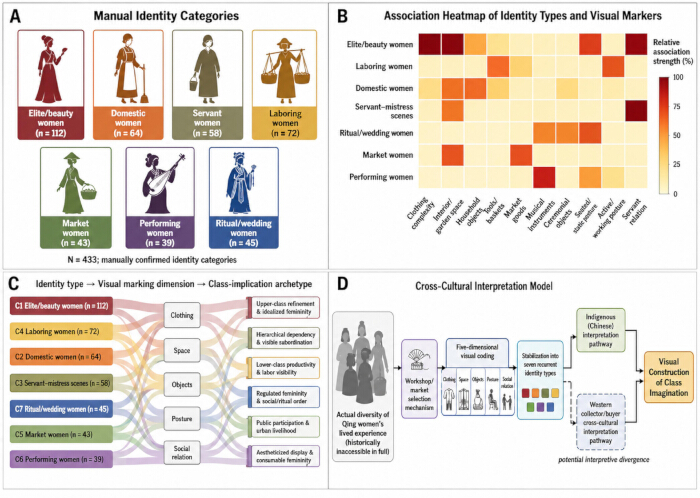
Figure 3: 視覚的手がかりの関連性と異文化解釈フレームワーク。(A) 433点の絵画コーパスにおける、裁定された7つの人間参照女性アイデンティティカテゴリーとそのサンプルサイズ。(B) 7つの人間参照カテゴリーと、服装、空間的設定、物体、姿勢、社会的関係にわたるコード化された視覚的マーカーとの間の関係性の相対的な強さを示す関連性ヒートマップ。関連性の強さは、各カテゴリー内のケースレベルの注釈から導出されたもの。(C) コード化された観察に基づき、人間参照カテゴリー、視覚的マーキング次元、および階級暗示アーキタイプの間の加重関係をまとめたアリュビアル図。(D) 描写された活動、工房および市場の選択、5次元の視覚的コーディング、繰り返し現れるアイデンティティタイプ、および潜在的な解釈経路を連携させた概念的な異文化解釈モデル。こちらのリンクをクリックして、この図の拡大版を表示してください。
表1:コーパスの特性およびメタデータの完全性 (N = 433)。 数値とパーセンテージは、日付間隔、ソース、媒体または形式、メタデータの完全性、女性像の表現、およびシーンタイプの6つの独立したブロックにまとめられている。各ブロックの分母は N = 433 であり、合計は433となる。パーセンテージはブロック内のコーパス比率であり、小数点第1位まで四捨五入している。こちらのリンクからファイルをダウンロードしてください。
表2:予備的なAIラベルと人間による参照カテゴリー(N = 433)。 Supportは、各人間参照カテゴリーに割り当てられた絵画の数を示します。Exact matchesは、予備的なAI生成ラベルが人間による参照カテゴリーと一致した絵画を示します。カテゴリーレベルの再現率は、完全一致数(exact matches)を人間参照のsupport数で除して算出されます。こちらをクリックしてファイルをダウンロードしてください。
表3:報告された計算プロファイルの概要。C1–C7は、検証済みのプロファイルサイズと主要なラベルを再現している。症例レベルのクラスター割り当てと、クラスター別カテゴリーの分割表を統合することで、教師なしクラスタリングが7つの人間基準カテゴリーに対応する視覚的構造を効果的に捉えたことが確認された。こちらをクリックしてファイルをダウンロードしてください。
表4:女性のアイデンティティカテゴリーと階級に関連する視覚的手がかりの定性的プロファイル。 数とパーセンテージは人間によるリファレンスカテゴリーを要約したものであり、衣服、空間、物体、姿勢、および社会的関係は、各カテゴリーに関連して繰り返し現れる視覚的プロファイルを特徴づけている。階級に関する解釈は、歴史的な社会的地位を直接測定したものではなく、絵画的パターンの図像学的読解を表している。こちらのリンクからファイルをダウンロードしてください。
付随図1:433枚の絵画コーパスにおける、予備的なAIラベルと判定済みの人間リファレンス カテゴリを比較した混同行列。行は判定済みの人間リファレンス カテゴリ(正解ラベル)を、列は予備的なCLIP生成カテゴリ(予測ラベル)を表す。セルの値は、各AI-人間ラベルの組み合わせにおける絵画の数を示す。対角線上のセルはAIと人間の完全一致を表し、対応するカテゴリレベルの再現率がパーセンテージで示されている。対角線外のセルは、予備的なAI分類と判定済みの人間リファレンス カテゴリとの不一致を表す。全体の完全一致精度は82.2%(356/433)であった。 こちらをクリックしてファイルをダウンロードしてください。
付随表1:予備的なAIラベル、判定済みの人間リファレンス カテゴリ、およびUMAPクラスター割り当ての症例レベルでの比較。 各行は、解析コーパスに含まれる433点の清代中国輸出絵画の1点を表している。本表には、安定したQEP画像識別子、予備的なCLIP ViT-B/32ラベル、人間コーダー1および人間コーダー2による独立した分類、判定済みの人間リファレンス カテゴリ、AIと人間の整合ステータス、およびUMAPクラスター割り当てを記載している。「Exact Match」は、予備的なAIラベルと判定済みの人間リファレンス カテゴリが一致していることを示し、「Mismatch」は不一致であることを示す。判定済みの人間カテゴリは、AIと人間の整合性分析におけるリファレンス分類として使用された。こちらのリンクをクリックしてファイルをダウンロードしてください。
補足表2:人間によるリファレンス分類と計算上のクラスター割り当ての分割表。行は判定された7つの人間リファレンスカテゴリーを表し、列は計算上のクラスター解析から得られたクラスターC1–C7を表します。セルの値は、各カテゴリーとクラスターの組み合わせに割り当てられた絵画の数を示しています。合計サポート数は、各人間リファレンスカテゴリーに含まれる絵画の数です。カテゴリーとクラスターの組み合わせにおける観察結果の集中度は、独立して導出された計算上のクラスターと判定された人間リファレンスカテゴリーとの対応に関する記述的な評価を提供します。こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
提供された集計サマリーにおいて、433件のレコードが7つの人間基準カテゴリに整理され、5つの視覚的ヒント・ファミリーを通じて記述されました。最大カテゴリは「エリート/美(Elite/beauty)」であり(112/43件)、356件の予備ラベルが報告された人間基準と一致しました(82.2%)。これらはコーパスの観察結果です。これらは、反復的な図像公式の研究を支持するものですが、それらの公式が清代の社会を忠実に再現していた、あるいは海外の観客に特定の反応を引き起こしたという、より強い主張を支持するものではありません13。
規範的なジェンダー言説、家庭内での地位、労働、および清朝の法律は、女性の生活を画一的に決定づけることなく、その在り方を形作っていました。盛清期の女性に関する研究では、家族や貞節に関する規範的な体制と並行して、労働、執筆、儀礼、宗教、および娯楽への参加が記録されています。八旗は法律と行政実務によって定義された世襲的かつ多民族的なステータスグループであり、したがって八旗への所属を自動的に満州族という民族性と同一視すべきではありません14,15,16,17。本研究において、服装、姿勢、所持品、および設定は、法的な階級、八旗か漢人かという帰属、民族性、道徳的適合性、あるいは実体としてのアイデンティティを示す証拠ではなく、絵画的な手がかりとして扱っています。それらの主張を行うには、アーカイブ資料や法的根拠が必要となります。
計算による知見には、文化的な配慮と技術的な抑制も必要である。汎用的な視覚言語モデルが文化的に中立であると想定すべきではない。発表されているCulturalVQAの結果では、地域や文化的側面によって性能にばらつきがあることが示されているが、そのベンチマークではCLIP ViT-B/32の評価は行われておらず、東アジアの歴史美術も使用されていない8,18,19。したがって、このコーパスを用いたケースマッチング・ベンチマークの実施は、代替されるのではなく、むしろ必要とされる。そのような実験結果が得られるまで、CLIPは清朝のアイデンティや階層に関する権威ではなく、予備的な整理補助手段として位置づけられる。計算パイプラインにより、SAMが厳格に補助的な局在化エビデンスとして機能したことが確認された。ラベル付けやクラスタリングの入力にマスクやマスク由来の特徴量は一切使用されておらず、視覚的な分類がセグメンテーションされていない画像のグローバルな意味論的埋め込みのみに基づいていることが保証されている。また、デジタル遺産研究においては、文化的感度、学際的な監視、アクセシビリティ、データ保護、および透明性のあるワークフローが強調されている20。
歴史的に見れば、これらのパターンの重要性は輸出絵画貿易にあります。中国の工房と海外の需要によって、持ち運び可能で理解しやすく、収集価値のある主題が選別され、規格化されました。また、工房で繰り返し描かれた図像は、単なる機械的な複製ではなく、変奏を伴う模写が行われていたことを示しています1,2,3,4,5。したがって、このコーパスは、どのような定型表現が大規模に繰り返されているかを示すことで、ジェンダー、階級、日常生活のイメージ、そして異文化間接触の歴史に寄与することができます。ただし、これらの図像が包括的な民族誌的記録であることを示すものではありません。計算機による比較は、精読や異文化的な文脈化の指針となりますが21、市場の意図や観客にとっての意味に関する主張には、制作記録、購入履歴、および受容の証拠に基づいた根拠が必要です。
感情的および認知的反応は、本研究の結果ではなく、今後の研究方向として残されています。Shiらは、好みの評価、潜在次元分析、およびアイトラッキングを組み合わせて、夏至ピンプリックランタン画に対する反応における感情的、形式美学的、および認知的な経路を区別しました2。同様の設計を用いることで、輸出絵画における衣服、物体、姿勢、または階層に対する視聴者の注目度の違いを検証できる可能性があります。本研究では評価、アイトラッキング、またはその他の観客データを収集していないため、画像コンテンツのみから感情的な覚醒、視覚的顕著性、または受容を推論することはできません。
制限事項は、理論的、方法論的、および実践的なものである。理論的には、物質的な手がかりのカテゴリーは、ジェンダー、家庭内関係、法的階級、民族性、および生活体験を単純化している。方法論的には、推論は、生存、収集、デジタル化、メタデータ、ゼロショットモデル、コーディング、および不均一な期間のバイアスによって制約される。分析パイプラインは堅牢なパターン検出を示すが、これらの構造的なバイアスは、計算結果を清時代の社会実態を映し出す透明な窓としてではなく、絵画的な慣習の分析として扱う必要性を強調している。実践面では、画像の権利が再配布を制限しており、知見が機関、時代、メディア、または計算環境を越えて一般化できない可能性がある。これらの制限があるものの、本研究は、繰り返される視覚的観察を自動的な結論ではなく、検証可能な歴史的問いに変換するための、人間が監視するフレームワークを提供する。介入研究ではなく解釈研究であるため、持続可能な開発目標(SDG)または指標への進捗は評価していない。それにもかかわらず、その主題は目標5に関連しており、権利を考慮したドキュメント化および異文化間教育的なフレーミングは、ターゲット1.4および4.7と概念的に一致しているが、SDGの成果は測定されていない。提供された再現性パッケージは、透明性の高いデジタル遺産ワークフローへの最近の要求や、永続的識別子、豊富なメタデータ、ライセンス、来歴、および再利用可能なデータ、アルゴリズム、ツール、ワークフローに関するFAIR原則の要件に準拠している20,23
開示事項
著者らに開示すべき事項はありません。
謝辞
著者は、コーパスの探索においてオンライン記録を提供したヴィクトリア・アンド・アルバート博物館、大英博物館、メトロポリタン美術館、スミソニアン国立アジア美術館、ピーボディ・エセックス博物館、香港美術館、大英図書館、ゲッティ研究所、およびその他の所蔵機関およびカタログ作成チームに感謝いたします。オンライン記録へのアクセスは、その画像の再配布許可を意味するものではありません。そのため、パネルレベルの権利およびソースリンクは別途記載しています。また、CLIPおよびSAMをサポートしているオープンリサーチコミュニティ、ならびにマカオシティ大学および広東理工師範大学からの事務的支援に感謝いたします。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | 予備的な画像–テキスト類似性分析および予備的なAIラベルの割り当てに使用される視覚言語モデル。 |
| 計算ワークステーション | Authors’ computational workstation | CUDA有効GPU;正確なハードウェア構成を報告すること | CLIPおよびSAMの推論および計算分析に使用されるワークステーション。元の実行環境からGPU、CPU、RAM、オペレーティングシステム、およびCUDAの仕様を報告する必要がある。 |
| Matplotlib | Matplotlib development team | Pythonパッケージ;正確なバージョンを報告すること | 計算による可視化、および分析図やプロットの作成に使用。 |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | メタデータの整理、スクリーニング記録、および表形式の研究データの管理に使用。 |
| NumPy | NumPy developers | Pythonパッケージ;正確なバージョンを報告すること | 数値計算、および画像特徴量や分析配列の操作に使用。 |
| pandas | pandas development team | Pythonパッケージ;正確なバージョンを報告すること | 構造化データの処理、メタデータ処理、およびケースレベルの分析出力の整理に使用。 |
| Python 3.10 | Python Software Foundation | Python 3.10 | 計算画像分析ワークフローの実装に使用されるプログラミング環境。 |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | CLIPベースの画像およびテキストエンコーディング、およびGPU推論を実行するために使用されるディープラーニングフレームワーク。 |
| scikit-learn | scikit-learn developers | Pythonパッケージ;正確なバージョンを報告すること | K-meansクラスタリング、凝集型クラスタリング、シルエット係数、Davies–Bouldin指数、およびCohen’s kappaの計算に使用。 |
| Segment Anything Model (SAM) | Meta AI Research | SAM | 視覚的検査のために、女性の人物、衣類、家具、道具、儀式用具、および建築領域を局在化させるために使用されるセグメンテーションモデル。 |
| umap-learn | McInnes et al. | UMAP Python implementation | コサイン距離を用いたCLIP画像埋め込みの次元削減および二次元可視化に使用。 |
参考文献
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.