本プロトコルでは、英中翻訳およびサイトトランスレーション(視覚翻訳)における認知努力の観察可能な相関物と、修正の機能的有効性を評価するために、マルチモーダルな行動記録を統合します。具体的には、キーストロークログ、スクリーンキャプチャ、音声分析、トランスクリプトに基づくコーディング、および標準化された品質評価を組み合わせて使用します。
この記事について
サマリー
要約
本記事では、英中筆記翻訳およびサイトトランスレーション( sight interpreting)における認知努力と戦略的修正の観察可能な相関関係を調査するための、マルチモーダルな行動プロトコルを提示します。筆記翻訳ではキーストロークログと画面録画を同期させ、サイトトランスレーションでは音声録音と逐語的な文字起こしを使用します。修正および自己修正エピソードは、全体的な出力品質の評価とは独立して、タイプ別および機能的な結果(有効、中立、または有害)別にコーディングされます。初心者グループと訓練済みグループに割り当てられた62名の参加者による実証では、両グループがカウンターバランスさせた順序で2つのタスク条件を完了しました。訓練済みの参加者は、筆記翻訳(20.1 ± 2.1 vs. 16.8 ± 2.3)およびサイトトランスレーション(18.9 ± 2.4 vs. 15.4 ± 2.6)において平均出力品質スコアが高く、有効な修正または自己修正の割合も高い結果となりました。ポーズ、削除、開始潜時、および修正密度は間接的でありタスクに依存するため、単一の構成概念の直接的な指標としてではなく、トライアンギュレーションを必要とする行動的な相関関係として解釈されます。本プロトコルは制御された説明文を対象としていますが、入力方法の処理、ポーズの閾値、テキストの比較可能性、およびスコアリング手順を再調整することで、他の言語ペアにも適応させることが可能です。
概要
英中筆記翻訳とサイトトランスレーション(視読翻訳)には、ソーステキストの理解、言語間転移、およびターゲット言語での定式化が必要ですが、それぞれ課されるタスク条件は異なります。筆記翻訳では、再読や後からの編集が可能である一方、サイトトランスレーションでは、より厳しい時間的制約の下での口頭での産出が求められます。認知負荷、処理困難度、および認知努力は関連していますが、互換性のない概念です。負荷はタスクの要求量に関するものであるのに対し、努力はそれらの要求の下で参加者が投入するリソースに関するものです。認知努力は潜在的かつ多次元的であるため、本研究では、レイテンシ(反応遅延)、ポーズ、脱落、および修正密度を、プランニング、モニタリング、運動プロセス、または困難さを反映し得る行動上の相関物として扱い、努力の直接的な測定値としてではなく、総合的に解釈する必要があります1,2,3,4,5,6,7,8.
プロセス指向の研究では、成果物のスコアと時間的に整合した行動記録を組み合わせることで、翻訳上の意思決定がいつ、どのように行われるかを特定します。キーストローク・ロギングは、作成および修正のシーケンスを把握する上で有用ですが、中国語の入力メソッドによる変換プロセスのため、物理的なキー入力イベントと確定された文字が切り離されることがあります。そのため、可視的なテキストの状態を再構成するには、同期させた画面録画が必要となります9,10,11。ポーズ(休止)の閾値は、普遍的な認知境界ではなく分析上の選択であり、閾値を短く設定することで、ポーズに基づく結論が大きく変わる可能性があります8,12。したがって、本プロトコルでは、明示的な同期確認、閾値の感度分析、およびタスク固有の指標と共通指標の分離が必要となります。
修正回数だけでは、モニタリングが出力を向上させたかどうかを判断することはできません。記述的な修正や口頭での自己修正は、語彙の選択、構文、意味、またはスタイルを対象とする場合がありますが、その機能的な結果は、元の意味および直前のターゲットセグメントと照らし合わせて判断されなければなりません。英語・中国語および中国語・英語の処理に関するサイト・インタープレッティング(視覚通訳)の研究では、トレーニング、方向性、眼球と音声の協調、および言語特有の問題トリガーがパフォーマンスパターンを変化させることが示されています13,14,15,16。このような理由から、エピソードの種類、エピソードの結果、最終的な成果物の品質、およびデリバリーに関連する行動は、それぞれ独立した変数としてコーディングされます。
本プロトコルは、制御されたコンピュータベースのセッションにおいて、短く専門性のない解説文を扱う成人学習者または訓練を受けた翻訳者・通訳者を対象に設計されています。書き言葉の産出においてキーストロークと画面記録をキャプチャでき、話し言葉の産出において高品質な音声を録音できる場合に最も適しています。この枠組みは他の言語ペアにも適応可能ですが、テキストのマッチング、情報単位へのセグメンテーション、キーボードまたは入力メソッドの動作、ポーズの閾値、および評価基準(レーティングアンカー)については、各言語ペアおよび表記体系ごとに再検証する必要があります17。本デモンストレーションでは、テキストの長さ、制限時間、出力モード、および修正の機会も異なるため、すべての差異をモダリティのみに起因するものとするのではなく、タスク条件の比較を行っています。
プロトコル
ヒト被験者を伴うすべての手法は、機関のガイドラインに従って実施され、桂林情報科技学院の人権研究倫理委員会の明確な承認を得て行われました(承認番号:UYHAJ2025899)。すべての参加者から、参加前に書面によるインフォームド・コンセントを得ています。本研究で使用した装置およびソフトウェアの包括的なリストについては、材料表をご参照ください。
1. 参加者の募集およびグループ分け
- 英語または翻訳専攻の学生およびプロの通訳訓練生からなる62名の参加者を募集する。すべての参加者が中国語を母国語とし、視覚および聴覚が正常であるか、または矯正により正常であることを確認する。
- 体系的な翻訳訓練の経験が12か月未満の参加者を初学者グループに、12か月以上の参加者を熟練者グループに割り当てる。すべての参加者について、事前の翻訳およびサイトトランスレーション( sight-interpreting)の実務経験を個別に報告する。
- タスク割り当て前に参加者のスクリーニングを行い、ソーステキストへの接触歴がある者、矯正不能な感覚障害がある者、または標準的な中国語入力メソッドを使用できない者を除外する。
- 禁止されている外部ツールの使用、不完全な遂行、ファイルの破損、または音声の不備など、あらかじめ規定された理由がある場合にのみ、録音後にタスクを除外する。
- 個人を特定できる情報を含まないタスク除外ログを保持する。最終的な解析サンプル数を、本文および図1A–Dにおいて一貫して報告する。
2. 材料の選択およびパイロット評価
- 一般的な学術、教育、社会、またはパブリックコミュニケーションの分野から、英語の短い解説文を選定する。翻訳テキストは約180~220語、サイトインタープリテーション(視覚翻訳)テキストは約120~160語のものを使用する。
- タスク条件間で、テキストの長さ、語彙の難易度、構文の複雑さ、情報密度、およびトピックの親しみやすさを一致させるか、統計的に調整する。
- 3名のバイリンガルの専門家に、語彙の難易度、構文の複雑さ、情報密度、トピックの親しみやすさ、および転移の適切性を1~5点の尺度(1 = 非常に低い、5 = 非常に高い)で独立して評価させる。
- 平均評価値について、95%信頼区間を伴う二元変量ランダム効果内クラス相関係数(ICC)を算出する。一致度が低い(ICC < 0.75)項目は修正する。
- 標準化されたマッチング変数が±10%の許容範囲内に収まるテキストペアのみを保持する。
- 情報単位を、独立してスコア付け可能な1つの概念、関係、または出来事を表現する、ソーステキストの最小の命題と定義する。タスク実施前に、境界に関する不一致を解決しておく。
- 本解析に含まれない参加者を対象に、指示内容、入力方法、同期、音質、および制限時間のパイロットテストを行う。完了時間の分布と、各制限時間に達した割合を記録する。
- パイロット参加者が天井効果または床効果を示した場合、あるいは持続的な曖昧さや記録の不安定さが見られた場合は、テキストまたは制限時間を修正する。本研究を開始する前に、すべての変更点を記録する。
3. タスクの実施および記録のセットアップ
- 標準化されたハードウェアおよびソフトウェア構成を用い、静穏で遮音された部屋で被験者を個別にテストする。
- 標準化された指示スクリプトを読み上げ、実験用ではない練習問題を1問提供する。辞書、検索エンジン、生成AI、機械翻訳、および外部コーパスの使用は禁止とする。
- 各トレーニンググループ内で2つのタスク順序(筆訳先か、サイトトランスレーション先か)をカウンターバランスさせ、5分間の休憩時間を設ける。
- 被験者の募集完了前に割り当てリストを作成し、適格性が確認されるまで割り当てを秘匿する。複数のソーステキストを使用する場合は、タスク順序とは独立してテキストの同一性をカウンターバランスさせ、分析用にテキストID変数を保持する。
- 英語のソーステキストを継続的に提示し、指定の入力フィールドに正確で自然な中国語訳を作成するよう被験者に指示する。編集は制限なく許可するが、外部テキストの貼り付けは厳格に禁止する。
- パイロットテストで設定した20分の制限時間を適用する。ただし、カウントダウン時計は表示せず、制限時間に達したかどうかを記録する。
- キーストローク・ロギング・ソフトウェアと継続的な画面録画を同期させ、筆訳プロセスのすべてを継続的にキャプチャする。後の行動抽出のため、最終的な翻訳出力とタイムスタンプ付きのログファイルを保存する。
- サイトトランスレーションのソーステキストを画面に提示し、書き留めることなく口頭で中国語訳を開始するよう被験者に指示する。
- 6分の制限時間を一貫して適用し、この制限時間に達したかどうかを記録する。時間制限による終了か、通常通り完了したかを区別する。
- デジタルオーディオキャプチャソフトウェアを用いて口頭出力を録音する。後のコーディングを容易にするため、これらの録音から厳密な逐語録を作成する。
4. 行動プロセスの指標の抽出
- ログファイルから筆記タスクの行動相関データを抽出し、初期潜時を刺激提示から最初の中国語文字が確定されるまでの間隔と定義する。
- タスク総時間、ポーズの回数と持続時間、削除率、修正密度、および産出率を抽出する。生のタイムスタンプおよび、各正規化指標に使用した正確な分母を保持する。
- 筆記ポーズの操作的閾値を2 sとする。カーソル移動、テキスト選択、または入力メソッドの候補選択中のポーズが含まれているかどうかを報告する。
- 波形データと検証済み書き起こしから口頭タスクの行動相関データを抽出し、開始潜時を刺激提示からターゲット言語による最初の意味のある発話までの間隔と定義する。
- 吸気、咳払い、および放棄された非語彙的な音を開始潜時から除外する。通訳総時間、無音ポーズ、充填ポーズ、反復、言い淀み(false starts)、自己修正、および発話速度を抽出する。
- 口頭の無音ポーズを、発話内の1.0 s以上の無音状態と定義する。波形データと検証済み書き起こしに照らしてポーズの境界を確認し、発話内ポーズのカウントから冒頭および末尾の無音部分を除外する。
- 実施したすべてのタスクについて品質管理記録を作成する。該当するプロセスファイルが読み取り可能で完全であるか、書き起こしが検証済みであるか、およびコーディングが完了または裁定済みであるかを記録する。元の記録を保存し、修正内容はすべて監査証跡で追跡する。
5. 戦略的修正および口頭セルフリペアのコーディング
- キーストロークログ、画面録画、および最終テキストを照合し、各書き換え修正を再構成する。
- 同一の対象セグメントに向けられた編集操作の連続を1つのエピソードとして扱い、別の箇所で編集が再開されてから少なくとも 2 s 経過した場合、または別のセグメントが編集された場合にエピソードを終了させる。
注意:中国語入力の場合、確定前の構成変更と、確定後の対象テキストの削除を区別し、後者のみをテキスト修正としてコーディングする。 - 意味的、統語的、語彙的、または様式的な変更に基づき、1つの主要な修正タイプを割り当てる。重複する場合は二次的なタグを許可するが、排他的なカウントには主要タグを使用する。補足資料 1に提供されている演習例を適用する。
- 口頭での自己修正をコーディングする前に、タイムスタンプ付きの逐語的書き起こしを作成する。最初の書き起こし担当者に対し、語彙内容、フィラー、繰り返し、言い出し直しの失敗(false starts)、中断、および判別不能な箇所をマークするように指示する。
- 訓練を受けた第2のレビュー担当者が、オーディオと照らして書き起こし内容を確認し、元のオーディオタイムスタンプを維持したまま不一致を解消する。
- 口頭での自己修正を、直前の対象言語セグメントを置換、補完、または修正する顕在的な再定式化と定義する。沈黙のみから潜在的なモニタリングを推論してはならない。口頭での自己修正に対しても、語彙的、統語的、意味的、および様式的な判断ルールを同様に適用する。
- 修正を伴わない完全な繰り返しを非流暢性(disfluency)として、新しい構成に続く放棄された開始を「言い出し直しの失敗+修正」として、また顕在的な再定式化を伴わない脱落や誤訳を出力エラーとしてコーディングする。
- オーディオが不明瞭な場合、または2つのカテゴリーが等しく妥当である場合は、そのエピソードを「曖昧」としてマークする。曖昧なエピソードには暫定的なタグを保持し、信頼性分析の前に裁定を行う。
- エピソード前後の対象セグメントを、ソースの情報単位および局所的な対象コンテキストと比較して、機能的な結果を判定する。この判定は、最終的なホリスティックスコアを明らかにする前に行う。ホリスティックスコアの変化を効果の定義として使用してはならない。
- 両グループおよびタスク順序から選択された出力の少なくとも 20%をダブルコーディングし、裁定前に独立したコードに基づいて信頼性を算出する。
- 評価者間一致度が Cohen’s kappa 0.80 を下回った場合は、再訓練および再コーディングを行う。この正確な閾値と、講じたあらゆる是正措置を記録する。
6. 品質評価および統計モデリング
- 各最終翻訳文およびサイト・インタープレテーション(視覚翻訳)の成果物を、Supplementary File 1の25点満点の分析ルーブリックを用いてスコア付けする。
- 規定のアンカーに基づき、正確性、完全性、語彙の適切性、一貫性、および目標言語の自然さを0から5まで評価する。グループ分けを確認した後に、スコアリング基準を恣意的に調整してはならない。
- サイト・インタープレテーションの評価項目については、音声と検証済みトランスクリプトの両方を使用するよう評価者に指示する。ポーズ(休止)および非流暢性の指標は、ルーブリックのスコアとは別に分析する。
- コードブックと少なくとも10件の練習用アウトプットを用いて、2名の独立した評価者をトレーニングする。その際、参加者のグループおよびタスクの順序は評価者に伏せる(ブラインド化する)。
- 独立したスコアリングおよびエピソードのコーディング後、協議を行う前に信頼性を算出する。不一致は合意によって解決し、合意に至らない場合にのみ3人目の評価者に相談する。
- 平均化された連続的な品質スコアについては、二元配置変量効果モデルによる絶対一致のクラス内相関係数を報告する。主要なカテゴリ的修正コードについてはCohenのkappaを、有効/中立/有害な結果コードについては別途kappaを報告する。二重コーディングされたエピソードの正確な数と割合を記載する。
- 分析前に、各プロセスファイルが読み取り可能で完全であることを確認し、記述タスクのログを対応するスクリーンレコードと照合し、トランスクリプトを音声と照合して検証する。
- 照合の失敗、明瞭性の問題、および修正措置を品質管理ログに記録する。頻度指標の正規化は、ポーズ頻度についてはソーステキストの情報単位100件あたり、記述修正密度については生成された中国語文字100字あたりとして行う。
- 機能的な結果(outcome)は、最終的なホリスティック品質スコアとは独立してコーディングする。修正後のセグメントが新たな問題を引き起こすことなくテキストを改善した場合は「有効(effective)」、実質的な変更がなかった場合は「中立(neutral)」、誤りを導入した場合は「有害(detrimental)」としてエピソードをコーディングする。
- 有効率を、「有効なエピソード数 ÷ 分類可能な全エピソード数」として算出する。なお、分母から曖昧なエピソードは除外する。
- 本デモンストレーションを探索的な反復測定データセットとして分析する。タスク条件、トレーニンググループ、ポーズ指標、修正密度、有効率、非流暢性負担、および発話速度を用いて、合計品質スコアを予測する固定効果モデルを指定する。
- 参加者のランダム切片を含める。また、設計に十分な独立サンプリング済みのテキストが含まれている場合にのみ、ソーステキストのランダム効果を含める。
- 連続予測変数を中心化し、残差を検査し、共線性を確認する。推定方法、ソフトウェアのバージョン、β、SE、95% CI、正確なp値、分散成分、AIC、BIC、および周辺/条件付きR2を報告する。分析は探索的であると記述し、確定的・因果的な主張は避ける。
- 匿名化されたデータ、辞書、コードブック、ルーブリック、ソフトウェアの詳細、スクリプト、および出力を含む、再現可能な分析パッケージをエクスポートする。公開前に、すべての図および表の値が、指定された変数および分析ステップまで追跡可能であることを確認する。
結果
参加者のベースライン特性およびデータの可用性
アンケートには62名の参加者(初心者31名、訓練済み者31名)が含まれ、タスクシートには124件の記録があり、参加者1名につき2件のタスク記録が完了したことが示された(表1)。初心者グループは、体系的な翻訳訓練の期間が12か月未満(観察された最大値は8.6か月)であったのに対し、訓練済みグループは少なくとも12か月(観察された最小値は13.3か月)であった。年齢、性別、英語学習期間、習熟度、およびタスク順序の分布は、グループ間で同様であった。図1に最終的な分析サンプルを示し、タスク固有のデータを明確に区別している。キーストロークログと画面録画は筆記翻訳に適用され、音声および逐語録はサイト・インタープリティング(視覚翻訳)に適用され、品質評価はその両方に適用される。
タスク条件ごとの行動プロファイル
行動プロファイルは、2つのタスク条件間およびトレーニング群間で異なっていました(表2;図2A–E)。筆記翻訳では完了時間がより長く、平均ポーズ時間も長かったのに対し、サイト・インタープレッティング(視覚翻訳)では、報告されたしきい値以下の100情報単位あたりのポーズ回数がより多くなりました。各タスク条件において、トレーニングを受けた群はタスクをより速く完了し、平均出力スコアが高くなりました。これらの対比は、テキストの長さ、制限時間、出力モード、および修正機会も異なっていたため、純粋なモダリティ効果として解釈されるべきではありません。ポーズは一様に妨げとなるわけではありません。ポーズは、未解決の困難、計画の成功、モニタリング、または入力方法に起因する活動を反映している可能性があるため、ポーズの測定値は、修正、デリバリー、および品質の測定値とともに解釈されます。
戦略的修正、自己修復、および予測モデリング
コーディングフレームワークでは、エピソードの種類と機能的な結果を分離して定義しました(表3、図3A–D)。訓練を受けた参加者は、初心者よりも書字による修正エピソードが多く生成されました(1タスクあたり 12.4 ± 3.7 vs. 8.9 ± 3.0)。一方で、口頭による自己修正の総数については、グループ間で有意な差は見られませんでした(1タスクあたり 4.9 ± 1.6 vs. 4.4 ± 1.5)。それにもかかわらず、訓練群は両方のタスクにおいて、有効なエピソードの割合が高い結果となりました。表4に報告されている混合効果の要約は、因果関係ではなく関連性を示すものです。そのため、図3Eでは、因果関係図ではなく、報告された固定効果の推定値と信頼区間を表示しています。
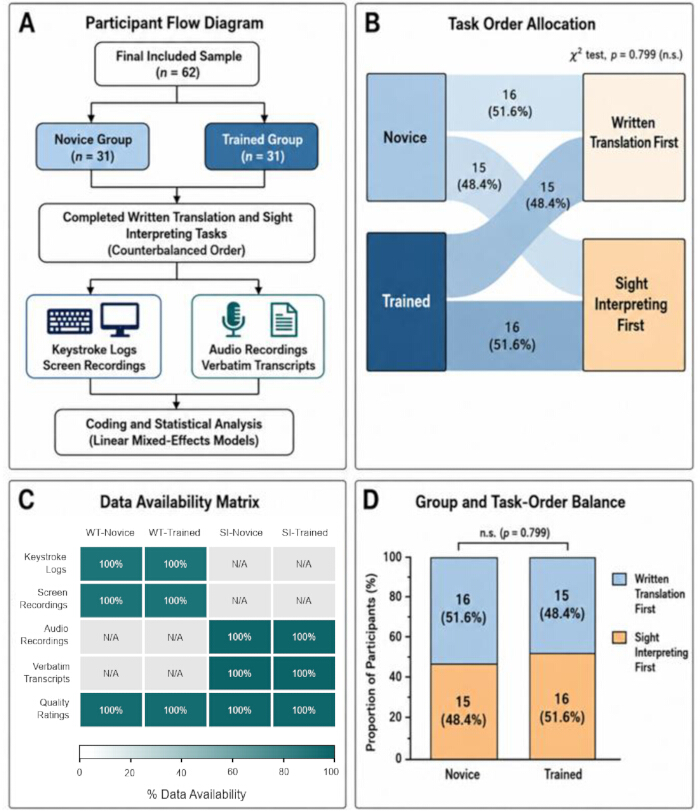
図 1: 参加者のフロー、タスク順序の割り当て、およびタスク別データの可用性。(A) 最終的に分析された62名の参加者と124件のタスク記録のサンプル。(B) 初心者群および訓練群内でのカウンターバランスを用いたタスク順序の割り当て。(C) 可用性マトリクス。キーストロークログと画面録画は筆訳のみに、音声録音と逐字起こしは視訳のみに、品質評価は両タスクに適用される。(D) 群と順序のバランス(カイ二乗検定、p = 0.799)。n = 62名(各群31名)。この図の拡大版を表示するには、ここをクリックしてください。
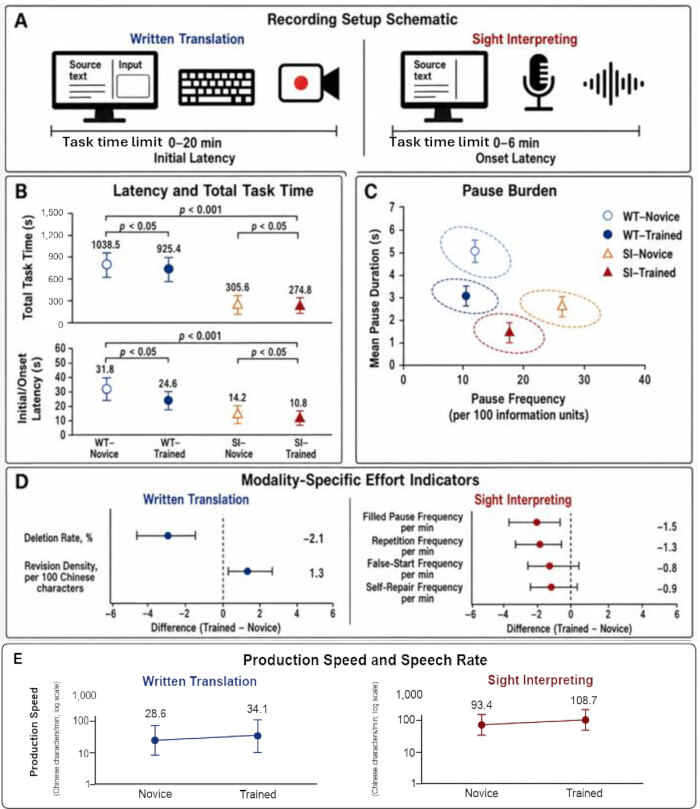
図 2: 筆記翻訳とサイトトランスレーションのタスク条件における行動プロファイル。(A>) タスク固有の記録セットアップ。(B>) 初回/開始潜時および総タスク時間。(C>) ポーズ頻度と平均ポーズ時間の共同分布。(D>) タスク固有の削除、修正、および口頭流暢性指標。(E>) 筆記産出率と口頭発話率。パネルB、C、Eにおいて、点とエラーバーは群平均 ± SDを示し、パネルDにおいて、点は熟練者と初心者の平均差、エラーバーは95%信頼区間を示す。n = 各群 31 名。パネルEのy軸は対数スケールで表示されている。こちらのリンクから本図の拡大版をご覧いただけます。
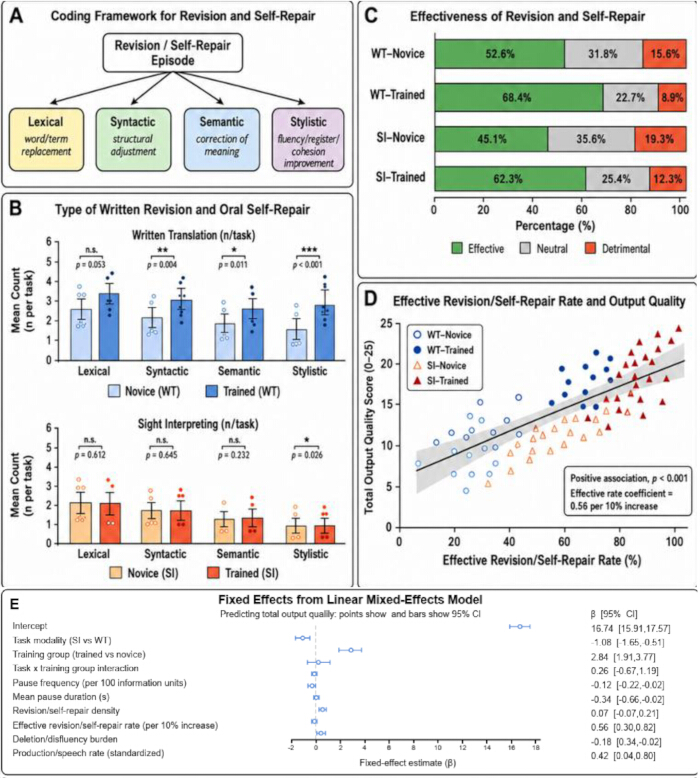
図3修正/自己修復コーディング、機能的成果、および出力品質の関連性。 (Aエピソードタイプおよび機能的転帰を独立して割り当てるための決定フレームワーク。B) 各タスク条件下における、語彙的、統語的、意味的、および文体的なエピソードの平均回数。 (C) 有効なエピソード、中立的なエピソード、および有害なエピソードの平均割合。 (D) 有効エピソード率と総出力品質スコアの記述的関連。 (E線形混合効果モデルによる固定効果を95%信頼区間とともに示すフォレストプロット(詳細は以下に記載) 表4); このプロットは相関関係を示すものであり、因果パスモデルを表すものではありません。 この図の拡大版を表示するには、ここをクリックしてください。
| 変数 | 初心者グループ(n = 31) | トレーニング群(n = 31) | p 値 |
| 年齢(歳) | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| 女性, n (%) | 22 (71.0) | 21 (67.7) | 0.779 |
| 英語学習期間(年) | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| 英語能力スコア | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| 翻訳トレーニング期間(月) | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| トレーニング期間の解釈(月数) | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| 事前の翻訳実務経験 5タスク以上、n (%) | 9 (29.0) | 24 (77.4) | <0.001 |
| 事前の視覚的解釈練習 5タスク以上、n (%) | 5 (16.1) | 20 (64.5) | <0.001 |
| 記述翻訳(まずに)、n (%) | 16 (51.6) | 15 (48.4) | 0.799 |
| 初診時の視力判定、n (%) | 15 (48.4) | 16 (51.6) | 0.799 |
表1:グループ別の参加者特性およびベースラインの言語トレーニングプロファイル。 変数は、連続データについては平均値 ± 標準偏差として、カテゴリーデータについては件数(パーセンテージ)として提示されている。記載されたp値は、ベースラインの人口統計学的バランスを検証し、意図したトレーニング期間の差異を確認するためのグループ間比較を反映している。
| 変数 | 記述翻訳 初心者 (n = 31) | トレーニング済み群 (n = 31) | 逐次通訳 初心者 (n = 31) | 視訳トレーニング済み群(n = 31) | タスク効果 p | 群効果 p |
| 初期/潜時, s | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| 総タスク時間(秒) | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| 100情報単位あたりのポーズ頻度 | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| 平均休止時間、s | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| 産出率/発話速度、漢字/分 | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| 欠損率 (%) | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| 修正密度(中国語100文字あたり) | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| 充填休止頻度(1分間あたり) | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| 繰り返し周波数(回/分) | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| 誤スタート頻度(回/分) | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| 自己修復頻度(/分) | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| 総合品質スコア、0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| 精度、0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| 完全性、0~5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| 語彙の適切性、0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| コヒーレンス、0~5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| ターゲット言語の自然さ、0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
表2:タスク条件およびグループ別の行動プロセス指標と出力品質。数値は平均値 ± 標準偏差で示されている。報告されたp値は、各プロセスおよび品質変数に対するタスク形式(筆記翻訳 vs. 視覚翻訳)およびトレーニング背景(初心者 vs. 訓練済み)の主効果を示す。
| 変数 | 筆記翻訳 初心者 | 筆記翻訳 熟練者 | p値 | サイトトランスレーション 初心者 | サイトトランスレーション 熟練者 | p値 |
| 語彙的修正/自己修正, n/タスク | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| 統語的修正/自己修正, n/タスク | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| 意味的修正/自己修正, n/タスク | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| 文体的修正/自己修正, n/タスク | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| 総修正/自己修正回数, n/タスク | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| 有効なエピソード, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| 中立的なエピソード, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| 有害なエピソード, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
表3:タスク条件別の書き換え修正および口頭自己修正のタイプと有効性。エピソードタイプはタスクあたりの平均回数(±標準偏差)として報告され、機能的結果は平均パーセンテージ(±標準偏差)として報告されている。p値は、各タスク様式内におけるグループ間差異の有意性を示す。
| 固定効果 | β | SE | 95%信頼区間 | p 値 |
| インターセプト | 16.74 | 0.42 | 15.91から17.57まで | <0.001 |
| タスク様式:サイト・インタープリティング(視覚翻訳)対 文書翻訳 | -1.08 | 0.29 | -1.65から-0.51 | <0.001 |
| トレーニング群:訓練済み vs 初心者 | 2.84 | 0.47 | 1.91から3.77 | <0.001 |
| タスクモダリティ × トレーニンググループ | 0.26 | 0.47 | -0.67 ~ 1.19 | 0.581 |
| ポーズ頻度(情報単位100個あたり) | -0.12 | 0.05 | -0.22から-0.02 | 0.018 |
| 平均休止時間、s | -0.34 | 0.16 | -0.66から-0.02 | 0.041 |
| 修正/自己修復密度 | 0.07 | 0.07 | -0.07から0.21 | 0.334 |
| 10%増加あたりの有効修正/自己修復率 | 0.56 | 0.13 | 0.30から0.82 | <0.001 |
| 削除/非流暢性の負荷 | -0.18 | 0.08 | -0.34 ~ -0.02 | 0.027 |
| 標準化発話速度 | 0.42 | 0.19 | 0.04~0.80 | 0.032 |
表4:総出力品質を予測する線形混合効果モデルから報告された固定効果。この要約では、指定されたすべてのタスクおよび行動予測因子について、非標準化係数(β)、標準誤差(SE)、95%信頼区間(CI)、および正確なp値を詳細に示しています。
ディスカッション
本研究では、英中筆記翻訳およびサイトトランスレーション(視覚翻訳)における、観察可能なプロセス指標の測定と戦略的な修正のコーディングに関するマルチモーダル・プロトコルを提示します。このプロトコルは、単一の認知努力変数を直接測定するものではありません。その代わりに、レイテンシ、ポーズ、削除、および修正パターンを、同期された記録および出力品質の根拠とのトライアンギュレーション(多角的な検証)によって意味が定まる、タスク依存的な行動相関として解釈します1,2,3,4,5,6,7,8。また、これら2つのタスクは、素材、タイミング、出力形式、および修正の機会において異なります。したがって、代表的な対比は、単一のモダリティによる効果ではなく、タスク条件による差異を記述するものです。主な分析上の寄与は、修正頻度と機能的な結果を分離したことにあります。報告された要約において、訓練を受けた参加者は、筆記による修正をより多く(少なくではなく)行いましたが、口頭での自己修正の総回数については、グループ間で有意な差は見られませんでした。効果的なエピソードの割合が高いことは、単純な頻度よりも品質のモニタリングの方がより有益である可能性を示唆していますが、この解釈は、透明性のある判定基準、独立した結果コーディング、および報告された信頼性に依存しています。補足資料 1のコードブックと具体例は、この区別を宣伝目的ではなく、再現可能なものにするために作成されています。
重要なステップは、レコード間の整合、オーディオ品質、トランスクリプトの検証、およびコーディングの一貫性です。ログと録音データを整合させる際は、利用可能なタイムスタンプおよびタスク境界のキューを確認する必要があります。書き起こしの前に、オーディオにクリッピングがないか、および明瞭であるかを確認し、提案されたポーズ境界は波形とトランスクリプトと照らし合わせて検証しなければなりません。中国語入力の場合、変換中のキーストロークを確定文字の修正と同一視してはいけません。これらのチェック内容および修正措置は、品質管理ログに記録して保持する必要があります。
解釈にはいくつかの制限がある。本実証では、学生および研修生のコホート、短文の一般的な解説文、異なるタスク量と制限時間、および便宜的サンプリングに基づいたサンプルを用いている。また、タスク条件は出力モードおよび修正機会において異なっており、データセットにはテキストレベルの変動を推定するための独立してサンプリングされたソーステキスト識別子が含まれていない。さらに、ポーズ(休止)の閾値は操作上の選択であり、長いポーズは生産的な計画立案と未解決の困難の両方を反映している可能性がある。専門家、専門領域、他の言語ペア、または他の表記体系への一般化には、素材、入力方法の処理、閾値、およびスコアリングアンカーの再検証が必要である。
今後の研究では、行動記録をアイトラッキング、瞳孔計測、または主観的なワークロード指標と組み合わせることで、どの休止や修正が注意、経験した努力、あるいは計画の成功に対応しているかを検証することが可能です5,6,13,14,15,16。Shreveらは視覚翻訳においてアイトラッキングを用いており、瞳孔計測研究として引用すべきではありません18。瞳孔計測については、Seeberによって直接的に論じられています5。このようなマルチモーダルな拡張においては、タスク要求、投入された努力、観察された行動、およびパフォーマンスを区別して保持すべきです。したがって、本プロトコルは、その指標が潜在的な認知努力に関する主張を裏付けるものの、それ自体で立証するものではない、透明性の高いプロセス評価フレームワークとして使用するのが最適です。
開示事項
著者は、商業的または財務的な利益相反がないことを報告します。人工知能の使用に関して、著者は、言語編集、一貫性の確認、変更履歴付き修正案の作成、および著者が提供したデータに基づく図表レイアウトの再生成を支援する目的のみに、改訂プロセスでOpenAI Codexを利用したことを開示します。著者は、AI支援によるすべての出力を細心の注意を払って確認しており、最終原稿の正確性、完全性、および独創性について全責任を負います。報告された要約の根拠となる構造化ワークブックは、Zenodo (https://doi.org/10.5281/zenodo.21189434) で公開されています。補足ファイル1には、コーディングマニュアルとアンカー付き品質ルーブリックが含まれています。
謝辞
著者は、研究室のサポートを提供した桂林情報技術学院、原文を評価したバイリンガルの専門家、独立評価者、および参加者に感謝いたします。本研究は、公的、商業的、または非営利セクターのいかなる資金提供機関からも特定の助成金を受けていません。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| 音響分析ソフト (Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| デスクトップコンピューター | Dell | OptiPlex | |
| デジタルオーディオ録音ソフト (Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| キーストローク・ロギング・ソフト (Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| 画面録画ソフト (OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| 統計解析ソフト (SPSS) | IBM | Version 27 |
参考文献
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
再版と許可
タグ
この記事は公開されました
動画は近日公開